Diese Folge hat einen anderen Charakter als die bisherigen. Die vorherigen erklären, was auf einer BIOS-Seite steht. Diese hier erklärt, was auf einer BIOS-Seite fehlt, und was das für Folgen hatte.
Angefangen hat es damit, dass ich beim Durchsehen der Startmeldungen über eine Zeile gestolpert bin, die ich vorher zwar hunderte Male gesehen, aber nie gelesen hatte:
acpi PNP0A08:07: _OSC: platform does not support [SHPCHotplug AER LTR DPC]
Übersetzt: das BIOS teilt dem Betriebssystem mit, dass es vier Dinge nicht unterstützt, unter anderem AER. Und AER ist die Fehlerbehandlung für PCIe. Teil 10 der Serie, alles Übrige unter BIOS & Firmware.
Was AER macht, und warum man es haben will
PCIe ist eine serielle Verbindung mit hoher Frequenz, und wie jede solche Verbindung ist sie nicht fehlerfrei. Es gibt zwei Sorten Fehler. Korrigierbare, bei denen ein Paket neu geschickt wird und niemand etwas merkt. Und nicht korrigierbare, bei denen Daten verloren sind.
AER, Advanced Error Reporting, zählt beides mit. Das ist vor allem bei den korrigierbaren interessant, denn die sind ein Frühwarnsystem: eine Verbindung, die langsam schlechter wird, fällt nicht plötzlich aus, sondern sammelt erst über Wochen korrigierte Fehler.
Das war für mich kein akademisches Thema. Meine NVMe-Laufwerke hängen nicht direkt am Board, sondern an einem 75 Zentimeter langen Kabel, das einen SlimSAS-Anschluss auf zwei Laufwerke aufteilt. 75 Zentimeter sind für ein Gen-4-Signal eine Menge. Wenn irgendwo in dieser Maschine eine Verbindung Ärger machen würde, dann diese.
Der Zustand vorher: die Bits werden gesetzt, aber niemand liest sie
Der spannende Teil ist, dass die Hardware trotzdem mitzählt. Im Statusregister der NVMe standen Fehlerbits:
lspci -vv -s c3:00.0 | grep DevSta
#   DevSta: CorrErr+ NonFatalErr- FatalErr- UnsupReq+
Das + hinter CorrErr heisst: hier ist mindestens ein korrigierbarer Fehler aufgetreten. Gleichzeitig standen die eigentlichen AER-Zähler auf null:
cat /sys/bus/pci/devices/0000:c3:00.0/aer_dev_correctable
#   TOTAL_ERR_COR 0
Kein Widerspruch, sondern genau das Bild, das man bei abgeschalteter Fehlerbehandlung erwartet. Die Hardware setzt ihre Statusbits, weil sie das immer tut. Aber es gibt niemanden, der sie ausliest, auswertet, ins Protokoll schreibt und wieder zurücksetzt. Ein Zähler, den keiner bedient.
Praktisch hiess das: PCIe-Fehler tauchten in meinem Journal überhaupt nicht auf. Wäre das Kabel langsam gestorben, hätte ich es erst gemerkt, wenn das Laufwerk weg gewesen wäre.
Warum das BIOS nein sagt
Der Mechanismus dahinter heisst _OSC, Operating System Capabilities. Beim Start fragt das Betriebssystem die Firmware: darf ich diese Dinge übernehmen? Die Firmware antwortet. Sagt sie nein, geht der Kernel davon aus, dass die Firmware das selbst macht, und hält sich raus.
Das Modell nennt sich firmware-first und ist in echten Servern durchaus sinnvoll: die Firmware fängt Fehler ab, meldet sie über einen definierten Kanal an das Betriebssystem, und der Verwaltungscontroller bekommt sie auch mit. In einem Rack mit Fernwartung will man genau das.
Nur muss die Firmware es dann auch tatsächlich tun. Und der Kanal dafür heisst WHEA.
WHEA, und die Falle die ich fast getappt wäre
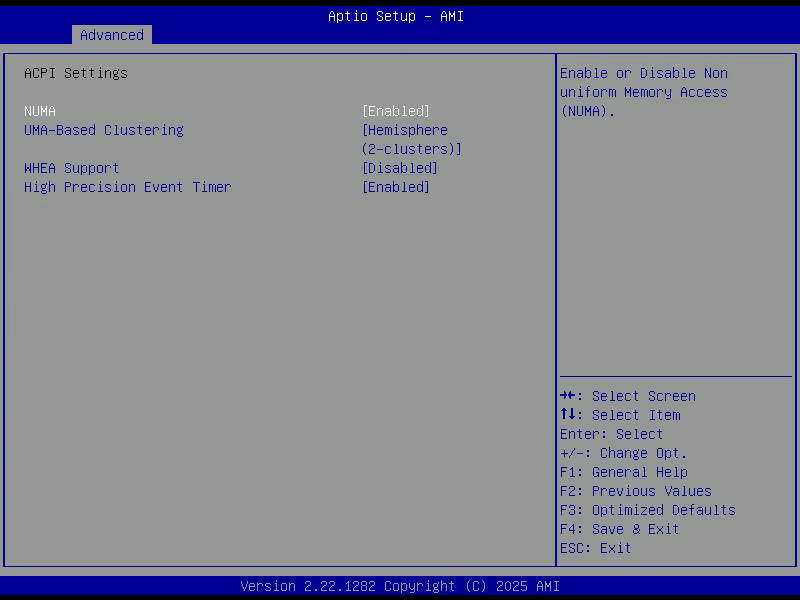
Unter Advanced > ACPI Settings steht:
NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]
WHEA Support                      [Disabled]
High Precision Event Timer        [Enabled]
WHEA ist der firmware-first-Kanal, und er steht auf Disabled. Damit war die Lage eindeutig: das BIOS sagt dem Betriebssystem „lass mal, ich mache das“, und macht es dann nicht.
Meine erste Reaktion war, WHEA einzuschalten. Das wäre falsch gewesen, und ich schreibe das hier auf, weil es die naheliegende und trotzdem schlechtere Lösung ist. Firmware-first bedeutet, dass Fehlerbehandlung über ACPI-Tabellen läuft, die die Firmware bereitstellen muss. Prüfen kann man das:
ls /sys/firmware/acpi/tables/ | grep -E "HEST|BERT|ERST|EINJ"
#   (keine Ausgabe)
Keine einzige davon vorhanden. Kein HEST, in dem stünde welche Fehlerquellen es überhaupt gibt. Kein BERT für Fehler aus dem letzten Absturz. Die Firmware ist für diesen Weg schlicht nicht eingerichtet.
Der bessere Weg ist die andere Richtung: dem Betriebssystem die Arbeit geben.
Ein Kernel-Parameter statt eines BIOS-Besuchs
Linux kennt dafür einen Schalter, der die _OSC-Antwort schlicht ignoriert:
GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pcie_ports=native"
Danach update-grub, neu starten, fertig. Der Unterschied ist deutlich:
# vorher
dmesg | grep -c "AER: enabled"
#   0

# nachher
dmesg | grep -c "AER: enabled"
#   7
Sieben Root Ports mit aktiver Fehlerbehandlung, darunter die beiden, um die es mir ging:
pcieport 0000:c2:04.0: AER: enabled with IRQ 130
pcieport 0000:c2:05.0: AER: enabled with IRQ 131
Wichtig für alle die das nachbauen: die _OSC-Zeile beim Booten sagt weiterhin platform does not support. Sie ändert sich nicht und wird sich nie ändern, das ist die Antwort der Firmware. Der Parameter sorgt nur dafür, dass der Kernel sie ignoriert. Wer nach dem Neustart auf diese Zeile schaut, hält die Massnahme fälschlich für wirkungslos. Das Erfolgskriterium ist AER: enabled, nicht _OSC.
Als Zugabe kam noch DPC dazu, Downstream Port Containment. Das riegelt bei einem schweren Fehler den betroffenen Anschluss ab, statt den ganzen Rechner mitzureissen. Bei einem Laufwerk an einem 75-Zentimeter-Kabel ist mir das ausgesprochen recht.
Die zwei Schalter im BIOS, die man dafür in Ruhe lassen muss
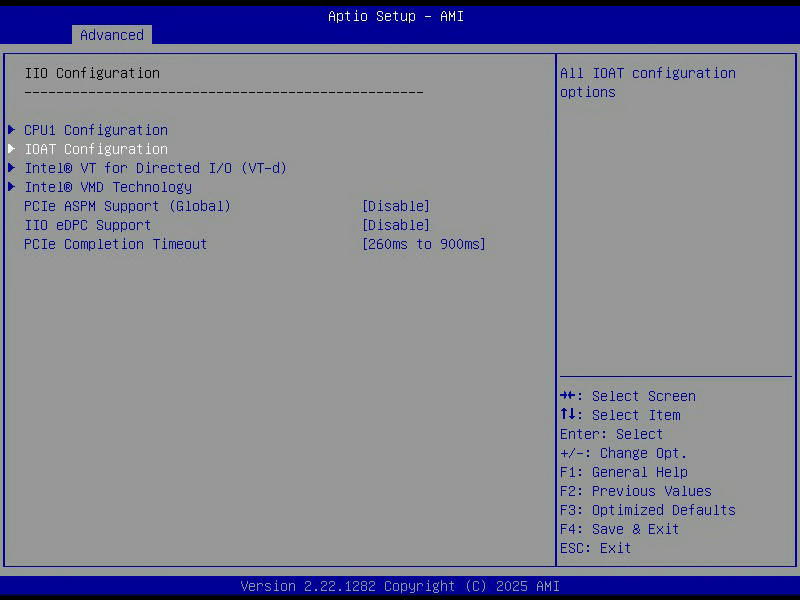
Unter Advanced > Chipset Configuration > North Bridge > IIO Configuration:
> CPU1 Configuration
> IOAT Configuration
> Intel(R) VT for Directed I/O (VT-d)
> Intel(R) VMD Technology
PCIe ASPM Support (Global)        [Disable]
IIO eDPC Support                  [Disable]
PCIe Completion Timeout           [260ms to 900ms]
Einen AER-Schalter gibt es hier nicht. Ich habe danach gesucht, ihn gibt es schlicht nicht, und deshalb war der Kernel-Parameter nicht der bequemere Weg sondern der einzige.
IIO eDPC Support ist die firmware-first-Variante von DPC, also das Gegenstück zu dem, was pcie_ports=native gerade aktiviert hat. Dass es auf Disable steht, ist der Grund weshalb der Kernel DPC übernehmen konnte. Nicht einschalten, sonst reisst die Firmware die Eindämmung wieder an sich und kollidiert mit dem nativen Mechanismus.
PCIe ASPM Support (Global) [Disable] ist etwas anderes und wird gerne verwechselt. ASPM sind Stromsparzustände für die Verbindung selbst: bei wenig Verkehr werden Teile der Leitung schlafen gelegt. Das spart im Leerlauf ein paar Watt und kostet Latenz beim Aufwachen. Auf Servern ist es traditionell aus, weil es in der Vergangenheit für schwer zu findende Aussetzer gesorgt hat. Meine NVMe kann es ohnehin nicht, das steht so in ihren Fähigkeiten.
Nicht verwechseln mit dem Herunterttakten aus Teil 8: dass eine Grafikkarte im Leerlauf auf PCIe 1.0 fällt, ist Link-Geschwindigkeitsverwaltung und hat mit ASPM nichts zu tun. ASPM regelt Zustände, nicht Tempo. Die beiden Befunde „ASPM ist aus“ und „der Link taktet runter“ stehen sich nicht im Weg.
Und dann kam das, weswegen ich das alles gemacht habe
Fehlerbehandlung aktiv zu haben ist nur die halbe Miete. Die Zähler im sysfs stehen nach jedem Neustart wieder auf null. Wer alle paar Wochen hinsieht, sieht nur den Ausschnitt seit dem letzten Start.
Also habe ich noch ein Paket nachinstalliert:
apt-get install rasdaemon
Das Ding läuft als Dienst, hört auf die Fehlerereignisse des Kernels und schreibt sie mit Zeitstempel in eine kleine Datenbank. Speicherfehler, Machine Checks, und eben AER. Beim Einrichten war alles auf null, und ich hatte ehrlich gesagt damit gerechnet, dass das so bleibt.
Beim Schreiben dieser Folge habe ich noch einmal nachgesehen:
ras-mc-ctl --summary
#   No Memory errors.
#
#   PCIe AER events summary:
#           15 Corrected errors: Receiver Error
#
#   No Extlog errors.
#   No MCE errors.
Fünfzehn korrigierte Fehler. Der Speicher ist sauber, die Machine Checks sind sauber, aber auf PCIe stand etwas. Und jetzt kommt der Teil, für den sich die ganze Übung gelohnt hat, denn die Datenbank weiss auch wo und wann:
ras-mc-ctl --errors
#   1  2026-08-03 12:48:54  0000:c2:05.0  Corrected error: Receiver Error
#   ...
#   15 2026-08-03 13:04:34  0000:c2:05.0  Corrected error: Receiver Error
Alle fünfzehn am selben Tag, innerhalb von sechzehn Minuten, alle am selben Anschluss. c2:05.0 ist der zweite NVMe-Port. Und der dritte August war der Tag, an dem an genau diesem Strang gearbeitet wurde.
Damit ist es keine besorgniserregende Meldung, sondern eine erklärbare: Empfangsfehler, während sich eine Verbindung aufbaut, sind erwartbar. Seitdem, und das ist die eigentlich gute Nachricht, ist kein einziger dazugekommen.
Aber genau das ist der Punkt. Ohne den Kernel-Parameter hätte niemand diese fünfzehn Ereignisse registriert. Ohne rasdaemon wären sie beim nächsten Neustart verschwunden. Und wenn dieselben fünfzehn Einträge nicht an einem einzigen Nachmittag aufgetreten wären, sondern verteilt über drei Wochen ohne dass jemand am Gehäuse war, dann wäre das die Vorwarnung gewesen, wegen der ich das alles überhaupt eingerichtet habe.
Fazit
Von allen Änderungen, die ich an dieser Maschine gemacht habe, ist diese die unauffälligste und vermutlich die nützlichste. Sie kostet einen Kernel-Parameter, ein Paket und einen Neustart. Sie ändert im Alltag nichts. Und sie ist der Unterschied zwischen „das Laufwerk ist plötzlich weg“ und „an diesem Anschluss stimmt seit zwei Wochen etwas nicht“.
Was ich mitnehme: eine Firmware, die _OSC mit „unterstütze ich nicht“ beantwortet und gleichzeitig den eigenen Meldeweg abgeschaltet hat, hinterlässt eine Lücke, die man nur findet wenn man danach sucht. Beim Einrichten einer neuen Maschine würde ich ab jetzt immer nach dieser einen Zeile im Startprotokoll greppen.
Nächste Folge: Virtualisierung. VT-d, IOMMU-Gruppen, VMD und ein Menü namens IOAT, in dem etwas ganz anderes steht als der Name vermuten lässt.
Siehe auch
- Teil 8 der Serie (die Anschlüsse an denen diese Fehler gezählt werden)
- Teil 6 der Serie (derselbe Dienst, dieselbe Datenbank, für den Speicher)
Falls jemand von euch eine steigende Zahl korrigierter PCIe-Fehler in freier Wildbahn hatte und am Ende die Ursache gefunden hat: Kabel, Riser, Steckplatz? Das würde mich sehr interessieren, ihr dürft mich jederzeit fragen.
Schreibe einen Kommentar