Wenn man einer virtuellen Maschine eine echte Grafikkarte geben will, stösst man ziemlich schnell auf einen Begriff, der wie eine Ausrede klingt: IOMMU-Gruppen. Man liest dann Sätze wie „deine Karte ist in derselben Gruppe wie der USB-Controller, also geht das nicht“, und wenn man Pech hat, findet man kurz darauf Anleitungen mit dem Wort „ACS-Override“ darin, die einem erklären wie man diese Regel umgeht und dabei die Isolation aushebelt.
Der Ursprung dieser ganzen Geschichte liegt in einem einzigen BIOS-Untermenü, und um das geht es heute. Teil 11 der Serie, alle Folgen unter BIOS & Firmware. Wir sind unter Advanced > Chipset Configuration > North Bridge > IIO Configuration, und diesmal in den Untermenüs statt auf der Übersicht.
VT-d, oder: wer darf in den Speicher schreiben
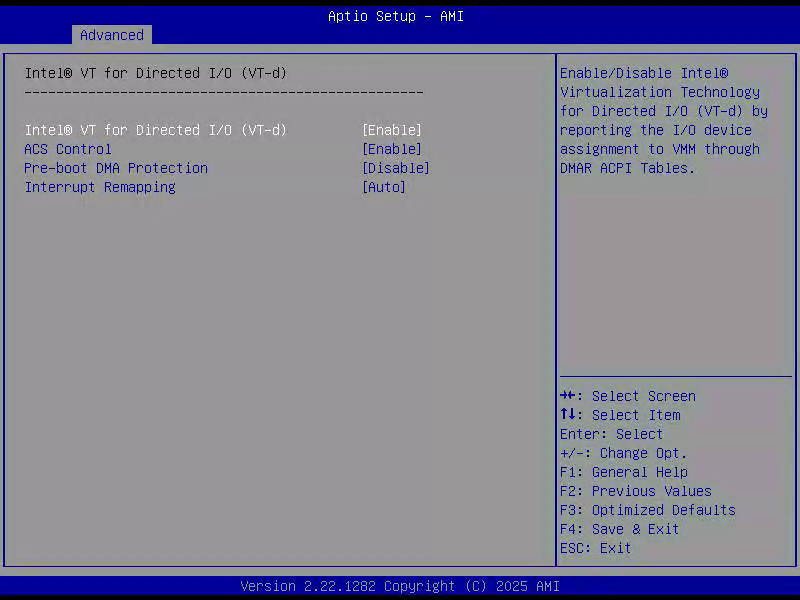
Intel(R) VT for Directed I/O (VT-d)   [Enable]
ACS Control                           [Enable]
Pre-boot DMA Protection               [Disable]
Interrupt Remapping                   [Auto]
Das Grundproblem, das VT-d löst, ist älter als Virtualisierung. Eine PCIe-Karte darf per DMA selbständig in den Arbeitsspeicher schreiben, ohne die CPU zu fragen. Das ist der Grund, warum Netzwerkkarten und Laufwerke überhaupt schnell sind. Es bedeutet aber auch, dass eine Karte in jeden beliebigen Speicherbereich schreiben kann, sofern niemand sie daran hindert.
Die IOMMU ist dieser Jemand. Sie sitzt zwischen den Geräten und dem Speicher und übersetzt Adressen, genau wie die MMU es für Prozesse tut. Ein Gerät sieht dann nur noch den Speicher, der ihm zugewiesen wurde. Damit kann man einer virtuellen Maschine eine echte Karte geben, ohne dass diese Karte den Speicher des Wirtssystems lesen könnte.
Bei mir ist das aktiv, was man am Startprotokoll sieht:
Interrupt Remapping ist der zweite Teil derselben Absicherung. Interrupts sind auf modernen Systemen einfach Schreibzugriffe auf eine bestimmte Adresse. Ohne Umsetzung könnte ein Gerät damit Interrupts auslösen, die für andere gedacht sind. Die Umsetzung schiebt eine Tabelle dazwischen.
Nebenbei erklärt das eine Kuriosität aus Teil 4: dort stand ein Schalter namens Extended APIC auf Disable, und trotzdem läuft mein System im x2APIC-Modus. Der Grund steht in der Zeile oben. Der Kernel schaltet x2APIC selbst ein, sobald Interrupt Remapping läuft, weil er es dafür braucht. Die BIOS-Option entscheidet nur, ob die Firmware es vorab tut.
ACS, und die Sache mit den Gruppen
ACS Control [Enable] ist der Schalter, wegen dem ich diese Folge angefangen habe.
Access Control Services regeln, ob zwei Geräte hinter demselben Switch direkt miteinander reden dürfen, ohne dass der Verkehr über die IOMMU läuft. Ohne ACS kann die IOMMU nicht garantieren, dass zwei Geräte voneinander getrennt sind, und muss sie deshalb als eine Einheit behandeln. Das ist eine IOMMU-Gruppe: die kleinste Menge Geräte, die man nur gemeinsam durchreichen kann.
Bei mir sieht das ordentlich aus:
ls /sys/kernel/iommu_groups | wc -l
#   102
102 Gruppen, und die meisten enthalten genau ein Gerät. Das ist der Zustand, den man haben will, und man bekommt ihn nicht geschenkt. Auf typischen Consumer-Boards liegen regelmässig ein halbes Dutzend Geräte in einer Gruppe, weil der Chipsatz sie hinter einem Switch ohne ACS bündelt. Dann kommen die Anleitungen mit dem ACS-Override ins Spiel, und die tun genau das wonach sie klingen: sie lügen dem Kernel vor, es gäbe eine Trennung. Für ein Heimlabor mag das reichen. Es ist trotzdem das Abschalten einer Sicherheitsfunktion, und man sollte wissen dass man es tut.
Ein Beispiel aus meiner Maschine, das den Unterschied zeigt: als vorübergehend eine Beschleunigerkarte in Steckplatz 7 steckte, landete sie allein in Gruppe 6. Alleine in einer Gruppe heisst durchreichbar, ohne Tricks, ohne Override. Das war die Voraussetzung dafür, überhaupt darüber nachzudenken, sie einer virtuellen Maschine zu geben.
Pre-boot DMA Protection [Disable] schützt das Zeitfenster vor dem Betriebssystemstart. Der klassische Angriff dagegen läuft über Thunderbolt: Gerät anstecken während der Rechner im Setup steht, per DMA Speicher auslesen. Dieses Board hat kein Thunderbolt, und wer physisch am Gehäuse steht, hat ohnehin bessere Möglichkeiten. Aus ist hier vertretbar.
VMD, und warum es aus bleibt
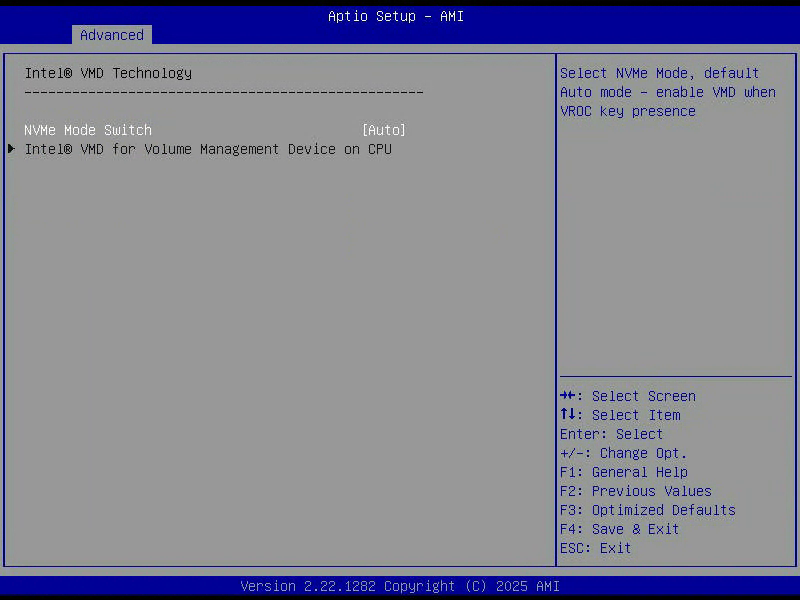
Intel(R) VMD Technology
NVMe Mode Switch                  [Auto]
> Intel(R) VMD for Volume Management Device on CPU
Volume Management Device ist eine Erfindung, die vor allem für vorkonfigurierte Server gedacht ist. Eingeschaltet fasst der Prozessor mehrere NVMe-Laufwerke zusammen und präsentiert sie nach aussen als ein einziges Gerät. Das ermöglicht Hot-Plug ohne Betriebssystemunterstützung und ist die Voraussetzung für Intels RAID-Lösung VROC.
Bei mir steht das auf Auto, und der Hilfetext im Setup sagt dazu wörtlich default Auto mode, enable VMD when VROC key presence. Also nur aktiv, wenn ein VROC-Lizenzschlüssel steckt. Es steckt keiner. Die Gegenprobe:
Nichts da, beide Laufwerke hängen direkt an ihren Root Ports.
Und dabei soll es bleiben. Mit eingeschaltetem VMD verschwinden meine NVMe-Laufwerke hinter einem Controller, brauchen einen zusätzlichen Treiber, und sind nicht mehr einzeln als PCIe-Geräte sichtbar. Damit wäre unter anderem das weg, was ich in Teil 10 gerade mühsam eingerichtet habe: die AER-Zähler pro Gerät. Ich tausche keine funktionierende Diagnose gegen ein RAID, das ich nicht will.
Der dritte Wert wäre Manual, und laut Handbuch erscheint erst dann das Untermenü, in dem sich VMD pro Stack einzeln einschalten lässt. Solange Auto steht, ist dort nichts zu holen, was erklärt warum ich es beim Durchklicken nie geöffnet habe.
Kleine Korrektur in eigener Sache: in meinen Notizen stand lange, VMD stünde auf Disabled. Der Schalter heisst tatsächlich NVMe Mode Switch und kennt Manual, VMD und Auto. Die Wirkung ist dieselbe, die Beschriftung war meine.
IOAT, das Menü das nicht hält was der Name verspricht
Ich habe dieses Menü mit einer klaren Erwartung geöffnet. IOAT steht für I/O Acceleration Technology, dahinter stecken DMA-Engines im Prozessor, die Speicherkopien erledigen ohne die Kerne zu beschäftigen. Ich hatte mit Schaltern wie Enable IOAT und DCA gerechnet. Beide gibt es nicht.
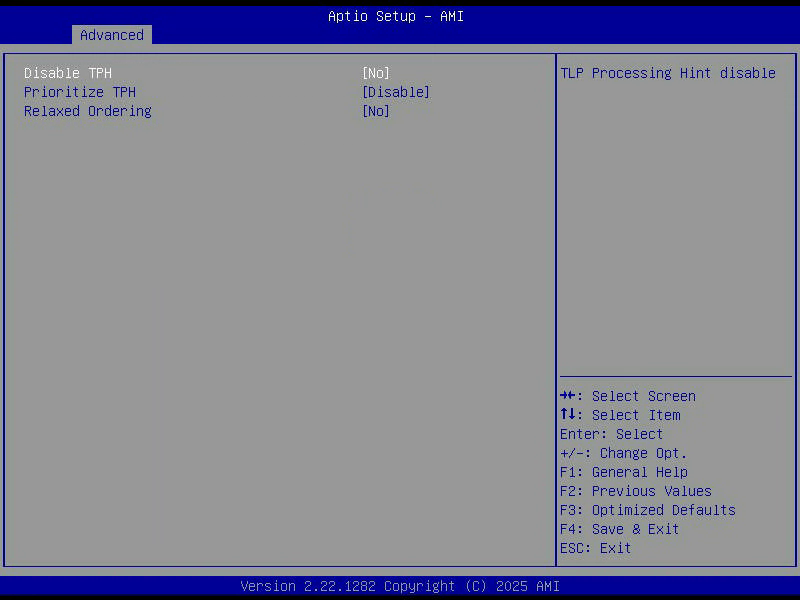
Stattdessen stehen dort drei Optionen, die mit dem Namen des Menüs wenig zu tun haben. TPH ist TLP Processing Hint: ein PCIe-Gerät kann einem Schreibzugriff einen Hinweis mitgeben, wohin die Daten am besten sollen, etwa direkt in den Cache eines bestimmten Kerns statt in den Hauptspeicher. Für eine Netzwerkkarte, deren Pakete gleich darauf verarbeitet werden, spart das den Umweg.
Relaxed Ordering erlaubt es, Transaktionen in anderer Reihenfolge abzuarbeiten als sie eingetroffen sind. Das kann Durchsatz bringen und setzt voraus, dass die Beteiligten keine Annahmen über die Reihenfolge treffen. Standard ist deshalb No.
Die DMA-Engines selbst laufen übrigens, ganz ohne sichtbaren Schalter:
ls /sys/class/dma/
#   dma0chan0  dma1chan0  ...  dma7chan0
Acht Kanäle. Der Name des Menüs stimmt also, der Inhalt passt nur nicht dazu.
Das Ganze hat mir nebenbei einen Fehler in meiner eigenen Dokumentation gezeigt. In meiner ersten Aufzeichnung war ein Bildschirm mit genau diesen drei Zeilen, und ich hatte ihn als „Slot-Unterseite“ abgelegt, weil ich das Menü nicht geöffnet hatte und nur den Inhalt sah. Es war die IOAT-Seite. Ich hatte sie die ganze Zeit, nur unter dem falschen Namen.
Was ich davon tatsächlich nutze
Ehrlich? Von diesen vier Menüs nutze ich aktiv genau eines. VT-d ist an und tut seinen Dienst, die Isolation ist sauber, 102 Gruppen sprechen für sich. VMD ist aus und soll aus bleiben, IOAT läuft von selbst, und die TPH-Einstellungen fasse ich nicht an ohne eine Messung zu haben.
Trotzdem ist es eine der Seiten, die ich nach diesem Durchgang anders sehe. Vorher war „IOMMU“ für mich ein Wort aus Passthrough-Anleitungen. Jetzt weiss ich, welcher Schalter dafür verantwortlich ist, dass meine Gruppen sauber getrennt sind, und warum das auf anderen Boards oft nicht so ist.
Nächste Folge: Storage. AHCI, Hot Plug, elf SATA-Anschlüsse von denen keiner belegt ist, und eine Sicherheitsfunktion in Laufwerken, die meine beiden NVMe nicht können.
Diese Folge hat einen anderen Charakter als die bisherigen. Die vorherigen erklären, was auf einer BIOS-Seite steht. Diese hier erklärt, was auf einer BIOS-Seite fehlt, und was das für Folgen hatte.
Angefangen hat es damit, dass ich beim Durchsehen der Startmeldungen über eine Zeile gestolpert bin, die ich vorher zwar hunderte Male gesehen, aber nie gelesen hatte:
acpi PNP0A08:07: _OSC: platform does not support [SHPCHotplug AER LTR DPC]
Übersetzt: das BIOS teilt dem Betriebssystem mit, dass es vier Dinge nicht unterstützt, unter anderem AER. Und AER ist die Fehlerbehandlung für PCIe. Teil 10 der Serie, alles Übrige unter BIOS & Firmware.
Was AER macht, und warum man es haben will
PCIe ist eine serielle Verbindung mit hoher Frequenz, und wie jede solche Verbindung ist sie nicht fehlerfrei. Es gibt zwei Sorten Fehler. Korrigierbare, bei denen ein Paket neu geschickt wird und niemand etwas merkt. Und nicht korrigierbare, bei denen Daten verloren sind.
AER, Advanced Error Reporting, zählt beides mit. Das ist vor allem bei den korrigierbaren interessant, denn die sind ein Frühwarnsystem: eine Verbindung, die langsam schlechter wird, fällt nicht plötzlich aus, sondern sammelt erst über Wochen korrigierte Fehler.
Das war für mich kein akademisches Thema. Meine NVMe-Laufwerke hängen nicht direkt am Board, sondern an einem 75 Zentimeter langen Kabel, das einen SlimSAS-Anschluss auf zwei Laufwerke aufteilt. 75 Zentimeter sind für ein Gen-4-Signal eine Menge. Wenn irgendwo in dieser Maschine eine Verbindung Ärger machen würde, dann diese.
Der Zustand vorher: die Bits werden gesetzt, aber niemand liest sie
Der spannende Teil ist, dass die Hardware trotzdem mitzählt. Im Statusregister der NVMe standen Fehlerbits:
Kein Widerspruch, sondern genau das Bild, das man bei abgeschalteter Fehlerbehandlung erwartet. Die Hardware setzt ihre Statusbits, weil sie das immer tut. Aber es gibt niemanden, der sie ausliest, auswertet, ins Protokoll schreibt und wieder zurücksetzt. Ein Zähler, den keiner bedient.
Praktisch hiess das: PCIe-Fehler tauchten in meinem Journal überhaupt nicht auf. Wäre das Kabel langsam gestorben, hätte ich es erst gemerkt, wenn das Laufwerk weg gewesen wäre.
Warum das BIOS nein sagt
Der Mechanismus dahinter heisst _OSC, Operating System Capabilities. Beim Start fragt das Betriebssystem die Firmware: darf ich diese Dinge übernehmen? Die Firmware antwortet. Sagt sie nein, geht der Kernel davon aus, dass die Firmware das selbst macht, und hält sich raus.
Das Modell nennt sich firmware-first und ist in echten Servern durchaus sinnvoll: die Firmware fängt Fehler ab, meldet sie über einen definierten Kanal an das Betriebssystem, und der Verwaltungscontroller bekommt sie auch mit. In einem Rack mit Fernwartung will man genau das.
Nur muss die Firmware es dann auch tatsächlich tun. Und der Kanal dafür heisst WHEA.
WHEA, und die Falle die ich fast getappt wäre
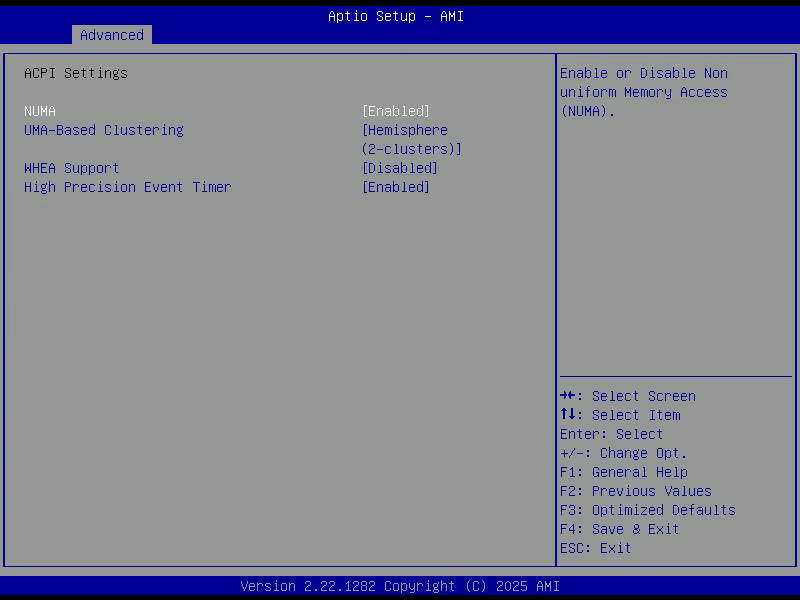
Unter Advanced > ACPI Settings steht:
NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]
WHEA Support                      [Disabled]
High Precision Event Timer        [Enabled]
WHEA ist der firmware-first-Kanal, und er steht auf Disabled. Damit war die Lage eindeutig: das BIOS sagt dem Betriebssystem „lass mal, ich mache das“, und macht es dann nicht.
Meine erste Reaktion war, WHEA einzuschalten. Das wäre falsch gewesen, und ich schreibe das hier auf, weil es die naheliegende und trotzdem schlechtere Lösung ist. Firmware-first bedeutet, dass Fehlerbehandlung über ACPI-Tabellen läuft, die die Firmware bereitstellen muss. Prüfen kann man das:
ls /sys/firmware/acpi/tables/ | grep -E "HEST|BERT|ERST|EINJ"
#   (keine Ausgabe)
Keine einzige davon vorhanden. Kein HEST, in dem stünde welche Fehlerquellen es überhaupt gibt. Kein BERT für Fehler aus dem letzten Absturz. Die Firmware ist für diesen Weg schlicht nicht eingerichtet.
Der bessere Weg ist die andere Richtung: dem Betriebssystem die Arbeit geben.
Ein Kernel-Parameter statt eines BIOS-Besuchs
Linux kennt dafür einen Schalter, der die _OSC-Antwort schlicht ignoriert:
Sieben Root Ports mit aktiver Fehlerbehandlung, darunter die beiden, um die es mir ging:
pcieport 0000:c2:04.0: AER: enabled with IRQ 130
pcieport 0000:c2:05.0: AER: enabled with IRQ 131
Wichtig für alle die das nachbauen: die _OSC-Zeile beim Booten sagt weiterhin platform does not support. Sie ändert sich nicht und wird sich nie ändern, das ist die Antwort der Firmware. Der Parameter sorgt nur dafür, dass der Kernel sie ignoriert. Wer nach dem Neustart auf diese Zeile schaut, hält die Massnahme fälschlich für wirkungslos. Das Erfolgskriterium ist AER: enabled, nicht _OSC.
Als Zugabe kam noch DPC dazu, Downstream Port Containment. Das riegelt bei einem schweren Fehler den betroffenen Anschluss ab, statt den ganzen Rechner mitzureissen. Bei einem Laufwerk an einem 75-Zentimeter-Kabel ist mir das ausgesprochen recht.
Die zwei Schalter im BIOS, die man dafür in Ruhe lassen muss
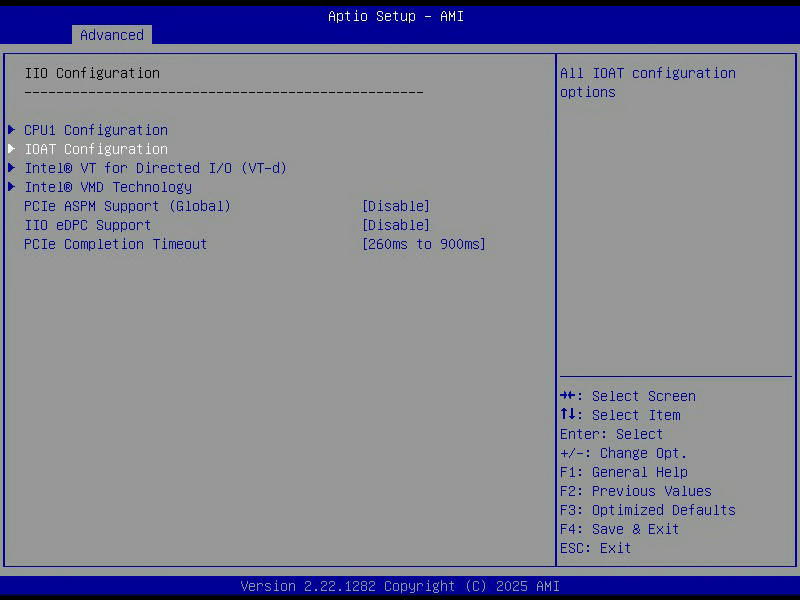
Unter Advanced > Chipset Configuration > North Bridge > IIO Configuration:
> CPU1 Configuration
> IOAT Configuration
> Intel(R) VT for Directed I/O (VT-d)
> Intel(R) VMD Technology
PCIe ASPM Support (Global)        [Disable]
IIO eDPC Support                  [Disable]
PCIe Completion Timeout           [260ms to 900ms]
Einen AER-Schalter gibt es hier nicht. Ich habe danach gesucht, ihn gibt es schlicht nicht, und deshalb war der Kernel-Parameter nicht der bequemere Weg sondern der einzige.
IIO eDPC Support ist die firmware-first-Variante von DPC, also das Gegenstück zu dem, was pcie_ports=native gerade aktiviert hat. Dass es auf Disable steht, ist der Grund weshalb der Kernel DPC übernehmen konnte. Nicht einschalten, sonst reisst die Firmware die Eindämmung wieder an sich und kollidiert mit dem nativen Mechanismus.
PCIe ASPM Support (Global) [Disable] ist etwas anderes und wird gerne verwechselt. ASPM sind Stromsparzustände für die Verbindung selbst: bei wenig Verkehr werden Teile der Leitung schlafen gelegt. Das spart im Leerlauf ein paar Watt und kostet Latenz beim Aufwachen. Auf Servern ist es traditionell aus, weil es in der Vergangenheit für schwer zu findende Aussetzer gesorgt hat. Meine NVMe kann es ohnehin nicht, das steht so in ihren Fähigkeiten.
Nicht verwechseln mit dem Herunterttakten aus Teil 8: dass eine Grafikkarte im Leerlauf auf PCIe 1.0 fällt, ist Link-Geschwindigkeitsverwaltung und hat mit ASPM nichts zu tun. ASPM regelt Zustände, nicht Tempo. Die beiden Befunde „ASPM ist aus“ und „der Link taktet runter“ stehen sich nicht im Weg.
Und dann kam das, weswegen ich das alles gemacht habe
Fehlerbehandlung aktiv zu haben ist nur die halbe Miete. Die Zähler im sysfs stehen nach jedem Neustart wieder auf null. Wer alle paar Wochen hinsieht, sieht nur den Ausschnitt seit dem letzten Start.
Also habe ich noch ein Paket nachinstalliert:
apt-get install rasdaemon
Das Ding läuft als Dienst, hört auf die Fehlerereignisse des Kernels und schreibt sie mit Zeitstempel in eine kleine Datenbank. Speicherfehler, Machine Checks, und eben AER. Beim Einrichten war alles auf null, und ich hatte ehrlich gesagt damit gerechnet, dass das so bleibt.
Beim Schreiben dieser Folge habe ich noch einmal nachgesehen:
ras-mc-ctl --summary
#   No Memory errors.
#
#   PCIe AER events summary:
#           15 Corrected errors: Receiver Error
#
#   No Extlog errors.
#   No MCE errors.
Fünfzehn korrigierte Fehler. Der Speicher ist sauber, die Machine Checks sind sauber, aber auf PCIe stand etwas. Und jetzt kommt der Teil, für den sich die ganze Übung gelohnt hat, denn die Datenbank weiss auch wo und wann:
Alle fünfzehn am selben Tag, innerhalb von sechzehn Minuten, alle am selben Anschluss. c2:05.0 ist der zweite NVMe-Port. Und der dritte August war der Tag, an dem an genau diesem Strang gearbeitet wurde.
Damit ist es keine besorgniserregende Meldung, sondern eine erklärbare: Empfangsfehler, während sich eine Verbindung aufbaut, sind erwartbar. Seitdem, und das ist die eigentlich gute Nachricht, ist kein einziger dazugekommen.
Aber genau das ist der Punkt. Ohne den Kernel-Parameter hätte niemand diese fünfzehn Ereignisse registriert. Ohne rasdaemon wären sie beim nächsten Neustart verschwunden. Und wenn dieselben fünfzehn Einträge nicht an einem einzigen Nachmittag aufgetreten wären, sondern verteilt über drei Wochen ohne dass jemand am Gehäuse war, dann wäre das die Vorwarnung gewesen, wegen der ich das alles überhaupt eingerichtet habe.
Fazit
Von allen Änderungen, die ich an dieser Maschine gemacht habe, ist diese die unauffälligste und vermutlich die nützlichste. Sie kostet einen Kernel-Parameter, ein Paket und einen Neustart. Sie ändert im Alltag nichts. Und sie ist der Unterschied zwischen „das Laufwerk ist plötzlich weg“ und „an diesem Anschluss stimmt seit zwei Wochen etwas nicht“.
Was ich mitnehme: eine Firmware, die _OSC mit „unterstütze ich nicht“ beantwortet und gleichzeitig den eigenen Meldeweg abgeschaltet hat, hinterlässt eine Lücke, die man nur findet wenn man danach sucht. Beim Einrichten einer neuen Maschine würde ich ab jetzt immer nach dieser einen Zeile im Startprotokoll greppen.
Nächste Folge: Virtualisierung. VT-d, IOMMU-Gruppen, VMD und ein Menü namens IOAT, in dem etwas ganz anderes steht als der Name vermuten lässt.
Siehe auch
Teil 8 der Serie (die Anschlüsse an denen diese Fehler gezählt werden)
Teil 6 der Serie (derselbe Dienst, dieselbe Datenbank, für den Speicher)
Falls jemand von euch eine steigende Zahl korrigierter PCIe-Fehler in freier Wildbahn hatte und am Ende die Ursache gefunden hat: Kabel, Riser, Steckplatz? Das würde mich sehr interessieren, ihr dürft mich jederzeit fragen.
Es gibt in jedem BIOS eine Seite, auf der die Dinge landen, die sonst nirgends hinpassen. Bei Supermicro heisst sie PCIe/PCI/PnP Configuration, und das PnP im Namen ist Plug and Play, ein Begriff aus den Neunzigern, der damals eher ein Versprechen als eine Beschreibung war. Ich interpretiere das einfach für mich jetzt mal so, ok?
Oben stehen Einstellungen, die für alle PCIe-Geräte gelten. Unten steht für jeden einzelnen Steckplatz eine Zeile. Beides ist interessant, aber aus unterschiedlichen Gründen. Das hier ist Teil 9, gesammelt liegt alles unter BIOS & Firmware.
Die obere Hälfte
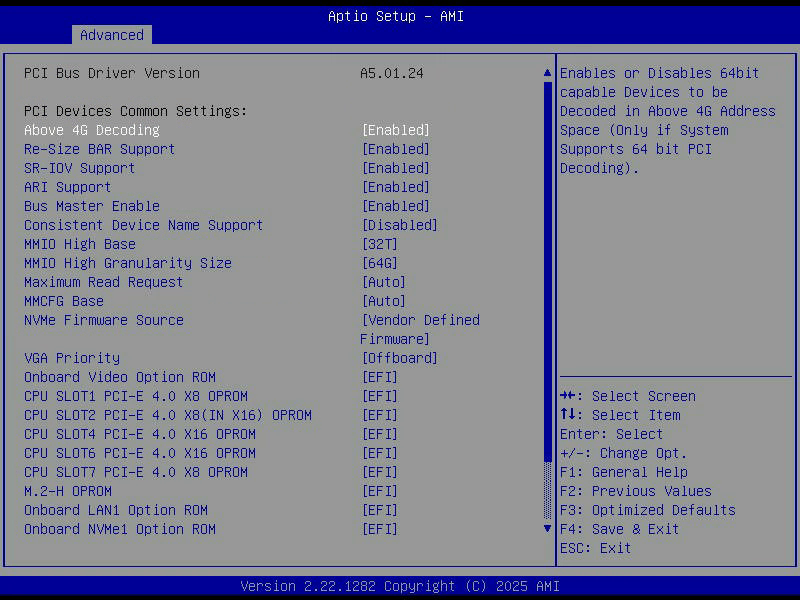
Above 4G Decoding                 [Enabled]
Re-Size BAR Support               [Enabled]
SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]
Bus Master Enable                 [Enabled]
Consistent Device Name Support    [Disabled]
MMIO High Base                    [32T]
MMIO High Granularity Size        [64G]
Maximum Read Request              [Auto]
MMCFG Base                        [Auto]
Alles auf Enabled, ich denke für mich genau richtig; also den Computer hier :D. Trotzdem lohnt es sich, die ersten beiden anzusehen, weil sie zusammengehören und weil sie ein handfestes Problem lösen. Mein letztes Bios hatte diese Möglichkeit nicht, weil die PCIe Version zu alt war. Ich freue mich also über diese neue Möglichkeit. Ich muss grade an Franck Ribéry „Jubel“ denken.
Das 4-GB-Problem, oder: warum 16 GB Grafikspeicher nicht sichtbar waren
Jedes PCIe-Gerät blendet seinen Speicher in den Adressraum des Rechners ein. Diese Fenster heissen BARs, Base Address Registers. Eine Grafikkarte mit 16 GB Videospeicher hätte gerne ein Fenster von 16 GB, damit die CPU auf den ganzen Speicher direkt zugreifen kann.
Das Problem: historisch lagen diese Fenster alle unterhalb der 4-GB-Grenze, weil dort in einem 32-Bit-Adressraum eben Schluss ist. Na wer erinnert sich noch an zu große DVD Images auf 32-Bit Filesystemen? Unterhalb von 4 GB liegen aber auch der Arbeitsspeicher, die Firmware und noch einiges mehr. Für die Geräte bleibt ein schmaler Streifen übrig, bei mir ist das dieser hier:
Global MMIO Low Base / Limit 90000000 / FBFFFFFF
Von 0x90000000 bis 0xFBFFFFFF, also knapp 1,7 GB für alle Karten zusammen. Da passt keine moderne Grafikkarte hinein, geschweige denn eine Grafikkarte und zwei Netzwerkkarten und zwei NVMe-Laufwerke.
Above 4G Decoding hebt diese Grenze auf. Die Fenster dürfen dann oberhalb von 4 GB liegen, und dort ist Platz ohne Ende:
Global MMIO High Base / Limit 0000200000000000 / 0000204FFFFFFFFF
Das beginnt bei 32 Terabyte und ist 320 GB gross. Genau das steht auch in der Zeile MMIO High Base [32T] weiter unten.
Ohne diesen Schalter bekommt eine 16-GB-Grafikkarte ein Notfallfenster von 256 MB und muss ihren restlichen Speicher stückweise durchreichen. Das funktioniert, kostet aber Leistung, und bei manchen Karten funktioniert es gar nicht. Wer sich fragt, warum sein Rechner mit einer neuen Grafikkarte gar nicht mehr durchbootet: hier nachsehen oder auch, wenn die Performance deutlich unter der Erwartung liegt.
Resizable BAR, der Schalter mit dem Spielerimage
Re-Size BAR Support ist der zweite Teil desselben Gedankens. Above 4G schafft den Platz, Resizable BAR erlaubt der Karte, ein entsprechend grosses Fenster tatsächlich anzufordern.
Bekannt geworden ist die Funktion vor ein paar Jahren als Gaming-Feature, weil AMD sie als „Smart Access Memory“ vermarktet hat und in einigen Spielen ein paar Prozent mehr Bilder pro Sekunde herauskamen. Der eigentliche Nutzen liegt woanders: überall dort, wo grosse Datenmengen in den Grafikspeicher wandern und die CPU dabei mitreden muss. Rechnen auf der GPU, Modelle laden, Videobearbeitung.
Bei mir ist es also erst 2026 angekommen:
lspci -vv -s 51:00.0 | grep -A2 "Resizable BAR"
#   BAR 1: current size: 16GB, supported: ... 16GB
16 GB aktuell, und 16 GB ist zugleich die grösste unterstützte Grösse. Der komplette Videospeicher ist eingeblendet, mehr geht nicht. Zwei BIOS-Schalter, die zusammen dafür sorgen, dass die Karte tut was sie soll und zwar, zumindest hier, ungebremst.
SR-IOV und ARI
SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]
SR-IOV steht für Single Root I/O Virtualization und erlaubt einer Karte, sich gegenüber dem System als mehrere Geräte auszugeben. Eine Netzwerkkarte meldet dann neben ihrer physischen Funktion noch eine Reihe virtueller, und jede davon kann einer virtuellen Maschine direkt zugewiesen werden. Die VM redet dann ohne Umweg über den Hypervisor mit der Hardware. Wichtig für VMs also.
Meine X710 kann das, ich nutze es immer mal wieder in verschiedenen Projekten. Der Schalter kostet nichts, solange niemand virtuelle Funktionen anlegt, und wenn ich es noch einmal brauche, muss ich nicht neu starten.
ARI ist die technische Voraussetzung dafür. Alternative Routing-ID Interpretation klingt kompliziert und ist eine Adressierungsfrage: klassisch hat ein PCIe-Gerät bis zu acht Funktionen. Eine Karte mit dutzenden virtuellen Funktionen sprengt das. ARI verschiebt die Bitgrenze im Adressfeld, sodass mehr Funktionen pro Bus möglich sind. Ohne ARI kein sinnvolles SR-IOV.
Bus Master Enable erlaubt Geräten, selbst Speicherzugriffe auszulösen, statt darauf zu warten dass die CPU sie abholt. Das ist DMA, und ohne DMA ist jede halbwegs moderne Karte unbrauchbar. Der Schalter existiert vermutlich nur noch aus historischen Gründen. Oder fällt euch etwas ein, warum man direkten Speicherzugriff nicht will?
Maximum Read Request [Auto] legt fest, wie viele Daten ein Gerät mit einer einzigen Anfrage holen darf. Grössere Anfragen bedeuten weniger Verwaltungsaufwand. An meiner NVMe ergibt Auto 512 Byte, was zunächst wenig aussieht. Es ist aber kein BIOS-Problem: das Laufwerk selbst gibt in seinen Fähigkeiten nur 512 Byte an. Hochdrehen würde also nichts bringen, solange die Gegenseite nicht mitspielt.
Die untere Hälfte: Option ROMs
VGA Priority                      [Offboard]
Onboard Video Option ROM          [EFI]
CPU SLOT1 PCI-E 4.0 X8 OPROM      [EFI]
CPU SLOT2 PCI-E 4.0 X8(IN X16) OPROM [EFI]
CPU SLOT4 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT6 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT7 PCI-E 4.0 X8 OPROM      [EFI]
M.2-H OPROM                       [EFI]
Onboard LAN1 Option ROM           [EFI]
Onboard NVMe1 Option ROM          [EFI]
Onboard NVMe2 Option ROM          [EFI]
Ein Option ROM ist ein Stück Firmware auf der Steckkarte selbst. Beim Start lädt das BIOS diesen Code und führt ihn aus, damit die Karte schon nutzbar ist, bevor ein Betriebssystem existiert. Klassische Beispiele: eine Netzwerkkarte, die über PXE booten soll. Ein Speichercontroller, von dem gestartet wird. Eine Grafikkarte, die ein Bild anzeigen soll. Ihr versteht schon…
Die drei Werte sind EFI, Legacy und Disabled. EFI heisst modernes UEFI-Modul, Legacy heisst 16-Bit-Code aus der BIOS-Zeit, Disabled heisst gar nicht laden.
Bei mir steht überall EFI, was zum restlichen System passt, denn Legacy-Boot ist auf diesem Board abgeschaltet. Interessant ist eher, dass man diese Liste überhaupt hat. Auf einem Desktopboard gibt es allenfalls einen Schalter für alle. Hier kann man pro Steckplatz entscheiden.
Wozu? Zwei Gründe. Erstens Startzeit: jedes Option ROM kostet Zeit, und Netzwerkkarten sind darin führend, weil sie auf Link warten. Zweitens Angriffsfläche: das ist fremder Code, der vor dem Betriebssystem mit vollen Rechten läuft. Wer die Karte nur unter Linux nutzt und nie davon bootet, verliert durch Disabled nichts.
Ich habe einen konkreten Kandidaten dafür. Meine X710 meldet auf der Driver-Health-Seite des BIOS Failed, weil ihr UEFI-Treiber älter ist als die Firmware, die ich vor einer Weile aktualisiert habe. Die Karte funktioniert unter Linux tadellos, nur der Vorstart-Code beschwert sich über sich selbst. CPU SLOT6 OPROM auf Disabled, und die Meldung wäre weg. Kostenpunkt: kein PXE-Boot über diese Karte, was ich noch nie gebraucht habe. Dazu mehr in Teil 13.
VGA Priority
VGA Priority [Offboard]
Dieses Board hat eine eingebaute Grafik. Sie sitzt im Verwaltungscontroller, dem ASPEED AST2600, und ihr einziger Zweck ist die Fernkonsole. Sie ist grottig, das ist Absicht, sie soll ein Terminal darstellen und sonst nichts.
VGA Priority entscheidet, welche Karte das Bild beim Start bekommt. Offboard heisst: die Steckkarte. Genau so meldet es das laufende System:
Ganz abschalten lässt sich die eingebaute Grafik nicht, und das ist auch gut so: sie hängt am Verwaltungscontroller, und wer sie loswürde, hätte auch keine Fernkonsole mehr. Genau über die habe ich diese ganze Serie aufgezeichnet. IPMI und so halt, Video aufnehmen, Bilder heraus kopieren usw….
Eine Kleinigkeit, die mir erst beim zweiten Mal aufgefallen ist
Die Liste oben endet bei Onboard NVMe2 Option ROM. In meiner ersten Aufzeichnung war das letzte, was ich hatte, Onboard NVMe1, weil ich nicht weit genug gescrollt hatte. Der Hilfetext auf derselben Seite sprach aber von NVMe2, es musste also noch etwas darunter geben.
Nächste Folge: die dritte und letzte PCIe-Folge. ASPM, eDPC und die Frage, wer eigentlich mitbekommt wenn auf einer PCIe-Verbindung Fehler auftreten. Bei mir war die Antwort eine Zeit lang: niemand.
Siehe auch
Teil 8 der Serie (Slots, Lanes und warum die Grafikkarte nur acht Bahnen nutzt)
Teil 7 der Serie (woher die Adressbereiche kommen, die hier verteilt werden)
Falls jemand von euch Option ROMs gezielt abgeschaltet und dabei messbar Startzeit gespart hat: wie viel war es? Ihr dürft mich jederzeit fragen.
Als ich diese Maschine geplant habe, stand in meinen Notizen ein Punkt, der mich mehr beschäftigt hat als alles andere: „BIOS, SlimSAS-Port auf x4x4-Bifurcation stellen, sonst wird das Laufwerk am Breakout-Kabel nicht erkannt.“ Ich hatte das irgendwo gelesen, es klang plausibel, und ich habe mich darauf eingestellt, im Setup danach suchen zu müssen.
Dann kam die Hardware, ich habe alles zusammengebaut, die Maschine ging an, das Laufwerk war da. Ich habe die Einstellung nie gefunden, weil es sie nicht gibt. Und das ist eigentlich der beste Einstieg in diese Folge, denn es zeigt genau, was man über PCIe auf einem Serverboard wissen muss: die Lanes sind fest verdrahtet, und das Setup zeigt einem nur, was daraus geworden ist.
Teil 8 der Serie, es geht um `Advanced > Chipset Configuration > North Bridge > IIO Configuration
CPU1 Configuration`. Die anderen Folgen liegen unter
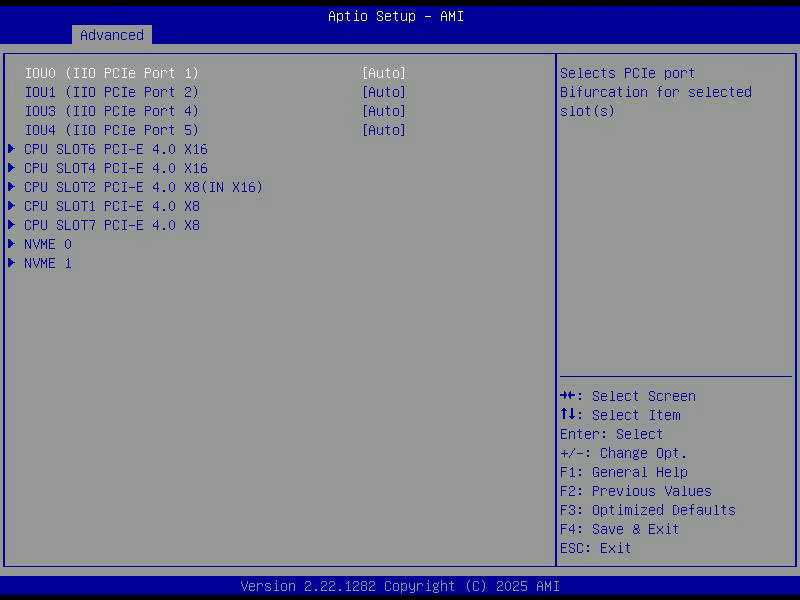
IOU0 (IIO PCIe Port 1)            [Auto]
IOU1 (IIO PCIe Port 2)            [Auto]
IOU3 (IIO PCIe Port 4)            [Auto]
IOU4 (IIO PCIe Port 5)            [Auto]
> CPU SLOT6 PCI-E 4.0 X16
> CPU SLOT4 PCI-E 4.0 X16
> CPU SLOT2 PCI-E 4.0 X8(IN X16)
> CPU SLOT1 PCI-E 4.0 X8
> CPU SLOT7 PCI-E 4.0 X8
> NVME 0
> NVME 1
Oben vier Einstellungen, unten sieben Untermenüs. Die vier oben sind die eigentliche Verteilung, die sieben unten sind das Ergebnis.
Mein Xeon Gold 5315Y stellt 64 PCIe-Bahnen der Generation 4 bereit. Diese 64 Bahnen sind im Prozessor in Blöcken organisiert, den IOUs, und jeder Block liefert 16 Bahnen. Vier Blöcke, 64 Bahnen. Was das Board daraus macht, ist Sache des Boardlayouts: hier sind es zwei Steckplätze mit sechzehn Bahnen, drei mit acht, und zwei Anschlüsse für NVMe-Laufwerke mit je vier.
Bifurcation, und warum sie mir keine Sorgen mehr macht
Bifurcation heisst wörtlich Gabelung, und gemeint ist das Aufteilen eines Blocks. Ein IOU mit sechzehn Bahnen kann als ein einziger x16-Anschluss auftreten oder als zwei x8 oder als vier x4. Das muss die Firmware wissen, bevor sie die Geräte aufzählt, denn danach ist die Aufteilung festgelegt.
Der klassische Anwendungsfall sind Adapterkarten, die vier NVMe-Laufwerke in einen einzigen x16-Steckplatz stecken. Ohne x4x4x4x4-Bifurcation sieht das Board nur das erste Laufwerk, oder gar keins. Genau davor hatte ich Respekt.
Auf diesem Board stehen alle vier Blöcke auf Auto, und das ist auch richtig so. Auto heisst, dass die Firmware beim Start selbst herausfindet, was steckt, und entsprechend aufteilt. Von Hand einstellen muss man nur, wenn eine Karte sich nicht korrekt meldet, was bei billigen passiven Adaptern vorkommt.
Und meine NVMe-Anschlüsse? Die sind gar nicht Teil dieser Aufteilung. NVME 0 und NVME 1 sind eigenständige Anschlüsse mit je vier fest zugeordneten Bahnen. Da ist nichts zu gabeln, weil da nichts zusammenhängt. Meine ursprüngliche Sorge war schlicht unbegründet, und ich lasse das hier so stehen, weil ich vermute, dass ich damit nicht der einzige bin.
Was in einem Slot-Untermenü steht
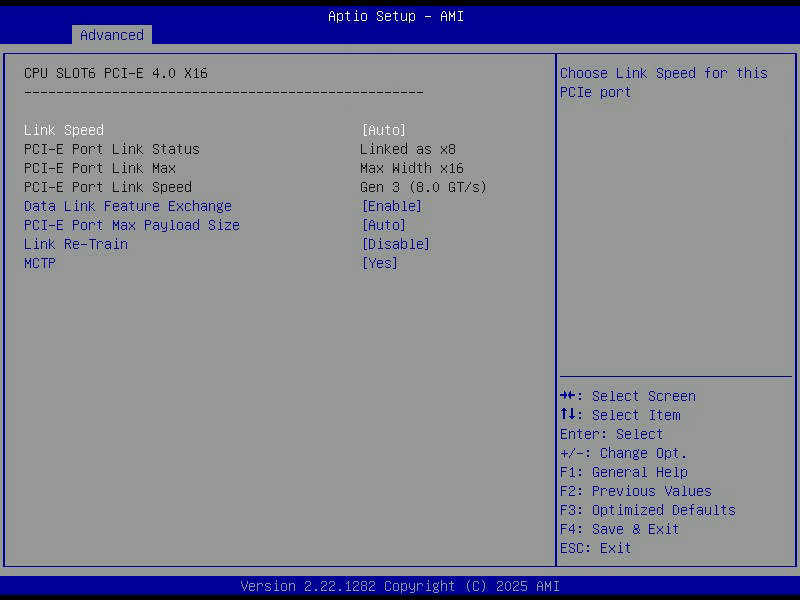
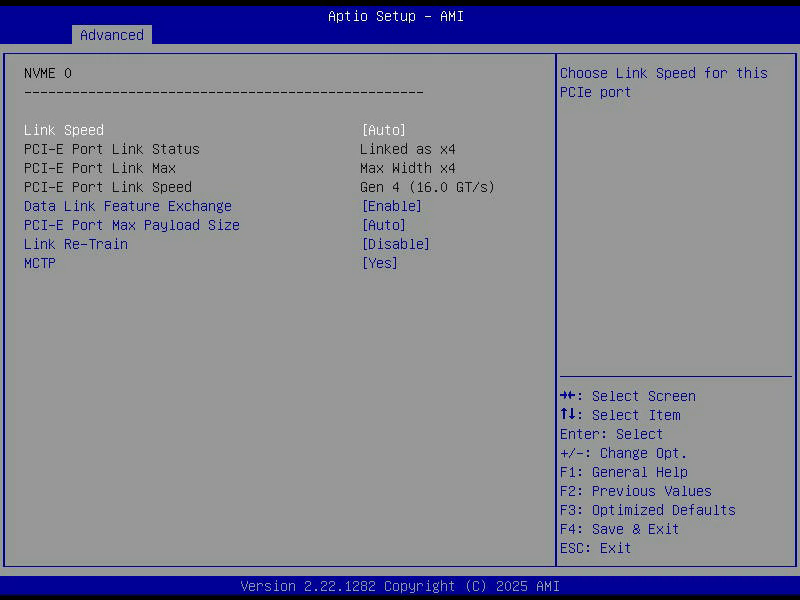
Jeder der sieben Einträge öffnet dieselbe Maske:
Link Speed                        [Auto]
PCI-E Port Link Status            Linked as x8
PCI-E Port Link Max                Max Width x16
PCI-E Port Link Speed              Gen 4 (16.0 GT/s)
Data Link Feature Exchange        [Enable]
PCI-E Port Max Payload Size       [Auto]
Link Re-Train                     [Disable]
MCTP                              [Yes]
Die drei mittleren Zeilen sind reine Anzeige und die interessantesten der ganzen Folge. Link Max ist, was der Steckplatz elektrisch könnte. Link Status ist, worauf sich Board und Karte tatsächlich geeinigt haben. Weichen die beiden voneinander ab, gibt es dafür immer einen Grund, und der ist nicht immer ein Problem.
MCTP steht für Management Component Transport Protocol. Darüber kann der Verwaltungscontroller des Boards mit Karten reden, die das unterstützen, etwa um Temperaturen oder Firmwarestände abzufragen, ohne dass das Betriebssystem beteiligt ist. Auf einem Serverboard eine Selbstverständlichkeit, auf einem Desktopboard undenkbar.
Link Re-Train erzwingt eine neue Aushandlung der Verbindung. Das ist ein Diagnosewerkzeug für den Fall, dass ein Link mit weniger Bahnen oder niedrigerer Geschwindigkeit hochkommt als er sollte.
Die Belegung meiner Maschine
Alle sieben Untermenüs durchgeklickt ergibt folgendes Bild:
CPU SLOT4  x16    Linked as x8            Gen 4     RTX 4060 Ti
CPU SLOT6  x16    Linked as x8            Gen 3     Intel X710, 2x 10G SFP+
CPU SLOT2  x8     Link Did Not Train      -         leer
CPU SLOT1  x8     Link Did Not Train      -         leer
CPU SLOT7  x8     Link Did Not Train      -         leer
NVME 0     x4     Linked as x4            Gen 4     Samsung PM1735
NVME 1     x4     Linked as x4            Gen 4     Samsung PM1735
Link Did Not Train klingt nach Fehler und heisst nur: da steckt nichts. Ein PCIe-Link handelt sich beim Start aus, und wenn am anderen Ende niemand antwortet, kommt eben keine Verbindung zustande.
Warum die Grafikkarte nur acht Bahnen bekommt
Das ist die Zeile, an der ich zuerst hängen geblieben bin. Die RTX 4060 Ti steckt in einem Steckplatz mit sechzehn Bahnen, das Board kann sechzehn, und trotzdem sagt das Setup Linked as x8.
Die Erklärung ist unspektakulär und liegt nicht am Board: der AD106-Chip auf dieser Karte hat physisch nur acht Bahnen. Nvidia hat das bei der 4060er Generation so entworfen und dafür einiges an Kritik eingesteckt, vor allem weil die Karte in älteren Rechnern mit PCIe 3.0 dann nur noch auf der Hälfte der Hälfte läuft. Bei mir ist es Gen 4 mit acht Bahnen, das entspricht Gen 3 mit sechzehn, und damit ist die Karte nicht ausgebremst.
Ein anderer Steckplatz würde daran nichts ändern. Das Limit sitzt auf der Karte.
Die X710 daneben ist der umgekehrte Fall: Gen 3 statt Gen 4, ebenfalls acht Bahnen. Auch das ist die Karte, sie ist schlicht älter. Acht Gen-3-Bahnen sind rund 8 GB pro Sekunde, für zwei 10-Gbit-Ports vollkommen ausreichend. Verschwendet ist nur, dass sie in einem Steckplatz sitzt der mehr könnte.
Der Fehler den ich fast gemacht hätte
Und jetzt der Teil, den ich für den nützlichsten dieser Folge halte. Als ich nach dem Zusammenbau im laufenden System nachgesehen habe, ob die Grafikkarte richtig angebunden ist, stand da das:
2.5GT/s ist PCIe 1.0. Auf einer Gen-4-Karte in einem Gen-4-Steckplatz. Zweimal downgraded. Ich war kurz davor, das Kabel, den Slot und meine Lebensentscheidungen zu hinterfragen.
Es ist völlig normal. Moderne Grafikkarten takten ihren PCIe-Link im Leerlauf herunter, genau wie sie ihren Chiptakt herunterfahren. Wer im Leerlauf misst, misst den Leerlauf. Mit ein bisschen Last sieht es anders aus:
Gen 4, acht Bahnen. Genau das, was das BIOS anzeigt.
Der Merksatz daraus, und der gilt für jede Grafikkarte: PCIe-Linkbreite und -geschwindigkeit niemals im Leerlauf beurteilen. Ein statisches lspci an einer Nvidia-Karte sagt praktisch nichts. Man braucht Last während der Messung, sonst jagt man einem Phantom hinterher.
Bei der NVMe ist das übrigens anders, die steht dauerhaft auf 16GT/s, Width x4. Solche Laufwerke drosseln ihren Link nicht in dieser Form.
Vier Bahnen für die NVMe, und warum das Absicht war
NVME 0
PCI-E Port Link Status            Linked as x4
PCI-E Port Link Max               Max Width x4
PCI-E Port Link Speed             Gen 4 (16.0 GT/s)
Die Samsung PM1735 ist eigentlich ein x8-Laufwerk. Sie hängt bei mir an einem Kabel, das einen SlimSAS-Anschluss mit acht Bahnen auf zwei Anschlüsse mit je vier aufteilt. Damit laufen zwei Laufwerke statt einem, jedes mit der Hälfte der Anbindung.
Das war eine bewusste Entscheidung beim Kauf, und mit etwas Abstand war es die richtige. Vier Gen-4-Bahnen sind theoretisch knapp 8 GB pro Sekunde. Gemessen habe ich mit vier parallelen Lesevorgängen 4,6 GB pro Sekunde, und das ist noch nicht die Obergrenze, weil das Werkzeug das ich benutzt habe immer nur eine Anfrage gleichzeitig offen hat.
Wie ich das Gefühl habe, dass die zweite Hälfte des Kabels sinnvoller investiert war als die zweiten vier Bahnen: inzwischen hängt dort ein zweites Laufwerk. Der Anschluss NVME 1, der bei meiner ersten Aufnahme noch Link Did Not Train meldete, zeigt jetzt ebenfalls Linked as x4. Und wieder war dafür im BIOS nichts einzustellen.
Fazit
PCIe-Verteilung auf einem Serverboard ist unspektakulärer als ihr Ruf. Die Lanes liegen fest, die Firmware zählt auf, das Setup zeigt das Ergebnis. Die drei Anzeigezeilen in den Slot-Untermenüs sind ein besseres Diagnosewerkzeug als alles, was man im laufenden System zusammensucht, weil sie den Zustand vor dem Betriebssystem zeigen und ohne Stromsparzustände.
Nächste Folge: die andere PCIe-Seite. Above 4G Decoding, Resizable BAR, SR-IOV, und die lange Liste der Option ROMs.
Falls jemand von euch bei Link Did Not Train schon mal eine echte Ursache gefunden hat und nicht nur einen leeren Steckplatz, erzähl mir davon. Ihr dürft mich gerne fragen.
Manche Bauteile überleben ihren eigenen Sinn. Diese Karte liegt seit Jahren bei mir herum, hat einmal einen echten Job gemacht, und heute ist sie ein Stück Technikgeschichte mit Kühlkörper. Also habe ich sie in meine Workstation gesteckt, einfach um zu sehen, was sie noch kann und wie sie sich gegen eine aktuelle CPU schlägt. Das Ergebnis ist interessanter geworden als erwartet, aber nicht auf die Art, die ich erwartet hatte.
Die Vorgeschichte: irgendwann lief bei mir ein FreeBSD-Server mit einer Intel-Atom-CPU, und diese CPU hatte kein AES-NI. Auf so einer Maschine verschlüsselte Platten zu betreiben ist zäh. Also kam eine Intel QuickAssist Adapter 8950-SCCP rein, eine PCIe-Steckkarte, die genau das in Hardware macht. Und sie hat ihren Job gut gemacht: weniger CPU-Last, mehr Durchsatz am Storage. Später wanderte sie in einen älteren Xeon, immer noch FreeBSD, immer noch GELI. FreeBSD 14 hat sie produktiv nie gesehen.
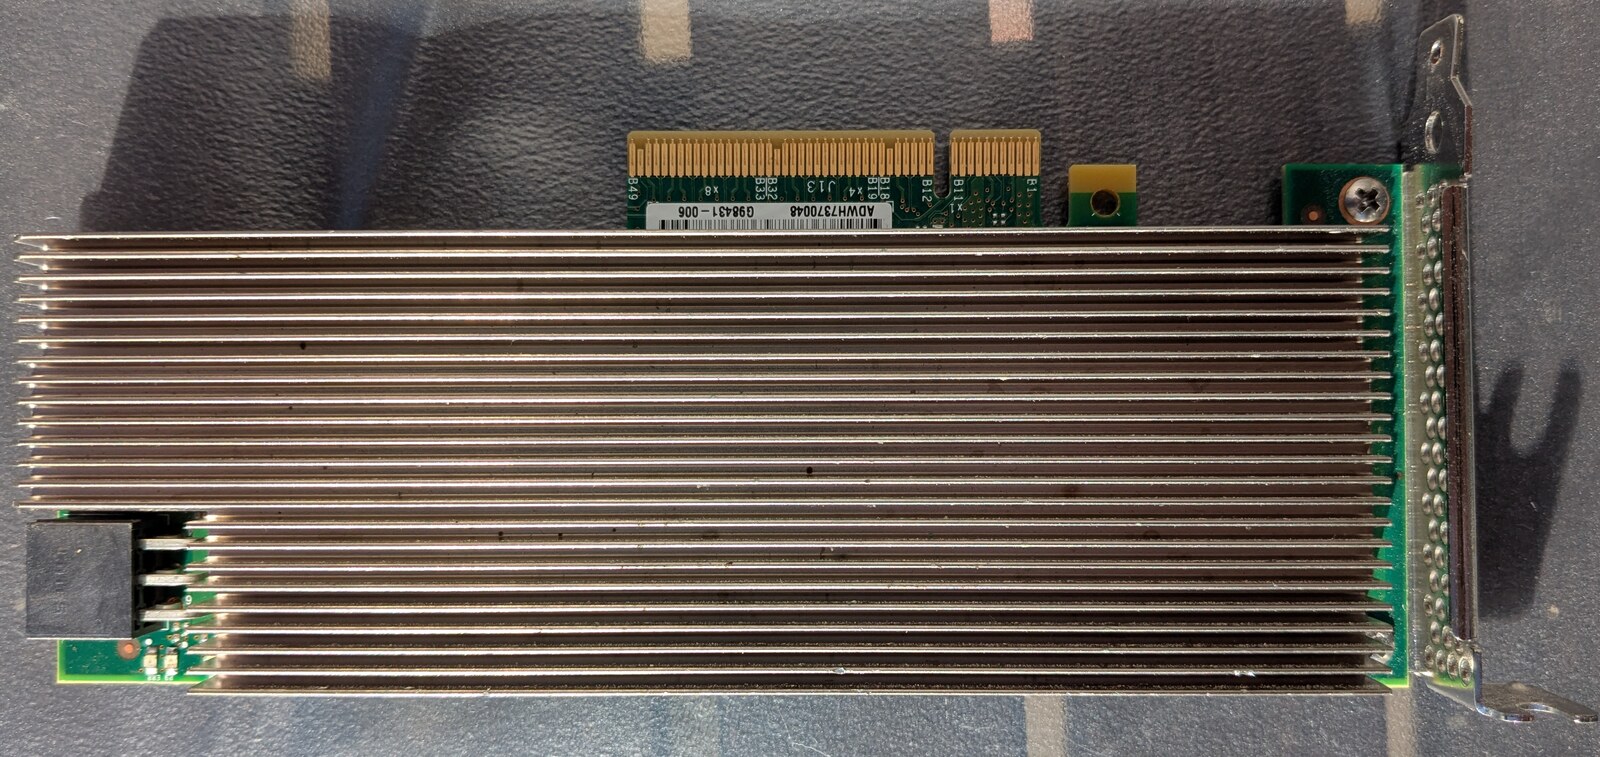
So hing sie im Server: Low Profile, PCIe x8, ein gerippter Aluklotz über fast der ganzen Platine. Lüfter gibt es keinen, den soll das Rack liefern.
Warum das damals überhaupt ein Problem war
Das ist der Teil, den heute fast keiner mehr auf dem Schirm hat: AES in der CPU war jahrelang keine Selbstverständlichkeit.AES-NI kam 2010 mit Westmere, aber Intel hat den Befehlssatz danach als Segmentierungsmerkmal benutzt. Bei vielen Atom-, Celeron- und Pentium-Modellen fehlte er, und zwar genau in den stromsparenden Storage- und Firewall-Plattformen, in denen man ihn am dringendsten gebraucht hätte. Ohne AES-NI rechnet eine CPU AES über Tabellen-Lookups, also grob eine Größenordnung langsamer, und obendrein mit Cache-Timing-Seitenkanälen, die man erst mit Aufwand wieder zubekommt.
Bei ARM war es lange genauso, und da ist es sogar noch besser zu greifen. ARMv7 hatte überhaupt keine AES-Befehle. Die Cryptography Extensions von ARMv8-A sind bis heute optional, ein Chiphersteller kann sie einfach weglassen. Der Raspberry Pi ist das schönste Beispiel: alle 64-Bit-fähigen Pis bis einschließlich Modell 4 haben keine AES-Beschleunigung, erst der BCM2712 im Pi 5 bringt sie mit. Wer sich mal gefragt hat, warum verschlüsselte Backups auf einem Pi 4 so quälend langsam sind: das ist der Grund, und es ist kein Softwareproblem.
Dazu kommt der zweite Teil der Geschichte. Verschlüsselung war lange die Ausnahme, nicht die Regel. Wer 2010 eine Webseite betrieben hat, hat HTTPS für den Loginbereich angeschaltet und sonst nirgends, weil es teuer war, weil Zertifikate Geld kosteten und weil TLS auf schwacher Hardware wirklich weh tat. Erst mit Snowden und vor allem mit dem Druck, den die Browserhersteller danach aufgebaut haben, kippte das ins Gegenteil. Plötzlich sollte alles verschlüsselt sein, und zwar sofort. In dieser Phase steckten in Loadbalancern und Reverse Proxies routinemäßig Offload-Karten, für Krypto oder für Kompression, weil die Allzweck-CPU dahinter das schlicht nicht mitgemacht hat. Diese Karte kommt aus genau dieser Zeit.
Was das für eine Karte ist
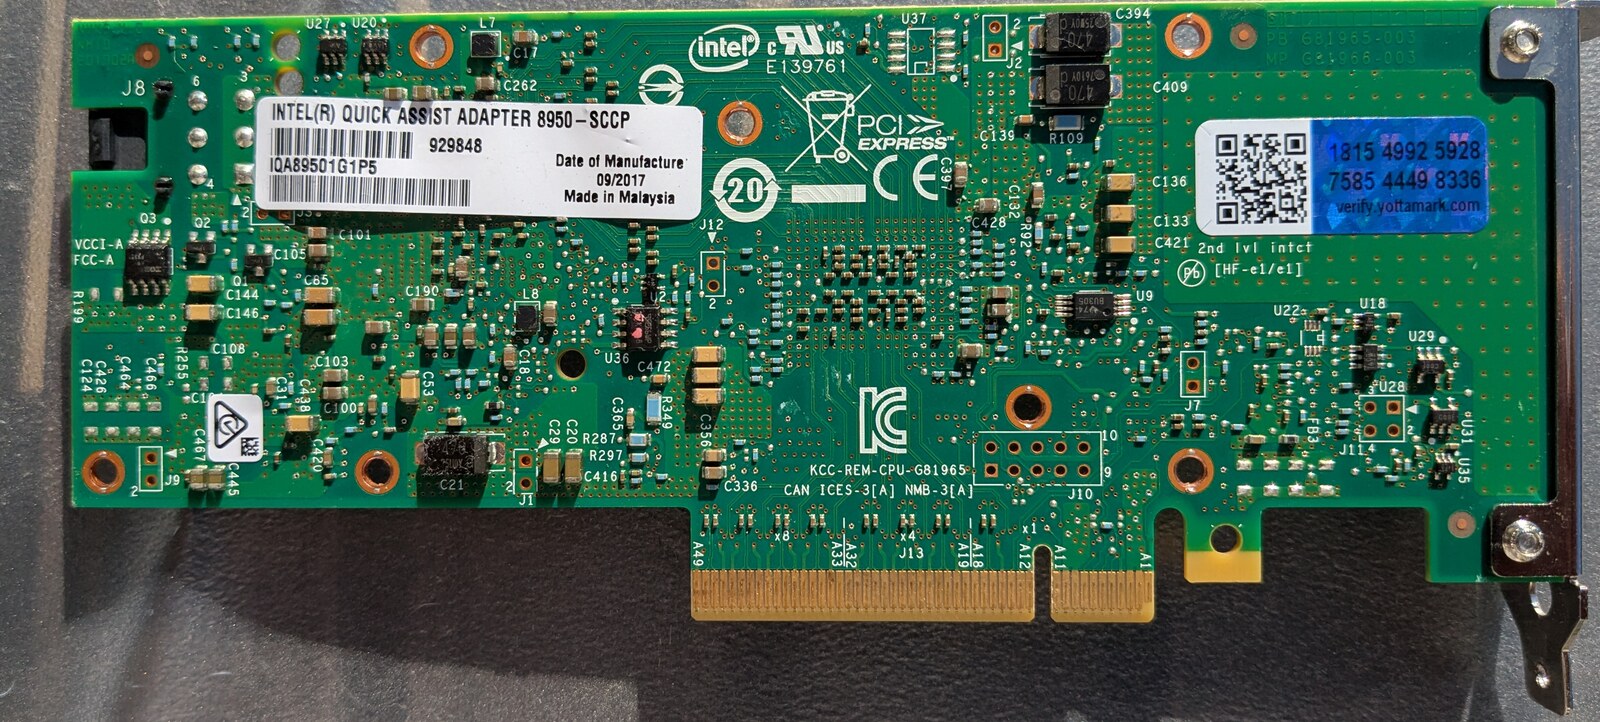
Auf dem Aufkleber steht INTEL(R) QUICK ASSIST ADAPTER 8950-SCCP, Bestellnummer IQA89501G1P5, Intel MM 929848, Herstelldatum 09/2017, Made in Malaysia. Der Chip darauf ist allerdings älter als die Karte: die Generation stammt aus Q4 2013.
Die Rückseite mit dem Typenschild. Der blaue Aufkleber ist ein Echtheitsmerkmal von yottamark, dazu KCC-Zulassung, UL-Nummer und das PCI-Express-Logo.
SCCP steht für Single Coleto Creek PCIe. Coleto Creek ist der interne Codename, der Beschleunigerchip heißt DH895xCC, und Intel hat ihn als Intel Communications Chipset 8955 verkauft. Die PCI-ID ist 8086:0435. Bei Intel ist die Karte längst End of Life, abgekündigt zusammen mit ihrem Nachfolger 8960.
Die Datenblattwerte, also Herstellerangaben und nichts von mir Gemessenes:
Angabe
Wert
Bulk-Krypto
bis 50 Gbit/s
Kompression
bis 24 Gbit/s
Host-Interface
PCIe Gen3 x8
SR-IOV
1 Physical Function, 32 Virtual Functions
Leistungsaufnahme
maximal etwa 40 W
Umgebungstemperatur
0 bis 55 Grad Celsius
Gebaut wurde das Ding nicht für Workstations, sondern für Telco und Netzwerk: VPN-Konzentratoren, IPsec-Gateways, TLS-Terminierung, Deduplizierungs-Appliances. 50 Gbit/s Bulk-Krypto in einer Low-Profile-Karte war 2013 eine Ansage. Mein Lieblingsdetail aus dem Featureset ist aber ein anderes: die Karte kann Kasumi und Snow 3G in Hardware, also die Mobilfunkchiffren aus 3G und LTE. Das ist so wunderbar spezifisch, dass man sofort weiß, in welchem Blech sie eigentlich stecken sollte, und das ist bestimmt kein Tower unter einem Schreibtisch.
Kühlkörper ab: zwei Chips, nicht einer
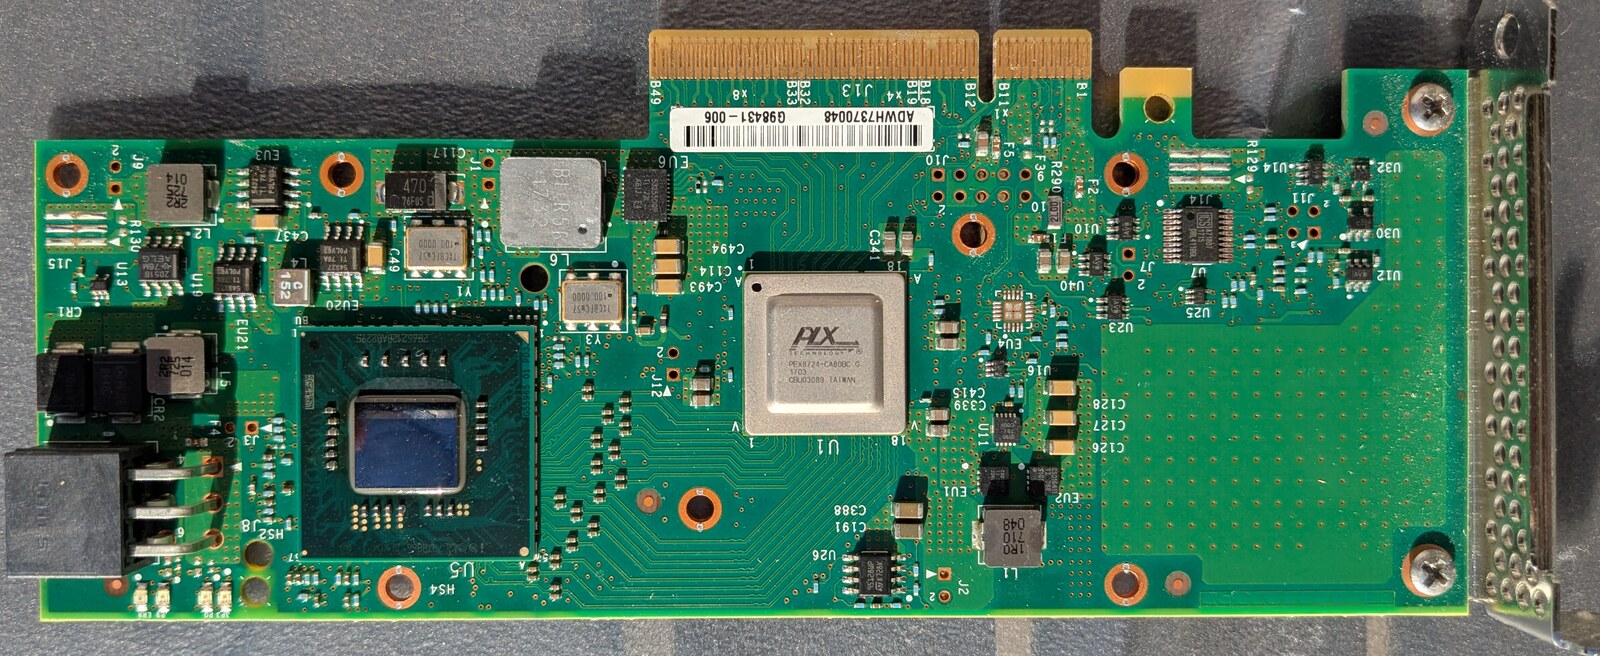
Jetzt wird es hübsch. Unter dem Kühlkörper sitzen nämlich nicht ein großer Chip, sondern zwei, und dazu eine Leerstelle.
Links U5, der Coleto Creek als Flip-Chip ohne Heatspreader. Mittig U1, der PLX PEX 8724. Rechts neben dem Slotblech die leere Fläche, um die es weiter unten geht.
Links auf Position U5 liegt der Coleto Creek als Flip-Chip-BGA ohne Heatspreader. Das nackte Silizium liegt frei, man schaut direkt auf den Die. Das sieht man heute selten und es ist genau der Grund, warum ich den Kühlkörper überhaupt abgeschraubt habe.
Mittig auf U1 sitzt aber ein Chip, den ich dort nicht erwartet hätte: ein PLX Technology PEX8724-CA80BC G, Fertigungscode 1703, also Kalenderwoche 3 in 2017, gefertigt in Taiwan. Das ist ein PCIe-Gen3-Switch mit 24 Lanes und 6 Ports. Auf einer Karte, die nur einen einzigen Beschleunigerchip trägt, ist ein Switch zunächst mal erklärungsbedürftig.
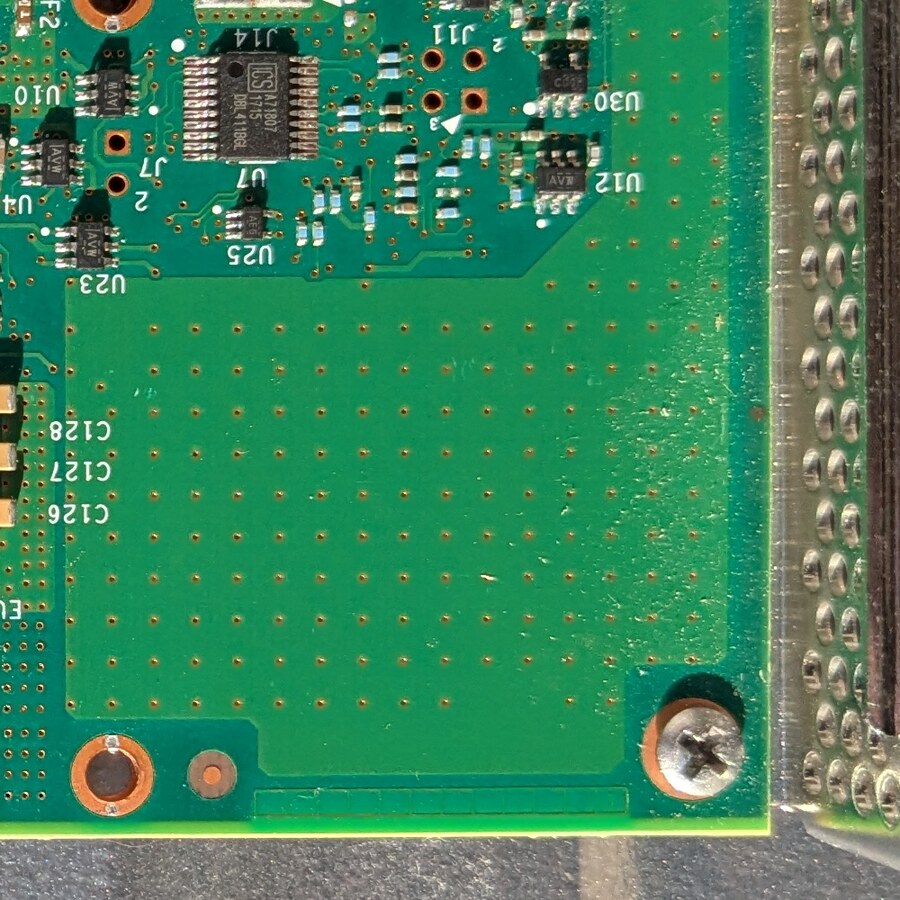
Rechts, direkt neben dem Slotblech, liegt dann noch eine komplett unbestückte BGA-Fläche. Ein vollständiges, leeres Lötpad-Raster in Chipgröße. Da war offensichtlich mal etwas geplant.
Der leere Platz aus der Nähe. Ein Platz in Chipgröße, alles drumherum bestückt, nur hier fehlt der Chip.
Wenn man Switch und Leerstelle zusammennimmt, geht eine Rechnung verdächtig glatt auf:
PEX 8724 = 24 Lanes

  x8  Upstream zum Slot
+ x8  zum bestückten Coleto Creek (U5)
+ x8  zu einem weiteren, unbestückten Platz
= 24
Und der Kernel liefert dazu tatsächlich einen passenden Befund: der Downstream-Port c4:08.0 des Switches existiert, hat LnkCap Width x8 und ist untrainiert, also LnkSta Width x0. Da hängt nichts dran.
Und hier muss ich mich selbst bremsen, denn die Versuchung ist groß. Belegt ist nur: in der Switch-Konfiguration sind diesem Port acht Lanes zugewiesen, und es hängt nichts daran. Nicht belegt ist, dass diese acht Lanes zu dem leeren Platz führen. Das könnte genauso ein nie herausgeführter Port sein oder für etwas völlig anderes gedacht gewesen sein. Die Lötfläche macht die Deutung attraktiv, und mehr ist es nicht. Wer es wirklich wissen will, müsste die Lanes am Board durchmessen oder das EEPROM des PEX8724 auslesen und dort in die Port Configuration schauen. Beides habe ich nicht gemacht.
Genauso vorsichtig muss man mit der naheliegenden Erzählung sein, Intel habe hier dieselbe Platine für eine Dual-Chip-Variante vorgesehen. Das passt zur Namenslogik, das S in SCCP steht ja für Single, und es passt zum leeren Platz. Eine offizielle Bestätigung für ein 8950-DCCP oder Ähnliches habe ich trotzdem nicht gefunden. Also: plausible Deutung, kein Faktum.
Am Rand der Platine sitzt außerdem noch ein schwarzer, geschirmter Steckverbinder mit der Bezeichnung J8. Der macht das, was bei einer Grafikkarte der Zusatzstecker macht: Stromversorgung direkt vom Netzteil. Das passt zu den bis zu 40 Watt aus dem Datenblatt, denn ein PCIe-Steckplatz dieser Bauform liefert nach Spezifikation nur 25 Watt. Dazu mehrere Spannungsregler mit Speicherdrosseln, ein 100-MHz-Quarz und Siebdruck-Markierungen für x1, x4 und x8 am Kartenrand.
Einbau: erfreulich langweilig
Die Karte steckt jetzt in einem Slot mit PCIe 4.0 x8 an einem Xeon Gold 5315Y, unter Linux Mint mit Kernel 7.0. Und dann passiert genau das, was man sich von einem In-Kernel-Treiber wünscht: nichts Besonderes.
Kein Paket installiert, keine Firmware nachgeladen, keine Konfigurationsdatei, kein adf_ctl. Die Module qat_dh895xcc und intel_qat laden von allein, die Firmware qat_895xcc.bin.zst lag über linux-firmware längst auf der Platte. Zwölf Acceleration Engines starten, alle Selftests bestehen, der Heartbeat meldet sich gesund. Ein Chip von 2013 auf einer Karte von 2017 in einem Board von 2021 unter einem Kernel von 2026, und es ist ein Nichtereignis. Das ist ein starkes Argument für In-Tree-Treiber, und es wird weiter unten noch bitter kontrastiert.
Das debugfs-Verzeichnis ist die interessanteste Fundstelle der ganzen Karte. Dort liegt in dev_cfg die komplette, vom Treiber selbst generierte Instanzkonfiguration: 16 Krypto-Instanzen, 16 Kompressions-Instanzen, je Instanz 512 gleichzeitige symmetrische oder 128 asymmetrische Requests, dazu Interrupt-Coalescing und ein Heartbeat-Timer. In fw_counters stehen Requests und Responses pro Acceleration Engine, und das ist später mein Beweis, dass die Karte wirklich rechnet und nicht die CPU heimlich einspringt. Dazu heartbeat/status, cnv_errors und 32 Ring-Banks unter transport/.
Ein PCIe-Switch, der Generationen übersetzt
Jetzt löst sich auch auf, warum der PLX-Switch da ist. So sieht der Baum aus:
Host-seitig läuft die Karte mit Gen3 x8, also 8 GT/s. Chip-seitig kommen aber nur Gen2 x8 an, also 5 GT/s. Der Coleto Creek ist ein Gen2-Baustein, und damit die Karte am Steckplatz trotzdem als moderne Gen3-x8-Karte auftritt, sitzt der PEX 8724 als Übersetzer dazwischen. Der QAT-Endpunkt behauptet in seiner LnkCap sogar x16, verdrahtet sind aber acht Lanes.
Das ist der erste wirklich belastbare Befund des Tages: das Nadelöhr sitzt auf der Karte, nicht im Steckplatz und nicht in der CPU. Dafür braucht man die Dual-Chip-Spekulation von oben überhaupt nicht.
Zwei weitere Kleinigkeiten aus dem laufenden System, die ich hübsch finde. Die Karte sitzt allein in ihrer IOMMU-Gruppe und unterstützt Function Level Reset, sie lässt sich also ohne ACS-Override-Gebastel per VFIO an eine VM durchreichen. Und sie meldet 32 Virtual Functions, aktiv sind davon null.
Der praktisch wichtigste Nebeneffekt des Einbaus hat aber gar nichts mit Krypto zu tun. Der PLX-Switch belegt vier Busnummern, und dadurch ist meine NVMe von c3:00.0 auf c7:00.0 gewandert. Auf der alten Adresse sitzt jetzt der Upstream-Port des Switches. Ich hatte mir ein setpci-Kommando mit der alten Adresse notiert, und das hätte nach dem Einbau munter in die Register des Switches geschrieben statt in die der SSD. Merke: PCI-Adressen sind nichts, was man sich aufschreibt. Die holt man sich jedes Mal frisch aus lspci. Ist ja jetzt nicht so, als wenn mir das schon mal untergekommen ist bzw. ich so was gefettfingert habe 😛
Die Prioritäten-Tabelle, oder: der Kernel hat schon entschieden
Der Treiber registriert zehn Algorithmen in der Crypto-API des Kernels, alle mit selftest: passed:
Diese Prioritäten sind die halbe Geschichte des Beitrags. Die Linux Crypto API wählt bei gleichem Algorithmusnamen immer die Implementierung mit der höchsten Priorität. Wenn man das mit den CPU-Implementierungen auf derselben Maschine vergleicht, wird es sehr deutlich:
Algorithmus
QAT
bester CPU-Wert
wer gewinnt
xts(aes)
100
xts-aes-vaes-avx2 = 600
CPU
cbc(aes)
100
cbc-aes-aesni höher
CPU
authenc(...)
100
CPU-Kombis höher
CPU
rsa
1000
rsa-generic = 100
Karte
dh
1000
dh-generic = 100
Karte
deflate
4001
deflate-generic = 0
Karte
Übersetzt heißt das: für symmetrische Massenverschlüsselung wird diese Karte nie von allein benutzt. Für rsa, dh und deflate dagegen immer. Das ist kein Zufall und kein Konfigurationsfehler, sondern eine Aussage der Kernel-Entwickler darüber, wo Offload bei einer aktuellen CPU überhaupt noch etwas bringt. Man kann diese Tabelle lesen wie ein Urteil über die Karte, und genau so ist sie auch gemeint.
Ein Detail nur mit Vorsicht: pkcs1(qat-rsa,sha512) steht mit Priorität 1000 registriert und hat den Selftest bestanden. Daraus folgt noch nicht, dass Kernel-Modul-Signaturprüfung tatsächlich über die Karte läuft. Die Registrierung macht es möglich, die Priorität spricht dafür, aber um es zu belegen müsste man den Verifikationspfad tracen und dabei die Zähler in fw_counters beobachten. Habe ich nicht gemacht, also behaupte ich es auch nicht.
Bevor die Zahlen kommen: was meine Messung nicht zeigt
Diesen Absatz gibt es, weil die Tabellen danach sonst präziser wirken als sie sind. Wer mir eine Zahl vorhält, soll wissen, wie sie entstanden ist.
Alle Kryptomessungen laufen über AF_ALG aus einem Python-Skript mit einem synchronen Request-Loop. Das ist ungefähr der Worst Case für eine asynchrone Offload-Karte: pro Request wird gewartet, statt die Queue tief zu halten, für die die Hardware gebaut wurde. Die Zahlen charakterisieren also diesen Zugangsweg, nicht die Karte an sich.
Kein Warmup, keine Wiederholungen, keine Streuung, kein CPU-Pinning. Angaben mit einer Nachkommastelle tragen eine Genauigkeit, die statistisch nicht gedeckt ist. Für belastbare Latenzen bräuchte es Median und P95 über mehrere Läufe.
Die Skalierung über Worker nutzt Prozesse, nicht Threads. Kontextwechsel und Speicherkopien gehen also mit in die Zahl ein.
cryptsetup benchmark ist selbst nur ein Indikator. Es misst im Speicher über die Crypto-API und ist laut eigener Manpage nicht direkt auf reale Storage-Verschlüsselung übertragbar.
Hart sind dagegen die fw_counters. Die kommen aus der Hardware und belegen, dass und wie oft die Karte gerechnet hat. Und die Form der Ergebnisse ist robust: Latenz pro Request hoch, Skalierung über Worker fast linear, CPU bei kleinen Blöcken weit vorn. Nur die absoluten Werte sind weich.
Als Gegner steht bewusst der ungünstigste Fall für die Karte: ein Xeon Gold 5315Y mit acht Kernen und vollem VAES-Befehlssatz. Wenn eine 13 Jahre alte Karte gegen die Rechenwerke einer aktuellen CPU antritt, dann bitte richtig.
Ein Strom, synchron: die Karte verliert deutlich
Zuerst die CPU-Basislinie mit cryptsetup benchmark, damit die Größenordnung steht:
aes-cbc   128b   1168,2 MiB/s enc   3936,0 MiB/s dec
aes-cbc   256b   1004,5 MiB/s enc   3729,8 MiB/s dec
aes-xts   256b   5494,4 MiB/s enc   5510,1 MiB/s dec
aes-xts   512b   5045,2 MiB/s enc   5053,6 MiB/s dec
Und dann der direkte Vergleich über AF_ALG, ein einzelner synchroner Strom:
Implementierung
Block
Durchsatz
Latenz pro Operation
xts-aes-vaes-avx2
4 KiB
1157,2 MiB/s
3,4 µs
xts-aes-vaes-avx2
16 KiB
2681,2 MiB/s
5,8 µs
xts-aes-vaes-avx2
64 KiB
4327,2 MiB/s
14,4 µs
qat_aes_xts
4 KiB
100,3 MiB/s
38,9 µs
qat_aes_xts
16 KiB
244,9 MiB/s
63,6 µs
qat_aes_xts
64 KiB
308,8 MiB/s
201,6 µs
cbc-aes-aesni
4 KiB
583,5 MiB/s
6,7 µs
qat_aes_cbc
4 KiB
79,8 MiB/s
48,9 µs
Pro Einzelrequest ist die Karte also grob elfmal langsamer als die CPU, ungefähr 39 gegen 3,4 Mikrosekunden bei 4 KiB. Für ein Bauteil, das mal genau dafür gekauft wurde, ist das eine ernüchternde Zahl.
Nur: das ist nicht die Hardwarelatenz der Karte. Gemessen ist die Latenz dieses Pfades, und der ist lang: Python, sendmsg über AF_ALG, Socket-Puffer, Kernel-Copy, Treiber, PCIe, Karte, und alles wieder zurück, plus Scheduling und Aufwecken des wartenden Prozesses. Ein erheblicher Teil davon kann im Socket-Pfad stecken. Die CPU-Variante läuft durch denselben Overhead, profitiert aber davon, dass sie synchron im selben Kontext rechnet und überhaupt nicht schlafen muss. Belastbar ist deshalb nur die relative Aussage für diesen Zugangsweg und die Form der Kurve. Wer die reine Hardwarelatenz will, braucht ein Frontend ohne Socket-Umweg, also praktisch den Userspace-Stack, und der existiert für diesen Chip nicht mehr. Dazu unten mehr. Das ist eine Messlücke, die ich mit den vorhandenen Mitteln nicht schließen kann, und ich schreibe sie lieber hin als sie zu verstecken.
Viele Ströme: jetzt zeigt sie, wofür sie gebaut wurde
Und dann wird es doch noch spannend. Dieselbe Messung mit parallelen Workern, Blockgröße 16 KiB:
Worker
qat_aes_xts
xts-aes-vaes-avx2
1
210,7 MiB/s
2632,6 MiB/s
2
454,1 MiB/s
5311,9 MiB/s
4
799,3 MiB/s
10777,5 MiB/s
8
1714,5 MiB/s
22056,0 MiB/s
16
2926,7 MiB/s
25229,7 MiB/s
Die Karte skaliert von einem auf 16 Worker um fast Faktor 14, also nahezu linear, und bei 16 Workern war sie noch nicht am Ende. Das ist exakt das Verhalten, für das so ein Baustein entworfen wurde: viele gleichzeitige, unabhängige Operationen, keine einzelne schnelle. Eine Karte in einem Loadbalancer sieht nie einen Strom, sie sieht tausende.
Nur skaliert die CPU eben auch. Und sie landet am Ende 8,6 mal höher. Das ist der ganze Punkt dieses Beitrags in einer Zahl. So fertig, feierabend, einpacken!
Dass wirklich die Karte gerechnet hat und nicht heimlich doch die CPU, zeigen die Firmware-Zähler nach dem Lauf:
Alle zwölf Acceleration Engines haben gearbeitet, Requests und Responses stimmen überall überein, kein verlorener Request. Die Verteilung ist nicht gleichmäßig, sondern fällt in Dreiergruppen von etwa 154k, 94k und 90k. Das kommt von der Zuordnung Ring-Bank zu Engine und ist so ein Detail, an dem man beim Lesen kleben bleibt.
Wo der Deckel liegen könnte, und warum ich mich da nicht festlege
Die 2926,7 MiB/s liegen auffällig nah an der Kapazität des internen Links:
2926,7 MiB/s Nutzdaten = 3069 MB/s
Jedes Byte muss zweimal über den Bus: rein zum Verschlüsseln, raus als Chiffrat.
Gen2 x8 = 5 GT/s x 8 Lanes x 8/10 = 4000 MB/s pro Richtung
3069 / 4000 = 77 % der theoretischen Richtungskapazität
77 Prozent Nutzlast auf einem PCIe-Link sind praktisch der Anschlag, mit dem TLP-Overhead bei 256 Byte MaxPayload liegt das erreichbare Maximum bei etwa 85 bis 90 Prozent. Das sieht also sehr nach einem Bus-Limit aus.
Aber: meine Messung kann das nicht trennen. Sie zeigt, dass dieser Zugangsweg in der Nähe eines Ceilings landet, und sie kann nicht sagen, ob das der PCIe-Link, der Treiber oder AF_ALG ist. Die Rechnung oben ist ein Plausibilitätsargument, keine Messung des Busses. Sauber wäre es, PCIe-Bandwidth-Events über die Uncore-Zähler mitzuschreiben. Das ist der wichtigste offene Messpunkt in diesem Beitrag, weil eine der Hauptaussagen daran hängt.
Noch eine Rechnung, die verlockend glatt aufgeht und bei der man aufpassen muss. Die gemessenen 2926,7 MiB/s sind 24,6 Gbit/s, das Datenblatt sagt 50 Gbit/s, das sind fast genau 49 Prozent. Und verdrahtet sind acht von 16 Lanes, also genau die Hälfte. Der Kurzschluss liegt auf der Zunge, und er ist falsch: „mit x16 wäre man auf dem Datenblattwert“ und „die Platine war für zwei Chips gedacht“ sind zwei verschiedene Hypothesen, nicht eine. In einer Dual-Chip-Bestückung bekäme jeder Chip x8, keiner käme je auf x16, und das Nadelöhr wäre dann der gemeinsame Gen3-x8-Upstream. Rechnerisch landet man auf beiden Wegen bei ungefähr 49 Gbit/s, aber über völlig verschiedene Mechanismen. Wer das zusammenrührt, argumentiert falsch, auch wenn das Ergebnis stimmt. Die Karte selbst hat ja auch nur einen PCIe 8x Anschluss.
Und es gibt eine zweite Lesart, an der der ganze Vergleich mit dem Marketing hängt. Wenn Intels 50 Gbit/s als Summe beider Richtungen gemeint sind, also 25 rein und 25 raus, dann reicht Gen2 x8 dafür aus, und meine gemessenen 24,6 Gbit/s pro Richtung sind aggregiert 49,2 Gbit/s. Dann lautet der richtige Satz nicht „die Karte erreicht die Hälfte“, sondern „die Karte erreicht ihre Spezifikation“. Intel dokumentiert nirgends, wie gezählt wird, also ist das aus den vorliegenden Unterlagen nicht entscheidbar. Die 24,6 Gbit/s stehen fest, nur ihre Deutung hängt an einer undokumentierten Konvention. Natürlich kann ich auch einfach dran vorbei gelesen haben oder ich messe falsch. Korrigiert mich gerne, dann lerne ich selbst etwas \o/
Und jetzt die Enttäuschung: dm-crypt will nicht
Der naheliegendste Anwendungsfall, und ausgerechnet genau der, für den die Karte in meinem FreeBSD-Server gearbeitet hat, funktioniert unter aktuellem Linux nicht:
# cryptsetup plainOpen /dev/ram0 probe --cipher capi:qat_aes_xts-plain64 --key-size 512 --key-file /dev/zero
device-mapper: reload ioctl on probe (252:3) failed: Datei oder Verzeichnis nicht gefunden
Der erste Reflex ist natürlich, dass ich den Namen falsch geschrieben habe. Also Gegenprobe mit derselben capi:-Syntax über sieben Varianten:
Angabe bei --cipher
Ergebnis
aes-xts-plain64
funktioniert
capi:xts(aes)-plain64
funktioniert
capi:xts-aes-aesni-plain64
funktioniert
capi:xts-aes-vaes-avx2-plain64
funktioniert
capi:xts-aes-vaes-avx512-plain64
funktioniert
capi:qat_aes_xts-plain64
Fehler, ENOENT
capi:qat_aes_cbc-plain64
Fehler, ENOENT
dm-crypt kann also sehr wohl einen konkreten Treiber adressieren, sogar xts-aes-vaes-avx512, das mit seiner niedrigen Priorität sonst nie zum Zug käme. Nur die beiden QAT-Treiber fliegen raus. Das ist kein Tippfehler und keine Namensauflösung.
Der Beweis kommt aus dem laufenden Kernel selbst, ausgelesen über die NETLINK_CRYPTO-Schnittstelle. Das ist die belastbare Quelle, denn sie sagt, was dieser Kernel registriert hat, und nicht, was irgendeine Quelldatei im Netz behauptet:
Der Unterschied ist genau ein Bit: 0x00010000, also CRYPTO_ALG_ALLOCATES_MEMORY. Alle symmetrischen QAT-Implementierungen haben es, keine einzige CPU-Implementierung hat es. Die niedrigen Bits sind übrigens kein Flag, sondern der Algorithmustyp.
Und dm-crypt fordert seine Transforms genau mit diesem Bit als Maske an, an drei Stellen im Code:
Die Suche findet damit nichts und liefert ENOENT, und das kommt oben als „Datei oder Verzeichnis nicht gefunden“ an. Kette geschlossen, keine Hypothese mehr. Dass qat-rsa das Flag nicht hat, passt genau ins Bild: RSA läuft über die Karte, weil es kein Block-I/O-Pfad ist.
Die Wendung: das ist eine Leitplanke, kein Bürokratiefehler
An dieser Stelle wollte ich anfangen zu schimpfen. Die Karte kann AES-XTS in Hardware, der Kernel registriert es, und der eine Konsument, für den es gedacht war, weigert sich. Klingt nach Linux, das sich selbst im Weg steht. Ist es aber nicht.
Die Maske stammt von Mikulas Patocka, und die Begründung im Commit ist knapp:
Don’t use crypto drivers that have the flag CRYPTO_ALG_ALLOCATES_MEMORY set. These drivers allocate memory and thus they are unsuitable for block I/O processing.
Der Grund dahinter ist ein Low-Memory-Deadlock. Stell dir vor, es wird auf ein dm-crypt-Gerät geswappt. Der Kernel will Speicher freimachen, schickt die Swap-Out-BIO durch dm-crypt, dm-crypt fragt die Crypto-API, und die fordert daraufhin Speicher an, den es gerade nicht gibt. Ende der Vorstellung.
Und mit QAT ist genau das schon einmal schiefgegangen. Im März 2022 gibt es einen Bericht auf der Kernel-Mailingliste über massive Datenkorruption mit QAT plus dm-crypt plus XFS. Die Diagnose kam von Giovanni Cabiddu, Intel:
The implementations of aead and skcipher in the QAT driver are not properly supporting requests with the CRYPTO_TFM_REQ_MAY_BACKLOG flag set. If the HW queue is full, the driver returns -EBUSY but does not enqueue the request.
Die Folge: dm-crypt wartet endlos auf die Completion eines Requests, der nie an die Hardware gegangen ist. Und das Dateisystem war hinüber. Das ist kein theoretisches Risiko, das ist ein Schadensfall mit Datum.
Die Zeitleiste danach ist lehrreich, weil sie nicht so endet, wie man denkt:
Datum
Was passiert
Juli 2020
Das Flag CRYPTO_ALG_ALLOCATES_MEMORY wird auf QAT gesetzt
Juli 2020
dm-crypt schließt Treiber mit diesem Flag aus (Patocka)
März 2022
Der Schadensfall: Datenkorruption mit QAT, dm-crypt und XFS
Mai 2022
Intel liefert den eigentlichen Fix, ein Backlog-Mechanismus
Juli 2023
Intel will das Flag entfernen, um QAT für dm-crypt zurückzuholen. Nie gemerged.
Juni 2025
Stattdessen: Priorität von Skcipher und AEAD wird von 4001 auf 100 gesenkt
August 2026
Auf meinem Kernel gemessen: Flag gesetzt, Priorität 100, dm-crypt verweigert
Die Auflösung war also nicht „dm-crypt darf QAT wieder benutzen“, sondern „QAT wird per Priorität aus dem Weg geräumt“. Und die Begründung in diesem Commit ist der stärkste Absatz, den ich zu dieser Karte gelesen habe:
Most kernel applications utilizing the crypto API operate synchronously and on small buffer sizes, therefore do not benefit from QAT acceleration. Reduce the priority of QAT implementations for both skcipher and aead algorithms, allowing more suitable alternatives to be selected by default.
„Synchron und kleine Puffer“ ist exakt das, was ich oben unabhängig gemessen habe, 39 gegen 3,4 Mikrosekunden bei 4 KiB. Der Kernel hat 2025 formal festgestellt, was meine Messung 2026 auf dieser Maschine bestätigt. Und der Patch, der Intels eigene Hardware degradiert, kommt von Intel, mit Acked-by von Eric Biggers. Wenn man es wohlwollend liest, ist das ein Hersteller, der ehrlich ist. Zur Version muss man genau sein: der Commit ging in Mainline 6.17, wurde aber wegen Cc: stable auch in ältere Stable-Zweige zurückportiert, war dort also schon vor dem 6.17-Release wirksam.
Und damit ist die Pointe eine viel bessere als „Linux ist im Weg“: was wie eine willkürliche Blockade aussieht, ist eine Leitplanke aus einem echten Schadensfall. Das erklärt übrigens auch, warum FreeBSD hier lockerer war. Dort gibt es diese Leitplanke nicht, es gibt keine Priority-Hierarchie, die den Beschleuniger aussortiert, und keine Maske, die ihn vom Blockgerät fernhält. Das heißt allerdings nicht, dass das Problem dort nicht existiert. Es heißt nur, dass niemand ein Geländer davor gebaut hat.
Ein Blick auf die FreeBSD-Seite lohnt an dieser Stelle sowieso, denn dort ist der Weg ein struktureller anderer. qat(4) ist ein Treiber für das OpenCrypto-Framework, also für crypto(9). Wer GELI benutzt, muss überhaupt nichts umkonfigurieren: GELI fragt das Framework, und das Framework nimmt den Beschleuniger. Deshalb war die Sache damals auch so unspektakulär, ich habe die Karte gesteckt und die Platten waren schneller.
Ganz so glatt war die Historie allerdings nicht. Im Basissystem gibt es qat(4) erst seit FreeBSD 13.0, und in 14.0 wurde dieser Treiber durch Intels Upstream-Variante ersetzt. Auf dem ersten Server, der noch älter war, kann es diesen Weg also nicht gegeben haben. Die aktuelle Manpage führt die Serie 8925 bis 8955 weiterhin als unterstützte Hardware, dieser Chip ist dort also nicht rausgefallen. Und noch etwas gegen zu viel Nostalgie: im FreeBSD-Forum gibt es einen Thread zur GELI-Performance, in dem QAT zunächst schlechter war als AES-NI. Erst nach dem Umstellen der QAT-Services berichtete der Autor rund 30 bis 34 Prozent Vorsprung bei AES-XTS mit SHA256, und bei anderen Lasten blieben Verluste. Die Karte war also auch damals kein bedingungsloser Gewinn, sondern eine, die zur Konfiguration passen musste.
Der zweite Dämpfer: Intels Userspace hat die Karte fallengelassen
Bleibt der andere große Anwendungsfall: TLS-Terminierung mit nginx oder HAProxy, OpenSSL-Offload. Dafür braucht man qatlib und dazu die QAT-Engine oder den Provider für OpenSSL. Auf meinem System ist davon nichts installierbar, kein Kandidat in den Repos, und OpenSSL 3.0.13 kennt nur den Default-Provider.
Schlimmer als „nicht gepackt“ ist aber der Grund: Intel hat dh895xcc aus qatlib entfernt. Die aktuellen Versionen unterstützen nur noch QAT Gen4, also die 4xxx- und 420xx-Serien. Die frühen Generationen sind nicht mehr dabei. Der Weg wäre der alte Out-of-Tree-Stack, und der baut gegen einen Kernel 7.0 nicht mehr.
Ich formuliere das bewusst nicht als „tot“. Behauptet ist: für diesen Chip ist der heutige Mainstream-Linux-Userspace praktisch abgehängt. Nicht behauptet ist, dass es global unmöglich wäre. Mit altem Kernel, altem Out-of-Tree-Treiber und passender Distribution ließe sich der Stack sicher noch aufbauen, und ältere DPDK-Versionen führten dh895xcc als unterstütztes Gerät. Es ist eine Frage von Aufwand und Kernel-Alter, nicht von Unmöglichkeit.
Die Ironie daran ist schön bitter. Intels eigener Userspace hat die Karte längst aufgegeben, während der Linux-Kernel sie weiter pflegt und beim Booten ohne ein einziges Paket zum Laufen bringt. Wer wissen will, warum In-Tree-Treiber so wertvoll sind: das hier ist der Beweis in einer Karte.
Ein dritter Befund noch, damit ihn niemand für einen Kartenfehler hält: ein einzelnes sendmsg über AF_ALG mit 256 KiB oder mehr blockiert dauerhaft. Aufgefallen ist mir das erst mit der Karte bei 1 MiB, reproduzieren lässt es sich aber mit dem CPU-Cipher genauso. Es ist also nicht die Hardware. Wo genau im AF_ALG-Pfad es hängt, habe ich nicht nachgewiesen, der Socket-Sendepuffer wäre die naheliegende Vermutung, aber eben eine ungeprüfte. Alle Messungen oben sind deshalb auf maximal 64 KiB begrenzt.
Kompression: der einzige Pfad, der von allein läuft, und er schadet
Erinnerst du dich an qat_deflate mit Priorität 4001 gegen deflate-generic mit 0? Jeder Kernel-Konsument, der nach deflate fragt, bekommt die Karte. Realistisch ist das zswap, die komprimierte Auslagerung im RAM.
Also nachgestellt: eine cgroup mit hartem Speicherlimit, 700 MiB gut komprimierbare anonyme Seiten, zswap auf deflate. Und tatsächlich, die Karte komprimiert die Auslagerung, 130.108 Firmware-Requests belegen das. Nur ist der direkte Vergleich bei gleicher Last ziemlich brutal:
zswap-Compressor
wall
user
sys
QAT-Requests
lzo (CPU)
0,85 s
0,11 s
0,72 s
0
deflate (QAT)
9,47 s
0,26 s
5,13 s
130.027
Elfmal langsamer. Und die System-CPU-Zeit steigt sogar von 0,72 auf 5,13 Sekunden, das Offload spart also nicht einmal CPU, es kostet zusätzlich welche. Der Grund ist derselbe wie überall in diesem Beitrag: zswap komprimiert eine 4-KiB-Seite pro Request, und das ist genau der Latenz-Worstcase.
Fair bleiben muss ich hier trotzdem: der Vergleich mischt zwei Effekte, denn Deflate ist algorithmisch auch schlicht teurer als LZO. Sauber wäre deflate auf CPU gegen deflate auf der Karte, und das habe ich nicht gemessen, weil sich deflate-generic bei Priorität 0 nicht ohne Weiteres erzwingen lässt. Die Aussage „QAT-zswap ist keine gute Idee“ trägt der Test, die Aufteilung zwischen Algorithmus und Latenz nicht.
Bleibt eine Frage, die ich hübsch finde: warum steht deflate überhaupt noch auf 4001? In der Datenkorruptions-Diskussion von 2022 schlug Intel vor, die Priorität der betroffenen Algorithmen auf 1 zu senken. Heute stehen Skcipher und AEAD bei 100, die Kompression aber weiter bei 4001. Die naheliegende Deutung: 4001 war ursprünglich die Politik „nimm immer den Beschleuniger“, sie wurde für Krypto nach dem Vorfall zurückgenommen und für Kompression nie. Damit wäre qat_deflate der letzte Überrest dieser alten Haltung, und ausgerechnet der Pfad, der heute noch stillschweigend gewinnt und dabei elfmal langsamer ist. Das ist allerdings meine Deutung, kein Beleg. Die Commit-Historie der Prioritätswerte für die Kompression habe ich nicht nachverfolgt.
Wer das nachbauen will: den Zustand danach wieder zurücksetzen, also enabled=N und compressor=lzo. Ein Dauerbetrieb mit dieser Einstellung wäre eine echte Verschlechterung der Maschine.
Die unvermeidliche Frage: kann man damit Bitcoin oder Monero minen?
Nein. Und zwar aus zwei völlig verschiedenen Gründen, und dieser Unterschied ist der eigentlich interessante Teil.
Monero geht prinzipiell nicht, nicht bloß langsam. Monero nutzt seit 2019 RandomX, und der Algorithmus wurde absichtlich so entworfen, dass Spezialhardware keinen Vorteil hat. Er generiert zur Laufzeit zufällige Programme aus Integer-, Fließkomma- und Branch-Instruktionen und führt sie in einer VM aus, teils JIT-compiliert. Er braucht 2 MiB Scratchpad pro Thread, permanent random-access beschrieben und gelesen. Und im Fast-Mode zusätzlich einen Datensatz von rund 2,08 GiB im RAM, aus dem die VM ständig liest. Das macht RandomX speichergebunden statt rechengebunden, und deshalb sind ASICs dort wirtschaftlich uninteressant.
Die QAT-Karte ist das exakte Gegenteil davon: eine Festfunktions-Pipeline. Sie kann AES, SHA, RSA, DH und Deflate, und nichts sonst. Sie hat keinen Befehlssatz, kein Scratchpad-Konzept und keinen Zugriff auf einen 2-GiB-Arbeitsdatensatz. AES kommt in RandomX zwar vor, aber als eingebetteter Schritt in der VM-Schleife, nicht als abtrennbare Massenoperation, die man an einen Coprozessor auslagern könnte. Die CPU dieser Maschine kann RandomX übrigens sehr wohl. Der Algorithmus ist ja genau für CPUs gemacht.
Bitcoin geht theoretisch, praktisch ist es absurd. Bitcoin ist doppeltes SHA-256 über einen 80 Byte großen Blockheader, und SHA-256 kann die Karte. Nur scheitert es an zwei harten Punkten.
Erstens ist es über diesen Stack nicht einmal ansprechbar. Der In-Kernel-Treiber registriert kein reines SHA-256, sondern nur authenc(hmac(sha256),cbc(aes)), also HMAC-authentifizierte Verschlüsselung. Nackte Hashes bekäme man nur über den Userspace-Stack, und der existiert für diesen Chip nicht mehr. Es gibt also gar keinen Weg, der Karte einen Blockheader zum Hashen zu geben.
Zweitens ist die Größenordnung hoffnungslos, und dafür genügt eine geschenkte Obergrenze. Selbst wenn die Karte ihre volle Datenblattleistung als reines Hashing liefern könnte, landet man bei realistischen 64 bis 128 Byte pro Hash-Operation in der Größenordnung von 10⁷ bis 10⁸ Hashes pro Sekunde, also höchstens einige zehn MH/s. Erreichen wird sie das nie, die gemessenen Latenzen zeigen ja, dass sie bei kleinen Nutzlasten zwei Größenordnungen unter ihrem Sweet Spot arbeitet.
Hashrate
Charakter der Zahl
QAT 8950
höchstens 10⁸ H/s
unerreichbare Obergrenze
ein aktueller ASIC-Miner
etwa 2 mal 10¹⁴ H/s
Produktangabe
Bitcoin-Gesamtnetz, 03.08.2026
9,3 mal 10²⁰ H/s
gemessen, 932 EH/s
Selbst mit der geschenkten Obergrenze liegt ein einzelner ASIC noch um mindestens sechs Größenordnungen über der Karte, und das Gesamtnetz um dreizehn. Der Anteil am Netz wäre günstigstenfalls in der Größenordnung 10⁻¹³, bei zehn Minuten Blockzeit also eine erwartete Wartezeit jenseits jeder sinnvollen Zeitskala, bei 40 Watt Dauerlast. Ich verzichte hier absichtlich auf eine konkrete Jahreszahl. Die klingt zwar gut, wäre aber Scheinpräzision auf einer geschätzten Grundlage. Größenordnungen sind hier die ehrlichere Währung, und sie sind genauso eindrucksvoll.
Die eigentliche Pointe ist aber eine sprachliche. Krypto-Beschleuniger heißt Kryptographie, nicht Kryptowährung. Die Karte ist für das gebaut, was Verbindungen und Platten schützt: TLS-Handshakes, IPsec-Tunnel, AES-XTS auf Blockgeräten. Dass beide Bedeutungen dasselbe Wort benutzen, ist ein Sprachunfall, und ich bin ziemlich sicher, dass er der Kryptographie mehr geschadet hat als der Kryptowährung.
Betrieb: man fliegt thermisch blind
Eine praktische Warnung, falls jemand auf die Idee kommt, so ein Ding in einen Desktop zu stecken: die Karte hat keinen Temperatursensor.sensors zeigt nichts, der BMC kennt sie nicht, in der SDR steht kein Eintrag. Man sieht also nicht, wie warm sie wird.
Und die Randbedingungen sind ungünstig: der Kühlkörper ist rein passiv und für den Querstrom eines Rackgehäuses ausgelegt, spezifiziert sind 0 bis 55 Grad Umgebungstemperatur, es dürfen bis zu 40 Watt Verlustleistung sein, und mein Gehäuse ist auf Ruhe optimiert, mit bewusst langsam drehenden Lüftern. Die Netzwerkkarte im Nachbarslot liegt schon im Leerlauf bei 61 Grad, und die beiden teilen sich denselben schlechten Luftstrom. Wie warm die Karte unter der Last aus diesem Beitrag wirklich geworden ist, weiß ich nicht. Ohne Sensor bräuchte es ein IR-Thermometer oder ein Thermoelement. Steht auf der Liste.
Überflüssig gewordene Technik, und warum mir das trotzdem naheliegt
Diese Karte ist für mich so etwas wie eine Soundkarte. Es gab eine Zeit, da war eine dedizierte Soundkarte selbstverständlich, weil der Rest der Maschine das einfach nicht konnte. Ich hänge immer noch an den alten Creative-Karten, nicht nur an den ISA-Dingern, auch an den späteren. Die hatten eine Wertigkeit, ein Gewicht, eine Bestückung, die man ansehen konnte. Man hat ein Bauteil gekauft, das eine Aufgabe hatte, und das hat man auch gesehen.
Heute steckt in meiner Workstation nicht einmal mehr eine Onboard-Lösung im Einsatz, sondern ein Behringer 302USB, also ein kleines Mischpult mit USB-Audiointerface. Für meinen Fall reicht das absolut. Die Aufgabe ist nicht verschwunden, sie hat nur ihren Platz gewechselt, und die CPU rechnet das nebenbei mit, ohne dass es jemandem auffällt. Genau das ist mit Krypto passiert. AES-NI und VAES haben die Beschleunigerkarte nicht besiegt, sie haben sie aufgesogen.
Immer kleiner, komplexer und leistungsfähiger ist total geil. Ohne diese Entwicklung gäbe es die Hälfte von dem nicht, was wir heute technisch machen. Aber sie macht das Verstehen sehr viel schwieriger. Mein alter C64 und der VC20 davor, die Dinger hat man noch verstanden. Eine CPU mit rund einem Megahertz in einem 40-Pin-Gehäuse, groß genug und langsam genug, dass man mit dem Oszilloskop an einzelne Pins konnte und dabei etwas gesehen hat. Man konnte am Speicher nachmessen. Das war begreifbar im wörtlichen Sinn. An dem Xeon in dieser Maschine messe ich nichts nach. Der Die ist unter einem Heatspreader, die Signale sind differentiell und liegen im Gigahertzbereich, und selbst wenn ich rankäme, wäre mein Oszilloskop zu langsam. Dass bei dieser Karte das nackte Silizium offen liegt, ist ein Zufall der Bauform, und trotzdem freut es mich jedes Mal.
Dafür haben wir heute AI, um uns Dinge erklären zu lassen, und das ist ein echter Gewinn. Ich komme damit an Ecken, an die ich vor zehn Jahren nur mit sehr viel mehr Zeit gekommen wäre. Wir müssen nur alle aufpassen, dass wir dabei nicht aufhören zu verstehen. Der Unterschied zwischen „ich habe es erklärt bekommen“ und „ich habe es verstanden“ ist genau der Unterschied zwischen diesem Beitrag und einer Feature-Liste. Und ein Teil davon passiert ja bereits in der AI-Entwicklung selbst: wir verstehen nicht mehr im Detail, was in diesen Systemen passiert. Stand jetzt halte ich das für ein Problem. Vielleicht ist es aber auch bald einfach das Normale, und ich bin der Typ, der dem Oszilloskop nachtrauert.
Ehrliche Gesamteinschätzung
Als Produktivkomponente ist die Karte in dieser Maschine sinnlos. Eine einzige moderne CPU der Einstiegsklasse schlägt sie bei symmetrischer Krypto um Faktor 8,6, der Anwendungsfall, für den sie gekauft wurde, ist unter Linux versperrt, Intels Userspace hat sie aufgegeben, sie zieht laut Datenblatt bis zu 40 Watt für etwas, das die CPU besser kann, und gekühlt wird sie für einen Luftstrom, den mein Gehäuse nicht liefert.
Als Lehr- und Erzählobjekt ist sie ausgezeichnet. An diesem einen Stück Platine lassen sich Krypto-Offload als Architektur, Latenz gegen Durchsatz, warum Queue-Tiefe alles ist, PCIe-Generationen und Lane-Budgets, PCIe-Switches, SR-IOV, IOMMU-Gruppen und die Prioritätslogik der Linux Crypto API erklären. Ich kenne wenige Bauteile, die auf so kleiner Fläche so viele Anknüpfungspunkte haben. Und sie funktioniert einfach, nach 13 Jahren, ohne ein einziges installiertes Paket.
Genau diese Spannung war der Grund, sie überhaupt noch einmal einzustecken.
Was offen bleibt
Die Karte per VFIO an eine FreeBSD-VM durchreichen und dort GELI auf QAT laufen lassen, also die Original-Nutzung rekonstruieren. Sie ist allein in ihrer IOMMU-Gruppe, technisch steht dem nichts im Weg. Das ist der Versuch, auf den ich am meisten Lust habe.
SR-IOV aktivieren und sehen, was der Treiber mit 32 Virtual Functions macht. Völlig ungetestet.
PCIe-Zähler messen, um zu belegen oder zu widerlegen, dass wirklich der Bus limitiert und nicht der Zugangspfad. Der wichtigste offene Messpunkt.
Die Benchmarks methodisch nachziehen: Warmup, mehrere Läufe, Median und P95, CPU-Pinning.
Kernel-RSA über die Karte messen.qat-rsa gewinnt per Priorität, aber es gibt keinen AF_ALG-Zugang zu akcipher.
Temperatur und echte Leistungsaufnahme, beides nur extern messbar.
Das PLX-EEPROM auslesen, um die Lane-Aufteilung zu belegen statt zu vermuten.
Hast du so eine Karte noch im Einsatz, vielleicht sogar noch produktiv? Dann würde mich das wirklich interessieren, und ihr dürft mich sehr gerne fragen.