Auf meiner alten Maschine standen zwei Prozessoren. Das klingt erst einmal nach doppelt so gut, und in Wahrheit war es vor allem doppelt so kompliziert. Ich habe damals ziemlich viel Zeit damit verbracht, einem Spiel beizubringen, dass es bitte auf der Hälfte der CPU laufen soll, und zwar auf derjenigen, an der auch die Grafikkarte hängt, weil der Weg zur anderen Hälfte zu lang war. Das Werkzeug dafür heisst NUMA, und wer einmal damit zu tun hatte, vergisst es nicht mehr.
Die neue Maschine hat einen Sockel. Damit ist das Thema erledigt, dachte ich. Ist es nicht ganz, und diese Folge erklärt warum. Es geht um Advanced > Chipset Configuration > North Bridge > Uncore Configuration und um zwei Zeilen aus den ACPI-Einstellungen. Alle Folgen dieser Serie stehen unter BIOS & Firmware.
Was Uncore überhaupt ist
Der Begriff kommt von Intel und meint alles auf dem Prozessorchip, was kein Rechenkern ist. Der gemeinsame L3-Cache. Die Speichercontroller. Die PCIe-Root-Ports. Das Verbindungsnetz, das all das miteinander verbindet. Bei einem modernen Xeon ist der Uncore flächenmässig ein erheblicher Teil des Chips und verbraucht auch einen erheblichen Teil des Stroms.
Der Uncore hat einen eigenen Takt, unabhängig von den Kernen. Er läuft weiter, wenn alle Kerne schlafen, denn irgendjemand muss ja mitbekommen, wenn eine Netzwerkkarte etwas will. Wenn man in Datenblättern liest, dass ein Serverprozessor im Leerlauf noch 40 Watt zieht, obwohl er angeblich nichts tut, ist das zum guten Teil der Uncore.
Die Kopfzeilen sagen mehr als der Rest
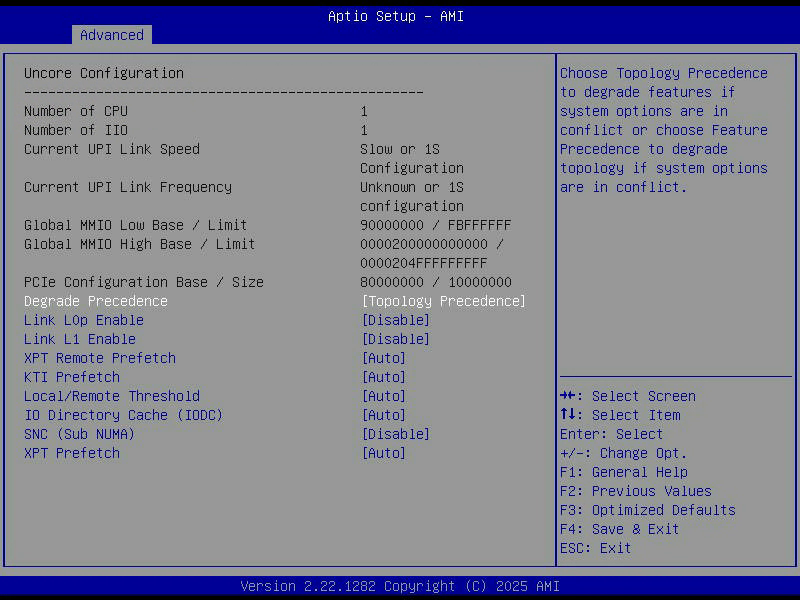
Number of CPU                     1
Number of IIO                     1
Current UPI Link Speed            Slow or 1S Configuration
Current UPI Link Frequency        Unknown or 1S configuration
Diese vier Zeilen finde ich fast rührend. UPI ist Ultra Path Interconnect, Intels Verbindung zwischen zwei Prozessoren in einem System. Über sie laufen Speicherzugriffe auf den Speicher des jeweils anderen und die gesamte Cache-Kohärenz, also die Buchhaltung darüber, wer gerade welche Speicherzeile in seinem Cache liegen hat.
Bei mir steckt genau eine CPU im Board. Also gibt es niemanden, mit dem geredet werden müsste, und das Setup sagt das auf seine eigene Art: 1S Configuration, Single Socket. Die Firmware weiss es, das Menü existiert trotzdem, weil dasselbe BIOS auch auf Zwei-Sockel-Boards läuft.
Number of IIO ist die Zahl der Integrated IO Hubs, also der Einheiten, die die PCIe-Lanes bereitstellen. Bei einem Sockel logischerweise eins.
Interessanter sind die Adressbereiche darunter:
Global MMIO Low Base / Limit      90000000 / FBFFFFFF
Global MMIO High Base / Limit     0000200000000000 / 0000204FFFFFFFFF
PCIe Configuration Base / Size    80000000 / 10000000
Das ist die Speicherlandkarte für alles, was nicht RAM ist. Der untere Bereich liegt unterhalb von 4 GB, ist entsprechend eng und wird knapp, sobald mehrere Karten mit grossen Speicherfenstern stecken. Der obere beginnt bei 0x200000000000, also bei 32 Terabyte, und ist der Grund, warum meine Grafikkarte ihre kompletten 16 GB Videospeicher einblenden kann. Dazu mehr in der Folge über Above 4G Decoding und Resizable BAR.
NUMA, obwohl es nichts zu verteilen gibt
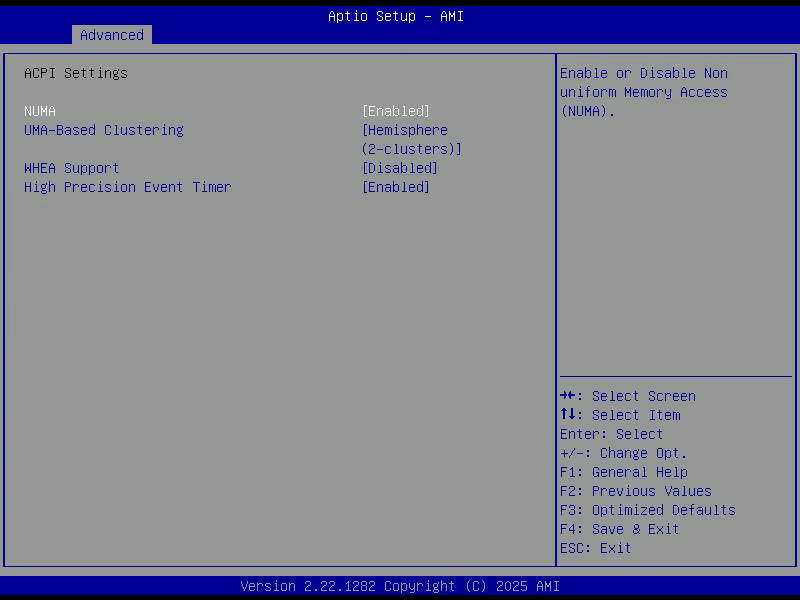
Zwei Menüs weiter, unter Advanced > ACPI Settings:
NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]
NUMA steht für Non-Uniform Memory Access und beschreibt den Umstand, dass nicht jeder Speicherzugriff gleich lange dauert. Bei zwei Sockeln ist das offensichtlich: der eigene Speicher ist nah, der des Nachbarn geht über UPI und kostet spürbar mehr Zeit. Das Betriebssystem muss davon wissen, sonst legt es Daten und die Prozesse die damit arbeiten in verschiedene Ecken der Maschine.
Bei einem Sockel gibt es diese Unterscheidung nicht, und mein System meldet folgerichtig:
lscpu | grep NUMA
#   NUMA-Knoten:            1
#   NUMA-Knoten0 CPU(s):    0-15
Ein Knoten, alle sechzehn logischen Prozessoren darin. Warum steht der Schalter dann auf Enabled? Weil er nicht nur Knoten erzeugt, sondern die ACPI-Tabellen füllt, in denen die Topologie beschrieben wird. Die stehen bei mir vollständig zur Verfügung:
ls /sys/firmware/acpi/tables/ | grep -E "SRAT|SLIT|HMAT"
#   HMAT  SLIT  SRAT
SRAT ordnet Prozessoren und Speicherbereiche einander zu, SLIT beschreibt die Entfernungen zwischen den Knoten, HMAT geht noch weiter und beschreibt Bandbreiten und Latenzen. Bei einem Knoten ist der Inhalt langweilig, aber vorhanden. Auf Disabled würde das Betriebssystem schlicht weniger über die Maschine wissen, ohne dafür irgendetwas zu gewinnen.
Der Schalter mit dem sperrigen Namen
UMA-Based Clustering [Hemisphere (2-clusters)] ist die Zeile, an der ich beim ersten Lesen hängen geblieben bin. Um sie zu verstehen, muss man wissen, wie so ein Chip innen aussieht.
Bei Ice Lake sitzen Kerne, Cache-Scheiben und Speichercontroller in einem Gitter, dem Mesh. Jeder Zugriff wandert durch dieses Gitter. Meine CPU hat vier Speichercontroller mit je zwei Kanälen, macht acht, und das ist genau die Zahl meiner Speichermodule. Je nachdem wo im Gitter ein Kern sitzt, ist der eine Controller näher als der andere.
Hemisphere teilt den Chip in zwei Bereiche und sorgt über eine Hash-Funktion dafür, dass eine Speicheradresse der Cache-Scheibe zugeordnet wird, die auf derselben Seite des Chips liegt wie der zuständige Speichercontroller. Der Weg durchs Gitter wird kürzer. Nach aussen bleibt es ein einziger Speicherbereich, das Betriebssystem merkt nichts davon. Die Variante Quadrant macht dasselbe mit vier Bereichen.
Passend dazu steht im Uncore-Menü:
SNC (Sub NUMA) [Disable]
Sub-NUMA-Clustering ist die radikale Variante derselben Idee. Es meldet dem Betriebssystem tatsächlich mehrere NUMA-Knoten, obwohl nur eine CPU steckt, und überlässt ihm die Verteilung. Für eine Datenbank, die weiss was sie tut, kann das etwas bringen. Für einen Desktop bringt es Ärger, weil plötzlich wieder Prozesse und ihr Speicher auseinanderlaufen können.
Ich habe mit genau diesem Problem auf der alten Maschine genug Abende verbracht. Das lasse ich aus, und zwar mit Nachdruck.
Die Prefetcher zwischen den Sockeln
XPT Prefetch                      [Auto]
XPT Remote Prefetch               [Auto]
KTI Prefetch                      [Auto]
Stale AtoS                        [Auto]
LLC Dead Line Alloc               [Enable]
IO Directory Cache (IODC)         [Auto]
Snoop Throttle Configuration      [Auto]
Local/Remote Threshold            [Auto]
In Teil 3 ging es um fünf Prefetcher, die raten welche Daten ein Kern als nächstes braucht. Das hier ist dieselbe Idee eine Ebene höher: raten, welchen Weg eine Anfrage nehmen wird, und sie schon mal losschicken.
XPT Prefetch schickt eine Speicheranfrage parallel zur Cache-Abfrage direkt an den Speichercontroller. Stellt sich heraus, dass die Daten doch im Cache lagen, war es umsonst. Stellt sich heraus, dass sie es nicht taten, hat man die Cache-Suche geschenkt bekommen. KTI Prefetch macht dasselbe über die Sockelverbindung hinweg, XPT Remote Prefetch ebenfalls, und beide sind bei einem Sockel gegenstandslos.
LLC Dead Line Alloc ist die einzige Zeile hier, die nicht auf Auto steht. Dahinter steckt eine Aufräumfrage: wenn eine Zeile aus dem L2 verdrängt wird, soll sie dann in den gemeinsamen L3 wandern, obwohl sie vermutlich tot ist, also nie wieder gebraucht wird? Enable heisst hier ja, und für allgemeine Lasten ist das die richtige Wette.
Snoop Throttle bremst die Kohärenzabfragen, wenn das Gitter überlastet ist. IO Directory Cache merkt sich, welche Cache-Zeilen von PCIe-Geräten angefasst wurden, damit nicht bei jedem DMA-Zugriff alle Kerne gefragt werden müssen.
Bei all diesen Zeilen gilt dasselbe: Auto bedeutet, dass Intel für die erkannte Konfiguration sinnvolle Werte hinterlegt hat. Wer hier von Hand dreht, sollte einen Messaufbau haben und eine konkrete Vermutung. Ich habe beides nicht, und ich glaube nicht, dass ich mit Raten schlauer bin als die Leute die den Chip entworfen haben.
Zwei Zeilen die ich fast überlesen hätte
Link L0p Enable                   [Disable]
Link L1 Enable                    [Disable]
Das sind Stromsparzustände für die UPI-Verbindung. L0p schaltet einen Teil der Leitungen ab, L1 die ganze Verbindung. Beide kosten Zeit beim Aufwachen, und beide sind hier ohne Wirkung, weil es keine UPI-Verbindung gibt.
Ich erwähne sie trotzdem, weil sie ein schönes Beispiel für etwas sind, das durch die ganze Serie zieht: ein Server-BIOS zeigt einem alles, was das Board könnte, nicht das was die konkrete Maschine hat. Wer hier ohne diese Einordnung durchgeht, stellt Dinge ein, die schlicht niemanden interessieren.
Fazit
Die Uncore-Seite ist die Seite, an der ich am wenigsten geändert habe und am meisten gelernt. Zwanzig Einstellungen, davon stehen sechzehn auf Auto, und das ist auch gut so. Was bleibt, ist ein ziemlich direkter Blick darauf, wie so ein Chip innen organisiert ist: ein Gitter, Speichercontroller an verschiedenen Stellen, Cache dazwischen, und eine Menge Mechanik die versucht, Wege abzukürzen.
Nächste Folge: PCIe. Slots, Lanes, was Bifurcation ist, und warum eine Grafikkarte in einem x16-Steckplatz trotzdem nur acht Bahnen nutzt.
Siehe auch
- Teil 3 der Serie (die fünf Prefetcher eine Ebene tiefer)
- Teil 6 der Serie (der Speicher, an dem diese vier Controller hängen)
Falls jemand von euch SNC auf einem Ein-Sockel-Xeon eingeschaltet und dabei etwas Messbares gewonnen hat, würde ich das gerne lesen. Ihr dürft mich jederzeit fragen.
Schreibe einen Kommentar