IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: Intel (Seite 1 von 2)

BIOS erklärt, Teil 12: elf leere SATA-Anschlüsse und eine Verschlüsselung die es nicht gibt

Diese Folge fängt mit einem Anti-Klimax an: die beiden Storage-Seiten dieses Boards zeigen bei mir ausschliesslich leere Anschlüsse.

SATA Port 0..7                    [Not Installed]
sSATA Port 0..2                   [Not Installed]

Elf Anschlüsse, elf mal nichts. Meine beiden Laufwerke sind NVMe und hängen an PCIe, dazu gab es Teil 8. Trotzdem ist das eine der Seiten, an der man am meisten über die Geschichte von Massenspeicher lernt, und am Ende dieser Folge steht ein Thema, das mich beim Nachlesen mehr beschäftigt hat als erwartet.

Teil 12, alle bisherigen Folgen unter BIOS & Firmware.

Warum es zwei SATA-Seiten gibt
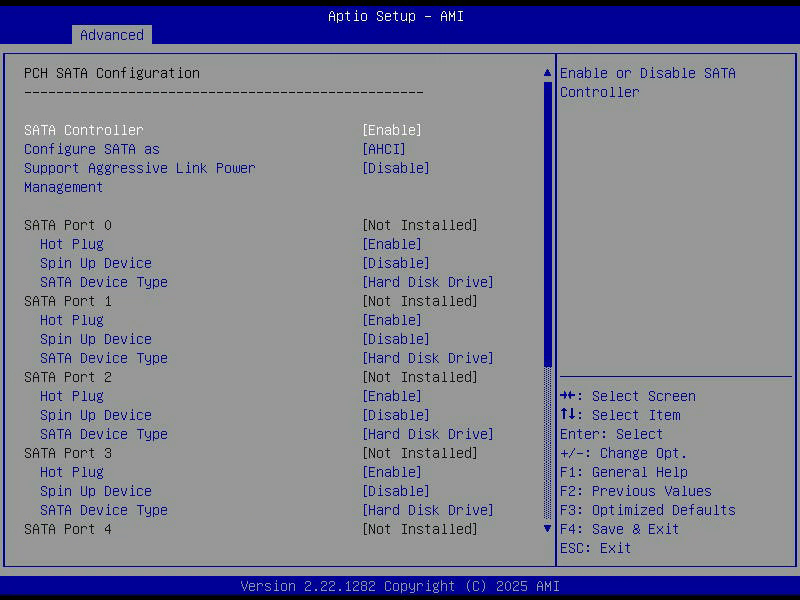
Aptio Setup, PCH SATA Configuration, AHCI-Modus und acht Anschlüsse, alle als Not Installed gemeldet

PCH SATA Configuration mit acht Anschlüssen und PCH sSATA Configuration mit drei. Das sind zwei getrennte Controller im Chipsatz, und das kleine s steht für secondary. Der Grund ist banal: irgendwann reichten die Anschlüsse des Hauptcontrollers nicht mehr, also hat Intel einen zweiten danebengesetzt. Für das Betriebssystem sind es zwei Geräte, und genau so sieht man sie:

lspci -nn | grep -i sata
#   00:11.5 SATA controller: ... C620 Series Chipset Family SSATA Controller [AHCI mode]
#   00:17.0 SATA controller: ... C620 Series Chipset Family SATA Controller [AHCI mode]

Elf Anschlüsse insgesamt, und Linux legt für jeden brav einen Port an, ob da etwas hängt oder nicht:

ls /sys/class/ata_port/
#   ata1 ata2 ata3 ata4 ata5 ata6 ata7 ata8 ata9 ata10

AHCI, und was die Alternative wäre

Configure SATA as                 [AHCI]

Dieser Schalter hat historisch mehr kaputte Windows-Installationen verursacht als vermutlich jeder andere im BIOS. Die Alternativen sind je nach Board IDE und RAID.

IDE lässt den Controller so tun, als wäre er ein Festplattencontroller von 1994. Kein Native Command Queuing, kein Hot Plug, dafür funktioniert es mit wirklich jedem Betriebssystem. AHCI ist der moderne Modus mit allem was dazugehört. RAID schiebt einen firmwaregestützten RAID-Verbund dazwischen, der in Wahrheit vom Treiber gemacht wird.

Der Klassiker war und ist: System im einen Modus installiert, später im BIOS umgestellt, Bluescreen beim nächsten Start, weil der passende Treiber nicht geladen wird. Unter Linux ist das entspannter, aber auch dort ändern sich die Gerätenamen.

AHCI ist auf diesem Board die richtige Wahl, und wäre es auch dann, wenn Laufwerke steckten. Softwareseitiges RAID ist unter Linux besser aufgehoben als in einer Chipsatz-Firmware, deren Metadatenformat man später nirgends mehr lesen kann.

Hot Plug, pro Anschluss

SATA Port 0
  Hot Plug                        [Enable]
  Spin Up Device                  [Disabled]
  SATA Device Type                [Hard Disk Drive]

Jeder der elf Anschlüsse hat sein eigenes kleines Untermenü mit denselben drei Einstellungen. Hot Plug erlaubt das Wechseln im laufenden Betrieb. Auf einem Serverboard ist das selbstverständlich an, weil dort Wechselrahmen sitzen. In einem Tower ohne Wechselrahmen ist es eine theoretische Freiheit, aber es kostet auch nichts.

Spin Up Device ist ein Relikt aus der Zeit rotierender Platten. Eingeschaltet lässt die Firmware die Laufwerke gestaffelt anlaufen statt alle gleichzeitig. Der Anlaufstrom einer Festplatte ist ein Vielfaches ihres Betriebsstroms, und wer zwölf davon gleichzeitig hochfährt, kann ein knapp bemessenes Netzteil in die Knie zwingen. Bei SSDs ist das gegenstandslos, bei einem Board für zwölf Platten nicht.

SATA Device Type unterscheidet zwischen Festplatte und SSD und dient vor allem dazu, der Firmware zu sagen ob sie mit Anlaufzeiten rechnen muss.

Support Aggressive Link Power Mgmt [Disable] ist das SATA-Gegenstück zu ASPM aus Teil 10: Stromsparzustände für die Verbindung. Auf Servern traditionell aus, weil es in der Vergangenheit zu sporadischen Abbrüchen geführt hat. Auf Notebooks dagegen unverzichtbar für die Akkulaufzeit.

Und jetzt zum interessanten Teil
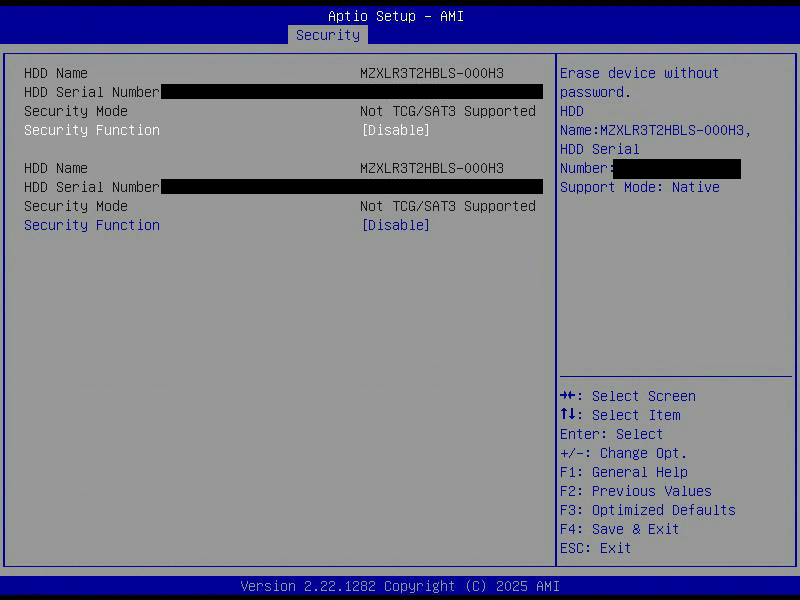
Aptio Setup, HDD Security, zwei Laufwerke mit geschwärzten Seriennummern und dem Vermerk Not TCG oder SAT3 Supported

Unter Security > HDD Security Configuration steht das hier:

HDD Name                          MZXLR3T2HBLS-000H3
HDD Serial Number                 (geschwärzt)
Security Mode                     Not TCG/SAT3 Supported
Security Function                 [Disable]

Zweimal dasselbe, weil zwei gleiche Laufwerke stecken. Und die dritte Zeile ist der Grund für diesen Abschnitt.

Es gibt seit langem eine Funktion, die im Laufwerk selbst sitzt und wenig bekannt ist: ATA Security. Man setzt ein Passwort direkt auf die Platte, und ohne dieses Passwort gibt sie keine Daten heraus. Kein Treiber, keine Software, das Laufwerk selbst verweigert die Arbeit.

Bei vielen modernen SSDs kommt etwas dazu, das die Sache erst richtig interessant macht: sie verschlüsseln ihre Daten intern ohnehin, auch ohne dass jemand ein Passwort gesetzt hat. Der Controller erzeugt beim ersten Start einen zufälligen Schlüssel, verschlüsselt damit alles was in den Flash geht, und entschlüsselt beim Lesen wieder. Das Betriebssystem merkt davon nichts.

Der Zweck ist dabei zunächst gar nicht Sicherheit, und das fand ich beim Nachlesen die überraschendste Erkenntnis: es geht um das Löschen. Wer ein Passwort setzt, schützt damit diesen bereits vorhandenen Schlüssel.

Denn daraus folgt der Trick, den ich vor einer Weile selbst genutzt habe. Ein Secure Erase auf so einem Laufwerk überschreibt nichts. Er wirft den internen Schlüssel weg und würfelt einen neuen. Danach sind sämtliche Daten auf dem Flash zwar noch physisch da, aber nur noch als Zufallsrauschen. Das ist nicht nur schneller als Überschreiben, es schont auch die Zellen, denn jedes Überschreiben kostet Lebensdauer. Das Ganze dauert entsprechend nicht Stunden, sondern:

hdparm --user-master u --security-set-pass p /dev/sda
hdparm --user-master u --security-erase-enhanced p /dev/sda

Bei den Samsung-SSDs, die ich so gelöscht habe, war das in unter einer Sekunde erledigt, obwohl das Werkzeug acht Minuten angekündigt hatte. Eine Intel-SSD im selben Durchgang brauchte siebzehn Sekunden. Beide waren danach leer, aber unterschiedlich leer: die Intel lieferte durchgehend Nullen, die Samsungs eine Mischung aus Nullen und Rauschen. Beides ist korrekt, es sind nur zwei verschiedene Herangehensweisen. Wer Nullen als Erfolgskriterium erwartet, hält ein Samsung-Ergebnis fälschlich für einen Fehlschlag.

Meine Laufwerke können das nicht

Not TCG/SAT3 Supported heisst genau das: diese beiden PM1735 unterstützen weder TCG Opal noch den ATA-Security-Durchgriff über SAT3. Es gibt hier also kein Laufwerkspasswort und keinen selbstverschlüsselnden Betriebsmodus, den man aktivieren könnte.

Das ist für Enterprise-NVMe nicht ungewöhnlich. Die Modellpalette wird üblicherweise in Varianten mit und ohne Verschlüsselungsfunktion aufgeteilt, weil manche Kunden aus regulatorischen Gründen ausdrücklich Laufwerke ohne Krypto brauchen. Meine sind offenbar aus der zweiten Gruppe.

Praktisch macht mir das nichts aus, weil ich ohnehin eine Ebene höher verschlüssele. Die Systemplatte läuft über LUKS, darüber liegt LVM, darin Wurzeldateisystem und Auslagerung. Damit ist alles verschlüsselt, inklusive Swap, und zwar mit einem Schlüssel den ich kontrolliere und nicht mit einem, der im Controller eines Laufwerks liegt.

Der Unterschied ist nicht nur philosophisch. Bei Laufwerksverschlüsselung vertraut man einer proprietären Implementierung, die man nicht prüfen kann, und es hat in der Vergangenheit mehrfach Untersuchungen gegeben, bei denen genau diese Implementierungen erhebliche Schwächen hatten. Bei LUKS kann man nachlesen was passiert.

Der Preis ist Rechenzeit, und der ist dank AES-NI vernachlässigbar. Dazu gab es in Teil 4 einen längeren Abschnitt.

Was ich stattdessen im Blick behalte

Wenn die Laufwerke selbst keine Sicherheitsfunktion anbieten, bleibt als Aufgabe des BIOS eigentlich nur, sie sauber anzubinden. Alles Weitere spielt sich im Betriebssystem ab, und dort sieht es gut aus:

smartctl -H /dev/nvme0
#   SMART overall-health self-assessment test result: PASSED

Available Spare:                    100%
Percentage Used:                    0%
Media and Data Integrity Errors:    0
Error Information Log Entries:      0
Power On Hours:                     3.166

Null Prozent Abnutzung nach gut dreitausend Betriebsstunden, keine Medienfehler, kein einziger Eintrag im Fehlerprotokoll. Eine Zeile fällt mir trotzdem auf: dreissig unsaubere Abschaltvorgänge. Das ist für eine Maschine, die auch mal hart ausgeschaltet wird, im Rahmen, aber es ist die Zahl, bei der ich hinsehe wenn sie plötzlich schneller steigt.

Fazit

Elf leere Anschlüsse und ein Laufwerk ohne Verschlüsselungsfunktion klingt nach einer mageren Folge. Ich fand sie trotzdem lohnend, weil zwei Dinge dabei herauskamen. Erstens die Erkenntnis, warum ein Secure Erase auf einer SSD in einer Sekunde fertig ist und trotzdem gründlicher als jedes Überschreiben. Und zweitens die Bestätigung, dass die Verschlüsselungsentscheidung an dieser Maschine bereits richtig getroffen ist, weil sie gar nicht anders getroffen werden konnte.

Nächste Folge: das Vorstart-Netzwerk. PXE, iSCSI, Option ROMs von Netzwerkkarten, und eine Karte die dem BIOS meldet, dass ihr eigener Treiber zu alt für sie selbst ist.

Siehe auch

Falls jemand von euch ATA Security produktiv einsetzt statt einer Softwarelösung: warum? Das würde mich ehrlich interessieren, ihr dürft mich jederzeit fragen.
BIOS erklärt, Teil 11: VT-d, 102 IOMMU-Gruppen und ein Menü das falsch beschriftet ist

Wenn man einer virtuellen Maschine eine echte Grafikkarte geben will, stösst man ziemlich schnell auf einen Begriff, der wie eine Ausrede klingt: IOMMU-Gruppen. Man liest dann Sätze wie „deine Karte ist in derselben Gruppe wie der USB-Controller, also geht das nicht“, und wenn man Pech hat, findet man kurz darauf Anleitungen mit dem Wort „ACS-Override“ darin, die einem erklären wie man diese Regel umgeht und dabei die Isolation aushebelt.

Der Ursprung dieser ganzen Geschichte liegt in einem einzigen BIOS-Untermenü, und um das geht es heute. Teil 11 der Serie, alle Folgen unter BIOS & Firmware. Wir sind unter Advanced > Chipset Configuration > North Bridge > IIO Configuration, und diesmal in den Untermenüs statt auf der Übersicht.

VT-d, oder: wer darf in den Speicher schreiben

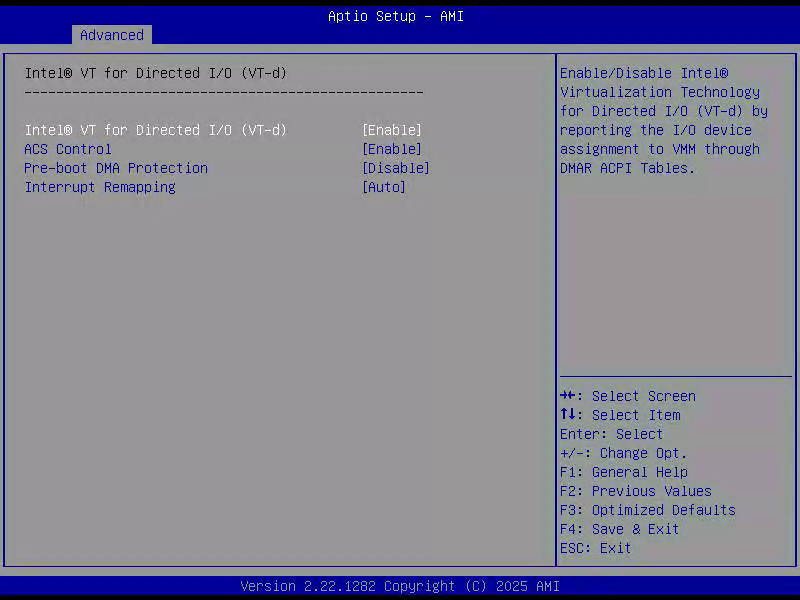
Aptio Setup, Intel VT for Directed I O, mit ACS Control, Pre-boot DMA Protection und Interrupt Remapping
Intel(R) VT for Directed I/O (VT-d)   [Enable]
ACS Control                           [Enable]
Pre-boot DMA Protection               [Disable]
Interrupt Remapping                   [Auto]

Das Grundproblem, das VT-d löst, ist älter als Virtualisierung. Eine PCIe-Karte darf per DMA selbständig in den Arbeitsspeicher schreiben, ohne die CPU zu fragen. Das ist der Grund, warum Netzwerkkarten und Laufwerke überhaupt schnell sind. Es bedeutet aber auch, dass eine Karte in jeden beliebigen Speicherbereich schreiben kann, sofern niemand sie daran hindert.

Die IOMMU ist dieser Jemand. Sie sitzt zwischen den Geräten und dem Speicher und übersetzt Adressen, genau wie die MMU es für Prozesse tut. Ein Gerät sieht dann nur noch den Speicher, der ihm zugewiesen wurde. Damit kann man einer virtuellen Maschine eine echte Karte geben, ohne dass diese Karte den Speicher des Wirtssystems lesen könnte.

Bei mir ist das aktiv, was man am Startprotokoll sieht:

dmesg | grep DMAR-IR
#   DMAR-IR: Enabled IRQ remapping in x2apic mode

Interrupt Remapping ist der zweite Teil derselben Absicherung. Interrupts sind auf modernen Systemen einfach Schreibzugriffe auf eine bestimmte Adresse. Ohne Umsetzung könnte ein Gerät damit Interrupts auslösen, die für andere gedacht sind. Die Umsetzung schiebt eine Tabelle dazwischen.

Nebenbei erklärt das eine Kuriosität aus Teil 4: dort stand ein Schalter namens Extended APIC auf Disable, und trotzdem läuft mein System im x2APIC-Modus. Der Grund steht in der Zeile oben. Der Kernel schaltet x2APIC selbst ein, sobald Interrupt Remapping läuft, weil er es dafür braucht. Die BIOS-Option entscheidet nur, ob die Firmware es vorab tut.

ACS, und die Sache mit den Gruppen

ACS Control [Enable] ist der Schalter, wegen dem ich diese Folge angefangen habe.

Access Control Services regeln, ob zwei Geräte hinter demselben Switch direkt miteinander reden dürfen, ohne dass der Verkehr über die IOMMU läuft. Ohne ACS kann die IOMMU nicht garantieren, dass zwei Geräte voneinander getrennt sind, und muss sie deshalb als eine Einheit behandeln. Das ist eine IOMMU-Gruppe: die kleinste Menge Geräte, die man nur gemeinsam durchreichen kann.

Bei mir sieht das ordentlich aus:

ls /sys/kernel/iommu_groups | wc -l
#   102

102 Gruppen, und die meisten enthalten genau ein Gerät. Das ist der Zustand, den man haben will, und man bekommt ihn nicht geschenkt. Auf typischen Consumer-Boards liegen regelmässig ein halbes Dutzend Geräte in einer Gruppe, weil der Chipsatz sie hinter einem Switch ohne ACS bündelt. Dann kommen die Anleitungen mit dem ACS-Override ins Spiel, und die tun genau das wonach sie klingen: sie lügen dem Kernel vor, es gäbe eine Trennung. Für ein Heimlabor mag das reichen. Es ist trotzdem das Abschalten einer Sicherheitsfunktion, und man sollte wissen dass man es tut.

Ein Beispiel aus meiner Maschine, das den Unterschied zeigt: als vorübergehend eine Beschleunigerkarte in Steckplatz 7 steckte, landete sie allein in Gruppe 6. Alleine in einer Gruppe heisst durchreichbar, ohne Tricks, ohne Override. Das war die Voraussetzung dafür, überhaupt darüber nachzudenken, sie einer virtuellen Maschine zu geben.

Pre-boot DMA Protection [Disable] schützt das Zeitfenster vor dem Betriebssystemstart. Der klassische Angriff dagegen läuft über Thunderbolt: Gerät anstecken während der Rechner im Setup steht, per DMA Speicher auslesen. Dieses Board hat kein Thunderbolt, und wer physisch am Gehäuse steht, hat ohnehin bessere Möglichkeiten. Aus ist hier vertretbar.

VMD, und warum es aus bleibt

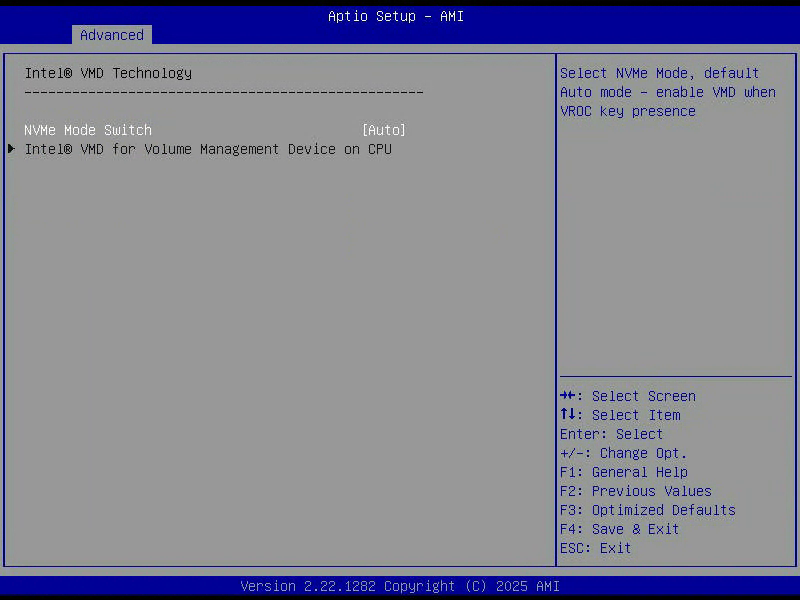
Aptio Setup, Intel VMD Technology, NVMe Mode Switch steht auf Auto
Intel(R) VMD Technology
NVMe Mode Switch                  [Auto]
> Intel(R) VMD for Volume Management Device on CPU

Volume Management Device ist eine Erfindung, die vor allem für vorkonfigurierte Server gedacht ist. Eingeschaltet fasst der Prozessor mehrere NVMe-Laufwerke zusammen und präsentiert sie nach aussen als ein einziges Gerät. Das ermöglicht Hot-Plug ohne Betriebssystemunterstützung und ist die Voraussetzung für Intels RAID-Lösung VROC.

Bei mir steht das auf Auto, und der Hilfetext im Setup sagt dazu wörtlich default Auto mode, enable VMD when VROC key presence. Also nur aktiv, wenn ein VROC-Lizenzschlüssel steckt. Es steckt keiner. Die Gegenprobe:

lspci -nn | grep -i "volume management"
#   (keine Ausgabe)

Nichts da, beide Laufwerke hängen direkt an ihren Root Ports.

Und dabei soll es bleiben. Mit eingeschaltetem VMD verschwinden meine NVMe-Laufwerke hinter einem Controller, brauchen einen zusätzlichen Treiber, und sind nicht mehr einzeln als PCIe-Geräte sichtbar. Damit wäre unter anderem das weg, was ich in Teil 10 gerade mühsam eingerichtet habe: die AER-Zähler pro Gerät. Ich tausche keine funktionierende Diagnose gegen ein RAID, das ich nicht will.

Der dritte Wert wäre Manual, und laut Handbuch erscheint erst dann das Untermenü, in dem sich VMD pro Stack einzeln einschalten lässt. Solange Auto steht, ist dort nichts zu holen, was erklärt warum ich es beim Durchklicken nie geöffnet habe.

Kleine Korrektur in eigener Sache: in meinen Notizen stand lange, VMD stünde auf Disabled. Der Schalter heisst tatsächlich NVMe Mode Switch und kennt Manual, VMD und Auto. Die Wirkung ist dieselbe, die Beschriftung war meine.

IOAT, das Menü das nicht hält was der Name verspricht

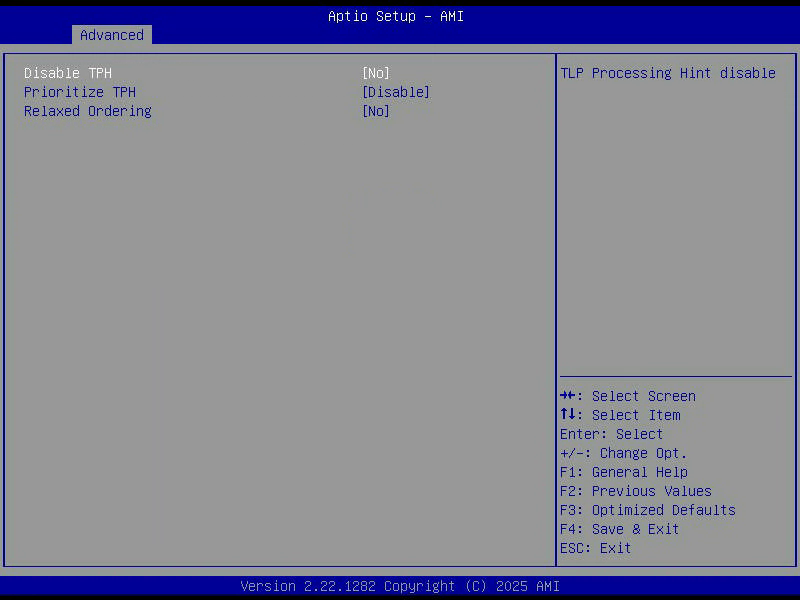
Aptio Setup, IOAT Configuration, mit Disable TPH, Prioritize TPH und Relaxed Ordering
IOAT Configuration
Disable TPH                       [No]
Prioritize TPH                    [Disable]
Relaxed Ordering                  [No]

Ich habe dieses Menü mit einer klaren Erwartung geöffnet. IOAT steht für I/O Acceleration Technology, dahinter stecken DMA-Engines im Prozessor, die Speicherkopien erledigen ohne die Kerne zu beschäftigen. Ich hatte mit Schaltern wie Enable IOAT und DCA gerechnet. Beide gibt es nicht.

Stattdessen stehen dort drei Optionen, die mit dem Namen des Menüs wenig zu tun haben. TPH ist TLP Processing Hint: ein PCIe-Gerät kann einem Schreibzugriff einen Hinweis mitgeben, wohin die Daten am besten sollen, etwa direkt in den Cache eines bestimmten Kerns statt in den Hauptspeicher. Für eine Netzwerkkarte, deren Pakete gleich darauf verarbeitet werden, spart das den Umweg.

Relaxed Ordering erlaubt es, Transaktionen in anderer Reihenfolge abzuarbeiten als sie eingetroffen sind. Das kann Durchsatz bringen und setzt voraus, dass die Beteiligten keine Annahmen über die Reihenfolge treffen. Standard ist deshalb No.

Die DMA-Engines selbst laufen übrigens, ganz ohne sichtbaren Schalter:

ls /sys/class/dma/
#   dma0chan0  dma1chan0  ...  dma7chan0

Acht Kanäle. Der Name des Menüs stimmt also, der Inhalt passt nur nicht dazu.

Das Ganze hat mir nebenbei einen Fehler in meiner eigenen Dokumentation gezeigt. In meiner ersten Aufzeichnung war ein Bildschirm mit genau diesen drei Zeilen, und ich hatte ihn als „Slot-Unterseite“ abgelegt, weil ich das Menü nicht geöffnet hatte und nur den Inhalt sah. Es war die IOAT-Seite. Ich hatte sie die ganze Zeit, nur unter dem falschen Namen.

Was ich davon tatsächlich nutze

Ehrlich? Von diesen vier Menüs nutze ich aktiv genau eines. VT-d ist an und tut seinen Dienst, die Isolation ist sauber, 102 Gruppen sprechen für sich. VMD ist aus und soll aus bleiben, IOAT läuft von selbst, und die TPH-Einstellungen fasse ich nicht an ohne eine Messung zu haben.

Trotzdem ist es eine der Seiten, die ich nach diesem Durchgang anders sehe. Vorher war „IOMMU“ für mich ein Wort aus Passthrough-Anleitungen. Jetzt weiss ich, welcher Schalter dafür verantwortlich ist, dass meine Gruppen sauber getrennt sind, und warum das auf anderen Boards oft nicht so ist.

Nächste Folge: Storage. AHCI, Hot Plug, elf SATA-Anschlüsse von denen keiner belegt ist, und eine Sicherheitsfunktion in Laufwerken, die meine beiden NVMe nicht können.

Siehe auch

Falls jemand von euch ACS-Override im Einsatz hat: aus Not oder bewusst? Und hat es je Ärger gemacht? Ihr dürft mich gerne fragen.

BIOS erklärt, Teil 10: mein Rechner hat PCIe-Fehler protokolliert, von denen ich nichts gewusst hätte

Diese Folge hat einen anderen Charakter als die bisherigen. Die vorherigen erklären, was auf einer BIOS-Seite steht. Diese hier erklärt, was auf einer BIOS-Seite fehlt, und was das für Folgen hatte.

Angefangen hat es damit, dass ich beim Durchsehen der Startmeldungen über eine Zeile gestolpert bin, die ich vorher zwar hunderte Male gesehen, aber nie gelesen hatte:

acpi PNP0A08:07: _OSC: platform does not support [SHPCHotplug AER LTR DPC]

Übersetzt: das BIOS teilt dem Betriebssystem mit, dass es vier Dinge nicht unterstützt, unter anderem AER. Und AER ist die Fehlerbehandlung für PCIe. Teil 10 der Serie, alles Übrige unter BIOS & Firmware.

Was AER macht, und warum man es haben will

PCIe ist eine serielle Verbindung mit hoher Frequenz, und wie jede solche Verbindung ist sie nicht fehlerfrei. Es gibt zwei Sorten Fehler. Korrigierbare, bei denen ein Paket neu geschickt wird und niemand etwas merkt. Und nicht korrigierbare, bei denen Daten verloren sind.

AER, Advanced Error Reporting, zählt beides mit. Das ist vor allem bei den korrigierbaren interessant, denn die sind ein Frühwarnsystem: eine Verbindung, die langsam schlechter wird, fällt nicht plötzlich aus, sondern sammelt erst über Wochen korrigierte Fehler.

Das war für mich kein akademisches Thema. Meine NVMe-Laufwerke hängen nicht direkt am Board, sondern an einem 75 Zentimeter langen Kabel, das einen SlimSAS-Anschluss auf zwei Laufwerke aufteilt. 75 Zentimeter sind für ein Gen-4-Signal eine Menge. Wenn irgendwo in dieser Maschine eine Verbindung Ärger machen würde, dann diese.

Der Zustand vorher: die Bits werden gesetzt, aber niemand liest sie

Der spannende Teil ist, dass die Hardware trotzdem mitzählt. Im Statusregister der NVMe standen Fehlerbits:

lspci -vv -s c3:00.0 | grep DevSta
#   DevSta: CorrErr+ NonFatalErr- FatalErr- UnsupReq+

Das + hinter CorrErr heisst: hier ist mindestens ein korrigierbarer Fehler aufgetreten. Gleichzeitig standen die eigentlichen AER-Zähler auf null:

cat /sys/bus/pci/devices/0000:c3:00.0/aer_dev_correctable
#   TOTAL_ERR_COR 0

Kein Widerspruch, sondern genau das Bild, das man bei abgeschalteter Fehlerbehandlung erwartet. Die Hardware setzt ihre Statusbits, weil sie das immer tut. Aber es gibt niemanden, der sie ausliest, auswertet, ins Protokoll schreibt und wieder zurücksetzt. Ein Zähler, den keiner bedient.

Praktisch hiess das: PCIe-Fehler tauchten in meinem Journal überhaupt nicht auf. Wäre das Kabel langsam gestorben, hätte ich es erst gemerkt, wenn das Laufwerk weg gewesen wäre.

Warum das BIOS nein sagt

Der Mechanismus dahinter heisst _OSC, Operating System Capabilities. Beim Start fragt das Betriebssystem die Firmware: darf ich diese Dinge übernehmen? Die Firmware antwortet. Sagt sie nein, geht der Kernel davon aus, dass die Firmware das selbst macht, und hält sich raus.

Das Modell nennt sich firmware-first und ist in echten Servern durchaus sinnvoll: die Firmware fängt Fehler ab, meldet sie über einen definierten Kanal an das Betriebssystem, und der Verwaltungscontroller bekommt sie auch mit. In einem Rack mit Fernwartung will man genau das.

Nur muss die Firmware es dann auch tatsächlich tun. Und der Kanal dafür heisst WHEA.

WHEA, und die Falle die ich fast getappt wäre

Aptio Setup, ACPI Settings, mit NUMA, UMA-Based Clustering im Hemisphere-Modus und WHEA Support auf Disabled

Unter Advanced > ACPI Settings steht:

NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]
WHEA Support                      [Disabled]
High Precision Event Timer        [Enabled]

WHEA ist der firmware-first-Kanal, und er steht auf Disabled. Damit war die Lage eindeutig: das BIOS sagt dem Betriebssystem „lass mal, ich mache das“, und macht es dann nicht.

Meine erste Reaktion war, WHEA einzuschalten. Das wäre falsch gewesen, und ich schreibe das hier auf, weil es die naheliegende und trotzdem schlechtere Lösung ist. Firmware-first bedeutet, dass Fehlerbehandlung über ACPI-Tabellen läuft, die die Firmware bereitstellen muss. Prüfen kann man das:

ls /sys/firmware/acpi/tables/ | grep -E "HEST|BERT|ERST|EINJ"
#   (keine Ausgabe)

Keine einzige davon vorhanden. Kein HEST, in dem stünde welche Fehlerquellen es überhaupt gibt. Kein BERT für Fehler aus dem letzten Absturz. Die Firmware ist für diesen Weg schlicht nicht eingerichtet.

Der bessere Weg ist die andere Richtung: dem Betriebssystem die Arbeit geben.

Ein Kernel-Parameter statt eines BIOS-Besuchs

Linux kennt dafür einen Schalter, der die _OSC-Antwort schlicht ignoriert:

GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pcie_ports=native"

Danach update-grub, neu starten, fertig. Der Unterschied ist deutlich:

# vorher
dmesg | grep -c "AER: enabled"
#   0

# nachher
dmesg | grep -c "AER: enabled"
#   7

Sieben Root Ports mit aktiver Fehlerbehandlung, darunter die beiden, um die es mir ging:

pcieport 0000:c2:04.0: AER: enabled with IRQ 130
pcieport 0000:c2:05.0: AER: enabled with IRQ 131

Wichtig für alle die das nachbauen: die _OSC-Zeile beim Booten sagt weiterhin platform does not support. Sie ändert sich nicht und wird sich nie ändern, das ist die Antwort der Firmware. Der Parameter sorgt nur dafür, dass der Kernel sie ignoriert. Wer nach dem Neustart auf diese Zeile schaut, hält die Massnahme fälschlich für wirkungslos. Das Erfolgskriterium ist AER: enabled, nicht _OSC.

Als Zugabe kam noch DPC dazu, Downstream Port Containment. Das riegelt bei einem schweren Fehler den betroffenen Anschluss ab, statt den ganzen Rechner mitzureissen. Bei einem Laufwerk an einem 75-Zentimeter-Kabel ist mir das ausgesprochen recht.

Die zwei Schalter im BIOS, die man dafür in Ruhe lassen muss

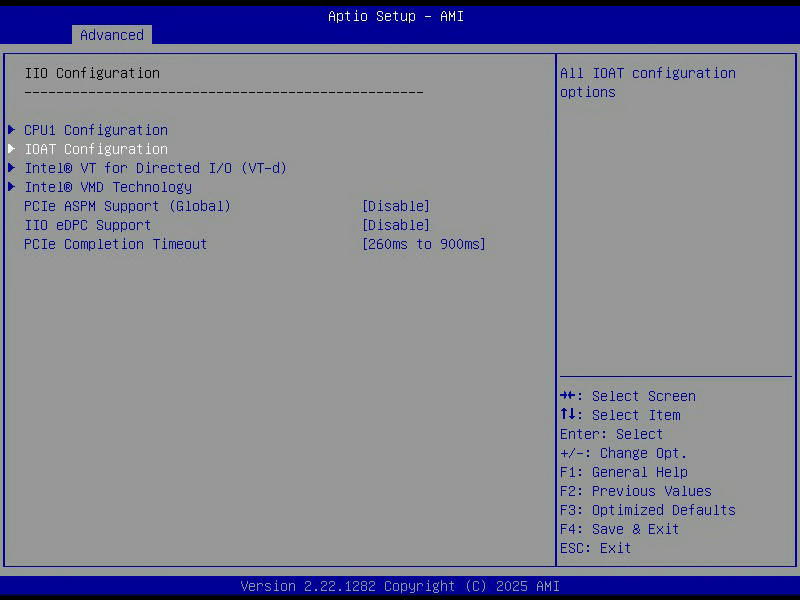
Aptio Setup, IIO Configuration, mit PCIe ASPM Support, IIO eDPC Support und PCIe Completion Timeout

Unter Advanced > Chipset Configuration > North Bridge > IIO Configuration:

> CPU1 Configuration
> IOAT Configuration
> Intel(R) VT for Directed I/O (VT-d)
> Intel(R) VMD Technology
PCIe ASPM Support (Global)        [Disable]
IIO eDPC Support                  [Disable]
PCIe Completion Timeout           [260ms to 900ms]

Einen AER-Schalter gibt es hier nicht. Ich habe danach gesucht, ihn gibt es schlicht nicht, und deshalb war der Kernel-Parameter nicht der bequemere Weg sondern der einzige.

IIO eDPC Support ist die firmware-first-Variante von DPC, also das Gegenstück zu dem, was pcie_ports=native gerade aktiviert hat. Dass es auf Disable steht, ist der Grund weshalb der Kernel DPC übernehmen konnte. Nicht einschalten, sonst reisst die Firmware die Eindämmung wieder an sich und kollidiert mit dem nativen Mechanismus.

PCIe ASPM Support (Global) [Disable] ist etwas anderes und wird gerne verwechselt. ASPM sind Stromsparzustände für die Verbindung selbst: bei wenig Verkehr werden Teile der Leitung schlafen gelegt. Das spart im Leerlauf ein paar Watt und kostet Latenz beim Aufwachen. Auf Servern ist es traditionell aus, weil es in der Vergangenheit für schwer zu findende Aussetzer gesorgt hat. Meine NVMe kann es ohnehin nicht, das steht so in ihren Fähigkeiten.

Nicht verwechseln mit dem Herunterttakten aus Teil 8: dass eine Grafikkarte im Leerlauf auf PCIe 1.0 fällt, ist Link-Geschwindigkeitsverwaltung und hat mit ASPM nichts zu tun. ASPM regelt Zustände, nicht Tempo. Die beiden Befunde „ASPM ist aus“ und „der Link taktet runter“ stehen sich nicht im Weg.

Und dann kam das, weswegen ich das alles gemacht habe

Fehlerbehandlung aktiv zu haben ist nur die halbe Miete. Die Zähler im sysfs stehen nach jedem Neustart wieder auf null. Wer alle paar Wochen hinsieht, sieht nur den Ausschnitt seit dem letzten Start.

Also habe ich noch ein Paket nachinstalliert:

apt-get install rasdaemon

Das Ding läuft als Dienst, hört auf die Fehlerereignisse des Kernels und schreibt sie mit Zeitstempel in eine kleine Datenbank. Speicherfehler, Machine Checks, und eben AER. Beim Einrichten war alles auf null, und ich hatte ehrlich gesagt damit gerechnet, dass das so bleibt.

Beim Schreiben dieser Folge habe ich noch einmal nachgesehen:

ras-mc-ctl --summary
#   No Memory errors.
#
#   PCIe AER events summary:
#           15 Corrected errors: Receiver Error
#
#   No Extlog errors.
#   No MCE errors.

Fünfzehn korrigierte Fehler. Der Speicher ist sauber, die Machine Checks sind sauber, aber auf PCIe stand etwas. Und jetzt kommt der Teil, für den sich die ganze Übung gelohnt hat, denn die Datenbank weiss auch wo und wann:

ras-mc-ctl --errors
#   1  2026-08-03 12:48:54  0000:c2:05.0  Corrected error: Receiver Error
#   ...
#   15 2026-08-03 13:04:34  0000:c2:05.0  Corrected error: Receiver Error

Alle fünfzehn am selben Tag, innerhalb von sechzehn Minuten, alle am selben Anschluss. c2:05.0 ist der zweite NVMe-Port. Und der dritte August war der Tag, an dem an genau diesem Strang gearbeitet wurde.

Damit ist es keine besorgniserregende Meldung, sondern eine erklärbare: Empfangsfehler, während sich eine Verbindung aufbaut, sind erwartbar. Seitdem, und das ist die eigentlich gute Nachricht, ist kein einziger dazugekommen.

Aber genau das ist der Punkt. Ohne den Kernel-Parameter hätte niemand diese fünfzehn Ereignisse registriert. Ohne rasdaemon wären sie beim nächsten Neustart verschwunden. Und wenn dieselben fünfzehn Einträge nicht an einem einzigen Nachmittag aufgetreten wären, sondern verteilt über drei Wochen ohne dass jemand am Gehäuse war, dann wäre das die Vorwarnung gewesen, wegen der ich das alles überhaupt eingerichtet habe.

Fazit

Von allen Änderungen, die ich an dieser Maschine gemacht habe, ist diese die unauffälligste und vermutlich die nützlichste. Sie kostet einen Kernel-Parameter, ein Paket und einen Neustart. Sie ändert im Alltag nichts. Und sie ist der Unterschied zwischen „das Laufwerk ist plötzlich weg“ und „an diesem Anschluss stimmt seit zwei Wochen etwas nicht“.

Was ich mitnehme: eine Firmware, die _OSC mit „unterstütze ich nicht“ beantwortet und gleichzeitig den eigenen Meldeweg abgeschaltet hat, hinterlässt eine Lücke, die man nur findet wenn man danach sucht. Beim Einrichten einer neuen Maschine würde ich ab jetzt immer nach dieser einen Zeile im Startprotokoll greppen.

Nächste Folge: Virtualisierung. VT-d, IOMMU-Gruppen, VMD und ein Menü namens IOAT, in dem etwas ganz anderes steht als der Name vermuten lässt.

Siehe auch

Falls jemand von euch eine steigende Zahl korrigierter PCIe-Fehler in freier Wildbahn hatte und am Ende die Ursache gefunden hat: Kabel, Riser, Steckplatz? Das würde mich sehr interessieren, ihr dürft mich jederzeit fragen.
BIOS erklärt, Teil 9: Above 4G, Resizable BAR und eine Liste von Option ROMs

Es gibt in jedem BIOS eine Seite, auf der die Dinge landen, die sonst nirgends hinpassen. Bei Supermicro heisst sie PCIe/PCI/PnP Configuration, und das PnP im Namen ist Plug and Play, ein Begriff aus den Neunzigern, der damals eher ein Versprechen als eine Beschreibung war. Ich interpretiere das einfach für mich jetzt mal so, ok?

Oben stehen Einstellungen, die für alle PCIe-Geräte gelten. Unten steht für jeden einzelnen Steckplatz eine Zeile. Beides ist interessant, aber aus unterschiedlichen Gründen. Das hier ist Teil 9, gesammelt liegt alles unter BIOS & Firmware.

Die obere Hälfte

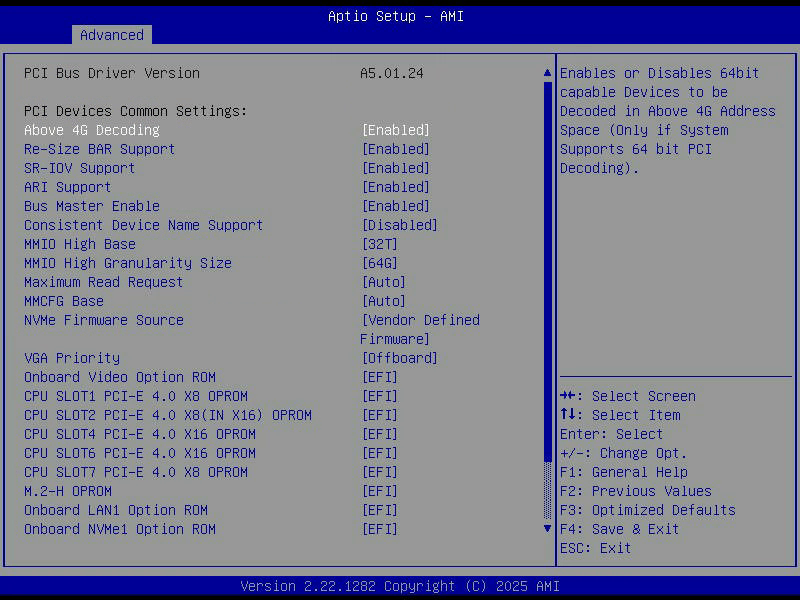
Aptio Setup, PCIe PCI PnP Configuration, mit Above 4G Decoding, Resizable BAR, SR-IOV und ARI
Above 4G Decoding                 [Enabled]
Re-Size BAR Support               [Enabled]
SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]
Bus Master Enable                 [Enabled]
Consistent Device Name Support    [Disabled]
MMIO High Base                    [32T]
MMIO High Granularity Size        [64G]
Maximum Read Request              [Auto]
MMCFG Base                        [Auto]

Alles auf Enabled, ich denke für mich genau richtig; also den Computer hier :D. Trotzdem lohnt es sich, die ersten beiden anzusehen, weil sie zusammengehören und weil sie ein handfestes Problem lösen. Mein letztes Bios hatte diese Möglichkeit nicht, weil die PCIe Version zu alt war. Ich freue mich also über diese neue Möglichkeit. Ich muss grade an Franck Ribéry „Jubel“ denken.

Das 4-GB-Problem, oder: warum 16 GB Grafikspeicher nicht sichtbar waren

Jedes PCIe-Gerät blendet seinen Speicher in den Adressraum des Rechners ein. Diese Fenster heissen BARs, Base Address Registers. Eine Grafikkarte mit 16 GB Videospeicher hätte gerne ein Fenster von 16 GB, damit die CPU auf den ganzen Speicher direkt zugreifen kann.

Das Problem: historisch lagen diese Fenster alle unterhalb der 4-GB-Grenze, weil dort in einem 32-Bit-Adressraum eben Schluss ist. Na wer erinnert sich noch an zu große DVD Images auf 32-Bit Filesystemen? Unterhalb von 4 GB liegen aber auch der Arbeitsspeicher, die Firmware und noch einiges mehr. Für die Geräte bleibt ein schmaler Streifen übrig, bei mir ist das dieser hier:

Global MMIO Low Base / Limit      90000000 / FBFFFFFF

Von 0x90000000 bis 0xFBFFFFFF, also knapp 1,7 GB für alle Karten zusammen. Da passt keine moderne Grafikkarte hinein, geschweige denn eine Grafikkarte und zwei Netzwerkkarten und zwei NVMe-Laufwerke.

Above 4G Decoding hebt diese Grenze auf. Die Fenster dürfen dann oberhalb von 4 GB liegen, und dort ist Platz ohne Ende:

Global MMIO High Base / Limit     0000200000000000 / 0000204FFFFFFFFF

Das beginnt bei 32 Terabyte und ist 320 GB gross. Genau das steht auch in der Zeile MMIO High Base [32T] weiter unten.

Ohne diesen Schalter bekommt eine 16-GB-Grafikkarte ein Notfallfenster von 256 MB und muss ihren restlichen Speicher stückweise durchreichen. Das funktioniert, kostet aber Leistung, und bei manchen Karten funktioniert es gar nicht. Wer sich fragt, warum sein Rechner mit einer neuen Grafikkarte gar nicht mehr durchbootet: hier nachsehen oder auch, wenn die Performance deutlich unter der Erwartung liegt.

Resizable BAR, der Schalter mit dem Spielerimage

Re-Size BAR Support ist der zweite Teil desselben Gedankens. Above 4G schafft den Platz, Resizable BAR erlaubt der Karte, ein entsprechend grosses Fenster tatsächlich anzufordern.

Bekannt geworden ist die Funktion vor ein paar Jahren als Gaming-Feature, weil AMD sie als „Smart Access Memory“ vermarktet hat und in einigen Spielen ein paar Prozent mehr Bilder pro Sekunde herauskamen. Der eigentliche Nutzen liegt woanders: überall dort, wo grosse Datenmengen in den Grafikspeicher wandern und die CPU dabei mitreden muss. Rechnen auf der GPU, Modelle laden, Videobearbeitung.

Bei mir ist es also erst 2026 angekommen:

lspci -vv -s 51:00.0 | grep -A2 "Resizable BAR"
#   BAR 1: current size: 16GB, supported: ... 16GB

16 GB aktuell, und 16 GB ist zugleich die grösste unterstützte Grösse. Der komplette Videospeicher ist eingeblendet, mehr geht nicht. Zwei BIOS-Schalter, die zusammen dafür sorgen, dass die Karte tut was sie soll und zwar, zumindest hier, ungebremst.

SR-IOV und ARI

SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]

SR-IOV steht für Single Root I/O Virtualization und erlaubt einer Karte, sich gegenüber dem System als mehrere Geräte auszugeben. Eine Netzwerkkarte meldet dann neben ihrer physischen Funktion noch eine Reihe virtueller, und jede davon kann einer virtuellen Maschine direkt zugewiesen werden. Die VM redet dann ohne Umweg über den Hypervisor mit der Hardware. Wichtig für VMs also.

Meine X710 kann das, ich nutze es immer mal wieder in verschiedenen Projekten. Der Schalter kostet nichts, solange niemand virtuelle Funktionen anlegt, und wenn ich es noch einmal brauche, muss ich nicht neu starten.

ARI ist die technische Voraussetzung dafür. Alternative Routing-ID Interpretation klingt kompliziert und ist eine Adressierungsfrage: klassisch hat ein PCIe-Gerät bis zu acht Funktionen. Eine Karte mit dutzenden virtuellen Funktionen sprengt das. ARI verschiebt die Bitgrenze im Adressfeld, sodass mehr Funktionen pro Bus möglich sind. Ohne ARI kein sinnvolles SR-IOV.

Bus Master Enable erlaubt Geräten, selbst Speicherzugriffe auszulösen, statt darauf zu warten dass die CPU sie abholt. Das ist DMA, und ohne DMA ist jede halbwegs moderne Karte unbrauchbar. Der Schalter existiert vermutlich nur noch aus historischen Gründen. Oder fällt euch etwas ein, warum man direkten Speicherzugriff nicht will?

Maximum Read Request [Auto] legt fest, wie viele Daten ein Gerät mit einer einzigen Anfrage holen darf. Grössere Anfragen bedeuten weniger Verwaltungsaufwand. An meiner NVMe ergibt Auto 512 Byte, was zunächst wenig aussieht. Es ist aber kein BIOS-Problem: das Laufwerk selbst gibt in seinen Fähigkeiten nur 512 Byte an. Hochdrehen würde also nichts bringen, solange die Gegenseite nicht mitspielt.

Die untere Hälfte: Option ROMs

VGA Priority                      [Offboard]
Onboard Video Option ROM          [EFI]
CPU SLOT1 PCI-E 4.0 X8 OPROM      [EFI]
CPU SLOT2 PCI-E 4.0 X8(IN X16) OPROM [EFI]
CPU SLOT4 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT6 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT7 PCI-E 4.0 X8 OPROM      [EFI]
M.2-H OPROM                       [EFI]
Onboard LAN1 Option ROM           [EFI]
Onboard NVMe1 Option ROM          [EFI]
Onboard NVMe2 Option ROM          [EFI]

Ein Option ROM ist ein Stück Firmware auf der Steckkarte selbst. Beim Start lädt das BIOS diesen Code und führt ihn aus, damit die Karte schon nutzbar ist, bevor ein Betriebssystem existiert. Klassische Beispiele: eine Netzwerkkarte, die über PXE booten soll. Ein Speichercontroller, von dem gestartet wird. Eine Grafikkarte, die ein Bild anzeigen soll. Ihr versteht schon…

Die drei Werte sind EFI, Legacy und Disabled. EFI heisst modernes UEFI-Modul, Legacy heisst 16-Bit-Code aus der BIOS-Zeit, Disabled heisst gar nicht laden.

Bei mir steht überall EFI, was zum restlichen System passt, denn Legacy-Boot ist auf diesem Board abgeschaltet. Interessant ist eher, dass man diese Liste überhaupt hat. Auf einem Desktopboard gibt es allenfalls einen Schalter für alle. Hier kann man pro Steckplatz entscheiden.

Wozu? Zwei Gründe. Erstens Startzeit: jedes Option ROM kostet Zeit, und Netzwerkkarten sind darin führend, weil sie auf Link warten. Zweitens Angriffsfläche: das ist fremder Code, der vor dem Betriebssystem mit vollen Rechten läuft. Wer die Karte nur unter Linux nutzt und nie davon bootet, verliert durch Disabled nichts.

Ich habe einen konkreten Kandidaten dafür. Meine X710 meldet auf der Driver-Health-Seite des BIOS Failed, weil ihr UEFI-Treiber älter ist als die Firmware, die ich vor einer Weile aktualisiert habe. Die Karte funktioniert unter Linux tadellos, nur der Vorstart-Code beschwert sich über sich selbst. CPU SLOT6 OPROM auf Disabled, und die Meldung wäre weg. Kostenpunkt: kein PXE-Boot über diese Karte, was ich noch nie gebraucht habe. Dazu mehr in Teil 13.

VGA Priority

VGA Priority                      [Offboard]

Dieses Board hat eine eingebaute Grafik. Sie sitzt im Verwaltungscontroller, dem ASPEED AST2600, und ihr einziger Zweck ist die Fernkonsole. Sie ist grottig, das ist Absicht, sie soll ein Terminal darstellen und sonst nichts.

VGA Priority entscheidet, welche Karte das Bild beim Start bekommt. Offboard heisst: die Steckkarte. Genau so meldet es das laufende System:

cat /sys/bus/pci/devices/0000:51:00.0/boot_vga    # 1  (RTX 4060 Ti)
cat /sys/bus/pci/devices/0000:03:00.0/boot_vga    # 0  (AST2600)

Ganz abschalten lässt sich die eingebaute Grafik nicht, und das ist auch gut so: sie hängt am Verwaltungscontroller, und wer sie loswürde, hätte auch keine Fernkonsole mehr. Genau über die habe ich diese ganze Serie aufgezeichnet. IPMI und so halt, Video aufnehmen, Bilder heraus kopieren usw….

Eine Kleinigkeit, die mir erst beim zweiten Mal aufgefallen ist

Die Liste oben endet bei Onboard NVMe2 Option ROM. In meiner ersten Aufzeichnung war das letzte, was ich hatte, Onboard NVMe1, weil ich nicht weit genug gescrollt hatte. Der Hilfetext auf derselben Seite sprach aber von NVMe2, es musste also noch etwas darunter geben.

Nächste Folge: die dritte und letzte PCIe-Folge. ASPM, eDPC und die Frage, wer eigentlich mitbekommt wenn auf einer PCIe-Verbindung Fehler auftreten. Bei mir war die Antwort eine Zeit lang: niemand.

Siehe auch

Falls jemand von euch Option ROMs gezielt abgeschaltet und dabei messbar Startzeit gespart hat: wie viel war es? Ihr dürft mich jederzeit fragen.

BIOS erklärt, Teil 8: fünf Steckplätze, 64 Bahnen und warum die Grafikkarte nur die Hälfte nutzt

Als ich diese Maschine geplant habe, stand in meinen Notizen ein Punkt, der mich mehr beschäftigt hat als alles andere: „BIOS, SlimSAS-Port auf x4x4-Bifurcation stellen, sonst wird das Laufwerk am Breakout-Kabel nicht erkannt.“ Ich hatte das irgendwo gelesen, es klang plausibel, und ich habe mich darauf eingestellt, im Setup danach suchen zu müssen.

Dann kam die Hardware, ich habe alles zusammengebaut, die Maschine ging an, das Laufwerk war da. Ich habe die Einstellung nie gefunden, weil es sie nicht gibt. Und das ist eigentlich der beste Einstieg in diese Folge, denn es zeigt genau, was man über PCIe auf einem Serverboard wissen muss: die Lanes sind fest verdrahtet, und das Setup zeigt einem nur, was daraus geworden ist.

Teil 8 der Serie, es geht um `Advanced > Chipset Configuration > North Bridge > IIO Configuration

CPU1 Configuration`. Die anderen Folgen liegen unter

BIOS & Firmware.

Die Seite

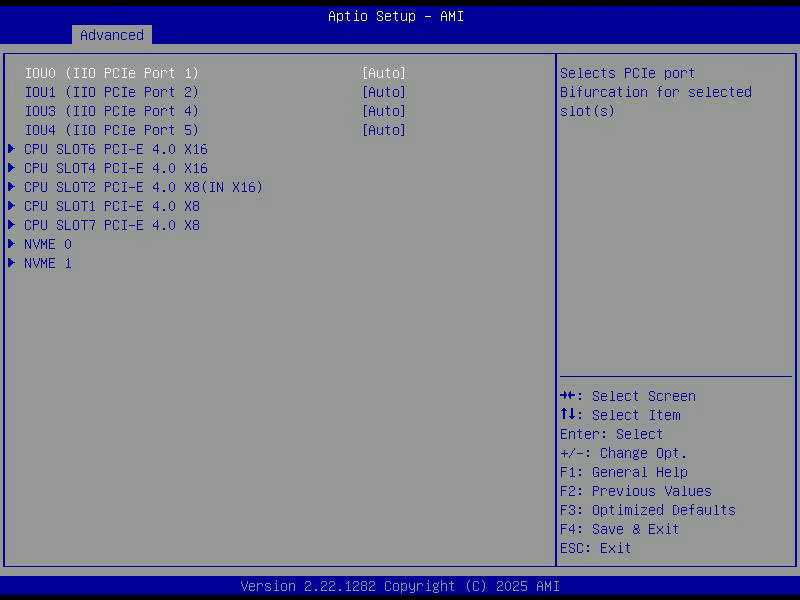
Aptio Setup, CPU1 Configuration, mit der Bifurcation der vier IOU und der Liste aller PCIe-Steckplätze
IOU0 (IIO PCIe Port 1)            [Auto]
IOU1 (IIO PCIe Port 2)            [Auto]
IOU3 (IIO PCIe Port 4)            [Auto]
IOU4 (IIO PCIe Port 5)            [Auto]
> CPU SLOT6 PCI-E 4.0 X16
> CPU SLOT4 PCI-E 4.0 X16
> CPU SLOT2 PCI-E 4.0 X8(IN X16)
> CPU SLOT1 PCI-E 4.0 X8
> CPU SLOT7 PCI-E 4.0 X8
> NVME 0
> NVME 1

Oben vier Einstellungen, unten sieben Untermenüs. Die vier oben sind die eigentliche Verteilung, die sieben unten sind das Ergebnis.

Mein Xeon Gold 5315Y stellt 64 PCIe-Bahnen der Generation 4 bereit. Diese 64 Bahnen sind im Prozessor in Blöcken organisiert, den IOUs, und jeder Block liefert 16 Bahnen. Vier Blöcke, 64 Bahnen. Was das Board daraus macht, ist Sache des Boardlayouts: hier sind es zwei Steckplätze mit sechzehn Bahnen, drei mit acht, und zwei Anschlüsse für NVMe-Laufwerke mit je vier.

Bifurcation, und warum sie mir keine Sorgen mehr macht

Bifurcation heisst wörtlich Gabelung, und gemeint ist das Aufteilen eines Blocks. Ein IOU mit sechzehn Bahnen kann als ein einziger x16-Anschluss auftreten oder als zwei x8 oder als vier x4. Das muss die Firmware wissen, bevor sie die Geräte aufzählt, denn danach ist die Aufteilung festgelegt.

Der klassische Anwendungsfall sind Adapterkarten, die vier NVMe-Laufwerke in einen einzigen x16-Steckplatz stecken. Ohne x4x4x4x4-Bifurcation sieht das Board nur das erste Laufwerk, oder gar keins. Genau davor hatte ich Respekt.

Auf diesem Board stehen alle vier Blöcke auf Auto, und das ist auch richtig so. Auto heisst, dass die Firmware beim Start selbst herausfindet, was steckt, und entsprechend aufteilt. Von Hand einstellen muss man nur, wenn eine Karte sich nicht korrekt meldet, was bei billigen passiven Adaptern vorkommt.

Und meine NVMe-Anschlüsse? Die sind gar nicht Teil dieser Aufteilung. NVME 0 und NVME 1 sind eigenständige Anschlüsse mit je vier fest zugeordneten Bahnen. Da ist nichts zu gabeln, weil da nichts zusammenhängt. Meine ursprüngliche Sorge war schlicht unbegründet, und ich lasse das hier so stehen, weil ich vermute, dass ich damit nicht der einzige bin.

Was in einem Slot-Untermenü steht

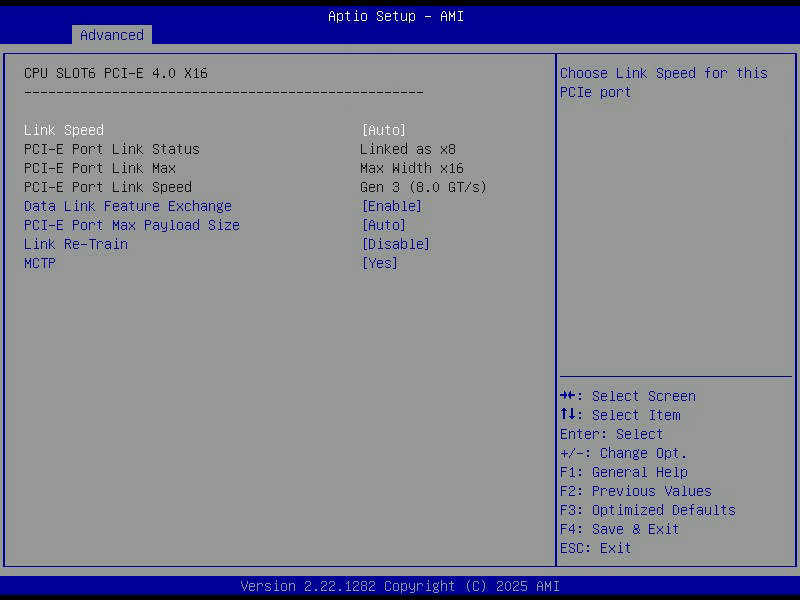
Jeder der sieben Einträge öffnet dieselbe Maske:

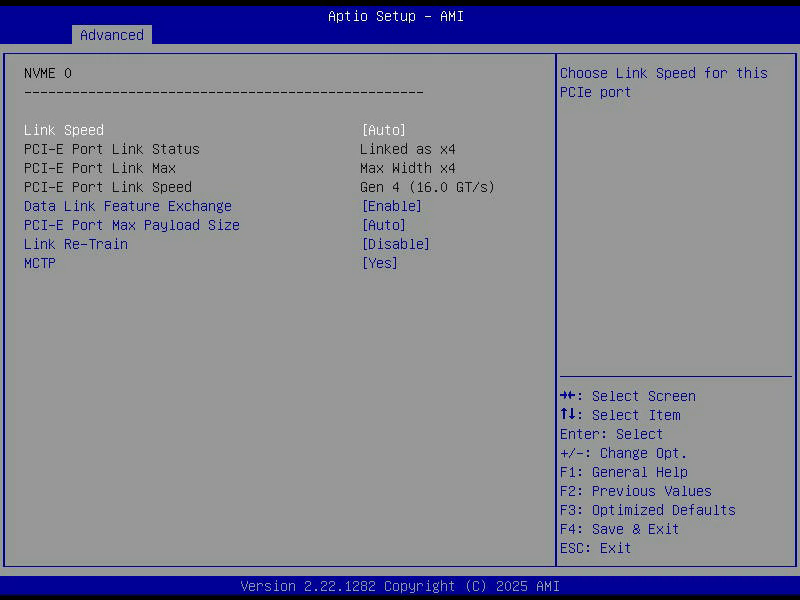
Link Speed                        [Auto]
PCI-E Port Link Status            Linked as x8
PCI-E Port Link Max                Max Width x16
PCI-E Port Link Speed              Gen 4 (16.0 GT/s)
Data Link Feature Exchange        [Enable]
PCI-E Port Max Payload Size       [Auto]
Link Re-Train                     [Disable]
MCTP                              [Yes]

Die drei mittleren Zeilen sind reine Anzeige und die interessantesten der ganzen Folge. Link Max ist, was der Steckplatz elektrisch könnte. Link Status ist, worauf sich Board und Karte tatsächlich geeinigt haben. Weichen die beiden voneinander ab, gibt es dafür immer einen Grund, und der ist nicht immer ein Problem.

MCTP steht für Management Component Transport Protocol. Darüber kann der Verwaltungscontroller des Boards mit Karten reden, die das unterstützen, etwa um Temperaturen oder Firmwarestände abzufragen, ohne dass das Betriebssystem beteiligt ist. Auf einem Serverboard eine Selbstverständlichkeit, auf einem Desktopboard undenkbar.

Link Re-Train erzwingt eine neue Aushandlung der Verbindung. Das ist ein Diagnosewerkzeug für den Fall, dass ein Link mit weniger Bahnen oder niedrigerer Geschwindigkeit hochkommt als er sollte.

Die Belegung meiner Maschine

Aptio Setup, Untermenü CPU SLOT6, die Netzwerkkarte mit Linked as x8

Alle sieben Untermenüs durchgeklickt ergibt folgendes Bild:

CPU SLOT4  x16    Linked as x8            Gen 4     RTX 4060 Ti
CPU SLOT6  x16    Linked as x8            Gen 3     Intel X710, 2x 10G SFP+
CPU SLOT2  x8     Link Did Not Train      -         leer
CPU SLOT1  x8     Link Did Not Train      -         leer
CPU SLOT7  x8     Link Did Not Train      -         leer
NVME 0     x4     Linked as x4            Gen 4     Samsung PM1735
NVME 1     x4     Linked as x4            Gen 4     Samsung PM1735

Link Did Not Train klingt nach Fehler und heisst nur: da steckt nichts. Ein PCIe-Link handelt sich beim Start aus, und wenn am anderen Ende niemand antwortet, kommt eben keine Verbindung zustande.

Warum die Grafikkarte nur acht Bahnen bekommt

Das ist die Zeile, an der ich zuerst hängen geblieben bin. Die RTX 4060 Ti steckt in einem Steckplatz mit sechzehn Bahnen, das Board kann sechzehn, und trotzdem sagt das Setup Linked as x8.

Die Erklärung ist unspektakulär und liegt nicht am Board: der AD106-Chip auf dieser Karte hat physisch nur acht Bahnen. Nvidia hat das bei der 4060er Generation so entworfen und dafür einiges an Kritik eingesteckt, vor allem weil die Karte in älteren Rechnern mit PCIe 3.0 dann nur noch auf der Hälfte der Hälfte läuft. Bei mir ist es Gen 4 mit acht Bahnen, das entspricht Gen 3 mit sechzehn, und damit ist die Karte nicht ausgebremst.

Ein anderer Steckplatz würde daran nichts ändern. Das Limit sitzt auf der Karte.

Die X710 daneben ist der umgekehrte Fall: Gen 3 statt Gen 4, ebenfalls acht Bahnen. Auch das ist die Karte, sie ist schlicht älter. Acht Gen-3-Bahnen sind rund 8 GB pro Sekunde, für zwei 10-Gbit-Ports vollkommen ausreichend. Verschwendet ist nur, dass sie in einem Steckplatz sitzt der mehr könnte.

Der Fehler den ich fast gemacht hätte

Und jetzt der Teil, den ich für den nützlichsten dieser Folge halte. Als ich nach dem Zusammenbau im laufenden System nachgesehen habe, ob die Grafikkarte richtig angebunden ist, stand da das:

lspci -vv -s 51:00.0 | grep LnkSta
#   LnkSta: Speed 2.5GT/s (downgraded), Width x8 (downgraded)

2.5GT/s ist PCIe 1.0. Auf einer Gen-4-Karte in einem Gen-4-Steckplatz. Zweimal downgraded. Ich war kurz davor, das Kabel, den Slot und meine Lebensentscheidungen zu hinterfragen.

Es ist völlig normal. Moderne Grafikkarten takten ihren PCIe-Link im Leerlauf herunter, genau wie sie ihren Chiptakt herunterfahren. Wer im Leerlauf misst, misst den Leerlauf. Mit ein bisschen Last sieht es anders aus:

# waehrend eine Videokodierung laeuft
nvidia-smi --query-gpu=pcie.link.gen.current,pcie.link.width.current --format=csv
#   4, 8

Gen 4, acht Bahnen. Genau das, was das BIOS anzeigt.

Der Merksatz daraus, und der gilt für jede Grafikkarte: PCIe-Linkbreite und -geschwindigkeit niemals im Leerlauf beurteilen. Ein statisches lspci an einer Nvidia-Karte sagt praktisch nichts. Man braucht Last während der Messung, sonst jagt man einem Phantom hinterher.

Bei der NVMe ist das übrigens anders, die steht dauerhaft auf 16GT/s, Width x4. Solche Laufwerke drosseln ihren Link nicht in dieser Form.

Vier Bahnen für die NVMe, und warum das Absicht war

Aptio Setup, Untermenü NVME 0, das Laufwerk meldet Linked as x4 mit PCIe der vierten Generation
NVME 0
PCI-E Port Link Status            Linked as x4
PCI-E Port Link Max               Max Width x4
PCI-E Port Link Speed             Gen 4 (16.0 GT/s)

Die Samsung PM1735 ist eigentlich ein x8-Laufwerk. Sie hängt bei mir an einem Kabel, das einen SlimSAS-Anschluss mit acht Bahnen auf zwei Anschlüsse mit je vier aufteilt. Damit laufen zwei Laufwerke statt einem, jedes mit der Hälfte der Anbindung.

Das war eine bewusste Entscheidung beim Kauf, und mit etwas Abstand war es die richtige. Vier Gen-4-Bahnen sind theoretisch knapp 8 GB pro Sekunde. Gemessen habe ich mit vier parallelen Lesevorgängen 4,6 GB pro Sekunde, und das ist noch nicht die Obergrenze, weil das Werkzeug das ich benutzt habe immer nur eine Anfrage gleichzeitig offen hat.

Wie ich das Gefühl habe, dass die zweite Hälfte des Kabels sinnvoller investiert war als die zweiten vier Bahnen: inzwischen hängt dort ein zweites Laufwerk. Der Anschluss NVME 1, der bei meiner ersten Aufnahme noch Link Did Not Train meldete, zeigt jetzt ebenfalls Linked as x4. Und wieder war dafür im BIOS nichts einzustellen.

Fazit

PCIe-Verteilung auf einem Serverboard ist unspektakulärer als ihr Ruf. Die Lanes liegen fest, die Firmware zählt auf, das Setup zeigt das Ergebnis. Die drei Anzeigezeilen in den Slot-Untermenüs sind ein besseres Diagnosewerkzeug als alles, was man im laufenden System zusammensucht, weil sie den Zustand vor dem Betriebssystem zeigen und ohne Stromsparzustände.

Nächste Folge: die andere PCIe-Seite. Above 4G Decoding, Resizable BAR, SR-IOV, und die lange Liste der Option ROMs.

Siehe auch

Falls jemand von euch bei Link Did Not Train schon mal eine echte Ursache gefunden hat und nicht nur einen leeren Steckplatz, erzähl mir davon. Ihr dürft mich gerne fragen.

BIOS erklärt, Teil 7: NUMA auf einer Maschine mit einem Sockel, und was Uncore eigentlich ist

Auf meiner alten Maschine standen zwei Prozessoren. Das klingt erst einmal nach doppelt so gut, und in Wahrheit war es vor allem doppelt so kompliziert. Ich habe damals ziemlich viel Zeit damit verbracht, einem Spiel beizubringen, dass es bitte auf der Hälfte der CPU laufen soll, und zwar auf derjenigen, an der auch die Grafikkarte hängt, weil der Weg zur anderen Hälfte zu lang war. Das Werkzeug dafür heisst NUMA, und wer einmal damit zu tun hatte, vergisst es nicht mehr.

Die neue Maschine hat einen Sockel. Damit ist das Thema erledigt, dachte ich. Ist es nicht ganz, und diese Folge erklärt warum. Es geht um Advanced > Chipset Configuration > North Bridge > Uncore Configuration und um zwei Zeilen aus den ACPI-Einstellungen. Alle Folgen dieser Serie stehen unter BIOS & Firmware.

Was Uncore überhaupt ist

Der Begriff kommt von Intel und meint alles auf dem Prozessorchip, was kein Rechenkern ist. Der gemeinsame L3-Cache. Die Speichercontroller. Die PCIe-Root-Ports. Das Verbindungsnetz, das all das miteinander verbindet. Bei einem modernen Xeon ist der Uncore flächenmässig ein erheblicher Teil des Chips und verbraucht auch einen erheblichen Teil des Stroms.

Der Uncore hat einen eigenen Takt, unabhängig von den Kernen. Er läuft weiter, wenn alle Kerne schlafen, denn irgendjemand muss ja mitbekommen, wenn eine Netzwerkkarte etwas will. Wenn man in Datenblättern liest, dass ein Serverprozessor im Leerlauf noch 40 Watt zieht, obwohl er angeblich nichts tut, ist das zum guten Teil der Uncore.

Die Kopfzeilen sagen mehr als der Rest

Aptio Setup, Uncore Configuration, mit Anzahl der Prozessoren, UPI-Status und den MMIO-Adressbereichen
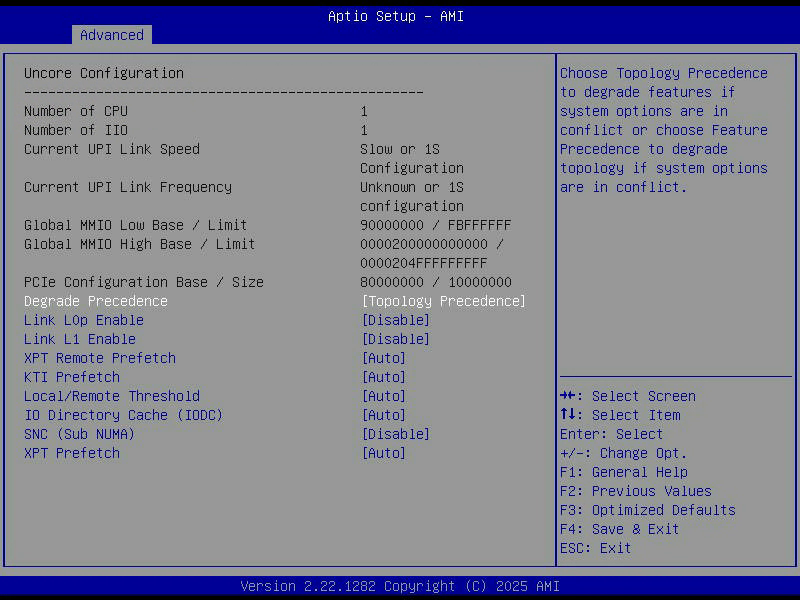
Number of CPU                     1
Number of IIO                     1
Current UPI Link Speed            Slow or 1S Configuration
Current UPI Link Frequency        Unknown or 1S configuration

Diese vier Zeilen finde ich fast rührend. UPI ist Ultra Path Interconnect, Intels Verbindung zwischen zwei Prozessoren in einem System. Über sie laufen Speicherzugriffe auf den Speicher des jeweils anderen und die gesamte Cache-Kohärenz, also die Buchhaltung darüber, wer gerade welche Speicherzeile in seinem Cache liegen hat.

Bei mir steckt genau eine CPU im Board. Also gibt es niemanden, mit dem geredet werden müsste, und das Setup sagt das auf seine eigene Art: 1S Configuration, Single Socket. Die Firmware weiss es, das Menü existiert trotzdem, weil dasselbe BIOS auch auf Zwei-Sockel-Boards läuft.

Number of IIO ist die Zahl der Integrated IO Hubs, also der Einheiten, die die PCIe-Lanes bereitstellen. Bei einem Sockel logischerweise eins.

Interessanter sind die Adressbereiche darunter:

Global MMIO Low Base / Limit      90000000 / FBFFFFFF
Global MMIO High Base / Limit     0000200000000000 / 0000204FFFFFFFFF
PCIe Configuration Base / Size    80000000 / 10000000

Das ist die Speicherlandkarte für alles, was nicht RAM ist. Der untere Bereich liegt unterhalb von 4 GB, ist entsprechend eng und wird knapp, sobald mehrere Karten mit grossen Speicherfenstern stecken. Der obere beginnt bei 0x200000000000, also bei 32 Terabyte, und ist der Grund, warum meine Grafikkarte ihre kompletten 16 GB Videospeicher einblenden kann. Dazu mehr in der Folge über Above 4G Decoding und Resizable BAR.

NUMA, obwohl es nichts zu verteilen gibt

Aptio Setup, ACPI Settings, mit NUMA, UMA-Based Clustering im Hemisphere-Modus und WHEA Support auf Disabled

Zwei Menüs weiter, unter Advanced > ACPI Settings:

NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]

NUMA steht für Non-Uniform Memory Access und beschreibt den Umstand, dass nicht jeder Speicherzugriff gleich lange dauert. Bei zwei Sockeln ist das offensichtlich: der eigene Speicher ist nah, der des Nachbarn geht über UPI und kostet spürbar mehr Zeit. Das Betriebssystem muss davon wissen, sonst legt es Daten und die Prozesse die damit arbeiten in verschiedene Ecken der Maschine.

Bei einem Sockel gibt es diese Unterscheidung nicht, und mein System meldet folgerichtig:

lscpu | grep NUMA
#   NUMA-Knoten:            1
#   NUMA-Knoten0 CPU(s):    0-15

Ein Knoten, alle sechzehn logischen Prozessoren darin. Warum steht der Schalter dann auf Enabled? Weil er nicht nur Knoten erzeugt, sondern die ACPI-Tabellen füllt, in denen die Topologie beschrieben wird. Die stehen bei mir vollständig zur Verfügung:

ls /sys/firmware/acpi/tables/ | grep -E "SRAT|SLIT|HMAT"
#   HMAT  SLIT  SRAT

SRAT ordnet Prozessoren und Speicherbereiche einander zu, SLIT beschreibt die Entfernungen zwischen den Knoten, HMAT geht noch weiter und beschreibt Bandbreiten und Latenzen. Bei einem Knoten ist der Inhalt langweilig, aber vorhanden. Auf Disabled würde das Betriebssystem schlicht weniger über die Maschine wissen, ohne dafür irgendetwas zu gewinnen.

Der Schalter mit dem sperrigen Namen

UMA-Based Clustering [Hemisphere (2-clusters)] ist die Zeile, an der ich beim ersten Lesen hängen geblieben bin. Um sie zu verstehen, muss man wissen, wie so ein Chip innen aussieht.

Bei Ice Lake sitzen Kerne, Cache-Scheiben und Speichercontroller in einem Gitter, dem Mesh. Jeder Zugriff wandert durch dieses Gitter. Meine CPU hat vier Speichercontroller mit je zwei Kanälen, macht acht, und das ist genau die Zahl meiner Speichermodule. Je nachdem wo im Gitter ein Kern sitzt, ist der eine Controller näher als der andere.

Hemisphere teilt den Chip in zwei Bereiche und sorgt über eine Hash-Funktion dafür, dass eine Speicheradresse der Cache-Scheibe zugeordnet wird, die auf derselben Seite des Chips liegt wie der zuständige Speichercontroller. Der Weg durchs Gitter wird kürzer. Nach aussen bleibt es ein einziger Speicherbereich, das Betriebssystem merkt nichts davon. Die Variante Quadrant macht dasselbe mit vier Bereichen.

Passend dazu steht im Uncore-Menü:

SNC (Sub NUMA)                    [Disable]

Sub-NUMA-Clustering ist die radikale Variante derselben Idee. Es meldet dem Betriebssystem tatsächlich mehrere NUMA-Knoten, obwohl nur eine CPU steckt, und überlässt ihm die Verteilung. Für eine Datenbank, die weiss was sie tut, kann das etwas bringen. Für einen Desktop bringt es Ärger, weil plötzlich wieder Prozesse und ihr Speicher auseinanderlaufen können.

Ich habe mit genau diesem Problem auf der alten Maschine genug Abende verbracht. Das lasse ich aus, und zwar mit Nachdruck.

Die Prefetcher zwischen den Sockeln

Aptio Setup, Uncore Configuration weiter unten, mit XPT Prefetch, KTI Prefetch und Sub-NUMA-Clustering
XPT Prefetch                      [Auto]
XPT Remote Prefetch               [Auto]
KTI Prefetch                      [Auto]
Stale AtoS                        [Auto]
LLC Dead Line Alloc               [Enable]
IO Directory Cache (IODC)         [Auto]
Snoop Throttle Configuration      [Auto]
Local/Remote Threshold            [Auto]

In Teil 3 ging es um fünf Prefetcher, die raten welche Daten ein Kern als nächstes braucht. Das hier ist dieselbe Idee eine Ebene höher: raten, welchen Weg eine Anfrage nehmen wird, und sie schon mal losschicken.

XPT Prefetch schickt eine Speicheranfrage parallel zur Cache-Abfrage direkt an den Speichercontroller. Stellt sich heraus, dass die Daten doch im Cache lagen, war es umsonst. Stellt sich heraus, dass sie es nicht taten, hat man die Cache-Suche geschenkt bekommen. KTI Prefetch macht dasselbe über die Sockelverbindung hinweg, XPT Remote Prefetch ebenfalls, und beide sind bei einem Sockel gegenstandslos.

LLC Dead Line Alloc ist die einzige Zeile hier, die nicht auf Auto steht. Dahinter steckt eine Aufräumfrage: wenn eine Zeile aus dem L2 verdrängt wird, soll sie dann in den gemeinsamen L3 wandern, obwohl sie vermutlich tot ist, also nie wieder gebraucht wird? Enable heisst hier ja, und für allgemeine Lasten ist das die richtige Wette.

Snoop Throttle bremst die Kohärenzabfragen, wenn das Gitter überlastet ist. IO Directory Cache merkt sich, welche Cache-Zeilen von PCIe-Geräten angefasst wurden, damit nicht bei jedem DMA-Zugriff alle Kerne gefragt werden müssen.

Bei all diesen Zeilen gilt dasselbe: Auto bedeutet, dass Intel für die erkannte Konfiguration sinnvolle Werte hinterlegt hat. Wer hier von Hand dreht, sollte einen Messaufbau haben und eine konkrete Vermutung. Ich habe beides nicht, und ich glaube nicht, dass ich mit Raten schlauer bin als die Leute die den Chip entworfen haben.

Zwei Zeilen die ich fast überlesen hätte

Link L0p Enable                   [Disable]
Link L1 Enable                    [Disable]

Das sind Stromsparzustände für die UPI-Verbindung. L0p schaltet einen Teil der Leitungen ab, L1 die ganze Verbindung. Beide kosten Zeit beim Aufwachen, und beide sind hier ohne Wirkung, weil es keine UPI-Verbindung gibt.

Ich erwähne sie trotzdem, weil sie ein schönes Beispiel für etwas sind, das durch die ganze Serie zieht: ein Server-BIOS zeigt einem alles, was das Board könnte, nicht das was die konkrete Maschine hat. Wer hier ohne diese Einordnung durchgeht, stellt Dinge ein, die schlicht niemanden interessieren.

Fazit

Die Uncore-Seite ist die Seite, an der ich am wenigsten geändert habe und am meisten gelernt. Zwanzig Einstellungen, davon stehen sechzehn auf Auto, und das ist auch gut so. Was bleibt, ist ein ziemlich direkter Blick darauf, wie so ein Chip innen organisiert ist: ein Gitter, Speichercontroller an verschiedenen Stellen, Cache dazwischen, und eine Menge Mechanik die versucht, Wege abzukürzen.

Nächste Folge: PCIe. Slots, Lanes, was Bifurcation ist, und warum eine Grafikkarte in einem x16-Steckplatz trotzdem nur acht Bahnen nutzt.

Siehe auch

Falls jemand von euch SNC auf einem Ein-Sockel-Xeon eingeschaltet und dabei etwas Messbares gewonnen hat, würde ich das gerne lesen. Ihr dürft mich jederzeit fragen.

BIOS erklärt, Teil 6: 256 GB ECC, ein Scrubber der jeden Tag putzt und ein Reparaturmechanismus im Speicherriegel

In dieser Folge geht es um Advanced > Chipset Configuration > North Bridge > Memory Configuration. Wer die Serie bis hierhin nicht mitgelesen hat: alle Teile liegen unter BIOS & Firmware, und es lohnt sich nicht, sie in der Reihenfolge zu lesen. Jede Folge steht für sich.

Was verbaut ist

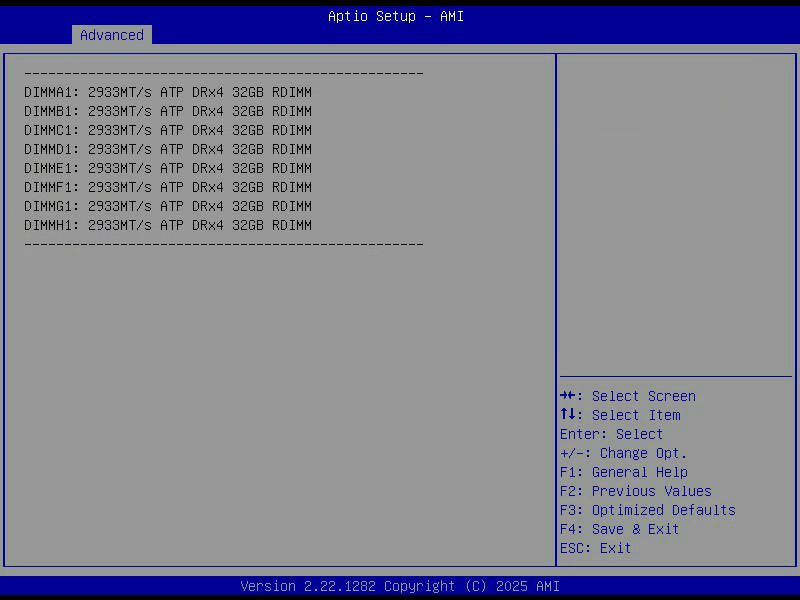
Aptio Setup, Memory Topology, alle acht Module mit 2933 Megatransfers und 32 Gigabyte als Registered DIMM
DIMMA1: 2933MT/s ATP DRx4 32GB RDIMM
DIMMB1: 2933MT/s ATP DRx4 32GB RDIMM
DIMMC1: 2933MT/s ATP DRx4 32GB RDIMM
DIMMD1: 2933MT/s ATP DRx4 32GB RDIMM
DIMME1: 2933MT/s ATP DRx4 32GB RDIMM
DIMMF1: 2933MT/s ATP DRx4 32GB RDIMM
DIMMG1: 2933MT/s ATP DRx4 32GB RDIMM
DIMMH1: 2933MT/s ATP DRx4 32GB RDIMM

Acht Steckplätze, acht Module, jedes 32 GB. Das ist die Seite Memory Topology, und sie sagt in acht Zeilen mehr über den Aufbau der Maschine als jedes Datenblatt.

RDIMM heisst Registered DIMM. Zwischen dem Speichercontroller und den eigentlichen Speicherchips sitzt ein Registerbaustein, der Adress- und Steuersignale zwischenspeichert und neu ausgibt. Der Grund ist elektrisch: je mehr Chips an einem Kanal hängen, desto stärker belastet das die Signalleitungen. Der Registerbaustein bricht diese Last auf. Deshalb gibt es in Servern acht Module pro Sockel und in Desktops vier, und deshalb kann man normale Desktop-Riegel hier nicht einsetzen. Der Preis ist ein Takt Latenz zusätzlich.

DRx4 beschreibt den Aufbau: Dual Rank, jeder Chip liefert 4 Bit. Zwei Ranks bedeutet, dass auf dem Modul zwei unabhängige Gruppen von Chips sitzen, zwischen denen der Controller umschalten kann. Während eine Gruppe noch mit einer Anfrage beschäftigt ist, kann er die andere schon ansprechen, was den Durchsatz verbessert.

Und 2933MT/s, obwohl auf den Modulen 3200 steht. Das ist keine Fehlfunktion, sondern die CPU. Der Xeon Gold 5315Y ist die Einstiegsvariante der Ice-Lake-Serie, und Intel hat den Speichertakt an die Prozessorstufe gekoppelt. Die teureren Modelle fahren 3200, meiner eben 2933. Die Riegel könnten mehr, sie dürfen nicht. Genau so meldet es auch das Betriebssystem:

dmidecode -t memory | grep -E "Speed|Configured"
#   Speed: 3200 MT/s
#   Configured Memory Speed: 2933 MT/s

Was das Modul kann, und was es tatsächlich tut. Der Unterschied sind rund acht Prozent Speicherbandbreite, die ich nicht bekomme. Verschmerzbar.

ECC, der Teil den alle kennen

Erstaunlicherweise gibt es auf dieser Seite gar keinen Schalter namens ECC. Bei registrierten Servermodulen ist Fehlerkorrektur keine Option, sondern eine Eigenschaft der Hardware. Sie ist da, sie ist an, fertig.

Falls es jemand nicht parat hat: ECC speichert zu je 64 Bit Nutzdaten 8 zusätzliche Prüfbits. Damit lässt sich ein gekipptes Bit erkennen und reparieren, und zwei gekippte Bits lassen sich zumindest erkennen. Das ist der Unterschied zwischen „im Log steht eine korrigierte Zeile“ und „irgendwo in einer Datei steht jetzt ein falsches Byte, viel Spass beim Suchen“.

Bits kippen häufiger als man denkt. Kosmische Strahlung, Alphateilchen aus dem Gehäusematerial, schlicht Alterung. Bei 256 GB, die dauerhaft laufen, ist das keine theoretische Grösse mehr.

Patrol Scrub, und die Zahl aus dem Handbuch

Patrol Scrub                      [Enable at End of POST]

Das ist mein Lieblingsschalter auf dieser Seite. ECC korrigiert nämlich nur dann, wenn jemand die betroffene Speicherstelle liest. Ein Bit in einem Speicherbereich, den seit drei Wochen niemand angefasst hat, kippt unbemerkt. Kippt in derselben Zeile ein zweites, ist der Fehler nicht mehr korrigierbar.

Patrol Scrub geht deshalb im Hintergrund den gesamten Speicher durch, liest jede Zeile, lässt ECC prüfen und schreibt sie korrigiert zurück. Vorbeugendes Putzen, damit sich Einzelfehler nicht zu Doppelfehlern summieren.

Das Handbuch nennt dazu eine Zahl, die man sonst nirgends findet:

the IO hub reads and writes back one cache line every 16K cycles … roughly 64 GB of memory behind the IO hub is scrubbed every day

Eine Cache-Zeile alle 16.000 Takte, macht etwa 64 GB pro Tag. Bei meinen 256 GB dauert ein kompletter Durchlauf also rund vier Tage. Das klingt langsam, ist aber genau der Punkt: der Scrubber soll im Hintergrund verschwinden und nicht die Speicherbandbreite auffressen, die eigentlich für Arbeit gedacht ist.

Enable at End of POST heisst, dass er nach dem Selbsttest startet, also bevor das Betriebssystem läuft, und dann durchgehend weiterarbeitet.

PPR: der Reparaturmechanismus im Riegel

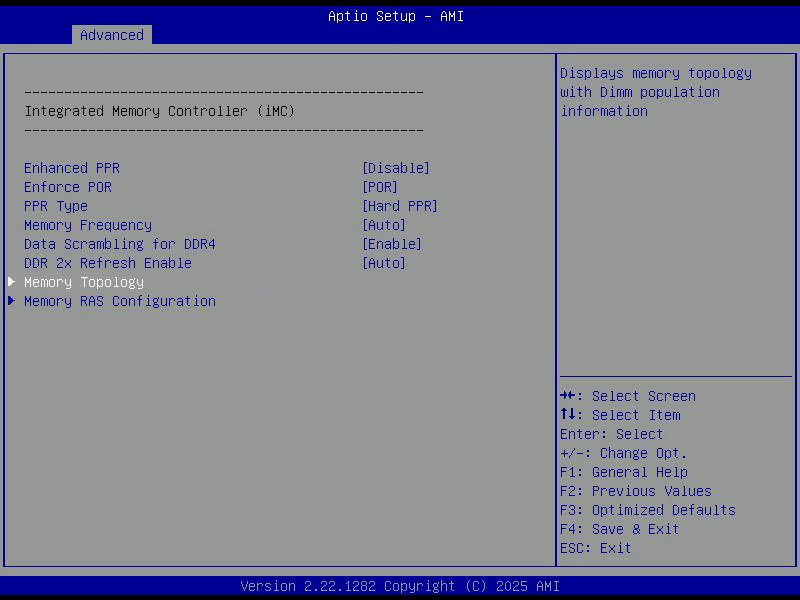
Aptio Setup, Memory Configuration, mit Enhanced PPR, PPR Type, Speichertakt und den Untermenüs für Topologie und RAS
Enhanced PPR                      [Disable]
PPR Type                          [Hard PPR]
Enforce POR                       [POR]

PPR steht für Post Package Repair, und dahinter steckt etwas, das mich beim Nachlesen ehrlich überrascht hat: moderne DDR4-Module haben Ersatzzeilen eingebaut. Fällt eine Speicherzeile dauerhaft aus, kann die Firmware sie stilllegen und eine Reservezeile an ihre Stelle setzen. Der Riegel repariert sich also selbst, im laufenden Betrieb einer Maschine, ohne dass ihn jemand anfasst.

Hard PPR bedeutet, dass diese Umleitung dauerhaft in den Riegel gebrannt wird und einen Neustart übersteht. Die Alternative Soft PPR gilt nur bis zum nächsten Ausschalten. Hart ist sinnvoller, kostet aber eine der wenigen Reservezeilen unwiderruflich.

Enforce POR steht für Plan of Record und ist die Frage, ob das Board die von Intel freigegebenen Speicherparameter erzwingt oder ob es auch aggressivere Kombinationen zulässt. Auf einem Serverboard mit 256 GB ECC ist die Antwort selbstverständlich ja.

Data Scrambling for DDR4 [Enable] weiter unten macht etwas ganz anderes, als der Name vermuten lässt. Das ist keine Verschlüsselung. Die Daten werden vor dem Schreiben mit einem Pseudozufallsmuster verwürfelt, damit auf den Datenleitungen keine langen Folgen identischer Bits entstehen. Solche Muster erzeugen Störungen auf den Nachbarleitungen und einen unruhigen Stromverbrauch. Verwürfeln macht das Signalbild gleichmässiger. Wer glaubt, sein Speicher sei damit verschlüsselt, irrt sich, dafür wäre TME zuständig, und über den habe ich in Teil 4 geschrieben.

Memory RAS: das Menü das kleiner ist als erwartet

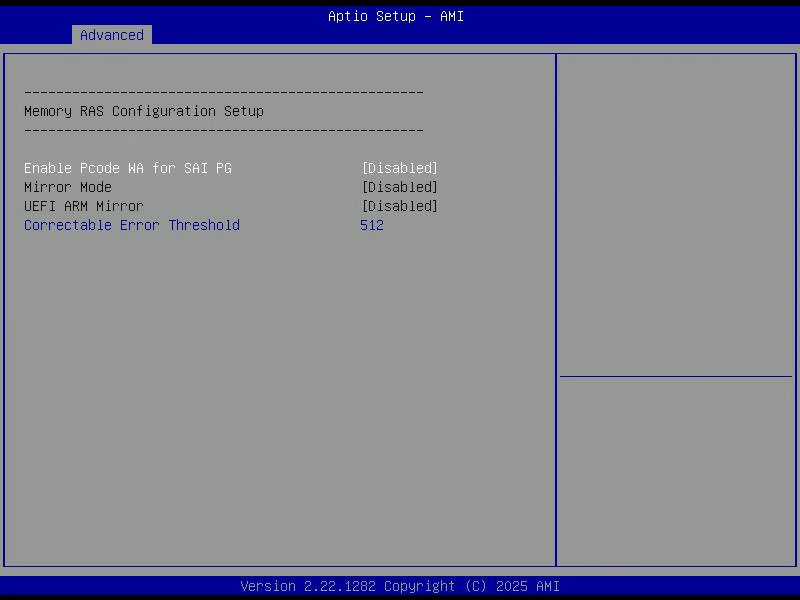
Aptio Setup, Memory RAS Configuration, mit Mirror Mode auf Disabled und der Schwelle für korrigierbare Fehler
Memory RAS Configuration Setup
Enable Pcode WA for SAI PG        [Disabled]
Mirror Mode                       [Disabled]
UEFI ARM Mirror                   [Disabled]
Correctable Error Threshold       512

RAS steht für Reliability, Availability, Serviceability, und ich hatte hier ehrlich gesagt mehr erwartet. In Intel-Dokumentation tauchen an dieser Stelle regelmässig Rank Sparing, ADDDC Sparing und PCLS auf. Auf diesem Board gibt es davon nichts, die Seite hat genau diese vier Zeilen und keinen Rollbalken.

Mirror Mode ist die interessanteste Option, gerade weil sie aus ist. Speicherspiegelung schreibt jeden Wert doppelt, auf zwei verschiedene Kanäle. Fällt eine Stelle dauerhaft aus, übernimmt die Kopie, ohne dass die Maschine stehenbleibt. Der Preis ist die Hälfte des Speichers: aus 256 GB würden 128.

Für einen Datenbankserver, bei dem eine Stunde Ausfall Geld kostet, kann das die richtige Rechnung sein. Für meine Workstation nicht. ECC fängt Einzelfehler ohnehin ab, Patrol Scrub verhindert dass sie sich anhäufen, und wenn wirklich ein Modul stirbt, tausche ich es. 128 GB zu verschenken, um mir einen Neustart zu ersparen, ist mir zu teuer.

Correctable Error Threshold 512 ist die Schwelle, ab der die Firmware eine Speicherstelle als auffällig meldet. Einzelne korrigierte Fehler passieren, das ist Normalbetrieb. 512 an derselben Stelle sind ein Muster.

Die Gegenprobe, und warum ich sie erst nachrüsten musste

An dieser Stelle kommt der Teil, bei dem ich mich selbst ertappt habe. Der ganze Aufwand oben, ECC, Scrubber, PPR, Fehlerschwellen, läuft ins Leere, wenn niemand hinsieht. Linux erfasst Speicherfehler über das EDAC-Subsystem, und das war bei mir aktiv:

ls /sys/devices/system/edac/mc/
#   mc0  mc1  mc2  mc3

Vier Speichercontroller, alle angebunden. Nur landeten die Ereignisse ausschliesslich im Kernel-Ringpuffer, und der ist nach einem Neustart leer. Ich hätte also gemerkt, wenn gerade etwas passiert. Ich hätte nie gemerkt, dass ein bestimmter Riegel seit Wochen langsam schlechter wird. Genau das ist aber der Fall, für den man ECC überhaupt haben will.

Nachgerüstet ist das mit einem einzigen Paket:

apt-get install rasdaemon
ras-mc-ctl --error-count
#   CPU_SrcID#0_MC#0_Chan#0_DIMM#0   CE 0   UE 0
#   ... (acht Zeilen)
ras-mc-ctl --summary
#   No Memory errors.

rasdaemon schreibt die Ereignisse in eine SQLite-Datenbank und führt sie pro Modul. CE sind korrigierte Fehler, UE nicht korrigierbare. Bei mir stehen beide auf null, und jetzt weiss ich das auch für die Vergangenheit und nicht nur für diesen Bootvorgang.

Ein Wermutstropfen: die acht Zähler heissen MC#0_Chan#0_DIMM#0 und nicht DIMMA1. Das Paket bringt für dieses Board keine Zuordnungstabelle mit. Ich könnte eine schreiben, die Reihenfolge liegt nahe, aber ich habe es bewusst gelassen. Ein falsches Etikett ist schlimmer als gar keins, weil es einen im Fehlerfall an den falschen Steckplatz schickt.

Nächste Folge: NUMA auf einer Maschine mit genau einem Sockel, warum das trotzdem ein Thema ist, und was Uncore und UPI eigentlich sind.

Siehe auch

Falls jemand von euch schon einmal ein PPR-Ereignis in freier Wildbahn gesehen hat, also einen Riegel der sich tatsächlich selbst repariert hat: das würde ich gerne hören. Ihr dürft mich jederzeit fragen.

BIOS erklärt, Teil 5: SpeedStep, Turbo, C-States und der Schalter der mir eine Woche Rätselraten erspart hätte

Willkommen bei Teil 5. Die bisherigen Folgen findest du gesammelt unter BIOS & Firmware. Heute geht es um Advanced > CPU Configuration > Advanced Power Management Configuration.

Advanced

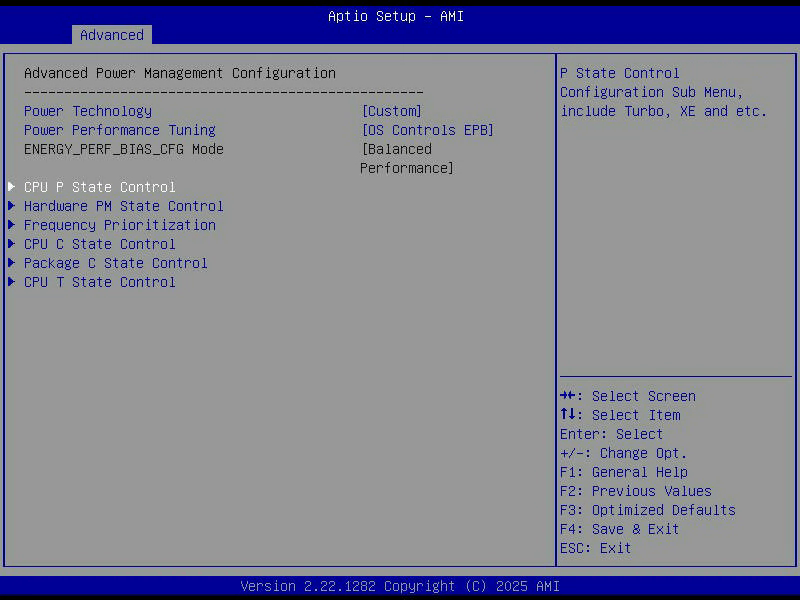
Aptio Setup, Advanced Power Management Configuration, mit Power Technology auf Custom und sechs Untermenüs

Die Seite selbst ist kurz:

Power Technology                  [Custom]
Power Performance Tuning          [OS Controls EPB]
ENERGY_PERF_BIAS_CFG Mode         [Balanced Performance]
> CPU P State Control
> Hardware PM State Control
> Frequency Prioritization
> CPU C State Control
> Package C State Control
> CPU T State Control

Die erste Zeile ist wichtiger als sie aussieht. Power Technology kennt neben Custom noch Disable und Energy Efficient, und solange sie nicht auf Custom steht, sind die sechs Untermenüs Dekoration: die Firmware setzt dann ihre eigenen Werte und überschreibt, was man darunter einstellt. Wer sich also wundert, warum eine Änderung im C-State-Menü nichts bewirkt, sollte zuerst hier nachsehen.

Power Performance Tuning auf OS Controls EPB heisst, dass das Betriebssystem den Energy Performance Bias steuern darf und nicht das BIOS. Das ist genau das, was man auf einer Linux-Maschine will. Der dritte Wert ENERGY_PERF_BIAS_CFG Mode ist der Vorgabewert, den die Firmware setzt, solange sich niemand darum kümmert, und Balanced Performance ist dafür eine vernünftige Mitte.

P-States: die Frequenz

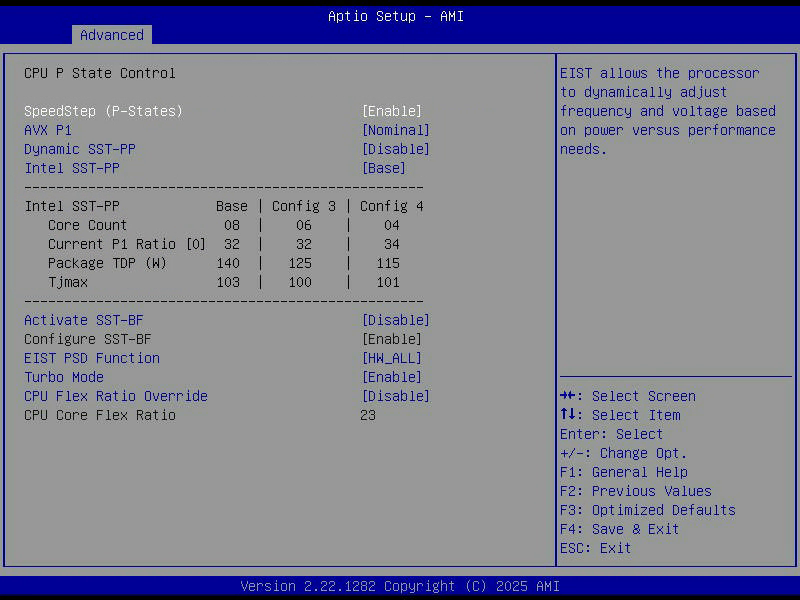
Aptio Setup, CPU P State Control, mit SpeedStep, Turbo Mode und der Tabelle der Speed-Select-Profile
SpeedStep (P-States)              [Enable]
AVX P1                            [Nominal]
Dynamic SST-PP                    [Disable]
Intel SST-PP                      [Base]
Activate SST-BF                   [Disable]
Configure SST-BF                  [Enable]
EIST PSD Function                 [HW_ALL]
Turbo Mode                        [Enable]
CPU Flex Ratio Override           [Disable]
CPU Core Flex Ratio               23

SpeedStep ist der Klassiker: die CPU darf ihre Frequenz und Spannung an die Last anpassen. Intel nennt das seit Ewigkeiten EIST, Enhanced Intel SpeedStep Technology. Ohne diesen Schalter läuft der Prozessor stur auf Basistakt, verbraucht im Leerlauf deutlich mehr und wird wärmer, ohne dafür irgendetwas zurückzugeben. Der bleibt an.

Turbo Mode ist die Gegenrichtung: die CPU darf über den Basistakt hinaus, solange Temperatur und Stromaufnahme es hergeben. Bei meinem Xeon Gold 5315Y sind das 3,2 GHz Basis und 3,6 GHz Turbo. Linux bestätigt beide Enden:

lscpu | grep MHz
#   CPU max MHz:  3600,0000
#   CPU min MHz:   800,0000

EIST PSD Function auf HW_ALL regelt, wer die Frequenzwechsel koordiniert. Bei HW_ALL macht das die Hardware für alle Kerne einer Domäne selbst, bei SW_ALL müsste das Betriebssystem mitreden. Hardware ist hier schneller und weiss ohnehin mehr, das lässt man so. ALso ich, öhm. joar. 😀

Der Teil der mich überrascht hat: Speed Select

Mitten auf der Seite steht eine kleine Tabelle, die ich vorher noch nie in einem BIOS gesehen habe:

Intel SST-PP            Base | Config 3 | Config 4
  Core Count             08  |    06    |    04
  Current P1 Ratio [0]   32  |    32    |    34
  Package TDP (W)       140  |   125    |   115
  Tjmax                 103  |   100    |   101

Das ist Intel Speed Select Technology, Variante Performance Profile. Die Idee dahinter: dieselbe CPU kann in mehreren fest definierten Betriebspunkten laufen, und man wählt beim Booten aus, welchen man haben möchte. Meine hat drei. Im Auslieferungszustand Base sind es acht Kerne bei 3,2 GHz und 140 Watt. Wählt man Config 4, bleiben vier Kerne übrig, dafür steigt der Basistakt auf 3,4 GHz und die Verlustleistung fällt auf 115 Watt.

Man tauscht also Kerne gegen Takt, und zwar nicht per Turbo-Zufall, sondern als garantierte Zusicherung. Für Software, die pro Kern lizenziert wird, ist das bares Geld. Für Lasten, die nicht parallelisieren, sind 200 MHz mehr Basistakt spürbar. Und für mich? Ehrlich gesagt nutzlos. Ich habe acht Kerne gekauft, weil ich acht Kerne wollte, und 200 MHz sind kein Argument dafür, die Hälfte davon wegzuwerfen.

Trotzdem finde ich es bemerkenswert, dass so etwas in einem BIOS steht, das ansonsten aussieht wie 2005. SST-BF daneben ist die verwandte Idee auf Kernebene: Base Frequency, einzelne Kerne bekommen dauerhaft mehr Takt, die übrigen entsprechend weniger. Steht bei mir auf Disable, und das passt, denn dafür müsste ich meine Last gezielt auf die schnellen Kerne pinnen. Wer das tut, weiss warum. Wer es nicht tut, gewinnt nichts.

Und hier lag die Antwort

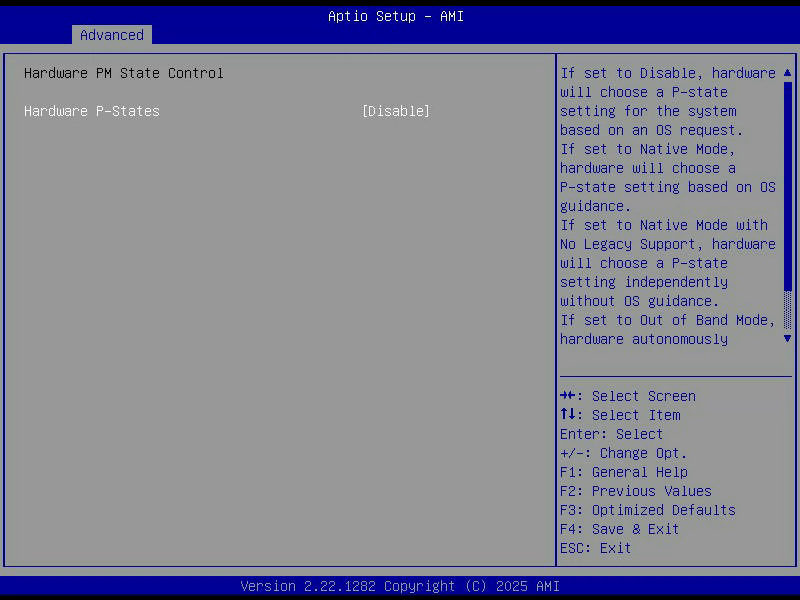
Aptio Setup, Hardware PM State Control, Hardware P-States steht auf Disable
Hardware PM State Control
Hardware P-States                 [Disable]

Ein Untermenü mit genau einer Zeile, und diese Zeile hat mich mehr gefreut als der ganze Rest der Seite. Um zu erklären warum, muss ich kurz ausholen.

Seit dem Umbau ist mir aufgefallen, dass Linux die Frequenzsteuerung auf dieser Maschine anders macht als erwartet. intel_pstate, der Treiber der bei Intel-CPUs normalerweise das Kommando übernimmt, läuft hier im passiven Modus:

cat /sys/devices/system/cpu/intel_pstate/status        # passive
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_driver # intel_cpufreq
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor # schedutil

Passiv bedeutet: der Treiber verhält sich wie ein gewöhnlicher cpufreq-Treiber und lässt den Kernel-Governor entscheiden. Aktiv bedeutet, dass er die Entscheidung selbst trifft und dabei Hardware-Unterstützung nutzt. Aktiv ist normalerweise der bessere Modus, weil die CPU schneller reagiert als jeder Governor es könnte.

Der Kernel schaltet in den aktiven Modus, wenn die CPU HWP beherrscht, Hardware P-States. Ice Lake beherrscht das. Nur taucht das entsprechende Flag bei mir gar nicht auf:

grep -o hwp /proc/cpuinfo | head -1
#   (keine Ausgabe)

Ich hatte das eine Weile für eine Eigenheit des Kernels gehalten, für eine Frage der Xeon-Variante, für irgendetwas Kompliziertes. Es war nichts davon. Es war dieser eine Schalter, zwei Menüebenen tief in einem Untermenü, das ich beim ersten Mal nicht geöffnet hatte. Ich sag doch, ich bin auch nur doof.

Was tut HWP eigentlich? Ohne HWP sagt das Betriebssystem der CPU, welche Frequenz sie fahren soll. Mit HWP sagt es ihr nur noch, worauf es ihm ankommt, irgendwo zwischen Sparsamkeit und Leistung, und die CPU sucht sich den Rest selbst. Der Vorteil ist die Reaktionszeit: die Hardware sieht Lastwechsel im Mikrosekundenbereich, der Governor im Millisekundenbereich. Bei kurzen, stossweisen Lasten, wie sie ein Desktop dauernd produziert, macht das einen Unterschied.

Werde ich es umstellen? Vermutlich ja, aber nicht heute und nicht ohne Messung. Auf der alten Maschine hatte ich Ärger mit schedutil, der mir zu träge hochgetaktet hat, insofern habe ich eine Vermutung wohin es geht. Aber genau solche Vermutungen sind der Grund, warum man am Ende Dinge kaputtoptimiert. Erst messen, dann drehen.

C-States: das Nichtstun

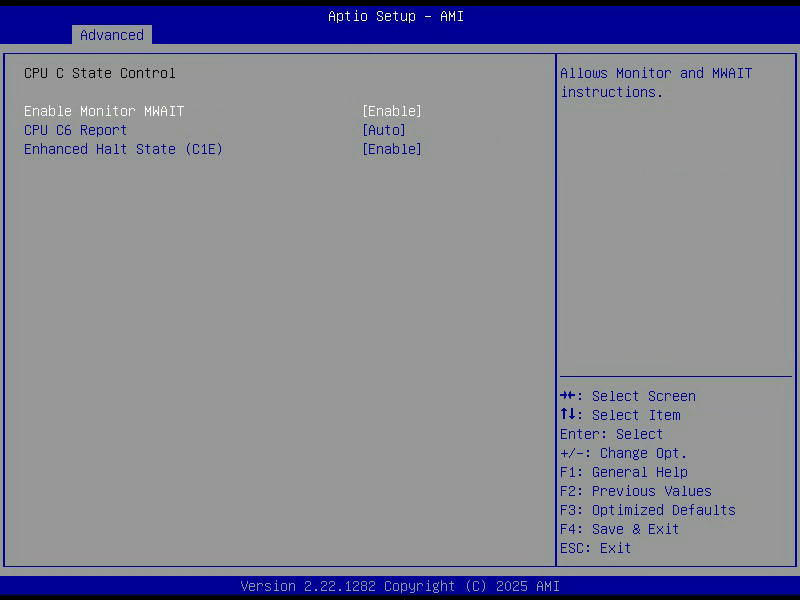
Aptio Setup, CPU C State Control, mit Monitor MWAIT, C6 Report und Enhanced Halt State
Enable Monitor MWAIT              [Enable]
CPU C6 Report                     [Auto]
Enhanced Halt State (C1E)         [Enable]

P-States regeln, wie schnell die CPU arbeitet. C-States regeln, wie tief sie schläft wenn sie gerade nichts tut. Je höher die Nummer, desto mehr wird abgeschaltet und desto länger dauert das Aufwachen. Was auf meiner Maschine ankommt, steht im sysfs:

POLL   0 us
C1     1 us
C1E    4 us
C6   170 us

C6 ist der interessante: dort wird der Kernzustand weggeschrieben und der Kern faktisch abgeschaltet. Das spart richtig Strom, kostet aber 170 Mikrosekunden zum Aufwachen. Für einen Rechner unter dem Schreibtisch ist das vollkommen egal. Für einen Paketfilter, der Latenz im einstelligen Mikrosekundenbereich garantieren soll, ist es das nicht, und genau deshalb steht in Tuning-Anleitungen für Netzwerkkram regelmässig, man solle die tiefen C-States abschalten.

Enable Monitor MWAIT ist die Voraussetzung für den ganzen Mechanismus: MONITOR und MWAIT sind die beiden Befehle, mit denen ein Kern sagt „weck mich, wenn sich diese Speicherstelle ändert“ und sich danach schlafen legt. Ohne sie bleibt nur die alte HLT-Schleife.

Package C State [Auto] eine Menüebene weiter ist die Steigerung davon: nicht mehr einzelne Kerne, sondern das ganze Paket samt Uncore und Speichercontroller. Das geht natürlich nur, wenn wirklich alle Kerne gleichzeitig nichts tun.

T-States, und warum sie aus sind

Software Controlled T-States      [Disable]

Der dritte Buchstabe im Bunde, und der unangenehmste. T-States drosseln nicht die Frequenz, sondern schieben Pausen ein: die CPU bekommt für einen Teil der Zeit schlicht keinen Takt. Das ist deutlich brutaler als ein P-State und eigentlich eine Notbremse für den Fall, dass es zu heiss wird.

Auf Disable heisst, dass das Betriebssystem diese Notbremse nicht selbst ziehen darf. Der thermische Schutz der Hardware bleibt davon unberührt, der arbeitet unabhängig weiter. Bei Tjmax 103 Grad und CPU-Temperaturen um die 40 im Leerlauf ist das eine sehr theoretische Diskussion.

Der Rest

Frequency Prioritization
RAPL Prioritization               [Disable]

RAPL ist Intels Mechanismus zur Leistungsbegrenzung. Mit RAPL Prioritization verteilt die Firmware ein knappes Leistungsbudget gezielt auf einzelne Kerne, statt alle gleichmässig zu drosseln. Das ergibt Sinn, wenn man dauerhaft am Powerlimit fährt und weiss, welche Kerne die wichtige Arbeit machen. Meine Maschine ist von beidem weit entfernt.

Was ich mitnehme

Der ganze Block ist erstaunlich gut eingestellt für ein Board, das im Auslieferungszustand von einem Serverhersteller kam. SpeedStep an, Turbo an, C-States an, T-States aus, das würde ich genau so einstellen. Ob da Supermicro oder Thomas Krenn sich Mühe gegeben hat?

Der einzige echte Fund ist Hardware P-States [Disable]. Und der ist vor allem deshalb schön, weil er zeigt, wozu so ein Durchgang gut ist: ich habe seit Wochen ein Verhalten beobachtet, das mich gewundert hat, und die Ursache lag die ganze Zeit sichtbar in einem Menü. Ich musste nur hineinschauen.

Nächste Folge: der Speicher. ECC, Patrol Scrub, PPR, und die Frage warum 256 GB DDR4-3200 in dieser Maschine mit 2933 laufen, klingt ja falsch oder?

Siehe auch

Falls jemand von euch intel_pstate im aktiven Modus gegen schedutil gemessen hat, auf einem Xeon und nicht auf einem Notebook: erzähl mir davon, bevor ich es selbst ausprobiere. Ihr dürft mich gerne fragen.

BIOS erklärt, Teil 4: AES-NI, SGX, TME und ein Schalter der nichts bewirkt

In der letzten Folge ging es um die obere Hälfte der CPU-Seite, also Kerne, Threads und Prefetcher. Die untere Hälfte ist die spannendere, weil dort keine Leistungsschalter mehr stehen, sondern Sicherheitsfunktionen. Und weil mindestens einer davon eine richtig gute Geschichte hat.

Zur Erinnerung für alle die neu dazustossen: ich gehe hier das BIOS meines Supermicro-Serverboards durch, Themenblock für Themenblock, alle Folgen liegen unter BIOS & Firmware.

AES-NI, oder: der Grund warum es eine Karte gab

Aptio Setup, CPU Configuration, mit Hyper-Threading, den fünf Prefetchern und AES-NI
AES-NI                          [Enable]

Ein Schalter und dahinter steckt eine ganze Ära. AES-NI sind sechs zusätzliche Prozessorbefehle, die AES in Hardware rechnen statt in Software. Der Unterschied ist keine Feinheit, er liegt grob bei einer Grössenordnung, und obendrein sind die Hardwarebefehle immun gegen die Cache-Timing-Seitenkanäle, mit denen man Software-AES angreifen kann. Aber vor allem is et dann ers rischtig flott mit der Crypto.

Ob die CPU es kann und darf, sieht man sofort im OS mit:

grep -o ' aes ' /proc/cpuinfo | head -1
#    aes

Warum es diesen Schalter überhaupt gibt, ist eine berechtigte Frage. Man schaltet AES-NI ja nicht ab, weil man gern langsam verschlüsselt. Die ehrliche Antwort ist vermutlich, dass er aus einer Zeit stammt, in der AES-NI ein Unterscheidungsmerkmal zwischen Produktlinien war, und niemand hat ihn seitdem entfernt. Oder hat jemand eine bessere Erklärung?

Über genau diese Zeit habe ich hier schon geschrieben. In meinem Beitrag zur Intel QuickAssist 8950-SCCP steckt eine Karte, die es nur deshalb gab, weil manche CPUs kein AES-NI hatten. Wer 2013 ein NAS mit einer Atom-CPU verschlüsseln wollte, brauchte Hilfe. Heute ist der Schalter eine Formalie, damals war er die Grenze zwischen „geht“ und „geht nicht“.

Virtualisierung und ein Schalter der Vertrauen heisst

Intel Virtualization Technology [Enable]
Enable SMX                      [Disable]

Der erste ist VT-x, im Handbuch etwas altmodisch VMX und in einer noch älteren Fassung sogar Vanderpool Technology genannt, nach dem Codenamen von 2003. Ohne ihn läuft keine Hardware-Virtualisierung, also weder KVM noch VirtualBox mit brauchbarer Geschwindigkeit. Bleibt selbstverständlich an.

Der zweite ist interessanter. SMX steht für Safer Mode Extensions und ist die Grundlage für Intel TXT, Trusted Execution Technology. Vereinfacht gesagt geht es darum, dass eine Maschine beim Start beweisen kann, dass sie genau die Software geladen hat, die sie laden sollte. Ein gemessener Start, verankert in der Hardware, ähnlich wie Measured Boot mit einem TPM, nur eine Ebene tiefer.

Dabei ist mir etwas aufgefallen, das ich nicht restlos erklären kann. Im Setup steht SMX auf Disable. In /proc/cpuinfo steht das Flag smx trotzdem drin. Die naheliegende Deutung ist, dass das Flag die Fähigkeit der CPU beschreibt und der BIOS-Schalter nur die Freigabe, dass CPUID also weiterhin „kann ich“ meldet, während die Firmware „darfst du nicht“ sagt. Belegen kann ich das nicht, ich habe es nur beobachtet. Wer da genauer Bescheid weiss, immer her damit. Ich bin ja auch nur doof.

Speicherverschlüsselung, und warum SGX daran hängt

Total Memory Encryption (TME)   [Disabled]

TME verschlüsselt den kompletten Arbeitsspeicher. Der Schlüssel wird bei jedem Start neu erzeugt, liegt im Speichercontroller und verlässt die CPU nie. Für das Betriebssystem ist das unsichtbar, es merkt schlicht nichts davon.

Wogegen hilft das? Gegen Angriffe, die physisch am Speicher ansetzen. Der Klassiker ist der Cold-Boot-Angriff, bei dem man die Riegel kühlt, aus der laufenden Maschine reisst und in einem anderen Gerät ausliest, weil DRAM seinen Inhalt für Sekunden bis Minuten behält. Dazu kommt alles, was per DMA am Speicher horcht. Bei einem Server im fremden Rechenzentrum ist das kein theoretisches Szenario. Sucht das mal auf YouTube ist so, das sieht immer krass aus. Vielleicht kann ich so etwas selbst irgendwann mal probieren.

Bei mir steht es auf Disabled, und das ist der Werksdefault. Meine Maschine steht in meiner Wohnung, die Systemplatte ist ohnehin mit LUKS verschlüsselt, und das Angriffsmodell, gegen das TME hilft, setzt jemanden voraus der hier steht während die Kiste läuft. Falls das passiert, habe ich grössere Probleme. Reizvoll finde ich es trotzdem, denn die Kosten sind gering: die Verschlüsselung sitzt im Speichercontroller und macht sich in Messungen kaum bemerkbar.

Ein Detail, über das ich beim Lesen des Handbuchs gestolpert bin, erklärt den Aufbau des Menüs:

*If the feature above is set to Enabled, the next five features are displayed*

Erst wenn TME an ist, erscheinen die fünf Zeilen darunter, und dazu gehört auch SGX. Die Enklaven-Technik hängt hier also an der Speicherverschlüsselung. Das ergibt Sinn, denn der geschützte Speicherbereich einer Enklave muss ja gegen genau die Zugriffe abgesichert sein, die TME abdeckt. Im Setup sieht man davon nur eine flache Liste, im Handbuch die Abhängigkeit.

SGX, und wie Intel die UHD-Blu-ray auf dem PC beerdigt hat

SW Guard Extensions (SGX)       [Disabled]
SGX Factory Reset               [Disabled]
SGX Package Info In-Band Access [Disabled]

SGX ist die Idee, dass ein Programm einen Speicherbereich anlegen kann, in den niemand hineinsehen darf. Nicht andere Programme, nicht der Kernel, nicht der Hypervisor, nicht einmal jemand mit Root. Die CPU verschlüsselt den Bereich und gibt ihn nur dem Code frei, der ihn angelegt hat. Diese Enklaven waren als Fundament für vertrauliche Berechnungen in fremden Rechenzentren gedacht.

Die Geschichte drumherum ist allerdings die bessere. SGX war jahrelang in normalen Desktop-Prozessoren drin, und die prominenteste Anwendung war nicht vertrauliches Rechnen, sondern Kopierschutz. Die Wiedergabe einer Ultra-HD-Blu-ray auf dem PC verlangte SGX, weil der Schlüsselaustausch in einer Enklave passierte. Dann hat Intel SGX ab der elften Generation aus den Consumer-CPUs entfernt, und damit war die UHD-Blu-ray-Wiedergabe auf neuen PCs vorbei. Wer eine Scheibe abspielen wollte, brauchte plötzlich einen älteren Prozessor.

Ich finde das aus mehreren Gründen bemerkenswert. Erstens ist es ein schönes Beispiel dafür, wie eine Sicherheitstechnik zweckentfremdet wird und dann an einer Produktentscheidung stirbt, die mit ihrem eigentlichen Zweck nichts zu tun hat. Zweitens hat es Leute getroffen, die für ihre legal gekauften Scheiben plötzlich keinen legalen Abspielweg mehr hatten, während der inoffizielle Weg weiterhin problemlos funktionierte. Kopierschutz eben.

Im Xeon lebt SGX weiter, dort war es nie der Kopierschutz sondern das Verkaufsargument. Bei mir steht es trotzdem aus, weil ich keine Software habe die Enklaven nutzt, und weil es ohnehin nur zusammen mit TME ginge. Der Vollständigkeit halber, im laufenden System taucht folgerichtig nichts davon auf:

grep -c ' sgx' /proc/cpuinfo    # 0
ls /sys/devices/system/cpu/ | grep -c sgx    # 0

46 Bit, wegen Hyper-V

Limit CPU PA to 46 bits         [Enable]

PA steht für Physical Address. Der Schalter begrenzt die Breite der physischen Adressen auf 46 Bit, was 64 Terabyte adressierbarem Speicher entspricht. Bei 256 GB im Rechner ist das reichlich weit weg von jeder Grenze. 46 Bit und 64 Bit, da muss ich direkt an fe80 bei IPv6 denken und das man die Luft gelassen hat, weil MAC Adressen auch irgendwann zu wenige sind. Ok da sind es 48 Bit aber denken muss ich daran.

Die Begründung im Handbuch ist knapp und ziemlich entlarvend:

Use this feature to limit the CPU physical address to 46 bits to support older hyper-v.

Ältere Hyper-V-Versionen kamen mit breiteren Adressen nicht klar, also gibt es im BIOS eines Serverboards von 2021 einen Schalter, der die CPU künstlich einschränkt, damit eine bestimmte Microsoft-Software läuft. Das ist Abwärtskompatibilität in ihrer reinsten Form. Der Effekt lässt sich direkt nachlesen:

grep -m1 'address sizes' /proc/cpuinfo
#   address sizes : 46 bits physical, 57 bits virtual

46 physisch, wie eingestellt. Die 57 virtuellen Bit sind übrigens eine ganz andere Baustelle, das ist Five-Level Paging, ebenfalls neu mit Ice Lake.

Eine Seriennummer im Prozessor

Aptio Setup, untere Hälfte der CPU Configuration, mit TME, SGX, PPIN Control und Extended APIC
PPIN Control                    [Lock/Disable]

PPIN steht für Protected Processor Inventory Number, eine eindeutige Nummer pro physischer CPU. Gedacht ist sie für die Fehleranalyse in grossen Flotten: wenn ein Prozessor Speicherfehler meldet, will man wissen welcher es war, und zwar auch nachdem er längst ausgebaut wurde.

Eine eindeutige, unveränderliche Hardwarenummer ist allerdings genau die Sorte Datenpunkt, an der sich vor Jahren schon einmal die Gemüter erhitzt haben. Der Pentium III hatte eine Seriennummer, der Aufschrei war so gross, dass Intel sie wieder entfernt hat. PPIN ist die gleiche Idee, nur diesmal mit einem Schalter davor und beschränkt auf Serverprozessoren.

Hier ist mir eine Abweichung aufgefallen. Das Handbuch nennt als mögliche Werte:

The options are Unlock/Disable and Unlock/Enable.

Im Setup steht aber Lock/Disable, ein Wert den das Handbuch gar nicht kennt. Passend dazu fehlt im laufenden System das Flag:

grep -c intel_ppin /proc/cpuinfo    # 0

Meine Lesart: Lock bedeutet, dass das Register gesperrt ist und die Nummer nicht ausgelesen werden kann, und das Handbuch ist an dieser Stelle schlicht nicht auf dem Stand der Firmware. Für mich ist das der Wunschzustand, ich brauche keine Seriennummer und niemand sonst braucht sie von mir. Nur schön dokumentiert ist es eben nicht.

Und zum Schluss der Schalter, der nichts bewirkt

Extended APIC                   [Disable]

Das ist mein Lieblingsfund auf dieser Seite, weil er aussieht wie eine vergessene Optimierung. Der APIC ist der Interrupt-Controller. x2APIC ist seine erweiterte Fassung, die mehr adressierbare Prozessoren und schnelleren Zugriff über Register statt über den Speicher erlaubt. Auf Disable denkt man reflexhaft: aha, hier liegt Leistung brach, das schalte ich mal ein.

Nur ist die Funktion längst aktiv. Aus dem Kernel-Log meiner laufenden Maschine:

DMAR-IR: Queued invalidation will be enabled to support x2apic and Intr-remapping.
DMAR-IR: Enabled IRQ remapping in x2apic mode
x2apic enabled
APIC: Switched APIC routing to: cluster x2apic

Der Grund ist eine Abhängigkeit, die man kennen muss: Interrupt-Remapping über VT-d verlangt x2APIC. Sobald der Kernel die IOMMU mit Interrupt-Remapping hochfährt, schaltet er x2APIC selbst ein, unabhängig davon was die Firmware vorher getan hat. Der BIOS-Schalter steuert nur, ob die Firmware das schon vorab macht. B.T.W.: habe ihr euch MMU beim Commodore C128 mal angeschaut?

Ich lasse ihn deshalb bewusst in Ruhe, und ich schreibe das hier so ausführlich auf, weil er genau die Art Schalter ist, an dem man beim nächsten Setup-Besuch wieder hängenbleibt und denkt, man hätte etwas übersehen. Hat man nicht.

Nächste Folge: Speicher. ECC, Patrol Scrub, und die Frage warum mein DDR4-3200 mit 2933 läuft und das völlig in Ordnung ist.

Siehe auch

Weiss jemand genauer, warum das smx-Flag in /proc/cpuinfo auftaucht obwohl der BIOS-Schalter auf Disable steht? Ich habe dazu keine belastbare Quelle gefunden und würde es gern richtig verstehen. Ihr dürft mich jederzeit fragen.

BIOS erklärt, Teil 3: acht Kerne, sechzehn Threads und fünf Prefetcher

Ein Detail, das mich an dieser Maschine bis heute amüsiert: die Kiste, die hier steht, hat weniger Kerne als die, die sie ersetzt hat. Vorher waren es zwei Xeon E5-2687W v3, zusammen 20 Kerne und 40 Threads. Jetzt ist es ein einzelner Xeon Gold 5315Y mit 8 Kernen und 16 Threads. Auf dem Papier ein deutlicher Rückschritt, in der Praxis für fast alles was ich mache ein Fortschritt, weil jeder einzelne Kern erheblich mehr leistet und weil PCIe 4.0 und 256 GB Speicher am Ende mehr wert sind als zwölf zusätzliche langsame Kerne.

Womit wir bei der Seite wären, um die es heute geht. Das hier ist die dritte Folge meiner Reise durch das BIOS dieses Supermicro-Boards, alle Teile stehen gesammelt unter BIOS & Firmware. Dran ist Advanced > CPU Configuration, und zwar die obere Hälfte. Die untere mit AES-NI, SGX und den Sicherheitsfunktionen bekommt die nächste Folge, sonst wird es zu lang.

Der Teil zum Anschauen

Aptio Setup, Processor Configuration, mit Prozessorsignatur, Takt, Mikrocode-Stand und den Cache-Grössen

Oben auf der Seite steht ein Block, an dem man nichts einstellen kann. Trotzdem lohnt sich der Blick, weil dort Dinge stehen, die man sonst zusammensuchen müsste:

Processor BSP Revision          606A6 - ICX M1
Processor ID                    000606A6
Processor Frequency             3.200GHz
Processor Max Ratio             20H
Processor Min Ratio             08H
Microcode Revision              0D000421
L1 Cache RAM(Per Core)          80KB
L2 Cache RAM(Per Core)          1280KB
L3 Cache RAM(Per Package)       12288KB

606A6 ist die Prozessorsignatur, aufgedröselt: Familie 6, Modell 6A, Stepping 6. ICX M1 ist Intels interne Bezeichnung dafür, ICX steht für Ice Lake. Die beiden Ratios sind Multiplikatoren in hexadezimal, 08H sind 8 und 20H sind 32. Mit dem üblichen Referenztakt von 100 MHz ergibt das 800 MHz im Leerlauf und 3,2 GHz als Basistakt. Genau diese Spanne meldet auch Linux:

lscpu | grep MHz
#   CPU max MHz:  3600,0000
#   CPU min MHz:   800,0000

Die 3600 oben drüber sind der Turbo, der geht über den Basisratio hinaus. Dazu mehr, sobald ich das Power-Management-Menü nachgereicht bekomme, das fehlt mir in meiner Aufzeichnung noch.

Am interessantesten finde ich die Cache-Zeilen. 1280 KB L2 pro Kern klingt viel, und das ist es auch. Bei Ice Lake hat Intel den L2 gegenüber der Vorgängergeneration deutlich aufgebohrt und im Gegenzug den gemeinsamen L3 kleiner gemacht. 12 MB L3 für acht Kerne sind für einen Xeon nicht üppig. Der Gedanke dahinter ist, dass Daten näher am Kern liegen und seltener über den Ring wandern müssen. Ob das für die eigene Last aufgeht, merkt man erst beim Messen, aber die Zahlen im Setup erzählen die Designentscheidung ziemlich direkt.

Das Microcode Revision 0D000421 ist übrigens der Wert, den auch Linux meldet:

grep -m1 microcode /proc/cpuinfo
#   microcode : 0xd000421

Das BIOS bringt also bereits den Mikrocode mit, den auch das Betriebssystem laden würde. Wer sich fragt, ob ein BIOS-Update wegen Mikrocode nötig wäre: hier eindeutig nein.

Kerne abschalten, in hexadezimal

Aptio Setup, CPU1 Core Disable Bitmap, mit dem Hinweis dass mindestens ein Kern aktiv bleiben muss
> CPU1 Core Disable Bitmap

Ein eigenes Untermenü mit genau einem Eintrag, und dieser Eintrag ist herrlich unhöflich. Das Handbuch beschreibt ihn so:

Select 0 to enable all cores or FFFFFFFFFFF to disable all cores. One core must be enabled.

Man gibt also eine Bitmaske in hexadezimal ein, in der jedes gesetzte Bit einen Kern abschaltet. Keine Auswahlliste, keine Zahl „wie viele Kerne hätten Sie gern“, eine Bitmaske. Und dann der wunderbare Nachsatz, dass mindestens ein Kern übrig bleiben muss, was man vermutlich nicht schreiben würde, wenn es nicht mal jemand ausprobiert hätte.

Wozu macht man so etwas? Der häufigste Grund ist Lizenzkosten. Es gibt genug Software, die pro Kern abgerechnet wird, und wenn eine Maschine dafür zu viele hat, schaltet man welche ab. Der zweite Grund ist Testen: Verhalten einer Anwendung auf weniger Kernen prüfen, ohne die Hardware zu tauschen. Bei mir steht das erwartungsgemäss auf 0, alle 16 logischen Prozessoren sind da:

cat /sys/devices/system/cpu/online     # 0-15
cat /sys/devices/system/cpu/offline    # leer

Wichtig zu verstehen ist der Unterschied zum Abschalten unter Linux. Wenn ich dort einen Kern offline nehme, existiert er weiter, er bekommt nur keine Arbeit mehr. Die Bitmaske im BIOS blendet ihn aus, bevor das Betriebssystem überhaupt startet. Für eine Lizenzzählung, die sich ansieht was die Maschine meldet, ist das ein Unterschied.

Hyper-Threading

Hyper-Threading [ALL]           [Enable]

Der bekannteste Schalter der Seite. Aus acht physischen Kernen werden sechzehn logische, weil jeder Kern zwei Befehlsströme gleichzeitig verwaltet und die Recheneinheiten teilt, die gerade nichts zu tun haben. Der Gewinn liegt je nach Last irgendwo zwischen nichts und dreissig Prozent.

Es gibt drei gute Gründe, das abzuschalten, und keiner davon trifft auf mich zu. Der erste sind Seitenkanalangriffe: mehrere der Spectre-Nachfolger nutzen aus, dass sich zwei Threads einen Kern teilen, und wer fremden Code auf seiner Maschine ausführen lässt, fährt ohne Hyper-Threading sicherer. Der zweite ist Latenz: bei harten Echtzeitanforderungen ist ein Kern, der sich mit niemandem abstimmen muss, berechenbarer. Der dritte sind wieder Lizenzen.

Für eine Workstation, auf der ich weiss was läuft, überwiegt der Durchsatz. Bleibt an.

Die fünf Prefetcher

Aptio Setup, CPU Configuration, mit Hyper-Threading, den fünf Prefetchern und AES-NI

Und jetzt der Teil, der wirklich interessant ist:

Hardware Prefetcher             [Enable]
Adjacent Cache Prefetch         [Enable]
DCU Streamer Prefetcher         [Enable]
DCU IP Prefetcher               [Enable]
LLC Prefetch                    [Enable]

Fünf Zeilen, die aussehen wie eine Liste von Marketingbegriffen und in Wirklichkeit fünf verschiedene Stücke Hardware beschreiben. Alle haben dieselbe Aufgabe: raten, welche Daten die CPU als nächstes braucht, und sie schon mal holen. Speicher ist quälend langsam gegenüber dem Prozessor, ein Zugriff der bis zum RAM durchschlägt kostet ein Vielfaches dessen, was aus dem Cache kommt. Jeder erfolgreiche Rateversuch spart diese Wartezeit.

Sie raten nur unterschiedlich:

  • Hardware Prefetcher ist der Streaming-Prefetcher für den L2. Er erkennt, dass ein Programm Speicher der Reihe nach durchläuft, und holt vorausschauend nach. Der klassische Fall ist eine Schleife über ein grosses Array.
  • Adjacent Cache Prefetch ist der simpelste von allen. Er holt zu jeder angeforderten 64-Byte-Cachezeile gleich die benachbarte mit, arbeitet also faktisch in 128-Byte-Blöcken. Die Wette lautet: wer diese Zeile braucht, braucht gleich auch die daneben.
  • DCU Streamer Prefetcher macht dasselbe wie der erste, aber eine Ebene näher am Kern, für den L1-Datencache. DCU steht für Data Cache Unit.
  • DCU IP Prefetcher ist der cleverste. IP steht hier für Instruction Pointer. Er merkt sich pro Befehl, welche Zugriffsmuster dieser Befehl in der Vergangenheit erzeugt hat, und extrapoliert daraus. Damit erwischt er auch Muster mit konstantem Abstand, etwa jedes achte Element einer Struktur, an denen ein reiner Streaming-Prefetcher scheitert.
  • LLC Prefetch zieht Daten in den gemeinsamen L3, den Last Level Cache.

Das Handbuch beschreibt den DCU IP Prefetcher übrigens als etwas, das „IP addresses“ vorlädt und damit „network connectivity“ verbessert. Das ist schlicht falsch, da hat jemand Instruction Pointer mit Internet Protocol verwechselt und den Satz nie wieder gelesen. Solche Sätze stehen in erstaunlich vielen Handbüchern, und sie sind eine gute Erinnerung daran, dass auch offizielle Dokumentation nur von Menschen geschrieben wird.

Die Gegenprobe: was davon kommt wirklich an

Das Schöne an diesen fünf Schaltern ist, dass man sie nicht glauben muss. Sie landen in einem Prozessorregister, und das kann man auslesen. MSR 0x1A4 heisst Prefetch Control, und die unteren vier Bits schalten die Prefetcher ab, wenn sie gesetzt sind:

modprobe msr
rdmsr -0 0x1a4
#   0000000000000000

Null. Kein Bit gesetzt, also kein Prefetcher abgeschaltet. Das deckt sich exakt mit dem, was das Setup anzeigt. Die Zuordnung ist Bit 0 für den Hardware Prefetcher, Bit 1 für Adjacent Cache Line, Bit 2 für den DCU Streamer und Bit 3 für den DCU IP Prefetcher. Man beachte die umgekehrte Logik: gesetztes Bit bedeutet aus.

Ich mag solche Gegenproben. Ein Screenshot zeigt, was das Setup behauptet. Das Register zeigt, was die CPU tatsächlich macht. Bei Firmware ist das nicht immer dasselbe.

Wann man daran drehen würde

Fast nie, ehrlich gesagt. Die Prefetcher sind für allgemeine Lasten deutlich im Plus, sonst hätte Intel sie nicht eingebaut. Es gibt aber Fälle, in denen sie schaden:

Bei Datenbanken und Graphen-Workloads mit stark zufälligem Zugriffsmuster liegt der Prefetcher regelmässig daneben, holt Daten die keiner braucht, und verdrängt dabei Daten die jemand gebraucht hätte. Bei Echtzeitanwendungen sind sie eine Jitter-Quelle, weil sie Speicherbandbreite zu unvorhersehbaren Zeitpunkten verbrauchen. Und bei manchen HPC-Codes, die ihre Zugriffe selbst sehr genau steuern, stört der Prefetcher mehr als er hilft.

Der entscheidende Punkt: das misst man, das rät man nicht. Und der grosse Vorteil des MSR ist, dass man dafür gar nicht ins BIOS muss. Man kann die Bits im laufenden System setzen, messen, und wieder zurücksetzen. Wer das ernsthaft ausprobiert, sollte allerdings wissen, dass wrmsr genau so gefährlich ist wie es klingt, und dass die Einstellung pro logischem Prozessor gilt.

Nächste Folge: die untere Hälfte derselben Seite. AES-NI, TME, SGX und ein Schalter namens Extended APIC, der aussieht wie eine vergessene Optimierung und keine ist.

Siehe auch

Hat jemand von euch schon mal Prefetcher gezielt abgeschaltet und dabei etwas gemessen, das sich gelohnt hat? Das würde mich wirklich interessieren, ihr dürft mich jederzeit fragen.
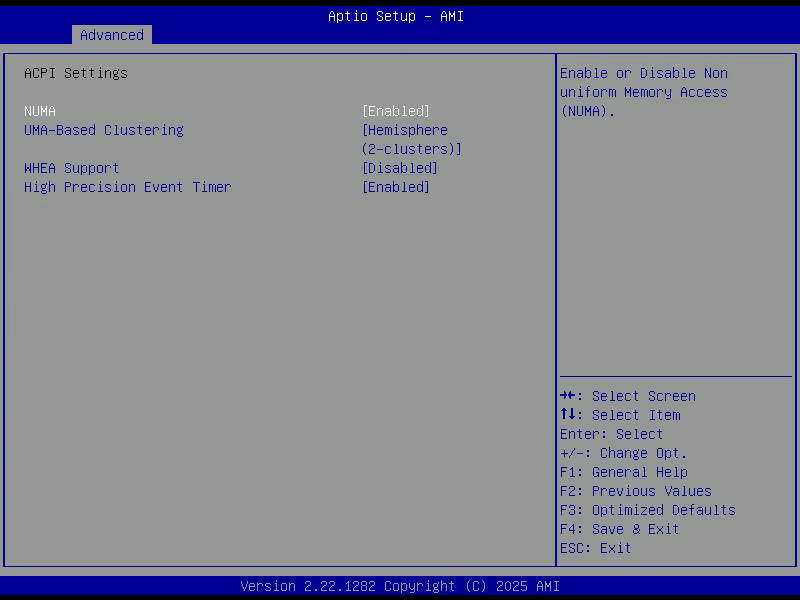
« Ältere Beiträge

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑