IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: Sysadmin (Seite 3 von 13)

NEXT Biometrics NB-2020-U Fingerabdruckleser unter Linux zum Laufen gebracht

In meinem Fujitsu Notebook steckt ein Fingerabdruckleser. Ein NEXT Biometrics NB-2020-U, USB ID 298d:2020. Unter Windows funktioniert er, unter Linux nicht. Kein Treiber, kein Support, nichts. Das Gerät taucht in lsusb auf, wird aber von keinem Treiber erkannt. Im libfprint Wiki steht es auf der Liste der nicht unterstützten Geräte. Dort steht es schon eine Weile.

Das hat mich gestört.
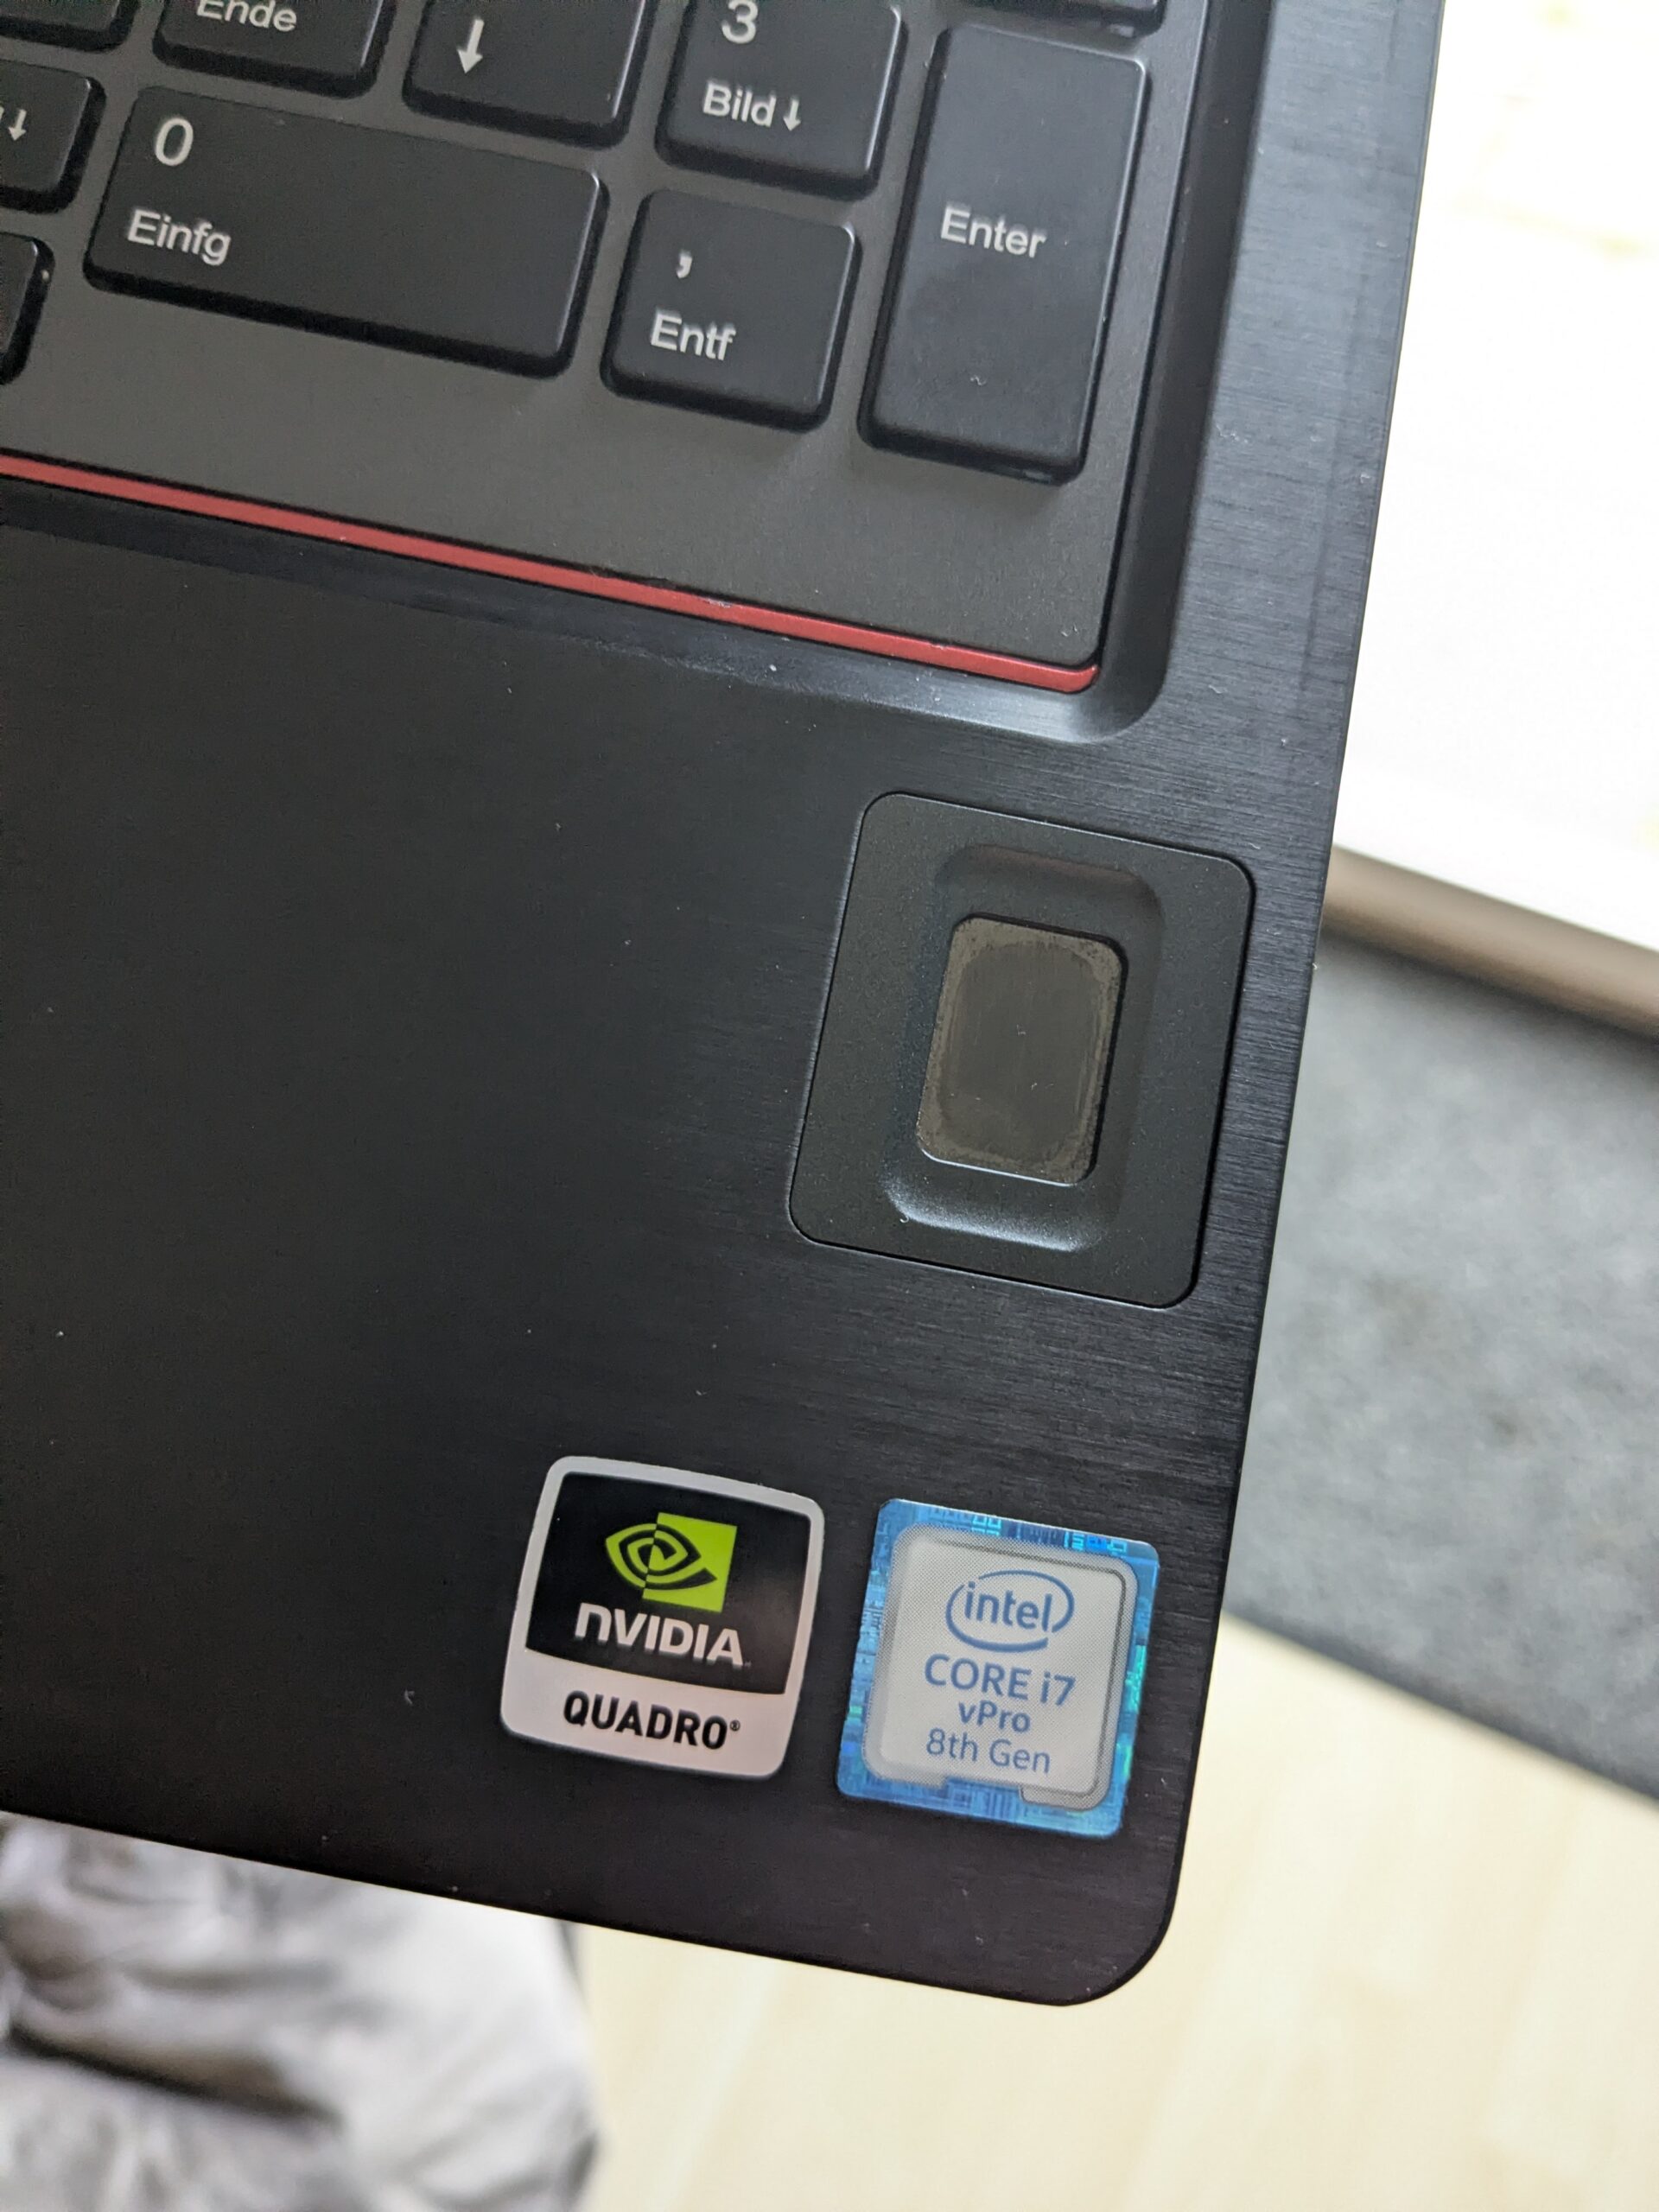
Picture of NB-2020-U

libfprint kennt den NB-1010-U. Das ist ein externer USB Fingerabdruckleser von NEXT Biometrics, der seit einiger Zeit einen funktionierenden Treiber hat. Der NB-2020-U ist die eingebettete Variante desselben Sensors, gedacht für den Einbau in Notebooks. Wenn man sich Teardown Reports ansieht, etwa von System Plus Consulting oder Yole Group, dann stellt man fest: Beide Geräte verwenden den identischen Sensor Die. Gleiche Technik, anderes Gehäuse.

Das war der erste Anhaltspunkt. Wenn die Hardware gleich ist, sollte auch das USB Protokoll gleich sein. Und wenn das Protokoll gleich ist, sollte der vorhandene Treiber funktionieren.

Bevor ich aber einfach auf Verdacht losprogrammiert habe, wollte ich es absichern. Ich habe NEXT Biometrics direkt angeschrieben. Kevin Hung, Director FAE bei NEXT Biometrics, hatte mir bereits 2022 auf eine Anfrage zu Linux Treibern geantwortet. Damals war sein Vorschlag, über Fujitsu zu gehen. Das führte ins Leere. Diesmal habe ich konkret angeboten, selbst einen libfprint Treiber zu schreiben, und um das SDK gebeten.

Kevin hat mir daraufhin das NBBiometrics ANF SDK 3.0.0.1384 zugeschickt. Ein komplettes SDK mit Headern, Bibliotheken, Beispielcode und Dokumentation. Das war sehr hilfreich, denn die Header bestätigen einiges. Das SDK nutzt eine einzige Shared Library libNBBiometrics.so für alle Gerätetypen. Der NB-1010-U hat den internen Gerätetyp 200, der NB-2020-U den Typ 202. Beide verwenden dasselbe Scanformat: 180×256 Pixel bei 385 DPI. Die USB Vendor ID ist bei beiden 0x298d, nur die Product ID unterscheidet sich: 0x1010 beim einen, 0x2020 beim anderen.

Wichtig: Das SDK ist proprietär. Für den eigentlichen Treiber habe ich keinen Code daraus verwendet. libfprint akzeptiert nur sauberen, eigenständig entwickelten Code. Das SDK diente ausschließlich als Referenz, um die Protokollkompatibilität zu bestätigen.

Also habe ich es einfach ausprobiert. Den bestehenden nb1010.c Treiber genommen, die USB Product ID 0x2020 zur id_table hinzugefügt und gebaut. Dann auf dem Fujitsu Notebook getestet.

Es funktionierte sofort.

Geräteerkennung, USB Interface Claim, die State Machine für die Fingererkennung, alles lief auf Anhieb. fprintd-enroll hat Fingerabdrücke aufgenommen, fprintd-verify hat sie korrekt verifiziert. Der bestehende Treibercode brauchte keinerlei Anpassungen. Null. Nur die PID in der Tabelle und den Gerätenamen.

Ein Blick auf die USB Deskriptoren bestätigt das Bild. Der NB-2020-U hat exakt dasselbe Endpoint Layout wie der NB-1010-U: Bulk OUT auf Endpoint 0x02, Bulk IN auf Endpoint 0x83. Dazu kommt ein Interrupt Endpoint auf 0x81, den der Treiber nicht verwendet. Die Kommunikation läuft identisch ab.

Der Patch selbst ist entsprechend klein. Drei Dateien, drei Zeilen rein, drei Zeilen raus:

  1. libfprint/drivers/nb1010.c: Die neue PID 0x2020 wird in die id_table eingetragen und der full_name auf "NextBiometrics NB-1010-U/NB-2020-U" erweitert.
  2. data/autosuspend.hwdb: Der Eintrag 298d:2020 wird von der Liste der nicht unterstützten Geräte in die Sektion des nb1010 Treibers verschoben.
  3. libfprint/fprint-list-udev-hwdb.c: Der Eintrag wird aus der Allowlist der nicht unterstützten Geräte entfernt, da er jetzt vom Treiber abgedeckt wird.

Den Merge Request habe ich bei libfprint upstream eingereicht: MR !569. Die CI Pipeline läuft durch, alle 124 Tests bestehen. Jetzt heißt es warten auf das Review durch die Maintainer.

Update, Juli 2026: Das Warten ist vorbei. MR !569 ist am 2. Juli 2026 upstream gemergt. Maintainer Marco Trevisan hat den Patch auf den aktuellen master rebased und per Auto-Merge aufgenommen, ohne blockierende Review-Kommentare. Der NB-2020-U wird damit ab der nächsten libfprint Version out of the box unterstützt. Die Details stehen im kurzen Nachtrag zum Merge.

Für alle, die denselben Fingerabdruckleser in ihrem Notebook haben: Sobald der Patch gemergt und in einer neuen libfprint Version enthalten ist, funktioniert der Sensor out of the box. Enrollment und Verifikation über fprintd laufen sauber. Wer nicht warten möchte, kann den Patch auch jetzt schon selbst auf ein aktuelles libfprint anwenden.

Im selben Fujitsu Notebook meiner Tochter steckt ein NB-2033-U, ein weiterer Fingerabdruckleser aus der gleichen Familie. Der verwendet allerdings ein komplett anderes Protokoll und ließ sich nicht einfach mit dem nb1010 Treiber ansprechen. Den habe ich per Reverse Engineering geknackt.
S/MIME-Zertifikat per DNS veröffentlichen – SMIMEA

SMIMEA — S/MIME-Zertifikat per DNS veröffentlichen

Siehe auch: Volksverschlüsselung wird eingestellt, OPENPGPKEY: GPG-Schlüssel direkt im DNS veröffentlichen, Kleiner Nachtrag zum GlobalSign S/MIME Zertifikat…

Mal wieder soweit: Mein aktuelles S/MIME-Zertifikat zum Signieren von E-Mails läuft aus. Also habe ich mir ein neues besorgt. Da GlobalSign keine Class-2-Zertifikate mehr für Privatpersonen anbietet, musste ich die CA wechseln. Durch Zufall bin ich auf SSLplus gestoßen – die haben echt gute Angebote für alle möglichen Zertifikate. Aber darum soll es in diesem Beitrag nicht gehen.

Wie immer will ich mein Zertifikat öffentlich zugänglich machen, sonst müsste jeder erst eine von mir signierte E-Mail erhalten, bevor er mein Zertifikat hat. Erst dann könnten Absender mir verschlüsselte E-Mails schicken.

Dafür gibt es ein experimentelles RFC 8162, das beschreibt, wie sich ein solches Zertifikat in einer DNSSEC-geschützten Zone veröffentlichen lässt. Natürlich gibt es im Internet wieder zig verschiedene Anleitungen und Wege, um das zu realisieren. Aber nichts wirklich Zuverlässiges, was ich finden konnte. Den DNS-Record für meine Bind9-Zone wieder manuell zu erstellen, hatte ich jedenfalls keine Lust.

Also habe ich zwei kleine Python3-Skripte geschrieben:

smimea_generate_record.py

Erstellt einen kopierbaren RR für die DNS-Zone. Kann interaktiv genutzt werden: Fragt nach E-Mail-Adresse und PEM-Zertifikat. Oder direkt mit Parametern aufgerufen werden. Prüft, ob E-Mail-Adresse und Zertifikat zusammenpassen, und gibt den fertigen Record aus.

./smimea_generate_record.py
Enter the email address: kernel-error@kernel-error.com
Enter the path to the PEM certificate: mail.pem
✅ Email 'kernel-error@kernel-error.com' matches the certificate!

🔹 **Generated BIND9 DNS Record:**

70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._smimecert.kernel-error.com. 3600 IN SMIMEA 3 0 0 (
   30820714308204FCA003020102021073C13C478DA7B114B871F00737F1B0FB30
   0D06092A864886F70D01010B0500304E310B300906035504061302504C312130
   1F060355040A0C1841737365636F20446174612053797374656D7320532E412E
   [... komplettes Zertifikat in Hex ...]
   7573CA35477D59B98DE4852065F58FB60E0E620D3E2F5CAD
   )

smimea_lookup.py

Fragt den SMIMEA-Record im DNS ab, lädt das Zertifikat herunter und prüft es mit OpenSSL auf Gültigkeit. Funktioniert interaktiv oder mit übergebenen Werten.

./smimea_lookup.py
Enter the email address: kernel-error@kernel-error.com

Querying DNS for SMIMEA record:
  70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._smimecert.kernel-error.com

Certificate saved as smimea_cert.der
Certificate successfully retrieved and verified:

Certificate:
    Data:
        Version: 3 (0x2)
        Signature Algorithm: sha256WithRSAEncryption
        Issuer: C = PL, O = Asseco Data Systems S.A., CN = Certum SMIME RSA CA
        Validity
            Not Before: Mar 13 13:41:55 2025 GMT
            Not After : Mar 13 13:41:54 2027 GMT
        Subject: SN = van de Meer, GN = Sebastian, CN = Sebastian van de Meer,
                 emailAddress = kernel-error@kernel-error.com
        Subject Public Key Info:
            Public Key Algorithm: rsaEncryption
                Public-Key: (4096 bit)
        X509v3 Extended Key Usage:
            E-mail Protection, TLS Web Client Authentication
        X509v3 Key Usage: critical
            Digital Signature, Non Repudiation, Key Encipherment, Data Encipherment
        X509v3 Subject Alternative Name:
            email:kernel-error@kernel-error.com

Beide Skripte findet ihr auf GitHub, damit ihr sie nutzen oder verbessern könnt.

Warum viele Anleitungen falsch sind

Warum habe ich geschrieben, dass ich nichts Zuverlässiges finden konnte? Nun, oft stoße ich auf Anleitungen, die noch auf TYPE53 basieren. Das ist nötig, wenn Bind9 den eigentlichen RR-Type noch nicht kennt – also ein klares Zeichen dafür, dass es sich um eine sehr frühe Implementierung handelt.

Ein weiteres häufiges Problem: Der Hash des Local-Parts wird einfach weggelassen. Stattdessen erfolgen die Abfragen direkt auf _smimecert., was aber falsch ist. Ohne den SHA256-Hash des Local-Parts gibt es keine eindeutige Zuordnung zur jeweiligen E-Mail-Adresse.

Aufbau des SMIMEA-DNS-Records

Der erste Teil — der SHA256-Hash — sorgt dafür, dass nicht einfach jeder direkt aus der DNS-Zone die E-Mail-Adressen auslesen kann. Statt die E-Mail-Adresse im Klartext zu speichern, wird nur der SHA256-Hash des Local-Parts (also der Teil vor dem @) genutzt. Wer die genaue E-Mail-Adresse kennt, kann den passenden DNS-Eintrag finden — aber jemand, der blind durch die Zone scannt, sieht nur Hashes.

Der _smimecert-Prefix zeigt an, dass es sich um einen SMIMEA-Record handelt, ähnlich wie bei ._tcp. für SRV-Records oder _acme-challenge. für Let’s Encrypt. Und schließlich kommt die Domain, zu der die E-Mail-Adresse gehört.

Manuelle Abfrage mit dig

Möchte man die Abfrage manuell durchführen, muss man zuerst den Local-Part der E-Mail-Adresse mit SHA256 hashen. Laut RFC 8162, Abschnitt 3.1 wird der Hash auf die ersten 28 Bytes (56 Hex-Zeichen) gekürzt, um die DNS-Label-Längenbeschränkung von 63 Zeichen (RFC 1035, Abschnitt 2.3.4) einzuhalten:

echo -n "kernel-error" | sha256sum | awk '{print $1}' | cut -c1-56
70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0

Anschließend die dig-Abfrage:

dig +dnssec +short 70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._smimecert.kernel-error.com. SMIMEA
3 0 0 30820714308204FCA003020102021073C13C478DA7B114B871F00737
F1B0FB300D06092A864886F70D01010B0500304E310B30090603550406
[... Zertifikat in Hex ...]

Was bedeuten die Felder?

  • 3 — Usage: End-Entity-Zertifikat (DANE-EE), also für die tatsächliche E-Mail-Verschlüsselung und Signatur
  • 0 — Selector: Das komplette Zertifikat wird gespeichert (alternativ: 1 für nur den Public Key)
  • 0 — Matching Type: Keine Hash-Funktion, das Zertifikat liegt im Klartext vor (alternativ: 1 für SHA-256, 2 für SHA-512)
  • Hex-Werte — Der eigentliche Zertifikatsinhalt in hexadezimaler Darstellung

Manuelle Prüfung auf der Konsole

Den kompletten DNS-Record abrufen, die SMIMEA-Parameter (3 0 0) entfernen und als Hex-Datei speichern:

dig +short 70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._smimecert.kernel-error.com SMIMEA | sed 's/^3 0 0 //' | tr -d '[:space:]' > dns_cert.hex

Hex in eine binäre DER-Datei umwandeln und mit OpenSSL anzeigen:

# Hex → DER
xxd -r -p dns_cert.hex dns_cert.der

# Zertifikat anzeigen
openssl x509 -inform DER -in dns_cert.der -text -noout

Verbreitung und Ausblick

SMIMEA ist leider noch immer nicht besonders weit verbreitet. Das liegt daran, dass das RFC noch immer experimental ist, aber auch daran, dass es auf weiteren Techniken aufbaut, die ebenfalls eher selten genutzt werden. Man braucht SMIMEA nur, wenn man überhaupt ein S/MIME-Zertifikat zur Signatur und Verschlüsselung von E-Mails verwendet. Zusätzlich muss die Domain per DNSSEC geschützt sein — und dann muss auch noch der zusätzliche Mehrwert von SMIMEA verstanden werden.

Denn SMIMEA verteilt nicht nur die Zertifikate, sondern macht einen direkt initial verschlüsselt erreichbar. Wenn man der Empfänger einer solchen signierten Nachricht ist, kann man das Zertifikat zudem gegen eine vertrauenswürdige DNS-Zone halten und sich so vergewissern, dass es wirklich die Signatur des Absenders ist — ähnlich wie bei TLSA/DANE.

Die Implementierung ist aktuell sehr überschaubar. Es gibt Milter für beispielsweise Postfix oder Plugins für Thunderbird, aber vor allem im Enterprise-Umfeld ist mir momentan keine funktionierende Lösung bekannt.

Eigentlich wollte ich doch nur schnell schreiben, dass ich da zwei Python-Skripte zusammengebastelt habe — und am Ende ist es doch wieder so ein riesiges Ding geworden. Aber ich denke, vor allem der Teil mit dem gekürzten Hash des Local-Parts ist wichtig zu erklären. Das ist echt eine verrückte Konstruktion. Klar, das hat seinen Sinn, aber zumindest ich bin damals genau an diesem Punkt hängen geblieben.


Das einzig korrekt funktionierende Online-Tool, das ich finden konnte: co.tt/smimea.cgi. Alle anderen sind nicht erreichbar, halten sich nicht ans RFC oder ich war zu blöde, sie zu bedienen. Fragen? Einfach melden.

Sicherheitslücken melden: Mein Umgang mit einem Vulnerability Report

Vulnerability Report

Vor Kurzem habe ich einen Vulnerability Report erhalten. Ich freue mich über solche Hinweise. Sie helfen mir, mein Setup zu verbessern, bevor jemand eine Schwachstelle tatsächlich ausnutzt.

Der Report

Subject: Vulnerability Report: Vulnerable System Detected at openpgpkey.kernel-error.com

Hello Team,

I have identified a security issue in your system related to a vulnerability
(CVE-2023-48795) in Terrapin.

Vulnerability Details:
- CVE Identifier: CVE-2023-48795
- Vulnerability Type: javascript
- Severity: medium
- Host: openpgpkey.kernel-error.com
- Affected Port: 22

[...]

Best Regards,
Security Team

Erste Einschätzung

Terrapin hatte ich eigentlich schon überall gepatcht. Dann der Hinweis auf openpgpkey.kernel-error.com. Die Domain existiert als CNAME und gehört zur Web Key Directory (WKD), damit GPG-Keys automatisiert abgerufen werden können. Ich habe das als CNAME zu wkd.keys.openpgp.org angelegt, weil dieser Keyserver eine E-Mail-Validierung beim Hochladen durchführt.

Der betroffene SSH-Server gehört also gar nicht zu meiner Infrastruktur. Ich kann selbst nichts tun.

Vulnerability Type: JavaScript bei einem SSH-Problem auf Port 22? Der Finder hat vermutlich sein Standard-Template benutzt und nicht angepasst. Aber ich wollte trotzdem prüfen, ob seine Einschätzung zum SSH-Server zutrifft:

# ssh-audit openpgpkey.kernel-error.com (gekürzt)
(gen) banner: SSH-2.0-OpenSSH_8.4p1 Debian-5+deb11u3
(gen) software: OpenSSH 8.4p1

(cve) CVE-2021-41617  -- (CVSSv2: 7.0) privilege escalation via supplemental groups
(cve) CVE-2016-20012  -- (CVSSv2: 5.3) enumerate usernames via challenge response

(kex) ecdh-sha2-nistp256  -- [fail] suspected NSA backdoor
(kex) ecdh-sha2-nistp384  -- [fail] suspected NSA backdoor
(kex) kex-strict-s-v00@openssh.com  -- [info] Terrapin counter-measure present

(key) ssh-rsa (2048-bit)  -- [fail] broken SHA-1 hash algorithm
(key) ecdsa-sha2-nistp256 -- [fail] suspected NSA backdoor

(mac) hmac-sha1-etm@openssh.com  -- [fail] broken SHA-1 hash algorithm
(mac) hmac-sha1                  -- [fail] broken SHA-1

Sieht tatsächlich nicht optimal aus. NIST-Kurven, SHA-1, 2048-Bit RSA. Der Hinweis war also nicht unberechtigt. Ich habe dem Finder freundlich und dankbar geantwortet, aber darauf hingewiesen, dass das System nicht zu meiner Infrastruktur gehört. Die relevanten WHOIS-Informationen zur IP habe ich mitgeschickt.

Die Antwort

Thank you for your answer.

Let me know if you need anything else from myside

I hope this type of hard efforts deserves something reward

„Hard efforts“. Ich will das nicht schlechtreden. Im beruflichen Umfeld hätte ich mich vielleicht sogar für eine Kleinigkeit stark gemacht. Aber hier geht es um meine private Infrastruktur, und dann noch mit dem JavaScript-Hinweis und der Meldung zu einem fremden System. Das wirkt oberflächlich. Also habe ich ihn freundlich darauf hingewiesen.

Wie man mit Vulnerability Reports umgehen sollte

Wenn euch eine solche Nachricht erreicht: Schnell und freundlich reagieren. Den Report ernst nehmen, bewerten und eine angemessene Rückmeldung geben. Die Mühe des Finders wertschätzen. Zwei Wochen später mit „Anzeige ist raus!“ zu antworten wäre der falsche Weg. Es ist für jemanden deutlich aufwendiger, eine Meldung zu schreiben, als das Ganze in ein Darknet-Forum zu posten und dort ein paar XMR einzusammeln.

Macht es den Leuten einfach, euch zu kontaktieren. Eine security.txt oder klare Kontaktinformationen für eine Security-Mailbox helfen ungemein. Hauptsache, jemand kann seinen Report unkompliziert abgeben, und er wird von jemandem gelesen, der das bewerten kann.

Mehr zum Thema security.txt:
securitytxt.org | Wikipedia | BSI Allianz für Cybersicherheit

Zum Vergleich: Mein eigener SSH-Server

So sieht meine SSH-Konfiguration von außen aus:

# ssh-audit bsd01.kernel-error.de (gekürzt)
(gen) banner: SSH-2.0-OpenSSH_9.7 DemMeisterSeinRennAuto
(gen) software: OpenSSH 9.7

(kex) sntrup761x25519-sha512@openssh.com  -- [info] Post-Quantum Key Exchange
(kex) curve25519-sha256                   -- [info] default since OpenSSH 6.4
(kex) diffie-hellman-group16-sha512       -- [info] available since OpenSSH 7.3
(kex) kex-strict-s-v00@openssh.com        -- [info] Terrapin counter-measure

(key) ssh-ed25519                         -- [info] available since OpenSSH 6.5

(enc) aes256-gcm@openssh.com              -- [info] available since OpenSSH 6.2
(enc) aes128-gcm@openssh.com              -- [info] available since OpenSSH 6.2

(mac) hmac-sha2-256-etm@openssh.com       -- [info] available since OpenSSH 6.2
(mac) hmac-sha2-512-etm@openssh.com       -- [info] available since OpenSSH 6.2

Keine NIST-Kurven, kein SHA-1, kein RSA, Post-Quantum Key Exchange mit sntrup761. Nur Ed25519 als Host Key. Der Banner ist übrigens Absicht.

Update September 2026: Auch auf der meldenden Seite hilft eine AI, wenn man sie lässt. Wie ich Claude für Security-Research freigeschaltet habe, beschreibt Anthropic Cyber Verification Program: wie ich Claude für Security-Arbeit freigeschaltet habe.

Fragen? Einfach melden.

BitLocker im Dual-Boot: Systemplatte auf Passwortschutz umstellen

Die Feiertage sind da, und ich hatte tatsächlich etwas Zeit zum Zocken. Gearbeitet wird unter Linux, gezockt unter Windows. Dafür habe ich mein Windows auf einer gesonderten SSD installiert, verschlüsselt mit BitLocker.

Illustration eines Dual-Boot-Systems mit Linux und Windows, dargestellt durch die Logos beider Betriebssysteme. Die Windows-Seite zeigt ein BitLocker-Schloss-Symbol, das auf die Verschlüsselung der Systemplatte hinweist.

Die SSD hat irgendwann aufgegeben, Windows musste neu drauf. Backup spare ich mir, ist eh nur zum Zocken. Windows 11, Treiber, Games, fertig. Aber: BitLocker fragt bei jedem Start nach dem Wiederherstellungsschlüssel, wenn ich vorher in Linux war. Das hatte ich schon mal, am gleichen Rechner. Damals nicht aufgeschrieben. Diesen Fehler mache ich nicht noch mal.

Das Problem

BitLocker mit TPM merkt, wenn sich die Boot-Kette ändert. Wechselt man über GRUB zwischen Linux und Windows, sieht das TPM eine Änderung und verlangt den Recovery Key. Die Lösung: TPM als Schlüsselschutz entfernen und stattdessen ein Passwort setzen. Dann fragt BitLocker bei jedem Start nach dem Passwort, egal ob vorher Linux oder Windows lief.

Gruppenrichtlinie anpassen

Damit Windows erlaubt, TPM vom Betriebssystemvolume zu entfernen, muss eine Gruppenrichtlinie geändert werden. Win + S, nach Gruppenrichtlinie bearbeiten suchen, dann:

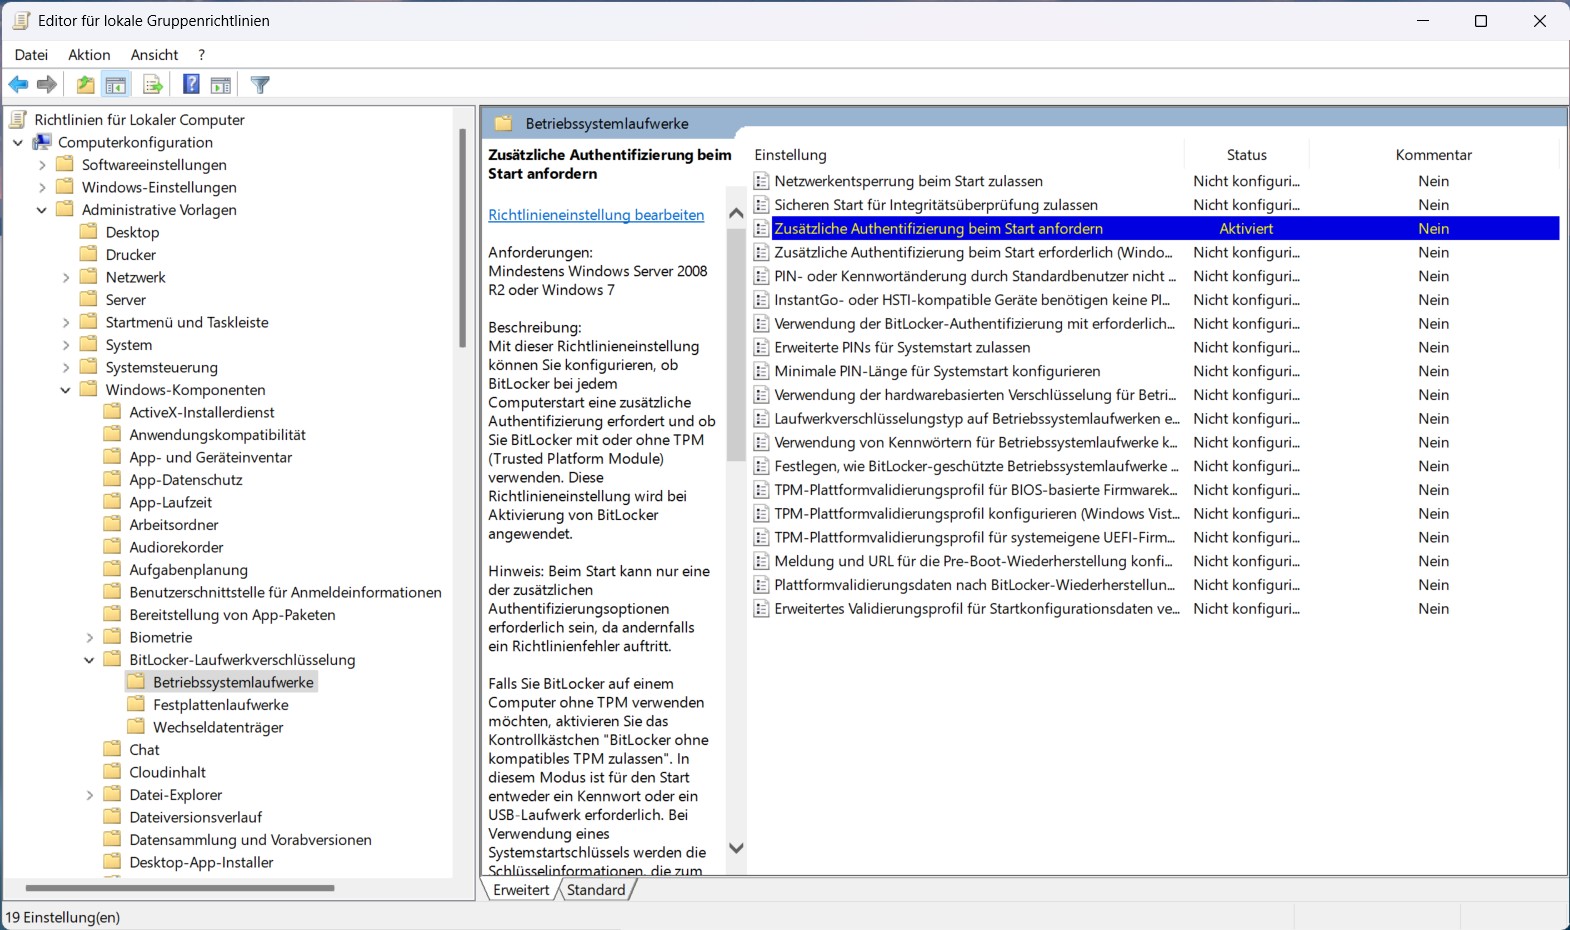
Computerkonfiguration → Administrative Vorlagen → BitLocker-Laufwerkverschlüsselung → Betriebssystemlaufwerke → Zusätzliche Authentifizierung beim Start anfordern

Editor für lokale Gruppenrichtlinien mit geöffneter Einstellung 'Zusätzliche Authentifizierung beim Start anfordern' unter 'Computerkonfiguration > Administrative Vorlagen > BitLocker-Laufwerkverschlüsselung > Betriebssystemlaufwerke'. Die Option ist aktiviert, um die BitLocker-Verschlüsselung ohne TPM zu ermöglichen.
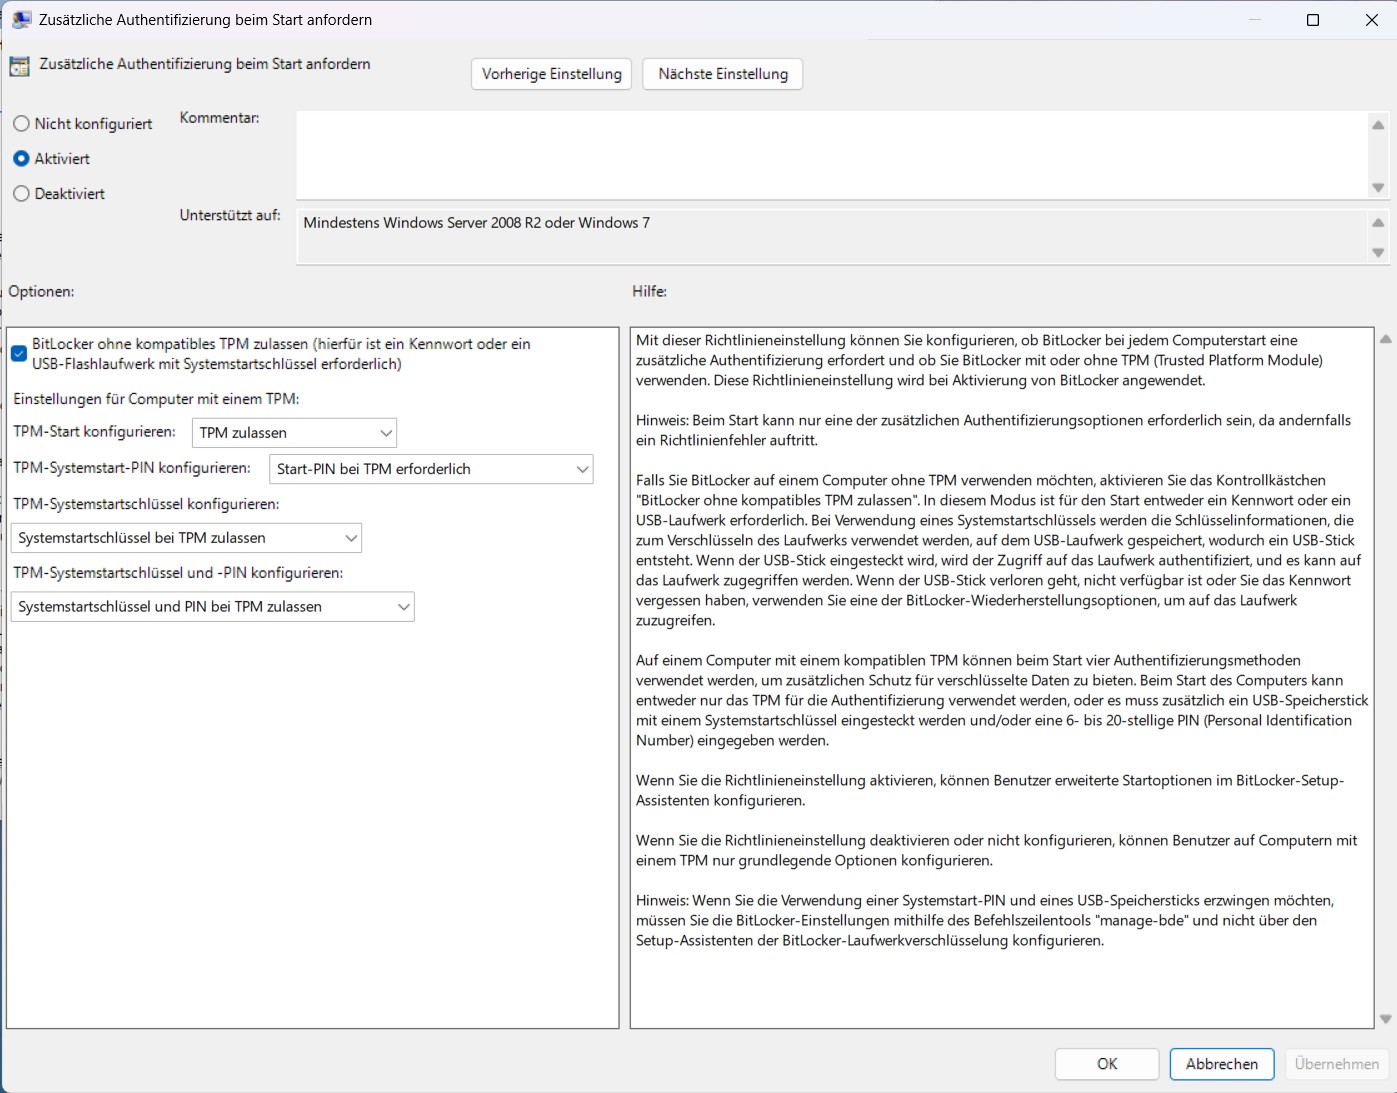
Detailansicht der Gruppenrichtlinieneinstellung 'Zusätzliche Authentifizierung beim Start anfordern'. Die Option 'BitLocker ohne kompatibles TPM zulassen' ist aktiviert, und die Konfiguration für TPM-Start, Systemstartschlüssel und PIN wird angezeigt. Die Beschreibung auf der rechten Seite erläutert die Auswirkungen der Richtlinie.

Den Haken bei „BitLocker ohne kompatibles TPM zulassen“ setzen. Danach im Administrator-Terminal die Richtlinie anwenden:

gpupdate /force

Schlüsselschutz umstellen

Zuerst den aktuellen Status prüfen:

manage-bde -protectors -get C:

In meinem Fall waren drei Schlüsselschutzvorrichtungen konfiguriert: Numerisches Kennwort, TPM und PIN, sowie TPM. Alle müssen weg, damit nur noch das Passwort übrig bleibt.

Schritt für Schritt im Administrator-Terminal:

# 1. Alle Schutzvorrichtungen deaktivieren
manage-bde -protectors -disable C:
# 2. Vorhandene Schutzvorrichtungen anzeigen (IDs notieren)
manage-bde -protectors -get C:
# 3. Jede Schutzvorrichtung einzeln löschen (ID aus Schritt 2)
manage-bde -protectors -delete C: -id {TPM-UND-PIN-ID}
manage-bde -protectors -delete C: -id {TPM-ID}
manage-bde -protectors -delete C: -id {NUMERISCHES-KENNWORT-ID}
# 4. Prüfen, dass keine mehr da sind
manage-bde -protectors -get C:
# Erwartete Ausgabe: "Es wurden keine Schlüsselschutzvorrichtungen gefunden."
# 5. Passwort als neue Schutzvorrichtung hinzufügen
manage-bde -protectors -add C: -password
# (Passwort eingeben und bestätigen)
# 6. Schutz wieder aktivieren
manage-bde -protectors -enable C:

Ergebnis prüfen

manage-bde -status
Volume "C:" [System]
    Verschlüsselt (Prozent):      100,0 %
    Verschlüsselungsmethode:      XTS-AES 128
    Schutzstatus:                 Der Schutz ist aktiviert.
    Schlüsselschutzvorrichtungen:
        Kennwort

Nur noch Kennwort als Schutzvorrichtung. Beim nächsten Start fragt BitLocker nach dem Passwort, unabhängig davon ob vorher Linux oder Windows lief. GRUB stört nicht mehr.

Wer auf der Linux-Seite ebenfalls verschlüsselt: Bei LUKS kann ein falsches Tastaturlayout bei der Passphrase-Abfrage für Verwirrung sorgen.

Fragen? Einfach melden.

FreeBSD SSH-Server absichern: MFA mit Google Authenticator einrichten​

SSH-Keys sind der Standard. Aber manchmal lässt es sich nicht vermeiden, dass ein Login nur mit Benutzername und Kennwort abgesichert ist. Um das aufzuwerten, lässt sich der SSH-Server mit einem zweiten Faktor ausstatten — hier mit dem Google Authenticator (TOTP) auf FreeBSD.

Installation

pkg install pam_google_authenticator

PAM-Konfiguration

In /etc/pam.d/sshd das Google Authenticator PAM-Modul als zweiten required-Eintrag nach pam_unix einfügen:

#
# PAM configuration for the "sshd" service
#

# auth
auth		required	pam_unix.so		no_warn try_first_pass
auth		required	/usr/local/lib/pam_google_authenticator.so

# account
account		required	pam_nologin.so
account		required	pam_login_access.so
account		required	pam_unix.so

# session
session		required	pam_permit.so

# password
password	required	pam_unix.so		no_warn try_first_pass

Die Reihenfolge ist wichtig: Erst das Kennwort (pam_unix), dann der TOTP-Code. Auf dem gleichen Weg lässt sich MFA auch für su, den Konsolen-Login oder SSH-Keys einrichten — einfach das entsprechende PAM-File anpassen.

sshd_config anpassen

In /etc/ssh/sshd_config muss Challenge-Response aktiviert sein:

# Seit OpenSSH 8.7 heißt die Option KbdInteractiveAuthentication
# ChallengeResponseAuthentication ist ein Alias und funktioniert weiterhin
KbdInteractiveAuthentication yes

Danach service sshd restart — aber vorher sicherstellen, dass man noch eine offene Session hat, falls etwas nicht stimmt.

Authenticator einrichten

Auf dem Smartphone den Google Authenticator installieren (oder eine andere TOTP-App wie Aegis, 2FAS oder den Microsoft Authenticator). Dann auf dem Server mit dem gewünschten Benutzer google-authenticator aufrufen:

cd ~
google-authenticator

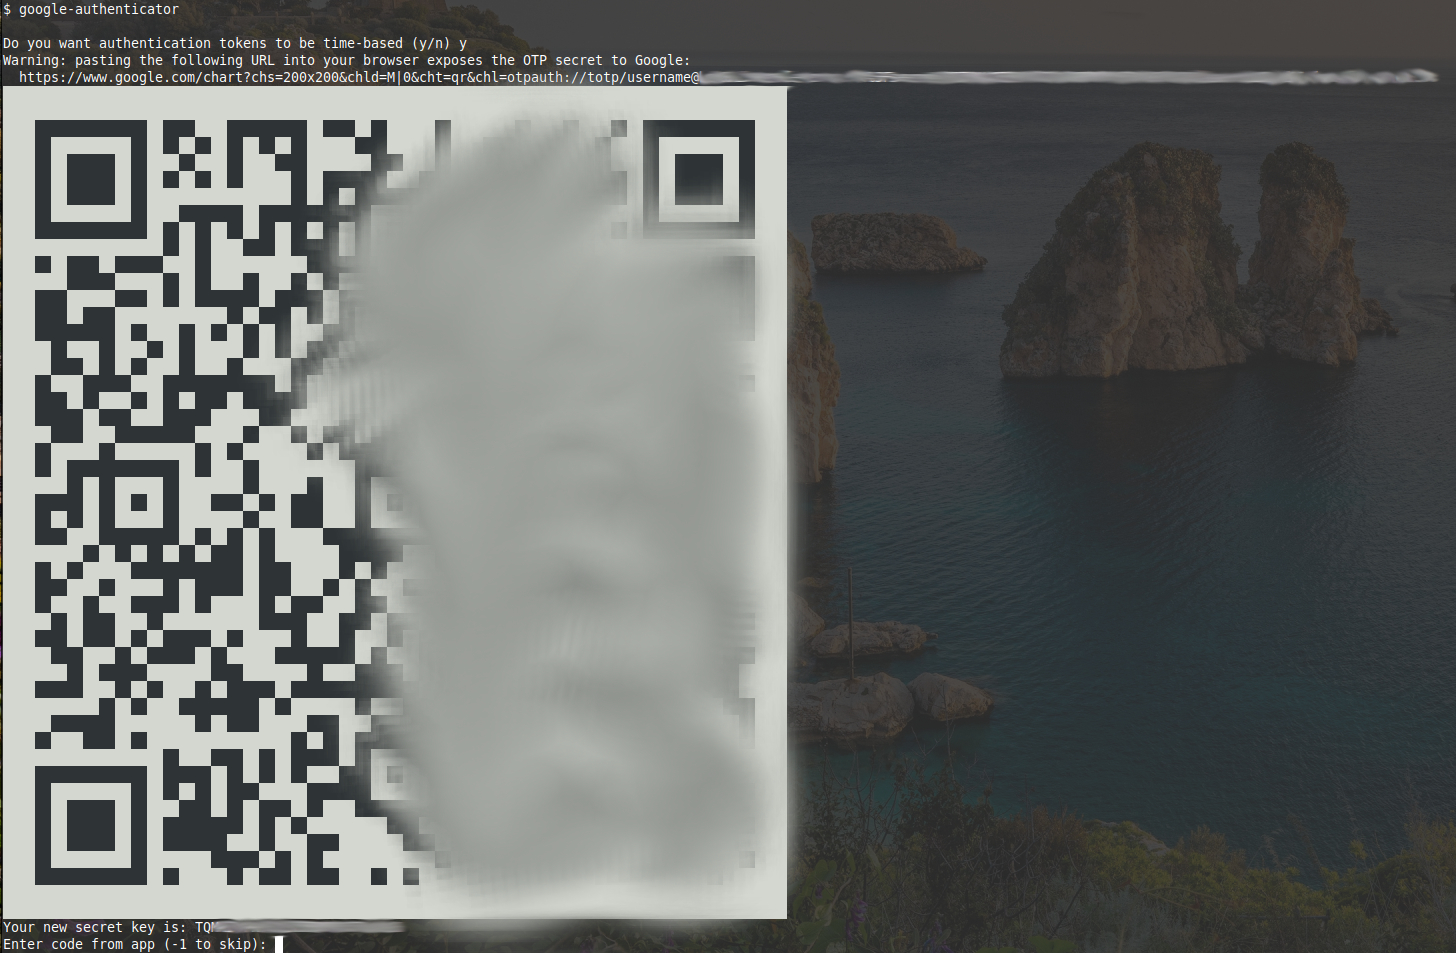
Das Tool zeigt einen QR-Code im Terminal, den man mit der Authenticator-App scannt:

Danach den angezeigten Code einmal eingeben — fertig. Bei jedem Kennwort-Login wird jetzt zusätzlich der aktuelle TOTP-Code abgefragt.

Wichtig: Das Tool zeigt auch Backup-Codes an. Diese unbedingt sicher aufbewahren — wenn das Smartphone verloren geht, kommt man sonst nicht mehr rein. Die Konfiguration liegt in ~/.google_authenticator und kann dort auch nachträglich eingesehen werden.

Siehe auch: FreeBSD OpenSSH: OS-Banner sicher entfernen, SSH-Bruteforce, DigitalOcean und AbuseIPDB – warum Blocken das Problem nicht löst

Unter Linux ist die Einrichtung sehr ähnlich — das PAM-Modul heißt dort libpam-google-authenticator. Fragen? Einfach melden.

DNSSEC und SSHFP unter Linux Mint und Ubuntu zum Laufen bringen

Heute habe ich versucht, mich von meiner neuen Linux Mint Installation aus mit einem meiner SSH-Server zu verbinden. Mein SSH-Client hat mich direkt gefragt, ob ich dem Hostkey vertrauen möchte:

ssh username@hostname.kernel-error.org
The authenticity of host 'hostname.kernel-error.org (2a01:5a8:362:4416::32)' can't be established.
ED25519 key fingerprint is SHA256:kTRGVCMRLiHfvJunW2CbW5H3NZmn3Wkx2KnHJXl3iJu.
This key is not known by any other names
Are you sure you want to continue connecting (yes/no/[fingerprint])?

Für viele ist das normal — man tippt „yes“ und sieht die Meldung nie wieder. Aber diese Meldung hat ihren Grund. Beim ersten Verbindungsaufbau zeigt SSH den Fingerprint des Server-Hostkeys an, damit man prüfen kann, ob man wirklich mit dem richtigen Server spricht und nicht mit einem Angreifer. Wer eh immer „yes“ sagt, könnte den Check auch gleich in seiner ~/.ssh/config abschalten:

Host *
    StrictHostKeyChecking no

SSHFP — Hostkeys per DNS verifizieren

Es gibt einen besseren Weg: SSHFP-Records (RFC 4255). Man hinterlegt die Fingerprints der erwarteten Hostkeys als DNS-Einträge. Der SSH-Client prüft diese automatisch — vorausgesetzt die DNS-Antwort ist per DNSSEC abgesichert. In der ~/.ssh/config:

Host *
   VerifyHostKeyDNS yes

Meine DNS-Server unterstützen alle DNSSEC, mein lokaler Resolver auf dem Router auch, die SSH-Config stimmt — und trotzdem erscheint die Meldung. Also mit ssh -vvv debuggen:

debug1: found 2 insecure fingerprints in DNS

Insecure. SSH findet die SSHFP-Records, vertraut ihnen aber nicht, weil die DNS-Antwort nicht als DNSSEC-validiert markiert ist.

Das Problem: systemd-resolved

Schneller Test mit dig +dnssec gegen Google DNS:

dig +dnssec hostname.kernel-error.org @8.8.8.8
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

Das ad-Flag (Authenticated Data) ist gesetzt — meine DNS-Server liefern DNSSEC korrekt aus. Auch der lokale Router-Resolver liefert ad. Aber ohne expliziten @server:

dig +dnssec hostname.kernel-error.org
;; flags: qr rd ra; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

Kein ad. Was steht in /etc/resolv.conf? 127.0.0.53 — systemd-resolved. Der Stub-Resolver von systemd schluckt das AD-Flag.

Man könnte in /etc/systemd/resolved.conf einfach DNSSEC=yes setzen — bei mir ging danach aber gar keine DNS-Auflösung mehr. Das liegt am Stub-Resolver, den man ebenfalls umkonfigurieren müsste. Nennt mich oldschool, aber für meine Zwecke reicht der klassische Weg über die vom NetworkManager gepflegte resolv.conf.

Lösung: systemd-resolved abschalten

sudo systemctl disable systemd-resolved
sudo systemctl stop systemd-resolved
sudo rm /etc/resolv.conf

In /etc/NetworkManager/NetworkManager.conf in der [main]-Sektion:

dns=default

NetworkManager neu starten:

sudo systemctl restart NetworkManager
cat /etc/resolv.conf
# Generated by NetworkManager
search kernel-error.local
nameserver 10.10.88.1
nameserver fd00:424e:6eff:f525:454e:6eff:f525:4241

DNS-Auflösung geht. Aber SSH sagt weiterhin „insecure“. Es fehlen noch zwei Optionen in der resolv.conf.

edns0 und trust-ad

Erste Erkenntnis — edns0 muss aktiviert sein, damit DNSSEC-Daten überhaupt transportiert werden. In /etc/resolv.conf:

options edns0

Jetzt zeigt dig das ad-Flag. Aber SSH sagt immer noch „insecure“. Warum? Ein Blick in den SSH-Quellcode — die ldns-Bibliothek macht die DNSSEC-Validierung:

        /* Check for authenticated data */
        if (ldns_pkt_ad(pkt)) {
                rrset->rri_flags |= RRSET_VALIDATED;
        } else { /* AD is not set, try autonomous validation */
                ldns_rr_list * trusted_keys = ldns_rr_list_new();
                /* ... */
                if ((err = ldns_verify_trusted(ldns_res, rrdata, rrsigs,
                     trusted_keys)) == LDNS_STATUS_OK) {
                        rrset->rri_flags |= RRSET_VALIDATED;
                }
        }

ldns prüft das AD-Flag im DNS-Paket. Aber die glibc setzt das AD-Flag in der Antwort nur dann, wenn trust-ad in der resolv.conf steht — sonst wird es aus Sicherheitsgründen herausgefiltert. Die vollständige Option:

options edns0 trust-ad

Und jetzt:

ssh username@hostname.kernel-error.org -vvv
[...]
debug1: found 2 secure fingerprints in DNS
debug3: verify_host_key_dns: checking SSHFP type 4 fptype 1
debug1: verify_host_key_dns: matched SSHFP type 4 fptype 1
debug3: verify_host_key_dns: checking SSHFP type 4 fptype 2
debug1: verify_host_key_dns: matched SSHFP type 4 fptype 2
debug1: matching host key fingerprint found in DNS

secure statt insecure. SSH verifiziert den Hostkey automatisch per DNSSEC — keine manuelle Fingerprint-Prüfung mehr nötig.

Rebootfest machen

Die manuell eingetragenen Optionen in der resolv.conf überleben keinen Reboot — der NetworkManager überschreibt die Datei. Per nmcli die Optionen dauerhaft im Netzwerkprofil setzen, für IPv4 und IPv6:

nmcli conn modify DEINE-PROFIL-UUID ipv4.dns-options edns0,trust-ad
nmcli conn modify DEINE-PROFIL-UUID ipv6.dns-options edns0,trust-ad

Die UUID des aktiven Profils findet man mit nmcli conn show. Beide Zeilen sind nötig — fehlt eine, greift es nicht.


Zusammenfassung: systemd-resolved unter Linux Mint und Ubuntu filtert das DNSSEC-AD-Flag heraus. Ohne AD-Flag kann SSH die SSHFP-Records nicht als vertrauenswürdig einstufen. Lösung: systemd-resolved abschalten, NetworkManager mit dns=default nutzen, edns0,trust-ad per nmcli setzen.

Wer einen DNSSEC-validierenden Resolver sucht — dns.kernel-error.de ist ein öffentlicher DNS-Resolver mit DNSSEC, DNS over TLS und DNS over HTTPS.

Und die offene Frage: Ich bin mit meinem FreeBSD-Wissen an das Thema gegangen. Wie macht man das als Linux-User mit systemd-resolved richtig? Schreibt mir, wenn ihr es wisst.

Siehe auch: SSH Host Keys per SSHFP

FreeBSD: Unverschlüsseltes ZFS-Dataset nachträglich verschlüsseln

Bild der Bücher FreeBSD Mastery ZFS und FreeBSD Mastery Advanced ZFS

ZFS Encryption lässt sich nicht nachträglich auf ein bestehendes Dataset aktivieren. Die Daten müssen per zfs send | zfs receive in ein neues, verschlüsseltes Dataset geschrieben werden. Typischer Anwendungsfall: Jails, die in eigenen Datasets liegen und nach einem FreeBSD-Upgrade auf 13+ verschlüsselt werden sollen.

Wer die Grundlagen zu ZFS Encryption noch braucht (Dataset anlegen, Passphrase, Mount nach Reboot), findet sie im Beitrag Native ZFS Encryption einrichten.

Ausgangslage

Ein Pool zroot mit dem unverschlüsselten Dataset varta:

zfs list zroot/varta
NAME          USED  AVAIL     REFER  MOUNTPOINT
zroot/varta   100M  12.0G      100M  /zroot/varta

zfs get encryption zroot/varta
NAME         PROPERTY    VALUE   SOURCE
zroot/varta  encryption  off     default

Migration

Bei zfs send | zfs receive kann man kein Passphrase interaktiv eingeben, weil stdin durch die Pipe belegt ist. Deshalb legt man den Schlüssel temporär in einer Datei ab:

echo 'MeinGeheimesPassphrase' > /tmp/keyfile.txt
chmod 600 /tmp/keyfile.txt

Snapshot erstellen und in ein neues verschlüsseltes Dataset senden:

zfs snapshot zroot/varta@migration

zfs send zroot/varta@migration | \
  zfs receive -F \
  -o encryption=on \
  -o keyformat=passphrase \
  -o keylocation=file:///tmp/keyfile.txt \
  zroot/en-varta

Das neue Dataset zroot/en-varta enthält jetzt dieselben Daten, verschlüsselt mit AES-256-GCM:

zfs list zroot/varta zroot/en-varta
NAME             USED  AVAIL     REFER  MOUNTPOINT
zroot/en-varta   100M  11.8G      100M  /zroot/en-varta
zroot/varta      100M  11.8G      100M  /zroot/varta

Aufräumen

Die Keyfile-Referenz auf Passphrase-Abfrage umstellen und die temporäre Datei löschen:

zfs set keylocation=prompt zroot/en-varta

zfs get keylocation zroot/en-varta
NAME            PROPERTY     VALUE   SOURCE
zroot/en-varta  keylocation  prompt  local

rm /tmp/keyfile.txt

Dann das alte Dataset entfernen und das neue umbenennen:

zfs destroy -r zroot/varta
zfs rename zroot/en-varta zroot/varta

Fertig. Das Dataset liegt jetzt verschlüsselt am selben Mountpoint wie vorher:

zfs get encryption,keylocation,keyformat zroot/varta
NAME         PROPERTY     VALUE        SOURCE
zroot/varta  encryption   aes-256-gcm  -
zroot/varta  keylocation  prompt       local
zroot/varta  keyformat    passphrase   -

Stolperfallen

Keyfile in /tmp ist ein Kompromiss. Auf FreeBSD-Default ist /tmp zwar ein tmpfs im RAM, aber bei Speicherdruck kann das System swappen. chmod 600 schützt gegen andere Benutzer, nicht gegen root, Backup-Prozesse oder einen Crash-Dump. Sauberer ist eine keylocation auf einem schon verschlüsselten Dataset oder ein FIFO statt einer regulären Datei. In beiden Fällen existiert die Passphrase nie persistent auf der Platte.

Properties gehen beim Send verloren. Ohne -R (Replication Stream) oder explizite -o-Optionen werden compression, recordsize, quota, reservation, atime und eigene Properties nicht mitübertragen. Wer compression=zstd oder recordsize=1M gesetzt hatte, muss die beim receive wieder setzen oder direkt einen Replication Stream nutzen.

Mountpoint nach dem Rename prüfen. Lag das alte Dataset auf /var/jails/varta, muss der Mountpoint nach dem Rename wieder explizit gesetzt werden, sonst landet das Dataset am Default-Pfad des Pools:

zfs set mountpoint=/var/jails/varta zroot/varta

Jail vorher stoppen. service jail stop <name> bzw. iocage stop oder bastille stop. Sonst sind Dateien offen, zfs destroy -r schlägt fehl und der Rename macht keinen Spaß.

Inkrementelle Migration für große Datasets

Bei Jails mit Datenbank, Mailspool oder einfach mehreren hundert GB ist Downtime gleich Send-Laufzeit nicht akzeptabel. Besser: initial senden während der Dienst läuft, dann nur kurz stoppen und den inkrementellen Rest nachziehen.

# Phase 1: initialer Send im laufenden Betrieb
zfs snapshot zroot/varta@migration-1
zfs send zroot/varta@migration-1 | \
  zfs receive -F \
  -o encryption=on \
  -o keyformat=passphrase \
  -o keylocation=file:///tmp/keyfile.txt \
  zroot/en-varta

# Phase 2: Dienst stoppen, inkrementelles Delta senden
service jail stop varta
zfs snapshot zroot/varta@migration-2
zfs send -i @migration-1 zroot/varta@migration-2 | \
  zfs receive zroot/en-varta

# Phase 3: Rename und Neustart
zfs destroy -r zroot/varta
zfs rename zroot/en-varta zroot/varta
zfs set mountpoint=/var/jails/varta zroot/varta
service jail start varta

Die Downtime reduziert sich so auf den inkrementellen Send plus Rename, bei einer typischen Mailbox sind das Sekunden statt Minuten. Bei sehr aktiven Datasets kann man mehrere inkrementelle Snapshots nacheinander schieben, bis das Delta klein genug für die gewünschte Zielzeit ist.

Update 2026: was heute dazugekommen ist

OpenZFS 2.x ist auf FreeBSD 14 und 15 stabil. Der eigentliche Migrationspfad hat sich nicht geändert, drumherum ist einiges dazugekommen:

Raw encrypted send/receive. Mit zfs send -w wird ein verschlüsseltes Dataset ohne Entschlüsselung übertragen. Der Remote-Host lagert den Stream, kennt den Schlüssel nicht und sieht keinen Klartext. Für Offsite-Backups der saubere Weg, sobald die Migration durch ist:

zfs snapshot zroot/varta@backup
zfs send -w -R zroot/varta@backup | \
  ssh backup@remote zfs receive backuppool/varta

Andere Keyformate. Statt keyformat=passphrase gehen auch keyformat=raw (32-Byte-Keyfile, z.B. aus HSM oder TPM) oder keyformat=hex (64 Zeichen Hex). keylocation=https://... holt den Schlüssel beim Pool-Import von einer URL, praktisch für headless Systeme, bei denen die Passphrase-Abfrage beim Boot stört.

Kompression vor Verschlüsselung. ZFS komprimiert zuerst, verschlüsselt danach. compression=zstd zusammen mit encryption=on wirkt also wie erwartet, und der komprimierte Zustand bleibt auch im Raw Stream erhalten.

Nur für Datenpools und Non-Root-Datasets. Diese Anleitung deckt Jails, Home-Verzeichnisse, Mailspools und ähnliches ab. Verschlüsseltes Root-on-ZFS ist ein eigenes Thema und braucht zusätzlich Boot-Environment-Handling (bectl) sowie ein geli-verschlüsseltes Swap.

Siehe auch

Native ZFS Encryption einrichten und nutzen für die Grundlagen zu Dataset, Passphrase und Mount nach Reboot. Verschlüsseltes ZFS-Backup auf USB-Platte mit geli für die Offline-Sicherung. Linux Mint mit verschlüsseltem ZFS-Root-Pool installieren für das Linux-Pendant mit Root-Pool.

Eine Übersicht über alle ZFS-Funktionen gibt es im ZFS-Überblick. Fragen? Einfach melden.

Firmware- und BIOS-Updates unter Linux einfach mit fwupd durchführen

fwupd-Logo — das Open-Source-Tool fuer Firmware-Updates unter Linux.

Firmware- und BIOS-Updates waren unter Linux lange eine Qual. Hersteller lieferten ihre Tools nur für DOS oder Windows. Wer ein Update wollte, musste eine Platte ausbauen, Windows installieren, Treiber suchen, Herstellertool laden — für ein Update. So macht das keinen Spaß.

fwupd hat das grundlegend geändert. Ein paar GNOME-Entwickler haben zusammen mit Dell ein einheitliches Update-Framework gebaut. Hersteller müssen sich nicht mehr um Installer und Betriebssystem-Support kümmern — sie stellen ihre Firmware-Images in einem zentralen Repository (LVFS) bereit, und fwupd verteilt sie.

Was kann fwupd?

fwupd aktualisiert BIOS/UEFI, Thunderbolt-Controller, NVMe-Firmware, Intel ME, Netzwerkkarten, Logitech-Empfänger und vieles mehr. Über 1.000 Geräte werden unterstützt. Es läuft als Daemon im Hintergrund, prüft täglich auf neue Updates und kann sie automatisch installieren oder ankündigen. Gnome und KDE bringen grafische Frontends mit, auf der Kommandozeile geht es genauso einfach.

Geräte prüfen

Testgerät: ein Lenovo ThinkPad X1 Carbon. fwupdmgr get-devices zeigt, welche Hardware erkannt und unterstützt wird:

root@errorlap:~# fwupdmgr get-devices
20N588101
│
├─Thunderbolt Controller:
│     Current version:     20.00
│     Vendor:              Lenovo (TBT:0x0109)
│     Device Flags:        • Internal device
│                          • Updatable
│                          • Requires AC power
│                          • Device stages updates
│
├─SAMSUNG MZVLB256HB88-000L7:
│     Summary:             NVM Express Solid State Drive
│     Current version:     4M2QEXH7
│     Vendor:              Samsung Electronics Co Ltd
│     Device Flags:        • Internal device
│                          • Updatable
│
├─System Firmware:
│     Current version:     0.1.65
│     Vendor:              LENOVO
│     Device Flags:        • Updatable
│                          • Needs a reboot after installation
│                          • Cryptographic hash verification is available
│
└─UEFI Device Firmware (3×):
      Current version:     192.64.1551 / 0.1.19 / 1.1.8
      Device Flags:        • Updatable
                           • Needs a reboot after installation

Bei diesem Gerät werden Thunderbolt-Controller, NVMe-SSD, System-Firmware und drei UEFI-Komponenten erkannt. Die Device Flags zeigen Voraussetzungen — zum Beispiel „Requires AC power“ (Netzteil anschließen) und „Needs a reboot“ (Neustart nach dem Update).

Updates suchen und installieren

Zuerst den Firmware-Katalog aktualisieren — fwupd merkt auch selbst, wenn der Datenstand zu alt ist, und bietet das automatisch an:

root@errorlap:~# fwupdmgr refresh --force
Fetching metadata https://cdn.fwupd.org/downloads/firmware.xml.gz
Downloading…             [***************************************]
Successfully downloaded new metadata: 5 local devices supported

Dann fwupdmgr get-updates — hier gab es Updates für die System-Firmware (0.1.65 → 0.1.70, fünf BIOS-Versionen mit Security-Fixes und Bugfixes) und die Intel ME (192.64.1551 → 192.71.1681, unter anderem 16 CVEs). Die Changelogs kommen direkt vom Hersteller über LVFS.

Installation mit fwupdmgr update:

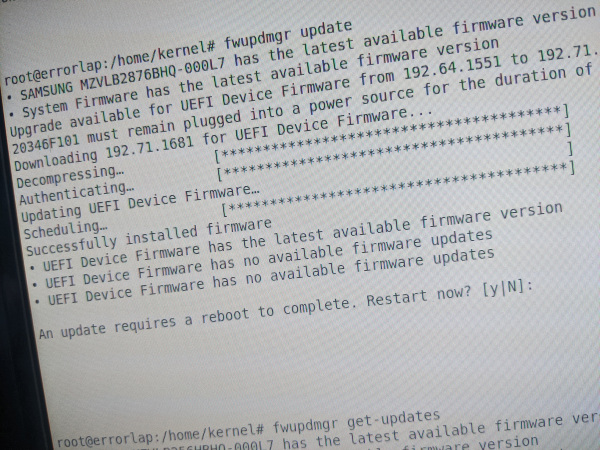
root@errorlap:~# fwupdmgr update
Upgrade available for UEFI Device Firmware from 192.64.1551 to 192.71.1681
20N588101 must remain plugged into a power source for the duration
of the update to avoid damage. Continue with update? [Y|n]: y
Downloading 192.71.1681 for UEFI Device Firmware...
Decompressing…           [***************************************]
Authenticating…          [***************************************]
Updating UEFI Device Firmware…
Scheduling…              [***************************************]
Successfully installed firmware

An update requires a reboot to complete. Restart now? [y|N]:

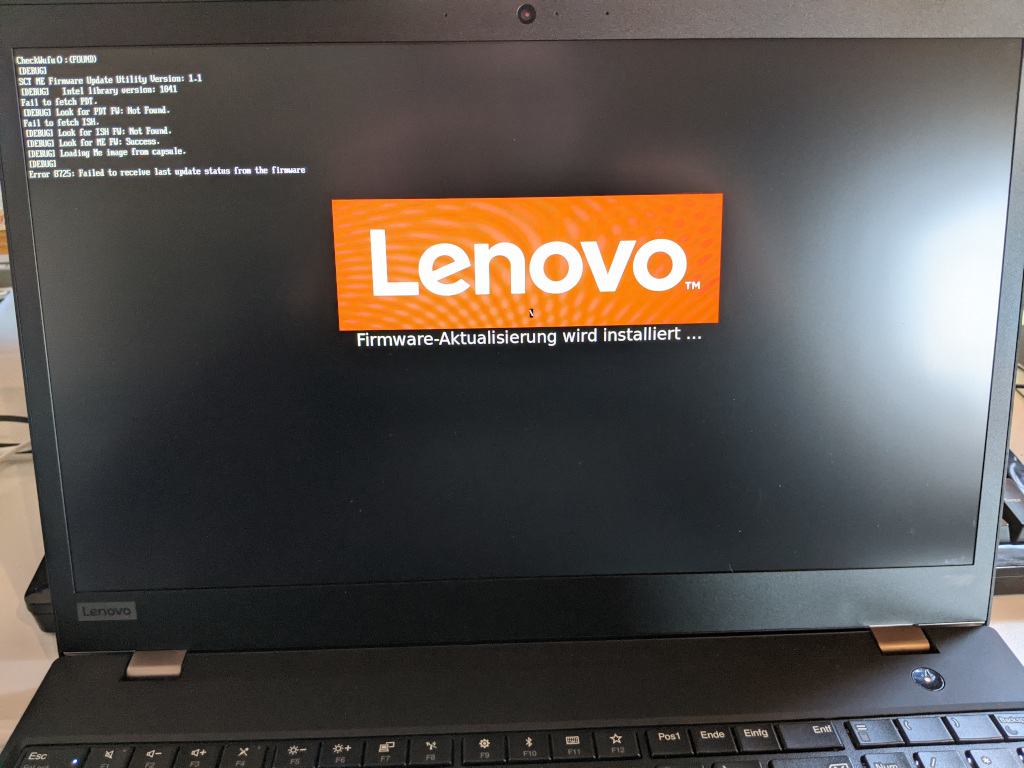
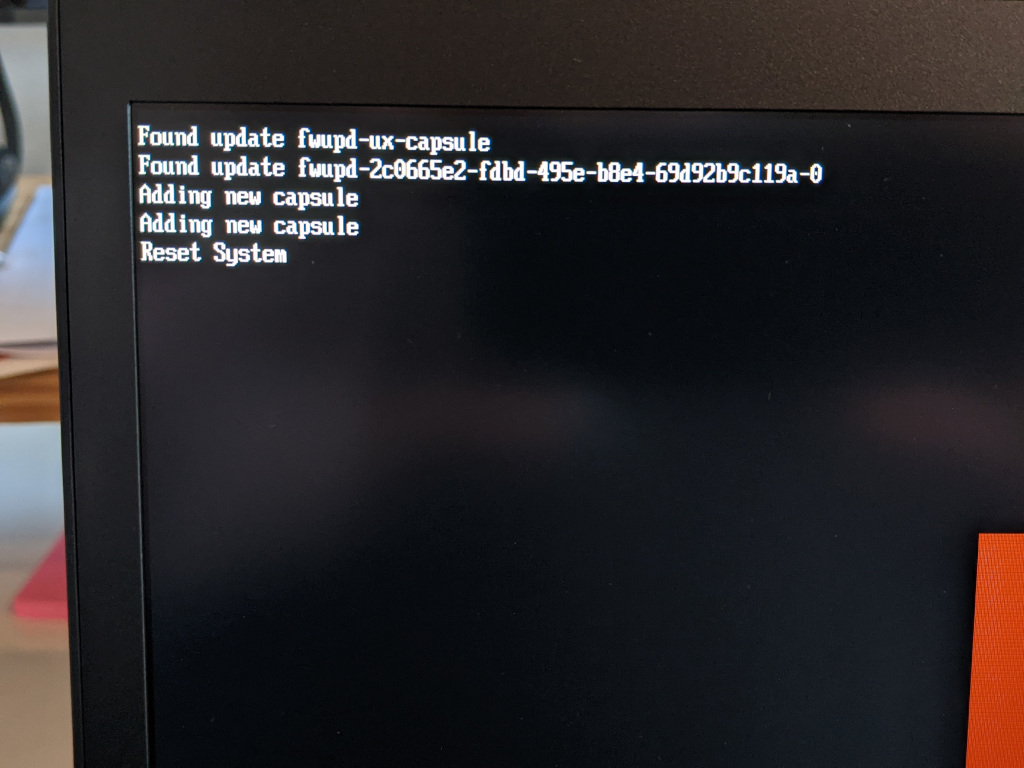
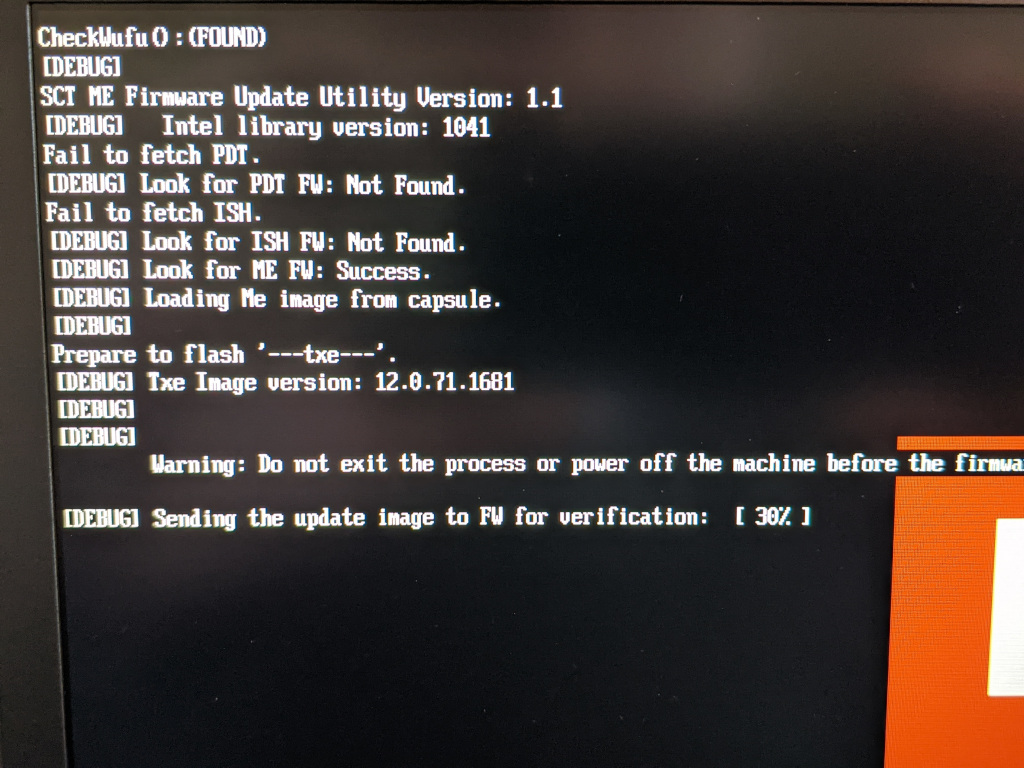
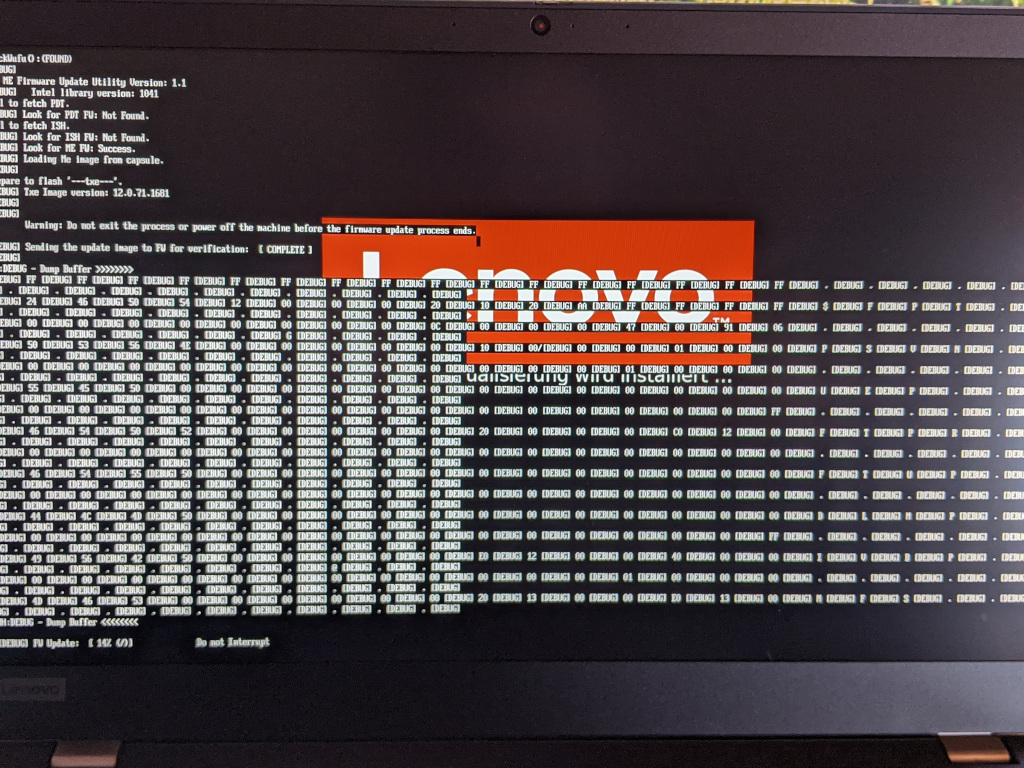
Beim Neustart übernimmt das UEFI — man sieht den Fortschritt auf dem Bildschirm (Fotos unten). Danach die Kontrolle:

root@errorlap:~# fwupdmgr get-updates
Devices that have been updated successfully:
 • System Firmware (0.1.65 → 0.1.70)
 • UEFI Device Firmware (192.64.1551 → 192.71.1681)

Sauber. Beide Updates eingespielt, keine Fehler. fwupd fragt am Ende noch, ob man einen anonymen Report hochladen möchte — das hilft den Herstellern, erfolgreiche und fehlgeschlagene Updates auf realer Hardware zu erkennen.

Was man wissen sollte

fwupd nutzt für BIOS-Updates den UEFI Capsule Update-Mechanismus. Das Firmware-Image wird in die EFI System Partition geschrieben, beim nächsten Boot übernimmt das UEFI die Installation. Dafür braucht das Gerät eine EFI System Partition und ein UEFI, das Capsule Updates unterstützt. Ältere BIOS-only-Systeme oder Hersteller ohne LVFS-Unterstützung fallen raus.

Es steht und fällt mit den Herstellern. Lenovo, Dell, HP und Intel sind gut dabei. Wenn euer Gerät nicht unterstützt wird — kurze Mail an den Hersteller-Support, warum sie nicht mit LVFS zusammenarbeiten. Jede Anfrage hilft.

Für FreeBSD-Nutzer: fwupd wurde 2021 auf der FOSDEM als BSD-Port vorgestellt und läuft mittlerweile auch auf FreeBSD. Die Abdeckung ist noch geringer als unter Linux, aber die Basis steht.

Wer noch Fragen hat — schreibt mir.

Siehe auch:

TRIM für SSDs im ZFS-Pool unter Linux aktivieren

Speicherzellen einer SSD sind nicht unendlich beschreibbar. Damit sie möglichst lange halten, verteilt die interne Logik der SSD Schreibzugriffe gleichmäßig über alle Bereiche — Wear Leveling. Dafür muss die SSD aber wissen, welche Blöcke wirklich frei sind. Diese Information kann sie nur vom Dateisystem bekommen. Genau dafür gibt es TRIM.

Wer sich für TRIM allgemein interessiert — im älteren Beitrag zu TRIM für SSDs und Flash-Speicher steht mehr zu den Grundlagen. Hier geht es nur um ZFS.

autotrim — kontinuierliches TRIM

ZFS kennt die Pool-Eigenschaft autotrim. Wenn aktiviert, schickt ZFS nach jedem Freigeben von Blöcken automatisch TRIM-Befehle an die darunterliegenden Geräte. Prüfen, ob es aktiv ist:

$ zpool get autotrim bpool rpool
NAME   PROPERTY  VALUE  SOURCE
bpool  autotrim  off    local
rpool  autotrim  off    local

Aktivieren:

$ zpool set autotrim=on bpool
$ zpool set autotrim=on rpool

Kontrolle — jetzt sollte on stehen:

$ zpool get autotrim bpool rpool
NAME   PROPERTY  VALUE  SOURCE
bpool  autotrim  on     local
rpool  autotrim  on     local

zpool trim — manuelles TRIM

Neben dem kontinuierlichen autotrim gibt es auch manuelles TRIM. Das ist sinnvoll, wenn man autotrim bisher nicht aktiviert hatte und den Pool einmalig aufräumen will:

$ zpool trim rpool

Der Fortschritt lässt sich mit zpool status -t rpool beobachten. Bei großen Pools kann das eine Weile dauern.

Tipp: SSD-Wartungsmodus

Wenn eine SSD nur am Strom hängt, ohne dass ein Rechner darauf zugreift, fallen viele SSDs in einen internen Wartungs- und Reparaturmodus. Die Firmware sortiert dann selbstständig Speicherzellen um, führt Diagnosen durch und versucht schwache Zellen zu retten. Einfach 2–3 Stunden laufen lassen. Über diesen Weg lassen sich manchmal sogar „tote“ SSDs wiederbeleben. Mit aktivem TRIM funktioniert das alles natürlich deutlich besser.

Hinweis für FreeBSD: autotrim und zpool trim funktionieren dort genauso — FreeBSD nutzt seit langem OpenZFS.

Fragen? Einfach melden.

FreeBSD IPv6-Probleme bei Netcup beheben

Dinosaurier beißt ein Patchkabel durch, im Hintergrund das Buch IPv6 Workshop.

Als Kunde, der bei Netcup FreeBSD-Rootserver auf KVM/QEMU-Basis einsetzt, habe ich schnell gemerkt, dass meine IPv6-Verbindung nicht stabil ist.

Symptome

  • Direkt nach dem Boot funktioniert IPv6 wie gewünscht
  • Nach einiger Zeit brechen Verbindungen zusammen — sowohl eingehend als auch ausgehend
  • Verbindungen haben „Startprobleme“ — ein Ping läuft erst ein paar Mal ins Leere, dann funktioniert plötzlich alles wieder für einen Moment

Ein Ping auf die IPv6-Adresse des Netcup-Gateways stellt die Konnektivität kurzzeitig her. Das deutet sofort auf ein NDP-Problem (Neighbor Discovery Protocol) hin.

Diagnose

FreeBSD behandelt Neighbor Solicitations anders als Linux. Netcups Netzwerk-Setup kommt damit offenbar nicht klar — unter Linux funktioniert IPv6 problemfrei, unter FreeBSD (und NetBSD) nicht. Die ICMPv6-Statistiken zeigen das Problem deutlich:

netstat -s -picmp6 | grep -i neighbor
    neighbor solicitation: 29          # Output: wenige eigene Anfragen
    neighbor advertisement: 10         # Output: wenige eigene Antworten
    neighbor solicitation: 633         # Input: Flut eingehender Anfragen
    neighbor advertisement: 25         # Input: wenige Antworten zurück
    423 bad neighbor solicitation messages  # <-- das Problem

633 eingehende Neighbor Solicitations, davon 423 als „bad" verworfen. FreeBSD verwirft die Anfragen, weil sie nicht von einer On-Link-Adresse kommen — ein Verhalten, das FreeBSD aus Sicherheitsgründen seit einem Security Advisory von 2008 erzwingt.

Lösung

FreeBSD anweisen, Neighbor Discovery nach RFC 4861 zu machen — das akzeptiert auch Solicitations von Off-Link-Adressen, wie es Netcups Router sendet. Zum Testen:

sysctl net.inet6.icmp6.nd6_onlink_ns_rfc4861=1

Funktioniert es, den Eintrag in /etc/sysctl.conf permanent machen:

net.inet6.icmp6.nd6_onlink_ns_rfc4861=1

Wichtig: FreeBSD hat dieses Verhalten aus Sicherheitsgründen deaktiviert. Die strenge Prüfung schützt gegen NDP-Spoofing-Angriffe. Auf einem VPS bei einem vertrauenswürdigen Hoster ist das Risiko überschaubar — auf einem System in einem offenen Netzwerk sollte man abwägen.

Netcup-Support

Ich habe einige Zeit mit dem Support verbracht. Das Problem wurde mir bestätigt — es liege an den Core-Routern, ein Update sei geplant, aber ohne Termin. Mein System wurde auf verschiedene Hosts verschoben, ohne Besserung. Das Problem ist im Netcup-Forum bekannt und betrifft alle BSD-Systeme. Aus meiner Sicht lässt Netcups Setup keine einfache Lösung zu, daher bleibt der sysctl-Workaround.

Siehe auch: IPv6 ULA und Priorität

Fragen? Einfach melden.

« Ältere Beiträge Neuere Beiträge »

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑