IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: MailServer (Seite 1 von 7)

RFC 9989 löst RFC 7489 ab: was sich für DMARC wirklich ändert

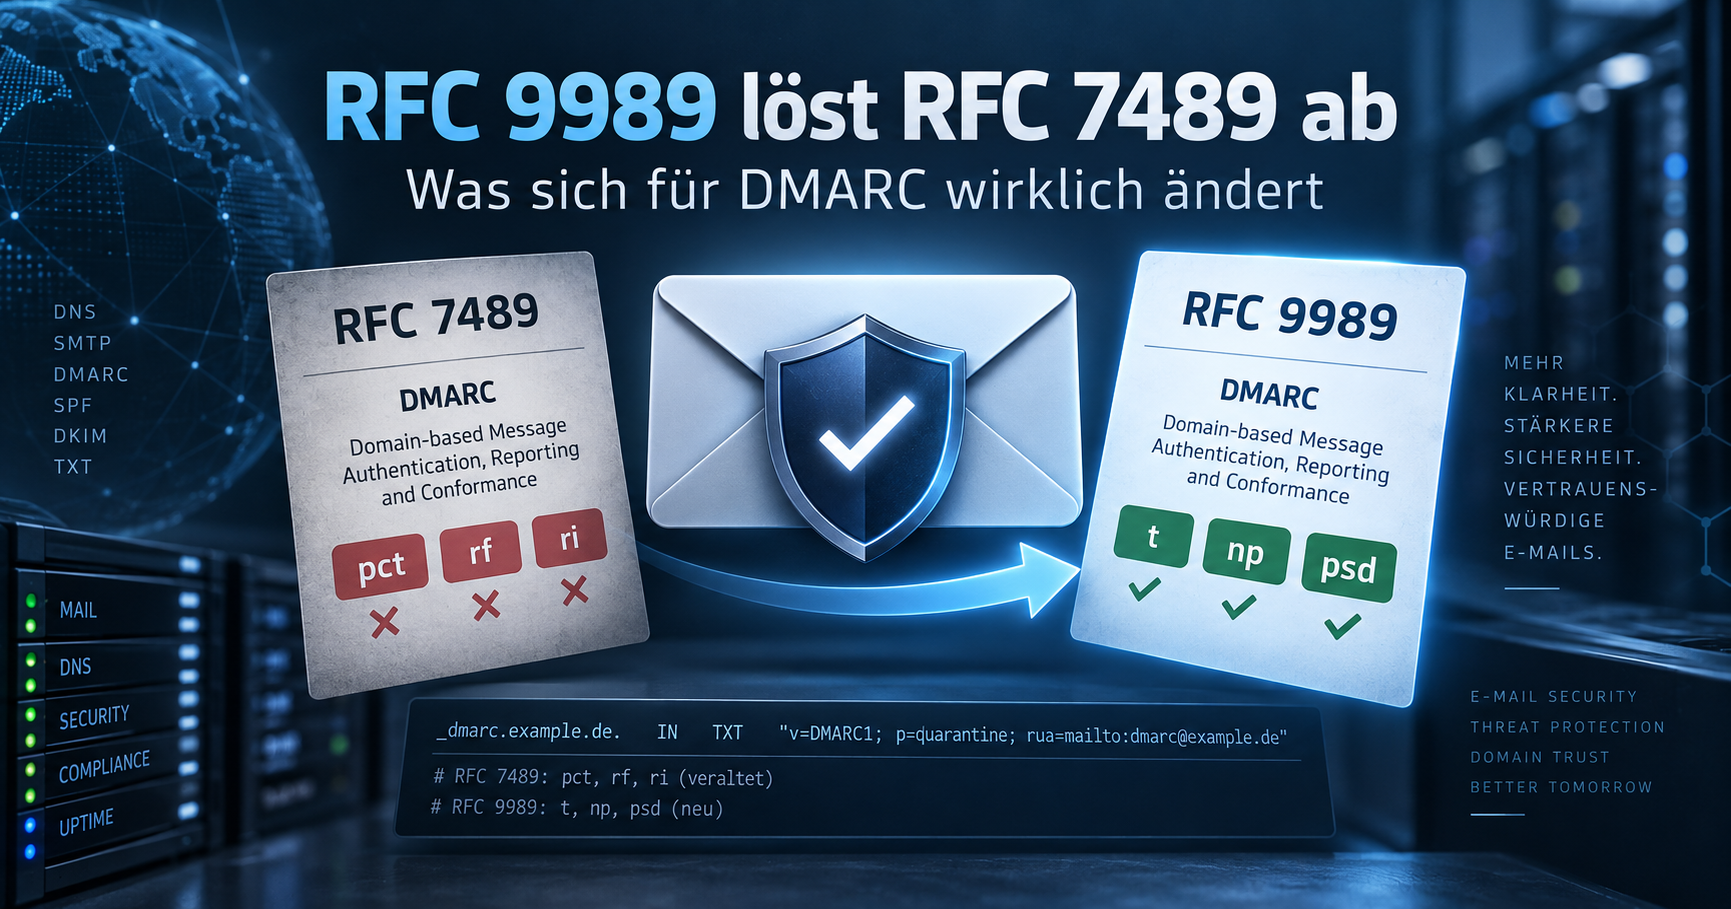
Beitragsbild zu RFC 9989 und DMARC, Vergleich mit RFC 7489, neuen DMARC-Tags und E-Mail-Sicherheitsdarstellung

Stefan Haun von cyberscale.io hat mir per Mail einen Hinweis geschickt: mein alter Beitrag zu DMARC bezieht sich auf RFC 7489, das seit Mai 2026 durch RFC 9989 abgelöst ist. Der Hinweis kam, so fühlt es sich für mich an, ggf. im Rahmen von Linkbuilding, mit Verweis auf seinen eigenen Guide zu DKIM und DMARC. Das schmälert die fachliche Korrektheit des Hinweises nicht, deshalb hier der ehrliche Dank und der längst überfällige Nachtrag. Mitbekommen hatte ich die neue RFC schon vor einer Weile, geschrieben aber noch nichts, weil es bei einem frischen RFC erstmal eine Zeit braucht, bis sich das in der Praxis herumspricht und Implementierungen nachziehen. Genau dieser Verzug taucht unten beim Praxis-Check nochmal auf.

Was RFC 9989 überhaupt ist

In der Community läuft das Projekt unter dem Namen DMARCbis. Anders als der Name vermuten lässt, ist daraus keine einzelne neue RFC geworden, sondern drei:

  • RFC 9989, die Kernspezifikation: Policy, Alignment, die Tags im Record.
  • RFC 9990, die aggregierten Reports, also die täglichen XML-Berichte.
  • RFC 9991, die Failure Reports, das ARF-Format pro Nachricht.

Alle drei tragen offiziell „Obsoletes: 7489“ im Kopf, RFC 9989 zusätzlich noch „Obsoletes: 9091“ (der 2021 veröffentlichte, experimentelle Vorläufer, der np und die Public-Suffix-Domain-Idee einführte und dessen Inhalt RFC 9989 jetzt vollständig integriert und ersetzt). Dazu ein Reifegrad-Sprung, der eine eigene Erwähnung wert ist: RFC 7489 war „Informational“, RFC 9989 ist „Standards Track“, also auf dem offiziellen Weg zum Internet Standard. DMARC verlässt damit den Status der informellen Beschreibung eines etablierten Verfahrens und wird zu einer echten IETF-Spezifikation.

Die Tags: drei raus, drei gegenüber RFC 7489 neu

Der eigentliche technische Kern steckt in der Menge der Policy-Tags im Record. Drei Tags sind aus der aktiven Spezifikation gestrichen (in der IANA-Registry stehen sie weiterhin, nur als historic markiert), drei sind gegenüber RFC 7489 neu, wobei np davon eigentlich ein Wiedersehen ist:

Entfernt (RFC 7489)Neu gegenüber RFC 7489 (RFC 9989)
pct, Prozent-Rollout der Policyt, expliziter Test-Modus
rf, Report-Format, quasi nie genutztnp, Policy für nicht existierende Subdomains, importiert aus RFC 9091
ri, Report-Intervall, von Empfängern ignoriertpsd, Public-Suffix-Domain-Flag

rf und ri werden von einem RFC-9989-konformen Empfänger nicht mehr ausgewertet, RFC 9989 selbst nennt für die Streichung keine ausführlichere Begründung als das Fehlen praktischer Relevanz. pct ist der interessantere Fall, dazu gleich mehr.

t: der Testmodus, der pct ersetzt

t=n ist der Default und bedeutet normale Durchsetzung. t=y setzt die in p, sp oder np konfigurierte Policy eine Stufe herab: aus reject wird quarantine, aus quarantine wird none. Reports laufen dabei unverändert weiter, man sieht also weiterhin, wer durchfallen würde. RFC 9989 selbst nennt t ausdrücklich nur einen Ersatz für einen Teil der alten pct-Funktionalität, nämlich für die beiden Randwerte: t=n und t=y sollen sich bei Empfängern und Zwischenstationen analog zu pct=100 und pct=0 verhalten, nicht zu jedem beliebigen Prozentwert dazwischen. pct=0 unter RFC 7489 führte nach Abschnitt 6.6.4 bei reject ebenfalls schon zu quarantine statt zu gar keiner Reaktion, t=y übernimmt diesen einen Spezialfall, nur ohne Prozentrechnung. Für einen echten Teil-Rollout mit Werten zwischen 0 und 100 gibt es dagegen keinen direkten Nachfolger, dazu unten mehr.

np: eine eigene Stufe für nicht existierende Subdomains

Unter RFC 7489 galt für Mail von einer Subdomain, egal ob sie einen eigenen DNS-Eintrag hat oder nicht, immer dieselbe Regel: sp, falls gesetzt, sonst p. Eine Subdomain, die gar nicht existiert, zum Beispiel irgendwas.example.com, wo irgendwas nie angelegt wurde, bekam also exakt dieselbe Policy wie eine echte, konfigurierte Subdomain. Genau das ist ein bekanntes Spoofing-Einfallstor, weil sich beliebige, nie existierende Namen fälschen lassen, für die es nie eine eigene Policy gab. np schafft jetzt erstmals eine eigene, von sp und p unterscheidbare Stufe genau für diesen Fall. Neu erfunden ist das Tag dabei nicht: RFC 9989 übernimmt es wörtlich aus dem 2021 veröffentlichten, experimentellen RFC 9091, das mit RFC 9989 ebenfalls obsolet wird, und macht daraus einen festen Bestandteil der Hauptspezifikation. Fehlt np weiterhin, fällt die Regel auf sp zurück, falls gesetzt, sonst auf p, genau wie in RFC 9989 Abschnitt 4.7 definiert. Wer schon vorher ein striktes sp=reject gesetzt hatte, bekommt also weiterhin exakt das gleiche Verhalten wie zuvor, nur jetzt mit der Möglichkeit, es bei Bedarf davon zu lösen.

DNS-Tree-Walk statt Public Suffix List, psd markiert die Grenze

Die eigentliche Änderung ist strukturell: RFC 9989 löst die Bestimmung der Organizational Domain von der statischen, extern gepflegten Public Suffix List und ersetzt sie durch einen DNS-Tree-Walk-Algorithmus. psd (Werte y, n, u, Default u) liefert dafür die expliziten Grenzmarkierungen: psd=y setzt ein Public Suffix Operator auf seinem eigenen Record, um zu sagen, dass darunter fremde, eigenständige Organizational Domains beginnen, psd=n sagt umgekehrt, dass genau diese Domain die Organizational Domain für sich und ihre Subdomains ist. Relevant ist das vor allem für Registries und Hoster, die selbst öffentlich registrierbare Second-Level-Domains betreiben, also Strukturen wie bei .co.uk. RFC 9989 weist ausdrücklich darauf hin, dass Public-Suffix-List-Auflösung und Tree-Walk in Einzelfällen zu unterschiedlichen Ergebnissen kommen können. Für eine gewöhnliche Domain wie diese hier, ohne PSO-Rolle, ändert sich am eigenen Verhalten dadurch nichts.

Macht das bestehende Records ungültig? Nein, by design, mit einer Ausnahme in beide Richtungen

DMARC trägt seit RFC 7489 die Regel, dass unbekannte Tags ignoriert werden müssen. RFC 9989 übernimmt das wörtlich und baut die ganze Abwärtskompatibilität darauf auf. Ein alter, nur RFC-7489-konformer Validator, der t oder np nicht kennt, überliest sie einfach und wendet weiterhin p und sp an. Er stürzt dabei nicht ab und verhält sich nicht falsch, er kennt nur die feinere neue Steuerung noch nicht. Das hat aber eine Kehrseite, die man beim Einsatz von t=y kennen sollte: genau derselbe alte Validator ignoriert auch t=y und wendet bei p=reject weiterhin reject in voller Härte an. t=y schützt also nur gegenüber Empfängern, die RFC 9989 bereits verstehen, nicht gegenüber alten Implementierungen. Umgekehrt ignoriert ein RFC-9989-konformer Validator ein vorhandenes pct, weil das Tag schlicht nicht mehr definiert ist.

Genau an dieser Stelle steckt die Nuance, die wehtun kann: wer noch mit pct zwischen 1 und 99 einen echten Teil-Rollout fährt, das klassische schrittweise Hochfahren auf reject mit einem Bruchteil der Nachrichten, bekommt bei einem RFC-9989-konformen Empfänger keine reduzierte Durchsetzung mehr. Das Tag wird ignoriert, die volle in p konfigurierte Policy greift sofort. Einen direkten Nachfolger für genau diesen Zwischenbereich gibt es nicht, t kennt nur an und aus. Wer so einen Teil-Rollout fährt, muss stattdessen auf eine echte Stufenmigration ausweichen, etwa p=none, dann p=quarantine, dann p=reject, mit t=y jeweils als zusätzliche Bremse innerhalb einer Stufe. Nur der Randfall pct=0 hat mit t=y einen echten, direkten Ersatz. Für alle anderen gilt: bestehende v=DMARC1-Records bleiben syntaktisch gültig, niemand muss etwas ändern, um funktionsfähig zu bleiben. Weitgehend kompatibel ist die richtige Beschreibung, additiv dagegen nicht ganz, weil eben doch drei Tags aus der aktiven Auswertung verschwinden und die Organizational-Domain-Bestimmung sich strukturell ändert.

Mailinglisten und die p=reject-Warnung

Abschnitt 7.4 rät Domains, deren Nutzer möglicherweise auf öffentlichen Mailinglisten schreiben, ausdrücklich von p=reject ab. Der Grund ist alt und in RFC 7960 im Detail beschrieben: Listen-Reflektoren brechen die SPF-Alignment, weil die Mail über einen fremden Server läuft, und selbst DKIM-Signaturen überleben nicht jede Listen-Software unverändert. Der konkrete, im RFC-Text selbst genannte Weg ist eine gestufte Migration: zuerst mindestens einen Monat p=none, dann mindestens ebenso lange p=quarantine, jeweils mit Auswertung der Reports, bevor überhaupt über p=reject nachgedacht wird. t=y wird an dieser Stelle im RFC nicht namentlich erwähnt, würde sich als zusätzliche Bremse innerhalb einer Stufe aber inhaltlich genauso eignen wie der frühere pct-Ansatz, das ist an dieser Stelle meine eigene Einordnung, keine RFC-Vorgabe. Wichtig zusätzlich, weil es die Wucht von p=reject etwas relativiert: RFC 9989 verpflichtet Empfänger, nicht allein aufgrund eines p=reject abzulehnen, und schreibt vor, einen DMARC-Fail ohne weitere eigene Erkenntnisse wie quarantine zu behandeln.

RFC 9990: DKIM-Ergebnisse und der Selector werden verbindlicher

In den regelmäßigen, in der Praxis meist täglichen aggregierten XML-Reports war das DKIM-Auth-Ergebnis unter RFC 7489 eher beiläufig spezifiziert. RFC 9990 macht daraus eine klare Pflicht, allerdings nur bedingt: wurde für eine Nachricht überhaupt eine DKIM-Signatur validiert, muss das Ergebnis im Report stehen, eine komplett unsignierte Nachricht braucht weiterhin kein eigenes DKIM-Element. Neu und für die Praxis besonders nützlich ist zusätzlich, dass der verwendete Selector jetzt ebenfalls verpflichtend im Report steht, unter RFC 7489 war er optional. Damit lässt sich aus den Reports direkt ablesen, welcher Selector bei welchem berichtenden Mail-Receiver (nicht) verifiziert, was Diagnosen bei DKIM-Key-Rotationen deutlich erleichtert.

RFC 9991: Failure Reports und die Datenschutzfrage

Das ARF-Format für die einzelnen Failure Reports ist nicht neu, das nutzte schon RFC 7489. Neu ist, dass RFC 9991 dieses Thema aus der Kernspezifikation herauslöst, in eine eigene RFC packt und dabei ein altbekanntes Problem konkreter adressiert: Failure Reports können personenbezogene Daten enthalten, Empfängeradressen und im schlechtesten Fall Teile des Mail-Inhalts. Genau deshalb liefern nach eigener Beobachtung viele große Empfänger schon seit Jahren kaum bis gar keine ruf-Reports aus, RFC 9991 selbst schreibt, dass die Datenschutzbedenken viele Betreiber dazu gebracht haben, den Einsatz von Failure Reports einzuschränken. RFC 9991 bringt jetzt konkrete Redaction-, Datenminimierungs- und Transport-Security-Empfehlungen mit, formuliert als starke Empfehlung, nicht als Pflicht oder Garantie. Ob das in der Praxis tatsächlich mehr Empfänger dazu bringt, ruf überhaupt zu bedienen, bleibt abzuwarten, ein Schritt in die richtige Richtung ist es trotzdem.

Praxis-Check an den eigenen sechs Domains

Live abgefragt mit dig +short TXT _dmarc.<domain>, Stand heute:

kernel-error.de:        v=DMARC1; p=reject; rua=mailto:postmaster@kernel-error.de; ruf=mailto:postmaster@kernel-error.de; fo=1; sp=reject; aspf=s;
kernel-error.com:       (identisch)
kernel-error.org:       (identisch)
vandemeer.de:           (identisch)
fuchs-meckenheim.de:    (identisch)
heidbreders.de:         (identisch)

Drei Beobachtungen dazu. Erstens: pct=100 stand ursprünglich noch auf allen sechs Records, ein Überbleibsel aus der Zeit vor dem eigentlich gewünschten vollen Rollout, dazu weder rf noch ri. Weil überall ohnehin die volle Durchsetzung gewollt war und kein Teil-Rollout lief, war die neue Bedeutungslosigkeit von pct genau der Anlass, das Tag von allen sechs Records ersatzlos zu streichen, kein Muss, aber ein guter Moment dafür.

Zweitens: heidbreders.de stand bislang als einzige der sechs Domains auf sp=none, die anderen fünf auf sp=reject. Beim Aufräumen gleich vereinheitlicht, jetzt tragen alle sechs sp=reject. np explizit zu setzen würde am eigenen Verhalten trotzdem nichts ändern, weil der Default, der Rückfall auf sp, für alle sechs Domains ohnehin schon reject ist. Es besteht kein Handlungsbedarf, ein expliziterer Record wäre höchstens Geschmackssache.

Drittens, und das ist der Punkt, der zur eingangs erwähnten Adoptionsverzögerung passt: rspamd, hier in Version 4.1.0 der eigene DMARC-Validator für eingehende Mail, unterstützt np nach aktuellem Stand von September 2026 noch nicht. Bekommt der eigene Filter eine gespoofte Mail von einer nicht existierenden Subdomain einer fremden Marke, deren Domain-Owner über np strenger sein wollte als über sp, wendet rspamd aktuell trotzdem die laxere sp-Policy an. Eine kleine, aber reale Lücke auf der Empfänger-Seite, bis rspamd nachzieht. Vier Monate nach Publikation der RFC haben ohnehin die wenigsten Absender-Domains np überhaupt gesetzt, akuten Grund zur Sorge gibt das nicht, einen Blick in die rspamd-Release-Notes aber schon.

Die Frage aus Abschnitt 7.4 ist dabei nicht, ob ich selbst eine Mailingliste betreibe, sondern ob Absender meiner Domains an fremden Mailinglisten oder ähnlichen indirekten Mail-Flows teilnehmen. Bei mir ist das praktisch nicht der Fall, für die eigene Infrastruktur bleibt die gestufte Migration also Theorie. Für Leser mit Nutzern, die auf Mailinglisten schreiben, ist sie es sehr wohl.

Kurzfassung: Kein akuter Handlungsbedarf für Domains mit bestehendem p=reject und pct=100. Wer noch einen Teil-Rollout mit einem pct-Wert zwischen 1 und 99 fährt, findet in t keinen direkten Ersatz und muss auf eine echte Stufenmigration über p ausweichen, nur der Randfall pct=0 lässt sich eins zu eins durch t=y ersetzen. np ist ein sinnvolles Sicherheits-Add-on, dessen Wirkung von der Update-Geschwindigkeit der empfängerseitigen Implementierungen abhängt, ein gutes Beispiel dafür, dass ein neues RFC nicht am Tag der Veröffentlichung live ist, sondern über Monate und Jahre durch Software-Updates bei allen Beteiligten durchsickert.

Siehe auch

Eigene Erfahrungen mit der Umstellung auf RFC 9989, oder Fragen zu DMARC allgemein? Dann darfst du mich sehr gerne fragen.
Post-Quantum TLS für E-Mail — Postfix und Dovecot mit X25519MLKEM768 auf FreeBSD 15

Visualisierung hybrider Post-Quantum-TLS-Verschlüsselung für E-Mail mit X25519MLKEM768 (ML-KEM-768 + X25519) auf Postfix und Dovecot unter FreeBSD 15

Siehe auch: Post-Quantum TLS für Nginx — X25519MLKEM768 auf FreeBSD 15 konfigurieren

Nachdem ich im letzten Beitrag OpenSSH mit hybriden Post-Quantum-Algorithmen abgesichert habe, lag die Frage nahe: Was ist eigentlich mit E-Mail? Mein FreeBSD 15 liefert Postfix 3.10.6, Dovecot 2.3.21.1 und OpenSSL 3.5.4 – und genau diese Kombination bringt alles mit, was man für quantensichere Verschlüsselung im Mailverkehr braucht. Ohne zusätzliche Pakete, ohne Patches, ohne Gefrickel.

Warum überhaupt PQC für E-Mail?

Das „Store now, decrypt later„-Szenario, das ich beim SSH-Beitrag angesprochen habe, trifft auf E-Mail mindestens genauso zu. E-Mails werden über SMTP zwischen Servern transportiert – und dieser Transport ist grundsätzlich abfangbar. Wer heute TLS-verschlüsselten Mailverkehr mitschneidet und archiviert, könnte diesen in einigen Jahren mit einem ausreichend leistungsfähigen Quantencomputer entschlüsseln. Zumindest theoretisch.

Heißt das, morgen liest jemand eure Mails? Nein. Aber wenn ihr vertrauliche Kommunikation betreibt und die heute eingesetzte Kryptografie in zehn Jahren noch standhalten soll, ist jetzt der richtige Zeitpunkt zum Handeln. Zumal der Aufwand (wie ihr gleich seht) überschaubar ist.

Was steckt hinter X25519MLKEM768?

Kurz zur Einordnung: ML-KEM (ehemals CRYSTALS-Kyber) ist der vom NIST im August 2024 standardisierte Post-Quantum-Algorithmus für den Schlüsselaustausch (FIPS 203). X25519MLKEM768 ist ein sogenannter Hybrid-Algorithmus – er kombiniert das klassische X25519 (Curve25519 ECDH) mit ML-KEM-768 zu einem gemeinsamen Schlüssel.

Der Clou dabei: Selbst wenn ML-KEM irgendwann gebrochen werden sollte, bleibt die klassische X25519-Komponente intakt. Und umgekehrt. Man muss also nicht darauf vertrauen, dass der neue Algorithmus auch wirklich hält – man bekommt das Beste aus beiden Welten.

Wer Firefox nutzt, hat das übrigens vermutlich schon in Aktion gesehen: Seit Firefox 124 wird bei TLS 1.3 standardmäßig X25519MLKEM768 für den Schlüsselaustausch verwendet. Schaut mal in die Verbindungsdetails einer HTTPS-Seite – die Chancen stehen gut, dass dort bereits ein hybrider PQC-Schlüsselaustausch stattfindet. Also, wenn der Server das anbietet, wie dieser hier *zwinker*.

Voraussetzungen prüfen

Bevor ihr konfiguriert, solltet ihr sicherstellen, dass euer OpenSSL ML-KEM überhaupt kann. Auf meinem FreeBSD 15:

$ openssl version
OpenSSL 3.5.4 30 Sep 2025 (Library: OpenSSL 3.5.4 30 Sep 2025)

Und dann die entscheidende Frage – kennt OpenSSL die benötigten KEM-Algorithmen?

$ openssl list -kem-algorithms | grep -i mlkem
  ML-KEM-512
  ML-KEM-768
  ML-KEM-1024
  X25519MLKEM768
  SecP256r1MLKEM768

Wenn X25519MLKEM768 in der Liste auftaucht, seid ihr startklar. Das ist bei OpenSSL ab Version 3.5 der Fall – der ML-KEM-Support ist im Default-Provider enthalten, es wird kein zusätzlicher OQS-Provider und kein liboqs benötigt.

Noch ein Check – sind die Algorithmen auch als TLS-Gruppen verfügbar?

$ openssl list -tls-groups | grep -i mlkem
  X25519MLKEM768
  SecP256r1MLKEM768
  SecP384r1MLKEM1024

Perfekt. Weiter geht’s.

Postfix konfigurieren

Postfix steuert die verwendeten TLS-Gruppen für den Schlüsselaustausch über den Parameter tls_eecdh_auto_curves. Dieser gilt sowohl für eingehende (smtpd) als auch für ausgehende (smtp) Verbindungen.

Vorher:

tls_eecdh_auto_curves = X25519, prime256v1, secp384r1

Nachher:

tls_eecdh_auto_curves = X25519MLKEM768, X25519, prime256v1, secp384r1

Das war’s. Eine Zeile. X25519MLKEM768 wird als bevorzugte Gruppe an den Anfang gestellt, die klassischen Kurven bleiben als Fallback erhalten. Clients die kein ML-KEM beherrschen, verhandeln einfach X25519 oder prime256v1 – die Abwärtskompatibilität bleibt also vollständig gewahrt.

Die Änderung setzt ihr entweder direkt in /usr/local/etc/postfix/main.cf oder über:

# postconf "tls_eecdh_auto_curves = X25519MLKEM768, X25519, prime256v1, secp384r1"
# postfix reload

Wichtig: Dieser Parameter beeinflusst alle Postfix-Dienste – SMTP (Port 25), Submission (Port 587) und SMTPS (Port 465). Ihr müsst also nicht jeden Port einzeln konfigurieren.

Update 01.04.2026: Die oben gezeigte globale Methode über main.cf hat einen Haken, den ich erst später auf der Postfix-Users Mailingliste realisiert habe. Die korrigierte Konfiguration mit getrennten Einstellungen für Inbound und Outbound findet ihr weiter unten im Nachtrag.

Dovecot konfigurieren

Dovecot verwendet den Parameter ssl_curve_list um die TLS-Gruppen für IMAP-Verbindungen festzulegen. Standardmäßig ist dieser leer, was bedeutet, dass OpenSSL seine eigenen Defaults verwendet. Das kann funktionieren, muss aber nicht.

In /usr/local/etc/dovecot/conf.d/10-ssl.conf:

ssl_curve_list = X25519MLKEM768:X25519:prime256v1:secp384r1

Achtung: Dovecot verwendet Doppelpunkte als Trennzeichen (OpenSSL-Syntax), Postfix verwendet Kommas. Nicht verwechseln. Ja, passiert mir oft.

Danach:

# doveadm reload

Überprüfen

Jetzt wird’s spannend. Funktioniert es tatsächlich? Zum Testen verwende ich openssl s_client direkt auf dem Server; denn euer lokales Linux oder macOS hat möglicherweise noch kein OpenSSL 3.5 mit ML-KEM-Support. Mein Linux Mint 22.3 hat es leider noch nicht *schnief*

SMTP (Port 25, STARTTLS):

$ openssl s_client -connect smtp.kernel-error.de:25 -starttls smtp \
    -groups X25519MLKEM768 -brief </dev/null 2>&1 | grep -E 'Protocol|group'
Protocol version: TLSv1.3
Negotiated TLS1.3 group: X25519MLKEM768

SMTPS (Port 465):

$ openssl s_client -connect smtp.kernel-error.de:465 \
    -groups X25519MLKEM768 -brief </dev/null 2>&1 | grep -E 'Protocol|group'
Protocol version: TLSv1.3
Negotiated TLS1.3 group: X25519MLKEM768

Submission (Port 587, STARTTLS):

$ openssl s_client -connect smtp.kernel-error.de:587 -starttls smtp \
    -groups X25519MLKEM768 -brief </dev/null 2>&1 | grep -E 'Protocol|group'
Protocol version: TLSv1.3
Negotiated TLS1.3 group: X25519MLKEM768

IMAPS (Port 993):

$ openssl s_client -connect imap.kernel-error.de:993 \
    -groups X25519MLKEM768 -brief </dev/null 2>&1 | grep -E 'Protocol|group'
Protocol version: TLSv1.3
Negotiated TLS1.3 group: X25519MLKEM768

Alle vier Ports verhandeln TLSv1.3 mit X25519MLKEM768. Die hybride Post-Quantum-Verschlüsselung ist aktiv.

Wenn ihr testen wollt, was passiert wenn ein Client kein ML-KEM unterstützt:

$ openssl s_client -connect imap.kernel-error.de:465 \
    -groups X25519 -brief </dev/null 2>&1 | grep -E 'Protocol|group'
Protocol version: TLSv1.3
Negotiated TLS1.3 group: X25519

Fallback auf X25519 – funktioniert sauber.

Was das nicht leistet

Wie schon beim SSH-Beitrag muss ich auch hier einschränken: Wir sichern damit den Schlüsselaustausch ab, nicht die Authentifizierung. Die TLS-Zertifikate verwenden weiterhin klassische Algorithmen (RSA, ECDSA). Für Post-Quantum-Signaturen in Zertifikaten bräuchte man ML-DSA (ehemals CRYSTALS-Dilithium) – und obwohl OpenSSL 3.5 das theoretisch unterstützt, gibt es Stand heute keine öffentliche Zertifizierungsstelle, die ML-DSA-Zertifikate ausstellt. Das wird kommen, ist aber noch Zukunftsmusik. Hey, wie ECDSA bei S/MIME (oder ist das schon anders?).

Für die Praxis bedeutet das: Ein Angreifer mit einem Quantencomputer könnte theoretisch die Serverauthentifizierung angreifen (ECDSA/RSA brechen), müsste das aber in Echtzeit tun – hier greift „store now, decrypt later“ nicht, weil eine gefälschte Authentifizierung nur im Moment der Verbindung nützt. Der Schlüsselaustausch hingegen – und damit die eigentliche Vertraulichkeit der transportierten E-Mails – ist durch X25519MLKEM768 auch gegen zukünftige Quantenangriffe geschützt.

Nachtrag (01.04.2026): Inbound und Outbound trennen

Ich muss die Postfix-Konfiguration oben korrigieren. Der Parameter tls_eecdh_auto_curves gilt für SMTP-Client und SMTP-Server gleichzeitig. Steht X25519MLKEM768 an erster Stelle, wird der PQC Key-Share direkt im initialen ClientHello mitgeschickt. Das bläht den ClientHello von rund 400 auf über 1400 Bytes auf.

Klingt erstmal harmlos. Ist es aber nicht. Manche Zielserver kommen mit dem übergroßen ClientHello nicht klar, der TLS-Handshake scheitert. Bei smtp_tls_security_level = may fällt Postfix dann stillschweigend auf Plaintext zurück. Dasselbe passiert bei dane ohne TLSA-Records, also bei der Mehrheit aller Domains da draußen. Eure Mails gehen raus, aber unverschlüsselt. Super.

Das Problem ist, dass hier zwei unterschiedliche Policies in einem Parameter stecken. Inbound will man PQC bevorzugen, weil man selbst kontrolliert was der Server akzeptiert. Outbound will man Kompatibilität priorisieren, weil man nicht weiß was auf der anderen Seite steht. Die gehören nicht in einen globalen Parameter.

Die Lösung: tls_eecdh_auto_curves nicht mehr global in main.cf setzen, sondern per master.cf pro Dienst überschreiben.

Server-Seite (Inbound) – PQC bevorzugen, an allen smtpd-Listenern:

smtp      inet  n       -       n       -       -       smtpd
  -o tls_eecdh_auto_curves=X25519MLKEM768,X25519,prime256v1,secp384r1

submission inet n       -       n       -       -       smtpd
  -o tls_eecdh_auto_curves=X25519MLKEM768,X25519,prime256v1,secp384r1

smtps     inet  n       -       n       -       -       smtpd
  -o tls_eecdh_auto_curves=X25519MLKEM768,X25519,prime256v1,secp384r1

Client-Seite (Outbound) – kleiner ClientHello, PQC nur via HelloRetryRequest:

smtp      unix  -       -       n       -       -       smtp
  -o tls_eecdh_auto_curves=X25519,X25519MLKEM768,prime256v1,secp384r1

Der Trick: Outbound steht X25519 an erster Stelle. Der initiale ClientHello bleibt damit klein. X25519MLKEM768 steht trotzdem in den supported_groups und wird verhandelt, wenn der Zielserver per HelloRetryRequest nachzieht. Inbound bekommen moderne Clients dagegen sofort PQC.

Dovecot ist davon nicht betroffen. Da gibt es nur die Server-Seite, ssl_curve_list bleibt wie oben beschrieben.

Noch ein Wort zum Postfix-Default: postconf -d zeigt auf meinem 3.10.6 kein X25519MLKEM768 im Default. Die postconf(5)-Doku beschreibt zwar für neuere Builds ein Delayed-Key-Share-Verhalten, aber was die Doku beschreibt und was ein konkreter Build tut, können zwei verschiedene Dinge sein. Deshalb die explizite Trennung per master.cf. Danke an die Postfix-Users Mailingliste für die Diskussion, die mich auf dieses Problem aufmerksam gemacht hat und selbstverständlich an den Kommentierenden!

Zwei Zeilen Konfiguration, ein Reload pro Dienst – und euer Mailserver verhandelt quantensichere Verschlüsselung. Okay, es sind jetzt ein paar mehr Zeilen als ursprünglich versprochen. Aber die Trennung zwischen Inbound und Outbound ist es wert, denn blind auf Kompatibilität aller Zielserver zu hoffen ist keine Strategie.

Update 01.05.2026: Mit Postfix 3.11.1 (FreeBSD 15.0-RELEASE-p7) und OpenSSL 3.5 sind sowohl die main.cf-Variante als auch dieser master.cf-Workaround Geschichte – der Built-in-Default ?X25519MLKEM768:DEFAULT macht beides überflüssig. Wire-Mitschnitt, ClientHello-Größenvergleich und externe Verifikation im Folgebeitrag.

Update Juli 2026: Warum der Schlüsselaustausch überhaupt hybrid ist und was ein KEM von Diffie-Hellman unterscheidet, erkläre ich ausführlich in X25519MLKEM768 zerlegt.

Viel Spaß beim Nachbauen – und wie immer: bei Fragen, fragen.

GPT in Rspamd aktivieren: so nutze ich das LLM-Signal im Score

Rspamd web interface showing GPT module spam scores

Seit einiger Zeit nutze ich das GPT-Modul von Rspamd, um bei der Spam-Erkennung ein zusätzliches Signal zu bekommen. Es ersetzt nichts — kein Bayes, kein DKIM, kein RBL — sondern ist ein weiterer Sensor im Gesamtbild. Wer sich fragt, wie das in der Praxis aussieht und worauf man achten muss: hier mein aktuelles Setup.

Update 2026-02-13: Dieser Beitrag wurde komplett überarbeitet. Die ursprüngliche Version nutzte json=false, was zu Parse-Problemen führte. Außerdem fehlte ein Custom Prompt — und genau das ist der entscheidende Punkt, wie sich herausgestellt hat.

Voraussetzungen

  • Rspamd >= 3.12 mit GPT-Plugin (bei mir aktuell 3.14.0 auf FreeBSD 15.0)
  • Ein OpenAI API-Key (oder kompatibler Endpoint)
  • Grundverständnis von Rspamd Metrics und Actions

OpenAI API-Key anlegen

OpenAI API usage dashboard for Rspamd GPT integration

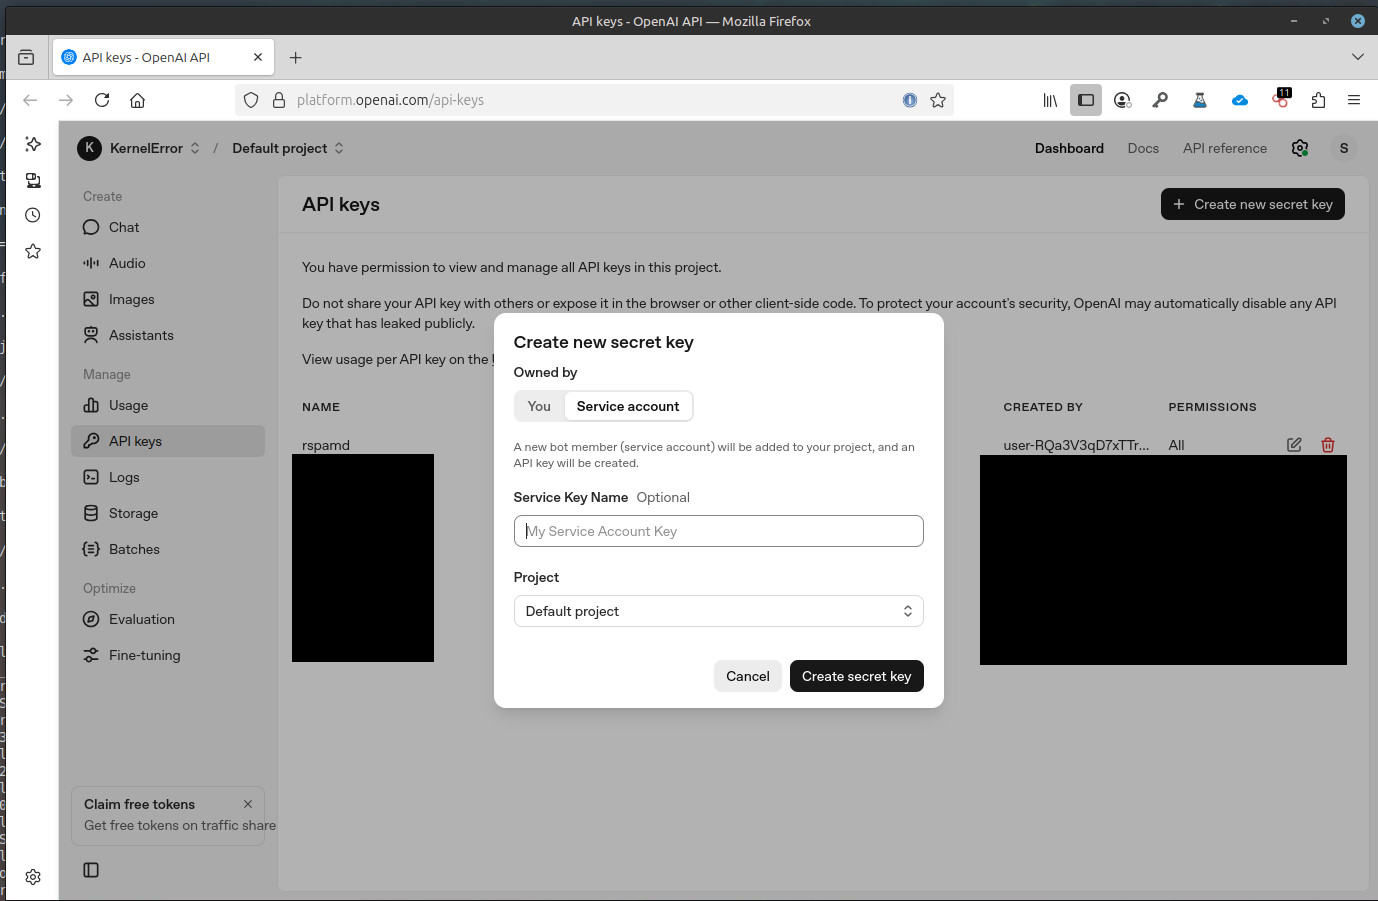
Wer noch keinen Key hat: Auf platform.openai.com einloggen, unter API Keys einen neuen Service-Account-Key erzeugen. Der Key wird nur einmal angezeigt — sicher ablegen. Den Verbrauch sieht man im Dashboard. Bei gpt-4o-mini und Mailfiltering sind die Kosten minimal.

Die Konfiguration: gpt.conf

Hier meine aktuelle /usr/local/etc/rspamd/local.d/gpt.conf:

enabled = true;
type = "openai";
model = "gpt-4o-mini";
api_key = "GEHEIMER-KEY";

model_parameters {
  gpt-4o-mini {
    max_tokens = 160;
    temperature = 0.0;
  }
}

timeout = 10s;
allow_ham = true;
allow_passthrough = false;
json = true;

prompt = "You are an email spam detector. Analyze the email and respond with ONLY a JSON object, no other text. The JSON must have these fields: "probability" (number 0.00-1.00 where 1.0=spam, 0.0=ham), "reason" (one sentence citing the strongest indicator). Example: {"probability": 0.85, "reason": "Unsolicited offer with urgent language and suspicious links."}  LEGITIMATE patterns: verification emails with codes, transactional emails (receipts, confirmations), newsletter unsubscribe links. Flag as spam only with MULTIPLE red flags: urgent threats, domain impersonation, requests for credentials, mismatched URLs.";

symbols_to_except {
  RCVD_IN_DNSWL_MED   = -0.1;
  RCVD_IN_DNSWL_HI    = -0.1;
  DWL_DNSWL_MED        = -0.1;
  WHITELIST_RECP_ADDR = -0.1;
  BAYES_HAM           = -0.1;
  SPAMTRAP            = 0;
  RCPT_IN_SPAMTRAP    = 0;
  SPAMTRAP_ADDR       = 0;
  RCVD_VIA_SMTP_AUTH  = 0;
  LOCAL_CLIENT        = 0;
  FROM_LOCAL          = 0;
}

Was hat sich gegenüber der alten Version geändert?

json = true und der Custom Prompt

Das ist die wichtigste Änderung. In meiner ursprünglichen Konfiguration stand json = false. Das funktionierte, hatte aber einen Haken: die Antwort des Modells wurde als Freitext geparst, was unzuverlässig war.

Mit json = true aktiviert Rspamd den JSON-Modus. Das Modell wird angewiesen, strukturiertes JSON zurückzuliefern, und der Parser erwartet ein Feld probability in der Antwort.

Und hier kommt der Fallstrick: Der Default-Prompt von Rspamd passt nicht zum JSON-Modus. Er fordert das Modell auf, nummerierte Textzeilen zurückzugeben:

Output ONLY 2 lines:
1. Numeric score: 0.00-1.00
2. One-sentence reason...

Der JSON-Parser erwartet aber:

{"probability": 0.85, "reason": "..."}

Das Ergebnis: cannot convert spam score im Log und GPT_UNCERTAIN(0.00) bei jeder Mail. Das GPT-Modul lief, lieferte aber nie ein verwertbares Ergebnis.

Lösung: ein Custom Prompt, der explizit JSON mit dem probability-Feld verlangt. Damit funktioniert die Kette:

  1. Rspamd sendet Mail + Prompt an OpenAI
  2. OpenAI antwortet mit {"probability": 0.9, "reason": "..."}
  3. Rspamd parst das JSON, findet probability, mappt auf GPT_SPAM/GPT_HAM/GPT_SUSPICIOUS

reason_header entfernt

In der alten Version hatte ich reason_header = "X-GPT-Reason" gesetzt. Das schrieb die GPT-Begründung als eigenen Header in die Mail. Mit json = true ist das nicht mehr nötig — die Reason steckt im JSON und taucht im Rspamd-Log auf. Außerdem entferne ich ohnehin GPT-Header per Milter-Config, damit keine internen Analyse-Details an den Empfänger durchsickern.

symbols_to_except angepasst

Änderungen gegenüber der alten Version:

  • GREYLIST entfernt: Greylisting ist kein Vertrauens-Signal. Eine Mail die Greylisting besteht, kann trotzdem Spam sein. GPT soll diese Mails weiterhin bewerten.
  • BAYES_HAM hinzugefügt: Wenn Bayes die Mail bereits sicher als Ham einstuft, spart man sich den GPT-Call. Sinnvoll für Newsletter und regelmäßige Korrespondenz.
  • SPAMTRAP-Symbole hinzugefügt: Mails an Spamtrap-Adressen brauchen keine GPT-Analyse, die sind per Definition Spam.

Scoring: Gewichte und Thresholds

Die GPT-Symbole und ihre Gewichte in der metrics.conf (bzw. local.d/groups.conf):

symbols {
  GPT_SPAM       { weight = 9.0;  description = "GPT: classified as SPAM"; }
  GPT_SUSPICIOUS { weight = 4.5;  description = "GPT: classified as SUSPICIOUS"; }
  GPT_HAM        { weight = -0.5; one_shot = true; description = "GPT: classified as HAM"; }
}

Warum diese Gewichte?

  • GPT_SPAM (9.0): Kräftig, aber alleine nicht genug zum Rejecten. Erst in Kombination mit anderen Signalen (Bayes, RBL, fehlende Auth) wird der Reject-Threshold erreicht.
  • GPT_SUSPICIOUS (4.5): Schiebt Grenzfälle in Richtung Greylist oder Add-Header. Genau dafür ist GPT am nützlichsten.
  • GPT_HAM (-0.5): Bewusst niedrig und one_shot. GPT soll Spam erkennen, nicht Ham retten.

Dazu die Action-Thresholds:

actions {
  greylist   = 4;
  add_header = 6;
  reject     = 12;
}

Reject-Threshold bei mir: 12 statt Default 15. Das geht, weil die traditionellen Checks (SPF, DKIM, DMARC, RBL, Bayes, DNSBL) bereits solide arbeiten. GPT kommt als zusätzliches Signal obendrauf.

Praxis-Beispiel

Hier eine echte Spam-Mail aus dem Log, bei der GPT korrekt angeschlagen hat:

rspamd_task_write_log: (default: T (reject): [13.83/12.00]
  [BAYES_SPAM(5.10){100.00%;},
   ABUSE_SURBL(5.00){next.schnapper-empfehlung.de:url;...},
   GPT_SPAM(2.40){0.9;},
   FROM_NEQ_ENVFROM(0.50){...},
   FORGED_SENDER(0.30){...},
   ...]

Was man hier sieht:

  • GPT_SPAM(2.40){0.9;} — GPT hat Probability 0.9 (90% Spam) zurückgeliefert. Rspamd mappt den Probability-Wert nicht 1:1 auf das konfigurierte Gewicht, sondern skaliert intern — hier ergeben sich 2.40 von maximal 9.0 Punkten.
  • Zusammen mit BAYES_SPAM (5.10) und ABUSE_SURBL (5.00) kommt die Mail auf 13.83 — deutlich über dem Reject-Threshold von 12.
  • GPT war hier nicht das ausschlaggebende Signal, hat aber zur Gesamtbewertung beigetragen.

Das ist genau das Verhalten, das ich will: GPT als ein Baustein unter vielen, der bei Grenzfällen den Ausschlag geben kann.

Datenschutz

Das muss gesagt werden: Mit diesem Setup fließen Mailinhalte an OpenAI. Wer personenbezogene Daten verarbeitet oder in einem regulierten Umfeld arbeitet, muss prüfen ob das zulässig ist. Alternative: selbst gehostete Modelle über Ollama oder kompatible lokale Endpoints. Rspamd unterstützt das über den type-Parameter.

Für meinen privaten Mailserver ist das Risiko vertretbar — und die Ergebnisse sprechen für sich.

Update 2026-05-06: Rspamd hat den Default-Prompt deutlich verbessert

Im Feedback zu diesem Beitrag kam ein guter Hinweis aus dem Fediverse von @bash2@momou.social: Vsevolod Stakhov, Maintainer von Rspamd, hat am 2. Oktober 2025 den Default-Prompt komplett überarbeitet. Commit 893ee871, Titel „Improve LLM prompt and add sender frequency tracking“. Der neue Prompt ist deutlich strukturierter, mit expliziten Sektionen für legitime Muster (Verifikations-Mails, Transaktions-Mails, Password-Resets) und für Phishing-Indikatoren, die mehrfach auftreten müssen, bevor klassifiziert wird. Das senkt False-Positives auf legitime Absender und ist eine klare Verbesserung gegenüber dem alten, knappen Default. Danke für den Hinweis!

Wichtig zur Einordnung: Der neue Default-Prompt liefert weiterhin strukturierten Plain-Text, kein JSON. Output-Format sind 2 bis 3 fest definierte Zeilen (Score, Reason, optional Kategorie). Was das für die beiden gängigen Setups bedeutet:

  • json = false: Wer ohne JSON-Modus fährt, profitiert direkt vom neuen Default-Prompt. Rspamd auf eine Version mit dem Commit aktualisieren, fertig.
  • json = true wie in diesem Beitrag: Custom Prompt mit JSON-Format bleibt Pflicht. Der neue Default ist immer noch kein JSON und kollidiert weiterhin mit dem Parser.

Zusätzlich neu im selben Commit: Sender-Frequency-Tracking. Rspamd klassifiziert in lualib/llm_context.lua jeden Absender per Redis-Counter als new, occasional, known oder frequent und gibt dem Modell die Info als Context-Snippet mit. Der Prompt weist das LLM dann an, bei known oder frequent die Phishing-Wahrscheinlichkeit zu reduzieren, sofern keine starken Gegen-Signale vorliegen. Voraussetzung ist, dass die LLM-Context-Funktion mit Redis-Backend läuft, weil das Feature über den sender_counts-Counter dort getrackt wird.

Mein Setup hier im Beitrag bleibt also unverändert: json = true plus Custom Prompt, der explizit ein probability-Feld verlangt. Wer stattdessen den neuen Default-Prompt nutzen möchte, sollte gleichzeitig auf json = false umstellen, sonst läuft man wieder in die alte Falle aus diesem Beitrag.

Zusammenfassung

ParameterWertWarum
jsontrueStrukturiertes Parsing, zuverlässiger als Freitext
promptCustomPflicht bei json=true! Default-Prompt liefert Textformat, Parser erwartet JSON
temperature0.0Deterministische Antworten, kein Kreativitäts-Bonus beim Spamfiltern
allow_hamtrueKleines positives Signal für legitime Mails
symbols_to_exceptBAYES_HAM, DNSWL, Whitelists, SMTP_AUTH, SpamtrapsUnnötige API-Calls vermeiden
reason_headernicht gesetztNicht nötig mit json=true, interne Details gehören nicht in den Header

Die wichtigste Erkenntnis: json = true ohne Custom Prompt ist kaputt. Der Default-Prompt und der JSON-Parser sprechen unterschiedliche Sprachen. Wer json = true setzt, muss einen Prompt mitliefern, der JSON mit einem probability-Feld verlangt. Sonst steht im Log cannot convert spam score und GPT liefert nur GPT_UNCERTAIN(0.00).

Siehe auch: rspamd mit Dovecot und IMAPSieve

Fragen? Einfach melden.

Rspamd: Automatisches Spam/Ham-Lernen mit Dovecot und IMAPSieve

Rspamd hat ein Webinterface. Da kann man E-Mails reinkopieren und als Spam oder Ham markieren. Klingt erstmal praktisch. Ist es aber nicht. Niemand kopiert ernsthaft den Quellcode jeder fehlklassifizierten Mail in ein Webformular. Das macht man einmal zum Testen und dann nie wieder.

Automatisches Spam-Training mit Rspamd über Dovecot IMAPSieve – Mail wird zwischen Inbox und Junk verschoben

Was man eigentlich will: Wenn ein Benutzer eine Mail in den Junk-Ordner verschiebt, soll rspamd das automatisch als Spam lernen. Und wenn eine Mail aus dem Junk-Ordner rausgeholt wird, soll rspamd sie als Ham lernen. Kein Webinterface, kein manueller Eingriff. Der Benutzer sortiert einfach seine Mails — und rspamd lernt mit.

Genau das geht mit Dovecot und IMAPSieve. Hier beschreibe ich, wie ich das bei mir eingerichtet habe. Die Konfiguration läuft seit Mai 2020 unverändert — über sechs Jahre, ohne eine einzige Anpassung. Das darf man ruhig als stabil bezeichnen.

Was passiert da eigentlich

Der Datenfluss ist simpel:

  • Benutzer verschiebt eine Mail in den Ordner „Junk“
  • Dovecot erkennt die Verschiebung per IMAPSieve
  • IMAPSieve startet ein Sieve-Script
  • Das Sieve-Script ruft ein Shell-Script auf
  • Das Shell-Script übergibt die Mail per rspamc an rspamd
  • Rspamd lernt die Mail als Spam (Bayes-Klassifikator)

In die andere Richtung genauso: Mail raus aus Junk, Dovecot erkennt es, rspamd lernt Ham. Egal ob der Benutzer über Thunderbird, Roundcube, ein Smartphone oder was auch immer sortiert — solange es IMAP ist, greift das.

Voraussetzungen

  • Dovecot mit Sieve-Support (dovecot-pigeonhole unter FreeBSD, dovecot-sieve unter Debian/Ubuntu)
  • Rspamd mit laufendem Controller-Worker
  • rspamc CLI-Tool (kommt mit rspamd mit)

Mein Setup läuft auf FreeBSD. Die Pfade beginnen daher mit /usr/local/. Unter Linux ist es /etc/dovecot/ statt /usr/local/etc/dovecot/ und /usr/lib/dovecot/ statt /usr/local/libexec/dovecot/. Ansonsten ist alles identisch.

Mein rspamd läuft in einer eigenen Jail und lauscht auf 127.0.0.3:11334. Wer rspamd lokal auf dem gleichen System hat, nimmt stattdessen 127.0.0.1:11334 oder den Unix-Socket.

Dovecot konfigurieren

Zuerst muss das Sieve-Plugin für IMAP aktiviert werden.

20-imap.conf:

protocol imap {
  mail_plugins = $mail_plugins sieve
}

Dann die IMAPSieve-Konfiguration. Hier wird festgelegt, welche Ordner-Aktionen welches Sieve-Script auslösen.

90-plugin.conf:

plugin {
  sieve_plugins = sieve_imapsieve sieve_extprograms

  # Wenn eine Mail in den Junk-Ordner kopiert oder dort ein Flag geaendert wird
  imapsieve_mailbox1_name = Junk
  imapsieve_mailbox1_causes = COPY FLAG
  imapsieve_mailbox1_before = file:/usr/local/etc/dovecot/sieve/report-spam.sieve

  # Wenn eine Mail AUS dem Junk-Ordner woanders hin verschoben wird
  imapsieve_mailbox2_name = *
  imapsieve_mailbox2_from = Junk
  imapsieve_mailbox2_causes = COPY
  imapsieve_mailbox2_before = file:/usr/local/etc/dovecot/sieve/report-ham.sieve

  sieve_pipe_bin_dir = /usr/local/libexec/dovecot

  sieve_global_extensions = +vnd.dovecot.pipe
}

Zwei Trigger: Einer für „Mail landet im Junk“ (→ Spam lernen), einer für „Mail verlässt Junk“ (→ Ham lernen). COPY deckt Verschieben ab, FLAG fängt den Fall ab, dass ein Mail-Client den Junk-Status per Flag statt per Verschieben setzt.

Sieve-Scripts

Jetzt die beiden Sieve-Scripts, die von IMAPSieve aufgerufen werden.

report-spam.sieve — wird ausgelöst, wenn eine Mail im Junk-Ordner landet:

require ["vnd.dovecot.pipe", "copy", "imapsieve", "environment", "imap4flags"];

if environment :is "imap.cause" "COPY" {
    pipe :copy "sa-learn-spam.sh";
}

# Beantworteten oder weitergeleiteten Spam ebenfalls lernen
elsif anyof (allof (hasflag "\\Answered",
                    environment :contains "imap.changedflags" "\\Answered"),
             allof (hasflag "$Forwarded",
                    environment :contains "imap.changedflags" "$Forwarded")) {
    pipe :copy "sa-learn-spam.sh";
}

Der erste Block fängt das normale Verschieben ab. Der zweite Block ist für einen Sonderfall: Wenn jemand auf eine Mail im Junk-Ordner antwortet oder sie weiterleitet, ändert sich das Flag — und auch das sollte als Spam gelernt werden.

report-ham.sieve — wird ausgelöst, wenn eine Mail den Junk-Ordner verlässt:

require ["vnd.dovecot.pipe", "copy", "imapsieve", "environment", "variables"];

if environment :matches "imap.mailbox" "*" {
  set "mailbox" "${1}";
}

if string "${mailbox}" [ "Trash", "train_ham", "train_prob", "train_spam" ] {
  stop;
}

pipe :copy "sa-learn-ham.sh";

Hier passiert etwas Wichtiges: Bevor die Mail als Ham gelernt wird, prüfen wir wohin sie verschoben wurde. Wenn sie im Papierkorb landet, war das vermutlich kein „Das ist kein Spam“ sondern ein „Ich lösche den Spam“. Deshalb: stop; für Trash und die Trainingsordner. Nur wenn die Mail in einen echten Ordner verschoben wird, ist es ein Ham-Signal.

Beide Scripts müssen kompiliert werden:

sievec /usr/local/etc/dovecot/sieve/report-spam.sieve
sievec /usr/local/etc/dovecot/sieve/report-ham.sieve

Shell-Scripts für rspamc

Die Sieve-Scripts rufen Shell-Scripts auf, die die Mail per rspamc an rspamd übergeben. Simpel — jeweils ein Einzeiler.

/usr/local/libexec/dovecot/sa-learn-spam.sh:

#!/bin/sh
exec /usr/local/bin/rspamc -h 127.0.0.3:11334 learn_spam

/usr/local/libexec/dovecot/sa-learn-ham.sh:

#!/bin/sh
exec /usr/local/bin/rspamc -h 127.0.0.3:11334 learn_ham

Die Dateinamen sa-learn-* kommen historisch von SpamAssassin. Verwirrend, wenn man rspamd nutzt. Man könnte sie auch rspamd-learn-spam.sh nennen — funktional ist es egal. Ich habe sie so gelassen, weil man funktionierende Dinge nicht anfasst.

Beide ausführbar machen:

chmod +x /usr/local/libexec/dovecot/sa-learn-spam.sh /usr/local/libexec/dovecot/sa-learn-ham.sh

Wer rspamd lokal laufen hat, ersetzt 127.0.0.3 durch 127.0.0.1 oder nutzt den Unix-Socket (-h /var/run/rspamd/rspamd.sock). Unter Linux liegen die Scripts in /usr/lib/dovecot/ statt /usr/local/libexec/dovecot/. Der Pfad in sieve_pipe_bin_dir muss natürlich dazu passen.

Wichtig: Damit rspamc ohne Passwort trainieren darf, muss die IP im rspamd Controller-Worker als vertrauenswürdig eingetragen sein. In /usr/local/etc/rspamd/local.d/worker-controller.inc (FreeBSD) bzw. /etc/rspamd/local.d/worker-controller.inc (Linux):

secure_ip = "127.0.0.0/8";
secure_ip = "::1";

Ohne das schlägt rspamc learn_spam mit einem Authentifizierungsfehler fehl. Bei Jail-Setups wie meinem muss die Jail-IP (127.0.0.3) in der Liste stehen.

Testen

Dovecot neu laden:

service dovecot reload

Dann eine beliebige Mail in den Junk-Ordner verschieben und im rspamd-Log nachschauen:

rspamd_controller_learn_fin_task: <127.0.0.3> learned message as spam: MESSAGE-ID

Mail wieder raus aus Junk in den Posteingang:

rspamd_controller_learn_fin_task: <127.0.0.3> learned message as ham: MESSAGE-ID

Wenn das im Log steht, funktioniert alles. Kein Neustart nötig, kein Cache-Flush, kein Warten.

Wie viel Training braucht rspamd

Rspamd nutzt einen Bayes-Klassifikator. Der braucht eine Mindestmenge an gelernten Nachrichten, bevor er aktiv wird. Die Standardeinstellung ist 200 — also mindestens 200 Spam-Mails und 200 Ham-Mails. Vorher ignoriert rspamd die Bayes-Ergebnisse komplett.

Das klingt nach viel, geht aber schneller als man denkt. Wer ein paar Dutzend Benutzer auf dem Server hat, kommt da in wenigen Wochen hin. Und danach wird rspamd mit jeder sortierten Mail ein bisschen besser.

Den aktuellen Stand kann man jederzeit prüfen:

rspamc stat

Unter Statfile sieht man wie viele Nachrichten rspamd bereits gelernt hat.

Rspamd trainiert standardmäßig einen globalen Bayes-Klassifikator — alle Benutzer lernen in denselben Pool. Wer das pro Benutzer trennen will, setzt in der classifier-bayes.conf:

per_user = true;

Für die meisten Setups mit einer Handvoll Domains ist der globale Pool sinnvoller — mehr Trainingsdaten, schneller gute Ergebnisse.

Hinweise

Die Konfiguration ist stabil — Dovecot-Updates, rspamd-Updates, FreeBSD-Upgrades, alles durchgelaufen ohne Anpassung.

Wer rspamd danach noch eine Stufe weiter bringen will: Ich habe einen eigenen Beitrag geschrieben, wie man GPT-basierte Spam-Erkennung in rspamd integriert. Das läuft zusätzlich zum Bayes-Klassifikator und fängt die Mails ab, die durch das statistische Netz rutschen.

Siehe auch: Postfix und AMaViS: content_filter oder smtpd_proxy_filter?, DMARC-Prüfung in Postfix: OpenDMARC und rspamd im Vergleich

Fragen? Schreib mir über die Kontaktseite.

Automatische E-Mail-Archivierung mit cleanup-maildir und Dovecot

IMAP-Postfächer wachsen mit der Zeit. Irgendwann hat man tausende Mails im Posteingang und in Sent, die Suche wird langsam und die Übersicht geht verloren. cleanup-maildir ist ein Python-Script das Mails nach Alter automatisch in Archiv-Ordner sortiert. Es läuft als Cronjob und arbeitet direkt auf dem Maildir-Verzeichnis.

Installation

# FreeBSD
pkg install cleanup-maildir

# Debian/Ubuntu
pip install cleanup-maildir

Grundlegender Aufruf

Alle Mails die älter als 365 Tage sind aus der Inbox ins Archiv verschieben:

# Inbox archivieren
sudo -u vmail cleanup-maildir --age=365 \
  --archive-folder='Archive.Inbox' \
  --maildir-root='/var/mail/vhosts/example.com/user' \
  archive ''

# Gesendete archivieren
sudo -u vmail cleanup-maildir --age=365 \
  --archive-folder='Archive.Sent' \
  --maildir-root='/var/mail/vhosts/example.com/user' \
  archive 'Sent/'

--age=365 fasst nur Mails an die älter als ein Jahr sind. --archive-folder gibt den Zielordner im IMAP-Postfach an. archive ist der Modus (alternativ delete). Der leere String '' steht für die Inbox, 'Sent/' für die gesendeten Mails.

Das Script legt automatisch Unterordner nach Jahr und Monat an. Die Struktur im Postfach sieht dann so aus:

Archive/
├── Inbox/
│   ├── 2024-01/
│   ├── 2024-02/
│   └── ...
└── Sent/
    ├── 2024-01/
    ├── 2024-02/
    └── ...

Cronjob

Als Cronjob einmal pro Nacht laufen lassen. Wichtig ist dass der Cronjob als der Benutzer läuft der Zugriff auf die Maildir-Verzeichnisse hat:

# /etc/crontab
30 3 * * * vmail cleanup-maildir --age=365 --archive-folder='Archive.Inbox' --maildir-root='/var/mail/vhosts/example.com/user' archive ''

Mehrere Postfächer mit LDAP

Bei mehreren Postfächern will man nicht für jeden Benutzer einen eigenen Cronjob-Eintrag pflegen. Ein Wrapper-Script kann die Benutzer, Maildir-Pfade und die Option ob archiviert werden soll aus dem LDAP holen. Das LDAP-Attribut (z.B. autoarchive=1) steuert pro Benutzer ob die Archivierung aktiv ist. So lässt sich die Archivierung zentral verwalten ohne auf jedem Mailserver Cronjobs anzupassen.

Python 3.11+ und kaputte Header

Ab Python 3.11 nutzt cleanup-maildir den strikten RFC-Header-Parser aus email.policy.default. Das führt zu einem Problem: Mails mit fehlerhaften Headern (z.B. Microsoft Exchange Message-IDs wie <[b378dfc5...]@microsoft.com>) lassen das Script mit einem IndexError abstürzen. Alle Mails nach der fehlerhaften werden nicht mehr verarbeitet.

Den Fix dafür habe ich als Pull Request eingereicht. Ein _safe_header()-Wrapper fängt Parse-Fehler ab und überspringt kaputte Header, statt das ganze Script abzubrechen. Bei mir hat das Script vorher bei Mail #8 aufgehört, danach liefen alle 2.986 Mails sauber durch.

Siehe auch: Dovecot Quota einrichten

Fragen? Einfach melden.

Outlook Autodiscover für IMAP und SMTP konfigurieren

Vor einigen Jahren habe ich bereits etwas zu Microsoft Office Outlook Autodiscover geschrieben. Ich setze es noch immer in ähnlicher Form ein. Hier der aktuelle Stand.

Nginx-Konfiguration

Hinter autodiscover.kernel-error.de steht ein Nginx, der unter /Autodiscover/Autodiscover.xml die Konfiguration für verschiedene Maildomains ausliefert. Die Location ist überschaubar:

location ~ /(?:a|A)utodiscover/(?:a|A)utodiscover.xml {
    root /usr/local/www/autodiscover.kernel-error.de;
    try_files /autodiscover/autodiscover.php =404;
    fastcgi_split_path_info ^(.+\.php)(/.+)$;
    fastcgi_pass unix:/var/run/php-fpm.sock;
    fastcgi_index index.php;
    fastcgi_param SCRIPT_FILENAME $request_filename;
    include fastcgi_params;
    fastcgi_cache MYAPP;
    fastcgi_cache_valid 200 60m;
}

Das PHP-Script

Jede Anfrage nach /autodiscover/autodiscover.xml wird an autodiscover.php weitergeleitet. Das Script liest die im POST übermittelte E-Mail-Adresse, prüft sie und liefert die XML-Antwort mit IMAP- und SMTP-Einstellungen zurück:

<?php
// Autodiscover responder — responds to POST on /autodiscover/autodiscover.xml

$request = file_get_contents("php://input");
preg_match( "/\<EMailAddress\>(.*?)\<\/EMailAddress\>/", $request, $email );

if (filter_var($email[1], FILTER_VALIDATE_EMAIL) === false) {
	throw new Exception('Invalid E-Mail provided');
}

// IMAP settings
$imapServer = 'imap.kernel-error.de';
$imapPort   = 993;
$imapSSL    = true;

// SMTP settings
$smtpServer = 'smtp.kernel-error.de';
$smtpPort   = 465;
$smtpSSL    = true;

header( 'Content-Type: application/xml' );
?>
<?php echo '<?xml version="1.0" encoding="utf-8" ?>'; ?>
<Autodiscover xmlns="http://schemas.microsoft.com/exchange/autodiscover/responseschema/2006">
  <Response xmlns="http://schemas.microsoft.com/exchange/autodiscover/outlook/responseschema/2006a">
    <Account>
      <AccountType>email</AccountType>
      <Action>settings</Action>
      <Protocol>
        <Type>IMAP</Type>
        <Server><?php echo $imapServer; ?></Server>
        <Port><?php echo $imapPort; ?></Port>
        <LoginName><?php echo $email[1]; ?></LoginName>
        <SPA>off</SPA>
        <SSL><?php echo $imapSSL ? 'on' : 'off'; ?></SSL>
        <AuthRequired>on</AuthRequired>
      </Protocol>
      <Protocol>
        <Type>SMTP</Type>
        <Server><?php echo $smtpServer; ?></Server>
        <Port><?php echo $smtpPort; ?></Port>
        <LoginName><?php echo $email[1]; ?></LoginName>
        <SPA>off</SPA>
        <SSL><?php echo $smtpSSL ? 'on' : 'off'; ?></SSL>
        <AuthRequired>on</AuthRequired>
        <SMTPLast>off</SMTPLast>
        <UsePOPAuth>off</UsePOPAuth>
      </Protocol>
    </Account>
  </Response>
</Autodiscover>

Wichtig im SMTP-Block

Drei Zeilen machen den Unterschied:

<AuthRequired>on</AuthRequired>
<SMTPLast>off</SMTPLast>
<UsePOPAuth>off</UsePOPAuth>

Ohne diese Einträge muss man im Outlook manuell den Haken setzen bei „Gleiche Einstellungen wie für den Posteingangsserver verwenden“. Das überfordert erstaunlich viele Anwender.

Mehrere Domains per SRV-Record

Damit Autodiscover nicht nur für kernel-error.de funktioniert, gibt es in den anderen DNS-Zonen SRV-Records, die auf die zentrale Autodiscover-Domain verweisen:

$ dig _autodiscover._tcp.kernel-error.com IN SRV +short
0 0 443 autodiscover.kernel-error.de.

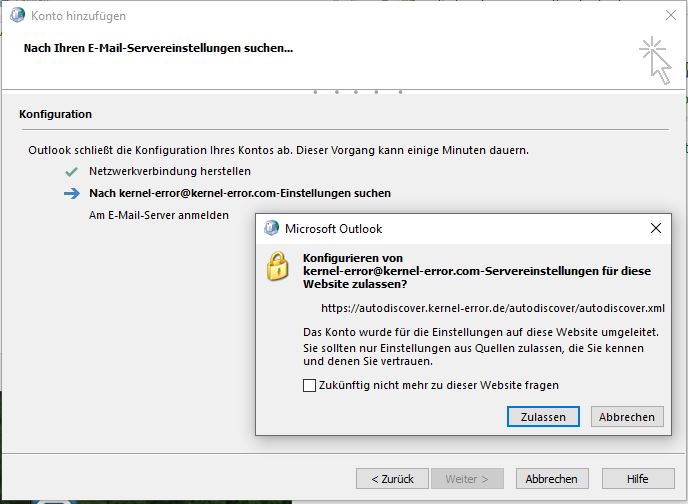
Outlook zeigt beim ersten Mal eine Warnmeldung, ob man dem Verweis folgen möchte:

Screenshot vom Outlook Client beim Konto hinzufügen. Frage ob die Konfiguration der Servereinstellungen von einer Webseite zugelassen werden soll.

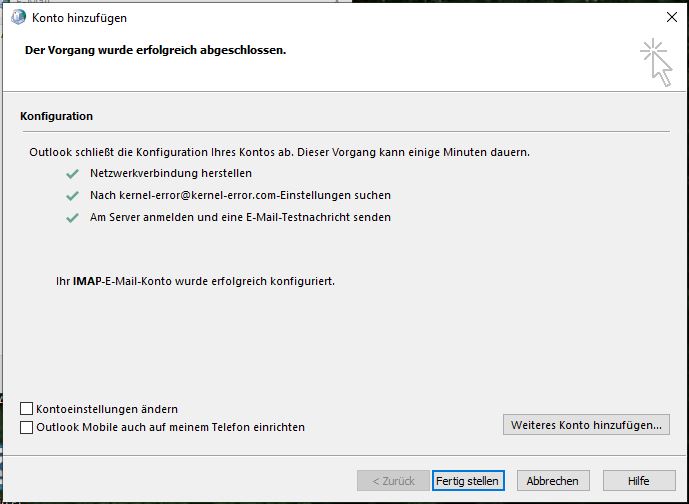
Einmal bestätigt, ist die Konfiguration abgeschlossen. Man könnte die Meldung auch per Registry-Key unterdrücken, aber für die meisten Benutzer reicht ein Klick.

Screenshot vom Outlook Client beim Konto hinzufügen. Vorgang wurde erfolgreich abgeschlossen.

Update März 2026: Aufgeräumt und abgesichert

Das Grundprinzip funktioniert seit 2019 unverändert. Outlook bekommt per POST seine Konfiguration, der Benutzer muss nur E-Mail-Adresse und Passwort eingeben. Ein paar Dinge habe ich aber überarbeitet.

PHP-Script: GET-Requests und fehlende Eingaben abfangen

Das alte Script hat bei GET-Requests oder einem leeren POST-Body mit HTTP 500 geantwortet. Es versuchte auf eine Variable zuzugreifen, die bei fehlendem XML-Body nicht existiert. Monitoring-Tools und neugierige Browser liefen damit gegen die Wand.

Die korrigierte Version prüft jetzt sauber:

<?php
// Nur POST erlauben
if ($_SERVER["REQUEST_METHOD"] !== "POST") {
    header("HTTP/1.1 405 Method Not Allowed");
    header("Allow: POST");
    exit;
}

$request = file_get_contents("php://input");
preg_match("/\<EMailAddress\>(.*?)\<\/EMailAddress\>/", $request, $email);

if (empty($email[1]) || filter_var($email[1], FILTER_VALIDATE_EMAIL) === false) {
    header("HTTP/1.1 400 Bad Request");
    exit;
}

// XSS-Schutz: E-Mail fuer XML-Ausgabe escapen
$loginName = htmlspecialchars($email[1], ENT_XML1, "UTF-8");

GET liefert jetzt 405, ein POST ohne gültigen Body gibt 400. Die E-Mail-Adresse wird zusätzlich mit htmlspecialchars() escaped, bevor sie in die XML-Antwort geschrieben wird.

Nginx: Kein Cache für dynamische Antworten

In der ursprünglichen Konfiguration steckt fastcgi_cache MYAPP mit 60 Minuten Gültigkeit. Das ist für Autodiscover falsch. Die Antwort enthält die E-Mail-Adresse des anfragenden Benutzers als <LoginName>. Mit Cache bekommt der zweite Benutzer die Adresse des ersten. Ohne Cache:

location ~* ^/autodiscover/autodiscover\.xml$ {
    try_files /autodiscover/autodiscover.php =404;
    fastcgi_pass  unix:/var/run/php-fpm.sock;
    fastcgi_index index.php;
    fastcgi_param SCRIPT_FILENAME $document_root/autodiscover/autodiscover.php;
    include       fastcgi_params;
}

Das ~* macht den Match case-insensitive, kürzer als die alte Regex mit (?:a|A).

Thunderbird Autoconfig auf dem gleichen Host

Inzwischen bedient autodiscover.kernel-error.de nicht mehr nur Outlook, sondern auch Thunderbird per Autoconfig. Dazu reicht eine zusätzliche Location im gleichen Server-Block:

location /mail/ {
    alias /usr/local/www/autoconfig-mail/mail/;
}

Thunderbird fragt https://autoconfig.<domain>/mail/config-v1.1.xml. Für jede Maildomain gibt es einen autoconfig.* CNAME und einen eigenen HTTPS-Server-Block. Outlook nutzt weiterhin den POST-Endpoint, Thunderbird die statische XML.

Siehe auch: Thunderbird Autoconfig

Fragen? Einfach melden.

Postfix: Verschleierung nur für SASL-Benutzer einrichten

Wie man bei allen ausgehenden E-Mails dafür sorgt, dass die Client IP Adresse sowie der eingesetzte Mailclient vom Postfix verschleiert wird… Ja dieses habe ich bereits geschrieben. Postfix soll verschleiern…

Nun kann es dennoch Sinn ergeben dieses nicht für jede E-Mail zu tun, welche den Mailserver verlässt. Wenn man dieses nur auf E-Mails anwenden möchte, welche von angemeldeten Benutzern versendet werden, funktioniert es wie folgt.

Man erstellt in der master.cf vom Postfix einen neuen Service:

anonym unix n       -       -       -       0       cleanup
  -o header_checks=pcre:/usr/local/etc/postfix/header_cleanup

Nun sorgt man in der gleichen Konfigurationsdatei noch dafür, dass am Ende vom Submission und smtps Service in diesen neuen Service gesprungen wird:

submission inet n       -       n       -       -       smtpd
[...]
  -o cleanup_service_name=anonym
[...]
smtps     inet  n       -       n       -       -       smtpd
[...]
  -o cleanup_service_name=anonym

Der Inhalt unserer /usr/local/etc/postfix/header_cleanup ist dabei weiterhin gleich:

/^(Received: from)[^\n]*(.*)/ REPLACE $1 ::88 (YOUR MOM [::88])$2
/^X-Originating-IP/ IGNORE
/^User-Agent*(.*)/ REPLACE User-Agent: YOUR MOMS MAILER
/^X-Mailer*(.*)/ REPLACE X-Mailer: YOUR MOMS MAILER

Nach einem Restart vom Postifx hat man nun den gewünschten Zustand. Natürlich dürfen nun die smtp_header_checks nicht mehr in der main.cf sein:

#smtp_header_checks = pcre:/usr/local/etc/postfix/header_cleanup

Viel Spaß

Fragen? Einfach melden.

Ich kann dir keine E-Mail schicken. Ich bekomme immer einen Fehler

Icon E-Mail Icon wird verdeckt von einem roten Kreis mit einem weißen Kreutz, welches verdeutlichen soll, dass E-Mail nicht funktioniert.

Einer der Vorteile eines eigenen Mailservers ist, dass man hier so restriktiv in seiner Konfiguration sein kann wie man es selbst für sich und seine Zwecke für richtig erachtet. So habe ich für mich entschieden, dass ich nur E-Mails annehmen möchte, welche über eine Transportverschlüsselung (TLS) bei mir eingeliefert werden. Wer also die folgende Meldung in seiner Errormail hat, dessen Mailserver hat sicher probiert die E-Mail bei mir ohne Transportverschlüsselung (also im Klartext) abzuliefern.

[...]
530-5.7.0 Must issue a STARTTLS command first
530 5.7.0 For assistance, visit https://matrix.to/#/@kernel-error:kernel-error.com
[...]

Transportverschlüsselung ist dabei bitte nicht zu verwechseln mit einer signierten oder gar verschlüsselten E-Mail. Ich nehme auch E-Mails an, welche weder signiert oder verschlüsselt sind. Die Transportverschlüsselung ist hier etwas wie das s bei httpS://. Das Mitlesen der E-Mail auf dem Weg zwischen eurem und meinem Mailserver soll damit nach Möglichkeit verhindert werden.

Möglichst verhindert werden? Ja, einen 100%tigen Schutz gibt es selbstverständlich nicht. Man kann nur versuchen sich diesem zu nähern. Dieses Nähern betrifft nun den zweiten Punkt welcher verhindern könnte, dass ihr mir eine E-Mail senden könnt. Die eingesetzte Transportverschlüsselung muss nämlich als „sicher“ gelten. Ich nehme also keine SSLv3 RC4 MD5 bla Verbindungen an. Wer also etwas wie das Folgende oder halt „Verbindung nicht möglich“ bekommt, dessen Mailserver ist nicht in der Lage eine „sichere“ TLS Verbindung aufzubauen.

warning: TLS library problem: error:1417A0C1:SSL routines:tls_post_process_client_hello:no shared ciphe

warning: TLS library problem: error:14209102:SSL routines:tls_early_post_process_client_hello:unsupported protocol

warning: TLS library problem: error:142090FC:SSL routines:tls_early_post_process_client_hello:unknown protocol

Warum macht dieses nun nicht jeder so? Nun… Möchte man als Unternehmen Geld damit verdienen, dass man in irgendeiner Form Benutzer dazu bringt bei einem einen E-Mail Service zu nutzen, dann möchte man natürlich seinen Kunden einen möglichst reibungsfreien Austausch ermöglichen. Denn der normale Benutzer wird es kaum verstehen und sicher einfach einen Anbieter wählen bei dem es „funktioniert“. Dieses könnte man daher als Grund anführen warum nicht jeder so restriktiv in seinen Empfangseinstellungen ist. Davon abgesehen hindert es kein Unternehmen daran, seinem Mailserver für ausgehende E-Mails die Möglichkeit zu schaffen gutes TLS zu sprechen. Ok, es sei denn dieser Server steht in China oder Nordkorea. Mein Mailserver ist also weit davon entfernt etwas Unmögliches zu verlangen!!!

Sprecht also mal mit der zuständigen Person eures Mailservers und fragt aus welchem Grund euer Mailserver nicht in der Lage ist sicheres TLS zu sprechen und ob man dieses nicht vielleicht doch ändern könnte!

Um mich in der Zwischenzeit dennoch irgendwie zu erreichen gibt es verschiedene Möglichkeiten welche man >>hier<< findet. Am einfachsten sicher über Matrix/Riot: @kernel-error:kernel-error.com.

Bis dahin.

Siehe auch: SPF-Record einrichten | DKIM einrichten

Postfix: Eingehende E-Mails ohne TLS ablehnen

Standardmäßig nimmt Postfix E-Mails auch ohne Transportverschlüsselung an. Mit smtpd_tls_security_level = may bietet der Server TLS an, erzwingt es aber nicht. Das bedeutet: Wenn die Gegenseite kein STARTTLS kann oder will, wird die Mail trotzdem im Klartext übertragen.

Man kann das ändern und E-Mails ohne TLS komplett ablehnen. Die Frage ist ob man sich das leisten kann.

Konfiguration

# /usr/local/etc/postfix/main.cf
smtpd_tls_security_level = encrypt

Mit encrypt verweigert Postfix die Annahme wenn der sendende Server kein STARTTLS aushandelt. Die Gegenseite bekommt einen temporären Fehler (454) und kann es später nochmal versuchen. Im Log steht dann:

postfix/smtpd: NOQUEUE: reject: RCPT from mail.example.de[...]: 454 4.7.0 TLS is required but was not offered

Vorher prüfen

Bevor man TLS erzwingt, sollte man wissen wie viele Mails betroffen wären. Im Postfix-Log lässt sich das auswerten:

# Anteil TLS vs. Klartext bei eingehenden Verbindungen
grep "TLS connection established" /var/log/maillog | wc -l
grep "connect from" /var/log/maillog | wc -l

In der Praxis liegt der TLS-Anteil bei den meisten Mailservern über 95 Prozent. Die letzten paar Prozent sind oft schlecht gewartete Systeme, Onlineshop-Bestätigungen oder Geräte aus Asien die sich nie um TLS gekümmert haben. Ob das ein Problem ist, hängt davon ab wessen Mails man bereit ist zu verlieren.

Ausgehend erzwingen

Für ausgehende Mails ist die Situation anders. Mit smtp_tls_security_level = encrypt verweigert Postfix die Zustellung wenn die Gegenseite kein TLS anbietet. Das ist riskant, weil man keine Kontrolle darüber hat ob der Empfänger-Server TLS kann.

Der bessere Weg für ausgehende Mails: MTA-STS und DANE prüfen automatisch ob die Zieldomain TLS verlangt und welches Zertifikat erwartet wird. Damit erzwingt man TLS nur dort wo die Gegenseite es auch unterstützt und verifiziert gleichzeitig die Identität.

# Ausgehend: opportunistisch, aber DANE wenn verfügbar
smtp_tls_security_level = dane
smtp_dns_support_level = dnssec

Mit dane als Security-Level nutzt Postfix DANE/TLSA-Records aus dem DNS. Ist ein TLSA-Record vorhanden, wird TLS erzwungen und das Zertifikat verifiziert. Ohne TLSA-Record bleibt es bei opportunistischem TLS. Zusammen mit dem Abschalten von TLS 1.0/1.1 ergibt das eine saubere Konfiguration. Fragen? Einfach melden.

Postfix: Client-Initiated Renegotiation sicher deaktivieren

client-initiated renegotiation beim SMTPD Server kann für DDoS Angriffe ausgenutzt werden. Die einzelnen TLS/SSL Optionen lassen sich über die recht gleichnamige Option im Postfix ein und ausschalten. Gibt es noch keinen mappenden Namen kann die jeweilige Option auch ein/ausgeschaltet werden mit dem jeweiligen Hexwert. Genau Infos findet man hier: http://www.postfix.org/postconf.5.html#tls_ssl_options

If the value of the parameter is a hexadecimal long integer starting with "0x", the options corresponding to the bits specified in its value are enabled (see openssl/ssl.h and SSL_CTX_set_options(3))

Für ein Postfix  3.3 und einem OpenSSL ab Version 1.1.1 ist der passende Hexwert 0x40000000.

Die Option setzt man wie so oft in der main.cf:

root@smtp:/ # postconf  tls_ssl_options
tls_ssl_options = 0x40000000

Ab Postfix >=3.4 gibt es: NO_RENEGOTIATION

Fragen? Dann fragen.

Fragen? Einfach melden.

« Ältere Beiträge

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑