IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: Linux (Seite 3 von 10)

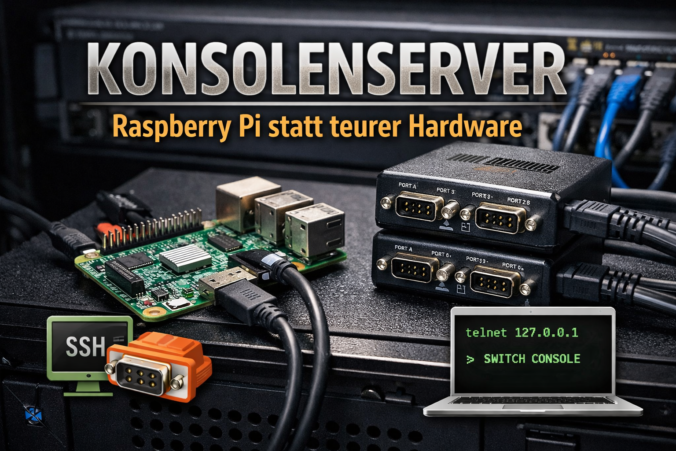
Raspberry Pi als serieller Konsolenserver

Wir haben 2026. Alles wandert in die Cloud. Trotzdem will ich heute über serielle Konsolen schreiben. Klingt retro, ist es aber nicht. Wenn ein Switch sich verkonfiguriert hat und das Netzwerk weg ist, hilft kein Ansible und kein Dashboard in der Cloud. Dann hilft nur noch der serielle Konsolenport. Out-of-Band Management ist nicht tot. Es wurde nur teuer verpackt.

Kommerzielle Konsolenserver kosten gerne vierstellig. Oder man nimmt einen Raspberry Pi der noch herum liegt und auf eine neue Aufgabe wartet (ich habe hier ein paar Pi1 oder 2 herum liegen). Zusammen mit zwei USB Serial Adaptern hat man für unter 50 Euro einen Konsolenserver mit acht Ports. Das reicht für die meisten Setups locker aus.
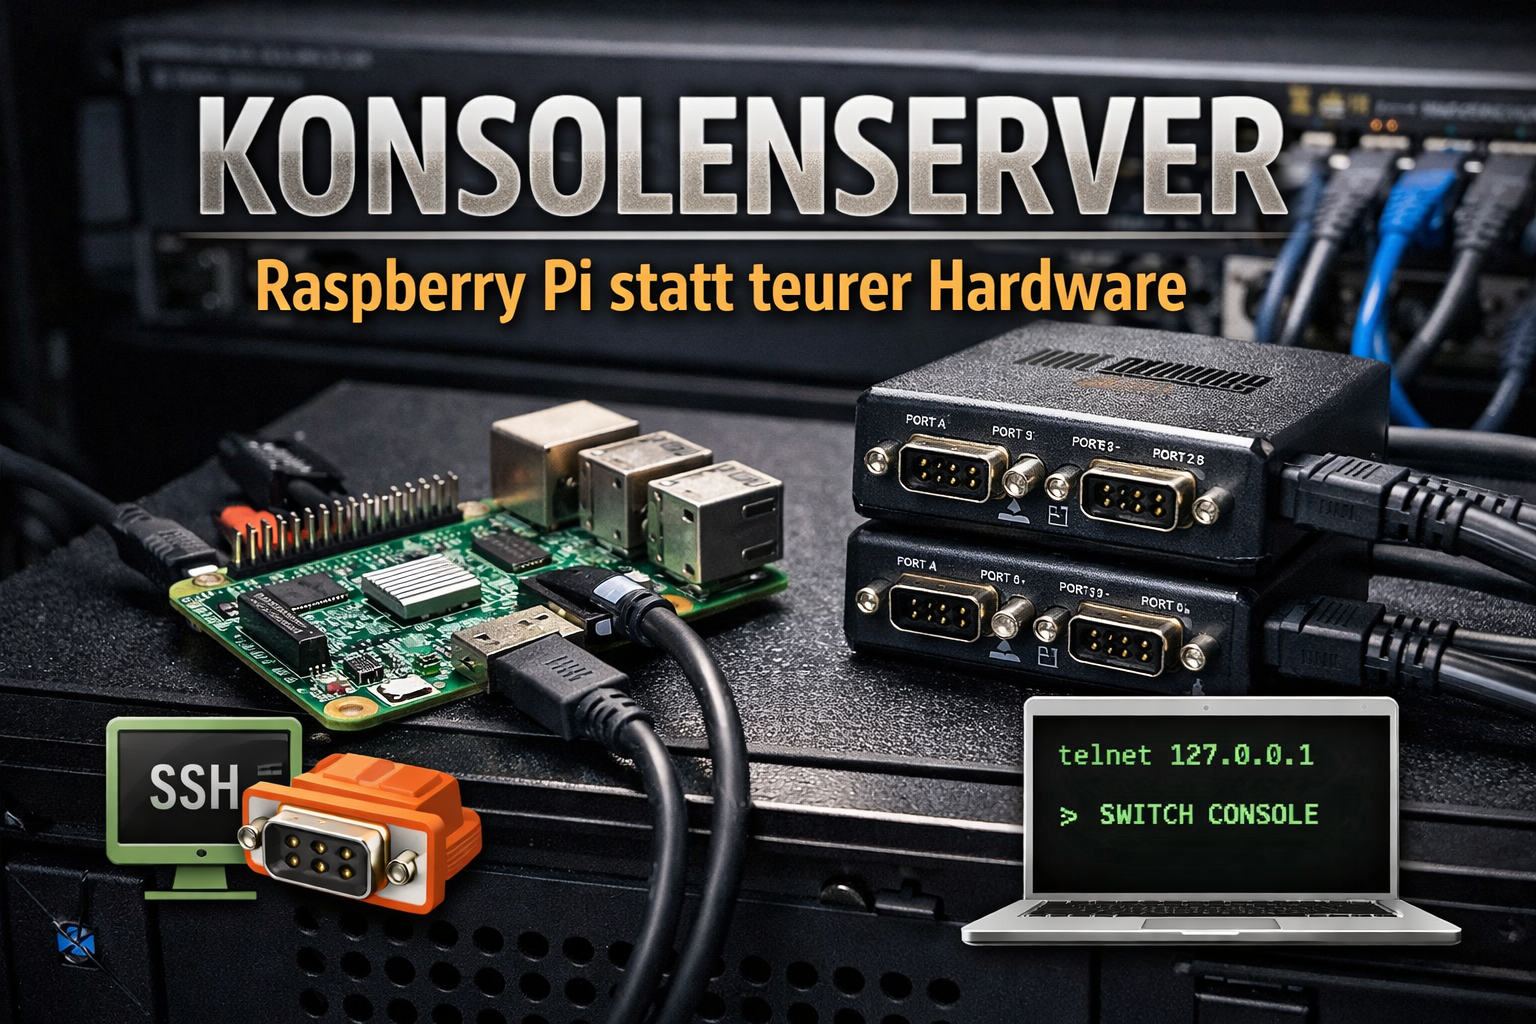
Raspberry Pi als DIY-Konsolenserver mit USB-Serial-Adaptern zur Verwaltung serieller Konsolen von Netzwerkgeräten über SSH und ser2net

Wofür ein Konsolenserver

Der klassische Fall: Ein paar Switches im Rack, jedes Gerät hat einen seriellen Konsolenport. Im Normalbetrieb konfiguriert man über das Netzwerk. Aber wenn mal eine falsche Route das Management Interface unerreichbar macht oder ein VLAN Umbau schiefgeht, steht man vor dem Gerät und steckt ein Kabel rein. Wenn das im DC in Frankfurt ist, oder vielleicht irgendwo in China, dann kann das spannend werden.

Oder man hat vorgebaut.

Ein Konsolenserver hängt permanent an den seriellen Ports der Netzwerkgeräte. Man kommt per SSH auf den Konsolenserver und von dort auf die serielle Konsole des Zielgeräts. Ob das Netzwerk funktioniert oder nicht, spielt keine Rolle mehr. Öhm also ja, so grob. Der Pi sollte dann ja schon noch erreichbar sein. Aber man hat ja in einem entfernten DC auch eine Dailin Line oder ähnliches, richtig? Richtig?
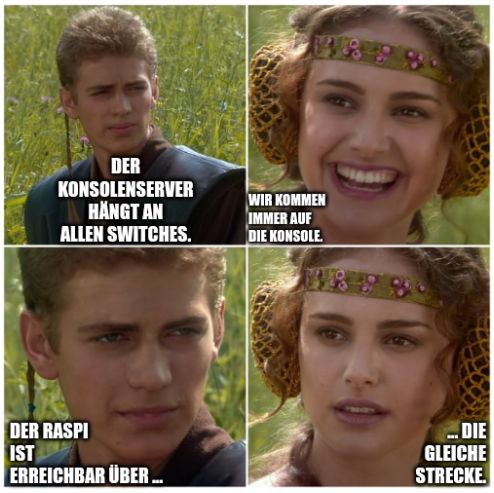
Meme mit Anakin und Padmé: „Der Konsolenserver hängt an allen Switches – wir kommen immer auf die Konsole – der Raspi ist erreichbar über … die gleiche Strecke.“

Hardware

Ein Raspberry Pi. Es muss kein aktuelles Modell sein. Selbst ein alter Pi 2 reicht völlig aus. Das Ding muss ser2net laufen lassen und ein paar serielle Ports bedienen, dafür braucht man keinen Quad Core mit 8 GB RAM. Der Pi aus der Schublade bekommt endlich eine sinnvolle Aufgabe.

FTDI Quad Port USB Serial Adapter (Vendor 0403, Product 6011). Pro Adapter bekommt man vier serielle Ports. Mit zwei Adaptern hat man acht Ports. Die Dinger gibt es für kleines Geld.

RS232 Kabel zu den Console Ports der Netzwerkgeräte. Welcher Stecker passt, hängt vom Hersteller ab. RJ45 auf DB9, DB9 auf DB9, die üblichen Verdächtigen. Da muss man schauen was die eigenen Geräte mitbringen.

Stabile Gerätenamen mit udev

Das erste Problem nach dem Einstecken der USB Adapter: Linux vergibt die /dev/ttyUSBx Nummern nach Lust und Laune. Nach einem Reboot kann ttyUSB0 plötzlich ttyUSB4 sein. Wenn man wissen will welcher Port an welchem Gerät hängt, ist das unpraktisch.

Die Lösung sind udev Regeln. Jeder FTDI Adapter hat eine eigene Seriennummer. Die findet man so:

udevadm info -a -n /dev/ttyUSB0 | grep serial

Damit baut man sich Regeln die stabile Symlinks erzeugen. Datei /etc/udev/rules.d/99-serial-consoles.rules:

SUBSYSTEMS=="usb", ENV{.LOCAL_ifNum}="$attr{bInterfaceNumber}"
SUBSYSTEM=="tty", ATTRS{idVendor}=="0403", ATTRS{idProduct}=="6011", ATTRS{serial}=="FT000001", SYMLINK+="quad0-%E{.LOCAL_ifNum}"
SUBSYSTEM=="tty", ATTRS{idVendor}=="0403", ATTRS{idProduct}=="6011", ATTRS{serial}=="FT000002", SYMLINK+="quad1-%E{.LOCAL_ifNum}"

FT000001 und FT000002 ersetzt man durch die echten Seriennummern der eigenen Adapter. Das Ergebnis sind stabile Symlinks: /dev/quad0-00 bis /dev/quad0-03 für den ersten Adapter, /dev/quad1-00 bis /dev/quad1-03 für den zweiten. Acht Ports, immer gleich benannt. Egal wie oft man den Pi neustartet.

ser2net

ser2net bildet die seriellen Ports auf TCP Ports ab. Man kann dann per Telnet auf einen bestimmten Port zugreifen und landet direkt auf der seriellen Konsole des zugehörigen Geräts. Installieren mit apt install ser2net, dann die Konfiguration in /etc/ser2net.conf:

localhost,2001:telnet:600:/dev/quad0-00:9600 8DATABITS NONE 1STOPBIT banner
localhost,2002:telnet:600:/dev/quad0-01:9600 8DATABITS NONE 1STOPBIT banner
localhost,2003:telnet:600:/dev/quad0-02:9600 8DATABITS NONE 1STOPBIT banner
localhost,2004:telnet:600:/dev/quad0-03:9600 8DATABITS NONE 1STOPBIT banner
localhost,2005:telnet:600:/dev/quad1-00:9600 8DATABITS NONE 1STOPBIT banner
localhost,2006:telnet:600:/dev/quad1-01:9600 8DATABITS NONE 1STOPBIT banner
localhost,2007:telnet:600:/dev/quad1-02:9600 8DATABITS NONE 1STOPBIT banner
localhost,2008:telnet:600:/dev/quad1-03:9600 8DATABITS NONE 1STOPBIT banner

9600 8N1 ist der Standard bei den meisten Netzwerkgeräten. Falls ein Gerät eine andere Baudrate braucht, passt man die entsprechende Zeile an. Der Timeout von 600 Sekunden trennt die Verbindung nach zehn Minuten Inaktivität. Das verhindert dass ein vergessenes Telnet die Konsole dauerhaft blockiert.

Direkter Zugriff mit minicom

Wer ser2net nicht nutzen will oder schnell direkt auf einen Port muss, nimmt minicom:

minicom -D /dev/quad0-00 -b 9600

minicom ist gut für schnelle Tests und Debugging. Für den Dauerbetrieb mit mehreren Ports gleichzeitig ist ser2net die bessere Wahl.

Warum localhost

ser2net ist im gezeigten Setup bewusst auf localhost gebunden. Man muss sich erst per SSH auf den Pi einloggen und dann telnet 127.0.0.1 200x aufrufen. Das ist Absicht.

Man könnte ser2net auch auf 0.0.0.0 binden und die Ports direkt aus dem Netz erreichen. Davon rate ich ab. Telnet ist unverschlüsselt. Auch in einem Management VLAN hat das nichts verloren.

Bessere Alternativen wenn man ohne SSH auf den Pi will:

  • ser2net ab Version 4.x unterstützt SSL/TLS. Damit hat man verschlüsselte Verbindungen direkt zu den Console Ports.
  • stunnel vor ser2net schalten. stunnel terminiert TLS und reicht die Verbindung an den lokalen ser2net weiter.
  • Wer nativen SSH Zugriff direkt auf die seriellen Ports braucht, sollte sich conserver anschauen. ser2net kann kein SSH.

Für die meisten Setups ist SSH auf den Pi und dann Telnet auf localhost der einfachste und sicherste Weg.

Absichern

Ein paar Dinge die man auf dem Pi noch machen sollte:

Den Default Benutzer pi löschen. Einen eigenen Benutzer anlegen. SSH Key Authentifizierung einrichten und Login per Passwort deaktivieren. Das ist nicht optional.

NTP konfigurieren. Timestamps in Logs sind nutzlos wenn die Uhrzeit nicht stimmt.

Syslog an einen zentralen Logserver weiterleiten. Wenn man serielle Konsolen mitschneidet, will man die Logs nicht nur lokal auf dem Pi haben.

Workflow

Der Alltag sieht dann so aus:

  1. SSH auf den Pi: ssh admin@10.0.0.50
  2. Telnet auf den gewünschten Port: telnet 127.0.0.1 2003
  3. Man landet auf der seriellen Konsole von Switch 3

Alternativ direkt mit minicom: minicom -D /dev/quad0-02 -b 9600

Zum Trennen: Ctrl-] und dann quit bei Telnet. Ctrl-A gefolgt von X bei minicom.

Fazit

Ein alter Raspberry Pi, zwei USB Adapter, ein paar Kabel. Mehr braucht man nicht für einen funktionierenden Konsolenserver mit acht Ports. Die Einrichtung dauert vielleicht eine Stunde. Danach läuft das Ding und man muss nie wieder ein Konsolenkabel quer durch den Serverraum schleppen.

Und der alte Pi aus der Schublade hat endlich wieder eine Aufgabe.

Ihr habt Fragen, Anmerkungen oder baut das Setup selbst nach? Meldet euch gerne über die Kontaktseite oder direkt per E-Mail.

Siehe auch: DHT22 am Raspberry Pi
peon-ping — Sound-Benachrichtigungen für Claude Code (und andere AI-Agents)

Wer mit AI-Coding-Agents arbeitet, kennt das Spiel. Claude Code läuft, macht sein Ding — und man sitzt daneben und wartet. Oder man wechselt kurz den Fokus, verpasst die Rückfrage und wundert sich zehn Minuten später, warum nichts mehr passiert. Terminal-Babysitting in Reinform.

Ein Bekannter hat mir dann peon-ping empfohlen. Kurz ausprobiert — direkt behalten. Danke dafür!

Was ist peon-ping?

peon-ping ist ein kleines Open-Source-Tool (MIT-Lizenz), das Sound-Benachrichtigungen für AI-Coding-Agents nachrüstet. Der Name ist Programm — im Default-Modus hört man den Peon aus Warcraft III. „Ready to work?“ wenn eine Session startet, „Work, work.“ wenn eine Aufgabe fertig ist, „Something need doing?“ wenn der Agent eine Eingabe braucht. Und wenn man zu schnell hintereinander Prompts abfeuert: „Me busy, leave me alone!“

peon-ping

Das Tool unterstützt nicht nur Claude Code, sondern auch Cursor, Codex, Windsurf, Kiro, GitHub Copilot und diverse andere Agents. Für Claude Code erfolgt die Integration über den nativen Hook-Mechanismus — es werden automatisch Hooks in ~/.claude/settings.json registriert.

Warum das Sinn ergibt

Das Problem ist simpel: Man startet Claude Code mit einer Aufgabe, wechselt in den Browser oder ein anderes Terminal — und verpasst den Moment, in dem der Agent fertig ist oder eine Frage hat. Ohne Feedback sitzt man entweder da und starrt auf den Output, oder man verliert Zeit, weil der Agent längst auf Eingabe wartet.

peon-ping löst das mit akustischem Feedback. Verschiedene Sounds für verschiedene Events — Task fertig, Fehler aufgetreten, Eingabe nötig, Rate-Limit erreicht. Dazu optional Desktop-Notifications als visuelles Overlay und sogar Push-Benachrichtigungen aufs Handy via ntfy.sh. Man kann also ruhig den Fokus wechseln und weiß trotzdem immer, was der Agent gerade treibt.

Installation unter Linux

Die Installation ist erfrischend simpel. Ein Einzeiler:

curl -fsSL peonping.com/install | bash

Alternativ gibt es auch Homebrew (brew install PeonPing/tap/peon-ping) oder Nix. Nach der Installation einmal das Setup laufen lassen:

peon-ping-setup

Das Setup registriert die Hooks in eurer Claude-Code-Konfiguration und installiert das Default-Sound-Pack. Fertig. Beim nächsten Start von Claude Code solltet ihr den Peon hören.

Für die Audio-Wiedergabe unter Linux nutzt peon-ping automatisch pw-play (PipeWire), paplay (PulseAudio), ffplay oder mpv — je nachdem, was verfügbar ist. Desktop-Notifications laufen über notify-send.

Konfiguration

Die Konfiguration liegt in ~/.claude/hooks/peon-ping/config.json. Die wichtigsten Optionen:

{
  "volume": 0.5,
  "enabled": true,
  "desktop_notifications": true,
  "default_pack": "peon",
  "pack_rotation": ["peon", "sc_kerrigan"],
  "pack_rotation_mode": "random"
}

volume regelt die Lautstärke (0.0 bis 1.0), desktop_notifications schaltet die visuellen Overlay-Benachrichtigungen ein oder aus, und pack_rotation lässt euch mehrere Sound-Packs im Wechsel abspielen — entweder zufällig oder reihum (round-robin). Man kann sogar Packs an bestimmte Projektverzeichnisse binden — GLaDOS für die Arbeit, Peon fürs Hobby.

Per CLI geht das Meiste auch schnell zwischendurch:

peon volume 0.3          # Leiser
peon pause               # Stummschalten
peon resume              # Wieder an
peon status              # Aktueller Zustand

Wer Claude Code nutzt, bekommt außerdem Slash-Commands: /peon-ping-toggle zum Stummschalten, /peon-ping-config für interaktive Einstellungen und /peon-ping-use <pack> zum Wechseln des Sound-Packs in der laufenden Session.

Sound Packs

Und hier wird es lustig. Auf openpeon.com gibt es über 164 Sound-Packs. Der Warcraft-Peon ist der Default, aber es gibt so ziemlich alles: GLaDOS aus Portal, Kerrigan aus StarCraft, den TF2 Engineer, Duke Nukem, Sheogorath aus Elder Scrolls, den Dude aus The Big Lebowski — sogar ein cleanes Chimes-Pack ohne Sprachlinien, falls man es dezenter mag.

Packs installieren und wechseln geht über die CLI:

peon packs list --registry      # Verfügbare Packs anzeigen
peon packs install glados       # GLaDOS installieren
peon packs use glados           # GLaDOS aktivieren
peon packs install --all        # Alle installieren (wenn man sich nicht entscheiden kann)

Die Packs basieren auf der offenen CESP-Spezifikation (Coding Event Sound Pack) — wer eigene Sounds mitbringen will, kann sich relativ einfach ein eigenes Pack bauen.

Fazit

peon-ping ist klein, kostenlos, Open Source (MIT) und löst ein echtes Problem. Kein Terminal-Babysitting mehr, keine verpassten Rückfragen. Und ja — es macht einfach Spaß, wenn der Peon einem bestätigt, dass die Arbeit erledigt ist. „Work complete.“

Nochmal Danke an den Bekannten für den Tipp. Manchmal sind es die kleinen Tools, die den größten Unterschied machen.

Links:

GitHub: github.com/PeonPing/peon-ping
Sound Packs: openpeon.com
Website: peonping.com

Update Oktober 2026: Wenn mehrere Agenten gleichzeitig laufen, reicht ein Ton allein irgendwann nicht mehr für den Überblick. Womit ich das inzwischen organisiere, steht in Orca: eine ADE, in der mehrere Coding-Agenten sauber nebeneinander arbeiten.

Nutzt ihr AI-Coding-Agents im Alltag? Wie haltet ihr es mit Benachrichtigungen — oder sitzt ihr auch und starrt auf den Output? Schreibt mir gerne, ich bin gespannt.

Quantis USB – Alter Quantenzufall aus der Schublade

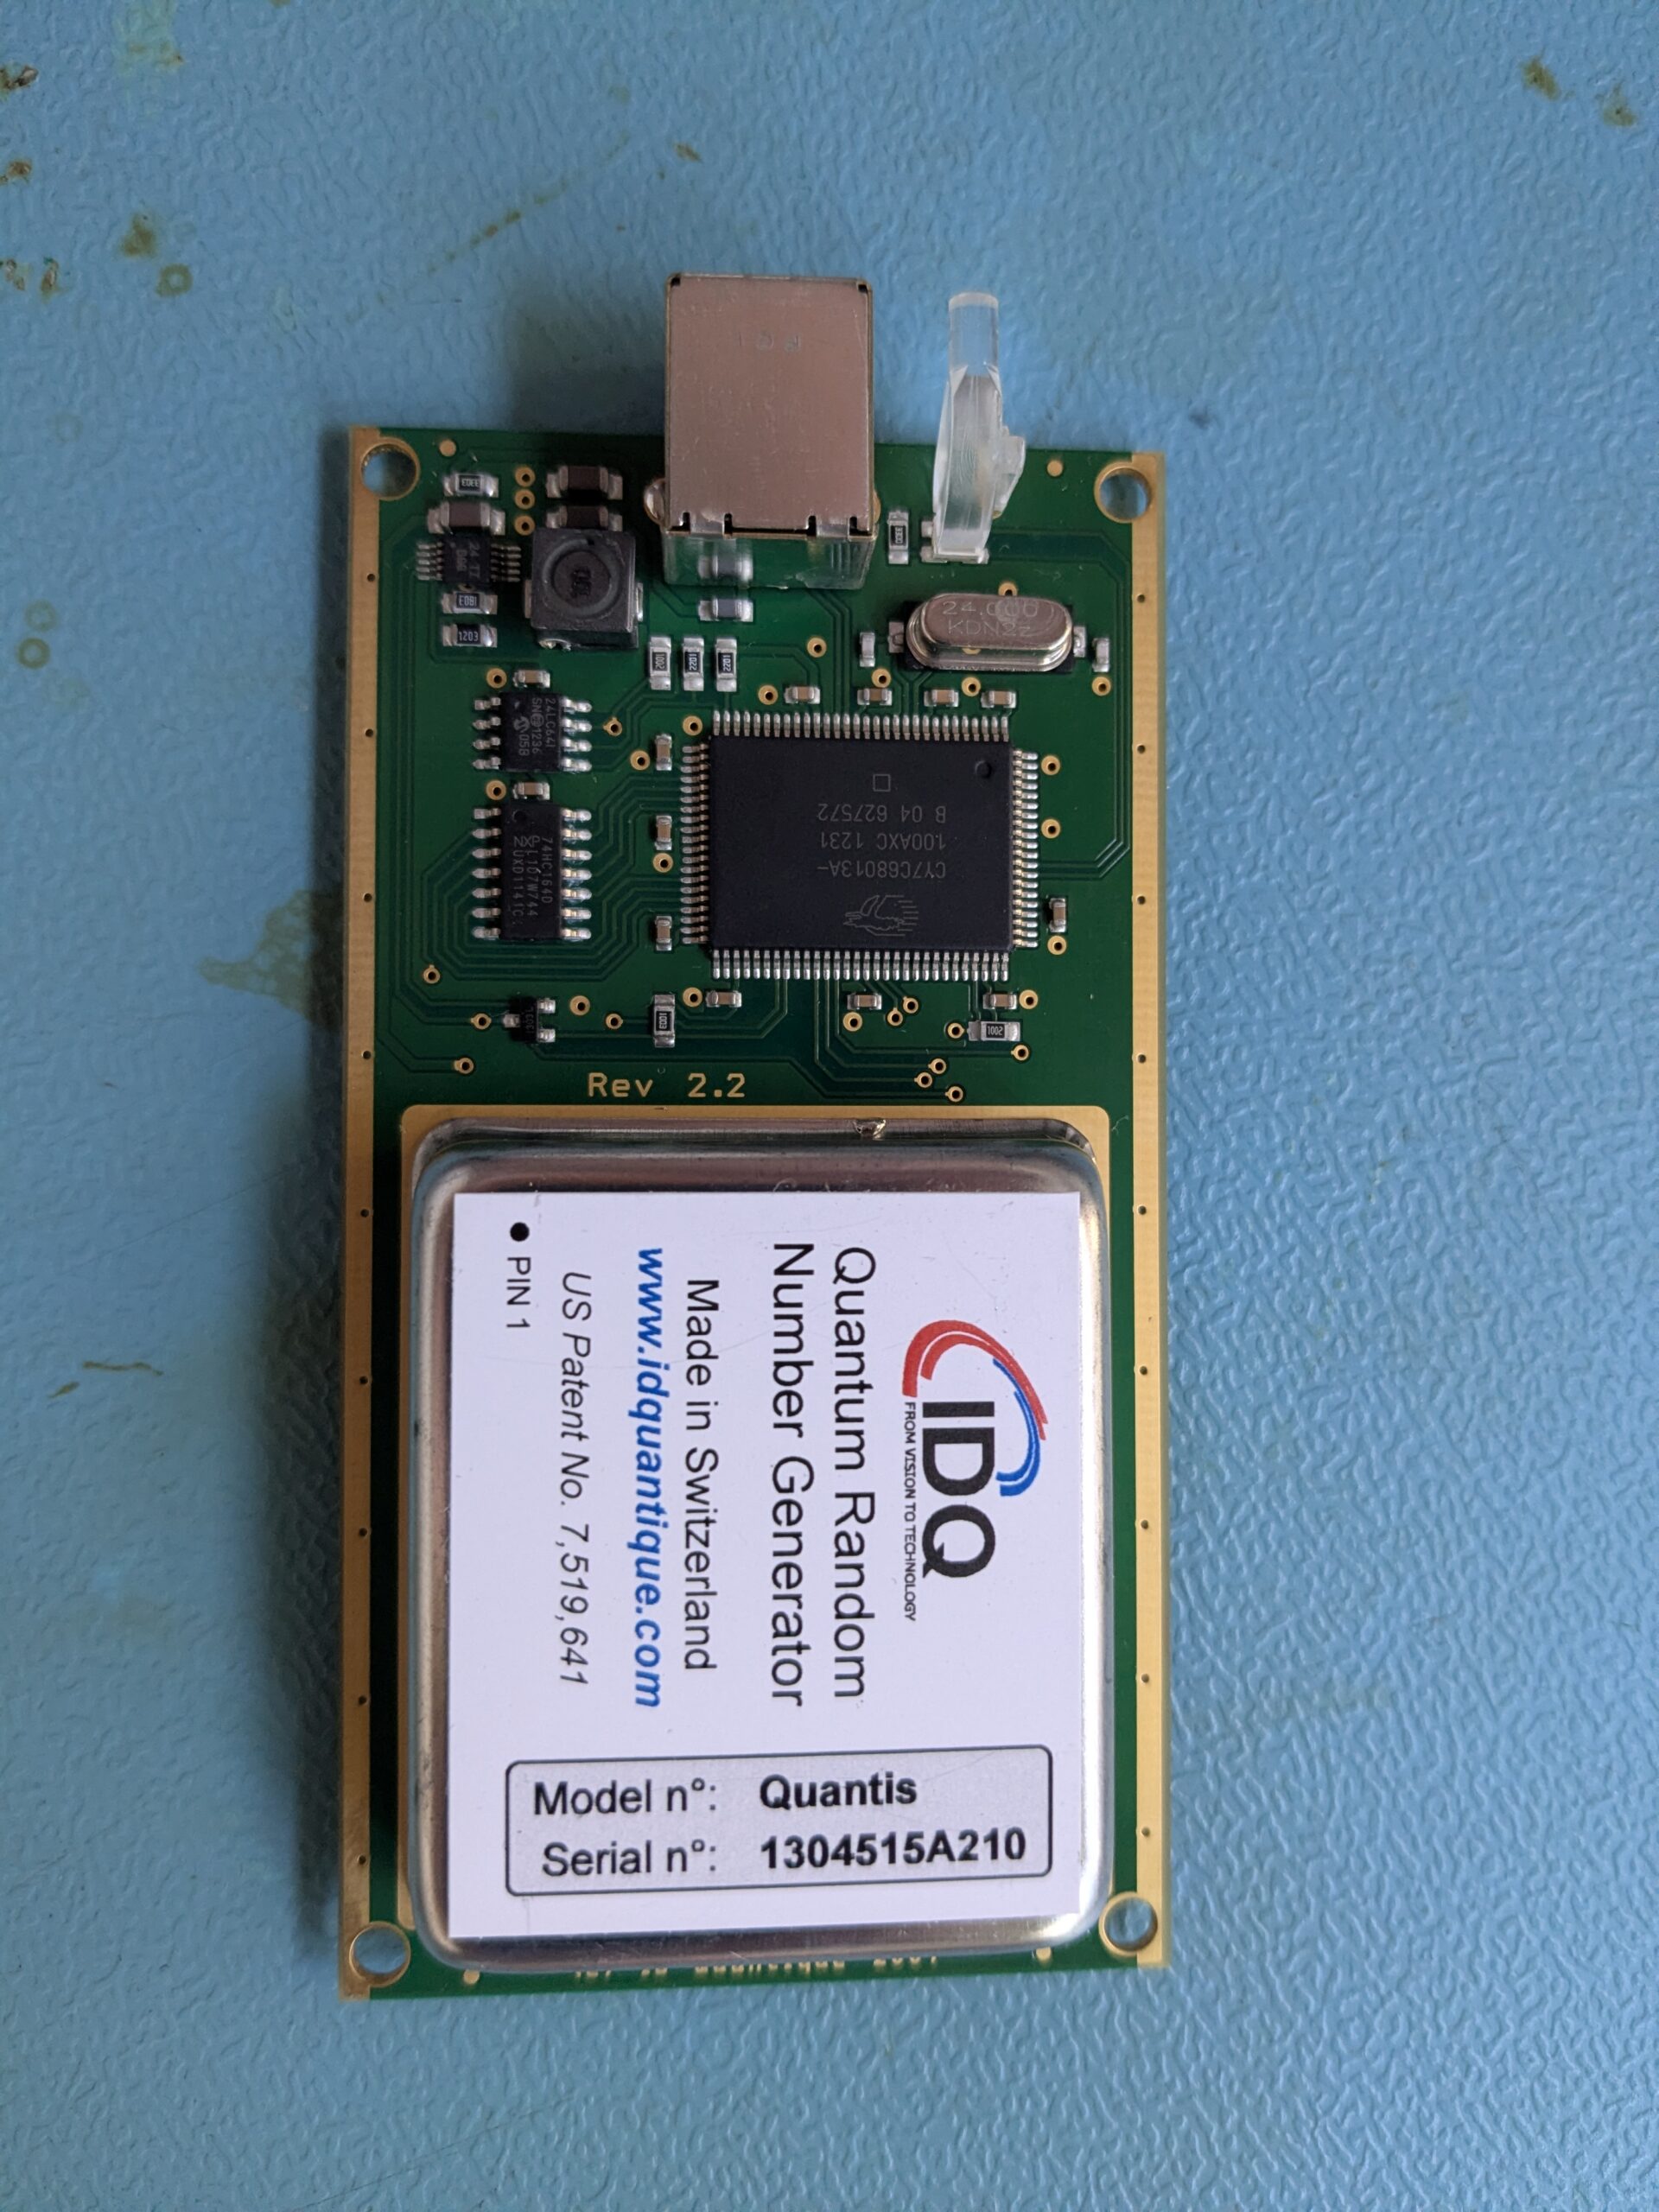
Ich hatte noch einen Quantis USB in der Schublade liegen. Einen Hardware-Quantenzufallsgenerator von ID Quantique aus Genf. Ein Gerät, das echten Zufall erzeugt. Nicht pseudo, nicht algorithmisch, nicht „irgendwie aus Interrupts zusammengewürfelt“, sondern auf Basis von Quantenphysik. Fundamental unvorhersagbar.

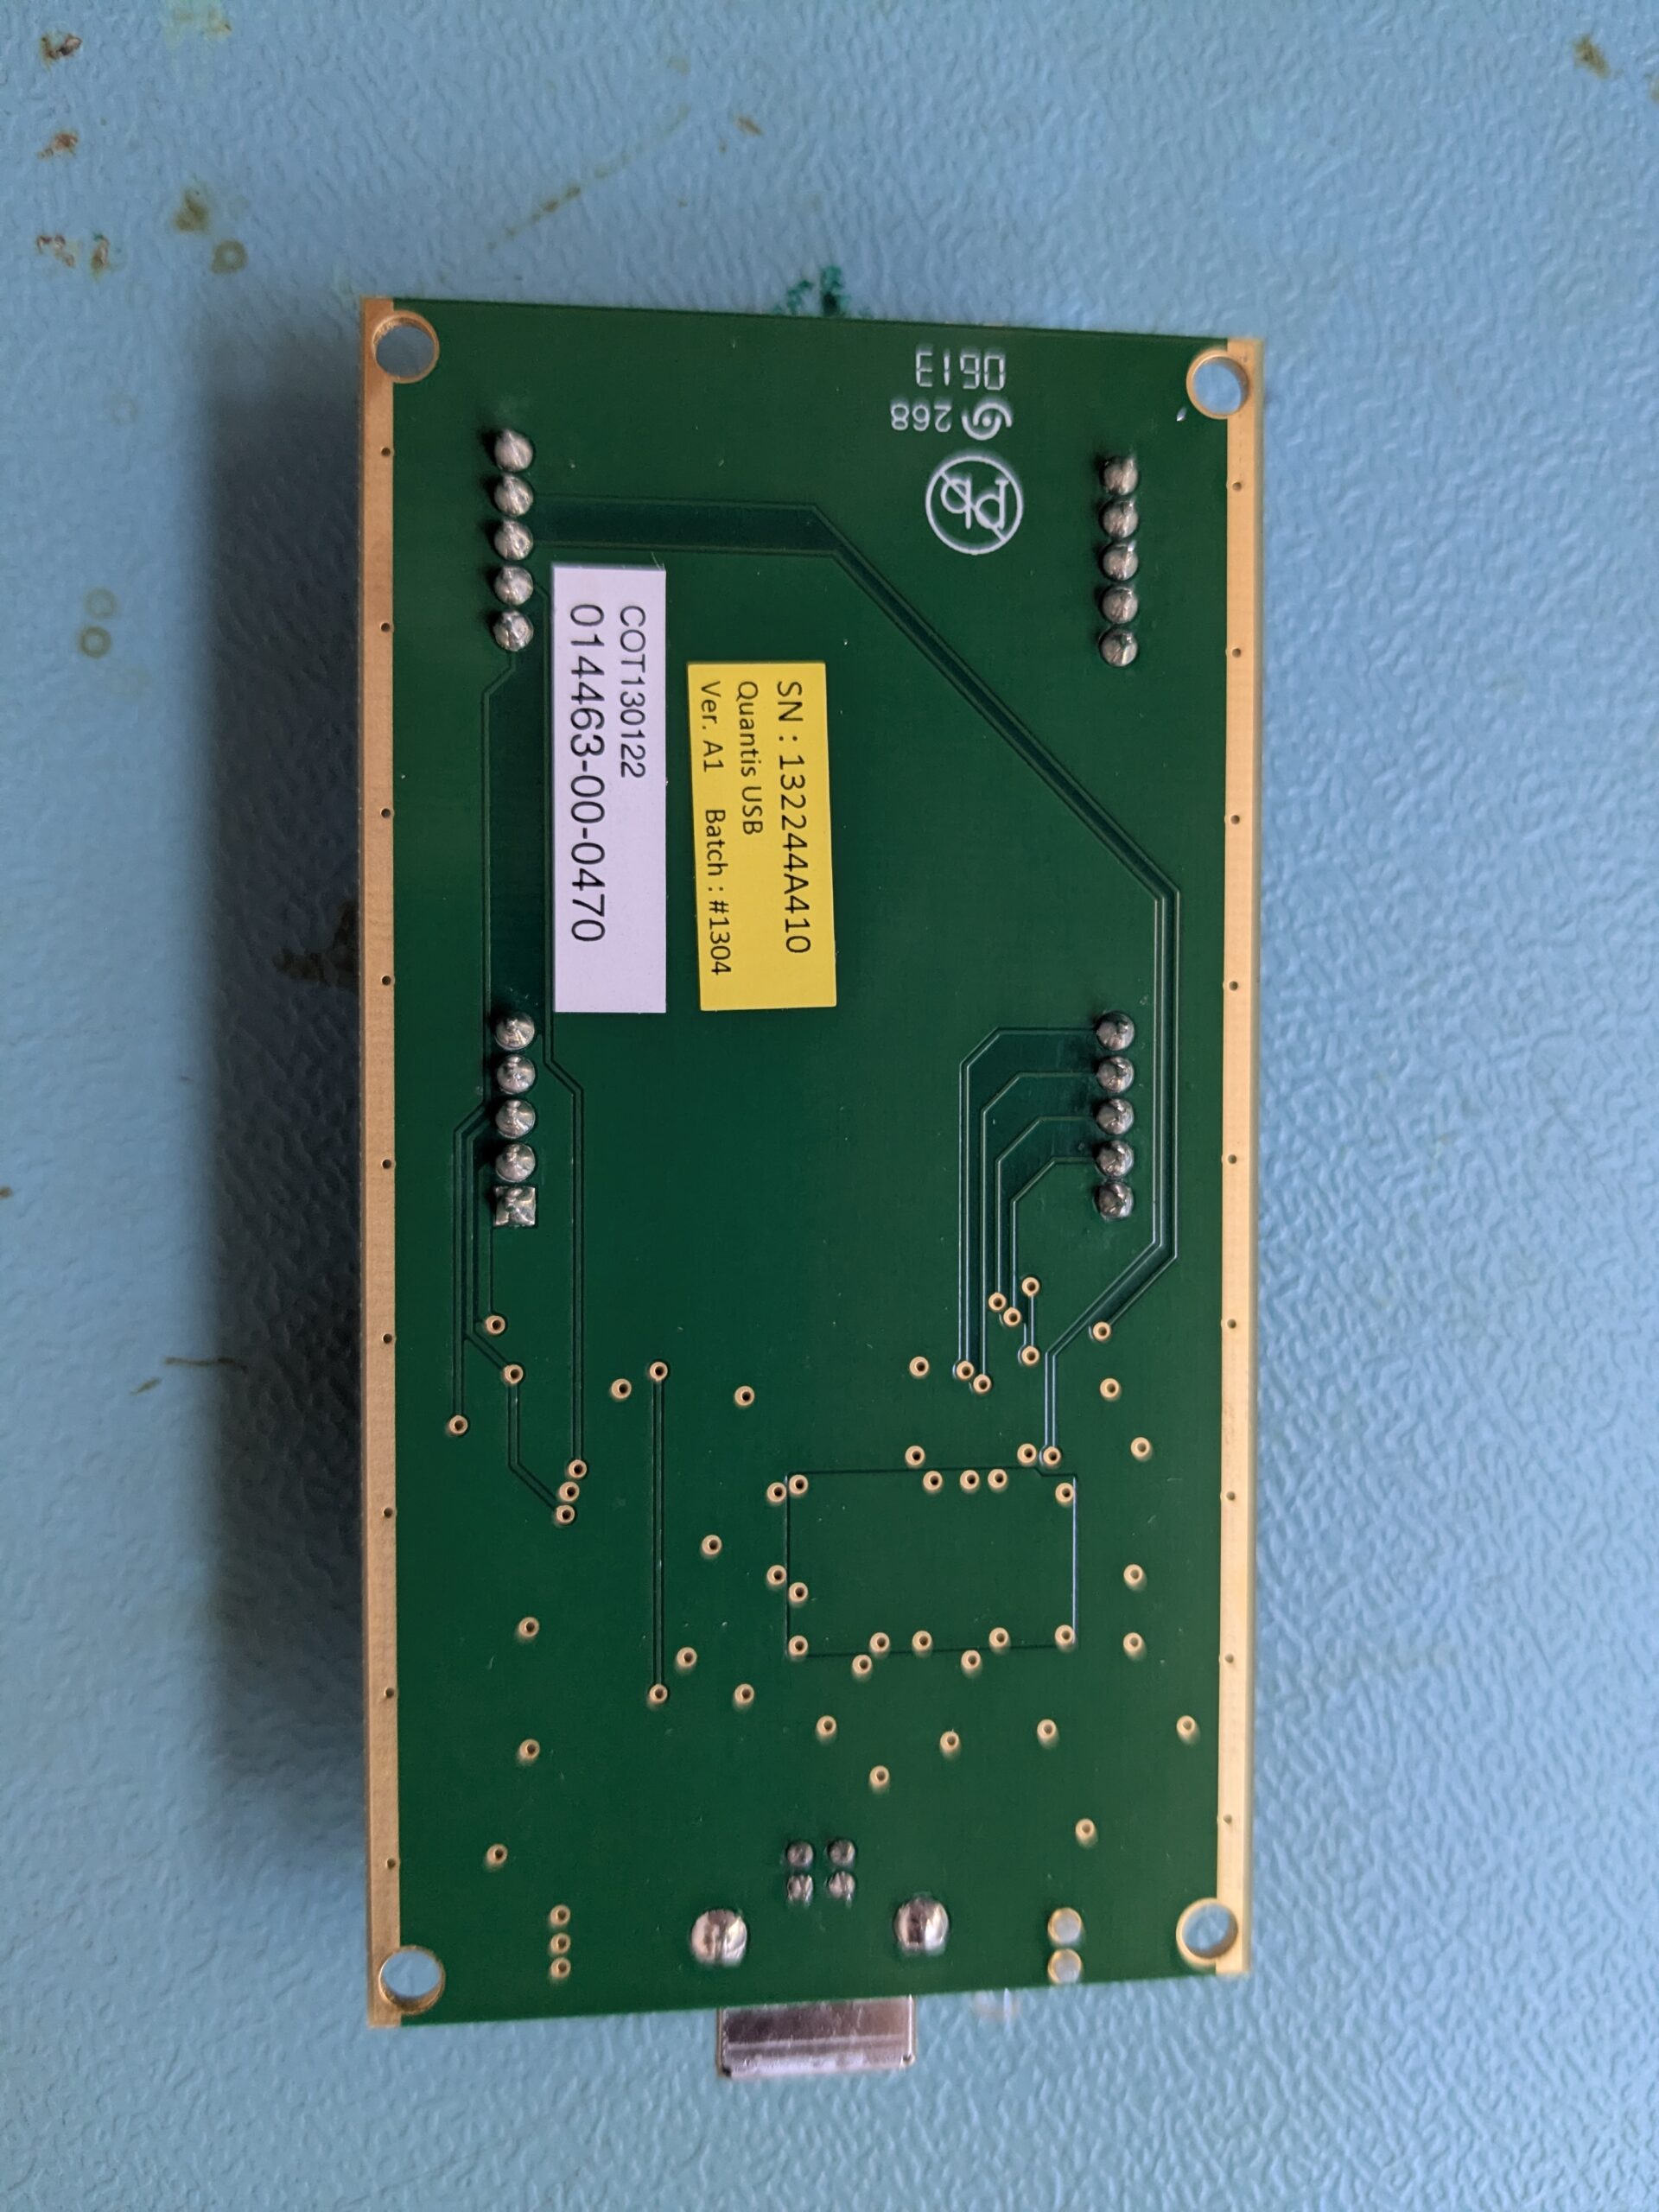
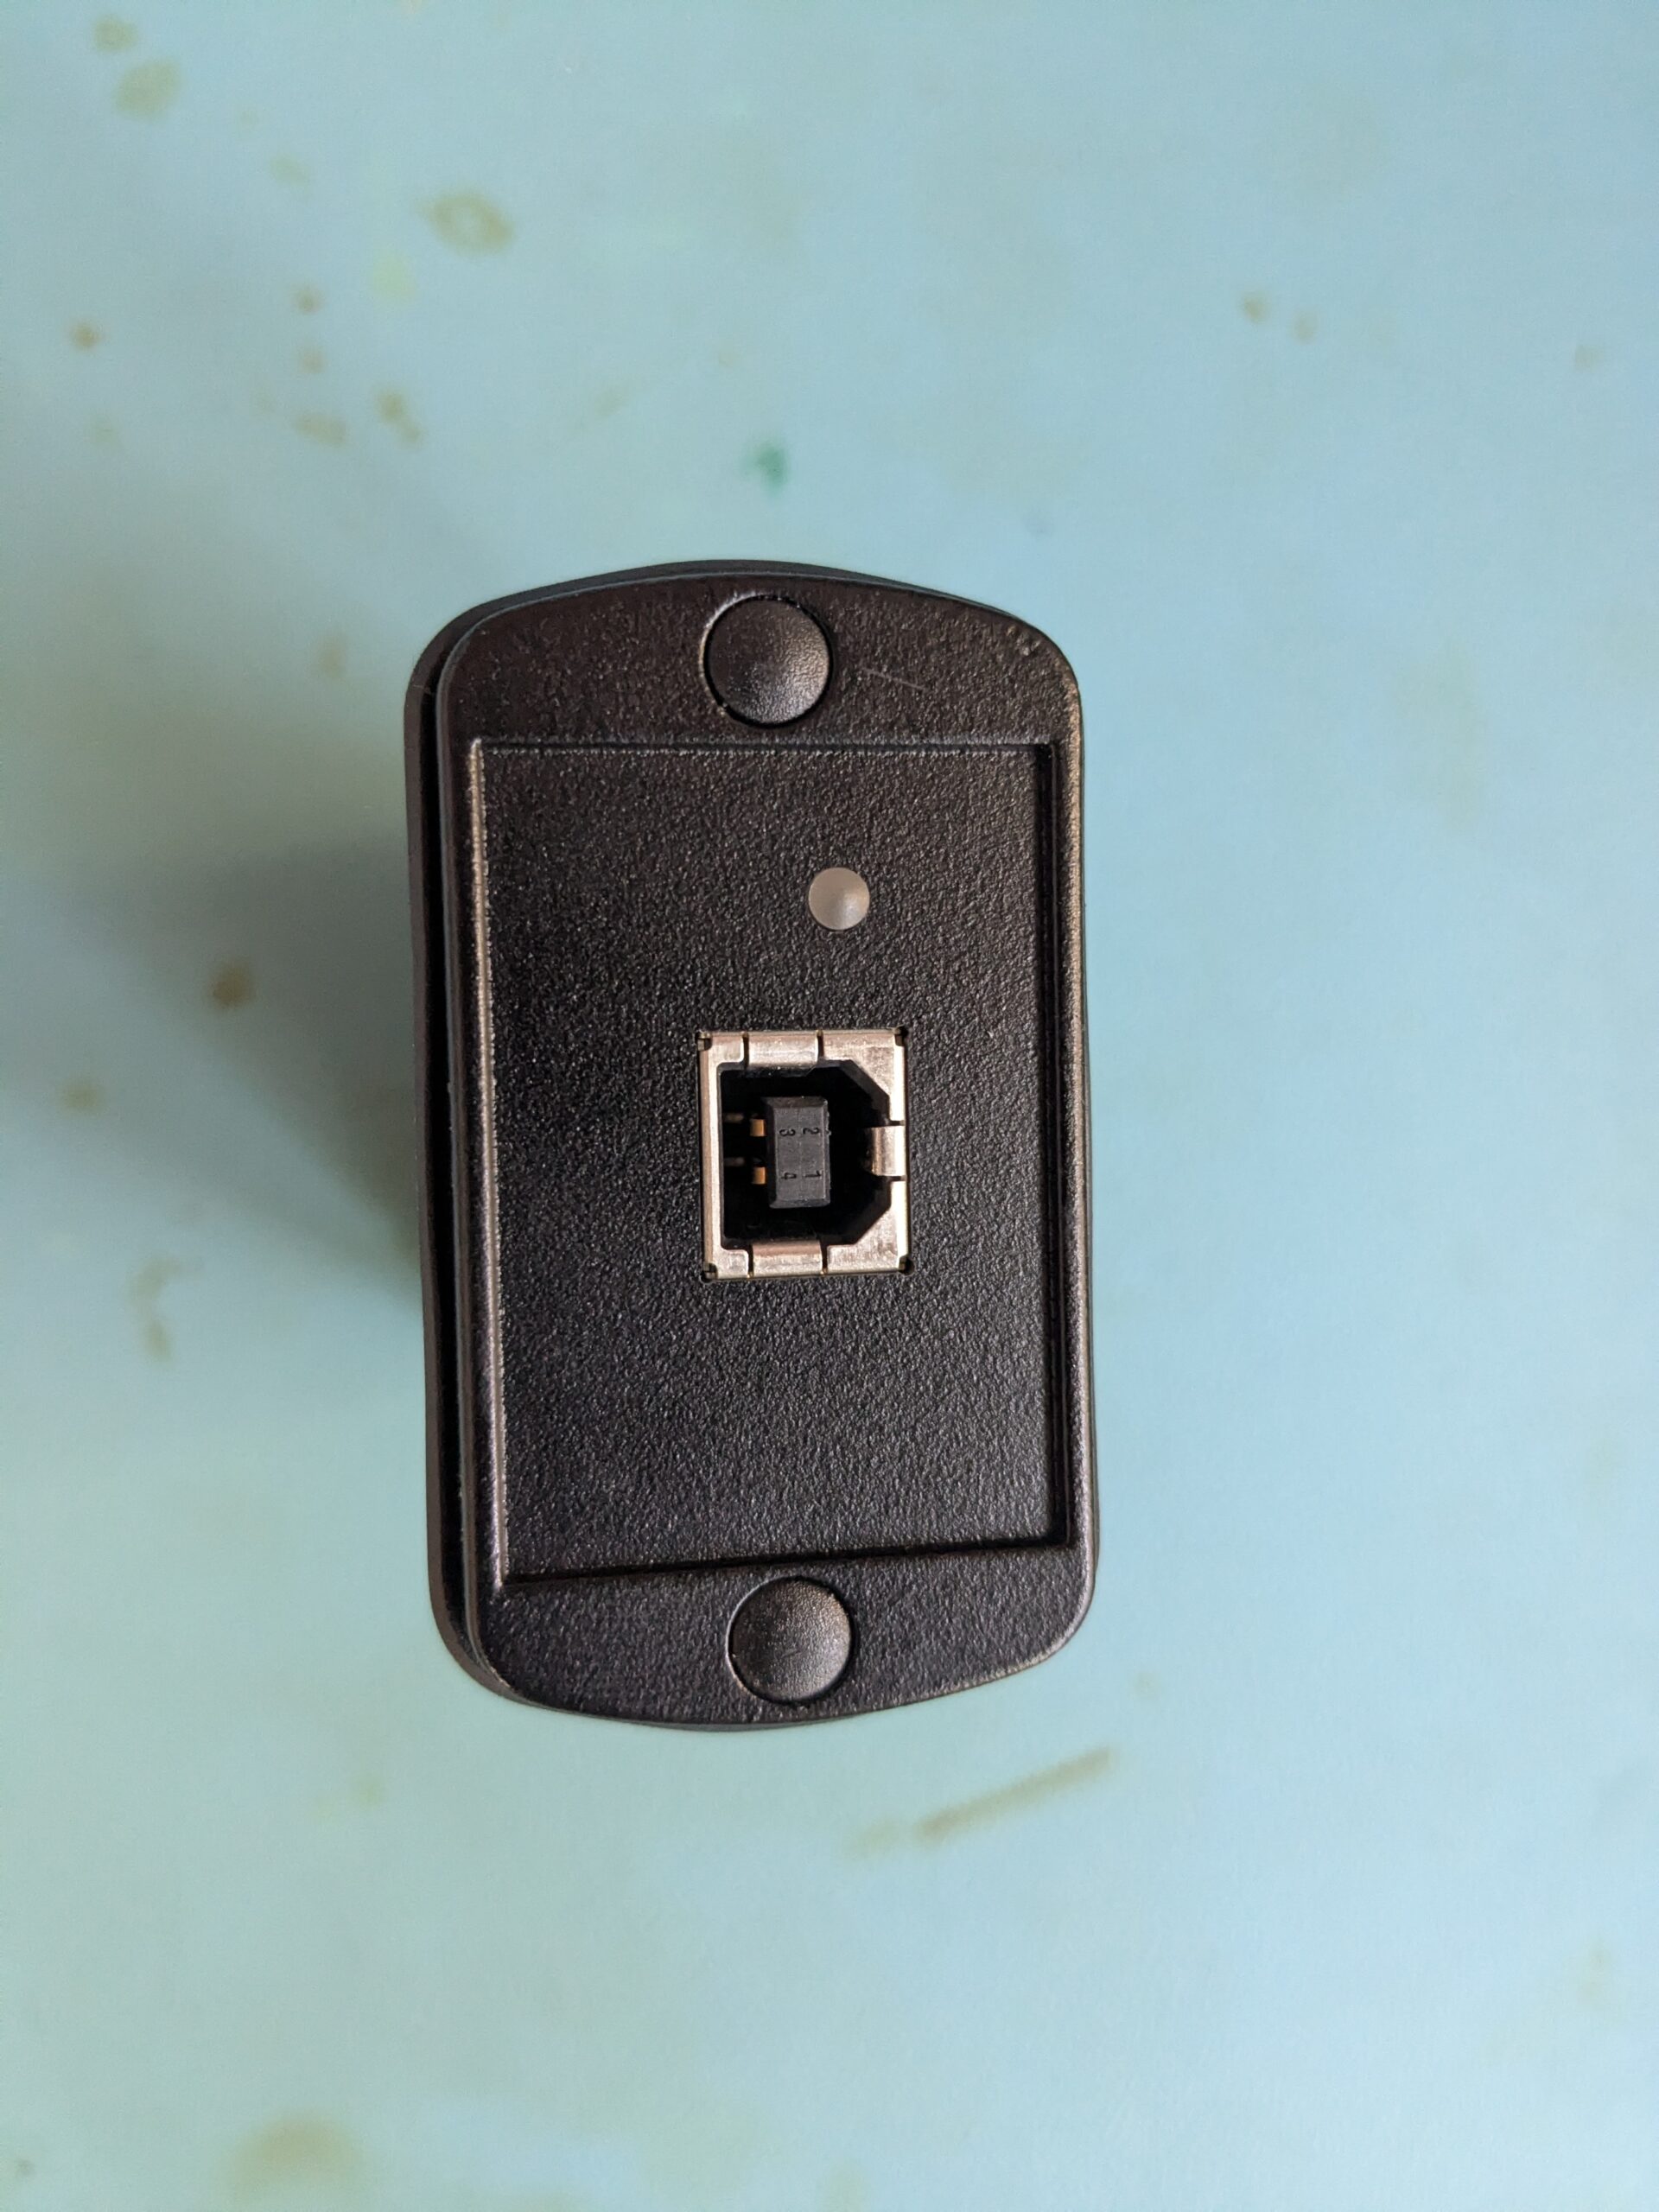
Image of quantis usb

Nachdem ich in den letzten Beiträgen OpenSSH und Postfix/Dovecot mit Post-Quantum-Kryptografie abgesichert habe, fiel mir wieder ein: PQC schützt die Algorithmen vor Quantencomputern. Schön und gut. Aber was ist eigentlich mit der Zufallsquelle, die diese Algorithmen füttert? Zeit, das Teil mal wieder anzuschließen und zu schauen, was es taugt.

Was steckt in dem Gerät?

Der Quantis USB von ID Quantique ist ein sogenannter Quantum Random Number Generator, kurz QRNG. Das Prinzip dahinter: Ein Photonendetektor misst quantenoptisches Vakuumrauschen. Das sind Fluktuationen im elektromagnetischen Feld, die nach den Gesetzen der Quantenmechanik fundamental zufällig sind. Nicht „fast zufällig“ oder „praktisch zufällig“, sondern physikalisch beweisbar unvorhersagbar. Das ist ein wichtiger Unterschied zu allem, was ein Algorithmus je leisten kann. Dazu gleich mehr.

Das Gerät selbst ist fast schon enttäuschend simpel. USB 2.0 High-Speed, ein einziger Bulk-IN-Endpoint (0x86), 512 Bytes pro Read, rund 4 Mbit/s Durchsatz. Flashbare Firmware gibt es nicht. Die „Intelligenz“ steckt in der Optik und einem FPGA, nicht in Software. Das Ding macht genau eine Sache, und die macht es gut.

Mein Testgerät hat die Seriennummer 132244A410. Der Quantis USB ist inzwischen ein Legacy-Produkt, ID Quantique hat einen Nachfolger mit höherem Durchsatz im Programm. Einen öffentlichen Preis hatte das Gerät nie. „Request a Quote“, wie das bei Nischenprodukten mit Zertifizierungsanforderungen so üblich ist. Das Gerät ist METAS-zertifiziert und war für Kunden gedacht, die Common-Criteria-Anforderungen erfüllen müssen. Vergleichbare QRNGs bewegen sich im Bereich von 900 bis 2.000 Euro. Nicht gerade ein Impulskauf.

Einrichten unter Linux

Angeschlossen an mein Linux Mint 22.3 (Ubuntu 24.04 Basis) meldet sich das Gerät sofort im Kernel-Log:

$ dmesg | tail
usb 1-1: New USB device found, idVendor=0aba, idProduct=0102
usb 1-1: Product: Quantis USB
usb 1-1: Manufacturer: id Quantique
usb 1-1: SerialNumber: 132244A410

Kein spezieller Treiber nötig. Das ist ein generisches USB-Bulk-Device, der Kernel erkennt es und das war’s. Die proprietäre libquantis von ID Quantique kann man sich komplett sparen. Man kann direkt mit pyusb auf den Endpoint zugreifen. So mag ich das.

Damit das auch ohne Root funktioniert, legt man eine udev-Regel an:

# /etc/udev/rules.d/99-quantis.rules
SUBSYSTEM=="usb", ATTR{idVendor}=="0aba", ATTR{idProduct}=="0102", MODE="0666", GROUP="plugdev", TAG+="uaccess"

Danach:

$ sudo udevadm control --reload-rules && sudo udevadm trigger

Gerät abstecken, wieder anstecken, fertig. Ab jetzt kann jeder Benutzer in der Gruppe plugdev auf das Gerät zugreifen.

Daten lesen mit Python

Zum Auslesen reicht das Paket python3-usb (pyusb). Installieren via apt install python3-usb, falls nicht vorhanden. Dann braucht man erstaunlich wenig Code:

import usb.core, usb.util

dev = usb.core.find(idVendor=0x0ABA, idProduct=0x0102)
dev.set_configuration()

cfg = dev.get_active_configuration()
intf = cfg[(0, 0)]
ep = usb.util.find_descriptor(
    intf,
    custom_match=lambda e:
        usb.util.endpoint_direction(e.bEndpointAddress) == usb.util.ENDPOINT_IN
)

data = ep.read(512, timeout=5000)
print(f"{len(data)} Bytes Quantenzufall gelesen")

Das ist alles. USB öffnen, Configuration setzen, den einen IN-Endpoint finden, 512 Bytes lesen. Fertig. Kein SDK, keine Bibliothek, kein Account, kein Cloud-Dienst. USB rein, Bytes raus.

Wichtig: Immer volle 512-Byte-Blöcke lesen (wMaxPacketSize). Wer weniger anfordert, bekommt USB-Overflow-Fehler. Das Gerät kennt keine halben Sachen. Es produziert kontinuierlich Zufallsdaten und schiebt sie in den USB-Puffer. Die müssen abgeholt werden, so wie sie kommen.

Für den Test habe ich das Ganze in eine Schleife gepackt und 100.000 Bytes gesammelt. Parallel dazu 100.000 Bytes aus /dev/urandom. Beide Datensätze dann durch dieselben statistischen Tests gejagt.

Der Test: Quantis vs. /dev/urandom

Jetzt wird’s spannend. Wie gut ist echter Quantenzufall im Vergleich zum Software-PRNG des Linux-Kernels?

Spoiler: Statistisch seht ihr keinen Unterschied. Und genau das ist der Punkt.

MetrikQuantis USB/dev/urandom
Shannon-Entropie7,998513 Bits/Byte7,998077 Bits/Byte
Maximum (theoretisch)8,0000008,000000
Effizienz99,9814 %99,9760 %
Chi² (Byte-Verteilung)205,8267,3
Erwartet (Chi²)~255 ± 23~255 ± 23
Bit-Balance (Anteil Einsen)49,975 %50,018 %
Serielle Korrelation+0,001230+0,003801
Längster Bit-Run (10 kB)15 Bits21 Bits
Erwarteter Run~16~16

Die Shannon-Entropie liegt bei beiden Quellen über 99,97 % des theoretischen Maximums von 8 Bit pro Byte. Das ist hervorragend. Die Chi²-Werte zeigen eine gleichmäßige Byte-Verteilung, beide liegen im erwarteten Bereich um 255. Die Bit-Balance ist nahezu perfekt bei 50/50, die serielle Korrelation praktisch null.

In den einfachen Tests schneidet der Quantis sogar minimal besser ab: niedrigere Korrelation, gleichmäßigere Verteilung, kürzerer maximaler Bit-Run. Aber ehrlich gesagt liegt das im statistischen Rauschen. Bei 100.000 Bytes Sample-Größe kann man keine belastbare Aussage über die Überlegenheit einer Quelle treffen. Man müsste Millionen oder Milliarden Bytes testen und Testsuiten wie die NIST SP 800-22 oder Dieharder durchlaufen lassen, um wirklich statistisch signifikante Unterschiede zu finden.

Heißt das, der Quantis ist überflüssig? Nein. Denn der Unterschied liegt nicht in der Statistik.

Wo liegt dann der echte Unterschied?

Die spannende Frage ist nicht, ob die Zahlen „zufälliger“ sind, sondern warum sie es sind.

/dev/urandom verwendet intern ChaCha20, einen deterministischen CSPRNG (Cryptographically Secure Pseudo-Random Number Generator). Der initiale Seed kommt aus der Kernel-Entropie: Hardware-Interrupts, Timing-Jitter, Geräte-Events, und seit einigen Jahren auch RDRAND/RDSEED aus der CPU, falls vorhanden. Das funktioniert in der Praxis hervorragend und ist extrem gut untersucht.

Aber es bleibt ein Algorithmus mit einem internen State. Wer diesen State kennt (und sei es nur theoretisch), kann alle zukünftigen Outputs berechnen. Das ist kein realistisches Angriffsszenario für euren Laptop. Aber es ist eine fundamentale Eigenschaft: Die Sicherheit von /dev/urandom basiert auf Berechnungsannahmen. Man nimmt an, dass ChaCha20 nicht effizient invertierbar ist. Stand heute stimmt das. Aber es ist eine Annahme, kein Beweis.

Der Quantis hingegen erzeugt Zufall aus Quantenvakuum-Fluktuationen. Da gibt es keinen Algorithmus, keinen State, keinen Seed. Die Unvorhersagbarkeit ist nicht durch die Komplexität eines Algorithmus geschützt, sondern durch die Gesetze der Quantenmechanik. Kein Angreifer, egal mit welcher Rechenleistung und egal mit wie viel Zeit, kann die nächsten Bits vorhersagen. Auch kein Quantencomputer. Das ist nicht berechnungstheoretisch sicher, sondern informationstheoretisch sicher. Die höchste Sicherheitskategorie, die es gibt.

Klingt akademisch? Zum Teil. Für den Alltag auf eurem Desktop oder Server reicht /dev/urandom völlig aus. Es gibt keinen bekannten praktischen Angriff darauf, und Linux‘ CSPRNG ist schnell, überall verfügbar und gut gewartet.

Aber es gibt Szenarien, in denen der Unterschied real zählt:

  • Erzeugung kryptografischer Schlüssel mit höchsten Sicherheitsanforderungen
  • Seeding von HSMs (Hardware Security Modules), die selbst keine eigene Entropiequelle haben
  • Regulatorische und Zertifizierungsanforderungen, also Common Criteria, FIPS-Validierung, BSI-Vorgaben
  • Wissenschaftliche Experimente, die physikalisch echten Zufall benötigen (z. B. Quantenoptik, Monte-Carlo-Simulationen)
  • Quantenschlüsselaustausch (QKD), ein Bereich in dem ID Quantique ebenfalls aktiv ist

Das größere Bild: QRNG und PQC

Post-Quantum Cryptography schützt kryptografische Algorithmen davor, von Quantencomputern gebrochen zu werden. ML-KEM für den Schlüsselaustausch, ML-DSA für Signaturen. Das ist die eine Seite der Medaille.

Die andere Seite ist die Zufallsquelle. Ein kryptografischer Algorithmus kann noch so quantensicher sein. Wenn der Zufall, mit dem Schlüssel erzeugt werden, vorhersagbar oder manipulierbar ist, hilft das alles nichts. Der Zufall ist das Fundament, auf dem alles andere aufbaut.

Ein QRNG schützt genau diesen Angriffsvektor. Beides zusammen, PQC-Algorithmen und eine quantenphysikalische Zufallsquelle, ergibt ein quantum-safe Gesamtsystem. Das ist heute für die meisten von uns Overkill. Aber die Bausteine existieren, sie sind verfügbar, und es schadet nicht zu wissen, wie sie funktionieren.

Übrigens: Wer jetzt denkt „dann stecke ich den Quantis in meinen Server und bin sicher“, der macht es sich zu einfach. Die Vertrauensfrage verschiebt sich nur. Woher weiß ich, dass das Gerät tatsächlich Quantenzufall liefert und nicht einfach einen internen PRNG hat? Bei einem zertifizierten Gerät wie dem Quantis gibt es dafür Prüfberichte. Aber Vertrauen in Hardware bleibt immer ein Thema. Das ist bei Intel RDRAND nicht anders.

Einbindung ins System

Für die Vollständigkeit: Der Quantis USB lässt sich über rng-tools (rngd) als zusätzliche Entropiequelle in den Kernel-Entropiepool einbinden. Für Server mit hohem Entropie-Bedarf, also TLS-Terminierung unter Last, Massenerzeugung von Schlüsseln oder VPN-Gateways, kann das sinnvoll sein.

Ich habe das auf meinem Desktop nicht gemacht. Brauche ich dort nicht. Aber die Möglichkeit steht im Raum, falls jemand von euch einen Quantis oder ein vergleichbares Gerät an einen Server hängen möchte.

Fazit

Ein alter Hardware-QRNG, ein USB-Port, ein paar Zeilen Python, und man hat echten Quantenzufall auf dem Tisch. Statistisch nicht unterscheidbar von /dev/urandom, aber fundamental anders in der Entstehung. Die Sicherheit kommt nicht aus einem Algorithmus, sondern aus der Physik. Informationstheoretisch statt berechnungstheoretisch. Ein Unterschied, der in den allermeisten Fällen keine praktische Rolle spielt. Aber ein verdammt eleganter.

Für euren Desktop braucht ihr das nicht. Aber verstehen, warum es existiert und wie es sich einordnet, gerade im Kontext von Post-Quantum-Kryptografie, das lohnt sich. Warum denke ich jetzt an CIA und MAD? ;-D

Wie haltet ihr es mit euren Zufallsquellen? Vertraut ihr blind auf /dev/urandom, oder habt ihr euch schon mal Gedanken über die Entropiequelle dahinter gemacht?

NEXT Biometrics NB-2020-U Fingerabdruckleser unter Linux zum Laufen gebracht

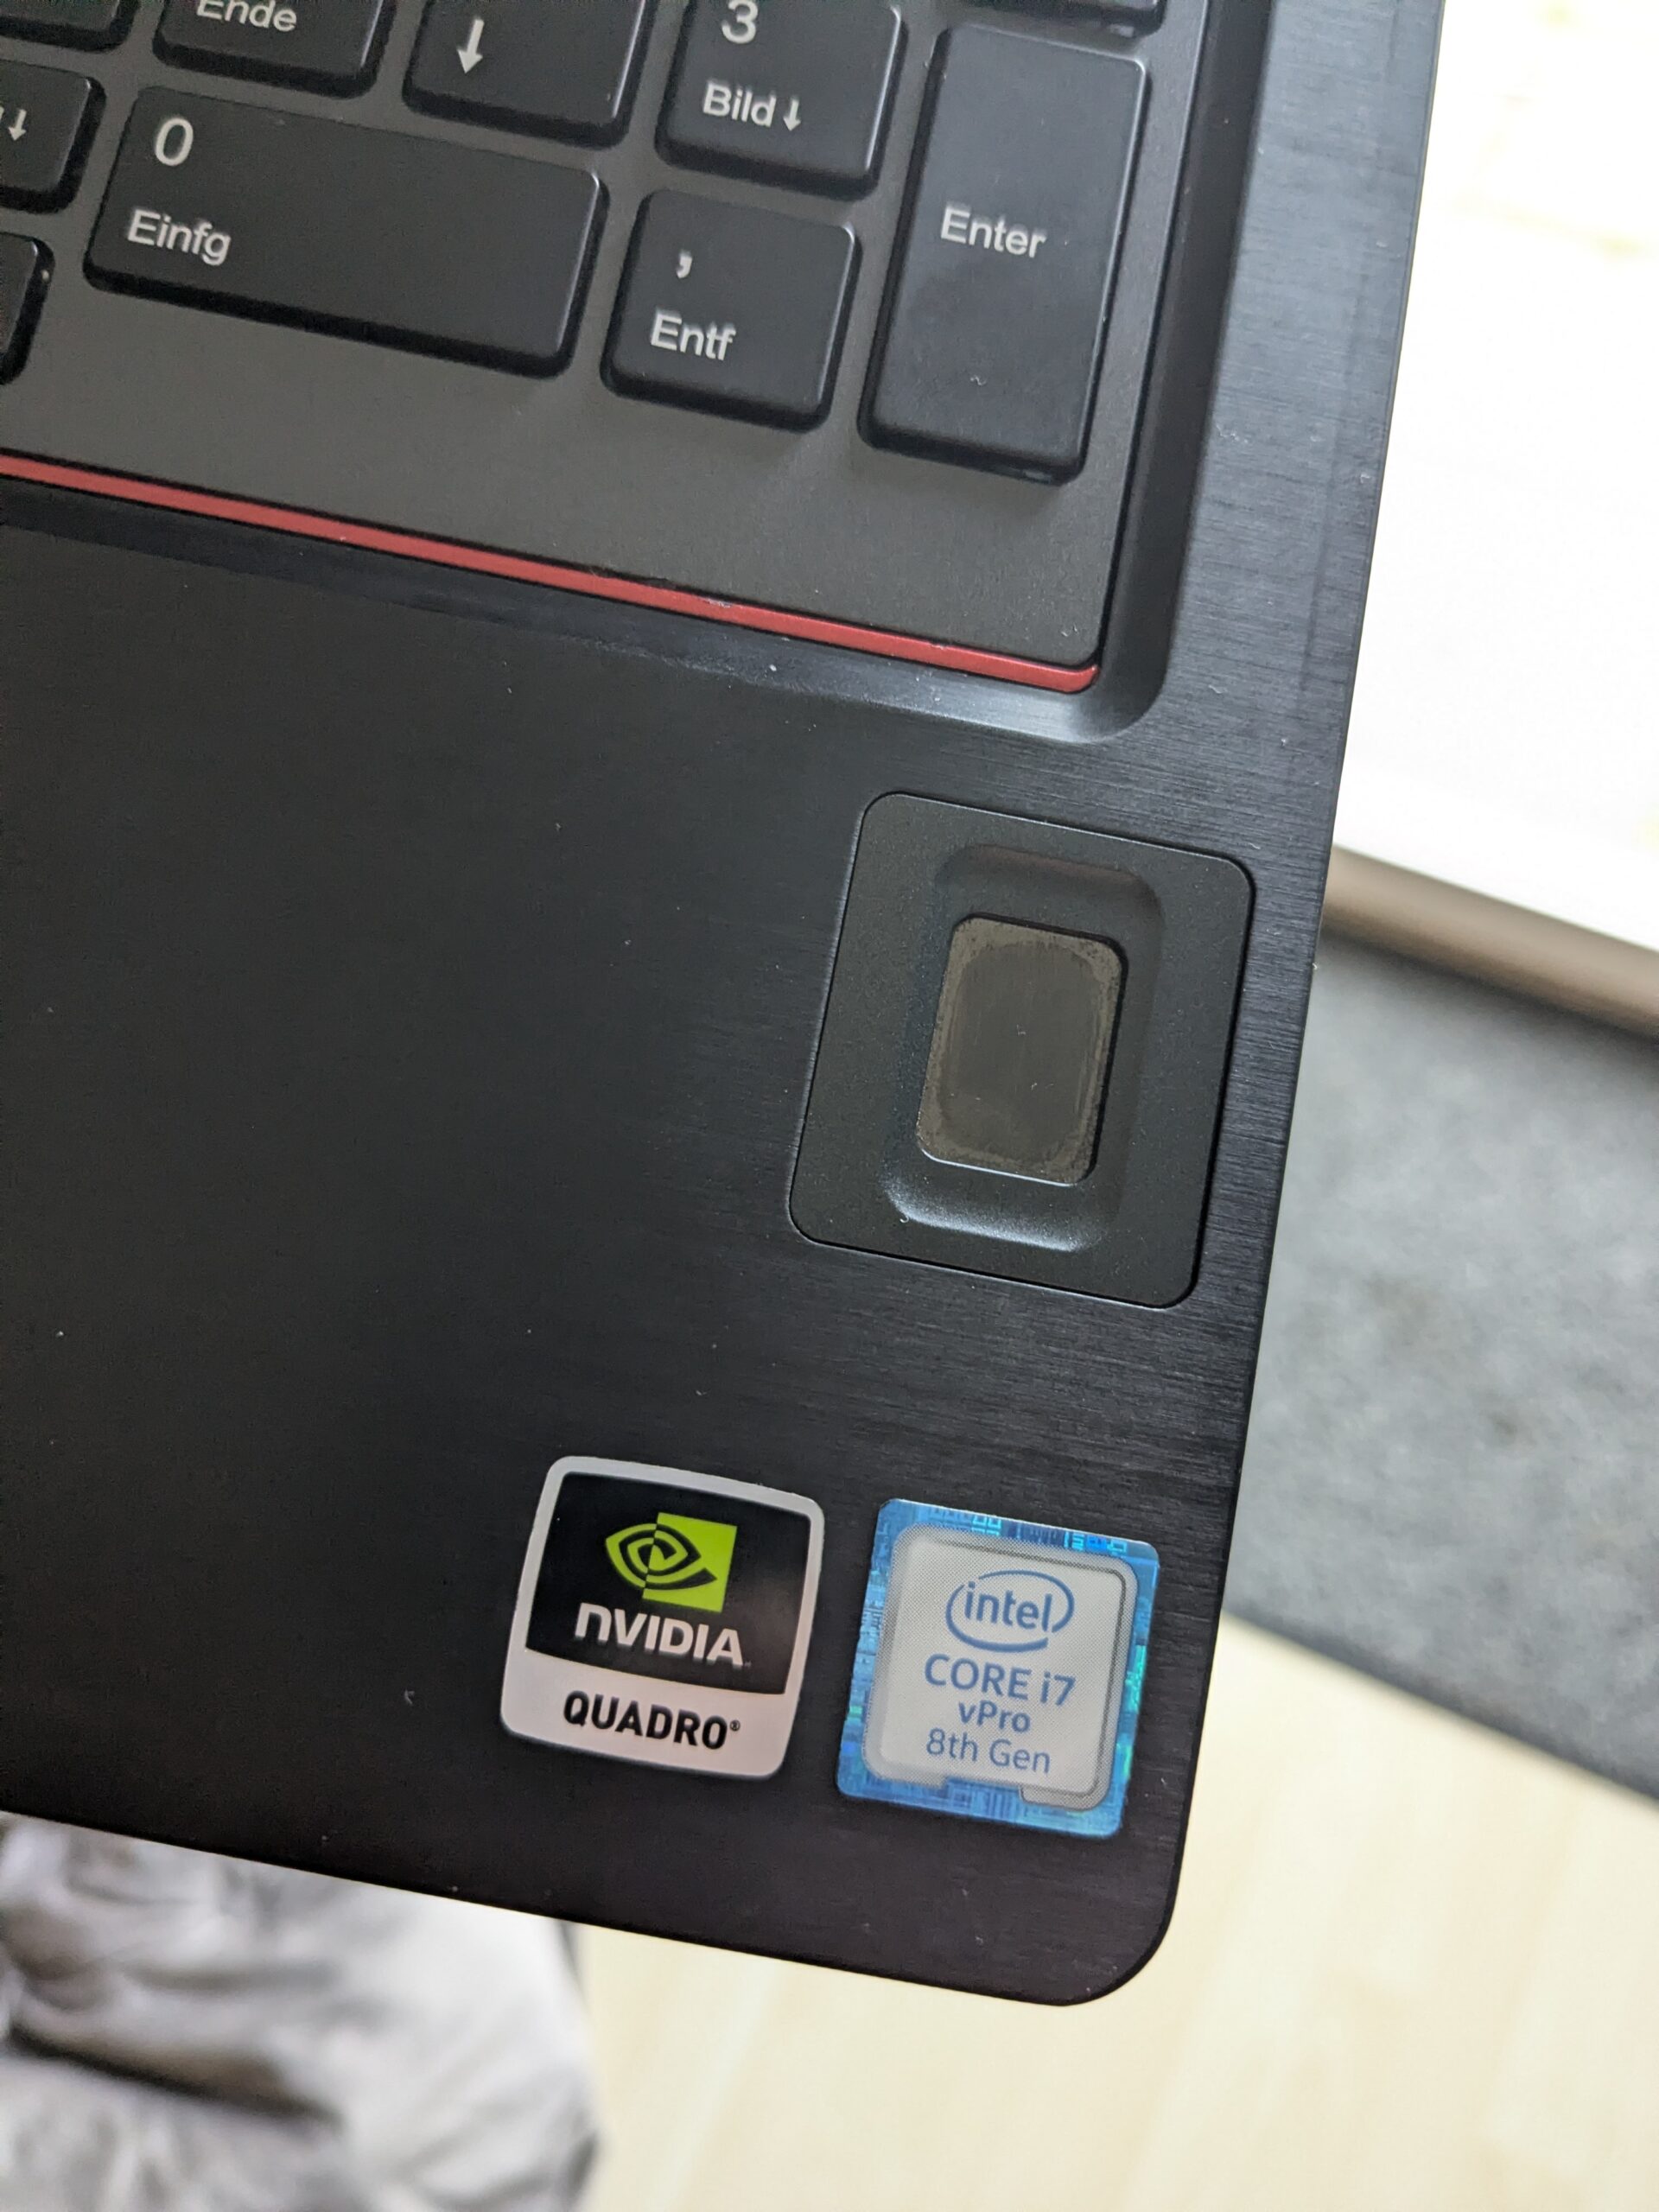
In meinem Fujitsu Notebook steckt ein Fingerabdruckleser. Ein NEXT Biometrics NB-2020-U, USB ID 298d:2020. Unter Windows funktioniert er, unter Linux nicht. Kein Treiber, kein Support, nichts. Das Gerät taucht in lsusb auf, wird aber von keinem Treiber erkannt. Im libfprint Wiki steht es auf der Liste der nicht unterstützten Geräte. Dort steht es schon eine Weile.

Das hat mich gestört.

Picture of NB-2020-U

libfprint kennt den NB-1010-U. Das ist ein externer USB Fingerabdruckleser von NEXT Biometrics, der seit einiger Zeit einen funktionierenden Treiber hat. Der NB-2020-U ist die eingebettete Variante desselben Sensors, gedacht für den Einbau in Notebooks. Wenn man sich Teardown Reports ansieht, etwa von System Plus Consulting oder Yole Group, dann stellt man fest: Beide Geräte verwenden den identischen Sensor Die. Gleiche Technik, anderes Gehäuse.

Das war der erste Anhaltspunkt. Wenn die Hardware gleich ist, sollte auch das USB Protokoll gleich sein. Und wenn das Protokoll gleich ist, sollte der vorhandene Treiber funktionieren.

Bevor ich aber einfach auf Verdacht losprogrammiert habe, wollte ich es absichern. Ich habe NEXT Biometrics direkt angeschrieben. Kevin Hung, Director FAE bei NEXT Biometrics, hatte mir bereits 2022 auf eine Anfrage zu Linux Treibern geantwortet. Damals war sein Vorschlag, über Fujitsu zu gehen. Das führte ins Leere. Diesmal habe ich konkret angeboten, selbst einen libfprint Treiber zu schreiben, und um das SDK gebeten.

Kevin hat mir daraufhin das NBBiometrics ANF SDK 3.0.0.1384 zugeschickt. Ein komplettes SDK mit Headern, Bibliotheken, Beispielcode und Dokumentation. Das war sehr hilfreich, denn die Header bestätigen einiges. Das SDK nutzt eine einzige Shared Library libNBBiometrics.so für alle Gerätetypen. Der NB-1010-U hat den internen Gerätetyp 200, der NB-2020-U den Typ 202. Beide verwenden dasselbe Scanformat: 180×256 Pixel bei 385 DPI. Die USB Vendor ID ist bei beiden 0x298d, nur die Product ID unterscheidet sich: 0x1010 beim einen, 0x2020 beim anderen.

Wichtig: Das SDK ist proprietär. Für den eigentlichen Treiber habe ich keinen Code daraus verwendet. libfprint akzeptiert nur sauberen, eigenständig entwickelten Code. Das SDK diente ausschließlich als Referenz, um die Protokollkompatibilität zu bestätigen.

Also habe ich es einfach ausprobiert. Den bestehenden nb1010.c Treiber genommen, die USB Product ID 0x2020 zur id_table hinzugefügt und gebaut. Dann auf dem Fujitsu Notebook getestet.

Es funktionierte sofort.

Geräteerkennung, USB Interface Claim, die State Machine für die Fingererkennung, alles lief auf Anhieb. fprintd-enroll hat Fingerabdrücke aufgenommen, fprintd-verify hat sie korrekt verifiziert. Der bestehende Treibercode brauchte keinerlei Anpassungen. Null. Nur die PID in der Tabelle und den Gerätenamen.

Ein Blick auf die USB Deskriptoren bestätigt das Bild. Der NB-2020-U hat exakt dasselbe Endpoint Layout wie der NB-1010-U: Bulk OUT auf Endpoint 0x02, Bulk IN auf Endpoint 0x83. Dazu kommt ein Interrupt Endpoint auf 0x81, den der Treiber nicht verwendet. Die Kommunikation läuft identisch ab.

Der Patch selbst ist entsprechend klein. Drei Dateien, drei Zeilen rein, drei Zeilen raus:

  1. libfprint/drivers/nb1010.c: Die neue PID 0x2020 wird in die id_table eingetragen und der full_name auf "NextBiometrics NB-1010-U/NB-2020-U" erweitert.
  2. data/autosuspend.hwdb: Der Eintrag 298d:2020 wird von der Liste der nicht unterstützten Geräte in die Sektion des nb1010 Treibers verschoben.
  3. libfprint/fprint-list-udev-hwdb.c: Der Eintrag wird aus der Allowlist der nicht unterstützten Geräte entfernt, da er jetzt vom Treiber abgedeckt wird.

Den Merge Request habe ich bei libfprint upstream eingereicht: MR !569. Die CI Pipeline läuft durch, alle 124 Tests bestehen. Jetzt heißt es warten auf das Review durch die Maintainer.

Update, Juli 2026: Das Warten ist vorbei. MR !569 ist am 2. Juli 2026 upstream gemergt. Maintainer Marco Trevisan hat den Patch auf den aktuellen master rebased und per Auto-Merge aufgenommen, ohne blockierende Review-Kommentare. Der NB-2020-U wird damit ab der nächsten libfprint Version out of the box unterstützt. Die Details stehen im kurzen Nachtrag zum Merge.

Für alle, die denselben Fingerabdruckleser in ihrem Notebook haben: Sobald der Patch gemergt und in einer neuen libfprint Version enthalten ist, funktioniert der Sensor out of the box. Enrollment und Verifikation über fprintd laufen sauber. Wer nicht warten möchte, kann den Patch auch jetzt schon selbst auf ein aktuelles libfprint anwenden.

Im selben Fujitsu Notebook meiner Tochter steckt ein NB-2033-U, ein weiterer Fingerabdruckleser aus der gleichen Familie. Der verwendet allerdings ein komplett anderes Protokoll und ließ sich nicht einfach mit dem nb1010 Treiber ansprechen. Den habe ich per Reverse Engineering geknackt.

PDS OSIcom-Office Box: Retro-PC mit JUMPtec SBC & SUSE Linux​

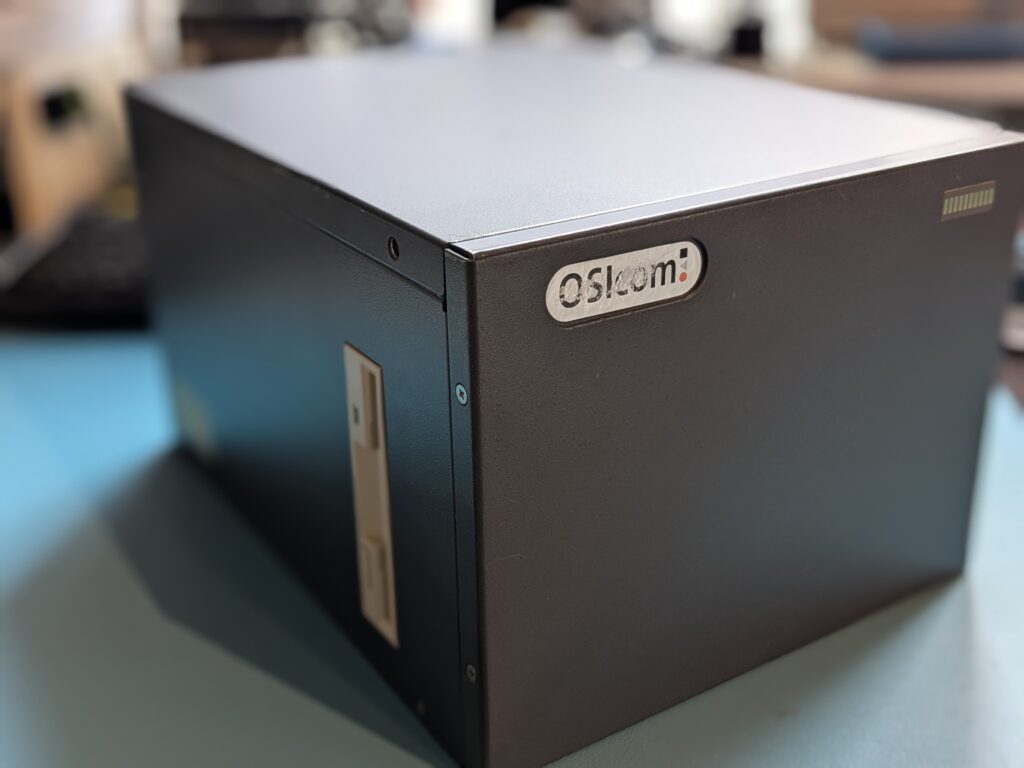
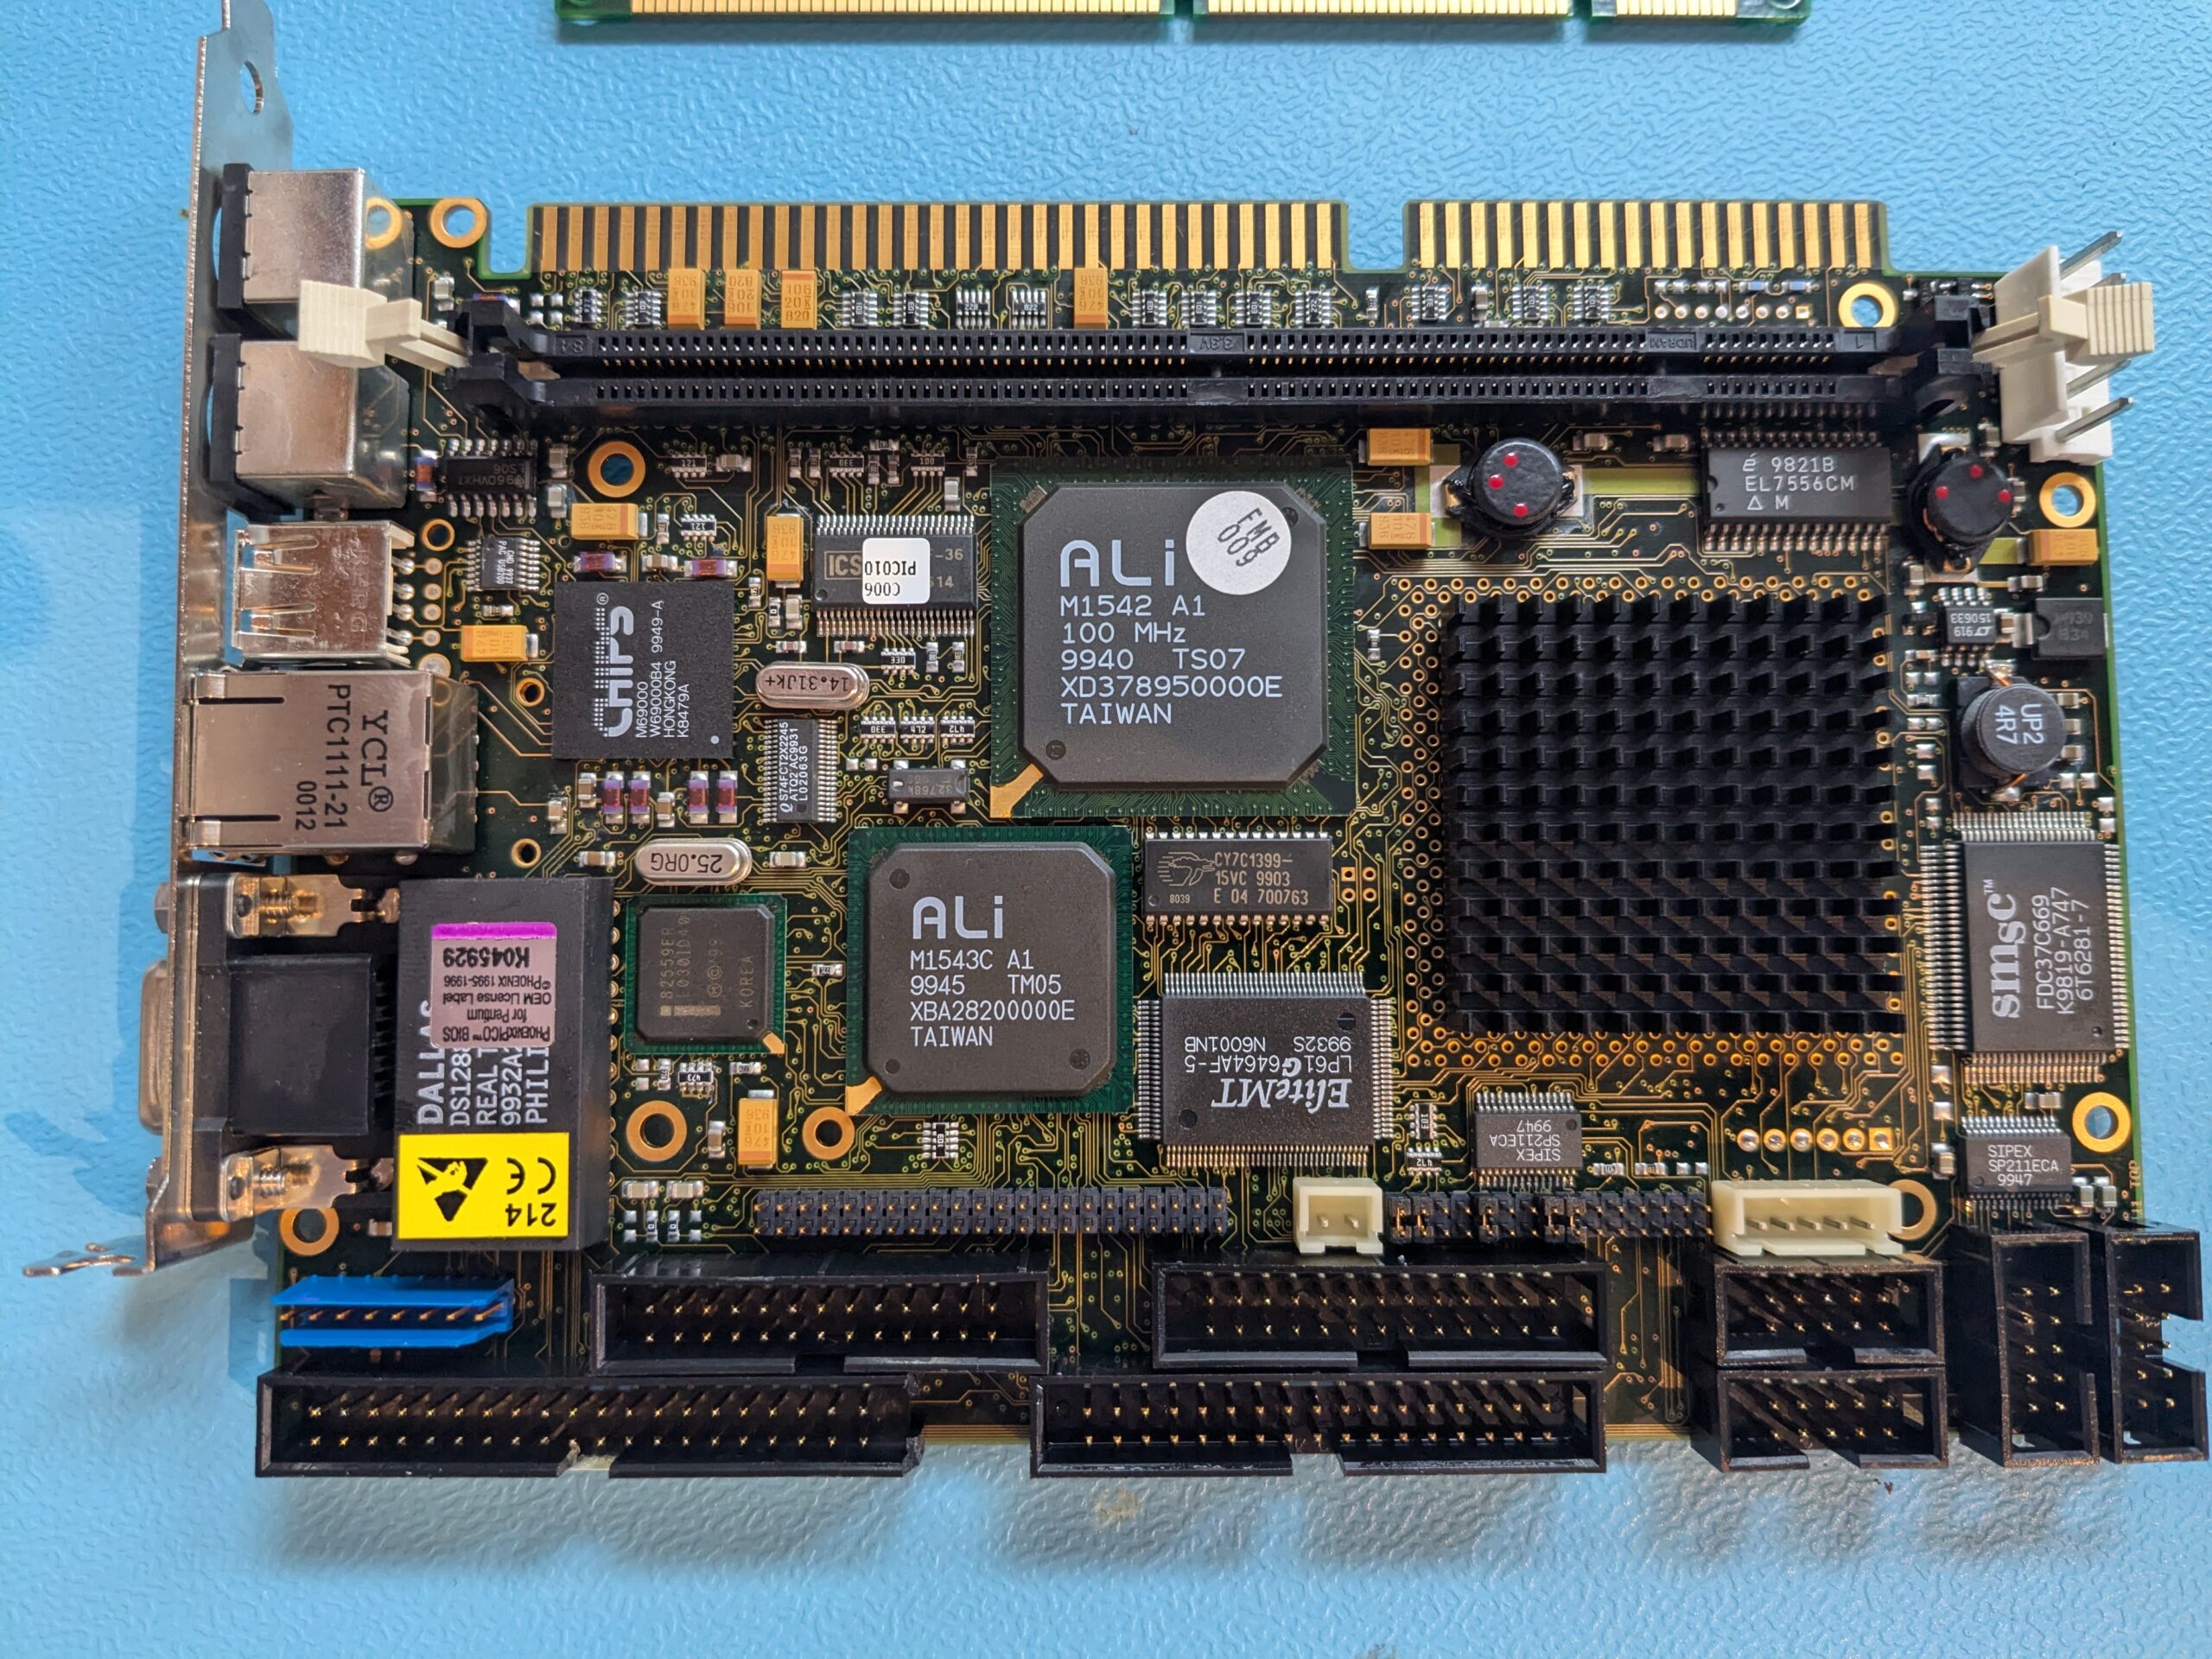
Vor etwas über 20 Jahren habe ich unter anderem mit OSIcom-office Boxen von PDS (Programm und Datenservice) gearbeitet. Dazu habe ich schon mal etwas geschrieben.

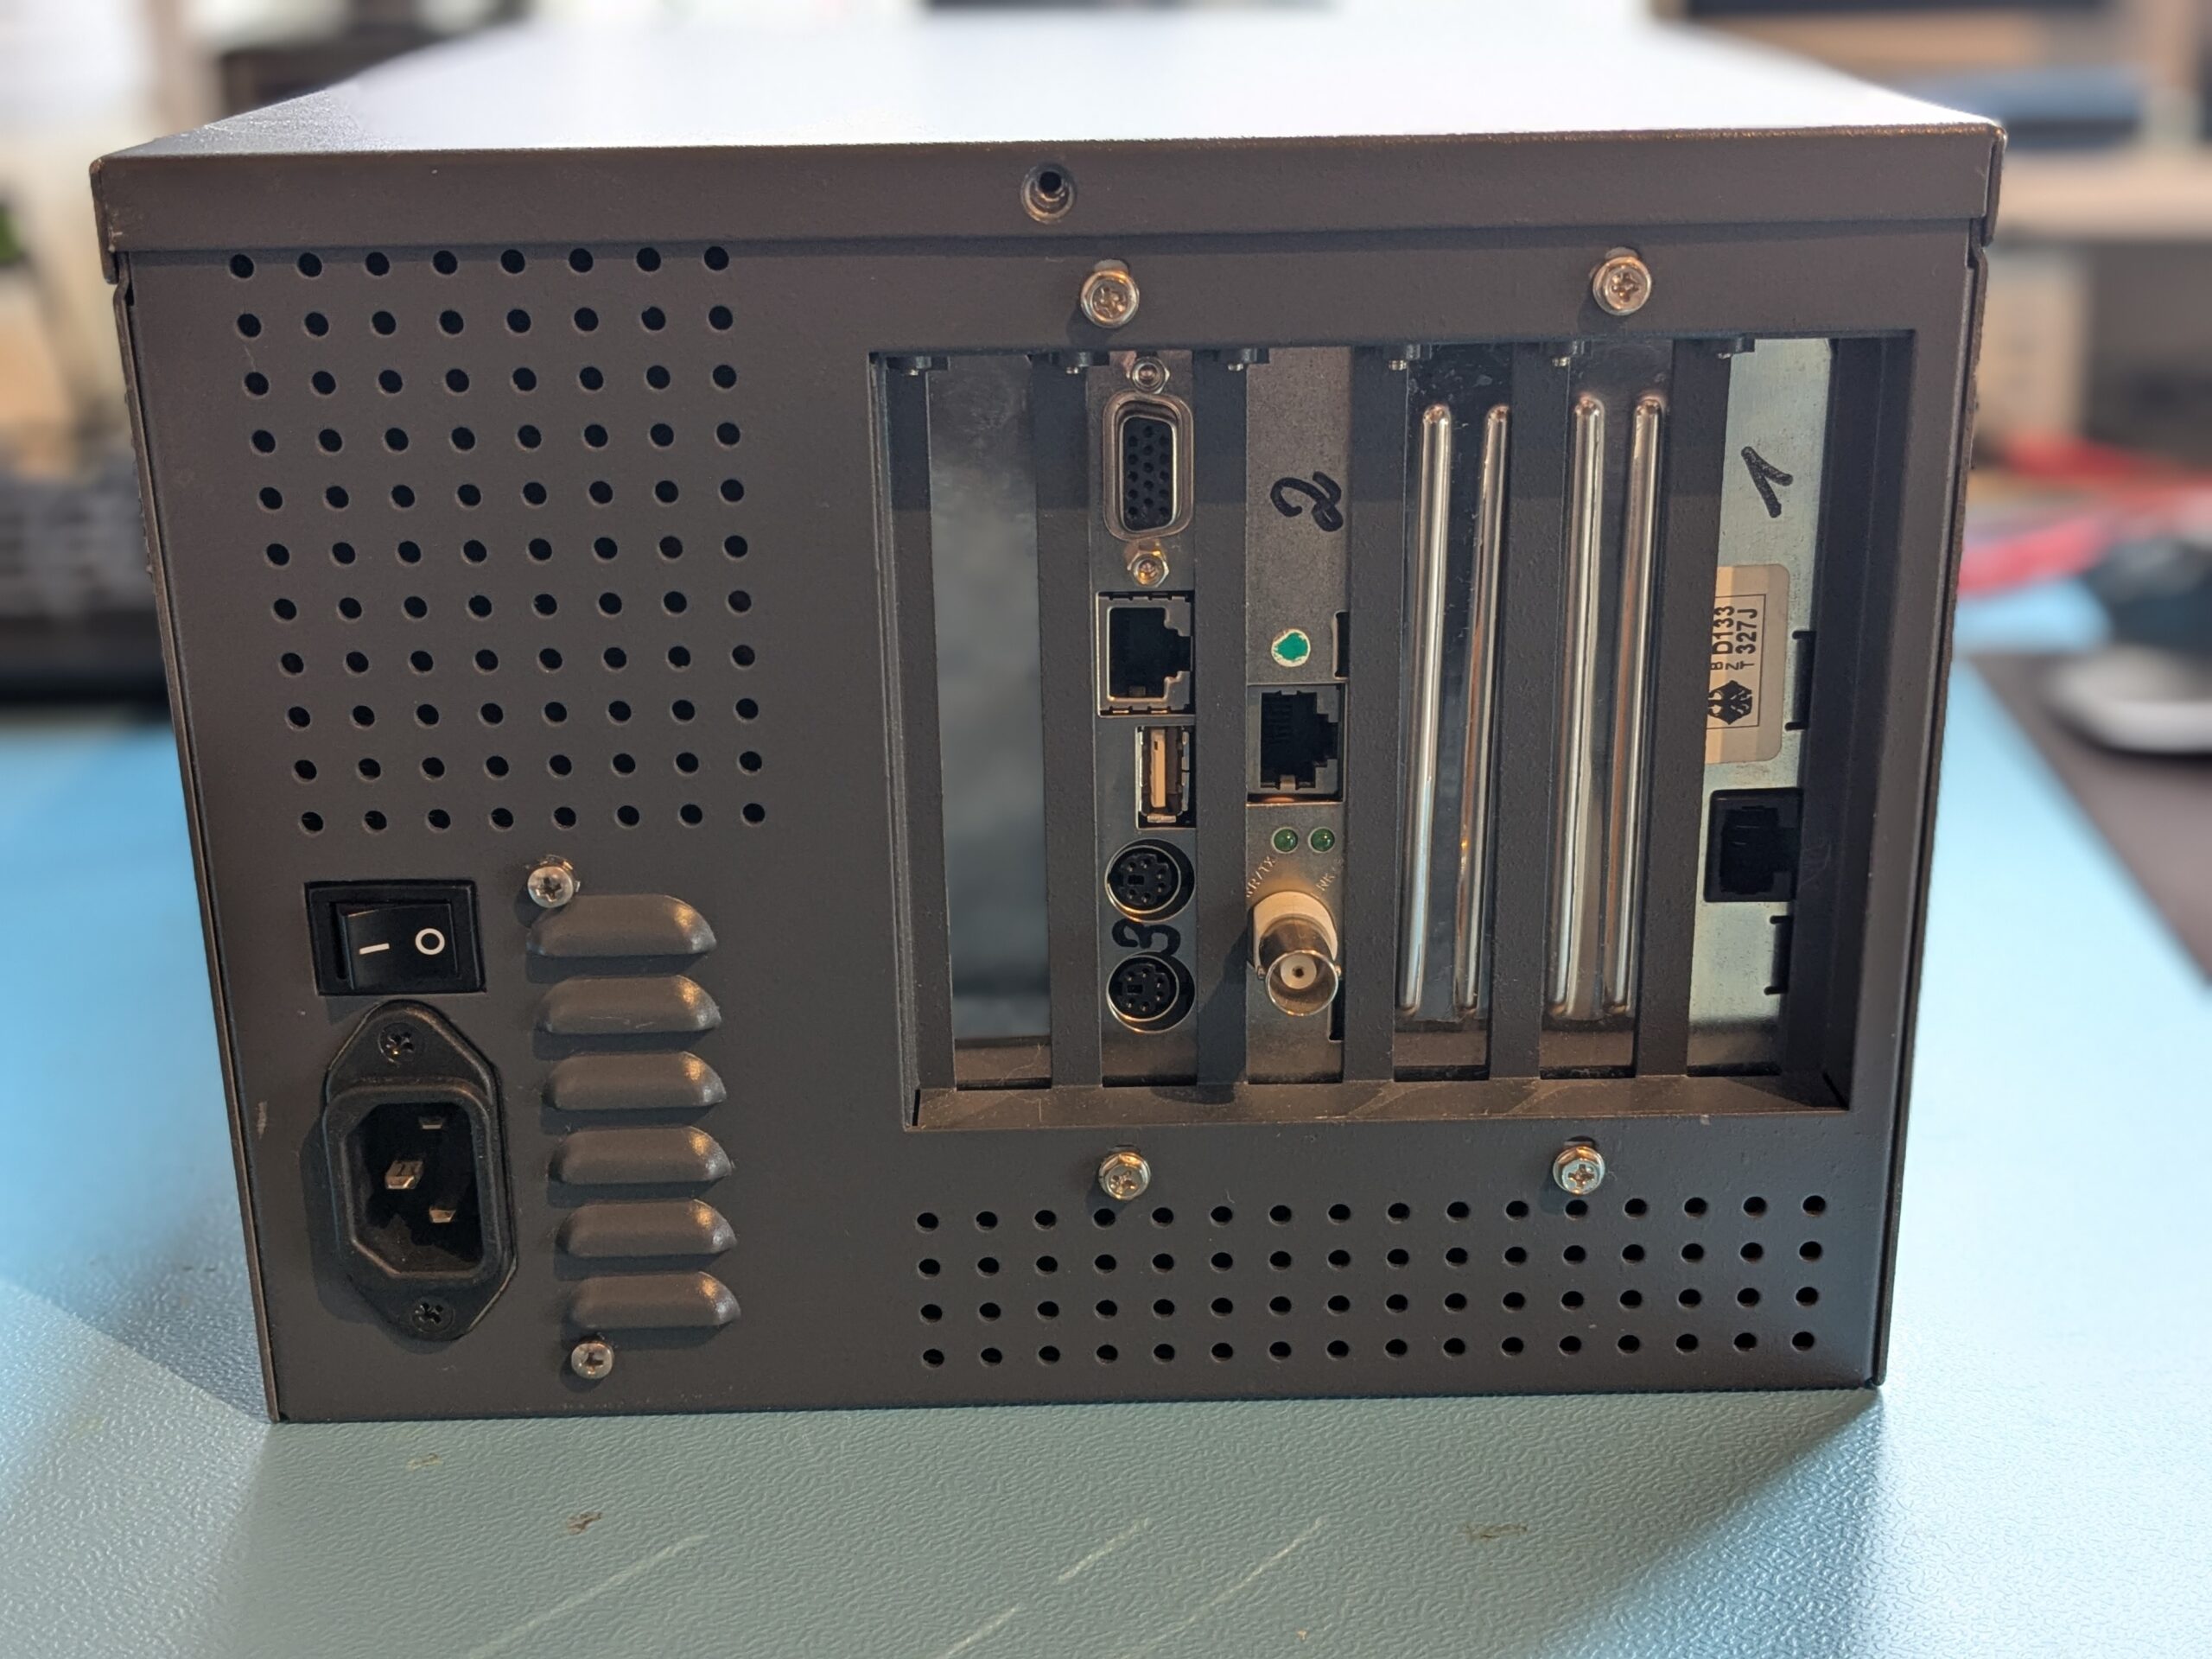
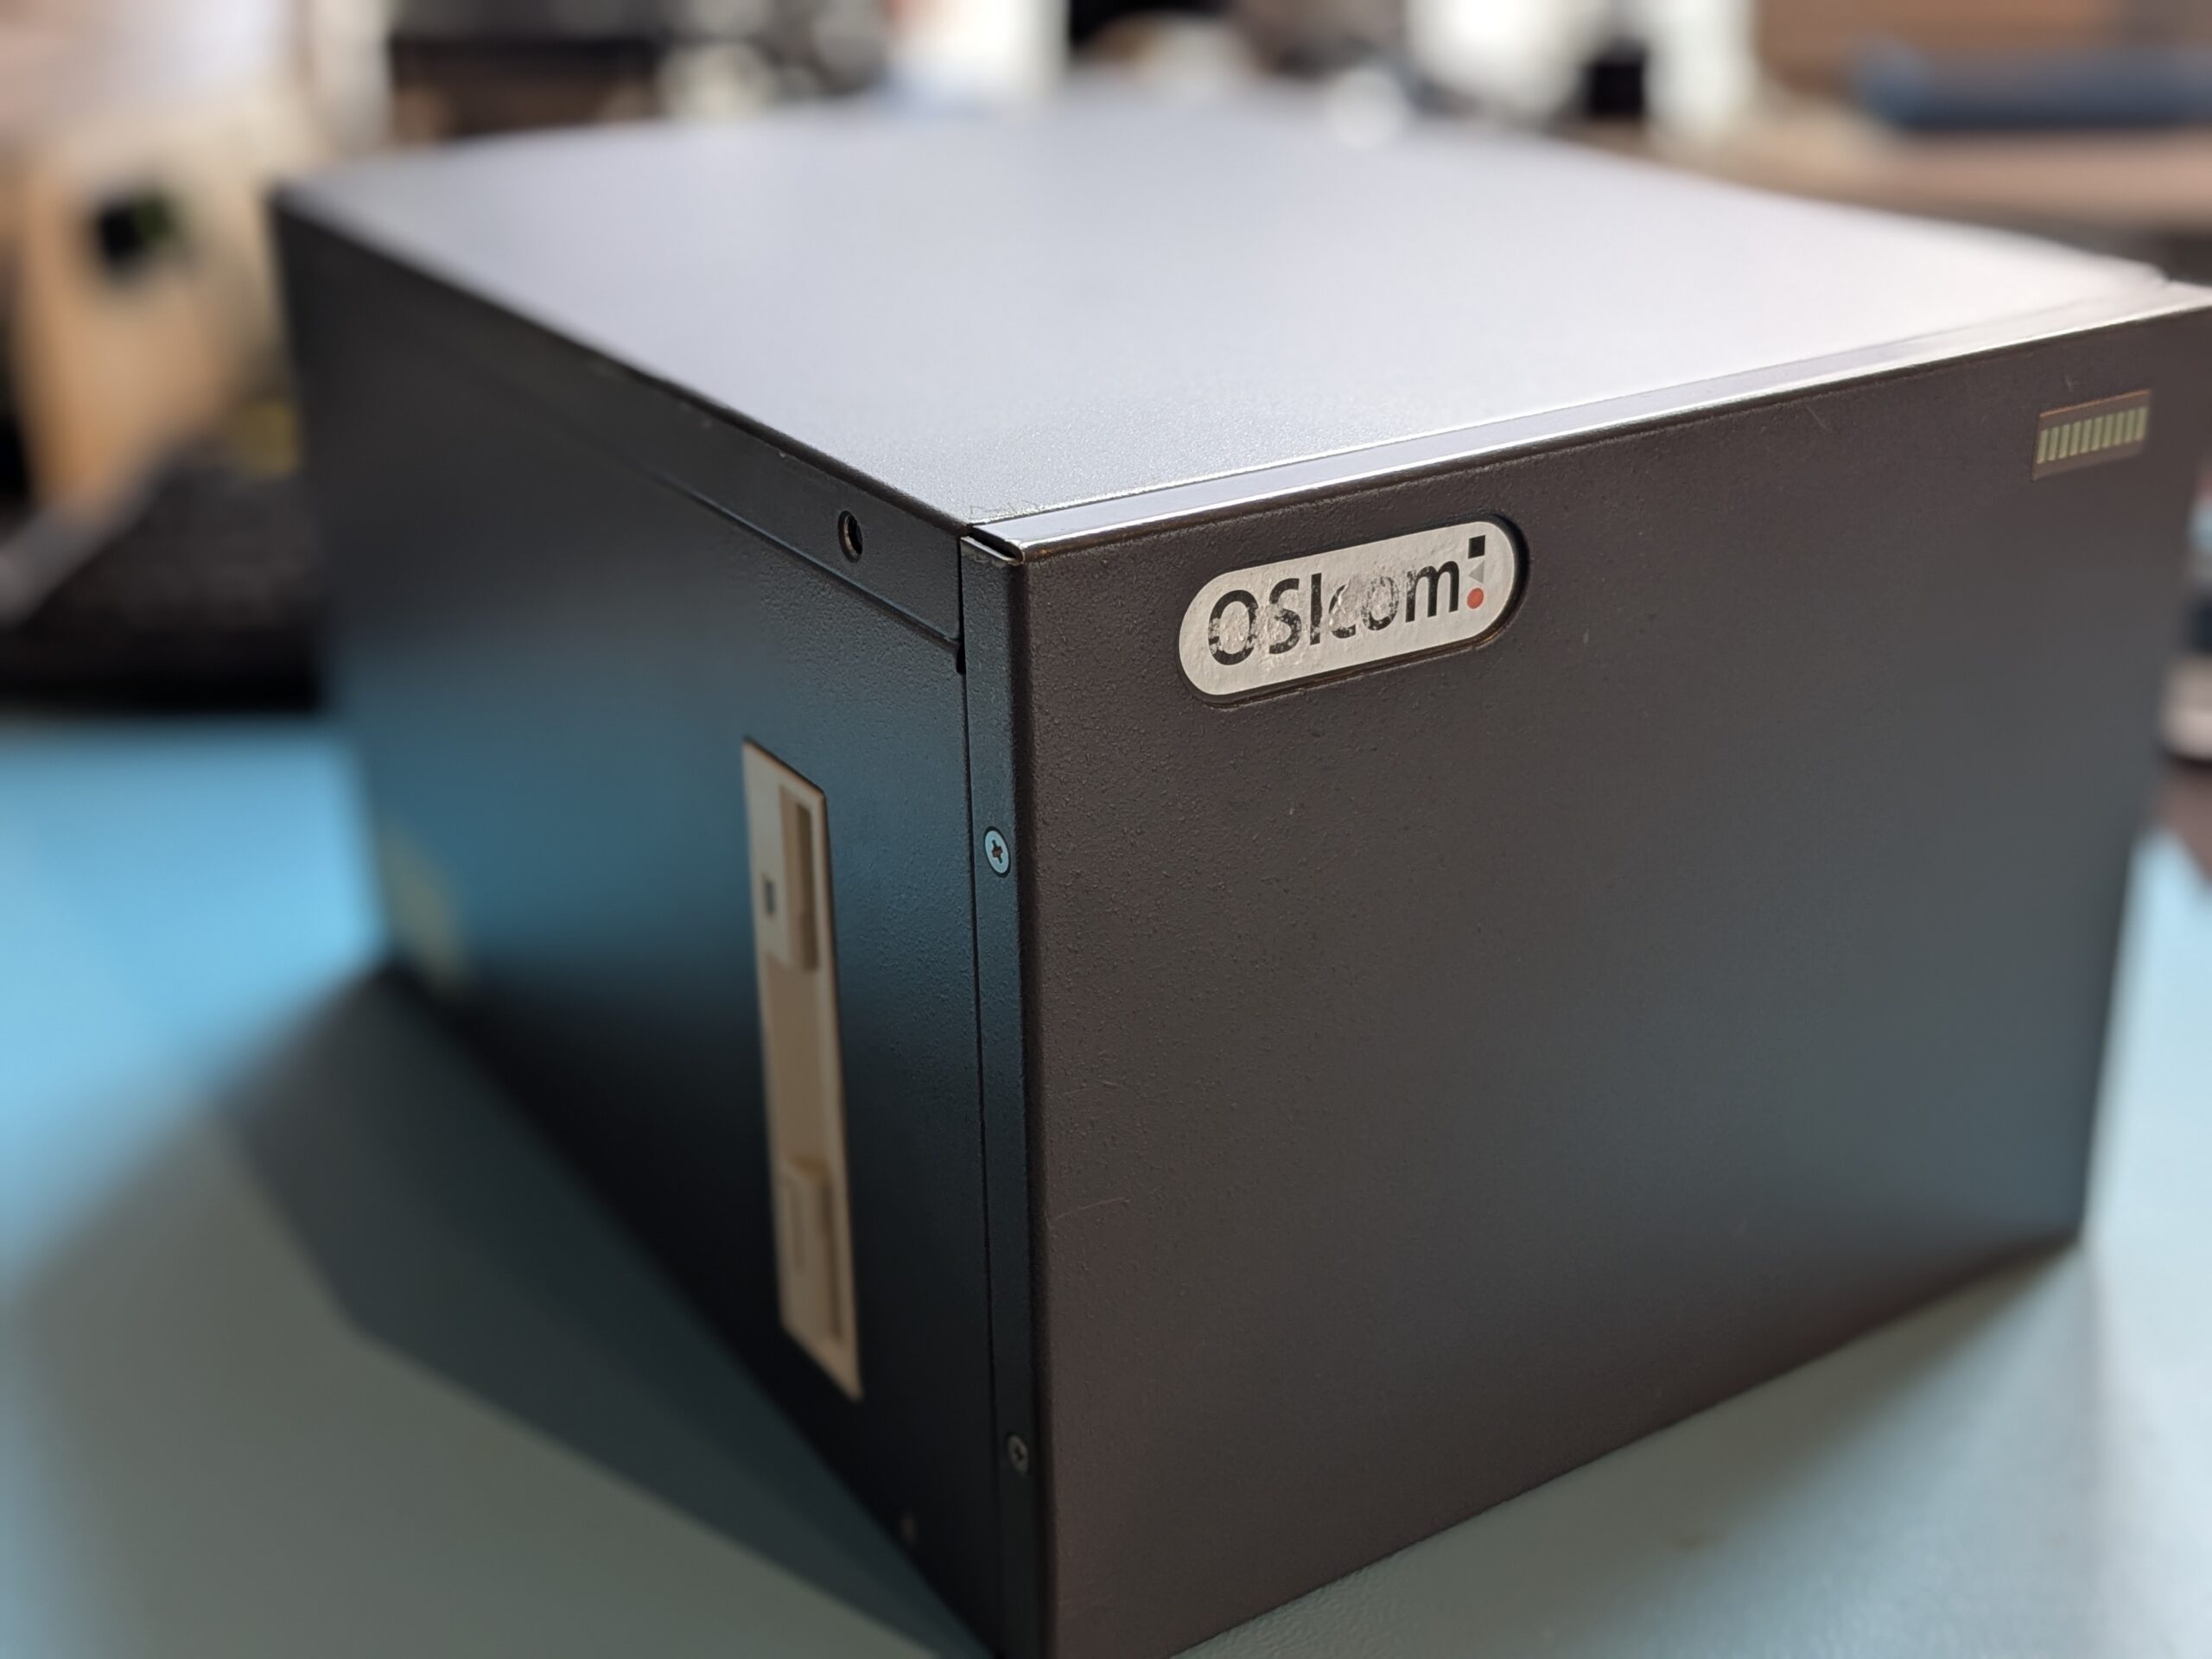
Picture of an PDS OSIcom-office Box

Zufällig bin ich dann in einem Onlineshop auf genau so eine OSIcom Box gestoßen, die dort zum Verkauf angeboten wurde. Der Preis lag deutlich über dem, was ich aus nostalgischen Gründen bereit wäre, dafür zu zahlen – aber ich habe einfach mal mein Glück versucht und per E-Mail ein Angebot unterbreitet. Und siehe da, der Verkäufer war einverstanden! Nun bin ich also Besitzer einer alten OSIcom-office Box. An dieser Stelle noch einmal vielen Dank an Wie-Tec für das Entgegenkommen.

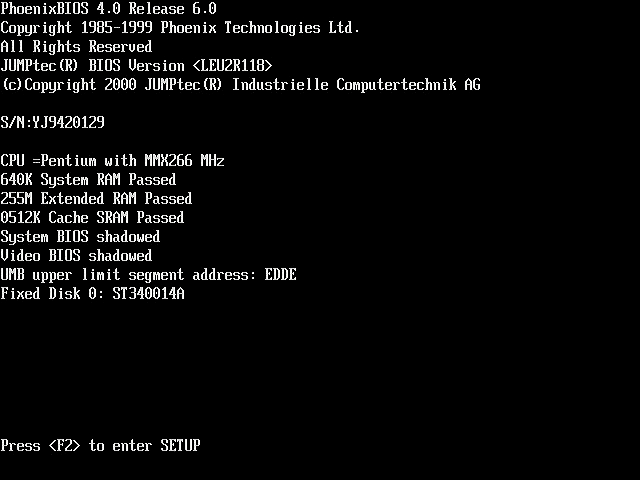
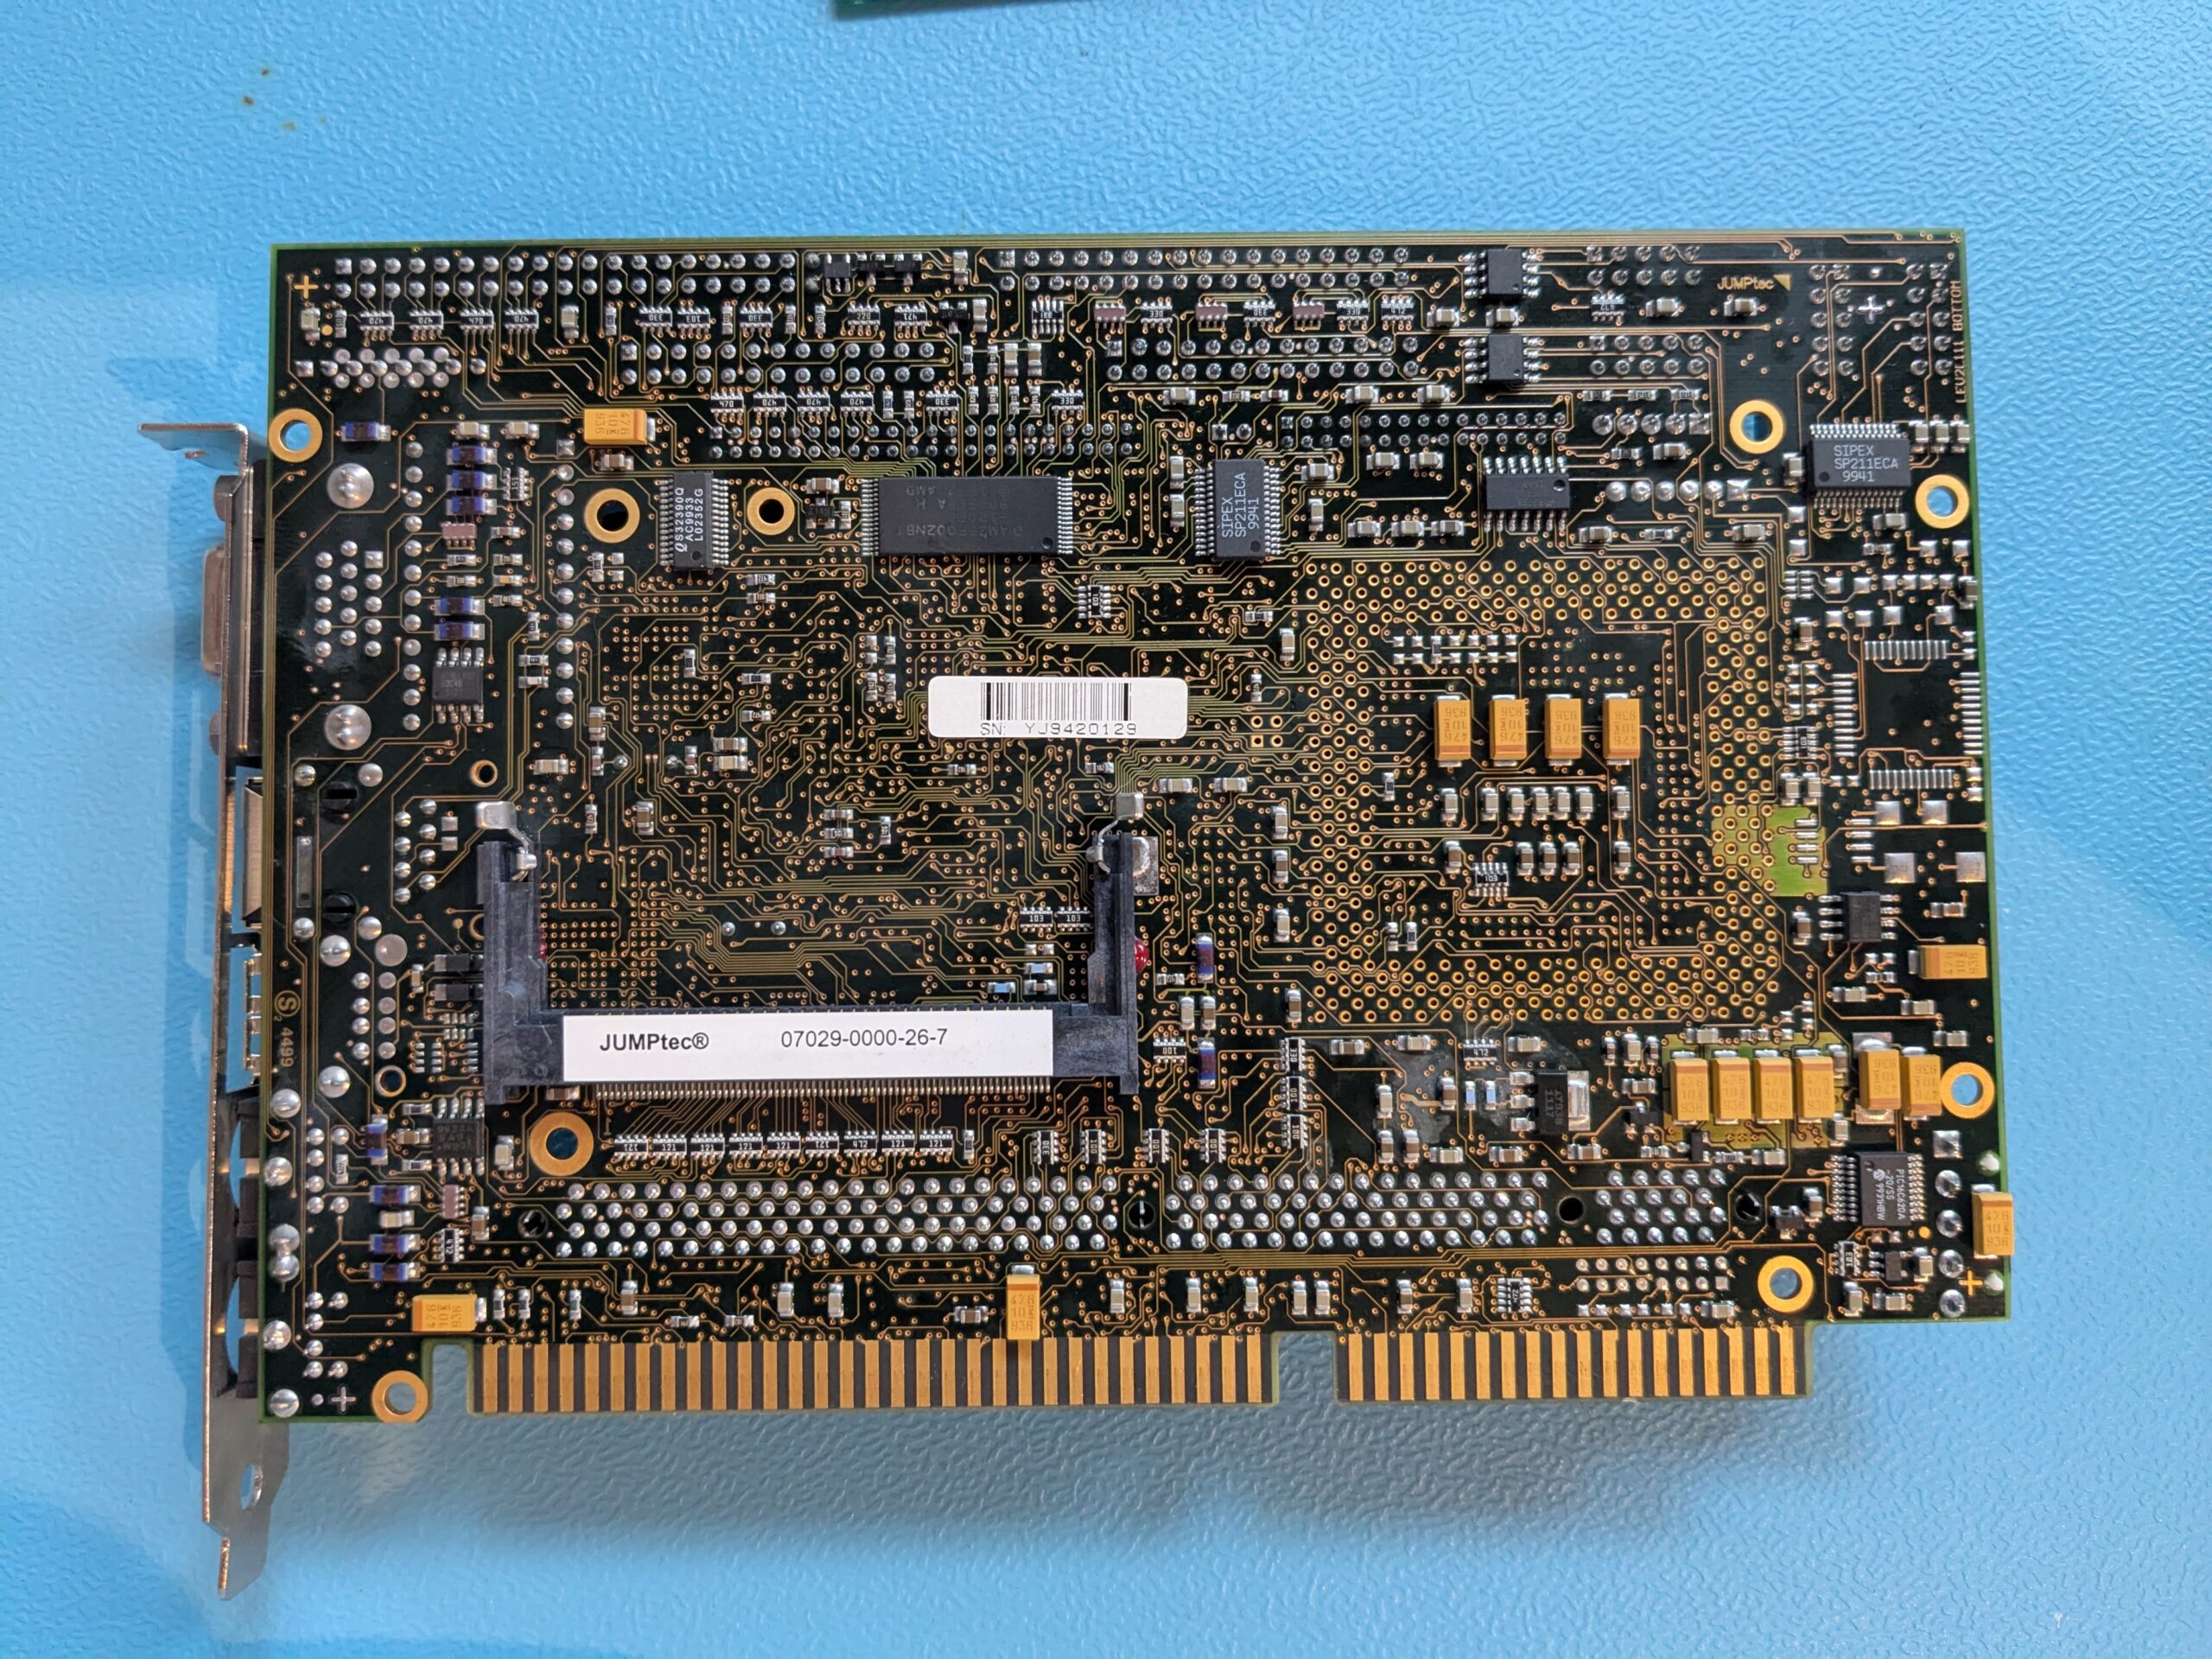
Die Box basiert auf einem SBC (Single Board Computer) von JUMPtec. Das Modell scheint folgendes zu sein: 07029-0000-26-7. Im POST wird die BIOS-Version <LEU2R118> angezeigt. Hersteller: JUMPtec® Industrielle Computertechnik AG.

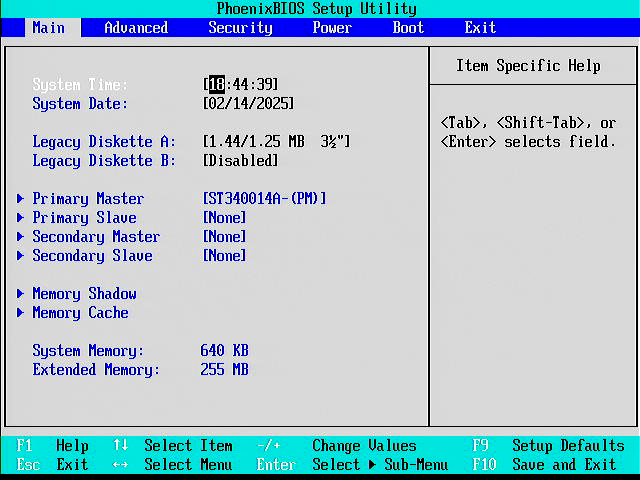
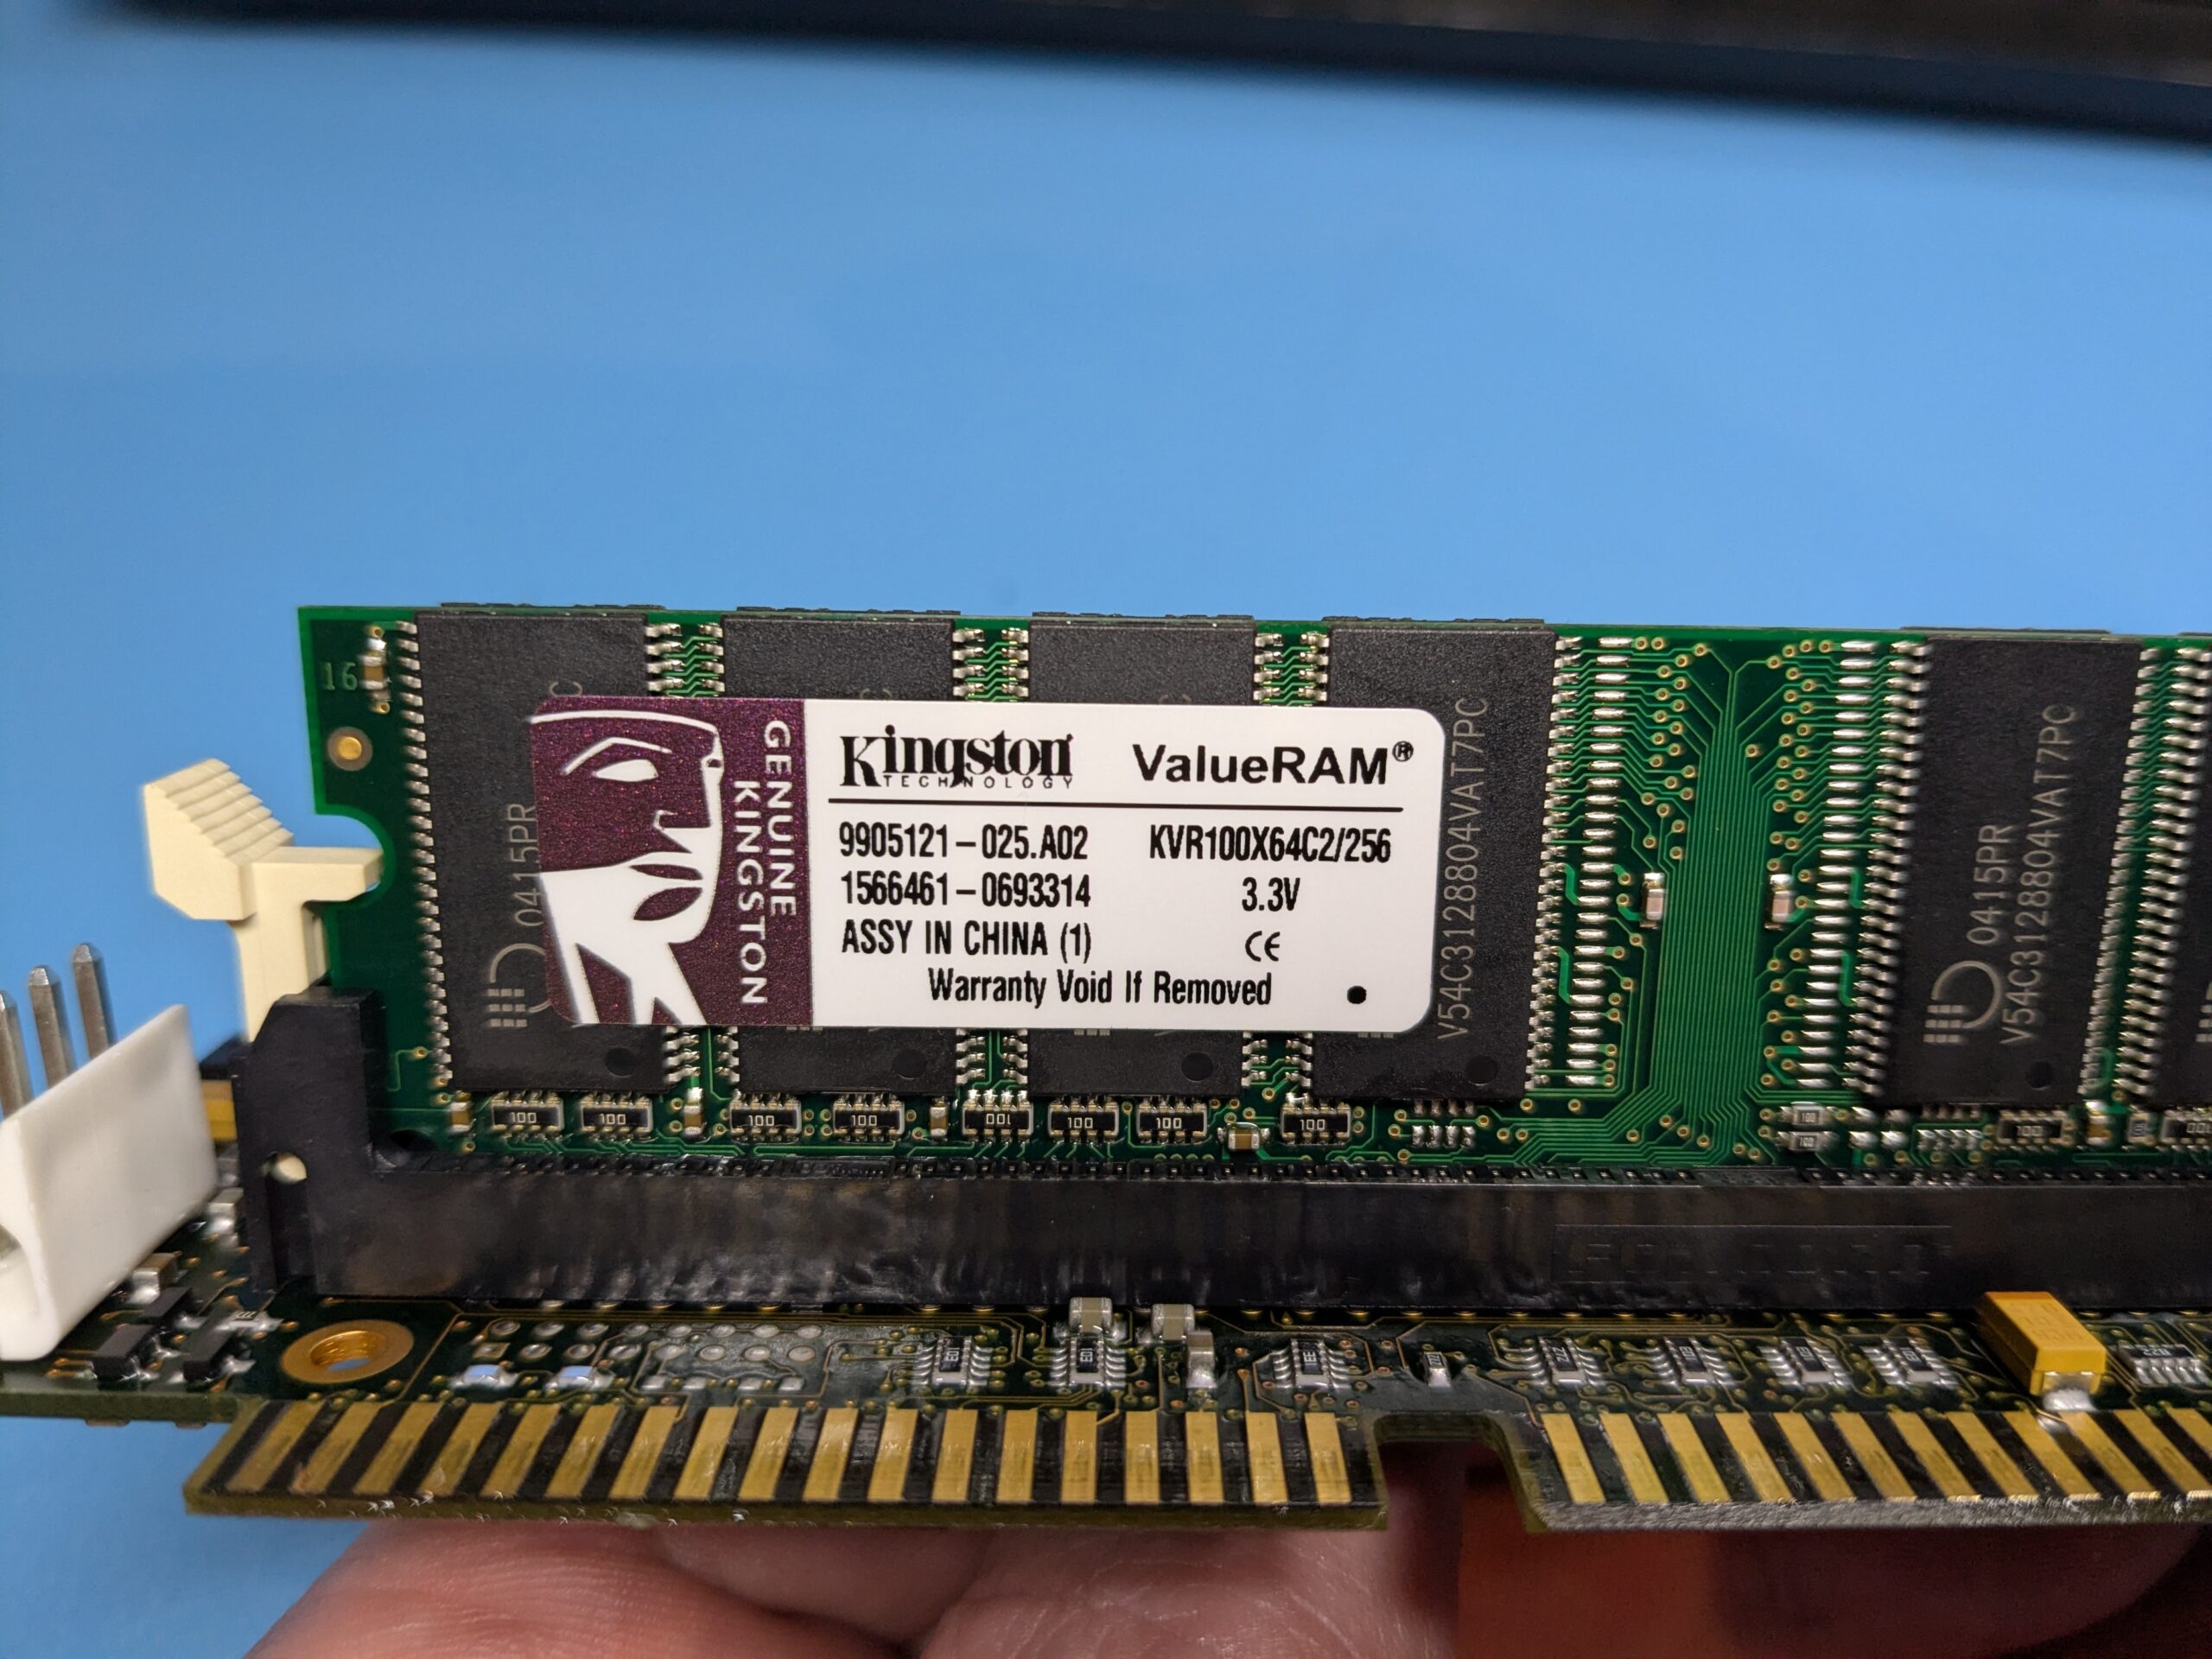
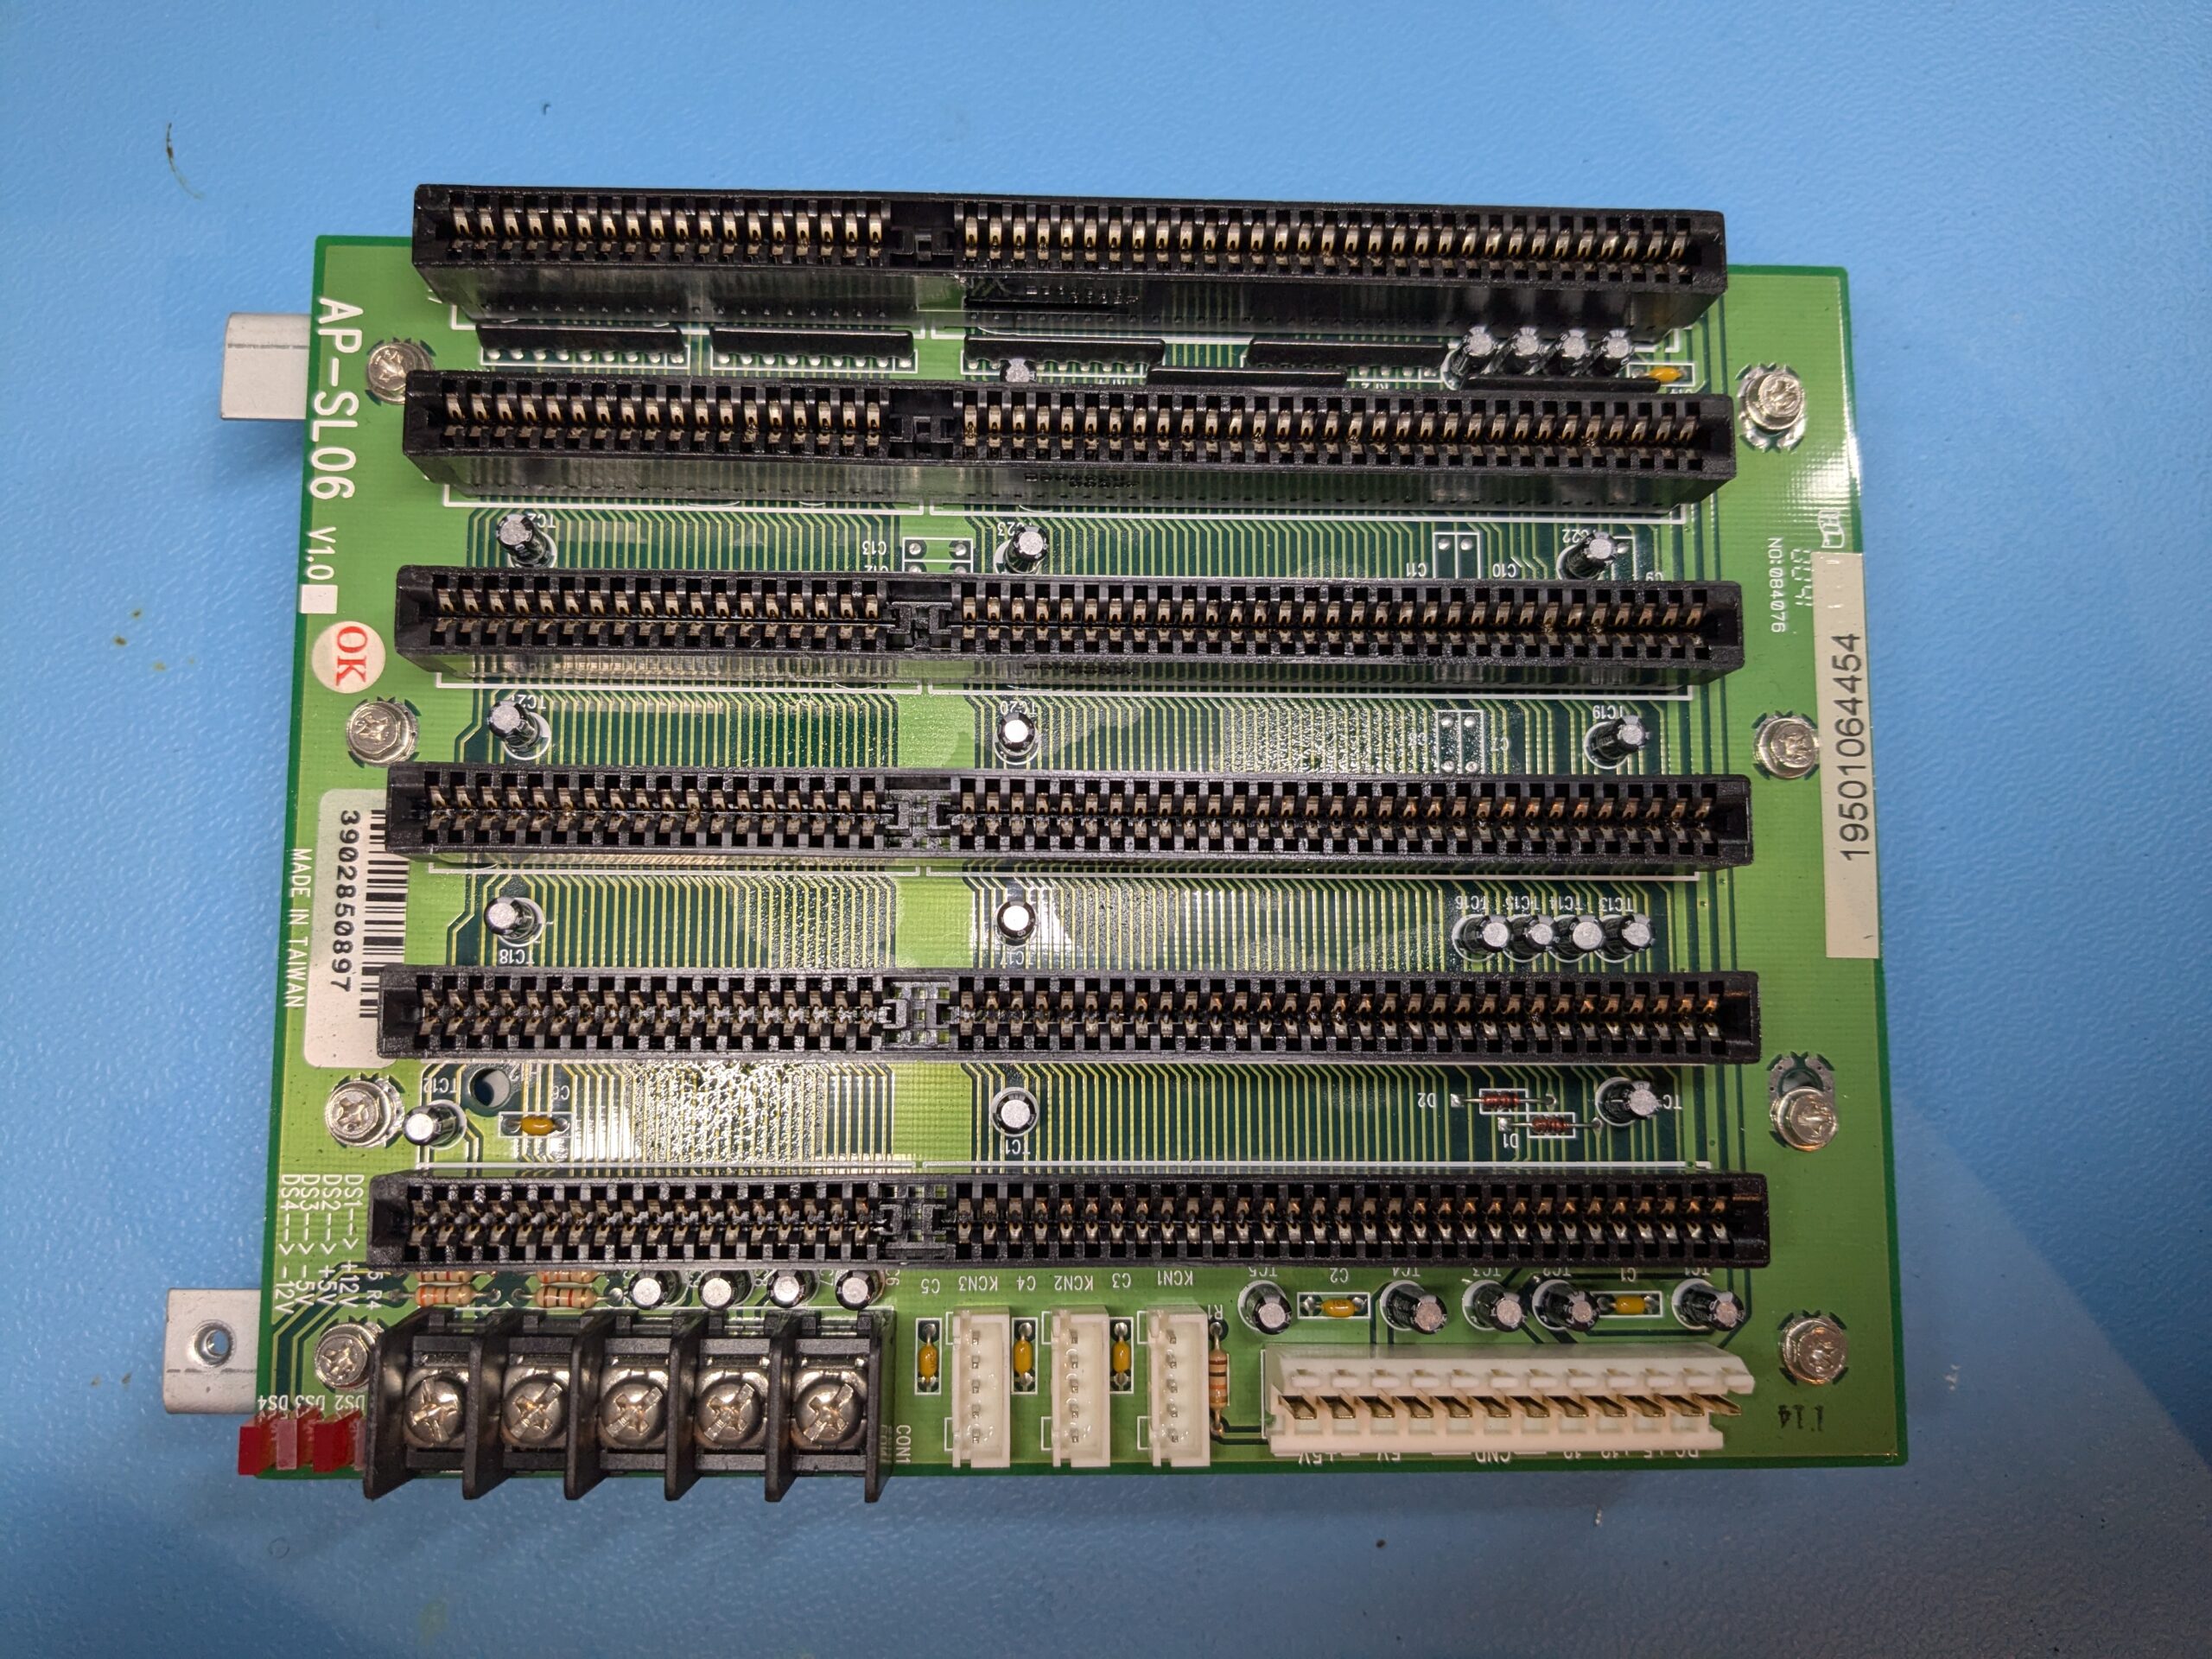
Verbaut sind ein Intel Pentium MMX 266 MHz, 256 MB RAM, eine 40 GB Festplatte, ein Diskettenlaufwerk, sowie eine Netzwerk- und ISDN-Karte. Der SBC steckt in einer ISA-Backplane. Das könnte sogar ein ziemlich guter Retro-DOS-Gaming-PC werden!

Spannenderweise war die Festplatte noch mit Daten gefüllt. Ob es sich dabei nur um eine Testinstallation oder echte Produktivdaten handelt, kann ich nicht bewerten. Überrascht hat mich das dennoch positiv, denn so konnte ich den kompletten Bootvorgang noch einmal genießen. Wobei – nicht nur ich:

Kernel 2.4.27 – man, ist das lange her! Grundlage ist ein altes SUSE Linux. Natürlich habe ich auch noch ein paar Bilder für euch angelegt.

Das BIOS konnte ich sichern, und zusammen mit den Bildern wird das sicher eine brauchbare Ergänzung für The Retro Web. Falls jemand von euch noch Handbücher oder ähnliches zur Hardware hat – ich würde mich sehr darüber freuen!

Siehe auch: Dallas DS80C400: 8051-Ethernet-Mikrocontroller neu entdeckt, Commodore Floppy Disk Preservation: Firmware-Bug im xum1541 gefunden und gefixt

Fragen? Einfach melden.

BitLocker im Dual-Boot: Systemplatte auf Passwortschutz umstellen

Die Feiertage sind da, und ich hatte tatsächlich etwas Zeit zum Zocken. Gearbeitet wird unter Linux, gezockt unter Windows. Dafür habe ich mein Windows auf einer gesonderten SSD installiert, verschlüsselt mit BitLocker.

Illustration eines Dual-Boot-Systems mit Linux und Windows, dargestellt durch die Logos beider Betriebssysteme. Die Windows-Seite zeigt ein BitLocker-Schloss-Symbol, das auf die Verschlüsselung der Systemplatte hinweist.

Die SSD hat irgendwann aufgegeben, Windows musste neu drauf. Backup spare ich mir, ist eh nur zum Zocken. Windows 11, Treiber, Games, fertig. Aber: BitLocker fragt bei jedem Start nach dem Wiederherstellungsschlüssel, wenn ich vorher in Linux war. Das hatte ich schon mal, am gleichen Rechner. Damals nicht aufgeschrieben. Diesen Fehler mache ich nicht noch mal.

Das Problem

BitLocker mit TPM merkt, wenn sich die Boot-Kette ändert. Wechselt man über GRUB zwischen Linux und Windows, sieht das TPM eine Änderung und verlangt den Recovery Key. Die Lösung: TPM als Schlüsselschutz entfernen und stattdessen ein Passwort setzen. Dann fragt BitLocker bei jedem Start nach dem Passwort, egal ob vorher Linux oder Windows lief.

Gruppenrichtlinie anpassen

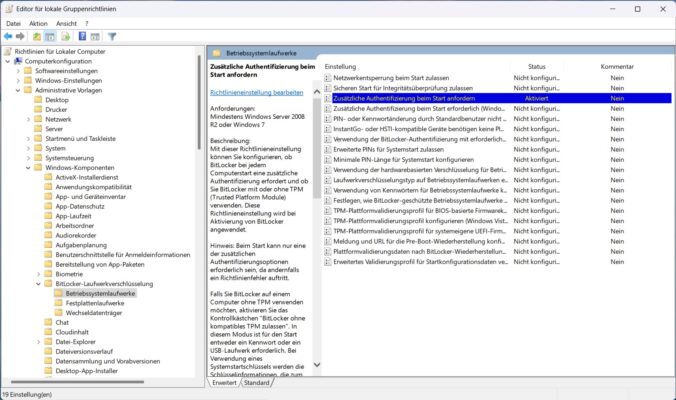
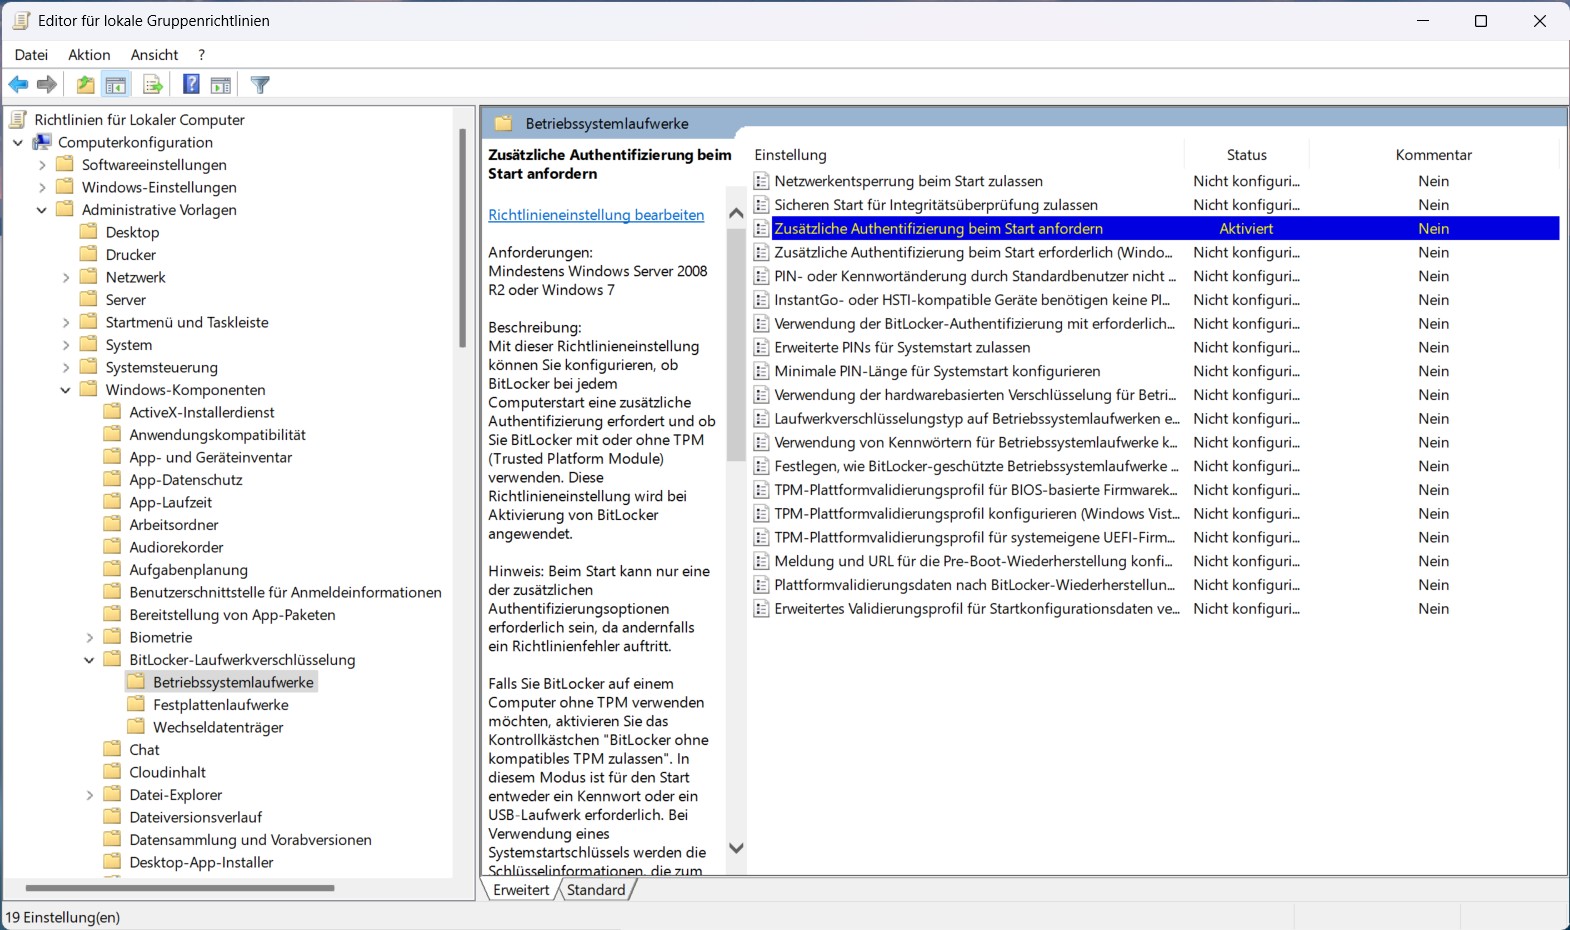
Damit Windows erlaubt, TPM vom Betriebssystemvolume zu entfernen, muss eine Gruppenrichtlinie geändert werden. Win + S, nach Gruppenrichtlinie bearbeiten suchen, dann:

Computerkonfiguration → Administrative Vorlagen → BitLocker-Laufwerkverschlüsselung → Betriebssystemlaufwerke → Zusätzliche Authentifizierung beim Start anfordern

Editor für lokale Gruppenrichtlinien mit geöffneter Einstellung 'Zusätzliche Authentifizierung beim Start anfordern' unter 'Computerkonfiguration > Administrative Vorlagen > BitLocker-Laufwerkverschlüsselung > Betriebssystemlaufwerke'. Die Option ist aktiviert, um die BitLocker-Verschlüsselung ohne TPM zu ermöglichen.
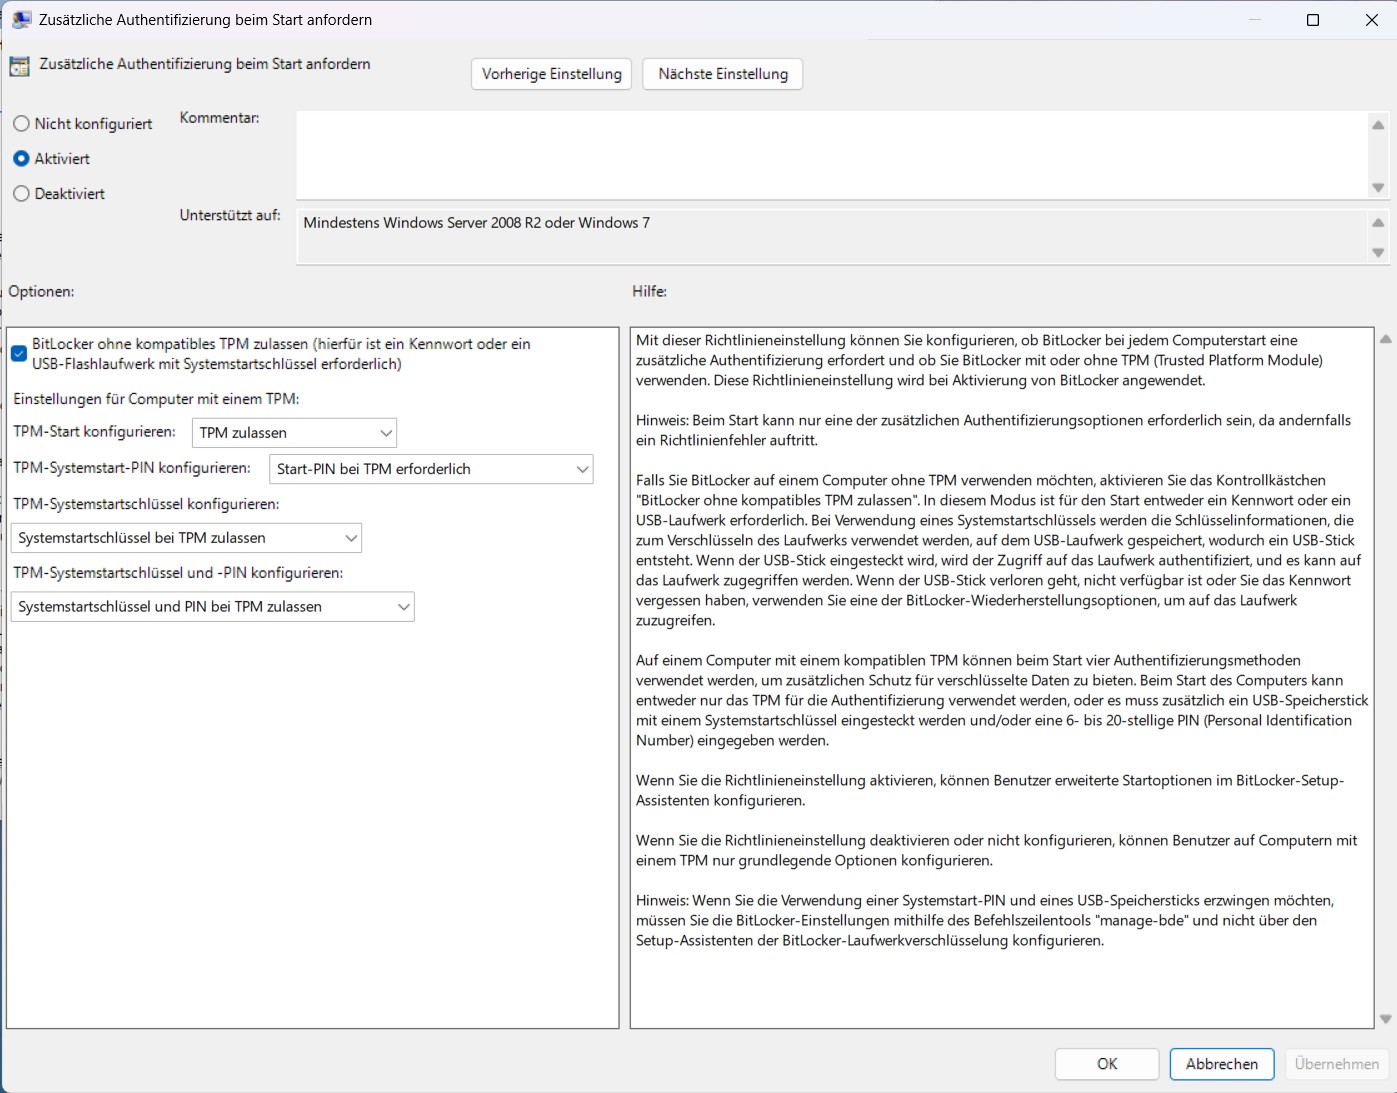
Detailansicht der Gruppenrichtlinieneinstellung 'Zusätzliche Authentifizierung beim Start anfordern'. Die Option 'BitLocker ohne kompatibles TPM zulassen' ist aktiviert, und die Konfiguration für TPM-Start, Systemstartschlüssel und PIN wird angezeigt. Die Beschreibung auf der rechten Seite erläutert die Auswirkungen der Richtlinie.

Den Haken bei „BitLocker ohne kompatibles TPM zulassen“ setzen. Danach im Administrator-Terminal die Richtlinie anwenden:

gpupdate /force

Schlüsselschutz umstellen

Zuerst den aktuellen Status prüfen:

manage-bde -protectors -get C:

In meinem Fall waren drei Schlüsselschutzvorrichtungen konfiguriert: Numerisches Kennwort, TPM und PIN, sowie TPM. Alle müssen weg, damit nur noch das Passwort übrig bleibt.

Schritt für Schritt im Administrator-Terminal:

# 1. Alle Schutzvorrichtungen deaktivieren
manage-bde -protectors -disable C:
# 2. Vorhandene Schutzvorrichtungen anzeigen (IDs notieren)
manage-bde -protectors -get C:
# 3. Jede Schutzvorrichtung einzeln löschen (ID aus Schritt 2)
manage-bde -protectors -delete C: -id {TPM-UND-PIN-ID}
manage-bde -protectors -delete C: -id {TPM-ID}
manage-bde -protectors -delete C: -id {NUMERISCHES-KENNWORT-ID}
# 4. Prüfen, dass keine mehr da sind
manage-bde -protectors -get C:
# Erwartete Ausgabe: "Es wurden keine Schlüsselschutzvorrichtungen gefunden."
# 5. Passwort als neue Schutzvorrichtung hinzufügen
manage-bde -protectors -add C: -password
# (Passwort eingeben und bestätigen)
# 6. Schutz wieder aktivieren
manage-bde -protectors -enable C:

Ergebnis prüfen

manage-bde -status
Volume "C:" [System]
    Verschlüsselt (Prozent):      100,0 %
    Verschlüsselungsmethode:      XTS-AES 128
    Schutzstatus:                 Der Schutz ist aktiviert.
    Schlüsselschutzvorrichtungen:
        Kennwort

Nur noch Kennwort als Schutzvorrichtung. Beim nächsten Start fragt BitLocker nach dem Passwort, unabhängig davon ob vorher Linux oder Windows lief. GRUB stört nicht mehr.

Wer auf der Linux-Seite ebenfalls verschlüsselt: Bei LUKS kann ein falsches Tastaturlayout bei der Passphrase-Abfrage für Verwirrung sorgen.

Fragen? Einfach melden.

VueScan: Beste Scannersoftware für alte und vielseitige Scanner

Einen guten Dokumentenscanner zu finden, der auch noch bezahlbar ist, kann schnell zu einer Herausforderung werden. Viele ältere Geräte verlieren nach kurzer Zeit den Support für das nächste Betriebssystem und funktionieren dann nicht mehr. Wenn der Scanner zusätzlich unter Linux reibungslos laufen soll, wird es noch spannender.

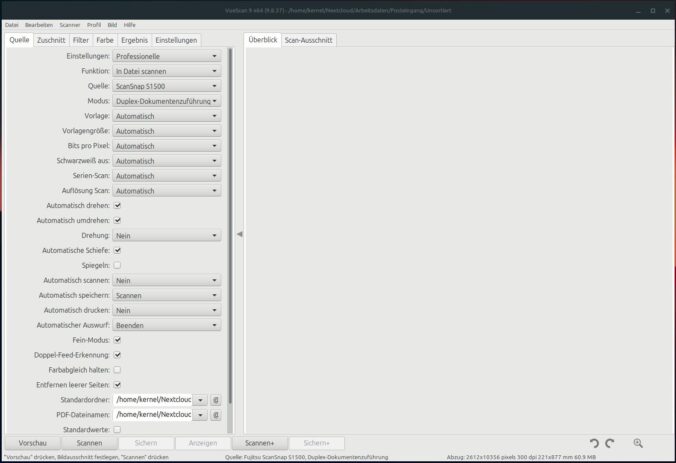
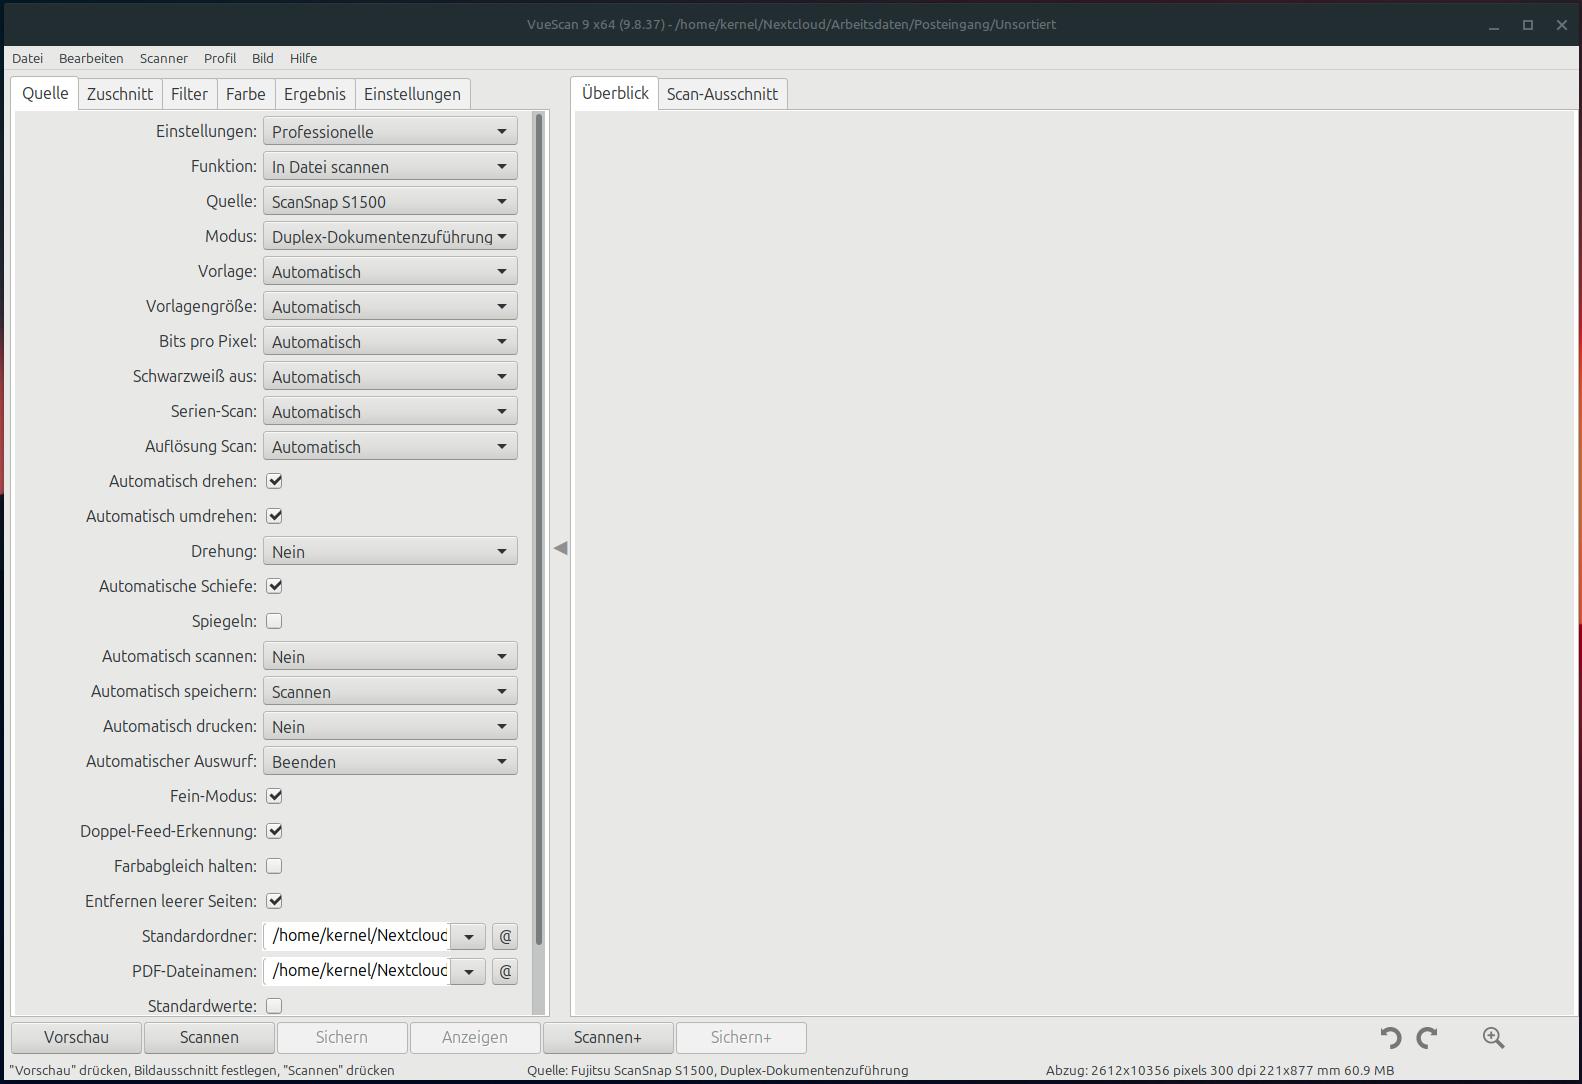
Vor vielen Jahren konnte ich mir günstig einen Fujitsu ScanSnap S1500 zulegen. Dieser Dokumentenscanner erfüllt genau meine Anforderungen: Er zieht mehrere Seiten über den automatischen Dokumenteneinzug (ADF) ein, scannt beidseitig, ist schnell und liefert eine gute Auflösung. Wenn ich ihn nicht brauche, lässt er sich genauso schnell zusammenklappen, wie er sich aufstellen lässt, und nimmt kaum Platz auf meinem ohnehin schon überladenen Schreibtisch ein. Ich nutze den Scanner, um meine Post, Rechnungen und andere wichtige Unterlagen zu digitalisieren. Anfangs lief dies noch über eine Windows-VM, da es lange keine wirklich einfache Software für Linux gab, die auf Knopfdruck Dokumente scannt, Texterkennung (OCR) anwendet und alles als durchsuchbares PDF abspeichert. Dieses PDF wandert dann automatisch in meine Nextcloud und hilft mir, Ordnung in meinen Unterlagen zu halten.

Vor etwa anderthalb Jahren stieß ich auf die Software VueScan. Zwar kostet sie etwas, aber für mich ist sie jeden Cent wert. Sie läuft nativ oder als Flatpak auf meinem Linux-System, bietet mehr Funktionen, als ich tatsächlich benötige, und unterstützt eine beeindruckend große Anzahl an Scannern. Sie scannt sogar mein Netzwerk nach anderen Geräten, so läuft auch mein Samsung-Multifunktionsdrucker problemlos damit. Was mich jedoch wirklich beeindruckt, sind die Menschen hinter der Software.

Soweit ich weiß, wird VueScan nur von zwei Leuten entwickelt. Sie reagieren extrem schnell auf E-Mail-Anfragen und bieten hervorragenden Support. Gestern ist die Anwendung zum ersten Mal abgestürzt. Ich konnte sie direkt wieder öffnen, und alles war in Ordnung. Da VueScan den Absturz jedoch selbst erkannte, öffnete sich sofort ein Dialog für einen Fehlerbericht. Das kennt man ja. Ich füllte den Bericht aus und schickte ihn ab. Heute hatte ich bereits eine E-Mail vom Entwickler im Postfach, der mir Unterstützung anbot und weitere Fragen zum Absturz stellte. Diese schnelle, persönliche Reaktion hat mich sehr positiv überrascht.

Klar, mir war bereits aufgefallen, dass VueScan sehr häufig und regelmäßig Updates erhält, aber dass der Entwickler so engagiert dahintersteht, beeindruckt mich wirklich. Das gibt mir ein gutes Gefühl. Die Software ist klasse, der Preis ist in Ordnung (ich habe die Professional-Version), und der Support sowie die Reaktionszeit sind erstklassig. Außerdem unterstützen sie gefühlt jeden Scanner auf diesem Planeten. Und ja, die Software gibt es natürlich auch für Windows und Mac.

Ich muss also nur einmal lernen, wie eine Software funktioniert, und bin dann in der Lage, auf verschiedenen Betriebssystemen und mit verschiedenen Geräten zu arbeiten. Ich möchte ja nicht Experte für x verschiedene Softwarelösungen werden, sondern einfach nur schnell meine Dokumente digitalisieren.

Ich bekomme für diesen Beitrag keinerlei Vergütung oder Ähnliches, ich bin einfach wirklich überzeugt von VueScan. Probiert es doch einfach mal aus, und ich bin gespannt, ob ihr meine Meinung teilt.

Fragen? Einfach melden.

Google Chrome: Hardwarebeschleunigung unter Linux (auch Flatpak) aktivieren

Wer Chrome unter Linux für Videocalls oder Microsoft Teams nutzt, kennt das Problem: hohe CPU-Auslastung, träge Performance, unscharfer Hintergrund fühlt sich an als wäre das System 15 Jahre alt. Ob Chrome aus den Paketquellen oder als Flatpak installiert ist, macht keinen Unterschied.

Die Ursache: Chrome nutzt unter Linux standardmäßig kaum GPU-Beschleunigung. Das lässt sich ändern.

Voraussetzung: VA-API prüfen

Zuerst sicherstellen, dass vainfo in der Konsole ohne Fehler läuft. Die meisten Distributionen bringen das out of the box mit. Falls nicht, gibt es im Arch Wiki gute Anleitungen dazu.

Aktuellen Status prüfen

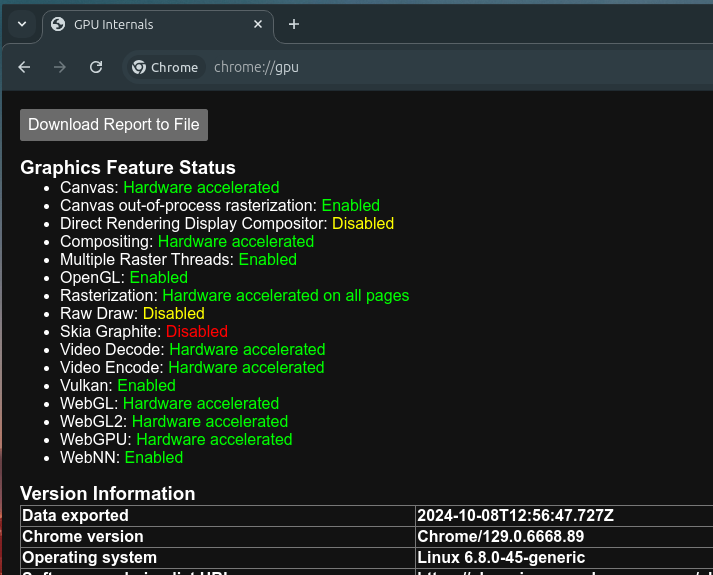
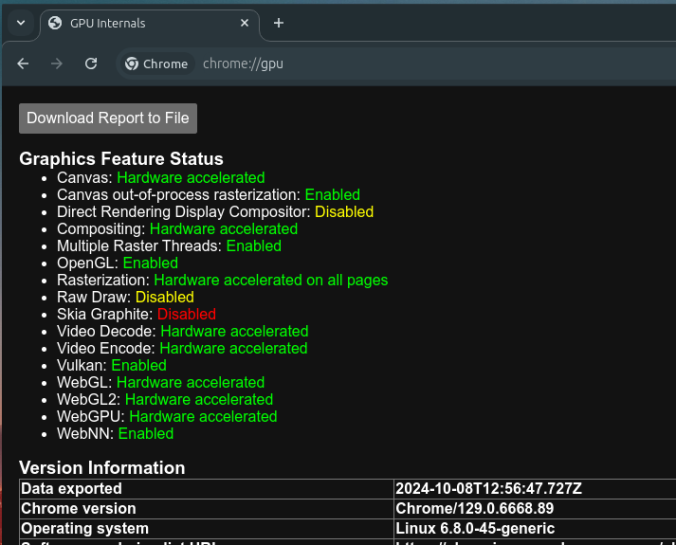
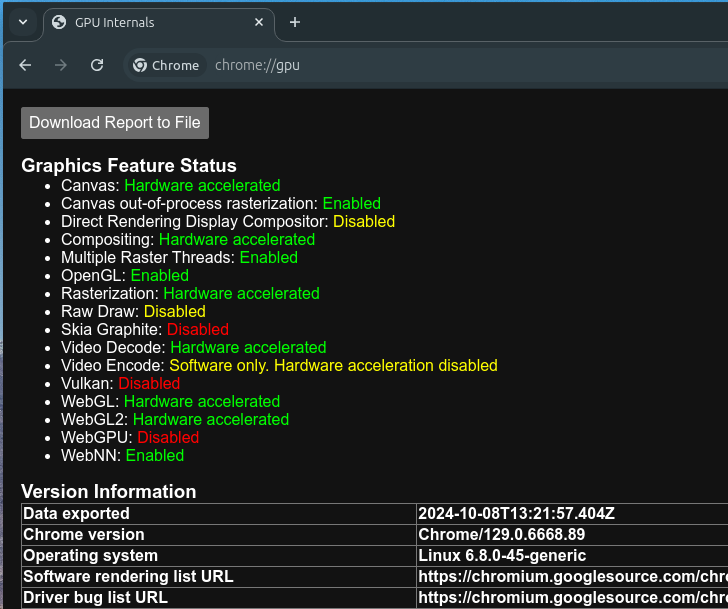
In Chrome chrome://gpu aufrufen. Typischerweise sind Video Encode, Vulkan und WebGPU deaktiviert. Nach der Anpassung sieht es so aus:

  • Rasterization: Hardware accelerated on all pages (vorher: nur „Hardware accelerated“)
  • Video Encode: Hardware accelerated (vorher: Software only)
  • Vulkan: Enabled (vorher: Disabled)
  • WebGPU: Hardware accelerated (vorher: Disabled)

Konfiguration

Die Flags kommen in eine Konfigurationsdatei:

  • Chrome/Chromium aus Paketquellen: ~/.config/chromium-flags.conf
  • Chrome als Flatpak: ~/.var/app/com.google.Chrome/config/chrome-flags.conf
--ignore-gpu-blocklist
--enable-zero-copy
--enable-gpu-rasterization
--enable-gpu-compositing
--enable-smooth-scrolling
--canvas-oop-rasterization
--disable-direct-composition-bug-workarounds
--enable-unsafe-webgpu
--enable-features=VaapiVideoDecoder,VaapiVideoEncoder,VaapiIgnoreDriverChecks,Vulkan,DefaultANGLEVulkan,VulkanFromANGLE,UseOzonePlatform
--ozone-platform=x11

Chrome neu starten und chrome://gpu erneut prüfen.

Tipp für Flatpak-Nutzer: Flatseal macht die allgemeine Konfiguration von Flatpaks deutlich bequemer.

Fragen? Einfach melden.

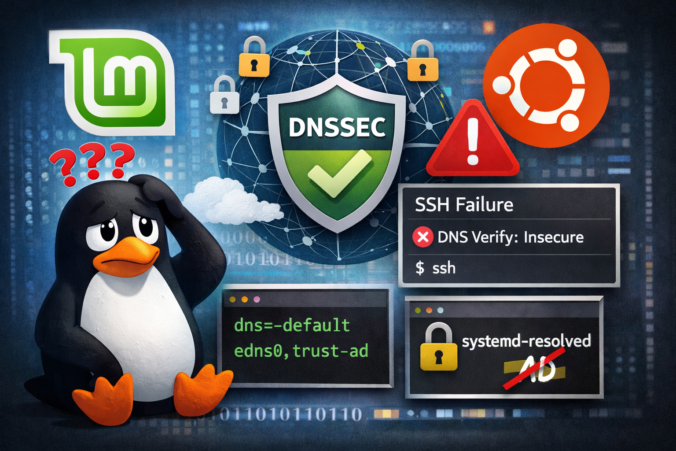
DNSSEC und SSHFP unter Linux Mint und Ubuntu zum Laufen bringen

Heute habe ich versucht, mich von meiner neuen Linux Mint Installation aus mit einem meiner SSH-Server zu verbinden. Mein SSH-Client hat mich direkt gefragt, ob ich dem Hostkey vertrauen möchte:

ssh username@hostname.kernel-error.org
The authenticity of host 'hostname.kernel-error.org (2a01:5a8:362:4416::32)' can't be established.
ED25519 key fingerprint is SHA256:kTRGVCMRLiHfvJunW2CbW5H3NZmn3Wkx2KnHJXl3iJu.
This key is not known by any other names
Are you sure you want to continue connecting (yes/no/[fingerprint])?

Für viele ist das normal — man tippt „yes“ und sieht die Meldung nie wieder. Aber diese Meldung hat ihren Grund. Beim ersten Verbindungsaufbau zeigt SSH den Fingerprint des Server-Hostkeys an, damit man prüfen kann, ob man wirklich mit dem richtigen Server spricht und nicht mit einem Angreifer. Wer eh immer „yes“ sagt, könnte den Check auch gleich in seiner ~/.ssh/config abschalten:

Host *
    StrictHostKeyChecking no

SSHFP — Hostkeys per DNS verifizieren

Es gibt einen besseren Weg: SSHFP-Records (RFC 4255). Man hinterlegt die Fingerprints der erwarteten Hostkeys als DNS-Einträge. Der SSH-Client prüft diese automatisch — vorausgesetzt die DNS-Antwort ist per DNSSEC abgesichert. In der ~/.ssh/config:

Host *
   VerifyHostKeyDNS yes

Meine DNS-Server unterstützen alle DNSSEC, mein lokaler Resolver auf dem Router auch, die SSH-Config stimmt — und trotzdem erscheint die Meldung. Also mit ssh -vvv debuggen:

debug1: found 2 insecure fingerprints in DNS

Insecure. SSH findet die SSHFP-Records, vertraut ihnen aber nicht, weil die DNS-Antwort nicht als DNSSEC-validiert markiert ist.

Das Problem: systemd-resolved

Schneller Test mit dig +dnssec gegen Google DNS:

dig +dnssec hostname.kernel-error.org @8.8.8.8
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

Das ad-Flag (Authenticated Data) ist gesetzt — meine DNS-Server liefern DNSSEC korrekt aus. Auch der lokale Router-Resolver liefert ad. Aber ohne expliziten @server:

dig +dnssec hostname.kernel-error.org
;; flags: qr rd ra; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1

Kein ad. Was steht in /etc/resolv.conf? 127.0.0.53 — systemd-resolved. Der Stub-Resolver von systemd schluckt das AD-Flag.

Man könnte in /etc/systemd/resolved.conf einfach DNSSEC=yes setzen — bei mir ging danach aber gar keine DNS-Auflösung mehr. Das liegt am Stub-Resolver, den man ebenfalls umkonfigurieren müsste. Nennt mich oldschool, aber für meine Zwecke reicht der klassische Weg über die vom NetworkManager gepflegte resolv.conf.

Lösung: systemd-resolved abschalten

sudo systemctl disable systemd-resolved
sudo systemctl stop systemd-resolved
sudo rm /etc/resolv.conf

In /etc/NetworkManager/NetworkManager.conf in der [main]-Sektion:

dns=default

NetworkManager neu starten:

sudo systemctl restart NetworkManager
cat /etc/resolv.conf
# Generated by NetworkManager
search kernel-error.local
nameserver 10.10.88.1
nameserver fd00:424e:6eff:f525:454e:6eff:f525:4241

DNS-Auflösung geht. Aber SSH sagt weiterhin „insecure“. Es fehlen noch zwei Optionen in der resolv.conf.

edns0 und trust-ad

Erste Erkenntnis — edns0 muss aktiviert sein, damit DNSSEC-Daten überhaupt transportiert werden. In /etc/resolv.conf:

options edns0

Jetzt zeigt dig das ad-Flag. Aber SSH sagt immer noch „insecure“. Warum? Ein Blick in den SSH-Quellcode — die ldns-Bibliothek macht die DNSSEC-Validierung:

        /* Check for authenticated data */
        if (ldns_pkt_ad(pkt)) {
                rrset->rri_flags |= RRSET_VALIDATED;
        } else { /* AD is not set, try autonomous validation */
                ldns_rr_list * trusted_keys = ldns_rr_list_new();
                /* ... */
                if ((err = ldns_verify_trusted(ldns_res, rrdata, rrsigs,
                     trusted_keys)) == LDNS_STATUS_OK) {
                        rrset->rri_flags |= RRSET_VALIDATED;
                }
        }

ldns prüft das AD-Flag im DNS-Paket. Aber die glibc setzt das AD-Flag in der Antwort nur dann, wenn trust-ad in der resolv.conf steht — sonst wird es aus Sicherheitsgründen herausgefiltert. Die vollständige Option:

options edns0 trust-ad

Und jetzt:

ssh username@hostname.kernel-error.org -vvv
[...]
debug1: found 2 secure fingerprints in DNS
debug3: verify_host_key_dns: checking SSHFP type 4 fptype 1
debug1: verify_host_key_dns: matched SSHFP type 4 fptype 1
debug3: verify_host_key_dns: checking SSHFP type 4 fptype 2
debug1: verify_host_key_dns: matched SSHFP type 4 fptype 2
debug1: matching host key fingerprint found in DNS

secure statt insecure. SSH verifiziert den Hostkey automatisch per DNSSEC — keine manuelle Fingerprint-Prüfung mehr nötig.

Rebootfest machen

Die manuell eingetragenen Optionen in der resolv.conf überleben keinen Reboot — der NetworkManager überschreibt die Datei. Per nmcli die Optionen dauerhaft im Netzwerkprofil setzen, für IPv4 und IPv6:

nmcli conn modify DEINE-PROFIL-UUID ipv4.dns-options edns0,trust-ad
nmcli conn modify DEINE-PROFIL-UUID ipv6.dns-options edns0,trust-ad

Die UUID des aktiven Profils findet man mit nmcli conn show. Beide Zeilen sind nötig — fehlt eine, greift es nicht.


Zusammenfassung: systemd-resolved unter Linux Mint und Ubuntu filtert das DNSSEC-AD-Flag heraus. Ohne AD-Flag kann SSH die SSHFP-Records nicht als vertrauenswürdig einstufen. Lösung: systemd-resolved abschalten, NetworkManager mit dns=default nutzen, edns0,trust-ad per nmcli setzen.

Wer einen DNSSEC-validierenden Resolver sucht — dns.kernel-error.de ist ein öffentlicher DNS-Resolver mit DNSSEC, DNS over TLS und DNS over HTTPS.

Und die offene Frage: Ich bin mit meinem FreeBSD-Wissen an das Thema gegangen. Wie macht man das als Linux-User mit systemd-resolved richtig? Schreibt mir, wenn ihr es wisst.

Siehe auch: SSH Host Keys per SSHFP

Kodi auf dem Raspberry Pi 4: Ruckelfreie Wiedergabe einrichten
Der Raspberry Pi 4 , egal ob mit 4GB oder 8GB RAM, ist in der Kombination mit Kodi eine wunderbare Erweiterung am Fernseher. Leider sorgte die letzte Version Kodi v19.3 (Matrix) bei mir für ein paar Problemchen. So stockte oder ruckelte die Wiedergabe von Videos oder die Wiedergabe lief für einige Minuten gut, dann wurde gebuffert, nur damit sich dieses Spielchen alle paar Minuten wiederholte. Egal ob im WLAN oder direkt am LAN.
Folgende Änderungen haben bei mir für eine Lösung der Probleme gesorgt:

  1. Erstellen einer XML Datei, welche die default Einstellungen des Cachings überschreibt.

    Speicherort und Dateiname ist: /storage/.kodi/userdata/advancedsettings.xml
<?xml version="1.0" encoding="utf-8"?>
<advancedsettings>
        <cache>
                <memorysize>524288000</memorysize>
                <buffermode>1</buffermode>
                <readfactor>6</readfactor>
        </cache>
</advancedsettings>

Achtung… Bei XML Dateien, spielt das richtige „Einrücken“ schon mal eine Rolle.

2. Erweitern des Arbeitsspeichers für die GPU, sowie das Erzwingen des „Turbo“ Modus.
Dafür einfach die Datei /flash/config.txt um folgende Zeilen erweitern/einpassen:

# Default GPU memory split, 76MB are needed for H264 decoder
gpu_mem=256
force_turbo=1

Wer dieses gerne per SSH machen möchte, muss das Volume /flash einmal schreibfähig mounten:

mount -o remount,rw /flash

Die Option gpu_mem setzt recht einfach den, für die Grafikkarte, reservierten Arbeitsspeicher fest auf 256MB. Dieses macht selbst bei der 4GB Raspberry PI 4 Version kein Problem.

force_turbo deaktiviert das dynamische, lastabhängige takten der CPU, GPU und des Arbeitsspeichers, sowie der Spannungen. Alles läuft daher auf Maximum, aber ohne zu übertakten. Dieses hat weniger Auswirkungen auf die Probleme bei der Wiedergabe, sorgt aber für ein allgemein „flüssigeres“ Verhalten. Dafür steigt die Stromaufnahme und die Temperatur. Da wir hier über einen Raspberry sprechen, ist es wohl für die Meisten zu vernachlässigen.

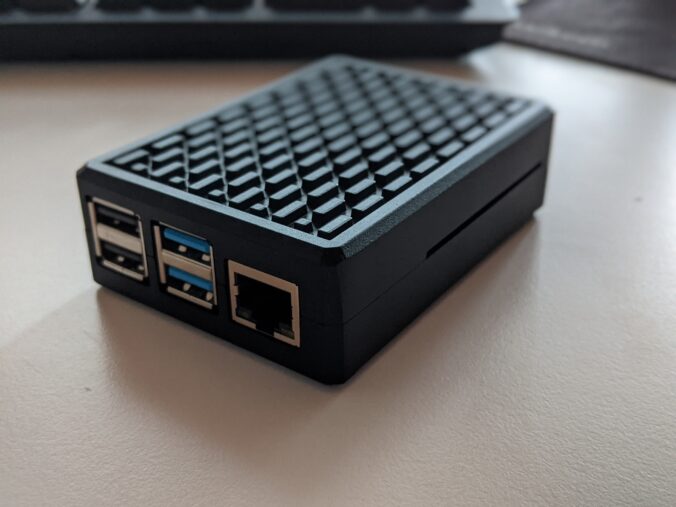
3. Um Temperatur und Geräuschpegel im Zaum zu halten, empfiehlt sich ein gutes passiv gekühltes Gehäuse. Folgendes kann ich empfehlen: https://amzn.to/3qF61pe

Das mitgelieferte Netzteil hat ausreichend Power, man kommt noch an „alles“ ran, das Gehäuse ist sehr massiv und selbst bei großer Last/langem Betrieb, wird alles nur handwarm.


Update Februar 2026 — Kodi 21 (Omega) / LibreELEC 12.x

Seit Kodi 21 (Omega), das mit LibreELEC 12.x ausgeliefert wird, funktioniert die oben beschriebene Cache-Konfiguration über die advancedsettings.xml nicht mehr korrekt. Die <cache> Sektion wird zwar noch eingelesen und im Log angezeigt — die tatsächlich aktiven Werte kommen aber aus den GUI-Settings (guisettings.xml). Im Kodi-Log erkennt man das an dieser Zeile:

New Cache GUI Settings (replacement of cache in advancedsettings.xml) are:
    Buffer Mode: 4
    Memory Size: 20 MB
    Read Factor: 4.00 x

Das bedeutet: Trotz konfigurierter 500 MB in der advancedsettings.xml läuft Kodi mit nur 20 MB Puffer — dem Default. Nicht gerade ideal.

Die neue Methode

Die Cache-Werte müssen jetzt direkt in /storage/.kodi/userdata/guisettings.xml gesetzt werden. Dafür Kodi stoppen, Datei bearbeiten, Kodi starten:

systemctl stop kodi
sleep 3

In der guisettings.xml diese drei Zeilen suchen und anpassen. Wichtig: Das default="true" muss entfernt werden, damit Kodi die Werte als benutzerdefiniert erkennt.

Vorher:

<setting id="filecache.buffermode" default="true">4</setting>
<setting id="filecache.memorysize" default="true">20</setting>
<setting id="filecache.readfactor" default="true">400</setting>

Nachher (Beispiel für 8 GB RAM):

<setting id="filecache.buffermode">1</setting>
<setting id="filecache.memorysize">500</setting>
<setting id="filecache.readfactor">600</setting>

Dann Kodi wieder starten:

systemctl start kodi

Was die Werte bedeuten

buffermode = 1

Legt fest, welche Quellen gepuffert werden:

WertBedeutung
0Nur Internet-Streams (HTTP, FTP…)
1Alles (Internet + LAN + lokal) ← empfohlen
2Nur „echte“ Internet-Streams
3Kein Puffer
4Alle Netzwerk-Quellen (Default in Kodi 21)

Wir setzen 1 statt 4, damit NFS-Quellen garantiert gepuffert werden — egal wie Kodi die Quelle intern klassifiziert.

memorysize = 500 (bzw. 250)

Die Größe des Puffers in MB. Das ist der Speicher, den Kodi im RAM reserviert, um Film-Daten vorauszulesen.

Praktisches Beispiel: Ein typischer 4K-Film hat ~80 Mbit/s Bitrate (ca. 10 MB/s).

  • 20 MB (Default): Nur ~2 Sekunden Film im Puffer. Wenn das Netzwerk kurz schwankt, stockt die Wiedergabe sofort.
  • 500 MB: Ca. 50 Sekunden Film im Puffer. Selbst wenn NFS mehrere Sekunden hängt, läuft die Wiedergabe weiter.

Empfohlene Werte nach verfügbarem RAM:

  • 8 GB RAM: memorysize = 500
  • 4 GB RAM: memorysize = 250

readfactor = 600 (= 6×)

Der Wert wird intern durch 100 geteilt, also 600 = 6,0×. Kodi liest Daten mit der 6-fachen Geschwindigkeit der benötigten Bitrate voraus. Bei einem 80 Mbit/s Film liest Kodi also mit ~480 Mbit/s vom NFS, bis der Puffer voll ist. Danach drosselt es auf die tatsächlich benötigte Rate. Das sorgt dafür, dass der Puffer sich schnell füllt und möglichst voll bleibt.

Verifizierung

Nach dem Neustart im Kodi-Log prüfen, ob die neuen Werte aktiv sind:

grep "New Cache GUI Settings" -A4 /storage/.kodi/temp/kodi.log

Hinweis zum Raspberry Pi 5
Die config.txt Anpassungen (gpu_mem=256 und force_turbo=1) gelten weiterhin für den Raspberry Pi 4. Beim Raspberry Pi 5 sind diese nicht nötig — er nutzt eine andere GPU-Architektur (VideoCore VII) und gpu_mem hat dort keine Wirkung.
« Ältere Beiträge Neuere Beiträge »

© 2026 -=Kernel-Error=-

Theme von Anders Norén — Hoch ↑