IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: Sysadmin (Seite 8 von 13)

Citrix XenServer Updates manuell über Bash installieren

Veraltet: Citrix XenServer wird seit 2024 nicht mehr in dieser Form angeboten. Das hier beschriebene manuelle Update-Verfahren gilt für XenServer 6.x/7.x und funktioniert mit aktuellen Versionen nicht mehr. Alternativen: Proxmox VE oder XCP-ng.

Der Citrix XenServer 6.2 ist zwar nun frei, Updates lassen sich aber nicht so einfach über das XenCenter installieren. Sie werden einem zwar noch angezeigt (so weiß man zumindest welche man installieren sollte) aber einfach durchklicken ist nicht mehr.

Über die Konsole ist es denn noch schnell erledigt, wie ich hier kurz beschreiben möchte! Um die Installation per Kommandozeile zu zeigen nehme ich folgenden Patch als Beispiel: Hotfix XS61E013 – For XenServer 6.1.0 Nun aber los zur commandline action…

Zuerst den jeweiligen Patch von support.citrix.com herunterladen.

$ wget http://support.citrix.com/servlet/KbServlet/download/33649-102-705213/XS61E013.zip

Dann das Zipfile auspacken:

$ unzip XS61E013.zip
Archive:  XS61E013.zip
  inflating: XS61E013.xsupdate       
  inflating: XS61E013-src-pkgs.tar.bz2
Als nächstes das xsupdate File auf den Server kopieren:
$ scp XS61E013.xsupdate root@10.8.4.66:/update/
XS61E013.xsupdate                                                                                                                      100% 1678KB   1.6MB/s   1.6MB/s   00:00
/update/ ist dabei ein Verzeichnis auf dem Citrix XenServer, welches ich zuvor angelegt habe.

Nun auf dem XenServer als root anmelden und in das passende Verzeichnis wechseln:

$ ssh root@10.8.4.66
Last login: Wed Apr  2 17:32:12 2014 from 10.33.45.21

XenServer dom0 configuration is tuned for maximum performance and reliability.

Configuration changes which are not explicitly documented or approved by Citrix
Technical Support, may not have been tested and are therefore not supported. In
addition, configuration changes may not persist after installation of a hotfix
or upgrade, and could also cause a hotfix or upgrade to fail.

Third party tools, which require modification to dom0 configuration, or
installation into dom0, may cease to function correctly after upgrade or hotfix
installation. Please consult Citrix Technical Support for advice regarding
specific tools.

Type "xsconsole" for access to the management console.
[root@dom0-sdb35 ~]# cd /update
[root@dom0-sdb35 update]# 

Ich schaue nun gerne immer zuerst welche Patches bereits installiert wurden:

[root@dom0-sdb35 update]# xe patch-list
uuid ( RO)                    : 7fd1ba20-1582-4b02-a61d-c251ad0b637c
              name-label ( RO): XS61E001
        name-description ( RO): Public Availability: fix for ISCSI multipathing
                    size ( RO): 862376
                   hosts (SRO): 427c6c42-a193-4740-8ed7-c664b5ace02c
    after-apply-guidance (SRO):

uuid ( RO)                    : c5354c77-4643-4e79-8cdf-fac914fc6c85
              name-label ( RO): XS61E003
        name-description ( RO): Public Availability: Xapi fixes
                    size ( RO): 6631433
                   hosts (SRO): 427c6c42-a193-4740-8ed7-c664b5ace02c
    after-apply-guidance (SRO): restartXAPI

uuid ( RO)

Wie man sehen kann sind auch bereits Patches eingespielt, was daran zu erkennen ist das sie dem host „zugewiesen“ sind. Um nun zuerst den gerade kopieren Patch in die Liste zu packen reicht folgender Befehl:

[root@dom0-sdb35 update]# xe patch-upload file-name=XS61E013.xsupdate
55aa7129-a5ff-4e90-899b-f89248d1182e
Und noch kontrollieren ob er in der Liste ist:
[root@dom0-sdb35 update]# xe patch-list
uuid ( RO)                    : 55aa7129-a5ff-4e90-899b-f89248d1182e
              name-label ( RO): XS61E013
        name-description ( RO): Public Availability: security fixes to Xen and xenstored
                    size ( RO): 1717976
                   hosts (SRO):
    after-apply-guidance (SRO): restartHost

Perfekt… Nun kann der Patch schon eingespielt werden. Dabei ist immer der Punkt: after-apply-guidance (SRO): zu beachten. In diesem Fall restartHost. Also am besten vorher brav alle VMs abschalten, Patch wie noch folgt einspielen und die Kiste einmal durchstarten.

[root@dom0-sdb35 update]# xe patch-apply uuid=55aa7129-a5ff-4e90-899b-f89248d1182e host-uuid=427c6c42-a193-4740-8ed7-c664b5ace02c
Preparing...                ##################################################
xen-hypervisor              ##################################################
Preparing...                ##################################################
xen-tools                   ##################################################

Etwas aufwendiger als mit dem XenCenter, denn noch gut und problemlos machbar! Ist der Patch eingespielt kann die Patch-Datei natürlich wieder vom Server gelöscht werden. Wenn sein Server direkt ins Internet darf, kann man ebenfalls direkt auf der Kiste den wget ausführen. Auf was man aber immer achten sollte ist der freie Plattenplatz. Denn wenn man so viele Updates auf die Kiste legt das dem dom0 plötzlich ein Platz mehr bleibt… Tja, dann hat man andere Probleme.

Noch Fragen?

Siehe auch: Citrix XenServer local storage größer >2TB, XenServer mit Nagios überwachen, XenServer Linux Softwareraid, Local ISO Repository
Bash Schnipsel Message Size Limit

Ich muss gerade bei einigen Systemen den Message Size Limit von Postfix kontrollieren. Jetzt liegen die verschiedenen Kundendomains in verschiedenen Containern. Ich muss also immer nachschauen welcher, da ich faul bin hat mir folgender Einzeiler die Arbeit etwas erleichtert….

kernel@errorpc ~ $ ssh xyz-user@`dig kernel-error.de in MX +short|sed -e 's/^.\{,3\}//'` "postconf | grep message_size_limit"
message_size_limit = 104857600

Er sammelt sich per dig den gesetzten MX Eintrag der jeweiligen Domain aus dem DNS (es gibt nur einen pro Domain), schneidet die Prio und das Leerzeichen ab und übergibt den übrigen Hostname dann an ssh, welches sich direkt als xyz-user dort anmeldet, Postfix nach dem eingestellten Wert fragt und direkt wieder „auflegt“.

Passt natürlich nicht für jeden Fall, war aber hier wieder schön.

Fragen? Einfach melden.

Apache: Sichere SSL/TLS-Verschlüsselung einrichten

Ich habe vor kurzem etwas über sichere SSL / TLS Einstellungen beim Mozilla Firefox geschrieben. Dabei habe ich etwas die Serveradmins in die Pflicht genommen, dafür zu sorgen dass ihre Seite so konfiguriert wird, dass erst überhaupt keine unsicheren Verfahren angeboten werden. Inzwischen sind ein paar Fragen bei mir angekommen wie ich es umgesetzt habe.

Begonnen habe ich mit dem Strict-Transport-Security Header. Sind diese gesetzt, und ein Client verbindet sich verschlüsselt (SSL / TLS) mit dem Webserver sagt ihm der Server: „Schön das du da bist. Ach ja, verbinde dich bitte die nächsten X Tage nur noch verschlüsselt mit mir, ok?“.

Normalerweise richten sich Webbrowser an diese „Bitte“ des Servers. Damit wird verhindert das ein Angreifer den Client überredet sich unverschlüsselt mit einem anderen Server zu unterhalten oder von der verschlüsselten Übertragung zur unverschlüsselten zu wechseln. Denn würde ein solcher Wechsel klappen, könnte der Angreifer ja ab dem Moment mitlesen!

Damit ich nun also die Strict-Transport-Security nutzen kann muss zuerst das Apache Modul headers aktiviert werden. Dieses erledige ich mit:

$ a2enmod headers

 Fehlt nur noch eine weitere Zeile in der vhost Konfiguration:

Header always set Strict-Transport-Security "max-age=15552000"

max-age gibt einen Zeitwert in Sekunden vor. Dieser darf/sollte nicht kleiner als 180 Tage sein. 15552000 entspricht dabei genau 180 Tagen.

Damit wird also schon mal jeder Client für die kommenden 180 Tag versuchen verschlüsselt mit mir zu sprechen. Natürlich ist an dieser Stelle zu bedenken, wenn ich mich plötzlich dazu entscheiden sollte SSL/TLS nicht mehr anzubieten, werden es die Clients denn noch weiter so probieren. Also aufpassen….

Auf zu ssl crime attack… Dieser Angriff ist möglich wenn die SSLCompression aktiviert ist. Ich erweitere also meine Konfiguration des vhosts im Apache um folgende Zeile:

SSLCompression off

Um direkt die unsicheren und veralteten Protokolle zu deaktivieren folgt auf dem Fuße:

SSLProtocol +ALL -SSLv3 -SSLv2

Damit sich gleich alle an die Reihenfolge meiner zugelassenen Cipher Suite halten, gebe ich dieses noch einmal expliziet vor:

SSLHonorCipherOrder On

Fehlen nur noch die zu verwendenden Cipher Suites…. Dabei beginne ich mit den gewünschten Favoriten und gehe Stück für Stück weiter runter. Am Ende verbiete ich noch diese, welche ich auf keinen Fall nutzen will (alles vor dem ein Ausrufezeichen „!“ steht).

SSLCipherSuite ECDHE-RSA-AES256-GCM-SHA384:ECDHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES256-GCM-SHA384:DHE-RSA-AES128-GCM-SHA256:ECDHE-RSA-AES256-SHA384:ECDHE-RSA-AES128-SHA256:ECDHE-RSA-AES256-SHA:ECDHE-RSA-AES128-SHA:DHE-RSA-AES256-SHA256:DHE-RSA-AES128-SHA256:DHE-RSA-AES256-SHA:DHE-RSA-AES128-SHA:ECDHE-RSA-DES-CBC3-SHA:EDH-RSA-DES-CBC3-SHA:AES256-GCM-SHA384:AES128-GCM-SHA256:AES256-SHA256:AES128-SHA256:AES256-SHA:AES128-SHA:DES-CBC3-SHA:HIGH:!aNULL:!eNULL:!EXPORT:!CAMELLIA:!DES:!MD5:!PSK:!RC4

 Nur noch den Apache neu starten und den aktuellen Zustand testen: https://www.ssllabs.com/ssltest/analyze.html?d=kernel-error.de

Noch Fragen? Na dann fragen!

Fragen? Einfach melden.

ownCloud

Veraltet: ownCloud wird nicht mehr aktiv weiterentwickelt. Der Nachfolger ist Nextcloud.

Zur kurzen Beschreibung von ownCloud greife ich jetzt einfach mal ganz faul auf den ersten Absatz aus dem passenden Wikipediaartikel zurück:

### schnipp ###

ownCloud ist eine Software-Suite, die einen ortsunabhängigen Speicherbereich für Daten zur Verfügung stellt. Das Projekt wurde im Januar 2010 vom KDE-Entwickler Frank Karlitschek ins Leben gerufen, um eine freie Alternative zu kommerziellen Cloud-Anbietern zu schaffen. Im Gegensatz zu kommerziellen Speicherdiensten kann ownCloud auf einem privaten Server ohne Zusatzkosten installiert werden. Somit können gerade bei sensiblen Daten die Bedenken gegenüber einer Datenweitergabe und der damit einhergehenden Abgabe der Kontrolle über die Daten zerstreut werden.

Als Grundlage setzt das Projekt auf PHP und einer angebundenen SQLite-, MySQL- oder PostgreSQL-Datenbank. Die ownCloud kann über eine Weboberfläche bedient werden und ist dadurch nicht an ein bestimmtes Betriebssystem gebunden. Aber auch andere Anwendungen, wie beispielsweise Dateimanager oder Groupwares, können die ownCloud über eine Schnittstelle ansprechen und Dateien und Daten lokal bereitstellen.

### schnapp ###

Im Grunde lässt sich ownCloud also mit recht kleinen Grundvoraussetzungen ownCloud in Betrieb nehmen. Selbst die einfache Installation ist nicht weiter aufwendig. Natürlich hängt es immer etwas davon ab, welche Systeme man noch anbinden möchte und wie groß es am Ende wirklich werden soll.

Inzwischen gibt es für alle möglichen Clients auch Software, welche sie an ownCloud anbindet. Evolution, Thunderbird, Kmail (und Anhang), Sync-Clients für Windows/Linux/… Man kann einfach auf seine Dateien per WebDAV zugreifen usw. usw…

Man hat also seine Daten wirklich unter der eigenen Kontrolle und würfelt sie nicht irgendwo hin. Dabei ist die nötige Basis so gering dass es alles sogar über einen Raspberry Pi läuft.

OK… Es hat natürlich einen Haken. Denn es ist wie immer, wenn man selbst dafür verantwortlich ist, dann ist man auch selbst dafür verantwortlich. Alles ist dann nur so sicher wie man es selbst abgesichert hat, sich um die Patchstände kümmert und die Konfiguration vorgenommen hat.

Denn noch bietet man natürlich selbst in der Regel ein nicht ganz so attraktives Ziel wie ein großer Clouddienstleister (ich mag das Wort cloud nicht…).

Siehe auch: ownCloud und Kalender / Kontakte synchronisieren, ownCloud News-App, ownCloud und Mozilla-Sync, Davdroid ownCloud sync

Fragen? Einfach melden.

Zum Dumm, zum Zum: Eine humorvolle Reflexion

Na, mal wieder Lust auf etwas aus der: „Mein Gott, van de Meer!“ Ecke? OK…
Ich werfe also gerade einige Domains auf einen neuen DNS Server. Alles prima, nur saugt sich der Slave die Zonen nach einer Änderung nicht vom Master. Ich teste alles durch renne wild umher und gehe schon anderen Leuten auf den Sack. Bis mir jemand sagt… Kommen die Notifys vielleicht noch vom alten Server? Der PTR von der IPv4 Adresse ist….. Gott bin ich doof. Mein Gott bin ich blöde…

Der neue DNS Server hat mehrere IPv4 Adressen. Der Bind hört natürlich auf eine, nur ist es nicht die primäre IPv4 Adresse des Servers. Der Bind schickt folglich die Notifys über eine andere IPv4 Adresse zum Slave. Der denkt sich… Ok tolle Info aber ich soll auf ne andere Adresse hören. Also interessiert er sich nicht und zieht sich die Zone nicht. Ist ja ich richtig so!

Ich Wurst habe nämlich vergessen dem Bind zu sagen dass er bitte einfach alles über eine bestimmte IPv4 Adresse versenden soll. Ich muss den Bind im Grunde an eine ausgehende IP Adresse binden.
Kann Bind natürlich, schon alleine wegen IPv6. Denn da hat man ja schnell mehrere Adressen.
Nun kann man dem Bind viele verschiedene Vorgaben machen, wie er denn bitte den Weg nach draußen zu nehmen hat. Man kann sagen über welche IP Adresse er selbst anfragen rausschicken soll, über welche Adresse er bitte die Zonen durchreichen soll und auch über welche Adresse er das Notify an den Slave schicken soll.

options {
......
transfer-source 1.2.3.4;
notify-source 1.2.3.4;
query-source 1.2.3.4;
......
};

Alles einfach in den Optionsblock und fertig ist:

So einfach kann es sein, WENN MAN DARAN DENKT! Damit bewegt sich Bind fast nur noch über die angegebene Adresse nach draußen. Man bin ich blöde und wieviel Zeit ich damit wieder verbrannt habe *heul*!

Fragen? Einfach melden.

Contabo VPS

Lange habe ich nach einem ordentlichen Anbieter für einen neuen vServer gesucht. Dabei galt es folgende Kriterien zu erfüllen:

– Min. 2 IPv4 Adressen
– Ein kleines IPv6 Netz
– Unbegrenzter Traffic
– Min. 100Mbit/s Anbindung
– Min. 2 CPUs
– Min. 4 GB RAM
– Min. 200 GB HDD
– Linux als OS

Natürlich habe ich zuerst die Großen abgeklappert.

– 1und1 kein IPv6 (warum nicht? Ich meine 2014 HALLO!?!?)
– Strato nur EINE IPv6 Adresse (Ö_ö eine IPv6 Adresse…. eine?)
– Host Europe kein IPv6 bei den vServer nur bei den Root Server EINE (tz..)
– 1blue kein IPv6
– Server4you kein IPv6 beim vServer, sonst soll es wohl gehen…
– Serverloft… Joar, die Kosten sind mir zu hoch. Sind aber auch keine vServer.
– usw. usw. usw…

IPv6 scheint noch immer ein größeres Problem zu sein, ist nicht voll integriert oder ist (wie auch meherer IPv4 Adressen) hochpreisigen Produkten vorbehalten.

Dann bin ich auf Contabo gestoßen. Ich war Opfer der Werbung im Linux Magazin 🙁 Preis/Leistung sah dabei einfach zu gut aus. Daher habe ich angerufen. Ohne lange Hoteline sprach ich mit einem Menschen. Diesem stellte ich direkt meine Fragen und er konnte sie überraschenderweise direkt und sicher beantworten. Mit sicher meine ich, dass man nicht das Gefühl hatte er würde es irgendwo nachlesen oder wäre nach einer kurzen Schulung auf die Hotline losgelassen worden. Nein, es war wirklich gut!

Natürlich habe ich abschließend die Frage gestellt wie es klappt dass die angegebene Leistung so gut ist, der Support so schön zu funktionieren scheint und die Ausstattung und Randbedingungen ebenfalls so gut erscheinen. Nach hörbarem Schmunzeln bekam ich die Antwort: Das würde oft gefragt…. Ich müsse es so sehen. Contabo selbst stellt wirklich nur die Hardware und die Infrastruktur. Für das System selbst ist man selbst verantwortlich. Wenn es da mal Probleme gibt, könnte der Support zwar helfen diese wäre dann aber Kostenpflichtig (er meinte damit wenn man seine Kiste mal zerfriemelt hat). Man müsse schon wissen was man tut, dieses würden Contabo bei seinen Produkten einfach voraussetzten.

Schien also genau das zu sein was ich gesucht habe! Daher habe ich bestellt… Wobei ich genau eine solche Antwort von jedem Root-Server erwarten würde.

Alles ging schnell und für mich verständlich online. Ich bekam eine E-Mail mit der Bitte Geld zu überweisen (wer konnte damit nur rechnen. ). Kurz nach meiner Überweisung flatterten bereits die Zugangsdaten in mein Postfach.

Wie bei der Bestellung angeklickt hatte ich schon eine zweite IPv4 Adresse und konnte die PTR-Records flott im Webmenü eintragen. Um die PTR-Records der IPv6 Adressen zu ändern musste ich kurz den Support per E-Mail bemühen. Freitags um 23:36 Uhr habe ich ihn angemailt als ich morgens aufgewacht bin hatte ich schon die Bestätigung in meinem Postfach. Das System selbst ist genau wie bestellt und hat mehr Leistungsreserven als erwartet. Ich habe 8GB Arbeitsspeicher, 400Gb Festplattenplatz und zwei CPUs mit 3,4GHz. Auf der Webseite war nur etwas von 3,2GHz zu lesen. Ok ok… die paar MHz machen den Braten jetzt nicht fett, das es Core I7 CPUs sind hat mich denn noch überrascht!

Ich habe natürlich Speicher und CPU mal mit Arbeit beworfen um zu testen ob es nicht nur Schein ist. Alles prima…. Die Storage Anbindung ist ja gerne mal etwas zu genau auf den Punkt dimensioniert. Bei meinem System kann ich nicht klagen. Performance und I/Os sind wunderbar und mehr als ausreichend.

100Mbit/s sind auch 100Mbit/s… Wobei man hier auf das „Kleingedruckte“ achten muss: Keine zusätzlichen Kosten durch Traffic (bei einem Durchschnittsverbrauch über 40 Mbit/s in einem zusammenhängenden Zeitraum von mindestens 5 Tagen erfolgt eine Umstellung der Anbindung auf 10 Mbit/s).

Zu dem Thema muss ich dann wohl mal eine kleine Auswertung vom Support anfordern. Sollte doch machbar sein, oder?

Ob mich dieses noch ärgert, werde ich herausfinden. Ob mich noch mehr ärgert wird sich zeigen!

Fragen? Einfach melden.

Ping6 funktioniert nicht auf fe80-Adresse: Fehlerbehebung

Ja, die liebe fe80 Adressen! Wer schon mal ganz unbedarft folgendes in seine Konsole hämmert:

$ ping6 fe80::20c:42ff:fe72:2ba6
connect: Invalid argument

Wundert sich sicher im ersten Moment über die freche Antwort: „connect: Invalid argument“. ABER das ist absolut richtig. Denn wenn man mehrere Netzwerkkarten in seinem Rechner verbastelt hat, dann hat man ebenfalls mehrere fe80 link local Adressen. Nämlich mindestens eine pro Netzwerkkarte. Damit sollte es jetzt schon klingeln, hm? Noch nicht? Na woher soll das Paket den bitte wissen über welche der Netzwerkkarten es denn den Weg zur angepingten Adresse nehmen soll?!?!? Genau überhaupt nicht! Daher muss das Interface welches als „Ausgang“ genutzt werden soll immer mit angegeben werden.

$ ping6 fe80::20c:42ff:fe72:2ba6%eth0
PING fe80::20c:42ff:fe72:2ba6%eth0(fe80::20c:42ff:fe72:2ba6) 56 data bytes
64 bytes from fe80::20c:42ff:fe72:2ba6: icmp_seq=1 ttl=64 time=0.323 ms
--- fe80::20c:42ff:fe72:2ba6%eth0 ping statistics ---
1 packets transmitted, 1 received, 0% packet loss, time 0ms
rtt min/avg/max/mdev = 0.323/0.323/0.323/0.000 ms

Unter Linux gibt man einfach %NIC-Name an und unter Windows einfach %NIC-ID:

C:\>ping -6 fe80::20c:42ff:fe72:2ba6%3

Ping wird ausgeführt für fe80::20c:42ff:fe72:2ba6%3 mit 32 Bytes Daten:
Antwort von fe80::20c:42ff:fe72:2ba6%3: Zeit<1ms

Ping-Statistik für fe80::20c:42ff:fe72:2ba6%3:
Pakete: Gesendet = 2, Empfangen = 2, Verloren = 0
(0% Verlust),
Ca. Zeitangaben in Millisek.:
Minimum = 0ms, Maximum = 0ms, Mittelwert = 0ms

C:\>

Wobei ich die Meldung eines Microsoft Windows doch schnell etwas verwirrend finde. Denn hier gibt es nur die Rückmeldung dass das Zielnetz nicht erreichbar ist. Was ja im Grunde korrekt ist, nur grenzt es leider den Fehler nicht so schön ein!

C:\>ping -6 fe80::20c:42ff:fe72:2ba6

Ping wird ausgeführt für fe80::20c:42ff:fe72:2ba6 mit 32 Bytes Daten:

Zielnetz nicht erreichbar.

Ping-Statistik für fe80::20c:42ff:fe72:2ba6:
Pakete: Gesendet = 4, Empfangen = 0, Verloren = 4 (100% Verlust),

C:\>

Japp, so einfach kann es sein.

Siehe auch: IPv6 Grundlagen

Fragen? Einfach melden.

Solaris 11 Shut Down / Herunterfahren Terminal

Veraltet: Solaris 11 und OpenIndiana werden kaum noch eingesetzt. Unter FreeBSD lautet der Befehl shutdown -p now, unter Linux systemctl poweroff.

Ich habe heute einen Anruf eines befreundeten Sysadmins bekommen. Der arme muss darf heute bei einem seiner Kunden den Serveraum umziehen… Dafür möchte er nun die Systeme abschalten. Jetzt steht dort ein Solaris 11 System und der zum System gehörende Admin ist krank (zufällig am Feiertag des Serverraumumzuges…)! Jetzt steht mein Bekannter also vor der Konsole und will die Kiste im Grunde nur abschalten. Folgendes Gespräch ergab sich:

Bekannter: init 0 geht nicht, beim shutdown -h now soll -h eine unknown option sein. Ich bin genervt… Wie geht das aus?
Ich: Solaris 11 im poduktiveinsatz? Dann habt ihr auch Support von Oracle; anrufen / chatte die helfen immer sofort.
Bekannter: Laber nicht rum, ich bin hier für die Microsoft Maschinen. Keine Ahnung wo ich weh anrufen kann. Du kannst das doch, oder?
Ich: Joar… Folgendes sollte dir helfen:

$ shutdown -y -i5 -g0

Bekanter: *Klacker Tipper*
Ich: Root Konsole hattest du schon oder?
Bekannter: *Klacker* japp *Klacker*
Ich: shutdown ist shutdown, -y ist damit du nicht gefragt wirst -i5 ist um die Kiste nach dem Shutdown auch aus zu machen und -g0 ist das es unverzüglich gemacht wird.
Bekannter: Warum ist das so kompliziert? Geht das nicht einfacher? Bei Linux ist das doch einfach shutdown -h now… Man… Ich will eine Maus! Ahh ich glaube er fährt runter!
Ich: Du hättest mit man shutdown den korrekten Befehl erlesen können.
Bekannter: Ach, das muss einfacher gehen!
Ich: Ok dann nimmer das nächste mal den Befehl poweroff…
Bekannter: Du Sack! Danke..

Ich finde es schon sinnvoll unterschiedliche Arten eines shutdown zu haben. Vor allem mit verschiedenen Arten der Signalisierung.

IPv6 ICMP Redirect erklärt: „rt6_redirect: source isn’t a valid nexthop“

Man stolpert irgendwann über diese Meldung im Kernel-Log:

rt6_redirect: source isn't a valid nexthop for redirect target
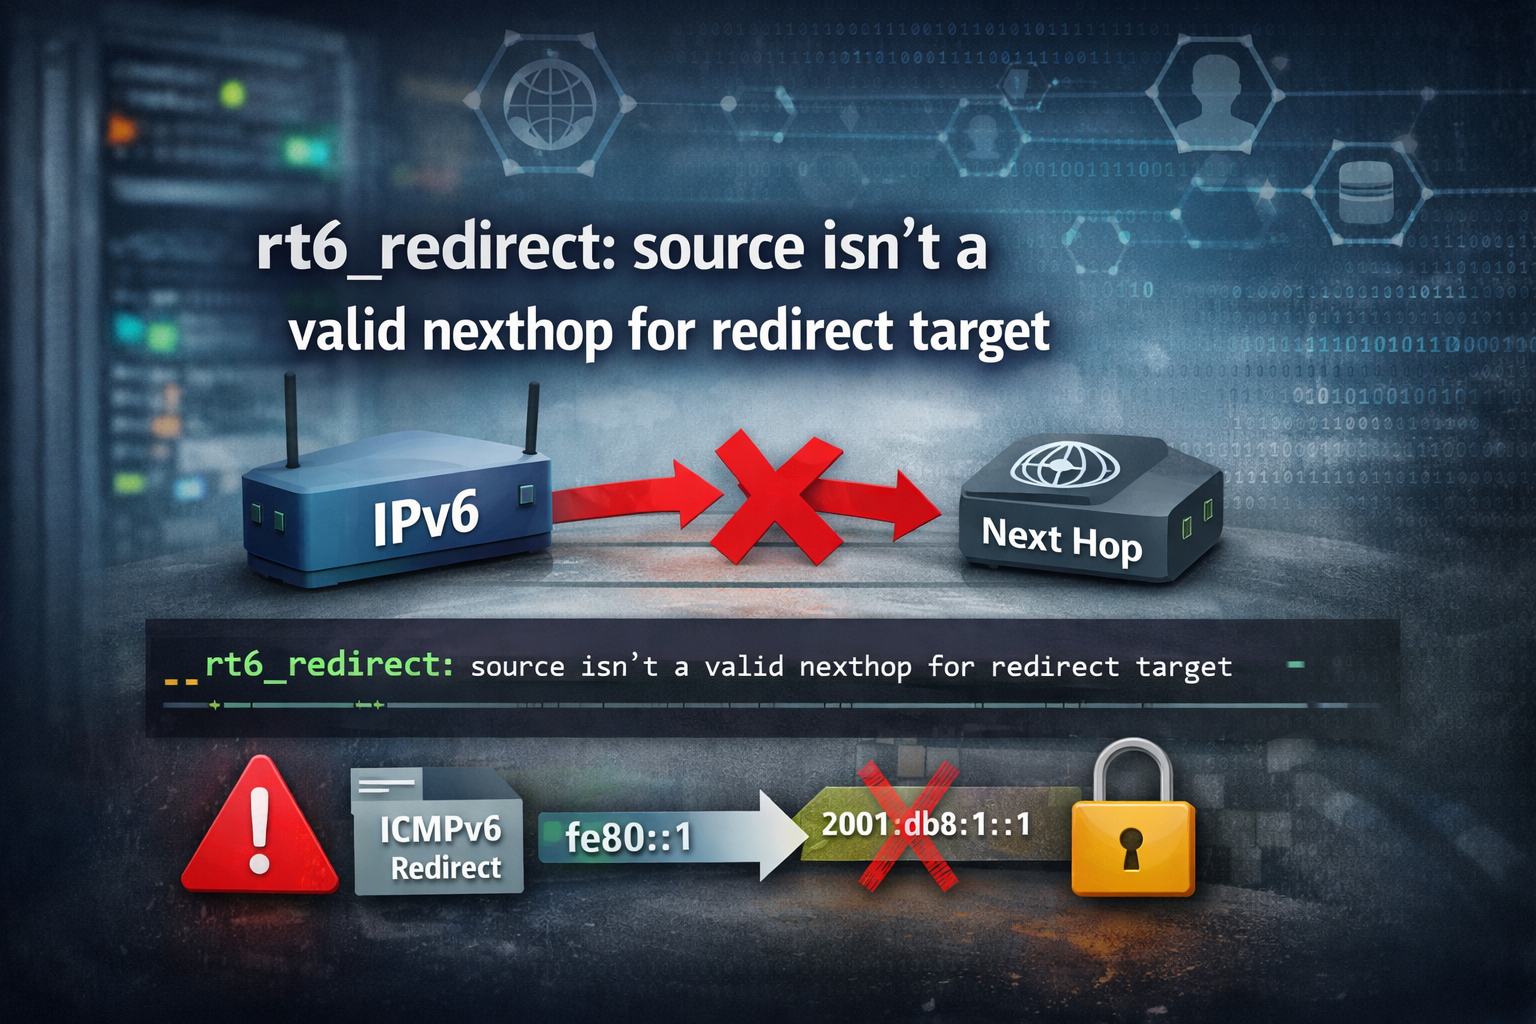
Illustration eines IPv6-Netzwerks mit Kernel-Logmeldung „rt6_redirect: source isn't a valid nexthop for redirect target“. Ein ICMPv6-Redirect verweist fälschlich von einer Link-Local-Adresse auf eine globale IPv6-Adresse als Next Hop, was vom System abgelehnt wird.

Gerne im Zusammenhang mit IPv6, gerne dann, wenn man glaubt, eigentlich alles richtig gemacht zu haben. Routing stimmt. Neighbors sehen gut aus. Und trotzdem meckert der Kernel.

Die Kurzfassung: Der Linux-Kernel hat ein ICMPv6 Redirect bekommen und lehnt es ab, weil der vorgeschlagene Next Hop aus seiner Sicht kein gültiger First Hop ist.

Worum geht es überhaupt?

ICMPv6 Redirects (Typ 137) sind Teil von Neighbor Discovery. Ein Router sagt damit zu einem Host sinngemäß:

„Für dieses Ziel gibt es einen besseren ersten Hop als mich.“

Wichtig: erster Hop. Nicht irgendein Router irgendwo, sondern ein direkt erreichbarer Nachbar auf dem Link.

Ein Redirect enthält deshalb zwei zentrale Informationen:

  • das Target (Zieladresse, für die das Redirect gilt)
  • den Better Next Hop

Und jetzt kommt der Teil, den viele Implementierungen (und Admins) gerne unterschätzen:
Der Host muss diesem Vorschlag nicht glauben.

Was Linux hier tatsächlich prüft

Linux ist bei Redirects ziemlich streng. Zu Recht. Redirects sind ein beliebtes Einfallstor für Unsinn und Angriffe.

Bevor der Kernel ein Redirect akzeptiert, prüft er u. a.:

  • stammt das Redirect von einem Router, den ich bereits als Router kenne?
  • liegt der vorgeschlagene Next Hop auf demselben Link?
  • ist dieser Next Hop als Neighbor bekannt bzw. grundsätzlich auflösbar?
  • passt das Ganze zur bestehenden Routing-Entscheidung?

Und genau hier schlägt diese Logmeldung zu.

Der Kernel schaut auf den Better Next Hop im Redirect und stellt fest:

„Diese Adresse kann für dieses Ziel kein gültiger Next Hop sein.“

Dann wird das Redirect verworfen. Keine neue Route. Kein Update. Nur diese Meldung.

Der Klassiker: Global statt Link-Local

In der Praxis sieht man das oft in Setups, in denen Router ihre Default-Route oder interne Routen nicht sauber über Link-Local-Adressen aufbauen.

Beispiel (vereinfacht):

default via 2001:db8:1::1 dev eth0

Sieht harmlos aus. Funktioniert auch meistens. Aber:
IPv6 erwartet, dass Router auf einem Link über ihre Link-Local-Adresse angesprochen werden.

Korrekt wäre also eher:

default via fe80::1 dev eth0

Was passiert nun?

Der Router verschickt ein Redirect und trägt als „Better Next Hop“ seine globale Adresse ein (z. B. 2001:db8:1::1).
Der Host bekommt das Redirect, prüft es – und sagt:

„Moment. Dieser Next Hop ist kein gültiger direkt erreichbarer Neighbor für dieses Ziel.“

Und genau dann landet diese Meldung im Log.

Wichtig:
Das Problem ist nicht primär, dass die Adresse global ist.
Das Problem ist, dass der Kernel den vorgeschlagenen Next Hop nicht als legitimen First Hop auf diesem Link akzeptiert.

Link-Local ist der Normalfall. Alles andere muss extrem gut begründet sein – und ist es fast nie.

Ein Blick auf die Nachbartabelle hilft

Wenn man wissen will, warum der Kernel das Redirect ablehnt, lohnt sich ein Blick in die Neighbor-Daten:

ip -6 neigh show

Oder gezielter:

ip -6 route get 2001:db8:dead:beef::1

Wenn der vorgeschlagene Next Hop dort nicht als sinnvoller Neighbor auftaucht, ist die Sache im Prinzip entschieden.
Kein Neighbor → kein gültiger Next Hop → Redirect wird verworfen.

Das Redirect live mitschneiden

Wenn man genau wissen will, ob der Router wirklich ein Redirect schickt und was er als Next Hop vorschlägt, hilft tcpdump. ICMPv6 Typ 137 ist das Redirect:

tcpdump -n -i eth0 'icmp6 and ip6[40] == 137'

Im Paket sieht man den Router als Absender, das Target (Ziel, für das der Hinweis gilt) und den Better Next Hop. Passt der Next Hop nicht zu einem gültigen Neighbor auf dem Link, ist klar warum der Kernel ablehnt.

Ebenfalls nützlich: ob der Host Redirects überhaupt annehmen will.

sysctl net.ipv6.conf.all.accept_redirects
sysctl net.ipv6.conf.eth0.accept_redirects

Default ist 1 auf einem Host, 0 auf einem Router. Zusätzlich greift secure_redirects (Default 1): nur Redirects von bereits bekannten Gateways werden überhaupt akzeptiert.

Default-Route mit Link-Local als Next Hop

Wer die Route selbst setzt (statische Konfiguration ohne RA), sollte Link-Local nehmen. Link-Local ist pro Interface nicht eindeutig, der Eintrag braucht also immer ein dev:

ip -6 route add default via fe80::1 dev eth0

Persistenz hängt vom System ab. systemd-networkd in /etc/systemd/network/*.network unter [Route] Gateway=fe80::1, netplan in /etc/netplan/*.yaml, die klassische /etc/network/interfaces kennt post-up ip -6 route .... Wichtig: das Interface muss im Eintrag stehen.

Mit Link-Local als Next Hop verschwindet die rt6_redirect-Meldung in der Regel. Der Kernel hat einen gültigen First Hop als Neighbor, und ein Redirect desselben Routers passt dann sauber ins Modell.

Oder: Redirects abschalten

Auf Servern in kontrollierten Hosting-Umgebungen (Hetzner, Netcup, Cloud-VPCs) ist das Routing sauber vorgegeben, und der Provider-Router hat keinen besseren Next Hop anzubieten. Dann sind ICMPv6-Redirects nur Rauschen im Log:

sysctl -w net.ipv6.conf.all.accept_redirects=0
sysctl -w net.ipv6.conf.default.accept_redirects=0

Persistent in /etc/sysctl.d/99-ipv6.conf. Nachteil: kennt der Router tatsächlich einen legitimen besseren Weg, bleibt der Host trotzdem bei seiner existierenden Route. Im Rechenzentrum mit einer einzigen Default-Route ist das genau richtig, in einem verzweigten Firmennetz mit mehreren Uplinks eher nicht.

Warum das kein Bug ist

Die Meldung klingt erstmal nach kaputtem Routing. Ist es aber meistens nicht.

Im Gegenteil:
Der Kernel verhält sich exakt so, wie es das Protokoll vorsieht. Redirects sind Hinweise, keine Befehle. Und Linux nimmt diese Hinweise nur an, wenn sie sauber in das bestehende Neighbor- und Routing-Modell passen.

Das schützt unter anderem vor:

  • falschen Router-Konfigurationen
  • kaputten RA-Setups
  • Bridge-/VM-Konstrukten mit „kreativem“ IPv6
  • trivialen Redirect-Spoofing-Angriffen

Update 2026: was heute anders ist

In modernen Setups begegnet einem die Meldung seltener. Nicht weil das Protokoll sich geändert hätte, sondern weil die Umgebung drumherum sauberer geworden ist:

  • Enterprise-Switches mit RA Guard und ND Inspection filtern unerwünschte RAs und Redirects bereits auf Layer 2 heraus. Cisco, Juniper und andere haben das seit Jahren im Portfolio.
  • Cloud-Umgebungen (AWS VPC, Hetzner Cloud, Azure) liefern ein sauber vorgegebenes Default-Gateway aus, in der Regel ein Link-Local-Hop. Redirects tauchen praktisch nie auf.
  • Home-Router (FritzBox, Unifi, OpenWrt) machen es per Default richtig.
  • SEND/CGA (RFC 3971) hätte kryptografisch signierte Neighbor Discovery gebracht und Redirect-Spoofing strukturell verhindert. Die Adoption ist praktisch bei null geblieben. Tot.

Übrig bleibt die Meldung heute fast nur in selbstgebauten VM- und Container-Setups, in denen Host- und Gast-Routing nicht sauber zusammenpassen, oder wenn in statischer Konfiguration aus Gewohnheit eine globale Adresse als Next Hop gesetzt wird.

Fazit

Die Meldung

rt6_redirect: source isn't a valid nexthop for redirect target

bedeutet nicht „IPv6 kaputt“.
Sie bedeutet: Ein Router hat ein Redirect geschickt, das aus Sicht des Hosts keinen gültigen Next Hop beschreibt.

In der Praxis ist das fast immer ein Hinweis auf:

  • Default- oder interne Routen ohne Link-Local-Next-Hop (siehe auch IPv6 ULA und Adresspriorisierung)
  • Router, die globale Adressen in Redirects verwenden
  • Setups, in denen Neighbor Discovery und Routing nicht sauber zusammenpassen

Oder anders gesagt:
Der Kernel ist hier nicht pingelig. Er ist vorsichtig. Und das ist gut so.

Siehe auch: IPv6 Grundlagen. Zum Nachlesen: RFC 4861 §8 (Redirect-Handling bei Hosts) und RFC 6980 (fragmentiertes Neighbor Discovery ist verboten — ein harter Security-Fix für ND-Spoofing).

Fragen? Einfach melden.

VirtualBox CompareExchange128

Veraltet: Windows 8 und 8.1 sind seit Januar 2023 komplett ohne Support. Das hier beschriebene VirtualBox-Problem ist nur bei diesem spezifischen Upgrade-Pfad relevant.

Da versuche ich gerade mein Windows 8 auf Windows 8.1 in der VirtualBox zu heben, da springt mich unverhofft eine Meldung an. Ich könne Windows 8.1 nicht installieren da mein Prozessor CompareExchange128 nicht unterstützt.

CompareExchange 128? Das kommt mir im Zusammenhang mit C/C++ und dem Compiler irgendwie bekannt vor. Ich hatte da mal etwas mit einer Binary unter einem FreeBSD. Hing zusammen mit einer AMD64 CPU und noch irgendwas… Gott, warum kann ich mir so einen Mist nicht merken. Aber ich habe in meiner aktuellen Kiste eine Intel CPU. Wobei es wohl eher mit 64Bit als mit dem CPU Hersteller zu schaffen hat. Kann mich da bitte noch mal jemand schlau machen?

Öhm wie auch immer ich erinnere mich daran dass irgendeine recht kryptisch aussehender „Befehlssatz/Anweisung“ im Prozessor genutzt werden sollte. Das Programm auf dem FreeBSD war irgendwie sehr Hardwarenahe übersetzt worden……

Google brachte mich auf den richtigen Weg, nachdem ich es mit: FreeBSD Compareexchange 128 und AMD64 gefüttert hatte. Plöp: http://en.wikipedia.org/wiki/X86-64 und CMPXCHG16B instruction.

Meine CPU:

$ cat /proc/cpuinfo |grep "model name"|uniq
model name : Intel(R) Core(TM) i5-3450 CPU @ 3.10GHz

Kann diese instruction aber und ich wüsste jetzt nicht das mein Bios oder Hostkernel es abschaltet (warum auch?). AAABBBER vielleicht muss man es für VirtualBox einschalten?!? Ok also VBoxManage und öhm sicherlich VBoxInternal und ich würde es bei CPUM?/device? Vermuten… Ach noch mal Google fragen!

Google bringt mit den Worten: CMPXCHG16B und VirtualBox auch direkt ein passendes Ergebnis!

$ VBoxManage setextradata "Windows 8 " VBoxInternal/CPUM/CMPXCHG16B 1

Tja, was soll ich sagen? Geht. Gefühlt habe ich mich mit dem Thema schon wieder zu lange beschäftigt und vor allem zu oft Google fragen müssen (ich bin so schlecht). Also tippe ich mal CompareExchange128 CPU und Instruction hier hin. Dann erinnere ich mich sicher daran es mal hier hin geschrieben zu haben .o0(oder auch nicht).

« Ältere Beiträge Neuere Beiträge »

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑