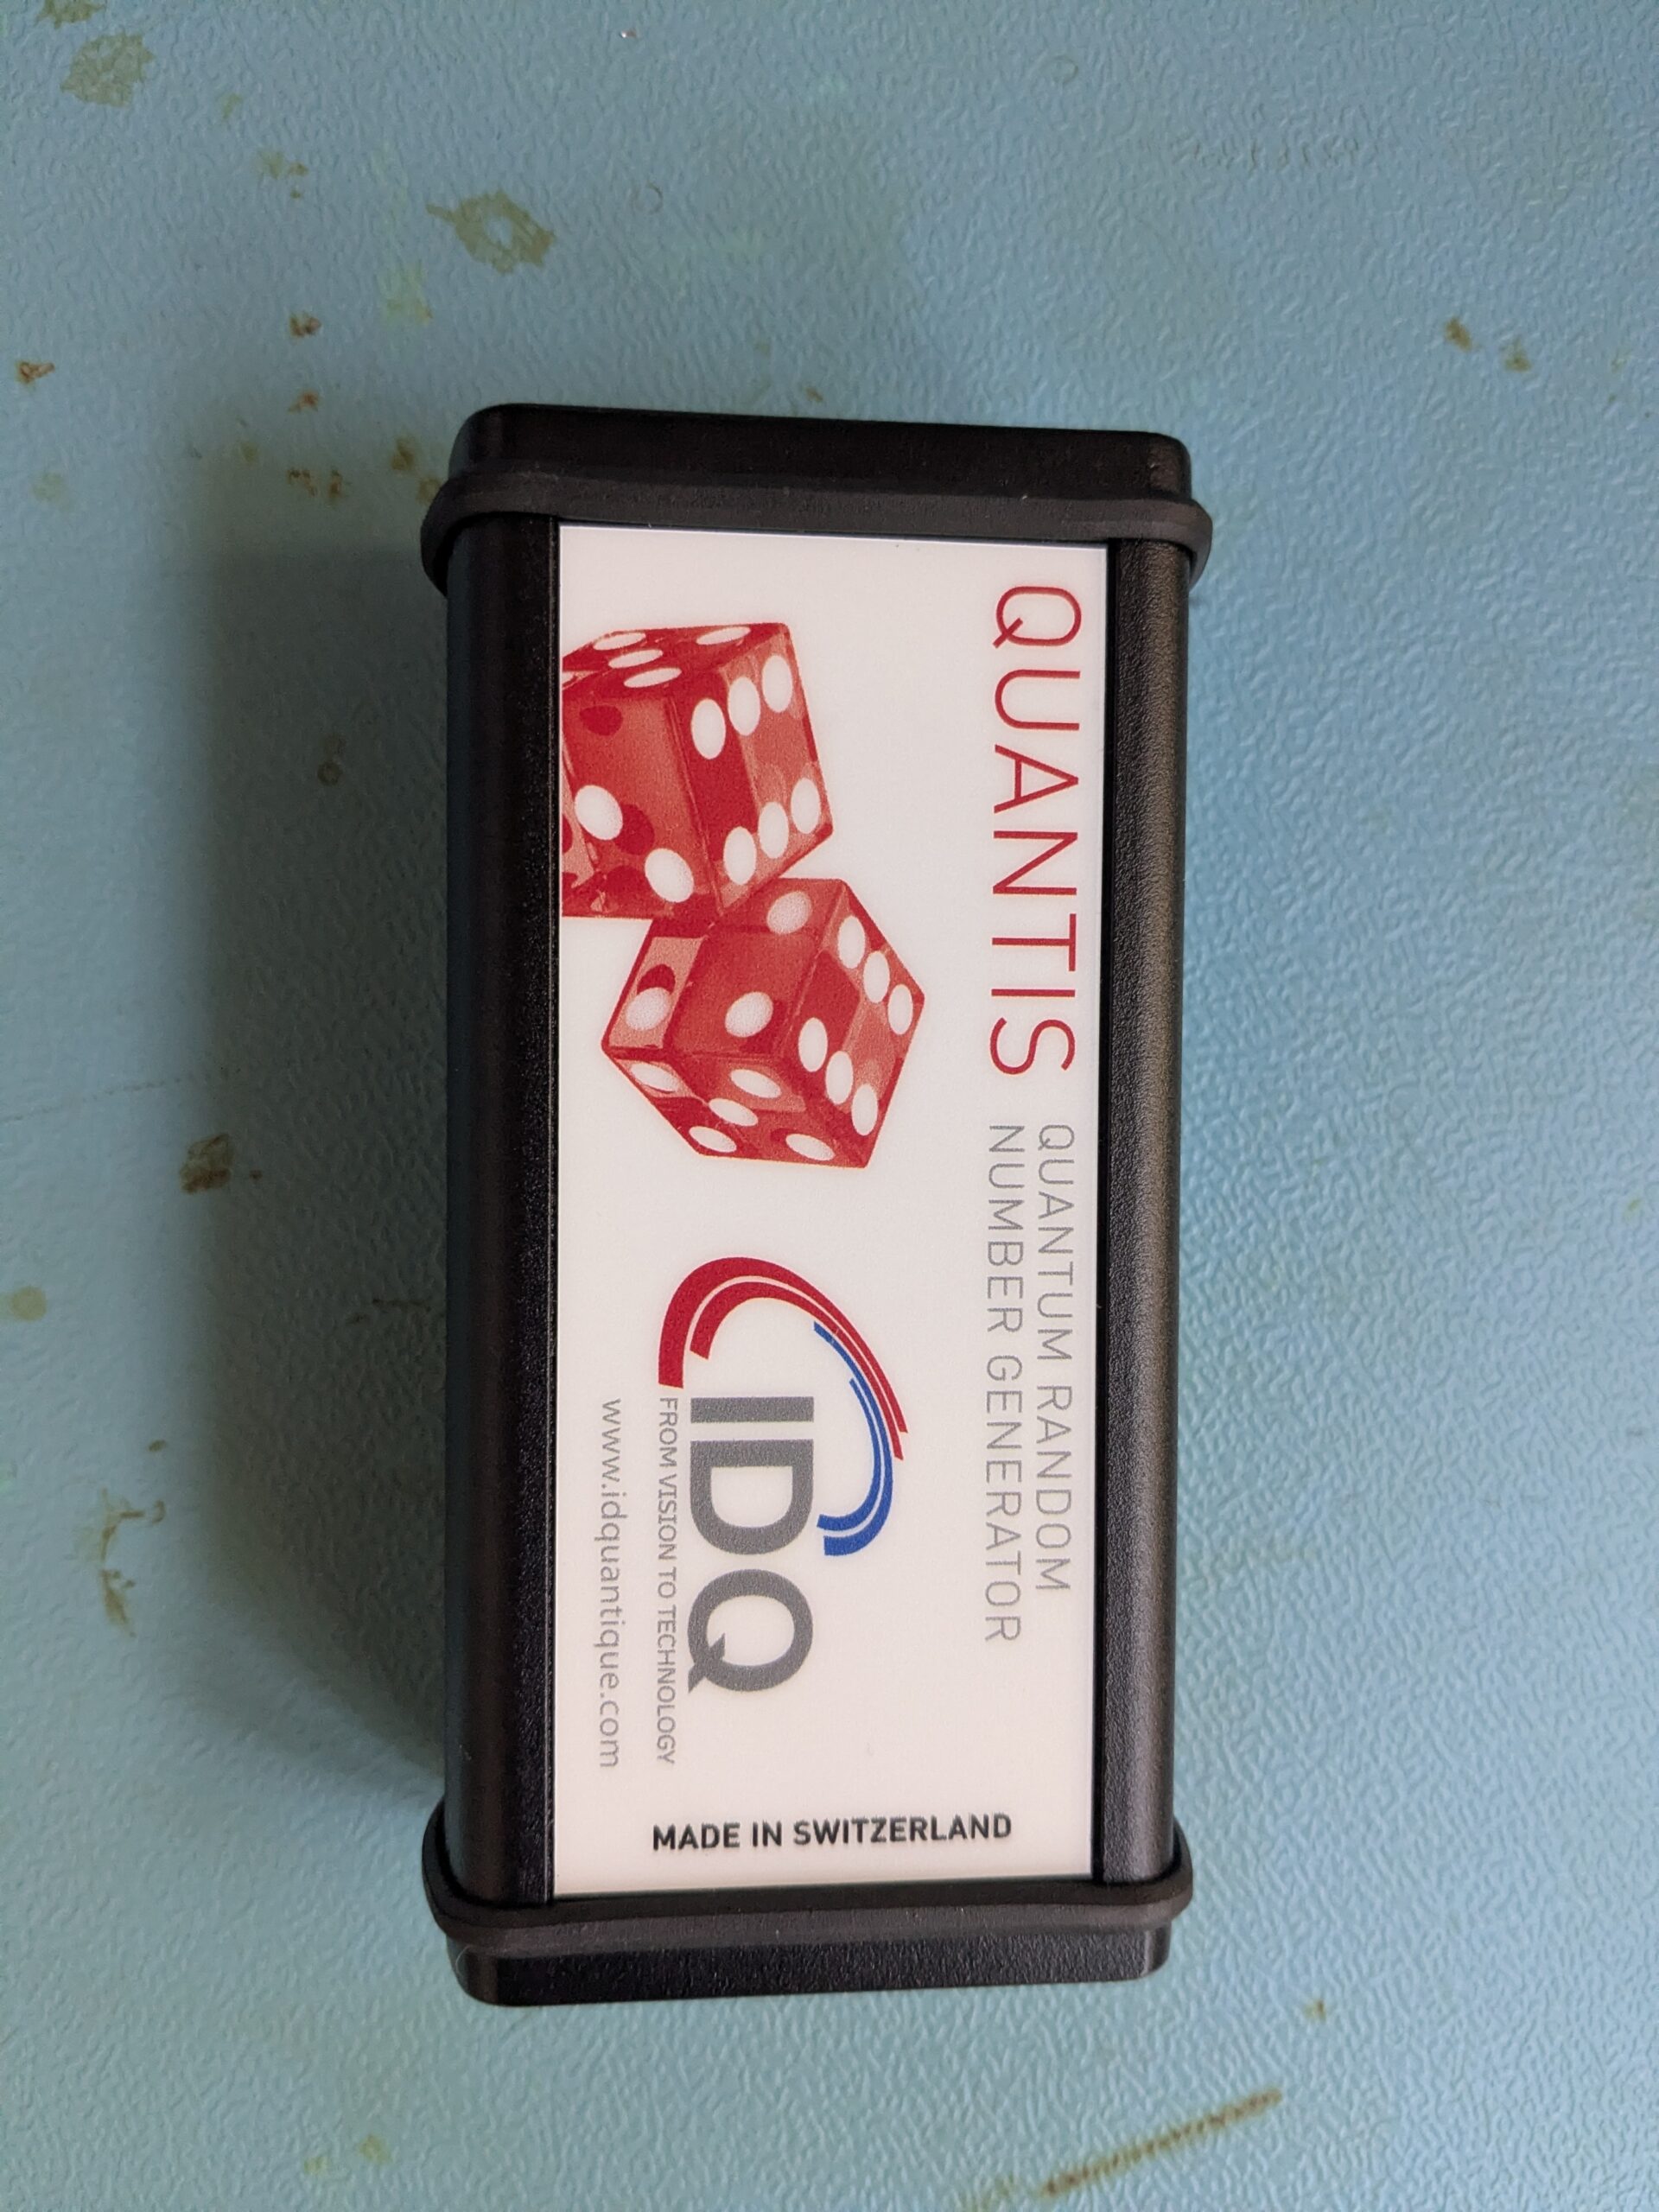
Eine alte 8-GB-microSD-Karte lag noch in der Schublade, entbehrlich genug für einen Härtetest. Die Ausgangsfrage war simpel: ist die Karte noch gut, oder produziert sie im Hintergrund längst stille Fehler? Bei einer SSD würde ich smartctl -a tippen und hätte binnen Sekunden Health-Prozent, Reallocated Sectors und Power-On-Hours auf dem Schirm. Bei einer SD-Karte geht genau das nicht, und der Grund dafür ist interessanter als die fehlende Zahl selbst.
Warum SMART hier nicht funktioniert
ATA- und NVMe-Laufwerke haben eine standardisierte SMART-Schnittstelle: fest definierte Attribute, die die Firmware selbst pflegt und die jedes Betriebssystem auf die gleiche Weise abfragen kann. SD-Karten haben nichts Vergleichbares. Der Flash-Controller auf der Karte übernimmt zwar Wear-Leveling und Bad-Block-Mapping, aber wie er das im Detail tut und was er darüber nach außen preisgibt, ist herstellerspezifisch und komplett verschlossen. Es gibt zwar eine SD Health Status Extension, CMD56-basiert, die unterstützt aber so gut wie kein Consumer-Werkzeug, und sie setzt einen nativen MMC-Host voraus, keinen USB-Kartenleser.
Ein Wort noch zu TRIM, bevor der Eindruck entsteht, SD-Karten hätten damit überhaupt nichts zu tun: der Linux-MMC-Stack unterstützt discard-artige Operationen für native mmcblk-Geräte durchaus. Nur bringt das über einen USB-Kartenleser nichts, weil die USB-Massenspeicher-Übersetzung diesen Pfad gar nicht durchreicht, das habe ich in diesem Test empirisch bestätigt. Und selbst auf einem nativen Host wäre das nur ein Erase-Hinweis an den Controller, keine standardisierte Health-Rückmeldung wie bei SSD-TRIM zusammen mit SMART.
Testkandidat und Aufbau
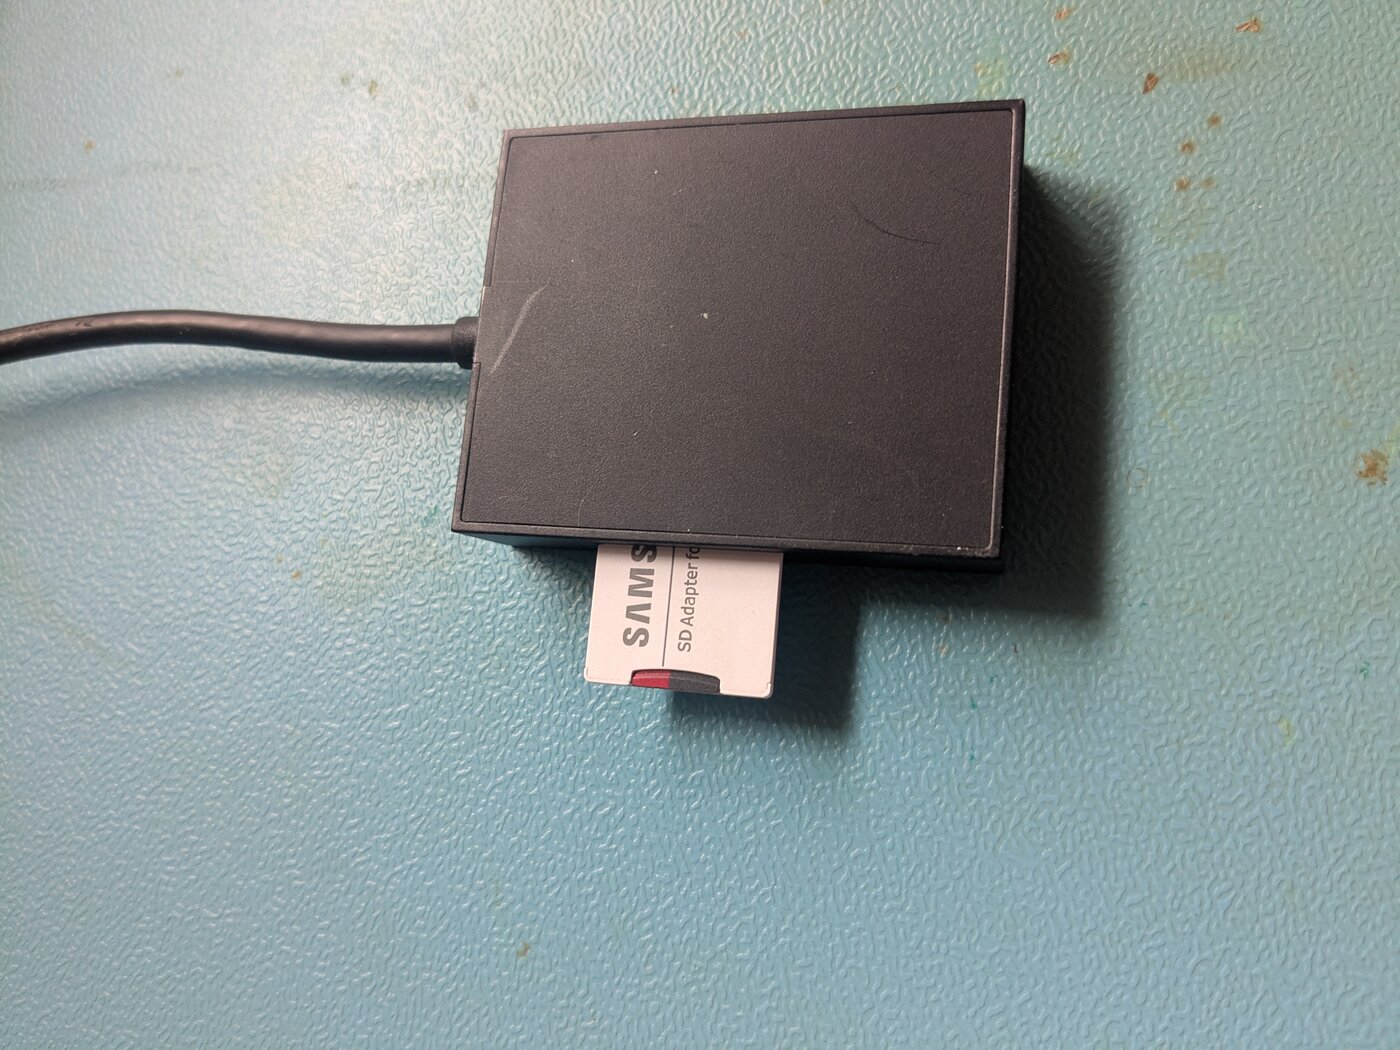
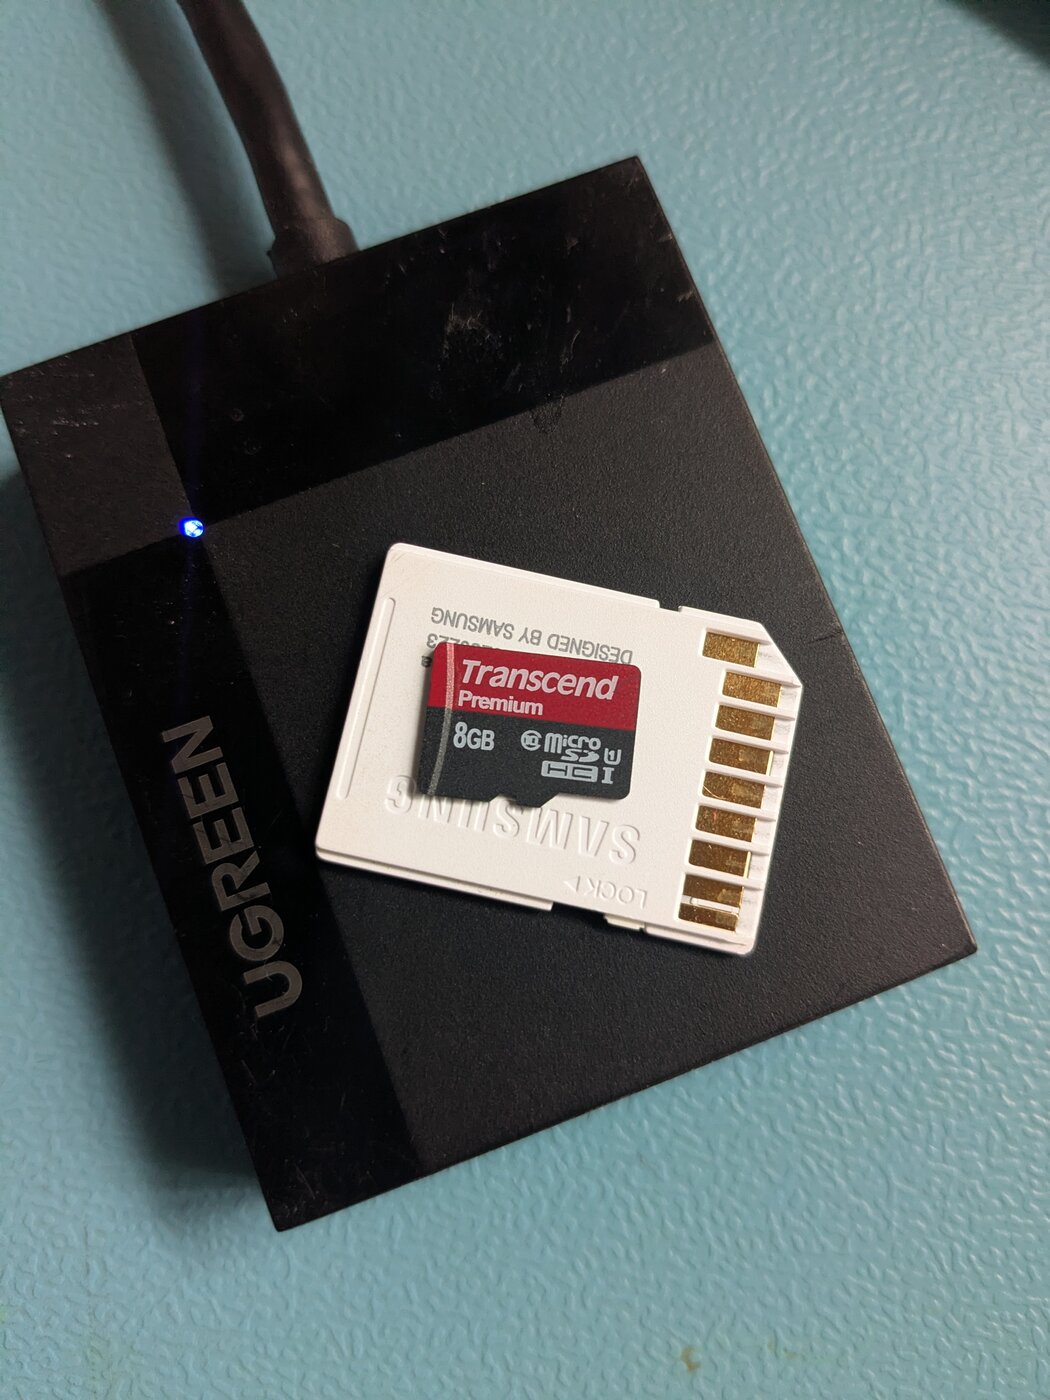
Für den Test kam eine Transcend Premium 8GB microSDHC zum Einsatz, Class 10, UHS-Speed-Class U1, in einem Samsung-Adapter auf volle SD-Größe gesteckt und über einen UGREEN-USB-Kartenleser ausgelesen. Der Leser meldet sich per USB als Genesys-Logic-Chip (05e3:0748), ein generischer Combo-Reader, wie er auch in vielen Laptops und günstigen USB-Dongles verbaut ist. Host war ein Linux Mint 22.3 mit Kernel 7.0.0-28-generic, Ubuntu-24.04-Unterbau, alle Befehle liefen als root.
So kam die Karte beim Testsystem an: microSD im Samsung-Adapter, gesteckt in den UGREEN-USB-Kartenleser.
Werkzeuge installieren
Bis auf badblocks, smartctl, hdparm und dd, die auf den meisten Systemen ohnehin vorhanden sind, kommt der Rest aus den Standard-Paketquellen, keine Drittanbieter-PPA nötig:
Installiert wurden f3 8.0, mmc-utils als Git-Snapshot von 2022, sdparm 1.12, flashbench 62 und fio 3.36, alles aus dem Ubuntu-Noble-Universe-Repository. Getestet auf Linux Mint 22.3, aber auf einem reinen Ubuntu 24.04 sollten Paketnamen und Versionen identisch sein.
Schritt 1: Identifikation, warum SMART eine Sackgasse ist
$ smartctl -a /dev/sdc
/dev/sdc: Unknown USB bridge [0x05e3:0x0748 (0x1209)]
Please specify device type with the -d option.

$ smartctl -a -d sat /dev/sdc
Read Device Identity failed: scsi error unsupported scsi opcode
A mandatory SMART command failed: exiting.

$ smartctl --scan
/dev/nvme0 -d nvme
/dev/nvme1 -d nvme
# sdc taucht gar nicht erst auf, smartd hält es für keinen unterstützten Gerätetyp

$ sdparm -a /dev/sdc
MODE SENSE(10): Malformed SCSI command
    /dev/sdc: Generic   MassStorageClass  1209

$ sdparm -i /dev/sdc
    /dev/sdc: Generic   MassStorageClass  1209
Device identification VPD page:
  Addressed logical unit:
    designator type: T10 vendor identification,  code set: ASCII
      vendor id: Generic
      vendor specific: STORAGE DEVICE
smartctl erkennt die Genesys-Logic-USB-Bridge gar nicht erst als unterstützten Gerätetyp. Erzwingt man SAT, also ATA-Kommandos über SCSI getunnelt, scheitert das vollständig, weil die Bridge-Firmware das Kommando schlicht nicht implementiert. Selbst der Geräte-Scan von smartd listet /dev/sdc gar nicht auf. sdparm kommt einen Schritt weiter, eine simple SCSI-INQUIRY funktioniert, aber die gemeldete Identität bleibt vollständig generisch: „Generic MassStorageClass“, „STORAGE DEVICE“. Weder Hersteller-ID noch Seriennummer noch irgendeine Form von Wear- oder Health-Daten sind über diesen Pfad erreichbar. Das ist der konkrete, reproduzierbare Beleg dafür, dass es für SD-Karten hinter einem USB-Leser kein SMART-Äquivalent gibt.
$ lsusb -v -d 05e3:0748
Bus 002 Device 007: ID 05e3:0748 Genesys Logic, Inc. All-in-One Cardreader
  bcdUSB               3.10
  idVendor           0x05e3 Genesys Logic, Inc.
  idProduct          0x0748 All-in-One Cardreader
  iSerial                 5 000000001209
  bInterfaceClass         8 Mass Storage
  bInterfaceSubClass      6 SCSI
  bInterfaceProtocol     80 Bulk-Only
  SuperSpeed USB Device Capability:
    wSpeedsSupported   0x000e  (Full/High/SuperSpeed, bis zu 5Gbps Link)
Der Leser meldet sich als „All-in-One Cardreader“ von Genesys Logic, ein verbreiteter generischer Combo-Chip, USB-3.1-fähig, spricht auf der SCSI-Ebene aber Bulk-Only Transport (BOT), nicht UAS. Wichtig für die Kausalität: BOT statt UAS ist für sich genommen nicht der Grund, warum SAT-Passthrough scheitert. Es gibt genug BOT-Bridges, die SAT unterstützen, und genug, die es nicht tun, unabhängig vom Transportprotokoll. Belegt ist hier nur, dass ausgerechnet diese Genesys-Bridge keine ATA- beziehungsweise SAT-Kommandos durchreicht, nicht dass USB-Bulk-Only-Bridges das grundsätzlich nicht könnten.
Der Aufdruck verrät mehr als jedes Software-Tool: Transcend Premium, 8GB, Class 10, UHS-Speed-Class U1.
Schritt 2: Durchsatz mit dd und hdparm
hdparm -t allein ergab rund 90 MB/s gepuffertes Lesen, plausibel, aber es lohnt sich, mit echtem O_DIRECT-I/O gegenzuprüfen, damit keine Bridge- oder Seiten-Cache-Effekte den Wert verfälschen.
$ hdparm -Tt /dev/sdc
 Timing cached reads:   24182 MB in  2.00 seconds = 12113.48 MB/sec
 Timing buffered disk reads: 272 MB in  3.00 seconds =  90.66 MB/sec

# 512MB Zufallsnutzlast zuerst im tmpfs erzeugt, damit die CPU-Last von
# /dev/urandom die eigentliche Messung nicht verfälscht
$ dd if=/dev/urandom of=/root/sdtest/payload.bin bs=1M count=512
536870912 Bytes (537 MB, 512 MiB) kopiert, 1,74754 s, 307 MB/s

# SCHREIBEN: Direct I/O direkt auf das Rohgerät, kein Seiten-Cache beteiligt
$ dd if=/root/sdtest/payload.bin of=/dev/sdc bs=1M count=512 oflag=direct,sync
536870912 Bytes (537 MB, 512 MiB) kopiert, 22,8654 s, 23,5 MB/s

# LESEN: erst flushen, dann Direct I/O der gleichen 512MB zurück
$ blockdev --flushbufs /dev/sdc
$ dd if=/dev/sdc of=/root/sdtest/readback.bin bs=1M count=512 iflag=direct
536870912 Bytes (537 MB, 512 MiB) kopiert, 6,28156 s, 85,5 MB/s

# Integritätscheck
$ cmp /root/sdtest/payload.bin /root/sdtest/readback.bin
MATCH: identical
Ergebnis: rund 23,5 MB/s sequenzielles Schreiben, rund 85,5 MB/s sequenzielles Lesen, mit byteidentischem Rücklese-Ergebnis. Die Asymmetrie zwischen Schreiben und Lesen ist normal und erwartbar, Schreiben braucht auf Flash-Ebene ein Erase-before-Program, Lesen nicht. 23,5 MB/s reißt die Class-10- und U1-Mindestangabe von 10 MB/s locker, für U3/V30 mit 30 MB/s Minimum würde es nicht reichen, was exakt zum aufgedruckten Rating der Karte passt: Class 10, U1, keine U3- oder V30-Kennzeichnung.
Schritt 3: f3probe, ist die Kapazität echt?
Bevor der große, langsame Test kommt, lohnt sich der schnelle: f3 (Fight Flash Fraud) bringt mit f3probe einen Kapazitätsbetrugs-Check, der binnen weniger Minuten läuft, statt die ganze Karte zu beschreiben.
$ f3probe --time-ops /dev/sdc

Probe finished, recovering blocks... Done

Good news: The device `/dev/sdc' is the real thing

Device geometry:
	         *Usable* size: 7.31 GB (15333376 blocks)
	        Announced size: 7.31 GB (15333376 blocks)
	                Module: 8.00 GB (2^33 Bytes)
	Approximate cache size: 0.00 Byte (0 blocks), need-reset=no
	   Physical block size: 512.00 Byte (2^9 Bytes)

Probe time: 1'46"
 Operation: total time / count = avg time
      Read: 29.32s / 4197116 = 6us
     Write: 1'15" / 4192321 = 18us
     Reset: 0us / 1 = 0us
Verdikt: eine echte Karte, keine Fälschung. Die angekündigte Größe, 8-GB-Modul mit 7,31 GB nutzbar, deckt sich mit der tatsächlich nutzbaren Größe, die f3probe per binärer Suche gefunden hat, also dort, wo Schreibvorgänge aufhören, korrekt anzukommen. Approximate cache size: 0.00 Byte ist ebenfalls ein gutes Zeichen: manche gefälschten Karten täuschen ihre Kapazität vor, indem sie eine kleine Menge echten Flashs als Write-Back-Cache benutzen, der Schreibvorgänge über die tatsächliche Kapazität hinaus vorübergehend „schluckt“ und damit naive Benchmarks täuscht. Diese Karte zeigt diesen Trick nicht. f3probe hat die für die Prüfung benutzten Blöcke danach wiederhergestellt, ohne -n gestartet, die Karte blieb also in ihrem vorherigen, leeren Zustand. Reine Probe-Zeit rund 1:46 Minuten, mit Block-Wiederherstellung insgesamt rund 3 Minuten, deutlich schneller als ein vollständiger Schreib-Lese-Durchlauf, weil f3probe gezielt sucht statt jeden Block anzufassen.
Verdikt: sauber. Jedes Byte jeder der 8 Testdateien, 7,08 GB insgesamt, bis auf rund 16 MB Restplatz gefüllt, kam exakt so zurück, wie es geschrieben wurde: 0 korrupte, 0 veränderte, 0 überschriebene Sektoren. Die gemessenen Geschwindigkeiten, 22,78 MB/s Schreiben und 90,32 MB/s Lesen, decken sich eng mit dem rohen dd-Direct-I/O-Benchmark aus Schritt 2, eine gute Gegenprobe, dass die Zahlen echt sind und kein Artefakt einer einzelnen Methode.
Schritt 5: badblocks, die Musterprüfung
$ umount /mnt/sdtest
$ badblocks -wsv /dev/sdc

Es wird nach defekten Blöcken gesucht (Lesen+Schreiben-Modus)
Von Block 0 bis 7666687
Es wird getestet Mit Muster 0xaa: ... 100% erledigt
Es wird getestet Mit Muster 0x55: ... 100% erledigt
Es wird getestet Mit Muster 0xff: ... 100% erledigt
Es wird getestet Mit Muster 0x00: ... 100% erledigt
Durchgang beendet, 0 defekte Blöcke gefunden. (0/0/0 Fehler)
Verdikt: 0 defekte Blöcke, über alle 4 Standard-Testmuster hinweg (0xAA/01010101, 0x55/10101010, 0xFF/lauter Einsen, 0x00/lauter Nullen, gewählt, um Stuck-at-0- und Stuck-at-1-Zellfehler ebenso wie Kopplungsfehler zwischen Nachbarbits zu erwischen). Gesamtlaufzeit für den kompletten Schreib-Lese-Vergleichs-Zyklus über alle 4 Muster: rund 26 Minuten 47 Sekunden auf dieser 7,31-GiB-Karte, was zur Schätzung von rund 27 Minuten aus den früheren Durchsatzwerten passt, 4-mal Schreibdurchlauf plus Lesedurchlauf bei rund 23,5/85 MB/s.
badblocks -w ist ein linearer, positionsbasierter Test, Teil von e2fsprogs. In einem Durchgang schreibt er dasselbe Muster auf jeden logischen Block und liest es zurück. Genau das ist der strukturelle Unterschied zu f3write/f3read, und der Grund, warum badblocks kein Ersatz für f3 bei der Kapazitätsbetrugsfrage ist: eine Karte, die Schreibvorgänge still auf einen kleineren physischen Bereich zurückführt, könnte in einem badblocks-Durchgang trotzdem das „richtige“ Muster zurückliefern, weil ohnehin jeder logische Block identischen Inhalt bekommt, das Aliasing bliebe unsichtbar. f3write vermeidet das, indem es positionsabhängige Pseudozufallsdaten schreibt, sodass Wraparound oder Aliasing als Mismatch auffällt. badblocks beantwortet dafür eine engere, ergänzende Frage: versagen bestimmte Blöcke oder Zellen dabei, irgendein Muster zuverlässig zu speichern, was der einmalige, pseudozufällige Schreibdurchgang von f3 pro Karte nicht so systematisch prüft, kein 0xAA/0x55/0xFF/0x00-Stuck-Bit-Sweep.
flashbench-f (find-fat) liest am Ende der ersten paar Erase-Blöcke zunehmend kleinere Häppchen und misst die Zeit dafür, auf der Suche nach dem Punkt, an dem die Lesegeschwindigkeit plötzlich einbricht. Die Grundidee: das deutet auf die interne Lese- beziehungsweise Page-Granularität des Flashs hin, weil das Lesen eines Teils einer internen Page oder eines Blocks genauso viel kosten kann wie das Lesen der ganzen Einheit, sub-granulare Reads verschwenden dann Bandbreite. Hier hält sich das Plateau, rund 26 bis 29 MB/s, passend zum rohen sequenziellen Lese-Benchmark, stabil bis hinunter zu 64 KiB, bricht dann bei 32 KiB auf weniger als die Hälfte ein (rund 12,6 bis 13,1 MB/s) und nochmal auf etwa ein Fünftel bei 16 KiB (rund 5,8 bis 5,9 MB/s). Ein sauberes, reproduzierbares Signal, 6 Wiederholungen pro Zeile, alle konsistent.
Die Schlussfolgerung bleibt bewusst vorsichtig formuliert: das ist ein Performance-Knick bei 64 KiB auf diesem konkreten Reader-Controller-Pfad, konsistent mit einer größeren internen Leseeinheit oder FTL-Gruppierung, aber keine direkte, verifizierte Messung der tatsächlichen physischen NAND-Page-Größe der Karte (typischerweise 8 bis 16 KiB, dafür bräuchte es Herstellerdokumentation oder eine andere Messmethode). Die Daten sind mit einer bestimmten Erklärung konsistent, sie beweisen sie nicht.
Schritt 7: fio, bleibt die Schreibrate konstant?
dd und f3write liefern Durchschnittswerte. fio mit einem Bandbreiten-Log pro Sekunde zeigt dagegen die Form des Schreibvorgangs über die vollen 6 GB, genau das will man sehen, wenn man einen Pseudo-SLC-Cache-Absturz sucht: viele Karten schreiben schnell in einen kleinen SLC-Modus-Puffer, bis der voll ist, und fallen danach auf eine deutlich niedrigere TLC- oder QLC-Dauerschreibrate ab.
Der Blick ins rohe Sekunden-Log lohnt sich, nicht nur die Zusammenfassung: 236 Einsekunden-Stichproben über den kompletten 6-GB-Schreibvorgang, alle im Bereich von 24576 bis 27675 KiB/s, also rund 24,0 bis 27,0 MB/s. Erste und letzte Stichprobe liegen im selben schmalen Band, kein erhöhter Burst am Anfang, kein Absturz später.
Verdikt: flach, kein erkennbarer SLC-Cache-Absturz auf dieser Karte. Auch hier lohnt sich die vorsichtige Formulierung: das beweist nicht, dass die Karte null Schreibpufferung hat, nur dass ein eventueller Puffer beziehungsweise Absturz innerhalb dieses 6-GB-Testfensters auf einer Karte mit nur rund 7,3 GB nutzbarer Gesamtkapazität nicht sichtbar wurde. Es könnte schlicht nicht genug Karte nach dem Puffer übrig sein, um einen Absturz zu zeigen, oder, wahrscheinlicher bei einer reinen Class-10/U1-Budgetkarte ohne A1/A2- oder „Extreme/Pro“-Einstufung, sie implementiert gar kein dynamisches SLC-Caching. So oder so steht das praktische Ergebnis: die Schreibleistung war über die gesamte Kapazität konsistent und vorhersagbar, nicht nach vorne verlagert.
Was für eMMC gilt, aber nicht für SD
Ein paar Dinge, die in diesem Testlauf nicht zum Einsatz kamen, aber der Vollständigkeit halber dazugehören. mmc extcsd read und seine Lebensdauer-Schätzfelder, das Nächste an einer echten Health-Prozentangabe in diesem Umfeld, sind eine eMMC-Eigenschaft. Eine wechselbare SD- oder microSD-Karte ist kein eMMC, dieser Pfad stand hier ohnehin nicht zur Verfügung, USB-Leser statt nativer MMC-Host. Ein nativer MMC-Host-Slot, etwa der eingebaute SD-Slot eines Laptops, würde dagegen mehr Identitätsdaten offenlegen als ein USB-Leser: /sys/block/mmcblkX/device/ mit cid, csd, scr, serial, manfid, name, oemid, preferred_erase_size und date, der Kernel parst die Identitätsregister der Karte direkt in sysfs, ganz ohne Zusatzwerkzeug. Wer also einen echten SD/MMC-Controller statt einer USB-SCSI-Bridge als Leser hat, bekommt das gratis dazu, in diesem Test war davon nichts erreichbar.
Und noch ein Missverständnis vorweg: der „SD Card Formatter“ der SD Association ist ein Formatierungs- und Reset-Werkzeug, das die werkseitige Partitionierung wiederherstellt, nachdem andere Betriebssysteme sie durcheinandergebracht haben, kein Health-Check-Werkzeug.
Die Reihenfolge, wenn du das nachmachen willst
Vom schnellsten und harmlosesten zum langsamsten und gründlichsten, ungefähr so, wie dieser Test auch abgelaufen ist:
smartctl -a -d sat und sdparm -a. Schneller, harmloser Versuch an Health- und Identitätsdaten, meist scheitert das über einen USB-Leser, und genau dieses Scheitern ist der Punkt, den man erklären sollte.
f3probe. Schneller Kapazitätsbetrugs-Check, für 8 GB etwa 2 bis 3 Minuten, minimal destruktiv, stellt die benutzten Blöcke standardmäßig wieder her.
f3write plus f3read. Der Haupttest, vollständige Schreib-Lese-Integritätsprüfung über die gesamte Kapazität, braucht ein Dateisystem.
badblocks -w. Destruktive Vier-Muster-Prüfung auf defekte Blöcke, Rohgerät, kein Dateisystem nötig. Fängt Dinge, die f3 strukturell nicht kann, siehe Schritt 5.
dd mit oflag/iflag=direct und/oder fio mit Bandbreiten-Log. Durchsatzzahlen und, mit fio, die Form der Schreibrate über die Zeit.
flashbench -f -o DATEI. Optional, für die Neugier, Hinweise auf die interne Lese-Granularität.
Fazit
Für diese konkrete Karte: gesund, echt, keine Defekte gefunden, bei jedem Test, der überhaupt in der Lage gewesen wäre, welche zu finden. Keine SMART-Werte erreichbar über den USB-Leser, echte Kapazität ohne Cache-Trickserei, null Datenkorruption über 7,08 GB, null defekte Blöcke über alle 4 Muster, rund 23 bis 27 MB/s Schreiben und rund 85 bis 90 MB/s Lesen, konsistent über vier unabhängige Messmethoden, kein SLC-Cache-Absturz über die volle Kapazität. Die Karte reißt ihre aufgedruckte Class-10/U1-Angabe locker, für U3/V30 würde es nicht reichen, was sie auch gar nicht behauptet.
Der eigentliche Punkt reicht über diese eine Karte hinaus: ohne SMART bleibt nur Verhaltenstestung statt Register-Abfrage. Schreiben, lesen, vergleichen, und der Karte dabei zusehen, statt sie nach einer Zahl zu fragen, die sie gar nicht hat.
Falls jemand einen zuverlässigeren Weg zur Health-Einschätzung einer SD-Karte unter Linux kennt, immer her damit. Und falls ihr selbst öfter mit fragwürdigen Billigkarten zu tun habt, dürft ihr mich zu dem Thema sehr gerne fragen.
Es gibt Dinge, die unter Linux in der breiten Masse vernachlässigt werden. Secure Boot ist so ein Beispiel, TPM ist ein anderes. Vielleicht ist es an der anfangs bescheidenen Unterstützung gescheitert, vieleicht sind die Themen technisch einfach unangenehm, am ehesten aber liegt es daran, dass der Mehrwert für die meisten überschaubar bleibt. Heute nehme ich mir den TPM vor.
Aufgefallen ist mir der Chip zweimal. Das erste Mal, als er durch die Medien ging, weil die Angst groß wurde, Microsoft mache damit unsere IT kaputt, und weil jemand anfing, sehr viele Patente einzureichen. Das zweite Mal viele Jahre später, als TPM 2.0 zur harten Voraussetzung für Windows 11 wurde. Dazwischen lagen zwanzig Jahre, in denen der Chip in fast jedes Endgerät gewandert ist, ohne dass sich jemand dafür interessiert hat.
In Notebooks und Fertig-PCs ist er heute meist fest verlötet. Bei Server-Mainboards kauft man ihn dagegen als Option dazu, ein kleines Steckmodul auf einem eigenen Header. Der Chip in meinem Testgerät ist ein Infineon OPTIGA SLB 9670, und genau dieselbe Chip-Familie sitzt auf den steckbaren TPM-Modulen für Supermicro-Boards. Damit schließt der Beitrag an die BIOS-Serie an, in der ich mich gerade Menü für Menü durch ein Serverboard arbeite.
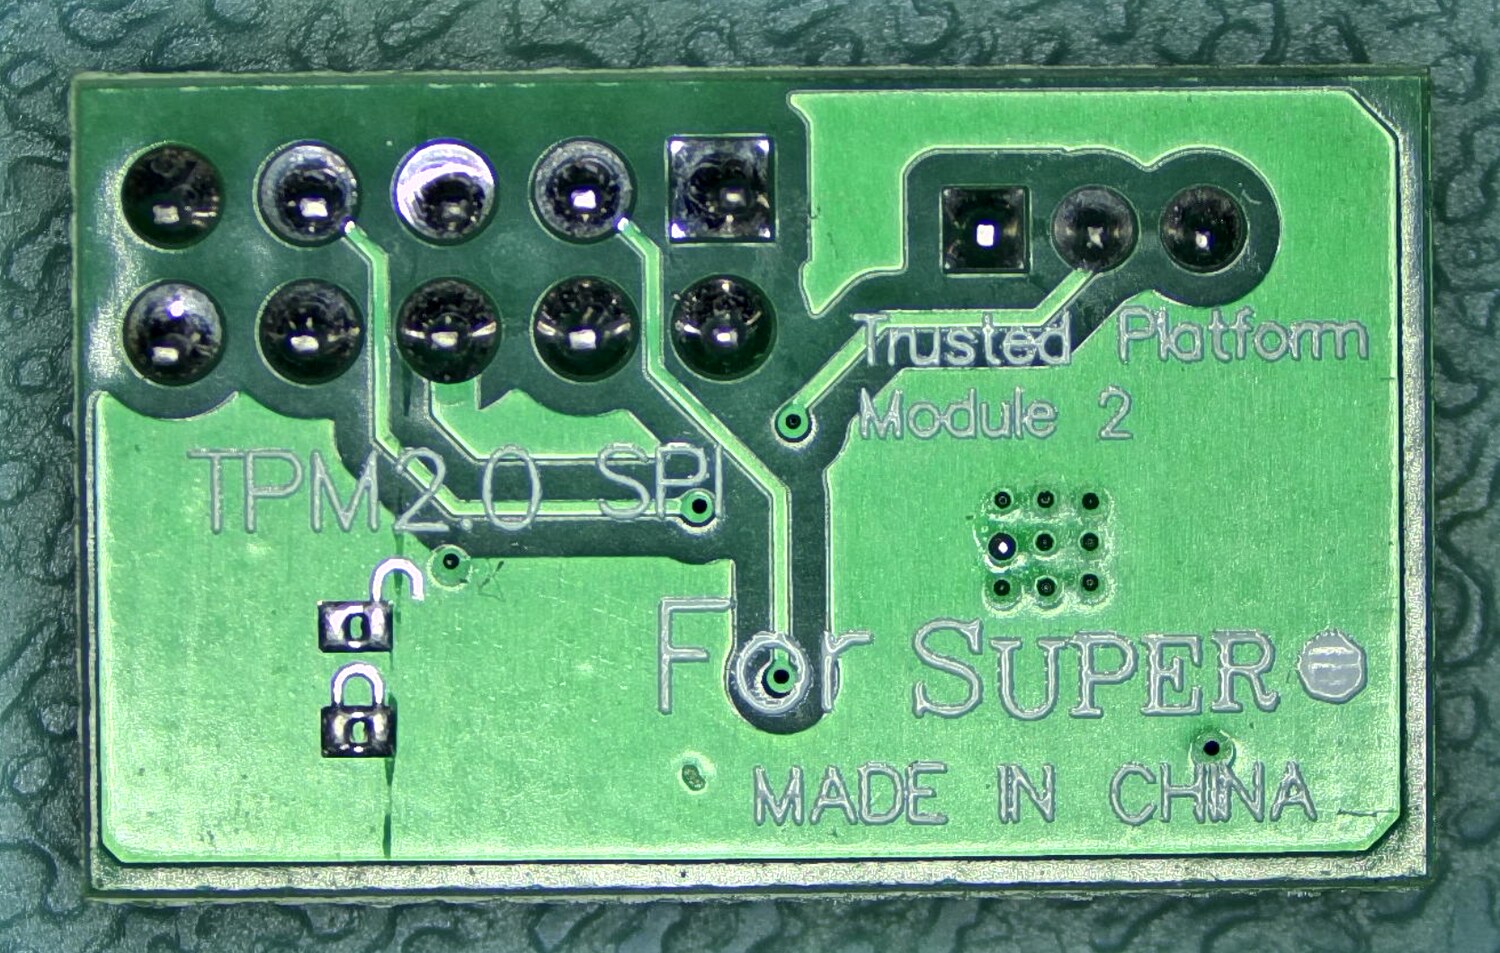
Das nachgerüstete TPM-Modul für den JTPM1-Header, hier freigestellt. Auf der Rückseite steckt ein echter Infineon SLB9670. Bei vielen Server-Boards gehört der Chip nicht zum Lieferumfang.
Erst die Geschichte, dann die Hände in den Chip. Alle Ausgaben hier sind echt und stammen vom 10. August 2026, gemessen auf einem Fujitsu Celsius H780 mit Linux Mint 22.3, Kernel 7.0.0-28-generic und tpm2-tools 5.6. Wo ich etwas nur aus Dokumentation kenne oder wo ich vermute, steht das dabei.
Angefangen hat alles mit einer Seriennummer in der CPU
Mitte der neunziger Jahre wollte Intel eine Identifizierungsfunktion direkt in den Prozessor bringen. Der erste Schritt war 1999 die Prozessor-Seriennummer im Pentium III, eine eindeutige Kennung, die jede Software auslesen konnte. Der öffentliche Widerstand war so heftig, dass Intel zurückzog. Das Vorhaben verschwand aber nicht, es suchte Deckung in einem Konsortium. Dieses Detail ist wichtig, weil es das Muster für alles setzt, was danach kam.
1999 gründeten Compaq, HP, IBM, Intel und Microsoft die Trusted Computing Platform Alliance, kurz TCPA. Im April 2003 wurde daraus die Trusted Computing Group, TCG, getragen von AMD, HP, IBM, Intel und Microsoft. Aus einer Firmenidee war ein Industriestandard geworden.
Der Chip, der nach einem Senator benannt wurde
In der Debatte bekam der TPM den Spottnamen „Fritz-Chip“. Der Name ging auf den US-Senator Fritz Hollings aus South Carolina zurück, der den CBDTPA vorantrieb, ein Gesetzesvorhaben, das Kopierschutz in aller Consumer-Elektronik verpflichtend machen sollte. Der Spottname war also ein politischer Vorwurf und keine technische Bezeichnung. Er hat trotzdem länger gehalten als das Gesetz, aus dem er kam.
Vertrauen, aber nicht dein Vertrauen
Ross Anderson von der Universität Cambridge schrieb 2002 und 2003 die Trusted Computing FAQ. Dieses Dokument hat die Debatte stärker geprägt als jede Herstellerankündigung, und es liegt bis heute unverändert online. Sein Kernargument in einem Satz: bei „Trust“ geht es nicht darum, dass der Nutzer dem Rechner vertraut, sondern darum, dass der Rechner dem Nutzer nicht vertraut.
Richard Stallman legte 2002 mit „Can you trust your computer?“ nach und prägte den Gegenbegriff treacherous computing, verräterisches Rechnen. Die FSF benutzt ihn heute noch. IBM antwortete mit einer Gegendarstellung von David Safford, „Clarifying Misinformation on TCPA“.
Die EFF ging einen dritten Weg, und der ist der interessanteste. Seth Schoen veröffentlichte im Oktober 2003 Trusted Computing: Promise and Risk und schlug ein konkretes Feature vor, den Owner Override. Der Eigentümer des Rechners sollte die Attestierung überstimmen können, seinem Bank-Server also erzählen dürfen, sein Opera sei ein Internet Explorer. Die Kritik hatte damit einen Reparaturvorschlag und war nicht bloß dagegen. Die TCG hat den Owner Override nie übernommen.
Microsoft nannte sein eigenes Vorhaben Palladium und benannte es am 24. Januar 2003 in Next-Generation Secure Computing Base um, NGSCB. Der Name wurde harmloser, die Architektur blieb dieselbe.
Zwei Patente von 2001, und ein Cypherpunk der zurückschoss
Im Dezember 2001 wurden Microsoft zwei Patente erteilt. Das eine ist US 6,330,670, „Digital rights management operating system“, angemeldet im Januar 1999, erteilt am 11. Dezember 2001, als Erfinder Paul England, John DeTreville und Butler Lampson. Das andere ist US 6,327,652, „Loading and identifying a digital rights management operating system“. Zusammen decken sie viele Grundelemente eines vertrauenswürdigen Betriebssystems ab.
Die Sorge dahinter war handfest und nicht abwegig. Wenn Palladium unter dieses Patent fällt, dann verletzt jeder unabhängige Nachbau das Patent. Also jeder einzelne Entwickler, jedes Open-Source-Projekt, jeder Wettbewerber. Ohne Lizenz von Microsoft kein freies Trusted Computing. Kritiker beschrieben das damals als Kombination aus Patentschutz und faktischem Zwang zur Nutzung, mit deutlich wettbewerbsrechtlichem Geschmack.
Der Gegenzug kam im August 2002 von einem Cypherpunk, der unter dem Namen Lucky Green auftrat. Er meldete selbst ein Patent an, und zwar auf Verfahren, mit denen Software auf einer Palladium- oder TCPA-Plattform gegen Kopieren geschützt werden kann. Der Zweck war offen defensiv: wer die Ansprüche hält, kann verhindern, dass genau diese Anwendungen ausgerollt werden. Auf einem Panel der USENIX Security wurde er gefragt, ob Microsoft nicht einfach Prior Art geltend machen könne. Sein Argument: Prior Art müsste unter Eid erklärt werden, und nach Jahren Arbeit am Projekt und einem ausführlichen eigenen DRM-Patent sei kaum vorstellbar, dem Palladium-Team wäre relevante Prior Art entgangen. Im September 2002 hielt er zusätzlich einen Vortrag mit dem Titel „TCPA: the mother(board) of all Big Brothers“.
Was daraus geworden ist
Die Auflösung ist unbequemer, als es beide Lager damals gedacht haben. NGSCB ist gescheitert, aber nicht an den Patenten. Im Mai 2004 stellte Microsoft die vollständige Architektur zurück, und die Begründung war wirtschaftlich: die Hardware-Landschaft war nicht reif, und vor allem waren die unabhängigen Softwarehersteller nicht bereit, ihre Anwendungen auf die nötigen neuen APIs umzuschreiben. Curtained Memory und der Nexus-Kernel fielen weg, die TPM-Unterstützung blieb übrig.
Der Chip selbst wurde offen. Nach TPM 1.2 kam TPM 2.0, veröffentlicht 2014 und als ISO/IEC 11889 internationaler Standard. Die TCG stellt die Referenz-Implementierung unter eine royalty-free Copyright-Lizenz, das Patentregime zwischen den Mitgliedern ist RAND. Damit war der Nachbau möglich und dem Patenthebel die Grundlage entzogen.
Linux hat es dann einfach implementiert. Der Treiber tpm_tis sitzt im Kernel, IBM brachte TrouSerS für TPM 1.2, für TPM 2.0 entstand mit Beteiligung von Intel und TCG der tpm2-tss-Stack samt tpm2-tools. Seit Linux 4.12 gibt es den Resource Manager im Kernel unter /dev/tpmrm0, wodurch der frühere Userspace-Daemon tpm2-abrmd für die meisten Fälle überflüssig wurde. Nichts davon brauchte eine Lizenz von Microsoft.
Die befürchtete Abriegelung kam trotzdem, nur von woanders. Kein einziger der Horror-Fälle aus der TCPA-FAQ wurde durch den TPM Realität. Wo Nutzer heute tatsächlich ausgesperrt werden, steckt eine andere Technik dahinter: Widevine beim Streaming, Play Integrity und früher SafetyNet bei Android, verriegelte Bootloader bei Telefonen, die Secure Enclave bei Apple, Attestierung bei Spielkonsolen. Der TPM wurde stattdessen ein langweiliger Schlüsselspeicher.
Ein Teil der Angst hat sich dann doch erfüllt, nur in anderer Form. Windows 11 macht TPM 2.0 zur harten Voraussetzung, und damit gilt funktionierende Hardware plötzlich als nicht unterstützt. Das ist keine DRM-Geschichte, sondern eine Elektroschrott- und Lebensdauer-Geschichte. Der Mechanismus ist aber derselbe: eine Hardware-Eigenschaft entscheidet, was auf dem Gerät laufen darf.
Und dann kam der Kreis zurück. 2023 schlugen Chrome-Entwickler bei Google die Web Environment Integrity API vor. Der Browser sollte sich von einer Vertrauensinstanz einen Nachweis über seine Umgebung ausstellen lassen, den Webseiten dann prüfen können. Das ist praktisch Wort für Wort das Szenario, vor dem Anderson zwanzig Jahre früher gewarnt hatte, nur ohne TPM. Nach massivem Widerstand zog Google den Vorschlag im November 2023 für Chromium auf dem Desktop zurück.
Hat die Patentanmeldung von damals also geholfen?
Das ist die Frage, mit der ich in die Recherche gegangen bin, und die Antwort ist zweiteilig. Die defensive Patentanmeldung hat, soweit öffentlich nachvollziehbar, nichts bewirkt. Es gibt kein erteiltes Patent, das man heute als den Grund benennen könnte, warum TCPA-DRM nicht kam. Der Gegenzug war eine wirksame Geste, aber kein wirksames Rechtsmittel. Gewirkt hat etwas anderes: erstens die Wirtschaftlichkeit, weil die Softwarehersteller nicht umschreiben wollten und es damit kein Produkt gab, zweitens die Öffnung der Spezifikation und die ISO-Standardisierung, die den Nachbau erlaubten.
Der zweite Teil verdient Anerkennung. Die Kampagne selbst hat gewirkt, nur nicht juristisch, sondern politisch. Der Lärm um TCPA hat plausibel dazu beigetragen, dass die TCG die Spezifikation öffnete, die aggressivsten Ideen fallen ließ und dass Fernattestierung zwanzig Jahre lang aus dem Consumer-Web draußen blieb. Als der Versuch 2023 mit Web Environment Integrity wiederkam, war das Muster des Widerstands eingeübt und der Vorschlag nach Monaten weg. Wichtig dabei: das ist meine Deutung. Die Kausalkette von der Kampagne 2002 zur offenen Spezifikation 2014 ist nirgends dokumentiert, das ist ein Plausibilitätsargument und keine Messung.
Bleibt der Eindruck: die Angst war berechtigt und falsch adressiert. Berechtigt, weil die Mechanik der Fernattestierung tatsächlich genau das kann, was befürchtet wurde. Falsch adressiert, weil der TPM davon der harmloseste Teil war und am Ende zu dem wurde, was jetzt kommt. Ein langsamer, sturer kleiner Chip, der Schlüssel nicht herausgibt.
Erst suchen, ganz ohne TPM-Werkzeug
Bevor ihr irgendetwas installiert: der Kernel weiß längst, ob da ein Chip sitzt. Er sagt es beim Start.
Drei Dinge stehen da drin. In der ersten Zeile übergibt UEFI die Adresse des Event-Logs, TPMEventLog=0x798c0018, also der Liste aller Messungen aus dem Startvorgang. Dann die ACPI-Tabelle TPM2, über die die Firmware mitteilt, wo und wie der Chip ansprechbar ist. Und in der letzten Zeile das Ergebnis: der Treiber tpm_tis hat unter der ACPI-Kennung MSFT0101 ein TPM der Version 2.0 gefunden.
Danach existieren zwei Gerätedateien, und der Unterschied zwischen ihnen ist wichtig.
# ls -la /dev/tpm*
crw-rw---- 1 tss root  10,   224 Aug 10 09:31 /dev/tpm0
crw-rw---- 1 tss tss  252, 65536 Aug 10 09:31 /dev/tpmrm0
/dev/tpm0 ist der rohe Zugang zum Chip. Daran kann genau ein Prozess gleichzeitig arbeiten, und wer die Ressourcen im Chip verwaltet, ist selbst dafür verantwortlich. /dev/tpmrm0 geht über den Resource Manager im Kernel, der das Ein- und Auslagern der Schlüssel-Kontexte übernimmt und mehrere Nutzer nebeneinander erlaubt. In der Praxis nimmt man immer /dev/tpmrm0, und die tpm2-tools tun das von sich aus.
Die Version steht ebenfalls im sysfs, und die solltet ihr prüfen, bevor ihr weiterlest.
# ls /sys/class/tpm/tpm0/
dev  device  pcr-sha1  pcr-sha256  power  ppi  subsystem  tpm_version_major  uevent

# cat /sys/class/tpm/tpm0/tpm_version_major
2
Eine 2 heißt TPM 2.0 und alles in diesem Beitrag gilt. Eine 1 heißt TPM 1.2, und dann gilt fast nichts davon, weil es ein anderer Standard mit einem anderen Software-Stack ist. Nebenbei verrät das Verzeichnis noch etwas: es gibt eine pcr-sha1– und eine pcr-sha256-Bank, der Chip führt die Messregister also in zwei Hash-Verfahren parallel.
Und weil der Kernel das ohnehin bereitstellt, kommt hier der erste kleine Aha-Moment, noch ganz ohne installiertes Paket. Die Messwerte des Startvorgangs liegen als Dateien herum.
Das sind drei der Platform Configuration Register, kurz PCR. Merkt euch den Wert von PCR 7, der taucht später mehrfach auf.
Die Falle mit lsmod
Das ist eine häufige Fehldiagnose, deshalb steht sie hier als eigener Punkt. Auf meinem Testsystem liefert lsmod | grep tpm nämlich schlicht nichts. Kein Modul, keine Ausgabe. Der Chip arbeitet trotzdem einwandfrei, weil tpm_tis in diesen Kernel fest eingebaut ist und deshalb in der Modulliste gar nicht erscheinen kann. Wer nach lsmod urteilt, hält ein funktionierendes TPM für abwesend. Fragt stattdessen nach der Treiberbindung.
# ls -l /sys/class/tpm/tpm0/device/driver
lrwxrwxrwx 1 root root 0 Aug 10 09:31 /sys/class/tpm/tpm0/device/driver -> ../../../bus/platform/drivers/tpm_tis

# cat /sys/class/tpm/tpm0/device/modalias
acpi:MSFT0101:MSFT0101:
Der Symlink zeigt, welcher Treiber das Gerät tatsächlich bedient. Das ist die Antwort auf die Frage, die lsmod nicht beantworten kann.
Wenn nichts auftaucht
Bleibt dmesg stumm und existiert kein /dev/tpm0, dann gibt es drei realistische Ursachen, in dieser Reihenfolge.
Im Firmware-Setup abgeschaltet. Die Option heißt je nach Hersteller „Security Device Support“, „TPM State“, „Trusted Computing“, „PTT“ oder „fTPM“. Wo diese Menüs bei einem Serverboard liegen und wie man sich dort zurechtfindet, habe ich in der BIOS-Serie ausführlich aufgeschrieben.
Physisch nicht vorhanden. Bei Server-Boards ist der TPM oft ein steckbares Modul auf einem eigenen Header, bei Supermicro etwa die AOM-TPM-Module auf dem Anschluss JTPM1. Wer ihn nicht mitbestellt hat, hat einen leeren Steckplatz. Bei Notebooks ist der Chip dagegen fast immer verlötet.
Vorhanden, aber als fTPM in der CPU statt als eigener Chip. Woran man das unterscheidet, steht weiter unten, und man liest es an einer einzigen Zeile ab.
Zwei Details aus dem Firmware-Setup, die hier gut passen. Erstens sind SHA-1-Bank und SHA-256-Bank oft getrennt schaltbar. Dass mein Testgerät beide Banks führt, ist also keine Selbstverständlichkeit, sondern eine Einstellung. Zweitens steht in demselben Menü meist ein TPM Clear. Finger weg, solange ihr nicht genau wisst, was daran hängt. Ein Clear wirft die Hierarchien im Chip weg, und damit ist alles, was gegen diesen Chip versiegelt war, unwiederbringlich verloren. Auch der BitLocker-Schlüssel eines parallel installierten Windows.
Die Schichten, bevor das erste Paket installiert wird
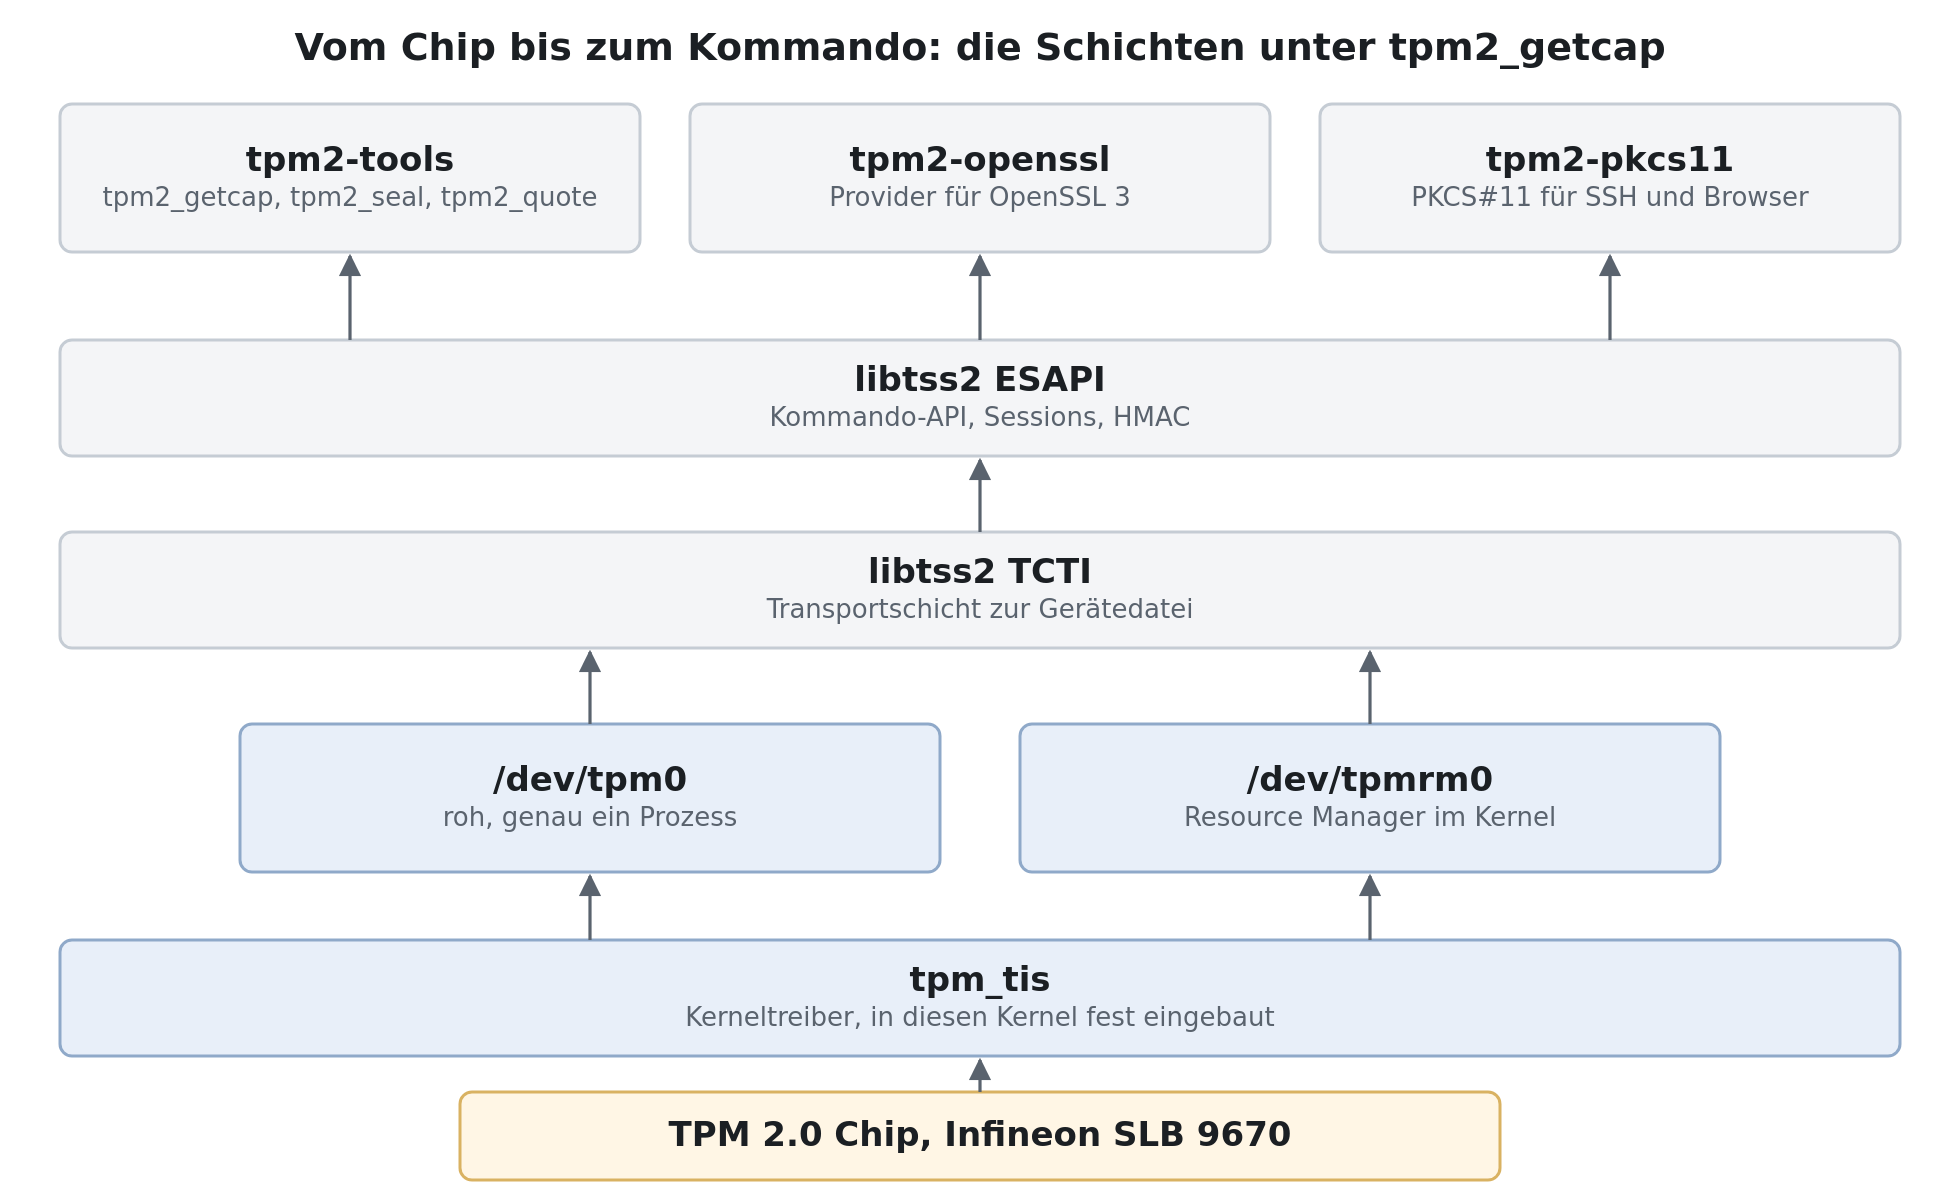
Es hilft, den Stack einmal von unten nach oben gesehen zu haben. Sonst installiert man ein Paket und wundert sich später, welche der vielen Bibliotheken wofür zuständig ist.
Der Weg eines Kommandos vom Werkzeug bis in den Chip. Über /dev/tpm0 arbeitet genau ein Prozess, über /dev/tpmrm0 mehrere.
Ganz unten der Chip, darüber der Kerneltreiber, darüber die beiden Gerätedateien. Erst dann kommt Userspace: die TCTI-Schicht kümmert sich um den Transport zur Gerätedatei, die ESAPI-Schicht um Kommandos, Sessions und HMAC-Absicherung. Ganz oben die drei Werkzeuge, die man tatsächlich in die Hand nimmt. Für die Pflichtausstattung reichen zwei Pakete.
Paket
Wofür
tpm2-tools
die tpm2_*-Kommandozeile, alles in diesem Beitrag läuft darüber
libtss2-*
der TSS2-Stack darunter, meist schon über systemd installiert
Dazu zwei optionale, die ich beide benutze, weil sie den Chip an Software anschließen, die von TPM nichts wissen muss.
Paket
Wofür
tpm2-openssl
Provider für OpenSSL 3, Schlüssel im Chip über die gewohnten openssl-Aufrufe
libtpm2-pkcs11-1 und libtpm2-pkcs11-tools
PKCS#11-Schnittstelle, damit SSH und Browser den Chip nutzen können
Und zwei, die ich ausdrücklich nicht installiere.
Paket
Warum nicht
tpm2-abrmd
Resource Manager im Userspace mit D-Bus-Schnittstelle. Seit Linux 4.12 macht der Kernel das über /dev/tpmrm0 selbst. Das Projekt ist nicht tot, es wird weiter gepflegt und ist für Simulatoren, Tests und manche Integrationen nach wie vor sinnvoll. Beides parallel zu betreiben führt aber zu Konflikten, deshalb hier bewusst nur der Kernel-Weg.
clevis, clevis-tpm2
binden ausschließlich LUKS2-Header. Ohne LUKS nutzlos, und auf diesem Gerät gibt es kein LUKS.
Auf meinem Mint 22.3 sind damit tpm2-tools 5.6, tpm2-openssl 1.2.0 und tpm2-pkcs11 1.9.0 gelandet. Der TSS2-Stack war schon da, den bringt systemd mit. Auf Fedora und RHEL heißt das Hauptpaket ebenfalls tpm2-tools, dazu tpm2-tss, unter Arch genauso tpm2-tools mit tpm2-tss als Abhängigkeit.
Eine Kleinigkeit, über die jeder beim ersten Mal stolpert: /dev/tpmrm0 gehört tss:tss. Entweder arbeitet ihr mit sudo, oder ihr nehmt euren Benutzer in die Gruppe tss auf. Die Rechte in der Ausgabe von ls -la /dev/tpm* weiter oben sagen genau das, crw-rw---- und keine Rechte für alle anderen.
Spricht der Chip?
Es gibt drei Stufen, aufsteigend im Aussagewert. Die erste ist der Lebenstest.
# tpm2_getrandom --hex 16
Kommen 16 Bytes zurück, dann funktioniert die ganze Kette von der Bibliothek über die Gerätedatei bis in die Hardware. Der Zufall kommt dabei wirklich aus dem Chip, und er ist gemächlich, dazu unten die Zahlen. Stufe zwei ist tpm2_getcap properties-fixed, da sagt der Chip, wer er ist. Stufe drei ist tpm2_getcap properties-variable, da sagt er, in welchem Zustand er ist. Beide sind gleich interessant, nur aus unterschiedlichen Gründen.
Rohe Hex-Werte, die plötzlich Sinn ergeben, wenn man sie einmal übersetzt. Das ist einer meiner Lieblingsmomente an dem ganzen Thema.
TPM2_PT_MANUFACTURER: 0x49465800 ist ASCII IFX, also Infineon.
VENDOR_STRING_1 und _2 ergeben zusammengesetzt SLB9 und 670, also ein Infineon OPTIGA SLB 9670.
TPM2_PT_REVISION: 0x74 ist Spezifikations-Revision 1.16, datiert auf Tag 265 des Jahres 2016.
FIRMWARE_VERSION_1: 0x7003F ist Firmware 7.63.
TPM2_PT_PCR_COUNT: 0x18 sind 24 PCRs.
TPM2_PT_HR_PERSISTENT_MIN: 0x7 heißt, dass nur sieben persistente Schlüsselplätze garantiert sind. Diese Zahl wird später richtig wichtig.
TPM2_PT_NV_COUNTERS_MAX: 0x8 sind genau acht monotone Zähler.
Und dann TPM2_PT_NV_INDEX_MAX: 0x680, also 1664. Hier lauert eine Fehldeutung, die in vielen Texten steht: das ist nicht der gesamte NV-Speicher des Chips, sondern die maximale Größe eines einzelnen NV-Index-Datenbereichs. Wie viel NV insgesamt frei ist, sagt diese Eigenschaft überhaupt nicht. Das steht im Datenblatt des Herstellers und liegt bei diesem Chip im Bereich einiger Kilobyte. Ich habe es nicht ermittelt, also behaupte ich hier auch keine Gesamtgröße.
Diskreter Chip oder fTPM in der CPU
Diese Unterscheidung ist keine Nebensächlichkeit, und man liest sie direkt am Hersteller-String ab.
Hersteller-String
Was es ist
IFX, NTC, STM, IBM
diskreter Chip auf dem Board oder auf einem Steckmodul
INTC
Intel Platform Trust Technology, läuft in der Management Engine
AMD
AMD fTPM, läuft im Platform Security Processor
Ein diskreter Chip hängt an einem physischen Bus, den man anzapfen kann. Ein fTPM hat diesen Bus nicht, dafür hat er andere Probleme. Beides kommt im Angriffs-Abschnitt zurück.
Für mein Testsystem ist die Sache klar: IFX, also ein diskreter Infineon SLB 9670. Aus Linux-Sicht hängt er als memory-mapped TIS an der ACPI-Kennung MSFT0101 und wird von tpm_tis bedient. Ob die physische Leitung dahinter LPC oder SPI ist, lässt sich aus dem Betriebssystem allein nicht entscheiden, weil der PCH einen SPI-TPM auch als MMIO-TIS durchreichen kann. Das ist also plausibel, aber nicht gemessen. Die einzige echte Antwort wäre ein Foto vom offenen Gerät, und dafür müsste das Notebook auseinander.
32 Fehlversuche, und deshalb reicht eine kurze PIN
Jetzt der Zustand, und das ist der wichtigste einzelne Abschnitt des ganzen Beitrags, weil er später alles trägt.
Diese drei Werte werden fast immer verwechselt, also einmal sauber.
MAX_AUTH_FAIL: 0x20 sind 32 fehlgeschlagene Authentifizierungsversuche, danach sperrt der Chip.
LOCKOUT_INTERVAL: 0x1C20 sind 7200 Sekunden, also 2 Stunden. Nach dieser Zeit wird der Fehlerzähler um genau eins verringert.
LOCKOUT_RECOVERY: 0x15180 sind 86400 Sekunden, also 24 Stunden. Das ist aber nicht die Erholung des normalen Zählers, sondern die Wartezeit, bevor nach einem fehlgeschlagenen Versuch mit lockoutAuth erneut mit lockoutAuth gearbeitet werden darf.
Einmal vorgerechnet, weil die Zahlen so viel deutlicher sind: ein einzelner Fehlversuch altert nach 2 Stunden aus. Von 32 verbrauchten Versuchen zurück auf null dauert also 64 Stunden und nicht 24.
Und das ist der eigentliche Mehrwert des ganzen Bauteils. Der Chip zählt Fehlversuche und sperrt. Deshalb reicht bei einem TPM eine sechsstellige PIN, wo ein Passwort-Hash auf der Platte eine Passphrase mit hoher Entropie bräuchte. Wer die Platte hat, probiert Millionen Passphrasen pro Sekunde durch. Wer vor dem TPM sitzt, bekommt 32 Versuche und darf dann zwei Stunden warten, um einen einzigen zurückzubekommen. Die Stärke kommt nicht aus dem Geheimnis, sie kommt aus der Hardware, die das Raten unterbindet. Fast jeder Text über TPM lässt diesen Punkt weg, und dann klingt die kurze PIN nach Leichtsinn.
Das Geburtszertifikat des Chips
Jetzt kommt der Teil, den ich in keinem der üblichen TPM-Howtos gesehen habe. In dem Chip liegt ab Werk ein Zertifikat, ausgestellt vom Hersteller auf den Endorsement Key. Erst die Liste der belegten NV-Indizes, dann das Zertifikat selbst.
0x1C00002 ist der TCG-Standardindex für das RSA-EK-Zertifikat, 0x1C0000A derselbe für ECC. 1184 Bytes, das passt zu einem X.509-Zertifikat. Also raus damit und mit gewohnten Werkzeugen anschauen.
# tpm2_nvread 0x1C00002 -o ek_rsa.der
WARN: Reading full size of the NV index

# openssl x509 -inform der -in ek_rsa.der -noout -subject -issuer -dates
subject=
issuer=C = DE, O = Infineon Technologies AG, OU = OPTIGA(TM) TPM2.0, CN = Infineon OPTIGA(TM) RSA Manufacturing CA 035
notBefore=Aug 21 14:09:40 2019 GMT
notAfter=Aug 21 14:09:40 2034 GMT
Zwei Dinge fallen sofort auf. Der Aussteller ist eine echte Hersteller-CA, „Infineon OPTIGA(TM) RSA Manufacturing CA 035“, und Infineon hat diesen Chip am 21. August 2019 signiert. Und der Subject ist leer. Ein TPM hat keinen Namen. Die Identität steckt woanders, nämlich in den Erweiterungen.
Der Subject Alternative Name trägt drei TCG-OIDs, und die decken sich exakt mit dem, was der Chip vorher selbst über sich gesagt hat. 2.23.133.2.1 ist der Hersteller, id:49465800, also wieder IFX. 2.23.133.2.2 ist das Modell, SLB 9670 TPM2.0. 2.23.133.2.3 ist die Firmware, id:073f, was genau die 7.63 von oben bestätigt. Die Extended Key Usage 2.23.133.8.1 ist tcg-kp-EKCertificate, dieses Zertifikat darf also nichts anderes sein als der Nachweis eines Endorsement Keys. Und Infineon veröffentlicht dazu eine Sperrliste.
Was ich hier bewusst weglasse, sind die Zertifikats-Seriennummer und der öffentliche EK-Schlüssel. Beide kennzeichnen dauerhaft und eindeutig genau dieses eine Notebook, und die TCG behandelt den EK aus genau diesem Grund als datenschutzrelevant. Damit erklärt sich beiläufig, warum es überhaupt Attestierungsschlüssel gibt: damit man für eine Attestierung nicht jedes Mal die dauerhafte Chip-Identität vorzeigen muss.
Das hier ist die Wurzel, auf der Fernattestierung aufsetzt. Ein Prüfer kann feststellen, dass in dieser Maschine ein echter, von Infineon signierter TPM sitzt, ohne dem Betriebssystem eine einzige Zeile zu glauben. Genau formuliert beweist das Zertifikat aber nur die Echtheit des Chips. Dass ein bestimmter Attestierungsschlüssel wirklich in diesem Chip liegt, ist ein zusätzlicher Schritt, und den nehme ich mir im Server-Teil vor.
Drei Dinge, alles andere ist Kombination
Bevor irgendein Anwendungsfall kommt: ein TPM bietet im Kern nur drei Dinge an. Alles, was danach als Feature verkauft wird, ist eine Kombination daraus.
Schlüssel, die nicht herauskommen. Ein Schlüssel mit dem Attribut fixedTPM wird im Chip erzeugt und verlässt ihn nie. Man kann ihn benutzen, man kann ihn nicht kopieren.
PCRs, Register die nur wachsen. 24 Register, hier mit SHA-1- und SHA-256-Bank. Man kann sie nicht setzen, nur erweitern, und die Rechenvorschrift dafür ist neu = hash(alt || messwert). Bei den Registern, auf die es ankommt, nämlich PCR 0 bis 15 auf einer PC-Client-Plattform, geht es nur über einen Neustart zurück. Deshalb kann man die Boot-Historie nicht nachträglich fälschen. Zwei Ausnahmen gehören dazu, sonst wird es ungenau: PCR 16 und PCR 23 sind zur Laufzeit zurücksetzbar. PCR 16 ist ausdrücklich als Debug-Register vorgesehen, und genau deshalb benutze ich es weiter unten für die Demonstration. Gegen ein zurücksetzbares PCR versiegelt niemand etwas Echtes.
Sealing, Geheimnisse an einen Zustand binden. Ein Geheimnis wird so verschlüsselt, dass der Chip es nur herausgibt, wenn eine Policy erfüllt ist, typischerweise ein bestimmter PCR-Zustand.
Dazu kommen als Nebenfunktionen die schon erwähnten monotonen Zähler, ein winziger NV-Speicher, ein Zufallszahlengenerator und die Lockout-Logik von oben.
Und weil es das häufigste Missverständnis überhaupt ist, gleich früh und deutlich: ein TPM ist kein Krypto-Beschleuniger, keine Secure Enclave mit eigener Rechenumgebung und kein Schutz gegen einen kompromittierten laufenden Kernel. Er schützt Schlüssel im Ruhezustand und er misst den Startvorgang. Wenn der laufende Kernel übernommen ist, benutzt der Angreifer den TPM einfach mit, ganz höflich über dieselbe Schnittstelle.
Measured Boot in acht Befehlen
Genug Theorie, jetzt der Beweis. Ich baue eine Policy aus dem aktuellen Zustand von PCR 7, erzeuge einen Primary Key im Chip und versiegle damit ein Geheimnis.
Das Geheimnis kommt zurück, weil PCR 7 noch genau den Wert hat, gegen den versiegelt wurde. Schön, beweist aber noch nichts. Interessant wird es erst, wenn sich die Messung ändert.
Dafür wechsle ich auf PCR 16, das Debug-Register. Der Grund ist praktisch: PCR 16 lässt sich ohne Neustart und ohne Firmware-Änderung erweitern, damit ist die Demonstration in einer einzigen Terminal-Sitzung reproduzierbar. Der Mechanismus ist derselbe wie bei PCR 7.
Und jetzt ändere ich die Messung. Das folgende Kommando ist genau das, was ein ausgetauschter Bootloader auch täte, nur mit einem selbstgewählten Messwert.
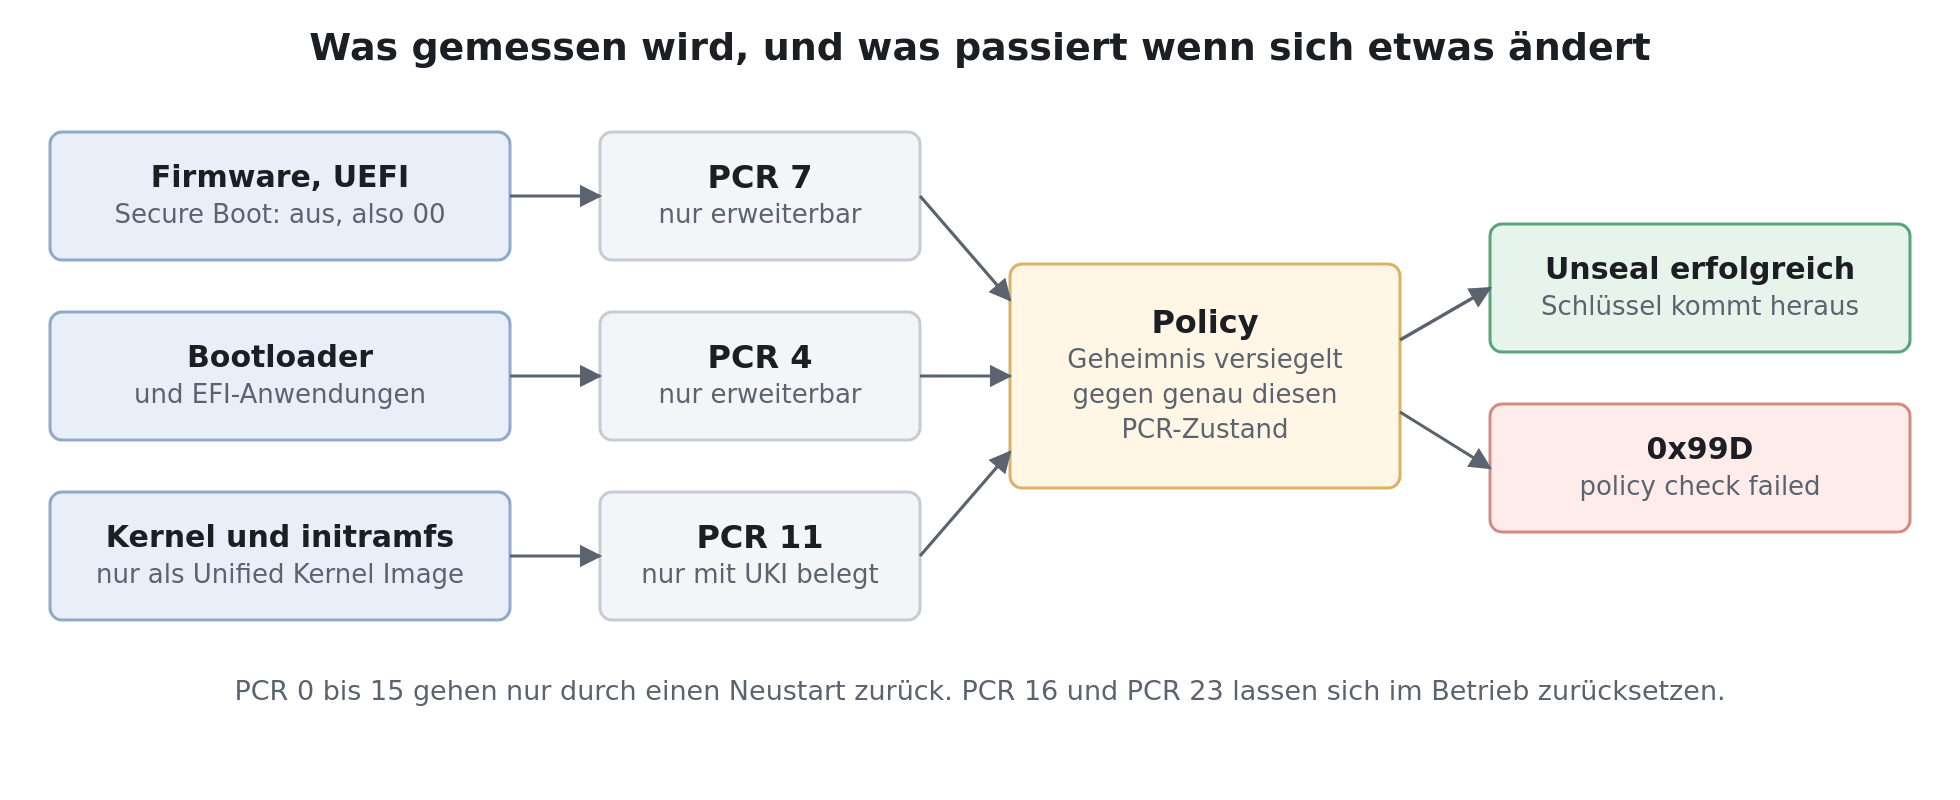
0x99D ist TPM_RC_POLICY_FAIL. Das Geheimnis liegt noch im Blob, es ist nicht gelöscht, es ist nur unerreichbar, solange PCR 16 diesen Wert trägt. Und jetzt der Punkt, auf den es mir ankommt: das ist keine Zugriffskontrolle im Betriebssystem. Da hat kein Dateisystem eine Berechtigung geprüft und kein Dienst eine Regel angewendet. Das ist eine Weigerung der Hardware. Sudo hilft hier nicht, weil root für diese Entscheidung überhaupt nicht zuständig ist.
Wer was misst, und was am Ende über das Entsiegeln entscheidet.
Und wenn ich das Register einfach zurücksetze?
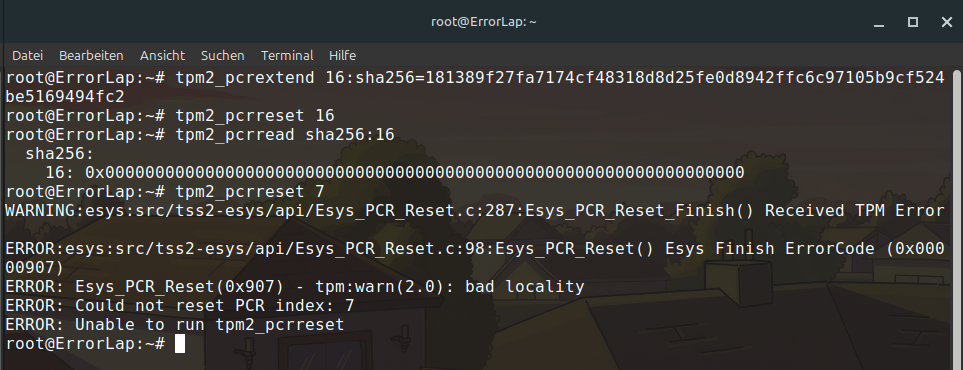
Das ist die Frage, die jeder aufmerksame Leser an dieser Stelle stellt, und sie ist völlig berechtigt. Bei PCR 16 geht das tatsächlich, ohne Neustart.
Dasselbe Kommando gegen PCR 7 lehnt die Hardware ab.
# tpm2_pcrreset 7
ERROR: Esys_PCR_Reset(0x907) - tpm:warn(2.0): bad locality
ERROR: Could not reset PCR index: 7
ERROR: Unable to run tpm2_pcrreset
0x907 ist TPM_RC_LOCALITY. Der Chip unterscheidet, aus welcher Vertrauensstufe ein Kommando kommt, und root auf dem laufenden System hat die Locality, die zum Zurücksetzen eines Boot-Mess-Registers nötig wäre, gar nicht. Das ist der ganze Unterschied zwischen einem Debug-Register und einem Boot-Mess-Register, ausgedrückt in einer Fehlermeldung.
PCR 16 lässt sich zurücksetzen, PCR 7 nicht. Root ändert daran nichts.
Die Platte startet ohne Passphrase, aber nur mit PIN
Der Klassiker am Arbeitsplatz ist LUKS2 zusammen mit systemd-cryptenroll. Der Nutzen ist echt: das Notebook startet ohne Eingabe, und ein ausgebautes Laufwerk bleibt trotzdem verschlüsselt.
Ehrlichkeit an dieser Stelle: dieses Kommando habe ich nicht ausgeführt, und ich konnte es auch nicht. Die Maschine hat gar kein LUKS, die Wurzel liegt auf ZFS mit der ZFS-eigenen Verschlüsselung, aes-256-gcm. Der Befehl steht hier also als dokumentiertes Verfahren nach Manpage und nicht als Messung.
Das Wichtigste daran ist das --tpm2-with-pin=yes. Ohne PIN entsperrt sich das Gerät für jeden, der es einschaltet, und die Festplattenverschlüsselung schützt dann nur noch gegen den Ausbau der SSD, nicht gegen den Diebstahl des Rechners. Mit PIN greift die Lockout-Logik von weiter oben, und genau dadurch wird eine kurze PIN sicher.
Bei der Auswahl der PCRs gibt es dann einen echten Zielkonflikt, der meist verschwiegen wird.
Nur PCR 7 gebunden übersteht Kernel-Updates, misst aber im Kern nur den Secure-Boot-Zustand. Das ist wenig Aussage für viel Bequemlichkeit.
PCR 7 plus 11 gebunden, zusammen mit einem Unified Kernel Image, erfasst tatsächlich Kernel und initrd. Dafür bricht jedes Kernel-Update die Bindung, wenn man nicht mit signierter Policy arbeitet. Eine wichtige Präzisierung dazu, sonst erklärt man die Folgen falsch: PCR 11 ist kein reines Kernel-Register. systemd-stub misst dort das UKI hinein, danach schreibt systemd-pcrphase im Verlauf des Startvorgangs weitere Phasen-Messungen in dasselbe Register. Der Wert von PCR 11 hängt also davon ab, in welcher Boot-Phase man ihn liest, und genau darauf beruht der Trick, dass ein Geheimnis nur im initrd aufgeht und im laufenden System nicht mehr.
PCR 0 bis 7 gebunden ist die strengste Variante, und dann sperrt euch jedes BIOS-Update aus. Das ist der Grund, warum es systemd-pcrlock gibt, das die erwarteten Messwerte vorab berechnet und die Policy nachzieht. Dieselbe Manpage bezeichnet sich allerdings selbst noch als experimentell.
Wer welches Register wofür benutzt, hat die UAPI Group in einer PCR-Registry für Linux zusammengetragen. Das ist die Tabelle, die man beim Basteln offen haben will.
Eine Lücke betrifft ziemlich viele Linux-Nutzer, deshalb sage ich sie deutlich: systemd-cryptenroll und clevis luks bind schreiben beide in einen LUKS2-Header. Wer seine Wurzel auf ZFS-Native-Encryption hat, hat keinen. Upstream-ZFS bringt keine TPM-Integration mit. Ein TPM-gestütztes Entsperren bräuchte dort ein eigenes tpm2_unseal, das zfs load-key füttert, gebaut ins initramfs. Das ist eine echte offene Baustelle und kein Rezept, das ich hier nebenbei hinschreibe.
Ein SSH-Schlüssel, der keine Datei hat
Das ist mein Lieblings-Anwendungsfall am Arbeitsplatz, weil der Nutzen in einem Satz erklärt ist. Ein Angreifer mit Lesezugriff auf ~/.ssh bekommt nichts Verwendbares. Der Schlüssel kann die Maschine nicht verlassen. Er ist nicht gestohlen, er ist an das Blech gebunden.
Die CKA_ID wird pro Schlüssel erzeugt, bei euch steht dort etwas anderes. Den öffentlichen Teil holt man sich in einem Format, das sshd versteht, direkt über den PKCS#11-Provider.
Diese Zeile wandert wie gewohnt in authorized_keys. Und damit der Nachweis auch etwas wert ist, zeige ich ihn als Vorher und Nachher. Auf dieser Maschine liegt in /root/.ssh nämlich kein einziger privater Schlüssel, es gibt also keine zweite Erklärung für einen erfolgreichen Public-Key-Login.
# ls /root/.ssh/id_*
ls: cannot access '/root/.ssh/id_*': No such file or directory

# ssh -o BatchMode=yes root@localhost true
root@localhost: Permission denied (publickey,password).
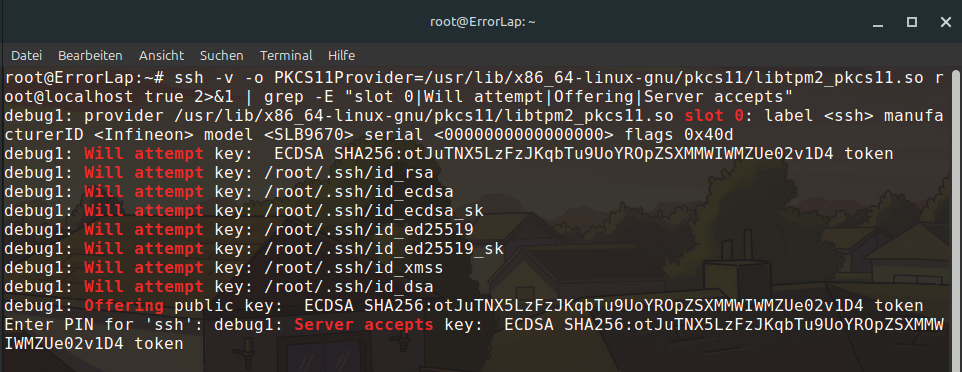
Die PIN habe ich für diesen Test über SSH_ASKPASS nicht interaktiv geliefert, im Alltag fragt ssh einfach danach. Richtig sehenswert wird es aber mit -v, denn da erzählt OpenSSH selbst, mit welchem Bauteil es gerade arbeitet.
debug1: provider /usr/lib/x86_64-linux-gnu/pkcs11/libtpm2_pkcs11.so: manufacturerID <tpm2-software.github.io> cryptokiVersion 2.40 libraryDescription <TPM2.0 Cryptoki> libraryVersion 1.9
debug1: provider /usr/lib/x86_64-linux-gnu/pkcs11/libtpm2_pkcs11.so slot 0: label <ssh> manufacturerID <Infineon> model <SLB9670> serial <0000000000000000> flags 0x40d
debug1: Will attempt key:  ECDSA SHA256:otJuTNX5LzFzJKqbTu9UoYROpZSXMMWIWMZUe02v1D4 token
debug1: Will attempt key: /root/.ssh/id_rsa
debug1: Will attempt key: /root/.ssh/id_ecdsa
debug1: Will attempt key: /root/.ssh/id_ed25519
debug1: Will attempt key: /root/.ssh/id_dsa
debug1: Offering public key:  ECDSA SHA256:otJuTNX5LzFzJKqbTu9UoYROpZSXMMWIWMZUe02v1D4 token
debug1: Server accepts key:  ECDSA SHA256:otJuTNX5LzFzJKqbTu9UoYROpZSXMMWIWMZUe02v1D4 token
Drei Sachen daran finde ich stark. Erstens nennt OpenSSH den Chip beim Namen, manufacturerID <Infineon> model <SLB9670>. Der SSH-Client sagt dir, welches Bauteil da gerade unterschreibt. Zweitens steht der TPM-Schlüssel in der Kandidatenliste mit dem Wort token, wo bei allen anderen ein Dateipfad steht, und diese Dateien existieren nicht einmal. Dieser Kontrast in einem Bildschirm ist das ganze Argument: dieser Schlüssel hat keine Datei. Drittens wird der Token-Schlüssel zuerst probiert, noch vor den nicht existierenden Dateien.
OpenSSH nennt Hersteller und Modell des Chips. Der Schlüssel steht als token in der Liste, alle anderen Kandidaten sind Dateien, die es nicht gibt.
Lasst mal kurz etwas heraus zoomen 😀 Meine Frau weist mich grade auf mein RBF hin. Wenn ich so konzentriert am Computer sitze und wie in diesem Fall etwas schreibe, dann schaue ich wohl meinen Monitor an, als wenn ich ihn gleich töten möchte. Tjo, und nun? Nun zoomen wir wieder ins Thema!
Die Zahl, die meine eigene Erwartung widerlegt hat
Meine Annahme vor der Messung war schlicht: eine ECDSA-Signatur kostet im Chip rund 97 Millisekunden, also merkt man beim Login nichts. Gemessen kommt etwas anderes heraus.
Weg
5 Logins
pro Login
Aufschlag
Schlüssel auf der Platte, Referenzwert
1,552 s
etwa 310 ms
Referenz
PKCS11Provider bei jedem Aufruf
8,013 s
etwa 1603 ms
etwa 1293 ms
Token einmal im ssh-agent
2,806 s
etwa 561 ms
etwa 251 ms
Die Ursache ist lehrreich. Bei PKCS11Provider baut ssh bei jedem einzelnen Login die komplette Kette neu auf: Store öffnen, Primary Key im TPM erzeugen, Kindschlüssel laden, signieren. Allein die Erzeugung des Primary Keys habe ich weiter oben mit 0,537 Sekunden gemessen. Die eigentliche Signatur ist damit der kleinste Posten in der Rechnung.
# ssh-add -s /usr/lib/x86_64-linux-gnu/pkcs11/libtpm2_pkcs11.so
Card added: /usr/lib/x86_64-linux-gnu/pkcs11/libtpm2_pkcs11.so
# ssh-add -l
256 SHA256:otJuTNX5LzFzJKqbTu9UoYROpZSXMMWIWMZUe02v1D4 /usr/lib/x86_64-linux-gnu/libtpm2_pkcs11.so.1.9.0 (ECDSA)
# time (for i in 1 2 3 4 5; do ssh root@localhost true; done)
real	0m2.806s
Mit ssh-add -s passiert diese Initialisierung einmal pro Sitzung statt einmal pro Verbindung, und die PIN wird auch nur einmal abgefragt. Zwei Gründe, dieselbe Empfehlung, also ganz klar: nehmt ssh-add -s und nicht PKCS11Provider bei jedem Aufruf.
Zur Messhygiene, wie immer: fünf Logins pro Zeile über Loopback, jeweils mit vollem Verbindungsaufbau und Prozessstart, kleine Stichprobe, keine Streuung berechnet. Das sind Größenordnungen und keine Benchmarks.
Der Nebeneffekt, den niemand erwähnt
Diesen Punkt habe ich selbst erst beim Aufräumen gemerkt, und jeder, der dem SSH-Abschnitt folgt, läuft hinein. tpm2_ptool init legt stillschweigend einen Primary Key an und macht ihn persistent im Chip. Vor der Demo waren drei persistente Handles belegt, danach vier.
Und jetzt zurück zu einer Zahl von weiter oben: TPM2_PT_HR_PERSISTENT_MIN ist auf diesem Chip 0x7. Garantiert sind also nur sieben persistente Plätze, und drei davon waren schon vorher weg. Wer bei jedem Basteln ein Handle liegen lässt, macht den Chip irgendwann voll. Den eigenen Müll findet und räumt man so weg:
Dazu eine Warnung, die ich nicht deutlich genug schreiben kann: räumt niemals Handles weg, die ihr nicht selbst angelegt habt. Die drei anderen lagen auf meinem Gerät schon vorher dort, vermutlich aus der Hersteller-Provisionierung oder aus einem früheren Windows-Leben. Wer einen fremden Primary Key entfernt, vernichtet alles, was darunter versiegelt war. Der sichere Weg führt über den Token-Store, denn dort steht das Handle drin, das zum eigenen Werkzeug gehört. Bei mir war es genau das 0x81000000 aus der Ausgabe oben, und ich habe vor dem Entfernen im Store nachgesehen, statt der Reihenfolge zu vertrauen.
Schlüssel im Chip, benutzt über OpenSSL
Für alles, was kein PKCS#11 spricht, gibt es den OpenSSL-3-Provider. Der schönste Moment daran ist ein PEM-Header.
Diese Datei enthält keinen privaten Schlüssel. Sie enthält einen Blob, den ausschließlich dieser eine Chip auspacken kann. Kopiert die Datei auf eine andere Maschine und sie ist wertlos. Signieren geht im Chip, prüfen geht überall.
Zum Prüfen habe ich nur den Standard-Provider gebraucht. Es ist eine ganz normale ECDSA-Signatur, die Gegenseite muss von einem TPM überhaupt nichts wissen. Deshalb lässt sich das in bestehende PKI einbauen, ohne irgendetwas umzustellen, und damit gehen Client-Zertifikate für VPN, 802.1X, mTLS und auch AWS IAM Roles Anywhere.
Der Zufallsgenerator, ehrlich klein geredet
Auf diesem System ist der TPM tatsächlich der Hardware-Zufallsgenerator, den der Kernel benutzt.
Der Nutzen davon ist vorhanden, aber klein. Moderne CPUs haben RDRAND, der Kernel hat einen guten Entropiepool, und rund 67 Millisekunden pro tpm2_getrandom-Aufruf sind für nichts geeignet, was Durchsatz braucht. Als zusätzliche, unabhängige Quelle im Pool ist es geschenkt und in Ordnung. Mehr würde ich daraus nicht machen.
Fernattestierung, der eigentliche große Fall
Auf Servern liegt der größere Nutzen, nicht am Arbeitsplatz. Das Problem zuerst: bei einer Kiste im Rechenzentrum oder in der Colo weiß man normalerweise nicht, ob sie noch die Software fährt, die man dort installiert hat. Alles, was man fragen kann, ist der Server selbst. Und wenn er kompromittiert ist, lügt er.
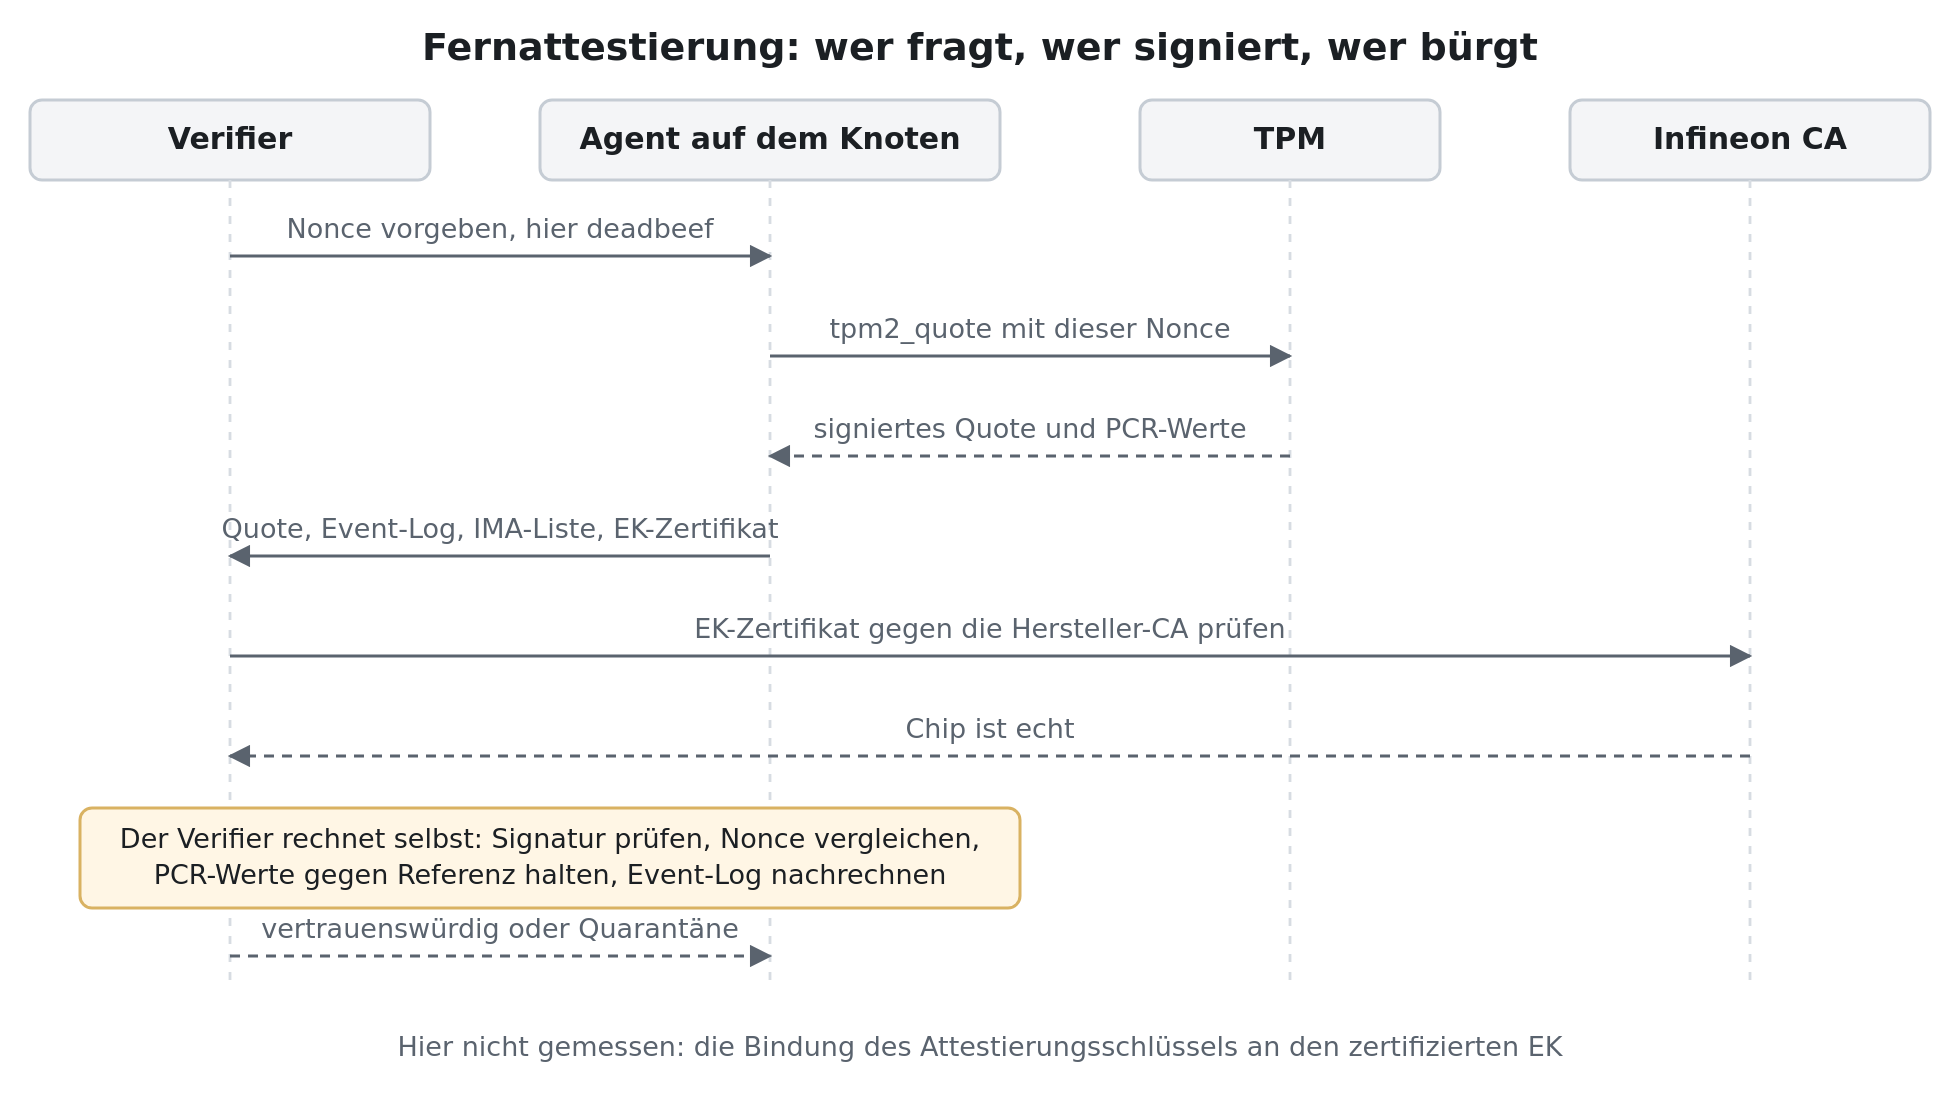
Der TPM löst das, weil er eine Aussage über den Startvorgang signiert, die das Betriebssystem nicht fälschen kann. Zwei Schlüssel braucht es dafür: den Endorsement Key als Chip-Identität und einen Attestierungsschlüssel, mit dem tatsächlich signiert wird.
Der qualified name ist didaktisch schön, weil er die Abstammung des Schlüssels von seinem Elternschlüssel mit einbezieht. Jetzt das Quote, mit einer Nonce, die sich der Prüfer ausdenkt. Ich nehme deadbeef in Hex.
Der quoted-Blob sieht wie Rauschen aus, ist aber lesbar, wenn man weiß wo man hinschaut.
ff544347 ist die Konstante TPM_GENERATED_VALUE und markiert die Struktur als im TPM entstanden. Wichtig für das Verständnis: sie allein verhindert keine Fälschung. Der Schutz entsteht daraus, dass ein Attestierungsschlüssel ein restricted Signaturschlüssel ist, der nur Daten unterschreibt, die der Chip selbst erzeugt hat. Diese Konstante ist das Erkennungsmerkmal dafür und nicht der Mechanismus.
8018 ist TPM2_ST_ATTEST_QUOTE, der Strukturtyp.
6465616462656566 ist meine Nonce, unverändert zurück. Genau das schlägt einen Replay.
07003f000d1900 ist die Firmware-Version, die in jedem Quote mitläuft. Das ist wieder die 7.63 von oben.
Geprüft wird offline, und zwar mit nichts als dem öffentlichen Attestierungsschlüssel.
Der Ablauf einer Attestierung. Der Prüfer glaubt dem Knoten nichts, er rechnet nach.
Die Lücke, die fast jedes Howto verschweigt
Und hier muss ich mich selbst bremsen, denn die Versuchung ist groß, die beiden vorherigen Abschnitte einfach nebeneinanderzulegen und „echte Hardware bestätigt echten Bootzustand“ daraus zu machen. Das wäre eine Beweiskette mit einem Loch in der Mitte.
tpm2_checkquote mit dem öffentlichen Attestierungsschlüssel beweist genau eine Sache: irgendjemand, der diesen Schlüssel besitzt, hat dieses Quote signiert. Es beweist nicht, dass dieser Schlüssel in demselben Chip steckt, dessen Infineon-Zertifikat ich weiter oben gezeigt habe.
Die fehlende Verbindung heißt Credential Activation. Der Prüfer verschlüsselt dabei ein Geheimnis so, dass es nur ausgepackt werden kann, wenn Endorsement Key und Attestierungsschlüssel im selben TPM liegen, klassisch über TPM2_MakeCredential auf der Prüferseite und TPM2_ActivateCredential auf der Knotenseite. Erst wenn der Knoten das Geheimnis zurückmelden kann, ist bewiesen, dass der Schlüssel zu diesem zertifizierten Chip gehört. Alternativ stellt eine Attestierungs-CA ein echtes AK-Zertifikat aus, nachdem sie diese Prüfung einmal gemacht hat. Wie das im Detail aussieht, steht in RFC 9683. Diesen Schritt habe ich hier nicht durchgeführt. Gemessen sind Quote und Signaturprüfung, die Bindung ist dokumentiertes Verfahren.
Keylime, vier Rollen und ein Prüfer der nicht aufhört
Genau diesen Schritt macht Keylime, und genau deshalb ist Keylime mehr als ein Skript um tpm2_quote herum. Die Architektur hat vier Rollen: einen Agent auf dem Knoten, einen Registrar, einen Verifier und einen Tenant. Der Agent schickt Event-Log, IMA-Hashes und Measured-Boot-Daten, der lokale TPM bürgt für die Echtheit, und über das EK-Zertifikat lässt sich beweisen, dass es überhaupt ein echter TPM ist. Der Verifier prüft dann fortlaufend und nicht nur einmal beim Start.
Damit das nicht nach Bastelei klingt: Keylime läuft in der IBM Cloud als Teil der Compliance-Anforderungen für FedRAMP und HITRUST, und SUSE dokumentiert es offiziell für SUSE Linux Micro. Das ist kein Laborspielzeug.
IMA und EVM, zwei Dinge die ständig verwechselt werden
Beide gehören zur Laufzeit-Integrität, machen aber Verschiedenes.
IMA, die Integrity Measurement Architecture, hasht Dateien beim Zugriff. Im Messmodus schreibt sie die Hashes in ein Kernel-Log und erweitert damit PCR 10. Im Appraisal-Modus verweigert sie zusätzlich die Ausführung, wenn Hash oder Signatur nicht passen.
EVM schützt die zugehörigen erweiterten Attribute, also die Sicherheits-Metadaten der Datei, mit einem HMAC oder einer Signatur. Ohne EVM könnte ein Angreifer mit Schreibrechten die IMA-Attribute einfach mitfälschen.
Der TPM-Bezug liegt bei IMA und bei PCR 10. Eine veränderte Binärdatei erzeugt eine Messung, die im TPM landet und rückwirkend nicht mehr zu entfernen ist, weil PCRs nur wachsen. Zusammen mit Secure Boot und Measured Boot entsteht so eine Kette von der Firmware bis zur einzelnen ausgeführten Datei. Ohne TPM wäre dieses Logbuch fälschbar, mit TPM nicht.
Verschlüsselte Server, die allein neu starten können
Operativ ist das der handfesteste Nutzen im Rechenzentrum. Ein verschlüsselter Server, der nach einem Reboot auf eine Passphrase wartet, ist ein Betriebsproblem, spätestens um drei Uhr nachts. Mit TPM-Bindung startet er durch. Der Zielkonflikt dahinter ist eine echte Architekturentscheidung.
TPM allein. Der Server startet ohne Menschen. Wer den ganzen Server stiehlt, bekommt einen Server, der sich selbst entsperrt.
Tang und Clevis, netzgebunden. Entsperrt nur, wenn der Server einen Tang-Server im eigenen Netz erreicht. Aus dem Rack getragen bleibt er zu. Braucht dafür einen erreichbaren Tang-Server, was beim Kaltstart eines ganzen Rechenzentrums ein Henne-Ei-Problem ist.
Beides kombiniert über Shamir Secret Sharing in Clevis, also zum Beispiel TPM und Tang zusammen.
Meine Empfehlung, und die ist unspektakulär: im eigenen Rack mit eigenem Netz nehmt Tang plus TPM über Clevis, weil dann beide Bedingungen gleichzeitig gelten müssen. Bei einer einzelnen Kiste in fremder Colo nehmt TPM mit PIN und tippt die eben ein, wenn es tatsächlich einen Kaltstart gibt. Ein Server, der sich ohne jede Bedingung selbst entsperrt, ist Verschlüsselung fürs Protokoll und nicht gegen einen Angreifer.
Maschinenidentität, die man nicht in eine VM klonen kann
Ein Schlüssel der die Maschine nicht verlassen kann ist eine Identität, die man nicht mitkopieren kann. Für Zero-Trust-Architekturen ist das der interessante Teil: SPIRE hat dafür einen TPM-Node-Attestor, und für Kubernetes-Knoten, die sich beim Beitritt beweisen sollen, ist das der saubere Weg. Verglichen mit einem Token in einer Cloud-Init-Datei, das jeder mitlesen und in eine beliebige VM kopieren kann, ist das ein anderes Sicherheitsniveau.
Ein TPM für jede VM, und was er nicht leistet
Ein physischer TPM hat genau eine Instanz und lässt sich nicht sinnvoll auf viele Gäste aufteilen. Die Lösung ist ein virtueller TPM pro VM. swtpm stellt dafür eine TPM-2.0-Implementierung im Userspace bereit, QEMU und libvirt binden sie als Gerät in die VM ein. Der Gast sieht ein ganz normales /dev/tpm0 und braucht keine Anpassung. Der Kernel bringt dazu den vTPM-Proxy-Treiber mit, /dev/vtpmx, über den Container und VMs eigene TPM-Instanzen bekommen. Genau so machen es die Cloud-Anbieter, und genau so kommt Windows 11 in einer VM überhaupt an seine TPM-2.0-Voraussetzung.
Die ehrliche Einordnung gehört dazu, weil das in Cloud-Architekturen regelmäßig falsch verstanden wird. Ein vTPM ist Software. Sein Zustand liegt als Datei auf dem Hypervisor. Wer den Hypervisor kontrolliert, kontrolliert den vTPM, und ein Angreifer mit root auf dem Host kann den Schlüsselzustand kopieren. Ein vTPM löst also das Problem „der Gast braucht ein TPM-Interface“, er liefert aber keine Hardware-Vertrauenswurzel für den Gast. Wer echte Attestierung einer VM will, braucht eine Kette, die beim TPM des Hosts beginnt, oder Confidential-Computing-Technik wie AMD SEV-SNP oder Intel TDX.
Zum Schluss noch ein kleiner Anwendungsfall, der technisch nichts Neues ist und praktisch viel bringt: die Datenbank-Zugangsdaten eines Dienstes so versiegeln, dass sie nur auf dieser Maschine und nur in diesem Bootzustand aufgehen. Derselbe Seal-Mechanismus wie oben, nur mit einem anderen Geheimnis. Ein kopiertes Image oder eine in eine VM gehobene Platte bringt die Zugangsdaten dann nicht mit.
Was geht, aber nichts bringt
Dieser Abschnitt ist mir genauso wichtig wie der Nutzen-Teil, also kürze ich ihn nicht ab. Zuerst das Missverständnis, das sich am leichtesten messen lässt.
1. Der TPM als Krypto-Beschleuniger. Gemessen und erledigt.
Operation
Wo
Zeit
RSA-2048-Schlüssel erzeugen
TPM
19,703 s
RSA-2048-Schlüssel erzeugen
CPU, openssl
0,220 s
ECC-P-256-Primary erzeugen
TPM
0,537 s
ECDSA P-256 signieren, 50 mal
TPM
4,862 s
ECDSA P-256 signieren, 50 mal
CPU, openssl
0,286 s
# time tpm2_createprimary -C o -g sha256 -G rsa2048 -c rsa_primary.ctx
real	0m19.703s
user	0m0.039s
sys	0m0.016s

# time openssl genpkey -algorithm RSA -pkeyopt rsa_keygen_bits:2048 -out /dev/null
real	0m0.220s
user	0m0.210s
sys	0m0.010s
Rund 90 mal langsamer bei der RSA-Schlüsselerzeugung. Ein Detail zur Messhygiene ist mir dabei wichtig: während der 19,7 Sekunden liegen user und sys bei 0,039 und 0,016 Sekunden. Die CPU langweilt sich also, die Zeit vergeht wirklich im Chip. Das ist eine Messung des TPM und nicht des Prozess-Overheads.
Die richtige Schlussfolgerung ist nicht, dass der TPM schlecht wäre, sondern dass er kein Beschleuniger ist und nie einer war. Das ist die interessante Kehrseite zu der Krypto-Beschleunigerkarte, die ich neulich gegen dieselbe Klasse moderner CPU gemessen habe. Dort verlor Spezial-Hardware, die schnell sein wollte. Hier verliert sie noch deutlicher, nur ist das kein Befund, sondern die Bauart. Der TPM wollte nie schnell sein, er wollte stur sein.
2. Massendaten im TPM verschlüsseln. Es gibt keinen Datenpfad dafür, und bei den Zahlen von oben erübrigt sich die Diskussion.
3. LUKS nur am TPM, ohne PIN. Technisch drei Minuten Arbeit. Ergebnis ist ein Notebook, das sich für jeden entsperrt, der den Deckel aufmacht. In Kombination mit dem Bus-Sniffing weiter unten ist das nahe an Sicherheitstheater. Wer die Passphrase-Eingabe loswerden will, nimmt die PIN.
4. Der TPM als Passwortspeicher oder Secret Store. Ein einzelner NV-Index kann auf diesem Chip höchstens 1664 Bytes halten, und es gibt genau 8 NV-Zähler. NV im TPM ist Flash mit begrenzten Schreibzyklen und als Ablage für Inhalte nicht gedacht. Der richtige Weg ist immer derselbe: die Geheimnisse liegen verschlüsselt auf der Platte, und nur der Schlüssel dafür wird im TPM versiegelt. Genau das tun systemd-cryptenroll und Clevis auch.
5. Sealing gegen PCR 0 bis 7 auf einem Gerät, das Firmware-Updates bekommt. Jedes BIOS-Update ändert die Messungen und sperrt euch aus. Ein Fall, in dem die Technik funktioniert und die Betriebspraxis daran zerbricht. Der Ausweg heißt signierte Policies und systemd-pcrlock, und im selben Atemzug gehört dazu, dass sich systemd-pcrlock selbst noch als experimentell bezeichnet.
6. Attestierung ohne unabhängigen Prüfer. Ein Quote, das auf derselben Maschine geprüft wird, beweist nichts. Wenn die Maschine übernommen ist, ist die Prüfung übernommen. Attestierung ergibt nur mit einem separaten Verifier und mit bekannten Referenzwerten Sinn. Sehr viele Aussagen der Art „wir nutzen TPM“ sind bei genauem Hinsehen genau das, eine Selbstprüfung.
7. TPM 1.2 im Jahr 2026. SHA-1 und RSA-2048, kein ECC, keine Algorithmen-Agilität, ein völlig anderer Software-Stack, nämlich TrouSerS statt tpm2-tss. Wer noch einen findet, sollte darauf nichts Neues bauen.
8. Die Erwartung, ein TPM schütze ein laufendes System. Das ist das größte Missverständnis, deshalb steht es hier noch einmal als eigener Punkt. Ein TPM schützt Schlüssel im Ruhezustand und misst den Start. Er tut nichts gegen einen Angreifer, der schon im Kernel sitzt, denn der fragt den Chip einfach ganz normal.
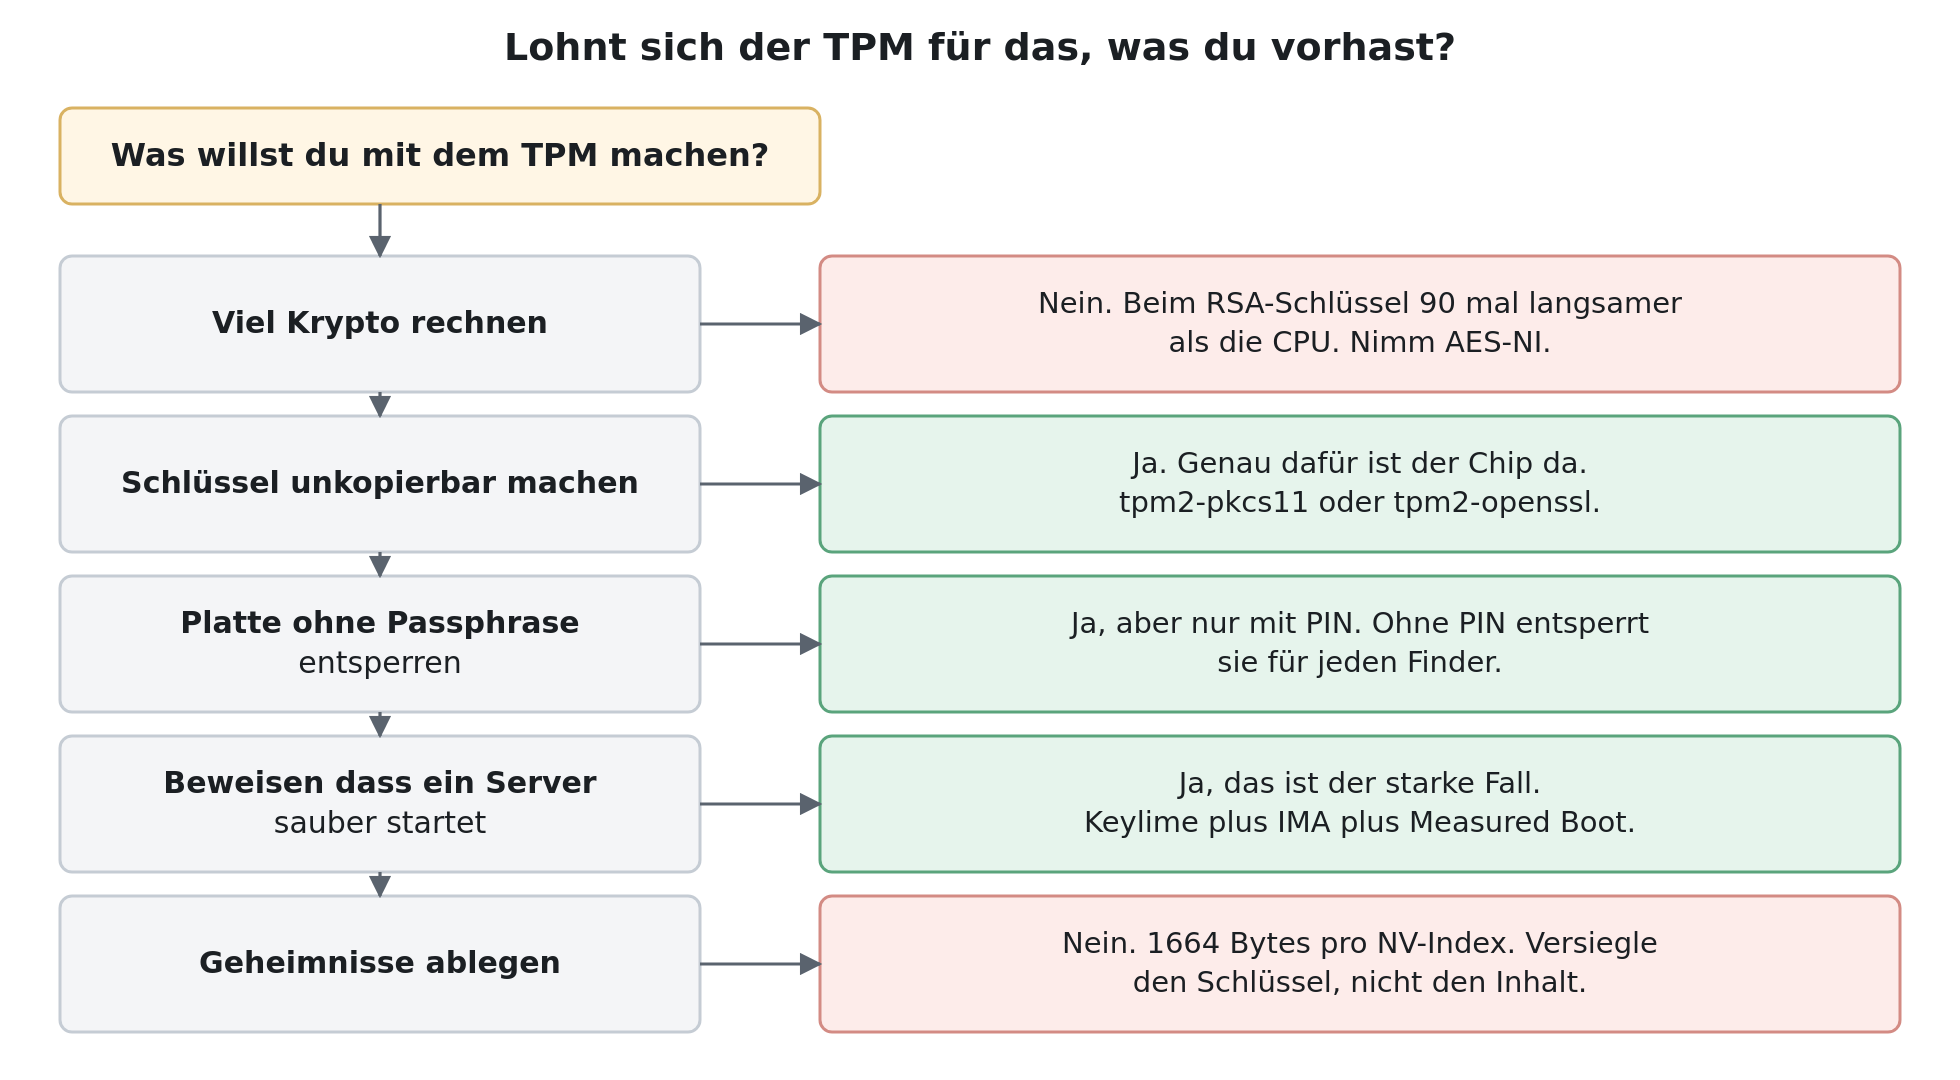
Fünf häufige Vorhaben und die kurze Antwort dazu.
Die Grenzen, und die Angriffe die es wirklich gibt
Ohne diesen Abschnitt wäre der Beitrag Werbung. Der Kern des Problems bei diskreten Chips ist unangenehm einfach: nach dem Entsiegeln gibt der TPM das Geheimnis über den Bus heraus, und klassisch liegt es dort im Klartext. Wer LPC oder SPI anzapft, liest den Schlüssel mit. Für BitLocker ist das seit Jahren praktisch demonstriert, und es ist ausdrücklich nicht auf Windows beschränkt. Securitum hat im September 2024 in einem echten Penetrationstest genau das gegen ein Linux-System mit LUKS und Clevis gezeigt.
Das betrifft mein Testsystem direkt, und ich schreibe das lieber offen hin, als es zu verstecken: der SLB 9670 ist ein diskreter Chip auf dem Board. Der Angriff braucht physischen Zugriff und Löterfahrung, aber er ist kein Papier-Szenario.
Die Gegenmaßnahme kann TPM 2.0 von sich aus: Sessions mit HMAC-Absicherung und Parameter-Verschlüsselung, und systemd benutzt das inzwischen. Die Grenze davon wird oft zu großzügig beschrieben, deshalb genau: das ist keine Vollverschlüsselung des Bus-Protokolls. Parameter Encryption schützt gezielt einzelne sensible Parameter in Kommandos und Antworten, also genau die Stelle, an der ein entsiegelter Schlüssel herauskäme. Kommandocodes, Handles und die übrigen Parameter bleiben sichtbar. Gegen das passive Mitlesen des Schlüssels ist es wirksam, gegen Verkehrsanalyse nicht, und gegen einen aktiven Interposer hilft es nur insofern, als die HMAC-Absicherung Manipulationen auffallen lässt. Der Kernel hat zu dieser Interposer-Frage eine eigene Dokumentationsseite. Und noch eine Einschränkung, die systemd selbst dokumentiert: die Art der Einbindung entwickelt sich weiter, alte Enrollments profitieren nicht rückwirkend. Wer vor Jahren enrolliert hat, sollte das neu machen.
Und dann eine Ironie, die zeigt wie dünn das Eis ist: CVE-2023-1017 saß genau in CryptParameterDecryption, also in dem Code, der diese verschlüsselten Parameter auspackt. Die Schutzfunktion war selbst der Angriffsweg.
Wer jetzt denkt, ein fTPM in der CPU sei automatisch besser, hat nur andere Probleme. faulTPM hat gezeigt, dass sich AMDs fTPM über Spannungs-Glitching am Platform Security Processor angreifen lässt. Und TPM-Fail demonstrierte 2019 Timing-Seitenkanäle, mit denen sich private ECDSA-Schlüssel rekonstruieren ließen, und zwar aus Intel PTT (CVE-2019-11090) und aus dem ST33 von STMicroelectronics (CVE-2019-16863). Zwei Details daran tragen den Punkt: der lokale Angriff auf Intels fTPM brauchte je nach Zugriffsrechten 4 bis 20 Minuten, und der ST33 trug eine Common-Criteria-Zertifizierung nach EAL 4+, die Schutz gegen Seitenkanäle ausdrücklich einschließt. Ein Zertifikat ist also kein Beweis.
Auch die Referenz-Implementierung selbst hatte Löcher. CVE-2023-1017 war ein Out-of-bounds-Write, CVE-2023-1018 ein Out-of-bounds-Read, beide in der TPM-2.0-Module-Library, also im Referenzcode der TCG. Betroffen waren dadurch gleichzeitig Software-TPMs wie libtpms und eine Reihe von Hardware-TPMs, deren Firmware auf diesem Code aufbaut. Gefunden hat sie Quarkslab und meldete sie im November 2022. Zwei Bytes über den Puffer hinaus, im ungünstigen Fall Codeausführung im TPM-Kontext, also genau in dem Bauteil, dessen einzige Aufgabe es ist, eine Vertrauensgrenze zu ziehen.
Was bleibt also unterm Strich: ein TPM hebt die Messlatte von „Platte ausbauen und kopieren“ auf „an das Board löten oder den SoC glitchen“. Das ist ein echter Fortschritt und kein magischer Schild. Mit PIN wird es deutlich stärker, weil dann die Lockout-Logik greift und Bus-Sniffing allein nicht mehr reicht.
Der Zustand dieses Testsystems, unbequem und aufschlussreich
Und jetzt der Teil, der mir selbst am meisten zu denken gibt. Der Chip in diesem Notebook arbeitet einwandfrei, wie alles hier oben zeigt. Benutzt wird er von diesem System für praktisch nichts.
Baustein
Zustand
Secure Boot
aus, und als 00 in PCR 7 gemessen
Wurzel-Dateisystem
ZFS-Native-Encryption, aes-256-gcm, nirgends LUKS
systemd-cryptenroll
vorhanden, systemd 255.4, ohne LUKS2 aber nutzlos
clevis
nicht installiert, würde hier auch nicht helfen
Unified Kernel Image
nicht im Einsatz
systemd-pcrextend.socket
übersprungen, ConditionSecurity=measured-uki nicht erfüllt
systemd-pcrmachine.service
übersprungen, dieselbe Bedingung
systemd-tpm2-setup-early.service
übersprungen, dieselbe Bedingung
die elf systemd-pcrlock-*-Units
alle disabled
TPM als /dev/hwrng
aktiv, tpm-rng-0
Die drei übersprungenen Units sind der interessanteste Eintrag in dieser Tabelle. Die Bedingung ConditionSecurity=measured-uki prüft nicht das Dateiformat, sondern den Bootweg. Weil dieses System nicht als gemessenes Unified Kernel Image über systemd-stub gestartet ist, überspringt systemd die halbe TPM-Infrastruktur einfach lautlos, ohne Fehler und ohne Warnung. Das ist genau die These aus der Einleitung, jetzt belegt: der Chip ist da, er funktioniert, und die Distribution benutzt ihn nicht.
Der Event-Log, und die Falle mit ls
Zum Abschluss noch eine Kleinigkeit, über die ich zuerst gestolpert bin. Der Event-Log, dessen Adresse die Firmware ganz oben in der ersten dmesg-Zeile übergeben hat, liegt im securityfs. Und ls behauptet, die Datei sei leer.
# ls -la /sys/kernel/security/tpm0/
total 0
-r--r----- 1 root tss 0 Aug 10 09:30 binary_bios_measurements

# tpm2_eventlog /sys/kernel/security/tpm0/binary_bios_measurements | grep -c EventNum
120
Null Bytes laut ls, und trotzdem 120 Events darin. securityfs gibt für diese Datei einfach keine Größe an. Was in den 120 Einträgen steckt, sortiert sich so:
Da steht der Secure-Boot-Zustand meiner Maschine als 00 im Log, und gehasht wandert genau dieser Wert in PCR 7. Das ist die Brücke zwischen dem Firmware-Setup und dem Chip: was ihr im BIOS umschaltet, wird gemessen und landet im TPM. Schaltet Secure Boot ein, und PCR 7 ändert sich. Alles, was gegen PCR 7 versiegelt war, geht danach nicht mehr auf. Wer den Zusammenhang einmal so gesehen hat, versteht auch, warum die Wahl der PCRs weiter oben ein Zielkonflikt ist und keine Geschmacksfrage.
Eine Nebenbemerkung, weil sie so schön zeigt, wie Secure-Boot-PKI in der Praxis funktioniert: im Log steckt auch der Platform Key des Boards, ein „Fujitsu ODM Quanta BIOS PK Certificate“, gültig von August 2012 bis August 2022. Es ist also seit Jahren abgelaufen. Die Firmware interessiert sich nicht dafür.
Was offen bleibt
Ob der SLB 9670 auf diesem Board über LPC oder über SPI angebunden ist. Aus dem Betriebssystem heraus nicht entscheidbar.
Warum der Login über PKCS11Provider rund 1,3 Sekunden Aufschlag kostet, ist plausibel erklärt, aber nicht einzeln nachgemessen. Ein strace oder ein Trace über tpm2_ptool würde es belegen.
systemd-cryptenroll mit LUKS2 konnte ich nicht testen, weil hier kein LUKS existiert.
Keylime habe ich nicht aufgesetzt. Die Beschreibung stützt sich auf Dokumentation von SUSE, Red Hat und dem Keylime-Projekt.
Die Bindung des Attestierungsschlüssels an den zertifizierten EK, also TPM2_MakeCredential und TPM2_ActivateCredential, habe ich nicht durchgeführt. Gemessen sind nur Quote und Signaturprüfung.
Wie viel NV-Speicher der SLB 9670 insgesamt hat, habe ich nicht ermittelt. NV_INDEX_MAX beantwortet diese Frage nicht.
Kein vTPM aufgesetzt. Der Abschnitt dazu ist dokumentiert und nicht gemessen.
Ob verschlüsselte TPM-Sessions Bus-Sniffing auf diesem konkreten Chip vollständig verhindern, habe ich nicht überprüft. Dafür bräuchte es einen Logic Analyzer.
Ein TPM-gestütztes Entsperren einer ZFS-Native-Encryption-Wurzel habe ich nicht gebaut.
Wie sich PCR 7 auf diesem Gerät nach dem Aktivieren von Secure Boot verändert. Das wäre ein naheliegender zweiter Teil.
Wenn ich hier etwas falsch dargestellt habe, oder wenn ihr einen der offenen Punkte schon gelöst habt, dann korrigiert mich gerne. Dann lerne ich selbst etwas. Ihr dürft mich dazu jederzeit fragen.
Und weil mich das wirklich interessiert: setzt ihr den TPM-Chip selbst ein, ignoriert ihr ihn bisher, oder nutzt ihr ihn eher zufällig?
Manche Bauteile überleben ihren eigenen Sinn. Diese Karte liegt seit Jahren bei mir herum, hat einmal einen echten Job gemacht, und heute ist sie ein Stück Technikgeschichte mit Kühlkörper. Also habe ich sie in meine Workstation gesteckt, einfach um zu sehen, was sie noch kann und wie sie sich gegen eine aktuelle CPU schlägt. Das Ergebnis ist interessanter geworden als erwartet, aber nicht auf die Art, die ich erwartet hatte.
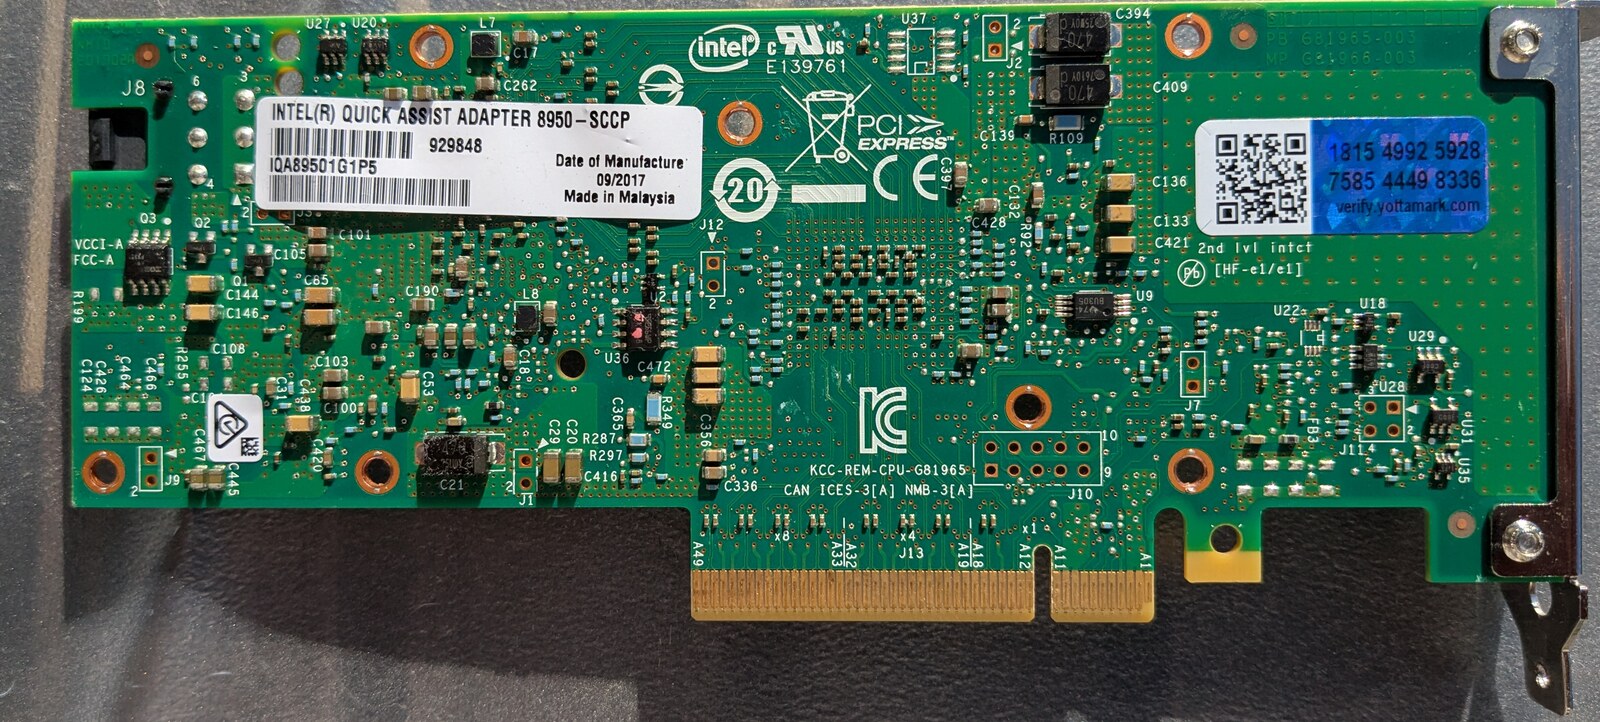
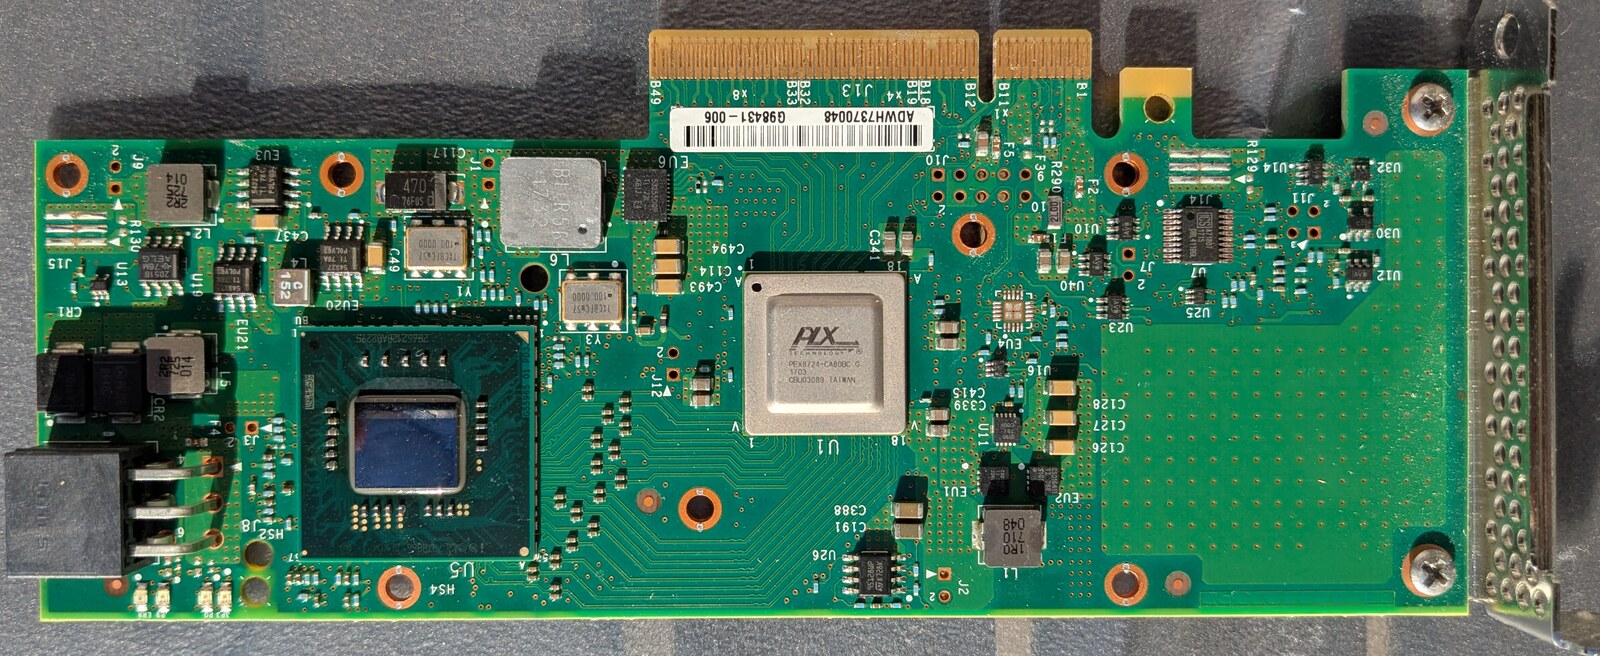
Die Vorgeschichte: irgendwann lief bei mir ein FreeBSD-Server mit einer Intel-Atom-CPU, und diese CPU hatte kein AES-NI. Auf so einer Maschine verschlüsselte Platten zu betreiben ist zäh. Also kam eine Intel QuickAssist Adapter 8950-SCCP rein, eine PCIe-Steckkarte, die genau das in Hardware macht. Und sie hat ihren Job gut gemacht: weniger CPU-Last, mehr Durchsatz am Storage. Später wanderte sie in einen älteren Xeon, immer noch FreeBSD, immer noch GELI. FreeBSD 14 hat sie produktiv nie gesehen.
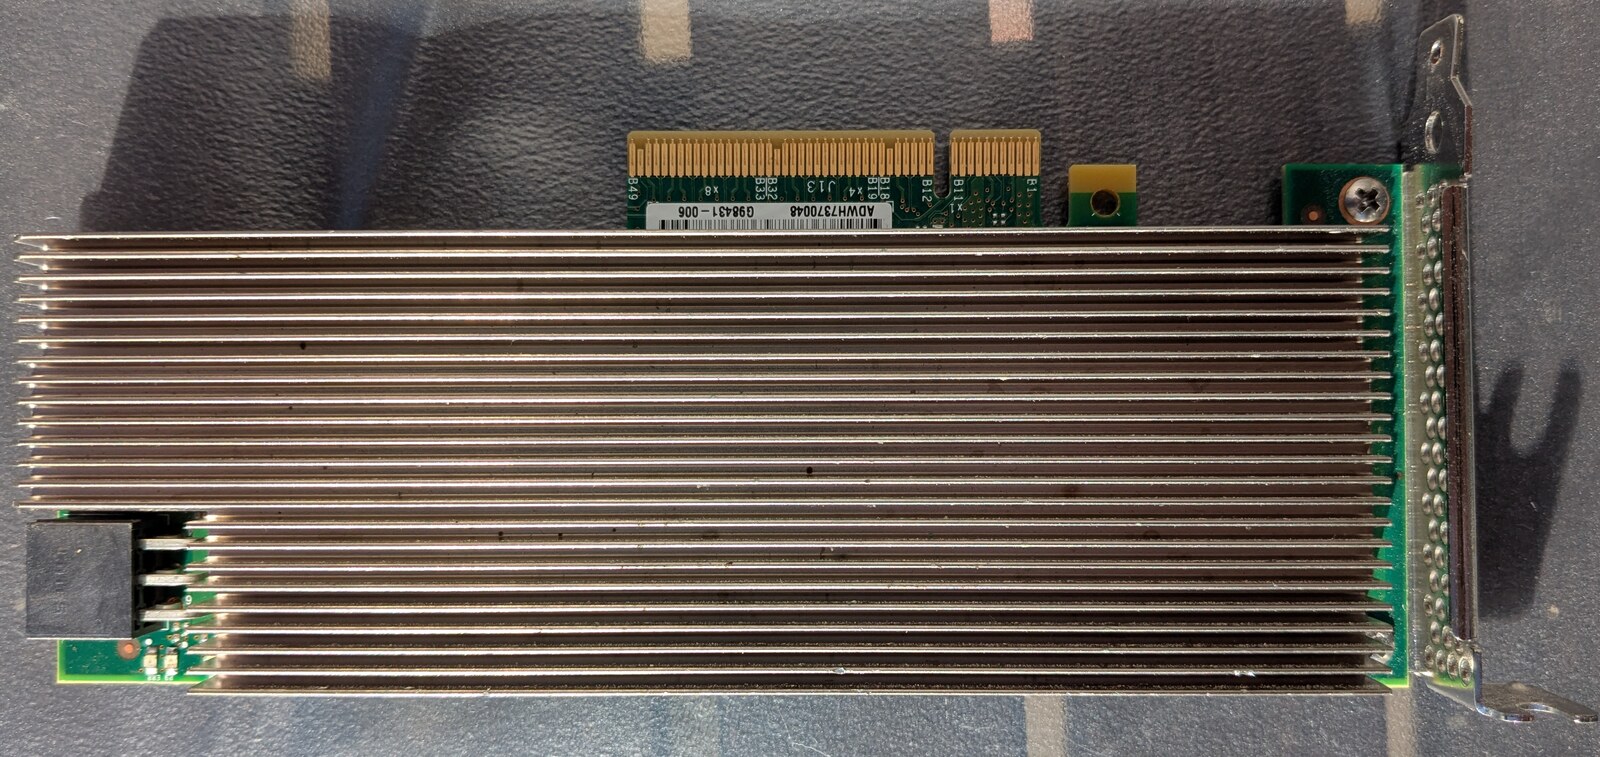
So hing sie im Server: Low Profile, PCIe x8, ein gerippter Aluklotz über fast der ganzen Platine. Lüfter gibt es keinen, den soll das Rack liefern.
Warum das damals überhaupt ein Problem war
Das ist der Teil, den heute fast keiner mehr auf dem Schirm hat: AES in der CPU war jahrelang keine Selbstverständlichkeit.AES-NI kam 2010 mit Westmere, aber Intel hat den Befehlssatz danach als Segmentierungsmerkmal benutzt. Bei vielen Atom-, Celeron- und Pentium-Modellen fehlte er, und zwar genau in den stromsparenden Storage- und Firewall-Plattformen, in denen man ihn am dringendsten gebraucht hätte. Ohne AES-NI rechnet eine CPU AES über Tabellen-Lookups, also grob eine Größenordnung langsamer, und obendrein mit Cache-Timing-Seitenkanälen, die man erst mit Aufwand wieder zubekommt.
Bei ARM war es lange genauso, und da ist es sogar noch besser zu greifen. ARMv7 hatte überhaupt keine AES-Befehle. Die Cryptography Extensions von ARMv8-A sind bis heute optional, ein Chiphersteller kann sie einfach weglassen. Der Raspberry Pi ist das schönste Beispiel: alle 64-Bit-fähigen Pis bis einschließlich Modell 4 haben keine AES-Beschleunigung, erst der BCM2712 im Pi 5 bringt sie mit. Wer sich mal gefragt hat, warum verschlüsselte Backups auf einem Pi 4 so quälend langsam sind: das ist der Grund, und es ist kein Softwareproblem.
Dazu kommt der zweite Teil der Geschichte. Verschlüsselung war lange die Ausnahme, nicht die Regel. Wer 2010 eine Webseite betrieben hat, hat HTTPS für den Loginbereich angeschaltet und sonst nirgends, weil es teuer war, weil Zertifikate Geld kosteten und weil TLS auf schwacher Hardware wirklich weh tat. Erst mit Snowden und vor allem mit dem Druck, den die Browserhersteller danach aufgebaut haben, kippte das ins Gegenteil. Plötzlich sollte alles verschlüsselt sein, und zwar sofort. In dieser Phase steckten in Loadbalancern und Reverse Proxies routinemäßig Offload-Karten, für Krypto oder für Kompression, weil die Allzweck-CPU dahinter das schlicht nicht mitgemacht hat. Diese Karte kommt aus genau dieser Zeit.
Was das für eine Karte ist
Auf dem Aufkleber steht INTEL(R) QUICK ASSIST ADAPTER 8950-SCCP, Bestellnummer IQA89501G1P5, Intel MM 929848, Herstelldatum 09/2017, Made in Malaysia. Der Chip darauf ist allerdings älter als die Karte: die Generation stammt aus Q4 2013.
Die Rückseite mit dem Typenschild. Der blaue Aufkleber ist ein Echtheitsmerkmal von yottamark, dazu KCC-Zulassung, UL-Nummer und das PCI-Express-Logo.
SCCP steht für Single Coleto Creek PCIe. Coleto Creek ist der interne Codename, der Beschleunigerchip heißt DH895xCC, und Intel hat ihn als Intel Communications Chipset 8955 verkauft. Die PCI-ID ist 8086:0435. Bei Intel ist die Karte längst End of Life, abgekündigt zusammen mit ihrem Nachfolger 8960.
Die Datenblattwerte, also Herstellerangaben und nichts von mir Gemessenes:
Angabe
Wert
Bulk-Krypto
bis 50 Gbit/s
Kompression
bis 24 Gbit/s
Host-Interface
PCIe Gen3 x8
SR-IOV
1 Physical Function, 32 Virtual Functions
Leistungsaufnahme
maximal etwa 40 W
Umgebungstemperatur
0 bis 55 Grad Celsius
Gebaut wurde das Ding nicht für Workstations, sondern für Telco und Netzwerk: VPN-Konzentratoren, IPsec-Gateways, TLS-Terminierung, Deduplizierungs-Appliances. 50 Gbit/s Bulk-Krypto in einer Low-Profile-Karte war 2013 eine Ansage. Mein Lieblingsdetail aus dem Featureset ist aber ein anderes: die Karte kann Kasumi und Snow 3G in Hardware, also die Mobilfunkchiffren aus 3G und LTE. Das ist so wunderbar spezifisch, dass man sofort weiß, in welchem Blech sie eigentlich stecken sollte, und das ist bestimmt kein Tower unter einem Schreibtisch.
Kühlkörper ab: zwei Chips, nicht einer
Jetzt wird es hübsch. Unter dem Kühlkörper sitzen nämlich nicht ein großer Chip, sondern zwei, und dazu eine Leerstelle.
Links U5, der Coleto Creek als Flip-Chip ohne Heatspreader. Mittig U1, der PLX PEX 8724. Rechts neben dem Slotblech die leere Fläche, um die es weiter unten geht.
Links auf Position U5 liegt der Coleto Creek als Flip-Chip-BGA ohne Heatspreader. Das nackte Silizium liegt frei, man schaut direkt auf den Die. Das sieht man heute selten und es ist genau der Grund, warum ich den Kühlkörper überhaupt abgeschraubt habe.
Mittig auf U1 sitzt aber ein Chip, den ich dort nicht erwartet hätte: ein PLX Technology PEX8724-CA80BC G, Fertigungscode 1703, also Kalenderwoche 3 in 2017, gefertigt in Taiwan. Das ist ein PCIe-Gen3-Switch mit 24 Lanes und 6 Ports. Auf einer Karte, die nur einen einzigen Beschleunigerchip trägt, ist ein Switch zunächst mal erklärungsbedürftig.
Rechts, direkt neben dem Slotblech, liegt dann noch eine komplett unbestückte BGA-Fläche. Ein vollständiges, leeres Lötpad-Raster in Chipgröße. Da war offensichtlich mal etwas geplant.
Der leere Platz aus der Nähe. Ein Platz in Chipgröße, alles drumherum bestückt, nur hier fehlt der Chip.
Wenn man Switch und Leerstelle zusammennimmt, geht eine Rechnung verdächtig glatt auf:
PEX 8724 = 24 Lanes

  x8  Upstream zum Slot
+ x8  zum bestückten Coleto Creek (U5)
+ x8  zu einem weiteren, unbestückten Platz
= 24
Und der Kernel liefert dazu tatsächlich einen passenden Befund: der Downstream-Port c4:08.0 des Switches existiert, hat LnkCap Width x8 und ist untrainiert, also LnkSta Width x0. Da hängt nichts dran.
Und hier muss ich mich selbst bremsen, denn die Versuchung ist groß. Belegt ist nur: in der Switch-Konfiguration sind diesem Port acht Lanes zugewiesen, und es hängt nichts daran. Nicht belegt ist, dass diese acht Lanes zu dem leeren Platz führen. Das könnte genauso ein nie herausgeführter Port sein oder für etwas völlig anderes gedacht gewesen sein. Die Lötfläche macht die Deutung attraktiv, und mehr ist es nicht. Wer es wirklich wissen will, müsste die Lanes am Board durchmessen oder das EEPROM des PEX8724 auslesen und dort in die Port Configuration schauen. Beides habe ich nicht gemacht.
Genauso vorsichtig muss man mit der naheliegenden Erzählung sein, Intel habe hier dieselbe Platine für eine Dual-Chip-Variante vorgesehen. Das passt zur Namenslogik, das S in SCCP steht ja für Single, und es passt zum leeren Platz. Eine offizielle Bestätigung für ein 8950-DCCP oder Ähnliches habe ich trotzdem nicht gefunden. Also: plausible Deutung, kein Faktum.
Am Rand der Platine sitzt außerdem noch ein schwarzer, geschirmter Steckverbinder mit der Bezeichnung J8. Der macht das, was bei einer Grafikkarte der Zusatzstecker macht: Stromversorgung direkt vom Netzteil. Das passt zu den bis zu 40 Watt aus dem Datenblatt, denn ein PCIe-Steckplatz dieser Bauform liefert nach Spezifikation nur 25 Watt. Dazu mehrere Spannungsregler mit Speicherdrosseln, ein 100-MHz-Quarz und Siebdruck-Markierungen für x1, x4 und x8 am Kartenrand.
Einbau: erfreulich langweilig
Die Karte steckt jetzt in einem Slot mit PCIe 4.0 x8 an einem Xeon Gold 5315Y, unter Linux Mint mit Kernel 7.0. Und dann passiert genau das, was man sich von einem In-Kernel-Treiber wünscht: nichts Besonderes.
Kein Paket installiert, keine Firmware nachgeladen, keine Konfigurationsdatei, kein adf_ctl. Die Module qat_dh895xcc und intel_qat laden von allein, die Firmware qat_895xcc.bin.zst lag über linux-firmware längst auf der Platte. Zwölf Acceleration Engines starten, alle Selftests bestehen, der Heartbeat meldet sich gesund. Ein Chip von 2013 auf einer Karte von 2017 in einem Board von 2021 unter einem Kernel von 2026, und es ist ein Nichtereignis. Das ist ein starkes Argument für In-Tree-Treiber, und es wird weiter unten noch bitter kontrastiert.
Das debugfs-Verzeichnis ist die interessanteste Fundstelle der ganzen Karte. Dort liegt in dev_cfg die komplette, vom Treiber selbst generierte Instanzkonfiguration: 16 Krypto-Instanzen, 16 Kompressions-Instanzen, je Instanz 512 gleichzeitige symmetrische oder 128 asymmetrische Requests, dazu Interrupt-Coalescing und ein Heartbeat-Timer. In fw_counters stehen Requests und Responses pro Acceleration Engine, und das ist später mein Beweis, dass die Karte wirklich rechnet und nicht die CPU heimlich einspringt. Dazu heartbeat/status, cnv_errors und 32 Ring-Banks unter transport/.
Ein PCIe-Switch, der Generationen übersetzt
Jetzt löst sich auch auf, warum der PLX-Switch da ist. So sieht der Baum aus:
Host-seitig läuft die Karte mit Gen3 x8, also 8 GT/s. Chip-seitig kommen aber nur Gen2 x8 an, also 5 GT/s. Der Coleto Creek ist ein Gen2-Baustein, und damit die Karte am Steckplatz trotzdem als moderne Gen3-x8-Karte auftritt, sitzt der PEX 8724 als Übersetzer dazwischen. Der QAT-Endpunkt behauptet in seiner LnkCap sogar x16, verdrahtet sind aber acht Lanes.
Das ist der erste wirklich belastbare Befund des Tages: das Nadelöhr sitzt auf der Karte, nicht im Steckplatz und nicht in der CPU. Dafür braucht man die Dual-Chip-Spekulation von oben überhaupt nicht.
Zwei weitere Kleinigkeiten aus dem laufenden System, die ich hübsch finde. Die Karte sitzt allein in ihrer IOMMU-Gruppe und unterstützt Function Level Reset, sie lässt sich also ohne ACS-Override-Gebastel per VFIO an eine VM durchreichen. Und sie meldet 32 Virtual Functions, aktiv sind davon null.
Der praktisch wichtigste Nebeneffekt des Einbaus hat aber gar nichts mit Krypto zu tun. Der PLX-Switch belegt vier Busnummern, und dadurch ist meine NVMe von c3:00.0 auf c7:00.0 gewandert. Auf der alten Adresse sitzt jetzt der Upstream-Port des Switches. Ich hatte mir ein setpci-Kommando mit der alten Adresse notiert, und das hätte nach dem Einbau munter in die Register des Switches geschrieben statt in die der SSD. Merke: PCI-Adressen sind nichts, was man sich aufschreibt. Die holt man sich jedes Mal frisch aus lspci. Ist ja jetzt nicht so, als wenn mir das schon mal untergekommen ist bzw. ich so was gefettfingert habe 😛
Die Prioritäten-Tabelle, oder: der Kernel hat schon entschieden
Der Treiber registriert zehn Algorithmen in der Crypto-API des Kernels, alle mit selftest: passed:
Diese Prioritäten sind die halbe Geschichte des Beitrags. Die Linux Crypto API wählt bei gleichem Algorithmusnamen immer die Implementierung mit der höchsten Priorität. Wenn man das mit den CPU-Implementierungen auf derselben Maschine vergleicht, wird es sehr deutlich:
Algorithmus
QAT
bester CPU-Wert
wer gewinnt
xts(aes)
100
xts-aes-vaes-avx2 = 600
CPU
cbc(aes)
100
cbc-aes-aesni höher
CPU
authenc(...)
100
CPU-Kombis höher
CPU
rsa
1000
rsa-generic = 100
Karte
dh
1000
dh-generic = 100
Karte
deflate
4001
deflate-generic = 0
Karte
Übersetzt heißt das: für symmetrische Massenverschlüsselung wird diese Karte nie von allein benutzt. Für rsa, dh und deflate dagegen immer. Das ist kein Zufall und kein Konfigurationsfehler, sondern eine Aussage der Kernel-Entwickler darüber, wo Offload bei einer aktuellen CPU überhaupt noch etwas bringt. Man kann diese Tabelle lesen wie ein Urteil über die Karte, und genau so ist sie auch gemeint.
Ein Detail nur mit Vorsicht: pkcs1(qat-rsa,sha512) steht mit Priorität 1000 registriert und hat den Selftest bestanden. Daraus folgt noch nicht, dass Kernel-Modul-Signaturprüfung tatsächlich über die Karte läuft. Die Registrierung macht es möglich, die Priorität spricht dafür, aber um es zu belegen müsste man den Verifikationspfad tracen und dabei die Zähler in fw_counters beobachten. Habe ich nicht gemacht, also behaupte ich es auch nicht.
Bevor die Zahlen kommen: was meine Messung nicht zeigt
Diesen Absatz gibt es, weil die Tabellen danach sonst präziser wirken als sie sind. Wer mir eine Zahl vorhält, soll wissen, wie sie entstanden ist.
Alle Kryptomessungen laufen über AF_ALG aus einem Python-Skript mit einem synchronen Request-Loop. Das ist ungefähr der Worst Case für eine asynchrone Offload-Karte: pro Request wird gewartet, statt die Queue tief zu halten, für die die Hardware gebaut wurde. Die Zahlen charakterisieren also diesen Zugangsweg, nicht die Karte an sich.
Kein Warmup, keine Wiederholungen, keine Streuung, kein CPU-Pinning. Angaben mit einer Nachkommastelle tragen eine Genauigkeit, die statistisch nicht gedeckt ist. Für belastbare Latenzen bräuchte es Median und P95 über mehrere Läufe.
Die Skalierung über Worker nutzt Prozesse, nicht Threads. Kontextwechsel und Speicherkopien gehen also mit in die Zahl ein.
cryptsetup benchmark ist selbst nur ein Indikator. Es misst im Speicher über die Crypto-API und ist laut eigener Manpage nicht direkt auf reale Storage-Verschlüsselung übertragbar.
Hart sind dagegen die fw_counters. Die kommen aus der Hardware und belegen, dass und wie oft die Karte gerechnet hat. Und die Form der Ergebnisse ist robust: Latenz pro Request hoch, Skalierung über Worker fast linear, CPU bei kleinen Blöcken weit vorn. Nur die absoluten Werte sind weich.
Als Gegner steht bewusst der ungünstigste Fall für die Karte: ein Xeon Gold 5315Y mit acht Kernen und vollem VAES-Befehlssatz. Wenn eine 13 Jahre alte Karte gegen die Rechenwerke einer aktuellen CPU antritt, dann bitte richtig.
Ein Strom, synchron: die Karte verliert deutlich
Zuerst die CPU-Basislinie mit cryptsetup benchmark, damit die Größenordnung steht:
aes-cbc   128b   1168,2 MiB/s enc   3936,0 MiB/s dec
aes-cbc   256b   1004,5 MiB/s enc   3729,8 MiB/s dec
aes-xts   256b   5494,4 MiB/s enc   5510,1 MiB/s dec
aes-xts   512b   5045,2 MiB/s enc   5053,6 MiB/s dec
Und dann der direkte Vergleich über AF_ALG, ein einzelner synchroner Strom:
Implementierung
Block
Durchsatz
Latenz pro Operation
xts-aes-vaes-avx2
4 KiB
1157,2 MiB/s
3,4 µs
xts-aes-vaes-avx2
16 KiB
2681,2 MiB/s
5,8 µs
xts-aes-vaes-avx2
64 KiB
4327,2 MiB/s
14,4 µs
qat_aes_xts
4 KiB
100,3 MiB/s
38,9 µs
qat_aes_xts
16 KiB
244,9 MiB/s
63,6 µs
qat_aes_xts
64 KiB
308,8 MiB/s
201,6 µs
cbc-aes-aesni
4 KiB
583,5 MiB/s
6,7 µs
qat_aes_cbc
4 KiB
79,8 MiB/s
48,9 µs
Pro Einzelrequest ist die Karte also grob elfmal langsamer als die CPU, ungefähr 39 gegen 3,4 Mikrosekunden bei 4 KiB. Für ein Bauteil, das mal genau dafür gekauft wurde, ist das eine ernüchternde Zahl.
Nur: das ist nicht die Hardwarelatenz der Karte. Gemessen ist die Latenz dieses Pfades, und der ist lang: Python, sendmsg über AF_ALG, Socket-Puffer, Kernel-Copy, Treiber, PCIe, Karte, und alles wieder zurück, plus Scheduling und Aufwecken des wartenden Prozesses. Ein erheblicher Teil davon kann im Socket-Pfad stecken. Die CPU-Variante läuft durch denselben Overhead, profitiert aber davon, dass sie synchron im selben Kontext rechnet und überhaupt nicht schlafen muss. Belastbar ist deshalb nur die relative Aussage für diesen Zugangsweg und die Form der Kurve. Wer die reine Hardwarelatenz will, braucht ein Frontend ohne Socket-Umweg, also praktisch den Userspace-Stack, und der existiert für diesen Chip nicht mehr. Dazu unten mehr. Das ist eine Messlücke, die ich mit den vorhandenen Mitteln nicht schließen kann, und ich schreibe sie lieber hin als sie zu verstecken.
Viele Ströme: jetzt zeigt sie, wofür sie gebaut wurde
Und dann wird es doch noch spannend. Dieselbe Messung mit parallelen Workern, Blockgröße 16 KiB:
Worker
qat_aes_xts
xts-aes-vaes-avx2
1
210,7 MiB/s
2632,6 MiB/s
2
454,1 MiB/s
5311,9 MiB/s
4
799,3 MiB/s
10777,5 MiB/s
8
1714,5 MiB/s
22056,0 MiB/s
16
2926,7 MiB/s
25229,7 MiB/s
Die Karte skaliert von einem auf 16 Worker um fast Faktor 14, also nahezu linear, und bei 16 Workern war sie noch nicht am Ende. Das ist exakt das Verhalten, für das so ein Baustein entworfen wurde: viele gleichzeitige, unabhängige Operationen, keine einzelne schnelle. Eine Karte in einem Loadbalancer sieht nie einen Strom, sie sieht tausende.
Nur skaliert die CPU eben auch. Und sie landet am Ende 8,6 mal höher. Das ist der ganze Punkt dieses Beitrags in einer Zahl. So fertig, feierabend, einpacken!
Dass wirklich die Karte gerechnet hat und nicht heimlich doch die CPU, zeigen die Firmware-Zähler nach dem Lauf:
Alle zwölf Acceleration Engines haben gearbeitet, Requests und Responses stimmen überall überein, kein verlorener Request. Die Verteilung ist nicht gleichmäßig, sondern fällt in Dreiergruppen von etwa 154k, 94k und 90k. Das kommt von der Zuordnung Ring-Bank zu Engine und ist so ein Detail, an dem man beim Lesen kleben bleibt.
Wo der Deckel liegen könnte, und warum ich mich da nicht festlege
Die 2926,7 MiB/s liegen auffällig nah an der Kapazität des internen Links:
2926,7 MiB/s Nutzdaten = 3069 MB/s
Jedes Byte muss zweimal über den Bus: rein zum Verschlüsseln, raus als Chiffrat.
Gen2 x8 = 5 GT/s x 8 Lanes x 8/10 = 4000 MB/s pro Richtung
3069 / 4000 = 77 % der theoretischen Richtungskapazität
77 Prozent Nutzlast auf einem PCIe-Link sind praktisch der Anschlag, mit dem TLP-Overhead bei 256 Byte MaxPayload liegt das erreichbare Maximum bei etwa 85 bis 90 Prozent. Das sieht also sehr nach einem Bus-Limit aus.
Aber: meine Messung kann das nicht trennen. Sie zeigt, dass dieser Zugangsweg in der Nähe eines Ceilings landet, und sie kann nicht sagen, ob das der PCIe-Link, der Treiber oder AF_ALG ist. Die Rechnung oben ist ein Plausibilitätsargument, keine Messung des Busses. Sauber wäre es, PCIe-Bandwidth-Events über die Uncore-Zähler mitzuschreiben. Das ist der wichtigste offene Messpunkt in diesem Beitrag, weil eine der Hauptaussagen daran hängt.
Noch eine Rechnung, die verlockend glatt aufgeht und bei der man aufpassen muss. Die gemessenen 2926,7 MiB/s sind 24,6 Gbit/s, das Datenblatt sagt 50 Gbit/s, das sind fast genau 49 Prozent. Und verdrahtet sind acht von 16 Lanes, also genau die Hälfte. Der Kurzschluss liegt auf der Zunge, und er ist falsch: „mit x16 wäre man auf dem Datenblattwert“ und „die Platine war für zwei Chips gedacht“ sind zwei verschiedene Hypothesen, nicht eine. In einer Dual-Chip-Bestückung bekäme jeder Chip x8, keiner käme je auf x16, und das Nadelöhr wäre dann der gemeinsame Gen3-x8-Upstream. Rechnerisch landet man auf beiden Wegen bei ungefähr 49 Gbit/s, aber über völlig verschiedene Mechanismen. Wer das zusammenrührt, argumentiert falsch, auch wenn das Ergebnis stimmt. Die Karte selbst hat ja auch nur einen PCIe 8x Anschluss.
Und es gibt eine zweite Lesart, an der der ganze Vergleich mit dem Marketing hängt. Wenn Intels 50 Gbit/s als Summe beider Richtungen gemeint sind, also 25 rein und 25 raus, dann reicht Gen2 x8 dafür aus, und meine gemessenen 24,6 Gbit/s pro Richtung sind aggregiert 49,2 Gbit/s. Dann lautet der richtige Satz nicht „die Karte erreicht die Hälfte“, sondern „die Karte erreicht ihre Spezifikation“. Intel dokumentiert nirgends, wie gezählt wird, also ist das aus den vorliegenden Unterlagen nicht entscheidbar. Die 24,6 Gbit/s stehen fest, nur ihre Deutung hängt an einer undokumentierten Konvention. Natürlich kann ich auch einfach dran vorbei gelesen haben oder ich messe falsch. Korrigiert mich gerne, dann lerne ich selbst etwas \o/
Und jetzt die Enttäuschung: dm-crypt will nicht
Der naheliegendste Anwendungsfall, und ausgerechnet genau der, für den die Karte in meinem FreeBSD-Server gearbeitet hat, funktioniert unter aktuellem Linux nicht:
# cryptsetup plainOpen /dev/ram0 probe --cipher capi:qat_aes_xts-plain64 --key-size 512 --key-file /dev/zero
device-mapper: reload ioctl on probe (252:3) failed: Datei oder Verzeichnis nicht gefunden
Der erste Reflex ist natürlich, dass ich den Namen falsch geschrieben habe. Also Gegenprobe mit derselben capi:-Syntax über sieben Varianten:
Angabe bei --cipher
Ergebnis
aes-xts-plain64
funktioniert
capi:xts(aes)-plain64
funktioniert
capi:xts-aes-aesni-plain64
funktioniert
capi:xts-aes-vaes-avx2-plain64
funktioniert
capi:xts-aes-vaes-avx512-plain64
funktioniert
capi:qat_aes_xts-plain64
Fehler, ENOENT
capi:qat_aes_cbc-plain64
Fehler, ENOENT
dm-crypt kann also sehr wohl einen konkreten Treiber adressieren, sogar xts-aes-vaes-avx512, das mit seiner niedrigen Priorität sonst nie zum Zug käme. Nur die beiden QAT-Treiber fliegen raus. Das ist kein Tippfehler und keine Namensauflösung.
Der Beweis kommt aus dem laufenden Kernel selbst, ausgelesen über die NETLINK_CRYPTO-Schnittstelle. Das ist die belastbare Quelle, denn sie sagt, was dieser Kernel registriert hat, und nicht, was irgendeine Quelldatei im Netz behauptet:
Der Unterschied ist genau ein Bit: 0x00010000, also CRYPTO_ALG_ALLOCATES_MEMORY. Alle symmetrischen QAT-Implementierungen haben es, keine einzige CPU-Implementierung hat es. Die niedrigen Bits sind übrigens kein Flag, sondern der Algorithmustyp.
Und dm-crypt fordert seine Transforms genau mit diesem Bit als Maske an, an drei Stellen im Code:
Die Suche findet damit nichts und liefert ENOENT, und das kommt oben als „Datei oder Verzeichnis nicht gefunden“ an. Kette geschlossen, keine Hypothese mehr. Dass qat-rsa das Flag nicht hat, passt genau ins Bild: RSA läuft über die Karte, weil es kein Block-I/O-Pfad ist.
Die Wendung: das ist eine Leitplanke, kein Bürokratiefehler
An dieser Stelle wollte ich anfangen zu schimpfen. Die Karte kann AES-XTS in Hardware, der Kernel registriert es, und der eine Konsument, für den es gedacht war, weigert sich. Klingt nach Linux, das sich selbst im Weg steht. Ist es aber nicht.
Die Maske stammt von Mikulas Patocka, und die Begründung im Commit ist knapp:
Don’t use crypto drivers that have the flag CRYPTO_ALG_ALLOCATES_MEMORY set. These drivers allocate memory and thus they are unsuitable for block I/O processing.
Der Grund dahinter ist ein Low-Memory-Deadlock. Stell dir vor, es wird auf ein dm-crypt-Gerät geswappt. Der Kernel will Speicher freimachen, schickt die Swap-Out-BIO durch dm-crypt, dm-crypt fragt die Crypto-API, und die fordert daraufhin Speicher an, den es gerade nicht gibt. Ende der Vorstellung.
Und mit QAT ist genau das schon einmal schiefgegangen. Im März 2022 gibt es einen Bericht auf der Kernel-Mailingliste über massive Datenkorruption mit QAT plus dm-crypt plus XFS. Die Diagnose kam von Giovanni Cabiddu, Intel:
The implementations of aead and skcipher in the QAT driver are not properly supporting requests with the CRYPTO_TFM_REQ_MAY_BACKLOG flag set. If the HW queue is full, the driver returns -EBUSY but does not enqueue the request.
Die Folge: dm-crypt wartet endlos auf die Completion eines Requests, der nie an die Hardware gegangen ist. Und das Dateisystem war hinüber. Das ist kein theoretisches Risiko, das ist ein Schadensfall mit Datum.
Die Zeitleiste danach ist lehrreich, weil sie nicht so endet, wie man denkt:
Datum
Was passiert
Juli 2020
Das Flag CRYPTO_ALG_ALLOCATES_MEMORY wird auf QAT gesetzt
Juli 2020
dm-crypt schließt Treiber mit diesem Flag aus (Patocka)
März 2022
Der Schadensfall: Datenkorruption mit QAT, dm-crypt und XFS
Mai 2022
Intel liefert den eigentlichen Fix, ein Backlog-Mechanismus
Juli 2023
Intel will das Flag entfernen, um QAT für dm-crypt zurückzuholen. Nie gemerged.
Juni 2025
Stattdessen: Priorität von Skcipher und AEAD wird von 4001 auf 100 gesenkt
August 2026
Auf meinem Kernel gemessen: Flag gesetzt, Priorität 100, dm-crypt verweigert
Die Auflösung war also nicht „dm-crypt darf QAT wieder benutzen“, sondern „QAT wird per Priorität aus dem Weg geräumt“. Und die Begründung in diesem Commit ist der stärkste Absatz, den ich zu dieser Karte gelesen habe:
Most kernel applications utilizing the crypto API operate synchronously and on small buffer sizes, therefore do not benefit from QAT acceleration. Reduce the priority of QAT implementations for both skcipher and aead algorithms, allowing more suitable alternatives to be selected by default.
„Synchron und kleine Puffer“ ist exakt das, was ich oben unabhängig gemessen habe, 39 gegen 3,4 Mikrosekunden bei 4 KiB. Der Kernel hat 2025 formal festgestellt, was meine Messung 2026 auf dieser Maschine bestätigt. Und der Patch, der Intels eigene Hardware degradiert, kommt von Intel, mit Acked-by von Eric Biggers. Wenn man es wohlwollend liest, ist das ein Hersteller, der ehrlich ist. Zur Version muss man genau sein: der Commit ging in Mainline 6.17, wurde aber wegen Cc: stable auch in ältere Stable-Zweige zurückportiert, war dort also schon vor dem 6.17-Release wirksam.
Und damit ist die Pointe eine viel bessere als „Linux ist im Weg“: was wie eine willkürliche Blockade aussieht, ist eine Leitplanke aus einem echten Schadensfall. Das erklärt übrigens auch, warum FreeBSD hier lockerer war. Dort gibt es diese Leitplanke nicht, es gibt keine Priority-Hierarchie, die den Beschleuniger aussortiert, und keine Maske, die ihn vom Blockgerät fernhält. Das heißt allerdings nicht, dass das Problem dort nicht existiert. Es heißt nur, dass niemand ein Geländer davor gebaut hat.
Ein Blick auf die FreeBSD-Seite lohnt an dieser Stelle sowieso, denn dort ist der Weg ein struktureller anderer. qat(4) ist ein Treiber für das OpenCrypto-Framework, also für crypto(9). Wer GELI benutzt, muss überhaupt nichts umkonfigurieren: GELI fragt das Framework, und das Framework nimmt den Beschleuniger. Deshalb war die Sache damals auch so unspektakulär, ich habe die Karte gesteckt und die Platten waren schneller.
Ganz so glatt war die Historie allerdings nicht. Im Basissystem gibt es qat(4) erst seit FreeBSD 13.0, und in 14.0 wurde dieser Treiber durch Intels Upstream-Variante ersetzt. Auf dem ersten Server, der noch älter war, kann es diesen Weg also nicht gegeben haben. Die aktuelle Manpage führt die Serie 8925 bis 8955 weiterhin als unterstützte Hardware, dieser Chip ist dort also nicht rausgefallen. Und noch etwas gegen zu viel Nostalgie: im FreeBSD-Forum gibt es einen Thread zur GELI-Performance, in dem QAT zunächst schlechter war als AES-NI. Erst nach dem Umstellen der QAT-Services berichtete der Autor rund 30 bis 34 Prozent Vorsprung bei AES-XTS mit SHA256, und bei anderen Lasten blieben Verluste. Die Karte war also auch damals kein bedingungsloser Gewinn, sondern eine, die zur Konfiguration passen musste.
Der zweite Dämpfer: Intels Userspace hat die Karte fallengelassen
Bleibt der andere große Anwendungsfall: TLS-Terminierung mit nginx oder HAProxy, OpenSSL-Offload. Dafür braucht man qatlib und dazu die QAT-Engine oder den Provider für OpenSSL. Auf meinem System ist davon nichts installierbar, kein Kandidat in den Repos, und OpenSSL 3.0.13 kennt nur den Default-Provider.
Schlimmer als „nicht gepackt“ ist aber der Grund: Intel hat dh895xcc aus qatlib entfernt. Die aktuellen Versionen unterstützen nur noch QAT Gen4, also die 4xxx- und 420xx-Serien. Die frühen Generationen sind nicht mehr dabei. Der Weg wäre der alte Out-of-Tree-Stack, und der baut gegen einen Kernel 7.0 nicht mehr.
Ich formuliere das bewusst nicht als „tot“. Behauptet ist: für diesen Chip ist der heutige Mainstream-Linux-Userspace praktisch abgehängt. Nicht behauptet ist, dass es global unmöglich wäre. Mit altem Kernel, altem Out-of-Tree-Treiber und passender Distribution ließe sich der Stack sicher noch aufbauen, und ältere DPDK-Versionen führten dh895xcc als unterstütztes Gerät. Es ist eine Frage von Aufwand und Kernel-Alter, nicht von Unmöglichkeit.
Die Ironie daran ist schön bitter. Intels eigener Userspace hat die Karte längst aufgegeben, während der Linux-Kernel sie weiter pflegt und beim Booten ohne ein einziges Paket zum Laufen bringt. Wer wissen will, warum In-Tree-Treiber so wertvoll sind: das hier ist der Beweis in einer Karte.
Ein dritter Befund noch, damit ihn niemand für einen Kartenfehler hält: ein einzelnes sendmsg über AF_ALG mit 256 KiB oder mehr blockiert dauerhaft. Aufgefallen ist mir das erst mit der Karte bei 1 MiB, reproduzieren lässt es sich aber mit dem CPU-Cipher genauso. Es ist also nicht die Hardware. Wo genau im AF_ALG-Pfad es hängt, habe ich nicht nachgewiesen, der Socket-Sendepuffer wäre die naheliegende Vermutung, aber eben eine ungeprüfte. Alle Messungen oben sind deshalb auf maximal 64 KiB begrenzt.
Kompression: der einzige Pfad, der von allein läuft, und er schadet
Erinnerst du dich an qat_deflate mit Priorität 4001 gegen deflate-generic mit 0? Jeder Kernel-Konsument, der nach deflate fragt, bekommt die Karte. Realistisch ist das zswap, die komprimierte Auslagerung im RAM.
Also nachgestellt: eine cgroup mit hartem Speicherlimit, 700 MiB gut komprimierbare anonyme Seiten, zswap auf deflate. Und tatsächlich, die Karte komprimiert die Auslagerung, 130.108 Firmware-Requests belegen das. Nur ist der direkte Vergleich bei gleicher Last ziemlich brutal:
zswap-Compressor
wall
user
sys
QAT-Requests
lzo (CPU)
0,85 s
0,11 s
0,72 s
0
deflate (QAT)
9,47 s
0,26 s
5,13 s
130.027
Elfmal langsamer. Und die System-CPU-Zeit steigt sogar von 0,72 auf 5,13 Sekunden, das Offload spart also nicht einmal CPU, es kostet zusätzlich welche. Der Grund ist derselbe wie überall in diesem Beitrag: zswap komprimiert eine 4-KiB-Seite pro Request, und das ist genau der Latenz-Worstcase.
Fair bleiben muss ich hier trotzdem: der Vergleich mischt zwei Effekte, denn Deflate ist algorithmisch auch schlicht teurer als LZO. Sauber wäre deflate auf CPU gegen deflate auf der Karte, und das habe ich nicht gemessen, weil sich deflate-generic bei Priorität 0 nicht ohne Weiteres erzwingen lässt. Die Aussage „QAT-zswap ist keine gute Idee“ trägt der Test, die Aufteilung zwischen Algorithmus und Latenz nicht.
Bleibt eine Frage, die ich hübsch finde: warum steht deflate überhaupt noch auf 4001? In der Datenkorruptions-Diskussion von 2022 schlug Intel vor, die Priorität der betroffenen Algorithmen auf 1 zu senken. Heute stehen Skcipher und AEAD bei 100, die Kompression aber weiter bei 4001. Die naheliegende Deutung: 4001 war ursprünglich die Politik „nimm immer den Beschleuniger“, sie wurde für Krypto nach dem Vorfall zurückgenommen und für Kompression nie. Damit wäre qat_deflate der letzte Überrest dieser alten Haltung, und ausgerechnet der Pfad, der heute noch stillschweigend gewinnt und dabei elfmal langsamer ist. Das ist allerdings meine Deutung, kein Beleg. Die Commit-Historie der Prioritätswerte für die Kompression habe ich nicht nachverfolgt.
Wer das nachbauen will: den Zustand danach wieder zurücksetzen, also enabled=N und compressor=lzo. Ein Dauerbetrieb mit dieser Einstellung wäre eine echte Verschlechterung der Maschine.
Die unvermeidliche Frage: kann man damit Bitcoin oder Monero minen?
Nein. Und zwar aus zwei völlig verschiedenen Gründen, und dieser Unterschied ist der eigentlich interessante Teil.
Monero geht prinzipiell nicht, nicht bloß langsam. Monero nutzt seit 2019 RandomX, und der Algorithmus wurde absichtlich so entworfen, dass Spezialhardware keinen Vorteil hat. Er generiert zur Laufzeit zufällige Programme aus Integer-, Fließkomma- und Branch-Instruktionen und führt sie in einer VM aus, teils JIT-compiliert. Er braucht 2 MiB Scratchpad pro Thread, permanent random-access beschrieben und gelesen. Und im Fast-Mode zusätzlich einen Datensatz von rund 2,08 GiB im RAM, aus dem die VM ständig liest. Das macht RandomX speichergebunden statt rechengebunden, und deshalb sind ASICs dort wirtschaftlich uninteressant.
Die QAT-Karte ist das exakte Gegenteil davon: eine Festfunktions-Pipeline. Sie kann AES, SHA, RSA, DH und Deflate, und nichts sonst. Sie hat keinen Befehlssatz, kein Scratchpad-Konzept und keinen Zugriff auf einen 2-GiB-Arbeitsdatensatz. AES kommt in RandomX zwar vor, aber als eingebetteter Schritt in der VM-Schleife, nicht als abtrennbare Massenoperation, die man an einen Coprozessor auslagern könnte. Die CPU dieser Maschine kann RandomX übrigens sehr wohl. Der Algorithmus ist ja genau für CPUs gemacht.
Bitcoin geht theoretisch, praktisch ist es absurd. Bitcoin ist doppeltes SHA-256 über einen 80 Byte großen Blockheader, und SHA-256 kann die Karte. Nur scheitert es an zwei harten Punkten.
Erstens ist es über diesen Stack nicht einmal ansprechbar. Der In-Kernel-Treiber registriert kein reines SHA-256, sondern nur authenc(hmac(sha256),cbc(aes)), also HMAC-authentifizierte Verschlüsselung. Nackte Hashes bekäme man nur über den Userspace-Stack, und der existiert für diesen Chip nicht mehr. Es gibt also gar keinen Weg, der Karte einen Blockheader zum Hashen zu geben.
Zweitens ist die Größenordnung hoffnungslos, und dafür genügt eine geschenkte Obergrenze. Selbst wenn die Karte ihre volle Datenblattleistung als reines Hashing liefern könnte, landet man bei realistischen 64 bis 128 Byte pro Hash-Operation in der Größenordnung von 10⁷ bis 10⁸ Hashes pro Sekunde, also höchstens einige zehn MH/s. Erreichen wird sie das nie, die gemessenen Latenzen zeigen ja, dass sie bei kleinen Nutzlasten zwei Größenordnungen unter ihrem Sweet Spot arbeitet.
Hashrate
Charakter der Zahl
QAT 8950
höchstens 10⁸ H/s
unerreichbare Obergrenze
ein aktueller ASIC-Miner
etwa 2 mal 10¹⁴ H/s
Produktangabe
Bitcoin-Gesamtnetz, 03.08.2026
9,3 mal 10²⁰ H/s
gemessen, 932 EH/s
Selbst mit der geschenkten Obergrenze liegt ein einzelner ASIC noch um mindestens sechs Größenordnungen über der Karte, und das Gesamtnetz um dreizehn. Der Anteil am Netz wäre günstigstenfalls in der Größenordnung 10⁻¹³, bei zehn Minuten Blockzeit also eine erwartete Wartezeit jenseits jeder sinnvollen Zeitskala, bei 40 Watt Dauerlast. Ich verzichte hier absichtlich auf eine konkrete Jahreszahl. Die klingt zwar gut, wäre aber Scheinpräzision auf einer geschätzten Grundlage. Größenordnungen sind hier die ehrlichere Währung, und sie sind genauso eindrucksvoll.
Die eigentliche Pointe ist aber eine sprachliche. Krypto-Beschleuniger heißt Kryptographie, nicht Kryptowährung. Die Karte ist für das gebaut, was Verbindungen und Platten schützt: TLS-Handshakes, IPsec-Tunnel, AES-XTS auf Blockgeräten. Dass beide Bedeutungen dasselbe Wort benutzen, ist ein Sprachunfall, und ich bin ziemlich sicher, dass er der Kryptographie mehr geschadet hat als der Kryptowährung.
Betrieb: man fliegt thermisch blind
Eine praktische Warnung, falls jemand auf die Idee kommt, so ein Ding in einen Desktop zu stecken: die Karte hat keinen Temperatursensor.sensors zeigt nichts, der BMC kennt sie nicht, in der SDR steht kein Eintrag. Man sieht also nicht, wie warm sie wird.
Und die Randbedingungen sind ungünstig: der Kühlkörper ist rein passiv und für den Querstrom eines Rackgehäuses ausgelegt, spezifiziert sind 0 bis 55 Grad Umgebungstemperatur, es dürfen bis zu 40 Watt Verlustleistung sein, und mein Gehäuse ist auf Ruhe optimiert, mit bewusst langsam drehenden Lüftern. Die Netzwerkkarte im Nachbarslot liegt schon im Leerlauf bei 61 Grad, und die beiden teilen sich denselben schlechten Luftstrom. Wie warm die Karte unter der Last aus diesem Beitrag wirklich geworden ist, weiß ich nicht. Ohne Sensor bräuchte es ein IR-Thermometer oder ein Thermoelement. Steht auf der Liste.
Überflüssig gewordene Technik, und warum mir das trotzdem naheliegt
Diese Karte ist für mich so etwas wie eine Soundkarte. Es gab eine Zeit, da war eine dedizierte Soundkarte selbstverständlich, weil der Rest der Maschine das einfach nicht konnte. Ich hänge immer noch an den alten Creative-Karten, nicht nur an den ISA-Dingern, auch an den späteren. Die hatten eine Wertigkeit, ein Gewicht, eine Bestückung, die man ansehen konnte. Man hat ein Bauteil gekauft, das eine Aufgabe hatte, und das hat man auch gesehen.
Heute steckt in meiner Workstation nicht einmal mehr eine Onboard-Lösung im Einsatz, sondern ein Behringer 302USB, also ein kleines Mischpult mit USB-Audiointerface. Für meinen Fall reicht das absolut. Die Aufgabe ist nicht verschwunden, sie hat nur ihren Platz gewechselt, und die CPU rechnet das nebenbei mit, ohne dass es jemandem auffällt. Genau das ist mit Krypto passiert. AES-NI und VAES haben die Beschleunigerkarte nicht besiegt, sie haben sie aufgesogen.
Immer kleiner, komplexer und leistungsfähiger ist total geil. Ohne diese Entwicklung gäbe es die Hälfte von dem nicht, was wir heute technisch machen. Aber sie macht das Verstehen sehr viel schwieriger. Mein alter C64 und der VC20 davor, die Dinger hat man noch verstanden. Eine CPU mit rund einem Megahertz in einem 40-Pin-Gehäuse, groß genug und langsam genug, dass man mit dem Oszilloskop an einzelne Pins konnte und dabei etwas gesehen hat. Man konnte am Speicher nachmessen. Das war begreifbar im wörtlichen Sinn. An dem Xeon in dieser Maschine messe ich nichts nach. Der Die ist unter einem Heatspreader, die Signale sind differentiell und liegen im Gigahertzbereich, und selbst wenn ich rankäme, wäre mein Oszilloskop zu langsam. Dass bei dieser Karte das nackte Silizium offen liegt, ist ein Zufall der Bauform, und trotzdem freut es mich jedes Mal.
Dafür haben wir heute AI, um uns Dinge erklären zu lassen, und das ist ein echter Gewinn. Ich komme damit an Ecken, an die ich vor zehn Jahren nur mit sehr viel mehr Zeit gekommen wäre. Wir müssen nur alle aufpassen, dass wir dabei nicht aufhören zu verstehen. Der Unterschied zwischen „ich habe es erklärt bekommen“ und „ich habe es verstanden“ ist genau der Unterschied zwischen diesem Beitrag und einer Feature-Liste. Und ein Teil davon passiert ja bereits in der AI-Entwicklung selbst: wir verstehen nicht mehr im Detail, was in diesen Systemen passiert. Stand jetzt halte ich das für ein Problem. Vielleicht ist es aber auch bald einfach das Normale, und ich bin der Typ, der dem Oszilloskop nachtrauert.
Ehrliche Gesamteinschätzung
Als Produktivkomponente ist die Karte in dieser Maschine sinnlos. Eine einzige moderne CPU der Einstiegsklasse schlägt sie bei symmetrischer Krypto um Faktor 8,6, der Anwendungsfall, für den sie gekauft wurde, ist unter Linux versperrt, Intels Userspace hat sie aufgegeben, sie zieht laut Datenblatt bis zu 40 Watt für etwas, das die CPU besser kann, und gekühlt wird sie für einen Luftstrom, den mein Gehäuse nicht liefert.
Als Lehr- und Erzählobjekt ist sie ausgezeichnet. An diesem einen Stück Platine lassen sich Krypto-Offload als Architektur, Latenz gegen Durchsatz, warum Queue-Tiefe alles ist, PCIe-Generationen und Lane-Budgets, PCIe-Switches, SR-IOV, IOMMU-Gruppen und die Prioritätslogik der Linux Crypto API erklären. Ich kenne wenige Bauteile, die auf so kleiner Fläche so viele Anknüpfungspunkte haben. Und sie funktioniert einfach, nach 13 Jahren, ohne ein einziges installiertes Paket.
Genau diese Spannung war der Grund, sie überhaupt noch einmal einzustecken.
Was offen bleibt
Die Karte per VFIO an eine FreeBSD-VM durchreichen und dort GELI auf QAT laufen lassen, also die Original-Nutzung rekonstruieren. Sie ist allein in ihrer IOMMU-Gruppe, technisch steht dem nichts im Weg. Das ist der Versuch, auf den ich am meisten Lust habe.
SR-IOV aktivieren und sehen, was der Treiber mit 32 Virtual Functions macht. Völlig ungetestet.
PCIe-Zähler messen, um zu belegen oder zu widerlegen, dass wirklich der Bus limitiert und nicht der Zugangspfad. Der wichtigste offene Messpunkt.
Die Benchmarks methodisch nachziehen: Warmup, mehrere Läufe, Median und P95, CPU-Pinning.
Kernel-RSA über die Karte messen.qat-rsa gewinnt per Priorität, aber es gibt keinen AF_ALG-Zugang zu akcipher.
Temperatur und echte Leistungsaufnahme, beides nur extern messbar.
Das PLX-EEPROM auslesen, um die Lane-Aufteilung zu belegen statt zu vermuten.
Hast du so eine Karte noch im Einsatz, vielleicht sogar noch produktiv? Dann würde mich das wirklich interessieren, und ihr dürft mich sehr gerne fragen.
Anfang März habe ich hier beschrieben, wie ich den NEXT Biometrics NB-2020-U in meinem Fujitsu Notebook unter Linux zum Laufen gebracht habe. Die ganze Arbeit lief am Ende auf eine einzige Product ID hinaus: 0x2020 im bestehenden nb1010 Treiber, weil der NB-2020-U denselben Sensor Die wie der NB-1010-U nutzt. Der Beitrag endete mit dem üblichen Cliffhanger: Merge Request eingereicht, CI grün, warten auf das Review durch die Maintainer.
Marco Trevisan, einer der libfprint Maintainer, hat den Patch auf den aktuellen master rebased, die Pipeline noch einmal durchlaufen lassen und ihn am 2. Juli 2026 per Auto-Merge aufgenommen (Commit 0fa670f). Blockierende Review-Kommentare gab es keine. Der Patch war klein und die Beweislage eindeutig: gleicher Sensor, gleiches USB Protokoll, gleicher Treiber, nur eine zusätzliche ID in der Tabelle.
Was das für Betroffene heißt
Für alle mit demselben Fingerabdruckleser im Notebook: Ab der nächsten libfprint Version wird der NB-2020-U out of the box erkannt. Kein eigener Patch mehr, kein Selberbauen. Enrollment und Verifikation über fprintd laufen dann direkt, sobald die Distribution die neue libfprint Version ausliefert. Wer nicht warten möchte, nimmt weiterhin den Patch aus dem ersten Beitrag oder baut direkt vom aktuellen master.
Der zweite Leser aus derselben Familie, der NB-2033-U mit seinem komplett eigenen Protokoll, hat einen eigenen Treiber von Grund auf bekommen. Dieser Merge Request !574 liegt noch beim Review, ist aber frisch auf den neuen master rebased und die Pipeline ist grün. Sobald auch der durch ist, folgt ein weiterer kurzer Nachtrag.
Vor knapp 11 Jahren ist bei uns einer dieser Wärmepumpentrockner eingezogen. Das Gerät hat seitdem wirklich viel Wäsche gesehen, einen Haushalt mit dem täglichen Berg an Handtüchern, Bettzeug und Kinderkram trocknet so ein Ding nicht nebenbei. Über die ganze Zeit lief er eigentlich problemlos. Zwei Mal musste ich ihn zerlegen und reinigen, sonst nichts. Genau dieser Punkt ist es aber, der mich diesmal über eine Stunde und ein Teppichmesser gekostet hat.
Der Patient: Bosch WTY87701 Home Professional, ausgerechnet mit dem Aufdruck SelfCleaning Condenser.
Das Symptom ist immer das gleiche: Die Wäsche wird einfach nicht mehr richtig trocken. Teilweise musste ein Programm zwei bis drei Mal durchlaufen, bis das Zeug aus der Trommel wirklich trocken war. Für einen Trockner, der laut Datenblatt 232 kWh im Jahr ziehen soll, sind drei Durchläufe pro Ladung natürlich eine Katastrophe, energetisch wie zeitlich. Meine Frau hatte das Gerät zu dem Zeitpunkt schon angezählt. Es blieb also noch ein Versuch, dann fliegt es raus.
Warum ein Wärmepumpentrockner überhaupt zusetzt
Ein Wärmepumpentrockner ist im Kern ein geschlossener Kreislauf. Die warme, feuchte Luft aus der Trommel wird an einem Verdampfer abgekühlt, das Wasser kondensiert und landet im Tank, dann wird die Luft an einem Kondensator wieder aufgeheizt und zurück in die Trommel geblasen. Dieser Wärmetauscher mit seinen eng stehenden Aluminiumlamellen ist das Herz des Geräts. Und genau dort lagern sich über die Jahre feinste Flusen ab, die das Sieb passieren. Setzt sich die Lamellenfläche zu, kommt kaum noch Luft durch, der Wärmeaustausch bricht ein, und die Wäsche bleibt klamm. Genau das beschreiben auch die einschlägigen Reparaturanleitungen: Flusen in den hinteren Kondensatorlamellen führen zu langen Laufzeiten und einer Wärmepumpe, die sich abmüht.
Die Ironie: ein SelfCleaning Condenser, der trotzdem dicht ist
Das Schöne an meinem Gerät: vorne prangt in großen Lettern SelfCleaning Condenser. Bosch wirbt damit, dass eine manuelle Reinigung des Kondensators nicht mehr nötig sei. Technisch steckt dahinter, dass während eines Trockengangs mehrfach Kondenswasser aus dem Prozess abgezweigt und über die Kondensatorfläche gespült wird, um Flusen wegzuschwemmen. Das funktioniert auch, aber eben nur an der vorderen, gut erreichbaren Fläche, die der Spülstrahl trifft. Die tieferen Lamellen und der Verdampfer dahinter bekommen davon nichts ab. Dort sammelt sich der Feinstaub über ein Jahrzehnt trotzdem an. „Selbstreinigend“ heißt hier also „die vordere Ebene bleibt frei“, nicht „der ganze Wärmetauscher bleibt sauber“. Nach knapp 11 Jahren ist der Unterschied dramatisch.
Hier die Eckdaten zum Gerät und zum Bauteil, um das sich gleich alles dreht:
BSH 00646776, ca. 225 x 145 mm, mit Dichtung und 6 Schrauben
Klappe passt laut Teilekatalog auf
Bosch Serie 6 / Serie 8 / Maxx 7, Siemens iQ300 bis iQ800
Typenschild: E-Nr. WTY87701, Typ WDT66, FD 9505, mit allen Kenndaten für die Ersatzteilsuche.
Wo man rankommt, und wo eben nicht
Das große Flusensieb innen vor der Trommel ist schnell raus, da bekommt man mit schmalen Fingern auch etwas heraus, aber an die spannenden Stellen kommt man so nicht. Vorne am Gerät gibt es noch eine kleine Abdeckung. Rechts dahinter sitzt ein Lüfter, links sieht es zumindest so aus, als hätte dort mal jemand über eine Art Klappe nachgedacht. Und zwar genau an der Stelle, an der man eine Klappe bräuchte, wenn man den Kondensator selbst reinigen will. Bei meinen letzten beiden Reinigungen konnte ich alles andere öffnen und sauber machen, aber an den Kondensator selbst kam ich nie richtig heran. Diesmal sollte es anders laufen.
Die Klappe, die Bosch vergessen hat einzubauen
Jetzt kommt der Teil, der mich erst gewundert und dann geärgert hat. Die Stelle, an der ich die Klappe erwartet hätte, ist im Gehäuse fast schon vorperforiert. Die Kontur ist angedeutet, das Material an der Linie spürbar dünner. Mit einem Teppichmesser lässt sich die Öffnung sehr einfach herstellen, man folgt einfach der angedachten Linie. Heißt im Klartext: Bosch hat die Service-Öffnung konstruktiv komplett vorgesehen, das Werkzeug für die Stanzung existiert, die Position stimmt, nur ausgeliefert wird das Gerät mit zugemachter Wand und ohne Klappe. Für genau diese Lücke gibt es sogar eine eigene Ersatzteilnummer, die 00646776, und einen ganzen Zubehörmarkt. Right to Repair sieht anders aus.
Das herausgetrennte Stück Gehäusewand. Die Kontur war vorperforiert, ein Teppichmesser entlang der angedachten Linie genügt.
Was dann hinter der frisch geschnittenen Öffnung zum Vorschein kam, war wirklich ekelig. Die Flusen hingen als kompakter, grauer Filz komplett vor den Kühlrippen und haben den Wärmetauscher zu einem großen Teil verdeckt. So kann der Kondensator natürlich nicht mehr arbeiten, da geht schlicht keine Luft mehr durch.
Der Blick hinter die frisch geschnittene Öffnung. Ein kompakter Flusenfilz verdeckt fast den kompletten Wärmetauscher.
Alles vorsichtig herausgeholt, abgesaugt und feucht nachgewischt. Die Lamellen waren an einigen Stellen verbogen, die habe ich anschließend so gut wie möglich wieder begradigt. Danach sah der Wärmetauscher wieder so aus, wie er soll: blankes Aluminium, freie Kanäle, Luft kann wieder hindurch.
Nach dem Reinigen und Begradigen der Lamellen: blankes Aluminium, freie Kanäle, die Luft kommt wieder durch.
Variante 1: die Klappe selbst drucken
Bleibt die Frage, wie man das Loch wieder sauber und vor allem dicht verschließt. Ein offenes Gehäuse zieht Falschluft und stört den Kreislauf. Ich habe eine wirklich erstklassige Druckdatei für meinen Bambu Lab X1-Carbon gefunden, ein Nachbau genau der BSH-Klappe 00646776: BSH 00646776 Condenser Door Service Panel auf MakerWorld.
Gedruckt habe ich die Abdeckung in grünem ABS und die Dichtung in TPU 95A. PLA wäre bei den Temperaturen rund um Kondensator und Wärmepumpe keine gute Idee. PLA fängt schon bei etwa 60 Grad an weich zu werden, sein Glasübergang liegt genau in dem Bereich, den so eine Baugruppe im Dauerbetrieb durchaus erreicht. Das Teil würde sich auf Dauer verziehen und die Dichtfläche verlieren. ABS liegt mit einem Glasübergang um die 105 Grad deutlich darüber und steckt die Wärme locker weg. Für die Dichtung will man dagegen etwas Flexibles, das die Spaltmaße ausgleicht und sauber abdichtet, deshalb das weiche TPU mit Shore 95A. Die Materialkombination ist hier kein Gimmick, sondern genau richtig gewählt.
Die in grünem ABS gedruckte Abdeckung von hinten, mit Versteifungsrippen und eingeprägter Teilenummer 00646776.
Die Versteifungsrippen auf der Rückseite und die eingeprägte Teilenummer zeigen, wie sauber die Datei gemacht ist. Mit aufgelegter TPU-Dichtung sieht das dann so aus:
Dieselbe Klappe mit der separat in TPU 95A gedruckten Dichtung.
Montiert wird mit sechs Schrauben in die vorhandenen Dome rund um die Öffnung. Die selbst gedruckte Abdeckung passt erstklassig und dichtet alles ab, wie man es sich wünscht.
Mit sechs Schrauben montiert. Die selbst gedruckte Klappe sitzt passgenau und dichtet sauber ab.
Variante 2: die fertige Klappe kaufen
Wer keinen 3D-Drucker hat, muss trotzdem nicht zum teuren Originalersatzteil greifen. Ich habe auf Amazon für knapp 15 Euro eine passende Abdeckung gefunden: Wartungsklappe für den Wärmetauscher. Die kommt aus spritzgegossenem, talkgefülltem Polypropylen (auf dem Bauteil steht die Materialkennung PP-TV30) und liegt damit thermisch ebenfalls im grünen Bereich. Im Set sind noch etwas Werkzeug zum Reinigen und sogar ein kleines Tool, mit dem sich die Kühlrippen wieder begradigen lassen.
Die gekaufte Alternative für knapp 15 Euro: Wartungsklappe plus Reinigungswerkzeug und ein kleines Tool zum Begradigen der Lamellen.
Auch diese fertige Klappe sitzt sauber in der Öffnung und schließt bündig ab. Auf dem Bauteil sind Teilenummer und Materialkennung mit eingegossen.
Die gekaufte Klappe aus talkgefülltem Polypropylen (PP-TV30) sitzt ebenso bündig. Teilenummer und Materialkennung sind eingegossen.
Beide Lösungen, die selbst gedruckte und die gekaufte, passen perfekt und dichten zuverlässig ab. Ich kann beide vorbehaltlos empfehlen. Wer einen Drucker mit ABS-tauglichem Gehäuse hat, druckt sich die Klappe für ein paar Cent Material selbst, alle anderen sind mit der 15-Euro-Variante inklusive Reinigungswerkzeug bestens bedient.
Und jetzt?
Der Trockner läuft wieder wie am ersten Tag. Eine Ladung, ein Durchlauf, Wäsche trocken. Auf den Fotos vom verdreckten Kondensator sieht es übrigens schlimmer aus, als es sich am Ende angefühlt hat, in einer guten Stunde war alles erledigt. Schöner Nebeneffekt: Ab jetzt brauche ich kein Teppichmesser mehr, sondern schraube die Klappe einmal im Jahr auf und sauge kurz durch. Vielleicht laufen so ja noch einmal 11 Jahre aus dem Teil heraus.
Läuft wieder: eine Ladung, ein Durchlauf. Das Display zeigt Schranktrocken mit normaler Restzeit.
Die kleine Moral: Lasst euch von einem „SelfCleaning“-Aufkleber nicht einlullen. Selbst die selbstreinigenden Geräte setzen sich über die Jahre zu, und ein bisschen Wartung verlängert die Lebensdauer enorm. Dass man dafür erst eine Klappe ins Gehäuse schneiden muss, die der Hersteller komplett vorbereitet, aber nicht freigibt, ist ein eigenes kleines Trauerspiel. Gut, dass es findige Leute mit Druckdateien und Ersatzteilen gibt.
Habt ihr auch so ein Gerät, bei dem die Service-Klappe ab Werk fehlt, oder eine eigene Druckdatei dafür? Dann lasst es mich gerne wissen, ihr dürft mich jederzeit fragen.
Im letzten Beitrag zum Thema hatte ich angekündigt, dass ich mir auch den NB-2033-U vornehmen will. Der steckt in einem zweiten Fujitsu Notebook hier, dem von meiner Tochter Maja. Gleicher Hersteller, gleiche Sensorfamilie, sollte ähnlich laufen wie beim NB-2020-U. Dachte ich.
Falsch gedacht.
Hersteller sagt: geht nicht
Ich hatte bei NEXT Biometrics nach Protokolldokumentation oder einem SDK für den NB-2033-U gefragt. Kevin Hung, Director FAE, antwortete freundlich aber eindeutig:
„Both 2020-U and 2033-U have different firmware and USB stack. The code flow (libusb) related to 2033-U and 2020-U is different. This could be the reason for 2033-U failure/unsupported in linux. As of now, it is not supported.“
Kein SDK, keine Doku, kein Support. Und 74 Einträge auf linux-hardware.org mit Status „failed“ für die USB ID 298d:2033. Weltweit kein Linux-Support für dieses Gerät.
Gut. Dann eben Reverse Engineering.
Erster Versuch: Windows-Treiber belauschen
Plan A war klassisch: Windows-Treiber in einer VM laufen lassen, USB-Traffic mitschneiden. VirtualBox installiert, USB-Passthrough konfiguriert, Windows gestartet. Der Fingerabdruckleser tauchte im Gerätemanager auf. Mit Code 31. Treiber konnte das Gerät nicht starten. Secure Boot hatte VirtualBox den Kernel-Treiber nicht signiert, und der USB-Passthrough war damit unbrauchbar.
Plan A verworfen.
Plan B: Das SDK direkt auf Linux
Das SDK von NEXT Biometrics (libNBBiometrics.so) unterstützt den NB-2033-U intern. Es kommuniziert direkt über libusb, ohne Kernel-Treiber. Das heißt: ich kann das SDK-Sample direkt auf dem Linux-Notebook laufen lassen und gleichzeitig den USB-Traffic mit usbmon mitschneiden.
Dafür musste Secure Boot deaktiviert werden. usbmon ist ein Kernel-Modul, und lockdown=integrity (von Secure Boot gesetzt) blockiert es auch für root. Secure Boot im BIOS aus, lockdown=none in GRUB, Neustart. Danach:
7654 Zeilen USB-Traffic. Das komplette Protokoll des NB-2033-U, aufgezeichnet während einer Enrollment-Session.
Was dabei rauskam
Das Protokoll ist komplett anders als beim NB-1010-U/NB-2020-U. Kevins Aussage stimmte. Hier die wesentlichen Unterschiede:
Eigenschaft
NB-1010-U / NB-2020-U
NB-2033-U
Bulk IN Endpoint
EP 3 (0x83)
EP 1 (0x81)
Kommandoformat
[0x80][CMD][SEQ][0x00]...
[CMD][0x00][LEN_LO][LEN_HI][PAYLOAD] (TLV)
Finger-Erkennung
Einzelnes 0x38
Zwei 0x0D Config + 0x38
Bildübertragung
90 Chunks à 540 Bytes
180 Chunks à 268 Bytes
Init
Einmal 0x07
Zweimal 0x07 nötig
Gleicher Sensor-Die (256×180 Pixel, 385 DPI, aktiv thermisch), aber ein komplett anderer USB-Stack. Der NB-2033-U nutzt ein TLV-Format (Type-Length-Value) statt des festen Kommandoschemas vom NB-1010-U. Jedes Kommando hat eine eigene Längenangabe, und die Antworten sind anders strukturiert.
Die Kommandos im Detail
Aus dem USB-Capture konnte ich sechs Kommandos identifizieren:
0x07 — Init/Wake. Muss zweimal gesendet werden, sonst reagiert der Sensor nicht.
0x0D — Sensor-Konfiguration. Wird zweimal vor jeder Finger-Erkennung gebraucht, um den „Enhanced“ Modus zu aktivieren.
0x38 — Finger-Erkennung. Byte 4 der Antwort ist der Detect-Level. Schwellwert 40.
Der Sensor misst Temperaturänderungen, nicht statischen Kontakt. Das klingt nach einem Detail, ist aber für die Treiber-Implementierung entscheidend. Finger auflegen erzeugt einen kurzen Spike im Detect-Wert (10 bis 50+). Finger bleibt liegen, und der Wert fällt zurück auf Basisniveau. Der Treiber muss also den Spike erkennen, nicht einen dauerhaften Zustand.
Dazu kommt: Nach dem Init gibt es transiente Spikes, die ungefähr 1,5 Sekunden brauchen, bis sie abklingen. Ohne Settle-Pause nach dem Init erkennt der Treiber Phantom-Finger.
Der Treiber
Rausgekommen ist nb2033.c, ein eigenständiger libfprint-Treiber mit rund 350 Zeilen. Kein proprietärer Code, keine SDK-Abhängigkeit. Das SDK diente nur als Referenz für die Capture-Analyse, der Treiber ist sauber von Grund auf geschrieben. Lizenz: LGPL 2.1+ wie alle libfprint-Treiber.
Der Merge Request ist eingereicht: MR !574 bei libfprint. Fünf Dateien: der neue Treiber, meson.build, autosuspend.hwdb und die Allowlist. CI läuft durch. Der verwandte MR !569 für den NB-2020-U ist noch in Review.
Für die Wiki-Aktualisierung (das Gerät von der „unsupported“ Liste nehmen) gibt es Issue #134.
Fazit
Der Hersteller sagt „not supported“, 74 Linux-User melden „failed“, und trotzdem war das an einem Nachmittag erledigt. SDK auf Linux ausführen, USB-Traffic mitschneiden, Protokoll rekonstruieren, Treiber schreiben, testen, upstream einreichen. Alles mit Open-Source-Tools: usbmon, libusb, libfprint.
Das Ergebnis: Majas Notebook hat jetzt einen funktionierenden Fingerabdruckleser unter Linux. Und sobald der Merge Request durch ist, haben ihn alle anderen auch.
Ich hatte noch einen Quantis USB in der Schublade liegen. Einen Hardware-Quantenzufallsgenerator von ID Quantique aus Genf. Ein Gerät, das echten Zufall erzeugt. Nicht pseudo, nicht algorithmisch, nicht „irgendwie aus Interrupts zusammengewürfelt“, sondern auf Basis von Quantenphysik. Fundamental unvorhersagbar.
Nachdem ich in den letzten Beiträgen OpenSSH und Postfix/Dovecot mit Post-Quantum-Kryptografie abgesichert habe, fiel mir wieder ein: PQC schützt die Algorithmen vor Quantencomputern. Schön und gut. Aber was ist eigentlich mit der Zufallsquelle, die diese Algorithmen füttert? Zeit, das Teil mal wieder anzuschließen und zu schauen, was es taugt.
Was steckt in dem Gerät?
Der Quantis USB von ID Quantique ist ein sogenannter Quantum Random Number Generator, kurz QRNG. Das Prinzip dahinter: Ein Photonendetektor misst quantenoptisches Vakuumrauschen. Das sind Fluktuationen im elektromagnetischen Feld, die nach den Gesetzen der Quantenmechanik fundamental zufällig sind. Nicht „fast zufällig“ oder „praktisch zufällig“, sondern physikalisch beweisbar unvorhersagbar. Das ist ein wichtiger Unterschied zu allem, was ein Algorithmus je leisten kann. Dazu gleich mehr.
Das Gerät selbst ist fast schon enttäuschend simpel. USB 2.0 High-Speed, ein einziger Bulk-IN-Endpoint (0x86), 512 Bytes pro Read, rund 4 Mbit/s Durchsatz. Flashbare Firmware gibt es nicht. Die „Intelligenz“ steckt in der Optik und einem FPGA, nicht in Software. Das Ding macht genau eine Sache, und die macht es gut.
Mein Testgerät hat die Seriennummer 132244A410. Der Quantis USB ist inzwischen ein Legacy-Produkt, ID Quantique hat einen Nachfolger mit höherem Durchsatz im Programm. Einen öffentlichen Preis hatte das Gerät nie. „Request a Quote“, wie das bei Nischenprodukten mit Zertifizierungsanforderungen so üblich ist. Das Gerät ist METAS-zertifiziert und war für Kunden gedacht, die Common-Criteria-Anforderungen erfüllen müssen. Vergleichbare QRNGs bewegen sich im Bereich von 900 bis 2.000 Euro. Nicht gerade ein Impulskauf.
Einrichten unter Linux
Angeschlossen an mein Linux Mint 22.3 (Ubuntu 24.04 Basis) meldet sich das Gerät sofort im Kernel-Log:
$ dmesg | tail
usb 1-1: New USB device found, idVendor=0aba, idProduct=0102
usb 1-1: Product: Quantis USB
usb 1-1: Manufacturer: id Quantique
usb 1-1: SerialNumber: 132244A410
Kein spezieller Treiber nötig. Das ist ein generisches USB-Bulk-Device, der Kernel erkennt es und das war’s. Die proprietäre libquantis von ID Quantique kann man sich komplett sparen. Man kann direkt mit pyusb auf den Endpoint zugreifen. So mag ich das.
Damit das auch ohne Root funktioniert, legt man eine udev-Regel an:
$ sudo udevadm control --reload-rules && sudo udevadm trigger
Gerät abstecken, wieder anstecken, fertig. Ab jetzt kann jeder Benutzer in der Gruppe plugdev auf das Gerät zugreifen.
Daten lesen mit Python
Zum Auslesen reicht das Paket python3-usb (pyusb). Installieren via apt install python3-usb, falls nicht vorhanden. Dann braucht man erstaunlich wenig Code:
Das ist alles. USB öffnen, Configuration setzen, den einen IN-Endpoint finden, 512 Bytes lesen. Fertig. Kein SDK, keine Bibliothek, kein Account, kein Cloud-Dienst. USB rein, Bytes raus.
Wichtig: Immer volle 512-Byte-Blöcke lesen (wMaxPacketSize). Wer weniger anfordert, bekommt USB-Overflow-Fehler. Das Gerät kennt keine halben Sachen. Es produziert kontinuierlich Zufallsdaten und schiebt sie in den USB-Puffer. Die müssen abgeholt werden, so wie sie kommen.
Für den Test habe ich das Ganze in eine Schleife gepackt und 100.000 Bytes gesammelt. Parallel dazu 100.000 Bytes aus /dev/urandom. Beide Datensätze dann durch dieselben statistischen Tests gejagt.
Der Test: Quantis vs. /dev/urandom
Jetzt wird’s spannend. Wie gut ist echter Quantenzufall im Vergleich zum Software-PRNG des Linux-Kernels?
Spoiler: Statistisch seht ihr keinen Unterschied. Und genau das ist der Punkt.
Metrik
Quantis USB
/dev/urandom
Shannon-Entropie
7,998513 Bits/Byte
7,998077 Bits/Byte
Maximum (theoretisch)
8,000000
8,000000
Effizienz
99,9814 %
99,9760 %
Chi² (Byte-Verteilung)
205,8
267,3
Erwartet (Chi²)
~255 ± 23
~255 ± 23
Bit-Balance (Anteil Einsen)
49,975 %
50,018 %
Serielle Korrelation
+0,001230
+0,003801
Längster Bit-Run (10 kB)
15 Bits
21 Bits
Erwarteter Run
~16
~16
Die Shannon-Entropie liegt bei beiden Quellen über 99,97 % des theoretischen Maximums von 8 Bit pro Byte. Das ist hervorragend. Die Chi²-Werte zeigen eine gleichmäßige Byte-Verteilung, beide liegen im erwarteten Bereich um 255. Die Bit-Balance ist nahezu perfekt bei 50/50, die serielle Korrelation praktisch null.
In den einfachen Tests schneidet der Quantis sogar minimal besser ab: niedrigere Korrelation, gleichmäßigere Verteilung, kürzerer maximaler Bit-Run. Aber ehrlich gesagt liegt das im statistischen Rauschen. Bei 100.000 Bytes Sample-Größe kann man keine belastbare Aussage über die Überlegenheit einer Quelle treffen. Man müsste Millionen oder Milliarden Bytes testen und Testsuiten wie die NIST SP 800-22 oder Dieharder durchlaufen lassen, um wirklich statistisch signifikante Unterschiede zu finden.
Heißt das, der Quantis ist überflüssig? Nein. Denn der Unterschied liegt nicht in der Statistik.
Wo liegt dann der echte Unterschied?
Die spannende Frage ist nicht, ob die Zahlen „zufälliger“ sind, sondern warum sie es sind.
/dev/urandom verwendet intern ChaCha20, einen deterministischen CSPRNG (Cryptographically Secure Pseudo-Random Number Generator). Der initiale Seed kommt aus der Kernel-Entropie: Hardware-Interrupts, Timing-Jitter, Geräte-Events, und seit einigen Jahren auch RDRAND/RDSEED aus der CPU, falls vorhanden. Das funktioniert in der Praxis hervorragend und ist extrem gut untersucht.
Aber es bleibt ein Algorithmus mit einem internen State. Wer diesen State kennt (und sei es nur theoretisch), kann alle zukünftigen Outputs berechnen. Das ist kein realistisches Angriffsszenario für euren Laptop. Aber es ist eine fundamentale Eigenschaft: Die Sicherheit von /dev/urandom basiert auf Berechnungsannahmen. Man nimmt an, dass ChaCha20 nicht effizient invertierbar ist. Stand heute stimmt das. Aber es ist eine Annahme, kein Beweis.
Der Quantis hingegen erzeugt Zufall aus Quantenvakuum-Fluktuationen. Da gibt es keinen Algorithmus, keinen State, keinen Seed. Die Unvorhersagbarkeit ist nicht durch die Komplexität eines Algorithmus geschützt, sondern durch die Gesetze der Quantenmechanik. Kein Angreifer, egal mit welcher Rechenleistung und egal mit wie viel Zeit, kann die nächsten Bits vorhersagen. Auch kein Quantencomputer. Das ist nicht berechnungstheoretisch sicher, sondern informationstheoretisch sicher. Die höchste Sicherheitskategorie, die es gibt.
Klingt akademisch? Zum Teil. Für den Alltag auf eurem Desktop oder Server reicht /dev/urandom völlig aus. Es gibt keinen bekannten praktischen Angriff darauf, und Linux‘ CSPRNG ist schnell, überall verfügbar und gut gewartet.
Aber es gibt Szenarien, in denen der Unterschied real zählt:
Erzeugung kryptografischer Schlüssel mit höchsten Sicherheitsanforderungen
Seeding von HSMs (Hardware Security Modules), die selbst keine eigene Entropiequelle haben
Regulatorische und Zertifizierungsanforderungen, also Common Criteria, FIPS-Validierung, BSI-Vorgaben
Wissenschaftliche Experimente, die physikalisch echten Zufall benötigen (z. B. Quantenoptik, Monte-Carlo-Simulationen)
Quantenschlüsselaustausch (QKD), ein Bereich in dem ID Quantique ebenfalls aktiv ist
Das größere Bild: QRNG und PQC
Post-Quantum Cryptography schützt kryptografische Algorithmen davor, von Quantencomputern gebrochen zu werden. ML-KEM für den Schlüsselaustausch, ML-DSA für Signaturen. Das ist die eine Seite der Medaille.
Die andere Seite ist die Zufallsquelle. Ein kryptografischer Algorithmus kann noch so quantensicher sein. Wenn der Zufall, mit dem Schlüssel erzeugt werden, vorhersagbar oder manipulierbar ist, hilft das alles nichts. Der Zufall ist das Fundament, auf dem alles andere aufbaut.
Ein QRNG schützt genau diesen Angriffsvektor. Beides zusammen, PQC-Algorithmen und eine quantenphysikalische Zufallsquelle, ergibt ein quantum-safe Gesamtsystem. Das ist heute für die meisten von uns Overkill. Aber die Bausteine existieren, sie sind verfügbar, und es schadet nicht zu wissen, wie sie funktionieren.
Übrigens: Wer jetzt denkt „dann stecke ich den Quantis in meinen Server und bin sicher“, der macht es sich zu einfach. Die Vertrauensfrage verschiebt sich nur. Woher weiß ich, dass das Gerät tatsächlich Quantenzufall liefert und nicht einfach einen internen PRNG hat? Bei einem zertifizierten Gerät wie dem Quantis gibt es dafür Prüfberichte. Aber Vertrauen in Hardware bleibt immer ein Thema. Das ist bei Intel RDRAND nicht anders.
Einbindung ins System
Für die Vollständigkeit: Der Quantis USB lässt sich über rng-tools (rngd) als zusätzliche Entropiequelle in den Kernel-Entropiepool einbinden. Für Server mit hohem Entropie-Bedarf, also TLS-Terminierung unter Last, Massenerzeugung von Schlüsseln oder VPN-Gateways, kann das sinnvoll sein.
Ich habe das auf meinem Desktop nicht gemacht. Brauche ich dort nicht. Aber die Möglichkeit steht im Raum, falls jemand von euch einen Quantis oder ein vergleichbares Gerät an einen Server hängen möchte.
Fazit
Ein alter Hardware-QRNG, ein USB-Port, ein paar Zeilen Python, und man hat echten Quantenzufall auf dem Tisch. Statistisch nicht unterscheidbar von /dev/urandom, aber fundamental anders in der Entstehung. Die Sicherheit kommt nicht aus einem Algorithmus, sondern aus der Physik. Informationstheoretisch statt berechnungstheoretisch. Ein Unterschied, der in den allermeisten Fällen keine praktische Rolle spielt. Aber ein verdammt eleganter.
Für euren Desktop braucht ihr das nicht. Aber verstehen, warum es existiert und wie es sich einordnet, gerade im Kontext von Post-Quantum-Kryptografie, das lohnt sich. Warum denke ich jetzt an CIA und MAD? ;-D
Wie haltet ihr es mit euren Zufallsquellen? Vertraut ihr blind auf /dev/urandom, oder habt ihr euch schon mal Gedanken über die Entropiequelle dahinter gemacht?
In meinem Fujitsu Notebook steckt ein Fingerabdruckleser. Ein NEXT Biometrics NB-2020-U, USB ID 298d:2020. Unter Windows funktioniert er, unter Linux nicht. Kein Treiber, kein Support, nichts. Das Gerät taucht in lsusb auf, wird aber von keinem Treiber erkannt. Im libfprint Wiki steht es auf der Liste der nicht unterstützten Geräte. Dort steht es schon eine Weile.
Das hat mich gestört.
libfprint kennt den NB-1010-U. Das ist ein externer USB Fingerabdruckleser von NEXT Biometrics, der seit einiger Zeit einen funktionierenden Treiber hat. Der NB-2020-U ist die eingebettete Variante desselben Sensors, gedacht für den Einbau in Notebooks. Wenn man sich Teardown Reports ansieht, etwa von System Plus Consulting oder Yole Group, dann stellt man fest: Beide Geräte verwenden den identischen Sensor Die. Gleiche Technik, anderes Gehäuse.
Das war der erste Anhaltspunkt. Wenn die Hardware gleich ist, sollte auch das USB Protokoll gleich sein. Und wenn das Protokoll gleich ist, sollte der vorhandene Treiber funktionieren.
Bevor ich aber einfach auf Verdacht losprogrammiert habe, wollte ich es absichern. Ich habe NEXT Biometrics direkt angeschrieben. Kevin Hung, Director FAE bei NEXT Biometrics, hatte mir bereits 2022 auf eine Anfrage zu Linux Treibern geantwortet. Damals war sein Vorschlag, über Fujitsu zu gehen. Das führte ins Leere. Diesmal habe ich konkret angeboten, selbst einen libfprint Treiber zu schreiben, und um das SDK gebeten.
Kevin hat mir daraufhin das NBBiometrics ANF SDK 3.0.0.1384 zugeschickt. Ein komplettes SDK mit Headern, Bibliotheken, Beispielcode und Dokumentation. Das war sehr hilfreich, denn die Header bestätigen einiges. Das SDK nutzt eine einzige Shared Library libNBBiometrics.so für alle Gerätetypen. Der NB-1010-U hat den internen Gerätetyp 200, der NB-2020-U den Typ 202. Beide verwenden dasselbe Scanformat: 180×256 Pixel bei 385 DPI. Die USB Vendor ID ist bei beiden 0x298d, nur die Product ID unterscheidet sich: 0x1010 beim einen, 0x2020 beim anderen.
Wichtig: Das SDK ist proprietär. Für den eigentlichen Treiber habe ich keinen Code daraus verwendet. libfprint akzeptiert nur sauberen, eigenständig entwickelten Code. Das SDK diente ausschließlich als Referenz, um die Protokollkompatibilität zu bestätigen.
Also habe ich es einfach ausprobiert. Den bestehenden nb1010.c Treiber genommen, die USB Product ID 0x2020 zur id_table hinzugefügt und gebaut. Dann auf dem Fujitsu Notebook getestet.
Es funktionierte sofort.
Geräteerkennung, USB Interface Claim, die State Machine für die Fingererkennung, alles lief auf Anhieb. fprintd-enroll hat Fingerabdrücke aufgenommen, fprintd-verify hat sie korrekt verifiziert. Der bestehende Treibercode brauchte keinerlei Anpassungen. Null. Nur die PID in der Tabelle und den Gerätenamen.
Ein Blick auf die USB Deskriptoren bestätigt das Bild. Der NB-2020-U hat exakt dasselbe Endpoint Layout wie der NB-1010-U: Bulk OUT auf Endpoint 0x02, Bulk IN auf Endpoint 0x83. Dazu kommt ein Interrupt Endpoint auf 0x81, den der Treiber nicht verwendet. Die Kommunikation läuft identisch ab.
Der Patch selbst ist entsprechend klein. Drei Dateien, drei Zeilen rein, drei Zeilen raus:
libfprint/drivers/nb1010.c: Die neue PID 0x2020 wird in die id_table eingetragen und der full_name auf "NextBiometrics NB-1010-U/NB-2020-U" erweitert.
data/autosuspend.hwdb: Der Eintrag 298d:2020 wird von der Liste der nicht unterstützten Geräte in die Sektion des nb1010 Treibers verschoben.
libfprint/fprint-list-udev-hwdb.c: Der Eintrag wird aus der Allowlist der nicht unterstützten Geräte entfernt, da er jetzt vom Treiber abgedeckt wird.
Den Merge Request habe ich bei libfprint upstream eingereicht: MR !569. Die CI Pipeline läuft durch, alle 124 Tests bestehen. Jetzt heißt es warten auf das Review durch die Maintainer.
Update, Juli 2026: Das Warten ist vorbei. MR !569 ist am 2. Juli 2026 upstream gemergt. Maintainer Marco Trevisan hat den Patch auf den aktuellen master rebased und per Auto-Merge aufgenommen, ohne blockierende Review-Kommentare. Der NB-2020-U wird damit ab der nächsten libfprint Version out of the box unterstützt. Die Details stehen im kurzen Nachtrag zum Merge.
Für alle, die denselben Fingerabdruckleser in ihrem Notebook haben: Sobald der Patch gemergt und in einer neuen libfprint Version enthalten ist, funktioniert der Sensor out of the box. Enrollment und Verifikation über fprintd laufen sauber. Wer nicht warten möchte, kann den Patch auch jetzt schon selbst auf ein aktuelles libfprint anwenden.
Im selben Fujitsu Notebook meiner Tochter steckt ein NB-2033-U, ein weiterer Fingerabdruckleser aus der gleichen Familie. Der verwendet allerdings ein komplett anderes Protokoll und ließ sich nicht einfach mit dem nb1010 Treiber ansprechen. Den habe ich per Reverse Engineering geknackt.
Ich nutze das digitale Multimeter OWON XDM1041. Preis-Leistung passt für mich sehr gut. Das Gerät lässt sich per USB mit dem PC verbinden, Messwerte können ausgelesen und aufgezeichnet werden. Für meine Elektronik-Projekte an der Werkbank bringt es alles mit, was ich brauche.
Die Herstellersoftware funktioniert, ist aber klar auf Windows fokussiert. Unter Linux nutze ich stattdessen RustyMeter, eine saubere Alternative: https://github.com/markusdd/rusty_meter
Mein XDM1041 lief zunächst mit der Firmware V3.3.0. Auf der OWON-Webseite findet sich aktuell jedoch kein Firmware-Download für dieses Gerät. Nach Kontakt mit dem Support per E-Mail hat mir OWON freundlicherweise die aktuellste Firmware (Stand: 08.01.2026) zur Verfügung gestellt: XDM10412212508.zip (MD5 509766ba23eb008f32f60a82cddca08b)
Das Firmware-Update selbst ist unkompliziert und funktioniert exakt wie in der Anleitung beschrieben. Nach dem Update läuft das Gerät mit Firmware V4.7.0, im Display angezeigt als 20220913.
Der ursprüngliche Download von OWON war leider sehr langsam, brach mehrfach ab und erzeugte wiederholt TLS-Fehler. Ob das an Routing-Problemen oder an der sprichwörtlichen „chinesischen Mauer“ liegt, lässt sich schwer sagen.
Natürlich habe ich ebenfalls gefragt, ob ich das Firmware Update hier zum Download anbieten kann. Das geht aber leider nicht, denn es scheint jeweils für gewisse Geräte unterschiedliche zu geben:
Dear,
We can’t share the firmware updates as each one is exclusive to a specific device and not cross-compatible.
Ihr müsst also jeweils selbst auf den Support zugehen, E-Mail hat für mich gut funktioniert. Ich habe noch nach einem Kontakt über WeChat gefragt und nach einem Changelog. Sollte ich etwas bekommen, ergänze ich es hier.
Weiter geht es mit einer Lötstation. Wie immer: Das ist ein Werkzeug, das ich selbst einsetze. Es bedeutet nicht, dass es das Beste der Welt ist oder dass man damit sofort eine professionelle SMD-Reparaturwerkstatt eröffnen sollte.
Ende des letzten Jahres war ich auf der Suche nach einer kompakten Lötstation, die eine ordentliche Wattleistung hat und eine Kombination aus Lötstation und Heißluftstation bietet. Sie sollte aber nicht zu teuer sein. Einzelne Geräte hatte ich zwar schon verschiedene, aber gedacht war es eher für den mobilen Einsatz im Repaircafé. Die dortigen Reparaturen sind meist überschaubar.
Dennoch muss ich zugeben, dass mich diese Station tatsächlich überrascht hat. Preis/Leistung sind wirklich gut. Fun Fact: Die FritzBox-Reparatur habe ich mit genau dieser Station gemacht – einfach um zu testen, was geht – und ja, es ging, und das sogar wirklich okay.
Natürlich ist sie nicht mit einer großen professionellen Station von beispielsweise Weller zu vergleichen. Aber das ist auch gar nicht der Anspruch. Das Ding kostet aktuell auf Amazon knapp 130 €. Dafür bekommt man 6 verschiedene Lötspitzen, Lötzinn, Heißluft mit verschiedenen Aufsätzen, ein digitales Display und ach … schaut mal selbst: https://amzn.to/47zAAmr
Ich würde behaupten: Die meisten Hobbyreparaturen – selbst im Bereich SMD – lassen sich damit problemlos durchführen. Aber hey, das ist nur meine Meinung.