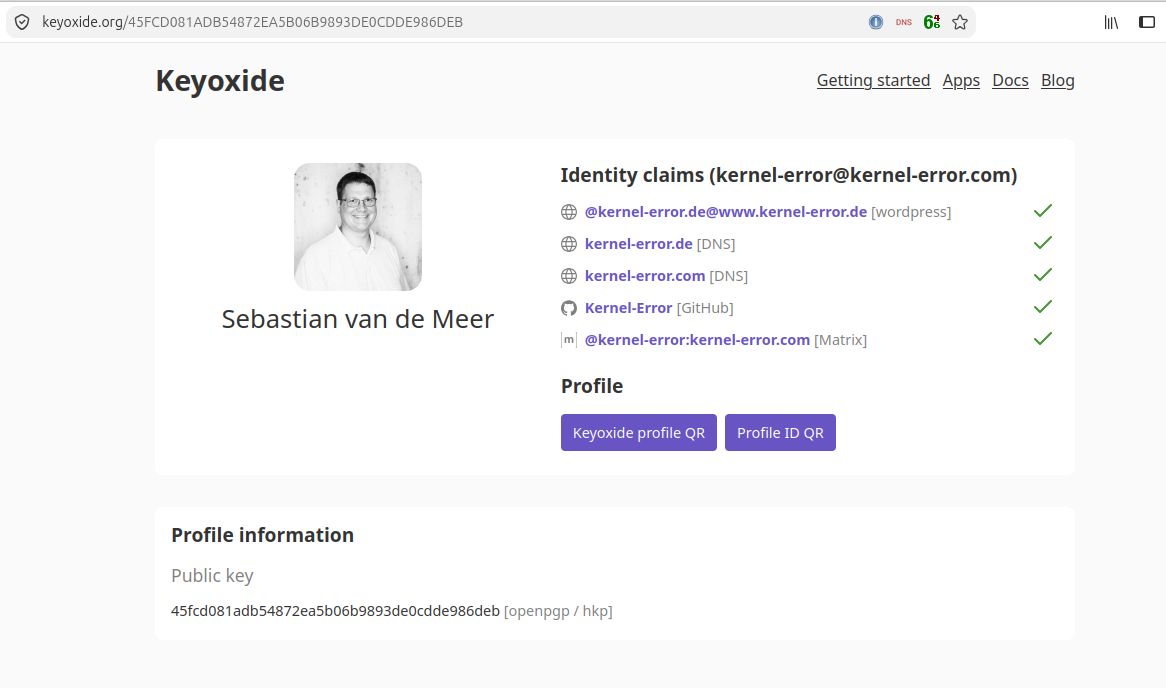
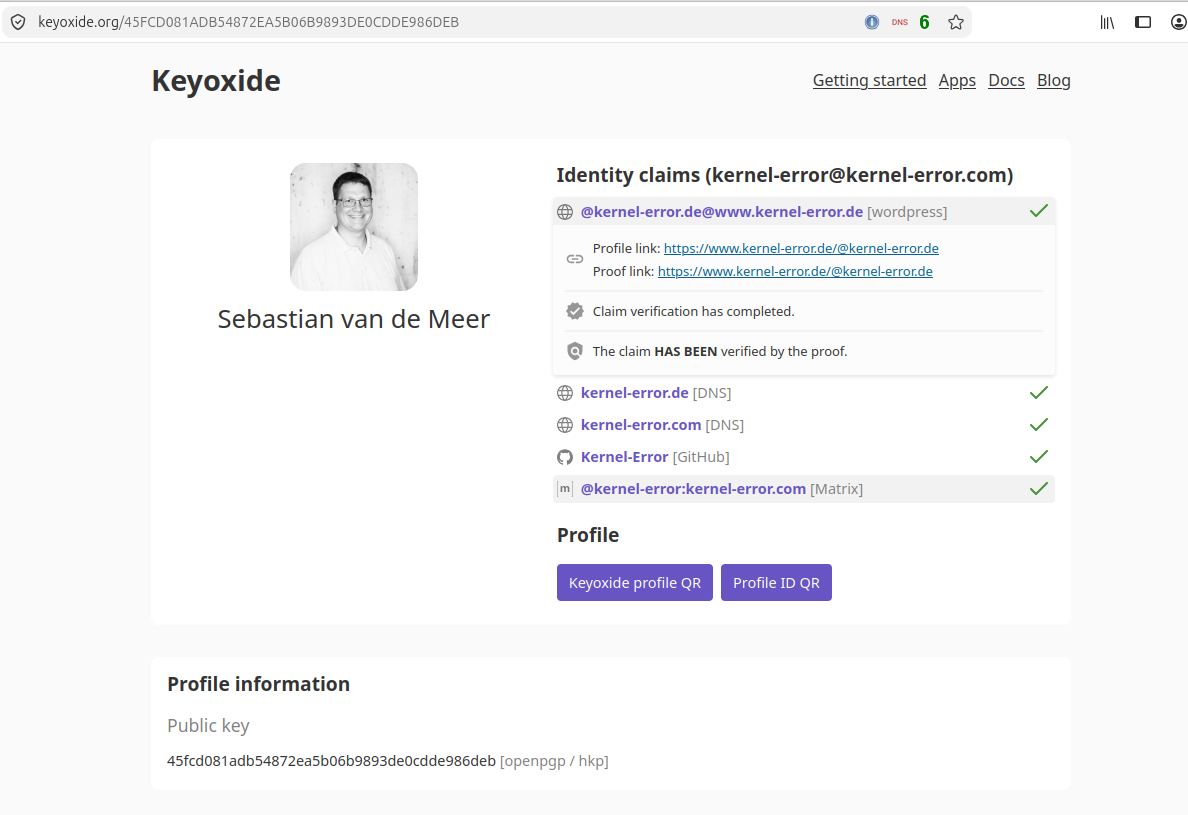
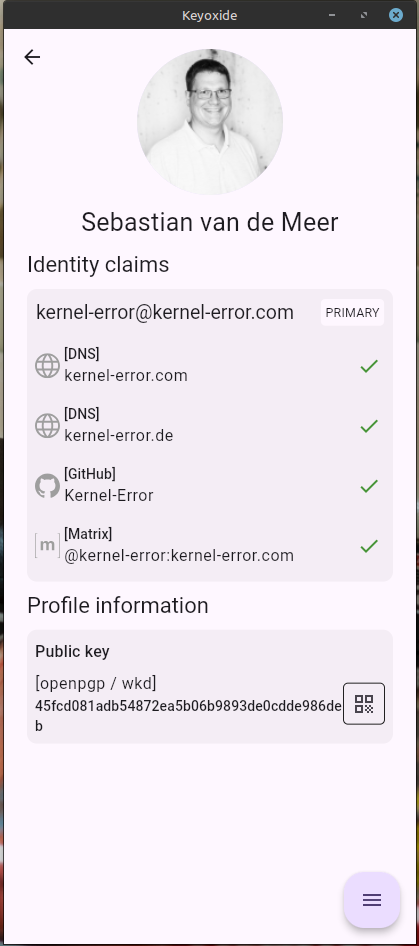
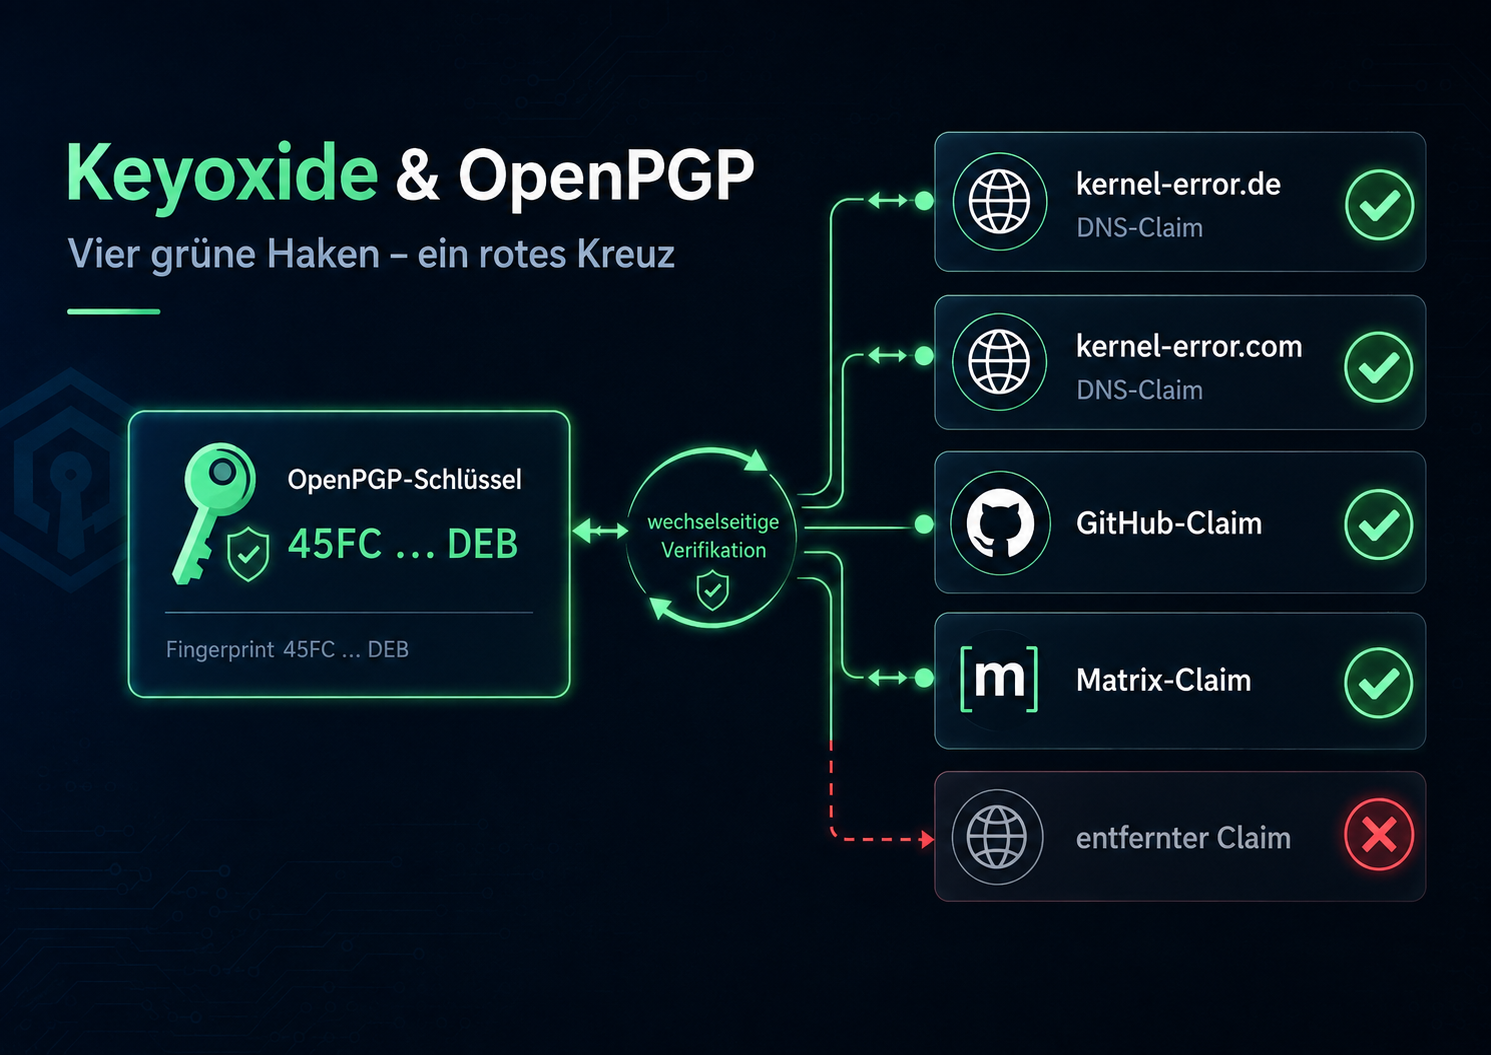
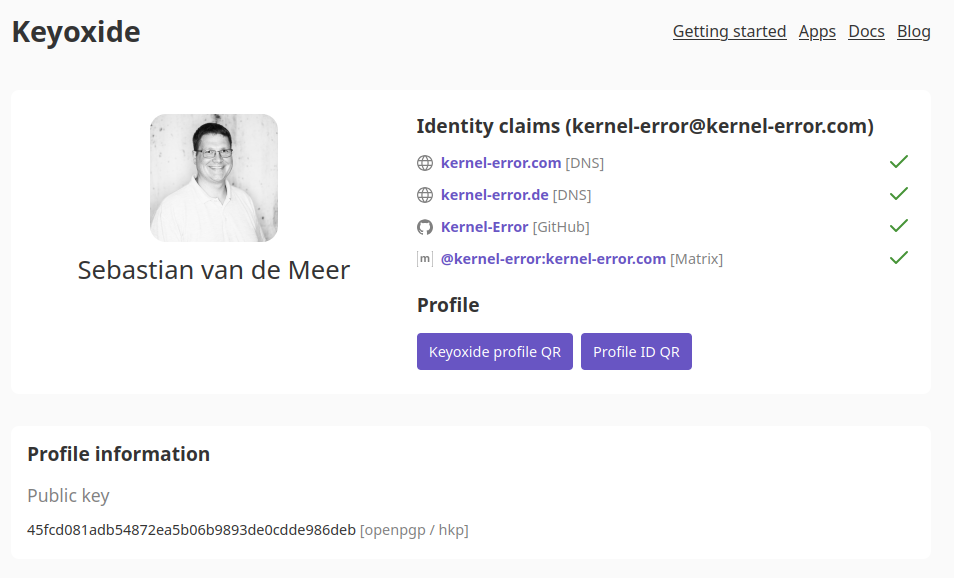
Zwei Keyoxide-Beiträge liegen schon hier, im ersten vier Claims über DNS, GitHub und Matrix, im zweiten die Linux-App und der Matrix-Kanal des Projekts. Was in beiden fehlte, war ein fünfter Claim, der genau dieses Blog beweist, den Fediverse-Actor @kernel-error.de@www.kernel-error.de. Der ist keine Mastodon-Instanz, sondern das WordPress-ActivityPub-Plugin, das aus diesem Blog selbst einen Actor macht. Im August habe ich genau diesen Claim gebaut, ausgerollt und noch am selben Tag wieder zurückgebaut, weil er einfach nicht grün wurde. Das hier ist die Geschichte, warum nicht, und was seit heute anders ist.
Der gescheiterte erste Versuch im August
Der Claim in der Selbstsignatur des Schlüssels: proof@ariadne.id=https://www.kernel-error.de/@kernel-error.de. Der Beweis dazu: ein Extra Field des ActivityPub-Plugins namens OpenPGP mit dem Wert openpgp4fpr:45FC…6DEB, exakt die Platzierung, die Keyoxide selbst als unterstützt dokumentiert. Der Actor lieferte auch wortgetreu {"type":"PropertyValue","name":"OpenPGP","value":"openpgp4fpr:45FC…6DEB"} aus. Trotzdem blieb der Claim rot.
Bei der Fehlersuche im August ist mir dabei ein echter Bug auf der eigenen Seite untergekommen und gleich mitgefixt: WordPress beantwortete OPTIONS-Anfragen auf die Actor-URL mit einem 301 auf die Startseite, ein umgeleiteter CORS-Preflight scheitert damit in jedem Browser hart. Eine eigene nginx-Location, die den Preflight selbst mit 204 beantwortet, hat das behoben, dauerhaft, unabhängig vom Rest dieser Geschichte, weil es jeden browserseitigen Consumer des Actors betrifft. Das steht bereits ausführlich im ersten Keyoxide-Beitrag.
Was im August systematisch ausgeschlossen wurde
Nach dem CORS-Fix ließ sich der Actor sauber abrufen, im Access-Log stand GET /@kernel-error.de 200 … "doipjs/2.1.0", das Werkzeug hinter Keyoxide hatte den Actor also tatsächlich in der Hand. Der Rest wurde einzeln durchgestrichen. Provider-Matching: die ActivityPub-Regel von doipjs ist ein Catch-all für jede https-URL, NodeInfo-Anfragen im Log belegten, dass die ActivityPub-Nachbearbeitung wirklich lief. Feld-Pfad: attachment.value ist einer von drei Pfaden, die doipjs durchsucht, neben summary und content. Groß- und Kleinschreibung des Fingerprints: doipjs kleinschreibt vor dem Vergleich, also irrelevant. Am Ende blieb nur ein Rückbau übrig, Notation raus, Redeploy über alle sieben Schlüssel-Kanäle, Feld gelöscht. Alles sah richtig aus, und trotzdem war es rot. Genau dieser Widerspruch ist der Grund, warum ich das jetzt, im September, zu Ende verfolgt habe.
Die Ursache im Verifizierer: doipjs und runJSON
doipjs ist die Bibliothek hinter keyoxide.org, Quelltext offen auf Codeberg. Die eigentliche Suchfunktion heißt runJSON(proofData, checkPath, params) und läuft einen JSON-Pfad ab. Zwei Zeilen daraus erklären den ganzen Fehler:
// Array: der Reihe nach abarbeiten, kein try/catch pro Element
if (Array.isArray(proofData)) {
  let result = false
  for (let index = 0; index < proofData.length; index++) {
    if (result) { continue }
    result = await runJSON(proofData[index], checkPath, params)
  }
  return result
}

// Objekt ohne den naechsten Schluessel im Pfad: wirft, sofort
if (typeof proofData === 'object' && !(checkPath[0] in proofData)) {
  throw new Error('err_json_structure_incorrect')
}
Steckt der Beweis in einem Array, iteriert runJSON über die Einträge und ruft sich selbst für jedes Element auf, ohne dabei einzelne Fehler abzufangen. Fehlt einem Objekt der nächste erwartete Schlüssel im Pfad, wirft die Funktion sofort. Beides zusammen bedeutet: im ersten Element eines Arrays, dem der gesuchte Schlüssel fehlt, bricht die ganze Suche ab, alles danach wird nie mehr angeschaut. Aufgefangen wird das erst eine Ebene höher, in run(), und zwar pro Zielpfad einzeln, summary, attachment.value, content bekommen je einen eigenen Try-Block. Ein Wurf in attachment.value gibt also nur diesen einen Pfad auf, summary und content laufen trotzdem weiter, finden dort aber naturgemäß nichts, weil der Beweis nur im Attachment-Array steht.
Die andere Hälfte: wie das ActivityPub-Plugin Profilfelder ausliefert
Die zweite Hälfte des Bugs steckt im WordPress-Plugin selbst, in class-extra-fields.php, Funktion fields_to_attachments(). Für jedes einzelne Profilfeld erzeugt die Funktion nicht ein Attachment, sondern zwei: zuerst ein klassisches PropertyValue mit name und value, das ist die Tabelle, die Mastodon rendert. Danach, als Unterstützung für FEP-fb2a, entweder ein Link mit href, wenn der Wert ein einzelner Link ist, oder ein Note mit content, wenn nicht.
Weder Link noch Note hat einen Schlüssel namens value. Im echten Actor sah das im August deshalb so aus:
attachment[0]  PropertyValue  Blog   value=...   geprueft, kein Treffer
attachment[1]  Link           Blog   href=...    kein value-Schluessel, wirft
attachment[2+] ...                               nie erreicht
doipjs prüft auf einem WordPress-Actor also faktisch nur attachment[0]. Die bestehenden Felder standen im August in der Reihenfolge Blog, GitHub, Matrix, Kontakt, das OpenPGP-Feld kam als fünftes dazu und lag damit nie an erster Stelle. Genau das erklärt jede einzelne Beobachtung von damals: erfolgreich abgerufen, korrektes JSON im Feld selbst, trotzdem rot.
Warum das auf Mastodon nie auffällt
Mastodon liefert für seine eigenen Profilfelder ausschließlich PropertyValue-Einträge aus, jedes Element im Array trägt also value, und die Schleife läuft ungestört durch, egal an welcher Position der Beweis steht. Der FEP-fb2a-Zusatz ist eine Erweiterung für genau die Fälle, die Mastodon nicht abdeckt, in diesem Fall anklickbare Links im Profil außerhalb der reinen Tabellenoptik. Niemand hat hier etwas falsch gemacht: das Plugin erweitert sinnvoll über Mastodon hinaus, doipjs ist gegen Mastodons Datenform geschrieben, und beide Annahmen treffen für sich genommen zu. Nur zusammen ergeben sie eine Reihenfolge-Abhängigkeit, die auf keinem der beiden Wege sichtbar wird, wenn man nur die eigene Seite testet.
Beim Gegenlesen dieser Analyse kamen noch zwei Präzisierungen dazu, die den Befund nicht ändern, aber schärfen. Erstens: ein Wurf in attachment.value beendet nicht die gesamte Verifikation, nur diesen einen Pfad, summary und content laufen wie oben beschrieben trotzdem weiter. Zweitens: ein reiner Unit-Test von verifications.run() übergeht den eigentlichen Netzwerk-Abruf, der wirkliche Beweis ist ein kompletter Durchlauf über Claim.match() und verify() gegen den lebenden Actor, dazu unten mehr. Vorschlag aus derselben Runde war außerdem, den Beweis zusätzlich oder stattdessen im Profil-summary zu platzieren, das ist positionsunabhängig. Entscheidung: das Extra Field bleibt, weil es das sauberere Profil ergibt, die Reihenfolge-Abhängigkeit wird dafür hier dokumentiert, summary bleibt die bekannte Rückfalloption.
Reproduziert, bevor irgendetwas am Schlüssel geändert wurde
Bevor der Schlüssel angefasst wurde, habe ich doipjs 2.1.0 lokal aus npm in ein Wegwerf-Verzeichnis installiert und dessen eigene verifications.run() plus die ActivityPub-Provider-Definition direkt gegen das echte, live abgerufene Actor-JSON laufen lassen, mit dem Beweis an unterschiedlichen Positionen eingesetzt:
live actor, unveraendert                             result=false errors=["err_json_structure_incorrect","err_json_structure_incorrect"]
OpenPGP an erster Stelle (Index 0)                   result=true  errors=[]
OpenPGP an letzter Stelle (Index 8), wie im August    result=false errors=["err_json_structure_incorrect","err_json_structure_incorrect"]
Nur PropertyValue (Mastodon-Form), OpenPGP letzte     result=true  errors=[]
Die beiden Fehler in den ersten zwei Zeilen sind der attachment.value-Pfad, dort steht der Link- oder Note-Eintrag ohne value, und der content-Pfad, ein Person-Actor hat kein Top-Level-content-Feld. Die letzte Zeile ist die Kontrollprobe: derselbe Beweis an derselben Position funktioniert, sobald das Array die reine Mastodon-Form hat. Vier Zeilen, die die ganze Geschichte erzählen. Der relative Importpfad war dabei nötig, doipjs/src/… lässt sich nicht als Package-Subpath importieren, die exports-Angabe in dessen package.json blockt das.
Der Fix auf dem Blog
Das Extra Field OpenPGP wurde neu angelegt, mit menu_order = -1, während die bestehenden vier auf 0 bis 3 stehen, Inhalt im selben Absatz-Blockformat, das das Plugin auch für die anderen Felder benutzt, <!-- wp:paragraph --><p>openpgp4fpr:45FC…6DEB</p><!-- /wp:paragraph -->. Eingefügt wurde das per direktem $wpdb->insert(), nicht über wp_insert_post(), weil Letzteres die ActivityPub-Hooks auslöst und ein Update für den Actor in die Outbox stellt, das später als Geister-Post auftaucht, Blog-Titel, Datum 2003. Gemessen: ap_outbox stand vorher und nachher bei genau demselben Wert. Danach zuerst der Redis-Object-Cache geleert, dann der nginx-FastCGI-Cache, die umgekehrte Reihenfolge würde FastCGI aus noch altem Redis-Inhalt neu befüllen. Im lebenden Actor sieht das Ergebnis jetzt so aus:
Der reine Text bekommt hier eine Note als Begleitung, kein Link drin, also kein Link-Eintrag. attachment[0] trägt jetzt den Beweis, genau da, wo doipjs zuerst und im Zweifel einzig hinsieht.
Die Gegenprobe vor der Schlüsseländerung
Nur der Reihenfolge-Test allein hätte mir nicht gereicht. Vor der eigentlichen Schlüsseländerung lief deshalb ein kompletter doipjs-Durchlauf, Abruf, Provider-Matching, Verifikation, Nachbearbeitung, gegen die produktive Seite, mit dem Fingerprint direkt übergeben, den Beweis brauchte der Schlüssel dafür noch nicht:
const claim = new Claim('https://www.kernel-error.de/@kernel-error.de', FINGERPRINT)
claim.match()      // ergibt: activitypub, owncast (die URI ist absichtlich mehrdeutig)
await claim.verify()
// ergibt: status 200 (VERIFIED), provider "wordpress" (aus NodeInfo),
//         profile "@kernel-error.de@www.kernel-error.de"
Erst nachdem dieser Test grün war, bekam der Schlüssel die Notation, dieselbe Regel wie schon bei den DNS-Claims: der Schlüssel behauptet nie öffentlich etwas, das noch nicht beweisbar ist.
Schlüssel und Redeploy über sieben Kanäle
Die Notation kam ausschließlich in die Namens-UID, in einer skriptgesteuerten gpg --batch --command-fd 0 --edit-key-Sitzung, sonst bekommt auch die Foto-UID den Claim mit. Danach geprüft: fünf Claims auf UID 1, Algorithmus-Präferenzen und Feature-Flags unverändert, die Governikus-eID-Zertifizierung und die Gegensignatur des alten Schlüssels weiterhin gültig, Ablaufdaten unverändert, Foto-UID unangetastet. Jede Claim-Änderung erzeugt eine neue Selbstsignatur, deshalb musste der aktualisierte Schlüssel auf alle sieben Kanäle: keys.openpgp.org, keyserver.ubuntu.com, pgpkeys.eu, WKD, sowohl über die Advanced-Methode via keys.openpgp.org als auch direkt selbst gehostet, der Download auf dem Blog, und der DANE-OPENPGPKEY-Record per Zone-Freeze/Thaw, DNSSEC-ad-Flag danach an drei öffentlichen Resolvern geprüft.
Eine gute Frage, die während des Rollouts aufkam: wenn WKD auf der eigenen Seite doch reicht, warum überhaupt noch auf die Keyserver hochladen, während gerade erst getestet wurde? Zwei Antworten. Erstens war der Test zu diesem Zeitpunkt schon abgeschlossen, der Ende-zu-Ende-Check lief gegen den lebenden Actor mit dem blanken Fingerprint, bevor der Schlüssel den Claim überhaupt trug, veröffentlicht wurde der Schlüssel erst, als das Ergebnis grün war. Zweitens ist WKD hier gar nicht wirklich nur die eigene Seite: die WKD-Advanced-Methode unter openpgpkey.kernel-error.com ist ein CNAME auf den WKD-Dienst von keys.openpgp.org, und Clients probieren Advanced zuerst. Auch das Keyoxide-Profil per Fingerprint holt sich den Schlüssel von keys.openpgp.org. Ohne das Keyserver-Update hätten die meisten Prüfer also weiterhin den alten Schlüssel mit vier Claims gesehen. Wahr und ebenfalls wichtig: Keyserver behalten jede Generation einer Selbstsignatur, es zählt nur die jüngste. Ein Claim lässt sich mit einer neueren Selbstsignatur zurückziehen, die alte Version verschwindet aber nie, das gehört vor der Veröffentlichung mitentschieden, nicht danach.
Das Ergebnis
Der Schlüssel abgerufen wie ein Fremder ihn abrufen würde, per HKP von keys.openpgp.org und per WKD, und mit doipjs gegen alle fünf Claims geprüft:
OK  200  wordpress  @kernel-error.de@www.kernel-error.de
OK  200  github     Kernel-Error
OK  200  dns        kernel-error.de
OK  200  dns        kernel-error.com
(Matrix braucht auf der Pruefer-Seite einen echten Matrix-Account, auf keyoxide.org gruen, in einem blanken lokalen Test nicht pruefbar)
Der Provider steht dabei als wordpress, doipjs liest den Software-Namen aus NodeInfo aus, bei diesem Blog tatsächlich {"software":{"name":"wordpress","version":"7.1"}}, live nachgeprüft. Die naheliegende erste Reaktion darauf war „müsste da nicht Mastodon stehen?“, die Antwort gehört in diesen Beitrag: der Account ist ein Fediverse-Account, kein Mastodon-Account, Mastodon ist nur eine von mehreren Implementierungen. Ein Account auf mastodon.social würde [mastodon] zeigen, einer auf einer GoToSocial-Instanz [gotosocial]. Man könnte den Namen in NodeInfo fälschen, das wäre aber falsch und nicht nur stilistisch: Server und Clients passen ihr Verhalten am Software-Namen aus, sie würden dann Mastodon-spezifische Endpunkte abfragen, die hier gar nicht existieren, und es wäre eine unwahre Aussage in einem Profil, dessen ganzer Zweck überprüfbare Echtheit ist.
Frische Schlüsselbunde über gpg --auto-key-locate clear,<methode> --locate-external-keys liefern für WKD, DANE und Keyserver jeweils alle fünf Claims. Größen mit fünf Claims: WKD direkt 13178 Byte, der volle Download 17926 Byte, der DANE-Record 1368 Byte, davon 70 Byte allein für diesen neuen Claim. Im Actor liegt attachment[0] jetzt auf PropertyValueOpenPGP, attachment[1] auf dessen Note-Begleitung, der Wert steht als reiner Text ohne umschließendes <p>, weil ein vorhandenes Code-Snippet auf dem Blog genau das aus Extra-Field-Werten entfernt, ursprünglich damit Mastodons rel="me"-Linkprüfung funktioniert, die einen nackten <a> als Wurzelelement erwartet. Zwei verschiedene Prüfer, zwei verschiedene Annahmen über die Form derselben Daten, an dieser einen Stelle trifft es genau zusammen.
Auf Mastodon selbst zeigt sich das neue Profilfeld erst, wenn entfernte Instanzen den Actor erneut abrufen, absichtlich wurde keine Update-Aktivität verschickt, das wäre wieder der Geister-Post-Mechanismus von oben. Keyoxide betrifft das nicht, das Werkzeug holt den Actor bei jeder Prüfung frisch.
Fünf von fünf, seit heute auch der Fediverse-Claim.
Lektionen
„Bei mir ist alles richtig“ kann wahr sein und trotzdem scheitern. Entscheidend sind die Annahmen des Verifizierers über die Form der Daten, nicht nur der Inhalt. Den Quelltext des Prüfers lesen, bevor man die eigene Seite zum fünften Mal durchsucht.
Eine Plugin-Funktion für bessere Zukunftskompatibilität, hier FEP-fb2a, bricht einen Verbraucher, der gegen Mastodons Datenform geschrieben wurde. Für sich genommen ist keiner der beiden im Unrecht.
Eine versteckte Abhängigkeit blieb übrig: der Beweis funktioniert nur, solange das OpenPGP-Feld das erste Profilfeld ist. Wer eigene Extra Fields verwaltet, sollte das im Kopf behalten.
Ein Upstream-Report an doipjs auf Codeberg ist noch nicht eingereicht. Der eigentlich richtige Fix wäre ein Try/Catch pro Array-Element in runJSON, das würde nebenbei auch die Abhängigkeit von der Feldreihenfolge auflösen.
Aufgeklappt: Profil-Link, Proof-Link, und die Prüfung ist durch.
Selbst schon mal an einer Reihenfolge-Abhängigkeit zwischen zwei fremden Projekten verzweifelt, oder eigene Erfahrungen mit ActivityPub-Profilfeldern? Dann darfst du mich sehr gerne fragen.
Im August ging es hier darum, wie ich meinen OpenPGP-Schlüssel über Keyoxide an DNS, GitHub und Matrix gebunden habe. Seitdem hat sich beim Werkzeug selbst einiges getan, und das ist einen kurzen Nachtrag wert: es gibt jetzt eine Linux-App im Flathub, die Android-App wurde aktualisiert, und für Fragen rund um Keyoxide gibt es einen eigenen Matrix-Kanal.
Die Linux-App im Flathub
Bisher habe ich mein eigenes Profil und die meiner Kontakte immer im Browser aufgerufen. Jetzt gibt es dafür eine eigenständige Anwendung, installierbar direkt aus dem Flathub. Wichtig für die Einordnung: das ist ein Community-Paket, gepflegt vom Entwickler Berker und nicht offiziell vom Keyoxide-Projekt selbst herausgegeben, auf der Flathub-Seite steht das auch so. Unter der Haube steckt dieselbe Flutter-Codebasis wie in der Android-App, `keyoxide-flutter`.
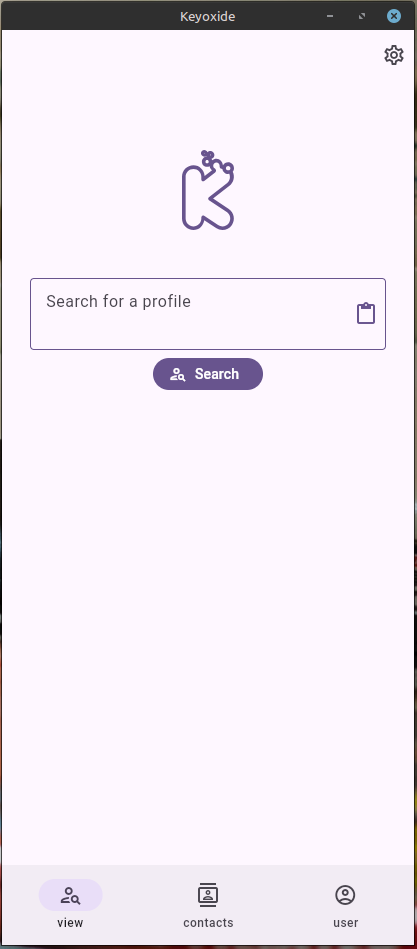
Auf meinem Linux Mint installiert, sieht der Einstieg schlicht aus: ein Suchfeld für ein beliebiges Profil, und darunter die eigene Profilansicht mit allen bestätigten Identity-Claims.
Die Keyoxide-App aus dem Flathub, Startbildschirm mit Suchfeld.
Das eigene Profil in der App, alle vier Claims mit grünem Haken.
Inhaltlich ändert das nichts an dem, was im August-Beitrag steht, DNS, GitHub und Matrix bleiben bestätigt, aber eine native App ist für den täglichen Gebrauch angenehmer als jedes Mal die richtige URL zu tippen.
Das Android-Update
Parallel zur Linux-App wurde auch die Android-Version aktualisiert, Version 2.4.4 auf Codeberg. Gleicher Entwickler, gleiche Codebasis, zwei Plattformen aus einer Quelle.
Der QR-Code, einmal nachgemessen
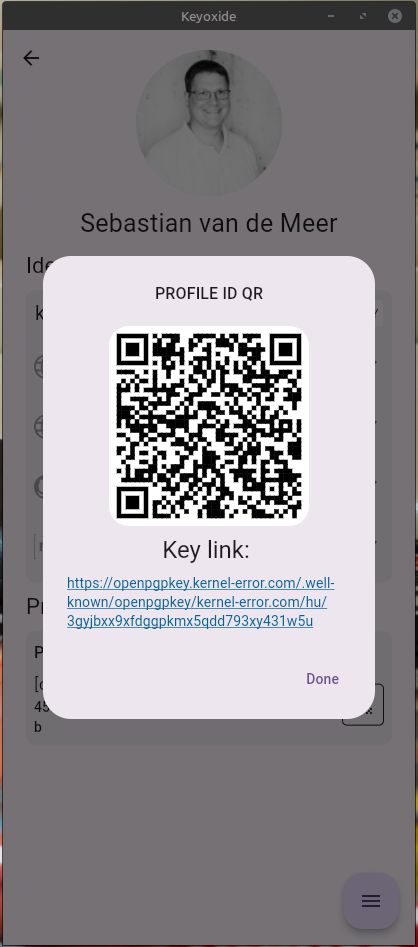
Die App zeigt unter „Profile ID QR“ einen QR-Code fürs eigene Profil, darunter als Klartext den sogenannten Key Link, die WKD-Adresse des öffentlichen Schlüssels. Bevor der hier landet, wollte ich wissen, ob der Code wirklich auf die richtige Datei zeigt und nicht auf einen veralteten Stand.
Profile ID QR mit dem Key Link im Klartext darunter.
Zwei Dinge lassen sich hier unabhängig nachrechnen. Erstens der Pfad selbst: Web Key Directory bildet die Adresse aus einem SHA-1-Hash des lokalen Teils der E-Mail-Adresse, Z-Base-32-kodiert. Für kernel-error@kernel-error.com ergibt sha1("kernel-error"), Z-Base-32-kodiert, exakt 3gyjbxx9xfdggpkmx5qdd793xy431w5u, also genau der Wert im Key Link. Zweitens der Inhalt: die Datei unter diesem Pfad lässt sich herunterladen und mit gpg --show-keys auswerten, der Fingerabdruck darin ist 45FC D081 ADB5 4872 EA5B 06B9 893D E0CD DE98 6DEB, derselbe wie im Screenshot und derselbe wie der seit Juli aktuelle Schlüssel. Der QR-Code zeigt also tatsächlich auf die richtige, aktuelle Datei, nicht auf einen Cache-Stand oder eine falsche Kodierung.
Ein Matrix-Kanal für Fragen
Wer selbst mit Keyoxide anfangen will oder unterwegs hängen bleibt, findet jetzt einen eigenen Raum für allgemeine Fragen: #keyoxide:matrix.org. Ich lese dort mit.
Ein Listener für IPv4 und IPv6 zusammen klingt nach der besseren Lösung. Ein Socket statt zwei, eine Konfigurationszeile weniger, ggf. ein Firewall-Regelwerk weniger zu pflegen. Bei QUIC auf diesem Blog lief das genau so, seit hier HTTP/3 aktiviert ist. Am 9. September 2026 ist mir aufgefallen, dass genau dieser eine Socket seit längerem dafür sorgt, dass nginx für die Hälfte der Clients ein Bit im IP-Header nie setzt, das QUIC eigentlich zwingend braucht. Kein Absturz, keine Fehlermeldung, kein Eintrag im Error-Log. Nur ein messbar höherer Anteil langsamer Verbindungen, der sich erst beim genauen Hinsehen als das entpuppt, was er ist.
Dieser Beitrag ist eine klassische Root-Cause-Analyse. Bug gefunden, Ursache im nginx-Quellcode verifiziert, Ursache zusätzlich im FreeBSD-Kernel nachvollzogen, gefixt, mit echten Produktionsdaten so gut wie möglich belegt.
Ein Socket für beides, das ist doch die naheliegende Wahl
Wer nginx mit QUIC betreibt, kennt die Direktive üblicherweise so:
Ein einziger IPv6-Socket mit ipv6only=off nimmt sowohl echte IPv6-Verbindungen als auch IPv4-Verbindungen an, dank IPv4-mapped-IPv6-Adressen (::ffff:a.b.c.d) nach RFC 3493. Ein Socket statt zwei, eine Zeile Konfiguration weniger. Genau deshalb ist das die naheliegende Wahl, wenn man von TCP kommt, wo dieser Trick seit Jahrzehnten problemlos funktioniert.
Bei QUIC ist genau dieser eine Socket ein Problem, und zwar eines, das man im laufenden Betrieb nicht sieht. Zumindest nicht sofort und nicht überall. Es müssen schon ein paar Dinge zusammen kommen um das Problem selbst zu fühlen. Fühlen? Eine lllaaaaannnngggggssssaaaaammmmeeeee Verbindung über IPv4.
Warum QUIC bei Fragmentierung empfindlicher ist als TCP über TLS
UDP datagrams MUST NOT be fragmented at the IP layer. In IPv4, the Don’t Fragment (DF) bit MUST be set if possible, to prevent fragmentation on the path.
Das ist keine Empfehlung, das ist ein MUST NOT direkt neben einem MUST. QUIC ermittelt seine eigene passende Paketgröße für einen Netzwerkpfad, entweder über klassisches PMTUD (das auf ICMP-Antworten angewiesen ist und auf der IP-Ebene ansetzt, das DF-Bit ist Teil genau dieses Mechanismus) oder über DPLPMTUD nach RFC 8899, das mit eigenen Sondierungspaketen arbeitet und ganz ohne ICMP auskommt. Wichtig ist hier nicht, welcher der beiden Mechanismen die Größe ermittelt, sondern was beide voraussetzen: ein zu großes Paket muss sauber verworfen werden, mit oder ohne ICMP-Antwort, statt fragmentiert beim Empfänger anzukommen. Wer sich jetzt an ICMPv6 für IPv6 erinnert fühlt, japp 🙂
Genau das geht in vielen Netzen schief, sobald ein Paket doch fragmentiert wird. Fragment-Filterung ist eine verbreitete Firmen- und Provider-Härtung, gerade weil fragmentierte Pakete historisch für allerlei Unfug missbraucht wurden. Solche Netze werfen fragmentierte QUIC-Pakete einfach weg, ohne jede Rückmeldung. QUICs eigene Verlusterkennung kann das von gewöhnlichem Paketverlust nicht unterscheiden, im schlechtesten Fall wird daraus eine Serie von Retransmissions und Timeouts statt eines schnellen, sauberen Fehlers. Bei TCP über TLS würde ein fragmentiertes Paket in den allermeisten Netzen einfach ankommen und zusammengesetzt werden, das ist dort seit jeher normaler Betrieb und niemanden juckt das DF-Bit besonders. Bei QUIC ist Fragmentierung der Fall, den das Protokoll bewusst ausschließen will, und genau der tritt hier auf.
Die Ursache, gefunden im nginx-Quellcode
Der Fund steckt in src/core/ngx_connection.c, in der Funktion ngx_configure_listening_sockets() (nicht zu verwechseln mit ngx_open_listening_sockets(), einer anderen Funktion in derselben Datei, die die Sockets öffnet, aber nicht die MTU-Discovery-Optionen setzt). Diese Funktion läuft beim Start und bei jedem Restart über alle bereits gebundenen Listen-Sockets und setzt dort die passenden Socket-Optionen. Der entscheidende Ausschnitt, wörtlich aus nginx 1.30.4:
Beide Zweige prüfen ls[i].sockaddr->sa_family, also die Adressfamilie des Listen-Sockets selbst, fest zum Zeitpunkt des Socket-Setups. Nicht die Familie des Ziels, an das ein bestimmtes Paket später geht. Für listen [::]:443 quic ... ipv6only=off; ist sa_family immer AF_INET6, egal ob ein konkretes Paket an einen echten IPv6-Host oder an eine IPv4-mapped-Adresse geht. Der AF_INET-Zweig, der IP_DONTFRAG fürs echte IPv4-Datagramm setzen würde, wird für diesen Socket schlicht nie erreicht.
Ein kleines Detail für alle, die selbst nachlesen: der IPv6-Fallback-Zweig (das #elif (NGX_HAVE_IP_DONTFRAG) im letzten Block) ist mit demselben Feature-Makro abgesichert wie der IPv4-Zweig, nicht mit dem separat getesteten NGX_HAVE_IPV6_DONTFRAG. Auf FreeBSD ändert das am Ergebnis nichts, hier sind beide Makros gesetzt, aber es ist eine kleine Ungenauigkeit im nginx-Quellcode selbst. So zumindest meine Interpretation, korrigiert mich gerne!
Der eigentliche Denkfehler dahinter: IPv6 hat gar kein DF-Bit
Wer IPV6_DONTFRAG im Code sieht, könnte annehmen, dass damit dasselbe Problem für IPv6 gelöst wird wie IP_DONTFRAG für IPv4. Ist es nicht, und der Unterschied ist der eigentliche Kern dieses Bugs.
Der IPv6-Header hat schlicht kein DF-Bit, weil er keines braucht. RFC 8200 verbietet Routern im Pfad die Fragmentierung von IPv6-Paketen grundsätzlich, das steht wörtlich in Abschnitt 4.5 (der auf Abschnitt 5 verweist): „unlike IPv4, fragmentation in IPv6 is performed only by source nodes, not by routers along a packet’s delivery path“. IPV6_DONTFRAG ist die tatsächliche RFC-3542-Option, Abschnitt 11.2 der Spezifikation, aber sie steuert nur, ob der sendende Host selbst über einen Fragment-Extension-Header fragmentieren darf. Ein Problem, das aus Sicht von IPv6 gar nicht existiert, sobald man es nicht selbst provoziert.
IP_DONTFRAG auf der IPv4-Seite ist dagegen keine RFC-3542-Option, sondern eine BSD-Socket-Erweiterung außerhalb dieses Standards. Zwei Optionen, die im Code wie ein symmetrisches Paar aussehen, lösen in Wirklichkeit zwei völlig verschiedene Probleme.
Und jetzt der Punkt, an dem beide Welten aufeinandertreffen. Ein send() auf diesem IPv6-Socket an eine IPv4-mapped-Zieladresse bringt am Ende ein echtes IPv4-Datagramm auf die Leitung, das ist Standardverhalten von Dual-Stack-Sockets nach RFC 3493. Dieses Datagramm braucht ein gesetztes DF-Bit im IPv4-Header, ein komplett anderes Feld als alles, was IPV6_DONTFRAG je anfasst. Der oben gezeigte Code-Pfad kommt an dieses Feld nie heran, weil er für einen AF_INET6-Socket ausschließlich die IPv6-Variante der Option setzt. Kann man das also auch irgendwie ein legacy IPv4 Problem nennen?
Warum ein einfacher Zusatz-Aufruf auf FreeBSD gar nicht helfen würde
Die naheliegende Reaktion: warum ruft nginx auf diesem Socket nicht einfach zusätzlich setsockopt(IPPROTO_IP, IP_DONTFRAG) auf? Ich bin dem im FreeBSD-Kernel-Quellcode nachgegangen, und die Antwort ist, dass das auf FreeBSD gar nicht funktionieren würde.
Der Options-Handler für einen AF_INET6-Socket ist ip6_ctloutput() in sys/netinet6/ip6_output.c, und der lehnt Optionen außerhalb von IPPROTO_IPV6 rundweg ab:
Ein setsockopt(fd, IPPROTO_IP, IP_DONTFRAG, ...) auf einem AF_INET6-Socket landet also mit EINVAL im Nichts. Das allein wäre schon Antwort genug, aber der zweite Teil ist genauso wichtig: wo genau setzt der Kernel das DF-Bit für einen IPv4-mapped-Send, der über einen IPv6-Socket rausgeht? In udp_usrreq.c, in der Funktion, die das eigentliche IPv4-UDP-Paket zusammenbaut:
if (inp->inp_flags & INP_DONTFRAG)
    ((struct ip *)ui)->ip_off |= htons(IP_DF);
Das DF-Bit wird nur gesetzt, wenn am PCB (dem Protocol Control Block der Verbindung) das Flag INP_DONTFRAG hängt. Und dieses Flag setzt ausschließlich ip_ctloutput() in ip_output.c, wenn IP_DONTFRAG auf IPPROTO_IP-Ebene erfolgreich gesetzt wurde, also genau der Aufruf, der auf einem AF_INET6-Socket mit EINVAL scheitert. Der IPv4-mapped-Sendepfad selbst führt übrigens tatsächlich über genau diese Funktion: udp6_send() in udp6_usrreq.c erkennt eine v4-mapped-Zieladresse auf einem Dual-Stack-Socket, gibt die eigenen Locks frei und ruft direkt udp_send(), also dieselbe IPv4-UDP-Ausgabefunktion, die auch ein echter AF_INET-Socket benutzt.
Damit schließt sich der Kreis / Beisst die Katze sich in den Schwanz, ihr wisst schon. INP_DONTFRAG kann nur über einen erfolgreichen IP_DONTFRAG-Aufruf auf einem echten AF_INET-Socket gesetzt werden, und ein AF_INET6-Socket kann diesen Aufruf laut ip6_ctloutput() gar nicht erst absetzen. Der Socket-Split ist auf FreeBSD damit nicht nur der pragmatische, sondern der einzig mögliche Fix. Ein hypothetischer nginx-Patch, der einfach den fehlenden setsockopt-Aufruf ergänzt, würde am Kernel selbst scheitern, bevor er überhaupt etwas bewirkt.
Was sich zwischen FreeBSD und Linux unterscheidet, und was nicht
Der Bug, wenn ich das so nennen darf, selbst sitzt im nginx-Quellcode und ist plattformunabhängig. Dieselbe sa_family-Abfrage wird auf Linux und FreeBSD gleich kompiliert und ist auf beiden gleichermaßen falsch.
Was sich unterscheidet, ist welche Socket-Option-API überhaupt zur Verfügung steht. IP_MTU_DISCOVER mit dem Wert IP_PMTUDISC_DO ist eine Linux-Erweiterung (auch musl bringt das Makro mit, nicht nur glibc), auf FreeBSD schlicht nicht deklariert. FreeBSD bietet stattdessen IP_DONTFRAG und IPV6_DONTFRAG. nginx testet im configure-Lauf beide Varianten (auto/unix, Feature-Tests für NGX_HAVE_IP_MTU_DISCOVER, NGX_HAVE_IP_DONTFRAG, NGX_HAVE_IPV6_DONTFRAG) und wählt zur Kompilierzeit die passende Variante. Auf dieser FreeBSD-Installation landet man im IP_DONTFRAG/IPV6_DONTFRAG-Zweig, und genau der ist von dem oben beschriebenen Bug betroffen.
Was ich nicht verifiziert habe, weil mir dafür ein Linux-Vergleichssystem fehlt (ich zu faul war eines aus dem Glas zu ziehen): ob sich das praktische Fehlerbild zwischen den beiden Kerneln tatsächlich unterscheidet, also wie stark Retransmissions ausfallen oder wie der jeweilige Kernel beim v4-mapped-Sendepfad mit dem DF-Äquivalent umgeht. Linux‘ PMTUD-Verhalten für genau diesen Fall könnte sich abweichend verhalten. Ehrliches Fazit an dieser Stelle: der nginx-Bug ist universell im Quellcode, das konkret beobachtete Fehlerbild ist hier ausschließlich für FreeBSD dokumentiert. Eine Aussage wie „genauso kaputt auf Linux“ würde ich ohne echten Beleg, also Paketmitschnitt oder Kernel-Quellcode-Analyse auf einem Linux-System, nicht treffen. Vielleicht mache ich mir die Mühe noch…. Vielleicht 😀
Der Fix: zwei Listener statt einem
Die Lösung ist, den einen Dual-Stack-Listener in zwei eigenständige Listener zu splitten, damit IPv4-Clients einen echten AF_INET-Socket bekommen, für den der obere Codepfad tatsächlich greift:
Ein Stolperstein dabei, den man sich leicht selbst stellt: ein einfaches zusätzliches listen 443 quic; neben einem unveränderten Dual-Stack-Socket kollidiert mit „Address already in use“, weil der alte Socket die IPv4-Wildcard-Adresse über ipv6only=off ja schon abdeckt. ipv6only muss auf dem IPv6-Listener also explizit auf on gesetzt werden, sonst gibt es keinen sauberen Split, sondern nur einen Fehlstart. Je nachdem, wie „ordentlich“ seine Konfiguration ist, kann es einen Moment dauern, alle diese Stellen zu finden, denn das muss für die komplette nginx Konfiguration angepasst sein!
Erster Stolperstein: ein reload reicht nicht
Eine reine ipv6only-Änderung an einem bestehenden QUIC-Socket erkennt nginx‘ Socket-Reuse-Logik bei einem reload nicht als neuen Socket. Bei mir blieb der alte Dual-Stack-Socket nach einem reinen reload laut sockstat weiter als udp46 aktiv, trotz fehlerfrei geprüfter Konfiguration (nginx -t) und trotz eines nginx -T-Dumps, der die neue Konfiguration bereits korrekt anzeigte. Ist bei solchen Dingen hin und wieder so, machen andere Dienste ja auch. Große Dinge wie Socket, wird oft nur bei einem echten Neustart vom Deinst gesetzt.
nginx -t prüft Syntax und versucht, referenzierte Dateien zu öffnen. Es sagt nichts darüber aus, ob ein bereits offener, laufender Listen-Socket bei einem Reload tatsächlich neu gebunden wird. Erst ein vollständiger service nginx restart hat die getrennten Sockets tatsächlich neu gebunden:
sockstat -4 -l | grep 443   # nur udp4
sockstat -6 -l | grep 443   # nur udp6
Nach dem Restart tauchte in der PROTO-Spalte ausschließlich udp4 und udp6 auf, kein einziges udp46 mehr auf Port 443. Das ist der eigentliche Beleg für den Reload-Stolperstein, keine Datei-Deskriptor-Analyse, nur der Blick auf einen laufenden Prozess. Das reiht sich in ein Muster ein, das mir auf dieser Infrastruktur schon öfter untergekommen ist: ein neues geladenes Modul, ein neuer server_name in einer bestehenden reuseport-Gruppe, jetzt ein ipv6only-Wechsel. Immer wieder dasselbe Grundmuster, ein Reload reicht bei bestimmten Änderungen an Listen-Sockets schlicht nicht. Aber ich wiederhole mich, hm?
Zweiter Stolperstein: jeder vHost braucht den Split
Der erste Durchlauf hat nur den Default-Server-Socket gesplittet. Alle anderen vHosts mit eigenem listen [::]:443 quic;, aber ohne eigenes listen 443 quic;, hingen danach nur noch am neuen IPv6-only-Socket. IPv4-QUIC-Verbindungen zu diesen Domains landeten beim Default-vHost, weil die SNI-Zuordnung auf dem neuen IPv4-Socket schlicht ins Leere lief. Sichtbar wurde das am falschen ausgelieferten TLS-Zertifikat und an einer Default-Antwort statt der eigentlich erwarteten.
Die Lehre daraus: bei einem reuseport-Split müssen alle Server-Blöcke der Adressgruppe angepasst werden, nicht nur der Default-Server. Der IPv4-Listener eines jeden weiteren vHosts docken danach ohne reuseport und ohne default_server einfach an die schon bestehende Gruppe an:
listen [::]:443 quic;
listen 443 quic;
Was im Error-Log nicht zu finden ist
Das nginx-Error-Log auf Level info, die komplette 15-Tage-Rotation samt .bz2-Archiven, enthält keine einzige [warn], [error] oder [crit]-Zeile mit QUIC-Bezug, weder vor noch nach dem Fix. Eine gezielte Suche nach den vier exakten Alert-Meldungen, die der oben zitierte Code beim Fehlschlagen eines setsockopt-Aufrufs loggen würde, kommt in der gesamten Historie null Mal vor. Vielleicht sollte ich das noch im Logging aufbohren, wenn möglich?!
Das ist methodisch wichtig: diese Alert-Meldungen enthalten das Wort „quic“ gar nicht. Ein reines grep -i quic im Error-Log hätte einen echten Fehlschlag dieser Aufrufe also gar nicht gefunden, selbst wenn es einen gegeben hätte. Erst die gezielte Suche nach dem exakten Meldungstext schließt aus, dass die Socket-Optionen fehlgeschlagen sind. Sie wurden erfolgreich gesetzt, nur eben die falsche Option für die falsche Adressfamilie. Kein Aufruf-Fehler, sondern genau der beschriebene Bug.
Warum das Error-Log strukturell nicht mehr hergibt: nginx sendet das UDP-Datagramm erfolgreich an den Kernel, die Fragmentierung passiert danach im Netz, an einem Router oder einer Middlebox, oder schon beim sendenden Host selbst, falls das ausgehende Interface-MTU überschritten wird. Davon bekommt der laufende nginx-Prozess in keinem Fall etwas mit. Wer nach diesem Bug im Error-Log sucht, wird nichts finden. Das ist erwartbar, nicht beruhigend, und ein blindes grep quic hätte selbst einen echten Konfigurationsfehler an dieser Stelle übersehen. Genau das ist der Punkt. Man sieht es am Server fast nur, wenn man auch einen tcpdump macht und auswertet. Denn die UDP Pakete gehen ja auf die Reise, sind sie nicht als „unzerteilbar“ markiert, kann und wird auf dem Weg aber bestimmt irgendein Router oder eine Firewall anfangen die Pakete klein zu hacken und dann ist es „kaputt“.
Verifikation über das Access-Log, und ihre Grenzen
nginx zeigt IPv4-Clients, die über einen Dual-Stack-Socket hereinkommen, im Access-Log als IPv4-mapped-Adresse (::ffff:a.b.c.d). Nach dem Fix kommen IPv4-QUIC-Clients über einen echten AF_INET-Socket herein und erscheinen als reine IPv4-Adresse ohne dieses Präfix. Diese Darstellung allein beweist schon, durch welchen Socket eine Verbindung lief, unabhängig von jeder Performance-Messung, aber eben auch unabhängig von jeder direkten Fragmentierungs-Messung.
Ausgewertet habe ich das Access-Log des Blogs (Format goa_ext, enthält $request_time), 13 Tage vor dem Fix plus den laufenden Tag danach, alle HTTP/3.0-Requests, aufgeteilt nach Adressdarstellung:
Zeitraum
Requests
Ø request_time
Max
Anteil über 1 s
vorher, IPv4 über kaputten Dual-Stack-Socket
12.537
0,461 s
130,3 s
5,33 %
nachher, IPv4 über eigenen udp4-Socket
946
0,037 s
1,4 s
0,42 %
Kontrollgruppe, natives IPv6, vorher
17.320
0,113 s
67,3 s
1,86 %
Kontrollgruppe, natives IPv6, nachher
1.168
0,082 s
5,7 s
2,14 %
Die betroffene IPv4-Gruppe lag vorher bei 5,33 Prozent über einer Sekunde, fast das Dreifache der IPv6-Baseline von 1,86 Prozent, und fällt nach dem Fix auf 0,42 Prozent, unter die IPv6-Baseline von 2,14 Prozent im selben Zeitraum. Genau dieser Kontrollgruppen-Vergleich macht die Zahlen für mich aussagekräftig, als Korrelation, die zur quellcode-basierten Root-Cause-Analyse passt, nicht als eigenständigen Fragmentierungsbeweis.
Eine zeitliche Punktprobe passt ins Bild: Restart am 9. September 2026 um 18:38:31 Uhr, letzter Request über den kaputten Dual-Stack-Pfad um 17:56:46 Uhr, erster Request über den neuen Pfad um 18:41:36 Uhr. Seit dem Restart lief keiner der 946 IPv4-HTTP/3.0-Requests mehr über die alte Darstellung. Das liegt plausibel am Restart-Zeitpunkt, mit einer Lücke ohne Traffic dieser Art von 42 Minuten davor und 3 Minuten danach bis zum ersten neuen Request, aber es ist kein exakter Sekundentreffer und ich beschreibe es auch nicht so.
Genauso wichtig wie die Zahlen sind für mich ihre Grenzen, deshalb ein eigener Absatz dafür statt eines Nebensatzes:
Ein fehlendes DF-Bit erlaubt Fragmentierung, es erzwingt sie nicht. Ein Datagramm, das auf jedem Hop unter dem dortigen MTU bleibt, ist unabhängig vom DF-Bit unproblematisch. Das kann zu Fragmentierung führen, es führt nicht automatisch dazu.
Die Adressdarstellung im Access-Log beweist, welchen Socket nginx verwendet hat. Sie sagt nichts über den DF-Bit-Zustand, die tatsächliche Paketgröße, die reale PMTU oder echte Fragmente auf der Leitung aus. Das gilt hier ohne Einschränkung, weil dieser vHost direkt am Internet hängt, ohne vorgeschaltete Proxy- oder Load-Balancer-Schicht, die $remote_addr umschreiben könnte.
Der Vergleich von 13 Tagen vorher gegen einen Teil eines Tages nachher ist kein kontrollierter Leistungsvergleich. Trafficmix, Client-Geografie, Cache-Zustand, Backend-Last und Tageszeit unterscheiden sich zwangsläufig. Die Zahlen sind ein starkes Indiz, kein experimenteller Beweis.
Die IPv6-Kontrollgruppe ist nicht vollständig unverändert geblieben. Nur der Anteil über einer Sekunde bleibt in vergleichbarer Größenordnung. Mittelwert und Maximum verschieben sich durchaus, vermutlich schlicht durch allgemein geringere Last oder einen anderen Trafficmix zum jeweiligen Zeitpunkt.
Eine Retransmission-Spirale statt eines schnellen Fails ist ein plausibles, aber kein garantiertes Symptom. Wie sich ein verlorenes, fragmentiertes QUIC-Paket konkret auswirkt, hängt von der Verlusterkennung und der PMTU-Implementierung der beteiligten QUIC-Stacks ab, auf Client- wie auf Serverseite.
Ein wirklich abschließender Beweis bräuchte einen Vorher- und Nachher-Paketmitschnitt, der das DF-Bit direkt zeigt, im Idealfall mit einem kontrollierten Test gegen ein reduziertes MTU. Ohne den betrachte ich die Produktionszahlen als starke, durch eine Kontrollgruppe abgesicherte Korrelation, die zur quellcode-basierten Root-Cause-Analyse passt, nicht als direkten Fragmentierungsbeweis. Ein Mitschnitt von der Vorher-Seite liegt inzwischen vor, dazu der nächste Abschnitt.
Ein Paketmitschnitt vom Tag vor dem Fix schließt einen Teil der Lücke
Nachtrag vom 12. September 2026: Der vorherige Abschnitt musste ohne einen echten Paketmitschnitt auskommen. Der liegt inzwischen vor. Zwei rund 41 Sekunden lange Aufzeichnungen vom 8. September 2026, einen Tag vor dem Fix, eine direkt auf dem Server, die andere gleichzeitig auf einem Notebook, das die Seite über ein anderes Netz aufgerufen hat. Beide zusammen zeigen den echten HTTP/3-Verkehr eines einzelnen Seitenaufrufs.
Ausgewertet mit tcpdump -r <Datei> -n -v, ein tshark stand mir nicht zur Verfügung. Jedes Paket trägt im IP-Header ein Identification-Feld, und das ist in beiden Mitschnitten innerhalb des Beobachtungsfensters durchgehend eindeutig, keine einzige Dopplung unter den mehr als dreitausend vom Server verschickten Paketen. Darüber lassen sich einzelne Datagramme zwischen den beiden Aufzeichnungen zweifelsfrei einander zuordnen, nicht nur über Summen vergleichen.
Richtung
Beim Server verschickt
Beim Notebook angekommen
Abgleich
Notebook zu Server
1.147, alle mit DF-Bit
1.147, alle mit DF-Bit
identisch, per ID geprüft
Server zu Notebook, klein genug fürs MTU
898, kein DF-Bit
898, dieselben IDs
0 Prozent Verlust
Server zu Notebook, fragmentiert, kein DF-Bit
2.162 erste Fragmente
878, per ID zugeordnet
1.284 fehlen, 59,4 Prozent
Kein einziges der 1.147 Pakete vom Notebook zum Server fehlt das DF-Bit, kein einziges der 3.060 Pakete in der Gegenrichtung trägt eines. Das bestätigt den Fund aus dem Quellcode jetzt direkt auf der Leitung, nicht nur über die Adressdarstellung im Access-Log. 2.162 dieser Server-Pakete sind schon beim Verlassen des Servers fragmentiert, jedes erste Fragment exakt 1500 Byte lang, also an der Ethernet-MTU gekappt. Von diesen 2.162 erscheinen im Notebook-Mitschnitt nur 878 wieder, eins zu eins über die ID zugeordnet. 1.284 fehlen komplett, das sind 59,4 Prozent. Die 898 kleinen, unfragmentierten Antworten kommen dagegen alle an, ebenfalls per ID geprüft und nicht bloß über die Summe verglichen. Über die ganzen 41 Sekunden verteilt liegt der fehlende Anteil in jedem Fünf-Sekunden-Fenster zwischen 51 und 68 Prozent. Kein Ausreißer am Anfang oder Ende der Aufzeichnung, der auf einen Zeitversatz zwischen den beiden Mitschnitten hindeuten würde.
Die zweite Hälfte jedes fragmentierten Datagramms taucht in keinem der beiden Mitschnitte auf. Vermutlich wurde mit einem Filter auf den UDP-Port aufgezeichnet, und ein IP-Fragment ohne den ersten Teil trägt keinen UDP-Header, an dem so ein Filter ansetzen könnte. Das lässt offen, ob einzelne der 878 angekommenen ersten Fragmente trotzdem nie vollständig zusammengesetzt werden konnten, weil ihre zweite Hälfte fehlte. 59,4 Prozent sind deshalb eine gemessene Untergrenze für den tatsächlichen Verlust, keine Obergrenze. Und es bleibt eine einzelne Sitzung, ein Client, ein Pfad, eine Zeitspanne von 41 Sekunden, kein Beleg für eine feste Verlustquote im ganzen Netz.
So sieht der Unterschied im Rohformat aus, Adressen durch Platzhalter ersetzt:
12:01:29.758438 IP (id 0, offset 0, flags [DF], length 1280)
    CLIENT.35577 > SERVER.443: UDP, length 1252
12:01:29.771757 IP (id 51997, offset 0, flags [+], length 1500)
    SERVER.443 > CLIENT.35577: UDP, length 1480
Dieser Mitschnitt stammt vom Tag vor dem Fix, ein gepaarter Mitschnitt von danach existiert aus dem echten Betrieb nicht. Der Versuch direkt nach dem Fix blieb leer, weil der dafür verwendete Client kein echtes HTTP/3 sprach und der Mitschnitt dadurch keinen QUIC-Verkehr enthielt. Die Vorher-Nachher-Zahlen aus dem Access-Log oben bleiben deshalb weiterhin die Grundlage für den gemessenen Effekt des Fixes. Was dieser Mitschnitt zusätzlich liefert, ist der direkte Beleg für den Mechanismus dahinter: das fehlende DF-Bit und die Fragmentierung selbst sind jetzt nicht mehr nur aus dem Quellcode abgeleitet, sondern auf der Leitung beobachtet.
Fazit
Ein einzelner Dual-Stack-Socket für QUIC ist offenbar kein Einzelfall, sondern eher ein wiederkehrendes Footgun-Muster über verschiedene Implementierungen hinweg. quic-go, die von Marten Seemann entwickelte QUIC-Bibliothek, musste DPLPMTUD auf älteren macOS-Versionen abschalten, weil sich das DF-Bit auf einem Dual-Stack-Socket dort schlicht nicht setzen ließ, und dokumentiert das offen. Ein separates Issue im selben Projekt beschreibt ein anderes, aber verwandtes Dual-Stack-Problem gerade auf FreeBSD (fehlgeschlagenes sendmsg für IPv4-mapped-Adressen), mit einem Verweis auf FreeBSDs eigene inet6(4)-Manpage, die für AF_INET6-Sockets ganz grundsätzlich empfiehlt, zwei getrennte Sockets zu verwenden, aus Sicherheitsgründen, unabhängig von QUIC. Die Empfehlung, IPv4 und IPv6 getrennt zu halten, existierte auf dieser Plattform also schon, bevor QUIC überhaupt erfunden wurde. Für den konkreten Fall hier heißt das, dass der Socket-Split kein Workaround für einen einzelnen nginx-Bug ist, sondern die Rückkehr zu der Architektur, die FreeBSD für genau diese Situation ohnehin vorsieht.
Ein Socket für beides bleibt bei TCP über TLS ein legitimer, funktionierender Kompromiss. Bei QUIC ist er, zumindest auf dieser Kombination aus nginx und FreeBSD, ein stiller Bug, der sich weder im Error-Log noch im laufenden Betrieb meldet, sondern nur über einen erhöhten Anteil langsamer Verbindungen bemerkbar macht. Wer selbst QUIC auf einem Dual-Stack-Listener betreibt, findet die Antwort auf die Frage, welchen Socket ein Client gerade benutzt, mit dem Access-Log-Trick oben in wenigen Minuten selbst heraus.
Der Servername im TLS-Handshake steht bis heute im Klartext im Netz, unabhängig davon, wie gut die DNS-Anfrage davor verschlüsselt war. Wer DNS over HTTPS oder DNS over TLS einsetzt, verbirgt den Lookup selbst, aber sobald der Browser die eigentliche Verbindung aufbaut, nennt das Client Hello die besuchte Domain im Server Name Indication Feld offen. Jeder Netzwerkbeobachter zwischen Client und Server sieht damit weiterhin, welche Website gerade aufgerufen wird, egal wie sauber DNS-Ebene und Transportebene sonst verschlüsselt sind.
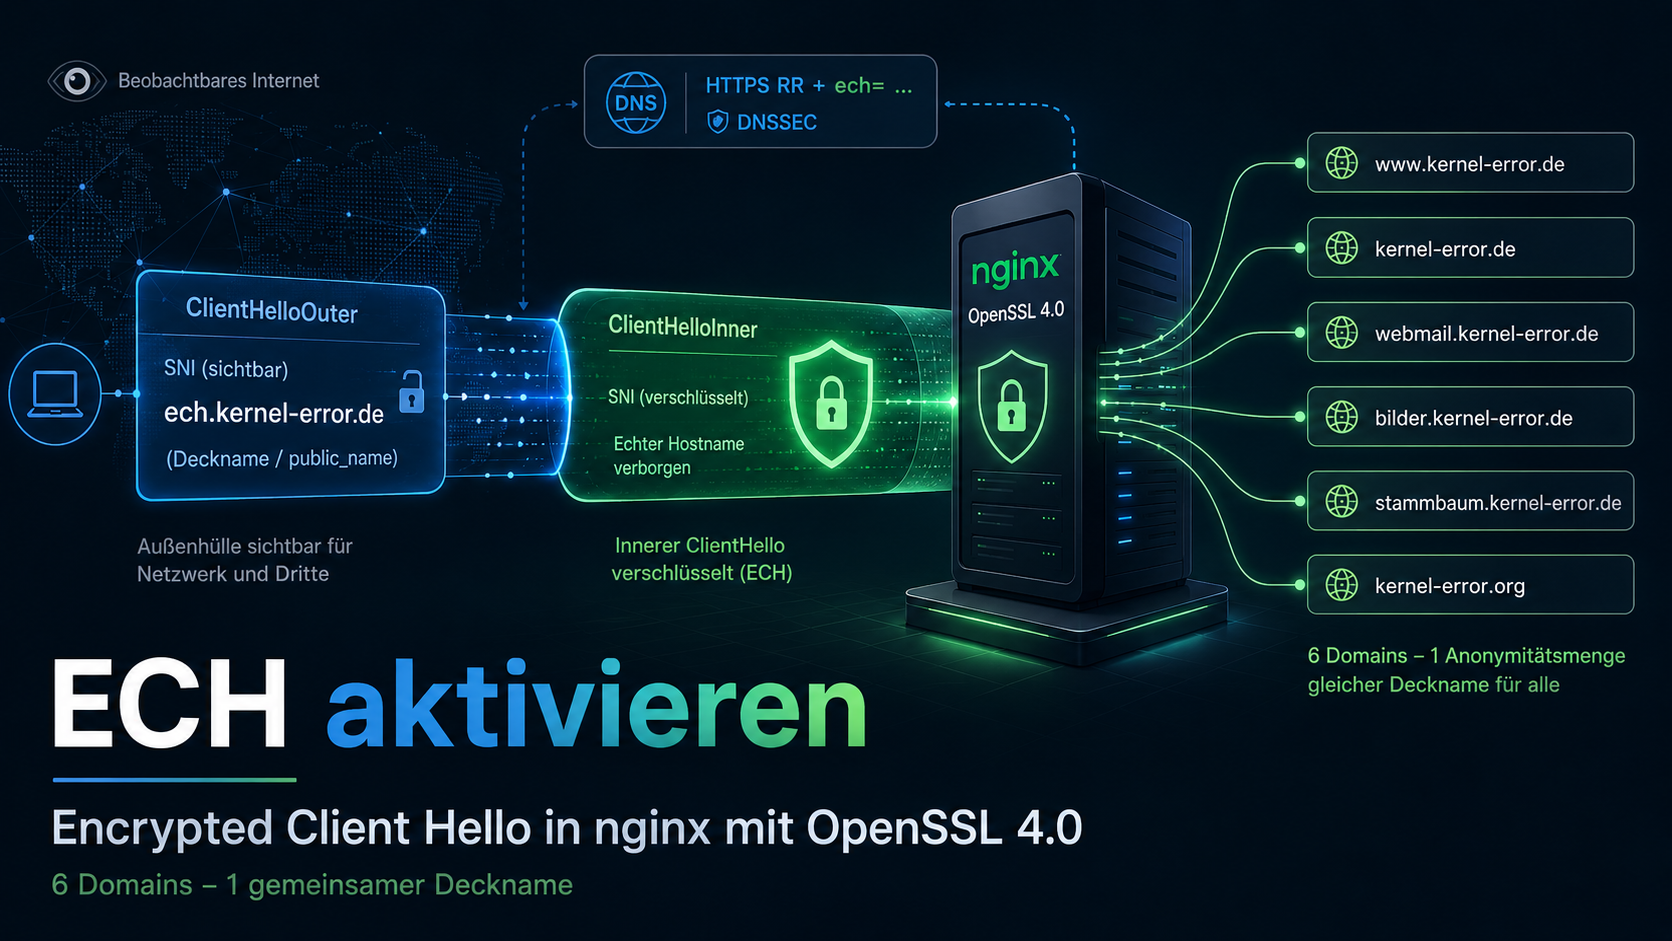
Encrypted Client Hello schließt genau diese Lücke, indem der eigentliche Servername in einen zweiten, verschlüsselten Client Hello wandert. Der folgende Beitrag beschreibt, wie ECH auf dieser Infrastruktur aktiviert wurde: mit OpenSSL 4.0 als Voraussetzung, nginx als Ports-Build und sechs Domains, die sich einen gemeinsamen Deckname teilen. Alle Befehle, Konfigurationsausschnitte und Testausgaben stammen aus dem produktiven Rollout und sind gegengeprüft, aktuell laufen alle sechs sauber verifiziert.
Was Encrypted Client Hello eigentlich verbirgt
Ein ECH-Verbindungsaufbau enthält zwei Client Hellos statt einem. Das äußere ist wie gewohnt unverschlüsselt, trägt aber nicht die echte Domain, sondern einen Deckname. Das innere steckt verschlüsselt im äußeren und enthält die tatsächlich angefragte Domain:
ClientHelloOuter: unverschlüsselt sichtbar, enthält public_name
ClientHelloInner: verschlüsselt, enthält die tatsächlich besuchte Domain
Der Server entschlüsselt das innere Client Hello mit einem Schlüssel, den er vorher über DNS veröffentlicht hat, wählt anhand der darin enthaltenen echten SNI den passenden vHost aus und antwortet als wäre nie ein Deckname im Spiel gewesen. Für den Browser läuft das komplett automatisch ab, sobald der Server ECH per DNS anbietet.
Voraussetzungen, bevor es losgeht
OpenSSL 4.0 oder neuer (ECH ist seit dem stabilen 4.0.0-Release vom 14. April 2026 Bestandteil, im Alpha-/Dev-Branch bereits ab 10./11. März 2026 verfügbar), alternativ BoringSSL
nginx 1.29.4 oder neuer, mit der Direktive ssl_ech_file (hier im Einsatz: 1.30.4)
eine DNSSEC-signierte Zone ist sinnvoll, aber keine normative ECH-Voraussetzung, dazu weiter unten mehr
Auch der erste Punkt ist keine Formalität. Das Lighttpd-Wiki führt ECH aktuell weiterhin als EXPERIMENTAL und nennt dieselbe Voraussetzung, OpenSSL 4.0 oder BoringSSL. ECH ist über die Server-Landschaft hinweg gesehen noch frisch, entsprechend lohnt vor dem eigenen Rollout ein Blick auf die aktuell installierte Softwareversion, nicht auf das, was vor einem halben Jahr noch galt.
Der Umstieg auf OpenSSL 4.0 als Ausgangspunkt
nginx läuft in dieser Jail als Ports-Build, nicht als Repo-Paket, weil das Paket Brotli und headers_more deaktiviert ausliefert. Damit lässt sich die verwendete OpenSSL-Hauptversion über die SSL-Flavor-Einstellung in /etc/make.conf steuern und nginx anschließend dagegen neu bauen:
Ein reload reicht an dieser Stelle ausdrücklich nicht. Die neuen Shared Libraries werden erst beim vollständigen Neustart der Worker-Prozesse eingebunden, ein reload behält die alten libssl-Bindings der laufenden Prozesse bei. Die neue Version zeigt sich danach direkt im Server-Build:
$ nginx -V
built with OpenSSL 4.0.1 9 Jun 2026
public_name ist die eigentliche Entscheidung
ssl_ech_file ist keine Bastellösung und kein Fork, sondern eine echte, in nginx-Mainline gemergte Direktive, sichtbar direkt im Quellcode unter src/http/modules/ngx_http_ssl_module.c und src/event/ngx_event_openssl.c. Technisch nutzt sie die OSSL_ECHSTORE-API, die mit OpenSSL 4.0 dazugekommen ist.
Der eigentlich entscheidende Wert ist public_name, der Name, der im unverschlüsselten ClientHelloOuter sichtbar bleibt. Ein Netzwerkbeobachter sieht ihn ohnehin, ECH hin oder her. Setzt man ihn auf die eigene, echte Domain, bringt die ganze Übung keinerlei Verschleierung: der Beobachter sieht exakt den Namen, den er auch ohne ECH gesehen hätte, nur mit einem zusätzlichen Handshake-Schritt drumherum.
Echten Schutz gibt es nur mit einem gemeinsamen public_name über mehrere unabhängige Domains hinweg, dem Anonymitätsset-Prinzip. Genau so macht es Cloudflare mit cloudflare-ech.com als Deckname für Millionen Kundendomains: wer nur sieht, dass jemand eine Verbindung zu cloudflare-ech.com aufbaut, weiß damit nichts über die konkret besuchte Seite unter den Millionen dahinter.
Ein gemeinsamer public_name reicht dafür allein aber noch nicht. Im ClientHelloOuter steht neben dem public_name auch die config_id unverschlüsselt, ein einzelnes Byte, das die verwendete ECHConfig identifiziert. Nutzt jede Domain einen eigenen ECH-Schlüssel, hat jede Domain automatisch auch eine eigene config_id, und ein Beobachter kann die Domains trotz identischem Deckname allein anhand dieses Bytes unterscheiden. RFC 9849 bringt es auf den Punkt: verwendet ein Server für verschiedene Servernamen unterschiedliche ECHConfig-Werte, hat jedes Anonymitätsset effektiv Größe 1, also gar keinen Effekt. Die Konsequenz für den eigenen Aufbau: alle teilnehmenden Domains müssen denselben Schlüssel und dieselbe ECHConfig nutzen, nicht nur denselben Deckname.
Diese eine nginx-Instanz hostet bereits rund zwanzig unabhängige Domains auf derselben IP, darunter dieser Blog, eine Therapiepraxis-Website, eine Fotogalerie, private Familienseiten, Webmail und ein URL-Shortener. Die Voraussetzung für ein eigenes, kleines Anonymitätsset war also schon da, es musste nur genutzt werden.
Umgesetzt wurde ein dedizierter Deckname, ech.kernel-error.de, ohne eigenen Inhalt. Sechs Domains teilen sich einen gemeinsamen ECH-Schlüssel und damit dieselbe ECHConfig, denselben public_name und dieselbe config_id: www.kernel-error.de, die Apex-Domain kernel-error.de, webmail.kernel-error.de, bilder.kernel-error.de und kernel-error.org als eigene, ebenfalls DNSSEC-signierte Zone. Die TLS-Zertifikats-Schlüssel der einzelnen Domains bleiben davon unberührt getrennt, das ist ein anderes Schlüsselpaar als der ECH-HPKE-Schlüssel und für die Anonymitätsset-Eigenschaft ohne Belang. stammbaum.kernel-error.de, ein CNAME auf www, erbt die ECH-Konfiguration automatisch per DNS-CNAME-Chasing, ganz ohne eigenen Eintrag.
Schlüssel erzeugen
Für die Schlüsselerzeugung braucht es das Port-OpenSSL unter /usr/local/bin/openssl, nicht das Base-System-OpenSSL von FreeBSD, dem fehlt der ech-Subcommand komplett:
Der Base64-Block zwischen den ECHCONFIG-Markern ist exakt der Wert, der später als ech=-Parameter in den DNS-Eintrag wandert. Das PEM-Format selbst folgt keinem nginx- oder OpenSSL-eigenen Standard, sondern ist mittlerweile als RFC 9934 festgeschrieben, hervorgegangen aus dem Internet-Draft draft-farrell-tls-pemesni, den auch das DEfO-Projekt in seinen ech-dev-utils dokumentiert.
Ein gemeinsamer Schlüsselspeicher für alle Domains
Bei mehreren Domains mit gemeinsamem public_name gehört ssl_ech_file auf die http{}-Ebene in der nginx.conf, noch vor die vHost-Includes, nicht in die einzelnen vHost-Dateien:
Der Grund liegt in der Reihenfolge des Handshakes. Die ECH-Entschlüsselung passiert, bevor nginx anhand der noch verschlüsselten echten SNI überhaupt den passenden vHost auswählen kann. In diesem Moment entscheiden die äußere SNI, also der gemeinsame public_name, und die vom Client mitgeschickte config_id, welcher Schlüssel überhaupt zum Entschlüsseln probiert wird. Ein Store auf http{}-Ebene stellt sicher, dass genau dieser eine, gemeinsame Schlüssel unabhängig vom initial per SNI getroffenen Serverblock verfügbar ist, egal welche der sechs Domains die Verbindung eigentlich betrifft.
Ein eigenes Zertifikat für den Deckname
Der Deckname selbst braucht ein eigenes Zertifikat mit ausschließlich diesem einen SAN-Eintrag, kein Wildcard-Zertifikat, das nebenbei auch die echten Domains auflistet. Sonst verrät schon das äußere Zertifikat die Domain-Familie, selbst wenn die konkrete Domain im Handshake verschlüsselt bleibt:
Die ECH-Konfiguration wird nicht als eigener Record-Typ verteilt, sondern als zusätzlicher ech=-SvcParam an der ohnehin schon vorhandenen HTTPS-Resource-Record angehängt, und zwar identisch auf allen sechs teilnehmenden Domains. Der Bootstrap-Mechanismus dafür steht in RFC 9848.
Eine DNSSEC-signierte Zone ist dafür nicht normativ vorgeschrieben, aber sinnvoll: ohne Signatur kann ein Man in the Middle den ech=-Parameter einfach aus der Antwort entfernen, ein klassischer Downgrade auf Klartext-SNI, den ein validierender Resolver mit DNSSEC erkennt. Vor jeder Form von Downgrade schützt das trotzdem nicht: ein Angreifer kann die gesamte HTTPS/SVCB-Auflösung unterdrücken statt sie zu manipulieren, und gegen dieses Denial hilft DNSSEC allein nicht.
Verifikation nach dem Rollout
Der naheliegende erste Test ist openssl s_client mit dem passenden ECH-Config-List-Wert. Ohne ein gesetztes CA-Bundle lassen sich ein echter ECH-Fehler und ein simpler Zertifikatsfehler dabei nicht unterscheiden, -CAfile ist deshalb Pflicht, nicht optional:
Derselbe Test läuft identisch, mit demselben Base64-Wert und demselben Erfolg, auch für kernel-error.de, webmail.kernel-error.de, bilder.kernel-error.de und kernel-error.org, alle fünf gegen dieselbe ECHConfig verifiziert.
Für eine unabhängige Zweitmeinung von außen eignet sich das externe Tool echcheck. Es prüft nicht nur, ob der Handshake gelingt, sondern auch DNS-Veröffentlichung, verwendete Kryptografie, das innere Zertifikat und die Retry-Konfiguration einzeln:
ECHConfig aus dem DNS: ✓
finale ECH-Version 0xfe0d: ✓
X25519, HKDF-SHA256, AES-128-GCM: ✓
öffentlicher Name ech.kernel-error.de: ✓
echter ECH-Handshake: Accepted (TLS 1.3): ✓
gültiges inneres Zertifikat: ✓
gültige Retry-Konfiguration, Wiederholung erfolgreich: ✓
SNI Leakage: ✓ (Einzel-SAN-Zertifikat für den Deckname)
Certificate (outer): ✓ (Einzel-SAN-Zertifikat für den Deckname)
In allen neun geprüften Kategorien kommt ein Haken zurück, auch bei den beiden Punkten, die erst nach dem Einzel-SAN-Zertifikat für den Deckname sauber wurden. Ein einmaliger CLI-Test sagt aber nichts darüber, ob echte Clients die Funktion später auch tatsächlich nutzen. Dafür lohnt sich ein erweitertes Log-Format, das den ECH-Status jeder einzelnen Verbindung mitschreibt:
Im laufenden Traffic zeigen sich damit bereits echte ech_status=SUCCESS-Verbindungen, neben NOT_TRIED für Clients ohne ECH-Unterstützung und GREASE für Clients, die absichtlich eine leere ECH-Erweiterung mitschicken, um Middleboxen an das Feld zu gewöhnen. Genau dieser Log-Eintrag ist der eigentliche Erfolgsnachweis, nicht der einzelne CLI-Test.
Während dieser TLS-Arbeiten am selben Server ist außerdem noch ein kleinerer Nebenfund aufgetaucht: ein externer TLS-Scan meldete, dass der Server unter TLS 1.2 weiterhin SHA-224 als Hash-Funktion für die Signatur beim Schlüsselaustausch akzeptierte, obwohl die konfigurierten Cipher-Suiten ohnehin ausschließlich ECDSA nutzen. RFC 9847 stuft SHA-224 in der TLS-HashAlgorithm-Registry inzwischen als „Discouraged“ ein, während SHA-256, SHA-384 und SHA-512 dort als „Recommended“ geführt werden. Ein guter Grund, es trotzdem weiter anzubieten, findet sich aber nicht, wenn SHA-256 und höher ohnehin zur Verfügung stehen. Unter TLS 1.3 stellt sich die Frage gar nicht erst, dort ist für SHA-224 kein Signature Scheme registriert, die Hash-Funktion lässt sich strukturell nicht wählen.
Cipher-Suite und Signaturalgorithmus fürs Handshake sind zwei getrennte Stellschrauben, eine sauber konfigurierte Cipher-Suite sagt nichts über die andere aus. Ohne explizite Vorgabe verwendet OpenSSL seine Default-Liste der SignatureAlgorithms, und die enthält SHA-224 weiterhin aus Kompatibilitätsgründen:
Peer signing digest: SHA224
New, TLSv1.2, Cipher is ECDHE-ECDSA-CHACHA20-POLY1305
Der Fix ist eine Zeile in der gemeinsamen TLS-Konfigurationsdatei, damit gilt sie automatisch für alle vHosts, nur ECDSA-Varianten gelistet, passend zum bestehenden reinen ECDSA-Cipher-Setup:
Auch hier reichte ein reload nicht, erst ein vollständiger Neustart übernahm die geänderte Liste, aus demselben Grund wie beim OpenSSL-Umstieg weiter oben. Danach lehnt der Server SHA-224 ab, SHA-256 funktioniert unverändert:
OpenSSL 4.0 war die technische Voraussetzung für diesen Umstieg, die eigentliche Entscheidung fiel aber woanders. Ein ECH-Setup mit dem eigenen Domainnamen als public_name wäre in wenigen Minuten fertig gewesen und hätte am Ende nichts verschleiert. Der Wert liegt allein in einem gemeinsamen Deckname über mehrere unabhängige Domains, und den gab es hier schon, bevor überhaupt eine Zeile Konfiguration geschrieben wurde.
Firefox unterstützt ECH seit Version 118, standardmäßig aktiv ist es seit Version 119, jeweils automatisch sobald ein Server es per DNS anbietet. Bei Chromium-basierten Browsern lässt sich keine ebenso feste Versionsgrenze nennen, der Rollout läuft dort gestaffelt über Channel und Policy. Der Nutzer muss in beiden Fällen nichts einstellen, die Aushandlung läuft beim ersten Verbindungsaufbau im Hintergrund. Wie schnell sich diese Versionsstände weiterentwickeln, lässt sich hier nicht dauerhaft verlässlich festschreiben, ein aktueller Blick in die jeweilige Browser-Dokumentation lohnt bei Zweifeln also immer.
Wer selbst mehrere unabhängige Domains auf derselben IP betreibt, hat die Grundvoraussetzung für ein eigenes Anonymitätsset damit häufig schon, ganz ohne Cloudflare oder einen anderen großen Anbieter dazwischen.
Vor zwölf Jahren habe ich hier beschrieben, wie der Familienkalender meiner Frau in die ownCloud gewandert ist. Vorher gab es ein Büchlein in ihrer Tasche und einen großen Kalender an der Wand, und beide waren selten einer Meinung. Seitdem liegen Termine und Kontakte unter eigener Kontrolle, und alles Mögliche greift darauf zu. Nur ein Gerät hat es nie getan: das Telefon am Schreibtisch.
Das hat mich lange nicht gestört, bis ich es einmal ausprobiert habe. Ein Anruf kommt rein, auf dem Bildschirm steht eine nackte Rufnummer, und ich sitze vor einem Rechner, auf dem 144 Kontakte mit genau dieser Nummer liegen. Das ist albern.
Mein sipgate-Konto ist alt. Wie alt genau, wusste ich selbst nicht mehr. In diesem Blog taucht sipgate erstmals im August 2009 auf, und 2015 habe ich beim Abschalten meiner alten 01801-Nummer geschrieben, ich hätte sie „vor ? 13 ? Jahren“ bekommen. Die Fragezeichen waren schon damals meine. Also habe ich einfach den Support gefragt, ausdrücklich nur aus Neugier. Die Antwort kam am nächsten Morgen: angemeldet am 30. April 2005. Da sipgate 2004 mit den Basis-Accounts gestartet ist, bin ich also aus dem ersten Jahr dabei, gut zwanzig Jahre. Dass sich jemand die Mühe macht, so eine reine Neugier-Frage überhaupt zu beantworten, finde ich bemerkenswert.
Was ich wollte, war jedenfalls nichts Exotisches: ein Softphone unter Linux, das an diesem Konto hängt und beim Klingeln in mein eigenes Adressbuch schaut statt in gar keines. Dazu am besten noch die Kalender, damit ich beim Telefonieren sehe, ob der Termin, über den gerade gesprochen wird, überhaupt frei ist.
Der Weg dahin war überraschend kurz, aber die naheliegenden Kandidaten führen alle in die Irre. Deshalb schreibe ich beides auf.
Warum der naheliegende Weg nicht funktioniert
Der erste Reflex ist, das Softphone des Anbieters zu nehmen. Bei sipgate steht dazu im eigenen Hilfecenter, dass es unter Linux nicht installiert, sondern nur ausgeführt wird, dass es kein 64 Bit kann, also weder auf x86_64 noch auf ARM läuft, und dass der Support in Kürze eingestellt wird und keine Updates mehr kommen. Das ist eine erfrischend ehrliche Ansage, hilft aber nicht weiter.
Der zweite Reflex heißt Linphone, und das ist die Falle, in der ich am längsten gesteckt habe. Linphone kann CardDAV wirklich, die Funktionen stecken vollständig in der Bibliothek liblinphone. Nur hat die Oberfläche der paketierten Version keinen einzigen Schalter dafür, dort gibt es bei den Adressbuchquellen ausschließlich LDAP. In die Oberfläche kam CardDAV erst mit Version 6.0, und die liegt in keinem einzigen Linux-Distributionsrepo. Ein Blick auf Repology zeigt für linphone-desktop gerade einmal AUR bei 6.1.2, alles andere hängt bei 4.x oder 5.x, Debian unstable bei 5.2.6. Der Hersteller selbst liefert für Linux ausschließlich AppImages aus, ohne veröffentlichte Prüfsumme und ohne eingebettete Update-Information. Wer sich nicht um Aktualisierungen kümmern will, ist damit an der falschen Adresse.
Blink fällt aus, weil es zwar ein ausgereifter SIP-Client ist, beim Adressbuch aber nur Google Contacts kennt. GNOME Calls wäre technisch ein Weg, ist aber für Telefone gebaut und als Desktop-Softphone dünn.
Nebenbei: die Frage wird gestellt. Im Nextcloud-Forum steht ein Thread vom August 2025 mit genau diesem Wunsch, und der Fragesteller verweist darin auf einen älteren Thread zum selben Thema, der ohne Ergebnis blieb. Die Antworten waren eine kommerzielle Lösung und ein Umweg über die FRITZ!Box. Was ich jetzt benutze, kam in keinem der beiden vor.
Die Kette, die tatsächlich funktioniert
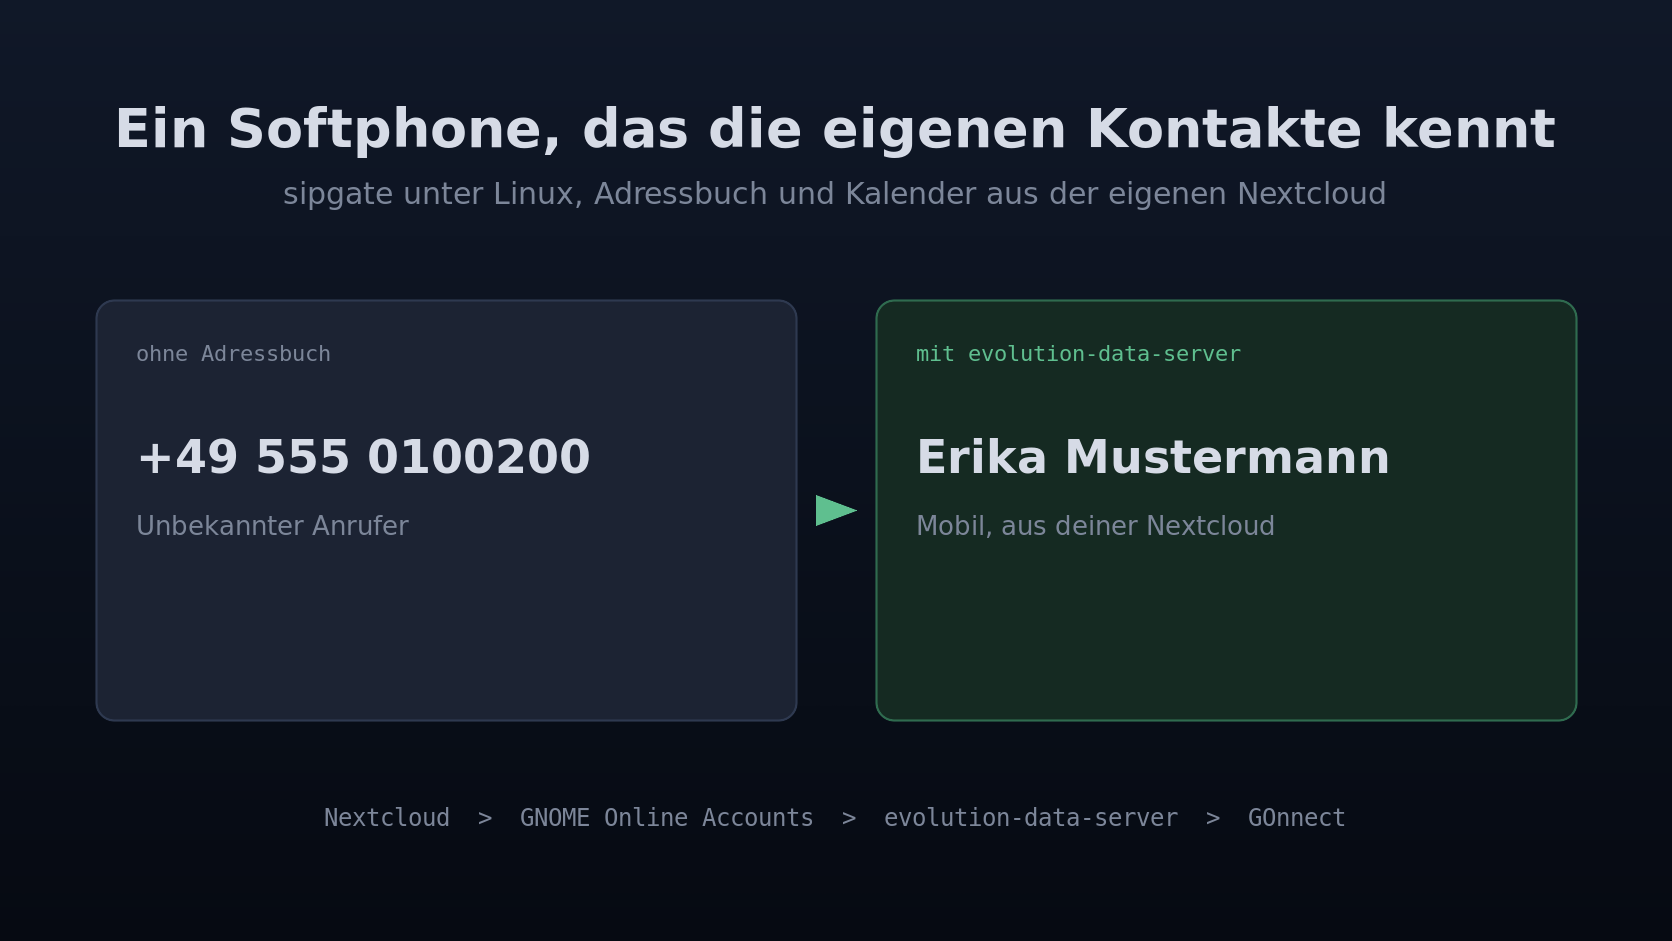
Der Trick besteht darin, dass das Softphone gar nicht mit der Nextcloud sprechen muss. Unter Linux gibt es dafür längst eine Zwischenschicht, und die heißt evolution-data-server. Sie ist auf so gut wie jedem Desktop installiert, weil Kalender- und Kontaktanwendungen darauf aufsetzen. Und sie spricht CalDAV und CardDAV von Haus aus.
Das Softphone ist damit austauschbar, und die Zugangsdaten der Cloud liegen genau an einer Stelle statt in jeder Anwendung noch einmal. Als Softphone nehme ich GOnnect von der GONICUS GmbH, einem Open-Source-UC-Client, den es als Flatpak auf Flathub gibt. Er kann als Adressbuchquellen LDAP, CardDAV, CSV und eben evolution-data-server.
Dass er über Flathub kommt, war für mich das Ausschlusskriterium gegen alles andere. Ein AppImage müsste ich von Hand nachziehen, ein Flatpak läuft mit flatpak update einfach mit.
Schritt 1: Die Nextcloud in die Online-Konten hängen
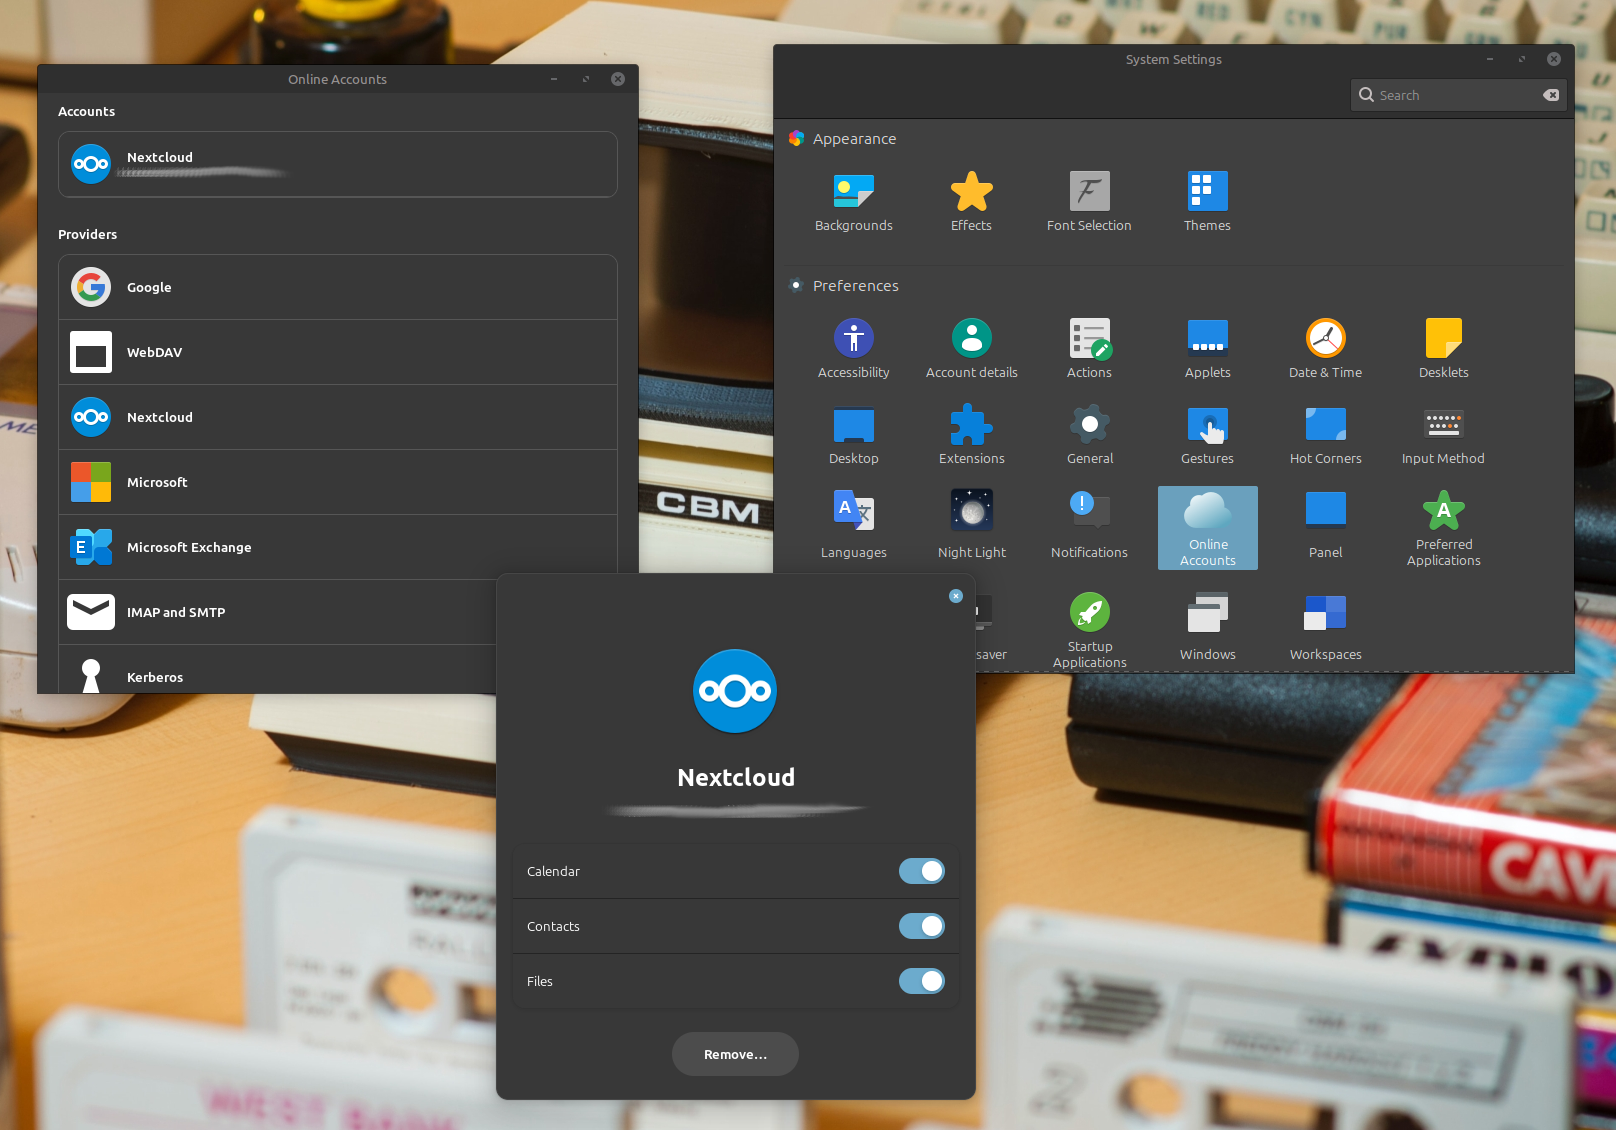
Unter Linux Mint findest du das unter „Online-Konten“, dahinter steckt gnome-online-accounts-gtk. Dort legst du ein Konto vom Typ Nextcloud an, trägst die Adresse deiner Instanz, deinen Benutzernamen und ein App-Passwort ein und hakst Kalender und Kontakte an.
Ein Konto vom Typ Nextcloud in den Online-Konten, Kalender und Kontakte angehakt. Ab hier kennt der ganze Rechner die Daten, nicht nur ein Programm.
Nimm dafür wirklich ein App-Passwort aus den Sicherheitseinstellungen deiner Nextcloud und nicht dein normales. Falls du später den Zugriff eines einzelnen Rechners zurückziehen willst, geht das damit mit einem Klick, ohne dass du überall sonst neue Zugangsdaten eintragen musst.
Wenn es geklappt hat, sieht die Konfiguration hinterher so aus:
Auf AcceptSslErrors=false lohnt ein Blick. Steht dort true, akzeptiert die Verbindung kaputte Zertifikate, und dann kannst du dir den ganzen Rest sparen.
Ab hier haben alle Programme auf dem Rechner Zugriff, die evolution-data-server nutzen. Das Softphone ist nur eines davon.
Schritt 2: GOnnect installieren
flatpak install flathub de.gonicus.gonnect
Das war der ganze Schritt. Rund 310 MB, und beim ersten Start liest GOnnect die Kontakte und Kalender aus evolution-data-server ein, ohne dass du irgendwo CardDAV konfigurieren müsstest. Bei mir standen im Protokoll direkt beim ersten Start:
gonnect.app.addressbook: Found 1 active configurations for address book plugin "EDS"
gonnect.app.feeder.EDSAddressBookFeeder: Loaded 144 contact(s) of source "Kontakte"
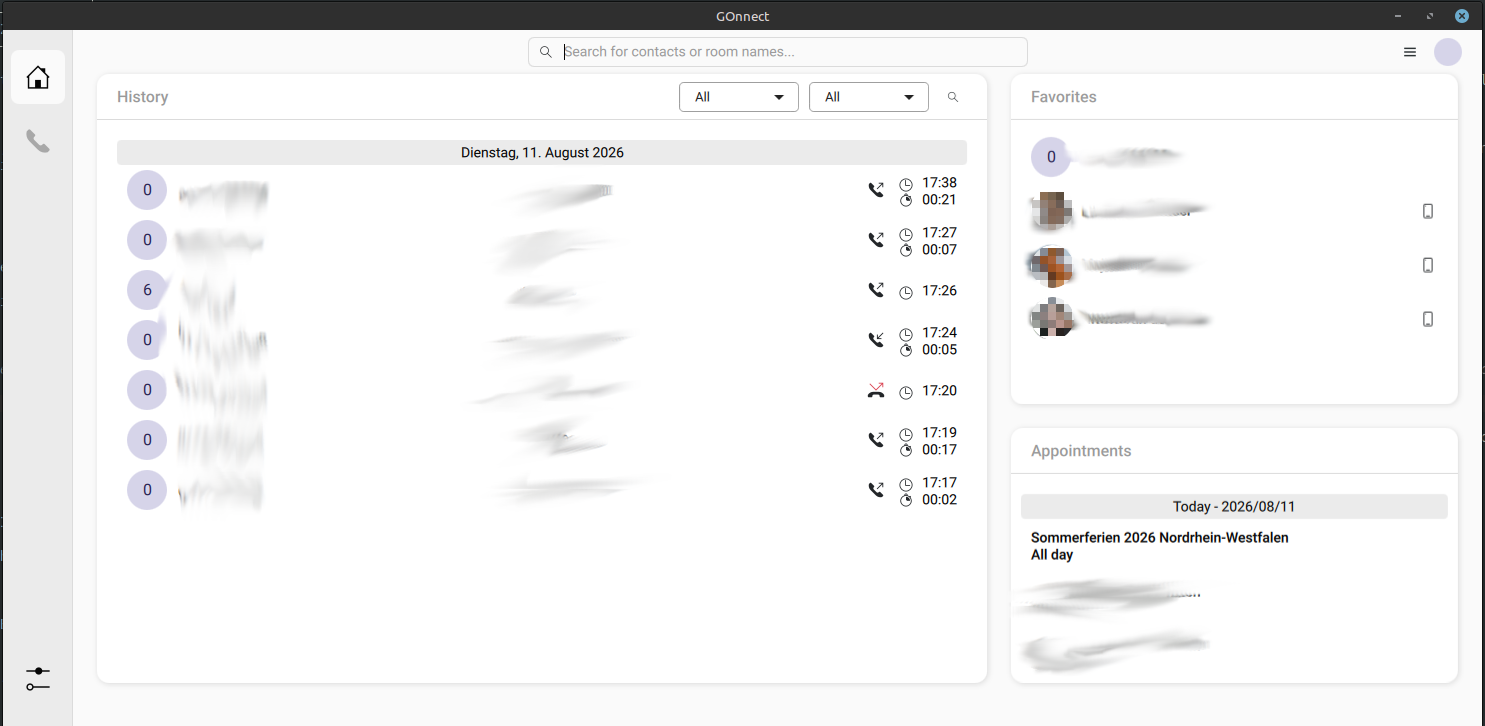
Ja, und die Kalender ebenfalls, inklusive der Familienkalender aus dem Beitrag von 2014. Die stehen dann rechts im Fenster, unter den Favoriten und neben der Anrufliste.
Links die Anrufliste, rechts die Favoriten und darunter die Termine aus dem Familienkalender. Namen, Nummern und Kontaktbilder sind unkenntlich gemacht.
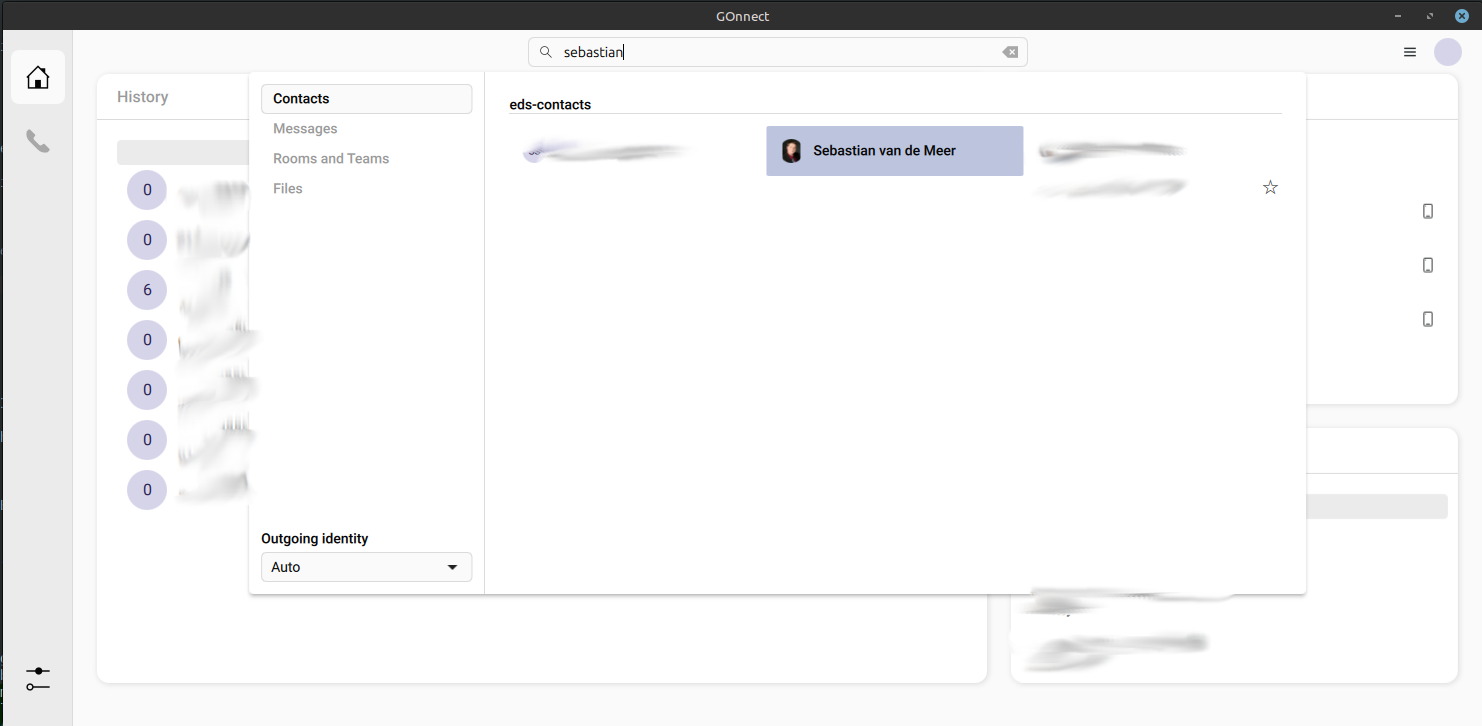
Und die Suche oben im Fenster greift auf dasselbe Adressbuch zu. Ein paar Buchstaben genügen, dann steht der Treffer da, und darüber die Quelle, aus der er kommt: eds-contacts. Genau darum ging es. Kein Zwischenschritt, kein Export, keine zweite Kontaktverwaltung im Softphone.
Ein paar Buchstaben genügen. Über dem Treffer steht die Quelle: eds-contacts, also das Adressbuch aus der eigenen Nextcloud.
Schritt 3: Das sipgate-Konto eintragen
Hier kommt die Eigenheit von GOnnect, an der man sich einmal stoßen muss: es gibt keinen Einrichtungsassistenten und keinen Einstellungsdialog für das SIP-Konto. Der Client ist dafür gebaut, in Firmen ausgerollt zu werden, und erwartet deshalb eine fertige Konfigurationsdatei. Die liegt hier:
Unter der Haube arbeitet PJSIP, entsprechend sehen die Schlüssel aus. Das hier ist die vollständige Konfiguration, die bei mir mit einem sipgate-Basis-Konto läuft:
1234567e0 ist deine SIP-ID aus dem sipgate-Konto, nicht deine Rufnummer.
Wichtig ist die Zeile type=digest. Du kannst dort auch dein Passwort im Klartext hinterlegen, aber das musst du nicht. SIP authentifiziert sich per Digest, und der Hash dafür ist schlicht MD5(Benutzer:Realm:Passwort). Den rechnest du dir selbst aus:
Das Ergebnis kommt hinter data=. Danach setzt du die Datei noch auf chmod 600.
Damit steht dein Passwort nicht mehr wörtlich in einer Konfigurationsdatei. Ehrlich bleiben muss man trotzdem: der Hash ist für diesen Realm genauso viel wert wie das Passwort selbst, wer ihn hat, kann sich anmelden. Der Gewinn ist ein anderer. Falls du dieses Passwort irgendwo sonst auch verwendest, liegt es hier nicht lesbar herum.
Ein Detail, das mich beim Ändern der Datei erwischt hat: GOnnect muss dabei beendet sein. Der Client schreibt die Datei beim Beenden aus dem Speicher zurück und überschreibt deine Änderungen sonst kommentarlos.
Was der Desktop davon merkt
Zwei Dinge sind mir erst im Betrieb aufgefallen, und beide gehören zu der Sorte, die man nicht vermisst, solange man sie nicht kennt.
Wenn ein Anruf reinkommt oder du selbst einen startest, pausiert die laufende Medienwiedergabe von selbst. Das YouTube-Video im Firefox hält an, der Musikplayer ebenso, und nach dem Auflegen läuft beides weiter. Dahinter steckt MPRIS, die Schnittstelle, über die sich Medienplayer unter Linux fernsteuern lassen. Für mich war das der Moment, in dem sich das Ding nicht mehr nach Fremdkörper angefühlt hat, sondern nach Teil des Desktops.
Das zweite: sip:-Links auf Webseiten funktionieren. Ein Klick darauf öffnet die Anwendung und wählt sofort. Der Client trägt sich beim Installieren als Handler für dieses Schema ein, du musst dafür nichts konfigurieren.
Verschlüsselung, und warum eine Zeile davon die wichtigste ist
sipgate kann das seit über zwanzig Jahren. Heise hat am 1. Februar 2006 über „sipgate-Crypto“ berichtet, damals schon mit TLS für die Signalisierung und SRTP für die Sprache bis zum Festnetz-Gateway. Das Problem war seinerzeit, dass kaum ein Endgerät mitspielte, weshalb sipgate passende Hardware gleich mit anbot. Zwanzig Jahre später kann es jedes Gerät, und trotzdem steht es in kaum einer Anleitung.
Eingeschaltet ist es nämlich nicht von allein. Die Standardkonfiguration läuft über UDP und unverschlüsselt, du musst zwei Dinge selbst ändern: sip.sipgate.de als Proxy eintragen und die Signalisierung von UDP auf TLS umstellen.
Interessant ist, was danach passiert. In der sipgate-Dokumentation steht dieser Satz:
Bei verschlüsselter Signalisierung erfordern wir ebenfalls, dass die Sprachdaten verschlüsselt werden. Ist diese Einstellung falsch, so werden Anrufe mit Fehler „488 No Acceptable here“ abgewiesen.
Sobald die Signalisierung verschlüsselt ist, erzwingt sipgate also auch die Sprachverschlüsselung. Das ist die angenehmste Sorte Sicherheitsentscheidung, weil sie einem die Wahl abnimmt. srtpUse=mandatory ist damit nicht meine Strenge, sondern schlicht das, was die Gegenseite ohnehin verlangt. Ein optional würde dir nichts retten, der Anruf käme trotzdem nicht zustande, nur mit einer verwirrenderen Fehlermeldung.
Kleine Randbemerkung, weil es mich gefreut hat: gefunden habe ich diesen Satz nicht durch Klicken im Hilfecenter, sondern hier:
curl https://help.sipgate.de/llms-full.txt
Das ist das komplette Hilfecenter als eine Textdatei, rund 350 KB, gedacht als maschinenlesbare Fassung für Sprachmodelle. Zum Durchsuchen mit grep ist das erheblich angenehmer als jede Suchmaske, und es beantwortet Fragen, die im Menü drei Ebenen tief liegen. Ich habe so etwas seit einer Weile selbst auf diesem Blog liegen, und es ist schön zu sehen, dass es sich langsam herumspricht.
Die eigentlich wichtige Zeile ist eine andere, und die steht in keinem Beispiel, das ich gefunden habe:
Die Voreinstellung von PJSIP ist verifyServer=false. Übersetzt heißt das: die Verbindung wird verschlüsselt, aber es wird nicht geprüft, mit wem. Jedes beliebige Zertifikat wird angenommen. Gegen jemanden, der auf dem Weg sitzt und die Verbindung übernimmt, ist so eine Verschlüsselung wertlos, weil er einfach sein eigenes Zertifikat vorzeigt. Erst mit diesen zwei Zeilen wird geprüft, und zwar gegen den Zertifikatsspeicher deines Systems.
Nachmessen statt glauben
Dass die Registrierung mit code=200 klappt, sagt über die Verschlüsselung nichts. Also nachsehen. Der einfachste Test zeigt, wohin die Verbindung überhaupt geht:
Port 5061, und auf Port 5060 liegt nichts mehr, es läuft also kein Klartext-SIP nebenher. Meine eigene Adresse habe ich ersetzt, die Gegenstellen sind echt. Ein whois auf 2001:ab7::/36 nennt die netzquadrat GmbH, und sip.sipgate.de löst genau auf diese Adressen auf. Das Zertifikat dazu:
TLSv1.2:
  TLS_ECDHE_RSA_WITH_AES_256_GCM_SHA384 (ecdh_x25519) - A
  TLS_ECDHE_RSA_WITH_CHACHA20_POLY1305_SHA256 (ecdh_x25519) - A
  ...
TLSv1.3:
  TLS_AKE_WITH_AES_256_GCM_SHA384 (ecdh_x25519) - A
  TLS_AKE_WITH_CHACHA20_POLY1305_SHA256 (ecdh_x25519) - A
  TLS_AKE_WITH_AES_128_GCM_SHA256 (ecdh_x25519) - A
cipher preference: server
least strength: A
Das Ergebnis ist erfreulich unaufgeregt. Es gibt nur TLS 1.2 und 1.3, die alten Versionen habe ich gegengeprüft und beide werden abgelehnt. Alles bewertet mit A, der Server bestimmt die Reihenfolge, und das Zertifikat ist RSA mit 4096 Bit. Ausgehandelt wird in der Praxis TLS 1.3 mit TLS_AES_256_GCM_SHA384 über X25519.
Ein Schönheitsfehler bleibt: unter TLS 1.2 stehen auch noch reine TLS_RSA_WITH_*-Suiten in der Liste, also solche ohne Forward Secrecy. Weil der Server die Reihenfolge vorgibt und ECDHE oben steht, bekommt sie in der Praxis niemand, sie sind der Rückfall für Uraltgeräte. Schöner wäre es trotzdem ohne.
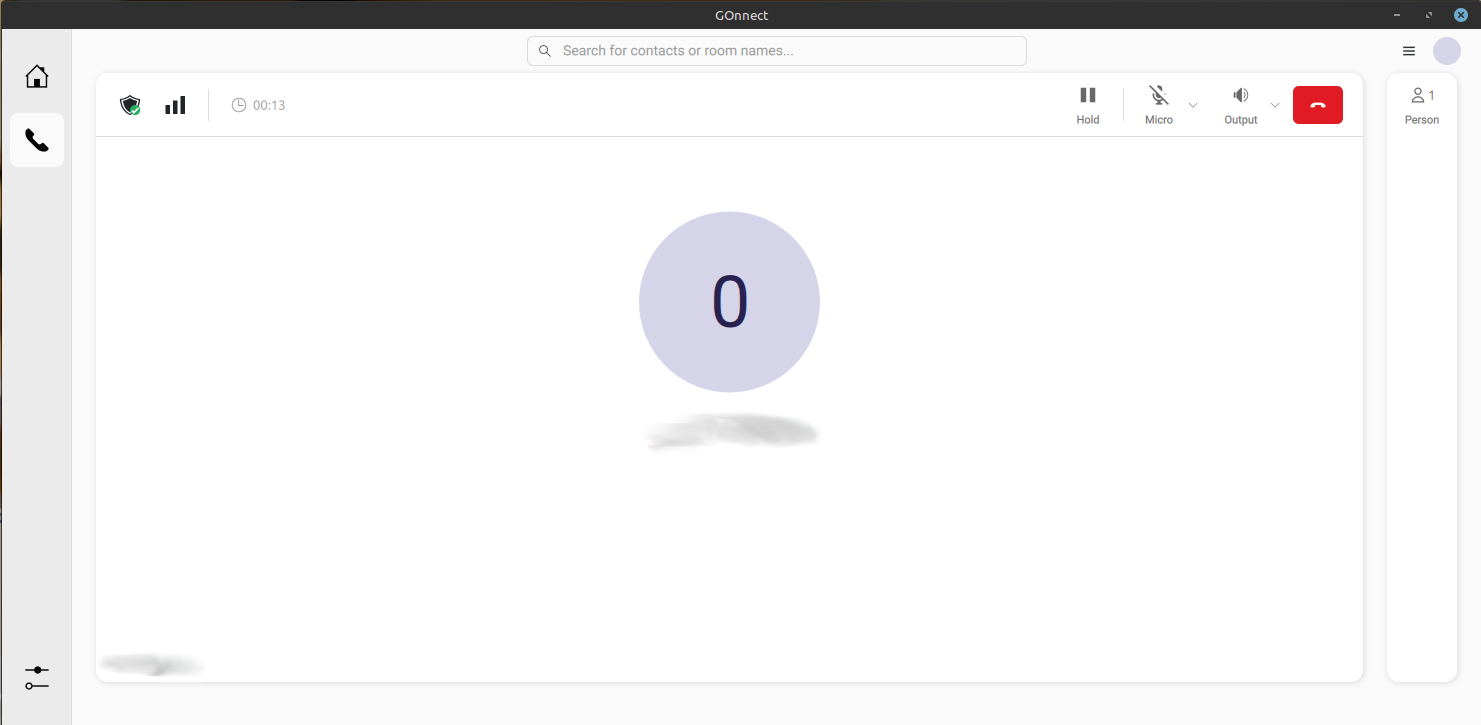
Bleibt die Sprache. Während des Gesprächs zeigt GOnnect oben links ein grünes Schild, das ist die Verschlüsselungsanzeige.
Das grüne Schild oben links ist die Verschlüsselungsanzeige. Was dahinter wirklich passiert, steht erst im Protokoll.
Ein Symbol ist aber nur ein Symbol. Was dahinter passiert, protokolliert der Client erst, wenn du ihn darum bittest:
[logging]
level=6
Danach einmal telefonieren und ins Protokoll schauen. Was du sehen willst, sind zwei Dinge. Erstens die Aushandlung, in der beide Seiten RTP/SAVP sprechen statt RTP/AVP:
Und zweitens die Bestätigung, welche der angebotenen Suiten die Gegenstelle genommen hat:
srtp0x...  SRTP started, keying=SDES, crypto=AES_256_CM_HMAC_SHA1_80
           SRTP status: Active  Crypto-suite: AES_256_CM_HMAC_SHA1_80
sipgate hat also die stärkste der vier angebotenen Varianten gewählt. Erst damit weiß ich, dass srtpUse=mandatory wirklich gegriffen hat und nicht still auf „aus“ stand. Nebenbei: mehr als diese vier hat der Client gar nicht im Angebot, alle mit AES im Counter-Modus und HMAC-SHA1. AES-GCM kennt diese PJSIP-Variante nicht, an der Stelle ist also nichts zu optimieren.
Und dann dreh den Loglevel wieder runter. In den Zeilen oben stehen die SRTP-Schlüssel im Klartext, die haben in einer Protokolldatei nichts verloren.
Was dabei nicht verschlüsselt ist
Hier muss ich die gute Laune etwas bremsen, denn „alles verschlüsselt“ wäre falsch.
Verschlüsselt ist die Strecke zwischen deinem Rechner und sipgate. Das ist viel wert, es schützt gegen dein WLAN, gegen fremde Netze und gegen deinen Provider, und zwar sowohl den Gesprächsinhalt als auch die Information, wen du wann anrufst.
Es endet aber bei sipgate. Rufst du ein Mobiltelefon an, läuft der Anruf ab dort durch das normale Telefonnetz, und dort gibt es keine Verschlüsselung. Dazu kommt, dass SDES als Schlüsselaustausch bedeutet, dass die Schlüssel im Signalisierungsweg stehen, den sipgate liest. Der ist zwar durch TLS gegen Dritte geschützt, aber sipgate kennt deine Schlüssel und könnte mithören. Etwas anderes steht auch gar nicht zur Wahl: ZRTP und DTLS-SRTP kommen in der gesamten sipgate-Dokumentation kein einziges Mal vor.
Echte Ende-zu-Ende-Verschlüsselung bekommst du nur zwischen zwei Clients, die direkt miteinander eines von beidem sprechen. Mit einem Anbieter dazwischen ist das, was hier läuft, die Obergrenze. Das ist kein Grund, es zu lassen, man sollte es nur nicht mit etwas verwechseln, das es nicht ist.
Kleinkram, der auffällt
Zwei Meldungen im Protokoll haben mich kurz beunruhigt und sind harmlos. Failed to connect to pipewire instance erscheint, weil das Flatpak den PulseAudio-Socket hat und auf pipewire-pulse zurückfällt. Die Geräte werden danach sauber gesetzt, der Ton funktioniert. Die Fehler des JitsiConnector betreffen die Videokonferenz-Anbindung und nicht das Telefonieren.
Was tatsächlich nicht geht: globale Tastenkürzel. Cinnamon bringt das Portal org.freedesktop.portal.GlobalShortcuts nicht mit, Anrufe per Tastendruck annehmen fällt damit aus. Alles andere, auch das Symbol im Systemabschnitt der Kontrollleiste, funktioniert.
Fazit
Der Teil, den ich für den schwierigen hielt, war der einfachste. Ich musste am Softphone überhaupt kein CardDAV einrichten, weil evolution-data-server das längst erledigt hatte. Ein Konto in den Online-Konten, und die Kontakte und Kalender stehen jedem Programm auf dem Rechner zur Verfügung.
Aufwendig war stattdessen, überhaupt einen Client zu finden, der unter Linux gepflegt wird und den man ohne AppImage-Gefummel aktuell hält. Dass ausgerechnet ein Client, der eigentlich für den Rollout in Firmen gedacht ist und deshalb keinen Einrichtungsdialog hat, für einen einzelnen Basis-Account die beste Wahl ist, hätte ich vorher nicht erwartet.
Und der Familienkalender, der 2014 in die ownCloud gewandert ist, steht jetzt neben dem Telefon. Nur zwölf Jahre später.
Am 16. März 2026 hat Bing meine Seite ausgeliefert wie an jedem Tag davor. Am 17. März nicht mehr. Nicht schlechter platziert, nicht seltener, sondern praktisch gar nicht. Sieben Tage lang kein einziger Klick. Und es blieb nicht bei der Websuche: die Zitate in Copilot hörten am selben Tag auf. Knapp vier Monate später, am 9. Juli, ging es genauso abrupt wieder los.
Bevor jetzt jemand Mitleid entwickelt: Bing macht bei diesem Blog rund ein Prozent des Traffics. Der Ausfall hat mich nichts gekostet, aufgefallen ist er mir erst Wochen später, und wäre er nie repariert worden, wäre das hier trotzdem kein trauriger Beitrag geworden. Interessant ist er aus einem anderen Grund.
So ein sauberer binärer Ausfall ist selten zu sehen. Kein Abrutschen über Wochen, kein Rauschen, sondern über Nacht zu und Monate später über Nacht wieder auf. Und das Beste: man kann es selbst rekonstruieren. Die Exporte aus den Webmaster Tools plus das eigene Access-Log reichen aus, um den Zeitpunkt auf den Tag genau zu datieren und eine sehr wahrscheinliche Ursache einzukreisen. Ohne dass der Anbieter je erklärt hätte, was er eigentlich getan hat.
Was jetzt kommt, ist also keine Beschwerde, sondern eine Fehleranalyse an einem Fall, bei dem der Schaden bei null lag und die Datenlage ungewöhnlich gut ist.
Zwei Kanten, dazwischen vier Monate
Absolute Zahlen zu Besuchern veröffentliche ich hier nicht, die braucht die Geschichte auch nicht. Erzählt wird ein Verlauf, kein Niveau. Alles Folgende ist deshalb indexiert: der Durchschnitt der Impressions pro Tag im Zeitraum 01.11.2025 bis 16.03.2026 ist die Baseline und bekommt den Wert 100. Impressions sind dabei die Anzahl der Ausspielungen in den Ergebnislisten, Klicks das, was danach kommt. Ich halte die beiden konsequent auseinander, weil genau in ihrem Verhältnis der interessanteste Teil steckt.
Monat
Index
Kommentar
2025-08
81
normaler, langsam wachsender Verlauf
2025-09
88
2025-10
104
2025-11
107
2025-12
108
Höchststand
2026-01
105
2026-02
91
2026-03
44
Einbruch am 17.03. mitten im Monat
2026-04
24
Teilerholung auf niedrigem Niveau
2026-05
10
zweiter Einbruch ab 16.05.
2026-06
7
Tiefpunkt
2026-07
55
am 09.07. fällt der Schalter wieder um
2026-08 (5 Tage)
74
Die Monatswerte glätten beide Kanten weg, weil sie mitten im Monat liegen. Nach Phasen sortiert wird es deutlicher. Gleiche Baseline, dazu die Klicks und die Klickrate:
Phase
Impressions
Klicks
CTR
Baseline 01.11.2025 bis 16.03.2026 (136 Tage)
100
100
2,75 %
17.03. bis 23.03.2026 (7 Tage)
0,6
0
0 %
24.03. bis 15.05.2026 (53 Tage)
21
41
5,3 %
16.05. bis 08.07.2026 (54 Tage)
6
12
5,2 %
09.07. bis 05.08.2026 (28 Tage)
69
95
3,75 %
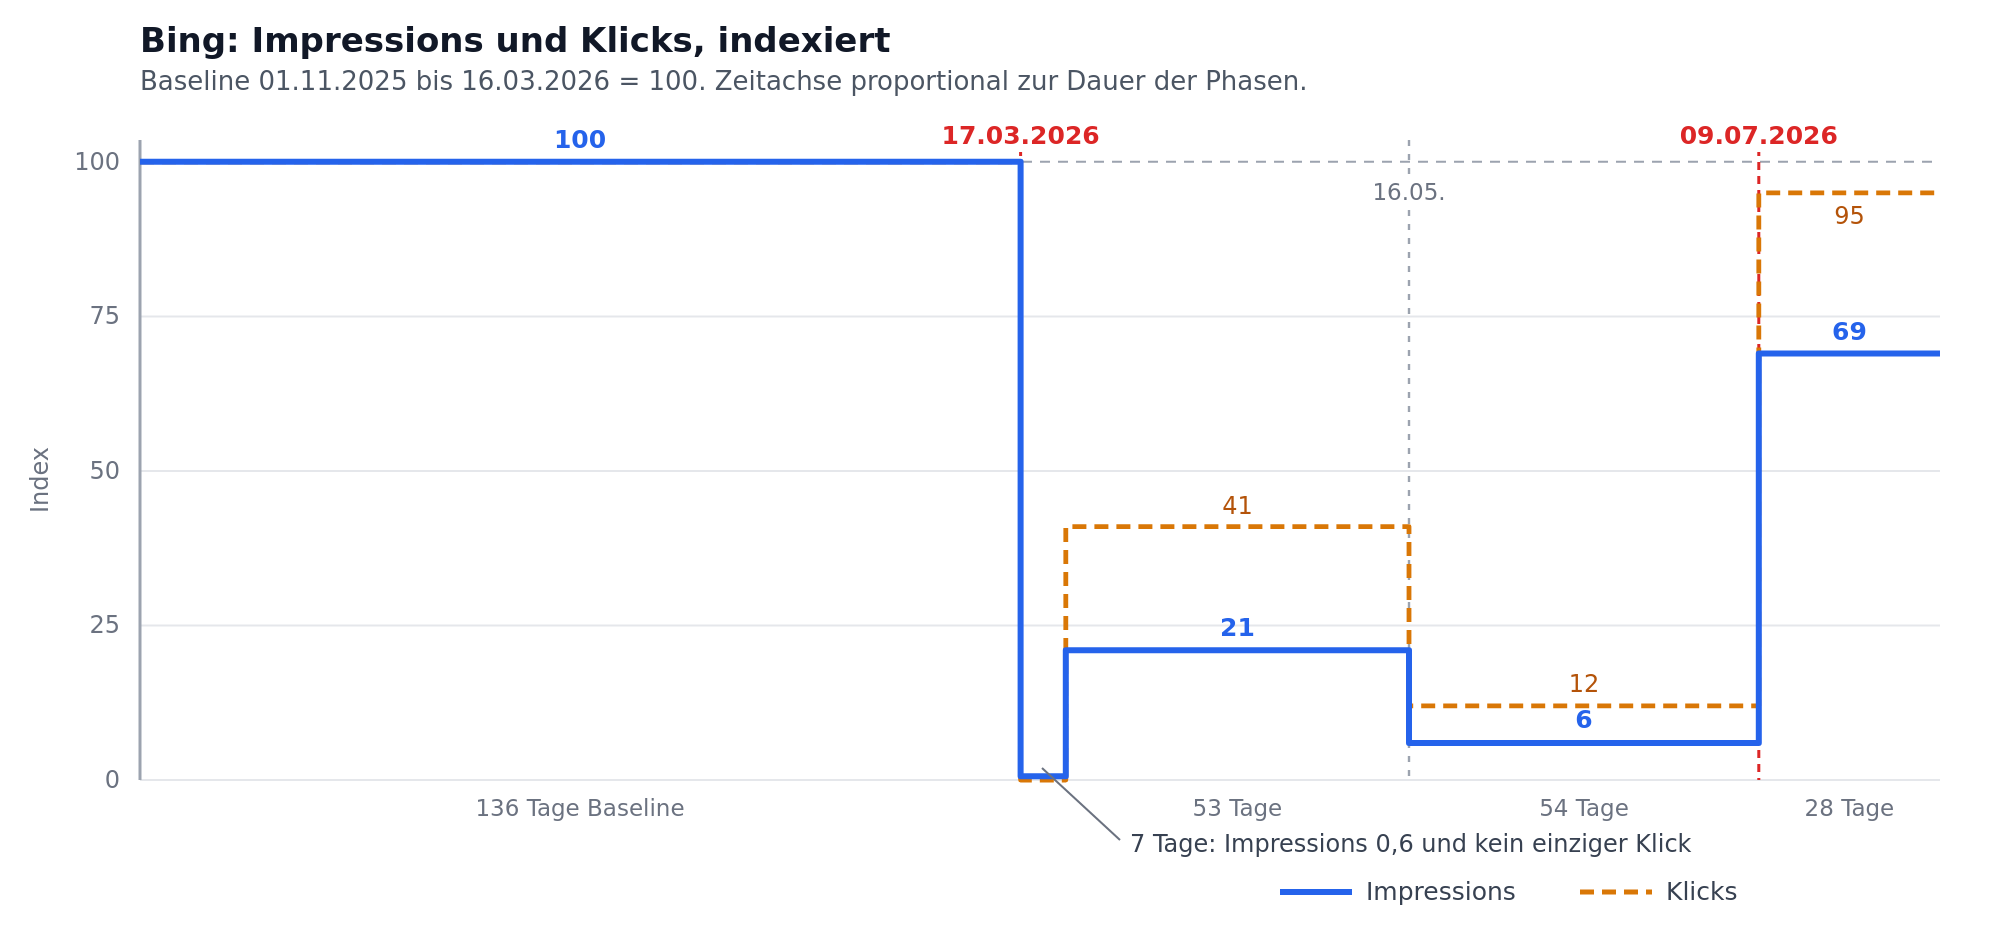
Dieselben Zahlen als Bild. Beide Kanten sind senkrecht, dazwischen liegen vier Monate. Die Klicks (gestrichelt) kommen fast vollständig zurück, die Impressions nicht.
Die erste Kante liegt zwischen dem 16. und dem 17. März: von normalem Niveau auf 0,6 Prozent der Baseline. Das ist kein Einbruch mehr, das ist aus. Eine Woche lang blieb es dabei, ohne einen einzigen Klick.
Die zweite Kante liegt zwischen dem 8. und dem 12. Juli: innerhalb von vier Tagen mehr als das Sechsfache. Der Anstieg beginnt am 9. Juli, also an genau dem Tag, an dem die Lösungs-Mail aus dem Support eintraf. Dazu später mehr, das Detail ist hübscher, als es klingt.
Das sieht nicht aus wie ein Ranking
Das ist die zentrale Beobachtung, und sie steckt in der Form der Kurve, nicht in ihrer Höhe. Rankings rutschen. Wenn eine Seite an Gewicht verliert, fällt sie über Wochen durch die Positionen, einzelne Suchbegriffe halten sich länger als andere, das Ganze franst aus. Was hier passiert ist, franst nirgends aus. Es ist an einem Tag da und am nächsten weg, und vier Monate später umgekehrt.
Zu einem Filter auf Domain-Ebene passt so ein Muster ausgesprochen gut. Ich schreibe bewusst passt zu und nicht beweist, denn die Form einer Kurve ist ein Indiz und keine Diagnose. Aber sie legt fest, wonach man überhaupt suchen muss: nach etwas, das sich ein- und ausschalten lässt, und nicht nach etwas, das langsam an Gewicht verliert.
Dazu kommt ein zweiter Befund, der in dieselbe Richtung zeigt und den ich für den stärkeren halte. Die Webmaster Tools weisen die Zitate in Copilot getrennt von der Websuche aus, es sind zwei verschiedene Oberflächen mit unterschiedlichen Auswahlmechanismen. Beide gingen am 17. März taggleich auf null. Dass eine Seite zeitgleich aus der Ergebnisliste und aus den KI-Antworten verschwindet, passt schlecht zu einer Bewertung einzelner Seiten und gut zu einem gemeinsamen Gate, das eine Ebene darüber sitzt und die ganze Domain betrifft. Ein Ranking-Effekt müsste sich erst durch die eine Oberfläche arbeiten und dann durch die andere, und ganz sicher nicht innerhalb eines Tages.
Ein Nebenbefund aus der Phasentabelle, der mir gut gefällt: die Klickrate war in den Ausfallphasen am höchsten. 5,3 und 5,2 Prozent gegen 2,75 Prozent in der Baseline. Das klingt zunächst nach einer guten Nachricht und ist das exakte Gegenteil. Wenn fast nichts mehr ausgeliefert wird, überleben nur die allerspezifischsten Suchanfragen, und die klicken naturgemäß gut. Eine steigende CTR ist eben nur dann ein gutes Zeichen, wenn der Nenner stabil bleibt.
Was es alles nicht war
Bevor man eine Ursache benennt, sollte man die naheliegenden Kandidaten abräumen. Das ist der Teil, der aus einer Vermutung eine Untersuchung macht.
Kein Crawling-Problem. Der Bingbot kam die ganze Zeit unverändert vorbei, rund 80 Anfragen pro Tag, ganz überwiegend mit Status 200. Das steht im eigenen Access-Log und ist damit die eine Quelle, der ich in diesem Fall vollständig traue. Gecrawlt wurde also durchgehend. Ausgeliefert wurde nur nichts.
Spricht klar gegen eine Löschung aus dem Index. DuckDuckGo und Ecosia beziehen ihre Ergebnisse von Bing und lieferten während der ganzen Zeit weiterhin Treffer zu meiner Domain. Bing selbst zeigte also weniger als seine eigenen Syndication-Partner. Die Inhalte waren demnach nach wie vor im Index, nur bing.com hat sie nicht mehr herausgegeben. Das ist für mich das hübscheste Detail des ganzen Falls und spricht stark für ein Gating auf der Ausliefer- oder Vertrauensebene statt für einen Deindex.
Spricht gegen ein reines Nutzersignal-Problem. Wenn eine Seite wegen schlechter Klickraten oder Nutzerverhalten abgewertet wird, erwartet man, dass die Klicks wegbrechen. Hier verschwanden die Impressions. Ich will das Argument nicht überdehnen: ein hinreichend starkes Vertrauens- oder Demotionssignal kann durchaus auch Impressions kosten. Es schwächt die Nutzersignal-Hypothese, es räumt sie nicht ab.
Nichts an Technik gefunden. Canonicals sauber, Sitemap in den Webmaster Tools als Success verarbeitet, am Server wurde im relevanten Zeitraum nichts umgestellt. Das ist ausdrücklich ein „nichts gefunden“ und kein „ausgeschlossen“, aber die üblichen Verdächtigen sind es damit nicht.
Keine Inhalts- oder Risikoklassifikation. Eigener Test mit SafeSearch von streng bis aus: kein Unterschied. Wer hier mit Erwachsenenfiltern hantiert, wird an diesem Blog wenig Freude haben, aber prüfen kostet nichts.
Keine Link-Armut. Die Google Search Console zeigte im selben Zeitraum ein diverses, redaktionelles deutsches Linkprofil aus Fachforen, Fachblogs und Projektseiten. Es fehlten keine Links. Das Gate hat die Domain trotz vorhandener Verweise ignoriert.
Und dann ist da noch die Kontrollgruppe, die einem hier die halbe Arbeit abnimmt: Google lief die ganze Zeit unauffällig weiter. Google liefert bei diesem Blog ohnehin um Größenordnungen mehr Suchklicks als Bing, ich hätte einen Einbruch dort also sofort gesehen. Gleiche Inhalte, gleicher Server, gleiche Technik, gleiche Links, ein Anbieter ganz normal, der andere komplett zu. An der Seite selbst kann es damit kaum gelegen haben. Für dieses Argument braucht es keine einzige Zahl, und das ist auch gut so.
Der Fund: eine Spalte namens Source
Die Webmaster Tools bieten einen Export mit dem Namen IndexNow Submitted URLs. Ich habe ihn lange für eine Fleißliste gehalten und nie hineingeschaut. Er hat eine Spalte, die den ganzen Fall aufgeschlossen hat, und die heißt Source. Sie unterscheidet, wer eine URL eingereicht hat:
wordpress steht für das WordPress-Plugin, das ereignisgesteuert meldet, wenn ein Beitrag veröffentlicht oder aktualisiert wird.
none steht für einen direkten Aufruf der HTTP-Schnittstelle, also von Hand oder per Skript.
Der Export umfasst 339 Einreichungen zwischen dem 04.01.2025 und dem 06.08.2026. Davon tragen 121 die Quelle wordpress und 218 die Quelle none. Und jetzt kommt der Teil, bei dem ich kurz still geworden bin: alle 218 manuellen Einreichungen liegen in einem einzigen Fenster, nämlich zwischen dem 11.02.2026 und dem 18.03.2026. Davor ausschließlich das Plugin. Danach ausschließlich das Plugin. Das Fenster ist scharf abgegrenzt, ohne eine einzige Ausnahme.
Datum
Einreichungen
Zeitfenster (CEST)
11.02.2026
93
11:35 bis 11:55
21.02.2026
1
09.03.2026
3
11.03.2026
6
12.03.2026
10
13.03.2026
3
14.03.2026
98
09:33 bis 15:00
18.03.2026
4
93 URLs in zwanzig Minuten. 98 URLs an einem einzigen Tag. 214 manuelle Einreichungen in 32 Tagen. Bei einem Blog mit rund 460 Beiträgen habe ich in fünf Wochen also grob die halbe Seite per Schnittstelle angeklopft. Und zwar durchweg alte, unveränderte Beiträge, an denen sich nichts getan hatte, außer dass ich sie gerne mal wieder frisch gecrawlt gesehen hätte.
Der Einbruch kam am 17.03.2026, also drei Tage nach dem zweiten Massen-Batch.
Was IndexNow ist und wofür ich es gehalten habe
IndexNow ist ein bewusst simpel gehaltenes Push-Protokoll. Statt darauf zu warten, dass irgendwann ein Crawler vorbeischaut, sagt die Seite der Suchmaschine aktiv Bescheid: diese URL hat sich geändert, schau noch mal rein. Technisch ist das ein Aufruf mit einer URL und einem Schlüssel, der als Textdatei im Web-Root liegt und die Domain ausweist. Bing, Yandex, Seznam, Naver und Yep hängen am selben Pool, eine Meldung erreicht also alle. Gedacht ist das Ganze als Ereignis-Signal: eine Änderung, eine Meldung.
Und genau hier liegt der Denkfehler, den ich rückblickend ziemlich sauber benennen kann. Das Ding sieht aus wie ein technischer Endpunkt zur Cache-Invalidierung. So habe ich es auch behandelt: Liste durchgehen, Schnittstelle anstoßen, fertig. Praktisch ist es aber ein Vertrauenskanal. Jede einzelne Einreichung trägt die implizite Behauptung „hier hat sich etwas geändert, das einen erneuten Besuch wert ist“. Zweihundert solcher Behauptungen für unveränderte Altbeiträge innerhalb von fünf Wochen sind aus Sicht des empfangenden Systems kein zu häufig aufgerufener Endpunkt, sondern ein Häufungsmuster, das nach Missbrauch aussieht. Völlig unabhängig davon, was ich mir dabei gedacht habe.
Dass das keine reine Rückschau-Weisheit ist, steht sogar in der Spezifikation. Die Liste der Antwortcodes kennt neben den üblichen Verdächtigen einen 429 Too Many Requests, und dahinter steht wörtlich potential Spam. Das Protokoll selbst denkt an dieser Stelle also bereits über Missbrauch nach, nicht über Serverlast. Nur: eine konkrete Obergrenze nennt die Dokumentation nirgends. Es gibt keine Zahl, gegen die man sich prüfen könnte, und einen 429 habe ich nie gesehen. Das Limit ist unsichtbar, bis man darüber ist, und dann meldet sich niemand.
Ein Detail passt hier noch gut hinein, auch wenn es die Kausalität nicht beweist: Google nimmt an IndexNow gar nicht teil. Der Kanal, über den ich hier zweihundertmal angeklopft habe, existiert bei dem einen Anbieter, der ausgefallen ist, und bei dem anderen, der unbeeindruckt weiterlief, schlicht nicht.
Wo die Rekonstruktion aufhört
Das muss klar dastehen, sonst wird aus einer ordentlichen Analyse eine Behauptung: Das ist eine sehr gut belegte Korrelation und kein Beweis. Microsoft hat die Ursache nie schriftlich benannt. Die spätere Lösungs-Mail verweist pauschal auf den Abschnitt Things to Avoid der Webmaster Guidelines und sonst auf nichts.
Was ich habe, ist zeitliche Nähe, ein scharf abgegrenztes Fenster, das exakt vor dem Ausfall endet, und keinen anderen plausiblen Auslöser im selben Zeitraum. Das ist die beste verfügbare Erklärung. Es ist nicht die bestätigte. Mit dieser Unterscheidung kann ich gut leben, sie macht den Fall nicht schwächer.
Offen bleibt auch der zweite Einbruch. Ab dem 16.05.2026 fiel der Wert noch einmal von Index 21 auf 6, und in diesem Zeitraum gab es überhaupt keine manuellen Einreichungen mehr. Plausibel wäre eine erneute automatische Bewertung, belegen kann ich das nicht. Das bleibt so stehen, weil Wegerklären hier nichts besser machen würde.
Der Support, oder: ein Lautsprecher ist keine Mailbox
Am 06.05.2026 habe ich ein Ticket aufgemacht, Nummer REQ00222409, Betreff sinngemäß „My site suddenly dropped in ranking“. Die automatische Bestätigung kam sofort und war erfreulich konkret: das Ticket werde einem Global Support Webmaster Engineer zugewiesen, eine Rückmeldung sei in 10 days zu erwarten.
Am 19.05.2026 habe ich nachgefragt, ganz konventionell per Antwort auf ebendiese Bestätigungsmail. Das Ergebnis war ein harter Bounce:
Der Fehler ist immerhin eindeutig. Die Absenderadresse ist eine interne Microsoft-365-Verteilergruppe, die ausschließlich authentifizierte Sender aus dem eigenen Tenant annimmt. Der Kanal, über den mein Ticket bestätigt wurde, kann also grundsätzlich keine Antwort empfangen. Das ist keine Mailbox, das ist ein Lautsprecher.
Parallel dazu war die Support-Oberfläche in den Webmaster Tools für diese Property nie freigeschaltet, dort stand durchgehend „No pages found“. Es gab damit buchstäblich keinen Rückkanal. Danach passierte 64 Tage lang nichts, und ich habe das Ticket innerlich abgehakt.
Die Mail, der ich erst nach dem Header-Check geglaubt habe
Am 09.07.2026 um 21:23 Uhr CEST kam dann doch noch eine Mail auf demselben Ticket. Der Kern: the issue related to your site … has been resolved, die Erholung könne up to 2-3 weeks dauern, das Ticket werde geschlossen, Rückfragen bitte über ein Feedback-Formular. Der Einweg-Kanal kann also durchaus zustellen. Nur empfangen kann er nichts.
Eine Mail, die nach zwei Monaten Funkstille auftaucht und etwas Erfreuliches behauptet, ist erst mal eine Mail und keine Tatsache. Also habe ich die Header gelesen, bevor ich ihr geglaubt habe. DKIM, SPF und DMARC standen alle auf pass, die Absenderdomain fährt eine DMARC-Policy auf reject, und meine eigene Spam-Filterung hat die Nachricht mit deutlich negativer Bewertung und no action durchgewinkt. Also echt, kein Spoofing. In einem Blog, in dem ziemlich viel über Mail-Härtung steht, ist so ein Blick kein Sonderaufwand, sondern Reflex.
Und dann steht in derselben Mail noch eine Empfehlung: zur Beschleunigung des erneuten Crawlens möge ich doch IndexNow nutzen. Also genau das Werkzeug, dessen massenhafte Verwendung die beste verfügbare Erklärung für den ganzen Vorfall ist. Ich habe den Rat nicht befolgt. Das WordPress-Plugin macht seinen ereignisgesteuerten Job, und das reicht.
Was zurückkam und was nicht
Bei den Klicks ist die Erholung praktisch vollständig, Index 95 gegen die Baseline. Bei den Impressions liegt sie bei rund zwei Dritteln bis drei Vierteln, Index 69 über die ersten 28 Tage und 74 in den ersten Augusttagen. Die Klickrate liegt nach der Erholung mit 3,75 Prozent über dem Vorher-Wert. Ob die Impressions noch weiter steigen oder ob das jetzt der neue Normalzustand ist, weiß ich schlicht nicht.
Wichtig ist mir dabei eine Sache, die man leicht falsch herum erzählen könnte: die Wiederherstellung kam serverseitig. Es gibt keinen erkennbaren Zusammenhang mit irgendeiner Maßnahme von mir. Dass das Ticket den Ausschlag gegeben hat, passt zeitlich gut, belegt ist es nicht. Ich habe in diesen vier Monaten nichts repariert, weil es an meinem Ende nichts zu reparieren gab.
Und ein Punkt ist ausdrücklich ungeklärt: ob die Copilot-Zitate wieder da sind. Hier lassen sich zwei Datenquellen leicht verwechseln, deshalb sauber getrennt. Der taggleiche Ausfall am 17. März stammt aus früheren, tagesaufgelösten Exporten, die ich im Juni ausgewertet habe, und den halte ich für belastbar. Die aktuellen Reports zur KI-Nutzung summieren dagegen über das volle 24-Monats-Fenster und lassen sich nicht auf einen Zeitraum eingrenzen. Sie enthalten also überwiegend Zitate aus der Zeit vor dem Vorfall, und aus ihnen lässt sich weder eine Erholung noch ein Ausfall ableiten. Für diese Frage sind sie schlicht unbrauchbar, auch wenn sie auf den ersten Blick beruhigend aussehen. Kurz: das Aussetzen ist datiert, die Rückkehr ist ungeprüft.
Was Microsoft konkret umgestellt hat, ist ebenfalls unbekannt und wurde nie mitgeteilt.
Was hängen bleibt
Ein automatisches „ich habe hier etwas Neues“-Signal ist kein technischer Endpunkt, sondern ein Vertrauenskanal mit einem unsichtbaren Limit. Man benutzt es so, wie es gedacht ist: ereignisgesteuert, ausgelöst von einer echten Änderung, und nicht als Batch-Werkzeug für eine Liste alter Beiträge. Das ist die eine Sache, die ich vorher nicht so gesehen habe.
Ansonsten steht der Schalter wieder auf an, niemand hat je aufgeschrieben, was er eigentlich war, und da hier ohnehin nur ein Nebenkanal dranhing, ist das auch völlig in Ordnung. Die Verteilung dieses Blogs steht auf mehreren Beinen, und Bing war nie eines der tragenden. Schulterzucken, weitermachen.
Hast du so ein Muster schon einmal an einer eigenen Domain gesehen, bei Bing oder woanders, und konntest es sauber datieren? Oder kennst du eine dokumentierte Obergrenze für IndexNow, die ich übersehen habe? Dann dürft ihr mich sehr gerne fragen.
Moin. Im letzten Beitrag ging es darum, wie ich meinen OpenPGP-Schlüssel an Domain, GitHub und Matrix gebunden habe, also um die Frage, woher eigentlich irgendwer wissen soll, dass dieser Schlüssel mir gehört. Ganz am Ende stand dort die Ankündigung eines zweiten Teils: wie das Ding überhaupt gebaut ist und wie sicher es wirklich ist. Der Teil ist jetzt hier.
Der Beitrag hat zwei Hälften, und die kannst du unabhängig voneinander lesen. Teil A ist ein Rezept. Wenn du einen Schlüssel nach demselben Muster bauen willst, arbeitest du dich von oben nach unten durch, inklusive der kompletten GnuPG-Konfiguration, alles kopierbar und in der richtigen Reihenfolge. Teil B erklärt, was die einzelnen Bauteile bedeuten, und endet mit einer ehrlichen Einschätzung, wie sicher das alles am Ende ist.
Der eigentliche Grund, warum ich das aufschreibe, ist aber ein anderer. Zwischen „mein Schlüssel ist modern“ und „mein Schlüssel ist richtig konfiguriert“ liegt eine Lücke, und in die bin ich mit Anlauf hineingesprungen. Der Schlüssel ist Lehrbuch: Ed25519, ein Hauptschlüssel, der ausschließlich zertifiziert, drei getrennte Unterschlüssel, fünf Jahre Laufzeit, über sieben Kanäle veröffentlicht, dazu eine eID-Zertifizierung. Und trotzdem wurde er vom ersten Tag an schwächer angesprochen als der Schlüssel, den er ablöst.
Aufgefallen wäre das niemandem, und genau das ist der interessante Teil. Das einzige Symptom war eine Warnzeile auf dem Terminal von jemandem, der mir eine verschlüsselte Mail schreibt. Also auf einem Rechner, den ich nie zu Gesicht bekomme. Und die Ursache war ausgerechnet eine Härtungsmaßnahme, die ich in bester Absicht eingebaut hatte, um einen musealen Algorithmus loszuwerden. Härtung, die etwas leise verschlechtert, finde ich als Geschichte deutlich spannender als noch eine Schlüsselerzeugungsanleitung. Nachbauen kannst du das übrigens in zwei Minuten, das Labor dazu steht weiter unten.
Der Schlüssel, um den es geht
Bestandteil
Wert
Hauptschlüssel
ed25519 0x893DE0CDDE986DEB, Verwendung [C], also nur zertifizieren
Fingerabdruck
45FC D081 ADB5 4872 EA5B 06B9 893D E0CD DE98 6DEB
Signatur-Unterschlüssel
ed25519 0xD788641D8588A674
Verschlüsselungs-Unterschlüssel
cv25519 0x429D03637892821A
Authentisierungs-Unterschlüssel
ed25519 0x22F2E3234664DDBE
UIDs
Sebastian van de Meer, dazu eine Foto-UID mit 10851 Byte
Gültigkeit
erzeugt am 24.07.2026, läuft am 23.07.2031 ab
Vorgänger
ed25519 0x5F279C362EEAB216, gültig bis 31.12.2026, zeichnet den neuen gegen
Fremdzertifizierung
Governikus/eID 0x5E5CCCB4A4BF43D7, Level 3
Umgebung
GnuPG 2.4.4, libgcrypt 1.10.3
Die Aufgabenteilung steht nicht nur in der Doku, die steht maschinenlesbar im Schlüssel selbst. Jede Bindungssignatur trägt ein Feld mit Schlüssel-Flags, und das sieht bei mir so aus:
Teil A ist der Ablauf, den ich für richtig halte, und bis auf die markierten Stellen genau der, den ich gegangen bin. Dort, wo der Befehl unten besser ist als das, was ich damals getippt habe, steht ein Hinweis dazu.
GnuPG 2.4.x ist die Annahme für den ganzen Beitrag. Zwei Dinge gleich vorweg, weil sie sonst später wehtun:
--quick-generate-keyverweigert den Dienst, wenn die UID bereits auf einem anderen Schlüssel im Schlüsselbund existiert. Genau deshalb ist dieser Schlüssel über eine Parameterdatei mit --batch --gen-key entstanden. Das trifft dich zuverlässig genau dann, wenn du einen Schlüssel rotierst, also in dem Moment, in dem der alte noch da ist.
Nichts hier braucht eine Smartcard, und nichts hier braucht root.
Wenn du bei GPG ganz am Anfang stehst, sind die Grundlagen zum Signieren und Verschlüsseln hier im Blog der bessere Einstieg. Dieser Beitrag setzt voraus, dass du weißt, was ein öffentlicher Schlüssel und ein Unterschlüssel sind.
Erst aufräumen, dann anfangen
Und zwar wirklich vorher, nicht hinterher. Mein ~/.gnupg war in einem Zustand, den ich hier nur ungern zugebe.
chmod 700 ~/.gnupg
find ~/.gnupg -type f -exec chmod 600 {} +

# Erst alle GnuPG-Frontends schließen und die Daemons beenden, sonst löschst du
# unter Umständen echte, aktive Locks:
gpgconf --kill all

# Übriggebliebene Lock-Dateien abgestürzter Läufe. Bei mir waren es 93 Stück.
find ~/.gnupg -name '.#lk*' -delete

# Altlasten, die keine 2.4er Installation mehr braucht
mkdir -p ~/gnupg-attic-$(date +%F)
mv ~/.gnupg/{cert8.db,key3.db,secmod.db} ~/gnupg-attic-$(date +%F)/ 2>/dev/null
Ein ~/.gnupg mit 775 und Dateien mit 664 ist erschreckend verbreitet, und ich will das gar nicht größer machen als es ist: Auf einem Einzelplatzrechner ist das keine Katastrophe. Es wird aber genau in dem Moment eine, in dem das Home-Verzeichnis in ein Backup, in einen Container-Mount oder in einen synchronisierten Ordner wandert. Und das passiert schneller, als man denkt.
Die gpg.conf, komplett
Das ist die tatsächlich laufende Konfiguration, so wie sie bei mir liegt, mit ihren Originalkommentaren. Der Block mit dem Warnhinweis ist die wichtigste Stelle im gesamten Beitrag, warum, steht in Teil B.
# ---- UX / output ----
keyid-format 0xlong
with-fingerprint
with-subkey-fingerprint
utf8-strings

# ---- Key discovery (local first, then WKD/DANE; email-validated keyserver last) ----
auto-key-retrieve
auto-key-locate local,wkd,dane,keyserver
keyserver hkps://keys.openpgp.org

# ---- Strong defaults ----
# cipher-algo / digest-algo are intentionally NOT forced: forcing them would override
# the recipient's stated capabilities. personal-*-preferences below select strong
# algorithms interoperably instead.
cert-digest-algo SHA512

# ---- KDF hardening for passphrase-derived symmetric keys (gpg -c / key export) ----
s2k-mode 3
s2k-digest-algo SHA512
s2k-cipher-algo AES256
s2k-count 65011712

# ---- WARNING. Legacy ciphers: do NOT disable 3DES here ----
# An earlier version of this file carried:
#     disable-cipher-algo 3DES
#     disable-cipher-algo IDEA
#     disable-cipher-algo CAST5
#     disable-cipher-algo BLOWFISH
#     disable-cipher-algo TWOFISH
# The 3DES line alone silently strips ALL algorithm preferences from every key you
# generate while it is active, and it also blocks DECRYPTION of old archives.
# New encryption never selects a legacy cipher anyway, because
# personal-cipher-preferences lists AES only.

# ---- Privacy / minimal metadata ----
no-comments
no-emit-version
export-options export-minimal

# ---- Listing/verification quality-of-life ----
verify-options show-uid-validity
list-options show-uid-validity

# ---- Trust model ----
trust-model tofu+pgp

# ---- Your key ----
default-key 0x45FCD081ADB54872EA5B06B9893DE0CDDE986DEB
# hidden-encrypt-to 0x45FCD081ADB54872EA5B06B9893DE0CDDE986DEB   # optional, off

# ---- Local policy: what *you* prefer when sending ----
personal-cipher-preferences AES256 AES192 AES
personal-digest-preferences SHA512 SHA384 SHA256
weak-digest SHA1
force-ocb

# ---- Preferences baked into keys you create from here on ----
default-preference-list SHA512 SHA384 SHA256 AES256 AES192 AES ZLIB BZIP2 ZIP Uncompressed
Zwei Zeilen darin sind Entscheidungen und keine Selbstverständlichkeiten, deshalb je ein Satz dazu.
force-ocb ist keine Präferenz, sondern eine Erzwingung. Es sorgt dafür, dass ausgehende Nachrichten die OCB-Variante aus der LibrePGP-Linie benutzen, und setzt sich dabei über das hinweg, was der Empfängerschlüssel ankündigt. Sehr alte oder anders implementierte Empfänger können solche Nachrichten nicht lesen. Das steht in einer gewissen Spannung zu dem Prinzip ein paar Zeilen weiter oben, wo ich cipher-algo bewusst nicht erzwinge. Für mich ist das in Ordnung, in einer Konfiguration zum Abschreiben würde ich die Zeile weglassen.
auto-key-retrieve holt unbekannte Schlüssel beim Prüfen automatisch nach. Sehr bequem, und es verrät dem Keyserver, welche signierten Nachrichten du wann liest. Für mich ein akzeptabler Tausch, bei einem anderen Bedrohungsmodell schaltest du das besser ab.
Dazu die beiden kleinen Geschwisterdateien. gpg-agent.conf:
Ein Hauptschlüssel, der nur zertifiziert, über eine Parameterdatei. Die Zeile Preferences: war in meinem echten Lauf nicht drin, nimm sie mit. Sie kostet nichts und fängt genau den Fehler ab, um den es in Teil B geht. Das ist keine Vermutung, ich habe es nachgemessen: Mit dieser Zeile bleiben die Präferenzen selbst dann im Schlüssel, wenn die defekte Konfiguration aktiv ist. Die eigentliche Kontrolle bleibt trotzdem der Paket-Dump gleich darunter, denn eine Parameterdatei ersetzt nie die Prüfung des fertigen Artefakts.
cat > keyparams.txt <<'EOF'
Key-Type: eddsa
Key-Curve: Ed25519
Key-Usage: cert
Name-Real: Sebastian van de Meer
Name-Email: kernel-error@kernel-error.com
Expire-Date: 5y
Preferences: AES256 AES192 AES SHA512 SHA384 SHA256 ZLIB BZIP2 ZIP Uncompressed
%ask-passphrase
%commit
EOF

gpg --batch --gen-key keyparams.txt
shred -u keyparams.txt
Und jetzt sofort nachsehen, ob die Präferenzen auch wirklich im Schlüssel gelandet sind. Genau diese Prüfung fehlte bei mir im Juli, und deshalb steht sie hier direkt hinter der Erzeugung und nicht irgendwo weiter unten.
Du willst dort pref-sym-algos, pref-hash-algos, pref-zip-algos und ein features mit gesetztem Bit 0x01 sehen. Wenn dort nur eine features-Zeile steht und sonst nichts, dann hör hier auf und lies erst den Abschnitt über den Defekt in Teil B. Dann stimmt etwas mit deiner Konfiguration nicht, und der Schlüssel trägt den Fehler ab sofort dauerhaft mit sich herum.
Zum shred oben noch ein Wort, weil es sonst falsche Sicherheit erzeugt: Es entfernt die sichtbare Arbeitsdatei, mehr nicht. Auf SSDs, auf ZFS, bei Snapshots und auf journalenden Dateisystemen ist damit überhaupt nicht garantiert, dass keine alten Blöcke mehr herumliegen. Solche Zwischendateien sollten deshalb von vornherein nur auf einem verschlüsselten Dateisystem entstehen.
Die drei Unterschlüssel
Interaktives --quick-add-key ist mir in einer nicht-interaktiven Shell mit einem /dev/tty-Fehler um die Ohren geflogen. Mit --batch läuft es durch.
240×288 Pixel, Graustufen-JPEG, 10851 Byte. Halt das Bild klein, es reist in jedem vollständigen Export mit und ist der mit Abstand größte Posten in der Schlüsselgröße.
gpg --edit-key $FPR
> addphoto
> /pfad/zu/sebastian-photo-uid.jpg
> save
Eine Sache dazu, die man vorher wissen sollte: Keiner der drei Keyserver, die ich benutze, hat die Foto-UID nach dem Upload je wieder herausgerückt. Für jeden Keyserver da draußen lege ich die Hand nicht ins Feuer, für die drei, auf die es ankommt, schon. Das Bild überlebt damit nur auf den Kanälen, die ich selbst hoste. Damit ist die Foto-UID Dekoration und keine Funktion. Das ist ein völlig legitimer Grund, sie trotzdem mitzunehmen, man sollte sich nur nichts vormachen.
Backup und Widerrufszertifikat, bevor irgendetwas veröffentlicht wird
Zwei Dinge müssen existieren, bevor der Schlüssel irgendwo landet: ein Backup des geheimen Schlüssels und ein Widerrufszertifikat. Beides später nachzuholen ist der Klassiker, den man genau einmal bereut.
Ein Widerrufszertifikat legt GnuPG bei der Erzeugung ohnehin schon selbst unter ~/.gnupg/openpgp-revocs.d/<FPR>.rev ab. Das Backup dagegen ist erst dann eines, wenn du es einmal zurückgespielt hast. Also rein damit in ein Wegwerf-GNUPGHOME und nachsehen, ob der geheime Hauptschlüssel dort auch wirklich auftaucht und nicht bloß die Datei lesbar war. Danach wandern beide auf Offline-Medien.
Wichtig, weil es ein sehr verbreitetes Missverständnis ist: Der s2k-*-Block aus der gpg.conf betrifft den passphrasenbasierten Schutz, also etwa gpg -c und den Export. Er sagt nichts darüber aus, wie der geheime Schlüssel in ~/.gnupg auf der Platte geschützt ist. Darum kümmert sich der gpg-agent mit eigenen Parametern, und bereits vorhandenes Schlüsselmaterial wird durch eine geänderte gpg.conf nicht rückwirkend neu verpackt. Wer die beiden verwechselt, glaubt an eine Härtung, die an dieser Stelle gar nicht wirkt. Was tatsächlich in deinem Backup steht, siehst du wie immer am Artefakt selbst, per gpg --list-packets secret-key-backup.asc.
Den Hauptschlüssel aus dem Alltag nehmen
Jetzt kommt der Schritt, der die ganze Aufteilung von oben überhaupt erst einlöst. Der Hauptschlüssel hat im Alltag nichts verloren. Gebraucht wird er nur, wenn ein Unterschlüssel verlängert, ersetzt oder widerrufen wird, wenn eine UID dazukommt oder wenn du einen fremden Schlüssel zertifizierst. Also fliegt sein geheimer Teil vom Arbeitsrechner herunter, und zwar genau jetzt, nachdem Backup und Widerrufszertifikat existieren und nicht vorher.
# nur die Unterschlüssel exportieren, ohne den geheimen Hauptschlüssel
gpg --export-secret-subkeys --armor $FPR > subkeys.asc

# das gesamte geheime Material aus dem Alltags-Keyring werfen
gpg --delete-secret-keys $FPR

# und danach ausschließlich die Unterschlüssel zurückholen
gpg --import subkeys.asc
shred -u subkeys.asc
Das Doppelkreuz hinter sec ist der ganze Punkt. Es bedeutet: GnuPG kennt den Hauptschlüssel, hat sein geheimes Gegenstück aber nicht mehr. Signieren, Entschlüsseln und Authentisieren laufen unverändert weiter, dafür sind die Unterschlüssel zuständig. Was nicht mehr geht, ist alles, was die Identität selbst betrifft, also neue Unterschlüssel anlegen, Laufzeiten verlängern, UIDs ergänzen und fremde Schlüssel zertifizieren.
Der geheime Hauptschlüssel liegt ab hier zusammen mit dem Widerrufszertifikat auf verschlüsseltem Wechselmedium. Wenn ich ihn brauche, kommt er ausdrücklich nicht zurück nach ~/.gnupg, sondern in ein temporäres GNUPGHOME, das hinterher wieder verschwindet.
Ein Detail dabei ist wichtig genug für einen eigenen Absatz, weil es sonst still danebengeht: Das Offline-Backup ist ein Schnappschuss. Es entstand oben, bevor der alte Schlüssel gegengezeichnet hat und bevor die Governikus-Zertifizierung da war. Diese Fremdsignaturen hängen am öffentlichen Teil, der im Alltags-Keyring liegt, nicht im Backup. Wer nur das Backup einspielt und dort arbeitet, exportiert hinterher einen Schlüssel, dem genau diese Signaturen fehlen. Also immer beides einspielen:
# aktuellen öffentlichen Stand samt Fremdsignaturen aus dem Alltags-Keyring mitnehmen
gpg --armor --export-options no-export-minimal --export $FPR > /tmp/pub-aktuell.asc

export GNUPGHOME=$(mktemp -d); chmod 700 "$GNUPGHOME"
trap 'rm -rf "$GNUPGHOME"' EXIT HUP INT TERM   # auch bei Abbruch aufräumen
gpg --import /media/offline/secret-key-backup.asc
gpg --import /tmp/pub-aktuell.asc

# hier die Arbeit am Schlüssel, etwa eine Laufzeit verlängern

gpg --armor --export-options no-export-minimal --export $FPR > /tmp/pub-neu.asc
rm -rf "$GNUPGHOME"; unset GNUPGHOME
Danach importierst du die aktualisierte öffentliche Hälfte in den Alltags-Keyring und rollst sie über alle Veröffentlichungskanäle aus. Das ist unbequem. Es soll unbequem sein, denn genau diese Unbequemlichkeit ist der Grund, warum der Hauptschlüssel selten angefasst wird und deshalb schwer zu verlieren ist.
Den alten Schlüssel den neuen gegenzeichnen lassen
Ein weicher Übergang statt einer harten Kante: Der alte Schlüssel bleibt bis zu seinem Ablauf gültig und zertifiziert den neuen. Wer dem alten Schlüssel schon vertraut, bekommt damit einen kryptografischen Pfad zum neuen, ohne mich irgendwo anrufen zu müssen.
Das ist ein eigenes Thema, deshalb hier nur zusammengefasst: Governikus ist nach meinem Stand vom August 2026 der einzige mir bekannte noch aktive Dienst in Deutschland, der OpenPGP-Schlüssel über die Online-Ausweisfunktion zertifiziert. Du schickst deinen öffentlichen Schlüssel hin, weist dich mit dem Personalausweis aus und bekommst eine Zertifizierung mit Level 3 zurück. Die Volksverschlüsselung fällt als Alternative aus, die macht ausschließlich S/MIME nach X.509, erzeugt die Schlüssel selbst und wird ohnehin eingestellt.
Strukturell wichtig für den Rest des Beitrags ist nur ein Punkt: Diese Zertifizierung ist eine Fremdsignatur. Und die Hälfte meiner Veröffentlichungskanäle wirft Fremdsignaturen weg. Warum, steht gleich.
Vier Exporte für vier Aufgaben
Das ist der Teil, den fast alle Anleitungen überspringen, und ausgerechnet hier fallen die echten Entscheidungen. Vier verschiedene Exporte desselben Schlüssels für vier verschiedene Jobs, mit den gemessenen Größen der Artefakte, die tatsächlich ausgeliefert werden:
Alle vier Befehle habe ich gegen die live ausgelieferten Dateien geprüft, sie reproduzieren die Artefakte byteidentisch, sha256 stimmt jeweils überein. Du kannst sie also so übernehmen.
Und jetzt die fiese Falle. In meiner gpg.conf steht global export-options export-minimal. Export-Optionen summieren sich, sie ersetzen einander nicht. --export-options export-clean hebt export-minimal also nicht auf. Du bekommst weiterhin einen minimalen Export, still und ohne Warnung, mit weggeworfenen Fremdsignaturen. Nur die ausdrückliche Verneinung funktioniert:
Das ist genau die Sorte Fehler, bei der du fest davon überzeugt bist, einen Schlüssel mit allen Signaturen veröffentlicht zu haben, während in Wahrheit die eID-Zertifizierung nie das Haus verlassen hat.
Die zweite Stolperfalle beim Export: export-minimal wirft zwar Fremdsignaturen weg, behält aber die Foto-UID. Für den DANE-Record muss auch das Bild raus, sonst wächst der Record von rund einem Kilobyte auf gute zwölf. Dieser Befehl hat den ausgelieferten Record mit 1298 Byte erzeugt:
Zwei Anmerkungen noch zu den Formaten, weil sich in der 2.4er Reihe etwas geändert hat:
--print-dane-recordsgibt es nicht mehr. Der Nachfolger heißt --export-options export-dane.
Verwechsle die beiden Ausgaben aber nicht. export-dane liefert einen fertigen DNS-Präsentationsblock, also $ORIGIN, Kommentarzeilen und generische TYPE61-Rdata, bei mir 25642 Byte. Das ist kein binäres Schlüsselmaterial. Zum Lesen ist es praktisch, der ausgelieferte Record entstand aber aus dem binären Export oben plus base64 -w0 openpgpkey.bin. Beide Wege sind gültige Zonefile-Syntax, RFC 7929 definiert die base64-Präsentationsform und RFC 3597 die generische TYPE61-Form, BIND frisst beides. Der Einzeiler passte einfach besser in meine bestehende Zone.
Wo der Schlüssel liegt, und warum genau dort
Sieben Kanäle, und jeder existiert aus einem anderen Grund. Das „warum“ ist dabei die interessantere Hälfte:
Kanal
Format
Warum dieser Kanal
keys.openpgp.org
voll hochgeladen, Server wirft Signaturen und Foto weg
der einzige Keyserver, der die Mailadresse validiert, und der, den moderne Clients abfragen
Vertrauen hängt an DNSSEC statt an einem Signaturgraphen, muss klein bleiben, es ist ein DNS-Record
WKD advanced
kein eigener Export, CNAME auf wkd.keys.openpgp.org
spiegelt keys.openpgp.org automatisch, lässt sich hier nicht selbst hosten
WKD direct (Apex)
voll binär, 13108 B
selbst gehostet, deshalb die einzige Stelle mit Foto und Fremdsignaturen
security.txt und Direktdownload
voll ASCII, 17833 B
auffindbar für Menschen und für Scanner
Zwei abgeleitete Namen tauchen dabei auf, und die werden regelmäßig falsch gebildet. Beide habe ich unabhängig nachgerechnet, sie stimmen mit dem überein, was ausgeliefert wird:
# WKD: z-base32 des SHA-1 vom lokalen Teil, ASCII-Großbuchstaben vorher klein gemacht
#   sha1("kernel-error") -> z-base32 -> 3gyjbxx9xfdggpkmx5qdd793xy431w5u
gpg --with-wkd-hash -k kernel-error@kernel-error.com

# DANE (RFC 7929): SHA-256 des kanonisierten UTF-8-Lokalteils, auf 28 Oktette gekürzt,
# hex-kodiert, dann ._openpgpkey.<domain>
#   70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._openpgpkey.kernel-error.com
Zwei Präzisierungen, damit hier keine Regel steht, die breiter ist als die Spezifikationen: WKD bildet ASCII-Großbuchstaben auf Kleinbuchstaben ab, das ist kein allgemeines Unicode-Lowercasing. Und DANE übernimmt diese Abbildung nicht einfach, RFC 7929 hat seine eigene Kanonisierung des lokalen Teils. Bei mir fallen beide zusammen, weil kernel-error schon reines Kleinbuchstaben-ASCII ist. Genau deshalb ist mir der Unterschied nie begegnet. Wer einen Lokalteil mit Großbuchstaben oder Nicht-ASCII hat, darf die beiden auf keinen Fall gleichsetzen.
Und weil ich schon dabei bin, mich zu blamieren: Bei einem früheren Review habe ich DANE als „fehlt“ markiert, weil ich den z-base32-Namen aus WKD gegen das DNS geprüft habe. Also den falschen Namen. DANE lief die ganze Zeit. Wenn du deinen eigenen Aufbau prüfst, prüfe bitte den Namen, den die jeweilige Spezifikation vorschreibt, und nicht den, den du gerade im Kopf hast. Wie man einen OPENPGPKEY-Record überhaupt in die Zone bekommt und wie man die Zone dafür mit BIND signiert, steht hier im Blog.
Eine Konsequenz aus der Tabelle überrascht die Leute regelmäßig, deshalb schreibe ich sie deutlich hin:
Die Governikus-Zertifizierung ist nur auf den klassischen Keyservern und auf den selbst gehosteten Kopien sichtbar. keys.openpgp.org wirft sie weg, und gpg bevorzugt die WKD-advanced-Methode, die wiederum auf keys.openpgp.org zeigt. Der Kanal, den die meisten Clients benutzen, ist also ausgerechnet der mit den wenigsten Signaturen.
Prüfen wie ein Fremder
Der letzte Schritt in Teil A, und der wichtigste: Hol dir deinen eigenen Schlüssel so, wie es jemand tut, der dich nicht kennt. Einmal pro Suchpfad, jedes Mal in einem frischen Schlüsselbund.
# den Schlüssel holen wie ein Fremder, einmal pro Lookup-Pfad
for m in dane wkd keyserver; do
  GNUPGHOME=$(mktemp -d) gpg --auto-key-locate clear,$m --locate-external-keys kernel-error@kernel-error.com
done

# welche Präferenzen bewirbt der Schlüssel tatsächlich?
gpg --export $FPR | gpg --list-packets | grep -E 'pref-|features'

# welchen Cipher wählt ein Absender wirklich?
gpg --status-fd 1 -d message.gpg | grep DECRYPTION_INFO
Damit endet das Rezept. Ab hier geht es darum, was die Teile bedeuten, und um die Frage, wie sicher der Aufbau am Ende wirklich ist.
Teil B: was das alles bedeutet
Wenn du bis hierher gekommen bist, hast du ein funktionierendes Rezept. Was du noch nicht hast, ist ein Gefühl dafür, warum die Teile so und nicht anders geschnitten sind, und wo der Aufbau trotz allem nachgibt. Genau darum geht es jetzt, und zwar in dieser Reihenfolge: erst die Struktur, dann die Zahlen, dann der Fehler und am Ende die Rechnung ohne Schönfärberei.
Warum ein Hauptschlüssel, der nur zertifiziert
Der Hauptschlüssel hat genau eine Aufgabe: zu sagen, wer zu diesem Schlüssel gehört. Er signiert die UIDs und er signiert die Unterschlüssel. Er signiert nie eine Mail und entschlüsselt nie irgendetwas. Alles Operative ist delegiert:
[C] certify   Identitätsanker. Wird selten benutzt. Eine Kompromittierung ist
              nicht reparierbar, ein Verlust nur über das Offline-Backup.
[S] sign      Signieren im Alltag
[E] encrypt   Entschlüsseln im Alltag
[A] auth      Authentisierung, etwa als SSH-Schlüssel
Der Gewinn: Ein kompromittierter oder ausgedienter Unterschlüssel lässt sich widerrufen und ersetzen, ohne die Identität anzufassen, ohne die gesammelten Fremdsignaturen zu verlieren und ohne den Fingerabdruck zu ändern, der an sieben Stellen veröffentlicht ist. Dass [S] und [E] getrennt sind, hat noch einen zweiten Grund: Sie haben unterschiedliche Lebenszyklen. Einen alten Signaturschlüssel zu vernichten ist harmlos. Einen alten Verschlüsselungsschlüssel zu vernichten heißt, dass du an dein Archiv nicht mehr herankommst.
Das Ganze zahlt sich allerdings nur aus, wenn du auch die Konsequenz ziehst: Der volle Nutzen dieser Aufteilung stellt sich erst ein, wenn der Hauptschlüssel offline liegt. Genau deshalb liegt er hier offline, auf verschlüsseltem Wechselmedium und zusammen mit dem Widerrufszertifikat. Er kommt nur heraus, wenn ein Unterschlüssel verlängert, ersetzt oder widerrufen werden muss, und dann in ein temporäres GNUPGHOME und nicht zurück in den Alltags-Keyring. Auf der Arbeitsmaschine liegen ausschließlich die drei Unterschlüssel. Ein Hauptschlüssel, der nur zertifiziert, aber trotzdem neben dem Mailclient herumliegt, ist am Ende nur Kosmetik.
Der [A]-Unterschlüssel existiert übrigens, ist aber bewusst nicht im gpg-agent für SSH verdrahtet, sshcontrol ist leer. Ich habe ihn erzeugt, um mir die Option offenzuhalten. Mehr ist es im Moment nicht.
Ed25519 und X25519, was die Zahlen bedeuten
Ed25519 zum Signieren und X25519, in GnuPG als cv25519 bezeichnet, zum Verschlüsseln liegen beide bei rund 128 Bit klassischem Sicherheitsniveau. Das ist vergleichbar mit RSA-3072 und deutlich oberhalb von RSA-2048.
Sie sind dramatisch kleiner und schneller. Deshalb passt der komplette Schlüssel mit drei Unterschlüsseln, Foto und drei Fremdsignaturen immer noch in 13 KB.
Curve25519 ist fehlbedienungsresistent entworfen: keine Parameter, die man falsch wählen kann, keine Invalid-Curve-Fallen, deterministische Nonces bei Ed25519. Ein großer Teil der historischen Signatur-Unfälle in der Praxis kam aus genau den Ecken, die diese Kurve wegräumt.
Ein Punkt dazu, den du im Kopf behalten solltest, weil er gleich noch wichtig wird: 128 Bit klassische Sicherheit sind die Obergrenze dieses Schlüssels. Merk dir die Zahl. Sie ist der Grund, warum die AES-Geschichte weiter unten weniger dramatisch ist, als sie zunächst klingt.
Algorithmen-Präferenzen: was sie sind und wer sie liest
Dieses Konzept muss sitzen, sonst funktioniert die Geschichte danach nicht. Vorweg ein Satz, den viele nie gehört haben: Eine OpenPGP-Nachricht ist immer hybrid. Der asymmetrische Teil, also dein Ed25519- und X25519-Material, verpackt ausschließlich einen zufällig erzeugten symmetrischen Sitzungsschlüssel. Die eigentlichen Nutzdaten verschlüsselt ein symmetrisches Verfahren, in der Regel AES. Der Fehler, um den es gleich geht, saß in dieser symmetrischen Hälfte.
Ein OpenPGP-Schlüssel trägt nämlich nicht nur öffentliche Schlüssel spazieren. Die Selbstsignatur jeder UID enthält Subpakete, die ankündigen, was der Besitzer verarbeiten kann:
Das features-Oktett ist die Stelle, an der ich mich in meinen eigenen Notizen vertan hatte, deshalb hier die Dekodierung. In der Linie, die GnuPG 2.4 implementiert, bedeuten die Bits des ersten Oktetts:
0x01  SEIPD-v1 mit Modification Detection Code (MDC)
0x02  AEAD
0x04  Unterstützung für das v5-Schlüssel- und Fingerabdruckformat
features 05 ist also 0x01 + 0x04, das heißt MDC und kein AEAD. features 07 wäre 0x01 + 0x02 + 0x04, und genau das bekommt ein Schlüssel, den GnuPG 2.4 mit Standardeinstellungen erzeugt. Der kaputte Zustand war features 04, also 0x04 ganz allein: weder MDC noch AEAD angekündigt.
Eine Versionsfußnote gehört dazu: Diese Bitbelegung und das Subpaket 34 stammen aus der LibrePGP-Linie, die GnuPG 2.4 umsetzt. RFC 9580 hat beides geändert, dort sind die AEAD-Präferenzen in Subpaket 39 umgezogen und das Feature-Modell wurde umgebaut. Diese Spaltung kommt weiter unten noch einmal zurück.
Wenn dir jemand etwas verschlüsselt, liest dessen GnuPG deine Präferenzliste und wählt daraus das stärkste Verfahren, das beide können. Das ist der ganze Mechanismus. Daraus folgen zwei Dinge, die den meisten Leuten gegen den Strich gehen:
Deine eigenen personal-cipher-preferences schützen dich nicht. Die bestimmen, was du verschickst. Was Leute dir schicken, bestimmt allein das, was dein veröffentlichter Schlüssel ankündigt.
Die Präferenzen stehen in einer Signatur. Sie zu ändern heißt, die Selbstsignatur neu auszustellen. Und damit ist jede veröffentlichte Kopie deines Schlüssels veraltet, bis du sie erneuerst. Bei mir sind das sieben Kanäle und eine Änderung an der DNS-Zone.
Und wenn ein Schlüssel gar nichts ankündigt? Dann greift der Rückfall. RFC 4880 schreibt dafür 3DES vor, den verpflichtend zu implementierenden Algorithmus. Moderne GnuPG-Versionen landen dort allerdings nicht mehr: Seit der 2.3er Reihe verschlüsselt gpg grundsätzlich nicht mehr mit 64-Bit-Blockchiffren, dafür müsstest du ausdrücklich --allow-old-cipher-algos setzen. Der Rückfall endet deshalb bei AES-128. Nicht kaputt, aber eben auch nicht das, was der Schlüssel bekommen sollte.
Der Defekt, gemessen
Ein x-beliebiger Absender, der meinem brandneuen Schlüssel etwas verschlüsselt, sah das hier:
gpg: WARNING: cipher algorithm AES not found in recipient preferences
gpg: AES.CFB encrypted data
[GNUPG:] DECRYPTION_INFO 2 7 0        # 7 = AES128
Derselbe Absender, wenn er dem Schlüssel von 2023 schreibt, den der neue gerade ablöst:
[GNUPG:] DECRYPTION_INFO 2 9 0 # 9 = AES256
Der neue Schlüssel hatte überhaupt keinepref-sym-algos, keine pref-hash-algos und keine pref-zip-algos, dazu features 04 statt 05. Er wurde also schwächer angesprochen als sein Vorgänger, lautlos, und der einzige Hinweis darauf erschien auf einem Terminal, das jemand anderem gehört.
Die Ursache, und eine Korrektur an mir selbst
In meinen Arbeitsnotizen stand als Ursache: „mit einer --batch --gen-key-Parameterdatei ohne Preferences:-Zeile gebaut“. Das ist falsch. Eine Parameterdatei ohne diese Zeile erzeugt völlig ordentliche Präferenzen aus den eingebauten Defaults von GnuPG. Nachgeprüft, es kommt das hier heraus:
Die echte Ursache saß in der gpg.conf. Ich habe die Juli-Konfiguration in einem Wegwerf-Schlüsselbund nachgestellt, der Defekt war sofort wieder da. Danach habe ich die Datei halbiert, bis eine einzige Zeile übrig blieb:
Konfiguration im Test
Ergebnis
Juli-gpg.conf, unverändert
features: 04, gar keine pref-*
ohne disable-cipher-algo 3DES
pref-sym-algos: 9 8 7 2, features: 07
ohne alledisable-cipher-algo-Zeilen
pref-sym-algos: 9 8 7 2, features: 07
ohne cipher-algo AES256
weiterhin kaputt, features: 04
nurdisable-cipher-algo 3DES vorhanden
kaputt, features: 04
disable-cipher-algo 3DES plus explizite Preferences:-Zeile
sauber, pref-sym-algos: 9 8 7, features: 05
disable-cipher-algo 3DES ist also notwendig und hinreichend, um den Defekt auszulösen. Eine Zeile, mehr nicht.
Der Mechanismus dahinter ist die eigentliche Pointe des ganzen Beitrags. 3DES ist in OpenPGP der verpflichtend zu implementierende Algorithmus, und in der Standardliste steht er auch sichtbar drin: pref-sym-algos: 9 8 7 2 endet auf der 2, und die 2 ist 3DES. Nimmst du GnuPG diesen einen Algorithmus lokal weg, verschwindet nicht nur er aus der Liste, sondern die Liste als Ganzes.
Beim Warum bleibe ich vorsichtig. Dass GnuPG intern keine gültige Liste mehr konstruieren kann und deshalb gar keine schreibt, ist die naheliegende Erklärung, beweisen lässt sie sich von der Kommandozeile aus nicht. Belegt ist der Auslöser, nicht der Code-Pfad dahinter. Der Effekt selbst ist dagegen eindeutig: Die Härtungszeile hat nicht einen schwachen Algorithmus aus der Liste entfernt, sie hat die komplette Liste entfernt. Und damit dafür gesorgt, dass Absender zurückfallen, und zwar auf etwas Schwächeres als das, was ich gerade weghärten wollte.
Das Labor zum Selbernachbauen
Zwei Minuten, kein echter Schlüssel wird angefasst, alles passiert in Wegwerf-Verzeichnissen unter /tmp. Wenn du mir nicht glaubst, ist das hier der schnellste Weg, es selbst zu sehen:
Bei mir kommt das hier heraus, und die eine Zeile Unterschied ist der ganze Defekt:
nopref:   gpg: WARNING: cipher algorithm AES not found in recipient preferences
          gpg: AES.CFB encrypted data
withpref: gpg: AES256.OCB encrypted data
Die Reparatur
Der Fix selbst ist unspektakulär, ein einziger Befehl im Editiermodus. Weil setpref die Selbstsignatur neu ausstellt, braucht er den Hauptschlüssel. Das Ganze läuft also einmal im temporären GNUPGHOME von weiter oben, mit dem Offline-Schlüssel und dem aktuellen öffentlichen Stand:
gpg --edit-key $FPR
> setpref AES256 AES192 AES SHA512 SHA384 SHA256 ZLIB BZIP2 ZIP Uncompressed
> y
> save
Danach steht da pref-sym 9 8 7, pref-hash 10 9 8, pref-zip 2 3 1 0 und features 05. Der Fingerabdruck bleibt unverändert, und die Governikus-Zertifizierung, die Gegensignatur des alten Schlüssels, die Foto-UID und sämtliche Ablaufdaten überleben. Das schreibe ich so ausdrücklich hin, weil viele Leute Angst vor setpref haben und glauben, es beschädige den Schlüssel. Tut es nicht. Was es tut: Es stellt die Selbstsignatur neu aus. Und damit müssen anschließend alle sieben Veröffentlichungskanäle aufgefrischt werden.
Zur Sicherheit gleich hinterher: default-preference-list in der gpg.conf festgenagelt, und die disable-cipher-algo-Zeilen sind endgültig raus.
Wie schlimm war es wirklich?
Hier will ich ehrlich sein statt dramatisch, sonst wird das hier auch nur wieder eine von diesen „ich habe einen Bug gefunden“-Geschichten.
AES-128 statt AES-256 ist real, aber überschaubar. AES-128 ist nicht gebrochen, es gibt keinen praktischen Angriff darauf. Und erinnere dich an die Zahl von weiter oben: Der asymmetrische Teil dieses Schlüssels liefert ohnehin rund 128 Bit klassische Sicherheit. Gemessen an der reinen Schlüsselsuche war AES-128 also nicht das schwächste Glied in der Kette, es hat lediglich mit dem Rest gleichgezogen. Über Implementierungsfehler, Seitenkanäle oder Protokollschwächen sagt dieser Vergleich nichts. Die faire Einordnung lautet: Das war ein Hygiene- und Signalisierungsfehler, keine ausnutzbare Schwachstelle. Bemerkenswert ist er, weil er lautlos war, automatisch passierte und von einer Härtungsmaßnahme verursacht wurde.
Das fehlende MDC-Bit sah schlimmer aus, als es war.features 04 heißt, dass das Bit 0x01 fehlte, mit dem ein Schlüssel Modification Detection ankündigt. Auf dem Papier lädt das einen Absender dazu ein, auf ein Paket ohne Integritätsschutz zurückzufallen, und das ist die Ecke, aus der EFAIL kam. Gemessen kam aber das hier heraus:
[GNUPG:] DECRYPTION_INFO 2 7 0
[GNUPG:] GOODMDC
Ein Absender mit GnuPG 2.4.x in Standardkonfiguration hat trotz des fehlenden Bits ein integritätsgeschütztes SEIPD-v1-Paket erzeugt und GOODMDC gemeldet. MDC ist dort schlicht immer an. Herauskommen aus dem Integritätsschutz muss man in dieser Version aktiv wollen, etwa über --rfc2440, das ausdrücklich den alten Modus ohne MDC erzeugt. Die tatsächliche Integritätslücke gegenüber einem 2.4.x-Absender mit Standardeinstellungen war damit null.
Diese Aussage gilt exakt so weit wie die Messung und keinen Meter weiter. Über andere Implementierungen oder ältere GnuPG-Versionen sagt sie nichts, und genau dort könnte ein fehlendes MDC-Signal im Prinzip sehr wohl noch eine Rolle spielen. „Kein aktueller Absender ist betroffen“ wäre schlicht gelogen, und irgendwer würde es nachprüfen.
Was wirklich Alarm verdient, ist keines von beiden für sich, sondern die Art des Versagens. Ein Schlüssel kann strukturell perfekt sein und trotzdem still auf den nackten Rückfallwert heruntergehandelt werden, ohne dass irgendwer etwas davon mitbekommt. Die einzige Diagnose erscheint auf einer Maschine, die dir nicht gehört. Weder gpg --list-keys noch --check-sigs noch irgendeine Keyserver-Seite zeigt dir das. Du musst dir Signatur-Subpakete ansehen, und das macht praktisch niemand.
Ein Punkt bleibt offen: AEAD
Der reparierte Schlüssel steht bei features 05 und hat keine pref-aead-algos. Gemessen bedeutet das:
AES256.CFB encrypted data      # reparierter Schlüssel, features 05
AES256.OCB encrypted data      # frisch erzeugter Schlüssel, features 07 plus pref-aead-algos: 2
setpref hat das MDC-Bit zurückgeholt, aber nie eine AEAD-Ankündigung ergänzt, weil der Schlüssel aus dem kaputten Zustand heraus repariert und nicht neu erzeugt wurde. Nachrüsten ginge, setpref … OCB liefert pref-aead-algos: 2 und features 07, auch das habe ich geprüft.
Ich lasse es trotzdem so. AES256-CFB mit MDC ist solide. Vor allem aber ist AEAD genau die Stelle, an der OpenPGP derzeit auseinanderläuft: Das AEAD von GnuPG 2.4 folgt der LibrePGP-Linie, RFC 9580 spezifiziert eine andere Konstruktion namens SEIPD v2. AEAD auf einem breit veröffentlichten Schlüssel anzukündigen bringt heute eine marginale Verbesserung und ein echtes Interoperabilitätsrisiko. Wer sich für die andere Baustelle im selben Themenfeld interessiert: Was in einem modernen Handshake steckt, habe ich am Beispiel X25519MLKEM768 auseinandergenommen. Dasselbe Argument gilt übrigens für force-ocb in meiner lokalen Konfiguration, das betrifft nur, was ich selbst verschicke, und ist eine bewusst etwas vorwärtsgewandte Entscheidung.
Ehrliche Gesamteinschätzung
Die Kryptografie ist in Ordnung. Ed25519, X25519, SHA-512 und AES-256 sind eine moderne, unaufgeregte Auswahl ohne bekannte praktische Schwächen, bei rund 128 Bit klassischer Sicherheit.
Die Struktur ist besser als der Durchschnitt. Hauptschlüssel nur zum Zertifizieren, getrennte Unterschlüssel, begrenzte Laufzeit von fünf Jahren, vorab erzeugtes Widerrufszertifikat und ein Backup, das nachweislich wiederherstellbar ist.
Das schwächste Glied ist kein Algorithmus. Es ist die Tatsache, dass die drei Alltags-Unterschlüssel auf einer dauerhaft laufenden Arbeitsmaschine liegen. Wer diese Maschine und die Passphrase bekommt, erzeugt bis zum Widerruf vollgültige Signaturen in meinem Namen und liest mein Archiv mit. Nach außen ist er also erst einmal ich. Was er nicht bekommt, ist der Identitätsanker: keine neue UID zertifizieren, keinen neuen Unterschlüssel binden, und der Fingerabdruck bleibt meiner. Ein kompromittierter Unterschlüssel fliegt raus und wird ersetzt, die Identität überlebt. Eine Smartcard würde den Rest weiter verkleinern, weil sich Schlüsselmaterial von der Karte nicht kopieren lässt. Sie löst es nicht: Steckt die Karte und ist sie entsperrt, wird eben auf der Karte signiert. Auf der Liste steht sie trotzdem.
Das Vertrauen in die Bindung ist geschichtet, nicht absolut. DNSSEC-signiertes DANE und selbst gehostetes WKD sind stark. Die Governikus-Zertifizierung ist die einzige echte Namens-Bindung. Das klassische Web of Trust trägt praktisch nichts mehr bei, die persönlichen Signaturen auf dieser Identität hängen an einem Schlüssel von 2011.
Post-Quantum: bewusst nicht adressiert. GnuPG 2.4.4 kann kein PQC, und die PQC-Arbeit in OpenPGP steckt noch im Entwurfsstadium mit praktisch keiner Interoperabilität. Curve25519 bietet gegen einen kryptografisch relevanten Quantencomputer keinerlei Widerstand, „heute sammeln, später entschlüsseln“ trifft also auf alles zu, was heute an diesen Schlüssel verschlüsselt wird. Ein hybrider Unterschlüssel lässt sich später ergänzen, ohne den Schlüssel neu zu bauen. Das ist eine der Auszahlungen des Unterschlüssel-Aufbaus von oben.
Was man daraus mitnimmt
Vier Punkte, und die gelten weit über OpenPGP hinaus:
Härtung kann schwächen. Einen verpflichtenden Basisalgorithmus zu entfernen hat die Verhandlung nicht verengt, sondern zerstört. Bevor du etwas abschaltest, das eine Spezifikation vorschreibt, sieh nach, was die Maschinerie drumherum macht, wenn es fehlt.
Prüfe das Artefakt, nicht den Befehl.gpg --batch --gen-key ist mit Rückgabewert 0 durchgelaufen und hat einen wunderschön aussehenden Schlüssel erzeugt. Sichtbar war der Defekt ausschließlich in --list-packets.
Konfiguration und Schlüssel sind nicht unabhängig. Der Schlüssel hat einen Defekt dauerhaft von der Konfiguration geerbt, die in den fünfzehn Sekunden aktiv war, in denen er entstand.
Manche Defekte sieht man nur von außen. Das Symptom erschien auf dem Terminal des Absenders. Teste deinen eigenen Schlüssel so, wie ein Fremder ihn benutzt. Genau dafür ist die Schleife mit mktemp -d und --locate-external-keys weiter oben da.
Und die Kurzfassung für alle, die nur bis hierher gescrollt haben: Ein moderner Schlüssel ist nicht automatisch ein korrekt konfigurierter Schlüssel. Der Unterschied steckt in Signatur-Subpaketen, die dir kein einziges Standardwerkzeug von sich aus zeigt.
Wenn du deinen eigenen Schlüssel gerade nachgeprüft hast und dort etwas anderes steht als erwartet, oder wenn ich mich irgendwo irre, dann dürft ihr mich sehr gerne fragen.
Moin. Seit dem 24. Juli 2026 habe ich einen neuen GPG-Schlüssel. Ed25519, gültig bis 2031, der Hauptschlüssel zertifiziert nur noch und hat für Signieren, Verschlüsseln und Authentisieren je einen eigenen Unterschlüssel. Technisch ein hübsches Ding. Der alte Schlüssel bleibt bis Ende des Jahres gültig und hat den neuen gegengezeichnet, damit der Wechsel keine harte Kante bekommt.
Und dann stand da die Frage, die eigentlich immer die wichtigere ist und trotzdem meistens hintenrunterfällt: Woher soll irgendwer wissen, dass dieser Schlüssel mir gehört? Nicht „wo finde ich den Schlüssel“, das ist gelöst. Sondern: Warum sollte jemand glauben, dass die Person, die diesen Schlüssel kontrolliert, dieselbe ist wie die hinter github.com/Kernel-Error, hinter dem Mastodon-Account und hinter dieser Domain?
Die alten Antworten funktionieren nicht mehr
Die klassische Antwort auf diese Frage heißt Web of Trust. Ich unterschreibe deinen Schlüssel, du unterschreibst meinen, irgendwann spannt sich ein Netz aus Signaturen über die Welt und jeder kann über ein paar Ecken einen Pfad zu jedem finden. Elegante Idee. Nur: Wann warst du zuletzt auf einer Keysigning-Party? Eben. Ich auch nicht.
Dazu kommt ein sehr praktisches Problem, über das kaum jemand redet: keys.openpgp.org, der Keyserver, den heute praktisch alle benutzen, veröffentlicht Fremdsignaturen grundsätzlich nicht. Zuverlässig überleben dort nur Selbstsignaturen, einzige Ausnahme sind eigens attestierte Fremdzertifizierungen, und die benutzt in der Praxis kaum jemand. Das ist als Schutz gegen Signatur-Flooding absolut nachvollziehbar, bedeutet aber eben auch: Das Web of Trust reist nicht mehr mit. Du kannst deinen Schlüssel von hundert Leuten unterschreiben lassen, auf dem meistgenutzten Keyserver sieht ihn trotzdem niemand mit diesen Unterschriften.
Die zweite klassische Antwort waren Zertifizierungsstellen für Personen. CAcert habe ich hier vor Jahren mal vorgestellt, und die Volksverschlüsselung wurde 2025 eingestellt. Übrig geblieben ist bei mir eine Zertifizierung über Governikus, die die Beglaubigung im Auftrag des BSI macht, also eine eID-basierte Bestätigung mit Level 3, die tatsächlich meinen bürgerlichen Namen an den Schlüssel bindet. Das ist eine der letzten echten Klarnamen-Bindungen, die man noch bekommt. Und ausgerechnet die ist eine Fremdsignatur, fliegt auf keys.openpgp.org also raus.
Was schon vorher da war, und was es eben nicht beweist
Beim Thema Erreichbarkeit war ich schon vorher gut aufgestellt. Der Schlüssel liegt im Web Key Directory, sowohl in der advanced als auch in der direct method. Er steht als OPENPGPKEY-Record in einer DNSSEC-signierten Zone, wie ich das hier vor Jahren schon einmal beschrieben habe. Er liegt auf keys.openpgp.org, keyserver.ubuntu.com und pgpkeys.eu. Er ist in der clearsigned security.txt referenziert, die zu meinem Umgang mit Vulnerability Reports gehört. Und er liegt schlicht als Datei zum Direktdownload.
Sieben Kanäle also. Alle beweisen exakt eine Sache: dass man den Schlüssel findet. Die Governikus-Zertifizierung beweist zusätzlich einen Namen. Aber keiner dieser Kanäle beweist, dass derselbe Schlüssel auch das GitHub-Konto kontrolliert, oder den Matrix-Account, oder die Domain als Identität und nicht nur als Hostingort einer Datei. Genau diese Lücke füllen Identity Claims, und genau dafür gibt es Keyoxide.
Der wichtigste Satz zuerst: Keyoxide hat keine Accounts
Das ist das größte Missverständnis, und ich schreibe es deshalb so deutlich wie möglich hin: Es gibt bei Keyoxide keine Registrierung, keinen Login, kein Profil zum Ausfüllen, keine API-Keys und keine Daten auf deren Seite. Man legt dort nichts an. Man kann dort gar nichts anlegen.
keyoxide.org ist ein zustandsloser Betrachter. Wenn jemand ein Profil öffnet, passiert Folgendes:
Der öffentliche Schlüssel wird geholt, per WKD oder von einem Keyserver.
Aus der Selbstsignatur werden die Notationen mit dem Namen proof@ariadne.id ausgelesen.
Jeder Claim wird live gegen den genannten Endpunkt aufgelöst, je nach Claim-Typ direkt im Browser oder über einen Proxy. Ein TXT-Record lässt sich aus einer Webseite heraus nun mal nicht selbst abfragen.
Grüne Haken werden gerendert, und danach vergisst der Dienst alles wieder.
Die Konsequenz daraus ist der eigentliche Clou: Der Schlüssel ist das Profil. Wenn keyoxide.org morgen offline geht, ist nichts kaputt. Die Claims stehen weiter im Schlüssel, die Proofs liegen weiter an ihren Endpunkten, und jeder kann die komplette Prüfung mit dig und curl von Hand nachvollziehen. Weiter unten zeige ich genau das.
Das ist das genaue Gegenmodell zu Keybase, wo die Verknüpfungen auf einem Server einer Firma lagen. Als die Firma verkauft wurde, war der Ärger groß und die Frage berechtigt, was mit den Identitäten passiert. Bei diesem Modell stellt sich die Frage nicht, weil der Betreiber nichts hält, was verloren gehen könnte. Die zugrundeliegende Spezifikation heißt Ariadne Identity, Keyoxide ist nur eine Implementierung davon.
Zwei Hälften, die aufeinander zeigen
Jeder Proof besteht aus zwei Aussagen, die sich gegenseitig referenzieren:
Hälfte
Liegt in
Sagt
Claim
der Selbstsignatur des Schlüssels
„Ich kontrolliere kernel-error.de“
Proof
genau diesem Endpunkt
„Der Schlüssel mit dem Fingerprint 45FC… gehört mir“
Auf den ersten Blick sieht das zirkulär aus. Der Schlüssel sagt, ihm gehöre die Domain, und die Domain sagt, ihr gehöre der Schlüssel. Beweist das nicht einfach gar nichts? Doch, und zwar genau deshalb, weil es zirkulär ist: Nur wer beides kontrolliert, kann beide Hälften zur Deckung bringen.
Spielen wir es durch. Jemand klaut meinen geheimen Schlüssel. Er kann jetzt beliebige Claims hineinschreiben, zum Beispiel „ich kontrolliere example.org“. Aber er kann bei example.org keinen TXT-Record setzen, der auf meinen Fingerprint zeigt. Der Claim bleibt rot. Umgekehrt: Jemand übernimmt eine meiner Domains und setzt dort einen TXT-Record mit meinem Fingerprint. Schön, aber ohne den geheimen Schlüssel kann er den passenden Claim nicht in die Selbstsignatur schreiben. Auch das ergibt keinen grünen Haken. Ein Angreifer mit einer der beiden Hälften bekommt nichts. Er braucht beide.
Warum eine Notation und keine Signatur
Ein Claim ist technisch ein Notation-Subpacket in der Selbstsignatur einer User-ID. Eine Notation ist ein frei definierbares Schlüssel-Wert-Paar, das im Signaturpaket mitsigniert wird. Der Name ist bei Ariadne immer proof@ariadne.id, der Wert beschreibt den Endpunkt.
Und hier schließt sich der Kreis zu dem Keyserver-Problem von oben. Weil die Claims in der Selbstsignatur stehen und nicht in einer Fremdsignatur, kann kein Keyserver sie wegputzen. Meine Governikus-Zertifizierung ist auf keys.openpgp.org verschwunden, weil sie eine Fremdsignatur ist. Die Keyoxide-Claims sind da, weil ein Keyserver eine Selbstsignatur nicht entfernen kann, ohne den Schlüssel dabei zu zerstören. Das ist für mich das stärkste praktische Argument, Notationen zu sammeln statt Unterschriften.
Vier Claims, vier sehr unterschiedliche Qualitäten
Live sind am Ende vier Claims, alle ausschließlich auf der Namens-UID:
Vier Claims, vier grüne Haken. Geprüft wird das erst beim Aufruf, gespeichert ist bei Keyoxide davon nichts. Der Fingerprint darunter ist der einzige Anker.
Das öffentliche Profil dazu liegt unter keyoxide.org/45FCD081ADB54872EA5B06B9893DE0CDDE986DEB. Bevor jetzt jemand vier grüne Haken sieht und denkt, das seien vier gleichwertige Beweise: sind sie nicht, und das gehört ausgesprochen.
Die beiden DNS-Claims sind mit Abstand die stärksten. Sie liegen in meinen eigenen, DNSSEC-signierten Zonen auf meinen eigenen Nameservern. Wer den Record fälschen will, muss meine Domain- oder DNS-Verwaltung übernehmen. Unterwegs fälschen reicht nicht, sofern der Prüfer DNSSEC auch wirklich validiert.
Der Gist-Claim hängt daran, dass GitHub sein URL-Schema beibehält und den Gist nicht wegräumt.
Der Matrix-Claim hängt an matrix.org und daran, dass ein bestimmter Raum weiter existiert und die Nachricht nicht gelöscht wird.
Ein Claim ist nie stärker als der Endpunkt, auf den er zeigt. Vier grüne Haken nebeneinander suggerieren eine Gleichwertigkeit, die es nicht gibt.
Domain-Proof: ein TXT-Record am Apex
Der Proof für eine Domain ist ein TXT-Record. Bei mir in beiden Zonen:
kernel-error.de.   IN TXT  "openpgp4fpr:45FCD081ADB54872EA5B06B9893DE0CDDE986DEB"
kernel-error.com.  IN TXT  "openpgp4fpr:45FCD081ADB54872EA5B06B9893DE0CDDE986DEB"
Am Apex, nicht unter www, und das ist eine bewusste Entscheidung. Der Claim behauptet etwas über die Identität der Domain, nicht über einen Webserver-Hostnamen. www ist nur ein Host darunter. Keyoxide rendert den Claim außerdem als den Domainnamen, und kernel-error.de liest sich als Identität, während www.kernel-error.de sich als Webseite liest. Kleiner Unterschied, aber genau der Punkt, um den es hier geht.
Beide TLDs bekommen den Record, weil sie bei mir verschiedene Rollen haben. Die .com ist die Mail-Identität mit WKD und DANE, die .de ist die Webpräsenz mit der security.txt. Beides bin ich, also gehört beides an den Schlüssel gebunden.
Beide Zonen sind DNSSEC-signiert und laufen mit inline-signing. Für so eine Bearbeitung heißt das: einfrieren, editieren, prüfen, wieder auftauen. Ein rndc reload ist hier der falsche Befehl.
Angenehm unspektakulär war dabei, dass mehrere TXT-Records am selben Namen problemlos nebeneinander leben. Der neue Record ist einfach neben den SPF-Record und zwei Verifizierungs-Records gerutscht, ohne dass ich irgendetwas anfassen musste.
Einen Bluesky-Claim habe ich bewusst weggelassen. Meine did:plc:... hängt ohnehin schon über einen DNS-TXT-Record und /.well-known/atproto-did an der Domain. Wer den Domain-Claim prüft, hat Bluesky damit transitiv mit erledigt. Noch ein Claim mehr wäre nur mehr Fläche ohne mehr Aussage.
GitHub: ein öffentlicher Gist namens proof.md
Für GitHub braucht es einen öffentlichen Gist. Die Datei darin mussproof.md heißen, der Inhalt ist eine einzige Zeile:
Eine Abgrenzung, über die regelmäßig jemand stolpert, deshalb explizit: Einen GPG-Schlüssel im GitHub-Profil zu hinterlegen, damit signierte Commits als „Verified“ angezeigt werden, ist eine völlig andere Sache. Anderer Mechanismus, anderer Zweck, und mit dem Keyoxide-Proof hat das nichts zu tun. Der hinterlegte Schlüssel wird von GitHub automatisch für die Commit-Verifikation benutzt. Einen Schalter „diesen Schlüssel als Signing Key verwenden“ gibt es für GPG-Schlüssel übrigens gar nicht, den gibt es nur für SSH-Schlüssel.
Matrix: der Proof ist eine Nachricht
Bei Matrix hat der Proof wieder eine ganz andere Form. Er ist weder eine Datei noch ein DNS-Record, sondern eine Nachricht in einem öffentlichen Raum. Man postet in #doipver:matrix.org schlicht:
Und zeigt dann in der Notation auf genau diese Nachricht. Beim Formatieren gibt es drei Kleinigkeiten, die man garantiert einmal falsch macht: Beim User wird das führende @ weggelassen, bei der Raum-ID das führende ! und bei der Event-ID das führende $. Aus @kernel-error:kernel-error.com wird also u/kernel-error:kernel-error.com, aus !dBfQZxCoGVmSTujfiv:matrix.org wird der nackte Rest, und genauso bei der Event-ID.
Wichtig ist außerdem, dass der Raum unverschlüsselt ist. Eine verschlüsselte Nachricht kann ein Prüfer nicht lesen, damit wäre der Proof wertlos. #doipver ist genau dafür da und entsprechend offen.
Der ganze Vorgang lässt sich komplett über die Client-Server-API erledigen, also POST /_matrix/client/v3/join/... und danach PUT /_matrix/client/v3/rooms/{roomId}/send/m.room.message/{txnId}. Die Antwort auf das Senden enthält direkt die event_id, also genau das, was die Notation braucht. Das ist elegant, wenn man es scripten will.
Ehrlicherweise muss man dazu aber sagen: Ein Access-Token gibt volle Kontrolle über den Account. Das aus der Hand zu geben, nur um eine einzige öffentliche Zeile abzusetzen, ist ein schlechtes Geschäft. Der Weg über Element von Hand kostet dreißig Sekunden: Nachricht posten, „Teilen“ beziehungsweise Permalink aufrufen, und Raum-ID sowie Event-ID direkt aus der matrix.to-URL ablesen. Wer trotzdem ein Token benutzt, sollte das Gerät danach abmelden.
Die Claims in den Schlüssel schreiben
Das eigentliche Eintragen passiert in gpg --edit-key. Sieht harmlos aus, hat aber gleich in Zeile zwei die erste Falle:
gpg --edit-key 0x893DE0CDDE986DEB
uid 1
notation
proof@ariadne.id=dns:kernel-error.de?type=TXT
save
Entfernen geht über notation und dann den gleichen Ausdruck mit einem führenden Minus, none löscht alle. Und weil man sich auf Anzeigen ungern verlässt, hier der Blick auf das, was wirklich im Schlüssel steht:
Ohne vorher eine UID auszuwählen schreibt gpg die Notation in jede UID. Bei mir also auch in die Foto-UID. Keyoxide prüft dann denselben Claim zweimal und zeigt ihn doppelt an. Die offizielle Dokumentation erwähnt das im Nebensatz, überlesen ist es schnell, und aufräumen darf man es anschließend von Hand.
Falle 2: jede Änderung schreibt die Selbstsignatur neu
Das ist der eigentliche Preis, und davor warnt einen niemand. Ein Claim mehr bedeutet eine neue Selbstsignatur, und damit ist jede veröffentlichte Kopie des Schlüssels veraltet. Konkret hieß das bei mir jedes Mal: neu hochladen zu drei Keyservern, zwei selbst gehostete Dateien überschreiben und noch eine DNSSEC-Zonenbearbeitung für den DANE-Record hinterher.
Wer drei Claims einzeln nacheinander setzt, macht diese Runde dreimal. Also: Claims sammeln und in einem Rutsch eintragen. Nebenbei wächst der Schlüssel auch spürbar. Die DANE-rdata ist im Lauf des Tages von 909 auf 1130 Byte gewachsen, die WKD-Datei von 12703 auf 12940 Byte. Nichts Dramatisches, aber bei einem DNS-Record schaut man da schon hin.
Falle 3: drei Caches, drei vorgetäuschte Fehlschläge an einem Nachmittag
Das ist der Teil, bei dem vermutlich jeder Leser nickt. An einem einzigen Nachmittag haben mir drei verschiedene Caches je einen kaputten Rollout vorgespielt. In allen drei Fällen war das Deployment in Ordnung und die Prüfung hat gelogen.
Der eigene Resolver. Nach dem Setzen des TXT-Records schlug die lokale Prüfung immer weiter fehl. Google, Cloudflare und Quad9 hatten den neuen Record sofort. Der veraltete Eintrag kam ausgerechnet von meinem eigenen DoT/DoH-Resolver, auf den systemd-resolved zeigt, und der hielt die alte Antwort noch etwa zwei Stunden fest. Das sieht exakt aus wie ein kaputtes Deployment und kostet echte Debugging-Zeit.
Der View-Name am Ende ist bei rndc flushname laut Handbuch optional. In meinem Setup mit einer eigenen resolver-View ist er aber Pflicht, sonst passiert schlicht nichts Sichtbares. Die allgemeine Lehre daraus: Wer eigene DNS-Änderungen prüft, fragt immer einen autoritativen Server und einen öffentlichen Resolver, niemals nur den Systemresolver.
Ein HTTP-Cache vor keyserver.ubuntu.com. Der lieferte einen veralteten Schlüssel mit nur der Hälfte der Claims aus. Ein angehängter Cache-Busting-Parameter brachte sofort die korrekte Version, und ein erneuter Upload wurde mit "ignored" quittiert. Der Server war also die ganze Zeit aktuell, nur der Cache davor nicht.
Und die Keyserver selbst. Keyserver mischen Selbstsignaturen, sie ersetzen sie nicht. Nach einem Update trägt die Keyserver-Kopie die alte und die neue Selbstsignatur. Ein naives grep -c notation zählt dann fünf Notationen, während die selbst gehostete Kopie drei zeigt. gpg nimmt beim Import die neueste, praktisch ist das also harmlos, aber jedes Verifikationsskript lügt einen dabei an. Man prüft besser, was ein frischer Import auflöst, nicht was im rohen Blob steht.
Die Moral aus allen drei Fällen ist dieselbe: gegen eine autoritative Quelle prüfen und gegen eine cache-busted Anfrage, niemals nur gegen die eine bequeme Quelle, die gerade zur Hand ist.
Falle 4: die Gist-Raw-URL springt den Host
Ein kurzer Schreckmoment mit einfacher Ursache. Die Adresse https://gist.github.com/<user>/<id>/raw/proof.md antwortet mit einem 301 auf gist.githubusercontent.com. Ein curl ohne -L liefert damit gar nichts zurück, was auf den ersten Blick nach einem kaputten Proof aussieht. Ist es nicht, es fehlt nur ein Buchstabe am Kommando.
Falle 5: –print-dane-records gibt es nicht mehr
In GnuPG 2.4 ist --print-dane-records weg. Der Aufruf bricht mit einem Fehler ab und verweist auf --export-options export-dane. Nur reicht export-minimal allein nicht: Die Foto-UID bleibt drin und bläst einen DANE-Record von rund einem Kilobyte auf etwa zwölf Kilobyte auf. Die kompakte Variante braucht zusätzlich einen Export-Filter:
Der fünfte Claim: Fediverse, und warum er nicht live ist
Jetzt der ehrliche Teil. Ein fünfter Claim war gebaut, ausgerollt, nie verifiziert und noch am selben Tag wieder zurückgebaut. Ich schreibe das hier hin, weil vier aufgeräumte grüne Haken nichts erzählen und dieser eine Fehlschlag mehr über die Technik verrät als der Rest zusammen.
Der Plan war ein Claim auf https://www.kernel-error.de/@kernel-error.de, also den ActivityPub-Actor dieses Blogs, mit dem Proof in den Profil-Metadaten. Beim WordPress-ActivityPub-Plugin werden die „Extra Fields“ als PropertyValue-Attachments an den Actor gehängt. Zwei Entscheidungen dabei waren richtig und bleiben es auch nach dem Rückbau.
Erstens: Die Claim-URL leitet im Browser um, liefert aber unter Accept: application/activity+json sauber den Actor aus. „Mach das doch mal im Browser auf“ ist bei einem maschinenlesbaren Endpunkt schlicht kein gültiger Test. Wer so prüft, verwirft eine funktionierende Adresse.
Zweitens: Die Platzierung war wichtiger als gedacht. Keyoxide akzeptiert den Proof in der Bio, in einem Beitrag oder in den Profil-Metadaten. Bei einem WordPress-Blog-Actor ist die Bio aber der Blog-Slogan, und der steht auf jeder einzelnen Seite der öffentlichen Webseite. Ein Fingerprint im Header, weil man die erstbeste dokumentierte Möglichkeit genommen hat. Die Profil-Metadaten sind genauso gültig und für Leser unsichtbar. Lohnt sich also, erst alle Optionen zu lesen und dann zu wählen.
Ein Implementierungsdetail mit echter Fallhöhe: Das Feld wurde mit $wpdb->insert eingetragen, ausdrücklich nicht mit wp_insert_post(). Letzteres feuert die ActivityPub-Hooks und erzeugt einen Update-Eintrag in der Outbox, der dann als Geisterbeitrag durch das Fediverse geht. Kontrolliert habe ich das über den Zeilenstand der ap_outbox vor und nach dem Eingriff: 130 zu 130, sowohl beim Anlegen als auch beim Löschen. Danach Caches leeren, und zwar zuerst Redis, dann FastCGI, sonst füllt sich der FastCGI-Cache sofort wieder aus den alten Redis-Daten. Wer mehr über das Plugin-Innenleben lesen mag, findet in meinem Beitrag zum eigenen ActivityPub-Plugin für Grav die Mechanik dahinter.
Und dann zeigte Keyoxide trotzdem ein rotes Kreuz.
Ein rotes Kreuz und eine sehr überzeugende falsche Fährte
Der Claim stand auf dem Profil als rotes Kreuz mit der Beschriftung [---], was so viel heißt wie „kein Service Provider hat gematcht“. Die anderen vier waren grün. Das Access-Log sah so aus:
OPTIONS /@kernel-error.de                     301
GET     /.well-known/nodeinfo                 200
GET     /wp-json/activitypub/1.0/nodeinfo/2.1  200
GET     /@kernel-error.de/api/config           404   (doipjs/2.1.0)
Die naheliegende Lesart ist falsch, und sie ist verführerisch. /api/config ist ein Owncast-Endpunkt. Man denkt sofort: Keyoxide hält meinen Claim für einen Owncast-Server, da ist die Provider-Erkennung kaputt. Stimmt aber nicht. Die beiden NodeInfo-Abfragen darüber stammen aus dem ActivityPub-Postprozessor von doipjs, ActivityPub hatte also gematcht. Die Owncast-Abfrage ist der Fallback, der danach läuft, weil der ActivityPub-Test bereits gescheitert war. Symptom, nicht Ursache.
Die Ursache steht in der ersten Zeile. WordPress beantwortet ein OPTIONS auf die hübsche Actor-URL mit einem 301 auf die Startseite. Und ein umgeleiteter CORS-Preflight ist in allen heute relevanten Browsern ein harter Fehler. Die Fetch-Spezifikation ist an der Stelle inzwischen weniger strikt formuliert, in der Praxis bricht der Browser trotzdem ab, und der Prüfer kommt nie an den Actor heran. Das Ärgerliche daran: Die CORS-Header waren die ganze Zeit korrekt gesetzt, Access-Control-Allow-Origin: * und der ganze Rest. Sie kamen nur mit Status 301, und damit sind sie wertlos.
Eine andere Claim-URL hilft nicht heraus. /@handle und /@handle/ antworten beide mit 301 auf OPTIONS, und die eigentliche Actor-ID /?author=0 beantwortet OPTIONS mit 405 und ganz ohne CORS-Header. Es musste also in den nginx, mit einer Location, die den Preflight selbst beantwortet:
Platziert als erste Regex-Location, damit sie vor den späteren gewinnt, und der Nicht-OPTIONS-Zweig spiegelt exakt das, was auch location / macht, damit normaler Verkehr unverändert durchläuft. Der Preflight ging damit von 301 auf 204.
Und der erste Fix reichte nicht, das Log hat es leise gesagt
Nach dem Reload kam sauber der 204. Aber das anschließende GET /@kernel-error.de tauchte im Access-Log überhaupt nicht auf, und doipjs marschierte direkt wieder zur Owncast-Abfrage weiter. Genau diese Abwesenheit ist die Fehlermeldung: Ein Preflight, der erfolgreich ist und auf den dann gar keine Anfrage folgt, bedeutet, dass der Browser die Antwort auf den Preflight abgelehnt hat.
Die Liste der erlaubten Header war schlicht geraten. Accept, Authorization, Content-Type klingt vernünftig, deckte aber offensichtlich nicht ab, was doipjs tatsächlich schickt. Die Erweiterung auf Access-Control-Allow-Headers: * war die zweite Hälfte des Fixes. Der Wildcard wirkt hier, weil die Anfrage ohne Credentials und ohne HTTP-Auth läuft. Bei einer Anfrage mit Credentials wäre der Stern wirkungslos, und Authorization deckt er ohnehin nie ab, den müsste man immer namentlich nennen. Oben steht schon die korrigierte Fassung.
Noch eine Warnung für alle, die so etwas nachbauen: Access-Control-Max-Age: 86400 heißt, dass der Browser die alte Preflight-Antwort einen Tag lang behält. Ein normales Neuladen leert den CORS-Preflight-Cache nicht. Also im privaten Fenster nachtesten, sonst jagt man ein Gespenst.
Drei Lehren daraus, die weit über Keyoxide hinaus gelten:
Richtige Header auf einem falschen Statuscode sind trotzdem kaputt. Ein 301 mit perfekten CORS-Headern scheitert genauso hart wie gar keine Header.
Ein Log liest man von oben nach unten, nicht von unten nach oben. Die verdächtigste Zeile, der 404, war die Folge. Der langweilige 301 zwei Zeilen darüber war der Fehler.
Eine Anfrage, die im Log fehlt, ist auch ein Befund. Die zweite Runde habe ich ausschließlich aus etwas diagnostiziert, das nicht passiert ist.
Ein Nebeneffekt, der mir erst hinterher aufging: Das war nie ein Keyoxide-Problem. Jeder Cross-Origin-Konsument meines ActivityPub-Actors, der dafür im Browser läuft und einen Preflight braucht, ist an diesem Redirect gescheitert, seit es die Adresse gibt, und es ist niemandem aufgefallen. Serverseitige Abrufer waren nie betroffen, die kennen kein CORS. Der nginx-Fix ist deshalb geblieben, auch nachdem der Claim wieder weg war. Er repariert einen echten Defekt, völlig unabhängig von Keyoxide.
Und trotzdem blieb es rot
Nach dem CORS-Fix zeigte das Log endlich das gewünschte Bild: OPTIONS ... 204, gefolgt von GET /@kernel-error.de 200 6915 "doipjs/2.1.0". Der Actor wurde geholt. Und der Claim blieb rot. Der Reihe nach ausgeschlossen habe ich dann:
Provider-Matching. Das Regex in activitypub.js ist ein Catch-All, und die NodeInfo-Abfragen im Log beweisen ohnehin, dass der zugehörige Postprozessor gelaufen ist.
Feldplatzierung.attachment.value ist eines der drei Felder, die doipjs durchsucht.
Inhalt und Schreibweise. Fingerprint einmal in Großbuchstaben, einmal in Kleinbuchstaben probiert. Beides ohne Treffer. Die anderen vier Claims benutzen alle Großbuchstaben und verifizieren einwandfrei, an der Schreibweise liegt es also nicht.
Bleibt ein Verdacht, den ich ausdrücklich als unbewiesen kennzeichne: Das hier ist ein WordPress-ActivityPub-Blog-Actor. NodeInfo meldet software: wordpress, und der preferredUsername lautet kernel-error.de, ist also ein Benutzername mit Punkten darin, den Mastodon so gar nicht erzeugen könnte. Das ist ein deutlich weniger befahrener Pfad durch doipjs als ein normales Mastodon-Profil. Weiterzukommen hätte bedeutet, fremdes JavaScript zu debuggen, für den fünften von fünf Claims.
Also habe ich aufgehört, und die Entscheidung gehört zur Geschichte dazu. Rückbau komplett: Notation aus dem Schlüssel entfernt, alle sieben Kanäle neu ausgerollt, das Profilfeld gelöscht, Caches geleert. Der Claim ist damit vollständig verschwunden, es bleibt also kein dauerhaftes rotes Kreuz stehen. Das ist übrigens eine erfreuliche Eigenschaft: Ein Claim, der nicht funktioniert, lässt sich sauber zurückziehen. Nur die Historie der Notation liegt für immer auf den Keyservern. Wer die rohen Schlüsseldaten auseinandernimmt, findet die alten Selbstsignaturen samt Claim also weiterhin. Im aktuellen Profil taucht er nicht mehr auf.
Zwei Stolpersteine aus dem Rückbau, die man kennen sollte:
Das Entfernen einer Notation braucht eine Bestätigung. Die Reihenfolge ist uid 1, dann notation, dann der Ausdruck mit führendem Minus, dann ein y, dann erst save. Ohne das y schluckt gpg das nachfolgende save als Antwort auf seine Rückfrage, und das Entfernen passiert stillschweigend gar nicht.
Keyserver behalten jede Generation von Selbstsignaturen. Nach dem Rückbau lagen auf keys.openpgp.org zehn Selbstsignaturen auf dieser UID, mit der Reihe 4, 5, 4, 3, 2, 0 Claims. Harmlos, weil gpg wie openpgp.js die neueste nimmt. Aber --export-options export-clean reduziert das nicht auf eine Selbstsignatur. Wer Notationen über einen so bereinigten Export zählt, zählt zu hoch und hält einen erfolgreichen Rückbau für gescheitert. Besser die Zeitstempel pro Signatur vergleichen.
Falle 6: ein langsamer Matrix-Raum sieht aus wie kaputte Föderation
Zum Schluss noch eine schöne Fehldiagnose. Der erste Versuch, #doipver:matrix.org beizutreten, starb mit ResponseNeverReceived. Das liest sich wie ein glasklarer Föderationsausfall, und ich habe entsprechend angefangen zu suchen. Nur: federationtester.matrix.org meldete FederationOK: true mit gültigen Zertifikaten über IPv4 und IPv6, und blankes TCP wie auch HTTPS vom Server nach matrix.org liefen einwandfrei.
#doipver ist einfach ein großer, stark föderierter Raum. Der Alias löst auf hunderte beteiligte Server auf, und ein make_join gegen einen einzelnen ausgelasteten Server dauert entsprechend. Geholfen haben zwei Dinge: mehrere Server zum Beitreten mitgeben und einen großzügigen Timeout setzen, 180 Sekunden waren genug. Der Parameter heißt in der aktuellen Spezifikation via, ich habe hier noch den älteren Namen server_name benutzt.
POST /_matrix/client/v3/join/%21dBfQZxCoGVmSTujfiv%3Amatrix.org
     ?server_name=matrix.org&server_name=privacyguides.org&server_name=monero.social
Die übertragbare Lehre, gerade für dieses Publikum: Bevor man aus einer einzigen gescheiterten Anfrage eine Föderationsstörung diagnostiziert, sollte man prüfen, ob die Anfrage nur langsam war. Am selben Tag tauchten übrigens noch zwei 429 Too Many Requests bei Schlüsselabfragen im Log auf, ebenfalls reine Ablenkung.
Selbst nachprüfen, ganz ohne die Webseite
Und hier kommt der Punkt, an dem das ganze Modell überzeugt. Du musst keyoxide.org nicht vertrauen, du kannst die komplette Prüfung selbst machen. Vier Schritte, gegen meinen Schlüssel:
# 1. Schlüssel holen, so wie es ein Fremder tun würde
gpg --auto-key-locate clear,wkd --locate-external-keys kernel-error@kernel-error.com

# 2. Claims aus der Selbstsignatur lesen
gpg --export 0x893DE0CDDE986DEB | gpg --list-packets | grep 'proof@ariadne.id'

# 3. Claims auflösen
dig +short TXT kernel-error.de   | grep openpgp4fpr
dig +short TXT kernel-error.com  | grep openpgp4fpr
curl -sSL https://gist.github.com/Kernel-Error/b51b81489a0600908cf09aca13765b9c/raw/proof.md
# Matrix: Nachricht im Client öffnen oder das Event per API lesen
#   Raum  !dBfQZxCoGVmSTujfiv:matrix.org
#   Event $q3zhGJTbPWZD5LjUnsnAI9p43YzHXglniNv_SL7dldQ

# 4. Gegen den Fingerprint aus Schritt 1 vergleichen, das ist die gesamte Prüfung
Das ist Keyoxide. Mehr macht die Seite auch nicht, sie macht es nur hübscher und schneller. Wenn du diese vier Schritte einmal von Hand durchgehst, sitzt das Argument „du musst der Webseite nicht vertrauen“ deutlich besser als jede Erklärung.
Was das beweist, und was eben nicht
Damit hier niemand mit falschen Erwartungen rausgeht, die ehrlichen Grenzen:
Claims sind praktisch dauerhaft. Sie stehen in der Selbstsignatur, die auf Keyserver hochgeladen wird, und keys.openpgp.org kennt kein Zurücknehmen. Man sollte also nur Identitäten claimen, die man dauerhaft und öffentlich an den Schlüssel gebunden haben möchte. Genau deshalb habe ich Telegram und Threema bewusst weggelassen.
Xing und LinkedIn habe ich übersprungen, es gibt dort keinen brauchbaren Proof-Mechanismus. Eine Klarnamen-Bindung existiert bei mir ohnehin in stärkerer Form über die eID-Zertifizierung. Telefonnummern, SIP und Postanschrift sind nicht verifizierbar und ohnehin eine schlechte Idee.
Das beweist Kontrolle, nicht Identität. Ein grüner Haken sagt: Dieselbe Instanz kontrolliert diesen Schlüssel und dieses Konto. Er sagt nicht, wer diese Instanz ist. Dafür braucht es weiterhin so etwas wie eine eID-Zertifizierung oder ein persönliches Treffen. Das ist die ehrliche Grenze des ganzen Ansatzes, und sie zu überverkaufen wäre falsch.
Die Prüfung ist nur so stark wie der schwächste Endpunkt. Eine DNSSEC-signierte Zone auf eigenen Nameservern ist stark. Ein Gist auf einer Plattform, die morgen ihr URL-Schema ändern kann, ist es nicht.
Keyoxide selbst ist eine Bequemlichkeitsschicht. Verschwindet Keyoxide, funktionieren die Claims weiter. Verschwindet GitHub, ist genau dieser eine Claim tot.
Nachtrag: der neue Schlüssel hatte noch ein ganz anderes Problem
Beim Durchleuchten des Setups ist mir nebenbei ein echter Defekt am funkelnagelneuen Schlüssel aufgefallen: Er hatte überhaupt keine Algorithmus-Präferenzen. Die Folge war messbar und wirklich unangenehm. Ein Dritter, der an den alten Schlüssel verschlüsselt hat, bekam AES256. Beim neuen Schlüssel wurde daraus stillschweigend AES128. Der neue, modernere Schlüssel wurde also schwächer adressiert als der, den er ablöst. Das ist eine eigene Geschichte und die erzähle ich in einem eigenen Beitrag, denn der Unterschied zwischen „mein Schlüssel ist modern“ und „mein Schlüssel ist korrekt konfiguriert“ verdient mehr als eine Randnotiz.
Fazit
Das Web of Trust ist als Alltagsmechanismus tot, die Zertifizierungsstellen für Privatpersonen sind weitgehend weg, und trotzdem bleibt die Frage bestehen, wem ein Schlüssel gehört. Identity Claims sind darauf eine überraschend saubere Antwort: kein Account, kein Anbieter, der etwas hält, keine Abhängigkeit von einer Firma, die morgen verkauft wird. Nur zwei Aussagen, die aufeinander zeigen, und ein Schlüssel, der sein Profil selbst ist.
Der Aufwand ist überschaubar, wenn man die Claims sammelt und in einem Rutsch einträgt. Die Zeit geht nicht für Keyoxide drauf, sondern für die eigenen Caches und für einen alten Redirect, den nie jemand hinterfragt hat. So gesehen war der gescheiterte fünfte Claim der nützlichste von allen.
Wie immer gilt: Wenn etwas unklar ist, wenn ich mich irgendwo irre oder wenn jemand doch noch weiß, warum ein WordPress-ActivityPub-Actor bei doipjs durchfällt, dann dürft ihr mich sehr gerne fragen.
Diese Geschichte fing als PHP-Problem an und endete mehrere Wochen später in einem Bug im FreeBSD-Basissystem, ganz unten im Runtime-Linker. Dazwischen liegen mindestens vier falsche Fährten, ein Crash, der bei jedem Lauf ein anderes Opfer suchte, und die schöne Erkenntnis, dass man eine Heap-Korruption nicht mit einzelnen Watchpoints fängt. Ich schreibe das bewusst mit allen Sackgassen auf, weil genau die der lehrreiche Teil sind. Wer nur die Auflösung will, springt ans Ende.
Das Symptom
PHP 8.4 auf FreeBSD 15 (amd64), im Zusammenspiel mit einer selbst gehosteten Nextcloud. Jeder occ-Aufruf und jeder Cron-Lauf lieferte sein Ergebnis korrekt ab und segfaultete danach. Signal 11, jedes Mal, mit schöner Regelmäßigkeit ein Core-Dump von rund 2,2 GB. Die Ausgabe stand vollständig da, bevor es knallte. Der Crash passierte erst im Module-Shutdown, also beim Aufräumen, nachdem die eigentliche Arbeit längst erledigt war.
Funktional war das harmlos. Ärgerlich war der Rest. Das dmesg füllte sich mit Zeilen der Sorte:
pid 12345 (php), jid 0, uid 80: exited on signal 11 (core dumped)
Die Platte lief mit 2,2-GB-Cores voll, und es gab einen unangenehmen Nebeneffekt: hängende Background-Jobs. Wenn PHP-FPM mitten in einem Nextcloud-Cron-Job segfaultet, wird das reserved_at in der Tabelle oc_jobs nie zurückgesetzt. Der Job gilt damit als dauerhaft in Bearbeitung und läuft nie wieder an. Aus einem kosmetischen Shutdown-Crash wurde so ein echtes Betriebsproblem.
Erste falsche Fährte: OPcache JIT
Ein Segfault in PHP, der frische JIT im Spiel: der erste Verdacht war schnell da. Also habe ich mich durch die JIT-Stufen gearbeitet. Tracing-JIT mit opcache.jit=1255, dann Function-JIT mit 1205, dann JIT komplett aus mit 0. Es crashte durch alle Stufen hindurch unverändert weiter.
JIT war auf FreeBSD 15 zwar tatsächlich für sich genommen kaputt und ist bei mir seitdem aus. Aber die Ursache für den Shutdown-Crash war er nicht. Erste Fährte verworfen.
Die Versions- und Build-Jagd
Nächster Verdacht: ein kaputter Build oder eine ABI-Unstimmigkeit zwischen dem PHP-Core und einer Extension. Also PHP komplett aus den Ports neu gebaut, damit Core und alle Extensions garantiert dieselbe Version tragen. Danach Symbol-Builds fürs Debugging. Und dann durch die Punktversionen gehangelt: 8.4.16, .18, .19, .20, .21, .22. Jede einzelne crashte gleich.
Damit war eine wichtige Sache geklärt: Build, Version und CFLAGS sind nicht der Unterschied. Was sich nicht ändert, wenn man alles daran ändert, liegt woanders.
Eine Lehre am Rande, die mich unnötig Zeit gekostet hat: --enable-debug wechselt das ABI-Verzeichnis der Extensions. Danach laden sämtliche als Paket installierten Extensions nicht mehr, weil sie im falschen Verzeichnis gesucht werden. Wer nur Debug-Symbole will, ohne das ABI zu verbiegen, baut so:
make CFLAGS+=" -g" STRIP=
Die Crash-Site per lldb aus dem Core
Das FreeBSD-Basissystem bringt kein gdb mit, dafür lldb. Aus dem Core kommt man so an den Backtrace:
Die crashende Instruktion war cmpq %rbx, 0x20(%r15). Der Offset 0x20 ist in zend_property_info das Feld ce, der Zeiger auf den Klassen-Eintrag. Das Register r15 stand auf 0x6b588e9c404, unaligned und außerhalb des Heaps. Das riecht nach einem Use-after-Free auf geteilte interne Klassen-Metadaten.
Ein genauerer Walk durch die Strukturen korrigierte meine erste Annahme. Der Offset 0x20 liegt nicht nur in zend_property_info, sondern genauso in zend_class_constant auf dem ce-Feld. Die crashende Schleife lief nicht über die Properties, sondern über die Klassen-Konstanten, also die constants_table. Die crashende Klasse war Pdo\Pgsql, eine der neuen internen Subklassen aus dem PHP-8.4-RFC zu den PDO-treiberspezifischen Subklassen, die von PDO erbt. Mein Verdacht drehte sich damit auf etwas 8.4-Spezifisches: Vererbung von internen Konstanten, vielleicht im Umfeld der Property Hooks.
Der Crash wandert
Und jetzt wurde es unangenehm. Die Crash-Site war nicht stabil. Von Lauf zu Lauf sah ich mal destroy_zend_class, mal zend_type_release, mal zend_interned_strings_dtor. Mal war das Opfer Pdo\Pgsql, mal ein arg_info von RedisCluster, mal ein zend_type, mal ein DateTimeZone.
Das ist das klassische Bild eines einzelnen korrumpierenden Schreibzugriffs mit wechselndem Opfer. Wer getroffen wird, hängt allein am Heap-Layout des jeweiligen Laufs. Das erklärt rückblickend, warum die vermeintlich genaue Klasse jedes Mal anders aussah. Ich hatte die ganze Zeit das Spätsymptom analysiert, nicht die Ursache. Als Beispiel eine ganz andere Crash-Site vom zweiten Rechner:
Das Opfer hier war ein permanenter interned String. Das sind die intern deduplizierten, prozessweit nur einmal abgelegten Zeichenketten, die PHP überall wiederverwendet, in diesem Lauf der Redis-Kommandoname zintercard. Sein Header war zerschossen, beim Freigeben faultet der Destruktor auf einem ZendMM-Block, der gar nicht mehr gemappt ist. Wieder ein anderer Tatort, dasselbe Muster: irgendwer schreibt einmal quer, und wer danach als Erstes über die zerstörte Stelle stolpert, nimmt den Fall.
Upstream-Issue GH-21995, und die Richtung dreht sich
An diesem Punkt habe ich das Ganze bei php-src als Issue GH-21995 aufgemacht. Zwei Reaktionen haben die Richtung gedreht.
Zuerst @iliaal, einer der PHP-Maintainer:
Cannot reproduce on Linux (ASAN, Valgrind all clean on 37 extension build), so if this is valid it might be FreeBSD specific.
ASAN und Valgrind sauber auf Linux ist ein starkes Indiz gegen einen klassischen Use-after-Free im Zend-Speichermanager. Ein solcher Fehler würde unter ASAN sofort auffliegen. Wenn er das nicht tut, sitzt das Problem woanders, vermutlich unterhalb von PHP.
Dann bestätigte @CamilleScholtz das Verhalten unabhängig, auf PHP 8.5.6, FreeBSD 15, und ausdrücklich nicht in einem Jail. Damit fielen zwei bequeme Ausreden weg: es war weder meine spezielle Konfiguration noch etwas, das in 8.5 schon behoben gewesen wäre.
Die VM reproduziert nicht, ein Heisenbug
Auf Bare-Metal crashte die unveränderte Paket-Installation praktisch bei jedem Lauf, gefühlt zu hundert Prozent. In einer VM dagegen kam ich auf rund 650 saubere Läufe, ohne einen einzigen Crash. Und sobald ich mit lldb und Watchpoints an das Objekt heranging, das ich für das Opfer hielt, verschob sich das Opfer. Die Beobachtung selbst veränderte das Heap-Layout und damit den Ausgang.
Das ist ein Heisenbug im Lehrbuchsinn. Ein einzelner Watchpoint auf ein einzelnes Objekt bringt hier nichts, weil der nächste Lauf ein anderes Objekt zerstört. Ich brauchte eine Messung, die gegen das Layout robust ist.
Messen statt raten: der Tabellen-Diff
Statt ein einzelnes Objekt zu beobachten, habe ich die ganze Tabelle der permanenten interned Strings an definierten Checkpoints verglichen. Ein eigenes lldb-Python-Skript zieht an jedem Checkpoint einen Snapshot der Tabelle und difft gegen den vorherigen. So ist es egal, welches konkrete Objekt in diesem Lauf getroffen wird, denn ich sehe jede Änderung an der ganzen Region.
Das Ergebnis war der erste harte Datenpunkt seit Wochen. Der korrumpierende Schreibzugriff passiert während des Spawns, genauer im Intervall zwischen posix_spawnp und posix_spawn_file_actions_destroy. Überschrieben wird ein zusammenhängender Block von rund 480 Byte, gefüllt mit 8-Byte-Zeigern. Das sieht aus wie Stack-Frames, die dort hingehören, wo sie nicht hingehören. Damit war klar: das ist keine PHP-interne Speicherverwaltung, das ist der Spawn.
Die Batterie: den Auslöser einkreisen
Jetzt konnte ich gezielt testen. Je 20 Läufe pro Kandidat. Nur proc_open crashte, und zwar 20 von 20. popen, exec, system, shell_exec, fopen, dazu Heap-Churn-Kandidaten wie str_repeat und range: alle 0 von 20. Es ging also nicht um fork und exec im Allgemeinen, auch nicht um Heap-Belastung, sondern spezifisch um proc_open.
Und dann entschied die Form des Aufrufs über Crash oder kein Crash:
Aufruf
Spawn-Pfad
Crash
proc_open(["true"], …) (relativ)
posix_spawnp → __libc_execvpe (PATH-Suche)
ja
proc_open(["/usr/bin/true"], …) (absolut)
posix_spawnp → execvPe direkt
nein
proc_open("true", …) (String)
posix_spawn (/bin/sh -c) → _execve
nein
Nur der relative Befehl ohne Schrägstrich im Namen crasht, weil nur der die PATH-Suche im Kind auslöst. Die Länge des PATH war dabei egal, auch mit einem einzigen Eintrag crashte es. Das grenzt es sauber gegen den alten Long-PATH-Overflow ab: es geht nicht um einen zu langen PATH, sondern um einen intrinsischen Stack-Verbrauch im no-slash-Suchzweig.
Das Minimal-Repro ist entsprechend kurz und kommt ganz ohne Framework aus:
php -r 'proc_open(["date"], [], $pipes);' # → signal 11
Ein Detail fehlt noch, und es ist wichtig: der Crash braucht den vollen Satz geladener Extensions. Ein Minimalsatz von 17 Extensions reicht, aber das Entfernen irgendeiner einzelnen davon stoppt den Crash. Konkret dieser Satz: session, dom, iconv, imagick, intl, pdo, pgsql, phar, simplexml, sodium, xml, xmlwriter, zip, zlib, memcached, pdo_pgsql, redis. Viele geladene Shared Objects plus ein proc_open: beides zusammen ist nötig, keins allein reicht. Diese Beobachtung war später der Schlüssel zur Ursache, auch wenn ich das zu dem Zeitpunkt noch nicht wusste.
Runter in die libc-Quelle
Der Spawn führte mich in /usr/src/lib/libc/gen/posix_spawn.c. Auf amd64 startet do_posix_spawn das Spawn-Kind so:
Für ein {"true", NULL} sind das rund 4128 Byte. Das Entscheidende an RFSPAWN beziehungsweise rfork_thread: das Kind bekommt bis zum exec einen geteilten Adressraum, ähnlich wie bei vfork. Kind und Eltern arbeiten bis zum exec also auf demselben Speicher. Bei einem relativen Kommando läuft das Kind über __libc_execvpe in die PATH-Suche. Meine Hypothese an dieser Stelle war: das Kind erschöpft seine gut 4 KB Stack und schreibt in den direkt darunter liegenden Heap des Elternprozesses. Das würde exakt zu dem 480-Byte-Block aus Zeigern passen, den der Tabellen-Diff gesehen hatte.
Der Beweis: guardspawn
Eine Hypothese ist nur so gut wie ihr Experiment. Also habe ich guardspawn.c geschrieben, einen kleinen Interposer per LD_PRELOAD, der rfork_thread(RFSPAWN) abfängt und dem Kind einen selbst kontrollierten Stack unterschiebt. Zwei Varianten, zwei klare Antworten:
Gebe ich dem Kind 1 MB Stack, fällt der Crash auf 0 von 30. Baseline ohne Interposer war 30 von 30.
Gebe ich dem Kind wieder nur gut 4 KB, aber mit einer Guard-Page direkt darunter, stirbt das Spawn-Kind selbst mit SIGSEGV, unabhängig von der genauen Stelle.
Damit war die Kernaussage bewiesen: das Kind erschöpft den knapp 4 KB großen Spawn-Stack. Genauso ehrlich habe ich es aber auch in den Report geschrieben: welcher exakte Frame den Puffer überläuft, war zu dem Zeitpunkt nicht bewiesen. Ein alleinstehendes C-Programm triggerte den Fehler nicht, das Ganze hing an der Last des Prozesses. Mein Verdacht ging Richtung Runtime-Linker, aber das war noch eine Vermutung, kein Beweis.
Eine ehrliche Selbstkorrektur
Zwischendurch hatte ich mich verrannt und einen Stack-Underflow zu bestimmt behauptet. Ein zweiter, kritischer Blick von außen und ein eigener Read der Quelle korrigierten das: execvPe selbst verbraucht deutlich weniger als 4 KB, und absolute Kommandos laufen auch durch execvPe und crashen trotzdem nicht. Der Unterschied liegt also nicht in einem bewiesenen Overflow in execvPe, sondern im no-slash-Zweig der PATH-Suche. Ich habe das im Report deshalb als Lokalisierung formuliert, nicht als bewiesenen Mechanismus.
Dazu gehört auch das ehrliche Eingeständnis, dass alle meine früheren php-src-Hypothesen falsch waren: die Property Hooks, der vermeintliche Use-after-Free auf Klassen-Konstanten, die interned-String-Korruption, die pgsql-Verdächtigungen. Das war alles die wandernde Fault-Site, das Spätsymptom, nie die Ursache. Wer wochenlang das Symptom seziert, baut sich überzeugende Theorien über das Symptom. Das gehört in so einen Bericht hinein, nicht wegretuschiert.
Der Bugreport ans FreeBSD-Basissystem
Mit dieser Lokalisierung habe ich den Bug im FreeBSD-Basissystem eingereicht: Bug 295991. Das php-src-Issue GH-21995 habe ich als kein php-src-Bug geschlossen und beide Seiten miteinander verlinkt.
Wichtig war mir die Abgrenzung zu FreeBSD-SA-20:18 beziehungsweise CVE-2020-7458 von 2020. Das war der Long-PATH-Overflow an genau dieser Code-Stelle, längst behoben. Mein Fall ist die gleiche Gegend im Code, aber unabhängig von der PATH-Länge. Es ist bewusst keine Sicherheitsgeschichte, sondern ein Stabilitätsproblem, ausgelöst von völlig legitimem Code beim Aufräumen.
Praktischer Nebenbefund für alle, die sich an der Anubis-Sperre der FreeBSD-Bugzilla stören: den Status eines Bugs bekommt man ohne Browser bequem per REST:
Jetzt kam der Teil, für den sich die Mühe des sauberen Reports gelohnt hat. @bdrewery, FreeBSD-Committer, bestätigte und reproduzierte den Fehler noch bequemer als ich, direkt über den www/nextcloud-Port mit occ status in einer Schleife:
there is some random corruption that shows up with php on exit when loaded with many extensions. Raising the stack size in posix_spawn avoids the problem.
Zur Ehrlichkeit gehört der Seitenhieb, den ich mir dabei eingefangen habe: den Text meines Reports nannte er einen unreadable AI mess. Inhaltlich hat er den Fall getroffen, die Form hat genervt. Das war eine gute und verdiente Lektion über Report-Stil, auf die ich am Ende noch einmal zurückkomme.
@kevans hat den Mechanismus dann endgültig festgenagelt, und zwar an einer Stelle, an der ich nur einen Verdacht hatte. Nicht execvPe sprengt den Stack, sondern der Runtime-Linker beim Lazy-Binding der Symbole. Der Pfad ist _rtld_bind → find_symdef → symlook_default → donelist_init. Und donelist_init macht ein alloca, dessen Größe mit der Zahl der geladenen Shared Objects skaliert:
Genau deshalb triggern schwer gelinkte Prozesse den Fehler und Spielzeug-Programme nicht. obj_count ist bei PHP mit dem vollen Extension-Satz groß, das alloca entsprechend fett, und auf dem gut 4 KB kleinen Spawn-Stack ist dann Schluss. Das deckt sich exakt mit meiner rtld-Vermutung aus dem Report und erklärt auch das 17-Extensions-Minimum: unter einer gewissen Zahl geladener Objekte bleibt das alloca klein genug.
Der Fix
Der Fix kam von @kib als Diff D57908. Die erste Revision regressierte und ließ eine www/onlyoffice-Umgebung crashen, mit ld-elf.so.1-Faults in beam.smp und x2t. Das war ein Multithreading-Problem, das kib noch vor dem Commit behoben hat. Danach ging es nach main:
1e370f0 „rtld: stop using unbound alloca()“ vom 29. Juni 2026. Die alloca-Aufrufe in der DoneList und in map_object wandern in den Heap, sobald sie groß werden. Vermerk MFC after: 1 week.
3de9dc5 vom 30. Juni 2026. Ein libc-Regressionstest, der eine Dummy-Shared-Library mehrfach mappt und mit einer Guard-Page arbeitet, um den Underflow zuverlässig zu triggern.
Beim Schreiben dieses Beitrags steht der MFC nach stable/15 an. Für ein 15.1-RELEASE kommt der Fix mit einem der künftigen 15.x-Patches. Bis dahin ist der Workaround simpel: absolute Pfade in proc_open vermeiden den crashenden no-slash-Zweig. Das ist Symptombekämpfung, kein Fix. Und wer nur das volllaufende Dateisystem im Blick hat, räumt die harmlosen Cores einfach weg.
Warum am Ende alles zusammenpasst
Das Schöne an der Auflösung ist, dass sie jedes einzelne der vielen Rätsel erklärt, die mich wochenlang in die Irre geführt haben:
Nur proc_open crasht, weil es das einzige PHP-Konstrukt ist, das posix_spawnp nutzt.
Nur relative Kommandos crashen, weil nur sie die PATH-Suche und damit das Lazy-Binding im Kind auslösen.
Nur FreeBSD auf amd64, weil der rfork_thread-Pfad mit dem kleinen malloc-Stack amd64- und i386-spezifisch ist.
ASAN und Valgrind sauber auf Linux, weil glibc posix_spawn ganz anders baut.
Der volle Extension-Satz nötig, weil viele Shared Objects das alloca im rtld erst groß genug für den Überlauf machen. Und die vielen permanenten interned Strings legen zusätzlich die späteren Opfer genau unter den Spawn-Puffer.
Zur Methode, und zum Report-Stil
Zwei Dinge nehme ich technisch mit. Erstens: eine Heap-Korruption mit wanderndem Opfer fängt man nicht mit einzelnen Watchpoints, weil das Beobachten das Layout verschiebt und damit das Opfer. Was funktioniert, sind layout-robuste Tabellen-Diffs an definierten Checkpoints. Nicht ein Objekt anstarren, sondern die ganze Region vorher und nachher vergleichen. Zweitens: ein LD_PRELOAD-Interposer mit Guard-Page ist ein billiges, definitives Ja-oder-Nein-Experiment für die Frage, ob ein Stack-Overflow vorliegt. Ein sauberes Experiment schlägt zehn plausible Theorien.
Und dann die Lektion, die mir @bdrewery verpasst hat. Ein Bugreport, der die ganze Hypothesenkette in den Body kippt, ist für den Leser eine Zumutung, egal wie korrekt die Analyse ist. Die richtige Form sind drei bis vier Sätze Kern ganz oben, das reproduzierbare Minimal-Beispiel gleich dahinter, und der ganze Ermittlungskrimi darunter für die, die ihn brauchen. Der Inhalt hat gestimmt, deshalb wurde der Bug gefixt. Aber die Form hätte den Committern viel Zeit gespart. Nächstes Mal Kern zuerst.
Ähnliche Geschichte im Notebook, im Basissystem festgefahren, oder einfach eine Meinung zum Report-Stil? Dann einfach fragen.
Ein einzelner ZFS-Pool aus zwei 7200-rpm-Platten war durch Metadaten-Random-I/O ausgebremst. Lösung ganz ohne Neuaufbau: die vorhandenen SSDs zu einem gespiegelten special vdev für Metadaten plus gespiegeltem SLOG umgebaut, zwei zpool add-Befehle im laufenden Betrieb. Resultat: Metadaten-Leselatenz von rund 46 ms auf rund 455 µs, also etwa Faktor hundert, bei voll erhaltener Verschlüsselung und Redundanz.
Drehende Platten sind ein ehrliches Stück Technik. Sie speichern viele Terabyte für wenig Geld und liefern bei sequenziellem Zugriff ordentlichen Durchsatz. Ihre Achillesferse ist der zufällige Zugriff auf viele kleine Blöcke, denn jede Kopfbewegung kostet Latenz im zweistelligen Millisekundenbereich aus Seek und Rotationswartezeit. Und genau dieses ungünstigste Muster produziert ein Copy-on-Write-Dateisystem wie ZFS am laufenden Band: Metadaten. Verzeichnis-ZAPs, dnodes, indirekte Blöcke, also die Block-Pointer-Bäume, dazu Spacemaps. Jedes ls, jedes stat, jeder Snapshot-Vergleich, jeder Scrub und jede find-Traversierung wühlt sich durch viele kleine, über die ganze Platte verstreute Metadatenblöcke. Auf einer HDD ist das der teuerste Spaß, den man haben kann.
Ich hatte genau diesen Schmerz auf einem dedizierten Server: ein bewusst simpel gehaltener ZFS-Pool, zwei Enterprise-SATA-Platten im Mirror als Kapazitätsspeicher, und ein nagender Verdacht, dass die Spindeln der Flaschenhals sind. Die spannende Frage war nicht, ob man das beheben kann, sondern wie elegant. Die Antwort heißt allocation classes, konkret ein special vdev. Und das Schöne daran: Der Umbau lief komplett im laufenden Betrieb, ohne den Pool neu aufzubauen, ohne Downtime, mit zwei Befehlen. Dieser Beitrag zeigt den ganzen Weg, inklusive der Baseline-Messung, die den Engpass erst beweist, eines Verschlüsselungs-Stolpersteins beim Umbau und der ehrlichen Frage, was so ein special vdev wirklich bringt.
Die Ausgangslage
Der Server läuft auf FreeBSD 15.1-RELEASE (amd64, 12 CPU-Threads, 64 GiB RAM). Ein einziger ZFS-Pool, 2023 ganz bewusst als schlichter Mirror angelegt:
Das Daten-vdev sind zwei 7200-rpm-Enterprise-SATA-Platten mit je 2 TB als Mirror (mirror-0, rund 1,8 TiB nutzbar), der eigentliche Kapazitätsspeicher.
Dazu zwei Datacenter-SATA-SSDs mit je 240 GB und Power-Loss-Protection. Die waren vorher suboptimal genutzt: eine als einzelner, nicht gespiegelter SLOG, die andere als L2ARC.
ARC-Limit anfangs 16 GiB, poolweit compression=lz4 und atime=off von Anfang an.
ashift=12 erzwungen über vfs.zfs.vdev.min_auto_ashift=12, also 4K-Sektor-Alignment, korrekt auch dann, wenn die Platten brav 512-Byte-Sektoren melden.
Die Power-Loss-Protection der SSDs ist kein Detail am Rande, sondern später für die SLOG-Sicherheit relevant: Eine SSD ohne Pufferschutz darf bei einem synchronen Write nicht behaupten, die Daten lägen sicher, solange sie noch im flüchtigen Cache stehen. Datacenter-SSDs mit Kondensator-gestütztem Cache dürfen das, und genau das braucht ein SLOG.
Erst messen, dann bauen
Bevor ich auch nur eine Partition angefasst habe, kam die wichtigste Phase: messen. Ohne Baseline kauft man Hardware nach Bauchgefühl und tunt am falschen Ende. Also lief ein eigener, delta-basierter Sampler über 30 Minuten, 90 Samples zu je 20 Sekunden. Er liest sysctl-Counter für CPU, ARC und Netz sowie iostat -x für die Platten-Busy und die Latenzen. Die wichtigste Spalte zur Einordnung der Last ist net-out, also der ausgehende Netzdurchsatz als Proxy dafür, was während des Laufs tatsächlich los war.
Das Ergebnis der Baseline (16 GiB ARC, alte SSD-Rollen) war eindeutig:
Der Flaschenhals ist der HDD-Mirror. Busy im Mittel 58 bis 62 %, Spitzen bis 100 bis 104 %, Latenz im Mittel rund 8 ms, unter Last bis 20 bis 24 ms. In 16 % der Samples war die HDD zu 95 % oder mehr ausgelastet, also gesättigt.
Die CPU war zu rund 95 % idle, RAM frei, der Netz-Peak lag bei rund 68 Mbit/s, also nur etwa 7 % des Gigabit-Links. Weder CPU noch RAM noch Netz waren das Limit.
Der ARC klebte an seinem 16-GiB-Limit (Mittel 15,7 GiB) bei einer Hit-Rate von rund 94,7 %. Der ARC war schlicht ausgehungert und hätte mehr RAM sofort genutzt.
Der einzelne SLOG lief bei rund 42 % Busy, war also nicht gesättigt. Die Spindeln waren das Limit, nicht der SLOG.
Das ist die didaktische Pointe, die ich jedem ans Herz lege: Ohne diese Messung wüsste ich nicht, ob CPU, RAM, Netz oder Platten klemmen, und ich wüsste nicht, ob das Problem auf der Lese- oder der Schreibseite liegt. Messen ist kein Nice-to-have, sondern die Voraussetzung dafür, das richtige Bauteil zu kaufen und am richtigen Hebel zu drehen.
Was ein special vdev ist, und warum nicht einfach All-SSD
Allocation classes sind ein OpenZFS-Feature (feature@allocation_classes), mit dem ein Pool mehrere Klassen von vdevs führen kann. Das special vdev ist die Klasse für Metadaten: ZFS legt dnodes, indirekte Blöcke und poolweite Metadaten bevorzugt dort ab statt auf dem normalen Daten-vdev. Über die Dataset-Property special_small_blocks kann man zusätzlich kleine Datenblöcke unterhalb einer einstellbaren Schwelle aufs special vdev ziehen. Im Kern verschiebt man also genau die Datenklasse, die eine HDD am schlechtesten beherrscht, auf ein Medium, das genau dafür gebaut ist.
Dass das hier der richtige Hebel ist, ist nicht geraten, sondern messbar: Der ARC dieses Servers besteht zu rund 85 % aus Metadaten, konkret 17,4 GB Metadaten gegenüber 3,0 GB Daten im ARC. Der Workload ist also metadaten-dominiert. Metadaten auf SSD zu verlagern trifft den Engpass damit an der Wurzel, denn das ist exakt der Random-I/O, an dem die Platten am meisten leiden. Bevor ich mich für das special vdev entschieden habe, standen aber andere Optionen auf dem Tisch:
Kompletter All-SSD-Pool aus zwei großen SSDs: der sauberste Komplettfix, aber teuer und ein großer Umbau mit Pool-Neuaufbau und vollständiger Datenmigration. Overkill, wenn der Großteil der Kapazität aus kalten, überwiegend sequenziell gelesenen Daten besteht.
Mehr RAM und ARC: hilft nur der Leseseite und nur, solange der Working Set in den ARC passt. Schreib-Metadaten müssen trotzdem auf stabilen Speicher, daran ändert RAM nichts.
L2ARC behalten: abgeschafft. Bei 24 GiB ARC lag die Lese-Hit-Rate schon bei rund 98,5 %. Der L2ARC brachte nur rund 1,3 % zusätzliche Reads, ist flüchtig (nach einem Reboot leer) und kostet sogar ARC-RAM für seine Header. Das Kosten-Nutzen-Verhältnis war negativ.
special vdev: die gewählte Lösung. Nutzt die vorhandenen SSDs, kein Pool-Neuaufbau, adressiert exakt den gemessenen Metadaten-Schmerz, inkrementell und live im Betrieb machbar.
Der Umbau Schritt für Schritt
Aus dem alten Zustand mit einem einzelnen SLOG und einem L2ARC sollte ein SLOG-Mirror plus ein special-vdev-Mirror werden. Beide SSDs werden also jeweils zur Hälfte für beide Zwecke genutzt, jeweils gespiegelt. Zuerst die alten Single-Rollen entfernen:
zpool remove zroot ada3p1     # alter L2ARC
zpool remove zroot ada2p1     # alter (einzelner) SLOG
Und hier kam der erste Stolperstein, der so lehrreich ist, dass er einen eigenen Absatz verdient. Das SLOG-Remove schlug zunächst fehl:
cannot remove ada2p1: Mount encrypted datasets to replay logs
Die Ursache: Es existierten verschlüsselte Datasets, deren Keys in diesem Boot nie geladen waren. Der SLOG lässt sich nicht entfernen, solange potenziell noch nicht abgespielte ZIL-Einträge für gesperrte Datasets vorliegen, denn ZFS müsste diese Einträge zum Replay erst entsperren. Erst nach dem Aufräumen und Entsperren ließ sich der SLOG sauber entfernen. Das ist gleichzeitig die perfekte Überleitung zum Verschlüsselungskapitel weiter unten, denn es zeigt, wie tief native ZFS-Encryption in den ZIL-Pfad eingreift.
Danach die SSDs neu partitionieren, sauber 1-MiB-aligned. Pro SSD wird p1 16 GiB groß (SLOG) und p2 rund 208 GiB (special). Das Ergebnis von gpart show ada2 ada3:
Beide Befehle bewusst ohne -f. So bleibt der Redundanz-Schutz von ZFS als Sicherheitsnetz aktiv: ZFS verweigert ein nicht-redundantes special oder log neben einem Mirror, solange man es nicht ausdrücklich erzwingt. Und genau dieses Verweigern ist hier gewollt.
Die wichtigste Warnung dieses Beitrags: Ein special vdev ist nicht optional für die Pool-Integrität. Verliert man ein nicht gespiegeltes special vdev, ist der gesamte Pool verloren, denn die Metadaten liegen dort, und ohne sie ist der Rest unlesbar. Das special vdev muss mindestens so redundant sein wie das Daten-vdev, hier also als Mirror. Für den SLOG gilt das in dieser Schärfe nicht, ein verlorener SLOG kostet nur die letzten Sekunden async-bestätigter sync-Writes, aber ein SLOG-Mirror verhindert, dass ein einzelner SSD-Ausfall den ZIL-Schutz aushebelt.
Das fertige Layout sieht in zpool status und zpool list -v dann so aus:
Zum SLOG-Sizing noch ein Wort, weil es oft falsch gemacht wird. Der SLOG puffert nur die dirty data eines, maximal zweier txg-Flush-Intervalle. Bei vfs.zfs.dirty_data_max = 4 GiB reichen 16 GiB SLOG mit großzügigem Polster, mehr bringt schlicht nichts. Genauso wichtig: Der SLOG beschleunigt nichts direkt. Er ist nur ein schnelles, stromausfallsicheres Zwischenlager für den ZIL, greift ausschließlich bei synchronen Writes (fsync oder O_SYNC) und wird im Normalbetrieb nie gelesen, sondern erst nach einem Crash zum Replay. Wer das verwechselt, sollte sich die Trennung einprägen: Der ZIL ist immer da, das ist das Konzept. Der SLOG ist nur ein optionales separates Gerät dafür.
Die unbequeme Wahrheit: nur neue Metadaten wandern
Hier muss ich ehrlich sein, denn es ist der am häufigsten missverstandene Punkt. Ein special vdev migriert keine bestehenden Metadaten. Es nimmt nur auf, was nach dem Hinzufügen geschrieben wird. Alte Metadaten bleiben auf der HDD liegen, bis sie durch Copy-on-Write ohnehin neu geschrieben werden. Der volle Effekt entsteht also erst über die Zeit oder durch einen optionalen zfs send | zfs recv-Rebuild der großen Datasets. Kein Sofort-magisch-alles-schneller, sondern ein Mechanismus, der sich befüllt. Dass er sich befüllt, sieht man an der Belegung, die mit jedem neuen Metadaten-Write wächst:
special mirror-3 206G alloc 5.38G free 201G FRAG 27% CAP 2.60%
Die Messung danach, und wie man sie ehrlich liest
Jetzt kommt der Teil, an dem viele Tuning-Berichte unsauber werden, weil sie einen Vorher-Nachher-Durchsatz behaupten, der unter unterschiedlicher Last gemessen wurde und damit nichts beweist. Ich gehe einen anderen Weg und zeige die Wirkung über drei Argumente, von denen zwei komplett lastunabhängig sind.
Erstens der Latenz-Split pro vdev, das stärkste und lastunabhängige Argument. zpool iostat -lv zeigt die Latenzen getrennt pro vdev. Die folgende Tabelle sind seit-Boot-kumulierte Mittelwerte, also langzeit-repräsentativ und kein zufälliger Augenblick:
Die Kernaussage steht in zwei Zahlen: Metadaten-Leselatenz 455 µs auf der special-SSD gegen 46 ms auf der HDD, das ist etwa Faktor hundert. Jeder Metadaten-Zugriff, der nicht ohnehin aus dem RAM bedient wird, ist seitdem rund hundertmal schneller. Zu den -l-Spalten kurz: total_wait ist die Gesamtwartezeit inklusive Queue, disk_wait die reine Gerätelatenz, syncq_wait und asyncq_wait die Zeit in den ZFS-internen Queues. Wer ein echtes Zeitfenster statt des Boot-Mittels sehen will, nimmt zpool iostat -lv zroot 10 2 und liest das zweite Sample, denn das erste ist immer der Seit-Boot-Durchschnitt.
Zweitens die ARC-Metadaten-Aufteilung, also die Struktur des Workloads. Sie erklärt, warum es gerade hier so viel bringt:
arcstats.metadata_size          = 17.4 GB     # rund 85 % des ARC sind Metadaten
arcstats.data_size              =  3.0 GB
arcstats.demand_metadata_hits   = 1,133,349,218
arcstats.demand_metadata_misses =    11,594,376   # müssen auf Platte ... jetzt SSD
arcstats.demand_data_hits       =   220,864,693
arcstats.demand_data_misses     =       672,908
Der Workload ist metadaten-dominiert. Die Lifetime-ARC-Hit-Rate liegt bei rund 98,9 %, aber die über 11,5 Millionen Metadaten-Misses müssen zwangsläufig auf Platte, und sie landen jetzt auf SSD statt auf HDD. Hier multipliziert sich der Faktor-hundert-Latenzvorteil mit der schieren Menge an Metadaten-Operationen. Das ist die quantitative Begründung dafür, warum ausgerechnet ein special vdev der wirksamste Hebel war und nicht etwa nur mehr ARC. Begleitend habe ich das ARC-Limit von 16 auf 24 GiB angehoben, weil RAM frei war. Die Folge war eine Hit-Rate von rund 95 % auf rund 99 %. Zwei Hebel, die zusammenwirken: weniger Misses überhaupt, und die verbliebenen sind jetzt SSD-schnell.
Das Herzstück: die 8,5-MB/s-Rechnung
Drittens, und das ist der eigentliche Aha-Moment, eine logische Schlussfolgerung statt eines Durchsatz-Vergleichs. Die Ausgangsmessung lief unter einer ganz konkreten Last: Ein Client lud zeitgleich größere Dateien herunter, ein klassischer Datei-Download. Der Netzdurchsatz dabei lag bei rund 68 Mbit/s, also etwa 8,5 MB/s. Und genau hier wird es interessant.
Eine einzelne 7200-rpm-HDD liefert sequenziell 150 bis 200 MB/s. Ein Download mit 8,5 MB/s ist also kaum 5 % dessen, was eine Platte im Schlaf kann, und hier zogen sogar zwei davon im Mirror mit. Trotzdem zeigte die Messung, dass der HDD-Mirror im Mittel rund 60 % ausgelastet war und in 16 % der Messintervalle voll gesättigt (95 % Busy oder mehr), mit Latenzen bis 20 bis 24 ms.
Das ist ein Widerspruch, und der Widerspruch ist der Beweis. Für sequenzielle 8,5 MB/s darf eine HDD niemals an die Sättigung kommen. Wenn sie es doch tut, dann waren diese Zugriffe nicht sequenziell, sondern seek-gebunden. Die Köpfe wurden permanent quer über die Platte gerissen. Wofür? Für das, was dieses System zu rund 85 % beschäftigt: Metadaten-Random-I/O, also dnodes, indirekte Blöcke und Verzeichnis-Lookups, die sich auf denselben zwei Spindeln mit dem Download um die Köpfe prügelten, verschärft durch die damals hohe Fragmentierung. Ein eigentlich harmloser Download zerfiel so in ein Seek-Gewitter.
Genau diese Konkurrenz wurde mit dem special vdev eliminiert. Die Metadaten-Zugriffe laufen jetzt auf den SSDs mit rund 455 µs statt zig Millisekunden. Die HDD-Köpfe können auf dem Datenstrom bleiben, statt ständig für Metadaten wegzuspringen. Derselbe Download belastet die Spindeln damit nur noch einen Bruchteil. Nicht, weil die Dateidaten schneller kämen, die liegen weiter auf HDD, sondern weil der Lärm daneben weg ist. Diese Schlussfolgerung steht ohne erfundenen Vergleich, sie ist wasserdicht: 8,5 MB/s sättigt physikalisch keine HDD, also waren es Seeks, also Metadaten-Kontention, und genau die habe ich verlagert.
Wie sich der Pool im ruhigen Normalbetrieb anfühlt, zeigt eine zweite, entspannte Momentaufnahme. Sie ist ausdrücklich kein Vorher-Nachher-Vergleich, sondern nur ein Blick auf den Alltag:
CPU idle 96.9 %   ARC hit 99.7 %   ARC 23.3 GiB
HDD busy ~2 %     HDD-Sättigung 0 %   HDD-Latenz ~1.5 ms
SSD busy 4.3 % / 4.5 % (gleichmäßig über beide Mirror-Member)
net-out-Peak 2.0 Mbit/s
Im ruhigen Normalbetrieb langweilt sich der HDD-Mirror, fast alle Reads kommen aus ARC oder SSD. Das illustriert den Alltag. Die eigentliche Wirkung des Umbaus zeigen aber die 8,5-MB/s-Rechnung oben sowie der Latenz-Split und die ARC-Aufteilung, und die gelten unabhängig von der Last.
Sicherheit und Verschlüsselung, die entscheidende Nuance
Die wichtigen Datasets dieses Systems sind nativ mit ZFS verschlüsselt (encryption = aes-256-gcm), die System- und Boot-Datasets nicht. Sobald man ein special vdev einführt, stellt sich sofort die sicherheitskritische Frage: Landet jetzt unverschlüsselter Klartext auf den SSDs, nur weil dort die Metadaten liegen? Die Antwort ist ein klares Nein, und die Begründung ist wichtig genug, um sie sauber auszuführen.
ZFS native encryption verschlüsselt Dateiinhalte und die sensiblen Objekt-Metadaten, also Dateinamen, Verzeichnisstruktur, dnodes, Attribute und ACLs. Diese Blöcke sind bereits Ciphertext, bevor der Allocator überhaupt entscheidet, auf welches vdev sie wandern. Ein special vdev ist nur ein anderer Ablageort und ändert an der Verschlüsselung nichts. Verschlüsselte Metadaten bleiben auf der special-SSD verschlüsselt.
Was ZFS-Encryption ohnehin nicht verbirgt, special vdev hin oder her, sind die Metadaten auf Pool- und Dataset-Ebene: Dataset-Namen, Pool-Struktur, Anzahl und Größe von Snapshots, die Blockpointer-Struktur. Das ist eine Eigenschaft von ZFS-Encryption und keine neue Schwäche durch das special vdev.
aes-256-gcm ist authenticated encryption (AEAD), liefert also Vertraulichkeit und gleichzeitig Integritäts- und Authentizitätsschutz der verschlüsselten Blöcke.
Ein schöner Praxisbezug schließt sich hier zum Umbau-Kapitel: Genau weil verschlüsselte Datasets im Spiel sind, blockierte das zpool remove mit der Meldung über das Mounten verschlüsselter Datasets zum Replay. Das zeigt anschaulich, wie tief Encryption in den ZIL- und SLOG-Pfad eingreift, denn der ZIL kann Einträge für verschlüsselte Datasets enthalten, die sich nur nach dem Entsperren abspielen lassen. Das Fazit zur Sicherheit ist damit eindeutig: Ein special vdev ist verschlüsselungs-neutral. Wer verschlüsselte Datasets nutzt, bekommt verschlüsselte Metadaten auf der special-SSD, kein Klartext-Leak.
Abwägung: Vorteile, Nachteile, Risiken
Was unterm Strich für das special vdev spricht:
Es adressiert den gemessenen Engpass, Metadaten-Random-I/O, direkt an der Wurzel.
Es nutzt vorhandene SSDs, also keine Neuanschaffung, kein Pool-Neuaufbau, live im laufenden Betrieb hinzugefügt.
Rund hundertfach niedrigere Metadaten-Leselatenz (455 µs gegen 46 ms), spürbar bei ls, stat, find, Snapshots, Scrub und allen Workloads mit vielen kleinen Dateien.
Über special_small_blocks später fein justierbar, um kleine Datenblöcke nachzuziehen, ohne Downtime und nur für neue Writes.
Verschlüsselungs-neutral.
Der I/O verteilt sich jetzt gleichmäßig über beide Mirror-Member. Vorher lag eine SSD als einzelner SLOG bei rund 42 % Busy, die andere als L2ARC quasi brach.
Und ehrlich auch die andere Seite, denn ein special vdev ist kein Selbstläufer:
Redundanz ist Pflicht, nicht Kür. Ein nicht-redundantes special vdev bedeutet Totalverlust des Pools bei SSD-Ausfall. Mirror ist zwingend.
Keine Migration bestehender Metadaten. Nur neue Writes wandern, der volle Effekt kommt erst per send und recv-Rebuild.
Das special vdev kann volllaufen. Ist es voll, fallen neue Metadaten auf das langsame Daten-vdev zurück. Das ist kein Fehler, aber der Effekt lässt nach, also Füllgrad mit zpool list -v überwachen.
special_small_blocks zu hoch gesetzt verstopft das special vdev mit Datenblöcken und lässt es schneller volllaufen. Vorsichtig hochtasten (von 0 über 4K und 8K bis vielleicht 32K) und dabei den Füllgrad beobachten.
Mehr vdevs bedeuten mehr Komplexität und mehr Teile, die ausfallen können. Den SSD-Wear im Blick behalten, hier bewusst Datacenter-SSDs mit Power-Loss-Protection gewählt, weil sie Dauerlast und sync-Writes aushalten.
Der zpool remove-Stolperstein mit verschlüsselten Datasets gehört dokumentiert, damit man im Ernstfall nicht in Panik gerät.
Die eigentliche Botschaft
ZFS erlaubt es, die Storage-Architektur inkrementell und im laufenden Betrieb an einen gemessenen Engpass anzupassen, ohne Pool-Neuaufbau, ohne Downtime, ohne Datenmigration als Vorbedingung. Aus einem simplen HDD-Mirror wurde durch zwei zpool add-Befehle ein hybrider, mehrstufiger Pool: kalte Massendaten auf günstigen Spindeln, heiße Metadaten und optional kleine Blöcke auf schnellen SSDs, synchrone Writes über einen gespiegelten SLOG. Diese Flexibilität, tiered storage als Live-Operation, kombiniert mit Checksumming, Compression, Snapshots und nativer Verschlüsselung im selben Dateisystem, ist der eigentliche Kern. Man kauft sich SSD-Speed genau dort, wo die Messung den Schmerz zeigt, und lässt den Rest günstig auf HDD. Kein anderes verbreitetes Dateisystem macht das so geradlinig.
Ausblick
special_small_blocks schrittweise anheben, um kleine Dateien und nicht nur Metadaten auf SSD zu ziehen, live und nur für neue Writes.
Ein optionaler send und recv-Rebuild der großen Datasets, um bestehende Metadaten auf das special vdev zu migrieren und so den vollen Effekt zu heben.
Eine lastgleiche Wiederholungsmessung in einem Hochlast-Fenster für eine saubere Zahl auf der Schreibseite.
Spickzettel
Die Befehle, mit denen man Layout, Latenzen und ARC-Komposition selbst nachsieht:
# Pool-Layout und Auslastung pro vdev
zpool status zroot
zpool list -v zroot

# Latenzen pro vdev (das Geld-Kommando), 2. Sample lesen für ein echtes Zeitfenster:
zpool iostat -lv zroot 10 2

# ARC: Größe und Metadaten/Daten-Split plus Demand-Hits und -Misses
sysctl kstat.zfs.misc.arcstats.size kstat.zfs.misc.arcstats.metadata_size kstat.zfs.misc.arcstats.data_size kstat.zfs.misc.arcstats.demand_metadata_hits kstat.zfs.misc.arcstats.demand_metadata_misses

# allocation_classes-Feature und special_small_blocks
zpool get feature@allocation_classes zroot
zfs get special_small_blocks zroot

# Verschlüsselungs-Status der Datasets
zfs get encryption,keystatus DATASET

# SSD-Partitionierung
gpart show ada2 ada3

# SLOG-Sizing-Kontext
sysctl vfs.zfs.dirty_data_max

# Pool-Historie (zeigt die echten add/remove-Befehle)
zpool history zroot
Selbst einen HDD-Pool mit einem special vdev entschärft, oder noch am Abwägen, ob sich der Umbau lohnt? Erzähl mir gern von deinem Layout, oder stell deine fragen.