IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Kategorie: Kernel-Error-Blog (Seite 1 von 51)

Persönlicher Tech-Blog von Sebastian van de Meer — Beiträge zu IT-Security, Netzwerken, FreeBSD, Linux, Elektronik und Maker-Projekten.

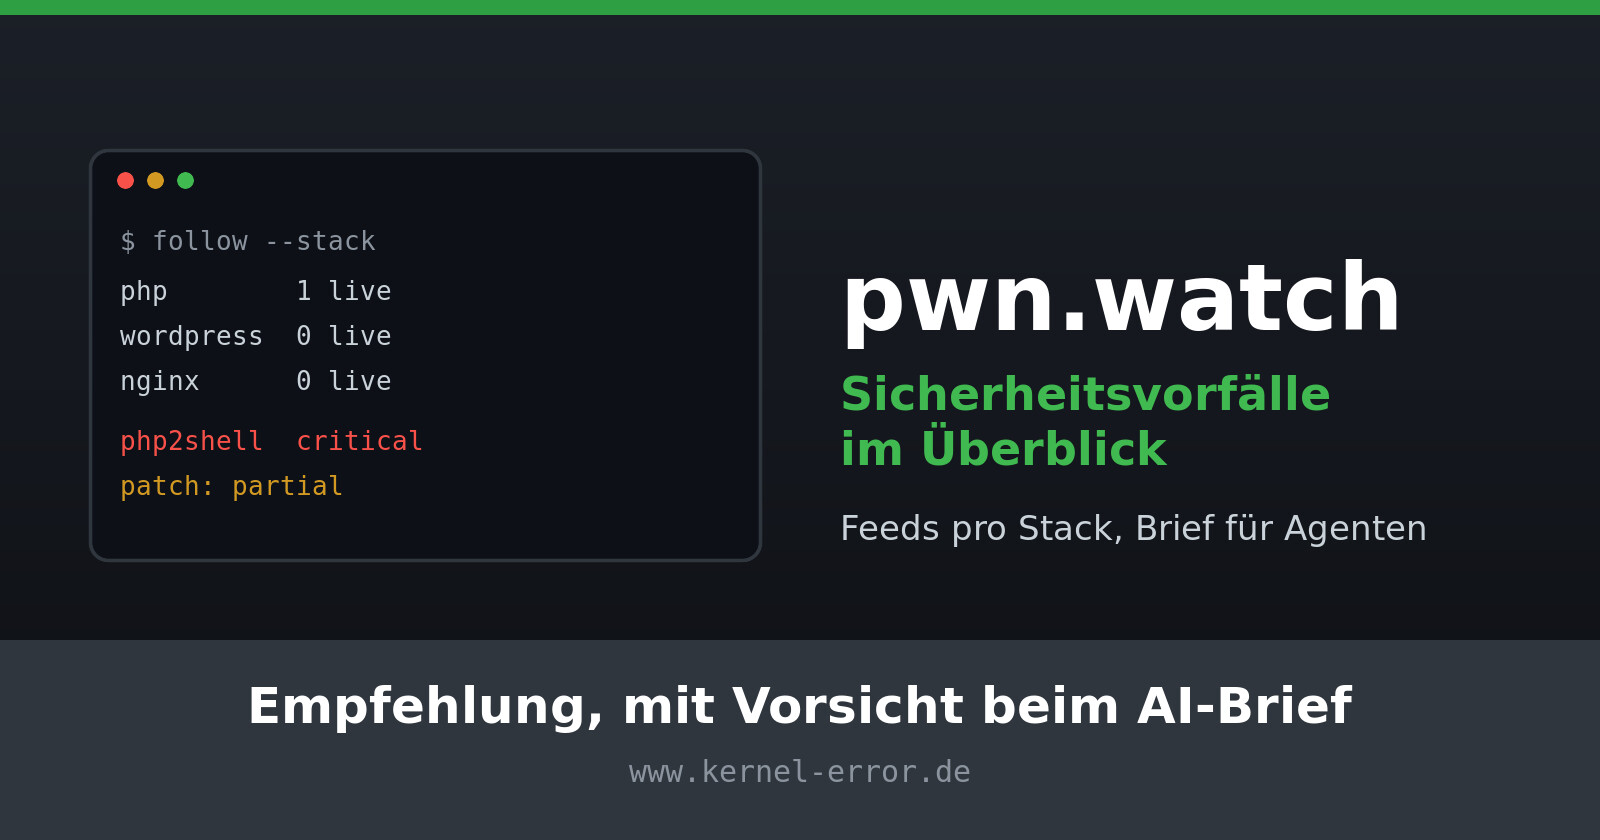
pwn.watch: Sicherheitsvorfälle im Überblick, mit Vorsicht beim Brief für die AI

Terminalfenster mit Feeds für php, wordpress und nginx und dem Vorfall php2shell, daneben der Schriftzug pwn.watch, Sicherheitsvorfälle im Überblick, darunter: Empfehlung, mit Vorsicht beim AI-Brief

Bei kritischen Lücken wie gerade bei php2shell ist die erste Meldung selten das Problem. Schwieriger sind die Tage danach: Welche Versionen sind wirklich repariert, wird die Lücke schon ausgenutzt, welcher Hersteller hat für seine Appliances schon Updates, und welche Meldung war doch nur ein Gerücht? Michael hat mir dafür pwn.watch empfohlen, und ich finde die Seite nützlich genug, um die Empfehlung hier weiterzugeben. Ein paar Punkte solltest du dabei aber im Hinterkopf behalten.

Was pwn.watch ist

pwn.watch sammelt aktuelle Sicherheitsvorfälle und teilt sie in drei Bereiche: Lücken in Software, die du selbst betreibst und patchen musst, Angriffe auf Firmen und Dienste, bei denen du höchstens Zugangsdaten tauschen kannst, und Supply-Chain-Vorfälle wie manipulierte Pakete. Hinter der Seite steht der Entwickler Kitze, finanziert wird sie über Sponsoren in der Seitenleiste.

Jeder Vorfall bekommt eine eigene Seite mit Patch-Status, betroffenen und reparierten Versionen, einer Zeitleiste und den Quellen dazu. Gerade die Zeitleiste macht den Unterschied zu einer einzelnen Nachrichtenmeldung. Beim Eintrag zu php2shell stehen zum Beispiel die ersten Ausnutzungsversuche, die laut AWS schon vor dem Release begannen, die Einschätzung von Sansec, dass die öffentlichen Exploits meist eine zusätzliche Lücke in der Anwendung brauchen, eine Regression in den neuen Versionen 8.4.27 und 8.5.12 und die Advisories der Hersteller von Appliances. Unbestätigte Behauptungen sind als solche markiert. Für so etwas hätte ich sonst ein Dutzend Tabs offen.

Nur das, was du auch betreibst

Am praktischsten finde ich die Feeds. Es gibt RSS und JSON nicht nur für alles, sondern auch pro Tag, also pro Hersteller, Produkt oder Plattform. Wer wie ich PHP, WordPress und nginx betreibt, abonniert einfach diese Feeds und bekommt nur noch die Vorfälle, die ihn auch betreffen:

https://pwn.watch/t/php/feed.xml
https://pwn.watch/t/wordpress/feed.xml
https://pwn.watch/t/nginx/feed.xml

Die Übersicht aller Tags findest du unter pwn.watch/tags. Für meinen Stack fehlen allerdings einige Dinge: Für FreeBSD, OpenSSL, Postfix oder Dovecot gibt es keinen eigenen Tag. Die Seite ersetzt deshalb weder die FreeBSD Security Advisories noch ein regelmäßiges pkg audit -F, sie ergänzt beides.

Der Button „Copy brief for your AI“

Auffällig ist der Button „Copy brief for your AI“ auf jeder Seite. Er erzeugt im Browser einen Markdown-Text und legt ihn in die Zwischenablage: was betroffen ist, welche Versionen repariert sind, ein paar Befehle zum Prüfen wie php -v oder nginx -v, Hinweise zum Patchen und die Links zu den Advisories. Den Text soll man direkt in einen Coding-Agenten wie Claude Code oder Cursor kopieren, der dann prüft, ob man betroffen ist, und im besten Fall gleich aktualisiert. Dazu gibt es eine llms.txt und die Daten jedes Vorfalls als JSON. Die Seite ist also ausdrücklich darauf ausgelegt, dass Agenten sie lesen.

Hier wäre ich vorsichtig. Die Prüfbefehle stammen aus einer festen Liste im Code der Seite und sind harmlos. Der Rest des Textes ist aber Freitext, den allein der Betreiber kontrolliert und der zum Teil aus Tweets und Artikeln zusammengetragen wird. Wenn du so etwas ungelesen an einen Agenten gibst, der Shell-Zugriff hat, vertraust du darauf, dass dieser Text nie manipuliert wird. Das ist genau der Weg, über den Prompt Injection funktioniert. Dazu kommt, dass der Brief nur den einfachen Teil abdeckt. Bei php2shell steht darin „upgrade to 8.3.36“. Die eigentliche Arbeit lag bei mir aber im Bauen aus den Ports, den Extensions und dem plötzlich falschen CA-Bundle. Das hätte kein Agent aus diesem Text gewusst. Nutz am besten die Vorschau neben dem Button und lies den Brief als Zusammenfassung, nicht als Arbeitsauftrag.

Mein Fazit

pwn.watch ist ein Ein-Personen-Projekt ohne Angaben dazu, wie die Daten gepflegt werden, und schreibt selbst, dass es keine Sicherheitsberatung ist und man vor dem Handeln das Advisory des Herstellers prüfen soll. So würde ich die Seite auch nutzen: als schnellen Überblick, als Sammlung der relevanten Quellen und als Feed für den eigenen Stack. Die Entscheidung, was auf dem eigenen Server passiert, nimmt sie dir nicht ab, und das sollte auch kein Agent für dich tun, der nur diesen Text kennt.

BIOS erklärt, Teil 11: VT-d, 102 IOMMU-Gruppen und ein Menü das falsch beschriftet ist

Wenn man einer virtuellen Maschine eine echte Grafikkarte geben will, stösst man ziemlich schnell auf einen Begriff, der wie eine Ausrede klingt: IOMMU-Gruppen. Man liest dann Sätze wie „deine Karte ist in derselben Gruppe wie der USB-Controller, also geht das nicht“, und wenn man Pech hat, findet man kurz darauf Anleitungen mit dem Wort „ACS-Override“ darin, die einem erklären wie man diese Regel umgeht und dabei die Isolation aushebelt.

Der Ursprung dieser ganzen Geschichte liegt in einem einzigen BIOS-Untermenü, und um das geht es heute. Teil 11 der Serie, alle Folgen unter BIOS & Firmware. Wir sind unter Advanced > Chipset Configuration > North Bridge > IIO Configuration, und diesmal in den Untermenüs statt auf der Übersicht.

VT-d, oder: wer darf in den Speicher schreiben

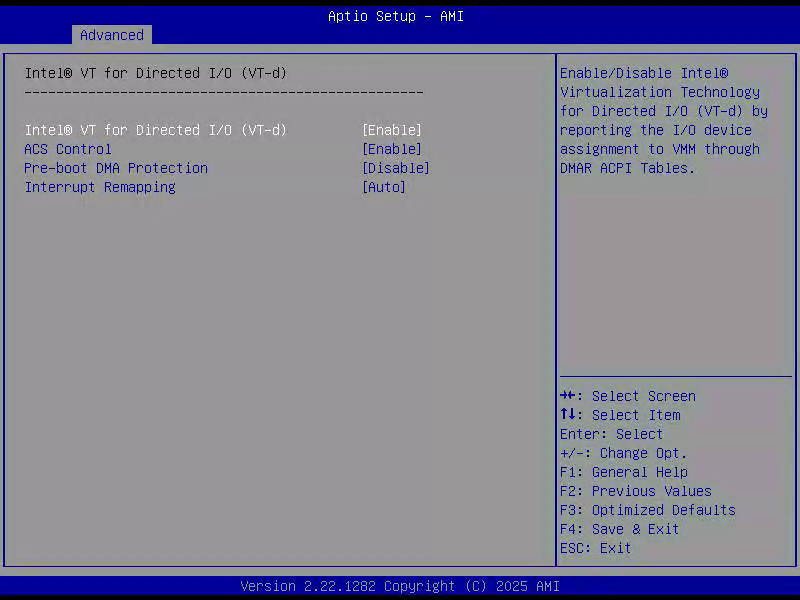
Aptio Setup, Intel VT for Directed I O, mit ACS Control, Pre-boot DMA Protection und Interrupt Remapping
Intel(R) VT for Directed I/O (VT-d)   [Enable]
ACS Control                           [Enable]
Pre-boot DMA Protection               [Disable]
Interrupt Remapping                   [Auto]

Das Grundproblem, das VT-d löst, ist älter als Virtualisierung. Eine PCIe-Karte darf per DMA selbständig in den Arbeitsspeicher schreiben, ohne die CPU zu fragen. Das ist der Grund, warum Netzwerkkarten und Laufwerke überhaupt schnell sind. Es bedeutet aber auch, dass eine Karte in jeden beliebigen Speicherbereich schreiben kann, sofern niemand sie daran hindert.

Die IOMMU ist dieser Jemand. Sie sitzt zwischen den Geräten und dem Speicher und übersetzt Adressen, genau wie die MMU es für Prozesse tut. Ein Gerät sieht dann nur noch den Speicher, der ihm zugewiesen wurde. Damit kann man einer virtuellen Maschine eine echte Karte geben, ohne dass diese Karte den Speicher des Wirtssystems lesen könnte.

Bei mir ist das aktiv, was man am Startprotokoll sieht:

dmesg | grep DMAR-IR
#   DMAR-IR: Enabled IRQ remapping in x2apic mode

Interrupt Remapping ist der zweite Teil derselben Absicherung. Interrupts sind auf modernen Systemen einfach Schreibzugriffe auf eine bestimmte Adresse. Ohne Umsetzung könnte ein Gerät damit Interrupts auslösen, die für andere gedacht sind. Die Umsetzung schiebt eine Tabelle dazwischen.

Nebenbei erklärt das eine Kuriosität aus Teil 4: dort stand ein Schalter namens Extended APIC auf Disable, und trotzdem läuft mein System im x2APIC-Modus. Der Grund steht in der Zeile oben. Der Kernel schaltet x2APIC selbst ein, sobald Interrupt Remapping läuft, weil er es dafür braucht. Die BIOS-Option entscheidet nur, ob die Firmware es vorab tut.

ACS, und die Sache mit den Gruppen

ACS Control [Enable] ist der Schalter, wegen dem ich diese Folge angefangen habe.

Access Control Services regeln, ob zwei Geräte hinter demselben Switch direkt miteinander reden dürfen, ohne dass der Verkehr über die IOMMU läuft. Ohne ACS kann die IOMMU nicht garantieren, dass zwei Geräte voneinander getrennt sind, und muss sie deshalb als eine Einheit behandeln. Das ist eine IOMMU-Gruppe: die kleinste Menge Geräte, die man nur gemeinsam durchreichen kann.

Bei mir sieht das ordentlich aus:

ls /sys/kernel/iommu_groups | wc -l
#   102

102 Gruppen, und die meisten enthalten genau ein Gerät. Das ist der Zustand, den man haben will, und man bekommt ihn nicht geschenkt. Auf typischen Consumer-Boards liegen regelmässig ein halbes Dutzend Geräte in einer Gruppe, weil der Chipsatz sie hinter einem Switch ohne ACS bündelt. Dann kommen die Anleitungen mit dem ACS-Override ins Spiel, und die tun genau das wonach sie klingen: sie lügen dem Kernel vor, es gäbe eine Trennung. Für ein Heimlabor mag das reichen. Es ist trotzdem das Abschalten einer Sicherheitsfunktion, und man sollte wissen dass man es tut.

Ein Beispiel aus meiner Maschine, das den Unterschied zeigt: als vorübergehend eine Beschleunigerkarte in Steckplatz 7 steckte, landete sie allein in Gruppe 6. Alleine in einer Gruppe heisst durchreichbar, ohne Tricks, ohne Override. Das war die Voraussetzung dafür, überhaupt darüber nachzudenken, sie einer virtuellen Maschine zu geben.

Pre-boot DMA Protection [Disable] schützt das Zeitfenster vor dem Betriebssystemstart. Der klassische Angriff dagegen läuft über Thunderbolt: Gerät anstecken während der Rechner im Setup steht, per DMA Speicher auslesen. Dieses Board hat kein Thunderbolt, und wer physisch am Gehäuse steht, hat ohnehin bessere Möglichkeiten. Aus ist hier vertretbar.

VMD, und warum es aus bleibt

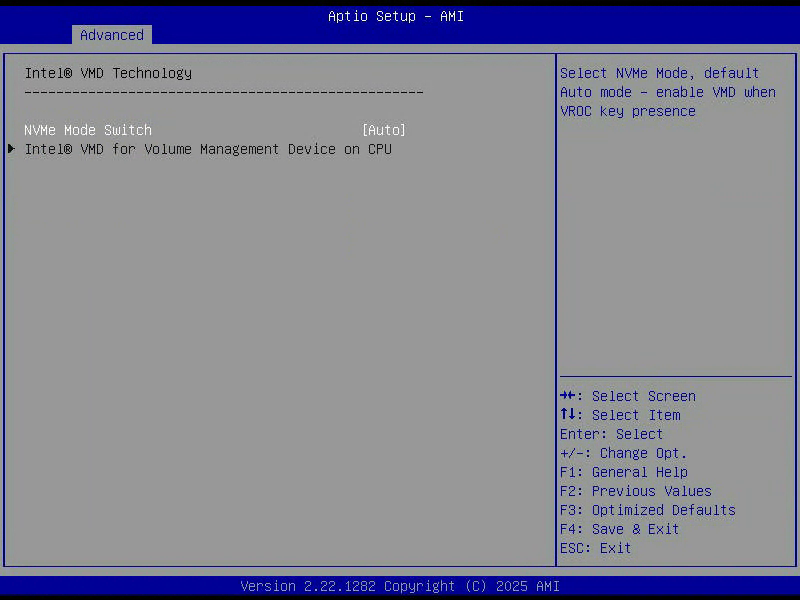
Aptio Setup, Intel VMD Technology, NVMe Mode Switch steht auf Auto
Intel(R) VMD Technology
NVMe Mode Switch                  [Auto]
> Intel(R) VMD for Volume Management Device on CPU

Volume Management Device ist eine Erfindung, die vor allem für vorkonfigurierte Server gedacht ist. Eingeschaltet fasst der Prozessor mehrere NVMe-Laufwerke zusammen und präsentiert sie nach aussen als ein einziges Gerät. Das ermöglicht Hot-Plug ohne Betriebssystemunterstützung und ist die Voraussetzung für Intels RAID-Lösung VROC.

Bei mir steht das auf Auto, und der Hilfetext im Setup sagt dazu wörtlich default Auto mode, enable VMD when VROC key presence. Also nur aktiv, wenn ein VROC-Lizenzschlüssel steckt. Es steckt keiner. Die Gegenprobe:

lspci -nn | grep -i "volume management"
#   (keine Ausgabe)

Nichts da, beide Laufwerke hängen direkt an ihren Root Ports.

Und dabei soll es bleiben. Mit eingeschaltetem VMD verschwinden meine NVMe-Laufwerke hinter einem Controller, brauchen einen zusätzlichen Treiber, und sind nicht mehr einzeln als PCIe-Geräte sichtbar. Damit wäre unter anderem das weg, was ich in Teil 10 gerade mühsam eingerichtet habe: die AER-Zähler pro Gerät. Ich tausche keine funktionierende Diagnose gegen ein RAID, das ich nicht will.

Der dritte Wert wäre Manual, und laut Handbuch erscheint erst dann das Untermenü, in dem sich VMD pro Stack einzeln einschalten lässt. Solange Auto steht, ist dort nichts zu holen, was erklärt warum ich es beim Durchklicken nie geöffnet habe.

Kleine Korrektur in eigener Sache: in meinen Notizen stand lange, VMD stünde auf Disabled. Der Schalter heisst tatsächlich NVMe Mode Switch und kennt Manual, VMD und Auto. Die Wirkung ist dieselbe, die Beschriftung war meine.

IOAT, das Menü das nicht hält was der Name verspricht

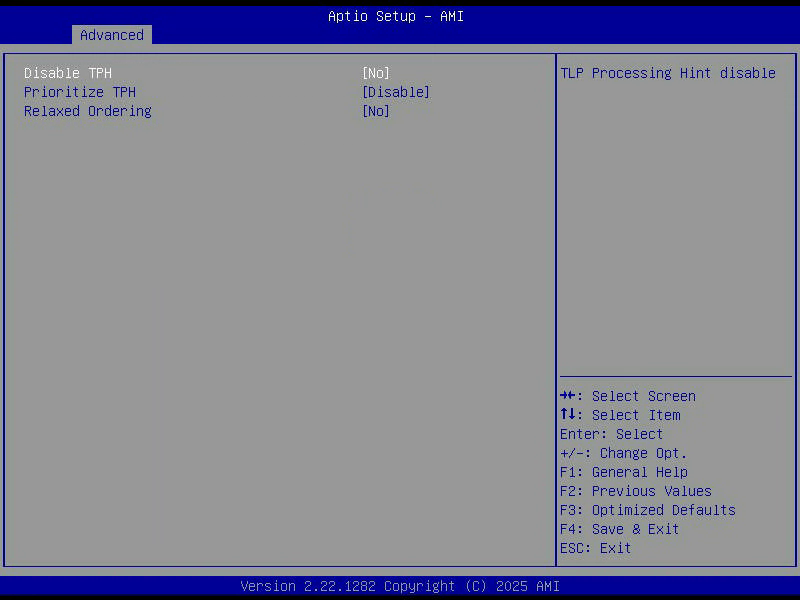
Aptio Setup, IOAT Configuration, mit Disable TPH, Prioritize TPH und Relaxed Ordering
IOAT Configuration
Disable TPH                       [No]
Prioritize TPH                    [Disable]
Relaxed Ordering                  [No]

Ich habe dieses Menü mit einer klaren Erwartung geöffnet. IOAT steht für I/O Acceleration Technology, dahinter stecken DMA-Engines im Prozessor, die Speicherkopien erledigen ohne die Kerne zu beschäftigen. Ich hatte mit Schaltern wie Enable IOAT und DCA gerechnet. Beide gibt es nicht.

Stattdessen stehen dort drei Optionen, die mit dem Namen des Menüs wenig zu tun haben. TPH ist TLP Processing Hint: ein PCIe-Gerät kann einem Schreibzugriff einen Hinweis mitgeben, wohin die Daten am besten sollen, etwa direkt in den Cache eines bestimmten Kerns statt in den Hauptspeicher. Für eine Netzwerkkarte, deren Pakete gleich darauf verarbeitet werden, spart das den Umweg.

Relaxed Ordering erlaubt es, Transaktionen in anderer Reihenfolge abzuarbeiten als sie eingetroffen sind. Das kann Durchsatz bringen und setzt voraus, dass die Beteiligten keine Annahmen über die Reihenfolge treffen. Standard ist deshalb No.

Die DMA-Engines selbst laufen übrigens, ganz ohne sichtbaren Schalter:

ls /sys/class/dma/
#   dma0chan0  dma1chan0  ...  dma7chan0

Acht Kanäle. Der Name des Menüs stimmt also, der Inhalt passt nur nicht dazu.

Das Ganze hat mir nebenbei einen Fehler in meiner eigenen Dokumentation gezeigt. In meiner ersten Aufzeichnung war ein Bildschirm mit genau diesen drei Zeilen, und ich hatte ihn als „Slot-Unterseite“ abgelegt, weil ich das Menü nicht geöffnet hatte und nur den Inhalt sah. Es war die IOAT-Seite. Ich hatte sie die ganze Zeit, nur unter dem falschen Namen.

Was ich davon tatsächlich nutze

Ehrlich? Von diesen vier Menüs nutze ich aktiv genau eines. VT-d ist an und tut seinen Dienst, die Isolation ist sauber, 102 Gruppen sprechen für sich. VMD ist aus und soll aus bleiben, IOAT läuft von selbst, und die TPH-Einstellungen fasse ich nicht an ohne eine Messung zu haben.

Trotzdem ist es eine der Seiten, die ich nach diesem Durchgang anders sehe. Vorher war „IOMMU“ für mich ein Wort aus Passthrough-Anleitungen. Jetzt weiss ich, welcher Schalter dafür verantwortlich ist, dass meine Gruppen sauber getrennt sind, und warum das auf anderen Boards oft nicht so ist.

Nächste Folge: Storage. AHCI, Hot Plug, elf SATA-Anschlüsse von denen keiner belegt ist, und eine Sicherheitsfunktion in Laufwerken, die meine beiden NVMe nicht können.

Siehe auch

Falls jemand von euch ACS-Override im Einsatz hat: aus Not oder bewusst? Und hat es je Ärger gemacht? Ihr dürft mich gerne fragen.

php2shell: PHP am Tag der Veröffentlichung aus den FreeBSD-Ports gepatcht

Warndreieck neben dem Schriftzug php2shell mit CVE-2026-109618 und CVE-2026-109619, reparierte Versionen 8.5.12, 8.4.27, 8.3.36 und 8.2.35, darunter: gepatcht, Blog wieder online

Wie im letzten Beitrag angekündigt, war mein Blog offline, bis das PHP-Update für die beiden kritischen Lücken auf dem Server eingespielt ist. Das ist inzwischen passiert, der Blog ist wieder erreichbar. Seit dem Nachmittag des 21. Oktober sind auch die technischen Details öffentlich, heise security hat sie im Artikel php2shell: Kritische Sicherheitslücken erlauben Codeeinschleusung in PHP zusammengefasst. In diesem Beitrag geht es weniger um die Lücken selbst als darum, wie ich PHP am Tag der Veröffentlichung auf FreeBSD gepatcht habe, über welche Fallen ich dabei gestolpert bin und wie ich geprüft habe, ob vorher schon jemand drin war.

Was hinter php2shell steckt

Unter dem Namen php2shell laufen zwei Fehler im Kern von PHP, beide mit CVSS 9.2 bewertet. CVE-2026-109618 steckt in der Speicherverwaltung. Läuft ein Skript in das eingestellte memory_limit, bricht PHP es ab und räumt danach auf. Mit einem passend gebauten Upload oder tief verschachtelten Arrays gerät genau dieses Aufräumen durcheinander, und am Ende kann ein Angreifer eigenen Code mit den Rechten des Webservers ausführen. CVE-2026-109619 sitzt in der Fehlerbehandlung. Hier bringt eine erste Anfrage PHP in einen kaputten Zustand, den eine zweite Anfrage an denselben Worker ausnutzt.

Die Anwendung selbst muss dafür keinen Fehler haben, und eine Anmeldung braucht der Angreifer auch nicht. Ein Angriff klappt zwar nicht beim ersten Versuch, nach einigen tausend bis zehntausend Anfragen aber zuverlässig. Für automatisierte Massenscans ist das kein Hindernis. Laut Wiz ist jede PHP-Version der letzten zehn Jahre von mindestens einer der beiden Lücken betroffen, das PHP-Team spricht sogar von allen Versionen seit PHP 5. Die reparierten Versionen sind 8.5.12, 8.4.27, 8.3.36 und 8.2.35.

Mein WordPress läuft mit PHP 8.3 als PHP-FPM hinter nginx, zum Zeitpunkt der Meldung in Version 8.3.33. pkg audit -F hat das Paket direkt für beide CVEs als verwundbar gemeldet. Laut Advisory ist Apache mit mod_php nachweislich per HTTP angreifbar, FPM gilt nach Analyse des Quellcodes ebenfalls als anfällig, auch wenn dafür noch kein vollständiger Exploit gezeigt wurde. Darauf wollte ich nicht wetten. Also habe ich nginx gestoppt, noch bevor es einen Patch gab. PHP-FPM lauscht bei mir nur auf einem Unix-Socket und ist ohne nginx davor von außen nicht erreichbar. Damit war die Angriffsfläche weg, ohne dass ich an PHP selbst etwas ändern musste.

Ports statt Paket

Der erste Reflex auf FreeBSD ist pkg upgrade. Nur lag im Paket-Repository auch nach pkg update -f noch PHP 8.3.35, und das ist verwundbar. Im Ports-Tree sah es anders aus: Der Commit lang/php83: Update version 8.3.35=>8.3.36 war wenige Minuten nach dem Upstream-Release in main und kurz darauf auch im Quartalszweig 2026Q4. Bis daraus ein Binärpaket im Repository wird, vergeht deutlich mehr Zeit. Wer einen Port sauber bauen kann, muss bei solchen Lücken also nicht warten.

Ist das wirklich der richtige Fix?

Dass ein Port eine neue Versionsnummer hat, heißt noch nicht, dass darin der richtige Fix steckt. Bevor ich gebaut habe, habe ich deshalb zwei Dinge geprüft. Erstens die Prüfsumme: Die SHA256-Summe von php-8.3.36.tar.xz aus der distinfo des Ports muss mit der Angabe auf php.net übereinstimmen.

cat /usr/ports/lang/php83/distinfo
curl -sS 'https://www.php.net/releases/index.php?json&version=8.3.36'

Beide Quellen nennen dd54693aa334c5c4d72e9aee96b082c2473750a18a6c1d105789c93a3b1692fd. Zweitens den Changelog: Der offizielle Changelog zu 8.3.36 enthält genau einen Eintrag, „Core: Fixed GHSA-w8hw-w9fx-j79w, GHSA-6wmf-4rv5-p3rp (Avoid state corruption via bailout)“. GHSA-w8hw-w9fx-j79w ist genau das Advisory, auf das auch heise verweist, und „Bailout“ ist der Abbruchpfad, den PHP bei einem Fatal Error nimmt. Das passt zu beiden Lücken. Die dritte Bestätigung kam nach der Installation: pkg audit -F meldet für PHP nichts mehr, die VuXML-Datenbank von FreeBSD stuft 8.3.36 also ebenfalls als repariert ein.

Bauen und tauschen

Vor dem Umbau habe ich einen ZFS-Snapshot der Jail angelegt, damit ich bei Problemen in Sekunden zurück kann. Danach ging es grob so weiter, hier vereinfacht ohne den jexec-Präfix:

# Rollback-Punkt
zfs snapshot zroot/jails/<jail>@pre-php2shell-$(date +%Y%m%d-%H%M)

# Ports-Tree auf denselben Zweig wie das Paket-Repository
cd /usr/ports && git fetch origin && git checkout 2026Q4 && git pull --ff-only

# Optionen gegen das installierte Paket abgleichen
pkg query '%Ok=%Ov' php83
make -C /usr/ports/lang/php83 showconfig

# Bauen, dann tauschen
make -C /usr/ports/lang/php83 -DBATCH clean build
make -C /usr/ports/lang/php83 -DBATCH deinstall install

Wichtig waren dabei die Extensions. Auf FreeBSD sind die PHP-Kern-Extensions eigene Pakete wie php83-mysqli, php83-curl oder php83-opcache. Technisch hätten die alten Extensions auch mit dem neuen Kern funktioniert, weil sich die Modul-API innerhalb von 8.3 nicht ändert. Der Sprung von 8.3.33 auf 8.3.36 enthält aber auch alle Korrekturen aus 8.3.34 und 8.3.35, und die stecken zu einem großen Teil in Extensions wie mysqlnd, openssl, phar, soap und filter. Nur den Kern zu tauschen hätte diese Lücken offen gelassen. Ich habe deshalb alle 43 Kern-Extensions aus demselben Tree neu gebaut. PECL-Extensions wie redis, APCu oder imagick haben eigene Versionsnummern und blieben, wie sie waren.

for o in $(pkg query -g '%o %v' 'php83-*' | awk '$2 ~ /^8\.3\.33/ {print $1}' | grep -v '^lang/php83$'); do
    make -C /usr/ports/$o -DBATCH clean build && make -C /usr/ports/$o -DBATCH deinstall install clean
done

Zum Schluss der Punkt, den man leicht vergisst: Ein neues Binary auf der Platte heißt nicht, dass der laufende Dienst es auch benutzt. PHP-FPM hatte noch das alte Programm im Speicher. Also neu starten und nachsehen, welches Binary der Prozess tatsächlich ausführt:

service php_fpm restart
procstat -b $(cat /var/run/php-fpm.pid)

Drei Stolperfallen

Ganz glatt lief es nicht. Die drei Probleme, die mir begegnet sind, dürften auch auf anderen Systemen auftauchen.

Build-Abhängigkeiten aus den Quellen. Der erste Versuch wollte cmake-core aus den Quellen bauen, eine reine Build-Abhängigkeit von re2c, und brach dabei ab. Solche Abhängigkeiten laufen nur während des Bauens und müssen nicht gepatcht sein. Mit make missing sieht man, was fehlt, und kann es einfach als Binärpaket per pkg install nachziehen.

deinstall install entfernt das PHP, das der Port selbst braucht. Beim Erzeugen der Paketliste ruft der Port ein php aus dem PATH auf. Nach dem deinstall gab es keins mehr, die Installation brach mit php: not found ab, und PHP war für ein paar Minuten gar nicht installiert. Da nginx ohnehin aus war, hatte das keine Außenwirkung. Gelöst habe ich es, indem ich das frisch gebaute CLI-Binary für diesen einen Aufruf vorne in den PATH gestellt habe:

PATH=/usr/ports/lang/php83/work/php-8.3.36/sapi/cli:$PATH make -C /usr/ports/lang/php83 -DBATCH install

Beim nächsten Mal lasse ich zuerst make stage laufen, solange das alte PHP noch installiert ist, und tausche erst danach.

Andere OpenSSL-Basis, anderes CA-Bundle. Das war die unangenehmste Falle, weil alle Prüfungen grün waren. Das alte PHP aus dem Paket-Repository war gegen das OpenSSL des Basissystems gebaut und nutzte dessen Zertifikatsspeicher /etc/ssl/cert.pem. Mein selbst gebautes PHP ist wegen DEFAULT_VERSIONS+=ssl=openssl40 in der /etc/make.conf gegen das OpenSSL aus den Ports gebaut und sucht seine CA-Zertifikate unter /usr/local/openssl/cert.pem. Diese Datei gab es nicht. Die Folge war, dass jede ausgehende TLS-Verbindung aus PHP mit Zertifikatsprüfung scheiterte. Aufgefallen ist das an einer PHP-Anwendung, die per TLS mit einem IMAP-Server spricht und nur noch „Connection to storage server failed“ meldete. nginx -t, php -m und php-fpm -t waren alle zufrieden, erst der Funktionstest hat es gezeigt.

php -r 'var_dump(openssl_get_cert_locations());'
# default_cert_file => /usr/local/openssl/cert.pem
ln -s /etc/ssl/cert.pem /usr/local/openssl/cert.pem

Alternativ lässt sich der Pfad auch per openssl.cafile in der php.ini setzen.

War schon jemand drin?

Nach dem Patch bleibt die Frage, ob die Lücke vorher schon ausgenutzt wurde. Hier hilft, dass der Angriff laut ist: Er braucht tausende Anfragen, die jeweils einen memory_limit-Abbruch oder einen Fatal Error auslösen. Selbst ein am Ende erfolgreicher Angriff hinterlässt also vorher viele Fehlversuche. Ich habe den gesamten vorhandenen Log-Zeitraum von 15 Tagen durchsucht, rotierte und mit bzip2 gepackte Logs eingeschlossen:

# Abstürze von FPM-Workern
for f in /var/log/php-fpm.log*; do bzcat -f "$f"; done | grep -E 'signal|SIGSEGV|core dumped'

# Speicher- und Fatal-Errors, PHP-FPM ohne eigenes error_log schreibt ins nginx-Errorlog
for f in /var/log/nginx/*error.log*; do bzcat -f "$f"; done | grep -aE 'Allowed memory size|PHP Fatal'

# Neue oder geänderte PHP-Dateien im Webroot
find /usr/local/www -type f \( -name '*.php*' -o -name '*.phar' -o -name '.user.ini' \) -newermt 2026-10-14

Das Ergebnis:

  • Keine abgestürzten FPM-Worker, kein SIGSEGV, kein Core-Dump.
  • Kein einziges Allowed memory size und kein PHP Fatal, weder im FPM-Log noch in den nginx-Errorlogs.
  • Keine Häufung von 5xx-Antworten und keine einzelne Quelle mit auffällig vielen POST-Anfragen. Die meisten POSTs kamen von der ActivityPub-Federation und von wp-cron.
  • Keine fremden Prozesse und keine unbekannten ausgehenden Verbindungen des Webserver-Benutzers, die Crontab enthält nur bekannte Einträge.
  • Im Webroot nur fünf neue WordPress-Sprachdateien. Ihr Zeitstempel passt zu einem wp-cron-Lauf im Access-Log, und der Inhalt ist das übliche <?php return [...] ohne eval, base64_decode oder Zugriffe auf Superglobals. In den Upload-Verzeichnissen liegt gar keine PHP-Datei.

Der einzige Treffer mit Exploit-Charakter war ein Massenscanner, der den alten pearcmd-Trick gegen PHP-CGI ausprobiert hat. Das ist eine ganz andere, alte Lücke, hat mit php2shell nichts zu tun und läuft gegen PHP-FPM ins Leere.

Zur Ehrlichkeit gehören auch die Grenzen dieser Prüfung. Access-Logs enthalten keine POST-Bodies, ein einzelner, gezielter Treffer mit wenigen Anfragen wäre so nicht zu erkennen. Wegen der nötigen Menge an Anfragen halte ich das aber für unwahrscheinlich. Außerdem reichen meine Logs nur 15 Tage zurück. Eine erfolgreiche Codeausführung hätte mit den Rechten des Webserver-Benutzers stattgefunden, die Logs gehören root und hätten von dort aus nicht verändert werden können. Mein Fazit ist deshalb: Es gibt keinen Hinweis auf Ausnutzungsversuche oder eine Kompromittierung. Das heißt „sehr unwahrscheinlich“, nicht „bewiesen ausgeschlossen“.

Was du prüfen solltest

Das PHP-Team hat zusätzlich Konfigurationsänderungen veröffentlicht, die den Angriff erschweren sollen, etwa memory_limit=-1, ein kleines post_max_size, ein niedriges max_input_nesting_level und bei FPM ein niedriges pm.max_requests. Das Team nennt das selbst eine temporäre Krücke. Diese Einstellungen können Funktion oder Leistung kosten, und keine davon schließt die Lücke. Komplett hilft nur das Update. Denk dabei auch an PHP, das du nicht direkt siehst:

  • Docker-Container bringen ihr eigenes PHP mit. Ein Update des Hosts hilft da nicht, das Image muss neu gezogen und der Container neu gestartet werden.
  • Geräte mit Weboberfläche wie pfSense, OPNsense, NAS-Systeme von Synology oder QNAP und viele Router nutzen PHP für ihre Verwaltung. Hier bist du auf Updates des Herstellers angewiesen. Bis dahin gehört so eine Oberfläche erst recht nicht ins Internet.
  • Gehostete Seiten hängen vom Hoster ab. Schau nach, ob er das Update schon eingespielt hat oder einen Termin nennt.
  • Alte PHP-Versionen bekommen teilweise Backports, das ist aber eine gute Gelegenheit, mindestens auf PHP 8.3 zu wechseln. PHP 8.2 bekommt nur noch bis Ende 2026 Sicherheitsupdates.
  • Auf FreeBSD lohnt sich bei kritischen Lücken der Blick in den Ports-Tree, bevor man auf das Paket wartet. Prüf dann aber auch, gegen welches OpenSSL der Port gebaut wird.

Mein Fazit

nginx abzuschalten war die einfachste Maßnahme, die garantiert wirkt, und ein paar Stunden ohne Blog tun niemandem weh. Das eigentliche Patchen hat mich mehr gelehrt als die Lücke selbst: Eine neue Versionsnummer ist noch kein Beweis für den richtigen Fix, ein neues Binary auf der Platte noch kein gepatchter Dienst, und eine grüne Konfigurationsprüfung noch kein funktionierendes System. Erst der Funktionstest und der Blick in die Logs geben am Ende ein ehrliches Bild.

Nachtrag 23. Oktober 2026: Wer die weitere Entwicklung zu php2shell verfolgen will, findet bei pwn.watch eine laufend aktualisierte Zeitleiste mit Patch-Status, Advisories und Feeds pro Stack. Mehr dazu in pwn.watch: Sicherheitsvorfälle im Überblick, mit Vorsicht beim Brief für die AI.

Kritische PHP-Lücken: mein Blog geht bis zum Update offline

Warndreieck neben dem Schriftzug PHP, kritische Sicherheitslücken, Update am 21.10.2026 um 16:00 Uhr, Blog bis zum Patch offline

Kurze Info in eigener Sache: Heute, am 21. Oktober 2026, veröffentlicht das PHP-Projekt um 16:00 Uhr unserer Zeit (14:00 Uhr UTC) ein Sicherheitsupdate für zwei kritische Lücken. heise security hat das in der Meldung Wichtige PHP-Updates am 21. Oktober beheben Codeeinschleusung-Schwachstellen zusammengefasst, und die Lage klingt ernst genug, dass ich meinen Blog vorerst vom Netz nehme.

Was bisher bekannt ist

Das PHP-Projekt hat das Update am Vortag auf php.net angekündigt. Beide Lücken sind mit CVSS 4.0 von 9.2 bewertet, betroffene und reparierte Versionen sollen erst mit dem Release genannt werden. Das CERT-EU warnt ebenfalls und spricht von möglicher Codeausführung aus der Ferne ohne Anmeldung.

Laut heise stecken die Fehler in jeder PHP-Version seit PHP 5. Ein bereits kursierender Proof of Concept zielt zwar nur auf die Server-API von LiteSpeed, darauf würde ich mich aber nicht verlassen. Auch die herumgereichte Gegenmaßnahme session.upload_progress.enabled = 0 soll nach Kenntnisstand von heise nicht helfen. Funktionierende Exploits erwartet heise innerhalb von Stunden, spätestens Tagen. Wer kein Risiko eingehen will, hat bis zum Update also nur die Wahl, PHP-Webserver vom Netz zu nehmen.

Warum mein Blog offline geht

Dieser Blog läuft mit WordPress und damit mit PHP auf einem FreeBSD-Server. Selbst wenn das Update um 16 Uhr erscheint, dauert es noch eine Weile, bis die gepatchten Pakete in den FreeBSD-Ports und im Paket-Repository landen und ich sie eingespielt habe. Für dieses Zeitfenster möchte ich keinen Server offen im Netz haben, auf dem jeder anonym Code ausführen könnte. Ein paar Stunden oder auch Tage ohne Blog sind ärgerlich, ein kompromittierter Server wäre deutlich ärgerlicher.

Ich nehme den Blog daher jetzt erst einmal offline. Sobald die reparierten PHP-Pakete installiert sind und ich mir die technischen Details angesehen habe, kommt er wieder zurück. Wer mir im Fediverse oder auf Bluesky folgt, bekommt diesen Beitrag trotzdem zu sehen, auch wenn die Seite selbst gerade nicht erreichbar ist.

Was du jetzt tun solltest

Wenn du selbst PHP-Anwendungen im Netz betreibst, schau jetzt nach, wo überall PHP läuft. Gerade bei vergessenen Testinstanzen, alten Foren oder einem phpMyAdmin wird es schnell unübersichtlich. Behalte die Sicherheitsmeldungen deiner Distribution im Blick und spiel die Updates ein, sobald sie da sind. Was davon du bis dahin vom Netz nimmst, musst du für deine eigenen Systeme abwägen.

Update 21. Oktober 2026: Der Blog ist wieder online. Was hinter php2shell steckt und wie ich PHP noch am selben Tag aus den FreeBSD-Ports gepatcht habe, steht im Folgebeitrag php2shell: PHP am Tag der Veröffentlichung aus den FreeBSD-Ports gepatcht.

Orca: eine ADE, in der mehrere Coding-Agenten sauber nebeneinander arbeiten

Illustration von Orca als Agent Development Environment: Vier KI-Coding-Agenten arbeiten parallel in getrennten Git-Worktrees an Code, Benutzeroberfläche, API und Tests. Ein Entwickler überprüft die Änderungen und führt sie zusammen.

Seit fast fünf Monaten arbeite ich mit Orca, und es ist in der Zeit zu einem Werkzeug geworden, das ich jeden Tag offen habe. Ich möchte es euch deshalb kurz vorstellen. Das hier ist kein großer Testbericht, eher eine Empfehlung mit ein paar Erklärungen dazu, was so ein Tool überhaupt ist und warum ich gerade bei diesem hängen geblieben bin.

Was ist eine ADE?

Eine IDE kennt jeder, der programmiert: Editor, Terminal, Debugger und Git in einem Programm. Sie ist für einen Menschen gebaut, der selbst tippt. Mit Coding-Agenten wie Claude Code oder Codex hat sich die Arbeit aber verschoben. Ich schreibe weniger Code selbst, ich gebe Aufgaben ab, schaue mir an, was zurückkommt, korrigiere und lasse weiterlaufen. Dafür ist eine klassische IDE nicht gemacht.

ADE steht für Agent Development Environment. Orca beschreibt das selbst ganz treffend: Eine IDE ist für dich gebaut, eine ADE für dich und deine Agenten. Im Mittelpunkt steht also nicht mehr der Editor, sondern die Frage, wie man mehrere Agenten gleichzeitig arbeiten lässt, ohne den Überblick zu verlieren. Was macht welcher Agent gerade, wer wartet auf eine Freigabe, wer ist fertig, und was hat er eigentlich geändert?

Der technische Kern dabei sind Git-Worktrees. Ein Worktree ist ein zusätzliches Arbeitsverzeichnis desselben Repositories mit eigenem Branch. Lässt man zwei Agenten im selben Verzeichnis arbeiten, schreiben sie sich gegenseitig in die Dateien, und spätestens beim Testlauf weiß keiner mehr, welche Änderung von wem kommt. Bekommt jeder Agent seinen eigenen Worktree, arbeiten sie sauber getrennt nebeneinander, und am Ende entscheide ich, was gemergt wird. Ohne Werkzeug ist das allerdings viel Handarbeit mit git worktree add, mehreren Terminals und dem Gefühl, ständig irgendwo etwas zu vergessen.

Was Orca besonders macht

Genau diese Handarbeit nimmt mir Orca ab. Ich lege eine Aufgabe an, Orca erstellt den Worktree, startet darin den Agenten und zeigt mir in der Seitenleiste alle laufenden Aufgaben über alle Projekte hinweg. Die Punkte, die Orca für mich von anderen Lösungen abheben:

  • Jeder CLI-Agent, jedes eigene Abo. Orca bringt keinen eigenen Agenten und kein eigenes Modell mit. Claude Code, Codex, Gemini, OpenCode und viele weitere sind vorkonfiguriert, und alles, was im Terminal läuft, lässt sich einbinden. Dabei nutze ich die Abos, die ich ohnehin habe. Ich bin also nicht an einen Anbieter gebunden und muss auch kein zusätzliches Abo abschließen.
  • Parallele Worktrees. Jede Aufgabe läuft isoliert. Man kann sogar denselben Prompt an mehrere Agenten geben, die Ergebnisse vergleichen und den besten Stand übernehmen.
  • Diffs kommentieren. Änderungen eines Agenten sehe ich als Diff, kann direkt an einzelne Zeilen Kommentare hängen und diese gesammelt an den Agenten zurückgeben. Das fühlt sich an wie ein Code-Review mit einem Kollegen und ist deutlich angenehmer, als jede Anmerkung einzeln in den Prompt zu tippen.
  • Terminals, Editor und Browser in einem Fenster. Terminals lassen sich beliebig teilen, der Verlauf übersteht einen Neustart. Für Web-Projekte gibt es pro Worktree ein eigenes Chromium-Fenster, in dem man ein Element anklicken und es samt HTML, CSS und Bildausschnitt an den Agenten schicken kann.
  • Worktrees per SSH. Die Agenten müssen nicht auf dem eigenen Rechner laufen. Orca kann Worktrees auf einer entfernten Maschine anlegen und dort Dateien, Git und Terminals bedienen.
  • Verbrauch im Blick. Orca zeigt die Nutzung von Claude und Codex an, inklusive der Zeitpunkte, an denen die Limits zurückgesetzt werden. Bei mehreren parallelen Agenten ist das Gold wert, weil die Kontingente sonst schneller weg sind, als man denkt.
  • Eine Begleit-App fürs Handy. Für iOS und Android gibt es eine App, mit der man den Status der Agenten sieht und auch unterwegs eine Rückfrage beantworten kann.

Dazu kommt etwas, das für mich nicht ganz unwichtig ist: Orca ist Open Source unter MIT-Lizenz und läuft auf Linux genauso wie auf macOS und Windows. Für Linux gibt es Pakete als .deb, .rpm und AppImage, jeweils für x86_64 und ARM64, dazu ein Paket im AUR. Dahinter steht das Startup Stably AI. Das Repository gibt es erst seit März 2026 und es hat inzwischen knapp 96.000 Sterne auf GitHub. Es scheint also nicht nur mir so zu gehen.

Was du wissen solltest

Orca sammelt anonyme Nutzungsdaten. Laut der Doku zur Telemetrie sind das Ereignisse wie App-Starts, neu angelegte Workspaces oder gestartete Agenten, verknüpft mit einer zufälligen lokalen ID. Dateiinhalte, Prompts, Ausgaben der Agenten sowie Repo- und Branch-Namen werden nach eigener Aussage nicht übertragen. Wer das trotzdem nicht möchte, schaltet es unter Settings > Privacy ab oder startet Orca mit einer dieser Umgebungsvariablen:

DO_NOT_TRACK=1
ORCA_TELEMETRY_DISABLED=1

Außerdem ist das Entwicklungstempo enorm. Neue Versionen kommen fast täglich, die Versionsnummer steht inzwischen bei 1.4.229. Das bringt laufend neue Funktionen, heißt aber auch, dass sich hin und wieder etwas verändert oder kurz hakt. Wer ein Werkzeug sucht, das sich über Monate nicht bewegt, ist hier falsch.

Und eine ADE nimmt dir das Denken nicht ab. Mehrere Agenten parallel arbeiten zu lassen, heißt auch, mehrere Ergebnisse parallel prüfen zu müssen. Orca macht das Prüfen deutlich bequemer, die Verantwortung für das, was am Ende gemergt wird, bleibt aber bei dir. Warum ich das für einen der wichtigsten Punkte beim Arbeiten mit AI halte, habe ich in AI, der Mensch als Flaschenhals schon einmal aufgeschrieben.

Mein Fazit

Wer nur ab und zu einen Agenten im Terminal startet, braucht Orca nicht unbedingt. Sobald aber mehrere Aufgaben gleichzeitig laufen, vielleicht sogar mit verschiedenen Agenten, wird es ohne passendes Werkzeug schnell unübersichtlich. Genau da spielt Orca seine Stärken aus. Es ist kostenlos, offen und hängt nicht an einem einzelnen Anbieter. Probiere es einfach mal aus, die Downloads gibt es auf onorca.dev.

Siehe auch:

Wenn ihr Fragen habt, dann dürft ihr mich sehr gerne fragen.

BIOS erklärt, Teil 10: mein Rechner hat PCIe-Fehler protokolliert, von denen ich nichts gewusst hätte

Diese Folge hat einen anderen Charakter als die bisherigen. Die vorherigen erklären, was auf einer BIOS-Seite steht. Diese hier erklärt, was auf einer BIOS-Seite fehlt, und was das für Folgen hatte.

Angefangen hat es damit, dass ich beim Durchsehen der Startmeldungen über eine Zeile gestolpert bin, die ich vorher zwar hunderte Male gesehen, aber nie gelesen hatte:

acpi PNP0A08:07: _OSC: platform does not support [SHPCHotplug AER LTR DPC]

Übersetzt: das BIOS teilt dem Betriebssystem mit, dass es vier Dinge nicht unterstützt, unter anderem AER. Und AER ist die Fehlerbehandlung für PCIe. Teil 10 der Serie, alles Übrige unter BIOS & Firmware.

Was AER macht, und warum man es haben will

PCIe ist eine serielle Verbindung mit hoher Frequenz, und wie jede solche Verbindung ist sie nicht fehlerfrei. Es gibt zwei Sorten Fehler. Korrigierbare, bei denen ein Paket neu geschickt wird und niemand etwas merkt. Und nicht korrigierbare, bei denen Daten verloren sind.

AER, Advanced Error Reporting, zählt beides mit. Das ist vor allem bei den korrigierbaren interessant, denn die sind ein Frühwarnsystem: eine Verbindung, die langsam schlechter wird, fällt nicht plötzlich aus, sondern sammelt erst über Wochen korrigierte Fehler.

Das war für mich kein akademisches Thema. Meine NVMe-Laufwerke hängen nicht direkt am Board, sondern an einem 75 Zentimeter langen Kabel, das einen SlimSAS-Anschluss auf zwei Laufwerke aufteilt. 75 Zentimeter sind für ein Gen-4-Signal eine Menge. Wenn irgendwo in dieser Maschine eine Verbindung Ärger machen würde, dann diese.

Der Zustand vorher: die Bits werden gesetzt, aber niemand liest sie

Der spannende Teil ist, dass die Hardware trotzdem mitzählt. Im Statusregister der NVMe standen Fehlerbits:

lspci -vv -s c3:00.0 | grep DevSta
#   DevSta: CorrErr+ NonFatalErr- FatalErr- UnsupReq+

Das + hinter CorrErr heisst: hier ist mindestens ein korrigierbarer Fehler aufgetreten. Gleichzeitig standen die eigentlichen AER-Zähler auf null:

cat /sys/bus/pci/devices/0000:c3:00.0/aer_dev_correctable
#   TOTAL_ERR_COR 0

Kein Widerspruch, sondern genau das Bild, das man bei abgeschalteter Fehlerbehandlung erwartet. Die Hardware setzt ihre Statusbits, weil sie das immer tut. Aber es gibt niemanden, der sie ausliest, auswertet, ins Protokoll schreibt und wieder zurücksetzt. Ein Zähler, den keiner bedient.

Praktisch hiess das: PCIe-Fehler tauchten in meinem Journal überhaupt nicht auf. Wäre das Kabel langsam gestorben, hätte ich es erst gemerkt, wenn das Laufwerk weg gewesen wäre.

Warum das BIOS nein sagt

Der Mechanismus dahinter heisst _OSC, Operating System Capabilities. Beim Start fragt das Betriebssystem die Firmware: darf ich diese Dinge übernehmen? Die Firmware antwortet. Sagt sie nein, geht der Kernel davon aus, dass die Firmware das selbst macht, und hält sich raus.

Das Modell nennt sich firmware-first und ist in echten Servern durchaus sinnvoll: die Firmware fängt Fehler ab, meldet sie über einen definierten Kanal an das Betriebssystem, und der Verwaltungscontroller bekommt sie auch mit. In einem Rack mit Fernwartung will man genau das.

Nur muss die Firmware es dann auch tatsächlich tun. Und der Kanal dafür heisst WHEA.

WHEA, und die Falle die ich fast getappt wäre

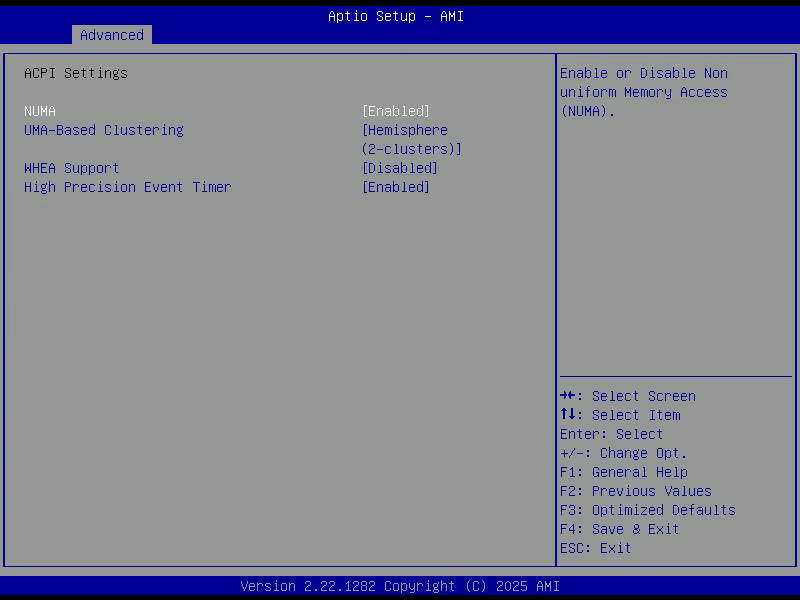
Aptio Setup, ACPI Settings, mit NUMA, UMA-Based Clustering im Hemisphere-Modus und WHEA Support auf Disabled

Unter Advanced > ACPI Settings steht:

NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]
WHEA Support                      [Disabled]
High Precision Event Timer        [Enabled]

WHEA ist der firmware-first-Kanal, und er steht auf Disabled. Damit war die Lage eindeutig: das BIOS sagt dem Betriebssystem „lass mal, ich mache das“, und macht es dann nicht.

Meine erste Reaktion war, WHEA einzuschalten. Das wäre falsch gewesen, und ich schreibe das hier auf, weil es die naheliegende und trotzdem schlechtere Lösung ist. Firmware-first bedeutet, dass Fehlerbehandlung über ACPI-Tabellen läuft, die die Firmware bereitstellen muss. Prüfen kann man das:

ls /sys/firmware/acpi/tables/ | grep -E "HEST|BERT|ERST|EINJ"
#   (keine Ausgabe)

Keine einzige davon vorhanden. Kein HEST, in dem stünde welche Fehlerquellen es überhaupt gibt. Kein BERT für Fehler aus dem letzten Absturz. Die Firmware ist für diesen Weg schlicht nicht eingerichtet.

Der bessere Weg ist die andere Richtung: dem Betriebssystem die Arbeit geben.

Ein Kernel-Parameter statt eines BIOS-Besuchs

Linux kennt dafür einen Schalter, der die _OSC-Antwort schlicht ignoriert:

GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pcie_ports=native"

Danach update-grub, neu starten, fertig. Der Unterschied ist deutlich:

# vorher
dmesg | grep -c "AER: enabled"
#   0

# nachher
dmesg | grep -c "AER: enabled"
#   7

Sieben Root Ports mit aktiver Fehlerbehandlung, darunter die beiden, um die es mir ging:

pcieport 0000:c2:04.0: AER: enabled with IRQ 130
pcieport 0000:c2:05.0: AER: enabled with IRQ 131

Wichtig für alle die das nachbauen: die _OSC-Zeile beim Booten sagt weiterhin platform does not support. Sie ändert sich nicht und wird sich nie ändern, das ist die Antwort der Firmware. Der Parameter sorgt nur dafür, dass der Kernel sie ignoriert. Wer nach dem Neustart auf diese Zeile schaut, hält die Massnahme fälschlich für wirkungslos. Das Erfolgskriterium ist AER: enabled, nicht _OSC.

Als Zugabe kam noch DPC dazu, Downstream Port Containment. Das riegelt bei einem schweren Fehler den betroffenen Anschluss ab, statt den ganzen Rechner mitzureissen. Bei einem Laufwerk an einem 75-Zentimeter-Kabel ist mir das ausgesprochen recht.

Die zwei Schalter im BIOS, die man dafür in Ruhe lassen muss

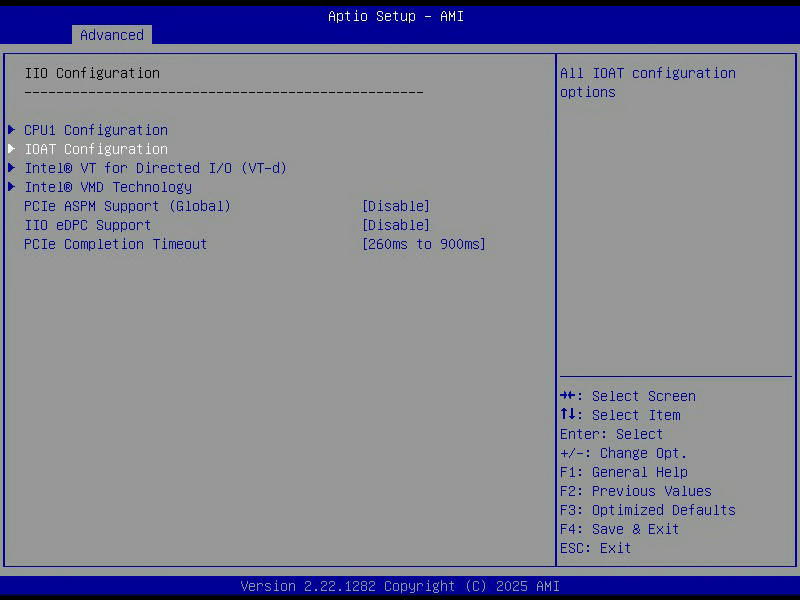
Aptio Setup, IIO Configuration, mit PCIe ASPM Support, IIO eDPC Support und PCIe Completion Timeout

Unter Advanced > Chipset Configuration > North Bridge > IIO Configuration:

> CPU1 Configuration
> IOAT Configuration
> Intel(R) VT for Directed I/O (VT-d)
> Intel(R) VMD Technology
PCIe ASPM Support (Global)        [Disable]
IIO eDPC Support                  [Disable]
PCIe Completion Timeout           [260ms to 900ms]

Einen AER-Schalter gibt es hier nicht. Ich habe danach gesucht, ihn gibt es schlicht nicht, und deshalb war der Kernel-Parameter nicht der bequemere Weg sondern der einzige.

IIO eDPC Support ist die firmware-first-Variante von DPC, also das Gegenstück zu dem, was pcie_ports=native gerade aktiviert hat. Dass es auf Disable steht, ist der Grund weshalb der Kernel DPC übernehmen konnte. Nicht einschalten, sonst reisst die Firmware die Eindämmung wieder an sich und kollidiert mit dem nativen Mechanismus.

PCIe ASPM Support (Global) [Disable] ist etwas anderes und wird gerne verwechselt. ASPM sind Stromsparzustände für die Verbindung selbst: bei wenig Verkehr werden Teile der Leitung schlafen gelegt. Das spart im Leerlauf ein paar Watt und kostet Latenz beim Aufwachen. Auf Servern ist es traditionell aus, weil es in der Vergangenheit für schwer zu findende Aussetzer gesorgt hat. Meine NVMe kann es ohnehin nicht, das steht so in ihren Fähigkeiten.

Nicht verwechseln mit dem Herunterttakten aus Teil 8: dass eine Grafikkarte im Leerlauf auf PCIe 1.0 fällt, ist Link-Geschwindigkeitsverwaltung und hat mit ASPM nichts zu tun. ASPM regelt Zustände, nicht Tempo. Die beiden Befunde „ASPM ist aus“ und „der Link taktet runter“ stehen sich nicht im Weg.

Und dann kam das, weswegen ich das alles gemacht habe

Fehlerbehandlung aktiv zu haben ist nur die halbe Miete. Die Zähler im sysfs stehen nach jedem Neustart wieder auf null. Wer alle paar Wochen hinsieht, sieht nur den Ausschnitt seit dem letzten Start.

Also habe ich noch ein Paket nachinstalliert:

apt-get install rasdaemon

Das Ding läuft als Dienst, hört auf die Fehlerereignisse des Kernels und schreibt sie mit Zeitstempel in eine kleine Datenbank. Speicherfehler, Machine Checks, und eben AER. Beim Einrichten war alles auf null, und ich hatte ehrlich gesagt damit gerechnet, dass das so bleibt.

Beim Schreiben dieser Folge habe ich noch einmal nachgesehen:

ras-mc-ctl --summary
#   No Memory errors.
#
#   PCIe AER events summary:
#           15 Corrected errors: Receiver Error
#
#   No Extlog errors.
#   No MCE errors.

Fünfzehn korrigierte Fehler. Der Speicher ist sauber, die Machine Checks sind sauber, aber auf PCIe stand etwas. Und jetzt kommt der Teil, für den sich die ganze Übung gelohnt hat, denn die Datenbank weiss auch wo und wann:

ras-mc-ctl --errors
#   1  2026-08-03 12:48:54  0000:c2:05.0  Corrected error: Receiver Error
#   ...
#   15 2026-08-03 13:04:34  0000:c2:05.0  Corrected error: Receiver Error

Alle fünfzehn am selben Tag, innerhalb von sechzehn Minuten, alle am selben Anschluss. c2:05.0 ist der zweite NVMe-Port. Und der dritte August war der Tag, an dem an genau diesem Strang gearbeitet wurde.

Damit ist es keine besorgniserregende Meldung, sondern eine erklärbare: Empfangsfehler, während sich eine Verbindung aufbaut, sind erwartbar. Seitdem, und das ist die eigentlich gute Nachricht, ist kein einziger dazugekommen.

Aber genau das ist der Punkt. Ohne den Kernel-Parameter hätte niemand diese fünfzehn Ereignisse registriert. Ohne rasdaemon wären sie beim nächsten Neustart verschwunden. Und wenn dieselben fünfzehn Einträge nicht an einem einzigen Nachmittag aufgetreten wären, sondern verteilt über drei Wochen ohne dass jemand am Gehäuse war, dann wäre das die Vorwarnung gewesen, wegen der ich das alles überhaupt eingerichtet habe.

Fazit

Von allen Änderungen, die ich an dieser Maschine gemacht habe, ist diese die unauffälligste und vermutlich die nützlichste. Sie kostet einen Kernel-Parameter, ein Paket und einen Neustart. Sie ändert im Alltag nichts. Und sie ist der Unterschied zwischen „das Laufwerk ist plötzlich weg“ und „an diesem Anschluss stimmt seit zwei Wochen etwas nicht“.

Was ich mitnehme: eine Firmware, die _OSC mit „unterstütze ich nicht“ beantwortet und gleichzeitig den eigenen Meldeweg abgeschaltet hat, hinterlässt eine Lücke, die man nur findet wenn man danach sucht. Beim Einrichten einer neuen Maschine würde ich ab jetzt immer nach dieser einen Zeile im Startprotokoll greppen.

Nächste Folge: Virtualisierung. VT-d, IOMMU-Gruppen, VMD und ein Menü namens IOAT, in dem etwas ganz anderes steht als der Name vermuten lässt.

Siehe auch

Falls jemand von euch eine steigende Zahl korrigierter PCIe-Fehler in freier Wildbahn hatte und am Ende die Ursache gefunden hat: Kabel, Riser, Steckplatz? Das würde mich sehr interessieren, ihr dürft mich jederzeit fragen.
BIOS erklärt, Teil 9: Above 4G, Resizable BAR und eine Liste von Option ROMs

Es gibt in jedem BIOS eine Seite, auf der die Dinge landen, die sonst nirgends hinpassen. Bei Supermicro heisst sie PCIe/PCI/PnP Configuration, und das PnP im Namen ist Plug and Play, ein Begriff aus den Neunzigern, der damals eher ein Versprechen als eine Beschreibung war. Ich interpretiere das einfach für mich jetzt mal so, ok?

Oben stehen Einstellungen, die für alle PCIe-Geräte gelten. Unten steht für jeden einzelnen Steckplatz eine Zeile. Beides ist interessant, aber aus unterschiedlichen Gründen. Das hier ist Teil 9, gesammelt liegt alles unter BIOS & Firmware.

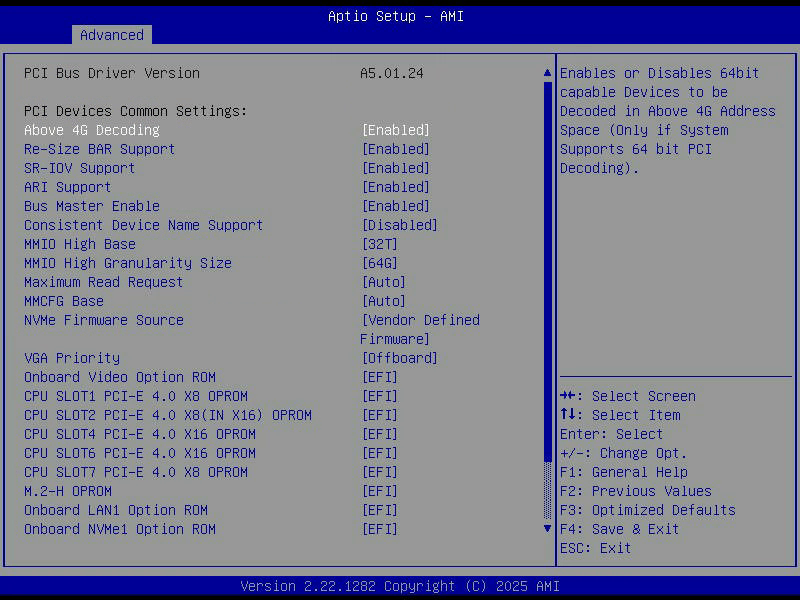
Die obere Hälfte

Aptio Setup, PCIe PCI PnP Configuration, mit Above 4G Decoding, Resizable BAR, SR-IOV und ARI
Above 4G Decoding                 [Enabled]
Re-Size BAR Support               [Enabled]
SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]
Bus Master Enable                 [Enabled]
Consistent Device Name Support    [Disabled]
MMIO High Base                    [32T]
MMIO High Granularity Size        [64G]
Maximum Read Request              [Auto]
MMCFG Base                        [Auto]

Alles auf Enabled, ich denke für mich genau richtig; also den Computer hier :D. Trotzdem lohnt es sich, die ersten beiden anzusehen, weil sie zusammengehören und weil sie ein handfestes Problem lösen. Mein letztes Bios hatte diese Möglichkeit nicht, weil die PCIe Version zu alt war. Ich freue mich also über diese neue Möglichkeit. Ich muss grade an Franck Ribéry „Jubel“ denken.

Das 4-GB-Problem, oder: warum 16 GB Grafikspeicher nicht sichtbar waren

Jedes PCIe-Gerät blendet seinen Speicher in den Adressraum des Rechners ein. Diese Fenster heissen BARs, Base Address Registers. Eine Grafikkarte mit 16 GB Videospeicher hätte gerne ein Fenster von 16 GB, damit die CPU auf den ganzen Speicher direkt zugreifen kann.

Das Problem: historisch lagen diese Fenster alle unterhalb der 4-GB-Grenze, weil dort in einem 32-Bit-Adressraum eben Schluss ist. Na wer erinnert sich noch an zu große DVD Images auf 32-Bit Filesystemen? Unterhalb von 4 GB liegen aber auch der Arbeitsspeicher, die Firmware und noch einiges mehr. Für die Geräte bleibt ein schmaler Streifen übrig, bei mir ist das dieser hier:

Global MMIO Low Base / Limit      90000000 / FBFFFFFF

Von 0x90000000 bis 0xFBFFFFFF, also knapp 1,7 GB für alle Karten zusammen. Da passt keine moderne Grafikkarte hinein, geschweige denn eine Grafikkarte und zwei Netzwerkkarten und zwei NVMe-Laufwerke.

Above 4G Decoding hebt diese Grenze auf. Die Fenster dürfen dann oberhalb von 4 GB liegen, und dort ist Platz ohne Ende:

Global MMIO High Base / Limit     0000200000000000 / 0000204FFFFFFFFF

Das beginnt bei 32 Terabyte und ist 320 GB gross. Genau das steht auch in der Zeile MMIO High Base [32T] weiter unten.

Ohne diesen Schalter bekommt eine 16-GB-Grafikkarte ein Notfallfenster von 256 MB und muss ihren restlichen Speicher stückweise durchreichen. Das funktioniert, kostet aber Leistung, und bei manchen Karten funktioniert es gar nicht. Wer sich fragt, warum sein Rechner mit einer neuen Grafikkarte gar nicht mehr durchbootet: hier nachsehen oder auch, wenn die Performance deutlich unter der Erwartung liegt.

Resizable BAR, der Schalter mit dem Spielerimage

Re-Size BAR Support ist der zweite Teil desselben Gedankens. Above 4G schafft den Platz, Resizable BAR erlaubt der Karte, ein entsprechend grosses Fenster tatsächlich anzufordern.

Bekannt geworden ist die Funktion vor ein paar Jahren als Gaming-Feature, weil AMD sie als „Smart Access Memory“ vermarktet hat und in einigen Spielen ein paar Prozent mehr Bilder pro Sekunde herauskamen. Der eigentliche Nutzen liegt woanders: überall dort, wo grosse Datenmengen in den Grafikspeicher wandern und die CPU dabei mitreden muss. Rechnen auf der GPU, Modelle laden, Videobearbeitung.

Bei mir ist es also erst 2026 angekommen:

lspci -vv -s 51:00.0 | grep -A2 "Resizable BAR"
#   BAR 1: current size: 16GB, supported: ... 16GB

16 GB aktuell, und 16 GB ist zugleich die grösste unterstützte Grösse. Der komplette Videospeicher ist eingeblendet, mehr geht nicht. Zwei BIOS-Schalter, die zusammen dafür sorgen, dass die Karte tut was sie soll und zwar, zumindest hier, ungebremst.

SR-IOV und ARI

SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]

SR-IOV steht für Single Root I/O Virtualization und erlaubt einer Karte, sich gegenüber dem System als mehrere Geräte auszugeben. Eine Netzwerkkarte meldet dann neben ihrer physischen Funktion noch eine Reihe virtueller, und jede davon kann einer virtuellen Maschine direkt zugewiesen werden. Die VM redet dann ohne Umweg über den Hypervisor mit der Hardware. Wichtig für VMs also.

Meine X710 kann das, ich nutze es immer mal wieder in verschiedenen Projekten. Der Schalter kostet nichts, solange niemand virtuelle Funktionen anlegt, und wenn ich es noch einmal brauche, muss ich nicht neu starten.

ARI ist die technische Voraussetzung dafür. Alternative Routing-ID Interpretation klingt kompliziert und ist eine Adressierungsfrage: klassisch hat ein PCIe-Gerät bis zu acht Funktionen. Eine Karte mit dutzenden virtuellen Funktionen sprengt das. ARI verschiebt die Bitgrenze im Adressfeld, sodass mehr Funktionen pro Bus möglich sind. Ohne ARI kein sinnvolles SR-IOV.

Bus Master Enable erlaubt Geräten, selbst Speicherzugriffe auszulösen, statt darauf zu warten dass die CPU sie abholt. Das ist DMA, und ohne DMA ist jede halbwegs moderne Karte unbrauchbar. Der Schalter existiert vermutlich nur noch aus historischen Gründen. Oder fällt euch etwas ein, warum man direkten Speicherzugriff nicht will?

Maximum Read Request [Auto] legt fest, wie viele Daten ein Gerät mit einer einzigen Anfrage holen darf. Grössere Anfragen bedeuten weniger Verwaltungsaufwand. An meiner NVMe ergibt Auto 512 Byte, was zunächst wenig aussieht. Es ist aber kein BIOS-Problem: das Laufwerk selbst gibt in seinen Fähigkeiten nur 512 Byte an. Hochdrehen würde also nichts bringen, solange die Gegenseite nicht mitspielt.

Die untere Hälfte: Option ROMs

VGA Priority                      [Offboard]
Onboard Video Option ROM          [EFI]
CPU SLOT1 PCI-E 4.0 X8 OPROM      [EFI]
CPU SLOT2 PCI-E 4.0 X8(IN X16) OPROM [EFI]
CPU SLOT4 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT6 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT7 PCI-E 4.0 X8 OPROM      [EFI]
M.2-H OPROM                       [EFI]
Onboard LAN1 Option ROM           [EFI]
Onboard NVMe1 Option ROM          [EFI]
Onboard NVMe2 Option ROM          [EFI]

Ein Option ROM ist ein Stück Firmware auf der Steckkarte selbst. Beim Start lädt das BIOS diesen Code und führt ihn aus, damit die Karte schon nutzbar ist, bevor ein Betriebssystem existiert. Klassische Beispiele: eine Netzwerkkarte, die über PXE booten soll. Ein Speichercontroller, von dem gestartet wird. Eine Grafikkarte, die ein Bild anzeigen soll. Ihr versteht schon…

Die drei Werte sind EFI, Legacy und Disabled. EFI heisst modernes UEFI-Modul, Legacy heisst 16-Bit-Code aus der BIOS-Zeit, Disabled heisst gar nicht laden.

Bei mir steht überall EFI, was zum restlichen System passt, denn Legacy-Boot ist auf diesem Board abgeschaltet. Interessant ist eher, dass man diese Liste überhaupt hat. Auf einem Desktopboard gibt es allenfalls einen Schalter für alle. Hier kann man pro Steckplatz entscheiden.

Wozu? Zwei Gründe. Erstens Startzeit: jedes Option ROM kostet Zeit, und Netzwerkkarten sind darin führend, weil sie auf Link warten. Zweitens Angriffsfläche: das ist fremder Code, der vor dem Betriebssystem mit vollen Rechten läuft. Wer die Karte nur unter Linux nutzt und nie davon bootet, verliert durch Disabled nichts.

Ich habe einen konkreten Kandidaten dafür. Meine X710 meldet auf der Driver-Health-Seite des BIOS Failed, weil ihr UEFI-Treiber älter ist als die Firmware, die ich vor einer Weile aktualisiert habe. Die Karte funktioniert unter Linux tadellos, nur der Vorstart-Code beschwert sich über sich selbst. CPU SLOT6 OPROM auf Disabled, und die Meldung wäre weg. Kostenpunkt: kein PXE-Boot über diese Karte, was ich noch nie gebraucht habe. Dazu mehr in Teil 13.

VGA Priority

VGA Priority                      [Offboard]

Dieses Board hat eine eingebaute Grafik. Sie sitzt im Verwaltungscontroller, dem ASPEED AST2600, und ihr einziger Zweck ist die Fernkonsole. Sie ist grottig, das ist Absicht, sie soll ein Terminal darstellen und sonst nichts.

VGA Priority entscheidet, welche Karte das Bild beim Start bekommt. Offboard heisst: die Steckkarte. Genau so meldet es das laufende System:

cat /sys/bus/pci/devices/0000:51:00.0/boot_vga    # 1  (RTX 4060 Ti)
cat /sys/bus/pci/devices/0000:03:00.0/boot_vga    # 0  (AST2600)

Ganz abschalten lässt sich die eingebaute Grafik nicht, und das ist auch gut so: sie hängt am Verwaltungscontroller, und wer sie loswürde, hätte auch keine Fernkonsole mehr. Genau über die habe ich diese ganze Serie aufgezeichnet. IPMI und so halt, Video aufnehmen, Bilder heraus kopieren usw….

Eine Kleinigkeit, die mir erst beim zweiten Mal aufgefallen ist

Die Liste oben endet bei Onboard NVMe2 Option ROM. In meiner ersten Aufzeichnung war das letzte, was ich hatte, Onboard NVMe1, weil ich nicht weit genug gescrollt hatte. Der Hilfetext auf derselben Seite sprach aber von NVMe2, es musste also noch etwas darunter geben.

Nächste Folge: die dritte und letzte PCIe-Folge. ASPM, eDPC und die Frage, wer eigentlich mitbekommt wenn auf einer PCIe-Verbindung Fehler auftreten. Bei mir war die Antwort eine Zeit lang: niemand.

Siehe auch

Falls jemand von euch Option ROMs gezielt abgeschaltet und dabei messbar Startzeit gespart hat: wie viel war es? Ihr dürft mich jederzeit fragen.
BIOS erklärt, Teil 8: fünf Steckplätze, 64 Bahnen und warum die Grafikkarte nur die Hälfte nutzt

Als ich diese Maschine geplant habe, stand in meinen Notizen ein Punkt, der mich mehr beschäftigt hat als alles andere: „BIOS, SlimSAS-Port auf x4x4-Bifurcation stellen, sonst wird das Laufwerk am Breakout-Kabel nicht erkannt.“ Ich hatte das irgendwo gelesen, es klang plausibel, und ich habe mich darauf eingestellt, im Setup danach suchen zu müssen.

Dann kam die Hardware, ich habe alles zusammengebaut, die Maschine ging an, das Laufwerk war da. Ich habe die Einstellung nie gefunden, weil es sie nicht gibt. Und das ist eigentlich der beste Einstieg in diese Folge, denn es zeigt genau, was man über PCIe auf einem Serverboard wissen muss: die Lanes sind fest verdrahtet, und das Setup zeigt einem nur, was daraus geworden ist.

Teil 8 der Serie, es geht um `Advanced > Chipset Configuration > North Bridge > IIO Configuration

CPU1 Configuration`. Die anderen Folgen liegen unter

BIOS & Firmware.

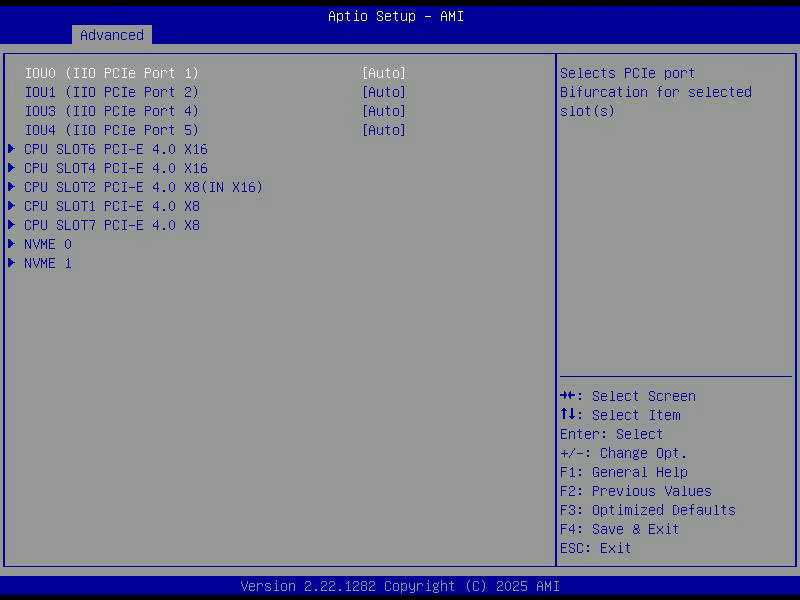
Die Seite

Aptio Setup, CPU1 Configuration, mit der Bifurcation der vier IOU und der Liste aller PCIe-Steckplätze
IOU0 (IIO PCIe Port 1)            [Auto]
IOU1 (IIO PCIe Port 2)            [Auto]
IOU3 (IIO PCIe Port 4)            [Auto]
IOU4 (IIO PCIe Port 5)            [Auto]
> CPU SLOT6 PCI-E 4.0 X16
> CPU SLOT4 PCI-E 4.0 X16
> CPU SLOT2 PCI-E 4.0 X8(IN X16)
> CPU SLOT1 PCI-E 4.0 X8
> CPU SLOT7 PCI-E 4.0 X8
> NVME 0
> NVME 1

Oben vier Einstellungen, unten sieben Untermenüs. Die vier oben sind die eigentliche Verteilung, die sieben unten sind das Ergebnis.

Mein Xeon Gold 5315Y stellt 64 PCIe-Bahnen der Generation 4 bereit. Diese 64 Bahnen sind im Prozessor in Blöcken organisiert, den IOUs, und jeder Block liefert 16 Bahnen. Vier Blöcke, 64 Bahnen. Was das Board daraus macht, ist Sache des Boardlayouts: hier sind es zwei Steckplätze mit sechzehn Bahnen, drei mit acht, und zwei Anschlüsse für NVMe-Laufwerke mit je vier.

Bifurcation, und warum sie mir keine Sorgen mehr macht

Bifurcation heisst wörtlich Gabelung, und gemeint ist das Aufteilen eines Blocks. Ein IOU mit sechzehn Bahnen kann als ein einziger x16-Anschluss auftreten oder als zwei x8 oder als vier x4. Das muss die Firmware wissen, bevor sie die Geräte aufzählt, denn danach ist die Aufteilung festgelegt.

Der klassische Anwendungsfall sind Adapterkarten, die vier NVMe-Laufwerke in einen einzigen x16-Steckplatz stecken. Ohne x4x4x4x4-Bifurcation sieht das Board nur das erste Laufwerk, oder gar keins. Genau davor hatte ich Respekt.

Auf diesem Board stehen alle vier Blöcke auf Auto, und das ist auch richtig so. Auto heisst, dass die Firmware beim Start selbst herausfindet, was steckt, und entsprechend aufteilt. Von Hand einstellen muss man nur, wenn eine Karte sich nicht korrekt meldet, was bei billigen passiven Adaptern vorkommt.

Und meine NVMe-Anschlüsse? Die sind gar nicht Teil dieser Aufteilung. NVME 0 und NVME 1 sind eigenständige Anschlüsse mit je vier fest zugeordneten Bahnen. Da ist nichts zu gabeln, weil da nichts zusammenhängt. Meine ursprüngliche Sorge war schlicht unbegründet, und ich lasse das hier so stehen, weil ich vermute, dass ich damit nicht der einzige bin.

Was in einem Slot-Untermenü steht

Jeder der sieben Einträge öffnet dieselbe Maske:

Link Speed                        [Auto]
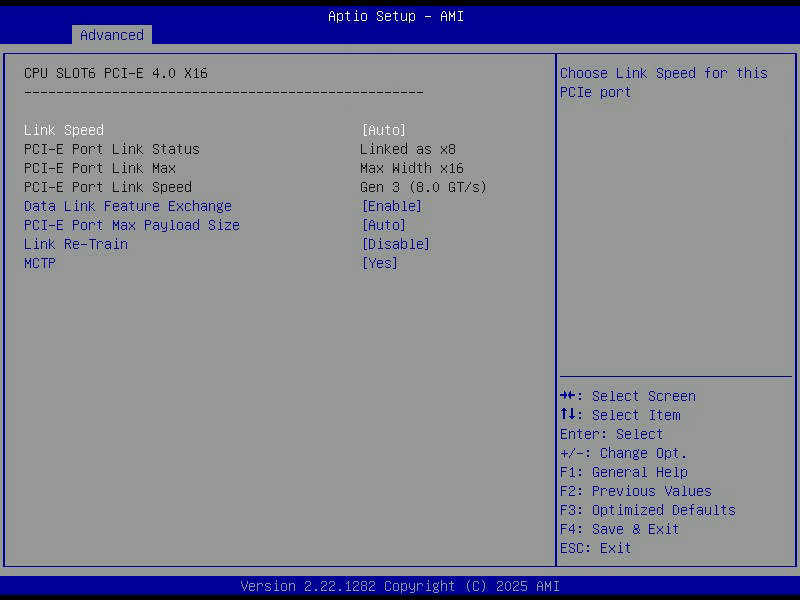
PCI-E Port Link Status            Linked as x8
PCI-E Port Link Max                Max Width x16
PCI-E Port Link Speed              Gen 4 (16.0 GT/s)
Data Link Feature Exchange        [Enable]
PCI-E Port Max Payload Size       [Auto]
Link Re-Train                     [Disable]
MCTP                              [Yes]

Die drei mittleren Zeilen sind reine Anzeige und die interessantesten der ganzen Folge. Link Max ist, was der Steckplatz elektrisch könnte. Link Status ist, worauf sich Board und Karte tatsächlich geeinigt haben. Weichen die beiden voneinander ab, gibt es dafür immer einen Grund, und der ist nicht immer ein Problem.

MCTP steht für Management Component Transport Protocol. Darüber kann der Verwaltungscontroller des Boards mit Karten reden, die das unterstützen, etwa um Temperaturen oder Firmwarestände abzufragen, ohne dass das Betriebssystem beteiligt ist. Auf einem Serverboard eine Selbstverständlichkeit, auf einem Desktopboard undenkbar.

Link Re-Train erzwingt eine neue Aushandlung der Verbindung. Das ist ein Diagnosewerkzeug für den Fall, dass ein Link mit weniger Bahnen oder niedrigerer Geschwindigkeit hochkommt als er sollte.

Die Belegung meiner Maschine

Aptio Setup, Untermenü CPU SLOT6, die Netzwerkkarte mit Linked as x8

Alle sieben Untermenüs durchgeklickt ergibt folgendes Bild:

CPU SLOT4  x16    Linked as x8            Gen 4     RTX 4060 Ti
CPU SLOT6  x16    Linked as x8            Gen 3     Intel X710, 2x 10G SFP+
CPU SLOT2  x8     Link Did Not Train      -         leer
CPU SLOT1  x8     Link Did Not Train      -         leer
CPU SLOT7  x8     Link Did Not Train      -         leer
NVME 0     x4     Linked as x4            Gen 4     Samsung PM1735
NVME 1     x4     Linked as x4            Gen 4     Samsung PM1735

Link Did Not Train klingt nach Fehler und heisst nur: da steckt nichts. Ein PCIe-Link handelt sich beim Start aus, und wenn am anderen Ende niemand antwortet, kommt eben keine Verbindung zustande.

Warum die Grafikkarte nur acht Bahnen bekommt

Das ist die Zeile, an der ich zuerst hängen geblieben bin. Die RTX 4060 Ti steckt in einem Steckplatz mit sechzehn Bahnen, das Board kann sechzehn, und trotzdem sagt das Setup Linked as x8.

Die Erklärung ist unspektakulär und liegt nicht am Board: der AD106-Chip auf dieser Karte hat physisch nur acht Bahnen. Nvidia hat das bei der 4060er Generation so entworfen und dafür einiges an Kritik eingesteckt, vor allem weil die Karte in älteren Rechnern mit PCIe 3.0 dann nur noch auf der Hälfte der Hälfte läuft. Bei mir ist es Gen 4 mit acht Bahnen, das entspricht Gen 3 mit sechzehn, und damit ist die Karte nicht ausgebremst.

Ein anderer Steckplatz würde daran nichts ändern. Das Limit sitzt auf der Karte.

Die X710 daneben ist der umgekehrte Fall: Gen 3 statt Gen 4, ebenfalls acht Bahnen. Auch das ist die Karte, sie ist schlicht älter. Acht Gen-3-Bahnen sind rund 8 GB pro Sekunde, für zwei 10-Gbit-Ports vollkommen ausreichend. Verschwendet ist nur, dass sie in einem Steckplatz sitzt der mehr könnte.

Der Fehler den ich fast gemacht hätte

Und jetzt der Teil, den ich für den nützlichsten dieser Folge halte. Als ich nach dem Zusammenbau im laufenden System nachgesehen habe, ob die Grafikkarte richtig angebunden ist, stand da das:

lspci -vv -s 51:00.0 | grep LnkSta
#   LnkSta: Speed 2.5GT/s (downgraded), Width x8 (downgraded)

2.5GT/s ist PCIe 1.0. Auf einer Gen-4-Karte in einem Gen-4-Steckplatz. Zweimal downgraded. Ich war kurz davor, das Kabel, den Slot und meine Lebensentscheidungen zu hinterfragen.

Es ist völlig normal. Moderne Grafikkarten takten ihren PCIe-Link im Leerlauf herunter, genau wie sie ihren Chiptakt herunterfahren. Wer im Leerlauf misst, misst den Leerlauf. Mit ein bisschen Last sieht es anders aus:

# waehrend eine Videokodierung laeuft
nvidia-smi --query-gpu=pcie.link.gen.current,pcie.link.width.current --format=csv
#   4, 8

Gen 4, acht Bahnen. Genau das, was das BIOS anzeigt.

Der Merksatz daraus, und der gilt für jede Grafikkarte: PCIe-Linkbreite und -geschwindigkeit niemals im Leerlauf beurteilen. Ein statisches lspci an einer Nvidia-Karte sagt praktisch nichts. Man braucht Last während der Messung, sonst jagt man einem Phantom hinterher.

Bei der NVMe ist das übrigens anders, die steht dauerhaft auf 16GT/s, Width x4. Solche Laufwerke drosseln ihren Link nicht in dieser Form.

Vier Bahnen für die NVMe, und warum das Absicht war

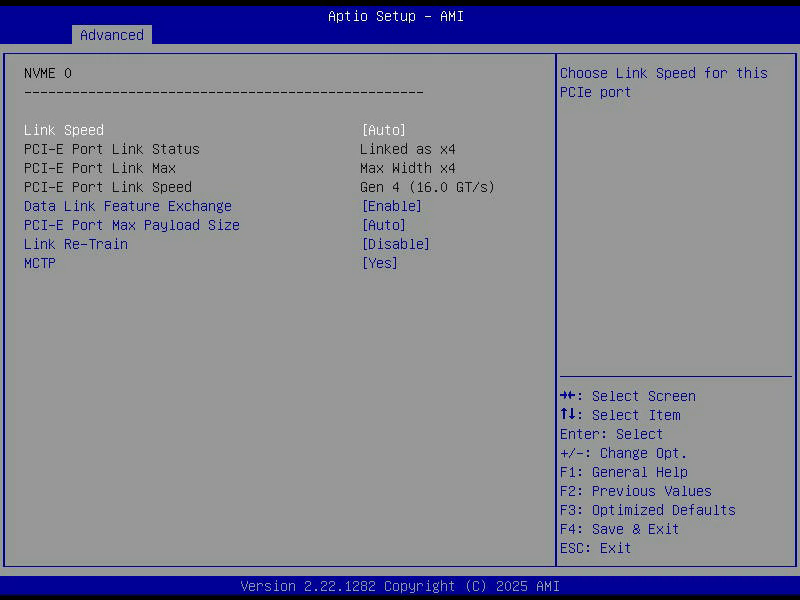
Aptio Setup, Untermenü NVME 0, das Laufwerk meldet Linked as x4 mit PCIe der vierten Generation
NVME 0
PCI-E Port Link Status            Linked as x4
PCI-E Port Link Max               Max Width x4
PCI-E Port Link Speed             Gen 4 (16.0 GT/s)

Die Samsung PM1735 ist eigentlich ein x8-Laufwerk. Sie hängt bei mir an einem Kabel, das einen SlimSAS-Anschluss mit acht Bahnen auf zwei Anschlüsse mit je vier aufteilt. Damit laufen zwei Laufwerke statt einem, jedes mit der Hälfte der Anbindung.

Das war eine bewusste Entscheidung beim Kauf, und mit etwas Abstand war es die richtige. Vier Gen-4-Bahnen sind theoretisch knapp 8 GB pro Sekunde. Gemessen habe ich mit vier parallelen Lesevorgängen 4,6 GB pro Sekunde, und das ist noch nicht die Obergrenze, weil das Werkzeug das ich benutzt habe immer nur eine Anfrage gleichzeitig offen hat.

Wie ich das Gefühl habe, dass die zweite Hälfte des Kabels sinnvoller investiert war als die zweiten vier Bahnen: inzwischen hängt dort ein zweites Laufwerk. Der Anschluss NVME 1, der bei meiner ersten Aufnahme noch Link Did Not Train meldete, zeigt jetzt ebenfalls Linked as x4. Und wieder war dafür im BIOS nichts einzustellen.

Fazit

PCIe-Verteilung auf einem Serverboard ist unspektakulärer als ihr Ruf. Die Lanes liegen fest, die Firmware zählt auf, das Setup zeigt das Ergebnis. Die drei Anzeigezeilen in den Slot-Untermenüs sind ein besseres Diagnosewerkzeug als alles, was man im laufenden System zusammensucht, weil sie den Zustand vor dem Betriebssystem zeigen und ohne Stromsparzustände.

Nächste Folge: die andere PCIe-Seite. Above 4G Decoding, Resizable BAR, SR-IOV, und die lange Liste der Option ROMs.

Siehe auch

Falls jemand von euch bei Link Did Not Train schon mal eine echte Ursache gefunden hat und nicht nur einen leeren Steckplatz, erzähl mir davon. Ihr dürft mich gerne fragen.

Anthropic Cyber Verification Program: wie ich Claude für Security-Arbeit freigeschaltet habe und für wen sich das lohnt

Heute hat mich mitten in einer Session in Claude Code diese Meldung erwischt:

● Opus 5.5's safeguards stopped the response above · continuing once with that noted

● Opus 5.5's safeguards flagged this session. You may be seeing this for the first time on an Opus model: Opus 5.5 is more capable and has stronger safeguards as a result, which can sometimes flag non-cybersecurity work. We're improving these safeguards to reduce the amount of incorrectly flagged messages. Opus 4.8 is answering instead, or you can edit and retry with Opus 5.5. Send feedback with /feedback or learn more: https://support.claude.com/en/articles/8106465

  Details: `[cyber]`
Anthropic Cyber Verification Program mit gesperrter Claude-Security-Anfrage, Identitätsprüfung und anschließend freigeschaltetem Zugriff für Security-Research.

Übersetzt heißt das: Ein Klassifikator hat meine Anfrage in die Schublade cyber gesteckt, Opus 5.5 hat die Antwort abgebrochen und ein schwächeres Modell hat übernommen. Der Modellwechsel ist ein vorgesehener Schutzmechanismus, auch wenn die Einstufung im Einzelfall ein Fehlalarm sein kann. Anthropic hat für bestimmte Security-Themen einen Riegel vorgeschoben, und wer dadurch bei legitimer defensiver Arbeit ausgebremst wird, kann sich um eine Freischaltung bewerben. Das Ganze heißt Cyber Verification Program, kurz CVP. Ich habe das heute durchgezogen und schreibe hier auf, warum es das gibt, für wen es gedacht ist und wie die Freischaltung abläuft. Weil öhm ja hilft vielleicht jemandem von euch.

Was hinter der Meldung steckt

Opus 5 und Opus 5.5 laufen nicht nackt. Jede Anfrage geht durch automatische Prüfungen, und die schauen nicht nur auf die letzte Nachricht. Laut Anthropics Hilfeseite zum Modellwechsel schauen die Klassifikatoren auf alles, was das Modell liest: Memory, Inhalte aus Connectors, Ergebnisse der Websuche und Dateien. Ein Fallback kann also auch durch etwas ausgelöst werden, das du gar nicht selbst getippt hast. Das könnte erklären, warum es mich in einer Session erwischt hat, in der ich eigentlich gar nichts Offensives vorhatte. Zum Beispiel, als ich diesen PHP, nein FreeBSD-rtld-Bug verfolgt habe, bin ich ein paar Mal an diesen Punkt gekommen.

Schlägt der Cyber-Klassifikator bei Opus 5 oder Opus 5.5 an, kann die Anfrage bei eingeschaltetem automatischem Modellwechsel auf Opus 4.8 zurückfallen. Als Beispiele nennt Anthropic Exploit-Generierung, das Scannen von Binaries nach Schwachstellen und Penetrationstests. Sicheres Programmieren, Quellcode nach Schwachstellen durchsuchen und Security-Issues sortieren soll dagegen weiter auf den großen Modellen laufen. Der Wechsel ist transparent, die Meldung oben ist genau dieser Hinweis. Wer den automatischen Wechsel nicht will, kann ihn in Claude Code unter Config > MODEL & OUTPUT abschalten, dann pausiert die Unterhaltung stattdessen.

Warum ich den Riegel richtig finde

Ich bin immer mal wieder als Security-Researcher unterwegs. Wenn mir irgendwo etwas auffällt, melde ich das nach Responsible Disclosure an die Betreiber. Der eine oder andere Leser erinnert sich vielleicht noch an eine etwas seltsame E-Mail oder einen noch seltsameren Anruf von mir, weil seine IP-Kamera offen im Netz hing :-). Bei genau dieser Arbeit bietet sich eine AI an. Einen Dienst einordnen, eine Konfiguration bewerten, einen Proof of Concept verstehen oder einen sauberen Report schreiben geht damit bei mir deutlich schneller.

Nur ist vieles in der IT-Sicherheit Dual Use. Das Wissen, mit dem ich eine Lücke finde und melde, lässt sich auch nutzen, um sie auszunutzen. Ein Modell, das einem Pentester beim Exploit hilft, kann ebenso jemandem helfen, der in fremde Netze einbrechen will. Dass so etwas nicht einfach jedem offensteht, der damit womöglich Mist baut, finde ich absolut richtig. Ich hätte mir eher Sorgen gemacht, wenn es diesen Riegel nicht gäbe.

Zwei Schubladen: verboten und Dual Use

Anthropic unterscheidet in der Beschreibung der Cyber-Safeguards zwei Kategorien, der Unterschied ist für das Verständnis wichtig:

  • Prohibited use: Dinge, die fast nur böswillig genutzt werden und kaum einen defensiven Zweck haben, etwa massenhafte Datenexfiltration oder die Entwicklung von Ransomware. Das bleibt gesperrt, daran ändert auch das CVP nichts. Das brauchst du so aber auch eher nicht, das zielt ja in der Regel auf Masse und das Ausnutzen.
  • High Risk Dual Use: Tätigkeiten mit einem legitimen defensiven Zweck, zum Beispiel das Ausnutzen von Schwachstellen im Rahmen eines Tests oder die Entwicklung offensiver Security-Werkzeuge. Standardmäßig gesperrt, aber genau hier setzt das CVP an. Das brauch ich und öhm du vielleicht auch?!

Das Programm ist also kein Generalschlüssel. Es verschiebt die Grenze für Leute, bei denen Anthropic nachvollziehen kann, wer sie sind und wofür sie das brauchen.

Für wen das Programm gedacht ist

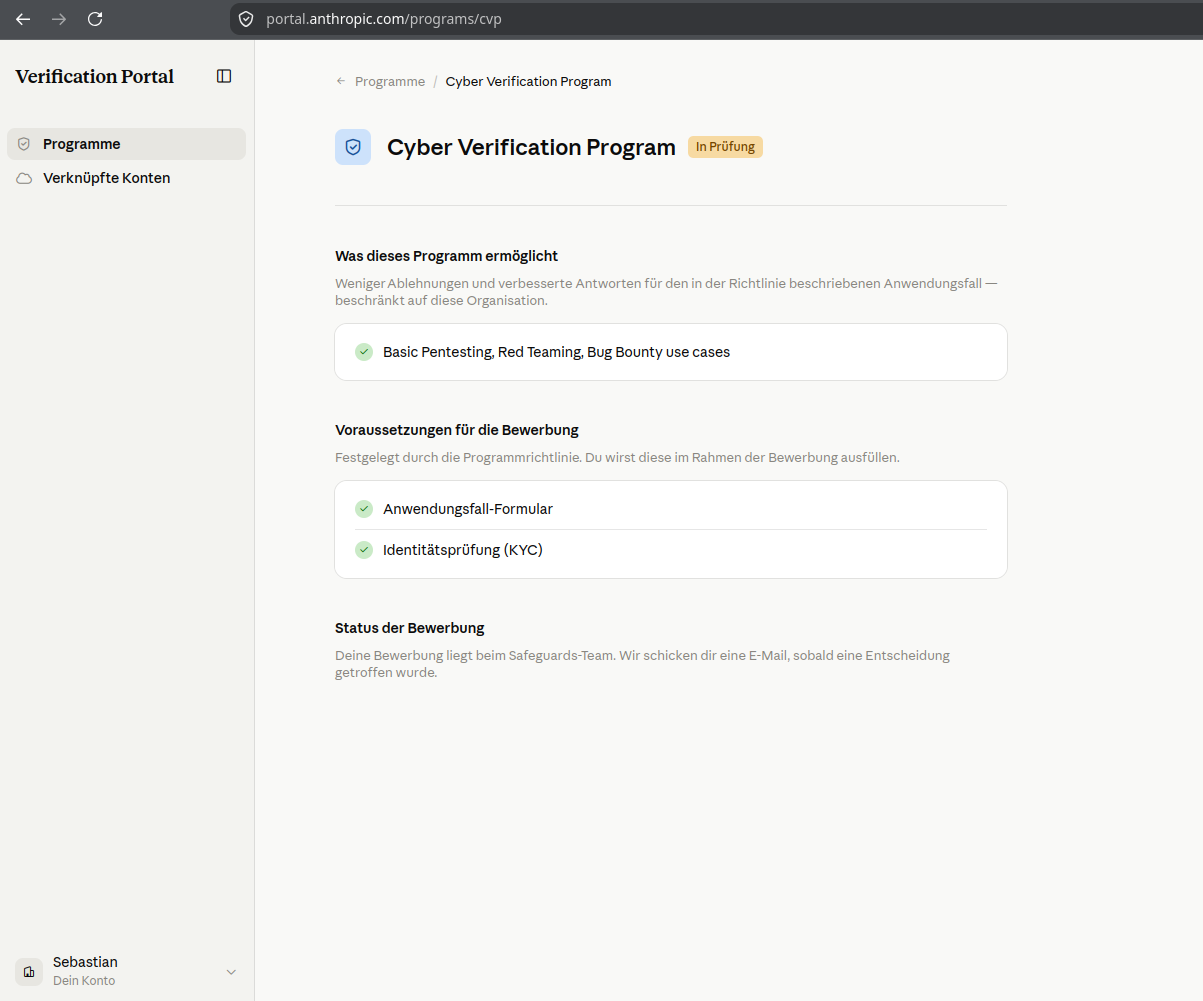
Das Portal nennt als Anwendungsfälle des Programms ganz nüchtern Basic Pentesting, Red Teaming, Bug Bounty use cases. Gemeint sind also Pentester, Red Teams, Bug-Bounty-Jäger und alle, die Schwachstellen suchen, um sie zu schließen oder zu melden. Das Programm ist kostenlos. Wer dagegen nur sicheren Code schreiben oder den eigenen Quellcode prüfen will, braucht es in der Regel nicht, das läuft auch ohne.

Ein paar Einschränkungen solltest du vorher kennen:

  • Die Freigabe hängt an einer Organisation, nicht an deiner Person. Bewirbst du dich mit deinem privaten Konto, gilt sie nicht automatisch im Team-Konto deines Arbeitgebers und umgekehrt.
  • Laut Hilfeseite können nur autorisierte Admins der jeweiligen Organisation die Bewerbung im Portal aufrufen. Bei meinem privaten Konto war ich das selbst, im Firmenkonto muss das also der Admin erledigen.
  • Organisationen mit Zero Data Retention sind derzeit ausgeschlossen. Das passt dazu, dass bei mir eine Datenspeicherung Bedingung für das aktive Programm ist (dazu gleich mehr).
  • Wer Claude über Anthropic direkt nutzt, also claude.ai, Claude Code oder die API, bewirbt sich über das Verification Portal. Für Microsoft Foundry, Claude auf AWS und Google Cloud gibt es eigene Wege, auf Amazon Bedrock gibt es das Programm derzeit nicht. Bei Drittanbietern, die Claude in ihre Produkte einbauen, musst du den jeweiligen Anbieter fragen.

So läuft die Bewerbung ab

Los geht es im Verification Portal unter portal.anthropic.com/programs/cvp. Dort meldest du dich mit deinem Anthropic-Konto an und wählst das Cyber Verification Program aus. Bei mir sah der Ablauf so aus:

  1. Identität bestätigen: Zuerst musst du dich mit einem amtlichen Lichtbildausweis ausweisen, im Portal heißt das Identitätsprüfung (KYC). Details dazu im nächsten Abschnitt.
  2. Anwendungsfall beschreiben: Danach folgt ein Formular mit ein paar Fragen dazu, was du machst und wofür du die Freischaltung brauchst.
  3. Belege angeben: Dazu gehören ein paar öffentlich nachprüfbare Dinge, die zeigen, dass du dich für das Programm qualifizierst. Bei mir waren das unter anderem dieser Blog und meine öffentlichen Profile. Mein Tipp: Beschreibe deine Tätigkeit möglichst nachvollziehbar und nenne Belege, die jeder selbst prüfen kann.
  4. Prüfung abwarten: Anschließend liegt alles beim Safeguards-Team von Anthropic. Das Team prüft die Bewerbung, und wird sie genehmigt, ist das Programm für deine Organisation aktiv. Die Entscheidung kommt per E-Mail.
Verification Portal von Anthropic mit dem Cyber Verification Program im Status In Prüfung. Freigeschaltet werden sollen Basic Pentesting, Red Teaming und Bug Bounty, als Voraussetzungen sind Anwendungsfall-Formular und Identitätsprüfung abgehakt.
Bewerbung abgeschickt: Anwendungsfall und Identitätsprüfung erledigt, jetzt ist das Safeguards-Team dran.

Anthropic peilt laut eigener Aussage eine Entscheidung innerhalb von zwei Werktagen an. Bei mir ging es deutlich schneller, zwischen den beiden Screenshots in diesem Beitrag liegt nicht einmal eine halbe Stunde. Darauf würde ich mich aber nicht verlassen.

Die Identitätsprüfung: was mit deinem Ausweis passiert

Den Ausweis irgendwo hochzuladen ist nichts, was ich leichtfertig mache. Deshalb habe ich mir angeschaut, was Anthropic dazu auf der Seite zur Identitätsprüfung schreibt. Die Prüfung macht der Dienstleister Persona. Du brauchst den echten, physischen Ausweis in der Hand und ein Handy mit Kamera, gegebenenfalls für ein Live-Selfie. Akzeptiert werden gültige amtliche Lichtbildausweise, als Beispiele nennt Anthropic Reisepass, Personalausweis und Führerschein. Kopien, Scans, Fotos von Fotos und digitale Ausweise werden nicht akzeptiert.

Ausweisbild und Selfie liegen laut Anthropic bei Persona und nicht auf den eigenen Systemen. Anthropic greift nur bei Bedarf darauf zu, etwa bei einem Einspruch, und kopiert die Bilder nicht. Die Daten dienen laut Anthropic der Verifizierung, der Betrugsprävention und rechtlichen sowie sicherheitsbezogenen Pflichten. Zum Training der Modelle werden sie nicht verwendet, und außer Anthropic und den Verifizierungspartnern bekommt sie niemand, es sei denn, es gibt eine gesetzliche Pflicht zur Herausgabe. Ob man dem vertraut, muss jeder selbst entscheiden. Für mich war das in Ordnung, schließlich will ich ja gerade, dass Anthropic weiß, wer da Exploits bespricht.

Die Bedingungen, damit es aktiv bleibt

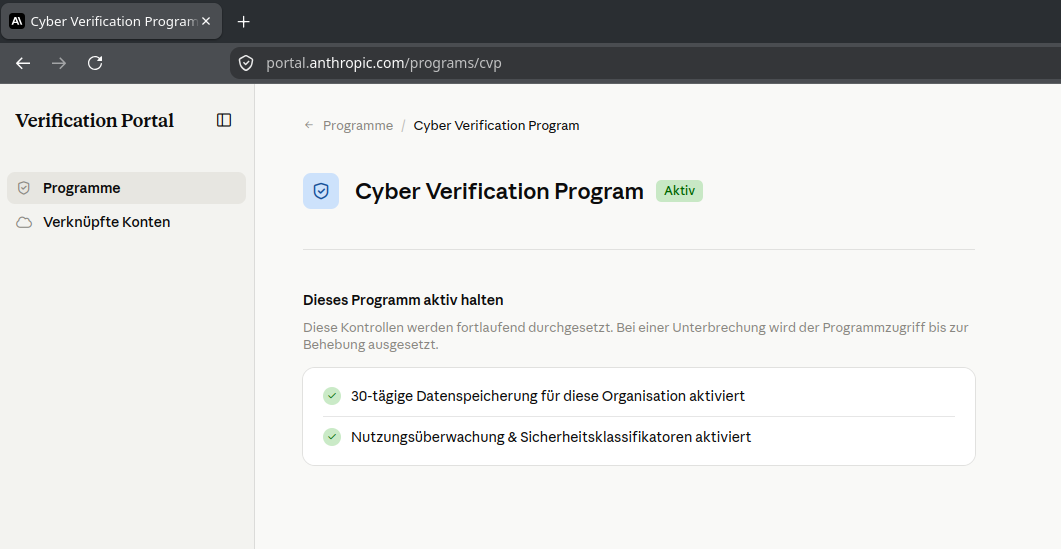
Nach der Freigabe steht das Programm im Portal auf Aktiv. Darunter stehen zwei Bedingungen, die laut Portal fortlaufend durchgesetzt werden:

  • 30-tägige Datenspeicherung für die Organisation
  • Nutzungsüberwachung und Sicherheitsklassifikatoren
Verification Portal von Anthropic mit dem Cyber Verification Program im Status Aktiv. Unter Dieses Programm aktiv halten sind die 30-tägige Datenspeicherung für die Organisation sowie Nutzungsüberwachung und Sicherheitsklassifikatoren als aktiviert markiert.
Freigegeben: Das Programm ist aktiv, solange Datenspeicherung und Überwachung eingeschaltet bleiben.

Fällt eine davon weg, ruht der Zugang, bis das behoben ist. Das ist der eigentliche Deal hinter dem Programm: Du bekommst mehr Spielraum, dafür akzeptierst du für deine Organisation eine 30-tägige Datenspeicherung sowie Nutzungsüberwachung und Klassifikatoren. Zusammen mit der Identitätsprüfung macht das Missbrauch deutlich besser nachvollziehbar. Ich finde diesen Tausch fair, für meine Arbeit waren die Bedingungen kein Problem.

Was das Programm nicht kann

Ein Punkt hat mich beim Nachlesen überrascht, und er betrifft genau die Meldung vom Anfang. Opus 5.5 ist derzeit noch nicht Teil des Cyber Verification Program. Anthropic schreibt, dass das Programm bald auf Opus 5.5 ausgeweitet werden soll. Bis dahin kann es dir auch mit aktivem CVP passieren, dass Opus 5.5 bei einer Cyber-Anfrage auf Opus 4.8 zurückfällt. Der Unterschied ist, dass die Dual-Use-Sperren auf Opus 4.8 dann gelockert sind. Laut Anthropic steht Organisationen, die Opus 4.8 über das CVP nutzen, außerdem Opus 5 mit weniger Cyber-Einschränkungen zur Verfügung.

Außerdem gilt weiter:

  • Die verbotene Kategorie bleibt verboten, auch mit Freigabe.
  • Auch freigeschaltete Nutzer können bei legitimer Arbeit noch geblockt werden. Anthropic schreibt das offen und arbeitet nach eigener Aussage daran.
  • Wirst du trotz Freigabe geblockt, prüfe zuerst, ob du in der richtigen Organisation angemeldet bist. Die Organisations-ID steht in der Bestätigungsmail. Hilft das nicht, gibt es ein Formular für Fehlalarme und Einsprüche, das auch nach einer Ablehnung der Bewerbung der richtige Weg ist.

Und bei OpenAI?

OpenAI geht für ChatGPT und Codex einen ähnlichen Weg. Die Security-Angebote dort laufen unter dem Namen Daybreak, Einzelpersonen stellen einen Antrag auf Trusted Access, den Einstieg dafür findest du unter chatgpt.com/cyber. Auch dort gehört eine Identitätsprüfung dazu, und auch dort garantiert sie keine Zulassung. Als ich mir das angeschaut habe, war für die Validierung allerdings ein größerer Account nötig. Bei Anthropic habe ich weder in der Doku noch in der Bewerbung eine Vorgabe zu einem bestimmten Abo gefunden, bei mir ging es ohne großen Account weiter. Das finde ich besser geregelt, denn gerade wer nebenbei Lücken sucht und meldet, hat nicht unbedingt das teuerste Paket.

Mein Fazit

Wer Sicherheitsforschung, Pentests oder Bug Bounty macht und dafür Claude nutzt, kann jederzeit über so eine Meldung stolpern. Dann lohnt sich das CVP. Die Bewerbung hat mich eine gute Viertelstunde gekostet, der Ausweis war das Aufwendigste daran. Im Gegenzug akzeptierst du Datenspeicherung und Überwachung, und genau so sollte das bei Werkzeugen dieser Klasse aus meiner Sicht auch sein. Wer diese Bedingungen nicht will oder nicht erfüllen kann, sollte sich ehrlich fragen, wofür er die Freischaltung eigentlich braucht.

Siehe auch:

Wenn ihr Fragen habt, dann dürft ihr mich sehr gerne fragen.

RFC 9989 löst RFC 7489 ab: was sich für DMARC wirklich ändert

Beitragsbild zu RFC 9989 und DMARC, Vergleich mit RFC 7489, neuen DMARC-Tags und E-Mail-Sicherheitsdarstellung

Stefan Haun von cyberscale.io hat mir per Mail einen Hinweis geschickt: mein alter Beitrag zu DMARC bezieht sich auf RFC 7489, das seit Mai 2026 durch RFC 9989 abgelöst ist. Der Hinweis kam, so fühlt es sich für mich an, ggf. im Rahmen von Linkbuilding, mit Verweis auf seinen eigenen Guide zu DKIM und DMARC. Das schmälert die fachliche Korrektheit des Hinweises nicht, deshalb hier der ehrliche Dank und der längst überfällige Nachtrag. Mitbekommen hatte ich die neue RFC schon vor einer Weile, geschrieben aber noch nichts, weil es bei einem frischen RFC erstmal eine Zeit braucht, bis sich das in der Praxis herumspricht und Implementierungen nachziehen. Genau dieser Verzug taucht unten beim Praxis-Check nochmal auf.

Was RFC 9989 überhaupt ist

In der Community läuft das Projekt unter dem Namen DMARCbis. Anders als der Name vermuten lässt, ist daraus keine einzelne neue RFC geworden, sondern drei:

  • RFC 9989, die Kernspezifikation: Policy, Alignment, die Tags im Record.
  • RFC 9990, die aggregierten Reports, also die täglichen XML-Berichte.
  • RFC 9991, die Failure Reports, das ARF-Format pro Nachricht.

Alle drei tragen offiziell „Obsoletes: 7489“ im Kopf, RFC 9989 zusätzlich noch „Obsoletes: 9091“ (der 2021 veröffentlichte, experimentelle Vorläufer, der np und die Public-Suffix-Domain-Idee einführte und dessen Inhalt RFC 9989 jetzt vollständig integriert und ersetzt). Dazu ein Reifegrad-Sprung, der eine eigene Erwähnung wert ist: RFC 7489 war „Informational“, RFC 9989 ist „Standards Track“, also auf dem offiziellen Weg zum Internet Standard. DMARC verlässt damit den Status der informellen Beschreibung eines etablierten Verfahrens und wird zu einer echten IETF-Spezifikation.

Die Tags: drei raus, drei gegenüber RFC 7489 neu

Der eigentliche technische Kern steckt in der Menge der Policy-Tags im Record. Drei Tags sind aus der aktiven Spezifikation gestrichen (in der IANA-Registry stehen sie weiterhin, nur als historic markiert), drei sind gegenüber RFC 7489 neu, wobei np davon eigentlich ein Wiedersehen ist:

Entfernt (RFC 7489)Neu gegenüber RFC 7489 (RFC 9989)
pct, Prozent-Rollout der Policyt, expliziter Test-Modus
rf, Report-Format, quasi nie genutztnp, Policy für nicht existierende Subdomains, importiert aus RFC 9091
ri, Report-Intervall, von Empfängern ignoriertpsd, Public-Suffix-Domain-Flag

rf und ri werden von einem RFC-9989-konformen Empfänger nicht mehr ausgewertet, RFC 9989 selbst nennt für die Streichung keine ausführlichere Begründung als das Fehlen praktischer Relevanz. pct ist der interessantere Fall, dazu gleich mehr.

t: der Testmodus, der pct ersetzt

t=n ist der Default und bedeutet normale Durchsetzung. t=y setzt die in p, sp oder np konfigurierte Policy eine Stufe herab: aus reject wird quarantine, aus quarantine wird none. Reports laufen dabei unverändert weiter, man sieht also weiterhin, wer durchfallen würde. RFC 9989 selbst nennt t ausdrücklich nur einen Ersatz für einen Teil der alten pct-Funktionalität, nämlich für die beiden Randwerte: t=n und t=y sollen sich bei Empfängern und Zwischenstationen analog zu pct=100 und pct=0 verhalten, nicht zu jedem beliebigen Prozentwert dazwischen. pct=0 unter RFC 7489 führte nach Abschnitt 6.6.4 bei reject ebenfalls schon zu quarantine statt zu gar keiner Reaktion, t=y übernimmt diesen einen Spezialfall, nur ohne Prozentrechnung. Für einen echten Teil-Rollout mit Werten zwischen 0 und 100 gibt es dagegen keinen direkten Nachfolger, dazu unten mehr.

np: eine eigene Stufe für nicht existierende Subdomains

Unter RFC 7489 galt für Mail von einer Subdomain, egal ob sie einen eigenen DNS-Eintrag hat oder nicht, immer dieselbe Regel: sp, falls gesetzt, sonst p. Eine Subdomain, die gar nicht existiert, zum Beispiel irgendwas.example.com, wo irgendwas nie angelegt wurde, bekam also exakt dieselbe Policy wie eine echte, konfigurierte Subdomain. Genau das ist ein bekanntes Spoofing-Einfallstor, weil sich beliebige, nie existierende Namen fälschen lassen, für die es nie eine eigene Policy gab. np schafft jetzt erstmals eine eigene, von sp und p unterscheidbare Stufe genau für diesen Fall. Neu erfunden ist das Tag dabei nicht: RFC 9989 übernimmt es wörtlich aus dem 2021 veröffentlichten, experimentellen RFC 9091, das mit RFC 9989 ebenfalls obsolet wird, und macht daraus einen festen Bestandteil der Hauptspezifikation. Fehlt np weiterhin, fällt die Regel auf sp zurück, falls gesetzt, sonst auf p, genau wie in RFC 9989 Abschnitt 4.7 definiert. Wer schon vorher ein striktes sp=reject gesetzt hatte, bekommt also weiterhin exakt das gleiche Verhalten wie zuvor, nur jetzt mit der Möglichkeit, es bei Bedarf davon zu lösen.

DNS-Tree-Walk statt Public Suffix List, psd markiert die Grenze

Die eigentliche Änderung ist strukturell: RFC 9989 löst die Bestimmung der Organizational Domain von der statischen, extern gepflegten Public Suffix List und ersetzt sie durch einen DNS-Tree-Walk-Algorithmus. psd (Werte y, n, u, Default u) liefert dafür die expliziten Grenzmarkierungen: psd=y setzt ein Public Suffix Operator auf seinem eigenen Record, um zu sagen, dass darunter fremde, eigenständige Organizational Domains beginnen, psd=n sagt umgekehrt, dass genau diese Domain die Organizational Domain für sich und ihre Subdomains ist. Relevant ist das vor allem für Registries und Hoster, die selbst öffentlich registrierbare Second-Level-Domains betreiben, also Strukturen wie bei .co.uk. RFC 9989 weist ausdrücklich darauf hin, dass Public-Suffix-List-Auflösung und Tree-Walk in Einzelfällen zu unterschiedlichen Ergebnissen kommen können. Für eine gewöhnliche Domain wie diese hier, ohne PSO-Rolle, ändert sich am eigenen Verhalten dadurch nichts.

Macht das bestehende Records ungültig? Nein, by design, mit einer Ausnahme in beide Richtungen

DMARC trägt seit RFC 7489 die Regel, dass unbekannte Tags ignoriert werden müssen. RFC 9989 übernimmt das wörtlich und baut die ganze Abwärtskompatibilität darauf auf. Ein alter, nur RFC-7489-konformer Validator, der t oder np nicht kennt, überliest sie einfach und wendet weiterhin p und sp an. Er stürzt dabei nicht ab und verhält sich nicht falsch, er kennt nur die feinere neue Steuerung noch nicht. Das hat aber eine Kehrseite, die man beim Einsatz von t=y kennen sollte: genau derselbe alte Validator ignoriert auch t=y und wendet bei p=reject weiterhin reject in voller Härte an. t=y schützt also nur gegenüber Empfängern, die RFC 9989 bereits verstehen, nicht gegenüber alten Implementierungen. Umgekehrt ignoriert ein RFC-9989-konformer Validator ein vorhandenes pct, weil das Tag schlicht nicht mehr definiert ist.

Genau an dieser Stelle steckt die Nuance, die wehtun kann: wer noch mit pct zwischen 1 und 99 einen echten Teil-Rollout fährt, das klassische schrittweise Hochfahren auf reject mit einem Bruchteil der Nachrichten, bekommt bei einem RFC-9989-konformen Empfänger keine reduzierte Durchsetzung mehr. Das Tag wird ignoriert, die volle in p konfigurierte Policy greift sofort. Einen direkten Nachfolger für genau diesen Zwischenbereich gibt es nicht, t kennt nur an und aus. Wer so einen Teil-Rollout fährt, muss stattdessen auf eine echte Stufenmigration ausweichen, etwa p=none, dann p=quarantine, dann p=reject, mit t=y jeweils als zusätzliche Bremse innerhalb einer Stufe. Nur der Randfall pct=0 hat mit t=y einen echten, direkten Ersatz. Für alle anderen gilt: bestehende v=DMARC1-Records bleiben syntaktisch gültig, niemand muss etwas ändern, um funktionsfähig zu bleiben. Weitgehend kompatibel ist die richtige Beschreibung, additiv dagegen nicht ganz, weil eben doch drei Tags aus der aktiven Auswertung verschwinden und die Organizational-Domain-Bestimmung sich strukturell ändert.

Mailinglisten und die p=reject-Warnung

Abschnitt 7.4 rät Domains, deren Nutzer möglicherweise auf öffentlichen Mailinglisten schreiben, ausdrücklich von p=reject ab. Der Grund ist alt und in RFC 7960 im Detail beschrieben: Listen-Reflektoren brechen die SPF-Alignment, weil die Mail über einen fremden Server läuft, und selbst DKIM-Signaturen überleben nicht jede Listen-Software unverändert. Der konkrete, im RFC-Text selbst genannte Weg ist eine gestufte Migration: zuerst mindestens einen Monat p=none, dann mindestens ebenso lange p=quarantine, jeweils mit Auswertung der Reports, bevor überhaupt über p=reject nachgedacht wird. t=y wird an dieser Stelle im RFC nicht namentlich erwähnt, würde sich als zusätzliche Bremse innerhalb einer Stufe aber inhaltlich genauso eignen wie der frühere pct-Ansatz, das ist an dieser Stelle meine eigene Einordnung, keine RFC-Vorgabe. Wichtig zusätzlich, weil es die Wucht von p=reject etwas relativiert: RFC 9989 verpflichtet Empfänger, nicht allein aufgrund eines p=reject abzulehnen, und schreibt vor, einen DMARC-Fail ohne weitere eigene Erkenntnisse wie quarantine zu behandeln.

RFC 9990: DKIM-Ergebnisse und der Selector werden verbindlicher

In den regelmäßigen, in der Praxis meist täglichen aggregierten XML-Reports war das DKIM-Auth-Ergebnis unter RFC 7489 eher beiläufig spezifiziert. RFC 9990 macht daraus eine klare Pflicht, allerdings nur bedingt: wurde für eine Nachricht überhaupt eine DKIM-Signatur validiert, muss das Ergebnis im Report stehen, eine komplett unsignierte Nachricht braucht weiterhin kein eigenes DKIM-Element. Neu und für die Praxis besonders nützlich ist zusätzlich, dass der verwendete Selector jetzt ebenfalls verpflichtend im Report steht, unter RFC 7489 war er optional. Damit lässt sich aus den Reports direkt ablesen, welcher Selector bei welchem berichtenden Mail-Receiver (nicht) verifiziert, was Diagnosen bei DKIM-Key-Rotationen deutlich erleichtert.

RFC 9991: Failure Reports und die Datenschutzfrage

Das ARF-Format für die einzelnen Failure Reports ist nicht neu, das nutzte schon RFC 7489. Neu ist, dass RFC 9991 dieses Thema aus der Kernspezifikation herauslöst, in eine eigene RFC packt und dabei ein altbekanntes Problem konkreter adressiert: Failure Reports können personenbezogene Daten enthalten, Empfängeradressen und im schlechtesten Fall Teile des Mail-Inhalts. Genau deshalb liefern nach eigener Beobachtung viele große Empfänger schon seit Jahren kaum bis gar keine ruf-Reports aus, RFC 9991 selbst schreibt, dass die Datenschutzbedenken viele Betreiber dazu gebracht haben, den Einsatz von Failure Reports einzuschränken. RFC 9991 bringt jetzt konkrete Redaction-, Datenminimierungs- und Transport-Security-Empfehlungen mit, formuliert als starke Empfehlung, nicht als Pflicht oder Garantie. Ob das in der Praxis tatsächlich mehr Empfänger dazu bringt, ruf überhaupt zu bedienen, bleibt abzuwarten, ein Schritt in die richtige Richtung ist es trotzdem.

Praxis-Check an den eigenen sechs Domains

Live abgefragt mit dig +short TXT _dmarc.<domain>, Stand heute:

kernel-error.de:        v=DMARC1; p=reject; rua=mailto:postmaster@kernel-error.de; ruf=mailto:postmaster@kernel-error.de; fo=1; sp=reject; aspf=s;
kernel-error.com:       (identisch)
kernel-error.org:       (identisch)
vandemeer.de:           (identisch)
fuchs-meckenheim.de:    (identisch)
heidbreders.de:         (identisch)

Drei Beobachtungen dazu. Erstens: pct=100 stand ursprünglich noch auf allen sechs Records, ein Überbleibsel aus der Zeit vor dem eigentlich gewünschten vollen Rollout, dazu weder rf noch ri. Weil überall ohnehin die volle Durchsetzung gewollt war und kein Teil-Rollout lief, war die neue Bedeutungslosigkeit von pct genau der Anlass, das Tag von allen sechs Records ersatzlos zu streichen, kein Muss, aber ein guter Moment dafür.

Zweitens: heidbreders.de stand bislang als einzige der sechs Domains auf sp=none, die anderen fünf auf sp=reject. Beim Aufräumen gleich vereinheitlicht, jetzt tragen alle sechs sp=reject. np explizit zu setzen würde am eigenen Verhalten trotzdem nichts ändern, weil der Default, der Rückfall auf sp, für alle sechs Domains ohnehin schon reject ist. Es besteht kein Handlungsbedarf, ein expliziterer Record wäre höchstens Geschmackssache.

Drittens, und das ist der Punkt, der zur eingangs erwähnten Adoptionsverzögerung passt: rspamd, hier in Version 4.1.0 der eigene DMARC-Validator für eingehende Mail, unterstützt np nach aktuellem Stand von September 2026 noch nicht. Bekommt der eigene Filter eine gespoofte Mail von einer nicht existierenden Subdomain einer fremden Marke, deren Domain-Owner über np strenger sein wollte als über sp, wendet rspamd aktuell trotzdem die laxere sp-Policy an. Eine kleine, aber reale Lücke auf der Empfänger-Seite, bis rspamd nachzieht. Vier Monate nach Publikation der RFC haben ohnehin die wenigsten Absender-Domains np überhaupt gesetzt, akuten Grund zur Sorge gibt das nicht, einen Blick in die rspamd-Release-Notes aber schon.

Die Frage aus Abschnitt 7.4 ist dabei nicht, ob ich selbst eine Mailingliste betreibe, sondern ob Absender meiner Domains an fremden Mailinglisten oder ähnlichen indirekten Mail-Flows teilnehmen. Bei mir ist das praktisch nicht der Fall, für die eigene Infrastruktur bleibt die gestufte Migration also Theorie. Für Leser mit Nutzern, die auf Mailinglisten schreiben, ist sie es sehr wohl.

Kurzfassung: Kein akuter Handlungsbedarf für Domains mit bestehendem p=reject und pct=100. Wer noch einen Teil-Rollout mit einem pct-Wert zwischen 1 und 99 fährt, findet in t keinen direkten Ersatz und muss auf eine echte Stufenmigration über p ausweichen, nur der Randfall pct=0 lässt sich eins zu eins durch t=y ersetzen. np ist ein sinnvolles Sicherheits-Add-on, dessen Wirkung von der Update-Geschwindigkeit der empfängerseitigen Implementierungen abhängt, ein gutes Beispiel dafür, dass ein neues RFC nicht am Tag der Veröffentlichung live ist, sondern über Monate und Jahre durch Software-Updates bei allen Beteiligten durchsickert.

Siehe auch

Eigene Erfahrungen mit der Umstellung auf RFC 9989, oder Fragen zu DMARC allgemein? Dann darfst du mich sehr gerne fragen.

« Ältere Beiträge

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑