IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: IPv6 (Seite 1 von 4)

QUIC auf Dual-Stack-Sockets: das DF-Bit, das nginx für IPv4-Clients nie setzt

nginx auf FreeBSD mit QUIC/HTTP/3: IPv6 ohne Router-Fragmentierung und IPv4 mit fehlendem DF-Bit auf einem Dual-Stack-Socket.

Ein Listener für IPv4 und IPv6 zusammen klingt nach der besseren Lösung. Ein Socket statt zwei, eine Konfigurationszeile weniger, ggf. ein Firewall-Regelwerk weniger zu pflegen. Bei QUIC auf diesem Blog lief das genau so, seit hier HTTP/3 aktiviert ist. Am 9. September 2026 ist mir aufgefallen, dass genau dieser eine Socket seit längerem dafür sorgt, dass nginx für die Hälfte der Clients ein Bit im IP-Header nie setzt, das QUIC eigentlich zwingend braucht. Kein Absturz, keine Fehlermeldung, kein Eintrag im Error-Log. Nur ein messbar höherer Anteil langsamer Verbindungen, der sich erst beim genauen Hinsehen als das entpuppt, was er ist.

Dieser Beitrag ist eine klassische Root-Cause-Analyse. Bug gefunden, Ursache im nginx-Quellcode verifiziert, Ursache zusätzlich im FreeBSD-Kernel nachvollzogen, gefixt, mit echten Produktionsdaten so gut wie möglich belegt.

Ein Socket für beides, das ist doch die naheliegende Wahl

Wer nginx mit QUIC betreibt, kennt die Direktive üblicherweise so:

listen [::]:443 quic reuseport ipv6only=off default_server;

Ein einziger IPv6-Socket mit ipv6only=off nimmt sowohl echte IPv6-Verbindungen als auch IPv4-Verbindungen an, dank IPv4-mapped-IPv6-Adressen (::ffff:a.b.c.d) nach RFC 3493. Ein Socket statt zwei, eine Zeile Konfiguration weniger. Genau deshalb ist das die naheliegende Wahl, wenn man von TCP kommt, wo dieser Trick seit Jahrzehnten problemlos funktioniert.

Bei QUIC ist genau dieser eine Socket ein Problem, und zwar eines, das man im laufenden Betrieb nicht sieht. Zumindest nicht sofort und nicht überall. Es müssen schon ein paar Dinge zusammen kommen um das Problem selbst zu fühlen. Fühlen? Eine lllaaaaannnngggggssssaaaaammmmeeeee Verbindung über IPv4.

Warum QUIC bei Fragmentierung empfindlicher ist als TCP über TLS

RFC 9000, Abschnitt 14, formuliert das ziemlich hart:

UDP datagrams MUST NOT be fragmented at the IP layer. In IPv4, the Don’t Fragment (DF) bit MUST be set if possible, to prevent fragmentation on the path.

Das ist keine Empfehlung, das ist ein MUST NOT direkt neben einem MUST. QUIC ermittelt seine eigene passende Paketgröße für einen Netzwerkpfad, entweder über klassisches PMTUD (das auf ICMP-Antworten angewiesen ist und auf der IP-Ebene ansetzt, das DF-Bit ist Teil genau dieses Mechanismus) oder über DPLPMTUD nach RFC 8899, das mit eigenen Sondierungspaketen arbeitet und ganz ohne ICMP auskommt. Wichtig ist hier nicht, welcher der beiden Mechanismen die Größe ermittelt, sondern was beide voraussetzen: ein zu großes Paket muss sauber verworfen werden, mit oder ohne ICMP-Antwort, statt fragmentiert beim Empfänger anzukommen. Wer sich jetzt an ICMPv6 für IPv6 erinnert fühlt, japp 🙂

Genau das geht in vielen Netzen schief, sobald ein Paket doch fragmentiert wird. Fragment-Filterung ist eine verbreitete Firmen- und Provider-Härtung, gerade weil fragmentierte Pakete historisch für allerlei Unfug missbraucht wurden. Solche Netze werfen fragmentierte QUIC-Pakete einfach weg, ohne jede Rückmeldung. QUICs eigene Verlusterkennung kann das von gewöhnlichem Paketverlust nicht unterscheiden, im schlechtesten Fall wird daraus eine Serie von Retransmissions und Timeouts statt eines schnellen, sauberen Fehlers. Bei TCP über TLS würde ein fragmentiertes Paket in den allermeisten Netzen einfach ankommen und zusammengesetzt werden, das ist dort seit jeher normaler Betrieb und niemanden juckt das DF-Bit besonders. Bei QUIC ist Fragmentierung der Fall, den das Protokoll bewusst ausschließen will, und genau der tritt hier auf.

Die Ursache, gefunden im nginx-Quellcode

Der Fund steckt in src/core/ngx_connection.c, in der Funktion ngx_configure_listening_sockets() (nicht zu verwechseln mit ngx_open_listening_sockets(), einer anderen Funktion in derselben Datei, die die Sockets öffnet, aber nicht die MTU-Discovery-Optionen setzt). Diese Funktion läuft beim Start und bei jedem Restart über alle bereits gebundenen Listen-Sockets und setzt dort die passenden Socket-Optionen. Der entscheidende Ausschnitt, wörtlich aus nginx 1.30.4:

#if (NGX_HAVE_IP_MTU_DISCOVER)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET) {
            value = IP_PMTUDISC_DO;

            if (setsockopt(ls[i].fd, IPPROTO_IP, IP_MTU_DISCOVER,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IP_MTU_DISCOVER) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#elif (NGX_HAVE_IP_DONTFRAG)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET) {
            value = 1;

            if (setsockopt(ls[i].fd, IPPROTO_IP, IP_DONTFRAG,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IP_DONTFRAG) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#endif

#if (NGX_HAVE_INET6)

#if (NGX_HAVE_IPV6_MTU_DISCOVER)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET6) {
            value = IPV6_PMTUDISC_DO;

            if (setsockopt(ls[i].fd, IPPROTO_IPV6, IPV6_MTU_DISCOVER,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IPV6_MTU_DISCOVER) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#elif (NGX_HAVE_IP_DONTFRAG)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET6) {
            value = 1;

            if (setsockopt(ls[i].fd, IPPROTO_IPV6, IPV6_DONTFRAG,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IPV6_DONTFRAG) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#endif
#endif

Beide Zweige prüfen ls[i].sockaddr->sa_family, also die Adressfamilie des Listen-Sockets selbst, fest zum Zeitpunkt des Socket-Setups. Nicht die Familie des Ziels, an das ein bestimmtes Paket später geht. Für listen [::]:443 quic ... ipv6only=off; ist sa_family immer AF_INET6, egal ob ein konkretes Paket an einen echten IPv6-Host oder an eine IPv4-mapped-Adresse geht. Der AF_INET-Zweig, der IP_DONTFRAG fürs echte IPv4-Datagramm setzen würde, wird für diesen Socket schlicht nie erreicht.

Ein kleines Detail für alle, die selbst nachlesen: der IPv6-Fallback-Zweig (das #elif (NGX_HAVE_IP_DONTFRAG) im letzten Block) ist mit demselben Feature-Makro abgesichert wie der IPv4-Zweig, nicht mit dem separat getesteten NGX_HAVE_IPV6_DONTFRAG. Auf FreeBSD ändert das am Ergebnis nichts, hier sind beide Makros gesetzt, aber es ist eine kleine Ungenauigkeit im nginx-Quellcode selbst. So zumindest meine Interpretation, korrigiert mich gerne!

Der eigentliche Denkfehler dahinter: IPv6 hat gar kein DF-Bit

Wer IPV6_DONTFRAG im Code sieht, könnte annehmen, dass damit dasselbe Problem für IPv6 gelöst wird wie IP_DONTFRAG für IPv4. Ist es nicht, und der Unterschied ist der eigentliche Kern dieses Bugs.

Der IPv6-Header hat schlicht kein DF-Bit, weil er keines braucht. RFC 8200 verbietet Routern im Pfad die Fragmentierung von IPv6-Paketen grundsätzlich, das steht wörtlich in Abschnitt 4.5 (der auf Abschnitt 5 verweist): „unlike IPv4, fragmentation in IPv6 is performed only by source nodes, not by routers along a packet’s delivery path“. IPV6_DONTFRAG ist die tatsächliche RFC-3542-Option, Abschnitt 11.2 der Spezifikation, aber sie steuert nur, ob der sendende Host selbst über einen Fragment-Extension-Header fragmentieren darf. Ein Problem, das aus Sicht von IPv6 gar nicht existiert, sobald man es nicht selbst provoziert.

IP_DONTFRAG auf der IPv4-Seite ist dagegen keine RFC-3542-Option, sondern eine BSD-Socket-Erweiterung außerhalb dieses Standards. Zwei Optionen, die im Code wie ein symmetrisches Paar aussehen, lösen in Wirklichkeit zwei völlig verschiedene Probleme.

Und jetzt der Punkt, an dem beide Welten aufeinandertreffen. Ein send() auf diesem IPv6-Socket an eine IPv4-mapped-Zieladresse bringt am Ende ein echtes IPv4-Datagramm auf die Leitung, das ist Standardverhalten von Dual-Stack-Sockets nach RFC 3493. Dieses Datagramm braucht ein gesetztes DF-Bit im IPv4-Header, ein komplett anderes Feld als alles, was IPV6_DONTFRAG je anfasst. Der oben gezeigte Code-Pfad kommt an dieses Feld nie heran, weil er für einen AF_INET6-Socket ausschließlich die IPv6-Variante der Option setzt. Kann man das also auch irgendwie ein legacy IPv4 Problem nennen?

Warum ein einfacher Zusatz-Aufruf auf FreeBSD gar nicht helfen würde

Die naheliegende Reaktion: warum ruft nginx auf diesem Socket nicht einfach zusätzlich setsockopt(IPPROTO_IP, IP_DONTFRAG) auf? Ich bin dem im FreeBSD-Kernel-Quellcode nachgegangen, und die Antwort ist, dass das auf FreeBSD gar nicht funktionieren würde.

Der Options-Handler für einen AF_INET6-Socket ist ip6_ctloutput() in sys/netinet6/ip6_output.c, und der lehnt Optionen außerhalb von IPPROTO_IPV6 rundweg ab:

level = sopt->sopt_level;
...
if (level != IPPROTO_IPV6) {
    error = EINVAL;
    ...
}

Ein setsockopt(fd, IPPROTO_IP, IP_DONTFRAG, ...) auf einem AF_INET6-Socket landet also mit EINVAL im Nichts. Das allein wäre schon Antwort genug, aber der zweite Teil ist genauso wichtig: wo genau setzt der Kernel das DF-Bit für einen IPv4-mapped-Send, der über einen IPv6-Socket rausgeht? In udp_usrreq.c, in der Funktion, die das eigentliche IPv4-UDP-Paket zusammenbaut:

if (inp->inp_flags & INP_DONTFRAG)
    ((struct ip *)ui)->ip_off |= htons(IP_DF);

Das DF-Bit wird nur gesetzt, wenn am PCB (dem Protocol Control Block der Verbindung) das Flag INP_DONTFRAG hängt. Und dieses Flag setzt ausschließlich ip_ctloutput() in ip_output.c, wenn IP_DONTFRAG auf IPPROTO_IP-Ebene erfolgreich gesetzt wurde, also genau der Aufruf, der auf einem AF_INET6-Socket mit EINVAL scheitert. Der IPv4-mapped-Sendepfad selbst führt übrigens tatsächlich über genau diese Funktion: udp6_send() in udp6_usrreq.c erkennt eine v4-mapped-Zieladresse auf einem Dual-Stack-Socket, gibt die eigenen Locks frei und ruft direkt udp_send(), also dieselbe IPv4-UDP-Ausgabefunktion, die auch ein echter AF_INET-Socket benutzt.

Damit schließt sich der Kreis / Beisst die Katze sich in den Schwanz, ihr wisst schon. INP_DONTFRAG kann nur über einen erfolgreichen IP_DONTFRAG-Aufruf auf einem echten AF_INET-Socket gesetzt werden, und ein AF_INET6-Socket kann diesen Aufruf laut ip6_ctloutput() gar nicht erst absetzen. Der Socket-Split ist auf FreeBSD damit nicht nur der pragmatische, sondern der einzig mögliche Fix. Ein hypothetischer nginx-Patch, der einfach den fehlenden setsockopt-Aufruf ergänzt, würde am Kernel selbst scheitern, bevor er überhaupt etwas bewirkt.

Was sich zwischen FreeBSD und Linux unterscheidet, und was nicht

Der Bug, wenn ich das so nennen darf, selbst sitzt im nginx-Quellcode und ist plattformunabhängig. Dieselbe sa_family-Abfrage wird auf Linux und FreeBSD gleich kompiliert und ist auf beiden gleichermaßen falsch.

Was sich unterscheidet, ist welche Socket-Option-API überhaupt zur Verfügung steht. IP_MTU_DISCOVER mit dem Wert IP_PMTUDISC_DO ist eine Linux-Erweiterung (auch musl bringt das Makro mit, nicht nur glibc), auf FreeBSD schlicht nicht deklariert. FreeBSD bietet stattdessen IP_DONTFRAG und IPV6_DONTFRAG. nginx testet im configure-Lauf beide Varianten (auto/unix, Feature-Tests für NGX_HAVE_IP_MTU_DISCOVER, NGX_HAVE_IP_DONTFRAG, NGX_HAVE_IPV6_DONTFRAG) und wählt zur Kompilierzeit die passende Variante. Auf dieser FreeBSD-Installation landet man im IP_DONTFRAG/IPV6_DONTFRAG-Zweig, und genau der ist von dem oben beschriebenen Bug betroffen.

Was ich nicht verifiziert habe, weil mir dafür ein Linux-Vergleichssystem fehlt (ich zu faul war eines aus dem Glas zu ziehen): ob sich das praktische Fehlerbild zwischen den beiden Kerneln tatsächlich unterscheidet, also wie stark Retransmissions ausfallen oder wie der jeweilige Kernel beim v4-mapped-Sendepfad mit dem DF-Äquivalent umgeht. Linux‘ PMTUD-Verhalten für genau diesen Fall könnte sich abweichend verhalten. Ehrliches Fazit an dieser Stelle: der nginx-Bug ist universell im Quellcode, das konkret beobachtete Fehlerbild ist hier ausschließlich für FreeBSD dokumentiert. Eine Aussage wie „genauso kaputt auf Linux“ würde ich ohne echten Beleg, also Paketmitschnitt oder Kernel-Quellcode-Analyse auf einem Linux-System, nicht treffen. Vielleicht mache ich mir die Mühe noch…. Vielleicht 😀

Der Fix: zwei Listener statt einem

Die Lösung ist, den einen Dual-Stack-Listener in zwei eigenständige Listener zu splitten, damit IPv4-Clients einen echten AF_INET-Socket bekommen, für den der obere Codepfad tatsächlich greift:

listen [::]:443 quic reuseport ipv6only=on default_server;
listen 443 quic reuseport default_server;

Ein Stolperstein dabei, den man sich leicht selbst stellt: ein einfaches zusätzliches listen 443 quic; neben einem unveränderten Dual-Stack-Socket kollidiert mit „Address already in use“, weil der alte Socket die IPv4-Wildcard-Adresse über ipv6only=off ja schon abdeckt. ipv6only muss auf dem IPv6-Listener also explizit auf on gesetzt werden, sonst gibt es keinen sauberen Split, sondern nur einen Fehlstart. Je nachdem, wie „ordentlich“ seine Konfiguration ist, kann es einen Moment dauern, alle diese Stellen zu finden, denn das muss für die komplette nginx Konfiguration angepasst sein!

Erster Stolperstein: ein reload reicht nicht

Eine reine ipv6only-Änderung an einem bestehenden QUIC-Socket erkennt nginx‘ Socket-Reuse-Logik bei einem reload nicht als neuen Socket. Bei mir blieb der alte Dual-Stack-Socket nach einem reinen reload laut sockstat weiter als udp46 aktiv, trotz fehlerfrei geprüfter Konfiguration (nginx -t) und trotz eines nginx -T-Dumps, der die neue Konfiguration bereits korrekt anzeigte. Ist bei solchen Dingen hin und wieder so, machen andere Dienste ja auch. Große Dinge wie Socket, wird oft nur bei einem echten Neustart vom Deinst gesetzt.

nginx -t prüft Syntax und versucht, referenzierte Dateien zu öffnen. Es sagt nichts darüber aus, ob ein bereits offener, laufender Listen-Socket bei einem Reload tatsächlich neu gebunden wird. Erst ein vollständiger service nginx restart hat die getrennten Sockets tatsächlich neu gebunden:

sockstat -4 -l | grep 443   # nur udp4
sockstat -6 -l | grep 443   # nur udp6

Nach dem Restart tauchte in der PROTO-Spalte ausschließlich udp4 und udp6 auf, kein einziges udp46 mehr auf Port 443. Das ist der eigentliche Beleg für den Reload-Stolperstein, keine Datei-Deskriptor-Analyse, nur der Blick auf einen laufenden Prozess. Das reiht sich in ein Muster ein, das mir auf dieser Infrastruktur schon öfter untergekommen ist: ein neues geladenes Modul, ein neuer server_name in einer bestehenden reuseport-Gruppe, jetzt ein ipv6only-Wechsel. Immer wieder dasselbe Grundmuster, ein Reload reicht bei bestimmten Änderungen an Listen-Sockets schlicht nicht. Aber ich wiederhole mich, hm?

Zweiter Stolperstein: jeder vHost braucht den Split

Der erste Durchlauf hat nur den Default-Server-Socket gesplittet. Alle anderen vHosts mit eigenem listen [::]:443 quic;, aber ohne eigenes listen 443 quic;, hingen danach nur noch am neuen IPv6-only-Socket. IPv4-QUIC-Verbindungen zu diesen Domains landeten beim Default-vHost, weil die SNI-Zuordnung auf dem neuen IPv4-Socket schlicht ins Leere lief. Sichtbar wurde das am falschen ausgelieferten TLS-Zertifikat und an einer Default-Antwort statt der eigentlich erwarteten.

Die Lehre daraus: bei einem reuseport-Split müssen alle Server-Blöcke der Adressgruppe angepasst werden, nicht nur der Default-Server. Der IPv4-Listener eines jeden weiteren vHosts docken danach ohne reuseport und ohne default_server einfach an die schon bestehende Gruppe an:

listen [::]:443 quic;
listen 443 quic;

Was im Error-Log nicht zu finden ist

Das nginx-Error-Log auf Level info, die komplette 15-Tage-Rotation samt .bz2-Archiven, enthält keine einzige [warn], [error] oder [crit]-Zeile mit QUIC-Bezug, weder vor noch nach dem Fix. Eine gezielte Suche nach den vier exakten Alert-Meldungen, die der oben zitierte Code beim Fehlschlagen eines setsockopt-Aufrufs loggen würde, kommt in der gesamten Historie null Mal vor. Vielleicht sollte ich das noch im Logging aufbohren, wenn möglich?!

Das ist methodisch wichtig: diese Alert-Meldungen enthalten das Wort „quic“ gar nicht. Ein reines grep -i quic im Error-Log hätte einen echten Fehlschlag dieser Aufrufe also gar nicht gefunden, selbst wenn es einen gegeben hätte. Erst die gezielte Suche nach dem exakten Meldungstext schließt aus, dass die Socket-Optionen fehlgeschlagen sind. Sie wurden erfolgreich gesetzt, nur eben die falsche Option für die falsche Adressfamilie. Kein Aufruf-Fehler, sondern genau der beschriebene Bug.

Warum das Error-Log strukturell nicht mehr hergibt: nginx sendet das UDP-Datagramm erfolgreich an den Kernel, die Fragmentierung passiert danach im Netz, an einem Router oder einer Middlebox, oder schon beim sendenden Host selbst, falls das ausgehende Interface-MTU überschritten wird. Davon bekommt der laufende nginx-Prozess in keinem Fall etwas mit. Wer nach diesem Bug im Error-Log sucht, wird nichts finden. Das ist erwartbar, nicht beruhigend, und ein blindes grep quic hätte selbst einen echten Konfigurationsfehler an dieser Stelle übersehen. Genau das ist der Punkt. Man sieht es am Server fast nur, wenn man auch einen tcpdump macht und auswertet. Denn die UDP Pakete gehen ja auf die Reise, sind sie nicht als „unzerteilbar“ markiert, kann und wird auf dem Weg aber bestimmt irgendein Router oder eine Firewall anfangen die Pakete klein zu hacken und dann ist es „kaputt“.

Verifikation über das Access-Log, und ihre Grenzen

nginx zeigt IPv4-Clients, die über einen Dual-Stack-Socket hereinkommen, im Access-Log als IPv4-mapped-Adresse (::ffff:a.b.c.d). Nach dem Fix kommen IPv4-QUIC-Clients über einen echten AF_INET-Socket herein und erscheinen als reine IPv4-Adresse ohne dieses Präfix. Diese Darstellung allein beweist schon, durch welchen Socket eine Verbindung lief, unabhängig von jeder Performance-Messung, aber eben auch unabhängig von jeder direkten Fragmentierungs-Messung.

Ausgewertet habe ich das Access-Log des Blogs (Format goa_ext, enthält $request_time), 13 Tage vor dem Fix plus den laufenden Tag danach, alle HTTP/3.0-Requests, aufgeteilt nach Adressdarstellung:

ZeitraumRequestsØ request_timeMaxAnteil über 1 s
vorher, IPv4 über kaputten Dual-Stack-Socket12.5370,461 s130,3 s5,33 %
nachher, IPv4 über eigenen udp4-Socket9460,037 s1,4 s0,42 %
Kontrollgruppe, natives IPv6, vorher17.3200,113 s67,3 s1,86 %
Kontrollgruppe, natives IPv6, nachher1.1680,082 s5,7 s2,14 %

Die betroffene IPv4-Gruppe lag vorher bei 5,33 Prozent über einer Sekunde, fast das Dreifache der IPv6-Baseline von 1,86 Prozent, und fällt nach dem Fix auf 0,42 Prozent, unter die IPv6-Baseline von 2,14 Prozent im selben Zeitraum. Genau dieser Kontrollgruppen-Vergleich macht die Zahlen für mich aussagekräftig, als Korrelation, die zur quellcode-basierten Root-Cause-Analyse passt, nicht als eigenständigen Fragmentierungsbeweis.

Eine zeitliche Punktprobe passt ins Bild: Restart am 9. September 2026 um 18:38:31 Uhr, letzter Request über den kaputten Dual-Stack-Pfad um 17:56:46 Uhr, erster Request über den neuen Pfad um 18:41:36 Uhr. Seit dem Restart lief keiner der 946 IPv4-HTTP/3.0-Requests mehr über die alte Darstellung. Das liegt plausibel am Restart-Zeitpunkt, mit einer Lücke ohne Traffic dieser Art von 42 Minuten davor und 3 Minuten danach bis zum ersten neuen Request, aber es ist kein exakter Sekundentreffer und ich beschreibe es auch nicht so.

Genauso wichtig wie die Zahlen sind für mich ihre Grenzen, deshalb ein eigener Absatz dafür statt eines Nebensatzes:

  • Ein fehlendes DF-Bit erlaubt Fragmentierung, es erzwingt sie nicht. Ein Datagramm, das auf jedem Hop unter dem dortigen MTU bleibt, ist unabhängig vom DF-Bit unproblematisch. Das kann zu Fragmentierung führen, es führt nicht automatisch dazu.
  • Die Adressdarstellung im Access-Log beweist, welchen Socket nginx verwendet hat. Sie sagt nichts über den DF-Bit-Zustand, die tatsächliche Paketgröße, die reale PMTU oder echte Fragmente auf der Leitung aus. Das gilt hier ohne Einschränkung, weil dieser vHost direkt am Internet hängt, ohne vorgeschaltete Proxy- oder Load-Balancer-Schicht, die $remote_addr umschreiben könnte.
  • Der Vergleich von 13 Tagen vorher gegen einen Teil eines Tages nachher ist kein kontrollierter Leistungsvergleich. Trafficmix, Client-Geografie, Cache-Zustand, Backend-Last und Tageszeit unterscheiden sich zwangsläufig. Die Zahlen sind ein starkes Indiz, kein experimenteller Beweis.
  • Die IPv6-Kontrollgruppe ist nicht vollständig unverändert geblieben. Nur der Anteil über einer Sekunde bleibt in vergleichbarer Größenordnung. Mittelwert und Maximum verschieben sich durchaus, vermutlich schlicht durch allgemein geringere Last oder einen anderen Trafficmix zum jeweiligen Zeitpunkt.
  • Eine Retransmission-Spirale statt eines schnellen Fails ist ein plausibles, aber kein garantiertes Symptom. Wie sich ein verlorenes, fragmentiertes QUIC-Paket konkret auswirkt, hängt von der Verlusterkennung und der PMTU-Implementierung der beteiligten QUIC-Stacks ab, auf Client- wie auf Serverseite.
  • Ein wirklich abschließender Beweis bräuchte einen Vorher- und Nachher-Paketmitschnitt, der das DF-Bit direkt zeigt, im Idealfall mit einem kontrollierten Test gegen ein reduziertes MTU. Ohne den betrachte ich die Produktionszahlen als starke, durch eine Kontrollgruppe abgesicherte Korrelation, die zur quellcode-basierten Root-Cause-Analyse passt, nicht als direkten Fragmentierungsbeweis. Ein Mitschnitt von der Vorher-Seite liegt inzwischen vor, dazu der nächste Abschnitt.

Ein Paketmitschnitt vom Tag vor dem Fix schließt einen Teil der Lücke

Nachtrag vom 12. September 2026: Der vorherige Abschnitt musste ohne einen echten Paketmitschnitt auskommen. Der liegt inzwischen vor. Zwei rund 41 Sekunden lange Aufzeichnungen vom 8. September 2026, einen Tag vor dem Fix, eine direkt auf dem Server, die andere gleichzeitig auf einem Notebook, das die Seite über ein anderes Netz aufgerufen hat. Beide zusammen zeigen den echten HTTP/3-Verkehr eines einzelnen Seitenaufrufs.

Ausgewertet mit tcpdump -r <Datei> -n -v, ein tshark stand mir nicht zur Verfügung. Jedes Paket trägt im IP-Header ein Identification-Feld, und das ist in beiden Mitschnitten innerhalb des Beobachtungsfensters durchgehend eindeutig, keine einzige Dopplung unter den mehr als dreitausend vom Server verschickten Paketen. Darüber lassen sich einzelne Datagramme zwischen den beiden Aufzeichnungen zweifelsfrei einander zuordnen, nicht nur über Summen vergleichen.

RichtungBeim Server verschicktBeim Notebook angekommenAbgleich
Notebook zu Server1.147, alle mit DF-Bit1.147, alle mit DF-Bitidentisch, per ID geprüft
Server zu Notebook, klein genug fürs MTU898, kein DF-Bit898, dieselben IDs0 Prozent Verlust
Server zu Notebook, fragmentiert, kein DF-Bit2.162 erste Fragmente878, per ID zugeordnet1.284 fehlen, 59,4 Prozent

Kein einziges der 1.147 Pakete vom Notebook zum Server fehlt das DF-Bit, kein einziges der 3.060 Pakete in der Gegenrichtung trägt eines. Das bestätigt den Fund aus dem Quellcode jetzt direkt auf der Leitung, nicht nur über die Adressdarstellung im Access-Log. 2.162 dieser Server-Pakete sind schon beim Verlassen des Servers fragmentiert, jedes erste Fragment exakt 1500 Byte lang, also an der Ethernet-MTU gekappt. Von diesen 2.162 erscheinen im Notebook-Mitschnitt nur 878 wieder, eins zu eins über die ID zugeordnet. 1.284 fehlen komplett, das sind 59,4 Prozent. Die 898 kleinen, unfragmentierten Antworten kommen dagegen alle an, ebenfalls per ID geprüft und nicht bloß über die Summe verglichen. Über die ganzen 41 Sekunden verteilt liegt der fehlende Anteil in jedem Fünf-Sekunden-Fenster zwischen 51 und 68 Prozent. Kein Ausreißer am Anfang oder Ende der Aufzeichnung, der auf einen Zeitversatz zwischen den beiden Mitschnitten hindeuten würde.

Die zweite Hälfte jedes fragmentierten Datagramms taucht in keinem der beiden Mitschnitte auf. Vermutlich wurde mit einem Filter auf den UDP-Port aufgezeichnet, und ein IP-Fragment ohne den ersten Teil trägt keinen UDP-Header, an dem so ein Filter ansetzen könnte. Das lässt offen, ob einzelne der 878 angekommenen ersten Fragmente trotzdem nie vollständig zusammengesetzt werden konnten, weil ihre zweite Hälfte fehlte. 59,4 Prozent sind deshalb eine gemessene Untergrenze für den tatsächlichen Verlust, keine Obergrenze. Und es bleibt eine einzelne Sitzung, ein Client, ein Pfad, eine Zeitspanne von 41 Sekunden, kein Beleg für eine feste Verlustquote im ganzen Netz.

So sieht der Unterschied im Rohformat aus, Adressen durch Platzhalter ersetzt:

12:01:29.758438 IP (id 0, offset 0, flags [DF], length 1280)
    CLIENT.35577 > SERVER.443: UDP, length 1252
12:01:29.771757 IP (id 51997, offset 0, flags [+], length 1500)
    SERVER.443 > CLIENT.35577: UDP, length 1480

Dieser Mitschnitt stammt vom Tag vor dem Fix, ein gepaarter Mitschnitt von danach existiert aus dem echten Betrieb nicht. Der Versuch direkt nach dem Fix blieb leer, weil der dafür verwendete Client kein echtes HTTP/3 sprach und der Mitschnitt dadurch keinen QUIC-Verkehr enthielt. Die Vorher-Nachher-Zahlen aus dem Access-Log oben bleiben deshalb weiterhin die Grundlage für den gemessenen Effekt des Fixes. Was dieser Mitschnitt zusätzlich liefert, ist der direkte Beleg für den Mechanismus dahinter: das fehlende DF-Bit und die Fragmentierung selbst sind jetzt nicht mehr nur aus dem Quellcode abgeleitet, sondern auf der Leitung beobachtet.

Fazit

Ein einzelner Dual-Stack-Socket für QUIC ist offenbar kein Einzelfall, sondern eher ein wiederkehrendes Footgun-Muster über verschiedene Implementierungen hinweg. quic-go, die von Marten Seemann entwickelte QUIC-Bibliothek, musste DPLPMTUD auf älteren macOS-Versionen abschalten, weil sich das DF-Bit auf einem Dual-Stack-Socket dort schlicht nicht setzen ließ, und dokumentiert das offen. Ein separates Issue im selben Projekt beschreibt ein anderes, aber verwandtes Dual-Stack-Problem gerade auf FreeBSD (fehlgeschlagenes sendmsg für IPv4-mapped-Adressen), mit einem Verweis auf FreeBSDs eigene inet6(4)-Manpage, die für AF_INET6-Sockets ganz grundsätzlich empfiehlt, zwei getrennte Sockets zu verwenden, aus Sicherheitsgründen, unabhängig von QUIC. Die Empfehlung, IPv4 und IPv6 getrennt zu halten, existierte auf dieser Plattform also schon, bevor QUIC überhaupt erfunden wurde. Für den konkreten Fall hier heißt das, dass der Socket-Split kein Workaround für einen einzelnen nginx-Bug ist, sondern die Rückkehr zu der Architektur, die FreeBSD für genau diese Situation ohnehin vorsieht.

Ein Socket für beides bleibt bei TCP über TLS ein legitimer, funktionierender Kompromiss. Bei QUIC ist er, zumindest auf dieser Kombination aus nginx und FreeBSD, ein stiller Bug, der sich weder im Error-Log noch im laufenden Betrieb meldet, sondern nur über einen erhöhten Anteil langsamer Verbindungen bemerkbar macht. Wer selbst QUIC auf einem Dual-Stack-Listener betreibt, findet die Antwort auf die Frage, welchen Socket ein Client gerade benutzt, mit dem Access-Log-Trick oben in wenigen Minuten selbst heraus.

Siehe auch:

Fragen, Einwände oder eigene Erfahrungen mit QUIC auf Dual-Stack-Sockets? Dann darfst du mich sehr gerne fragen.
Bald ist wieder FrOSCon: warum ich seit zwanzig Jahren hinfahre und wen ich dort treffen möchte

Moin.

Konferenz-Namensschild an einem grünen Schlüsselband, Aufschrift FrOSCon 2026, Sankt Augustin, darunter der Name Kernel-Error und ein Stempel mit dabei seit 2007

Am kommenden Wochenende ist wieder FrOSCon. Samstag der 15. und Sonntag der 16. August, wie immer an der Hochschule Bonn-Rhein-Sieg in Sankt Augustin, Grantham-Allee 20. Der Eintritt ist frei, es laufen sieben Vortragsschienen und zwei Workshop-Räume parallel, samstagabend gibt es das Social Event. Das Programm steht online.

Es ist die 21. Ausgabe. Die erste war 2006, die Konferenz wird also gerade zwanzig. Ich bin an beiden Tagen dort und würde mich sehr freuen, wenn wir uns treffen und ein bisschen quatschen. Also: ist noch jemand von euch da? Sag mir gerne vorher Bescheid, dann verabreden wir uns, oder sprich mich einfach an, wenn du mich irgendwo im Foyer siehst.

Und falls du noch nie dort warst: fahr hin. Der Eintritt kostet nichts, das Programm ist gut, und diese Mischung aus Vorträgen, Ständen und Leuten, die dir ungefragt ihr Projekt erklären wollen, gibt es in der Form nicht oft.

Warum es nicht jedes Jahr klappt

Ich versuche eigentlich jedes Jahr, auf die FrOSCon zu kommen. Das scheitert regelmäßig daran, dass meine Kinder rund um dieses Wochenende Geburtstag haben, und das geht dann selbstverständlich vor. Dieses Jahr passt es, deshalb schreibe ich das hier überhaupt.

Beim Zusammensuchen der alten Beiträge habe ich dann etwas gefunden, das mich kurz sehr still gemacht hat. In meinen Entwürfen liegt ein Beitrag vom 9. August 2013, der nie veröffentlicht wurde. Darin steht:

Ich habe gerade die Bestätigung meines FrOSCon Tickets bekommen 🙂 Die FrOSCon ist dieses Jahr vom 24.08-25.08.2013 in Sankt Augustin. Ich schaffe es nicht immer zur FrOSCon denn meine Kinder haben immer um diesen Dreh Geburtstag. Das geht dann vor! In diesem Jahr klappt es genau und dieses freut mich natürlich umso mehr! Wir sehen uns also auf der FrOSCon….

Ich, in einem Entwurf vom 9. August 2013, den ich nie veröffentlicht habe

Dreizehn Jahre später sitze ich hier und schreibe im Grunde denselben Absatz noch einmal. Gleiche Konferenz, gleicher Ort, gleiche Terminkollision, gleiche Freude, dass es diesmal passt. Nur die Kinder sind inzwischen deutlich größer. Den Beitrag von 2013 lasse ich übrigens in der Schublade, der hat sich seinen Platz dort verdient.

Und die Kinder?

Möglicherweise dreht sich die Sache dieses Jahr sogar. Teckids e.V. macht an beiden Tagen die Mini-FrogLabs, das Jugendprogramm der Konferenz. Samstag geht es um Luanti, also eigene Mods und Kreaturen in 3D, Sonntag um Spieleprogrammierung mit Python. Gedacht ist das etwa ab der vierten Klasse bis sechzehn, Vorkenntnisse braucht niemand, bezahlt wird so viel man mag, und man meldet sich für jeden Tag einzeln an. Das schaue ich mir für meine Kinder auf jeden Fall an. Nach all den Jahren, in denen die Kinder der Grund waren, nicht hinzufahren, wäre das eine schöne Wendung.

Wie das bei mir angefangen hat

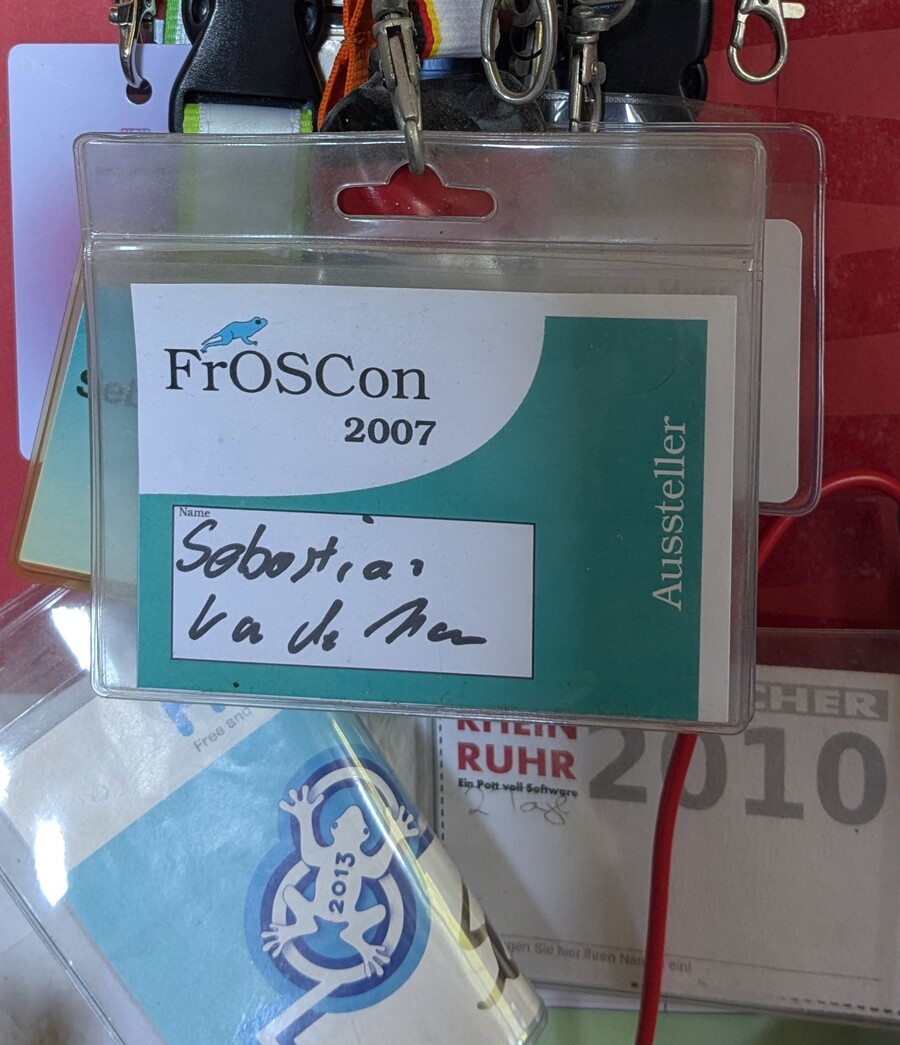
Wann ich zum ersten Mal dort war, kriege ich nicht mehr sicher zusammen. Mein Gefühl sagt 2006, belegen kann ich 2007. Es gibt Bilder aus dem Jahr in meiner Galerie, in einem Beitrag von 2013 hängt ein Schlüsselband von der FrOSCon 2007 an meinem Schlüsselbund, und der Ausweis hängt bis heute bei mir im Arbeitszimmer an der Wand.

Drei Konferenzausweise an bunten Schlüsselbändern an einer Wand. Vorne der Ausweis der FrOSCon 2007 mit handgeschriebenem Namen und dem senkrechten Aufdruck Aussteller, darunter ein hellblaues Schild der FrOSCon 2013 mit Frosch-Logo, rechts ein Besucherausweis der OpenRheinRuhr 2010.
Der Ausweis von 2007 hängt noch im Arbeitszimmer, rechts senkrecht steht Aussteller. Darunter das hellblaue Schild von 2013, das belegt, dass ich in dem Jahr tatsächlich dort war, auch wenn der Beitrag dazu nie erschienen ist. Rechts daneben der Besucherausweis der OpenRheinRuhr 2010.

Damals habe ich am Stand von CAcert mitgeholfen, einer von der Gemeinschaft betriebenen Zertifizierungsstelle, die kostenlos Zertifikate ausgestellt hat, lange bevor das normal war. Das Vertrauen kam dort nicht von einem Audit, sondern von Menschen: Punkte gab es, wenn man einem Assurer seinen Ausweis zeigte. Genau das haben wir den ganzen Tag gemacht, und ich fand das damals ganz große Klasse.

Geworden ist daraus nichts. Der Antrag auf Aufnahme in den Truststore von Mozilla wurde noch im selben Jahr zurückgezogen, und bis heute vertraut kein Browser dieser Wurzel. Ein curl auf die Seite bricht immer noch mit self-signed certificate in certificate chain ab, gerade nachgesehen. Gelöst hat das Problem später Let’s Encrypt, mit einem Protokoll statt mit Menschen und Ausweisen. Technisch die bessere Antwort, ein bisschen wehmütig macht es mich trotzdem.

Hängengeblieben ist trotzdem etwas. Mein Interesse an Zertifikaten, Schlüsseln und dem ganzen Vertrauenskram hat genau dort angefangen, und das hat mich seitdem nicht mehr losgelassen.

Die Keysigning-Party

Zum selben Themenkreis gehört das andere, wozu ich früher immer gegangen bin, wenn es sich einrichten ließ: die GPG-Keysigning-Party. Das Prinzip war schön unaufgeregt. Vorher schickt jeder seinen Schlüssel-Fingerprint ein, vor Ort steht man in einer Reihe, vergleicht die Zeile auf dem ausgedruckten Zettel mit dem, was die andere Person vorliest, sieht sich einen Ausweis an, hakt ab. Zu Hause signiert man dann die Schlüssel, deren Zeile gestimmt hat. Eine Stunde Anstehen, ein Blatt Papier, und danach hängt das eigene Schlüsselbund ein Stück fester im Netz.

Im offiziellen Zeitplan für dieses Jahr finde ich keine Keysigning-Party. Das muss nichts heißen, solche Runden organisieren sich oft nebenbei und stehen dann in keinem Programmheft. Falls sich jemand findet, bin ich sofort dabei. Und ganz unabhängig davon, weil es der einfachere Weg ist: wenn wir uns auf der FrOSCon über den Weg laufen, würde ich mich sehr über ein Cross-Signing meines neuen Schlüssels freuen. Der ist frisch, trägt die Kennung 0x893DE0CDDE986DEB, den Fingerprint bringe ich ausgedruckt mit und den Personalausweis sowieso. Wie ich ihn gebaut und woran ich ihn beim Härten kaputt gemacht habe, steht hier im Blog. Die Rolle, die früher der Ausweis am Klapptisch hatte, übernehmen bei mir mittlerweile nachprüfbare Identity-Claims. Funktioniert gut, ersetzt aber das Anstehen nicht.

Ein Gruß an Jens Link, und eine offene Frage

Aus den frühen Jahren ist mir ein Vortrag bis heute im Kopf geblieben, und zwar einer über IPv6 von Jens Link. Der Mann hat es geschafft, mich mit Adressarchitektur und Autokonfiguration zum Lachen zu bringen und mir im selben Vortrag klarzumachen, dass da erheblich mehr dahintersteckt als eine Pflichtaufgabe, die man irgendwann mal erledigen muss. Das können nicht viele. Ich bin danach an dem Thema hängengeblieben und habe es nie wieder losgelassen.

Fair muss ich dazusagen, dass ich nicht durch ihn angefangen habe. Mein ältester Beitrag zu IPv6 hier im Blog ist vom März 2003, vier Jahre vor diesem Wochenende, es ging um Adressarchitektur und radvd unter Linux. Dass daraus vierunddreißig Beiträge geworden sind, verteilt über die Jahre bis 2021, dafür trägt dieser Vortrag aber einen guten Teil der Schuld. Wenn man einmal gesehen hat, wie jemand über so ein Thema begeistert und komisch reden kann, schaut man danach anders hin. Einen Gruß nach Berlin also, und ein Dankeschön obendrauf.

Genau erinnern kann ich mich nach knapp zwanzig Jahren natürlich nicht mehr, weder an das Jahr noch an die Folien. Der Eindruck ist geblieben, das reicht mir.

Und eine Frage, bei der ihr mir helfen könnt. In meiner Erinnerung wollte er damals ein Buch über IPv6 schreiben. Ich habe es nie gesehen, was aber genauso gut daran liegen kann, dass es an mir vorbeigegangen ist. Auf seiner Seite finde ich keins, und sein Vortragsarchiv reicht nicht so weit zurück, dass ich damit etwas belegen könnte. Weiß es jemand? Ist das Buch erschienen, ist es liegen geblieben, oder habe ich mir das über die Jahre selbst zusammengebaut? Im Fediverse ist er als @quux unterwegs.

Worauf ich schauen will

Festlegen will ich mich nicht, das wird bei mir sowieso spontan. Auf dem Zettel stehen aber diese acht:

Wenn ich die Liste so ansehe, ist das Muster ziemlich eindeutig. Sechs von acht liegen in der Security-Schiene, die anderen zwei kommen aus dem Themenblock zum Recht auf Reparatur, und mehrfach geht es um Haftung und Regulierung statt um Technik. Das ist neu für mich. Drei davon laufen am Samstag im selben Raum, zwei sogar direkt hintereinander, das kommt mir sehr entgegen. Ob ich es aus dem CrypTool-Workshop rechtzeitig rausschaffe, steht auf einem anderen Blatt, der Zeitplan verrät keine Endzeiten.

Die Stände, an denen ich hängen bleiben werde

Auf meiner Runde stehen das CrypTool Projekt, ElectroBSD, Freie Software und Bildung, illumos, Matrix, The PHP Foundation, XMPP und der Datenburg e.V. Bei illumos werde ich vermutlich am längsten stehen, aus reiner Nostalgie, mein Solaris-Archiv hier im Blog hat immerhin achtunddreißig Beiträge. Bei The PHP Foundation habe ich sogar eine konkrete Frage im Gepäck, nachdem ich mich neulich durch einen PHP-Absturz bis in den Laufzeitlinker von FreeBSD gegraben habe.

Auf der Ausstellerliste steht übrigens ein Name, bei dem ich kurz grinsen musste: CAcert ist dieses Jahr wieder mit einem Stand da, neunzehn Jahre später, im selben Gebäude. Die Wurzel liegt weiterhin in keinem Truststore, die Leute stehen trotzdem wieder hinter dem Tisch. Da gehe ich vorbei und sage einmal Danke.

Zwanzig Jahre

Was mich beim Schreiben am meisten getroffen hat, ist nicht die CAcert-Geschichte, sondern die Rechnung dahinter. Von meinem belegten ersten Besuch bis heute sind es neunzehn Jahre. Rechne ich mein Gefühl mit, dass es 2006 war, sind es zwanzig. Die Konferenz gibt es genauso lange. Zwischen dem Klapptisch mit den Assurance-Formularen und dem Beitrag, den ich neulich über einen TPM-Chip geschrieben habe, liegt also ziemlich genau mein halbes Leben mit diesem Hobby. Ich habe mich beim Nachrechnen ehrlich alt gefühlt.

Andererseits: das Wochenende ist immer noch dasselbe Wochenende. Gleiche Hochschule, freier Eintritt, Leute, die einem an einem Stand irgendetwas erklären, wovon sie viel zu begeistert sind. Das ist eine ziemlich gute Konstante.

Siehe auch:

Wenn du auch auf der FrOSCon bist, sag gerne Bescheid, ich freue mich über jeden Kaffee im Stehen und über jede Signatur. Und wenn du die Sache mit dem IPv6-Buch aufklären kannst, oder sonst etwas dazu wissen möchtest, dann darfst du mich sehr gerne fragen.
FreeBSD IPv6-Probleme bei Netcup beheben

Dinosaurier beißt ein Patchkabel durch, im Hintergrund das Buch IPv6 Workshop.

Als Kunde, der bei Netcup FreeBSD-Rootserver auf KVM/QEMU-Basis einsetzt, habe ich schnell gemerkt, dass meine IPv6-Verbindung nicht stabil ist.

Symptome

  • Direkt nach dem Boot funktioniert IPv6 wie gewünscht
  • Nach einiger Zeit brechen Verbindungen zusammen — sowohl eingehend als auch ausgehend
  • Verbindungen haben „Startprobleme“ — ein Ping läuft erst ein paar Mal ins Leere, dann funktioniert plötzlich alles wieder für einen Moment

Ein Ping auf die IPv6-Adresse des Netcup-Gateways stellt die Konnektivität kurzzeitig her. Das deutet sofort auf ein NDP-Problem (Neighbor Discovery Protocol) hin.

Diagnose

FreeBSD behandelt Neighbor Solicitations anders als Linux. Netcups Netzwerk-Setup kommt damit offenbar nicht klar — unter Linux funktioniert IPv6 problemfrei, unter FreeBSD (und NetBSD) nicht. Die ICMPv6-Statistiken zeigen das Problem deutlich:

netstat -s -picmp6 | grep -i neighbor
    neighbor solicitation: 29          # Output: wenige eigene Anfragen
    neighbor advertisement: 10         # Output: wenige eigene Antworten
    neighbor solicitation: 633         # Input: Flut eingehender Anfragen
    neighbor advertisement: 25         # Input: wenige Antworten zurück
    423 bad neighbor solicitation messages  # <-- das Problem

633 eingehende Neighbor Solicitations, davon 423 als „bad" verworfen. FreeBSD verwirft die Anfragen, weil sie nicht von einer On-Link-Adresse kommen — ein Verhalten, das FreeBSD aus Sicherheitsgründen seit einem Security Advisory von 2008 erzwingt.

Lösung

FreeBSD anweisen, Neighbor Discovery nach RFC 4861 zu machen — das akzeptiert auch Solicitations von Off-Link-Adressen, wie es Netcups Router sendet. Zum Testen:

sysctl net.inet6.icmp6.nd6_onlink_ns_rfc4861=1

Funktioniert es, den Eintrag in /etc/sysctl.conf permanent machen:

net.inet6.icmp6.nd6_onlink_ns_rfc4861=1

Wichtig: FreeBSD hat dieses Verhalten aus Sicherheitsgründen deaktiviert. Die strenge Prüfung schützt gegen NDP-Spoofing-Angriffe. Auf einem VPS bei einem vertrauenswürdigen Hoster ist das Risiko überschaubar — auf einem System in einem offenen Netzwerk sollte man abwägen.

Netcup-Support

Ich habe einige Zeit mit dem Support verbracht. Das Problem wurde mir bestätigt — es liege an den Core-Routern, ein Update sei geplant, aber ohne Termin. Mein System wurde auf verschiedene Hosts verschoben, ohne Besserung. Das Problem ist im Netcup-Forum bekannt und betrifft alle BSD-Systeme. Aus meiner Sicht lässt Netcups Setup keine einfache Lösung zu, daher bleibt der sysctl-Workaround.

Siehe auch: IPv6 ULA und Priorität

Fragen? Einfach melden.

We have now run out of IPv4 addresses.

Wenn ich dann mal „zitieren“ darf..

Dear colleagues,

Today, at 15:35 UTC+1 on 25 November 2019, we made our final /22 IPv4 allocation from the last remaining addresses in our available pool. We have now run out of IPv4 addresses.

Our announcement will not come as a surprise for network operators - IPv4 run-out has long been anticipated and planned for by the RIPE community. In fact, it is due to the community's responsible stewardship of these resources that we have been able to provide many thousands of new networks in our service region with /22 allocations after we reached our last /8 in 2012.

----------------------------------------------------------------
Recovered IPv4 Addresses and the Waiting List
----------------------------------------------------------------

Even though we have run out, we will continue to recover IPv4 addresses in the future. These will come from organisations that have gone out of business or whose LIR accounts are closed, or from networks that return addresses they no longer need. They will be allocated to our members according to their position on a new waiting list that is now active.

While we therefore expect to be allocating IPv4 for some time, these small amounts will not come close to the many millions of addresses that networks in our region need today. Only LIRs that have never received an IPv4 allocation from the RIPE NCC (of any size) may request addresses from the waiting list, and they are only eligible to receive a single /24 allocation.

LIRs that have submitted an IPv4 request can see their position on the waiting list in the LIR Portal. A new graph has also been published that shows the number of requests on the waiting list and the number of days that the LIR at the front of the queue has been waiting:
https://www.ripe.net/manage-ips-and-asns/ipv4/ipv4-waiting-list

----------------------------------------------------------------
Call for Greater Progress on IPv6
----------------------------------------------------------------

This event is another step on the path towards global exhaustion of the remaining IPv4 addressing space. In recent years, we have seen the emergence of an IPv4 transfer market and greater use of Carrier Grade Network Address Translation (CGNAT) in our region. There are costs and trade-offs with both approaches and neither one solves the underlying problem, which is that there are not enough IPv4 addresses for everyone.

Without wide-scale IPv6 deployment, we risk heading into a future where the growth of our Internet is unnecessarily limited - not by a lack of skilled network engineers, technical equipment or investment, but by a shortage of unique network identifiers. There is still a long way to go, and we call on all stakeholders to play their role in supporting the IPv6 roll-out.

At the RIPE NCC, we are here to support our membership and the wider RIPE community in this work. Aside from allocating the IPv6 resources that will be required, we will continue to provide advice, training, measurements and tools to help network operators as they put their deployment plans into action.

We are optimistic and excited to see what the next chapter will bring. So let's get to work - and together, let's shape the future of the Internet.

Best regards,

Everyone at the RIPE NCC

Japp… RIPE NCC ist damit leer!

Siehe auch: IPv6 Grundlagen

Fragen? Einfach melden.

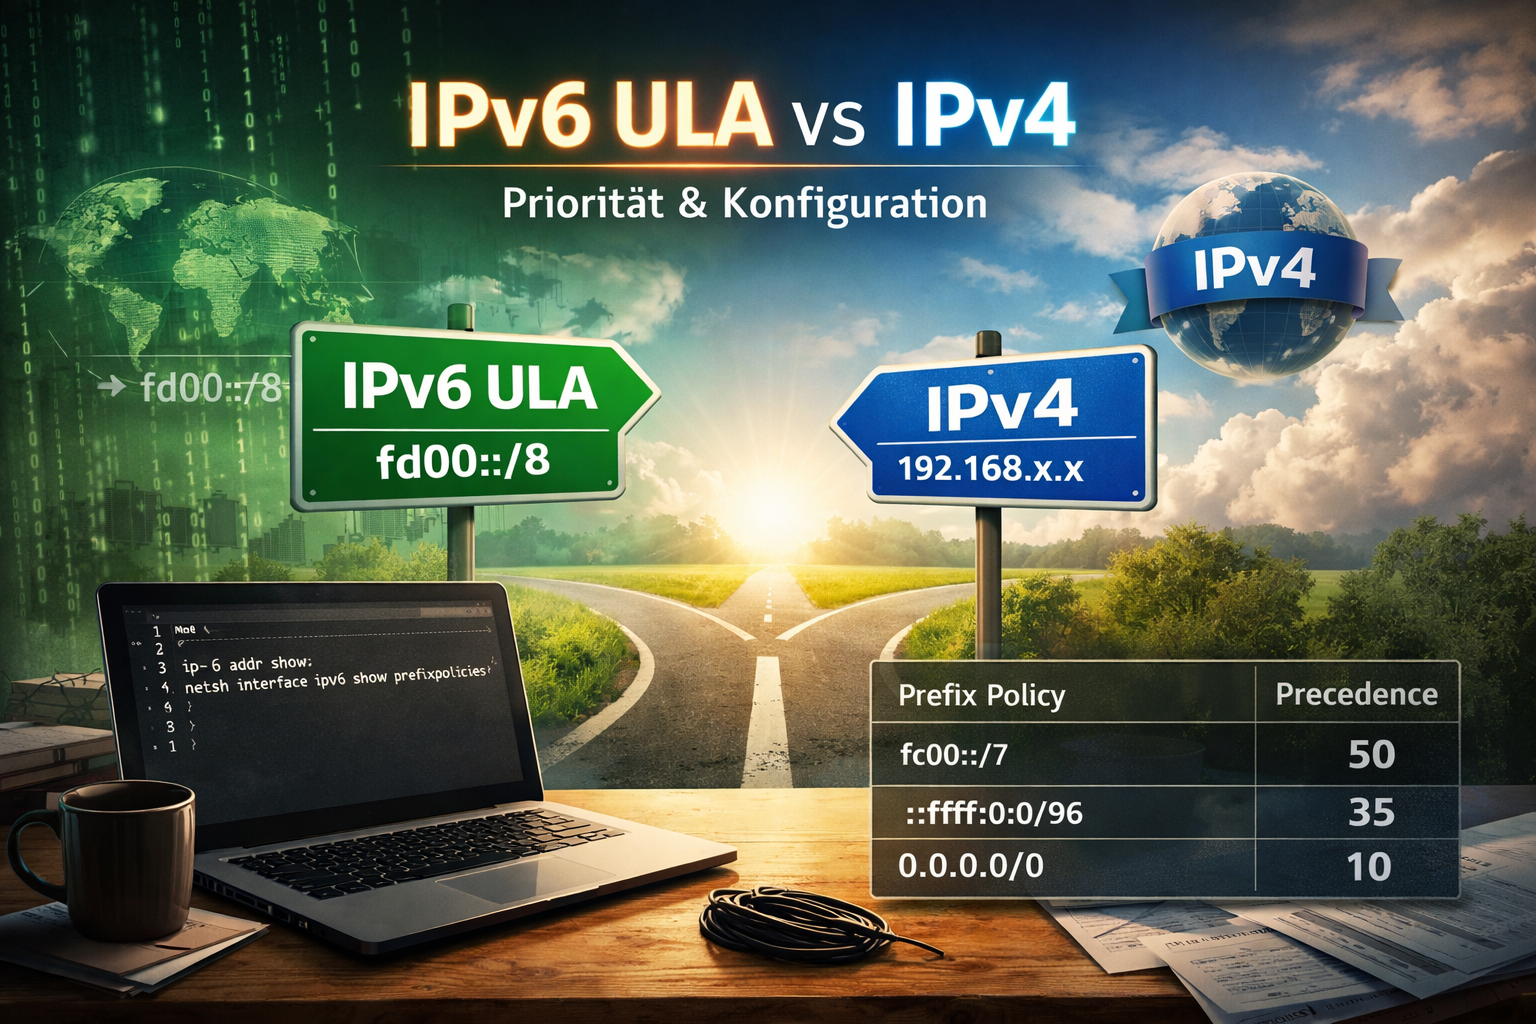
IPv6 ULA (fd00::/8), fc00::/7 und warum die Priorität oft anders ist als erwartet

Pv6 Unique Local Address fd00::/8 vs IPv4 – Priorität, Prefix Policy und Default Address Selection

Unique Local IPv6 Addresses sind eines dieser Themen, über die man meist erst stolpert, wenn man IPv6 ernsthaft benutzt. Nicht beim ersten „IPv6 ist an“-Häkchen, sondern dann, wenn man anfängt, Netze sauber zu trennen, VPNs aufzubauen, interne Services umzuziehen oder einfach keine Lust mehr auf NAT und IPv4-Private hat. Wer die IPv6-Grundlagen auffrischen will, findet dort den Einstieg.

ULA sollen genau das sein: lokal, eindeutig genug, nicht global routbar. Im Prinzip der IPv6-Nachfolger von 10/8 & Co. Klingt simpel. Ist es auch – bis man merkt, dass Betriebssysteme mit ULA manchmal Dinge tun, die man nicht intuitiv erwartet.

Fangen wir vorne an.

Der reservierte Adressraum für ULA ist fc00::/7. Das liest man oft so, und formal ist das auch korrekt. Praktisch relevant ist davon aber nur fd00::/8. Das sogenannte L-Bit (local) muss gesetzt sein. Der andere Teil, also fc00::/8, ist bis heute nicht weiter definiert und sollte in realen Netzen schlicht nicht verwendet werden. Wenn man ULA nutzt, dann immer fd….

Eine typische ULA sieht dann so aus:

fdXX:XXXX:XXXX::/48

Aufgeschlüsselt:

| 8 Bit | 40 Bit    | 16 Bit | 64 Bit        |
| fd    | Global ID | Subnet | Interface ID |
  • fd → Local-Bit gesetzt
  • Global ID → pseudozufällig, soll Kollisionen vermeiden
  • Subnet → klassische Subnetzstruktur
  • Interface ID → wie bei anderen IPv6-Unicast-Adressen

Die Global ID ist nicht „zentral vergeben“, sondern wird lokal generiert. Ziel ist nicht Sicherheit, sondern praktische Eindeutigkeit, falls Netze später zusammengeführt werden. In der Praxis funktioniert das erstaunlich gut.

Bis hierhin ist alles noch harmlos. Die eigentliche Verwirrung beginnt in dem Moment, in dem ein Host mehrere mögliche Wege zum Ziel hat.

Dual-Stack ist heute der Normalfall. IPv4 und IPv6 gleichzeitig. Und plötzlich steht ein System vor der Frage:
Nehme ich IPv4? Nehme ich IPv6? Und wenn IPv6 – welche Adresse eigentlich?

Die Antwort darauf regelt RFC 6724. Dort ist die Default Address Selection definiert. Vereinfacht gesagt: eine Prioritätenliste für Adresspräfixe. Jedes Präfix bekommt eine Präzedenz. Höher gewinnt.

Und genau hier liegt der Punkt, der viele überrascht:
IPv6 ULA haben nach RFC 6724 eine niedrigere Priorität als IPv4.

Das heißt ganz konkret:
Ist ein Ziel sowohl über IPv4 als auch über IPv6-ULA erreichbar, wird IPv4 bevorzugt.

Das fühlt sich erstmal kontraintuitiv an. IPv6 ist doch „das Neue“. Aber aus Sicht des Standards ist die Logik klar: ULA sind bewusst lokal begrenzt. IPv4 ist – trotz aller Altlasten – global eindeutig. Also gewinnt IPv4.

In der Praxis sieht man dieses Verhalten regelmäßig, vor allem auf Linux- und FreeBSD-Systemen, die sich sehr nah am RFC orientieren. Windows und Apple-Systeme mischen zusätzlich noch Happy-Eyeballs-Mechanismen hinein, was das Verhalten manchmal schwerer nachvollziehbar macht, am Grundprinzip aber nichts ändert.

Wenn man verstehen will, was ein System tatsächlich tut, hilft ein Blick in die jeweilige Prefix-Policy.

Diagnose: Welche Prioritäten nutzt mein System?

Linux:

ip -6 addr show
ip -6 route show
ip -f inet6 addrlabel show

Interessant ist vor allem die Ausgabe der Address-Labels. Dort sieht man, mit welcher Präzedenz fd00::/8, IPv4-Mapped-Adressen und andere Präfixe bewertet werden.

Windows:

netsh interface ipv6 show prefixpolicies

Hier sieht man sehr direkt, welche Präzedenz Windows den einzelnen Präfixen zuordnet. In der Default-Konfiguration liegt ULA unter IPv4.

FreeBSD:

ip6addrctl

Auch hier ist die RFC-6724-Policy gut sichtbar.

Spätestens an dieser Stelle wird klar, warum ein interner Dienst trotz sauber konfigurierter IPv6-ULA plötzlich doch über IPv4 angesprochen wird. Das System macht exakt das, was der Standard vorsieht.

Nun kann man sagen: „Okay, verstanden.“
Oder man kann sagen: „Das ist nicht das Verhalten, das ich will.“

Beides ist legitim.

Anpassung: ULA bewusst höher priorisieren

Wenn ULA für interne Kommunikation wichtiger sind als IPv4 – etwa in reinen IPv6-Infrastrukturen mit IPv4 nur als Fallback – kann man die Präzedenz anpassen.

Linux (/etc/gai.conf):

# IPv6 ULA höher priorisieren als IPv4
precedence fd00::/8  45

Nach einem Reload des Stacks oder Neustart gilt die neue Reihenfolge.

Windows:

netsh interface ipv6 set prefixpolicy fd00::/8 precedence=45 label=1

Damit liegt ULA über IPv4. Windows speichert diese Einstellung persistent.

FreeBSD:

Je nach Version über ip6addrctl oder entsprechende rc-Settings.

Wichtig: Das ist keine rein kosmetische Änderung. Man greift hier bewusst in die Adressauswahl ein. Das sollte man nur tun, wenn man das Netzdesign verstanden hat und weiß, warum man es will.

ULA sind kein Ersatz für Global Unicast Addresses. Sie sind auch kein Allheilmittel. Sie sind ein Werkzeug. Ein gutes – aber eben eines mit klar definiertem Scope.

Spannend ist, dass es inzwischen Entwürfe gibt, die das Verhalten von RFC 6724 weiterentwickeln. Ziel ist unter anderem, ULA-zu-ULA-Kommunikation besser zu priorisieren und bestimmte unerwünschte IPv4-Fallbacks zu vermeiden (ähnlich dem Problem mit Carrier Grade NAT und IPv6). Stand heute ist das aber noch nicht flächendeckend umgesetzt. Man sollte sich also nicht darauf verlassen, sondern das Verhalten der eigenen Systeme prüfen.

Am Ende bleibt:

ULA funktionieren. Sie sind sauber spezifiziert. Aber ihre Priorität ist kein Zufall, sondern eine bewusste Designentscheidung. Wer sie einsetzt, sollte wissen, warum IPv4 manchmal „gewinnt“ – und dann entscheiden, ob das so bleiben soll oder nicht.

Wie so oft bei IPv6 liegt das eigentliche Problem nicht im Protokoll, sondern in den Erwartungen, die man aus der IPv4-Welt mitbringt.

Siehe auch: IPv6 Grundlagen

Fragen? Einfach melden.

Mein IPv6 Samsung/HP Problem wurde gelöst!

Ich bin absolut überrascht. Das gesammte Thema war für mich nach der letzten Kommunikation „erledigt“. In den nächsten Jahren hätte ich nicht mehr mit einer Veränderung gerechnet…

Da kam heute aus dem Nichts folgende E-Mail:

Hallo Herr van de Meer,
 
manchmal geschehen noch kleine Wunder. Ich habe heute ein .par File für unsere IPv6 Herausforderung bekommen und erfolgreich bei meiner Maschine testen können.
Es ist jetzt also auch mit Samsung Maschinen möglich, eine „saubere und korrekte IP Adresse“ zuzuweisen.
Wenn noch Bedarf besteht, stelle ich ihnen gerne ein Link zum Download zur Verfügung.
 
Beste Grüße nach Bonn

Ich habe natürlich diesen Patch angefragt, blitzartig bekommen und eingespielt.

macbook-s-meer:~ kernel$ ping6 -c3 fd00:118f:335:62::253
PING6(56=40+8+8 bytes) fd00:118f:335:42:c3:51f8:2949:1641 --> fd00:118f:335:62::253
16 bytes from fd00:118f:335:62::253, icmp_seq=0 hlim=63 time=0.884 ms
16 bytes from fd00:118f:335:62::253, icmp_seq=1 hlim=63 time=0.703 ms
16 bytes from fd00:118f:335:62::253, icmp_seq=2 hlim=63 time=0.718 ms

--- fd00:118f:335:62::253 ping6 statistics ---
3 packets transmitted, 3 packets received, 0.0% packet loss
round-trip min/avg/max/std-dev = 0.703/0.768/0.884/0.082 ms

Das geht jetzt einfach! Das geht wirklich. Ich kann dem Drucker eine feste IP Adresse meiner Wahl geben.

Siehe auch: IPv6 ULA und Priorität

Fragen? Einfach melden.

Mein IPv6 Samsung/HP Problem geht weiter..

Die Antwort auf meine letzte Nachricht war schnell!

JSP-Framework sind Java-Serverseiten, die in SWS verwendet werden.
Bevor wir die Benutzereingaben von Java-Serverseiten auf unsere Backend-Module anwenden, wird geprüft, ob die angegebenen Werte die vordefinierten Anforderungen erfüllen, die für diese Werte festgelegt sind.
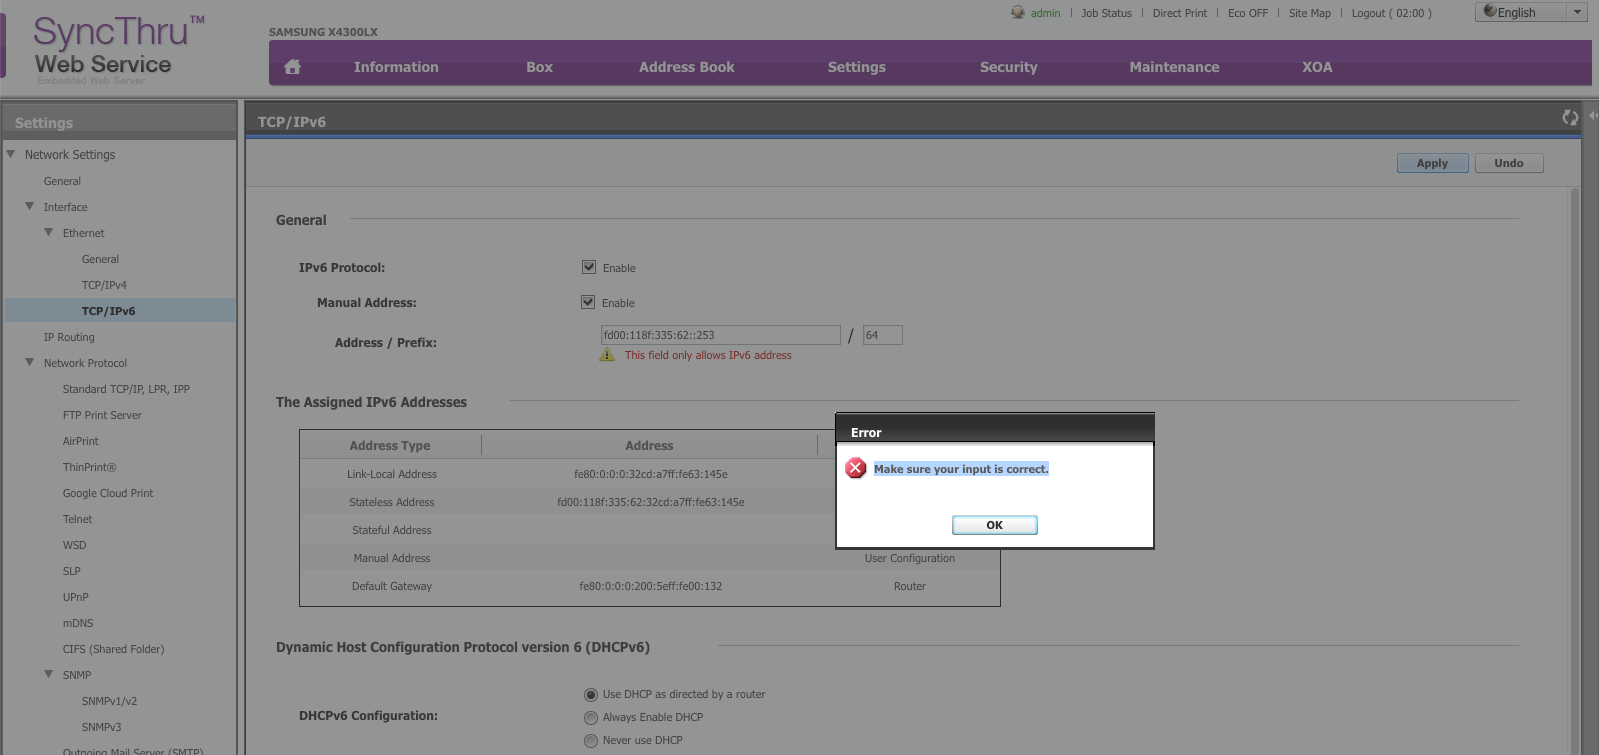
Der Kunde kann die angegebene IP-Adresse (fd00) nicht anwenden, da unsere in JSPs vorhandenen Validierungsprüfungen fehlschlagen, bevor der Wert an Backend-Module übergeben wird.
Das JSP-Framework und die Bibliotheken sind offene Frameworks und werden von unserer Firmware intern verwendet.
Dies bedeutet jedoch, dass wir das entsprechende JSP-Framework selbst nicht ändern oder ändern können.
Daher unterstützen unsere Geräte die eindeutige lokale Adressierungsfunktion nicht.
Der Workaround (it is recommended to use the link local address fe80:333:333:62::253 instead of the fd00:333:333:62::253 IPv6 address), den wir zur Verfügung gestellt haben, ist alles, was wir tun können.

Der vorgeschobene Grund JSP-Framework hält nicht mal bis zum Satzende. Ein ehrliches: „Ja das ist ein Problem, dieses ist uns aber im Moment egal weil das Problem weniger als 1% unserer Kunden haben und wenn sich dieses ändert schauen wir es uns an!“…. So etwas wäre noch immer nicht gut aber ehrlich. Der Grund JSP-Framework beleidigt mich zusätzlich!

Damit sind wir wohl am Ende mit dem Thema.

Siehe auch: IPv6 ULA und Priorität, IPv6 ULA und das SyncThru Web Service von Samsung / HP mögen sich nicht…, Ich brauche einen HP/Samsung Techniker – Update zum IPv6 Druckerproblem, Mein IPv6 Samsung/HP Problem wurde gelöst!

Fragen? Einfach melden.

Ich brauche einen HP/Samsung Techniker – Update zum IPv6 Druckerproblem

Ihr erinnert euch sicher noch an das IPv6 Druckerproblem zwischen uns und HP/Samsung, oder? Es gibt ein kleines Updates zu dem Thema!

Betreff: RE: X4300 und IPv6
  
was ist aus der IPv6 Anfrage des Kunden geworden? Hat der Admin einen anderen Weg gefunden?
Wir hatten den Fall eskaliert und folgende Antwort bekommen:
 
JSP will successfully validate only following IPv6 address types in manual address box:1. Site local IPv6 addresses (With prefix fec0)2. Link local addresses with prefix fe803. Global unicast addresses with prefix
 
Das heißt zusammengefasst, dass der Kopierer nicht mit einer Unique Local Address (fd00 Präfix) arbeiten kann.
Ich würde mich freuen, wenn sie sich diesbezüglich nochmal bei uns melden, damit wir wissen, ob wir den Fall schließen können.
 
Danke und beste Grüße

fec0?!?!? Das war eine Idee aus 1995 welche 2004 aus guten Gründen mit RFC 3879 gekippt wurde. Der Drucker frisst also fe80 sauber per EUI-64 (oh was ein wunder), globale Adressen (ok, kann jemand sinnvolle und brauche Ansätze nennen warum man das tun sollte?!?) und Adressen die man seit knapp 15 Jahren nicht mehr benutzen sollte.

Mal sehen wie Samsung / HP nun darauf reagiert. Ich kann doch nicht der einzige auf diesem Planeten mit dem Problem sein. dieses JSP-Ding wird doch auf allen erdenklichen Netzwerkdruckern eingesetzt. Das muss doch noch jemandem auffallen, oder? Dieser Bug muss doch nur von einem Entwickler dort gelesen werden, der versteht was ich sage, dann macht er es schnell schön und gelöst ist das Problem. Ist da denn keiner?!?

Siehe auch: Mein IPv6 Samsung/HP Problem geht weiter.., Mein IPv6 Samsung/HP Problem wurde gelöst!

Fragen? Einfach melden.

IPv6 ULA und das SyncThru Web Service von Samsung / HP mögen sich nicht…

Inzwischen ist es kaum noch etwas Besonders von seinem ISP mit einem echten globalen IPv6 /64 beworfen zu werden. Dualstack bietet fast jeder an. Die meisten Dienste im Internet sind ebenfalls so erreichbar und fast jeder in der IT hat zumindest schon mal von IPv6 gehört.

Nicht ganz so bekannt sind anscheinend bei IPv6 die ULAs die Unique Local Addresses RFC 4193. Es ist der Bereich fc00::/7 und im speziellen der Bereich fd00::/8 ist bei IPv6 vergleichbar mit den alten bekannten 10.0.0.0/8, 172.16.0.0/12 und natürlich 192.168.0.0/16. Wenn mal also sein internes Netzwerk für IPv6 Aufbaut benutzt man diese Adressen.

Auf der Arbeit beschäftigen wir uns auch mit diesem Thema. Wir haben uns ein /48 gewürfelt, geplant wie wir verschiedene /56 daraus auf die verschiedenen Standorte verteilen bis am Ende in den verschiedenen Netzten ein /64 per RA herauskommt. Stück für Stück verteilen wir im Moment die einzelnen Netze und so bekommen immer wieder neue Systeme zu ihrer IPv4 Adresse auch eine IPv6 Adresse. Immer mal wieder stößt man selbst 2018 dabei noch auf Überraschungen. Die eine oder andere werde ich in der nächsten Zeit mit euch teilen.

Starten möchte ich heute mit unserer Samsung Printstation X4300LX. Diesem Drucker wollten wir die im zugedachte IPv6 ULA fest einstellen. Leider beantwortete der Drucker diesen Versuch immer nur mit: Make sure your input is correct. This field only allows IPv6 address

Gehen wir erst einmal auf das Thema fest einstellen ein, bevor dazu die ersten Mails kommen.

Bei IPv6 sollte der Client selbst sich darum kümmern eine Adresse zu haben. Selbst im kleinsten „sinnvollen“ IPv6 Netz (/64) gibt es so viele Adressen, dass bekannte zentrale Möglichkeiten schnell gestresst sein könnten. Daher bekommt der Client per RA Router Advertisement einige der nötigen Informationen um sich selbst eine Adresse zu basteln. Im Zusammenspiel mit der eigenen MAC Adresse kommt dann eine IPv6 Adresse zustande. Sofern diese Adresse nicht schon einmal im Netzwerk vertreten ist (dieses prüft der Client selbst per NDP Neighbor Discovery Protocol) hat der Drucker damit immer die selbe Adresse. Warum also selbst eine feste IPv6 Adresse am Drucker vergeben? Nun ja, für die Zeit der Umstellung ist es etwas einfacher wenn die IPv6 Adressen für uns Menschen etwas übersichtlicher sind. Die eigentlichen Benutzer kommen an keiner Stelle mit den Adressen in Berührung, sie nutzen ausschließlich den DNS Namen. Für uns Admins ist es dennoch etwas einfacher wenn gewisse zentale Systeme schon für uns an der IPv6 Adresse erkennbar sind. Zumindest solange wir noch im Aufbau des gesamten ULA Netzwerkes bei uns sind. Später wird dieses natürlich anders sein.

Zurück zum Drucker! Die eingegebene IPv6 Adresse ist natürlich gültig und absolut korrekt. Also haben wir uns an unseren Servicepartner für den Drucker gewendet. Hier ist IPv6 noch nicht so „weit“. Aussage war das wir die Ersten sind welche sich zu diesem Thema jemals gemeldet haben. Unser Servicepartner hat sich selbst noch etwas schlau gemacht und ist dann direkt in Kontakt mit Samsung / HP getreten. Die erste Rückmeldung die wir bekommen haben ist: Wenn wir das fd00 zum Beginn weglassen, dann könnten wir eine Adresse eintragen. Sie könnten dieses an verschiedenen Drucker so nachstellen. Zusammen sind wir dann zum Schluss gekommen, dass einfach die Adressüberprüfung vom Samsung SyncThru Web Service einen Bug hat. Unser Servicepartner ist also wieder in Kontakt mit seinem Ansprechparnter bei Samsung / HP getreten. Von diesem kam einige Zeit später eine E-Mail welche uns weitergeleitet wurde. In dieser E-Mail wird uns erklärt das IPv6 Adressen eindeutig sein sollten und wie sich aus der MAC Adresse eine IPv6 Adresse berechnet. Was natürlich absolut korrekt ist, unser eigentliches Problem nur leider nicht betrifft oder löst. Wir haben also wieder mit unserem Servicepartner gesprochen welcher uns wenig Hoffnung machte. Wenn Samsung / HP meint keinen Fehler gemacht zu haben wird es schwer ihnen das Gegenteil zu beweisen. Wir könnten dem Drucker ja einfach per DHCPv6 eine Adresse reservieren….

Joar könnten wir…. Wir haben einen zentralen DHCPv4 und auch einen zentralen DHCPv6 Server. Verschiedene DHCP-Relay Server leiten die Anfragen aus verschiedenen Netzten an diesen weiter. Dieses funktioniert für IPv4 und IPv6 problemlos. Für IPv4 kümmert er sich zusätzlich um gewisse Reservierungen und die Adressvergabe. Bei IPv6 (hierzu ist im RA das Flag „other config“ gesetzt) holt er sich Dinge wie DNS, Timeserver, Searchdomains usw… Wir wollen aus beschriebenen Gründen keine Adressreservierungen per DHCPv6. Ausgewählte Systeme bekommen hier eine eindeutige und vorher definierte IPv6 Adresse und der Rest darf alleine rechnen. DHCPv6 fällt also raus. Für diese Druckstation werden wir also ersteinmal die selbstgerechnete Adresse benutzen bis wir es zusammen mit unserem Servicepartner geschafft haben Samsung / HP davon zu überzeugen das es einen Bug in ihrem SyncThru Web Service gibt.

Wenn also jemand einen guten Kontakt hat….. Wir können ja nicht die Einzigen sein welche versuchen ein ULA Netz aufzubauen, oder?

Samsung / HP sind nicht die Einzigen welche hier noch Probleme haben. Wir sind noch auf viele andere spannende Dinge gestoßen und wir werden sich noch auf einige kommen. Ausgewählte wird es hier wie angekündigt geben!

Siehe auch: IPv6 Samsung/HP Problem gelöst, Ich brauche einen HP/Samsung Techniker – Update zum IPv6 Druckerproblem, Mein IPv6 Samsung/HP Problem geht weiter..

Fragen? Einfach melden.

IPv6 Traffic hat sich verdoppelt

Wenn ich meine Graphen so verfolge sehe ich eine Verdopplung des IPv6 Traffics seit dem Anfang diesen Jahres beim HTTPS Traffic. SMTP ist es nur knapp 50% mehr. Ich würde nun jetzt einfach mal behaupten dass inzwischen viel mehr Enduser mit einer IPv6 Adresse unterwegs sind und Mailserverbetreiber so schnell nicht „nachziehen“.

Mich überrascht dieser starke Anstieg in 2017 etwas daher habe ich nun mal alles gegen meinen IPv4 Traffic gehalten.

Insg. habe ich von meinen Systemen ausgehend 12,5% mehr IPv6 Traffic als IPv4 Traffic. Eingehend habe ich tatsächlich 6% mehr IPv6 Traffic als IPv4 Traffic. OK OK jetzt bin ich dabei sicher nicht repräsentativ… Nur ist in 2017 das Verhältnis zumindest bei mir von IPv4 zu IPv6 gekippt. Jetzt sind alle Systeme bei mir durchgängig IPv6 fähig und alles bewegt sich sicher sehr in seiner eigenen Blase, nicht zu viel herein steigern…

Gab es da nicht vor Kurzem eine Heise Meldung?

https://www.heise.de/newsticker/meldung/IPv4-Adressen-immer-knapper-Adressklau-sogar-mit-gefaelschter-Sterbeurkunde-3872129.html

Schaue ich mir die großen an sieht man das es mehr wird und vor allem auch bei uns in Deutschland:

https://www.google.de/ipv6/statistics.html

https://stats.labs.apnic.net/ipv6

Mit einigen Bekannten habe ich ebenfalls gesprochen, hier zeigt sich ein sehr ähnliches Bild. Wir bleiben nur immer in der gleichen „Blase“. Mein Brötchengeber wäre noch ein ganz guter und sicher schon ein repräsentativ Statistikgeber, nur leider ist es hier produktiv noch extrem dunkel wenn es um IPv6 geht. 🙁 Hier gibt es gerade andere Baustellen.

Wie ist es denn bei euch? Jemand ein paar Zahlen oder Links für mich?

Update

Na schau an, eine erste Anregung habe ich schon mal. Mobile Endgeräte... Wenn man nicht gerade bei der Telekom ist sind viele noch mit ihren Smartphones auf IPv4 festgebunden. Statistiken von google/facebook/twitter usw. wird dieses sicher stark verfälschen. Wobei *grübel* verfälschen? Ist „das Internet“ (ich denke gerade an The IT Crowd) nicht inzwischen eher Smartphone? Benutzer mit einem Smartphone werden meine Webseite kaum anschauen, denn sie sieht mit so einem Gerät noch viel schlimmer aus als sie es bereits mit einem normalen Browser tut.

Siehe auch: IPv6 Grundlagen

Fragen? Einfach melden.

« Ältere Beiträge

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑