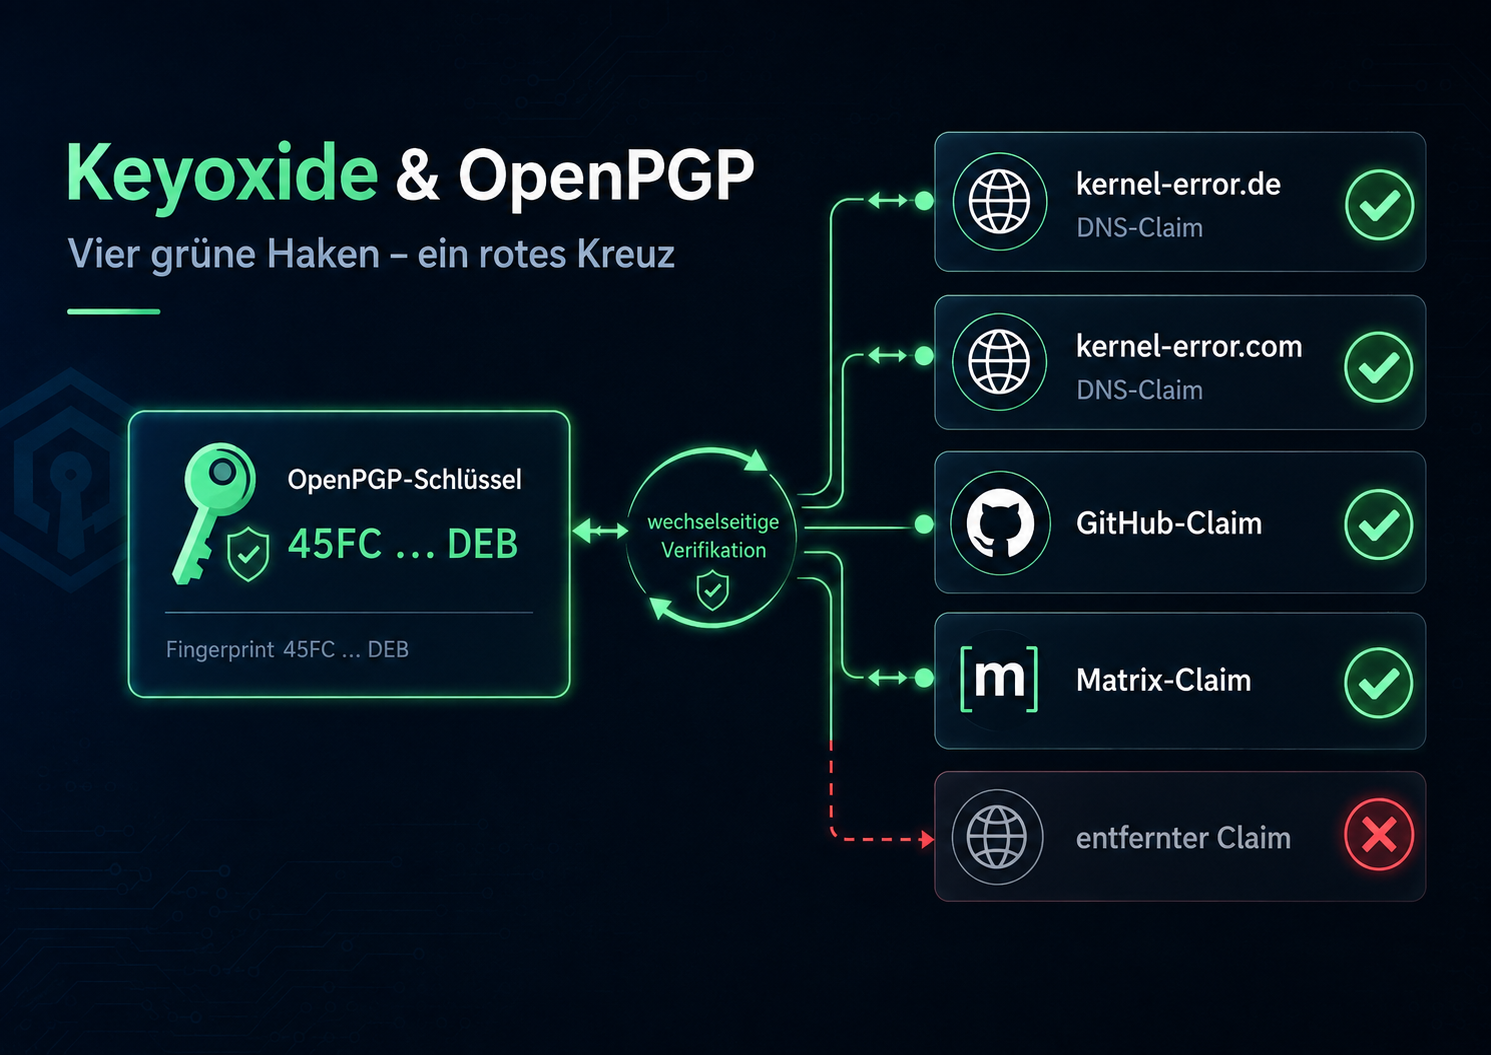
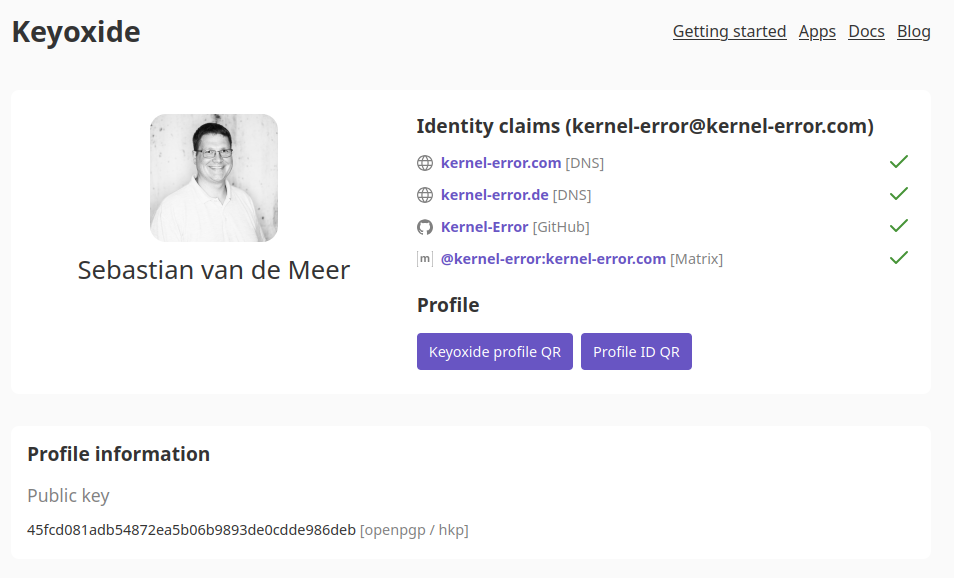
Zwei Keyoxide-Beiträge liegen schon hier, im ersten vier Claims über DNS, GitHub und Matrix, im zweiten die Linux-App und der Matrix-Kanal des Projekts. Was in beiden fehlte, war ein fünfter Claim, der genau dieses Blog beweist, den Fediverse-Actor @kernel-error.de@www.kernel-error.de. Der ist keine Mastodon-Instanz, sondern das WordPress-ActivityPub-Plugin, das aus diesem Blog selbst einen Actor macht. Im August habe ich genau diesen Claim gebaut, ausgerollt und noch am selben Tag wieder zurückgebaut, weil er einfach nicht grün wurde. Das hier ist die Geschichte, warum nicht, und was seit heute anders ist.
Der gescheiterte erste Versuch im August
Der Claim in der Selbstsignatur des Schlüssels: proof@ariadne.id=https://www.kernel-error.de/@kernel-error.de. Der Beweis dazu: ein Extra Field des ActivityPub-Plugins namens OpenPGP mit dem Wert openpgp4fpr:45FC…6DEB, exakt die Platzierung, die Keyoxide selbst als unterstützt dokumentiert. Der Actor lieferte auch wortgetreu {"type":"PropertyValue","name":"OpenPGP","value":"openpgp4fpr:45FC…6DEB"} aus. Trotzdem blieb der Claim rot.
Bei der Fehlersuche im August ist mir dabei ein echter Bug auf der eigenen Seite untergekommen und gleich mitgefixt: WordPress beantwortete OPTIONS-Anfragen auf die Actor-URL mit einem 301 auf die Startseite, ein umgeleiteter CORS-Preflight scheitert damit in jedem Browser hart. Eine eigene nginx-Location, die den Preflight selbst mit 204 beantwortet, hat das behoben, dauerhaft, unabhängig vom Rest dieser Geschichte, weil es jeden browserseitigen Consumer des Actors betrifft. Das steht bereits ausführlich im ersten Keyoxide-Beitrag.
Was im August systematisch ausgeschlossen wurde
Nach dem CORS-Fix ließ sich der Actor sauber abrufen, im Access-Log stand GET /@kernel-error.de 200 … "doipjs/2.1.0", das Werkzeug hinter Keyoxide hatte den Actor also tatsächlich in der Hand. Der Rest wurde einzeln durchgestrichen. Provider-Matching: die ActivityPub-Regel von doipjs ist ein Catch-all für jede https-URL, NodeInfo-Anfragen im Log belegten, dass die ActivityPub-Nachbearbeitung wirklich lief. Feld-Pfad: attachment.value ist einer von drei Pfaden, die doipjs durchsucht, neben summary und content. Groß- und Kleinschreibung des Fingerprints: doipjs kleinschreibt vor dem Vergleich, also irrelevant. Am Ende blieb nur ein Rückbau übrig, Notation raus, Redeploy über alle sieben Schlüssel-Kanäle, Feld gelöscht. Alles sah richtig aus, und trotzdem war es rot. Genau dieser Widerspruch ist der Grund, warum ich das jetzt, im September, zu Ende verfolgt habe.
Die Ursache im Verifizierer: doipjs und runJSON
doipjs ist die Bibliothek hinter keyoxide.org, Quelltext offen auf Codeberg. Die eigentliche Suchfunktion heißt runJSON(proofData, checkPath, params) und läuft einen JSON-Pfad ab. Zwei Zeilen daraus erklären den ganzen Fehler:
// Array: der Reihe nach abarbeiten, kein try/catch pro Element
if (Array.isArray(proofData)) {
  let result = false
  for (let index = 0; index < proofData.length; index++) {
    if (result) { continue }
    result = await runJSON(proofData[index], checkPath, params)
  }
  return result
}

// Objekt ohne den naechsten Schluessel im Pfad: wirft, sofort
if (typeof proofData === 'object' && !(checkPath[0] in proofData)) {
  throw new Error('err_json_structure_incorrect')
}
Steckt der Beweis in einem Array, iteriert runJSON über die Einträge und ruft sich selbst für jedes Element auf, ohne dabei einzelne Fehler abzufangen. Fehlt einem Objekt der nächste erwartete Schlüssel im Pfad, wirft die Funktion sofort. Beides zusammen bedeutet: im ersten Element eines Arrays, dem der gesuchte Schlüssel fehlt, bricht die ganze Suche ab, alles danach wird nie mehr angeschaut. Aufgefangen wird das erst eine Ebene höher, in run(), und zwar pro Zielpfad einzeln, summary, attachment.value, content bekommen je einen eigenen Try-Block. Ein Wurf in attachment.value gibt also nur diesen einen Pfad auf, summary und content laufen trotzdem weiter, finden dort aber naturgemäß nichts, weil der Beweis nur im Attachment-Array steht.
Die andere Hälfte: wie das ActivityPub-Plugin Profilfelder ausliefert
Die zweite Hälfte des Bugs steckt im WordPress-Plugin selbst, in class-extra-fields.php, Funktion fields_to_attachments(). Für jedes einzelne Profilfeld erzeugt die Funktion nicht ein Attachment, sondern zwei: zuerst ein klassisches PropertyValue mit name und value, das ist die Tabelle, die Mastodon rendert. Danach, als Unterstützung für FEP-fb2a, entweder ein Link mit href, wenn der Wert ein einzelner Link ist, oder ein Note mit content, wenn nicht.
Weder Link noch Note hat einen Schlüssel namens value. Im echten Actor sah das im August deshalb so aus:
attachment[0]  PropertyValue  Blog   value=...   geprueft, kein Treffer
attachment[1]  Link           Blog   href=...    kein value-Schluessel, wirft
attachment[2+] ...                               nie erreicht
doipjs prüft auf einem WordPress-Actor also faktisch nur attachment[0]. Die bestehenden Felder standen im August in der Reihenfolge Blog, GitHub, Matrix, Kontakt, das OpenPGP-Feld kam als fünftes dazu und lag damit nie an erster Stelle. Genau das erklärt jede einzelne Beobachtung von damals: erfolgreich abgerufen, korrektes JSON im Feld selbst, trotzdem rot.
Warum das auf Mastodon nie auffällt
Mastodon liefert für seine eigenen Profilfelder ausschließlich PropertyValue-Einträge aus, jedes Element im Array trägt also value, und die Schleife läuft ungestört durch, egal an welcher Position der Beweis steht. Der FEP-fb2a-Zusatz ist eine Erweiterung für genau die Fälle, die Mastodon nicht abdeckt, in diesem Fall anklickbare Links im Profil außerhalb der reinen Tabellenoptik. Niemand hat hier etwas falsch gemacht: das Plugin erweitert sinnvoll über Mastodon hinaus, doipjs ist gegen Mastodons Datenform geschrieben, und beide Annahmen treffen für sich genommen zu. Nur zusammen ergeben sie eine Reihenfolge-Abhängigkeit, die auf keinem der beiden Wege sichtbar wird, wenn man nur die eigene Seite testet.
Beim Gegenlesen dieser Analyse kamen noch zwei Präzisierungen dazu, die den Befund nicht ändern, aber schärfen. Erstens: ein Wurf in attachment.value beendet nicht die gesamte Verifikation, nur diesen einen Pfad, summary und content laufen wie oben beschrieben trotzdem weiter. Zweitens: ein reiner Unit-Test von verifications.run() übergeht den eigentlichen Netzwerk-Abruf, der wirkliche Beweis ist ein kompletter Durchlauf über Claim.match() und verify() gegen den lebenden Actor, dazu unten mehr. Vorschlag aus derselben Runde war außerdem, den Beweis zusätzlich oder stattdessen im Profil-summary zu platzieren, das ist positionsunabhängig. Entscheidung: das Extra Field bleibt, weil es das sauberere Profil ergibt, die Reihenfolge-Abhängigkeit wird dafür hier dokumentiert, summary bleibt die bekannte Rückfalloption.
Reproduziert, bevor irgendetwas am Schlüssel geändert wurde
Bevor der Schlüssel angefasst wurde, habe ich doipjs 2.1.0 lokal aus npm in ein Wegwerf-Verzeichnis installiert und dessen eigene verifications.run() plus die ActivityPub-Provider-Definition direkt gegen das echte, live abgerufene Actor-JSON laufen lassen, mit dem Beweis an unterschiedlichen Positionen eingesetzt:
live actor, unveraendert                             result=false errors=["err_json_structure_incorrect","err_json_structure_incorrect"]
OpenPGP an erster Stelle (Index 0)                   result=true  errors=[]
OpenPGP an letzter Stelle (Index 8), wie im August    result=false errors=["err_json_structure_incorrect","err_json_structure_incorrect"]
Nur PropertyValue (Mastodon-Form), OpenPGP letzte     result=true  errors=[]
Die beiden Fehler in den ersten zwei Zeilen sind der attachment.value-Pfad, dort steht der Link- oder Note-Eintrag ohne value, und der content-Pfad, ein Person-Actor hat kein Top-Level-content-Feld. Die letzte Zeile ist die Kontrollprobe: derselbe Beweis an derselben Position funktioniert, sobald das Array die reine Mastodon-Form hat. Vier Zeilen, die die ganze Geschichte erzählen. Der relative Importpfad war dabei nötig, doipjs/src/… lässt sich nicht als Package-Subpath importieren, die exports-Angabe in dessen package.json blockt das.
Der Fix auf dem Blog
Das Extra Field OpenPGP wurde neu angelegt, mit menu_order = -1, während die bestehenden vier auf 0 bis 3 stehen, Inhalt im selben Absatz-Blockformat, das das Plugin auch für die anderen Felder benutzt, <!-- wp:paragraph --><p>openpgp4fpr:45FC…6DEB</p><!-- /wp:paragraph -->. Eingefügt wurde das per direktem $wpdb->insert(), nicht über wp_insert_post(), weil Letzteres die ActivityPub-Hooks auslöst und ein Update für den Actor in die Outbox stellt, das später als Geister-Post auftaucht, Blog-Titel, Datum 2003. Gemessen: ap_outbox stand vorher und nachher bei genau demselben Wert. Danach zuerst der Redis-Object-Cache geleert, dann der nginx-FastCGI-Cache, die umgekehrte Reihenfolge würde FastCGI aus noch altem Redis-Inhalt neu befüllen. Im lebenden Actor sieht das Ergebnis jetzt so aus:
Der reine Text bekommt hier eine Note als Begleitung, kein Link drin, also kein Link-Eintrag. attachment[0] trägt jetzt den Beweis, genau da, wo doipjs zuerst und im Zweifel einzig hinsieht.
Die Gegenprobe vor der Schlüsseländerung
Nur der Reihenfolge-Test allein hätte mir nicht gereicht. Vor der eigentlichen Schlüsseländerung lief deshalb ein kompletter doipjs-Durchlauf, Abruf, Provider-Matching, Verifikation, Nachbearbeitung, gegen die produktive Seite, mit dem Fingerprint direkt übergeben, den Beweis brauchte der Schlüssel dafür noch nicht:
const claim = new Claim('https://www.kernel-error.de/@kernel-error.de', FINGERPRINT)
claim.match()      // ergibt: activitypub, owncast (die URI ist absichtlich mehrdeutig)
await claim.verify()
// ergibt: status 200 (VERIFIED), provider "wordpress" (aus NodeInfo),
//         profile "@kernel-error.de@www.kernel-error.de"
Erst nachdem dieser Test grün war, bekam der Schlüssel die Notation, dieselbe Regel wie schon bei den DNS-Claims: der Schlüssel behauptet nie öffentlich etwas, das noch nicht beweisbar ist.
Schlüssel und Redeploy über sieben Kanäle
Die Notation kam ausschließlich in die Namens-UID, in einer skriptgesteuerten gpg --batch --command-fd 0 --edit-key-Sitzung, sonst bekommt auch die Foto-UID den Claim mit. Danach geprüft: fünf Claims auf UID 1, Algorithmus-Präferenzen und Feature-Flags unverändert, die Governikus-eID-Zertifizierung und die Gegensignatur des alten Schlüssels weiterhin gültig, Ablaufdaten unverändert, Foto-UID unangetastet. Jede Claim-Änderung erzeugt eine neue Selbstsignatur, deshalb musste der aktualisierte Schlüssel auf alle sieben Kanäle: keys.openpgp.org, keyserver.ubuntu.com, pgpkeys.eu, WKD, sowohl über die Advanced-Methode via keys.openpgp.org als auch direkt selbst gehostet, der Download auf dem Blog, und der DANE-OPENPGPKEY-Record per Zone-Freeze/Thaw, DNSSEC-ad-Flag danach an drei öffentlichen Resolvern geprüft.
Eine gute Frage, die während des Rollouts aufkam: wenn WKD auf der eigenen Seite doch reicht, warum überhaupt noch auf die Keyserver hochladen, während gerade erst getestet wurde? Zwei Antworten. Erstens war der Test zu diesem Zeitpunkt schon abgeschlossen, der Ende-zu-Ende-Check lief gegen den lebenden Actor mit dem blanken Fingerprint, bevor der Schlüssel den Claim überhaupt trug, veröffentlicht wurde der Schlüssel erst, als das Ergebnis grün war. Zweitens ist WKD hier gar nicht wirklich nur die eigene Seite: die WKD-Advanced-Methode unter openpgpkey.kernel-error.com ist ein CNAME auf den WKD-Dienst von keys.openpgp.org, und Clients probieren Advanced zuerst. Auch das Keyoxide-Profil per Fingerprint holt sich den Schlüssel von keys.openpgp.org. Ohne das Keyserver-Update hätten die meisten Prüfer also weiterhin den alten Schlüssel mit vier Claims gesehen. Wahr und ebenfalls wichtig: Keyserver behalten jede Generation einer Selbstsignatur, es zählt nur die jüngste. Ein Claim lässt sich mit einer neueren Selbstsignatur zurückziehen, die alte Version verschwindet aber nie, das gehört vor der Veröffentlichung mitentschieden, nicht danach.
Das Ergebnis
Der Schlüssel abgerufen wie ein Fremder ihn abrufen würde, per HKP von keys.openpgp.org und per WKD, und mit doipjs gegen alle fünf Claims geprüft:
OK  200  wordpress  @kernel-error.de@www.kernel-error.de
OK  200  github     Kernel-Error
OK  200  dns        kernel-error.de
OK  200  dns        kernel-error.com
(Matrix braucht auf der Pruefer-Seite einen echten Matrix-Account, auf keyoxide.org gruen, in einem blanken lokalen Test nicht pruefbar)
Der Provider steht dabei als wordpress, doipjs liest den Software-Namen aus NodeInfo aus, bei diesem Blog tatsächlich {"software":{"name":"wordpress","version":"7.1"}}, live nachgeprüft. Die naheliegende erste Reaktion darauf war „müsste da nicht Mastodon stehen?“, die Antwort gehört in diesen Beitrag: der Account ist ein Fediverse-Account, kein Mastodon-Account, Mastodon ist nur eine von mehreren Implementierungen. Ein Account auf mastodon.social würde [mastodon] zeigen, einer auf einer GoToSocial-Instanz [gotosocial]. Man könnte den Namen in NodeInfo fälschen, das wäre aber falsch und nicht nur stilistisch: Server und Clients passen ihr Verhalten am Software-Namen aus, sie würden dann Mastodon-spezifische Endpunkte abfragen, die hier gar nicht existieren, und es wäre eine unwahre Aussage in einem Profil, dessen ganzer Zweck überprüfbare Echtheit ist.
Frische Schlüsselbunde über gpg --auto-key-locate clear,<methode> --locate-external-keys liefern für WKD, DANE und Keyserver jeweils alle fünf Claims. Größen mit fünf Claims: WKD direkt 13178 Byte, der volle Download 17926 Byte, der DANE-Record 1368 Byte, davon 70 Byte allein für diesen neuen Claim. Im Actor liegt attachment[0] jetzt auf PropertyValueOpenPGP, attachment[1] auf dessen Note-Begleitung, der Wert steht als reiner Text ohne umschließendes <p>, weil ein vorhandenes Code-Snippet auf dem Blog genau das aus Extra-Field-Werten entfernt, ursprünglich damit Mastodons rel="me"-Linkprüfung funktioniert, die einen nackten <a> als Wurzelelement erwartet. Zwei verschiedene Prüfer, zwei verschiedene Annahmen über die Form derselben Daten, an dieser einen Stelle trifft es genau zusammen.
Auf Mastodon selbst zeigt sich das neue Profilfeld erst, wenn entfernte Instanzen den Actor erneut abrufen, absichtlich wurde keine Update-Aktivität verschickt, das wäre wieder der Geister-Post-Mechanismus von oben. Keyoxide betrifft das nicht, das Werkzeug holt den Actor bei jeder Prüfung frisch.
Fünf von fünf, seit heute auch der Fediverse-Claim.
Lektionen
„Bei mir ist alles richtig“ kann wahr sein und trotzdem scheitern. Entscheidend sind die Annahmen des Verifizierers über die Form der Daten, nicht nur der Inhalt. Den Quelltext des Prüfers lesen, bevor man die eigene Seite zum fünften Mal durchsucht.
Eine Plugin-Funktion für bessere Zukunftskompatibilität, hier FEP-fb2a, bricht einen Verbraucher, der gegen Mastodons Datenform geschrieben wurde. Für sich genommen ist keiner der beiden im Unrecht.
Eine versteckte Abhängigkeit blieb übrig: der Beweis funktioniert nur, solange das OpenPGP-Feld das erste Profilfeld ist. Wer eigene Extra Fields verwaltet, sollte das im Kopf behalten.
Ein Upstream-Report an doipjs auf Codeberg ist noch nicht eingereicht. Der eigentlich richtige Fix wäre ein Try/Catch pro Array-Element in runJSON, das würde nebenbei auch die Abhängigkeit von der Feldreihenfolge auflösen.
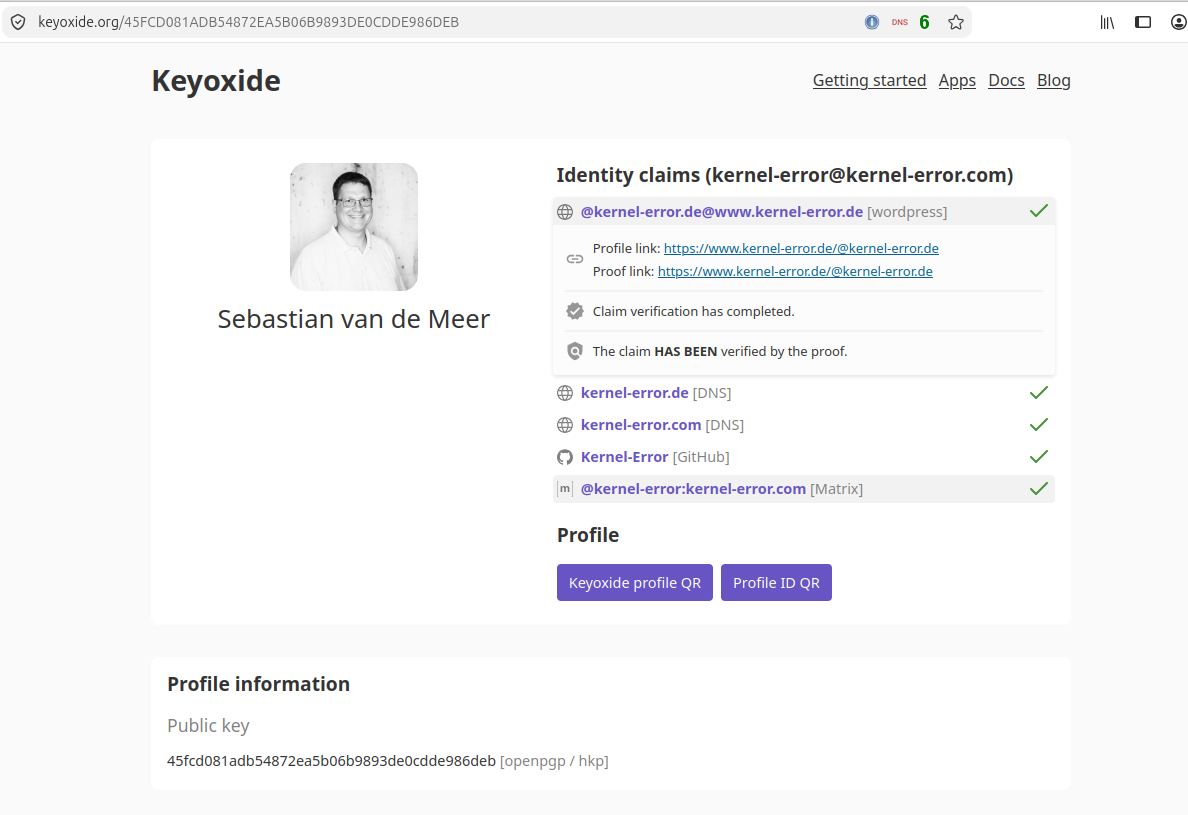
Aufgeklappt: Profil-Link, Proof-Link, und die Prüfung ist durch.
Selbst schon mal an einer Reihenfolge-Abhängigkeit zwischen zwei fremden Projekten verzweifelt, oder eigene Erfahrungen mit ActivityPub-Profilfeldern? Dann darfst du mich sehr gerne fragen.
Im August ging es hier darum, wie ich meinen OpenPGP-Schlüssel über Keyoxide an DNS, GitHub und Matrix gebunden habe. Seitdem hat sich beim Werkzeug selbst einiges getan, und das ist einen kurzen Nachtrag wert: es gibt jetzt eine Linux-App im Flathub, die Android-App wurde aktualisiert, und für Fragen rund um Keyoxide gibt es einen eigenen Matrix-Kanal.
Die Linux-App im Flathub
Bisher habe ich mein eigenes Profil und die meiner Kontakte immer im Browser aufgerufen. Jetzt gibt es dafür eine eigenständige Anwendung, installierbar direkt aus dem Flathub. Wichtig für die Einordnung: das ist ein Community-Paket, gepflegt vom Entwickler Berker und nicht offiziell vom Keyoxide-Projekt selbst herausgegeben, auf der Flathub-Seite steht das auch so. Unter der Haube steckt dieselbe Flutter-Codebasis wie in der Android-App, `keyoxide-flutter`.
Auf meinem Linux Mint installiert, sieht der Einstieg schlicht aus: ein Suchfeld für ein beliebiges Profil, und darunter die eigene Profilansicht mit allen bestätigten Identity-Claims.
Die Keyoxide-App aus dem Flathub, Startbildschirm mit Suchfeld.
Das eigene Profil in der App, alle vier Claims mit grünem Haken.
Inhaltlich ändert das nichts an dem, was im August-Beitrag steht, DNS, GitHub und Matrix bleiben bestätigt, aber eine native App ist für den täglichen Gebrauch angenehmer als jedes Mal die richtige URL zu tippen.
Das Android-Update
Parallel zur Linux-App wurde auch die Android-Version aktualisiert, Version 2.4.4 auf Codeberg. Gleicher Entwickler, gleiche Codebasis, zwei Plattformen aus einer Quelle.
Der QR-Code, einmal nachgemessen
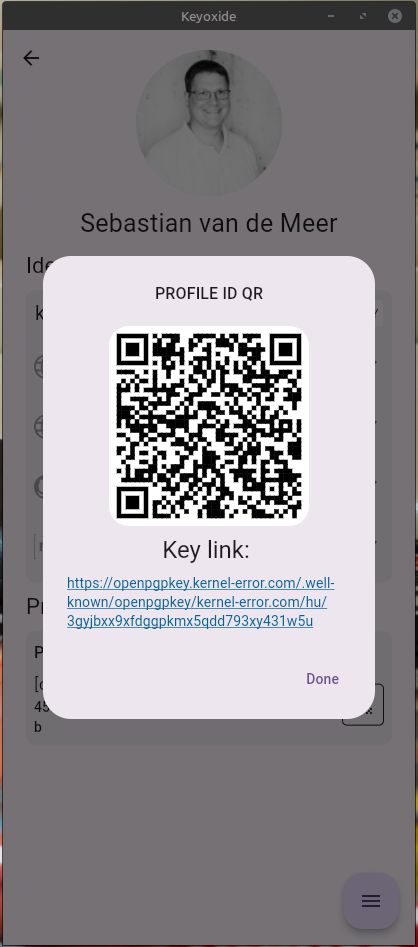
Die App zeigt unter „Profile ID QR“ einen QR-Code fürs eigene Profil, darunter als Klartext den sogenannten Key Link, die WKD-Adresse des öffentlichen Schlüssels. Bevor der hier landet, wollte ich wissen, ob der Code wirklich auf die richtige Datei zeigt und nicht auf einen veralteten Stand.
Profile ID QR mit dem Key Link im Klartext darunter.
Zwei Dinge lassen sich hier unabhängig nachrechnen. Erstens der Pfad selbst: Web Key Directory bildet die Adresse aus einem SHA-1-Hash des lokalen Teils der E-Mail-Adresse, Z-Base-32-kodiert. Für kernel-error@kernel-error.com ergibt sha1("kernel-error"), Z-Base-32-kodiert, exakt 3gyjbxx9xfdggpkmx5qdd793xy431w5u, also genau der Wert im Key Link. Zweitens der Inhalt: die Datei unter diesem Pfad lässt sich herunterladen und mit gpg --show-keys auswerten, der Fingerabdruck darin ist 45FC D081 ADB5 4872 EA5B 06B9 893D E0CD DE98 6DEB, derselbe wie im Screenshot und derselbe wie der seit Juli aktuelle Schlüssel. Der QR-Code zeigt also tatsächlich auf die richtige, aktuelle Datei, nicht auf einen Cache-Stand oder eine falsche Kodierung.
Ein Matrix-Kanal für Fragen
Wer selbst mit Keyoxide anfangen will oder unterwegs hängen bleibt, findet jetzt einen eigenen Raum für allgemeine Fragen: #keyoxide:matrix.org. Ich lese dort mit.
Der Servername im TLS-Handshake steht bis heute im Klartext im Netz, unabhängig davon, wie gut die DNS-Anfrage davor verschlüsselt war. Wer DNS over HTTPS oder DNS over TLS einsetzt, verbirgt den Lookup selbst, aber sobald der Browser die eigentliche Verbindung aufbaut, nennt das Client Hello die besuchte Domain im Server Name Indication Feld offen. Jeder Netzwerkbeobachter zwischen Client und Server sieht damit weiterhin, welche Website gerade aufgerufen wird, egal wie sauber DNS-Ebene und Transportebene sonst verschlüsselt sind.
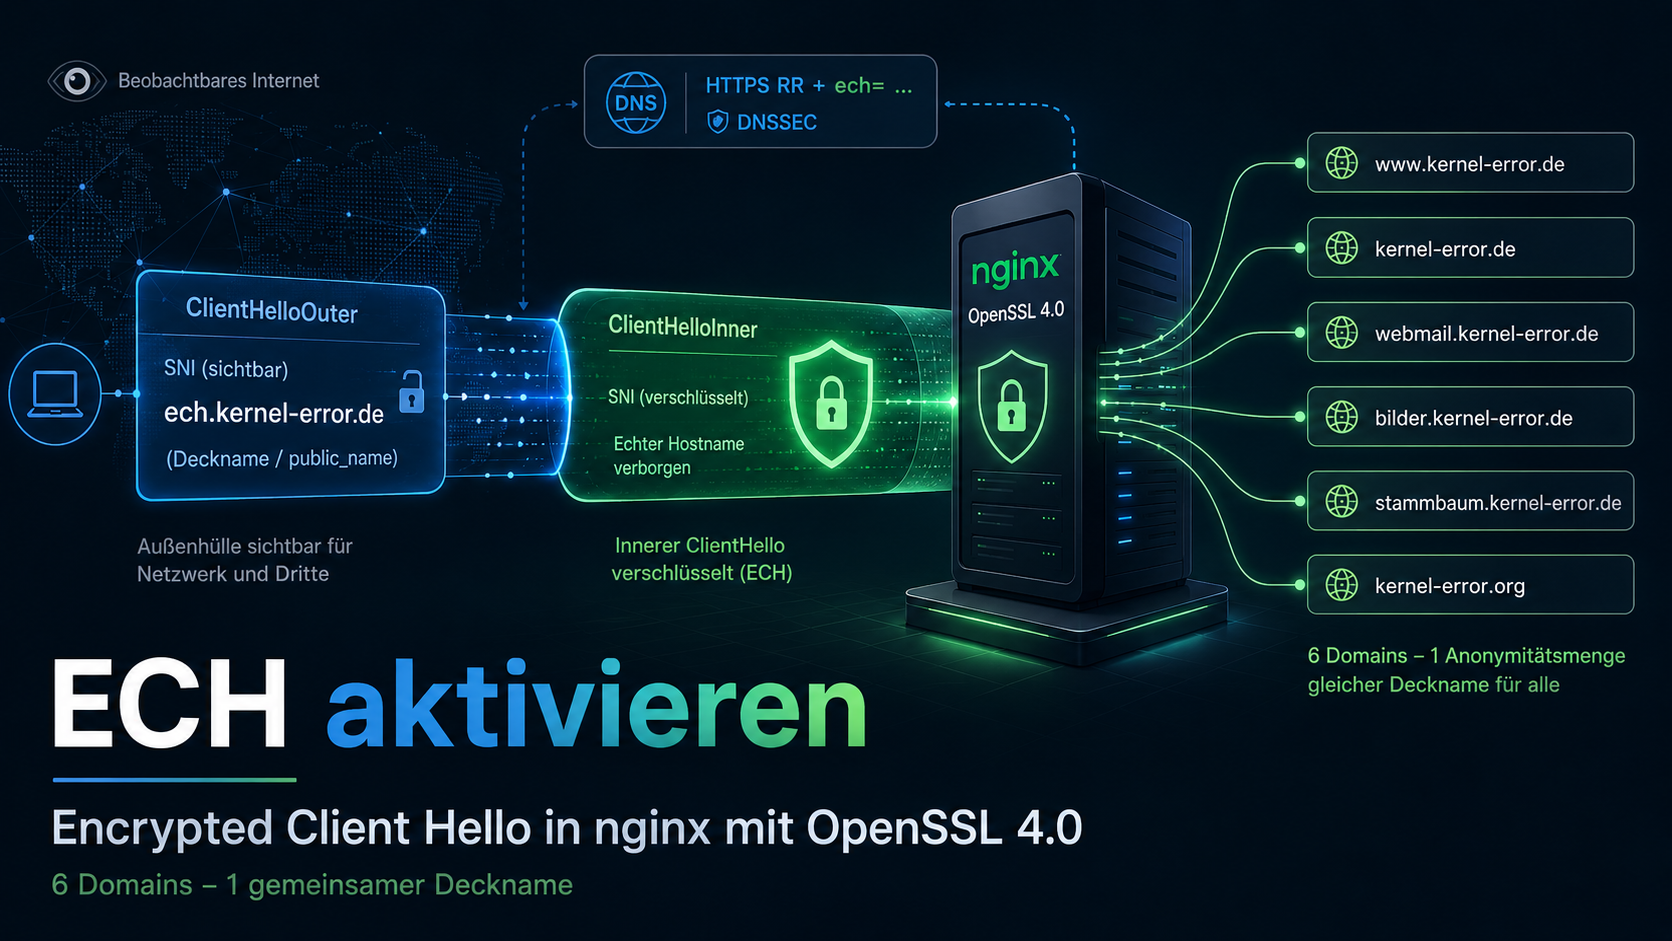
Encrypted Client Hello schließt genau diese Lücke, indem der eigentliche Servername in einen zweiten, verschlüsselten Client Hello wandert. Der folgende Beitrag beschreibt, wie ECH auf dieser Infrastruktur aktiviert wurde: mit OpenSSL 4.0 als Voraussetzung, nginx als Ports-Build und sechs Domains, die sich einen gemeinsamen Deckname teilen. Alle Befehle, Konfigurationsausschnitte und Testausgaben stammen aus dem produktiven Rollout und sind gegengeprüft, aktuell laufen alle sechs sauber verifiziert.
Was Encrypted Client Hello eigentlich verbirgt
Ein ECH-Verbindungsaufbau enthält zwei Client Hellos statt einem. Das äußere ist wie gewohnt unverschlüsselt, trägt aber nicht die echte Domain, sondern einen Deckname. Das innere steckt verschlüsselt im äußeren und enthält die tatsächlich angefragte Domain:
ClientHelloOuter: unverschlüsselt sichtbar, enthält public_name
ClientHelloInner: verschlüsselt, enthält die tatsächlich besuchte Domain
Der Server entschlüsselt das innere Client Hello mit einem Schlüssel, den er vorher über DNS veröffentlicht hat, wählt anhand der darin enthaltenen echten SNI den passenden vHost aus und antwortet als wäre nie ein Deckname im Spiel gewesen. Für den Browser läuft das komplett automatisch ab, sobald der Server ECH per DNS anbietet.
Voraussetzungen, bevor es losgeht
OpenSSL 4.0 oder neuer (ECH ist seit dem stabilen 4.0.0-Release vom 14. April 2026 Bestandteil, im Alpha-/Dev-Branch bereits ab 10./11. März 2026 verfügbar), alternativ BoringSSL
nginx 1.29.4 oder neuer, mit der Direktive ssl_ech_file (hier im Einsatz: 1.30.4)
eine DNSSEC-signierte Zone ist sinnvoll, aber keine normative ECH-Voraussetzung, dazu weiter unten mehr
Auch der erste Punkt ist keine Formalität. Das Lighttpd-Wiki führt ECH aktuell weiterhin als EXPERIMENTAL und nennt dieselbe Voraussetzung, OpenSSL 4.0 oder BoringSSL. ECH ist über die Server-Landschaft hinweg gesehen noch frisch, entsprechend lohnt vor dem eigenen Rollout ein Blick auf die aktuell installierte Softwareversion, nicht auf das, was vor einem halben Jahr noch galt.
Der Umstieg auf OpenSSL 4.0 als Ausgangspunkt
nginx läuft in dieser Jail als Ports-Build, nicht als Repo-Paket, weil das Paket Brotli und headers_more deaktiviert ausliefert. Damit lässt sich die verwendete OpenSSL-Hauptversion über die SSL-Flavor-Einstellung in /etc/make.conf steuern und nginx anschließend dagegen neu bauen:
Ein reload reicht an dieser Stelle ausdrücklich nicht. Die neuen Shared Libraries werden erst beim vollständigen Neustart der Worker-Prozesse eingebunden, ein reload behält die alten libssl-Bindings der laufenden Prozesse bei. Die neue Version zeigt sich danach direkt im Server-Build:
$ nginx -V
built with OpenSSL 4.0.1 9 Jun 2026
public_name ist die eigentliche Entscheidung
ssl_ech_file ist keine Bastellösung und kein Fork, sondern eine echte, in nginx-Mainline gemergte Direktive, sichtbar direkt im Quellcode unter src/http/modules/ngx_http_ssl_module.c und src/event/ngx_event_openssl.c. Technisch nutzt sie die OSSL_ECHSTORE-API, die mit OpenSSL 4.0 dazugekommen ist.
Der eigentlich entscheidende Wert ist public_name, der Name, der im unverschlüsselten ClientHelloOuter sichtbar bleibt. Ein Netzwerkbeobachter sieht ihn ohnehin, ECH hin oder her. Setzt man ihn auf die eigene, echte Domain, bringt die ganze Übung keinerlei Verschleierung: der Beobachter sieht exakt den Namen, den er auch ohne ECH gesehen hätte, nur mit einem zusätzlichen Handshake-Schritt drumherum.
Echten Schutz gibt es nur mit einem gemeinsamen public_name über mehrere unabhängige Domains hinweg, dem Anonymitätsset-Prinzip. Genau so macht es Cloudflare mit cloudflare-ech.com als Deckname für Millionen Kundendomains: wer nur sieht, dass jemand eine Verbindung zu cloudflare-ech.com aufbaut, weiß damit nichts über die konkret besuchte Seite unter den Millionen dahinter.
Ein gemeinsamer public_name reicht dafür allein aber noch nicht. Im ClientHelloOuter steht neben dem public_name auch die config_id unverschlüsselt, ein einzelnes Byte, das die verwendete ECHConfig identifiziert. Nutzt jede Domain einen eigenen ECH-Schlüssel, hat jede Domain automatisch auch eine eigene config_id, und ein Beobachter kann die Domains trotz identischem Deckname allein anhand dieses Bytes unterscheiden. RFC 9849 bringt es auf den Punkt: verwendet ein Server für verschiedene Servernamen unterschiedliche ECHConfig-Werte, hat jedes Anonymitätsset effektiv Größe 1, also gar keinen Effekt. Die Konsequenz für den eigenen Aufbau: alle teilnehmenden Domains müssen denselben Schlüssel und dieselbe ECHConfig nutzen, nicht nur denselben Deckname.
Diese eine nginx-Instanz hostet bereits rund zwanzig unabhängige Domains auf derselben IP, darunter dieser Blog, eine Therapiepraxis-Website, eine Fotogalerie, private Familienseiten, Webmail und ein URL-Shortener. Die Voraussetzung für ein eigenes, kleines Anonymitätsset war also schon da, es musste nur genutzt werden.
Umgesetzt wurde ein dedizierter Deckname, ech.kernel-error.de, ohne eigenen Inhalt. Sechs Domains teilen sich einen gemeinsamen ECH-Schlüssel und damit dieselbe ECHConfig, denselben public_name und dieselbe config_id: www.kernel-error.de, die Apex-Domain kernel-error.de, webmail.kernel-error.de, bilder.kernel-error.de und kernel-error.org als eigene, ebenfalls DNSSEC-signierte Zone. Die TLS-Zertifikats-Schlüssel der einzelnen Domains bleiben davon unberührt getrennt, das ist ein anderes Schlüsselpaar als der ECH-HPKE-Schlüssel und für die Anonymitätsset-Eigenschaft ohne Belang. stammbaum.kernel-error.de, ein CNAME auf www, erbt die ECH-Konfiguration automatisch per DNS-CNAME-Chasing, ganz ohne eigenen Eintrag.
Schlüssel erzeugen
Für die Schlüsselerzeugung braucht es das Port-OpenSSL unter /usr/local/bin/openssl, nicht das Base-System-OpenSSL von FreeBSD, dem fehlt der ech-Subcommand komplett:
Der Base64-Block zwischen den ECHCONFIG-Markern ist exakt der Wert, der später als ech=-Parameter in den DNS-Eintrag wandert. Das PEM-Format selbst folgt keinem nginx- oder OpenSSL-eigenen Standard, sondern ist mittlerweile als RFC 9934 festgeschrieben, hervorgegangen aus dem Internet-Draft draft-farrell-tls-pemesni, den auch das DEfO-Projekt in seinen ech-dev-utils dokumentiert.
Ein gemeinsamer Schlüsselspeicher für alle Domains
Bei mehreren Domains mit gemeinsamem public_name gehört ssl_ech_file auf die http{}-Ebene in der nginx.conf, noch vor die vHost-Includes, nicht in die einzelnen vHost-Dateien:
Der Grund liegt in der Reihenfolge des Handshakes. Die ECH-Entschlüsselung passiert, bevor nginx anhand der noch verschlüsselten echten SNI überhaupt den passenden vHost auswählen kann. In diesem Moment entscheiden die äußere SNI, also der gemeinsame public_name, und die vom Client mitgeschickte config_id, welcher Schlüssel überhaupt zum Entschlüsseln probiert wird. Ein Store auf http{}-Ebene stellt sicher, dass genau dieser eine, gemeinsame Schlüssel unabhängig vom initial per SNI getroffenen Serverblock verfügbar ist, egal welche der sechs Domains die Verbindung eigentlich betrifft.
Ein eigenes Zertifikat für den Deckname
Der Deckname selbst braucht ein eigenes Zertifikat mit ausschließlich diesem einen SAN-Eintrag, kein Wildcard-Zertifikat, das nebenbei auch die echten Domains auflistet. Sonst verrät schon das äußere Zertifikat die Domain-Familie, selbst wenn die konkrete Domain im Handshake verschlüsselt bleibt:
Die ECH-Konfiguration wird nicht als eigener Record-Typ verteilt, sondern als zusätzlicher ech=-SvcParam an der ohnehin schon vorhandenen HTTPS-Resource-Record angehängt, und zwar identisch auf allen sechs teilnehmenden Domains. Der Bootstrap-Mechanismus dafür steht in RFC 9848.
Eine DNSSEC-signierte Zone ist dafür nicht normativ vorgeschrieben, aber sinnvoll: ohne Signatur kann ein Man in the Middle den ech=-Parameter einfach aus der Antwort entfernen, ein klassischer Downgrade auf Klartext-SNI, den ein validierender Resolver mit DNSSEC erkennt. Vor jeder Form von Downgrade schützt das trotzdem nicht: ein Angreifer kann die gesamte HTTPS/SVCB-Auflösung unterdrücken statt sie zu manipulieren, und gegen dieses Denial hilft DNSSEC allein nicht.
Verifikation nach dem Rollout
Der naheliegende erste Test ist openssl s_client mit dem passenden ECH-Config-List-Wert. Ohne ein gesetztes CA-Bundle lassen sich ein echter ECH-Fehler und ein simpler Zertifikatsfehler dabei nicht unterscheiden, -CAfile ist deshalb Pflicht, nicht optional:
Derselbe Test läuft identisch, mit demselben Base64-Wert und demselben Erfolg, auch für kernel-error.de, webmail.kernel-error.de, bilder.kernel-error.de und kernel-error.org, alle fünf gegen dieselbe ECHConfig verifiziert.
Für eine unabhängige Zweitmeinung von außen eignet sich das externe Tool echcheck. Es prüft nicht nur, ob der Handshake gelingt, sondern auch DNS-Veröffentlichung, verwendete Kryptografie, das innere Zertifikat und die Retry-Konfiguration einzeln:
ECHConfig aus dem DNS: ✓
finale ECH-Version 0xfe0d: ✓
X25519, HKDF-SHA256, AES-128-GCM: ✓
öffentlicher Name ech.kernel-error.de: ✓
echter ECH-Handshake: Accepted (TLS 1.3): ✓
gültiges inneres Zertifikat: ✓
gültige Retry-Konfiguration, Wiederholung erfolgreich: ✓
SNI Leakage: ✓ (Einzel-SAN-Zertifikat für den Deckname)
Certificate (outer): ✓ (Einzel-SAN-Zertifikat für den Deckname)
In allen neun geprüften Kategorien kommt ein Haken zurück, auch bei den beiden Punkten, die erst nach dem Einzel-SAN-Zertifikat für den Deckname sauber wurden. Ein einmaliger CLI-Test sagt aber nichts darüber, ob echte Clients die Funktion später auch tatsächlich nutzen. Dafür lohnt sich ein erweitertes Log-Format, das den ECH-Status jeder einzelnen Verbindung mitschreibt:
Im laufenden Traffic zeigen sich damit bereits echte ech_status=SUCCESS-Verbindungen, neben NOT_TRIED für Clients ohne ECH-Unterstützung und GREASE für Clients, die absichtlich eine leere ECH-Erweiterung mitschicken, um Middleboxen an das Feld zu gewöhnen. Genau dieser Log-Eintrag ist der eigentliche Erfolgsnachweis, nicht der einzelne CLI-Test.
Während dieser TLS-Arbeiten am selben Server ist außerdem noch ein kleinerer Nebenfund aufgetaucht: ein externer TLS-Scan meldete, dass der Server unter TLS 1.2 weiterhin SHA-224 als Hash-Funktion für die Signatur beim Schlüsselaustausch akzeptierte, obwohl die konfigurierten Cipher-Suiten ohnehin ausschließlich ECDSA nutzen. RFC 9847 stuft SHA-224 in der TLS-HashAlgorithm-Registry inzwischen als „Discouraged“ ein, während SHA-256, SHA-384 und SHA-512 dort als „Recommended“ geführt werden. Ein guter Grund, es trotzdem weiter anzubieten, findet sich aber nicht, wenn SHA-256 und höher ohnehin zur Verfügung stehen. Unter TLS 1.3 stellt sich die Frage gar nicht erst, dort ist für SHA-224 kein Signature Scheme registriert, die Hash-Funktion lässt sich strukturell nicht wählen.
Cipher-Suite und Signaturalgorithmus fürs Handshake sind zwei getrennte Stellschrauben, eine sauber konfigurierte Cipher-Suite sagt nichts über die andere aus. Ohne explizite Vorgabe verwendet OpenSSL seine Default-Liste der SignatureAlgorithms, und die enthält SHA-224 weiterhin aus Kompatibilitätsgründen:
Peer signing digest: SHA224
New, TLSv1.2, Cipher is ECDHE-ECDSA-CHACHA20-POLY1305
Der Fix ist eine Zeile in der gemeinsamen TLS-Konfigurationsdatei, damit gilt sie automatisch für alle vHosts, nur ECDSA-Varianten gelistet, passend zum bestehenden reinen ECDSA-Cipher-Setup:
Auch hier reichte ein reload nicht, erst ein vollständiger Neustart übernahm die geänderte Liste, aus demselben Grund wie beim OpenSSL-Umstieg weiter oben. Danach lehnt der Server SHA-224 ab, SHA-256 funktioniert unverändert:
OpenSSL 4.0 war die technische Voraussetzung für diesen Umstieg, die eigentliche Entscheidung fiel aber woanders. Ein ECH-Setup mit dem eigenen Domainnamen als public_name wäre in wenigen Minuten fertig gewesen und hätte am Ende nichts verschleiert. Der Wert liegt allein in einem gemeinsamen Deckname über mehrere unabhängige Domains, und den gab es hier schon, bevor überhaupt eine Zeile Konfiguration geschrieben wurde.
Firefox unterstützt ECH seit Version 118, standardmäßig aktiv ist es seit Version 119, jeweils automatisch sobald ein Server es per DNS anbietet. Bei Chromium-basierten Browsern lässt sich keine ebenso feste Versionsgrenze nennen, der Rollout läuft dort gestaffelt über Channel und Policy. Der Nutzer muss in beiden Fällen nichts einstellen, die Aushandlung läuft beim ersten Verbindungsaufbau im Hintergrund. Wie schnell sich diese Versionsstände weiterentwickeln, lässt sich hier nicht dauerhaft verlässlich festschreiben, ein aktueller Blick in die jeweilige Browser-Dokumentation lohnt bei Zweifeln also immer.
Wer selbst mehrere unabhängige Domains auf derselben IP betreibt, hat die Grundvoraussetzung für ein eigenes Anonymitätsset damit häufig schon, ganz ohne Cloudflare oder einen anderen großen Anbieter dazwischen.
Moin. Seit dem 24. Juli 2026 habe ich einen neuen GPG-Schlüssel. Ed25519, gültig bis 2031, der Hauptschlüssel zertifiziert nur noch und hat für Signieren, Verschlüsseln und Authentisieren je einen eigenen Unterschlüssel. Technisch ein hübsches Ding. Der alte Schlüssel bleibt bis Ende des Jahres gültig und hat den neuen gegengezeichnet, damit der Wechsel keine harte Kante bekommt.
Und dann stand da die Frage, die eigentlich immer die wichtigere ist und trotzdem meistens hintenrunterfällt: Woher soll irgendwer wissen, dass dieser Schlüssel mir gehört? Nicht „wo finde ich den Schlüssel“, das ist gelöst. Sondern: Warum sollte jemand glauben, dass die Person, die diesen Schlüssel kontrolliert, dieselbe ist wie die hinter github.com/Kernel-Error, hinter dem Mastodon-Account und hinter dieser Domain?
Die alten Antworten funktionieren nicht mehr
Die klassische Antwort auf diese Frage heißt Web of Trust. Ich unterschreibe deinen Schlüssel, du unterschreibst meinen, irgendwann spannt sich ein Netz aus Signaturen über die Welt und jeder kann über ein paar Ecken einen Pfad zu jedem finden. Elegante Idee. Nur: Wann warst du zuletzt auf einer Keysigning-Party? Eben. Ich auch nicht.
Dazu kommt ein sehr praktisches Problem, über das kaum jemand redet: keys.openpgp.org, der Keyserver, den heute praktisch alle benutzen, veröffentlicht Fremdsignaturen grundsätzlich nicht. Zuverlässig überleben dort nur Selbstsignaturen, einzige Ausnahme sind eigens attestierte Fremdzertifizierungen, und die benutzt in der Praxis kaum jemand. Das ist als Schutz gegen Signatur-Flooding absolut nachvollziehbar, bedeutet aber eben auch: Das Web of Trust reist nicht mehr mit. Du kannst deinen Schlüssel von hundert Leuten unterschreiben lassen, auf dem meistgenutzten Keyserver sieht ihn trotzdem niemand mit diesen Unterschriften.
Die zweite klassische Antwort waren Zertifizierungsstellen für Personen. CAcert habe ich hier vor Jahren mal vorgestellt, und die Volksverschlüsselung wurde 2025 eingestellt. Übrig geblieben ist bei mir eine Zertifizierung über Governikus, die die Beglaubigung im Auftrag des BSI macht, also eine eID-basierte Bestätigung mit Level 3, die tatsächlich meinen bürgerlichen Namen an den Schlüssel bindet. Das ist eine der letzten echten Klarnamen-Bindungen, die man noch bekommt. Und ausgerechnet die ist eine Fremdsignatur, fliegt auf keys.openpgp.org also raus.
Was schon vorher da war, und was es eben nicht beweist
Beim Thema Erreichbarkeit war ich schon vorher gut aufgestellt. Der Schlüssel liegt im Web Key Directory, sowohl in der advanced als auch in der direct method. Er steht als OPENPGPKEY-Record in einer DNSSEC-signierten Zone, wie ich das hier vor Jahren schon einmal beschrieben habe. Er liegt auf keys.openpgp.org, keyserver.ubuntu.com und pgpkeys.eu. Er ist in der clearsigned security.txt referenziert, die zu meinem Umgang mit Vulnerability Reports gehört. Und er liegt schlicht als Datei zum Direktdownload.
Sieben Kanäle also. Alle beweisen exakt eine Sache: dass man den Schlüssel findet. Die Governikus-Zertifizierung beweist zusätzlich einen Namen. Aber keiner dieser Kanäle beweist, dass derselbe Schlüssel auch das GitHub-Konto kontrolliert, oder den Matrix-Account, oder die Domain als Identität und nicht nur als Hostingort einer Datei. Genau diese Lücke füllen Identity Claims, und genau dafür gibt es Keyoxide.
Der wichtigste Satz zuerst: Keyoxide hat keine Accounts
Das ist das größte Missverständnis, und ich schreibe es deshalb so deutlich wie möglich hin: Es gibt bei Keyoxide keine Registrierung, keinen Login, kein Profil zum Ausfüllen, keine API-Keys und keine Daten auf deren Seite. Man legt dort nichts an. Man kann dort gar nichts anlegen.
keyoxide.org ist ein zustandsloser Betrachter. Wenn jemand ein Profil öffnet, passiert Folgendes:
Der öffentliche Schlüssel wird geholt, per WKD oder von einem Keyserver.
Aus der Selbstsignatur werden die Notationen mit dem Namen proof@ariadne.id ausgelesen.
Jeder Claim wird live gegen den genannten Endpunkt aufgelöst, je nach Claim-Typ direkt im Browser oder über einen Proxy. Ein TXT-Record lässt sich aus einer Webseite heraus nun mal nicht selbst abfragen.
Grüne Haken werden gerendert, und danach vergisst der Dienst alles wieder.
Die Konsequenz daraus ist der eigentliche Clou: Der Schlüssel ist das Profil. Wenn keyoxide.org morgen offline geht, ist nichts kaputt. Die Claims stehen weiter im Schlüssel, die Proofs liegen weiter an ihren Endpunkten, und jeder kann die komplette Prüfung mit dig und curl von Hand nachvollziehen. Weiter unten zeige ich genau das.
Das ist das genaue Gegenmodell zu Keybase, wo die Verknüpfungen auf einem Server einer Firma lagen. Als die Firma verkauft wurde, war der Ärger groß und die Frage berechtigt, was mit den Identitäten passiert. Bei diesem Modell stellt sich die Frage nicht, weil der Betreiber nichts hält, was verloren gehen könnte. Die zugrundeliegende Spezifikation heißt Ariadne Identity, Keyoxide ist nur eine Implementierung davon.
Zwei Hälften, die aufeinander zeigen
Jeder Proof besteht aus zwei Aussagen, die sich gegenseitig referenzieren:
Hälfte
Liegt in
Sagt
Claim
der Selbstsignatur des Schlüssels
„Ich kontrolliere kernel-error.de“
Proof
genau diesem Endpunkt
„Der Schlüssel mit dem Fingerprint 45FC… gehört mir“
Auf den ersten Blick sieht das zirkulär aus. Der Schlüssel sagt, ihm gehöre die Domain, und die Domain sagt, ihr gehöre der Schlüssel. Beweist das nicht einfach gar nichts? Doch, und zwar genau deshalb, weil es zirkulär ist: Nur wer beides kontrolliert, kann beide Hälften zur Deckung bringen.
Spielen wir es durch. Jemand klaut meinen geheimen Schlüssel. Er kann jetzt beliebige Claims hineinschreiben, zum Beispiel „ich kontrolliere example.org“. Aber er kann bei example.org keinen TXT-Record setzen, der auf meinen Fingerprint zeigt. Der Claim bleibt rot. Umgekehrt: Jemand übernimmt eine meiner Domains und setzt dort einen TXT-Record mit meinem Fingerprint. Schön, aber ohne den geheimen Schlüssel kann er den passenden Claim nicht in die Selbstsignatur schreiben. Auch das ergibt keinen grünen Haken. Ein Angreifer mit einer der beiden Hälften bekommt nichts. Er braucht beide.
Warum eine Notation und keine Signatur
Ein Claim ist technisch ein Notation-Subpacket in der Selbstsignatur einer User-ID. Eine Notation ist ein frei definierbares Schlüssel-Wert-Paar, das im Signaturpaket mitsigniert wird. Der Name ist bei Ariadne immer proof@ariadne.id, der Wert beschreibt den Endpunkt.
Und hier schließt sich der Kreis zu dem Keyserver-Problem von oben. Weil die Claims in der Selbstsignatur stehen und nicht in einer Fremdsignatur, kann kein Keyserver sie wegputzen. Meine Governikus-Zertifizierung ist auf keys.openpgp.org verschwunden, weil sie eine Fremdsignatur ist. Die Keyoxide-Claims sind da, weil ein Keyserver eine Selbstsignatur nicht entfernen kann, ohne den Schlüssel dabei zu zerstören. Das ist für mich das stärkste praktische Argument, Notationen zu sammeln statt Unterschriften.
Vier Claims, vier sehr unterschiedliche Qualitäten
Live sind am Ende vier Claims, alle ausschließlich auf der Namens-UID:
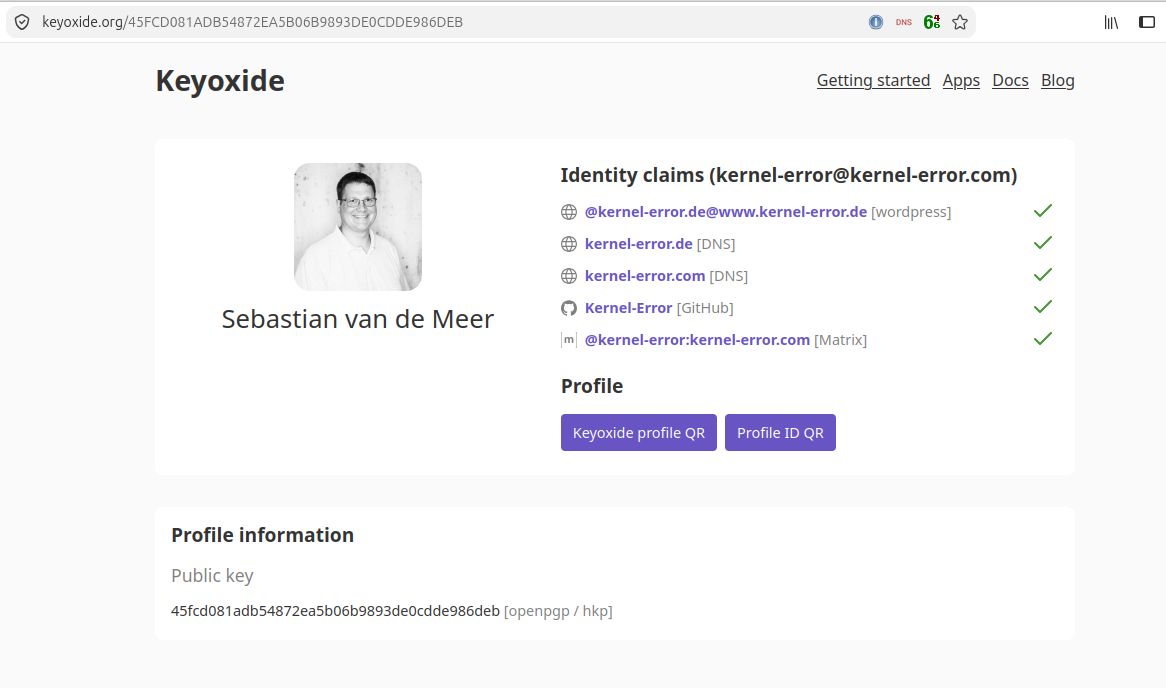
Vier Claims, vier grüne Haken. Geprüft wird das erst beim Aufruf, gespeichert ist bei Keyoxide davon nichts. Der Fingerprint darunter ist der einzige Anker.
Das öffentliche Profil dazu liegt unter keyoxide.org/45FCD081ADB54872EA5B06B9893DE0CDDE986DEB. Bevor jetzt jemand vier grüne Haken sieht und denkt, das seien vier gleichwertige Beweise: sind sie nicht, und das gehört ausgesprochen.
Die beiden DNS-Claims sind mit Abstand die stärksten. Sie liegen in meinen eigenen, DNSSEC-signierten Zonen auf meinen eigenen Nameservern. Wer den Record fälschen will, muss meine Domain- oder DNS-Verwaltung übernehmen. Unterwegs fälschen reicht nicht, sofern der Prüfer DNSSEC auch wirklich validiert.
Der Gist-Claim hängt daran, dass GitHub sein URL-Schema beibehält und den Gist nicht wegräumt.
Der Matrix-Claim hängt an matrix.org und daran, dass ein bestimmter Raum weiter existiert und die Nachricht nicht gelöscht wird.
Ein Claim ist nie stärker als der Endpunkt, auf den er zeigt. Vier grüne Haken nebeneinander suggerieren eine Gleichwertigkeit, die es nicht gibt.
Domain-Proof: ein TXT-Record am Apex
Der Proof für eine Domain ist ein TXT-Record. Bei mir in beiden Zonen:
kernel-error.de.   IN TXT  "openpgp4fpr:45FCD081ADB54872EA5B06B9893DE0CDDE986DEB"
kernel-error.com.  IN TXT  "openpgp4fpr:45FCD081ADB54872EA5B06B9893DE0CDDE986DEB"
Am Apex, nicht unter www, und das ist eine bewusste Entscheidung. Der Claim behauptet etwas über die Identität der Domain, nicht über einen Webserver-Hostnamen. www ist nur ein Host darunter. Keyoxide rendert den Claim außerdem als den Domainnamen, und kernel-error.de liest sich als Identität, während www.kernel-error.de sich als Webseite liest. Kleiner Unterschied, aber genau der Punkt, um den es hier geht.
Beide TLDs bekommen den Record, weil sie bei mir verschiedene Rollen haben. Die .com ist die Mail-Identität mit WKD und DANE, die .de ist die Webpräsenz mit der security.txt. Beides bin ich, also gehört beides an den Schlüssel gebunden.
Beide Zonen sind DNSSEC-signiert und laufen mit inline-signing. Für so eine Bearbeitung heißt das: einfrieren, editieren, prüfen, wieder auftauen. Ein rndc reload ist hier der falsche Befehl.
Angenehm unspektakulär war dabei, dass mehrere TXT-Records am selben Namen problemlos nebeneinander leben. Der neue Record ist einfach neben den SPF-Record und zwei Verifizierungs-Records gerutscht, ohne dass ich irgendetwas anfassen musste.
Einen Bluesky-Claim habe ich bewusst weggelassen. Meine did:plc:... hängt ohnehin schon über einen DNS-TXT-Record und /.well-known/atproto-did an der Domain. Wer den Domain-Claim prüft, hat Bluesky damit transitiv mit erledigt. Noch ein Claim mehr wäre nur mehr Fläche ohne mehr Aussage.
GitHub: ein öffentlicher Gist namens proof.md
Für GitHub braucht es einen öffentlichen Gist. Die Datei darin mussproof.md heißen, der Inhalt ist eine einzige Zeile:
Eine Abgrenzung, über die regelmäßig jemand stolpert, deshalb explizit: Einen GPG-Schlüssel im GitHub-Profil zu hinterlegen, damit signierte Commits als „Verified“ angezeigt werden, ist eine völlig andere Sache. Anderer Mechanismus, anderer Zweck, und mit dem Keyoxide-Proof hat das nichts zu tun. Der hinterlegte Schlüssel wird von GitHub automatisch für die Commit-Verifikation benutzt. Einen Schalter „diesen Schlüssel als Signing Key verwenden“ gibt es für GPG-Schlüssel übrigens gar nicht, den gibt es nur für SSH-Schlüssel.
Matrix: der Proof ist eine Nachricht
Bei Matrix hat der Proof wieder eine ganz andere Form. Er ist weder eine Datei noch ein DNS-Record, sondern eine Nachricht in einem öffentlichen Raum. Man postet in #doipver:matrix.org schlicht:
Und zeigt dann in der Notation auf genau diese Nachricht. Beim Formatieren gibt es drei Kleinigkeiten, die man garantiert einmal falsch macht: Beim User wird das führende @ weggelassen, bei der Raum-ID das führende ! und bei der Event-ID das führende $. Aus @kernel-error:kernel-error.com wird also u/kernel-error:kernel-error.com, aus !dBfQZxCoGVmSTujfiv:matrix.org wird der nackte Rest, und genauso bei der Event-ID.
Wichtig ist außerdem, dass der Raum unverschlüsselt ist. Eine verschlüsselte Nachricht kann ein Prüfer nicht lesen, damit wäre der Proof wertlos. #doipver ist genau dafür da und entsprechend offen.
Der ganze Vorgang lässt sich komplett über die Client-Server-API erledigen, also POST /_matrix/client/v3/join/... und danach PUT /_matrix/client/v3/rooms/{roomId}/send/m.room.message/{txnId}. Die Antwort auf das Senden enthält direkt die event_id, also genau das, was die Notation braucht. Das ist elegant, wenn man es scripten will.
Ehrlicherweise muss man dazu aber sagen: Ein Access-Token gibt volle Kontrolle über den Account. Das aus der Hand zu geben, nur um eine einzige öffentliche Zeile abzusetzen, ist ein schlechtes Geschäft. Der Weg über Element von Hand kostet dreißig Sekunden: Nachricht posten, „Teilen“ beziehungsweise Permalink aufrufen, und Raum-ID sowie Event-ID direkt aus der matrix.to-URL ablesen. Wer trotzdem ein Token benutzt, sollte das Gerät danach abmelden.
Die Claims in den Schlüssel schreiben
Das eigentliche Eintragen passiert in gpg --edit-key. Sieht harmlos aus, hat aber gleich in Zeile zwei die erste Falle:
gpg --edit-key 0x893DE0CDDE986DEB
uid 1
notation
proof@ariadne.id=dns:kernel-error.de?type=TXT
save
Entfernen geht über notation und dann den gleichen Ausdruck mit einem führenden Minus, none löscht alle. Und weil man sich auf Anzeigen ungern verlässt, hier der Blick auf das, was wirklich im Schlüssel steht:
Ohne vorher eine UID auszuwählen schreibt gpg die Notation in jede UID. Bei mir also auch in die Foto-UID. Keyoxide prüft dann denselben Claim zweimal und zeigt ihn doppelt an. Die offizielle Dokumentation erwähnt das im Nebensatz, überlesen ist es schnell, und aufräumen darf man es anschließend von Hand.
Falle 2: jede Änderung schreibt die Selbstsignatur neu
Das ist der eigentliche Preis, und davor warnt einen niemand. Ein Claim mehr bedeutet eine neue Selbstsignatur, und damit ist jede veröffentlichte Kopie des Schlüssels veraltet. Konkret hieß das bei mir jedes Mal: neu hochladen zu drei Keyservern, zwei selbst gehostete Dateien überschreiben und noch eine DNSSEC-Zonenbearbeitung für den DANE-Record hinterher.
Wer drei Claims einzeln nacheinander setzt, macht diese Runde dreimal. Also: Claims sammeln und in einem Rutsch eintragen. Nebenbei wächst der Schlüssel auch spürbar. Die DANE-rdata ist im Lauf des Tages von 909 auf 1130 Byte gewachsen, die WKD-Datei von 12703 auf 12940 Byte. Nichts Dramatisches, aber bei einem DNS-Record schaut man da schon hin.
Falle 3: drei Caches, drei vorgetäuschte Fehlschläge an einem Nachmittag
Das ist der Teil, bei dem vermutlich jeder Leser nickt. An einem einzigen Nachmittag haben mir drei verschiedene Caches je einen kaputten Rollout vorgespielt. In allen drei Fällen war das Deployment in Ordnung und die Prüfung hat gelogen.
Der eigene Resolver. Nach dem Setzen des TXT-Records schlug die lokale Prüfung immer weiter fehl. Google, Cloudflare und Quad9 hatten den neuen Record sofort. Der veraltete Eintrag kam ausgerechnet von meinem eigenen DoT/DoH-Resolver, auf den systemd-resolved zeigt, und der hielt die alte Antwort noch etwa zwei Stunden fest. Das sieht exakt aus wie ein kaputtes Deployment und kostet echte Debugging-Zeit.
Der View-Name am Ende ist bei rndc flushname laut Handbuch optional. In meinem Setup mit einer eigenen resolver-View ist er aber Pflicht, sonst passiert schlicht nichts Sichtbares. Die allgemeine Lehre daraus: Wer eigene DNS-Änderungen prüft, fragt immer einen autoritativen Server und einen öffentlichen Resolver, niemals nur den Systemresolver.
Ein HTTP-Cache vor keyserver.ubuntu.com. Der lieferte einen veralteten Schlüssel mit nur der Hälfte der Claims aus. Ein angehängter Cache-Busting-Parameter brachte sofort die korrekte Version, und ein erneuter Upload wurde mit "ignored" quittiert. Der Server war also die ganze Zeit aktuell, nur der Cache davor nicht.
Und die Keyserver selbst. Keyserver mischen Selbstsignaturen, sie ersetzen sie nicht. Nach einem Update trägt die Keyserver-Kopie die alte und die neue Selbstsignatur. Ein naives grep -c notation zählt dann fünf Notationen, während die selbst gehostete Kopie drei zeigt. gpg nimmt beim Import die neueste, praktisch ist das also harmlos, aber jedes Verifikationsskript lügt einen dabei an. Man prüft besser, was ein frischer Import auflöst, nicht was im rohen Blob steht.
Die Moral aus allen drei Fällen ist dieselbe: gegen eine autoritative Quelle prüfen und gegen eine cache-busted Anfrage, niemals nur gegen die eine bequeme Quelle, die gerade zur Hand ist.
Falle 4: die Gist-Raw-URL springt den Host
Ein kurzer Schreckmoment mit einfacher Ursache. Die Adresse https://gist.github.com/<user>/<id>/raw/proof.md antwortet mit einem 301 auf gist.githubusercontent.com. Ein curl ohne -L liefert damit gar nichts zurück, was auf den ersten Blick nach einem kaputten Proof aussieht. Ist es nicht, es fehlt nur ein Buchstabe am Kommando.
Falle 5: –print-dane-records gibt es nicht mehr
In GnuPG 2.4 ist --print-dane-records weg. Der Aufruf bricht mit einem Fehler ab und verweist auf --export-options export-dane. Nur reicht export-minimal allein nicht: Die Foto-UID bleibt drin und bläst einen DANE-Record von rund einem Kilobyte auf etwa zwölf Kilobyte auf. Die kompakte Variante braucht zusätzlich einen Export-Filter:
Der fünfte Claim: Fediverse, und warum er nicht live ist
Jetzt der ehrliche Teil. Ein fünfter Claim war gebaut, ausgerollt, nie verifiziert und noch am selben Tag wieder zurückgebaut. Ich schreibe das hier hin, weil vier aufgeräumte grüne Haken nichts erzählen und dieser eine Fehlschlag mehr über die Technik verrät als der Rest zusammen.
Der Plan war ein Claim auf https://www.kernel-error.de/@kernel-error.de, also den ActivityPub-Actor dieses Blogs, mit dem Proof in den Profil-Metadaten. Beim WordPress-ActivityPub-Plugin werden die „Extra Fields“ als PropertyValue-Attachments an den Actor gehängt. Zwei Entscheidungen dabei waren richtig und bleiben es auch nach dem Rückbau.
Erstens: Die Claim-URL leitet im Browser um, liefert aber unter Accept: application/activity+json sauber den Actor aus. „Mach das doch mal im Browser auf“ ist bei einem maschinenlesbaren Endpunkt schlicht kein gültiger Test. Wer so prüft, verwirft eine funktionierende Adresse.
Zweitens: Die Platzierung war wichtiger als gedacht. Keyoxide akzeptiert den Proof in der Bio, in einem Beitrag oder in den Profil-Metadaten. Bei einem WordPress-Blog-Actor ist die Bio aber der Blog-Slogan, und der steht auf jeder einzelnen Seite der öffentlichen Webseite. Ein Fingerprint im Header, weil man die erstbeste dokumentierte Möglichkeit genommen hat. Die Profil-Metadaten sind genauso gültig und für Leser unsichtbar. Lohnt sich also, erst alle Optionen zu lesen und dann zu wählen.
Ein Implementierungsdetail mit echter Fallhöhe: Das Feld wurde mit $wpdb->insert eingetragen, ausdrücklich nicht mit wp_insert_post(). Letzteres feuert die ActivityPub-Hooks und erzeugt einen Update-Eintrag in der Outbox, der dann als Geisterbeitrag durch das Fediverse geht. Kontrolliert habe ich das über den Zeilenstand der ap_outbox vor und nach dem Eingriff: 130 zu 130, sowohl beim Anlegen als auch beim Löschen. Danach Caches leeren, und zwar zuerst Redis, dann FastCGI, sonst füllt sich der FastCGI-Cache sofort wieder aus den alten Redis-Daten. Wer mehr über das Plugin-Innenleben lesen mag, findet in meinem Beitrag zum eigenen ActivityPub-Plugin für Grav die Mechanik dahinter.
Und dann zeigte Keyoxide trotzdem ein rotes Kreuz.
Ein rotes Kreuz und eine sehr überzeugende falsche Fährte
Der Claim stand auf dem Profil als rotes Kreuz mit der Beschriftung [---], was so viel heißt wie „kein Service Provider hat gematcht“. Die anderen vier waren grün. Das Access-Log sah so aus:
OPTIONS /@kernel-error.de                     301
GET     /.well-known/nodeinfo                 200
GET     /wp-json/activitypub/1.0/nodeinfo/2.1  200
GET     /@kernel-error.de/api/config           404   (doipjs/2.1.0)
Die naheliegende Lesart ist falsch, und sie ist verführerisch. /api/config ist ein Owncast-Endpunkt. Man denkt sofort: Keyoxide hält meinen Claim für einen Owncast-Server, da ist die Provider-Erkennung kaputt. Stimmt aber nicht. Die beiden NodeInfo-Abfragen darüber stammen aus dem ActivityPub-Postprozessor von doipjs, ActivityPub hatte also gematcht. Die Owncast-Abfrage ist der Fallback, der danach läuft, weil der ActivityPub-Test bereits gescheitert war. Symptom, nicht Ursache.
Die Ursache steht in der ersten Zeile. WordPress beantwortet ein OPTIONS auf die hübsche Actor-URL mit einem 301 auf die Startseite. Und ein umgeleiteter CORS-Preflight ist in allen heute relevanten Browsern ein harter Fehler. Die Fetch-Spezifikation ist an der Stelle inzwischen weniger strikt formuliert, in der Praxis bricht der Browser trotzdem ab, und der Prüfer kommt nie an den Actor heran. Das Ärgerliche daran: Die CORS-Header waren die ganze Zeit korrekt gesetzt, Access-Control-Allow-Origin: * und der ganze Rest. Sie kamen nur mit Status 301, und damit sind sie wertlos.
Eine andere Claim-URL hilft nicht heraus. /@handle und /@handle/ antworten beide mit 301 auf OPTIONS, und die eigentliche Actor-ID /?author=0 beantwortet OPTIONS mit 405 und ganz ohne CORS-Header. Es musste also in den nginx, mit einer Location, die den Preflight selbst beantwortet:
Platziert als erste Regex-Location, damit sie vor den späteren gewinnt, und der Nicht-OPTIONS-Zweig spiegelt exakt das, was auch location / macht, damit normaler Verkehr unverändert durchläuft. Der Preflight ging damit von 301 auf 204.
Und der erste Fix reichte nicht, das Log hat es leise gesagt
Nach dem Reload kam sauber der 204. Aber das anschließende GET /@kernel-error.de tauchte im Access-Log überhaupt nicht auf, und doipjs marschierte direkt wieder zur Owncast-Abfrage weiter. Genau diese Abwesenheit ist die Fehlermeldung: Ein Preflight, der erfolgreich ist und auf den dann gar keine Anfrage folgt, bedeutet, dass der Browser die Antwort auf den Preflight abgelehnt hat.
Die Liste der erlaubten Header war schlicht geraten. Accept, Authorization, Content-Type klingt vernünftig, deckte aber offensichtlich nicht ab, was doipjs tatsächlich schickt. Die Erweiterung auf Access-Control-Allow-Headers: * war die zweite Hälfte des Fixes. Der Wildcard wirkt hier, weil die Anfrage ohne Credentials und ohne HTTP-Auth läuft. Bei einer Anfrage mit Credentials wäre der Stern wirkungslos, und Authorization deckt er ohnehin nie ab, den müsste man immer namentlich nennen. Oben steht schon die korrigierte Fassung.
Noch eine Warnung für alle, die so etwas nachbauen: Access-Control-Max-Age: 86400 heißt, dass der Browser die alte Preflight-Antwort einen Tag lang behält. Ein normales Neuladen leert den CORS-Preflight-Cache nicht. Also im privaten Fenster nachtesten, sonst jagt man ein Gespenst.
Drei Lehren daraus, die weit über Keyoxide hinaus gelten:
Richtige Header auf einem falschen Statuscode sind trotzdem kaputt. Ein 301 mit perfekten CORS-Headern scheitert genauso hart wie gar keine Header.
Ein Log liest man von oben nach unten, nicht von unten nach oben. Die verdächtigste Zeile, der 404, war die Folge. Der langweilige 301 zwei Zeilen darüber war der Fehler.
Eine Anfrage, die im Log fehlt, ist auch ein Befund. Die zweite Runde habe ich ausschließlich aus etwas diagnostiziert, das nicht passiert ist.
Ein Nebeneffekt, der mir erst hinterher aufging: Das war nie ein Keyoxide-Problem. Jeder Cross-Origin-Konsument meines ActivityPub-Actors, der dafür im Browser läuft und einen Preflight braucht, ist an diesem Redirect gescheitert, seit es die Adresse gibt, und es ist niemandem aufgefallen. Serverseitige Abrufer waren nie betroffen, die kennen kein CORS. Der nginx-Fix ist deshalb geblieben, auch nachdem der Claim wieder weg war. Er repariert einen echten Defekt, völlig unabhängig von Keyoxide.
Und trotzdem blieb es rot
Nach dem CORS-Fix zeigte das Log endlich das gewünschte Bild: OPTIONS ... 204, gefolgt von GET /@kernel-error.de 200 6915 "doipjs/2.1.0". Der Actor wurde geholt. Und der Claim blieb rot. Der Reihe nach ausgeschlossen habe ich dann:
Provider-Matching. Das Regex in activitypub.js ist ein Catch-All, und die NodeInfo-Abfragen im Log beweisen ohnehin, dass der zugehörige Postprozessor gelaufen ist.
Feldplatzierung.attachment.value ist eines der drei Felder, die doipjs durchsucht.
Inhalt und Schreibweise. Fingerprint einmal in Großbuchstaben, einmal in Kleinbuchstaben probiert. Beides ohne Treffer. Die anderen vier Claims benutzen alle Großbuchstaben und verifizieren einwandfrei, an der Schreibweise liegt es also nicht.
Bleibt ein Verdacht, den ich ausdrücklich als unbewiesen kennzeichne: Das hier ist ein WordPress-ActivityPub-Blog-Actor. NodeInfo meldet software: wordpress, und der preferredUsername lautet kernel-error.de, ist also ein Benutzername mit Punkten darin, den Mastodon so gar nicht erzeugen könnte. Das ist ein deutlich weniger befahrener Pfad durch doipjs als ein normales Mastodon-Profil. Weiterzukommen hätte bedeutet, fremdes JavaScript zu debuggen, für den fünften von fünf Claims.
Also habe ich aufgehört, und die Entscheidung gehört zur Geschichte dazu. Rückbau komplett: Notation aus dem Schlüssel entfernt, alle sieben Kanäle neu ausgerollt, das Profilfeld gelöscht, Caches geleert. Der Claim ist damit vollständig verschwunden, es bleibt also kein dauerhaftes rotes Kreuz stehen. Das ist übrigens eine erfreuliche Eigenschaft: Ein Claim, der nicht funktioniert, lässt sich sauber zurückziehen. Nur die Historie der Notation liegt für immer auf den Keyservern. Wer die rohen Schlüsseldaten auseinandernimmt, findet die alten Selbstsignaturen samt Claim also weiterhin. Im aktuellen Profil taucht er nicht mehr auf.
Zwei Stolpersteine aus dem Rückbau, die man kennen sollte:
Das Entfernen einer Notation braucht eine Bestätigung. Die Reihenfolge ist uid 1, dann notation, dann der Ausdruck mit führendem Minus, dann ein y, dann erst save. Ohne das y schluckt gpg das nachfolgende save als Antwort auf seine Rückfrage, und das Entfernen passiert stillschweigend gar nicht.
Keyserver behalten jede Generation von Selbstsignaturen. Nach dem Rückbau lagen auf keys.openpgp.org zehn Selbstsignaturen auf dieser UID, mit der Reihe 4, 5, 4, 3, 2, 0 Claims. Harmlos, weil gpg wie openpgp.js die neueste nimmt. Aber --export-options export-clean reduziert das nicht auf eine Selbstsignatur. Wer Notationen über einen so bereinigten Export zählt, zählt zu hoch und hält einen erfolgreichen Rückbau für gescheitert. Besser die Zeitstempel pro Signatur vergleichen.
Falle 6: ein langsamer Matrix-Raum sieht aus wie kaputte Föderation
Zum Schluss noch eine schöne Fehldiagnose. Der erste Versuch, #doipver:matrix.org beizutreten, starb mit ResponseNeverReceived. Das liest sich wie ein glasklarer Föderationsausfall, und ich habe entsprechend angefangen zu suchen. Nur: federationtester.matrix.org meldete FederationOK: true mit gültigen Zertifikaten über IPv4 und IPv6, und blankes TCP wie auch HTTPS vom Server nach matrix.org liefen einwandfrei.
#doipver ist einfach ein großer, stark föderierter Raum. Der Alias löst auf hunderte beteiligte Server auf, und ein make_join gegen einen einzelnen ausgelasteten Server dauert entsprechend. Geholfen haben zwei Dinge: mehrere Server zum Beitreten mitgeben und einen großzügigen Timeout setzen, 180 Sekunden waren genug. Der Parameter heißt in der aktuellen Spezifikation via, ich habe hier noch den älteren Namen server_name benutzt.
POST /_matrix/client/v3/join/%21dBfQZxCoGVmSTujfiv%3Amatrix.org
     ?server_name=matrix.org&server_name=privacyguides.org&server_name=monero.social
Die übertragbare Lehre, gerade für dieses Publikum: Bevor man aus einer einzigen gescheiterten Anfrage eine Föderationsstörung diagnostiziert, sollte man prüfen, ob die Anfrage nur langsam war. Am selben Tag tauchten übrigens noch zwei 429 Too Many Requests bei Schlüsselabfragen im Log auf, ebenfalls reine Ablenkung.
Selbst nachprüfen, ganz ohne die Webseite
Und hier kommt der Punkt, an dem das ganze Modell überzeugt. Du musst keyoxide.org nicht vertrauen, du kannst die komplette Prüfung selbst machen. Vier Schritte, gegen meinen Schlüssel:
# 1. Schlüssel holen, so wie es ein Fremder tun würde
gpg --auto-key-locate clear,wkd --locate-external-keys kernel-error@kernel-error.com

# 2. Claims aus der Selbstsignatur lesen
gpg --export 0x893DE0CDDE986DEB | gpg --list-packets | grep 'proof@ariadne.id'

# 3. Claims auflösen
dig +short TXT kernel-error.de   | grep openpgp4fpr
dig +short TXT kernel-error.com  | grep openpgp4fpr
curl -sSL https://gist.github.com/Kernel-Error/b51b81489a0600908cf09aca13765b9c/raw/proof.md
# Matrix: Nachricht im Client öffnen oder das Event per API lesen
#   Raum  !dBfQZxCoGVmSTujfiv:matrix.org
#   Event $q3zhGJTbPWZD5LjUnsnAI9p43YzHXglniNv_SL7dldQ

# 4. Gegen den Fingerprint aus Schritt 1 vergleichen, das ist die gesamte Prüfung
Das ist Keyoxide. Mehr macht die Seite auch nicht, sie macht es nur hübscher und schneller. Wenn du diese vier Schritte einmal von Hand durchgehst, sitzt das Argument „du musst der Webseite nicht vertrauen“ deutlich besser als jede Erklärung.
Was das beweist, und was eben nicht
Damit hier niemand mit falschen Erwartungen rausgeht, die ehrlichen Grenzen:
Claims sind praktisch dauerhaft. Sie stehen in der Selbstsignatur, die auf Keyserver hochgeladen wird, und keys.openpgp.org kennt kein Zurücknehmen. Man sollte also nur Identitäten claimen, die man dauerhaft und öffentlich an den Schlüssel gebunden haben möchte. Genau deshalb habe ich Telegram und Threema bewusst weggelassen.
Xing und LinkedIn habe ich übersprungen, es gibt dort keinen brauchbaren Proof-Mechanismus. Eine Klarnamen-Bindung existiert bei mir ohnehin in stärkerer Form über die eID-Zertifizierung. Telefonnummern, SIP und Postanschrift sind nicht verifizierbar und ohnehin eine schlechte Idee.
Das beweist Kontrolle, nicht Identität. Ein grüner Haken sagt: Dieselbe Instanz kontrolliert diesen Schlüssel und dieses Konto. Er sagt nicht, wer diese Instanz ist. Dafür braucht es weiterhin so etwas wie eine eID-Zertifizierung oder ein persönliches Treffen. Das ist die ehrliche Grenze des ganzen Ansatzes, und sie zu überverkaufen wäre falsch.
Die Prüfung ist nur so stark wie der schwächste Endpunkt. Eine DNSSEC-signierte Zone auf eigenen Nameservern ist stark. Ein Gist auf einer Plattform, die morgen ihr URL-Schema ändern kann, ist es nicht.
Keyoxide selbst ist eine Bequemlichkeitsschicht. Verschwindet Keyoxide, funktionieren die Claims weiter. Verschwindet GitHub, ist genau dieser eine Claim tot.
Nachtrag: der neue Schlüssel hatte noch ein ganz anderes Problem
Beim Durchleuchten des Setups ist mir nebenbei ein echter Defekt am funkelnagelneuen Schlüssel aufgefallen: Er hatte überhaupt keine Algorithmus-Präferenzen. Die Folge war messbar und wirklich unangenehm. Ein Dritter, der an den alten Schlüssel verschlüsselt hat, bekam AES256. Beim neuen Schlüssel wurde daraus stillschweigend AES128. Der neue, modernere Schlüssel wurde also schwächer adressiert als der, den er ablöst. Das ist eine eigene Geschichte und die erzähle ich in einem eigenen Beitrag, denn der Unterschied zwischen „mein Schlüssel ist modern“ und „mein Schlüssel ist korrekt konfiguriert“ verdient mehr als eine Randnotiz.
Fazit
Das Web of Trust ist als Alltagsmechanismus tot, die Zertifizierungsstellen für Privatpersonen sind weitgehend weg, und trotzdem bleibt die Frage bestehen, wem ein Schlüssel gehört. Identity Claims sind darauf eine überraschend saubere Antwort: kein Account, kein Anbieter, der etwas hält, keine Abhängigkeit von einer Firma, die morgen verkauft wird. Nur zwei Aussagen, die aufeinander zeigen, und ein Schlüssel, der sein Profil selbst ist.
Der Aufwand ist überschaubar, wenn man die Claims sammelt und in einem Rutsch einträgt. Die Zeit geht nicht für Keyoxide drauf, sondern für die eigenen Caches und für einen alten Redirect, den nie jemand hinterfragt hat. So gesehen war der gescheiterte fünfte Claim der nützlichste von allen.
Wie immer gilt: Wenn etwas unklar ist, wenn ich mich irgendwo irre oder wenn jemand doch noch weiß, warum ein WordPress-ActivityPub-Actor bei doipjs durchfällt, dann dürft ihr mich sehr gerne fragen.
Wenn ein Browser eine HTTPS-Verbindung aufbaut, braucht er normalerweise mehrere DNS-Lookups und Round-Trips, bevor er überhaupt weiß, welche Protokolle der Server unterstützt. Erst A/AAAA-Record abfragen, dann TCP-Verbindung, dann TLS-Handshake, dann Alt-Svc-Header parsen für HTTP/3. Das ist ineffizient und seit November 2023 gibt es mit RFC 9460 eine saubere Lösung dafür: den HTTPS Resource Record.
Die großen Browser Hersteller unterstützen das ebenfalls schon, eigentlich mehr aus Eigeninteresse, denn viele Vorschläge kommen sogar direkt von ihnen. Oh, natürlich sollte die jeweilige Zone auch per DNSSec geschützt sein, denn wir wollen uns hier ja auf´s DNS verlassen können. Richtig?! Wenn ihr also noch kein DNSsec für eure Domain aktiviert habt (warum nicht?) dann bitte jetzt, wir haben bald 2026!
Ich habe das jetzt auf meiner DNS-Infrastruktur (BIND 9.20, FreeBSD, Master-Slave-Setup) für alle relevanten Dienste ausgerollt und dabei auch gleich SVCB-Records für die DNS-Server selbst gesetzt. Hier die Details.
Was ist der HTTPS RR?
Der HTTPS Resource Record (Typ 65) ist in RFC 9460 definiert („Service Binding and Parameter Specification via the DNS“, November 2023). Die Idee ist simpel: ein einziger DNS-Lookup liefert dem Client alles, was er für den Verbindungsaufbau braucht. IP-Adressen, unterstützte Protokolle wie HTTP/2 oder HTTP/3, Ports, und perspektivisch auch die ECH-Konfiguration für verschlüsselten SNI.
Ohne HTTPS RR sieht der Ablauf so aus: Der Client fragt A und AAAA ab, baut eine TCP-Verbindung auf, macht den TLS-Handshake, und erfährt erst aus dem Alt-Svc-Header oder durch ALPN im TLS, dass der Server auch HTTP/3 kann. Beim nächsten Request kann er dann QUIC probieren. Das sind mindestens zwei Verbindungsversuche, bis er auf dem optimalen Protokoll landet.
Mit HTTPS RR weiß der Client schon nach dem DNS-Lookup: „Dieser Server spricht h3 und h2, ist unter diesen IPs erreichbar, und hier ist die ECH-Config.“ Er kann direkt mit QUIC/HTTP/3 starten, ohne vorher TCP probiert zu haben.
Die SvcParams im Detail
Ein HTTPS RR besteht aus einer Priorität (SvcPriority), einem Zielnamen (TargetName) und einer Reihe von Service Parameters (SvcParams). Hier ein Überblick über alle definierten Parameter:
alpn (Application-Layer Protocol Negotiation): Signalisiert welche Protokolle der Server unterstützt. Typische Werte sind h2 (HTTP/2 über TLS), h3 (HTTP/3 über QUIC) oder dot (DNS over TLS). Der Client weiß damit vor dem Verbindungsaufbau, welche Protokolle zur Verfügung stehen.
ipv4hint / ipv6hint: IP-Adressen als Hint. Der Client kann diese nutzen, statt einen separaten A/AAAA-Lookup zu machen. Das spart einen Round-Trip. Wichtig: das sind Hints, keine autoritativen Antworten. Der Client darf und sollte trotzdem den normalen A/AAAA-Record prüfen.
ech (Encrypted Client Hello): Enthält den öffentlichen Schlüssel und die Parameter für ECH. Damit verschlüsselt der Client den SNI (Server Name Indication) im TLS-Handshake, sodass ein Beobachter auf dem Netzwerkpfad nicht sehen kann, welche Domain angefragt wird. Das ist der größte Privacy-Gewinn, den HTTPS RR bieten kann. Dazu später mehr.
port: Falls der Service auf einem nicht-Standard-Port läuft. Bei normalen Webservern auf 443 nicht nötig.
no-default-alpn: Signalisiert, dass die Standard-ALPNs (die sich aus dem Schema ergeben) nicht gelten. Wird benötigt wenn ein Server z.B. nur h3, aber nicht h2 unterstützt.
mandatory: Listet Parameter auf, die ein Client zwingend verstehen muss, um den Record nutzen zu können. Ein Client, der einen mandatory-Parameter nicht kennt, muss den ganzen Record ignorieren.
SvcPriority: Die Priorität des Records. 0 bedeutet AliasMode (Weiterleitung auf einen anderen Namen, ähnlich CNAME), Werte größer 0 sind ServiceMode. Mehrere Records mit unterschiedlichen Prioritäten ermöglichen Fallback-Ketten.
TargetName: Der Zielserver. Wenn er sich vom abgefragten Namen unterscheidet, leitet der Client die Anfrage an diesen Host weiter. Das ermöglicht Indirektion, ähnlich wie bei SRV-Records.
SVCB: Das generische Pendant
Der SVCB Resource Record (Typ 64) kommt aus demselben RFC 9460, ist aber nicht auf HTTPS beschränkt. HTTPS RR ist technisch gesehen nur eine spezialisierte Variante von SVCB für das HTTPS-Schema. SVCB kann für beliebige Protokolle genutzt werden.
Besonders interessant wird SVCB für die DNS Service Discovery nach RFC 9461 („Service Binding Mapping for DNS Servers“, ebenfalls 2023). Damit kann ein DNS-Server per DNS-Record signalisieren, dass er DoT (DNS over TLS) und DoH (DNS over HTTPS, RFC 8484) unterstützt. Der Record liegt unter dem Prefix _dns. vor dem Servernamen.
Der dohpath-Parameter aus RFC 9461 teilt dem Client direkt den URI-Pfad zum DoH-Endpoint mit, z.B. /dns-query{?dns}. Damit braucht der Client keine separate Konfiguration mehr, wo der DoH-Endpoint liegt. Zusammen mit RFC 9462 („Discovery of Designated Resolvers“, DDR) kann ein Client damit automatisch erkennen, dass sein Resolver verschlüsselte Protokolle unterstützt, und automatisch upgraden.
Was ich konkret deployt habe
Insgesamt 5 neue Records in zwei Zonen. Für www.kernel-error.de und cloud.kernel-error.com existierten bereits HTTPS RRs.
HTTPS RR für matrix.kernel-error.com (Synapse Reverse Proxy). Über CNAME-Auflösung deckt dieser Record auch chat.kernel-error.com und admin.kernel-error.com ab:
Laut RFC 9460 können HTTPS RR und CNAME nicht am selben DNS-Namen koexistieren. Das hat direkte Auswirkungen auf mein Setup: chat.kernel-error.com und admin.kernel-error.com sind CNAMEs auf matrix.kernel-error.com. Ein separater HTTPS RR für diese Namen ist also nicht möglich und auch nicht nötig. Der Client folgt dem CNAME und nutzt dann den HTTPS RR des Ziels.
Gleiches gilt für signaling.kernel-error.com, das ein CNAME auf rtc.kernel-error.com ist.
Was bewusst nicht umgesetzt wurde
ECH (Encrypted Client Hello): Wäre der größte Privacy-Gewinn. ECH verschlüsselt den SNI im TLS-Handshake, sodass ein Beobachter nicht sehen kann, welche Domain der Client anfragt. OpenSSL 3.5 hat die API dafür, aber nginx nutzt sie nicht. Selbst in Version 1.29.7 gibt es keine native ECH-Unterstützung. Dafür bräuchte es entweder Patches für nginx oder einen anderen Reverse Proxy. Sobald sich das ändert, kommt der ech-Parameter in die HTTPS RRs.
DoQ (DNS over QUIC, RFC 9250): DoQ ist ein eigenes Protokoll, das DNS direkt über QUIC transportiert, ohne HTTP-Overhead. Das ist nicht dasselbe wie DoH über HTTP/3! BIND 9.20 unterstützt kein DoQ. Dafür müsste man ein separates Frontend wie dnsproxy oder AdGuard DNS davor setzen.
SVCB für SMTP/IMAP: Es gibt IETF-Drafts, die SVCB auf Mail-Protokolle ausweiten wollen (SMTP Submission, IMAPS). Da diese aber noch kein finaler RFC sind und aktuell kein MTA oder Client sie auswertet, habe ich darauf verzichtet. Die bestehenden SRV-Records (_imaps._tcp, _submission._tcp, _submissions._tcp) sind heute das Richtige.
HTTPS RR für turn.kernel-error.com: Der primäre Zweck ist TURN/STUN, nicht Web. Clients bekommen den Server aus der Synapse-Konfiguration, ein HTTPS RR bringt hier keinen Vorteil.
HTTPS RR für rtc.kernel-error.com: Kein HTTP/3 auf diesem Server, da der nginx dort ohne h3-Modul läuft. Ein HTTPS RR mit nur alpn="h2" würde kaum Mehrwert bringen.
Deployment in DNSSEC-signierten Zonen
Beide Zonen sind mit DNSSEC signiert (ECDSAP256SHA256, inline-signing). Der Workflow für Änderungen an signierten Zonen ist immer derselbe:
Nach dem thaw signiert BIND die neuen Records automatisch und der Slave (ns1) übernimmt die Änderungen sofort per NOTIFY und AXFR. BIND 9.20 unterstützt HTTPS und SVCB Records nativ, es ist also kein TYPE65-Workaround mit generischer Record-Syntax nötig.
Die offensichtlichste Lücke ist ECH. Sobald nginx native Unterstützung bekommt, wird der ech-Parameter in alle HTTPS RRs eingetragen. Das wäre dann echte SNI-Verschlüsselung für alle Dienste.
SVCB für SMTP und IMAP wäre der nächste logische Schritt, sobald die aktuellen IETF-Drafts zu finalen RFCs werden und MTAs/Clients anfangen, sie auszuwerten. Immer mal wieder setzte ich auch IETF-Drafts in meinem Setup oder Labor Setup um. In diesem speziellen Fall sehe ich darin aber keinen Nutzen. Aus irgendeinem Grund schaffen es solche IT Security Themen bei E-Mails nur sehr selten in eine „schnelle“ Umsetzung. Die Browserhersteller machen da bei HTTPS wohl genug selbst. Viele Ideen kommen ja sogar von diesen.
Und DoQ (RFC 9250) steht auf der Liste, sobald BIND oder ein brauchbarer Proxy es unterstützt. Dann würden die SVCB-Records um alpn="doq" ergänzt. Ich möchte nicht wieder etwas vor meinen DNS stellen. Das wird aber bereits von den großen Browsern unterstützt!
Mal wieder soweit: Mein aktuelles S/MIME-Zertifikat zum Signieren von E-Mails läuft aus. Also habe ich mir ein neues besorgt. Da GlobalSign keine Class-2-Zertifikate mehr für Privatpersonen anbietet, musste ich die CA wechseln. Durch Zufall bin ich auf SSLplus gestoßen – die haben echt gute Angebote für alle möglichen Zertifikate. Aber darum soll es in diesem Beitrag nicht gehen.
Wie immer will ich mein Zertifikat öffentlich zugänglich machen, sonst müsste jeder erst eine von mir signierte E-Mail erhalten, bevor er mein Zertifikat hat. Erst dann könnten Absender mir verschlüsselte E-Mails schicken.
Dafür gibt es ein experimentelles RFC 8162, das beschreibt, wie sich ein solches Zertifikat in einer DNSSEC-geschützten Zone veröffentlichen lässt. Natürlich gibt es im Internet wieder zig verschiedene Anleitungen und Wege, um das zu realisieren. Aber nichts wirklich Zuverlässiges, was ich finden konnte. Den DNS-Record für meine Bind9-Zone wieder manuell zu erstellen, hatte ich jedenfalls keine Lust.
Also habe ich zwei kleine Python3-Skripte geschrieben:
smimea_generate_record.py
Erstellt einen kopierbaren RR für die DNS-Zone. Kann interaktiv genutzt werden: Fragt nach E-Mail-Adresse und PEM-Zertifikat. Oder direkt mit Parametern aufgerufen werden. Prüft, ob E-Mail-Adresse und Zertifikat zusammenpassen, und gibt den fertigen Record aus.
./smimea_generate_record.py
Enter the email address: kernel-error@kernel-error.com
Enter the path to the PEM certificate: mail.pem
✅ Email 'kernel-error@kernel-error.com' matches the certificate!

🔹 **Generated BIND9 DNS Record:**

70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._smimecert.kernel-error.com. 3600 IN SMIMEA 3 0 0 (
   30820714308204FCA003020102021073C13C478DA7B114B871F00737F1B0FB30
   0D06092A864886F70D01010B0500304E310B300906035504061302504C312130
   1F060355040A0C1841737365636F20446174612053797374656D7320532E412E
   [... komplettes Zertifikat in Hex ...]
   7573CA35477D59B98DE4852065F58FB60E0E620D3E2F5CAD
   )
smimea_lookup.py
Fragt den SMIMEA-Record im DNS ab, lädt das Zertifikat herunter und prüft es mit OpenSSL auf Gültigkeit. Funktioniert interaktiv oder mit übergebenen Werten.
./smimea_lookup.py
Enter the email address: kernel-error@kernel-error.com

Querying DNS for SMIMEA record:
  70e1c7d87e825b3aba45e2a478025ea0d91d298038436abde5a4c2d0._smimecert.kernel-error.com

Certificate saved as smimea_cert.der
Certificate successfully retrieved and verified:

Certificate:
    Data:
        Version: 3 (0x2)
        Signature Algorithm: sha256WithRSAEncryption
        Issuer: C = PL, O = Asseco Data Systems S.A., CN = Certum SMIME RSA CA
        Validity
            Not Before: Mar 13 13:41:55 2025 GMT
            Not After : Mar 13 13:41:54 2027 GMT
        Subject: SN = van de Meer, GN = Sebastian, CN = Sebastian van de Meer,
                 emailAddress = kernel-error@kernel-error.com
        Subject Public Key Info:
            Public Key Algorithm: rsaEncryption
                Public-Key: (4096 bit)
        X509v3 Extended Key Usage:
            E-mail Protection, TLS Web Client Authentication
        X509v3 Key Usage: critical
            Digital Signature, Non Repudiation, Key Encipherment, Data Encipherment
        X509v3 Subject Alternative Name:
            email:kernel-error@kernel-error.com
Beide Skripte findet ihr auf GitHub, damit ihr sie nutzen oder verbessern könnt.
Warum viele Anleitungen falsch sind
Warum habe ich geschrieben, dass ich nichts Zuverlässiges finden konnte? Nun, oft stoße ich auf Anleitungen, die noch auf TYPE53 basieren. Das ist nötig, wenn Bind9 den eigentlichen RR-Type noch nicht kennt – also ein klares Zeichen dafür, dass es sich um eine sehr frühe Implementierung handelt.
Ein weiteres häufiges Problem: Der Hash des Local-Parts wird einfach weggelassen. Stattdessen erfolgen die Abfragen direkt auf _smimecert., was aber falsch ist. Ohne den SHA256-Hash des Local-Parts gibt es keine eindeutige Zuordnung zur jeweiligen E-Mail-Adresse.
Aufbau des SMIMEA-DNS-Records
Der erste Teil — der SHA256-Hash — sorgt dafür, dass nicht einfach jeder direkt aus der DNS-Zone die E-Mail-Adressen auslesen kann. Statt die E-Mail-Adresse im Klartext zu speichern, wird nur der SHA256-Hash des Local-Parts (also der Teil vor dem @) genutzt. Wer die genaue E-Mail-Adresse kennt, kann den passenden DNS-Eintrag finden — aber jemand, der blind durch die Zone scannt, sieht nur Hashes.
Der _smimecert-Prefix zeigt an, dass es sich um einen SMIMEA-Record handelt, ähnlich wie bei ._tcp. für SRV-Records oder _acme-challenge. für Let’s Encrypt. Und schließlich kommt die Domain, zu der die E-Mail-Adresse gehört.
Manuelle Abfrage mit dig
Möchte man die Abfrage manuell durchführen, muss man zuerst den Local-Part der E-Mail-Adresse mit SHA256 hashen. Laut RFC 8162, Abschnitt 3.1 wird der Hash auf die ersten 28 Bytes (56 Hex-Zeichen) gekürzt, um die DNS-Label-Längenbeschränkung von 63 Zeichen (RFC 1035, Abschnitt 2.3.4) einzuhalten:
Hex in eine binäre DER-Datei umwandeln und mit OpenSSL anzeigen:
# Hex → DER
xxd -r -p dns_cert.hex dns_cert.der

# Zertifikat anzeigen
openssl x509 -inform DER -in dns_cert.der -text -noout
Verbreitung und Ausblick
SMIMEA ist leider noch immer nicht besonders weit verbreitet. Das liegt daran, dass das RFC noch immer experimental ist, aber auch daran, dass es auf weiteren Techniken aufbaut, die ebenfalls eher selten genutzt werden. Man braucht SMIMEA nur, wenn man überhaupt ein S/MIME-Zertifikat zur Signatur und Verschlüsselung von E-Mails verwendet. Zusätzlich muss die Domain per DNSSEC geschützt sein — und dann muss auch noch der zusätzliche Mehrwert von SMIMEA verstanden werden.
Denn SMIMEA verteilt nicht nur die Zertifikate, sondern macht einen direkt initial verschlüsselt erreichbar. Wenn man der Empfänger einer solchen signierten Nachricht ist, kann man das Zertifikat zudem gegen eine vertrauenswürdige DNS-Zone halten und sich so vergewissern, dass es wirklich die Signatur des Absenders ist — ähnlich wie bei TLSA/DANE.
Die Implementierung ist aktuell sehr überschaubar. Es gibt Milter für beispielsweise Postfix oder Plugins für Thunderbird, aber vor allem im Enterprise-Umfeld ist mir momentan keine funktionierende Lösung bekannt.
Eigentlich wollte ich doch nur schnell schreiben, dass ich da zwei Python-Skripte zusammengebastelt habe — und am Ende ist es doch wieder so ein riesiges Ding geworden. Aber ich denke, vor allem der Teil mit dem gekürzten Hash des Local-Parts ist wichtig zu erklären. Das ist echt eine verrückte Konstruktion. Klar, das hat seinen Sinn, aber zumindest ich bin damals genau an diesem Punkt hängen geblieben.
Das einzig korrekt funktionierende Online-Tool, das ich finden konnte: co.tt/smimea.cgi. Alle anderen sind nicht erreichbar, halten sich nicht ans RFC oder ich war zu blöde, sie zu bedienen. Fragen? Einfach melden.
Heute habe ich versucht, mich von meiner neuen Linux Mint Installation aus mit einem meiner SSH-Server zu verbinden. Mein SSH-Client hat mich direkt gefragt, ob ich dem Hostkey vertrauen möchte:
ssh username@hostname.kernel-error.org
The authenticity of host 'hostname.kernel-error.org (2a01:5a8:362:4416::32)' can't be established.
ED25519 key fingerprint is SHA256:kTRGVCMRLiHfvJunW2CbW5H3NZmn3Wkx2KnHJXl3iJu.
This key is not known by any other names
Are you sure you want to continue connecting (yes/no/[fingerprint])?
Für viele ist das normal — man tippt „yes“ und sieht die Meldung nie wieder. Aber diese Meldung hat ihren Grund. Beim ersten Verbindungsaufbau zeigt SSH den Fingerprint des Server-Hostkeys an, damit man prüfen kann, ob man wirklich mit dem richtigen Server spricht und nicht mit einem Angreifer. Wer eh immer „yes“ sagt, könnte den Check auch gleich in seiner ~/.ssh/config abschalten:
Host *
    StrictHostKeyChecking no
SSHFP — Hostkeys per DNS verifizieren
Es gibt einen besseren Weg: SSHFP-Records (RFC 4255). Man hinterlegt die Fingerprints der erwarteten Hostkeys als DNS-Einträge. Der SSH-Client prüft diese automatisch — vorausgesetzt die DNS-Antwort ist per DNSSEC abgesichert. In der ~/.ssh/config:
Host *
   VerifyHostKeyDNS yes
Meine DNS-Server unterstützen alle DNSSEC, mein lokaler Resolver auf dem Router auch, die SSH-Config stimmt — und trotzdem erscheint die Meldung. Also mit ssh -vvv debuggen:
debug1: found 2 insecure fingerprints in DNS
Insecure. SSH findet die SSHFP-Records, vertraut ihnen aber nicht, weil die DNS-Antwort nicht als DNSSEC-validiert markiert ist.
Das Problem: systemd-resolved
Schneller Test mit dig +dnssec gegen Google DNS:
dig +dnssec hostname.kernel-error.org @8.8.8.8
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 2, AUTHORITY: 0, ADDITIONAL: 1
Das ad-Flag (Authenticated Data) ist gesetzt — meine DNS-Server liefern DNSSEC korrekt aus. Auch der lokale Router-Resolver liefert ad. Aber ohne expliziten @server:
Kein ad. Was steht in /etc/resolv.conf? 127.0.0.53 — systemd-resolved. Der Stub-Resolver von systemd schluckt das AD-Flag.
Man könnte in /etc/systemd/resolved.conf einfach DNSSEC=yes setzen — bei mir ging danach aber gar keine DNS-Auflösung mehr. Das liegt am Stub-Resolver, den man ebenfalls umkonfigurieren müsste. Nennt mich oldschool, aber für meine Zwecke reicht der klassische Weg über die vom NetworkManager gepflegte resolv.conf.
DNS-Auflösung geht. Aber SSH sagt weiterhin „insecure“. Es fehlen noch zwei Optionen in der resolv.conf.
edns0 und trust-ad
Erste Erkenntnis — edns0 muss aktiviert sein, damit DNSSEC-Daten überhaupt transportiert werden. In /etc/resolv.conf:
options edns0
Jetzt zeigt dig das ad-Flag. Aber SSH sagt immer noch „insecure“. Warum? Ein Blick in den SSH-Quellcode — die ldns-Bibliothek macht die DNSSEC-Validierung:
        /* Check for authenticated data */
        if (ldns_pkt_ad(pkt)) {
                rrset->rri_flags |= RRSET_VALIDATED;
        } else { /* AD is not set, try autonomous validation */
                ldns_rr_list * trusted_keys = ldns_rr_list_new();
                /* ... */
                if ((err = ldns_verify_trusted(ldns_res, rrdata, rrsigs,
                     trusted_keys)) == LDNS_STATUS_OK) {
                        rrset->rri_flags |= RRSET_VALIDATED;
                }
        }
ldns prüft das AD-Flag im DNS-Paket. Aber die glibc setzt das AD-Flag in der Antwort nur dann, wenn trust-ad in der resolv.conf steht — sonst wird es aus Sicherheitsgründen herausgefiltert. Die vollständige Option:
options edns0 trust-ad
Und jetzt:
ssh username@hostname.kernel-error.org -vvv
[...]
debug1: found 2 secure fingerprints in DNS
debug3: verify_host_key_dns: checking SSHFP type 4 fptype 1
debug1: verify_host_key_dns: matched SSHFP type 4 fptype 1
debug3: verify_host_key_dns: checking SSHFP type 4 fptype 2
debug1: verify_host_key_dns: matched SSHFP type 4 fptype 2
debug1: matching host key fingerprint found in DNS
secure statt insecure. SSH verifiziert den Hostkey automatisch per DNSSEC — keine manuelle Fingerprint-Prüfung mehr nötig.
Rebootfest machen
Die manuell eingetragenen Optionen in der resolv.conf überleben keinen Reboot — der NetworkManager überschreibt die Datei. Per nmcli die Optionen dauerhaft im Netzwerkprofil setzen, für IPv4 und IPv6:
Die UUID des aktiven Profils findet man mit nmcli conn show. Beide Zeilen sind nötig — fehlt eine, greift es nicht.
Zusammenfassung: systemd-resolved unter Linux Mint und Ubuntu filtert das DNSSEC-AD-Flag heraus. Ohne AD-Flag kann SSH die SSHFP-Records nicht als vertrauenswürdig einstufen. Lösung: systemd-resolved abschalten, NetworkManager mit dns=default nutzen, edns0,trust-ad per nmcli setzen.
Wer einen DNSSEC-validierenden Resolver sucht — dns.kernel-error.de ist ein öffentlicher DNS-Resolver mit DNSSEC, DNS over TLS und DNS over HTTPS.
Und die offene Frage: Ich bin mit meinem FreeBSD-Wissen an das Thema gegangen. Wie macht man das als Linux-User mit systemd-resolved richtig? Schreibt mir, wenn ihr es wisst.
Standardmäßig nimmt Postfix E-Mails auch ohne Transportverschlüsselung an. Mit smtpd_tls_security_level = may bietet der Server TLS an, erzwingt es aber nicht. Das bedeutet: Wenn die Gegenseite kein STARTTLS kann oder will, wird die Mail trotzdem im Klartext übertragen.
Man kann das ändern und E-Mails ohne TLS komplett ablehnen. Die Frage ist ob man sich das leisten kann.
Mit encrypt verweigert Postfix die Annahme wenn der sendende Server kein STARTTLS aushandelt. Die Gegenseite bekommt einen temporären Fehler (454) und kann es später nochmal versuchen. Im Log steht dann:
postfix/smtpd: NOQUEUE: reject: RCPT from mail.example.de[...]: 454 4.7.0 TLS is required but was not offered
Vorher prüfen
Bevor man TLS erzwingt, sollte man wissen wie viele Mails betroffen wären. Im Postfix-Log lässt sich das auswerten:
In der Praxis liegt der TLS-Anteil bei den meisten Mailservern über 95 Prozent. Die letzten paar Prozent sind oft schlecht gewartete Systeme, Onlineshop-Bestätigungen oder Geräte aus Asien die sich nie um TLS gekümmert haben. Ob das ein Problem ist, hängt davon ab wessen Mails man bereit ist zu verlieren.
Ausgehend erzwingen
Für ausgehende Mails ist die Situation anders. Mit smtp_tls_security_level = encrypt verweigert Postfix die Zustellung wenn die Gegenseite kein TLS anbietet. Das ist riskant, weil man keine Kontrolle darüber hat ob der Empfänger-Server TLS kann.
Der bessere Weg für ausgehende Mails: MTA-STS und DANE prüfen automatisch ob die Zieldomain TLS verlangt und welches Zertifikat erwartet wird. Damit erzwingt man TLS nur dort wo die Gegenseite es auch unterstützt und verifiziert gleichzeitig die Identität.
# Ausgehend: opportunistisch, aber DANE wenn verfügbar
smtp_tls_security_level = dane
smtp_dns_support_level = dnssec
Mit dane als Security-Level nutzt Postfix DANE/TLSA-Records aus dem DNS. Ist ein TLSA-Record vorhanden, wird TLS erzwungen und das Zertifikat verifiziert. Ohne TLSA-Record bleibt es bei opportunistischem TLS. Zusammen mit dem Abschalten von TLS 1.0/1.1 ergibt das eine saubere Konfiguration. Fragen? Einfach melden.
SMTP überträgt E-Mails standardmäßig im Klartext. Mit STARTTLS lässt sich die Verbindung verschlüsseln, aber kein sendender Server ist gezwungen das auch zu tun. Schlimmer noch: Ein Angreifer im Netzwerk kann die STARTTLS-Antwort einfach unterdrücken und die Verbindung bleibt unverschlüsselt. MTA-STS (RFC 8461) löst dieses Problem: Der Empfänger veröffentlicht eine Policy, die sendenden Servern sagt „hier wird nur verschlüsselt zugestellt, mit gültigem Zertifikat, an genau diesen MX“.
MTA-STS vs. DANE
Es gibt zwei Wege, Transportverschlüsselung für E-Mail zu erzwingen: DANE und MTA-STS. DANE nutzt DNSSEC und TLSA-Records im DNS. Das ist technisch sauberer, setzt aber DNSSEC auf der Empfängerseite voraus. Viele große Provider (Google, Microsoft) haben kein DNSSEC. MTA-STS funktioniert ohne DNSSEC: Die Policy liegt als Textdatei auf einem Webserver, abgesichert durch ein normales TLS-Zertifikat. Wer beides kann, sollte beides einsetzen. DANE für die Server die DNSSEC können, MTA-STS für den Rest.
Die drei Komponenten
MTA-STS besteht aus drei Teilen: einem DNS-Record, einer Policy-Datei auf einem Webserver und optional TLS Reporting.
1. DNS TXT-Record
Ein TXT-Record unter _mta-sts.domain.de signalisiert, dass eine Policy existiert:
_mta-sts.kernel-error.de. IN TXT "v=STSv1;id=20260115130000Z;"
Die id ist ein beliebiger String. Sendende Server cachen die Policy und prüfen über die ID ob sich etwas geändert hat. Bei jeder Policy-Änderung muss die ID aktualisiert werden. Ich verwende dafür einen Zeitstempel, das macht es nachvollziehbar.
2. Policy-Datei
Die eigentliche Policy liegt unter https://mta-sts.domain.de/.well-known/mta-sts.txt. Wichtig: Der Webserver muss ein gültiges TLS-Zertifikat haben und unter genau diesem Hostnamen erreichbar sein.
enforce = nur verschlüsselt zustellen. testing = wie enforce, aber bei Fehlern trotzdem zustellen (gut zum Einstieg). none = Policy deaktiviert.
mx
An welche MX-Server zugestellt werden darf. Mehrere Einträge möglich (je eine Zeile). Wildcards gehen: *.kernel-error.de
max_age
Wie lange die Policy gecacht wird, in Sekunden. 2419200 = 28 Tage.
Der empfohlene Weg: Mit mode: testing anfangen und die TLS-Reports auswerten. Wenn alles sauber ist, auf enforce umstellen.
3. TLS Reporting
Wie bei DMARC gibt es auch für MTA-STS ein Reporting-System: SMTP TLS Reporting (RFC 8460). Ein weiterer DNS TXT-Record teilt Absendern mit, wohin sie Berichte über TLS-Verbindungsprobleme schicken sollen:
_smtp._tls.kernel-error.de. IN TXT "v=TLSRPTv1;rua=mailto:postmaster@kernel-error.de"
Die Reports kommen als JSON per Mail und enthalten Informationen über fehlgeschlagene TLS-Verbindungen, ungültige Zertifikate oder MX-Mismatches. Google und Microsoft schicken diese Reports zuverlässig.
Postfix und MTA-STS
Postfix prüft von Haus aus keine MTA-STS-Policies. Für die ausgehende Seite braucht es postfix-mta-sts-resolver, ein Policy-Daemon der sich als smtp_tls_policy_maps in Postfix einhängt. Der Daemon cached die Policies und liefert Postfix die passende TLS-Konfiguration pro Zieldomain.
Die eingehende Seite braucht keine Software. Die drei DNS-Records und die Policy-Datei auf dem Webserver reichen aus. Sendende Server wie Gmail, Outlook oder Yahoo werten die Policy selbständig aus.
Zusammen mit SPF, DKIM, DMARC und DANE ergibt MTA-STS eine lückenlose Absicherung: Authentifizierung (wer darf senden), Integrität (DKIM-Signatur) und Transportverschlüsselung (DANE/MTA-STS). Fragen? Einfach melden.
Die niederländische Regierung betreibt mit internet.nl ein kostenloses Testtool für Webserver und Mailserver. Im Gegensatz zu Qualys SSL Labs, das sich auf TLS-Konfiguration konzentriert, prüft internet.nl das gesamte E-Mail-Sicherheitsbild einer Domain.
Was getestet wird
Der Mailserver-Test prüft:
STARTTLS
Ob der MX TLS anbietet und welche Protokollversionen und Cipher unterstützt werden
Ob MTA-STS konfiguriert ist und die Policy konsistent ist
DNSSEC
Ob die Domain mit DNSSEC gesichert ist
Für jede Kategorie gibt es Punkte. 100 Prozent erreicht man nur wenn alles korrekt konfiguriert ist. Domains die sowohl beim Web- als auch beim Mailtest 100 Prozent erreichen, landen in der Hall of Fame.
Strenge Anforderungen
internet.nl ist strenger als die meisten anderen Testtools. TLS 1.0 und 1.1 geben Abzug. Ohne DANE ist kein voller Score möglich. Die Cipher-Anforderungen orientieren sich an den niederländischen IT-Sicherheitsrichtlinien, die auch für Behörden gelten.
Das macht den Test besonders nützlich als Benchmark. Wer dort 100 Prozent hat, hat sein E-Mail-Setup nach aktuellem Stand abgesichert. Wer Abzüge bekommt, sieht genau wo es hakt.
Fremde Domains testen
Man kann beliebige Domains testen, nicht nur die eigene. Das ist praktisch um Dienstleister, Geschäftspartner oder den eigenen Provider zu prüfen. Ein kurzer Test zeigt schnell ob der Mailserver auf der anderen Seite zeitgemäß konfiguriert ist oder ob dort noch SSLv3 mit RC4 läuft.