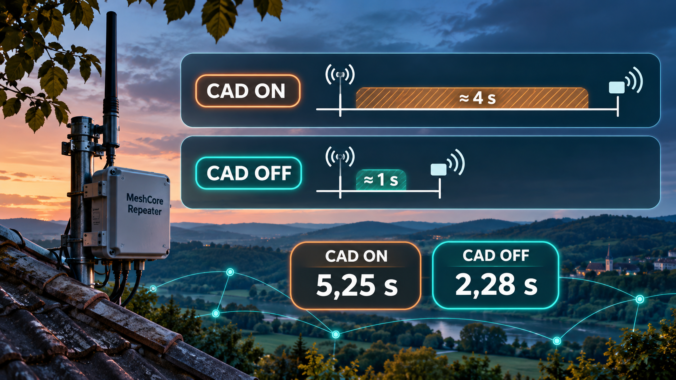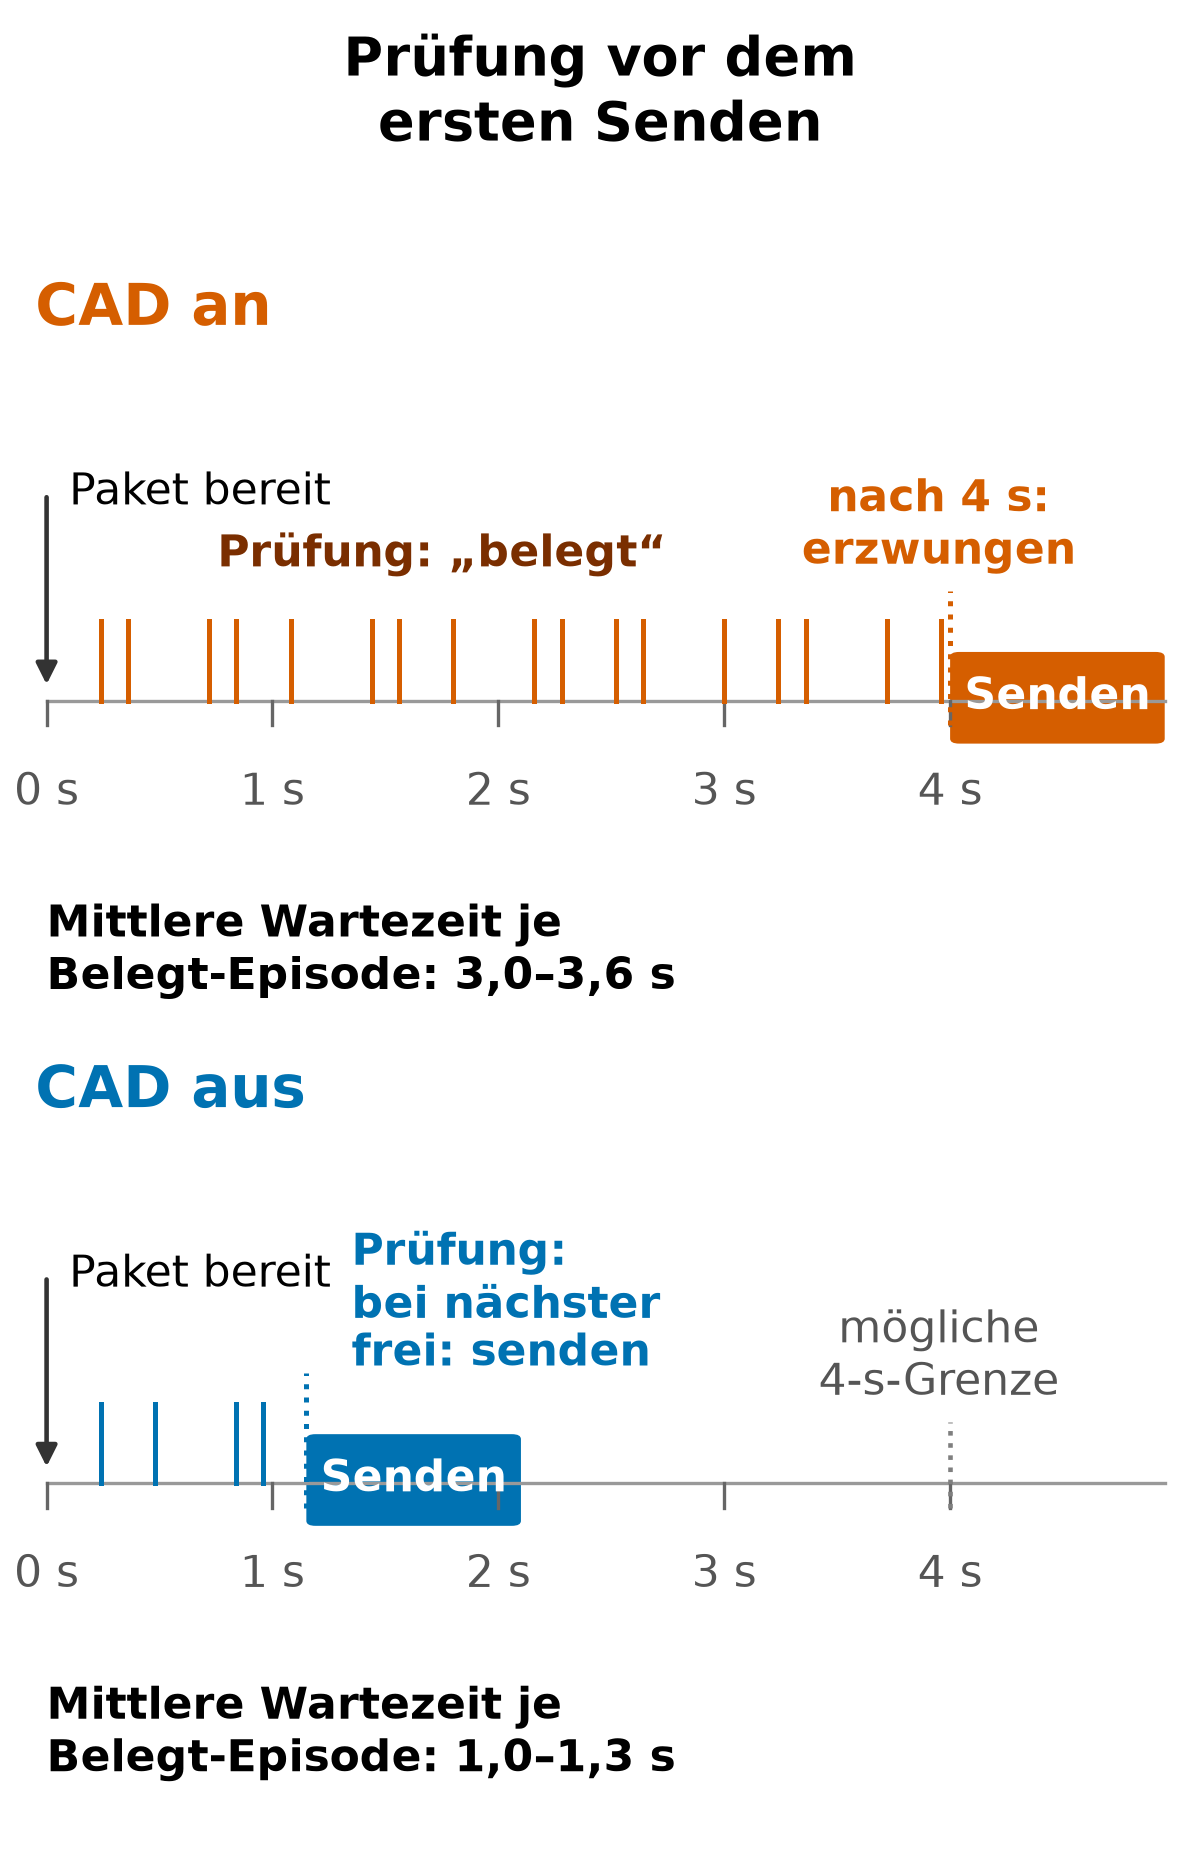
In Teil 1 ging es um Coding Rate, den Community-Fork und die Kanalfilter, in Teil 2 um CAD. Dabei sind mir drei Dinge aufgefallen, die ich mit den Statistiken der Firmware allein nicht erklären konnte. Bei eingeschaltetem CAD endeten 80 bis 93 % der beobachteten Belegt-Episoden nach rund vier Sekunden mit einer erzwungenen Sendung. Bei einem früheren TRACE-Test dauerte der Hin- und Rückweg über einen Repeater rund fünf Sekunden. Außerdem blieb der geschätzte Rauschboden bei −120 dBm hängen.
Raten wollte ich an der Stelle nicht mehr. Also habe ich mir eigene Debug-Builds der Firmware gebaut, die zählen, was im Repeater passiert, und sie vorsichtig auf den laufenden Repeater geflasht. Mögliche Korrekturen ließen sich darin zur Laufzeit an- und ausschalten und in ausgelosten A/B-Blöcken vergleichen. Das Ergebnis vorweg: Eine Korrektur spart Sendungen, ohne dass sich bei der Zustellung etwas messbar ändert, eine zweite räumt die Wiederholungszähler auf. Beide habe ich an die Projekte zurückgegeben. Und beim Rauschboden habe ich eine Erklärung gefunden, die zu den Daten passt, aber noch kein Beweis ist.
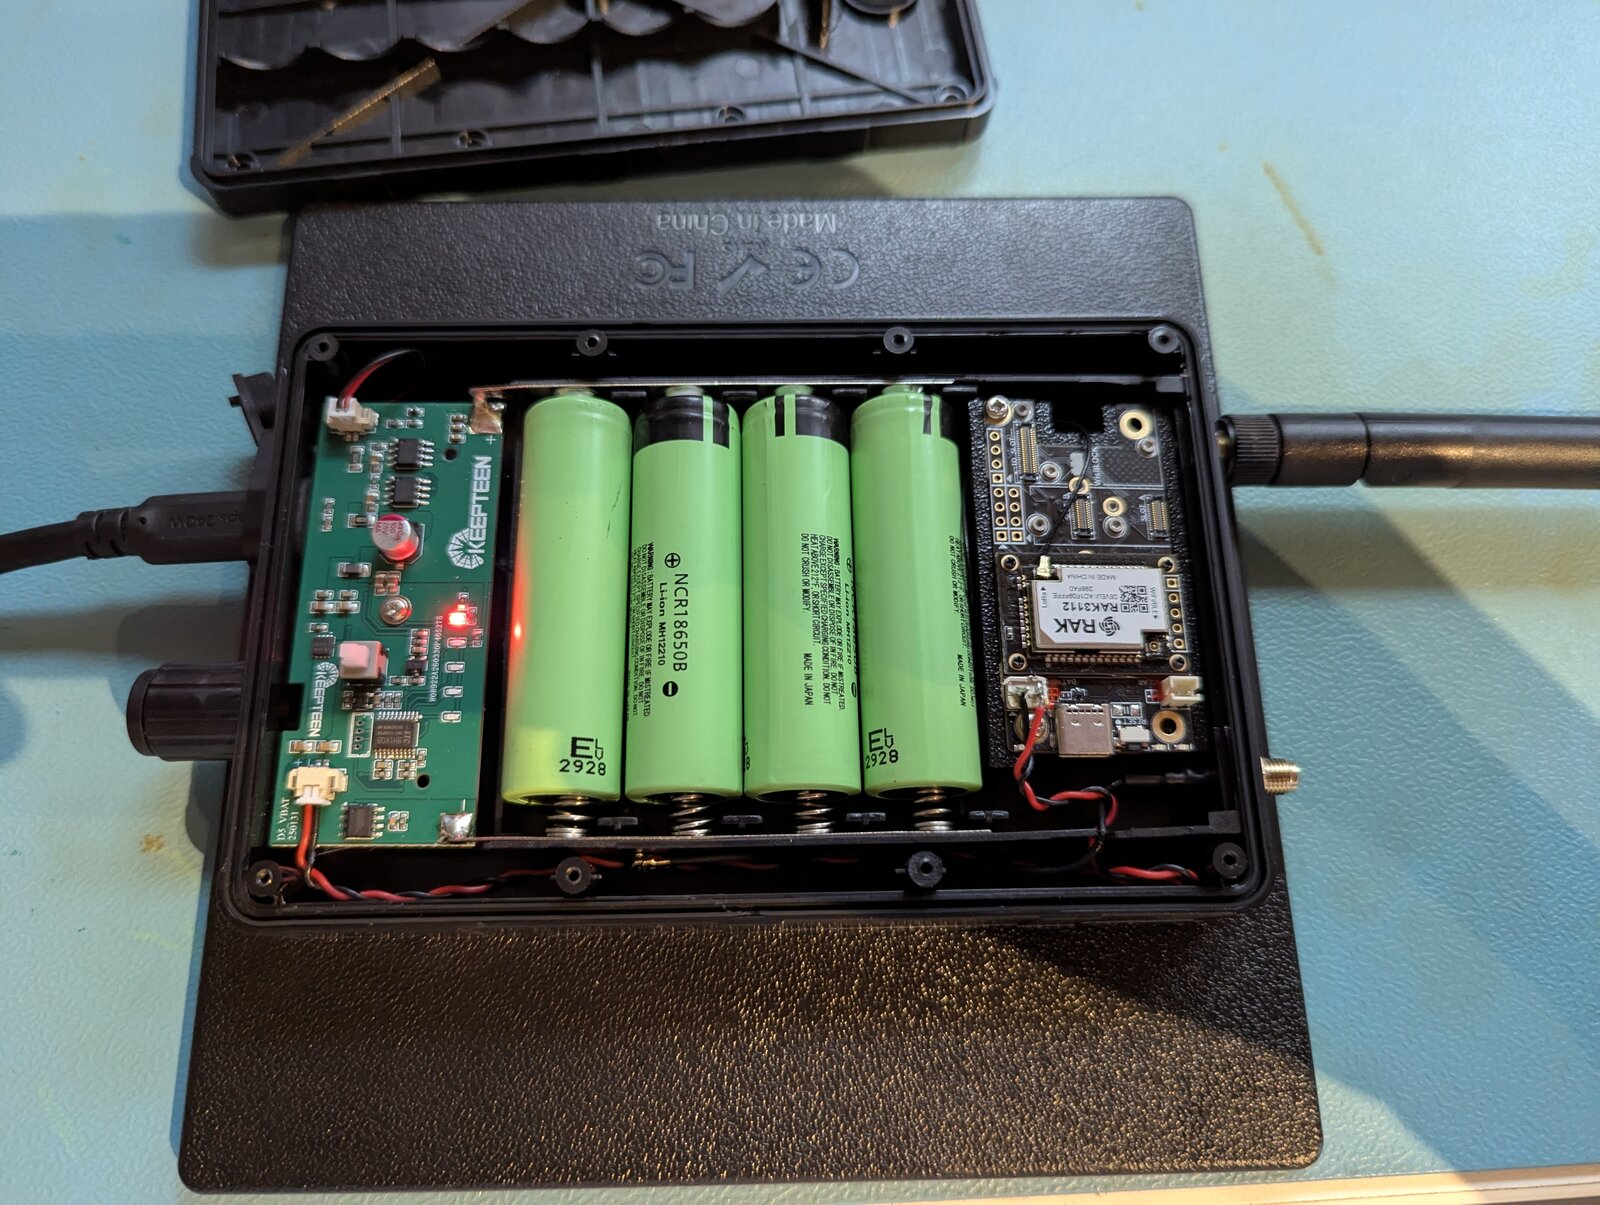
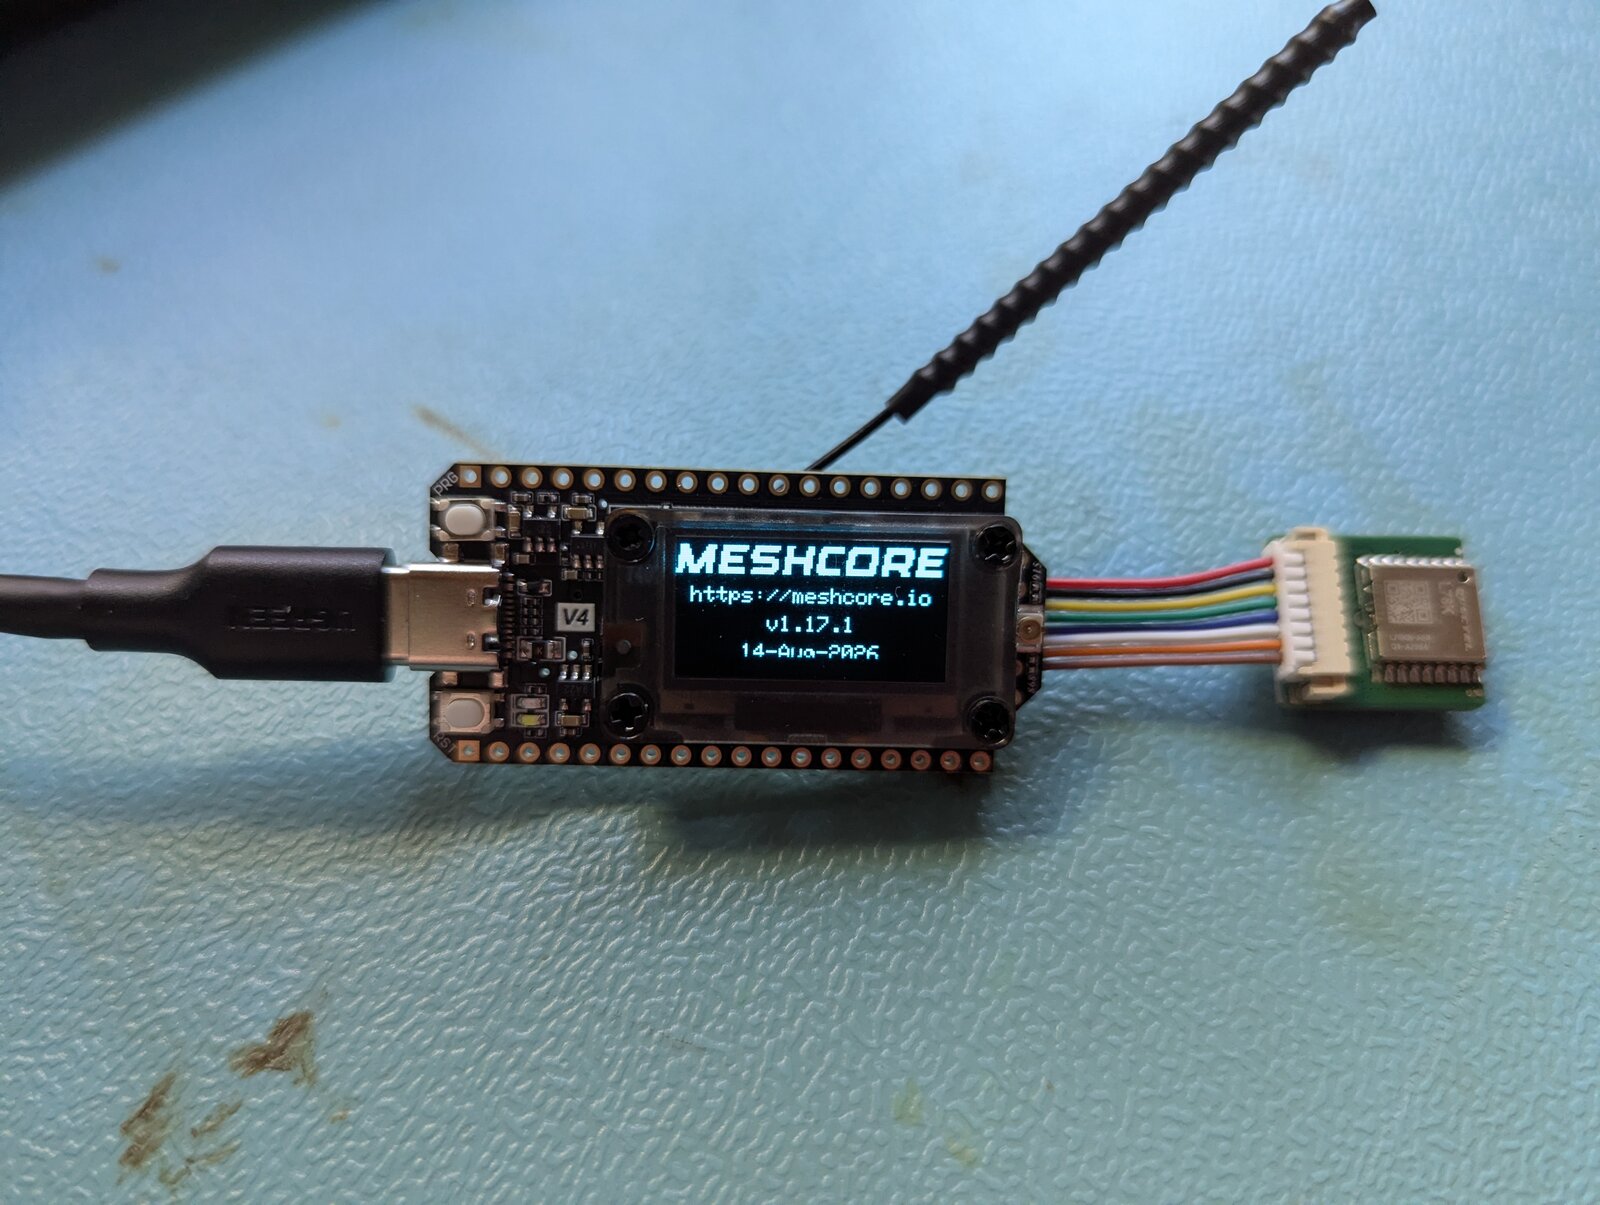
Zum Aufbau, falls du die ersten beiden Teile nicht kennst: Mein Repeater hat das Hop-Präfix 1863. Er ist ein Heltec V4.3 mit dem Frontend KCT8103L, also mit Leistungsverstärker und rauscharmem Vorverstärker (LNA), an einer Außenantenne. Als Firmware lief der Community-Fork m0urs/MeshCore, die Debug-Builds basieren auf dessen Release mups18-2.
Zähler statt Raten: die Debug-Builds
Die ersten Debug-Builds haben nur gezählt. Sie hatten Zähler für die CAD-Prüfungen und für die Sendefreigabe, sonst nichts. Spätere Builds bekamen zusätzliche Messpunkte und experimentelle Korrekturen, die ich über die serielle Konsole mit set dbg.fix ... on|off schalten konnte. Diese Schalter lagen nur im RAM, ein Neustart hat alle wieder ausgeschaltet. So konnte ich eine Korrektur testen, ohne für jeden Versuch neu zu flashen, und im Zweifel war ein Reboot die Rückfallebene.
Vor jedem Flash bin ich dieselbe Liste durchgegangen:
- eine zweite Meinung zum geänderten Code
- ein vollständiges Backup der 16 MB Flash
- die Konfiguration vorher und nachher auslesen und vergleichen, bis auf die Zähler musste sie gleich sein
- ein aufgeschriebener Rückweg mit dem alten Image
Die Versuche selbst liefen unbeaufsichtigt über Skripte. Für die Korrekturen bei TRACE und beim Rauschboden und später für die Direktnachrichten habe ich Paare aus zwei Blöcken gebildet und innerhalb jedes Paars ausgelost, welcher Block mit und welcher ohne Korrektur läuft. Ausgewertet habe ich auf Blockebene mit einem gepaarten Permutationstest. Bei vier Paaren ist das kleinste mögliche p übrigens 0,125, große Signifikanz ist so also nicht zu holen. Die Wartezeit-Phasen beim Rauschboden liefen dagegen in fester Reihenfolge, und die späteren Läufe mit aktiviertem CAD waren einfache Beobachtungen nacheinander, ohne Auslosung. Das sage ich jeweils dazu.
Eine Sache ist mir wichtig: Diese Debug-Builds sind kein Angebot zum Nachmachen. Sie sind Messwerkzeuge für genau diesen einen Repeater, deshalb gibt es sie hier auch nicht zum Download.
TRACE: zwei Korrekturen bei den Wiederholungen
TRACE ist in MeshCore ein Werkzeug zur Laufzeitmessung. Du schickst ein TRACE-Paket über einen festgelegten Pfad von Repeatern und bekommst es zurück, mit dem Signal-Rausch-Abstand jedes Hops. Für meine Versuche habe ich etwa alle 20 Sekunden ein TRACE über 1863 und über 1863 und einen Nachbarn zurück zu 1863 geschickt.
Ein Repeater leitet ein TRACE weiter und horcht danach, ob der nächste Hop es seinerseits weiterleitet. Hört er das nicht, wiederholt er seine Sendung. Die Zähler zeigten dabei zwei Stellen, an denen der Repeater mehr gesendet hat als nötig.
Die erste Stelle: Eine Wiederholung stand schon in der Warteschlange, obwohl der nächste Hop das Paket in der Zwischenzeit weitergeleitet hatte. Der Repeater hat die Weiterleitung gehört und trotzdem wiederholt. Die Korrektur in PR #25 bricht die wartende Wiederholung ab, sobald die Weiterleitung des nächsten Hops mitgehört wurde. Bei #25 entfielen im Versuch rund 40 überflüssige TRACE-Wiederholungen je 30 Minuten.
Die zweite Stelle betrifft den letzten Repeater vor dem Ziel. Auch er hat das TRACE über den Pfad mit Wiederholungen geschickt. Mit PR #26 sendet der letzte Repeater vor dem Ziel den TRACE einmal über die normale Sendefreigabe. Im Versuch ging der Zähler für Wiederholungen dabei ungefähr auf die Hälfte zurück, die Zahl der Sendungen blieb aber etwa gleich. Der letzte Hop zählt nur nicht mehr als Wiederholung.
Für die Zustellung und die Laufzeit ließ sich in diesen Versuchen kein Unterschied nachweisen. Wirklich Sendungen spart also nur #25. #26 legt vor allem fest, über welche Prüfung der letzte Hop sendet, und bereinigt die Zähler. Eine bessere Zustellung kann ich aus keiner der beiden ableiten. Die genauen Zahlen der Versuche stehen im Anhang.
Der Rauschboden, der bei −120 dBm hängen bleibt
Die Firmware schätzt laufend den Rauschboden, also das Grundrauschen im Kanal. Diese Schätzung fließt unter anderem in die Prüfung ein, ob eine Wiederholung gesendet werden darf. Ich nenne sie hier Resend-Schranke. Sie meldet „belegt“, wenn der aktuelle RSSI-Wert mindestens 12 dB über dem geschätzten Rauschboden liegt.
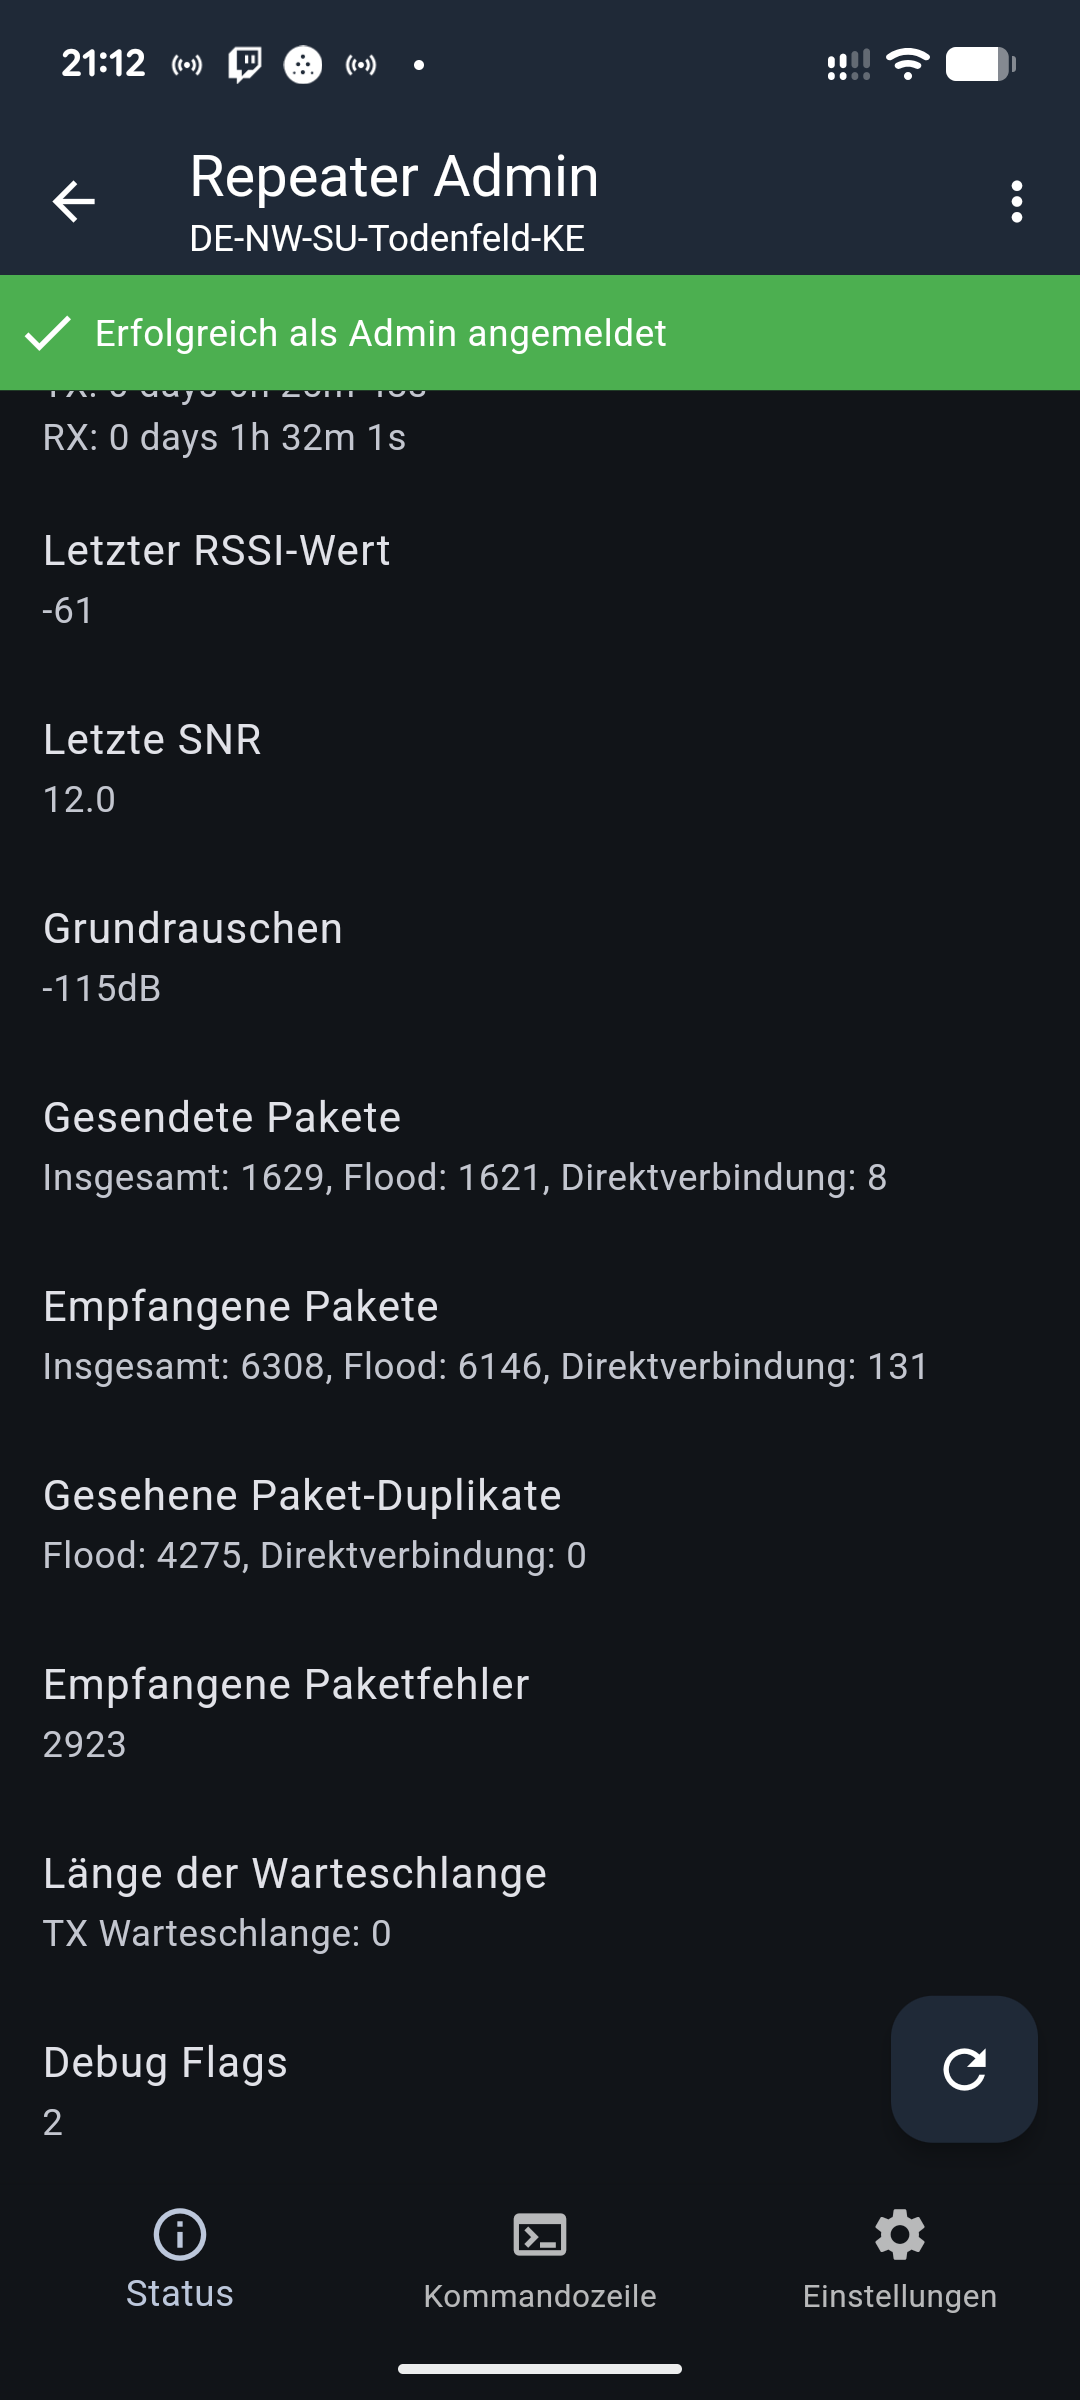
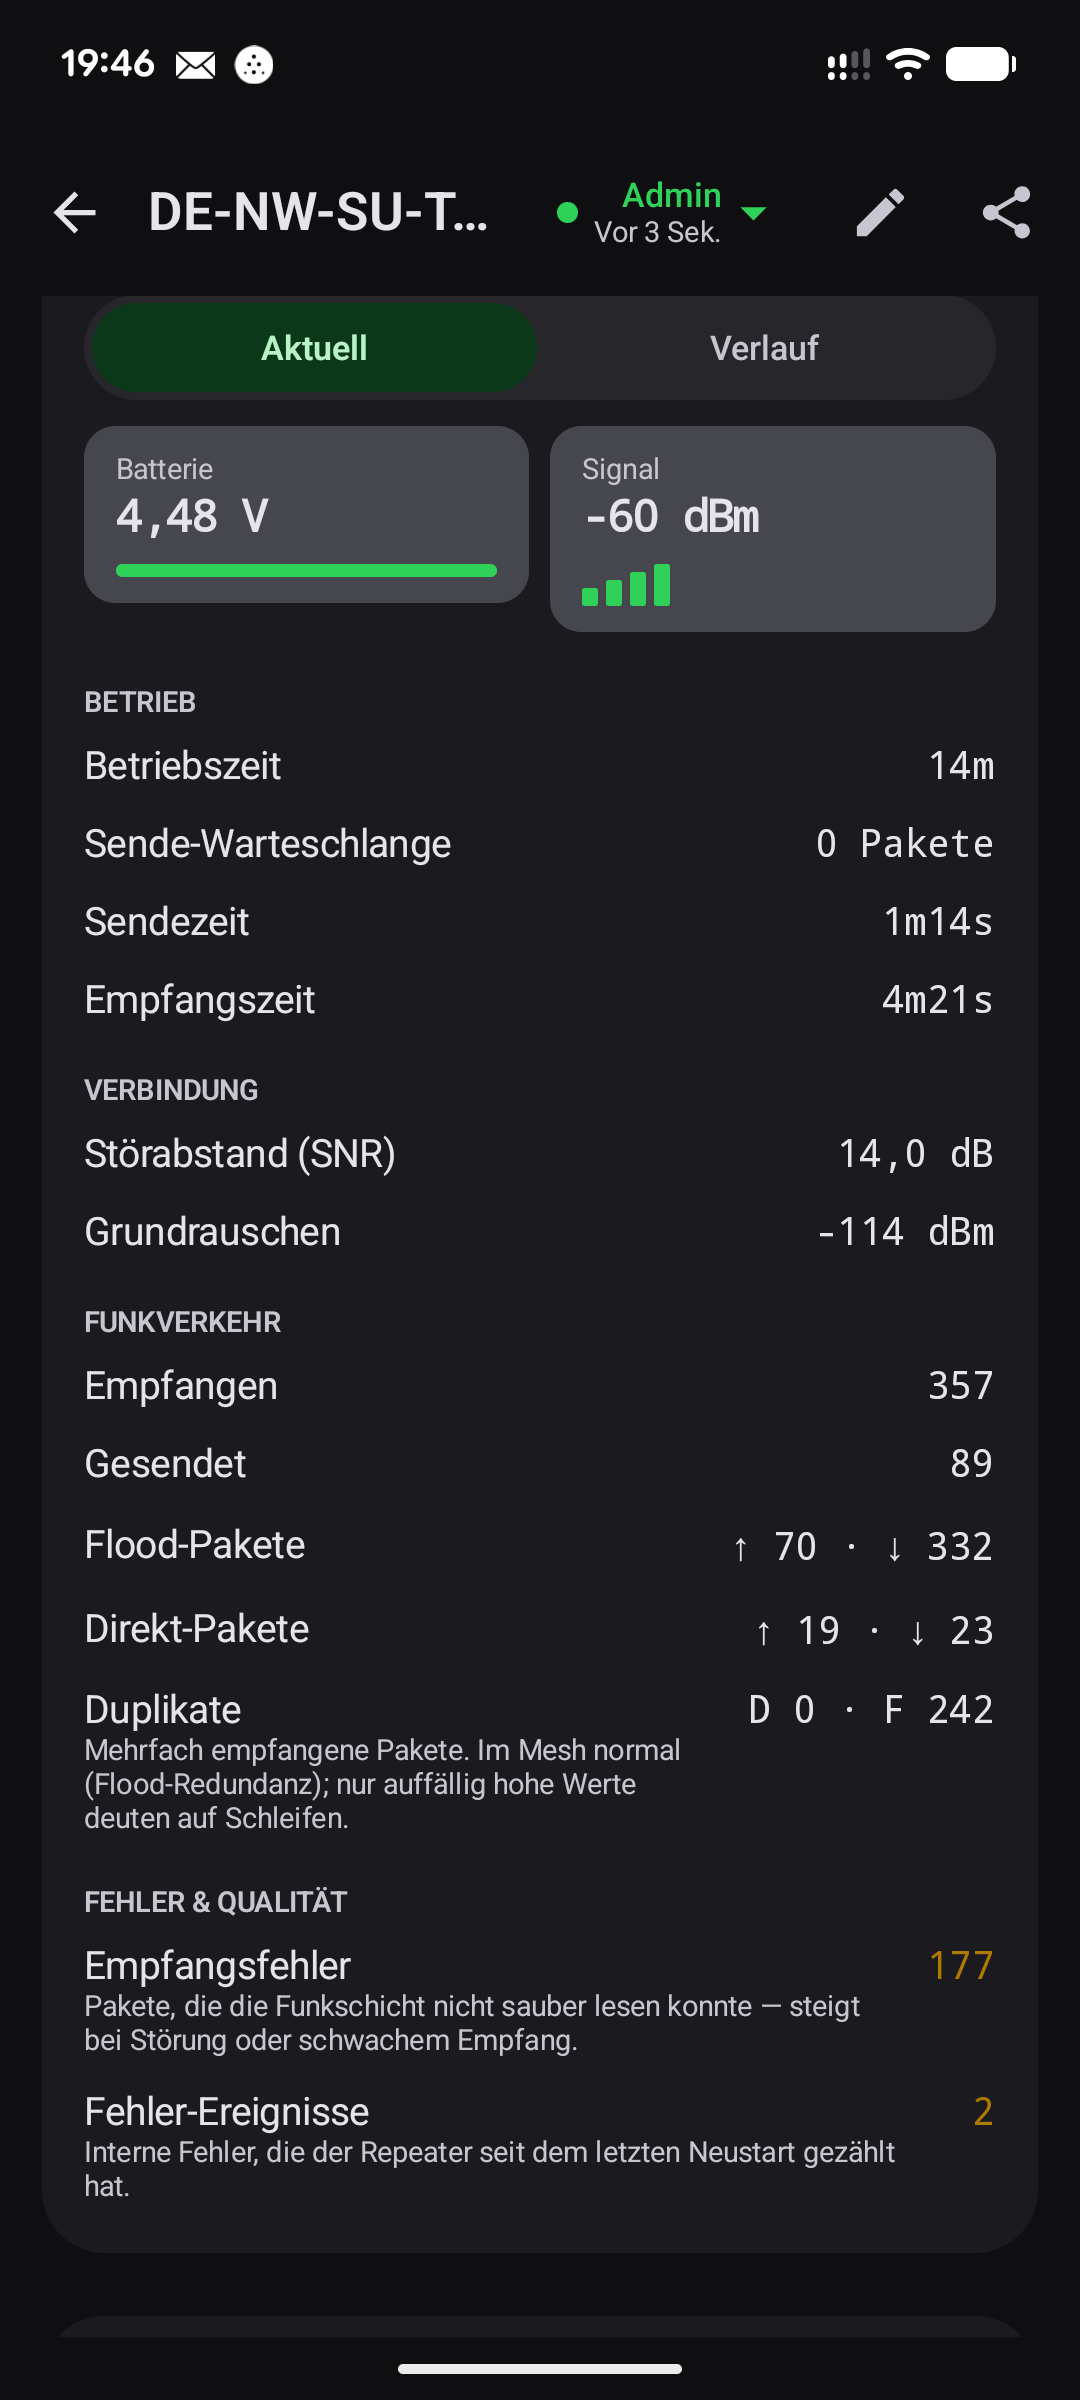
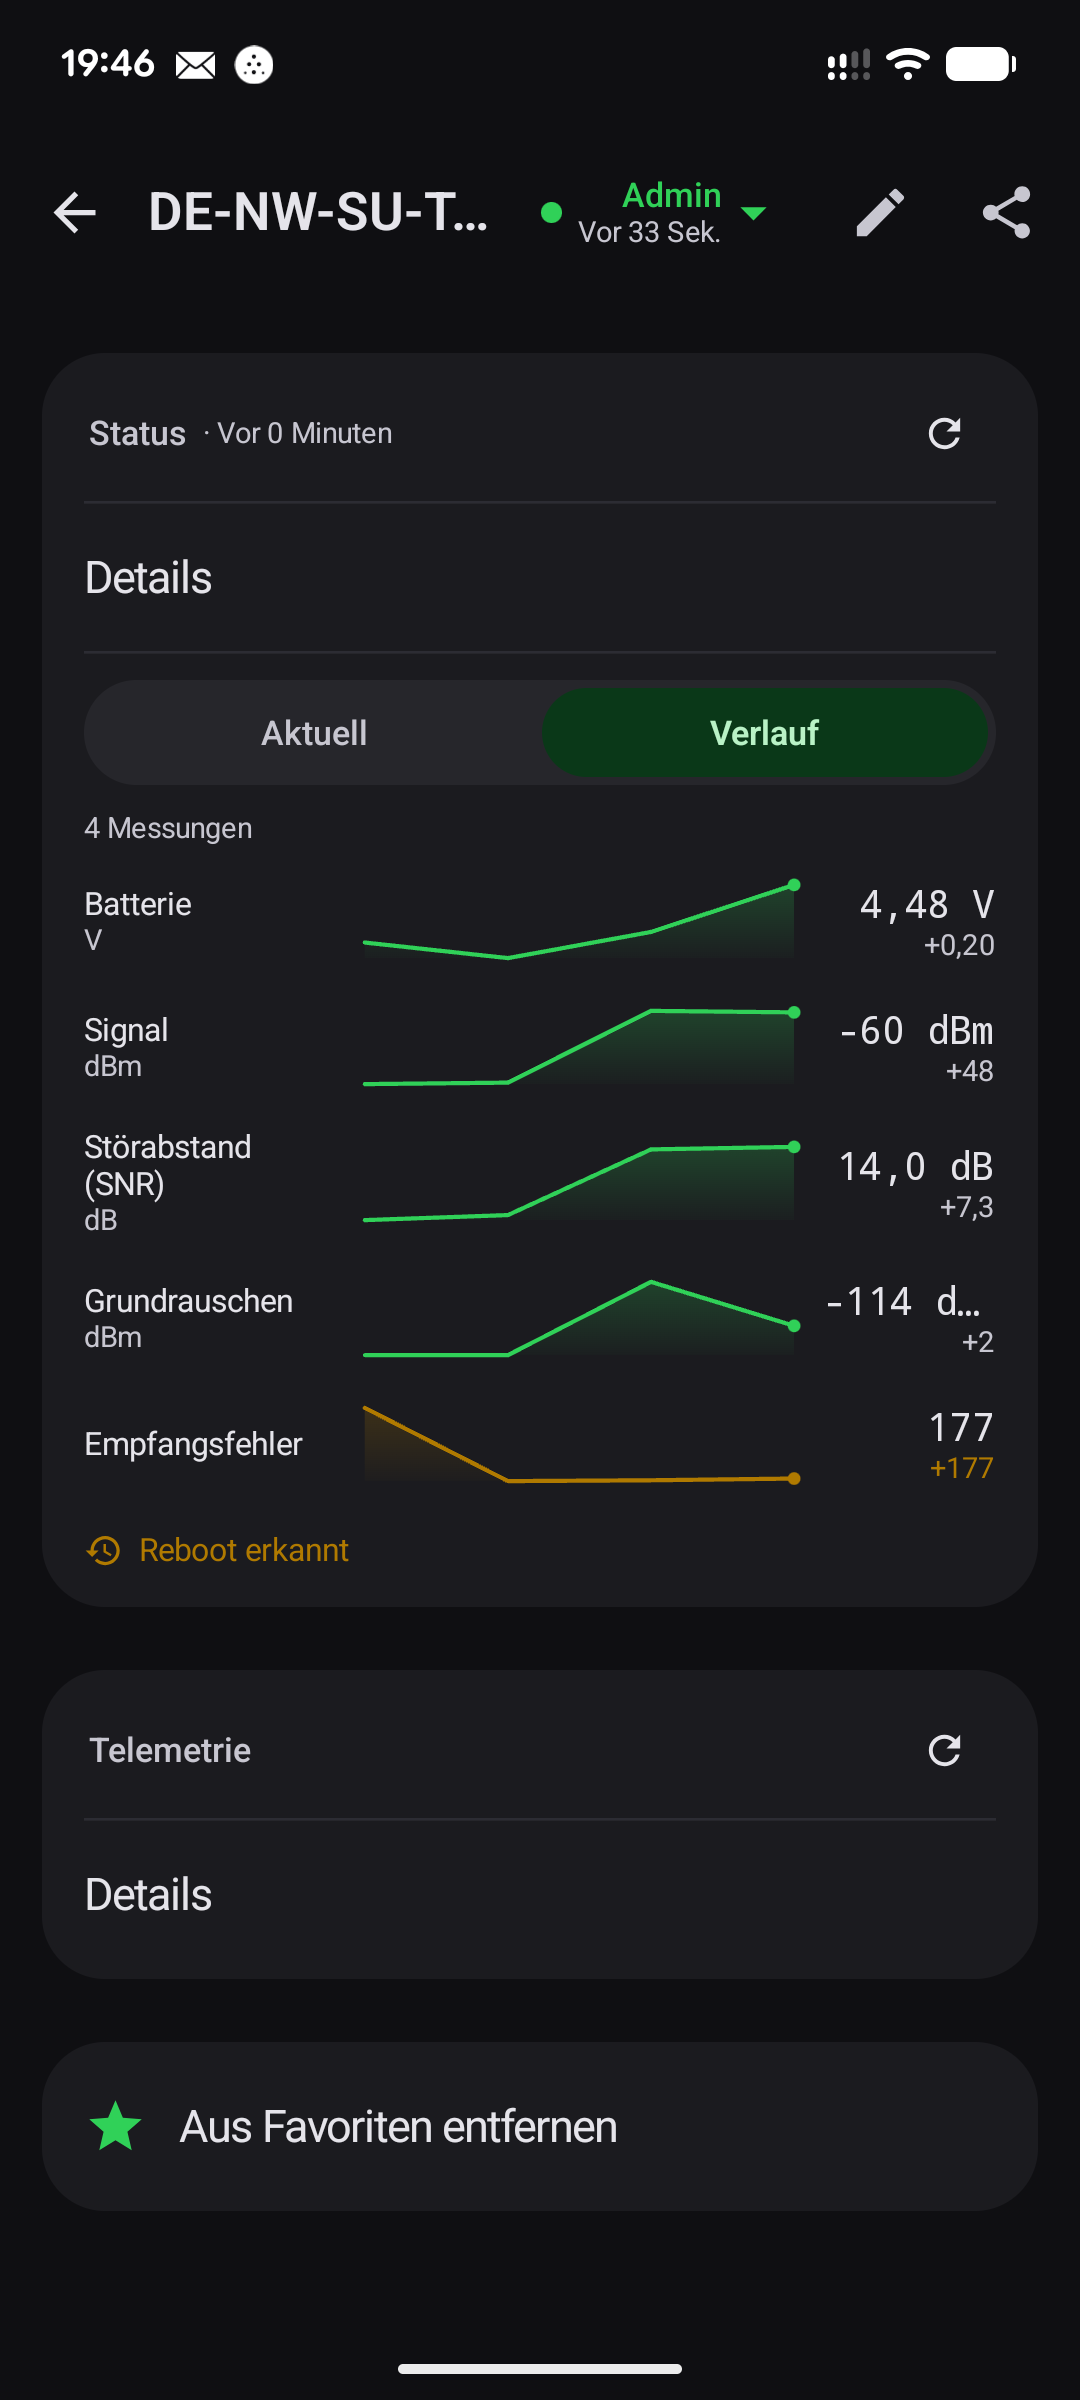
Wenn alles funktioniert pendelt sich der Originalschätzer auf meinem Heltec bei etwa −80 bis −93 dBm ein. Der LNA ist in diesem Wert schon mit drin, mit Boards ohne LNA ist die Zahl also nicht vergleichbar. Bei mir fiel die Schätzung aber immer wieder auf −120 dBm, die Untergrenze im Code, und blieb dort stundenlang. Das hatte ich zuerst auf der Standard-Firmware gesehen, nicht erst mit meinen Debug-Builds.
Im Quellcode des Forks fand sich eine mögliche Erklärung. Der Schätzer übernimmt nur RSSI-Werte unterhalb des aktuellen Schätzwerts plus 14 dB. Das ist sinnvoll, damit laufende Pakete den Rauschboden nicht nach oben ziehen. Es gibt im Code auch eine Wartezeit, die frische Messwerte direkt nach dem Start des Empfängers ignoriert. Im untersuchten Fork galt die 20-ms-Wartezeit nur während der RXPS-Kalibrierung. Mit ausgeschaltetem RX-Stromsparen, so wie bei mir, wartete der Schätzer nach einem Neustart des Empfängers also garnicht. Im Upstream-Code steht bei resetAGC() übrigens schon ein Kommentar zu einem hängenden Wert bei −120 dBm. Zurückgesetzt wird die Schätzung dort aber nur, wenn agc.reset.interval größer als 0 ist, und bei mir steht es auf 0.
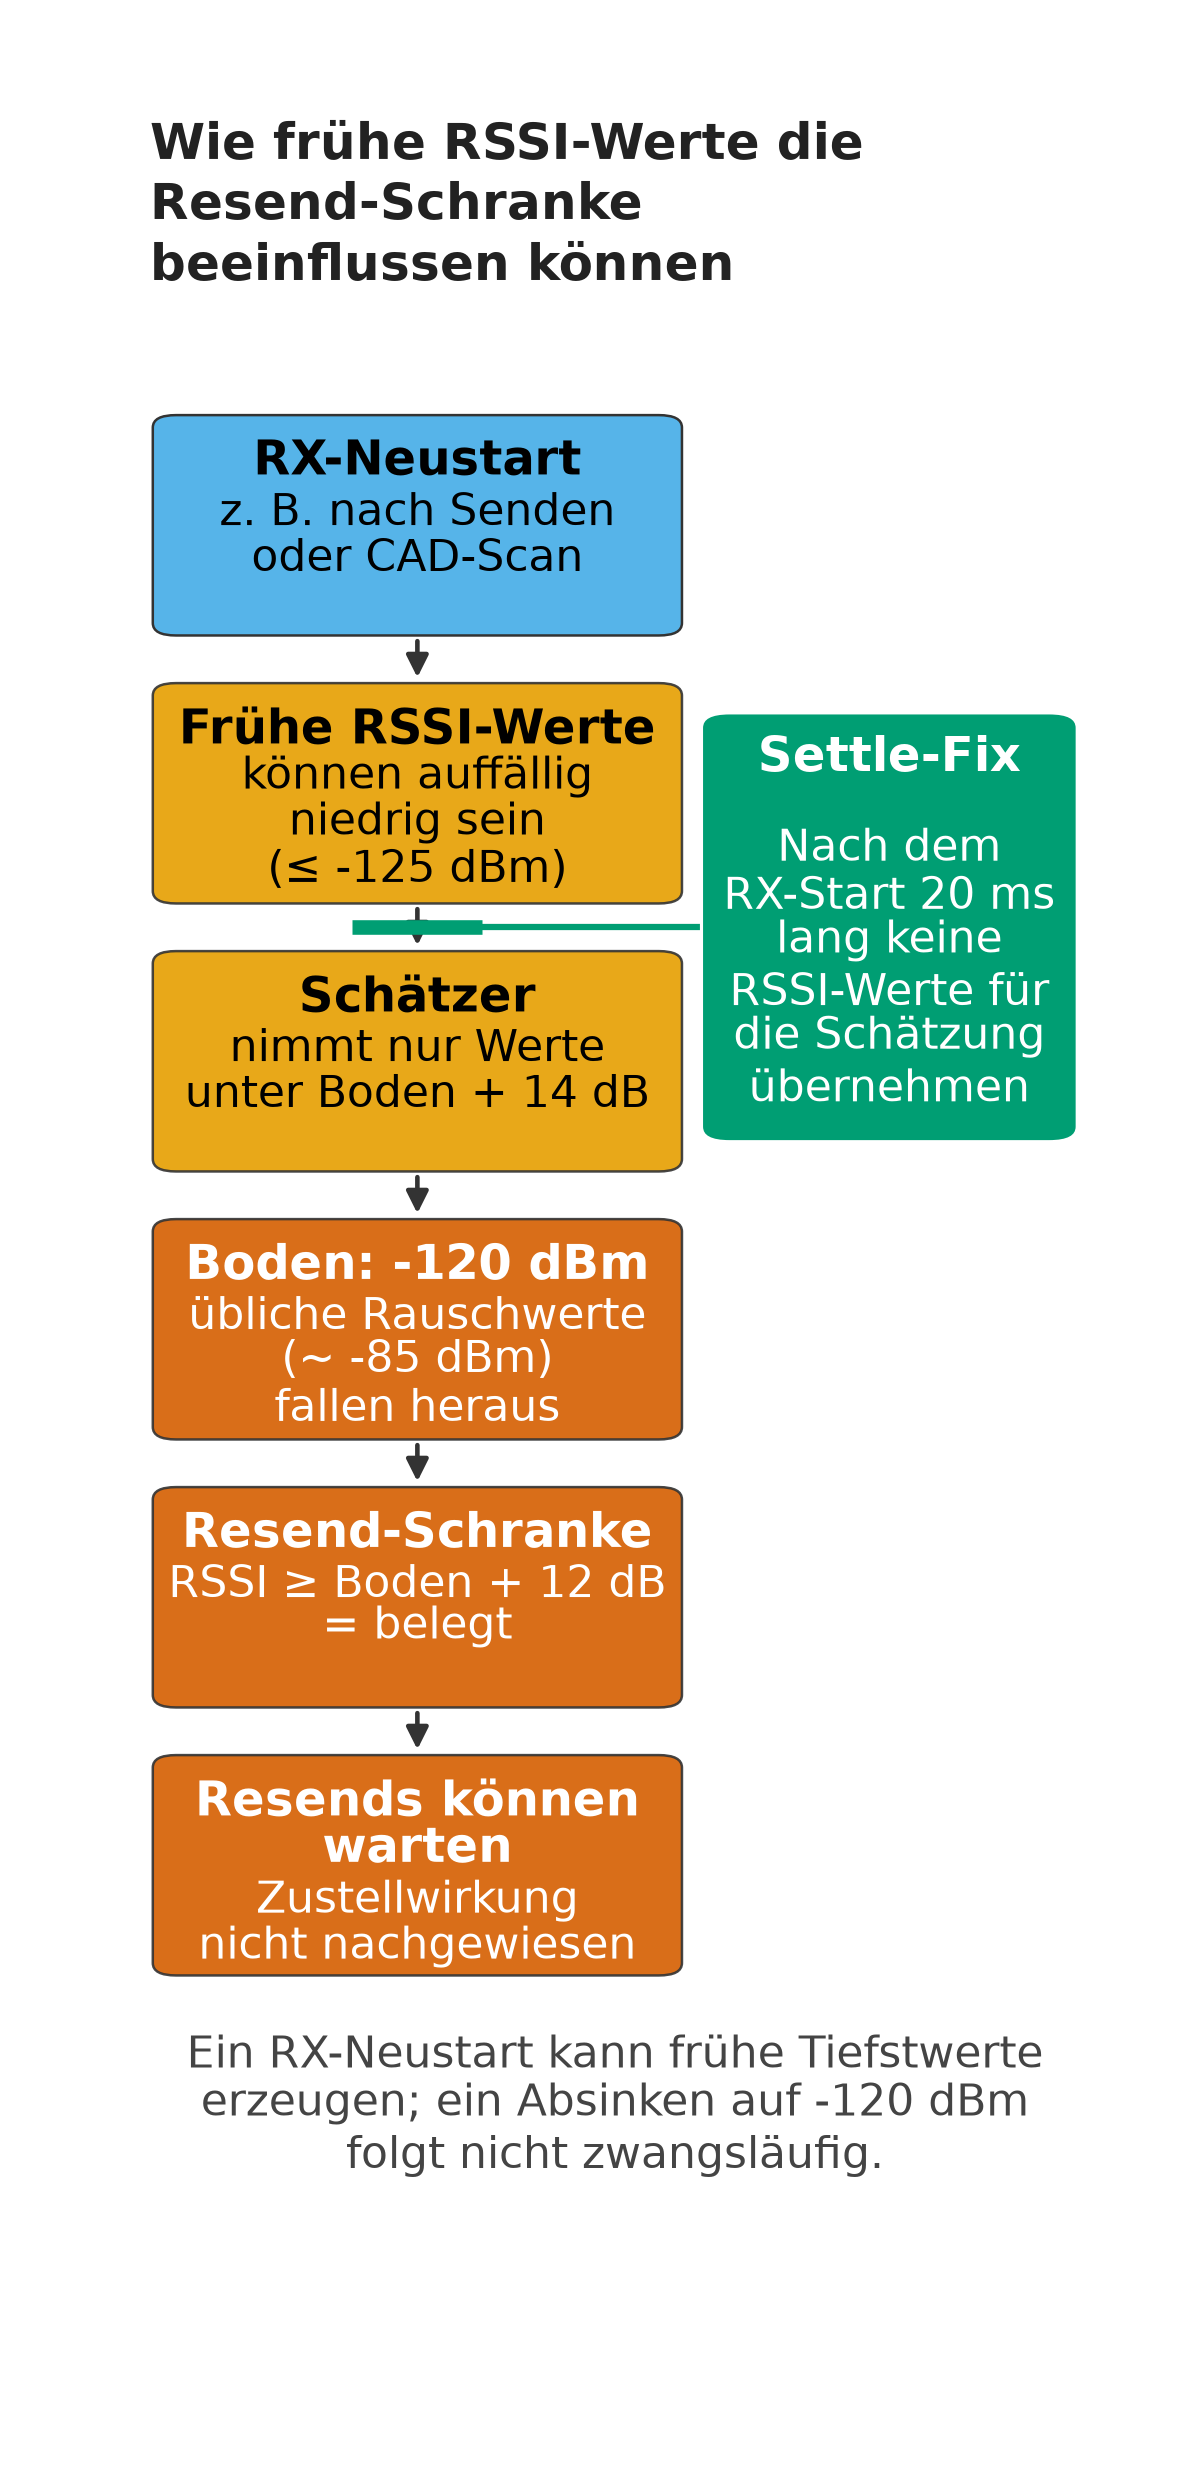
Um das zu prüfen, habe ich einen Debug-Build mit zusätzlichen Messpunkten gebaut. Er protokolliert für jeden übernommenen RSSI-Wert, wie lange der Start des Empfängers her ist, und hat einen Schalter für eine Wartezeit von 20 ms nach dem RX-Start. Diesen Schalter nenne ich im Folgenden Settle-Fix. Dann liefen sechs Phasen abwechselnd ohne und mit Wartezeit.
Ohne Wartezeit übernahm der Schätzer in den ausgewerteten Phasen 22.993 Werte von höchstens −125 dBm, alle weniger als 5 ms nach dem RX-Start. Mit Wartezeit waren es null. Zwischen −125 und −110 dBm lag in keiner Phase ein einziger übernommener Wert. In keiner dieser sechs Phasen fiel der Schätzwert auf −120 dBm. Zusammen mit der Annahmeschwelle im Code ergibt das eine plausible Erklärung für den später beobachteten Einbruch. Ein Schwung sehr niedriger Werte direkt nach dem RX-Start zieht die Schätzung nach unten. Steht sie erst einmal bei −120 dBm, liegt die Annahmegrenze bei −106 dBm, und normales Rauschen um −83 dBm wird gar nicht mehr übernommen. Die Schätzung kommt dann nur sehr langsam wieder hoch. Bewiesen ist dieser Ablauf nicht, er passt aber zu allem, was ich gemessen habe.
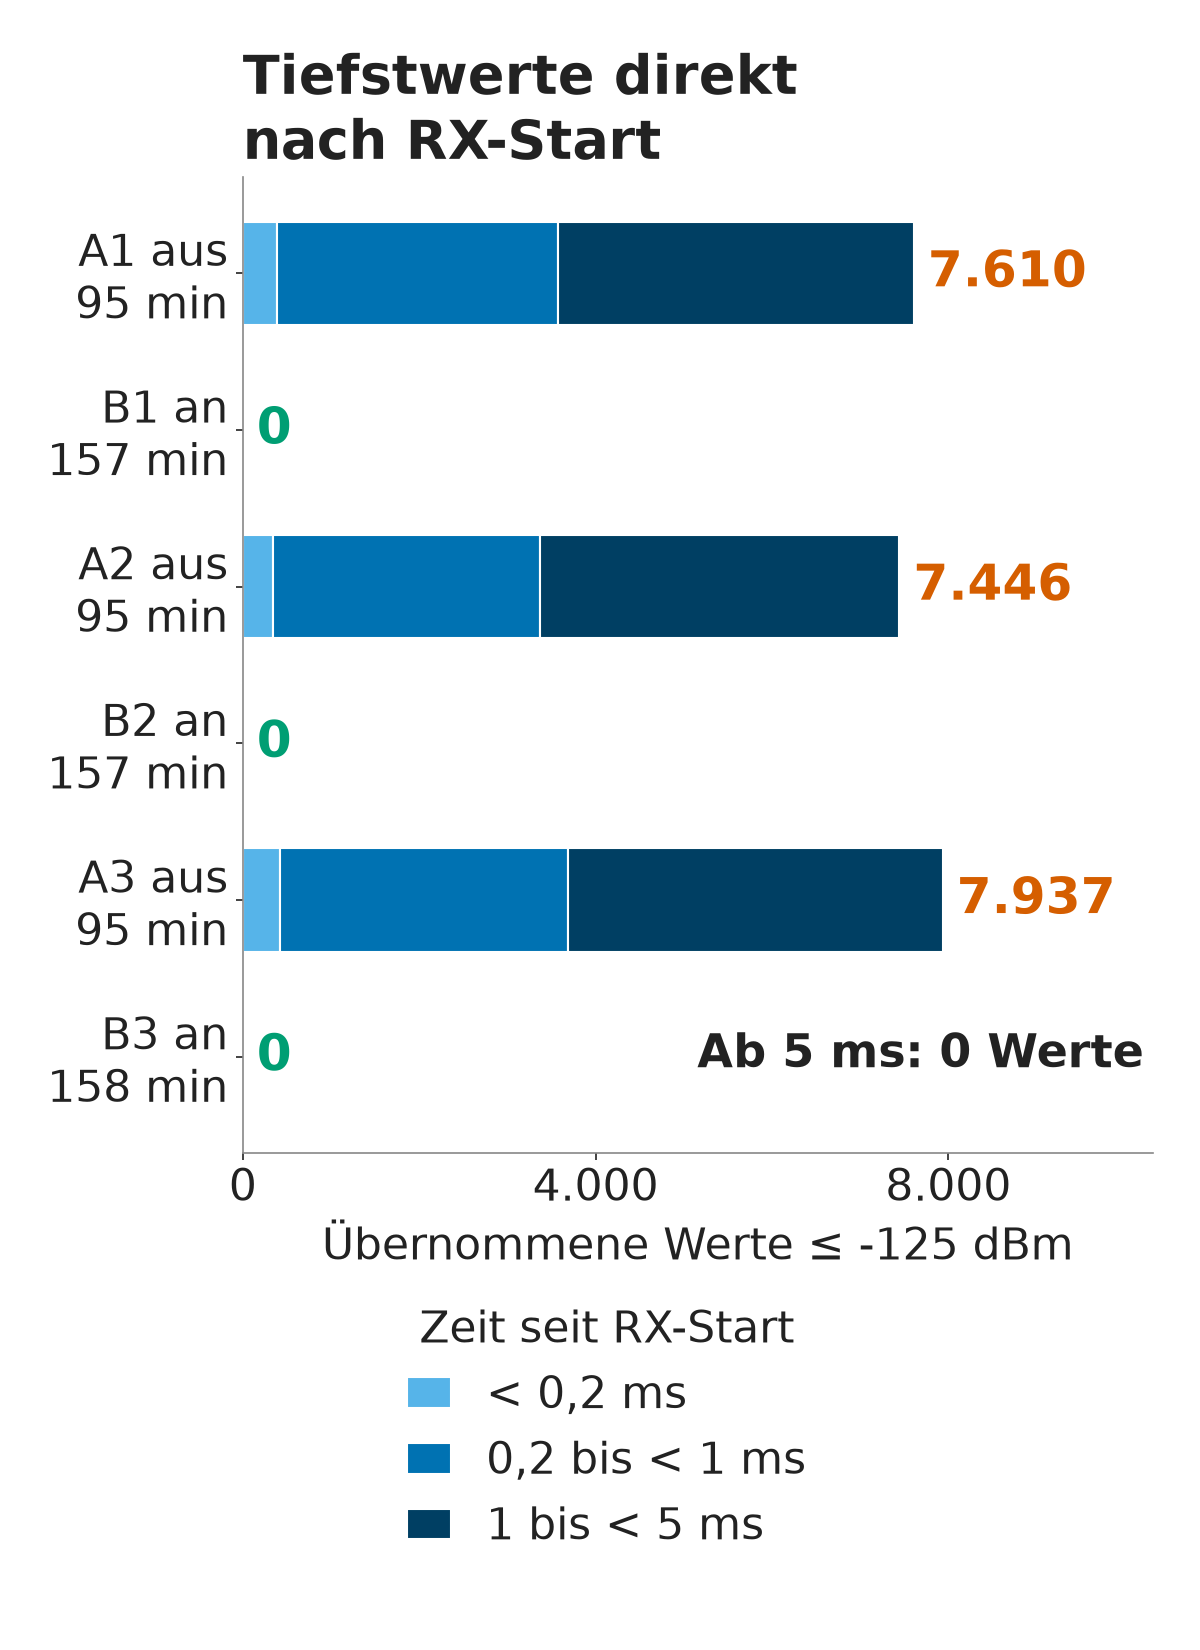
Wie schnell die Schätzung einbricht, war sehr unterschiedlich. Mit ausgeschaltetem CAD beim Senden und diagnostischen CAD-Scans etwa alle 1,5 s im dbg6 protokollierte der Originalschätzer rund 45 Minuten nach dem Flash erstmals −120 dBm. Frühere Läufe erreichten die Untergrenze mit aktiviertem CAD innerhalb von etwa einer Stunde. Ohne CAD und ohne Wartezeit kam der Einbruch einmal in einem dbg4-Lauf erst nach etwa 11,5 Stunden, einmal mit dem unveränderten Release mups18-3 schon wenige Minuten nach dem Start. Drei weitere Blöcke mit diesem Release von je rund 45 Minuten blieben ohne Einbruch. Jeder CAD-Scan startet den Empfänger neu, und in meinen Läufen mit aktiviertem CAD kam der Einbruch früh. Dass mehr Neustarts ihn zuverlässig beschleunigen, lässt sich daraus aber nicht ableiten, schnell ging es eben auch einmal ohne CAD.
Spielt das für den Betrieb eine Rolle? Ein Hinweis kam aus dem Versuch mit dem Median-Schätzer, in dem Direktnachrichten über den Repeater liefen. Dort gab es zufällig einen 30-Minuten-Block, in dem der Schätzwert schon bei −120 dBm stand und die Rauschboden-Korrektur aus war. In diesem Block meldete die Resend-Schranke 315 Mal „belegt“, 101 Mal davon wegen der RSSI-Prüfung. In den übrigen Blöcken dieser Versuchsreihe waren es 16 bis 52 Mal, davon höchstens zweimal wegen RSSI. Dieser Vergleich ergab sich im Betrieb und war nicht ausgelost. Ein Einfluss auf die Zustellung blieb offen. Ob die fünf Sekunden aus dem frühen TRACE-Test mit dem hängenden Rauschboden zusammenhängen, passt zeitlich, ich habe es aber nicht getrennt geprüft.
Die Wartezeit über mehrere Tage
Ein paar Stunden ohne Einbruch sagen wenig, wenn der Einbruch ohne CAD auch mal elf Stunden dauern kann. Also habe ich die Wartezeit eingeschaltet, während die Schätzung gerade bei −120 dBm festhing, und sie dann einfach laufen lassen.
Der Originalschätzer meldete erstmals etwa 5 Stunden und 13 Minuten nach dem Einschalten der Wartezeit eine Erholung auf −113 dBm. Ab dem ersten wieder normalen Wert protokollierte dbg6 bis zum Test eines Firmware-Wechsels 178 Werte zwischen −94 und −70 dBm über 46 Stunden und 21 Minuten. Die ersten 41 Stunden davon lagen vor der ersten Stufe des DM-Vergleichs, den ich weiter unten beschreibe.
Danach habe ich die Wartezeit ohne den ganzen Debug-Code in einen Test-Build auf Basis des aktuellen Fork-Releases mups18-3 übernommen. In einem eigenen Lauf protokollierte v1.18.0.mups3-nfsettle 3.406 Werte zwischen −95 und −60 dBm über etwa 59,5 Stunden ohne Neustart, mit ausgeschaltetem CAD und ausgeschaltetem RXPS. Die Tagesmediane lagen bei −84 bis −85 dBm, kein einziger Wert lag bei −100 dBm oder darunter.
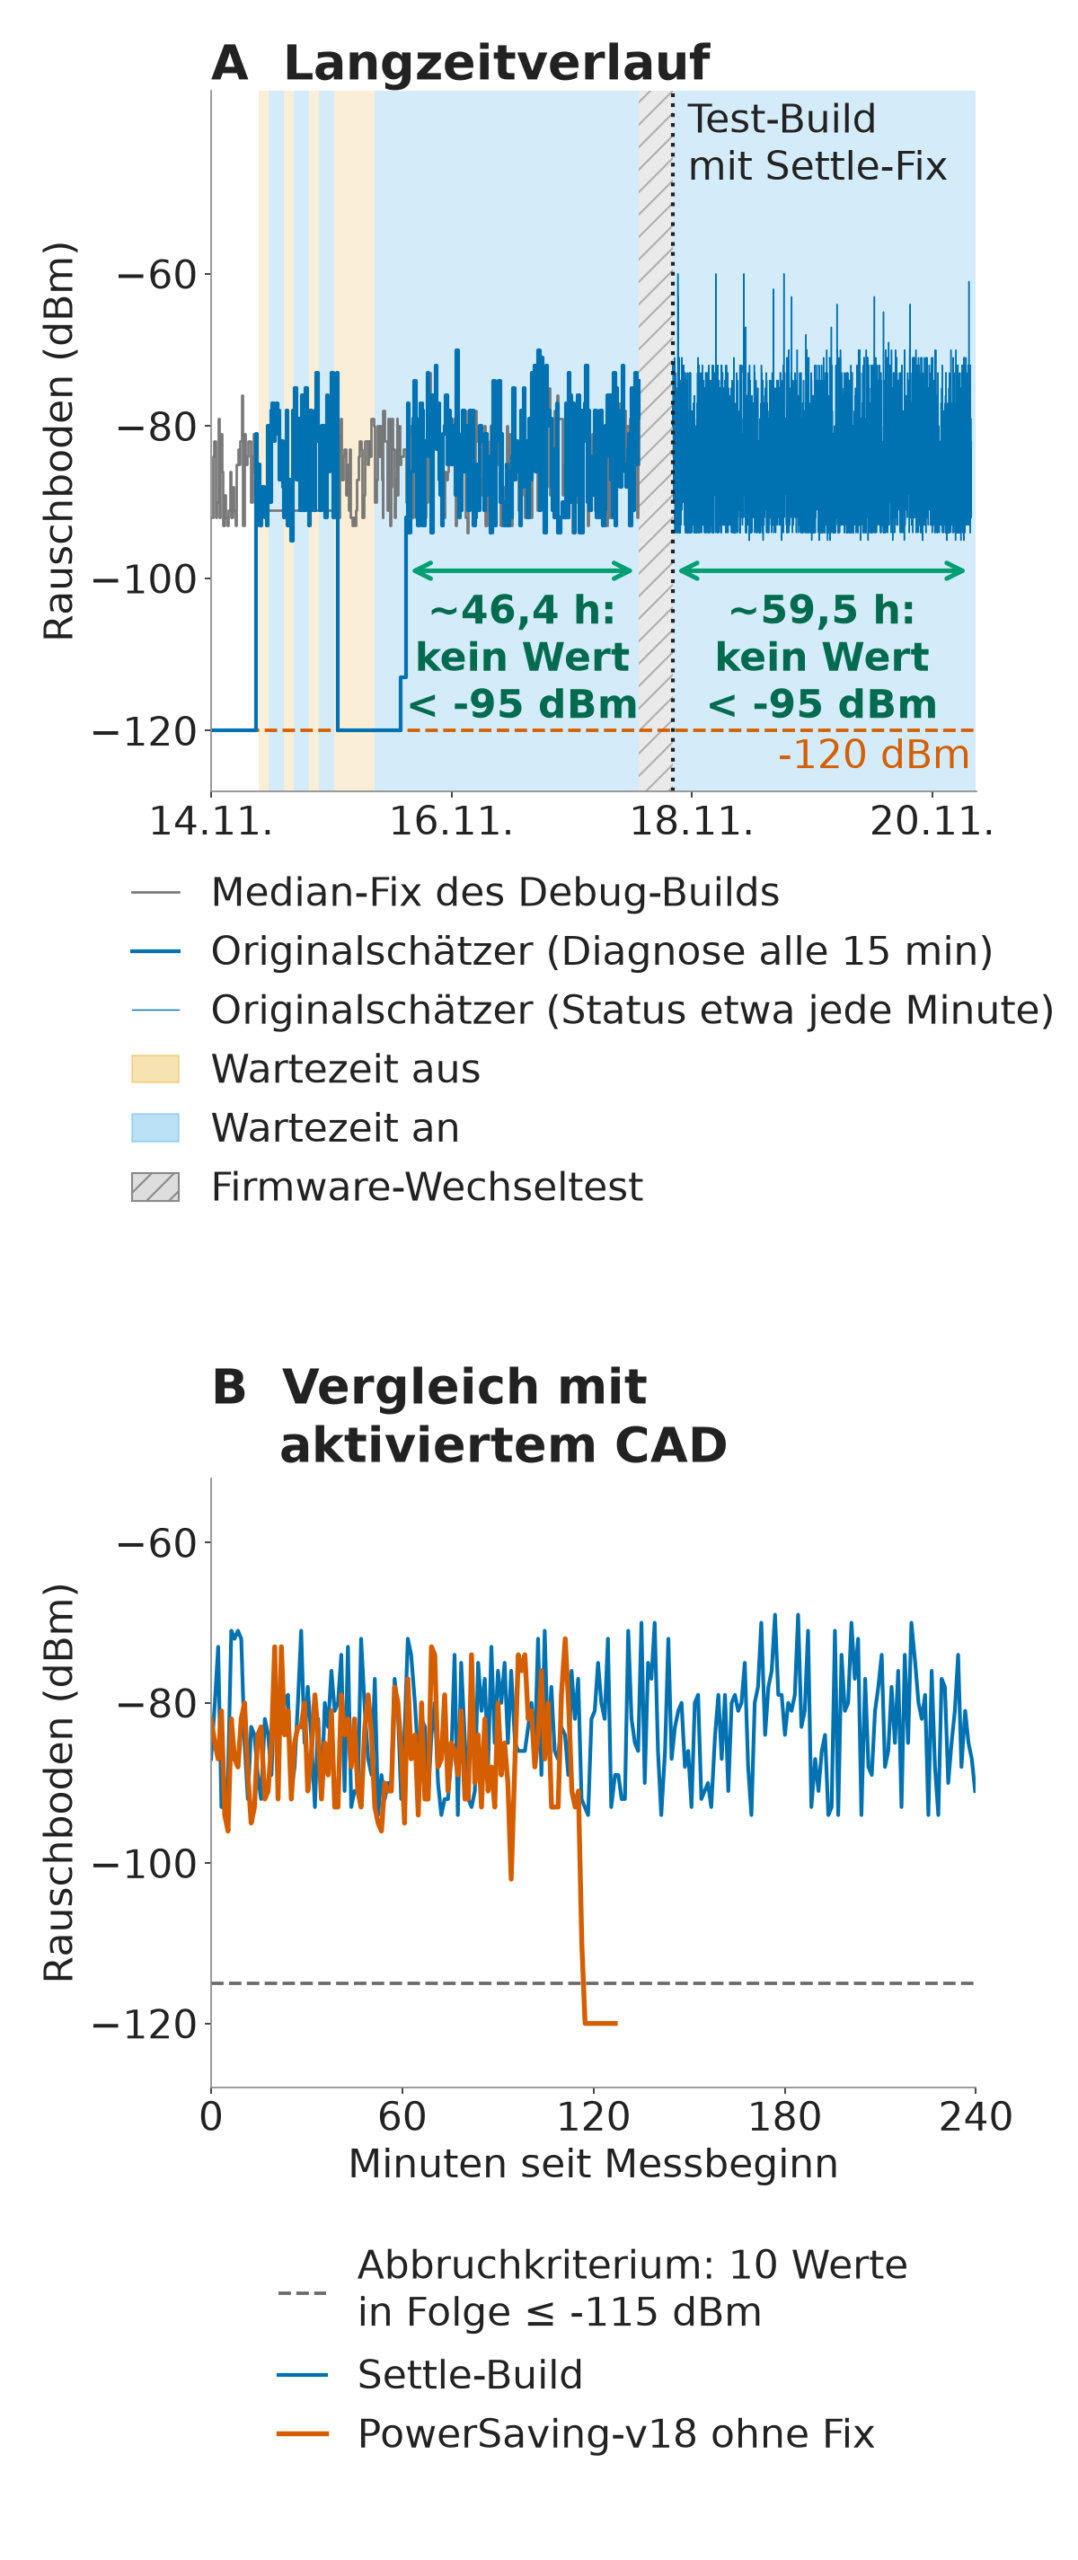
Weil CAD die Neustarts des Empfängers vervielfacht, wollte ich das auch mit aktiviertem CAD sehen. Der Fork baut auf PowerSaving-v18 von IoTThinks auf, und der Maintainer dort hat um einen Test der unveränderten Version gebeten. Der Vergleich lief nacheinander auf demselben Board am selben Standort, jeweils mit aktiviertem CAD und deaktiviertem RXPS. Der Test-Build mit Settle-Fix basierte auf mups18-3 und enthielt damit auch die Direct-Wiederholungen und den Kanalfilter des Forks. Der Einbruch trat im PowerSaving-v18-Lauf auf. Dort kam der erste von zehn aufeinanderfolgenden Werten bei −120 dBm etwa 117 Minuten nach Messbeginn, die Messung endete nach etwa 127 Minuten. Ein früherer 30-Minuten-Lauf mit PowerSaving-v18 endete mit dem Versionswechsel. Im vierstündigen Lauf mit dem Test-Build blieb der Einbruch aus, alle 230 Werte lagen zwischen −94 und −69 dBm. Welche Unterschiede zwischen den Builds zu diesem Ergebnis beitrugen, lässt sich aus den beiden Läufen nicht bestimmen.
Nach diesem Vergleich habe ich den Test-Build wieder mit ausgeschaltetem CAD und RXPS eingerichtet und nach einem Neustart geprüft. So läuft 1863 jetzt.
Zur Einordnung: Das ist ein Board an einem Standort, mit einem Lauf pro Build. Vom fertigen Test-Build habe ich rund zweieinhalb Tage Daten, dazu die etwa 46 Stunden auf dem Debug-Build, beides mit ausgeschaltetem CAD. Ohne CAD und ohne Wartezeit kam der Einbruch bei mir einmal nach wenigen Minuten und einmal erst nach etwa 11,5 Stunden. Die Daten sprechen deutlich für die Wartezeit, ein Beweis sind sie nicht.
Direktnachrichten: wo gehen sie verloren?
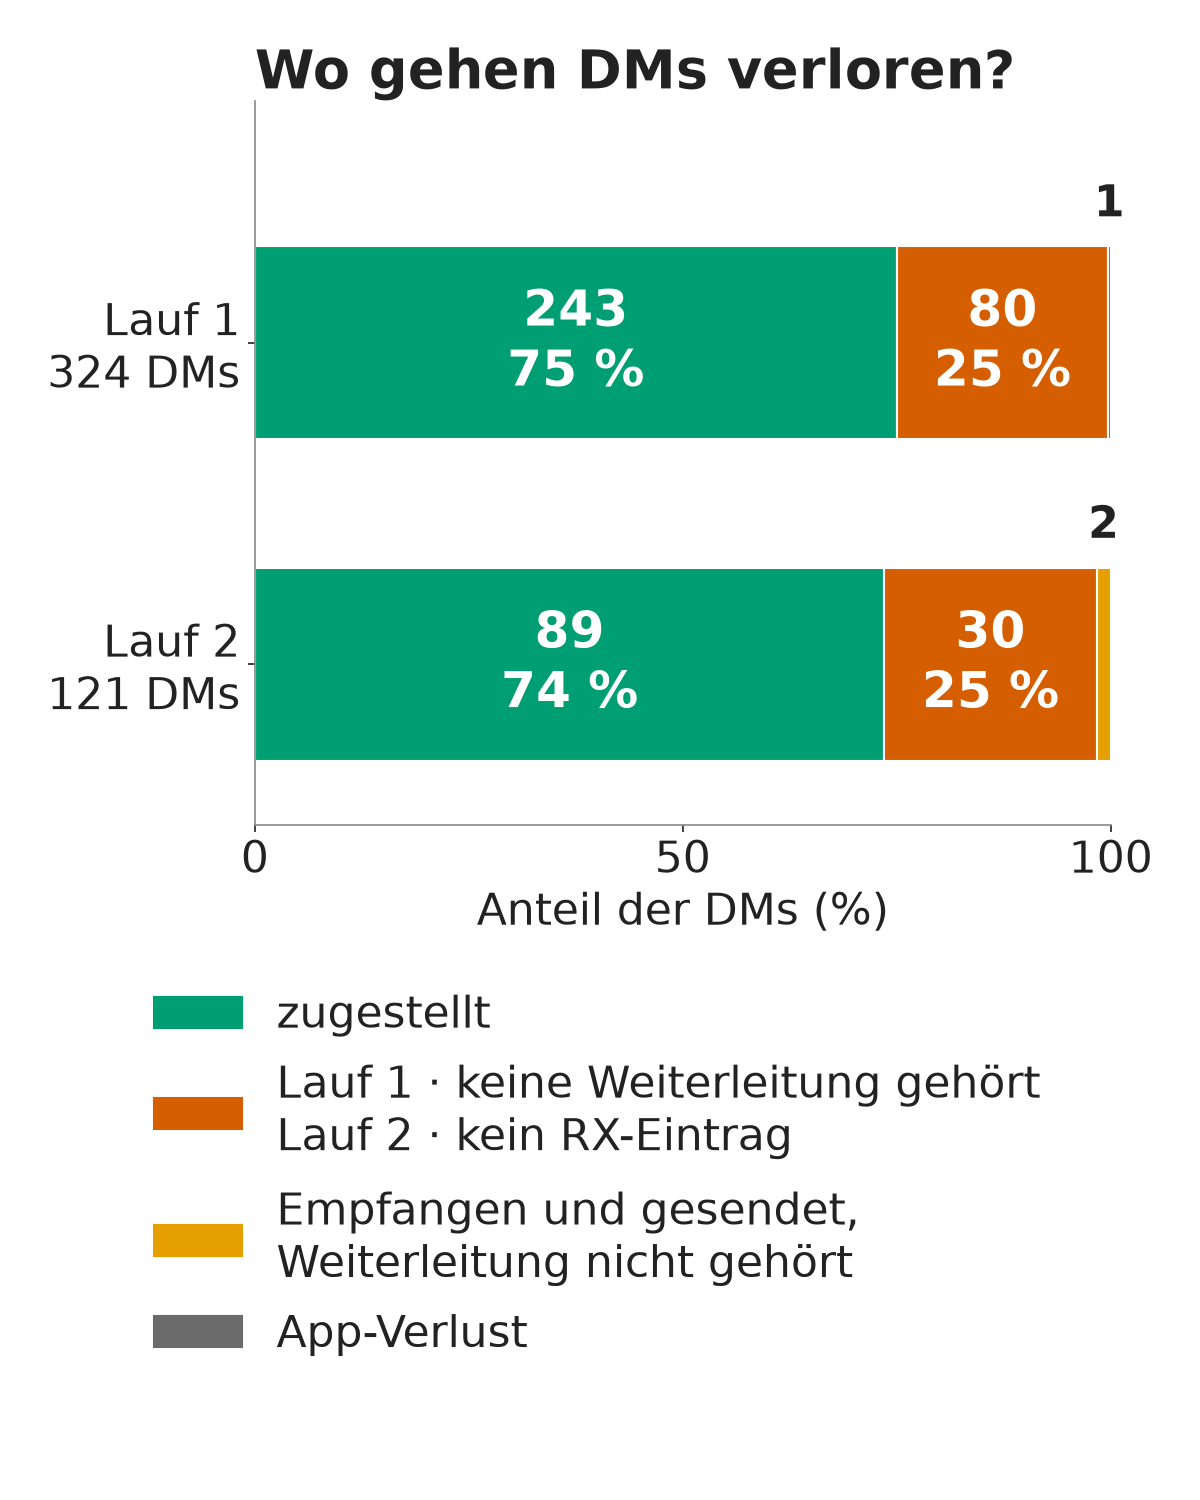
Bei den CAD-Versuchen aus Teil 2 ist mir noch etwas anderes aufgefallen. Direktnachrichten (DMs) zwischen zwei eigenen Companions über nur einen starken Hop, nämlich 1863, kamen nur zu etwa drei Vierteln an. Also habe ich zwei Läufe gemacht, in denen beide Companions alles mitloggen, was sie empfangen. Im zweiten Lauf hat zusätzlich der Repeater jedes dekodierte Paket protokolliert.
In den beiden Läufen kamen 75,0 % und 73,6 % der Direktnachrichten an. Im zweiten Lauf fehlte bei 30 von 32 Verlusten ein dekodierter Empfangseintrag am Repeater. Damit liegt die letzte beobachtbare Lücke bei diesen Nachrichten vor der erfolgreichen Dekodierung. Die Funkursache blieb offen. Das Paketlog erfasst nur dekodierte Pakete, ein fehlender Eintrag sagt also nicht, ob das Paket gar nicht ankam, zu schwach war oder mit etwas anderem kollidiert ist. Eine mögliche zeitliche Überlappung mit anderen dekodierten Paketen fand sich bei 9 von 29 verlorenen und 39 von 84 zugestellten Nachrichten mit auswertbarem Zeitbezug. Bei den verlorenen Nachrichten kam so eine Überlappung also nicht häufiger vor als bei den zugestellten.
Eine naheliegende Frage war, ob die Debug-Builds selbst die Zustellung verschlechtern. Die absoluten Zahlen der Versuche stammen ja alle von Debug-Builds, auch wenn die drei Symptome vom Anfang schon auf normaler Firmware auftraten. Deshalb habe ich das in zwei Stufen verglichen.
In der ersten Stufe lief durchgehend dbg6, und ich habe nur den zusätzlichen Messpunkt für den Rauschboden an- und ausgeschaltet, der alle 50 ms den RSSI-Wert über SPI liest. Dabei war zu beachten, dass mit dem Messpunkt auch der Median eingefroren wurde, den die Resend-Schranke im Debug-Build nutzte. In der zweiten Stufe habe ich das Release mups18-3 gegen dbg6 mit allen vier experimentellen Schaltern verglichen. Weder der erste noch der zweite Vergleich zeigte über vier Paare einen Unterschied bei Zustellung oder Laufzeit. Beide Vergleiche haben aber mehr verändert als nur die Messung selbst, als reine Messung des Debug-Aufwands taugen sie also nicht. Über beide Läufe hörten die Companions bei 119 von 120 Verlusten in der ersten Stufe und bei 202 von 209 in der zweiten keine Weiterleitung. Die Zahlen stehen im Anhang.
Was ich zurückgegeben habe
Der Fork bittet darum, pro Änderung einen eigenen PR zu stellen und bei größeren Änderungen vorher ein Issue aufzumachen. Daran habe ich mich gehalten.
Die beiden TRACE-Korrekturen gingen als #25 und #26 an den Fork. Der Maintainer hat beide geprüft, mit meiner Autorschaft übernommen und die PRs deshalb geschlossen. Der Fork hat beide TRACE-Änderungen in mups18-3 übernommen und mich in den Release-Notes als Autor genannt. Die Wiederholungslogik des Forks geht auf den Upstream-PR #2670 zurück; dessen Autor hat beide Korrekturen nach dem Vorbild von #25/#26 übernommen und den Median-Schätzer in den separaten PR #2933 ausgelagert. Der Fork-Maintainer hat seine Portierung daran angepasst.
Den Rauschboden habe ich auf Wunsch des Fork-Maintainers als Issue #27 gemeldet. Mein Vorschlag: die Wartezeit nach jedem erfolgreichen Start des Dauerempfangs anwenden und nicht nur im Kalibrierfenster. Der Maintainer hat die Analyse im Code bestätigt und dieselbe Prüfung auch in der Basis PowerSaving-v18 von IoTThinks gefunden. Deshalb ging es dort in Issue #133 weiter.
usrflo, der Autor des Upstream-PRs #2933 mit dem Median-Schätzer, hat im Issue erklärt, dass sein Median-Schätzer keinen Dauerempfang braucht. Die 50 ms sind nur der Mindestabstand zwischen zwei Messungen, die Blöcke füllen sich auch über mehrere Wachphasen hinweg. Der Fork-Maintainer hat die Wahl zwischen den beiden Ansätzen dann der IoTThinks-Basis überlassen.
Den Patch mit der Wartezeit habe ich zuerst nicht als PR eingereicht, sondern als Test-Branch mit einer Vorabversion veröffentlicht. Dort gibt es einen Build für den Heltec V4 als Repeater, und der Patch lässt sich auch sauber auf PowerSaving-v18 anwenden. In #133 hat der Maintainer um einen Test der unveränderten PowerSaving-v18 gebeten und dafür die Version 18.1120 veröffentlicht. Getestet habe ich sie als Commit 8315e60a. Das Ergebnis über mehrere Tage und den Vergleich mit aktiviertem CAD habe ich dort gepostet und ergänzt, zusammen mit dem Angebot, einen PR gegen PowerSaving-v18 zu stellen. Der Maintainer hat das angenommen und um einen PR gegen Dev-PS18 gebeten, der ist jetzt als PR #36 offen. Auf seine Frage, ob auch die normale MeshCore-Firmware betroffen ist, habe ich geantwortet: Laut Quellcode gibt es in main und dev von meshcore-dev nach dem RX-Start gar keine Wartezeit, bei derselben Annahmeschwelle, und mein Repeater stand schon mit der Standard-Firmware bei −120 dBm. Die 20-ms-Wartezeit bringt dort erst der schon erwähnte PR #2933. Mit eingeschaltetem RX-Stromsparen misst PowerSaving nach dem Code nur im Kalibrierfenster, in dem die Wartezeit schon greift, das dürfte erklären, warum es dort nicht aufgefallen ist.
In #2933 hat übrigens ein anderes Projekt auf einem SX1268 nach einem AGC-Reset einen etwa 8 ms langen Anstieg der RSSI-Werte gemeldet und will seinen eigenen Workaround fallen lassen, sobald #2933 mit seiner 20-ms-Wartezeit übernommen ist. Das ist eine einzelne Beobachtung auf einem anderen Chip, die schon vor meiner gemeldet wurde und unabhängig davon gut zu dem passt, was ich gesehen habe.
KI-Werkzeuge haben mir beim Lesen des Quellcodes, beim Erstellen der Debug-Builds und bei der Auswertung geholfen; Aussagen zum Verhalten habe ich im Quellcode geprüft und die beschriebenen Änderungen am Repeater getestet.
Was du damit anfangen kannst
Wenn du einen MeshCore-Repeater betreibst, schau dir den geschätzten Rauschboden in den Statistiken an. Steht er über Stunden bei −120 dBm, ist das wahrscheinlich kein besonders ruhiger Standort, gerade bei einem Board mit LNA. Dann rechnet zumindest im Fork die Resend-Schranke mit einem falschen Wert. Ein Neustart setzt die Schätzung zurück, das Problem kommt aber wieder.
Wer RXPS nutzt oder einen solarbetriebenen Repeater betreibt, kann seine Erfahrungen mit dem Test-Build im verlinkten Issue teilen. Genau diese Fälle konnte ich mit meinem Repeater am Netzteil nicht testen.
Und wenn du selbst an einer Firmware drehst: Zähler einbauen, Korrekturen schaltbar machen, Blöcke auslosen. Das kostet am Anfang Zeit, erspart aber viele Diskussionen darüber, ob etwas „gefühlt besser“ ist.
Anhang: Methode und Zahlen
Builds. Alle Debug-Builds basieren auf mups18-2. dbg1 und dbg3 zählten nur CAD-Prüfungen und Sendefreigaben. dbg4 brachte drei schaltbare Korrekturen: F1 bricht wartende TRACE-Wiederholungen ab (entspricht #25), F2 schickt das TRACE am letzten Hop einmal über die normale Sendefreigabe (entspricht #26), F3 ersetzt für die Resend-Schranke den Originalschätzer durch einen Median-Schätzer. Ab dbg4 lief außerdem ein Messpunkt mit, der alle rund 50 ms den RSSI-Wert liest, auch bei ausgeschalteten Korrekturen. dbg5 kam mit Messpunkten zum Rauschboden dazu (Alter jedes RSSI-Werts seit dem RX-Start, RSSI-Klassen, Übernahme und Verwerfen von Schätzwerten) und dem Schalter für die 20 ms Wartezeit. dbg6 ergänzte die CAD-Testscans aus Teil 2. Vor jedem Flash: Backup, Konfigurationsvergleich, Rückweg bereit. Heute läuft auf 1863 der veröffentlichte Test-Build v1.18.0.mups3-nfsettle, also mups18-3 mit dem Wartezeit-Patch, ohne Debug-Code und ohne RAM-Schalter, mit ausgeschaltetem CAD und RXPS.
TRACE-Versuche. Je vier ausgeloste Paare aus 30-Minuten-Blöcken. C1 prüfte #26 mit 697 TRACE-Versuchen, C2 prüfte #25 mit 704. Die gepaarten Permutationstests ergaben für Zustellung und Laufzeit p-Werte zwischen 0,25 und 1,00. Bei C2 lag die Zustellung über drei Hops mit Korrektur 5,9 Prozentpunkte niedriger (p = 0,25). Mechanisch erwartet ist das nicht, weil der Abbruch erst nach einer gehörten Weiterleitung greift, ich habe es aber notiert.
Median-Schätzer (C3). DMs zwischen zwei Companions über 1863, je vier ausgeloste Paare. In den ausgelosten Blöcken kamen mit Median-Schätzer 169 von 238 (71,0 %) und ohne 168 von 240 (70,0 %) an. Die Blockmittel lagen bei 71,0 % und 70,0 % (gepaartes p = 1,00), die Laufzeit bei 3,24 s und 3,16 s (gepaartes p = 0,75). F3 ändert nur den Rauschboden für die Resend-Schranke.
Wartezeit-Phasen (dbg5). Feste Reihenfolge A1, B1, A2, B2, A3, B3, A ohne und B mit Wartezeit.
| Phase | Wartezeit | ausgewertet | übernommen ≤ −125 dBm | davon < 5 ms nach RX-Start | Schätzbereich |
|---|---|---|---|---|---|
| A1 | aus | 95 min | 7.610 | 7.610 | −93 bis −80 dBm |
| B1 | an | 157 min | 0 | 0 | −90 bis −77 dBm |
| A2 | aus | 95 min | 7.446 | 7.446 | −95 bis −78 dBm |
| B2 | an | 157 min | 0 | 0 | −91 bis −75 dBm |
| A3 | aus | 95 min | 7.937 | 7.937 | −91 bis −73 dBm |
| B3 | an | 158 min | 0 | 0 | −92 bis −73 dBm |
Die 95 Minuten sind die ausgewerteten Diagnosefenster. Über die vollen 120 Minuten der A-Phasen waren es 9.554, 9.365 und 10.119 Werte, mit demselben Muster.
DM-Vergleich, Stufe 1. Durchgehend dbg6, vier ausgeloste Paare aus 30-Minuten-Blöcken, Messpunkt an gegen aus. Von 492 DMs gingen 482 in die gepaarte Auswertung ein (239 mit, 243 ohne Messpunkt). Zustellung im Blockmittel 78,6 % gegen 73,2 % (gepaartes p = 0,25), Laufzeit 2,11 s gegen 2,24 s (gepaartes p = 0,25). Drei Paare lagen bei der Zustellung zugunsten des eingeschalteten Messpunkts, eins war gleich.
DM-Vergleich, Stufe 2. Release mups18-3 gegen dbg6 mit allen vier Schaltern an, vier ausgeloste Paare aus 45-Minuten-Blöcken, die ersten 10 Minuten jedes Blocks nicht gewertet. 553 DMs in der gepaarten Auswertung (278 Release, 275 dbg6). Zustellung im Blockmittel 74,8 % gegen 73,1 % (gepaartes p = 0,875), Laufzeit 2,18 s gegen 2,30 s (gepaartes p = 0,50).
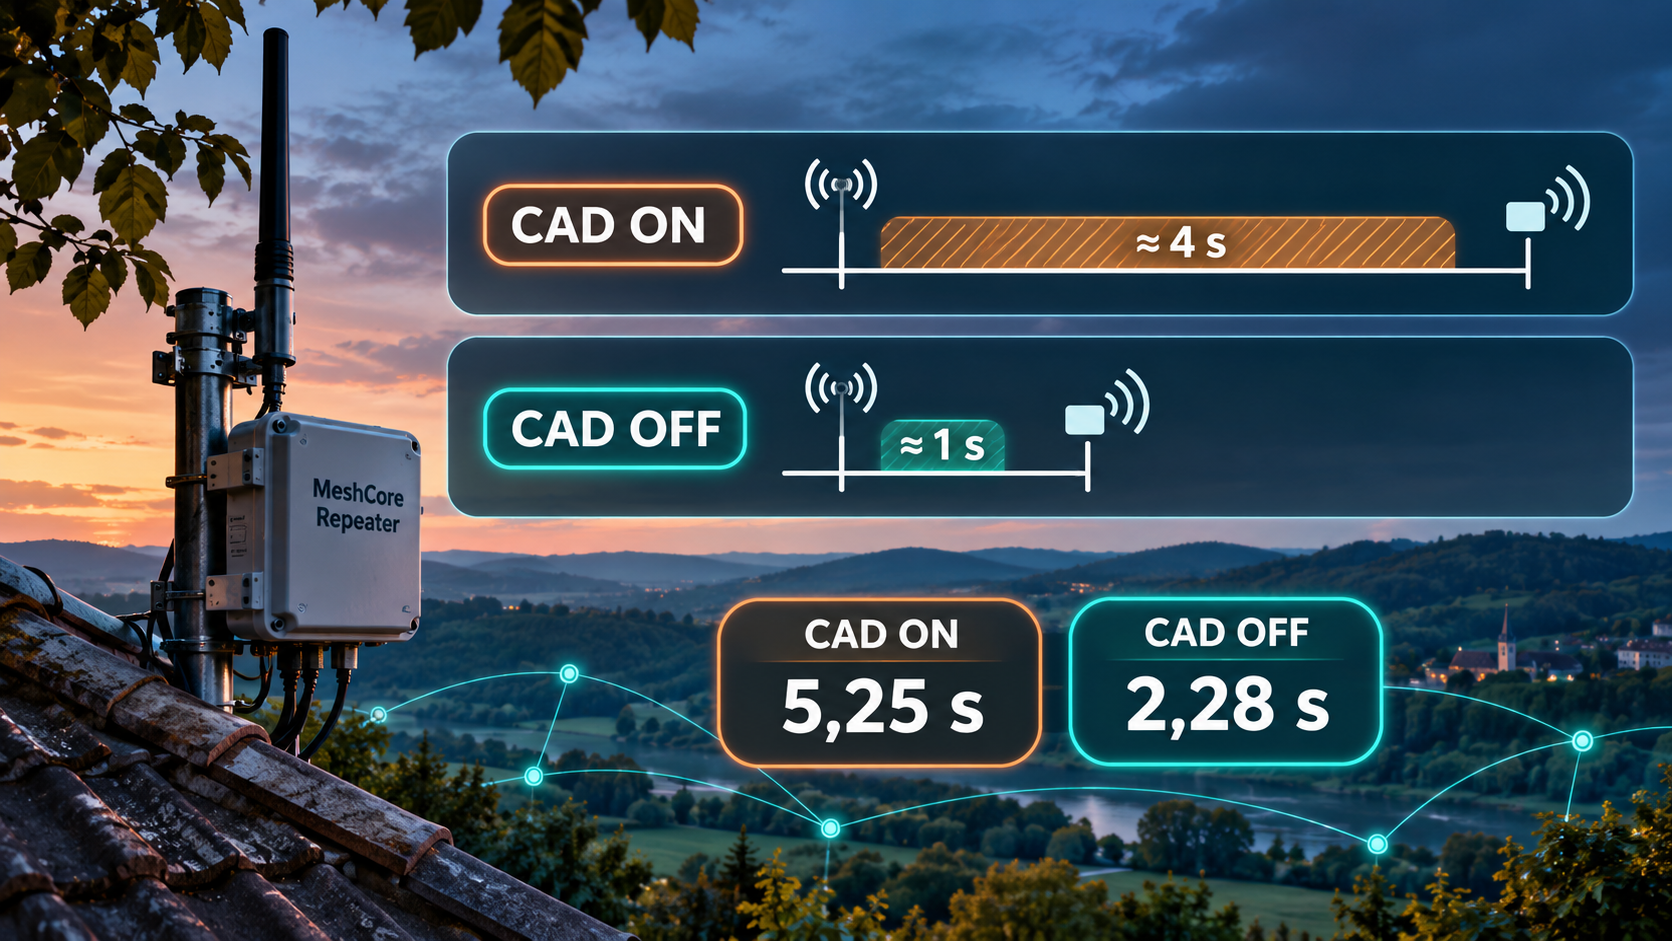
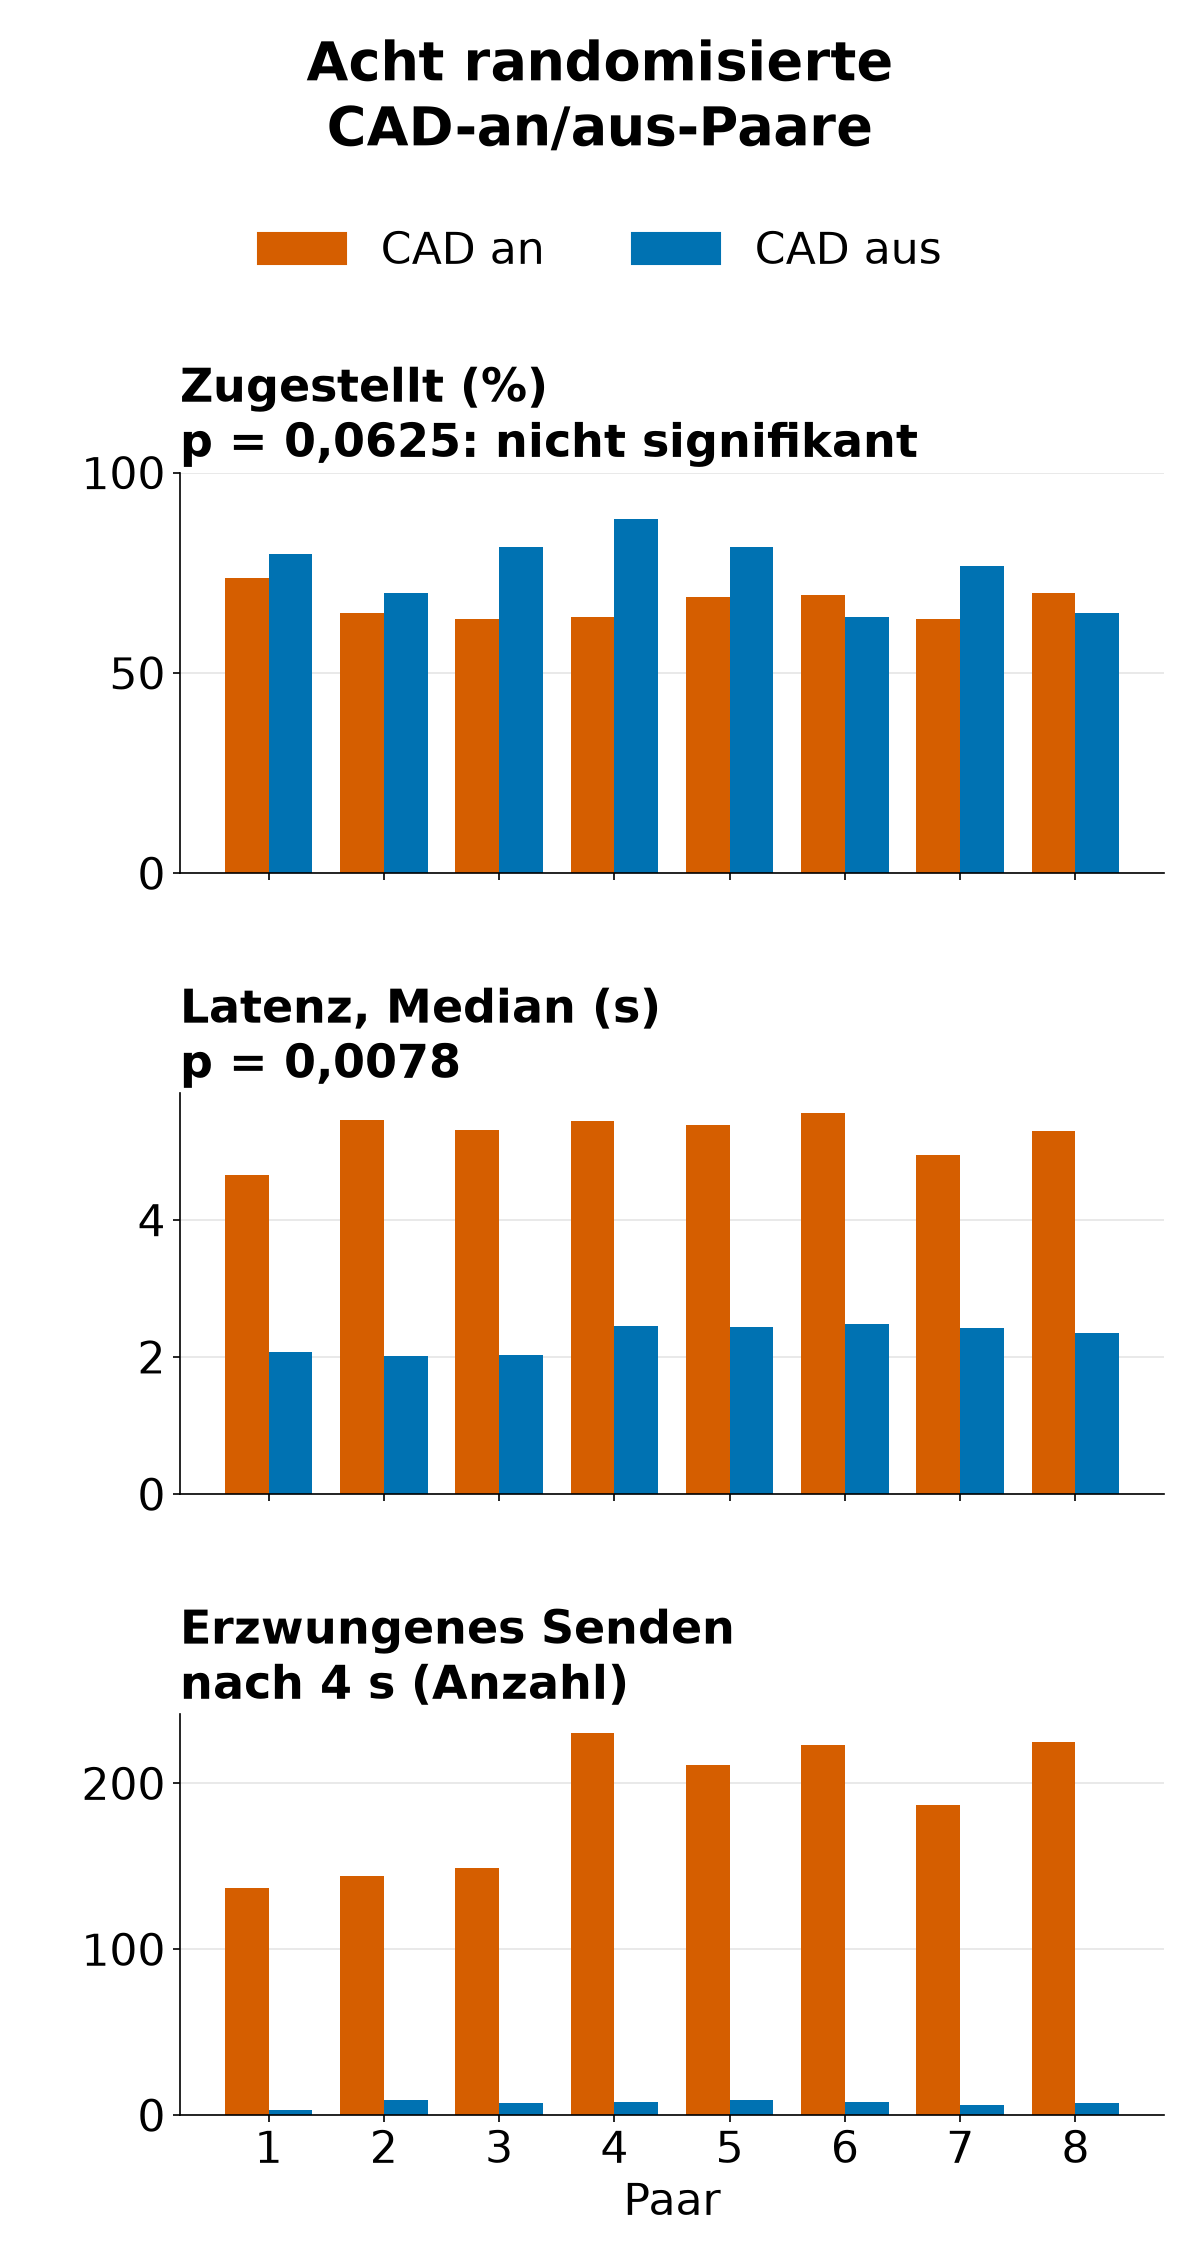
CAD-Vergleich aus Teil 2. Im CAD-Vergleich aus Teil 2 lag die Zustellung im Blockmittel bei 67,2 % mit CAD und 75,8 % ohne CAD (gepaartes p = 0,0625). Das Mittel der Blockmediane für die Empfangslatenz lag bei 5,25 s und 2,28 s (gepaartes p = 0,0078).