IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Schlagwort: nginx

QUIC auf Dual-Stack-Sockets: das DF-Bit, das nginx für IPv4-Clients nie setzt

nginx auf FreeBSD mit QUIC/HTTP/3: IPv6 ohne Router-Fragmentierung und IPv4 mit fehlendem DF-Bit auf einem Dual-Stack-Socket.

Ein Listener für IPv4 und IPv6 zusammen klingt nach der besseren Lösung. Ein Socket statt zwei, eine Konfigurationszeile weniger, ggf. ein Firewall-Regelwerk weniger zu pflegen. Bei QUIC auf diesem Blog lief das genau so, seit hier HTTP/3 aktiviert ist. Am 9. September 2026 ist mir aufgefallen, dass genau dieser eine Socket seit längerem dafür sorgt, dass nginx für die Hälfte der Clients ein Bit im IP-Header nie setzt, das QUIC eigentlich zwingend braucht. Kein Absturz, keine Fehlermeldung, kein Eintrag im Error-Log. Nur ein messbar höherer Anteil langsamer Verbindungen, der sich erst beim genauen Hinsehen als das entpuppt, was er ist.

Dieser Beitrag ist eine klassische Root-Cause-Analyse. Bug gefunden, Ursache im nginx-Quellcode verifiziert, Ursache zusätzlich im FreeBSD-Kernel nachvollzogen, gefixt, mit echten Produktionsdaten so gut wie möglich belegt.

Ein Socket für beides, das ist doch die naheliegende Wahl

Wer nginx mit QUIC betreibt, kennt die Direktive üblicherweise so:

listen [::]:443 quic reuseport ipv6only=off default_server;

Ein einziger IPv6-Socket mit ipv6only=off nimmt sowohl echte IPv6-Verbindungen als auch IPv4-Verbindungen an, dank IPv4-mapped-IPv6-Adressen (::ffff:a.b.c.d) nach RFC 3493. Ein Socket statt zwei, eine Zeile Konfiguration weniger. Genau deshalb ist das die naheliegende Wahl, wenn man von TCP kommt, wo dieser Trick seit Jahrzehnten problemlos funktioniert.

Bei QUIC ist genau dieser eine Socket ein Problem, und zwar eines, das man im laufenden Betrieb nicht sieht. Zumindest nicht sofort und nicht überall. Es müssen schon ein paar Dinge zusammen kommen um das Problem selbst zu fühlen. Fühlen? Eine lllaaaaannnngggggssssaaaaammmmeeeee Verbindung über IPv4.

Warum QUIC bei Fragmentierung empfindlicher ist als TCP über TLS

RFC 9000, Abschnitt 14, formuliert das ziemlich hart:

UDP datagrams MUST NOT be fragmented at the IP layer. In IPv4, the Don’t Fragment (DF) bit MUST be set if possible, to prevent fragmentation on the path.

Das ist keine Empfehlung, das ist ein MUST NOT direkt neben einem MUST. QUIC ermittelt seine eigene passende Paketgröße für einen Netzwerkpfad, entweder über klassisches PMTUD (das auf ICMP-Antworten angewiesen ist und auf der IP-Ebene ansetzt, das DF-Bit ist Teil genau dieses Mechanismus) oder über DPLPMTUD nach RFC 8899, das mit eigenen Sondierungspaketen arbeitet und ganz ohne ICMP auskommt. Wichtig ist hier nicht, welcher der beiden Mechanismen die Größe ermittelt, sondern was beide voraussetzen: ein zu großes Paket muss sauber verworfen werden, mit oder ohne ICMP-Antwort, statt fragmentiert beim Empfänger anzukommen. Wer sich jetzt an ICMPv6 für IPv6 erinnert fühlt, japp 🙂

Genau das geht in vielen Netzen schief, sobald ein Paket doch fragmentiert wird. Fragment-Filterung ist eine verbreitete Firmen- und Provider-Härtung, gerade weil fragmentierte Pakete historisch für allerlei Unfug missbraucht wurden. Solche Netze werfen fragmentierte QUIC-Pakete einfach weg, ohne jede Rückmeldung. QUICs eigene Verlusterkennung kann das von gewöhnlichem Paketverlust nicht unterscheiden, im schlechtesten Fall wird daraus eine Serie von Retransmissions und Timeouts statt eines schnellen, sauberen Fehlers. Bei TCP über TLS würde ein fragmentiertes Paket in den allermeisten Netzen einfach ankommen und zusammengesetzt werden, das ist dort seit jeher normaler Betrieb und niemanden juckt das DF-Bit besonders. Bei QUIC ist Fragmentierung der Fall, den das Protokoll bewusst ausschließen will, und genau der tritt hier auf.

Die Ursache, gefunden im nginx-Quellcode

Der Fund steckt in src/core/ngx_connection.c, in der Funktion ngx_configure_listening_sockets() (nicht zu verwechseln mit ngx_open_listening_sockets(), einer anderen Funktion in derselben Datei, die die Sockets öffnet, aber nicht die MTU-Discovery-Optionen setzt). Diese Funktion läuft beim Start und bei jedem Restart über alle bereits gebundenen Listen-Sockets und setzt dort die passenden Socket-Optionen. Der entscheidende Ausschnitt, wörtlich aus nginx 1.30.4:

#if (NGX_HAVE_IP_MTU_DISCOVER)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET) {
            value = IP_PMTUDISC_DO;

            if (setsockopt(ls[i].fd, IPPROTO_IP, IP_MTU_DISCOVER,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IP_MTU_DISCOVER) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#elif (NGX_HAVE_IP_DONTFRAG)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET) {
            value = 1;

            if (setsockopt(ls[i].fd, IPPROTO_IP, IP_DONTFRAG,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IP_DONTFRAG) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#endif

#if (NGX_HAVE_INET6)

#if (NGX_HAVE_IPV6_MTU_DISCOVER)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET6) {
            value = IPV6_PMTUDISC_DO;

            if (setsockopt(ls[i].fd, IPPROTO_IPV6, IPV6_MTU_DISCOVER,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IPV6_MTU_DISCOVER) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#elif (NGX_HAVE_IP_DONTFRAG)

        if (ls[i].quic && ls[i].sockaddr->sa_family == AF_INET6) {
            value = 1;

            if (setsockopt(ls[i].fd, IPPROTO_IPV6, IPV6_DONTFRAG,
                           (const void *) &value, sizeof(int))
                == -1)
            {
                ngx_log_error(NGX_LOG_ALERT, cycle->log, ngx_socket_errno,
                              "setsockopt(IPV6_DONTFRAG) "
                              "for %V failed, ignored",
                              &ls[i].addr_text);
            }
        }

#endif
#endif

Beide Zweige prüfen ls[i].sockaddr->sa_family, also die Adressfamilie des Listen-Sockets selbst, fest zum Zeitpunkt des Socket-Setups. Nicht die Familie des Ziels, an das ein bestimmtes Paket später geht. Für listen [::]:443 quic ... ipv6only=off; ist sa_family immer AF_INET6, egal ob ein konkretes Paket an einen echten IPv6-Host oder an eine IPv4-mapped-Adresse geht. Der AF_INET-Zweig, der IP_DONTFRAG fürs echte IPv4-Datagramm setzen würde, wird für diesen Socket schlicht nie erreicht.

Ein kleines Detail für alle, die selbst nachlesen: der IPv6-Fallback-Zweig (das #elif (NGX_HAVE_IP_DONTFRAG) im letzten Block) ist mit demselben Feature-Makro abgesichert wie der IPv4-Zweig, nicht mit dem separat getesteten NGX_HAVE_IPV6_DONTFRAG. Auf FreeBSD ändert das am Ergebnis nichts, hier sind beide Makros gesetzt, aber es ist eine kleine Ungenauigkeit im nginx-Quellcode selbst. So zumindest meine Interpretation, korrigiert mich gerne!

Der eigentliche Denkfehler dahinter: IPv6 hat gar kein DF-Bit

Wer IPV6_DONTFRAG im Code sieht, könnte annehmen, dass damit dasselbe Problem für IPv6 gelöst wird wie IP_DONTFRAG für IPv4. Ist es nicht, und der Unterschied ist der eigentliche Kern dieses Bugs.

Der IPv6-Header hat schlicht kein DF-Bit, weil er keines braucht. RFC 8200 verbietet Routern im Pfad die Fragmentierung von IPv6-Paketen grundsätzlich, das steht wörtlich in Abschnitt 4.5 (der auf Abschnitt 5 verweist): „unlike IPv4, fragmentation in IPv6 is performed only by source nodes, not by routers along a packet’s delivery path“. IPV6_DONTFRAG ist die tatsächliche RFC-3542-Option, Abschnitt 11.2 der Spezifikation, aber sie steuert nur, ob der sendende Host selbst über einen Fragment-Extension-Header fragmentieren darf. Ein Problem, das aus Sicht von IPv6 gar nicht existiert, sobald man es nicht selbst provoziert.

IP_DONTFRAG auf der IPv4-Seite ist dagegen keine RFC-3542-Option, sondern eine BSD-Socket-Erweiterung außerhalb dieses Standards. Zwei Optionen, die im Code wie ein symmetrisches Paar aussehen, lösen in Wirklichkeit zwei völlig verschiedene Probleme.

Und jetzt der Punkt, an dem beide Welten aufeinandertreffen. Ein send() auf diesem IPv6-Socket an eine IPv4-mapped-Zieladresse bringt am Ende ein echtes IPv4-Datagramm auf die Leitung, das ist Standardverhalten von Dual-Stack-Sockets nach RFC 3493. Dieses Datagramm braucht ein gesetztes DF-Bit im IPv4-Header, ein komplett anderes Feld als alles, was IPV6_DONTFRAG je anfasst. Der oben gezeigte Code-Pfad kommt an dieses Feld nie heran, weil er für einen AF_INET6-Socket ausschließlich die IPv6-Variante der Option setzt. Kann man das also auch irgendwie ein legacy IPv4 Problem nennen?

Warum ein einfacher Zusatz-Aufruf auf FreeBSD gar nicht helfen würde

Die naheliegende Reaktion: warum ruft nginx auf diesem Socket nicht einfach zusätzlich setsockopt(IPPROTO_IP, IP_DONTFRAG) auf? Ich bin dem im FreeBSD-Kernel-Quellcode nachgegangen, und die Antwort ist, dass das auf FreeBSD gar nicht funktionieren würde.

Der Options-Handler für einen AF_INET6-Socket ist ip6_ctloutput() in sys/netinet6/ip6_output.c, und der lehnt Optionen außerhalb von IPPROTO_IPV6 rundweg ab:

level = sopt->sopt_level;
...
if (level != IPPROTO_IPV6) {
    error = EINVAL;
    ...
}

Ein setsockopt(fd, IPPROTO_IP, IP_DONTFRAG, ...) auf einem AF_INET6-Socket landet also mit EINVAL im Nichts. Das allein wäre schon Antwort genug, aber der zweite Teil ist genauso wichtig: wo genau setzt der Kernel das DF-Bit für einen IPv4-mapped-Send, der über einen IPv6-Socket rausgeht? In udp_usrreq.c, in der Funktion, die das eigentliche IPv4-UDP-Paket zusammenbaut:

if (inp->inp_flags & INP_DONTFRAG)
    ((struct ip *)ui)->ip_off |= htons(IP_DF);

Das DF-Bit wird nur gesetzt, wenn am PCB (dem Protocol Control Block der Verbindung) das Flag INP_DONTFRAG hängt. Und dieses Flag setzt ausschließlich ip_ctloutput() in ip_output.c, wenn IP_DONTFRAG auf IPPROTO_IP-Ebene erfolgreich gesetzt wurde, also genau der Aufruf, der auf einem AF_INET6-Socket mit EINVAL scheitert. Der IPv4-mapped-Sendepfad selbst führt übrigens tatsächlich über genau diese Funktion: udp6_send() in udp6_usrreq.c erkennt eine v4-mapped-Zieladresse auf einem Dual-Stack-Socket, gibt die eigenen Locks frei und ruft direkt udp_send(), also dieselbe IPv4-UDP-Ausgabefunktion, die auch ein echter AF_INET-Socket benutzt.

Damit schließt sich der Kreis / Beisst die Katze sich in den Schwanz, ihr wisst schon. INP_DONTFRAG kann nur über einen erfolgreichen IP_DONTFRAG-Aufruf auf einem echten AF_INET-Socket gesetzt werden, und ein AF_INET6-Socket kann diesen Aufruf laut ip6_ctloutput() gar nicht erst absetzen. Der Socket-Split ist auf FreeBSD damit nicht nur der pragmatische, sondern der einzig mögliche Fix. Ein hypothetischer nginx-Patch, der einfach den fehlenden setsockopt-Aufruf ergänzt, würde am Kernel selbst scheitern, bevor er überhaupt etwas bewirkt.

Was sich zwischen FreeBSD und Linux unterscheidet, und was nicht

Der Bug, wenn ich das so nennen darf, selbst sitzt im nginx-Quellcode und ist plattformunabhängig. Dieselbe sa_family-Abfrage wird auf Linux und FreeBSD gleich kompiliert und ist auf beiden gleichermaßen falsch.

Was sich unterscheidet, ist welche Socket-Option-API überhaupt zur Verfügung steht. IP_MTU_DISCOVER mit dem Wert IP_PMTUDISC_DO ist eine Linux-Erweiterung (auch musl bringt das Makro mit, nicht nur glibc), auf FreeBSD schlicht nicht deklariert. FreeBSD bietet stattdessen IP_DONTFRAG und IPV6_DONTFRAG. nginx testet im configure-Lauf beide Varianten (auto/unix, Feature-Tests für NGX_HAVE_IP_MTU_DISCOVER, NGX_HAVE_IP_DONTFRAG, NGX_HAVE_IPV6_DONTFRAG) und wählt zur Kompilierzeit die passende Variante. Auf dieser FreeBSD-Installation landet man im IP_DONTFRAG/IPV6_DONTFRAG-Zweig, und genau der ist von dem oben beschriebenen Bug betroffen.

Was ich nicht verifiziert habe, weil mir dafür ein Linux-Vergleichssystem fehlt (ich zu faul war eines aus dem Glas zu ziehen): ob sich das praktische Fehlerbild zwischen den beiden Kerneln tatsächlich unterscheidet, also wie stark Retransmissions ausfallen oder wie der jeweilige Kernel beim v4-mapped-Sendepfad mit dem DF-Äquivalent umgeht. Linux‘ PMTUD-Verhalten für genau diesen Fall könnte sich abweichend verhalten. Ehrliches Fazit an dieser Stelle: der nginx-Bug ist universell im Quellcode, das konkret beobachtete Fehlerbild ist hier ausschließlich für FreeBSD dokumentiert. Eine Aussage wie „genauso kaputt auf Linux“ würde ich ohne echten Beleg, also Paketmitschnitt oder Kernel-Quellcode-Analyse auf einem Linux-System, nicht treffen. Vielleicht mache ich mir die Mühe noch…. Vielleicht 😀

Der Fix: zwei Listener statt einem

Die Lösung ist, den einen Dual-Stack-Listener in zwei eigenständige Listener zu splitten, damit IPv4-Clients einen echten AF_INET-Socket bekommen, für den der obere Codepfad tatsächlich greift:

listen [::]:443 quic reuseport ipv6only=on default_server;
listen 443 quic reuseport default_server;

Ein Stolperstein dabei, den man sich leicht selbst stellt: ein einfaches zusätzliches listen 443 quic; neben einem unveränderten Dual-Stack-Socket kollidiert mit „Address already in use“, weil der alte Socket die IPv4-Wildcard-Adresse über ipv6only=off ja schon abdeckt. ipv6only muss auf dem IPv6-Listener also explizit auf on gesetzt werden, sonst gibt es keinen sauberen Split, sondern nur einen Fehlstart. Je nachdem, wie „ordentlich“ seine Konfiguration ist, kann es einen Moment dauern, alle diese Stellen zu finden, denn das muss für die komplette nginx Konfiguration angepasst sein!

Erster Stolperstein: ein reload reicht nicht

Eine reine ipv6only-Änderung an einem bestehenden QUIC-Socket erkennt nginx‘ Socket-Reuse-Logik bei einem reload nicht als neuen Socket. Bei mir blieb der alte Dual-Stack-Socket nach einem reinen reload laut sockstat weiter als udp46 aktiv, trotz fehlerfrei geprüfter Konfiguration (nginx -t) und trotz eines nginx -T-Dumps, der die neue Konfiguration bereits korrekt anzeigte. Ist bei solchen Dingen hin und wieder so, machen andere Dienste ja auch. Große Dinge wie Socket, wird oft nur bei einem echten Neustart vom Deinst gesetzt.

nginx -t prüft Syntax und versucht, referenzierte Dateien zu öffnen. Es sagt nichts darüber aus, ob ein bereits offener, laufender Listen-Socket bei einem Reload tatsächlich neu gebunden wird. Erst ein vollständiger service nginx restart hat die getrennten Sockets tatsächlich neu gebunden:

sockstat -4 -l | grep 443   # nur udp4
sockstat -6 -l | grep 443   # nur udp6

Nach dem Restart tauchte in der PROTO-Spalte ausschließlich udp4 und udp6 auf, kein einziges udp46 mehr auf Port 443. Das ist der eigentliche Beleg für den Reload-Stolperstein, keine Datei-Deskriptor-Analyse, nur der Blick auf einen laufenden Prozess. Das reiht sich in ein Muster ein, das mir auf dieser Infrastruktur schon öfter untergekommen ist: ein neues geladenes Modul, ein neuer server_name in einer bestehenden reuseport-Gruppe, jetzt ein ipv6only-Wechsel. Immer wieder dasselbe Grundmuster, ein Reload reicht bei bestimmten Änderungen an Listen-Sockets schlicht nicht. Aber ich wiederhole mich, hm?

Zweiter Stolperstein: jeder vHost braucht den Split

Der erste Durchlauf hat nur den Default-Server-Socket gesplittet. Alle anderen vHosts mit eigenem listen [::]:443 quic;, aber ohne eigenes listen 443 quic;, hingen danach nur noch am neuen IPv6-only-Socket. IPv4-QUIC-Verbindungen zu diesen Domains landeten beim Default-vHost, weil die SNI-Zuordnung auf dem neuen IPv4-Socket schlicht ins Leere lief. Sichtbar wurde das am falschen ausgelieferten TLS-Zertifikat und an einer Default-Antwort statt der eigentlich erwarteten.

Die Lehre daraus: bei einem reuseport-Split müssen alle Server-Blöcke der Adressgruppe angepasst werden, nicht nur der Default-Server. Der IPv4-Listener eines jeden weiteren vHosts docken danach ohne reuseport und ohne default_server einfach an die schon bestehende Gruppe an:

listen [::]:443 quic;
listen 443 quic;

Was im Error-Log nicht zu finden ist

Das nginx-Error-Log auf Level info, die komplette 15-Tage-Rotation samt .bz2-Archiven, enthält keine einzige [warn], [error] oder [crit]-Zeile mit QUIC-Bezug, weder vor noch nach dem Fix. Eine gezielte Suche nach den vier exakten Alert-Meldungen, die der oben zitierte Code beim Fehlschlagen eines setsockopt-Aufrufs loggen würde, kommt in der gesamten Historie null Mal vor. Vielleicht sollte ich das noch im Logging aufbohren, wenn möglich?!

Das ist methodisch wichtig: diese Alert-Meldungen enthalten das Wort „quic“ gar nicht. Ein reines grep -i quic im Error-Log hätte einen echten Fehlschlag dieser Aufrufe also gar nicht gefunden, selbst wenn es einen gegeben hätte. Erst die gezielte Suche nach dem exakten Meldungstext schließt aus, dass die Socket-Optionen fehlgeschlagen sind. Sie wurden erfolgreich gesetzt, nur eben die falsche Option für die falsche Adressfamilie. Kein Aufruf-Fehler, sondern genau der beschriebene Bug.

Warum das Error-Log strukturell nicht mehr hergibt: nginx sendet das UDP-Datagramm erfolgreich an den Kernel, die Fragmentierung passiert danach im Netz, an einem Router oder einer Middlebox, oder schon beim sendenden Host selbst, falls das ausgehende Interface-MTU überschritten wird. Davon bekommt der laufende nginx-Prozess in keinem Fall etwas mit. Wer nach diesem Bug im Error-Log sucht, wird nichts finden. Das ist erwartbar, nicht beruhigend, und ein blindes grep quic hätte selbst einen echten Konfigurationsfehler an dieser Stelle übersehen. Genau das ist der Punkt. Man sieht es am Server fast nur, wenn man auch einen tcpdump macht und auswertet. Denn die UDP Pakete gehen ja auf die Reise, sind sie nicht als „unzerteilbar“ markiert, kann und wird auf dem Weg aber bestimmt irgendein Router oder eine Firewall anfangen die Pakete klein zu hacken und dann ist es „kaputt“.

Verifikation über das Access-Log, und ihre Grenzen

nginx zeigt IPv4-Clients, die über einen Dual-Stack-Socket hereinkommen, im Access-Log als IPv4-mapped-Adresse (::ffff:a.b.c.d). Nach dem Fix kommen IPv4-QUIC-Clients über einen echten AF_INET-Socket herein und erscheinen als reine IPv4-Adresse ohne dieses Präfix. Diese Darstellung allein beweist schon, durch welchen Socket eine Verbindung lief, unabhängig von jeder Performance-Messung, aber eben auch unabhängig von jeder direkten Fragmentierungs-Messung.

Ausgewertet habe ich das Access-Log des Blogs (Format goa_ext, enthält $request_time), 13 Tage vor dem Fix plus den laufenden Tag danach, alle HTTP/3.0-Requests, aufgeteilt nach Adressdarstellung:

ZeitraumRequestsØ request_timeMaxAnteil über 1 s
vorher, IPv4 über kaputten Dual-Stack-Socket12.5370,461 s130,3 s5,33 %
nachher, IPv4 über eigenen udp4-Socket9460,037 s1,4 s0,42 %
Kontrollgruppe, natives IPv6, vorher17.3200,113 s67,3 s1,86 %
Kontrollgruppe, natives IPv6, nachher1.1680,082 s5,7 s2,14 %

Die betroffene IPv4-Gruppe lag vorher bei 5,33 Prozent über einer Sekunde, fast das Dreifache der IPv6-Baseline von 1,86 Prozent, und fällt nach dem Fix auf 0,42 Prozent, unter die IPv6-Baseline von 2,14 Prozent im selben Zeitraum. Genau dieser Kontrollgruppen-Vergleich macht die Zahlen für mich aussagekräftig, als Korrelation, die zur quellcode-basierten Root-Cause-Analyse passt, nicht als eigenständigen Fragmentierungsbeweis.

Eine zeitliche Punktprobe passt ins Bild: Restart am 9. September 2026 um 18:38:31 Uhr, letzter Request über den kaputten Dual-Stack-Pfad um 17:56:46 Uhr, erster Request über den neuen Pfad um 18:41:36 Uhr. Seit dem Restart lief keiner der 946 IPv4-HTTP/3.0-Requests mehr über die alte Darstellung. Das liegt plausibel am Restart-Zeitpunkt, mit einer Lücke ohne Traffic dieser Art von 42 Minuten davor und 3 Minuten danach bis zum ersten neuen Request, aber es ist kein exakter Sekundentreffer und ich beschreibe es auch nicht so.

Genauso wichtig wie die Zahlen sind für mich ihre Grenzen, deshalb ein eigener Absatz dafür statt eines Nebensatzes:

  • Ein fehlendes DF-Bit erlaubt Fragmentierung, es erzwingt sie nicht. Ein Datagramm, das auf jedem Hop unter dem dortigen MTU bleibt, ist unabhängig vom DF-Bit unproblematisch. Das kann zu Fragmentierung führen, es führt nicht automatisch dazu.
  • Die Adressdarstellung im Access-Log beweist, welchen Socket nginx verwendet hat. Sie sagt nichts über den DF-Bit-Zustand, die tatsächliche Paketgröße, die reale PMTU oder echte Fragmente auf der Leitung aus. Das gilt hier ohne Einschränkung, weil dieser vHost direkt am Internet hängt, ohne vorgeschaltete Proxy- oder Load-Balancer-Schicht, die $remote_addr umschreiben könnte.
  • Der Vergleich von 13 Tagen vorher gegen einen Teil eines Tages nachher ist kein kontrollierter Leistungsvergleich. Trafficmix, Client-Geografie, Cache-Zustand, Backend-Last und Tageszeit unterscheiden sich zwangsläufig. Die Zahlen sind ein starkes Indiz, kein experimenteller Beweis.
  • Die IPv6-Kontrollgruppe ist nicht vollständig unverändert geblieben. Nur der Anteil über einer Sekunde bleibt in vergleichbarer Größenordnung. Mittelwert und Maximum verschieben sich durchaus, vermutlich schlicht durch allgemein geringere Last oder einen anderen Trafficmix zum jeweiligen Zeitpunkt.
  • Eine Retransmission-Spirale statt eines schnellen Fails ist ein plausibles, aber kein garantiertes Symptom. Wie sich ein verlorenes, fragmentiertes QUIC-Paket konkret auswirkt, hängt von der Verlusterkennung und der PMTU-Implementierung der beteiligten QUIC-Stacks ab, auf Client- wie auf Serverseite.
  • Ein wirklich abschließender Beweis bräuchte einen Vorher- und Nachher-Paketmitschnitt, der das DF-Bit direkt zeigt, im Idealfall mit einem kontrollierten Test gegen ein reduziertes MTU. Ohne den betrachte ich die Produktionszahlen als starke, durch eine Kontrollgruppe abgesicherte Korrelation, die zur quellcode-basierten Root-Cause-Analyse passt, nicht als direkten Fragmentierungsbeweis. Ein Mitschnitt von der Vorher-Seite liegt inzwischen vor, dazu der nächste Abschnitt.

Ein Paketmitschnitt vom Tag vor dem Fix schließt einen Teil der Lücke

Nachtrag vom 12. September 2026: Der vorherige Abschnitt musste ohne einen echten Paketmitschnitt auskommen. Der liegt inzwischen vor. Zwei rund 41 Sekunden lange Aufzeichnungen vom 8. September 2026, einen Tag vor dem Fix, eine direkt auf dem Server, die andere gleichzeitig auf einem Notebook, das die Seite über ein anderes Netz aufgerufen hat. Beide zusammen zeigen den echten HTTP/3-Verkehr eines einzelnen Seitenaufrufs.

Ausgewertet mit tcpdump -r <Datei> -n -v, ein tshark stand mir nicht zur Verfügung. Jedes Paket trägt im IP-Header ein Identification-Feld, und das ist in beiden Mitschnitten innerhalb des Beobachtungsfensters durchgehend eindeutig, keine einzige Dopplung unter den mehr als dreitausend vom Server verschickten Paketen. Darüber lassen sich einzelne Datagramme zwischen den beiden Aufzeichnungen zweifelsfrei einander zuordnen, nicht nur über Summen vergleichen.

RichtungBeim Server verschicktBeim Notebook angekommenAbgleich
Notebook zu Server1.147, alle mit DF-Bit1.147, alle mit DF-Bitidentisch, per ID geprüft
Server zu Notebook, klein genug fürs MTU898, kein DF-Bit898, dieselben IDs0 Prozent Verlust
Server zu Notebook, fragmentiert, kein DF-Bit2.162 erste Fragmente878, per ID zugeordnet1.284 fehlen, 59,4 Prozent

Kein einziges der 1.147 Pakete vom Notebook zum Server fehlt das DF-Bit, kein einziges der 3.060 Pakete in der Gegenrichtung trägt eines. Das bestätigt den Fund aus dem Quellcode jetzt direkt auf der Leitung, nicht nur über die Adressdarstellung im Access-Log. 2.162 dieser Server-Pakete sind schon beim Verlassen des Servers fragmentiert, jedes erste Fragment exakt 1500 Byte lang, also an der Ethernet-MTU gekappt. Von diesen 2.162 erscheinen im Notebook-Mitschnitt nur 878 wieder, eins zu eins über die ID zugeordnet. 1.284 fehlen komplett, das sind 59,4 Prozent. Die 898 kleinen, unfragmentierten Antworten kommen dagegen alle an, ebenfalls per ID geprüft und nicht bloß über die Summe verglichen. Über die ganzen 41 Sekunden verteilt liegt der fehlende Anteil in jedem Fünf-Sekunden-Fenster zwischen 51 und 68 Prozent. Kein Ausreißer am Anfang oder Ende der Aufzeichnung, der auf einen Zeitversatz zwischen den beiden Mitschnitten hindeuten würde.

Die zweite Hälfte jedes fragmentierten Datagramms taucht in keinem der beiden Mitschnitte auf. Vermutlich wurde mit einem Filter auf den UDP-Port aufgezeichnet, und ein IP-Fragment ohne den ersten Teil trägt keinen UDP-Header, an dem so ein Filter ansetzen könnte. Das lässt offen, ob einzelne der 878 angekommenen ersten Fragmente trotzdem nie vollständig zusammengesetzt werden konnten, weil ihre zweite Hälfte fehlte. 59,4 Prozent sind deshalb eine gemessene Untergrenze für den tatsächlichen Verlust, keine Obergrenze. Und es bleibt eine einzelne Sitzung, ein Client, ein Pfad, eine Zeitspanne von 41 Sekunden, kein Beleg für eine feste Verlustquote im ganzen Netz.

So sieht der Unterschied im Rohformat aus, Adressen durch Platzhalter ersetzt:

12:01:29.758438 IP (id 0, offset 0, flags [DF], length 1280)
    CLIENT.35577 > SERVER.443: UDP, length 1252
12:01:29.771757 IP (id 51997, offset 0, flags [+], length 1500)
    SERVER.443 > CLIENT.35577: UDP, length 1480

Dieser Mitschnitt stammt vom Tag vor dem Fix, ein gepaarter Mitschnitt von danach existiert aus dem echten Betrieb nicht. Der Versuch direkt nach dem Fix blieb leer, weil der dafür verwendete Client kein echtes HTTP/3 sprach und der Mitschnitt dadurch keinen QUIC-Verkehr enthielt. Die Vorher-Nachher-Zahlen aus dem Access-Log oben bleiben deshalb weiterhin die Grundlage für den gemessenen Effekt des Fixes. Was dieser Mitschnitt zusätzlich liefert, ist der direkte Beleg für den Mechanismus dahinter: das fehlende DF-Bit und die Fragmentierung selbst sind jetzt nicht mehr nur aus dem Quellcode abgeleitet, sondern auf der Leitung beobachtet.

Fazit

Ein einzelner Dual-Stack-Socket für QUIC ist offenbar kein Einzelfall, sondern eher ein wiederkehrendes Footgun-Muster über verschiedene Implementierungen hinweg. quic-go, die von Marten Seemann entwickelte QUIC-Bibliothek, musste DPLPMTUD auf älteren macOS-Versionen abschalten, weil sich das DF-Bit auf einem Dual-Stack-Socket dort schlicht nicht setzen ließ, und dokumentiert das offen. Ein separates Issue im selben Projekt beschreibt ein anderes, aber verwandtes Dual-Stack-Problem gerade auf FreeBSD (fehlgeschlagenes sendmsg für IPv4-mapped-Adressen), mit einem Verweis auf FreeBSDs eigene inet6(4)-Manpage, die für AF_INET6-Sockets ganz grundsätzlich empfiehlt, zwei getrennte Sockets zu verwenden, aus Sicherheitsgründen, unabhängig von QUIC. Die Empfehlung, IPv4 und IPv6 getrennt zu halten, existierte auf dieser Plattform also schon, bevor QUIC überhaupt erfunden wurde. Für den konkreten Fall hier heißt das, dass der Socket-Split kein Workaround für einen einzelnen nginx-Bug ist, sondern die Rückkehr zu der Architektur, die FreeBSD für genau diese Situation ohnehin vorsieht.

Ein Socket für beides bleibt bei TCP über TLS ein legitimer, funktionierender Kompromiss. Bei QUIC ist er, zumindest auf dieser Kombination aus nginx und FreeBSD, ein stiller Bug, der sich weder im Error-Log noch im laufenden Betrieb meldet, sondern nur über einen erhöhten Anteil langsamer Verbindungen bemerkbar macht. Wer selbst QUIC auf einem Dual-Stack-Listener betreibt, findet die Antwort auf die Frage, welchen Socket ein Client gerade benutzt, mit dem Access-Log-Trick oben in wenigen Minuten selbst heraus.

Siehe auch:

Fragen, Einwände oder eigene Erfahrungen mit QUIC auf Dual-Stack-Sockets? Dann darfst du mich sehr gerne fragen.
ECH aktivieren: Encrypted Client Hello in nginx mit OpenSSL 4.0, sechs Domains und ein gemeinsamer Deckname

Der Servername im TLS-Handshake steht bis heute im Klartext im Netz, unabhängig davon, wie gut die DNS-Anfrage davor verschlüsselt war. Wer DNS over HTTPS oder DNS over TLS einsetzt, verbirgt den Lookup selbst, aber sobald der Browser die eigentliche Verbindung aufbaut, nennt das Client Hello die besuchte Domain im Server Name Indication Feld offen. Jeder Netzwerkbeobachter zwischen Client und Server sieht damit weiterhin, welche Website gerade aufgerufen wird, egal wie sauber DNS-Ebene und Transportebene sonst verschlüsselt sind.

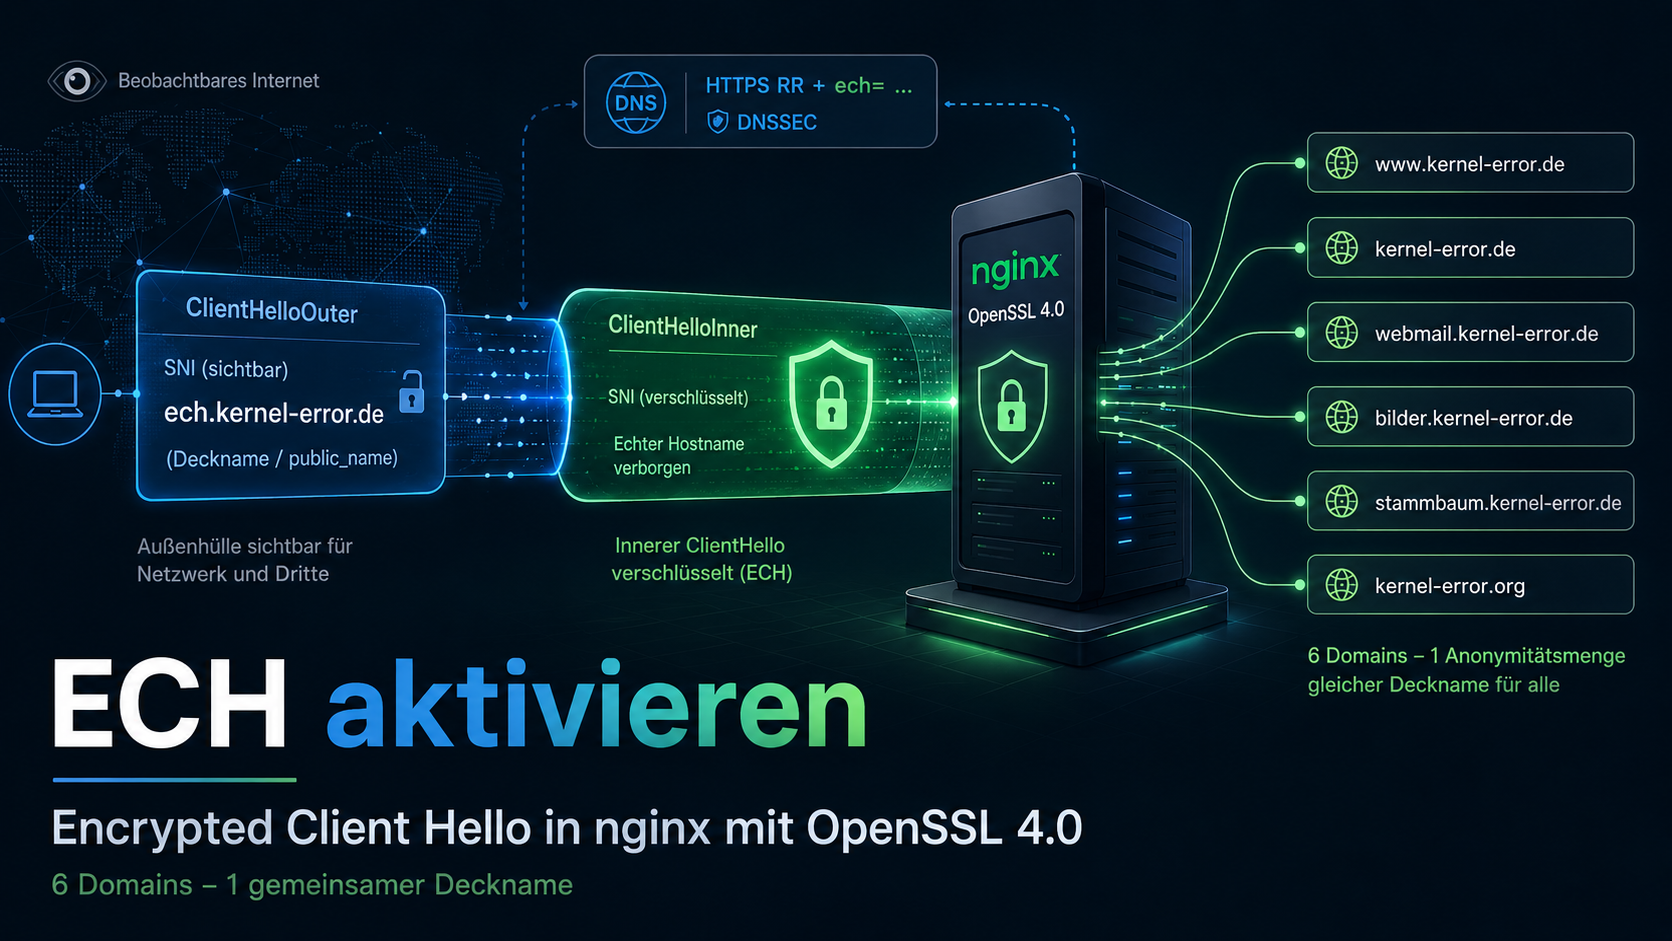
Illustration zu Encrypted Client Hello (ECH): Ein sichtbarer ClientHelloOuter mit dem gemeinsamen Decknamen ech.kernel-error.de schützt die verschlüsselten Hostnamen mehrerer Domains auf einem nginx-Server mit OpenSSL 4.0.

Encrypted Client Hello schließt genau diese Lücke, indem der eigentliche Servername in einen zweiten, verschlüsselten Client Hello wandert. Der folgende Beitrag beschreibt, wie ECH auf dieser Infrastruktur aktiviert wurde: mit OpenSSL 4.0 als Voraussetzung, nginx als Ports-Build und sechs Domains, die sich einen gemeinsamen Deckname teilen. Alle Befehle, Konfigurationsausschnitte und Testausgaben stammen aus dem produktiven Rollout und sind gegengeprüft, aktuell laufen alle sechs sauber verifiziert.

Was Encrypted Client Hello eigentlich verbirgt

Ein ECH-Verbindungsaufbau enthält zwei Client Hellos statt einem. Das äußere ist wie gewohnt unverschlüsselt, trägt aber nicht die echte Domain, sondern einen Deckname. Das innere steckt verschlüsselt im äußeren und enthält die tatsächlich angefragte Domain:

ClientHelloOuter: unverschlüsselt sichtbar, enthält public_name
ClientHelloInner: verschlüsselt, enthält die tatsächlich besuchte Domain

Der Server entschlüsselt das innere Client Hello mit einem Schlüssel, den er vorher über DNS veröffentlicht hat, wählt anhand der darin enthaltenen echten SNI den passenden vHost aus und antwortet als wäre nie ein Deckname im Spiel gewesen. Für den Browser läuft das komplett automatisch ab, sobald der Server ECH per DNS anbietet.

Voraussetzungen, bevor es losgeht

  • OpenSSL 4.0 oder neuer (ECH ist seit dem stabilen 4.0.0-Release vom 14. April 2026 Bestandteil, im Alpha-/Dev-Branch bereits ab 10./11. März 2026 verfügbar), alternativ BoringSSL
  • nginx 1.29.4 oder neuer, mit der Direktive ssl_ech_file (hier im Einsatz: 1.30.4)
  • eine DNSSEC-signierte Zone ist sinnvoll, aber keine normative ECH-Voraussetzung, dazu weiter unten mehr

Auch der erste Punkt ist keine Formalität. Das Lighttpd-Wiki führt ECH aktuell weiterhin als EXPERIMENTAL und nennt dieselbe Voraussetzung, OpenSSL 4.0 oder BoringSSL. ECH ist über die Server-Landschaft hinweg gesehen noch frisch, entsprechend lohnt vor dem eigenen Rollout ein Blick auf die aktuell installierte Softwareversion, nicht auf das, was vor einem halben Jahr noch galt.

Der Umstieg auf OpenSSL 4.0 als Ausgangspunkt

nginx läuft in dieser Jail als Ports-Build, nicht als Repo-Paket, weil das Paket Brotli und headers_more deaktiviert ausliefert. Damit lässt sich die verwendete OpenSSL-Hauptversion über die SSL-Flavor-Einstellung in /etc/make.conf steuern und nginx anschließend dagegen neu bauen:

jexec nginx pkg unlock -y nginx
# /etc/make.conf: DEFAULT_VERSIONS+=ssl=openssl40 (vorher openssl35)
jexec nginx make -C /usr/ports/www/nginx missing
jexec nginx make -C /usr/ports/www/nginx -DBATCH build
jexec nginx make -C /usr/ports/www/nginx -DBATCH deinstall install
jexec nginx pkg lock -y nginx
jexec nginx service nginx restart

Ein reload reicht an dieser Stelle ausdrücklich nicht. Die neuen Shared Libraries werden erst beim vollständigen Neustart der Worker-Prozesse eingebunden, ein reload behält die alten libssl-Bindings der laufenden Prozesse bei. Die neue Version zeigt sich danach direkt im Server-Build:

$ nginx -V
built with OpenSSL 4.0.1 9 Jun 2026

public_name ist die eigentliche Entscheidung

ssl_ech_file ist keine Bastellösung und kein Fork, sondern eine echte, in nginx-Mainline gemergte Direktive, sichtbar direkt im Quellcode unter src/http/modules/ngx_http_ssl_module.c und src/event/ngx_event_openssl.c. Technisch nutzt sie die OSSL_ECHSTORE-API, die mit OpenSSL 4.0 dazugekommen ist.

Der eigentlich entscheidende Wert ist public_name, der Name, der im unverschlüsselten ClientHelloOuter sichtbar bleibt. Ein Netzwerkbeobachter sieht ihn ohnehin, ECH hin oder her. Setzt man ihn auf die eigene, echte Domain, bringt die ganze Übung keinerlei Verschleierung: der Beobachter sieht exakt den Namen, den er auch ohne ECH gesehen hätte, nur mit einem zusätzlichen Handshake-Schritt drumherum.

Echten Schutz gibt es nur mit einem gemeinsamen public_name über mehrere unabhängige Domains hinweg, dem Anonymitätsset-Prinzip. Genau so macht es Cloudflare mit cloudflare-ech.com als Deckname für Millionen Kundendomains: wer nur sieht, dass jemand eine Verbindung zu cloudflare-ech.com aufbaut, weiß damit nichts über die konkret besuchte Seite unter den Millionen dahinter.

Ein gemeinsamer public_name reicht dafür allein aber noch nicht. Im ClientHelloOuter steht neben dem public_name auch die config_id unverschlüsselt, ein einzelnes Byte, das die verwendete ECHConfig identifiziert. Nutzt jede Domain einen eigenen ECH-Schlüssel, hat jede Domain automatisch auch eine eigene config_id, und ein Beobachter kann die Domains trotz identischem Deckname allein anhand dieses Bytes unterscheiden. RFC 9849 bringt es auf den Punkt: verwendet ein Server für verschiedene Servernamen unterschiedliche ECHConfig-Werte, hat jedes Anonymitätsset effektiv Größe 1, also gar keinen Effekt. Die Konsequenz für den eigenen Aufbau: alle teilnehmenden Domains müssen denselben Schlüssel und dieselbe ECHConfig nutzen, nicht nur denselben Deckname.

Diese eine nginx-Instanz hostet bereits rund zwanzig unabhängige Domains auf derselben IP, darunter dieser Blog, eine Therapiepraxis-Website, eine Fotogalerie, private Familienseiten, Webmail und ein URL-Shortener. Die Voraussetzung für ein eigenes, kleines Anonymitätsset war also schon da, es musste nur genutzt werden.

Umgesetzt wurde ein dedizierter Deckname, ech.kernel-error.de, ohne eigenen Inhalt. Sechs Domains teilen sich einen gemeinsamen ECH-Schlüssel und damit dieselbe ECHConfig, denselben public_name und dieselbe config_id: www.kernel-error.de, die Apex-Domain kernel-error.de, webmail.kernel-error.de, bilder.kernel-error.de und kernel-error.org als eigene, ebenfalls DNSSEC-signierte Zone. Die TLS-Zertifikats-Schlüssel der einzelnen Domains bleiben davon unberührt getrennt, das ist ein anderes Schlüsselpaar als der ECH-HPKE-Schlüssel und für die Anonymitätsset-Eigenschaft ohne Belang. stammbaum.kernel-error.de, ein CNAME auf www, erbt die ECH-Konfiguration automatisch per DNS-CNAME-Chasing, ganz ohne eigenen Eintrag.

Schlüssel erzeugen

Für die Schlüsselerzeugung braucht es das Port-OpenSSL unter /usr/local/bin/openssl, nicht das Base-System-OpenSSL von FreeBSD, dem fehlt der ech-Subcommand komplett:

openssl ech -public_name ech.kernel-error.de -out /usr/local/etc/nginx/ssl/ech/shared.kernel-error.pem

Das Ergebnis ist eine PEM-Datei mit zwei Blöcken, dem privaten Schlüssel und der öffentlichen ECH-Konfiguration:

-----BEGIN PRIVATE KEY-----
...
-----END PRIVATE KEY-----
-----BEGIN ECHCONFIG-----
AEb+DQBC8AAgACDKMT4bTYtGnUXKvOkeuYEWDaByMjijSRINkLQxIEHQQQAEAAEAAQATZWNoLmtlcm5lbC1lcnJvci5kZQAA
-----END ECHCONFIG-----

Der Base64-Block zwischen den ECHCONFIG-Markern ist exakt der Wert, der später als ech=-Parameter in den DNS-Eintrag wandert. Das PEM-Format selbst folgt keinem nginx- oder OpenSSL-eigenen Standard, sondern ist mittlerweile als RFC 9934 festgeschrieben, hervorgegangen aus dem Internet-Draft draft-farrell-tls-pemesni, den auch das DEfO-Projekt in seinen ech-dev-utils dokumentiert.

Ein gemeinsamer Schlüsselspeicher für alle Domains

Bei mehreren Domains mit gemeinsamem public_name gehört ssl_ech_file auf die http{}-Ebene in der nginx.conf, noch vor die vHost-Includes, nicht in die einzelnen vHost-Dateien:

ssl_ech_file /usr/local/etc/nginx/ssl/ech/shared.kernel-error.pem;

Der Grund liegt in der Reihenfolge des Handshakes. Die ECH-Entschlüsselung passiert, bevor nginx anhand der noch verschlüsselten echten SNI überhaupt den passenden vHost auswählen kann. In diesem Moment entscheiden die äußere SNI, also der gemeinsame public_name, und die vom Client mitgeschickte config_id, welcher Schlüssel überhaupt zum Entschlüsseln probiert wird. Ein Store auf http{}-Ebene stellt sicher, dass genau dieser eine, gemeinsame Schlüssel unabhängig vom initial per SNI getroffenen Serverblock verfügbar ist, egal welche der sechs Domains die Verbindung eigentlich betrifft.

Ein eigenes Zertifikat für den Deckname

Der Deckname selbst braucht ein eigenes Zertifikat mit ausschließlich diesem einen SAN-Eintrag, kein Wildcard-Zertifikat, das nebenbei auch die echten Domains auflistet. Sonst verrät schon das äußere Zertifikat die Domain-Familie, selbst wenn die konkrete Domain im Handshake verschlüsselt bleibt:

certbot certonly --nginx -d ech.kernel-error.de --key-type ecdsa
X509v3 Subject Alternative Name:
    DNS:ech.kernel-error.de

Der nginx-vHost für den Deckname bleibt inhaltsleer und erbt den Schlüsselspeicher automatisch von der http{}-Ebene:

server {
    listen      [::]:443 ssl;
    http2 on;
    server_name ech.kernel-error.de;
    ssl_certificate     /usr/local/etc/letsencrypt/live/ech.kernel-error.de/fullchain.pem;
    ssl_certificate_key /usr/local/etc/letsencrypt/live/ech.kernel-error.de/privkey.pem;
    include              /usr/local/etc/nginx/tls-default.conf;
    location / { return 204; }
}

Der DNS-Eintrag

Die ECH-Konfiguration wird nicht als eigener Record-Typ verteilt, sondern als zusätzlicher ech=-SvcParam an der ohnehin schon vorhandenen HTTPS-Resource-Record angehängt, und zwar identisch auf allen sechs teilnehmenden Domains. Der Bootstrap-Mechanismus dafür steht in RFC 9848.

www  IN HTTPS  1 www.kernel-error.de. ( alpn="h3,h2" ipv4hint=148.251.30.200
     ipv6hint=2a01:4f8:262:4716::443
     ech="AEb+DQBC8AAgACDKMT4bTYtGnUXKvOkeuYEWDaByMjijSRINkLQxIEHQQQAEAAEAAQATZWNoLmtlcm5lbC1lcnJvci5kZQAA" )

Eine DNSSEC-signierte Zone ist dafür nicht normativ vorgeschrieben, aber sinnvoll: ohne Signatur kann ein Man in the Middle den ech=-Parameter einfach aus der Antwort entfernen, ein klassischer Downgrade auf Klartext-SNI, den ein validierender Resolver mit DNSSEC erkennt. Vor jeder Form von Downgrade schützt das trotzdem nicht: ein Angreifer kann die gesamte HTTPS/SVCB-Auflösung unterdrücken statt sie zu manipulieren, und gegen dieses Denial hilft DNSSEC allein nicht.

Verifikation nach dem Rollout

Der naheliegende erste Test ist openssl s_client mit dem passenden ECH-Config-List-Wert. Ohne ein gesetztes CA-Bundle lassen sich ein echter ECH-Fehler und ein simpler Zertifikatsfehler dabei nicht unterscheiden, -CAfile ist deshalb Pflicht, nicht optional:

openssl s_client -connect 148.251.30.200:443 -servername www.kernel-error.de -ech_config_list "AEb+DQBC8AAgACDKMT4bTYtGnUXKvOkeuYEWDaByMjijSRINkLQxIEHQQQAEAAEAAQATZWNoLmtlcm5lbC1lcnJvci5kZQAA" -CAfile /etc/ssl/cert.pem
Verify return code: 0 (ok)
ECH: success: 1
ECH: inner: www.kernel-error.de
ECH: outer: ech.kernel-error.de

Derselbe Test läuft identisch, mit demselben Base64-Wert und demselben Erfolg, auch für kernel-error.de, webmail.kernel-error.de, bilder.kernel-error.de und kernel-error.org, alle fünf gegen dieselbe ECHConfig verifiziert.

Für eine unabhängige Zweitmeinung von außen eignet sich das externe Tool echcheck. Es prüft nicht nur, ob der Handshake gelingt, sondern auch DNS-Veröffentlichung, verwendete Kryptografie, das innere Zertifikat und die Retry-Konfiguration einzeln:

ECHConfig aus dem DNS: ✓
finale ECH-Version 0xfe0d: ✓
X25519, HKDF-SHA256, AES-128-GCM: ✓
öffentlicher Name ech.kernel-error.de: ✓
echter ECH-Handshake: Accepted (TLS 1.3): ✓
gültiges inneres Zertifikat: ✓
gültige Retry-Konfiguration, Wiederholung erfolgreich: ✓
SNI Leakage: ✓ (Einzel-SAN-Zertifikat für den Deckname)
Certificate (outer): ✓ (Einzel-SAN-Zertifikat für den Deckname)

In allen neun geprüften Kategorien kommt ein Haken zurück, auch bei den beiden Punkten, die erst nach dem Einzel-SAN-Zertifikat für den Deckname sauber wurden. Ein einmaliger CLI-Test sagt aber nichts darüber, ob echte Clients die Funktion später auch tatsächlich nutzen. Dafür lohnt sich ein erweitertes Log-Format, das den ECH-Status jeder einzelnen Verbindung mitschreibt:

log_format tls_extended
  '$remote_addr - $remote_user [$time_local] '
  '"$request" $status $body_bytes_sent '
  '"$http_referer" "$http_user_agent" '
  'proto=$ssl_protocol cipher=$ssl_cipher kx_curve=$ssl_curve '
  'alpn=$ssl_alpn_protocol reused=$ssl_session_reused sni=$ssl_server_name '
  'ech_status=$ssl_ech_status ech_outer_sni=$ssl_ech_outer_server_name';

Im laufenden Traffic zeigen sich damit bereits echte ech_status=SUCCESS-Verbindungen, neben NOT_TRIED für Clients ohne ECH-Unterstützung und GREASE für Clients, die absichtlich eine leere ECH-Erweiterung mitschicken, um Middleboxen an das Feld zu gewöhnen. Genau dieser Log-Eintrag ist der eigentliche Erfolgsnachweis, nicht der einzelne CLI-Test.

Während dieser TLS-Arbeiten am selben Server ist außerdem noch ein kleinerer Nebenfund aufgetaucht: ein externer TLS-Scan meldete, dass der Server unter TLS 1.2 weiterhin SHA-224 als Hash-Funktion für die Signatur beim Schlüsselaustausch akzeptierte, obwohl die konfigurierten Cipher-Suiten ohnehin ausschließlich ECDSA nutzen. RFC 9847 stuft SHA-224 in der TLS-HashAlgorithm-Registry inzwischen als „Discouraged“ ein, während SHA-256, SHA-384 und SHA-512 dort als „Recommended“ geführt werden. Ein guter Grund, es trotzdem weiter anzubieten, findet sich aber nicht, wenn SHA-256 und höher ohnehin zur Verfügung stehen. Unter TLS 1.3 stellt sich die Frage gar nicht erst, dort ist für SHA-224 kein Signature Scheme registriert, die Hash-Funktion lässt sich strukturell nicht wählen.

Cipher-Suite und Signaturalgorithmus fürs Handshake sind zwei getrennte Stellschrauben, eine sauber konfigurierte Cipher-Suite sagt nichts über die andere aus. Ohne explizite Vorgabe verwendet OpenSSL seine Default-Liste der SignatureAlgorithms, und die enthält SHA-224 weiterhin aus Kompatibilitätsgründen:

openssl s_client -connect 148.251.30.200:443 -servername www.kernel-error.de -tls1_2 -sigalgs "ECDSA+SHA224"
Peer signing digest: SHA224
New, TLSv1.2, Cipher is ECDHE-ECDSA-CHACHA20-POLY1305

Der Fix ist eine Zeile in der gemeinsamen TLS-Konfigurationsdatei, damit gilt sie automatisch für alle vHosts, nur ECDSA-Varianten gelistet, passend zum bestehenden reinen ECDSA-Cipher-Setup:

ssl_conf_command SignatureAlgorithms ECDSA+SHA384:ECDSA+SHA256:ECDSA+SHA512;

Auch hier reichte ein reload nicht, erst ein vollständiger Neustart übernahm die geänderte Liste, aus demselben Grund wie beim OpenSSL-Umstieg weiter oben. Danach lehnt der Server SHA-224 ab, SHA-256 funktioniert unverändert:

SHA224: error:...:SSL routines:ssl3_read_bytes:tls alert handshake failure:...
SHA256: Peer signing digest: SHA256, New, TLSv1.2, Cipher is ECDHE-ECDSA-CHACHA20-POLY1305

Fazit

OpenSSL 4.0 war die technische Voraussetzung für diesen Umstieg, die eigentliche Entscheidung fiel aber woanders. Ein ECH-Setup mit dem eigenen Domainnamen als public_name wäre in wenigen Minuten fertig gewesen und hätte am Ende nichts verschleiert. Der Wert liegt allein in einem gemeinsamen Deckname über mehrere unabhängige Domains, und den gab es hier schon, bevor überhaupt eine Zeile Konfiguration geschrieben wurde.

Firefox unterstützt ECH seit Version 118, standardmäßig aktiv ist es seit Version 119, jeweils automatisch sobald ein Server es per DNS anbietet. Bei Chromium-basierten Browsern lässt sich keine ebenso feste Versionsgrenze nennen, der Rollout läuft dort gestaffelt über Channel und Policy. Der Nutzer muss in beiden Fällen nichts einstellen, die Aushandlung läuft beim ersten Verbindungsaufbau im Hintergrund. Wie schnell sich diese Versionsstände weiterentwickeln, lässt sich hier nicht dauerhaft verlässlich festschreiben, ein aktueller Blick in die jeweilige Browser-Dokumentation lohnt bei Zweifeln also immer.

Wer selbst mehrere unabhängige Domains auf derselben IP betreibt, hat die Grundvoraussetzung für ein eigenes Anonymitätsset damit häufig schon, ganz ohne Cloudflare oder einen anderen großen Anbieter dazwischen.

Siehe auch

Bei Fragen zum Setup, zur Wahl des Decknamens oder zum eigenen Anonymitätsset dürft ihr mich sehr gerne fragen.

Post-Quantum TLS auf Nginx: 15 Tage $ssl_curve ausgewertet, wer macht mit?

Post-Quantum TLS auf Nginx – Auswertung der Key-Exchange-Gruppen (X25519MLKEM768 vs. klassisch)

Vor einigen Wochen habe ich Nginx hier auf X25519MLKEM768 umgestellt und den Weg dorthin in einem eigenen Beitrag dokumentiert: Post-Quantum TLS für Nginx auf FreeBSD 15. Am Ende des Beitrags stand ein kleines Versprechen. Ich erweitere das Logging um die ausgehandelte Key-Exchange-Gruppe, lasse das ein paar Wochen laufen und werte dann aus, wer was tatsächlich spricht. Das ist jetzt eingelöst.

Der Messaufbau, in zwei Zeilen

Nginx kennt die Variable $ssl_curve. Die ist seit Ewigkeiten verfügbar und liefert pro Verbindung zurück, welche Kurve bzw. Gruppe beim TLS-Handshake benutzt wurde. Also X25519MLKEM768, X25519, secp384r1, prime256v1 und so weiter. Im Log-Format einfach nach $ssl_cipher eingehängt, einen Reload in den Nginx geschickt, fertig.

log_format goa_ext
  '$remote_addr - $remote_user [$time_local] '
  '"$request" $status $body_bytes_sent '
  '"$http_referer" "$http_user_agent" '
  '$host $server_protocol $scheme '
  '$request_time $upstream_response_time $upstream_status $upstream_addr '
  '$ssl_protocol $ssl_cipher $ssl_curve $upstream_cache_status';

Nach rund 15 Tagen liegen grob 180.000 HTTPS-Handshakes im Log, verteilt über alles, was so an HTTPS-Clients vorbeikommt. Das ist genug Masse, um ein paar belastbare Muster zu sehen, ohne dass einzelne Ausreißer das Gesamtbild kippen. Exakte Besucherzahlen werde ich in diesem Beitrag bewusst nicht auflisten, das ist auch nicht das Thema. Mich interessiert die relative Verteilung. Wer macht PQ, wer macht es nicht?

Die eine Zahl vorweg

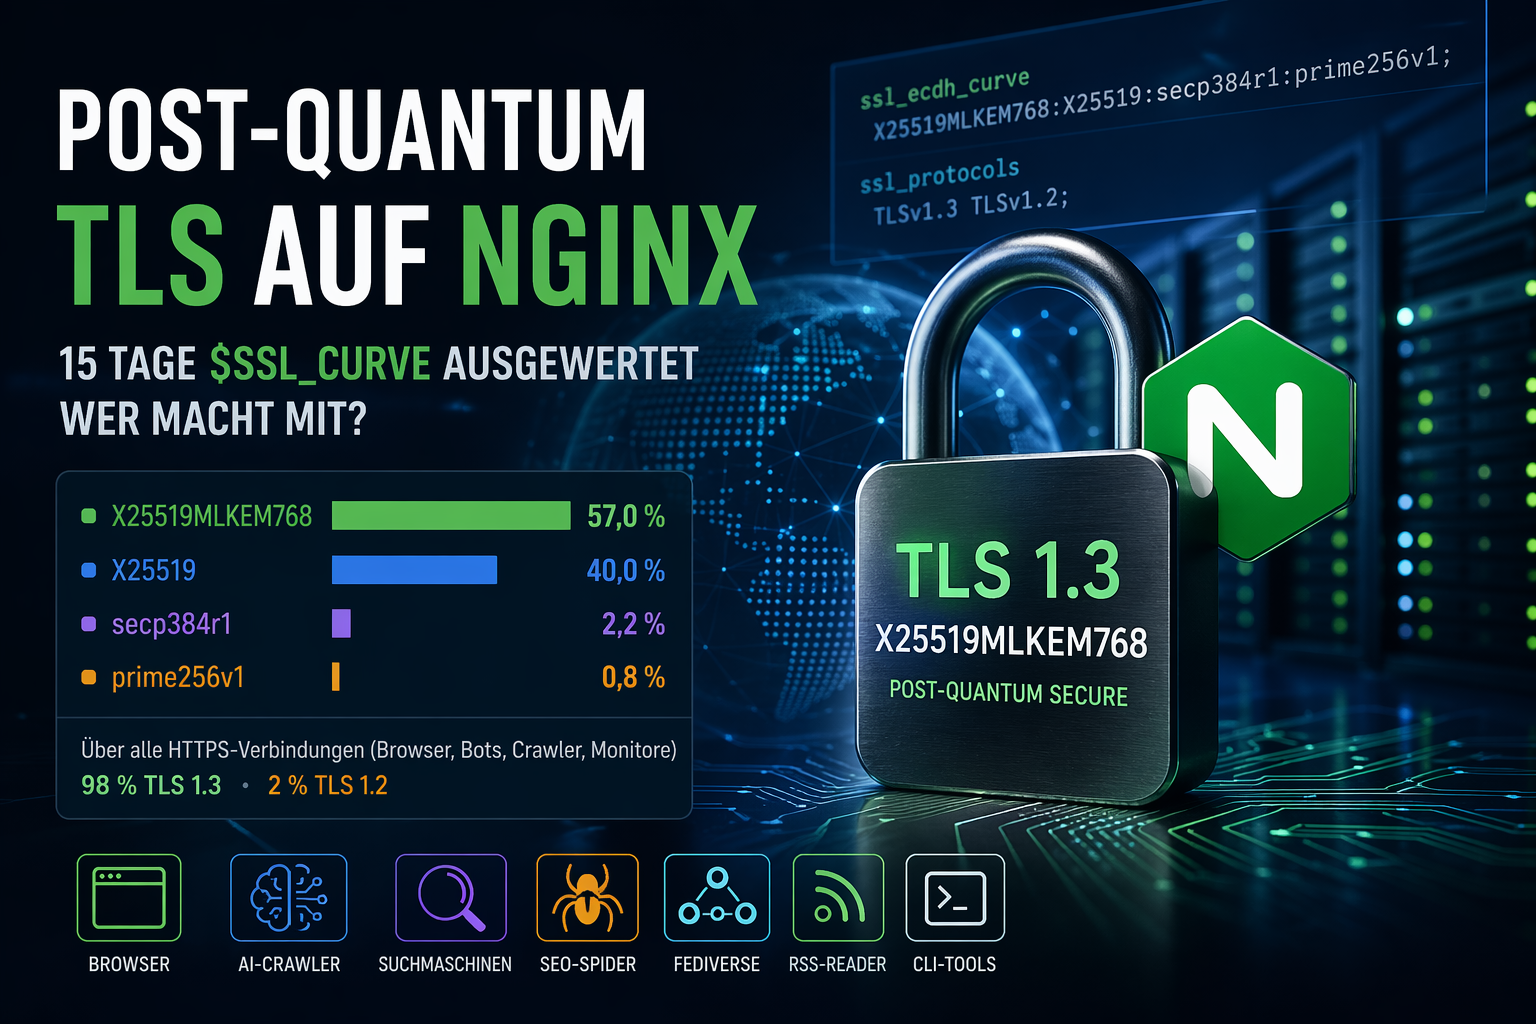
Über alle HTTPS-Verbindungen (Browser, Bots, Crawler, Monitore, alles) sieht die Verteilung der Kurven so aus:

X25519MLKEM768   57,0 %   <- Post-Quantum-Hybrid
X25519           40,0 %   <- klassisches TLS 1.3
secp384r1         2,2 %   <- meist TLS 1.2
prime256v1        0,8 %   <- meist TLS 1.2

Klingt erstmal ordentlich. 57 % PQ über das komplette Gemisch, 98 % TLS 1.3, lediglich 2 % TLS 1.2. Aber in dieser Zahl stecken ein paar Dinge versteckt drin, die man erst sieht, sobald man die User-Agents grob auseinandersortiert. Ich habe das in ein paar Kübel geworfen: Browser, AI-Crawler, klassische Suchmaschinen, SEO-Spider, Fediverse-Software, RSS-Reader, Monitore und CLI-Tools. Nicht perfekt, aber brauchbar.

Browser, die Post-Quantum-Avantgarde

Bei echten Browsern (Chrome, Firefox, Safari, Edge) sieht es deutlich freundlicher aus. Zusammengenommen sprechen rund 77 % der Browser-Verbindungen bereits MLKEM768. Aufgeschlüsselt:

Firefox    87 % PQ   <- klarer Champion
Safari     75 % PQ
Edge       73 % PQ
Chrome     72 % PQ
Opera       2 % PQ   <- haengt seltsam weit hinten

Firefox liegt erkennbar vorn. Nicht weltbewegend weit, aber deutlich. Mozilla hat MLKEM768 früh aktiviert und nutzt standardmäßig die Hybrid-Gruppe, wenn der Server sie anbietet. Chrome hängt etwas hinter den anderen und ich vermute, das liegt an den ganzen älteren Chrome-Builds, die in Embedded-Devices, WebViews und seltsamen Apps stecken und auch als Chrome im User-Agent stehen. Opera dagegen nimmt fast immer nur klassisches X25519. Keine Ahnung warum, schaue ich mir vielleicht mal gesondert an.

Das Schöne daran ist: Ich habe für diese 77 % exakt nichts getan außer die Nginx-Konfiguration anzupassen. Kein Opt-in, kein Banner, keine Weiche. X25519MLKEM768 steht ganz oben in ssl_ecdh_curve und wird genommen, wenn der Client es kann. Der Rest ist reines Client-Upgrade-Verhalten. Das ist eigentlich die schönste Erkenntnis aus der ganzen Auswertung. Wenn die Serverseite rechtzeitig aktualisiert wird, zieht die Clientseite fast geräuschlos nach.

AI-Crawler, flächendeckend bei null

Jetzt kommt der Teil, den ich so nicht erwartet hätte. Die großen AI-Crawler holen sich hier regelmäßig Inhalte ab (siehe auch von SEO zu AEO: llms.txt und llms-full.txt), der TLS-Stack dahinter ist bei praktisch allen auf dem Stand von vor zwei Jahren:

OpenAI GPTBot             0 % PQ    -> X25519
Anthropic ClaudeBot       0 % PQ    -> X25519
Meta AI (ExternalAgent)   0 % PQ    -> X25519
PerplexityBot             0 % PQ    -> X25519
ChatGPT-User              0 % PQ    -> X25519
OpenAI SearchBot          0 % PQ    -> X25519
GoogleOther               0 % PQ    -> X25519
Amazonbot                 0 % PQ    -> TLS 1.2 + secp384r1

Amazon ist nochmal ein eigenes Kapitel. Amazonbot kommt hier ausschließlich mit TLS 1.2 und secp384r1. Das ist ein TLS-Stack, den ich persönlich bei einem Unternehmen, das Cloud-Sicherheit verkauft, nicht mehr erwartet hätte. Aber Messungen lügen nicht.

Zwei echte Ausnahmen gibt es:

ByteDance Bytespider     91 % PQ   <- ueberraschend
DuckAssistBot           100 % PQ   <- auch ueberraschend

Auf diese zwei hätte ich nicht gesetzt. TikToks Crawler macht zu über 90 % PQ, DuckDuckGos AI-Helper zu 100 %. Wer hätte das gedacht.

Klassische Suchmaschinen, auch nicht besser

Bei den traditionellen Suchmaschinen ist das Bild fast identisch zum AI-Lager:

Googlebot       0 % PQ
Applebot        0 % PQ
PetalBot        0 % PQ
Baiduspider     0 % PQ
SeznamBot       0 % PQ
Qwant           0 % PQ
YandexBot       1 % PQ
Bingbot         0 % PQ und zu 99,6 % auf TLS 1.2 + secp384r1
DuckDuckBot    84 % PQ   <- der einzige helle Fleck

Besonders bitter: Bingbot. Der läuft hier praktisch ausschließlich auf TLS 1.2 mit secp384r1. Microsofts Produktions-Webcrawler, 2026, mit einem TLS-Stack, den Webauditoren seit Jahren rot anstreichen. Googlebot ist immerhin auf TLS 1.3, aber halt ohne PQ. Der einzige, der fürs Thema etwas tut, ist DuckDuckBot. Respekt dafür.

SEO-Spider, am weitesten hinten

Der traurigste Haufen. AhrefsBot, SemrushBot, MJ12bot, DotBot, Barkrowler, DataForSeoBot, SeekportBot, Vebidoobot, alle zwischen 0 % und 3 % PQ. Vebidoobot kommt komplett auf TLS 1.2 rein. Das sind kommerzielle Produkte, die von Seitenbetreibern dafür bezahlt werden, Webseiten zu analysieren und Empfehlungen auszusprechen. Analysieren tun sie mit einem TLS-Stack, den sie ihren eigenen Kunden vermutlich als kritischen Finding in den Bericht schreiben würden. Kurios.

Fediverse, alles drin je nach Codebase

Seit dem Anschluss ans Fediverse ist das hier die zweitgrößte Traffic-Quelle nach den Browsern, deshalb habe ich mir das extra angeschaut. Mastodon stellt davon den Löwenanteil, weil es schlicht die meisten Instanzen gibt:

Mastodon                  62 % PQ
snac / GoToSocial /
  Friendica / Hubzilla    73 % PQ   <- Go/C-basiert
Misskey / Sharkey / ...   34 % PQ
Akkoma                     0 % PQ
Pleroma                    0 % PQ

Bei Mastodon gibt es eine große Varianz zwischen den Instanzen, weil die Ruby- und OpenSSL-Version des jeweiligen Server-Hosts entscheidet, ob PQ geht. Aktuelle Distribution mit OpenSSL 3.5 oder neuer: dabei. Noch auf OpenSSL 3.0 festhängend: nicht dabei. Der Schnitt liegt bei 62 %, was für ein so diverses Ökosystem schon erstaunlich ordentlich ist.

snac und GoToSocial liegen deutlich höher, weil sie in Go beziehungsweise C geschrieben sind und moderne TLS-Stacks mitbringen. Akkoma und Pleroma (beide Elixir/Erlang) zeigen dagegen gar keine PQ-Adoption. Das hängt an der OpenSSL-Version, die die BEAM-VM dort nutzt. Misskey und die ganzen Forks dazwischen liegen bei rund einem Drittel.

RSS-Reader, unerwartet modern

Hätte ich vorher schätzen sollen, hätte ich RSS-Reader eher am Ende dieser Liste verortet. Alte Technologie, alte Software, wahrscheinlich alter TLS-Stack. Stimmt aber nicht:

Miniflux              100 % PQ   <- Go-basiert
FreshRSS               82 % PQ
NextCloud-News         81 % PQ   <- zahlenmaessig vorn
Tiny Tiny RSS          37 % PQ
Inoreader               0 % PQ
Feedly                  0 % PQ   <- haengt auch hinten

Miniflux macht 100 % PQ, weil es in Go geschrieben ist und ab Go 1.24 MLKEM768 standardmäßig im TLS-Stack sitzt. FreshRSS und NextCloud-News laufen meist auf aktuellen PHP/curl-Umgebungen und ziehen MLKEM darüber mit. Feedly als kommerzieller Anbieter: 0 %. Also genau das Gegenteil dessen, was ich erwartet hätte. Self-Hosted ist hier eindeutig moderner unterwegs als die SaaS-Variante.

CLI-Werkzeuge und Kuriositäten

go-http-client     93 % PQ   <- Go 1.24+
curl               30 % PQ   <- je nach OpenSSL-Build
python-requests    16 % PQ
Node (axios)       61 % PQ
okhttp              0 % PQ
wget                0 % PQ
Twitterbot         97 % PQ   <- unerwartet weit vorn

Das Muster ist eigentlich immer dasselbe. Der TLS-Stack der Laufzeitumgebung entscheidet. Go ≥ 1.24 macht es automatisch, moderne Node-Versionen bringen einen aktuellen OpenSSL mit, Python und curl hängen an der Distribution. okhttp auf Android und wget: Fehlanzeige.

Kleiner Spaß am Rande. Twitterbot ist zu 97 % auf MLKEM. Also ausgerechnet der Link-Preview-Crawler von X/Twitter ist moderner unterwegs als alle anderen Social-Preview-Bots zusammen. WhatsApp: 4 %, Discord: 0 %, LinkedIn ist kaum vertreten. Warum Twitter? Keine Ahnung. Vermutlich ein moderner Go-Client unter der Haube.

TLS 1.2, wer hängt noch ganz unten?

2 % des Traffics kommen komplett mit TLS 1.2, also ohne jede Chance auf PQ. Die Top-Kandidaten sind:

vebidoobot (SEO-Spider)
Amazonbot
DotBot, MJ12bot (SEO)
theoldreader.com (RSS-SaaS)
http.rb/Mastodon auf aelteren Instanzen
ein paar vereinzelte Alt-Browser und Skype-Link-Previews

Also fast ausschließlich kommerzielle Crawler, deren TLS-Library vor der ganzen 1.3-Welle kompiliert wurde, und ein paar ältere Mastodon-Instanzen. Reale Leser sind so gut wie nicht betroffen. Wer heute einen Feed-Reader mit TLS 1.2 nutzt, hat vermutlich andere Probleme zuerst zu lösen.

Gibt es einen Trend in den 15 Tagen?

Nicht wirklich. Der PQ-Anteil pro Tag schwankt zwischen 46 % und 65 %, je nach Traffic-Mix (mehr Browser an Wochentagen, mehr Crawler nachts und am Wochenende). Einen klaren Aufwärts- oder Abwärtstrend gibt es nicht. Wir sind im Plateau. Die Browser haben den Sprung gemacht, der Rest der Welt noch nicht. Der nächste Sprung kommt, wenn die großen Crawler-Betreiber ihre Go-, Python- oder Node-Stacks aktualisieren oder OpenSSL 3.5+ in den gängigen Distributionen ankommt. Bei Debian Trixie, RHEL 10 und Ubuntu 26.04 sollte das passieren, dann reden wir in einem Jahr nochmal.

Was ich daraus mitnehme

  • Echte Besucher sind bei MLKEM768 schon sehr weit. Browser-Entwicklung funktioniert erstaunlich gut.
  • AI- und SEO-Crawler sind deutlich hinter dem, was man erwarten würde. Cutting Edge in der Marketing-Abteilung, Uralt-Stack im Maschinenraum.
  • Fediverse-Software ist so divers wie ihre Codebasen. Bei Mastodon entscheidet die Instanz, nicht die Software.
  • RSS-Reader sind unerwartet modern unterwegs. Self-Hosted schlägt SaaS auch hier.
  • Am Ende hängt fast alles an der OpenSSL-Version unter der Anwendung. Wieder mal.
  • Bingbot auf TLS 1.2 ist 2026 trotzdem noch bemerkenswert.

Was mich am meisten gefreut hat: Ich habe keinerlei Reibungsverluste gesehen. Kein Client ist wegen PQ gestolpert, keine Verbindung ist fehlgeschlagen, die vorher funktioniert hätte. Der Handshake wählt einfach die beste gemeinsame Gruppe und gut ist. Deshalb nochmal der Appell an alle, die den Einstellungs-Beitrag noch vor sich haben: Das ist wirklich ein Zweizeiler. Macht es einfach.

Nächster Check in ein paar Monaten

Ich lasse das Logging weiterlaufen und schaue in ein paar Monaten nochmal rein. Was mich besonders interessiert:

  • Wann machen OpenAI, Anthropic und Meta ihren Crawler modern? Bleibt das auf Jahre bei 0 % PQ, oder kommt da plötzlich ein Sprung?
  • Schafft es OpenSSL 3.5 in die nächsten Long-Term-Release-Linuxe, und wie schnell ziehen Mastodon-Instanzen nach?
  • Springt Googlebot irgendwann auf PQ um? Bisher nein. Wenn das kommt, dürfte das unmittelbar sichtbar sein.
  • Kommt TLS 1.3 für Amazonbot? Zumindest das wäre ein Anfang.

Siehe auch

Update Juli 2026: Was hinter der Gruppe X25519MLKEM768 steckt, die hier in rund 57 Prozent der Handshakes auftaucht, zerlege ich in einem eigenen Beitrag: X25519MLKEM768 zerlegt.

Wie immer: Bei Fragen, fragen.

Fundstücke aus dem Netz: Angie, llmfit, idiocracy.wtf und KI-Alert-Analyse

Beitragsbild: Fundstücke aus dem Netz – Angie Nginx-Fork, llmfit Hardware-Check, idiocracy.wtf und KI-gestützte Alert-Analyse für Kubernetes

Kurze Pause von den eigenen Projekten, heute kein tiefer Dive. Ein paar Fundstücke, die in den letzten Wochen offen im Browser lagen und aus unterschiedlichen Gründen hängen geblieben sind. Keine Reviews, keine lange Analyse, einfach „schaut euch das mal an“.

Angie: Nginx-Fork von den alten Entwicklern

Angie ist ein Drop-in-Ersatz für nginx, gestartet von ehemaligen nginx-Core-Entwicklern nachdem F5 den Laden übernommen hat. Konfig-Syntax 100 Prozent kompatibel, dazu out-of-the-box HTTP/3, eine REST-API für Metriken, Prometheus-Export, Docker-Integration für dynamische Upstreams und automatisches ACME-Handling ohne Certbot-Gefrickel. Ob ich hier irgendwann mal umsteige, keine Ahnung, aber im Auge behalten ist es definitiv wert.

llmfit: Welches Modell läuft eigentlich auf meiner Kiste?

llmfit ist ein kleines Terminal-Tool, das eure Hardware abklopft (RAM, VRAM, CPU, GPU) und euch sagt, welche lokalen Sprachmodelle darauf realistisch laufen. Über 400 Modelle in der Datenbank, filterbar nach Parametern, Quantisierung, Architektur und Kontextlänge, dazu automatische Runtime-Erkennung für vLLM, MLX oder llama.cpp. Spart eine Menge Zeit beim Rumprobieren, welche GGUF-Quant-Stufe jetzt noch auf die 16 GB VRAM passt.

idiocracy.wtf: Sind wir schon so weit?

idiocracy.wtf im Stil der alten „Is it weekend?“-Seiten, mit nur einer Frage: „Are We Idiocracy Yet?“. Sinnlos, minimalistisch und genau deshalb gut. Wer den Film von Mike Judge nicht kennt, unbedingt nachholen. Und wer ihn kennt, weiß schon warum hier gleichzeitig gelacht und geweint wird.

KI-gestützte Alert-Analyse für Kubernetes und CheckMK

Ein wirklich lesenswerter Beitrag von geekbundle.org: KI-gestützte Alert-Analyse für Kubernetes und CheckMK. Monitoring-Alerts gehen per Webhook an ein kleines Open-Source-Projekt, das diagnostische Daten sammelt (Prometheus-Metriken, Pod-Logs, SSH-Diagnose) und Claude für die Root-Cause-Analyse nutzt. Ergebnis kommt als Push via ntfy zurück. Sauber umgesetzt mit unprivilegiertem User, Command-Denylist und Secret-Redaction, also genau so wie man sowas bauen will. Wer sich mit Agentic-AI im Ops-Umfeld beschäftigt, findet hier einen ehrlichen, praxisnahen Einstieg.

Siehe auch

Eigene Fundstücke oder Ergänzungen zu dem was hier steht? Gerne in den Kommentaren oder per fragen.

Post-Quantum TLS für Nginx — X25519MLKEM768 auf FreeBSD 15 konfigurieren

Nachdem ich zuerst OpenSSH und dann Postfix und Dovecot mit Post-Quantum-Kryptografie ausgestattet habe, kamen einige Rückfragen: Wie sieht das eigentlich für Nginx aus? Kann man das auf dem Webserver genauso einfach aktivieren? Kurze Antwort: Ja. Noch kürzer sogar als bei E-Mail.

Nginx TLS-Konfiguration mit Post-Quantum-Key-Exchange X25519MLKEM768 für HTTPS.

Spannend finde ich dabei, dass ausgerechnet der Webserver die meisten Nachfragen erzeugt hat. SSH und E-Mail laufen hier längst mit X25519MLKEM768, aber die Leser wollten vor allem wissen, wie das für HTTPS geht. Vermutlich weil jeder eine Webseite hat, aber nicht jeder seinen eigenen Mailserver betreibt?! Es kommt ja immer darauf an, was man macht und welche Daten man übermittelt. Aber SSH oder E-Mail würde mich selbst nervöser machen als normales surfen. Wobei…. Ich melde mich ja auch an, hm. OK, immer MFA. Na, eine normale E-Mail ist ja schon immer eine Postkarte, wenn man keine zusätzliche Verschlüsselung nutzt (was kaum jemand macht).

Worum geht es?

Wer die Vorgeschichte noch nicht kennt: X25519MLKEM768 ist ein hybrider Schlüsselaustausch, der klassisches X25519 (Curve25519 ECDH) mit dem Post-Quantum-Algorithmus ML-KEM-768 kombiniert. Standardisiert vom NIST als FIPS 203. Der Vorteil des hybriden Ansatzes: Selbst wenn sich ML-KEM irgendwann als unsicher herausstellt, bleibt X25519 als Absicherung. Und andersherum genauso.

Das „Store now, decrypt later“ Szenario kennt ihr vielleicht schon aus den anderen Beiträgen. Jemand schneidet heute euren TLS-verschlüsselten Datenverkehr mit und entschlüsselt ihn in ein paar Jahren mit einem Quantencomputer. Bei HTTPS betrifft das alles, was über die Leitung geht: Formulardaten, Login-Credentials, API-Aufrufe, Session-Cookies. Ob das in der Praxis relevant ist? Kommt auf euer Bedrohungsmodell an. Aber der Aufwand für die Absicherung ist so gering, dass es keinen Grund gibt, es nicht zu tun.

Es hängt an OpenSSL, nicht an Nginx

Das ist eigentlich die zentrale Erkenntnis aus allen drei Beiträgen: Ob PQC funktioniert oder nicht, entscheidet fast ausschließlich die OpenSSL-Version. Nginx, Postfix, Dovecot, OpenSSH, sie alle delegieren den Schlüsselaustausch an OpenSSL (oder LibreSSL, BoringSSL, je nach System). Die Anwendung selbst muss lediglich die gewünschte Gruppe konfigurieren können. Und das können alle genannten Programme seit Jahren.

Konkret braucht ihr OpenSSL 3.5 oder neuer. Erst ab dieser Version ist ML-KEM nativ im Default-Provider enthalten, ohne externen OQS-Provider, ohne liboqs, ohne selbst kompilieren. FreeBSD 15 liefert das von Haus aus. Bei den meisten Linux-Distributionen sieht es Stand heute leider noch anders aus. Ubuntu 24.04 hat OpenSSL 3.0, Debian 12 hat 3.0, RHEL 9 hat 3.0. Für ein aktuelles OpenSSL müsst ihr dort entweder selbst bauen oder auf neuere Releases warten.

Voraussetzungen prüfen

Auf meinem FreeBSD 15:

$ openssl version
OpenSSL 3.5.4 30 Sep 2025 (Library: OpenSSL 3.5.4 30 Sep 2025)

Nginx muss natürlich gegen dieses OpenSSL gelinkt sein. Das prüft ihr so:

$ nginx -V 2>&1 | grep -oE 'OpenSSL [0-9]+\.[0-9]+\.[0-9]+'
OpenSSL 3.5.4

Und dann die entscheidende Frage: Kennt OpenSSL die Gruppe X25519MLKEM768?

$ openssl list -tls-groups | grep -i mlkem
  X25519MLKEM768
  SecP256r1MLKEM768
  SecP384r1MLKEM1024

Wenn X25519MLKEM768 in der Liste auftaucht, kann es losgehen.

Nginx konfigurieren

In Nginx heißt die relevante Direktive ssl_ecdh_curve. Der Name ist etwas irreführend, denn sie steuert nicht nur ECDH-Kurven, sondern alle Key-Exchange-Gruppen die OpenSSL kennt. Also auch hybride PQC-Gruppen.

Meine Konfiguration in der TLS-Defaults-Datei, die per include in alle vHosts eingebunden wird:

ssl_ecdh_curve  X25519MLKEM768:X25519:secp384r1:prime256v1;

Das war’s. Eine Zeile. X25519MLKEM768 steht als bevorzugte Gruppe ganz vorne. Dahinter folgen die klassischen Kurven als Fallback für Clients, die noch kein ML-KEM sprechen. Die Reihenfolge ist die Präferenz.

Wer die Direktive lieber pro vHost setzen möchte, statt global, kann das natürlich auch tun. Ich bevorzuge eine zentrale TLS-Datei, weil ich sonst bei jedem TLS-Update zwanzig Configs anfassen müsste.

Zusätzlich habe ich die TLS 1.3 Cipher Suites explizit gesetzt:

ssl_conf_command  Ciphersuites TLS_CHACHA20_POLY1305_SHA256:TLS_AES_256_GCM_SHA384:TLS_AES_128_GCM_SHA256;
ssl_conf_command  Options PrioritizeChaCha;

ChaCha20 als erste Wahl, weil es auf Clients ohne AES-NI (ältere Smartphones, ARM-Geräte) deutlich schneller ist. Auf Servern mit AES-NI ist der Unterschied minimal. PrioritizeChaCha sorgt dafür, dass der Server ChaCha20 bevorzugt, wenn der Client es an erster Stelle anbietet.

Die komplette TLS-Konfiguration sieht bei mir so aus:

# Protokolle
ssl_protocols              TLSv1.2 TLSv1.3;
ssl_prefer_server_ciphers  on;

# Key-Exchange-Gruppen (Reihenfolge = Präferenz)
ssl_ecdh_curve             X25519MLKEM768:X25519:secp384r1:prime256v1;

# TLS 1.3 Cipher Suites
ssl_conf_command           Ciphersuites TLS_CHACHA20_POLY1305_SHA256:TLS_AES_256_GCM_SHA384:TLS_AES_128_GCM_SHA256;
ssl_conf_command           Options PrioritizeChaCha;

# TLS 1.2 Cipher Suites (nur ECDSA, kein RSA)
ssl_ciphers                ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-ECDSA-AES128-GCM-SHA256;

# Session Handling
ssl_session_cache          shared:SSL:50m;
ssl_session_timeout        1d;
ssl_session_tickets        off;

# OCSP Stapling
ssl_stapling               on;
ssl_stapling_verify        on;

# HSTS
add_header Strict-Transport-Security "max-age=63072000; includeSubDomains; preload" always;

Danach die Konfiguration testen und Nginx neu laden:

# nginx -t
nginx: the configuration file /usr/local/etc/nginx/nginx.conf syntax is ok
nginx: configuration file /usr/local/etc/nginx/nginx.conf test is successful
# service nginx reload

Überprüfen

Funktioniert es? Mit openssl s_client lässt sich das schnell prüfen:

$ openssl s_client -connect www.kernel-error.de:443 \
    -groups X25519MLKEM768 -brief </dev/null 2>&1 | grep -E 'Protocol|group|Cipher'
Protocol version: TLSv1.3
Ciphersuite: TLS_CHACHA20_POLY1305_SHA256
Negotiated TLS1.3 group: X25519MLKEM768

TLSv1.3 mit X25519MLKEM768. Läuft. Der hybride Post-Quantum-Schlüsselaustausch ist aktiv.

Und was passiert, wenn ein Client kein ML-KEM kann?

$ openssl s_client -connect www.kernel-error.de:443 \
    -groups X25519 -brief </dev/null 2>&1 | grep -E 'Protocol|group|Cipher'
Protocol version: TLSv1.3
Ciphersuite: TLS_CHACHA20_POLY1305_SHA256

Sauberer Fallback auf X25519. Kein Fehler, keine Unterbrechung. Der Client bekommt einfach die stärkste Gruppe, die beide Seiten gemeinsam haben.

Browser-Support

Das Schöne bei HTTPS im Vergleich zu E-Mail oder SSH: Die Browser haben Post-Quantum-Kryptografie teilweise schon vor den Servern implementiert. Chrome verwendet seit Version 124 (April 2024) X25519MLKEM768 als bevorzugte Gruppe. Firefox seit Version 124 ebenfalls. Safari seit macOS 15 Sequoia und iOS 18. Edge zieht mit Chrome mit.

Wenn ihr also Nginx mit X25519MLKEM768 konfiguriert, profitieren die meisten eurer Besucher sofort davon. Ohne dass sie irgendetwas tun müssen. Das ist bei SSH und E-Mail anders, da sind die Clients noch nicht so weit. Womit sich auch erklärt, warum das Thema bei Webservern mehr Aufmerksamkeit bekommt.

HTTP/3 und QUIC

Wer wie ich HTTP/3 (QUIC) aktiviert hat, bekommt PQC dort automatisch mit. QUIC verwendet TLS 1.3 als Transportverschlüsselung und nutzt dieselbe ssl_ecdh_curve Konfiguration. Kein zusätzlicher Konfigurationsaufwand.

listen [::]:443 quic reuseport;
listen 443 quic reuseport;

Wer QUIC noch nicht nutzt: Der Overhead ist minimal, der Vorteil bei mobilen Verbindungen deutlich spürbar. Mehr dazu in meinem HTTP/3 Beitrag.

Davon abgesehen, wie ist das eigentlich mit Microsoft? Cloudflare macht ja schon knapp zu 66% PQC im HTTP Traffic. Es ist 2026, fragen wir doch mal eine AI: claude „Sag mal, wie ist das eigentlich bei Microsoft Produkten, wie Exchange oder IIS im Bezug auf PQC? Wird das schon unterstützt oder kommt das bald?“

● Gute Frage — Microsoft ist da tatsächlich in einer interessanten Position:                                                                                                                                                                                                                                                  
                 
  Windows / Schannel (TLS-Stack)                                                                                                                                                                                                                                                                                              
                  
  - Windows 11 24H2 / Windows Server 2025 haben experimentelle Unterstützung für ML-KEM (X25519MLKEM768) in TLS 1.3 bekommen — allerdings zunächst nur als Preview/Feature-Flag, nicht standardmäßig aktiv.                                                                                                                   
  - Der zugrunde liegende TLS-Stack (Schannel) muss das können, damit IIS und Exchange davon profitieren.                                                                                                                                                                                                                     

  IIS

  - IIS nutzt Schannel direkt. Sobald Schannel auf dem jeweiligen Windows Server PQC-Key-Exchange unterstützt und es aktiviert ist, kann IIS das theoretisch sofort.
  - Stand meines Wissens (Mai 2025): Noch kein produktiver PQC-Support in IIS. Die Preview in Windows Server 2025 ist eher für Tests gedacht.

  Exchange

  - Exchange Online (Microsoft 365): Microsoft hat angekündigt, PQC schrittweise in ihre Cloud-Dienste zu integrieren. Für TLS-Verbindungen zwischen Microsoft-Datacentern wurde bereits mit PQC experimentiert.
  - Exchange On-Premises: Hängt komplett am darunterliegenden Windows Server / Schannel. Solange Schannel kein produktives PQC kann, kann Exchange es auch nicht.

  Microsofts Roadmap

  - Microsoft hat ein "Quantum-Safe Program" und arbeitet aktiv an PQC-Integration in Windows, Azure und M365.
  - Die Priorität liegt auf TLS 1.3 mit ML-KEM (hybrid, also X25519MLKEM768.
  - Einen festen Zeitplan für "PQC by default" in Exchange/IIS gibt es meines Wissens noch nicht.

  Fazit

  Microsoft ist hintendran verglichen mit dem Open-Source-Stack. OpenSSL 3.5+ / LibreSSL / BoringSSL haben PQC-Support bereits produktionsreif. Bei Microsoft wartet man darauf, dass Schannel das nativ und stabil liefert — und bis das
  in Exchange On-Prem ankommt, dauert es erfahrungsgemäß nochmal länger.

  Für Exchange Online dürfte Microsoft das irgendwann einfach serverseitig einschalten, ohne dass Admins etwas tun müssen. Für On-Prem heißt es: warten auf den nächsten Windows Server Release, der PQC in Schannel GA (General Availability) hat.

  Caveat: Mein Wissensstand ist Mai 2025 — es kann sein, dass Microsoft seitdem konkretere Termine genannt hat. Wäre ggf. einen Blick in den Microsoft Security Blog wert.

Klingt gut. Ich muss ja zugeben, dass ich, seit ich nicht mehr mit Martin Peuker bei Items arbeite, irgendwie komplett von der Microsoft-Welt abgekoppelt bin. Oh, ist das jetzt korrekt von der AI? Keine Ahnung, „klingt“ richtig.

Was das nicht leistet

Den Absatz kennt ihr inzwischen aus den anderen Beiträgen, aber er gehört dazu: Wir sichern hier den Schlüsselaustausch ab, nicht die Authentifizierung. Die TLS-Zertifikate nutzen weiterhin klassische Algorithmen (in meinem Fall ECDSA P-384). Für Post-Quantum-Signaturen bräuchte man ML-DSA (ehemals CRYSTALS-Dilithium) in den Zertifikaten, aber keine öffentliche CA stellt solche Zertifikate aus. Das wird kommen, aber noch nicht heute.

In der Praxis heißt das: Ein Angreifer mit Quantencomputer könnte die Serverauthentifizierung angreifen, müsste das aber in Echtzeit tun. „Store now, decrypt later“ greift dort nicht. Der Schlüsselaustausch und damit die Vertraulichkeit eurer Daten ist durch X25519MLKEM768 geschützt. Auch in Zukunft.

Fazit

Eine Zeile in der Nginx-Konfiguration, ein Reload, fertig. Euer Webserver verhandelt danach mit jedem modernen Browser einen quantensicheren Schlüsselaustausch. Vollständig abwärtskompatibel für ältere Clients. Kein Risiko, kein Aufwand, kein Nachteil.

Die eigentliche Hürde ist nicht Nginx, sondern die OpenSSL-Version auf eurem System. Wer FreeBSD 15 oder ein System mit OpenSSL 3.5+ hat, kann sofort loslegen. Alle anderen müssen auf ihre Distribution warten oder selbst bauen.

Damit habe ich jetzt SSH, E-Mail und Webserver mit Post-Quantum-Kryptografie abgedeckt. Fehlt eigentlich nur noch DNS. Aber DoH und DoT laufen ja auch über TLS … *grübel*

Update: Inzwischen habe ich HTTPS RR und SVCB Records für alle Dienste deployt. Damit wissen Clients schon beim DNS-Lookup, dass HTTP/3 und QUIC verfügbar sind.

Update 2: Wer wissen will, ob die eigenen Besucher tatsächlich PQC nutzen: Nginx kann die ausgehandelte Key-Exchange-Gruppe loggen. Die Variable $ssl_curve zeigt pro Verbindung, ob X25519MLKEM768, klassisches X25519 oder etwas anderes verhandelt wurde. Einfach ins bestehende Log-Format einfügen, irgendwo nach $ssl_cipher:

log_format combined_pqc
  '$remote_addr - $remote_user [$time_local] '
  '"$request" $status $body_bytes_sent '
  '"$http_referer" "$http_user_agent" '
  '$ssl_protocol $ssl_cipher $ssl_curve';

Im Log sieht das dann so aus. Ein Chrome mit PQC-Support:

203.0.113.42 - - [07/Apr/2026:13:22:36 +0200] "GET / HTTP/2.0" 200 56687 "-" "Mozilla/5.0 [...] Chrome/146.0.0.0" TLSv1.3 TLS_CHACHA20_POLY1305_SHA256 X25519MLKEM768

Und ein älterer Client ohne PQC:

198.51.100.7 - - [07/Apr/2026:14:05:11 +0200] "GET / HTTP/2.0" 200 56687 "-" "Mozilla/5.0 [...] Chrome/109.0.0.0" TLSv1.3 TLS_AES_256_GCM_SHA384 X25519

Der Unterschied steht ganz am Ende: X25519MLKEM768 vs. X25519. Ein Reload, ein paar Wochen sammeln, und ihr habt echte Zahlen statt Theorie. Ich werde die Ergebnisse in einem eigenen Beitrag auswerten, sobald genug Daten zusammengekommen sind.

Update Juli 2026: Was in X25519MLKEM768 eigentlich steckt, KEM, Hybrid und die Byte-Reihenfolge, habe ich Bestandteil für Bestandteil hier zerlegt: X25519MLKEM768 zerlegt.

Wie immer: Bei Fragen, fragen.

Kernel-Error jetzt auch im Tor-Netz: meine .onion-Adresse

Kurzfassung: www.kernel-error.de ist zusätzlich als Tor Hidden Service erreichbar.
Meine .onion-Adresse: jjyvff6eh3kp7ydfkamm27cldhsee2cl6wzfa5lfjyrfyribgeaesgqd.onion

Illustration: Kernel-Error Blog als HTTPS-Website und Tor Hidden Service (.onion) mit Fokus auf Privatsphäre, ohne Exit-Node und ohne DNS-Leaks

Der ursprüngliche Beitrag war ziemlich kurz gehalten. Seither werde ich immer wieder gefragt, wie das eigentlich zusammenspielt und was man bei so einem Setup alles bedenken muss. Also habe ich ihn deutlich erweitert und versuche, den Aufbau von der Idee bis zum fertigen vHost nachvollziehbar zu machen – inklusive der Stolperfallen, die ich unterwegs eingesammelt habe.

Warum überhaupt eine Onion-Variante?

Die Seite läuft ohnehin unter HTTPS mit aktuellen Cipher-Suites, Post-Quantum Key Exchange und HSTS. Technisch gesehen passiert zwischen Besucher und Server also schon heute nichts Unverschlüsseltes. Trotzdem gibt es ein paar Gründe, die für einen zusätzlichen Hidden Service sprechen:

  • Metadaten-Minimierung: Beim Clearnet-Abruf sieht der Provider mindestens, dass jemand mit meiner IP spricht. DNS-Resolver, Transit-Router und der Exit-Punkt kennen das Ziel. Bei einem Hidden Service ist außerhalb des Tor-Netzwerks gar nichts mehr zu sehen – weder IP noch DNS-Namen.
  • Kein Exit-Node: Wer meine Seite über einen normalen Tor-Browser mit Clearnet-URL besucht, spricht am Ende über einen Exit-Node mit meinem Server. Der Exit sieht zwar nur TLS, kann aber Metadaten wie SNI oder Zielhost mitbekommen und je nach Land auch gesperrt werden. Mit einer Onion-Adresse fällt der Exit-Node komplett weg.
  • Keine CA-Abhängigkeit: Die .onion-Adresse ist der Public-Key-Hash selbst. Wer die korrekte Adresse kennt, spricht kryptografisch nachweisbar mit meinem Server – ganz ohne Zertifikatsausstellerin und ohne OCSP-Kaskade.
  • Zensurresistenz: Sollte der Clearnet-Zugang aus irgendeinem Grund blockiert sein – falsche DNS-Antworten, gesperrte IP, generelle Sperre der Domain – bleibt die Onion-Variante unabhängig davon erreichbar.
  • Spielerei und Lerneffekt: Ich finde das Konzept hinter v3-Onions schlicht spannend. Ed25519-Keys, Rendezvous-Protokoll, Introduction Points – da steckt eine Menge gut durchdachte Krypto drin, die man am eigenen Dienst deutlich besser versteht als aus Diagrammen.

Wie das Ganze aufgebaut ist

Der Blog läuft in einer FreeBSD-Jail mit Nginx, PHP-FPM und einer eigenen Tor-Instanz. Für den Hidden Service sind drei Bausteine relevant:

  • Der Tor-Daemon hält das Schlüsselmaterial und den Rendezvous-Teil. Er lauscht nicht auf einer öffentlichen IP, sondern hängt sich in das Tor-Netzwerk und meldet dort den Dienst an.
  • Nginx stellt einen eigenen vHost bereit, der ausschließlich auf einer Loopback-Adresse (127.0.0.6:80) lauscht. Öffentlich erreichbar ist dieser vHost nie – er wird ausschließlich vom lokalen Tor-Prozess angesprochen.
  • PHP-FPM liefert wie gewohnt über einen Unix-Socket die WordPress-Inhalte aus – allerdings ohne FastCGI-Cache für den Onion-Pfad. Dazu gleich mehr.

Der Vorteil dieser Trennung: Alles, was der Tor-Daemon an den Nginx weiterreicht, kommt garantiert aus dem Tor-Netzwerk. Und alles, was der Clearnet-vHost ausliefert, geht garantiert nicht über das Onion-Interface. Zwei saubere Welten, gleiche Codebasis, null Überschneidung im Cache.

Tor-Daemon: torrc

Die minimale Konfiguration für einen v3-Hidden-Service ist überraschend kurz:

HiddenServiceDir      /var/db/tor/hidden_service/
HiddenServiceVersion  3
HiddenServicePort     80 127.0.0.6:80
SocksPort             127.0.0.6:9050
Log                   notice file /var/log/tor/notices.log

Beim ersten Start legt Tor in HiddenServiceDir das komplette Schlüsselmaterial selbst an: den privaten ed25519-Schlüssel, die daraus abgeleitete hostname-Datei mit der .onion-Adresse und ein paar weitere Dateien für die Introduction-Points. Diese Dateien sind privilegiert – wer sie hat, kann den Dienst übernehmen und sich gegenüber der Welt als mein Server ausgeben. Entsprechend gehören sie dem _tor-User, haben mode 700 und sind im Backup separat behandelt.

Die Adresse selbst ist 56 Zeichen lang und wird aus dem ed25519-Public-Key abgeleitet. Aenderbar ist sie nicht – wer eine bestimmte Wunschadresse will, muss mit Tools wie mkp224o so lange Schlüssel durchprobieren, bis der Base32-Prefix passt. Hat mich nicht gereizt, dafür ist meine Adresse eben zufällig.

Nginx-vHost für den Onion-Service

Der eigentliche vHost ist bewusst klein gehalten. Kein Cache, kein TLS, keine QUIC-Spielereien – alles, was spezifisch für den Clearnet-Teil ist, fehlt hier:

server {
    listen 127.0.0.6:80;
    server_name jjyvff6eh3kp7ydfkamm27cldhsee2cl6wzfa5lfjyrfyribgeaesgqd.onion;

    root  /usr/local/www/www.kernel-error.de;
    index index.php index.html index.htm;

    # access/error-logs per Default aus (keine Besucher-Spuren im Dateisystem).
    # Nur bei Bedarf zu Debugging-Zwecken aktivieren und später wieder aus.
    #access_log /var/log/nginx/www-kernel-error-de-access_tor.log combined;
    #error_log  /var/log/nginx/www-kernel-error-de-error_tor.log;

    add_header X-Robots-Tag      "noarchive, noimageindex" always;
    add_header Permissions-Policy "interest-cohort=()"    always;

    location / {
        try_files $uri $uri/ /index.php?$args;
    }

    location ~* \.(css|gif|ico|jpeg|jpg|js|png|svg|webp|woff2?)$ {
        access_log off;
        expires 30d;
        add_header Cache-Control "public";
        try_files $uri =404;
    }

    location ~ \.php$ {
        try_files $uri =404;
        fastcgi_split_path_info ^(.+\.php)(/.+)$;
        fastcgi_pass unix:/var/run/php-fpm.sock;
        fastcgi_index index.php;

        include fastcgi_params;
        fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name;
        fastcgi_param PATH_INFO       $fastcgi_path_info;

        # Cache hart deaktivieren - kein gemeinsamer Pool mit dem Clearnet-vHost
        fastcgi_no_cache      1;
        fastcgi_cache_bypass  1;
    }
}

Ein paar Punkte sind bewusst so gewählt:

  • listen 127.0.0.6:80: Die Adresse ist frei wählbar innerhalb von 127.0.0.0/8, muss aber mit dem HiddenServicePort in der torrc übereinstimmen. Ich nehme bewusst nicht 127.0.0.1, damit der Onion-Listener klar vom Standard-Loopback zu unterscheiden ist – hilft beim Debugging und bei sockstat.
  • Kein TLS: Zwischen Tor-Daemon und Nginx liegt nur die Loopback-Schnittstelle, dafür braucht es kein Zertifikat. Und .onion-Zertifikate gibt es nur über kommerzielle CAs (Extended Validation), Let’s Encrypt stellt keine aus. Der eigentliche Schutz auf dem Draht kommt komplett aus dem Tor-Protokoll – End-to-End verschlüsselt vom Tor-Client bis hier zur Loopback-Adresse.
  • Getrennte Logs (per Default aus): Im Normalbetrieb sind access_log und error_log im Onion-vHost auskommentiert – so entstehen erst gar keine Dateien mit IP-, User-Agent- oder Pfad-Informationen der Onion-Besucher. Zum Debugging lassen sich die beiden Zeilen kurz einkommentieren, danach bewusst wieder aus. Wichtig ist auf jeden Fall, dass Clearnet- und Onion-Zugriffe nie im gleichen Logfile landen – über Zeitstempel und User-Agent-Muster ließen sich sonst leicht Korrelationen bilden.
  • X-Robots-Tag: noarchive, noimageindex verhindert, dass Suchmaschinen die Onion-Variante cachen oder Bilder indexieren. noindex setze ich bewusst nicht – wer die Onion-Adresse kennt, darf sie auch in Verzeichnissen auftauchen lassen.
  • Permissions-Policy: interest-cohort=() schaltet Googles FLoC-/Topics-API explizit aus. Für einen Privacy-Blog im Tor-Netz ist das eher symbolisch, schadet aber nicht.

Der Knackpunkt: Cache-Isolation

Der Clearnet-vHost nutzt einen FastCGI-Cache (fastcgi_cache_path), damit WordPress nicht jede Seitenauslieferung neu rendern muss. Das ist für einen Blog mit statischen Inhalten ein riesiger Performance-Boost. Genau dieser Cache ist aber auch der Punkt, an dem man sich beim Onion-Betrieb ins Knie schießen kann.

Wenn der Onion-vHost denselben Cache-Pool verwenden würde, könnten zwei unerwünschte Effekte auftreten:

  • Cross-Origin-Leakage im HTML: WordPress baut absolute Links anhand der siteurl/home-Option. Die steht auf https://www.kernel-error.de. Wenn eine Clearnet-Anfrage cached, landen in jedem Link Clearnet-URLs im Cache-Eintrag. Liefert der Onion-vHost dann dieselbe Seite aus dem Cache, sieht der Tor-Besucher eine Seite voller Clearnet-Links – und jeder Klick würde ihn aus dem Hidden Service hinauskatapultieren.
  • Fingerprinting über Cache-Keys: Abhängig davon, wer die Seite zuerst aufgerufen hat, liefert der Cache deterministisch „warme“ oder „kalte“ Antworten. Ein Angreifer, der beide Varianten beobachtet, kann Rückschlüsse ziehen. Klein, aber unnötig.

Die Lösung ist bewusst stumpf: Der Onion-vHost bekommt gar keinen fastcgi_cache_path-Verweis. Zusätzlich stehen im location ~ \.php$-Block die beiden Schalter fastcgi_no_cache 1 und fastcgi_cache_bypass 1, damit selbst bei versehentlich geerbter Konfiguration weder gelesen noch geschrieben wird. Jeder Request rendert frisch durch den FPM.

Bei der Besucher-Zahl über den Hidden Service ist das unkritisch. Die Clearnet-Seite bleibt gleichzeitig durch ihren eigenen Cache schnell – beide Welten profitieren von ihrer jeweils passenden Strategie.

Der Onion-Location-Header und die Meldung im Tor Browser

Damit Besucher überhaupt erfahren, dass es eine Onion-Variante gibt, setzt der Clearnet-vHost zwei zusätzliche Header:

add_header Onion-Location "http://jjyvff6eh3kp7ydfkamm27cldhsee2cl6wzfa5lfjyrfyribgeaesgqd.onion$request_uri" always;
add_header Alt-Svc        'http="jjyvff6eh3kp7ydfkamm27cldhsee2cl6wzfa5lfjyrfyribgeaesgqd.onion:80"; ma=86400' always;

Der Onion-Location-Header ist ein vom Tor-Project definiertes Signal. Ruft man den Blog im Tor Browser (Version 9.5 oder neuer) über die Clearnet-Adresse auf, blendet der Browser eine unauffällige „.onion available“-Schaltfläche in der URL-Leiste ein und bietet an, auf die Hidden-Service-Variante umzuschalten. Das ist die „Meldung“, die einige irritiert: Sie kommt nicht von meiner Seite, sondern direkt vom Tor Browser, der den Header interpretiert.

Wichtig dabei: Der Tor Browser akzeptiert den Header nur, wenn ein paar Bedingungen erfüllt sind. Das verhindert, dass ein kompromittierter Server Besucher auf fremde Hidden Services umlenken kann:

  • Die Ursprungsseite muss per HTTPS ausgeliefert worden sein.
  • Die im Header angegebene .onion-Adresse muss wohlgeformt sein (v3, 56 Zeichen, Base32).
  • Die Nutzerin muss die Umleitung aktiv bestätigen – es gibt keine automatische Weiterleitung.

Der Alt-Svc-Header (RFC 7838) ist die generische Variante. Einige alternative Clients nutzen ihn, um Alternative-Services im Hintergrund vorzumerken. Für den Tor Browser ist primär der Onion-Location-Header relevant, Alt-Svc ist eher Absicherung.

DNS als zusätzliche Verifikation

Ein Header auf der Seite ist eine gute Sache – wer dem Server vertraut, bekommt den Hinweis auf den Onion-Service. Was aber, wenn jemand meine Angabe kontrollieren will, ohne die Seite selbst aufgerufen zu haben?

Dafür habe ich einen einfachen TXT-Record im DNS hinterlegt:

dig +short TXT www.kernel-error.de
"onion=jjyvff6eh3kp7ydfkamm27cldhsee2cl6wzfa5lfjyrfyribgeaesgqd.onion"

Das Format onion=… ist kein offizieller Standard, sondern meine persönliche Konvention. Es gibt einen Internet-Draft von Alec Muffett (draft-muffett-same-origin-onion-v2), der einen ähnlichen Ansatz beschreibt, aber als RFC nie durchgegangen ist. Bis sich etwas Standardisiertes etabliert, bleibe ich bei meinem einfachen Ansatz: Wer wissen will, ob die Onion-Adresse wirklich zu mir gehört, vergleicht den Header, den TXT-Record und meine öffentlichen Ankündigungen. Die Zone selbst ist DNSSEC-signiert, der TXT-Record ist also nicht spürbar manipulierbar, solange der Resolver DNSSEC validiert.

Wem das zu wacklig ist: Für .onion gibt es auch kommerzielle Zertifikate (DigiCert stellt EV-Zertifikate für Onion-Services aus). Damit könnte man die Onion-Seite zusätzlich hinter HTTPS legen und in der Tor-Browser-URL-Leiste wäre die Organisation sichtbar. Für einen privaten Blog ist der Aufwand und die Kosten aber deutlich höher als der Nutzen.

Warum kein TLS-Zertifikat nötig ist

Der Punkt irritiert am Anfang fast jeden: Eine Webseite ohne HTTPS, im Jahr 2026, fühlt sich einfach falsch an. Wenn man sich aber anschaut, wofür TLS im Clearnet eigentlich da ist, wird schnell klar, warum es bei einem Tor Hidden Service tatsächlich überflüssig ist.

TLS erfüllt zwei Aufgaben gleichzeitig:

  • Vertraulichkeit auf der Leitung: Niemand zwischen Client und Server soll mitlesen können – weder der ISP, noch das WLAN im Cafe, noch ein Transit-Provider.
  • Identitätsnachweis des Servers: Der Client muss sicher sein können, dass er tatsächlich mit dem Server spricht, der hinter dem Domainnamen steht. Diese Aufgabe übernimmt die CA-Kette, die das Zertifikat an den DNS-Namen bindet.

Bei einem Tor Hidden Service sind beide Aufgaben bereits in das Protokoll selbst eingebaut – ohne dass irgendwo ein Zertifikat im Spiel wäre:

  • Vertraulichkeit kommt aus dem Tor-Tunnel: Der Datenstrom zwischen Client und Hidden Service lauft durch mehrere übereinander gelegte Verschlüsselungsschichten. Jedes Relay kann nur die eigene Schicht entfernen und sieht dadurch nur das nächste Ziel, nicht den Inhalt und auch nicht den gesamten Pfad. Auf dem Draht ist der Traffic zu keinem Zeitpunkt im Klartext zu sehen – ein zusätzliches TLS würde dieselbe Eigenschaft nur ein zweites Mal liefern.
  • Authentizität steckt in der Adresse: Die 56 Zeichen einer v3-Onion sind keine willkürliche Zeichenfolge, sondern die Base32-Darstellung eines ed25519-Public-Keys (plus Checksumme und Versionsbyte). Beim Verbindungsaufbau fordert der Tor-Client vom Server eine Signatur an und prüft sie gegen genau diesen Public-Key. Passt sie nicht, kommt keine Verbindung zustande. Damit übernimmt die Adresse selbst die Rolle, die im Clearnet das Zertifikat spielt – nur dass hier keine CA existieren muss, die das beglaubigt.

Anders formuliert: Der Hidden Service ist von der ersten Byte an selbst-authentisierend. Die Sicherheitsgarantie steht und fällt mit der korrekten Onion-Adresse, nicht mit einem Dritten, der sie beglaubigen müsste. Deshalb hat Let’s Encrypt für .onion-Adressen bewusst nie Zertifikate ausgestellt – es gibt schlicht nichts, was eine CA hier noch verifizieren könnte, was nicht schon durch die Adresse selbst belegt wäre.

Den einzigen verbleibenden Nutzen eines Zertifikats – das sichtbare Organisationskürzel in der Tor-Browser-URL-Leiste bei EV-Zertifikaten – kann man sich für einen privaten Blog guten Gewissens sparen.

Firewall und Systemhärtung

Die schöne Eigenschaft eines Hidden Service: Es muss kein zusätzlicher Port nach außen geöffnet werden. Der Tor-Prozess baut nur ausgehende Verbindungen auf, der Nginx-Onion-vHost lauscht nur auf der Loopback-Adresse. Aus Sicht einer Firewall ändert sich durch den Hidden Service gar nichts.

Trotzdem gibt es ein paar Punkte, die ich bewusst setze:

  • Jail-Isolation: Tor und Nginx laufen in derselben FreeBSD-Jail. Die Jail hat nur die öffentliche IP für den Clearnet-Nginx und separate Loopback-Adressen für interne Dienste. Dadurch kann der Tor-Prozess nicht „aus Versehen“ auf andere Dienste zugreifen – und er teilt sich seinen Kernel-Namespace nur mit dem, was ich bewusst in dieselbe Jail gelegt habe.
  • Dateirechte: /var/db/tor/hidden_service/ gehört dem _tor-User, mode 700. Das private Schlüsselmaterial muss genauso behandelt werden wie ein TLS-Private-Key – wer es hat, kann meine .onion übernehmen.
  • WordPress-Härtung: Der Login (wp-admin, wp-login.php) wird über das Plugin WPS Hide Login auf eine nicht-offensichtliche URL gelegt und ist ohnehin nur via Clearnet mit HTTPS erreichbar. Im Onion-vHost wird die Login-URL weder verlinkt noch erwähnt. Administration findet ausschließlich über die Clearnet-Variante statt.
  • Keine Log-Korrelation: Die getrennten Access-Logs habe ich schon erwähnt. Zusätzlich analysiere ich sie separat und führe keine IPs aus dem Clearnet-Log mit dem Onion-Log zusammen. Das wäre technisch möglich, würde aber den Sinn des Setups konterkarieren.
  • Keine externen Ressourcen: Das Theme und die eingebundenen Plugins laden keine Fonts von Google, keine Scripts von CDNs, keine Gravatare aus der Welt. Wenn ein Element doch mal nach www.kernel-error.de auflaufen sollte (etwa durch ein falsch konfiguriertes Plugin), würde der Tor Browser das als Mixed-Origin-Request anzeigen und viele Nutzerinnen würden es nicht mehr laden – das fällt dann schnell auf und ich fixe es.

Warum das als „sicher“ gilt

„Sicher“ ist immer relativ – gegenüber welchem Angreifer, unter welchem Modell? Ein paar Eigenschaften kann man aber konkret benennen:

  • End-to-End verschlüsselt: Tor baut zwischen Client und Hidden Service einen dreistufigen Tunnel durch Rendezvous- und Introduction-Points. Keiner der Zwischenknoten sieht, wer mit wem spricht oder was übertragen wird. Auf dem Draht sieht außerdem niemand eine .onion-Adresse – die Rendezvous-Logik wählt den Zielknoten indirekt.
  • Kryptografische Authentizität der Adresse: Die 56 Zeichen der v3-Onion sind der Base32-codierte ed25519-Public-Key samt Checksumme und Versionsbyte. Wer die richtige Adresse getippt oder kopiert hat, landet kryptografisch garantiert auf dem Server, der den zugehörigen privaten Schlüssel hat. Keine CA, kein DNS, kein Zwischenhändler kann das verändern, ohne dass die Adresse anders aussieht.
  • Kein TLS nötig: Verschlüsselung kommt aus dem Tor-Tunnel, Authentizität aus der Adresse selbst. Details dazu stehen weiter oben im eigenen Abschnitt – kurz: TLS würde die Eigenschaften nicht ergänzen, sondern nur doppeln.
  • Anonymität der Besucher: Der Server sieht keine echte Client-IP, nur einen Rendezvous-Punkt im Tor-Netz. Zensur und Traffic-Analyse auf dem letzten Stück entfallen vollständig.
  • Vertraulichkeit für mich: Der Server ist nicht öffentlich erreichbar, es gibt keinen offenen Port, den man mit nmap finden könnte. Die öffentliche IP des Servers ist durch die Tor-Rendezvous-Logik nicht aus dem Netzwerkverkehr ableitbar, solange ich nicht durch Fehlkonfiguration (etwa hart verlinkte Clearnet-URLs im HTML) Hinweise leake.

Stolperfallen und was man besser lässt

  • WordPress-URLs: siteurl und home bleiben auf der Clearnet-URL. Einige Anleitungen empfehlen, bei Aufruf der Onion-Variante die URL dynamisch umzuschreiben. Das habe ich bewusst nicht gemacht – es führt zu kaputten Canonical-Links, mischt Content- und Admin-Bereich und bricht meist den Blöck-Editor. Stattdessen akzeptiere ich, dass im Onion-HTML auch mal eine Clearnet-Link vorkommt (etwa im Footer), und setze darauf, dass der Tor Browser korrekt warnt, bevor er dort hinschickt.
  • Externe Embeds: YouTube-Videos, Twitter-Embeds, Gravatare – alles Dinge, die eine Onion-Seite sofort deanonymisieren könnten, wenn sie geladen würden. Das Theme und die Plugins auf diesem Blog laden bewusst keine externen Ressourcen.
  • Redis/Object-Cache: Der Object-Cache speichert keine gerenderten HTML-Seiten, sondern nur WP-interne Objekte. Hier ist die Vermischung unkritisch, weil die resultierenden URLs erst beim Rendern (durch den jeweiligen vHost) entstehen.
  • FastCGI-Cache: Wie oben beschrieben – für die Onion-Variante komplett deaktiviert. Wer es trotzdem aktivieren will, braucht zwingend einen eigenen fastcgi_cache_path, eigenes Key-Schema und muss den Host-Teil im Cache-Key haben.
  • Monitoring: Klassische Uptime-Checks von außen funktionieren auf .onion-Adressen nicht ohne weiteres. Dienste wie Uptime-Kuma können inzwischen Tor-Proxy nutzen, ansonsten hilft ein kleiner curl --socks5-hostname-Check.

Was man noch härter machen kann

Für meinen privaten Blog halte ich das beschriebene Setup für ein solides Minimum. Wer seinen Hidden Service strenger absichern will – etwa weil dort Whistleblower-Material, Redaktions-Inhalte oder andere wirklich schutzwürdige Dinge liegen – sollte ein paar zusätzliche Punkte beachten:

  • Zusätzliche HTTP-Header: Referrer-Policy: no-referrer verhindert, dass beim Klick auf einen externen Link die .onion-URL als Referer mitgeschickt wird. Content-Security-Policy (restriktiv, z. B. default-src 'self'; img-src 'self' data:;) blockt Mixed-Origin-Requests hart, bevor der Browser sie überhaupt versucht. Dazu X-Content-Type-Options: nosniff und X-Frame-Options: DENY, damit Clickjacking und MIME-Sniffing ausgeschlossen sind.
  • server_tokens off: Im Haupt-vHost ist der Nginx-Version-String schon länger abgeschaltet und durch einen eigenen Custom-Header ersetzt. Im Onion-vHost gehört server_tokens off; genauso rein – ohne das steht die Nginx-Version in jeder 404-Seite und erleichtert Fingerprinting.
  • Tor-Daemon härten: Sandbox 1 in der torrc aktiviert unter FreeBSD Capsicum und unter Linux Seccomp-Filter. Damit bekommt der Tor-Prozess nur die Syscalls, die er wirklich braucht. Zusätzlich lässt sich mit HiddenServiceEnableIntroDoSDefense 1 sowie HiddenServiceEnableIntroDoSRatePerSec und HiddenServiceEnableIntroDoSBurstPerSec ein integrierter DoS-Schutz am Introduction-Point aktivieren – seit Tor 0.4.2 gibt es das als Plugin-freie Bordmittel.
  • Client Authorization: Für wirklich nicht-öffentliche Dienste kennt Tor einen Mechanismus, bei dem nur Clients mit passendem x25519-Key-Paar den Hidden Service überhaupt erreichen. Die Adresse ist dann zwar im Tor-Netz bekannt, ohne die Private-Key-Datei auf dem Client kommt man aber keinen Zentimeter weit. Für einen öffentlichen Blog unpassend, für ein Journalisten-Dropbox-Setup die wichtigste Absicherung überhaupt.
  • Offline-Backup der Hidden-Service-Keys: Wenn der Inhalt von /var/db/tor/hidden_service/ verloren geht, ist die .onion-Adresse weg – es gibt keinen Weg, sie wiederherzustellen. Das private Schlüsselmaterial gehört deshalb auf einen verschlüsselten Offline-Datenträger und sollte genauso behandelt werden wie ein TLS-Root-Key. Wer die Adresse überträgt, überträgt gleichzeitig die Fähigkeit, sie zu betreiben – das ist nichts, was in einem Cloud-Backup liegen sollte.
  • Jail-/Container-Trennung von Tor und Web: Aktuell laufen Tor-Daemon und Nginx in derselben FreeBSD-Jail, weil sie über die Loopback-Adresse sowieso miteinander sprechen müssen. Wer paranoider sein will, packt den Tor-Prozess in eine eigene Jail mit eigener Loopback-IP und forwardet nur den HiddenService-Port – dann kann ein kompromittierter WordPress-Prozess nicht mal versehentlich an die Schlüsseldateien. Für mich persönlich ist der Aufwand zurzeit nicht gerechtfertigt, für einen Hochrisiko-Service aber eine ernsthafte Option.
  • Ehrliche Einschätzung zur Anonymität des Betreibers: Wer einen Hidden Service betreibt, um die eigene Identität zu schützen, muss auch alles drumherum sauber haben – Domain-Whois, Zertifikats-SANs auf dem Clearnet-Host, Uptime-Monitoring, Backups, Zeitstempel in Git-Commits, selbst die Systemzeit auf dem Server. Die .onion-Adresse alleine macht den Betreiber nicht anonym. Sie ist ein Baustein, kein Gesamtkonzept.

Für diesen Blog ist das bewusst nicht alles umgesetzt. Ich veröffentliche unter Klarnamen und möchte nur die Daten meiner Besucher besser schützen. Für jemanden, der aus guten Gründen wirklich anonym bleiben muss, sind die Punkte oben Pflicht, nicht Kür.

Fazit

Ein Tor Hidden Service für einen bestehenden WordPress-Blog ist überraschend geradlinig aufzusetzen. Die technische Umsetzung umfasst im Kern einen Tor-Daemon mit v3-Konfiguration, einen getrennten Nginx-vHost ohne HTTPS und ohne FastCGI-Cache, sowie zwei Header im Clearnet-vHost. Der Aufwand bleibt überschaubar, der Gewinn an Erreichbarkeit und Metadaten-Minimierung ist messbar.

Wer die Adresse im Tor Browser aufruft, bekommt exakt den gleichen Blog zu sehen – nur ohne TLS-Handshake, ohne Exit-Node und ohne Spur im eigenen DNS-Resolver. Die Seite wird nicht häufig aus dem Tor-Netz aufgerufen, aber sie ist für die Fälle da, in denen sie gebraucht wird. Und ehrlich gesagt: Es macht auch einfach Spaß, ein System so zu bauen, dass beide Welten sauber nebeneinander existieren.

Siehe auch: HTTP/3 und QUIC, Post-Quantum TLS für Nginx, TLS-ECDHE einfach erklärt

Fragen? Einfach melden.

WordPress wp-cron.php: Ist die angebliche Sicherheitslücke real?

Picture of an hacker checken for wordpress vulnerability

In letzter Zeit begegnen mir immer wieder sogenannte „Vulnerability Report Scams“. Klar, mit Angst und Unwissenheit kann man Geld verdienen, also wird es auch jemand tun. Besonders fällt mir das im Zusammenhang mit der wp-cron.php auf.

Ich habe häufig Reports gesehen, die in etwa so aussehen:

Critical Vulnerability Report- {Critical BUG #P1} - https://www.example.com/ - vulnerable to attack via wp-cron.php

Hello  Security team,

I am a Security Engineer, Cyber Security Researcher, Bug Bounty Hunter  & Ethical Hacker. While testing your domain https://www.example.com/ I have found some important vulnerabilities in your site.

Vulnerability Name:   https://www.example.com/  -  vulnerable to DoS attack via wp-cron.php

Vulnerable Domain:  https://www.example.com/wp-cron.php

Description:

The WordPress application is vulnerable to a Denial of Service (DoS) attack via the wp-cron.php script. This script is used by WordPress to perform scheduled tasks, such as publishing scheduled posts, checking for updates, and running plugins.
An attacker can exploit this vulnerability by sending a large number of requests to the wp-cron.php script, causing it to consume excessive resources and overload the server. This can lead to the application becoming unresponsive or crashing, potentially causing data loss and downtime.

I found this vulnerability at https://www.example.com/wp-cron.php endpoint.

Steps to Reproduce: reference- https://hackerone.com/reports/1888723

navigate to: https://www.example.com/wp-cron.php
intercept the request through the burp suite
right click on the request and send it to the repeater
Now send a request, and you will see the response as  200 OK

---

this can be also done by the curl command given below

curl -I "https://www.example.com/wp-cron.php"

POC: Attached

Impact:

If successful, this misconfigured wp-cron.php file can cause lots of damage to the site, such as:

Potential Denial of Service (DoS) attacks, resulting in unavailability of the application.
Server overload and increased resource usage, leading to slow response times or application crashes.
Potential data loss and downtime of the site.
Hackers can exploit the misconfiguration to execute malicious tasks, leading to security breaches.

Exploitation:
Exploitation can be done through a GitHub tool called doser.go https://github.com/Quitten/doser.go
I did not do that as this can impact your website.
Get the doser.py script at https://github.com/Quitten/doser.py
Use this command to run the script: python3 doser.py -t 999 -g 'https://www.example.com/wp-cron.php'
Go after https://www.example.com/ 1000 requests of the doser.py script.
The site returns code 502.

Suggested Mitigation/Remediation Actions:

To mitigate this vulnerability, it is recommended to disable the default WordPress wp-cron.php script and set up a server-side cron job instead. Here are the steps to disable the default wp-cron.php script and set up a server-side cron job:
Access your website's root directory via FTP or cPanel File Manager.
Locate the wp-config.php file and open it for editing.
Add the following line of code to the file, just before the line that says "That's all, stop editing! Happy publishing.":

1define('DISABLE_WP_CRON', true);

Save the changes to the wp-config.php file.
Set up a server-side cron job to run the wp-cron.php script at the desired interval. This can be done using the server's control panel or by editing the server's crontab file.
References:

For more information about this vulnerability, please refer to the following resources:

https://hackerone.com/reports/1888723

https://medium.com/@mayank_prajapati/what-is-wp-cron-php-0dd4c31b0fee

Cron
Fix Them ----- I have protected your company and saved it from a big loss so give me some appreciation Bounty Reward. I am sharing my PayPal ID with you. Paypal ID: woop woop Current Market Value Minimum Bounty Reward for Critical BUG P1 Type. The bug I reported is part of type P1 Vulnerability severity Bug bounty reward amount (in USD) P1 (Critical) $2500 P2 (High) $1500 P3 (Medium) $1000 P4 (Low) $500 Please feel free to let me know if you have any other questions or need further information. I am happy to secure it. I hope this will be fixed soon. Feel free to let me know if you have any other questions. Thanks & Regards

Ist das nun ein echtes Problem oder nicht?

Ja und Nein. In der Nachricht wird korrekt beschrieben, was die wp-cron.php tut und warum sie wichtig ist. Auch die Tatsache, dass sie extern unendlich oft aufgerufen werden kann und dadurch potenziell eine Überlastung auslösen könnte, ist nicht falsch. Selbst der Tipp, auf eine lokale Crontab-Version umzusteigen, ist nicht verkehrt. Allerdings muss man das Ganze in den richtigen Kontext setzen: wp-cron.php ist standardmäßig in WordPress aktiviert und wird für geplante Aufgaben genutzt. Die geplanten Aufgaben werden in der Datenbank abgelegt. Gibt es etwas zu tun und die wp-cron.php wird aufgerufen, dann wird auch gearbeitet. Gibt es nichts zu tun, dann gibt es auch keine Arbeit. Die Empfehlung, sie zu deaktivieren und durch einen serverseitigen Cron-Job zu ersetzen, ist eher eine Performance-Optimierung als eine echte Sicherheitsmaßnahme.

Es handelt sich nicht um einen Zero-Day-Exploit und es gibt keine direkte Gefahr eines Datenabflusses. Falls es wirklich zu Performance-Problemen kommt, gibt es einfache Gegenmaßnahmen. Sollte tatsächlich jemand versuchen, die wp-cron.php gezielt anzugreifen, hilft ein simples Rate Limiting, entweder über die Firewall oder direkt mit mod_security (Apache) bzw. limit_req (nginx).

Rate Limiting mit nginx

limit_req_zone $binary_remote_addr zone=cronlimit:10m rate=1r/s;

server {
    location = /wp-cron.php {
        limit_req zone=cronlimit burst=3 nodelay;
        limit_req_status 429;
    }
}

Das begrenzt die Anfragen auf 1 pro Sekunde, mit maximal 3 Anfragen in kurzer Zeit.

Sollte man wp-cron.php deaktivieren?

Nicht unbedingt. Klar, im Fall eines Angriffs kann das als erste Maßnahme helfen. Besser ist es aber, wp-cron.php lokal auszuführen und den Zugriff darauf über den Webserver auf bestimmte IP-Adressen zu beschränken. Anschließend kann man einen Cronjob anlegen, der alle 15 Minuten ausgeführt wird:

*/15 * * * * wget -q -O - https://www.example.com/wp-cron.php?doing_wp_cron >/dev/null 2>&1

Zugriff per nginx einschränken:

location ~* ^/wp-cron.php$ {
    allow 1.2.3.4;  # Ersetze mit deiner IP
    deny all;
}

Fazit

Das ist ganz sicher kein P1-Bug. Und wenn der Report direkt eine Preistabelle mitliefert, ist das schon ein ziemlich eindeutiges Zeichen für einen Scam.

  • Ja, wp-cron.php könnte unter bestimmten Umständen zu Problemen führen.
  • Nein, es ist kein echter Sicherheits-Bug.
  • Wer weiß, was er tut, hat bereits die richtigen Maßnahmen getroffen.

Keine Panik. Stattdessen lieber kurz die eigene Konfiguration prüfen und gut ist. Wer auf das nginx Rate Limit setzt und dieses testen möchte, kann mein rate_limit_test.sh auf GitHub nutzen.

Siehe auch: Ist mein Netzwerk kompromittiert?

Fragen? Einfach melden.

Jetzt mit HTTP/3 und QUIC: Schnelleres Surfen leicht gemacht

Von QUIC habt ihr sicher alle schon gehört, seit knapp Mitte 2021 ist dieser neue Standard fertig und in einem recht einfach zu merkendem RFC 9000 beschrieben.

Im Grunde geht es darum, HTTP-Verbindungen schneller zu machen und dabei sogar UDP zum Einsatz zu bringen. Nicht ganz korrekt ist es einfach eine Weiterentwicklung von SPDY.

Um zu testen, ob eine Webseite bereits HTTP/3 also QUIC unterstützt, kann ich euch http3check.net ans Herz legen. Diese gibt, wenn gewünscht, sogar noch ein paar Detailinformationen aus.

Wer sehen möchte, ob sein Browser QUIC „macht“, kann auch nginx.org nutzen. Steht oben „Congratulations! You’re connected over QUIC.“ Dann ist man ein Gewinner.

Die Konfiguration am Nginx ist wie immer sehr einfach und ein sehr gutes Beispiel findet sich direkt von nginx.

Mein Nginx spricht dieses nun ebenfalls, mal sehen ob es Probleme gibt.


Update März 2026: Drei Jahre HTTP/3 im Betrieb

Es sind jetzt gut drei Jahre vergangen und ich kann sagen: Es gab keine Probleme. Kein einziges. HTTP/3 läuft hier seit 2022 auf allen vHosts und ich habe nie einen Fehler gesehen, der auf QUIC zurückzuführen war. Auch in den Logfiles nichts Auffälliges.

Illustration zu HTTP/3 und QUIC: schneller Web-Transport über UDP mit moderner Verschlüsselung und Browser-Support

Was sich geändert hat: Damals war HTTP/3 in Nginx noch experimentell und brauchte einen separaten Build mit dem quiche-Patch oder BoringSSL. Seit Nginx 1.25.0 (Mai 2023) ist HTTP/3 offiziell im Mainline-Branch enthalten und wird mit dem normalen --with-http_v3_module Build-Flag aktiviert. Kein Patch mehr, kein BoringSSL mehr, einfach OpenSSL 3.x und fertig. Mein aktueller Stack: Nginx 1.29.4 mit OpenSSL 3.5.4 auf FreeBSD 15.

Was bringt HTTP/3 in der Praxis?

Der größte Vorteil von QUIC gegenüber TCP ist die Verbindungsaufbauzeit. Bei TCP+TLS braucht ihr mindestens zwei Roundtrips, bevor Daten fließen (TCP Handshake + TLS Handshake). QUIC macht das in einem einzigen Roundtrip. Bei einem Wiederverbindungsversuch sogar in null Roundtrips (0-RTT).

Auf einer Glasfaserleitung mit 5 ms Latenz merkt ihr das kaum. Aber auf einem Smartphone im Zug mit 80 ms Latenz und gelegentlichem Paketverlust macht das einen spürbaren Unterschied. Dazu kommt, dass QUIC auf UDP basiert und damit das Head-of-Line-Blocking Problem von TCP löst: Ein verlorenes Paket blockiert nicht mehr alle Streams, sondern nur den einen betroffenen.

Konfiguration 2026

Die Konfiguration hat sich seit 2022 etwas verändert. Hier mein aktuelles Setup für den Blog-vHost:

server {
    listen [::]:443 ssl;
    listen [::]:443 quic;

    http2 on;

    server_name  www.kernel-error.de;

    # TLS (wird per include eingebunden)
    include tls-default.conf;
    ssl_certificate      /path/to/fullchain.pem;
    ssl_certificate_key  /path/to/privkey.pem;

    # ...
}

Wichtig sind zwei Dinge. Erstens: Der quic Listener läuft auf demselben Port 443 wie der SSL-Listener, nur eben über UDP statt TCP. Zweitens: Die Clients müssen wissen, dass HTTP/3 verfügbar ist. Das passiert über den Alt-Svc Header:

add_header Alt-Svc 'h3=":443"; ma=86400' always;

Dieser Header sagt dem Browser: „Ich spreche auch h3 auf Port 443, merk dir das für 24 Stunden.“ Beim nächsten Besuch nutzt der Browser dann direkt QUIC. Ohne diesen Header bleibt alles bei HTTP/2 über TCP.

Optional könnt ihr auch einen HTTPS-DNS-Record (SVCB) setzen, damit der Browser schon beim DNS-Lookup weiß, dass HTTP/3 verfügbar ist:

$ dig +short HTTPS www.kernel-error.de
1 . alpn="h3,h2" ipv4hint=148.251.30.200 ipv6hint=2a01:4f8:262:4716::443

Mit alpn="h3,h2" im HTTPS-Record kann der Browser die QUIC-Verbindung schon beim allerersten Besuch aufbauen, ohne erst auf den Alt-Svc Header warten zu müssen.

Firewall nicht vergessen

Ein Klassiker, der mich 2022 kurz stolpern ließ: QUIC braucht UDP Port 443. Wenn eure Firewall nur TCP 443 durchlässt, sehen die Clients den Alt-Svc Header, versuchen QUIC und laufen ins Timeout. Auf FreeBSD mit pf:

pass in quick on $ext_if proto udp to $jail_nginx port 443

Post-Quantum-Kryptografie inklusive

QUIC verwendet intern TLS 1.3 für die Verschlüsselung. Das heißt: Wenn ihr in eurer Nginx-TLS-Konfiguration X25519MLKEM768 als Key-Exchange-Gruppe konfiguriert habt, gilt das automatisch auch für QUIC-Verbindungen. Kein extra Aufwand. Euer HTTP/3 Traffic ist dann ebenfalls mit hybridem Post-Quantum-Schlüsselaustausch abgesichert.

Browser-Support

2022 war HTTP/3 noch ein Feature für Early Adopter. 2026 ist es Standard. Chrome, Firefox, Safari und Edge unterstützen QUIC seit Jahren. Laut den Logfiles dieses Blogs nutzen inzwischen gut 40% der Besucher HTTP/3. Tendenz steigend, weil immer mehr Mobilgeräte von dem schnelleren Verbindungsaufbau profitieren.

Wer es noch nicht aktiviert hat: Der Aufwand ist minimal, die Vorteile real und das Risiko gleich null. Drei Jahre Betrieb ohne ein einziges Problem sprechen für sich.

Siehe auch: HTTPS RR und SVCB Records — per DNS-Record signalisieren, dass HTTP/3 verfügbar ist. Damit können Clients direkt mit QUIC starten, ohne vorher TCP zu probieren.

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑