IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Kategorie: Kernel-Error-Blog (Seite 1 von 51)

Persönlicher Tech-Blog von Sebastian van de Meer — Beiträge zu IT-Security, Netzwerken, FreeBSD, Linux, Elektronik und Maker-Projekten.

LoRa-Mesh mit MeshCore, Teil 2: Der erste Companion mit dem Heltec V4

Heltec WiFi LoRa 32 V4 mit MeshCore-Companion-Firmware und angeschlossenem GPS-Modul auf einer blauen Werkbankmatte. Im Hintergrund sind Flash-Befehle, Bluetooth-Kopplung mit dem Smartphone und ein dezentrales LoRa-Mesh-Netzwerk dargestellt.

Im ersten Teil ging es um die Theorie: was LoRa ist, was MeshCore daraus macht und warum ich hier bei MeshCore gelandet bin. Jetzt wird es praktisch. Bevor ein Repeater aufs Dach kommt, braucht man erst einmal ein Gerät, mit dem man selbst im Mesh mitreden kann. Bei MeshCore heißt das Companion: ein kleiner LoRa-Node, der per Bluetooth am Smartphone oder am PC hängt und für dich funkt. Ich habe dafür einen Heltec WiFi LoRa 32 V4 genommen. Es gibt natürlich noch mehr und auch Geräte, die kein Smartphone brauchen aber ich mag es mit dem Smartphone zusammen.

Was in der Box steckt

Mein erstes Board war ein einzelner Heltec V4 mit GPS. In der kleinen Plastikbox lagen die Platine, eine Federantenne mit u.FL-Stecker (oft IPEX genannt), ein GPS-Modul mit achtadrigem Kabel, zwei JST-Kabel für Akku oder Solarzelle und zwei Stiftleisten, die nicht eingelötet sind. Auf der Box steht „LoRa Band, HP 863-928 MHz“, auf der Platine selbst HTIT-WB32LAF V4.3. Das ist die Revision 4.3 mit dem Frontend KCT8103L, also einem zusätzlichen Leistungsverstärker (PA) und rauscharmen Vorverstärker (LNA) vor dem eigentlichen LoRa-Chip SX1262. Der Rechner auf dem Board ist ein ESP32-S3 mit 16 MB Flash und 2 MB PSRAM, dazu kommen ein kleines OLED, USB-C und zwei Taster.
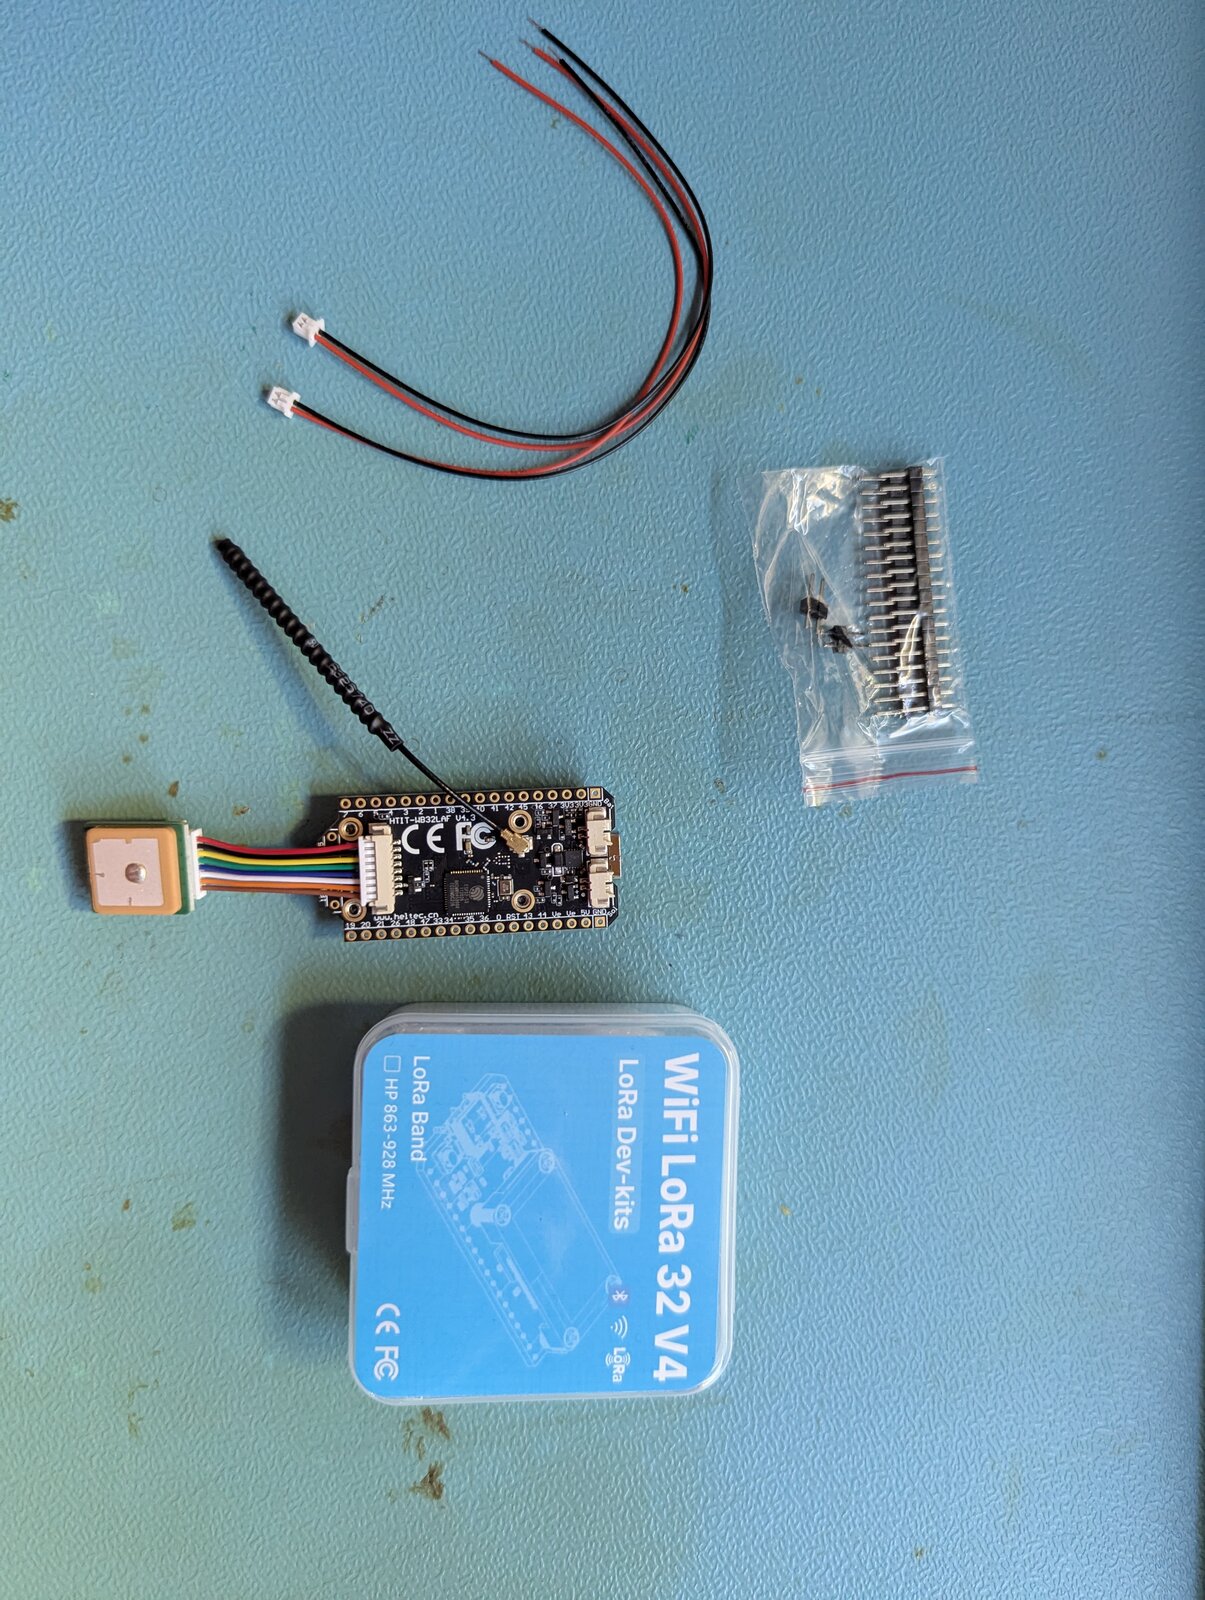
Ausgepackter Heltec WiFi LoRa 32 V4 auf einer blauen Werkbankmatte: Platine mit angeschlossenem GPS-Modul und Federantenne, zwei JST-Kabel mit roten und schwarzen Adern, eine Tüte mit Stiftleisten und die blaue Plastikbox mit der Aufschrift WiFi LoRa 32 V4
Lieferumfang des Heltec V4: Board, GPS-Modul, Federantenne, zwei JST-Kabel und Stiftleisten. Achtung, auf diesem Foto steckt die Antenne noch an der 2,4-GHz-Buchse. Doof ich bin.

Später habe ich mir noch das Komplettset geholt: Heltec V4 ohne GPS, dafür mit fertigem Gehäuse und 3000-mAh-LiPo. Auf dem läuft heute mein persönlicher Node „Kernel-Error“. Wer einfach nur schnell ins Mesh will, ist mit diesem Set besser bedient als ich mit meinem nackten Board, denn Gehäuse und Akku sind dann schon erledigt. Wie der erste Heltec danach ins Auto gewandert ist, steht weiter unten.

Ab Werk war auf dem Board Meshtastic 2.7.22 installiert. Ein meshtastic --info über USB lief sofort. Die Region stand auf UNSET, so sendet das Board gar nicht, bevor man eine Region gesetzt hat. Das finde ich vernünftig, so schreit das Ding nicht schon in die Luft, ganz ohne config. Ich wollte aber MeshCore, also musste die Firmware runter.

Achtung: Der Heltec V4 hat zwei identische IPEX-Buchsen. LoRa ist die Buchse an der Spitze der Platine, auf der Oberseite direkt neben dem GNSS-Stecker. Die andere sitzt unten neben dem ESP32-S3 und gehört zum 2,4-GHz-Teil. Und schick nie ein Paket raus, ohne dass an der LoRa-Buchse eine Antenne oder ein Abschlusswiderstand hängt. Die Sendeleistung muss irgendwo hin, sonst kommt sie zurück und kann die PA beschädigen. Also erst die Antenne, dann USB. Wenn ihr das dann noch direkt richtig anschließt und nicht, wie ich, einfach mal fummelt….
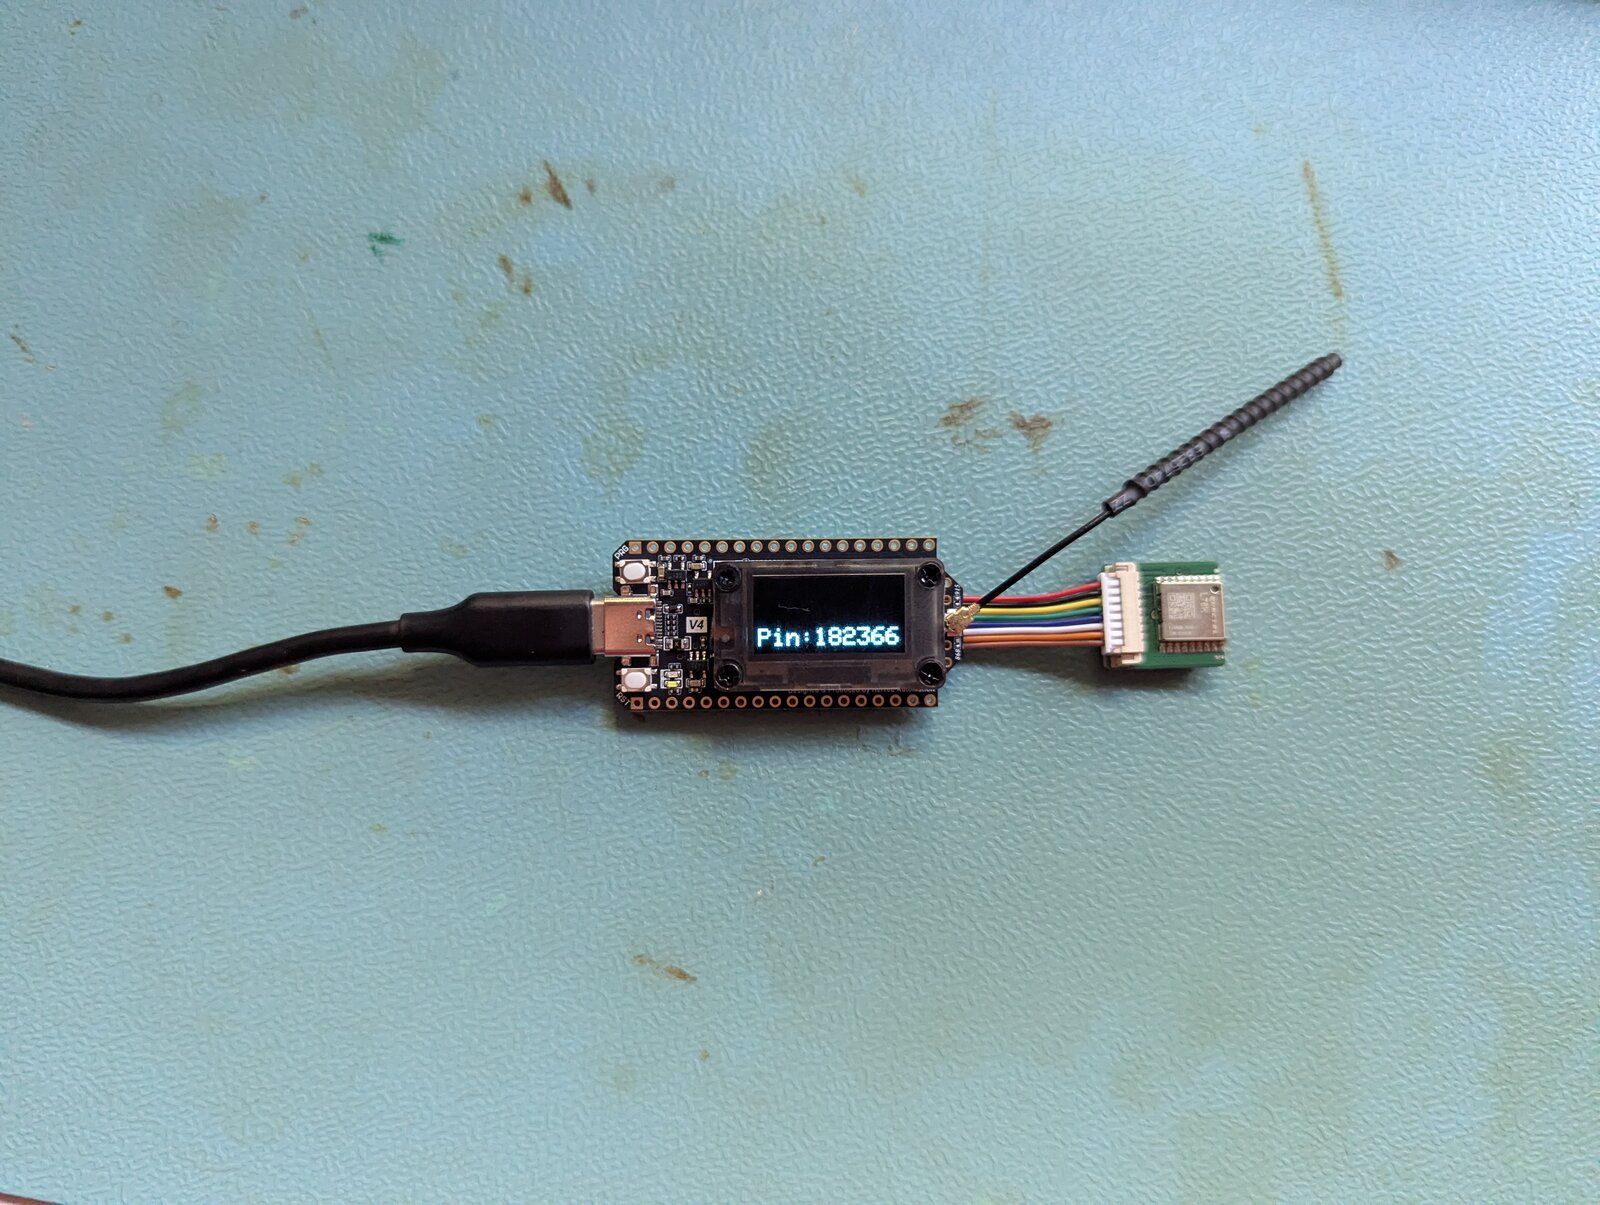
Heltec V4 von oben am USB-C-Kabel, das OLED zeigt Pin: 182366, die Federantenne steckt an der IPEX-Buchse an der Spitze der Platine direkt neben dem farbigen GNSS-Kabel, rechts das grüne GPS-Modul
So ist es richtig: Die Federantenne steckt an der LoRa-Buchse an der Spitze, direkt neben dem GNSS-Kabel. Auf dem Display steht der BLE-PIN fürs Pairing.

Erst sichern, dann flashen

Bevor ich irgendetwas überschreibe, ziehe ich ein komplettes Abbild des Flashs. Damit komme ich jederzeit zurück auf den Werkszustand. Klar könnte ich einfach wieder die Meshtastic Firmware drüber brennen. Ich bin aber schon ein paar mal mit so etwas auf die Nase gefallen und die drei Minuten für eine Sicherung habe ich dann doch. Der ESP32-S3 meldet sich über seinen nativen USB-Port als /dev/ttyACM0, einen USB-Seriell-Wandler gibt es auf dem Board nicht. Mit esptool schaue ich zuerst, was überhaupt verbaut ist, und lese dann die vollen 16 MB aus. Das hat bei mir knapp 100 Sekunden gedauert.

$ esptool --port /dev/ttyACM0 flash-id
Chip type:          ESP32-S3 (QFN56) (revision v0.2)
Features:           Wi-Fi, BT 5 (LE), Dual Core + LP Core, 240MHz, Embedded PSRAM 2MB (AP_3v3)
Detected flash size: 16MB

$ esptool --port /dev/ttyACM0 --baud 921600 read-flash 0 ALL backup/heltec-v4-factory-16MB.bin

Die Zeile mit dem PSRAM ist wichtig für die Wahl der richtigen Firmware. MeshCore baut für den V4 mehrere Varianten: heltec_v4, heltec_v4_r8 und jeweils noch _tft-Versionen. Das „R2“ im Produktnamen steht für den ESP32-S3R2 mit 2 MB PSRAM, und das bestätigt esptool. Also heltec_v4. Die r8-Variante benutzt andere Pins für Display-Versorgung und LED, mit dem falschen Image bleibt das Display dunkel. Ratet doch mal, woher ich das so genau sagen kann? Nicht, dass noch das Gefühl aufkommt, dass ich hier Ahnung von dem hätte, was ich mache. Wie immer: Korrigiert mit bitte. Ich will was lernen.

Die Releases auf GitHub sind nach Rolle getrennt: Companion, Repeater und Room Server haben eigene Tags. Für das Handgerät brauche ich den Companion mit Bluetooth, also eine Datei nach dem Muster heltec_v4_companion_radio_ble-<version>-merged.bin. „merged“ heißt, dass Bootloader, Partitionstabelle und Anwendung in einem Image stecken, das ab Adresse 0x0 geschrieben wird. Die SHA-256-Summe habe ich gegen den Digest des GitHub-Assets geprüft, dann den Flash gelöscht, damit keine Meshtastic-Reste liegen bleiben, und das Image geschrieben (vergesst das mit dem Löschen nicht, kommt sonst schnell mal spannendes bei herum):

$ gh release download companion-v1.17.1 -R meshcore-dev/MeshCore -p 'heltec_v4_companion_radio_ble-v1.17.1-d929643-merged.bin'
$ sha256sum heltec_v4_companion_radio_ble-v1.17.1-d929643-merged.bin
$ esptool --port /dev/ttyACM0 erase-flash
$ esptool --port /dev/ttyACM0 --baud 921600 write-flash 0x0 heltec_v4_companion_radio_ble-v1.17.1-d929643-merged.bin

Die 1,3 MB waren in unter fünf Sekunden drauf. Wer keine Lust auf die Kommandozeile hat, kann auch den Web-Flasher von MeshCore im Browser nehmen. Den habe ich selbst nicht benutzt, das Backup vorher solltest du aber in beiden Fällen machen.

Eine Sache aus dem Quellcode der V4-Variante muss man kennen: Dort steht LORA_TX_POWER=10 mit dem Kommentar, dass daraus am Ende 22 dBm werden. Die Sendeleistung in der App ist auf diesem Board die Ausgangsleistung des SX1262, die externe PA legt laut diesem Kommentar etwa 12 dB obendrauf. Eine „22“ in der App bedeutet beim Heltec V4 also nicht 22 dBm an der Antenne. Mein Companion bleibt deshalb auf 10, dem Wert, den MeshCore für den V4 ohnehin mitbringt. Was das für die Grenzwerte heißt, rechne ich in Teil 4 durch. Ja, hehe… Der cliffhanger bleibt auch hier.

Pairing mit der App

Nach dem Flashen bootet das Board direkt in MeshCore und zeigt auf dem OLED einen sechsstelligen PIN. Den gibt man beim Bluetooth-Pairing in der MeshCore-App ein. Der PIN wird bei jedem Start neu gewürfelt. Der Companion nimmt immer nur einen BLE-Client gleichzeitig an. Hängt das Handy dran, findet der PC das Gerät nicht, und umgekehrt. Was mich bestimmt 10 min. meines Lebens gekostet hat, das zu realisieren.

Beim ersten Verbinden fragt die App nach einem Funk-Preset. Hier im Rheinland funkt die Community mit „EU/UK (Narrow)“, das sind 869,618 MHz, 62,5 kHz Bandbreite, Spreading Factor 8 und Coding Rate 8. Welches Preset in deiner Gegend gilt, solltest du bei der lokalen Community nachschauen, denn mit anderer Frequenz, Bandbreite oder anderem Spreading Factor hörst du schlicht niemanden. Die Coding Rate steht dagegen im LoRa-Header, ein Empfänger mit Coding Rate 5 versteht also auch Pakete mit Coding Rate 8. Danach bekommt der Node einen Namen. Meiner heißt „Kernel-Error“.
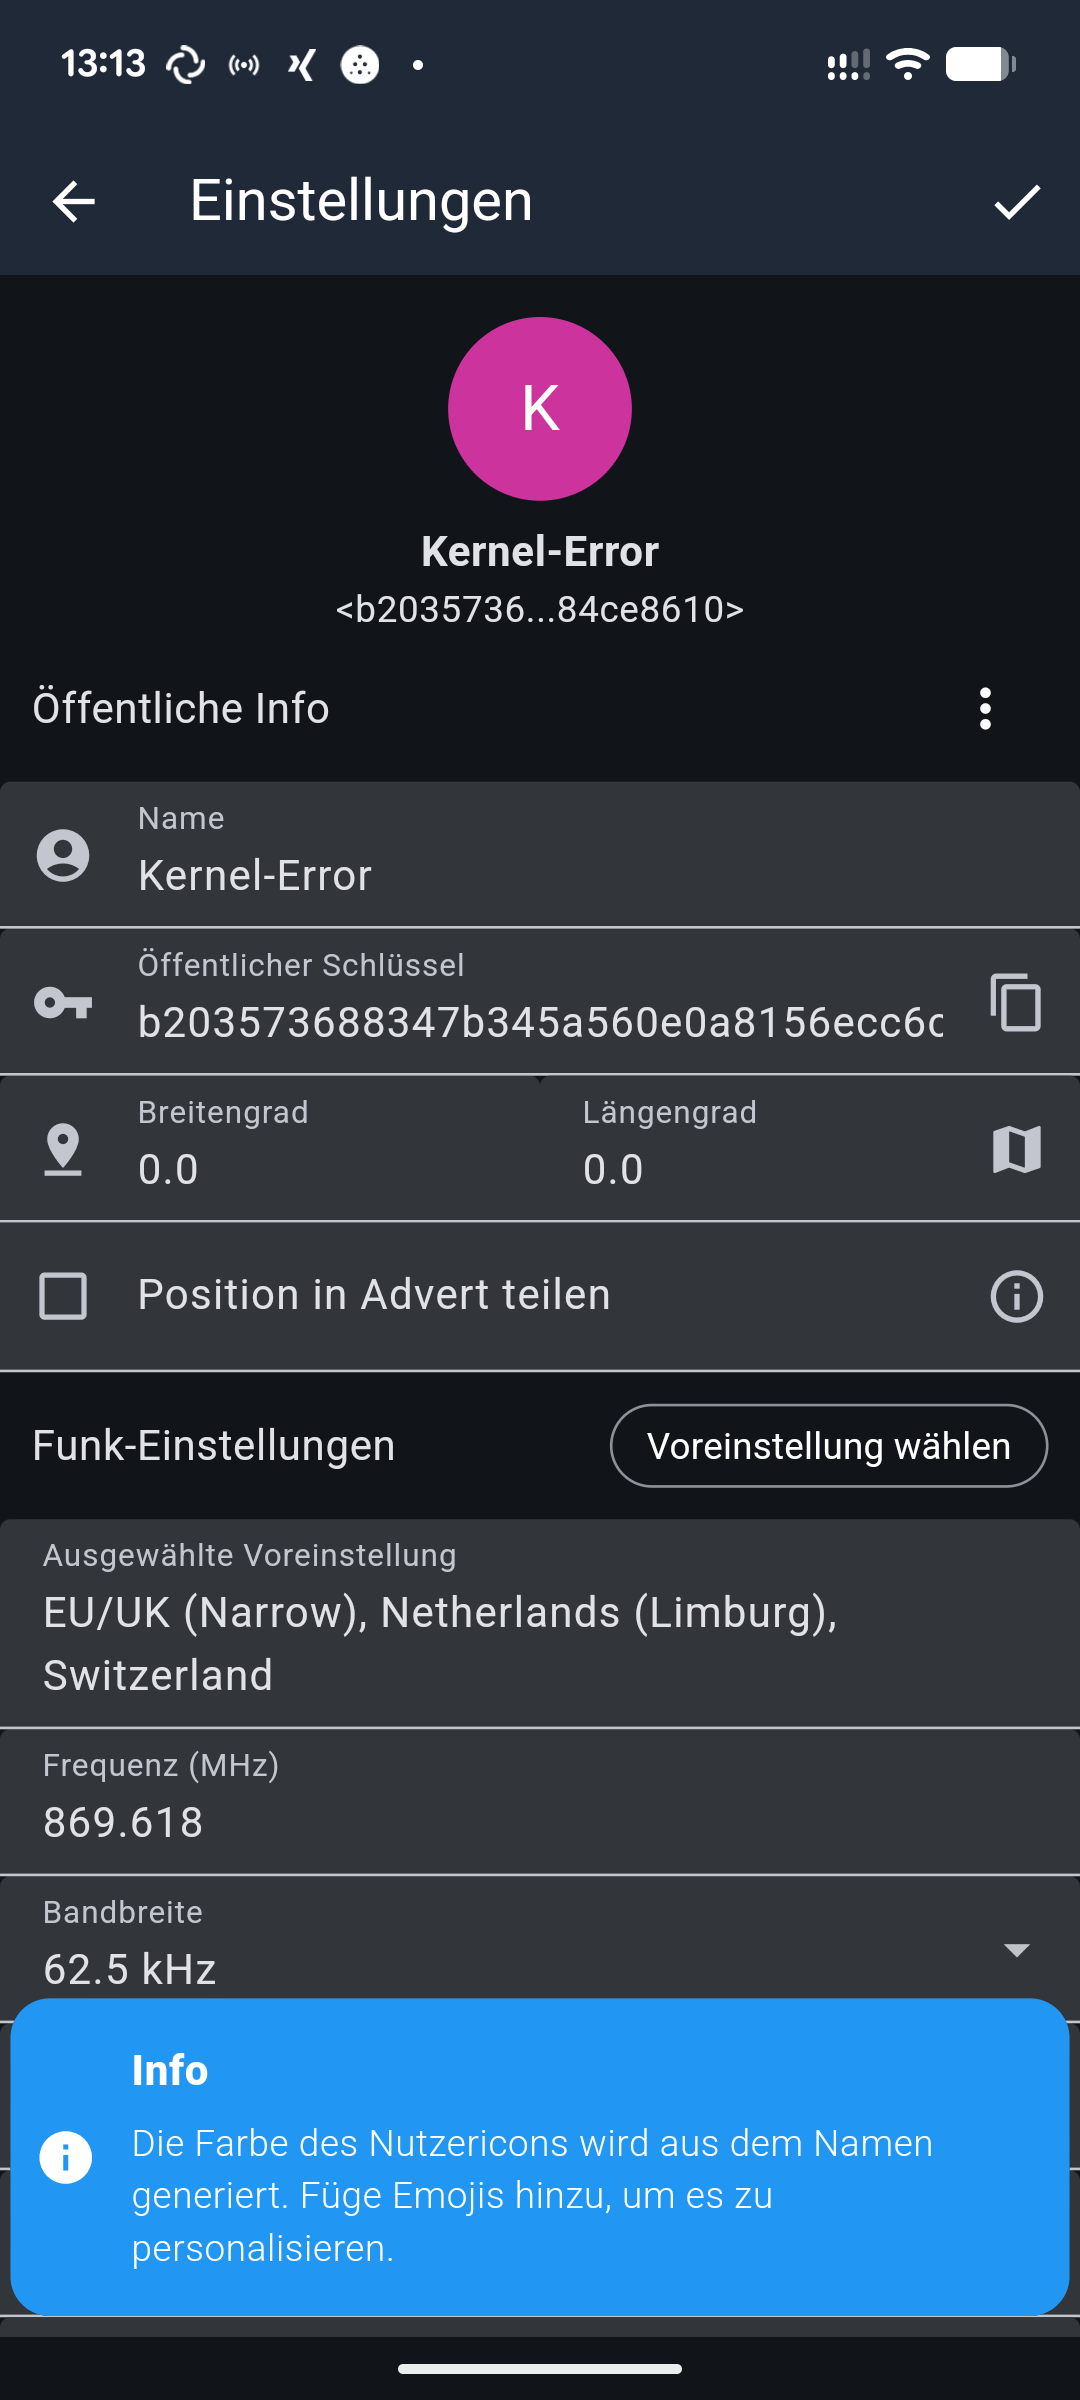
MeshCore-App, Einstellungen des Nodes Kernel-Error: Avatar mit dem Buchstaben K, darunter der verkürzte Schlüssel b2035736...84ce8610, Felder für Name und öffentlichen Schlüssel, Breiten- und Längengrad 0.0, Häkchen Position in Advert teilen nicht gesetzt, Preset EU/UK (Narrow) mit 869.618 MHz und 62.5 kHz, unten ein Info-Hinweis zur Iconfarbe
Die Node-Einstellungen in der App. Unter dem Namen steht die Kurzform des öffentlichen Schlüssels, die Position wird nicht im Advert geteilt.

Erstes Advert, erste Nachrichten

Ein Advert ist die Visitenkarte eines Nodes: Name, öffentlicher Schlüssel, Typ und optional eine Position, signiert mit dem privaten Schlüssel, aber nicht verschlüsselt. Ein Companion verschickt so etwas nur, wenn du es auslöst. Als Flood-Advert geht es über die Repeater in die Fläche, als Zero-Hop-Advert erreicht es nur die direkte Nachbarschaft.

Nach meinem ersten Flood-Advert war die Kontaktliste leer. Das ist normal und hat mich trotzdem kurz irritiert. Ein Advert holt keine Liste aus dem Netz, Kontakte tauchen erst auf, wenn du die Adverts der anderen hörst, und Repeater senden die nur in längeren Abständen. Etwas Geduld hilft also. Bei mir hat es zusätzlich etwas länger gedauert, weil die Antenne an der falschen Buchse steckte, siehe oben. Ja, ich bin einer von denen, die auf dem ersten Foto die Antenne an der falschen Buchse hatten.

Ob eine Nachricht wirklich rausgegangen ist, zeigt dir die App selbst. Unter jeder eigenen Kanalnachricht zeigt sie an, wie viele Repeater sie wiederholt haben. Hört dein Companion einen Repeater deine Nachricht weitersenden, ist sie im Mesh. Diese „heard repeats“ empfiehlt auch Mesh Rheinland zum Testen. Bei mir stand unter dem ersten „geht“ im Public-Kanal „1 Repeater empfangen“, drumherum liefen Testnachrichten aus Velbert, Euskirchen und Lengerich.
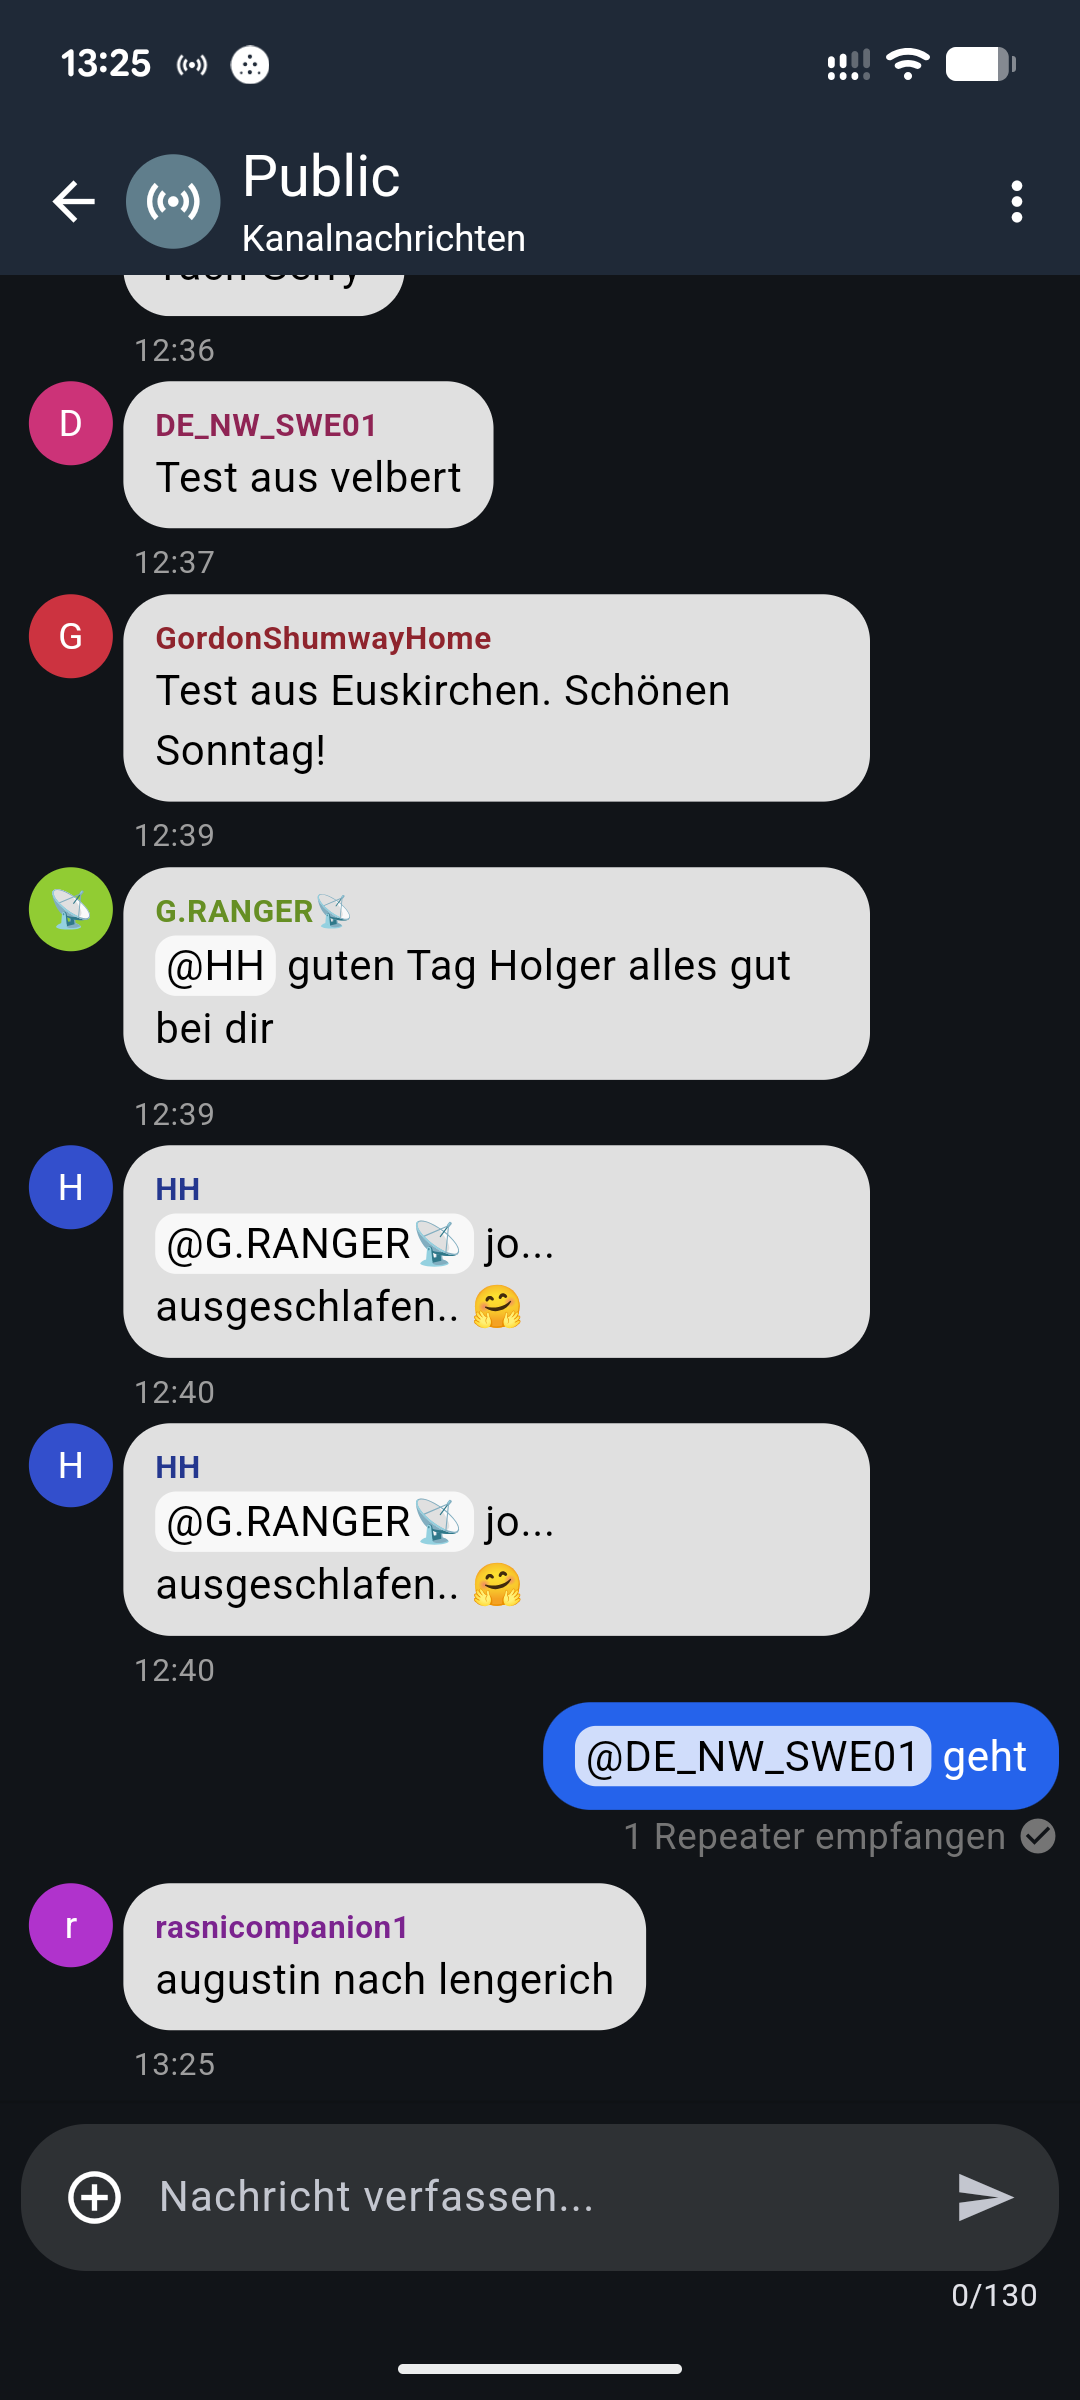
MeshCore-App im Kanal Public: Nachrichten anderer Nutzer wie Test aus velbert und Test aus Euskirchen, rechts die eigene blaue Nachricht @DE_NW_SWE01 geht mit dem Vermerk 1 Repeater empfangen und einem Häkchen, unten das Eingabefeld mit 0/130 Zeichen
Der Moment, in dem es funktioniert: „1 Repeater empfangen“ unter der eigenen Nachricht heißt, dass ein Repeater sie weitergesendet hat.

Avatar per Emoji

Ein Profilbild kann man nicht hochladen. Die App erzeugt die Farbe des Icons aus dem Namen und zeigt den ersten Buchstaben. Steht am Anfang des Namens ein Emoji, nimmt die App das statt des Buchstabens. Ich habe mich zuerst „😈 Kernel-Error“ genannt, das kommt dem FreeBSD-Daemon am nächsten, einen echten Beastie gibt es als Emoji leider nicht. Falls jemand ein Unicode-Zeichen für Beastie kennt, sagt gerne Bescheid, ich schaue dann nach, ob die App es mitmacht. Der Name darf maximal 31 Byte lang sein, ein Emoji frisst davon meist vier. Nach dem Umbenennen ein Flood-Advert schicken, damit die anderen den neuen Namen lernen. Am Schlüssel ändert sich nichts. Das kleine OLED kann übrigens keine Emojis darstellen und zeigt nur den Text.
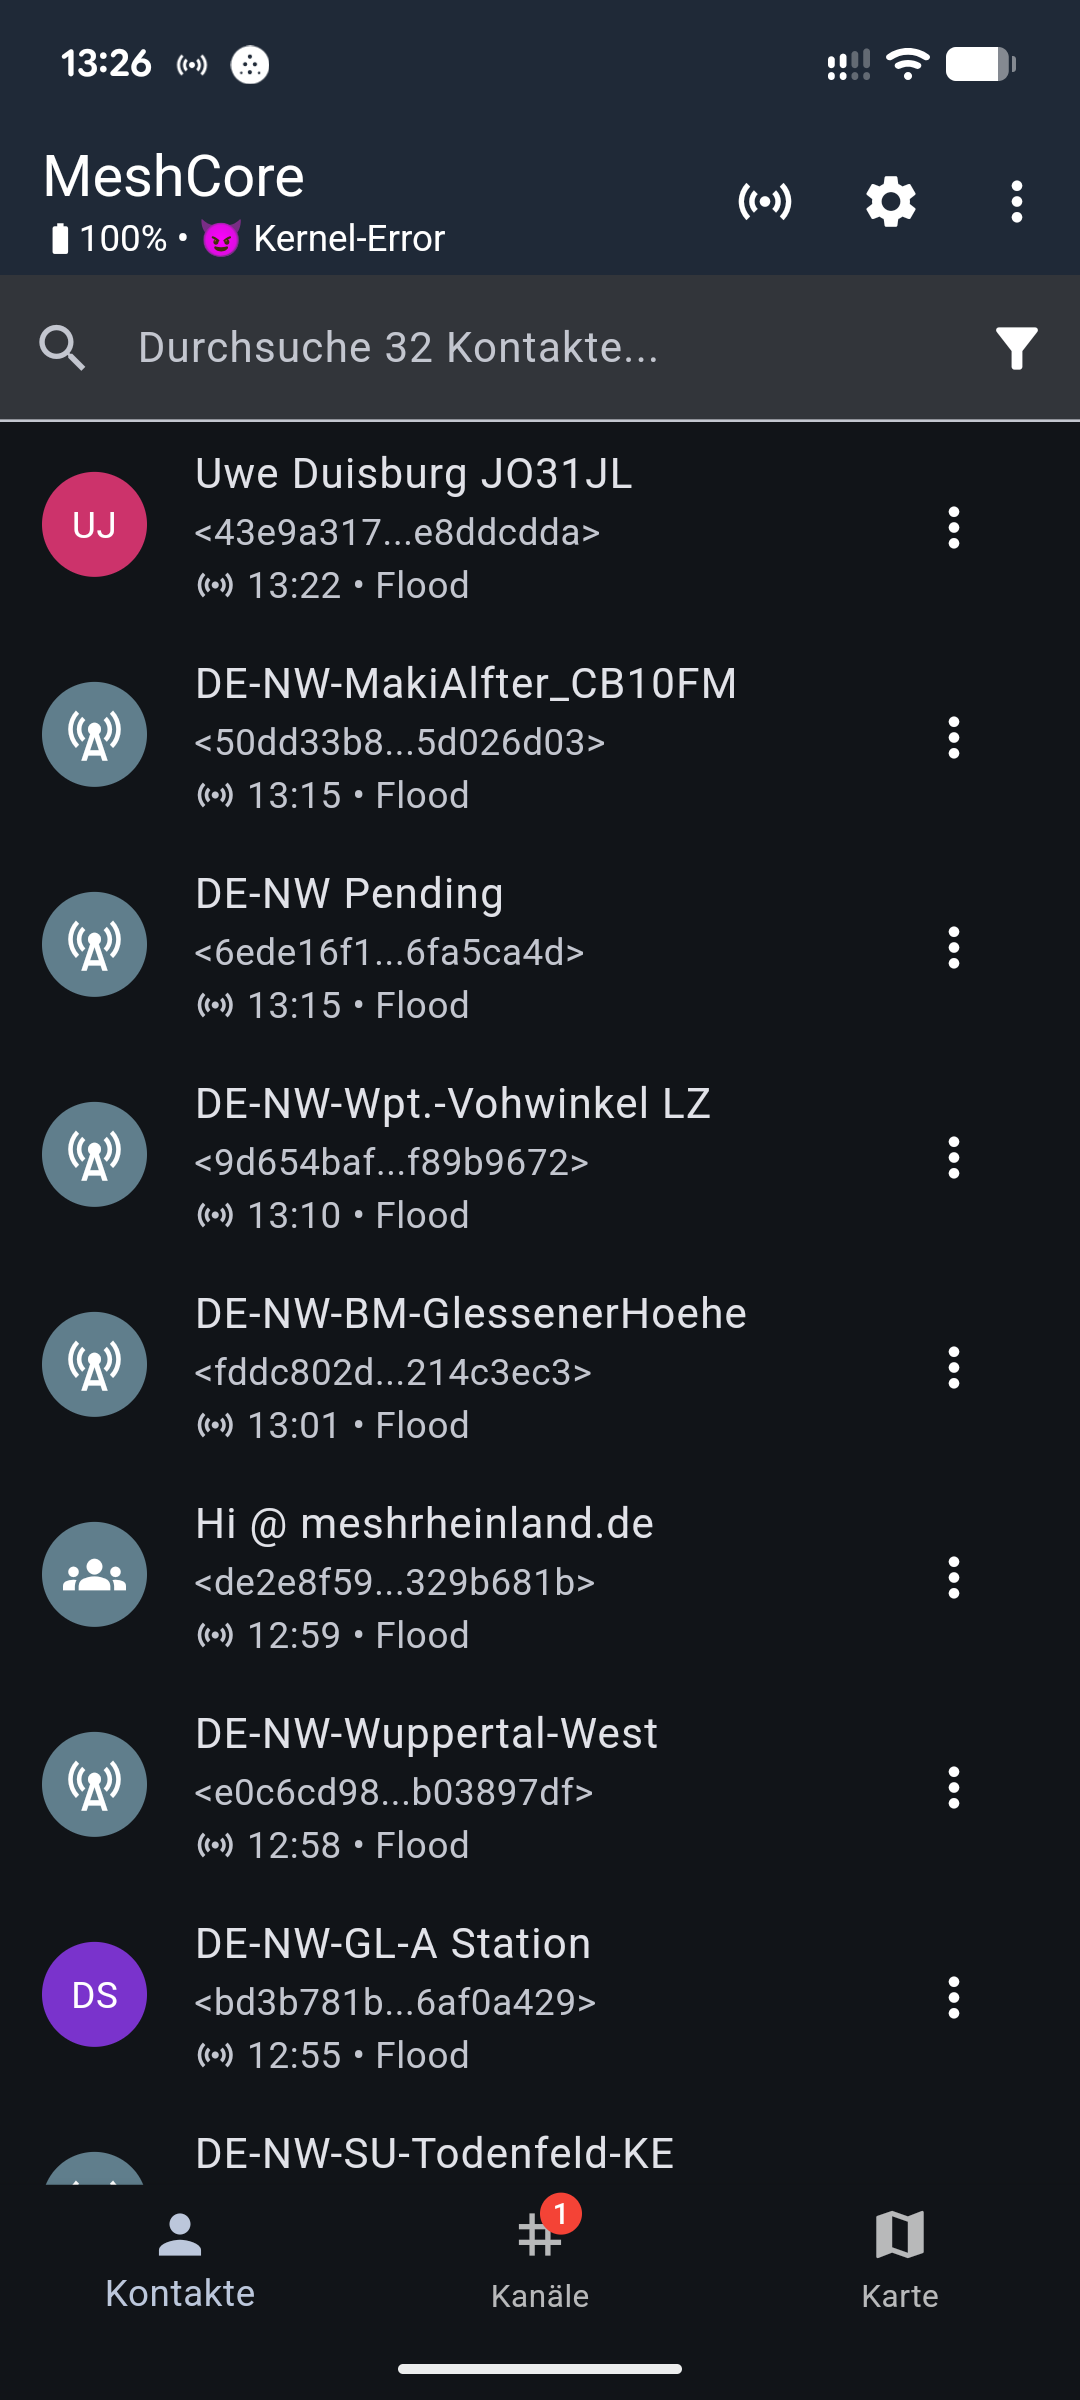
MeshCore-App, Kontaktliste mit 32 Einträgen, oben in der Kopfzeile 100 Prozent Akku und der Name Kernel-Error mit Teufels-Emoji, darunter Repeater wie DE-NW-Wpt.-Vohwinkel LZ, DE-NW-BM-GlessenerHoehe, DE-NW-Wuppertal-West und der Raum Hi @ meshrheinland.de, jeweils mit verkürztem Schlüssel und Uhrzeit
Nach ein paar Stunden füllt sich die Kontaktliste. Oben steht der Node mit Emoji im Namen.

Kontakte und warum der Schlüssel zählt

Wie in Teil 1 beschrieben, ist die Identität eines Nodes sein Schlüsselpaar und der Name nur ein Etikett. Die App zeigt deshalb neben jedem Kontakt eine Kurzform des öffentlichen Schlüssels, die ersten und letzten acht Hex-Zeichen, bei mir <b2035736...84ce8610>. Wenn du sicher sein willst, dass du wirklich mit der Person schreibst, die du meinst, vergleich diesen Fingerprint über einen anderen Weg: persönlich, am Telefon oder über eine Webseite, der du vertraust. Erst dann ist der Kontakt verifiziert.

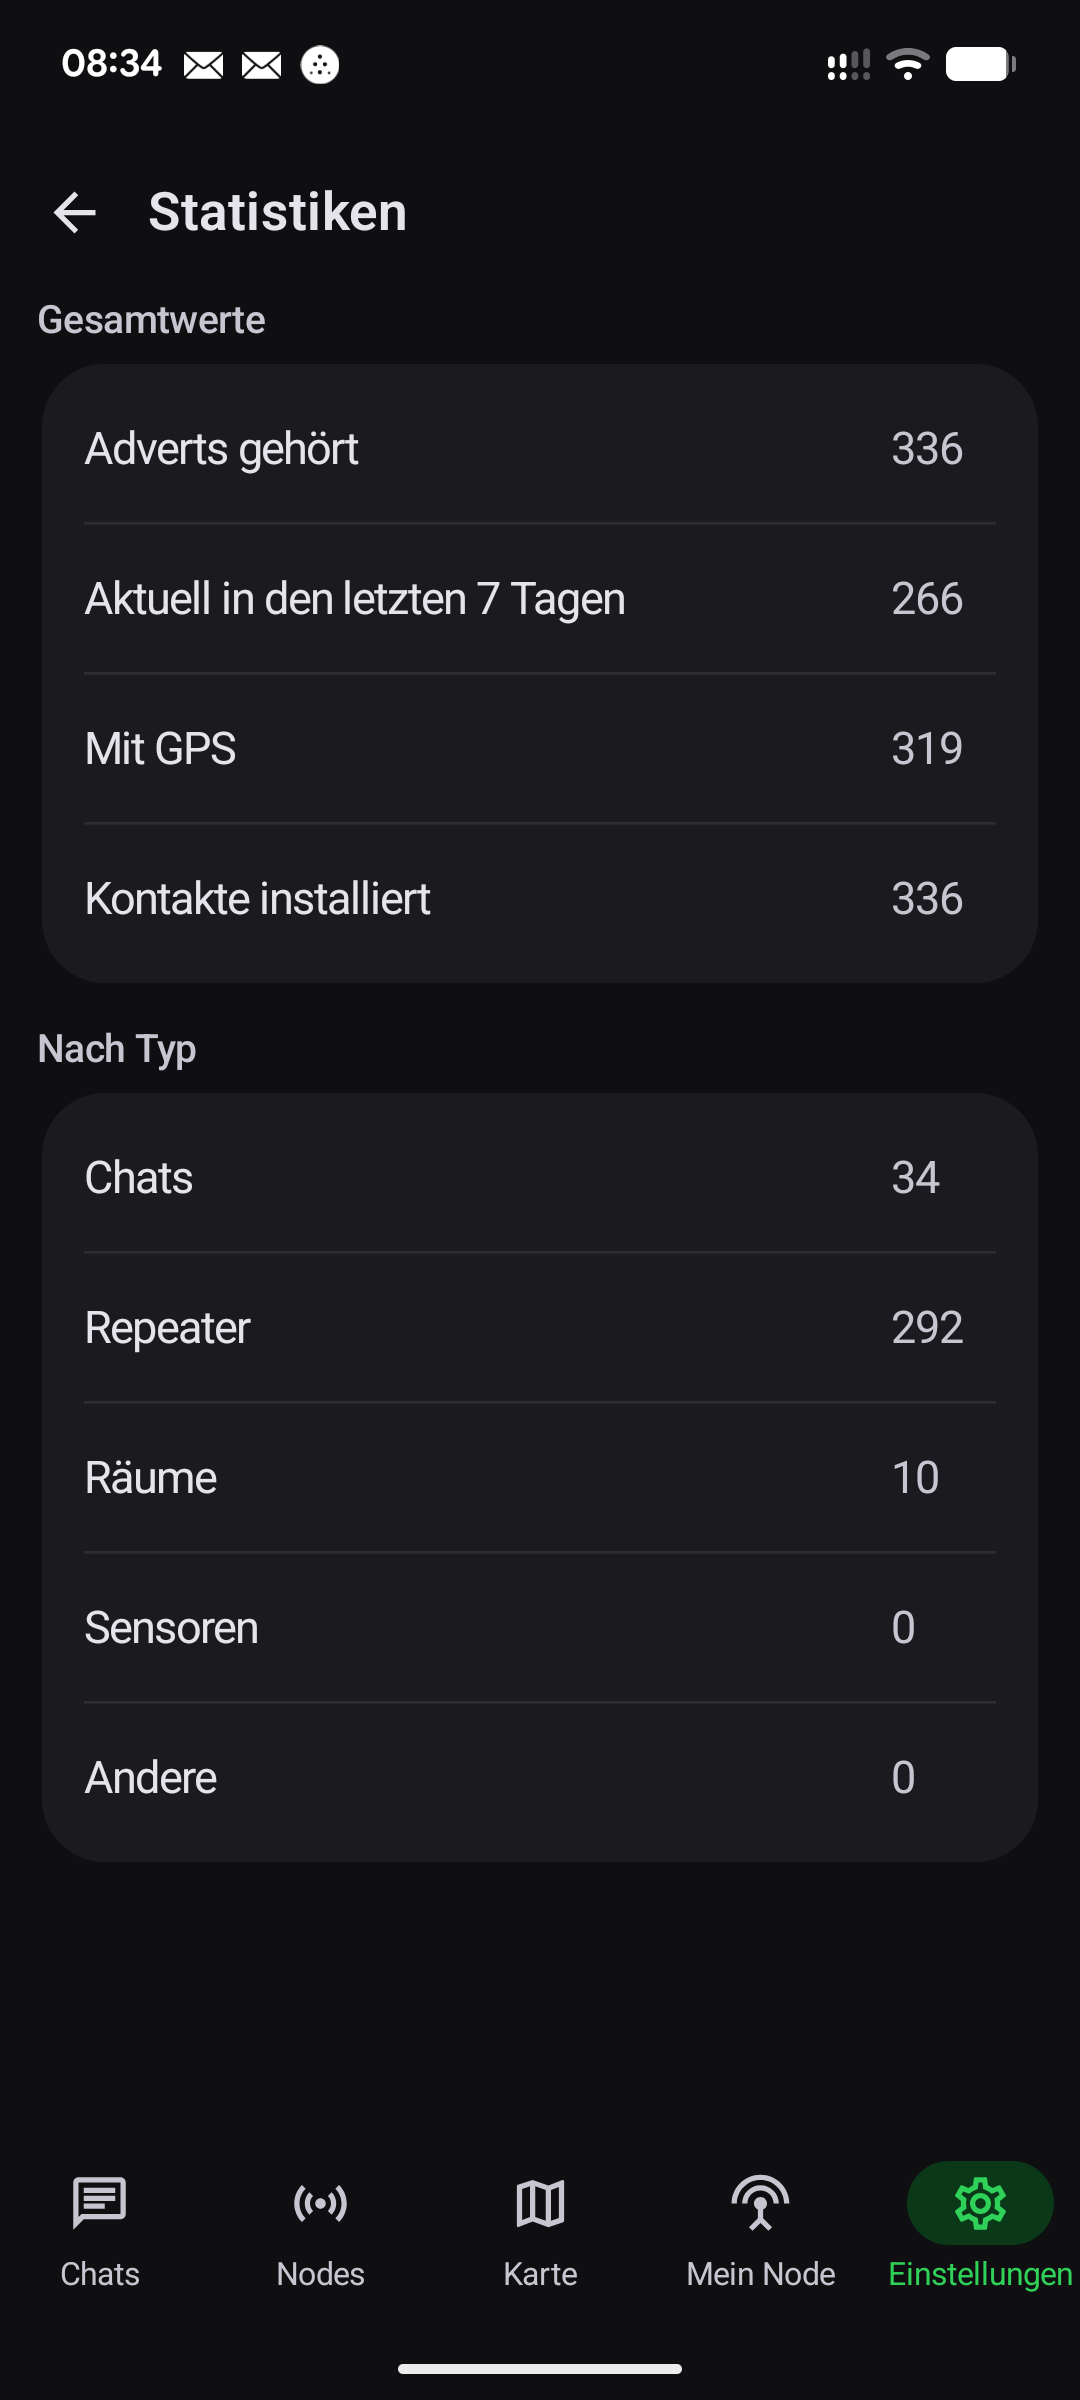
Standardmäßig wird jedes gehörte Advert zum Kontakt. Das wird schnell viel: Die Kontakttabelle ist auf dem Heltec-BLE-Build auf 350 Einträge begrenzt, und im Rheinland gibt es viele Repeater. Ist die Tabelle voll und „älteste überschreiben“ aus, landen neue Kontakte nicht mehr in der Liste. Die Firmware reicht das Advert dann zwar noch an die App weiter und meldet, dass der Speicher voll ist, speichert den Kontakt aber nicht. Ich habe deshalb auf selektives Hinzufügen umgestellt: Chats, Repeater und Room Server ja, Sensoren nein, maximal drei Hops entfernt, älteste überschreiben an. Favoriten werden beim Überschreiben nicht angefasst, die eigenen wichtigen Kontakte sollte man also als Favorit markieren.

Die App kann die komplette Node-Konfiguration als JSON exportieren und wieder importieren. Achtung: In diesem Export steckt der private Schlüssel, und dazu die zuletzt bekannte Position, auch wenn du sie nicht im Advert teilst. Behandle die Datei wie einen privaten SSH-Schlüssel. Wer ihn hat, kann sich als dein Node ausgeben und deine Direktnachrichten lesen. Hier deshalb nur ein bereinigter Auszug mit den Teilen, die wirklich etwas einstellen:

"radio_settings": {
  "frequency": 869618,
  "bandwidth": 62500,
  "spreading_factor": 8,
  "coding_rate": 8,
  "tx_power": 10
},
"other_settings": {
  "manual_add_contacts": 1,
  "advert_location_policy": 0
},
"auto_add_settings": {
  "auto_add_chat": true,
  "auto_add_repeater": true,
  "auto_add_room_server": true,
  "auto_add_sensor": false,
  "overwrite_oldest": true,
  "auto_add_max_hops": 4
}

manual_add_contacts: 1 schaltet das selektive Hinzufügen ein, erst dann wirken die auto_add_*-Schalter. auto_add_max_hops: 4 bedeutet bis zu drei Hops, 0 hieße ohne Grenze. advert_location_policy: 0 hält die Position aus dem Advert raus. Ein Companion, der meistens zu Hause liegt, würde sonst die Wohnadresse ins Netz senden. Wenn du so etwas übernehmen willst, setz die Werte in der App oder kopier nur diese Blöcke. Einen fremden Export mitsamt Schlüssel zu importieren, klont eine fremde Identität, und zwei Nodes mit demselben Schlüssel bringen das Routing für beide durcheinander.

Die Einstellungen, auf die es ankommt

Zwei Einstellungen stehen nicht im Export und müssen von Hand gesetzt werden: die Größe der Pfad-Hashes und der Default-Scope. Den Pfad-Hash habe ich auf 2 Byte gestellt, damit sich Repeater auf dem Weg seltener verwechseln lassen. Der Default-Scope steht auf #de, weil die Repeater hier ungescopte Floods ignorieren. Beides erkläre ich ausführlich in Teil 6. Die Funkwerte entsprechen dem Preset, zur Sendeleistung von 10 steht oben schon alles. Ein Board ohne externe PA würde man dagegen mit seiner echten Ausgangsleistung einstellen.
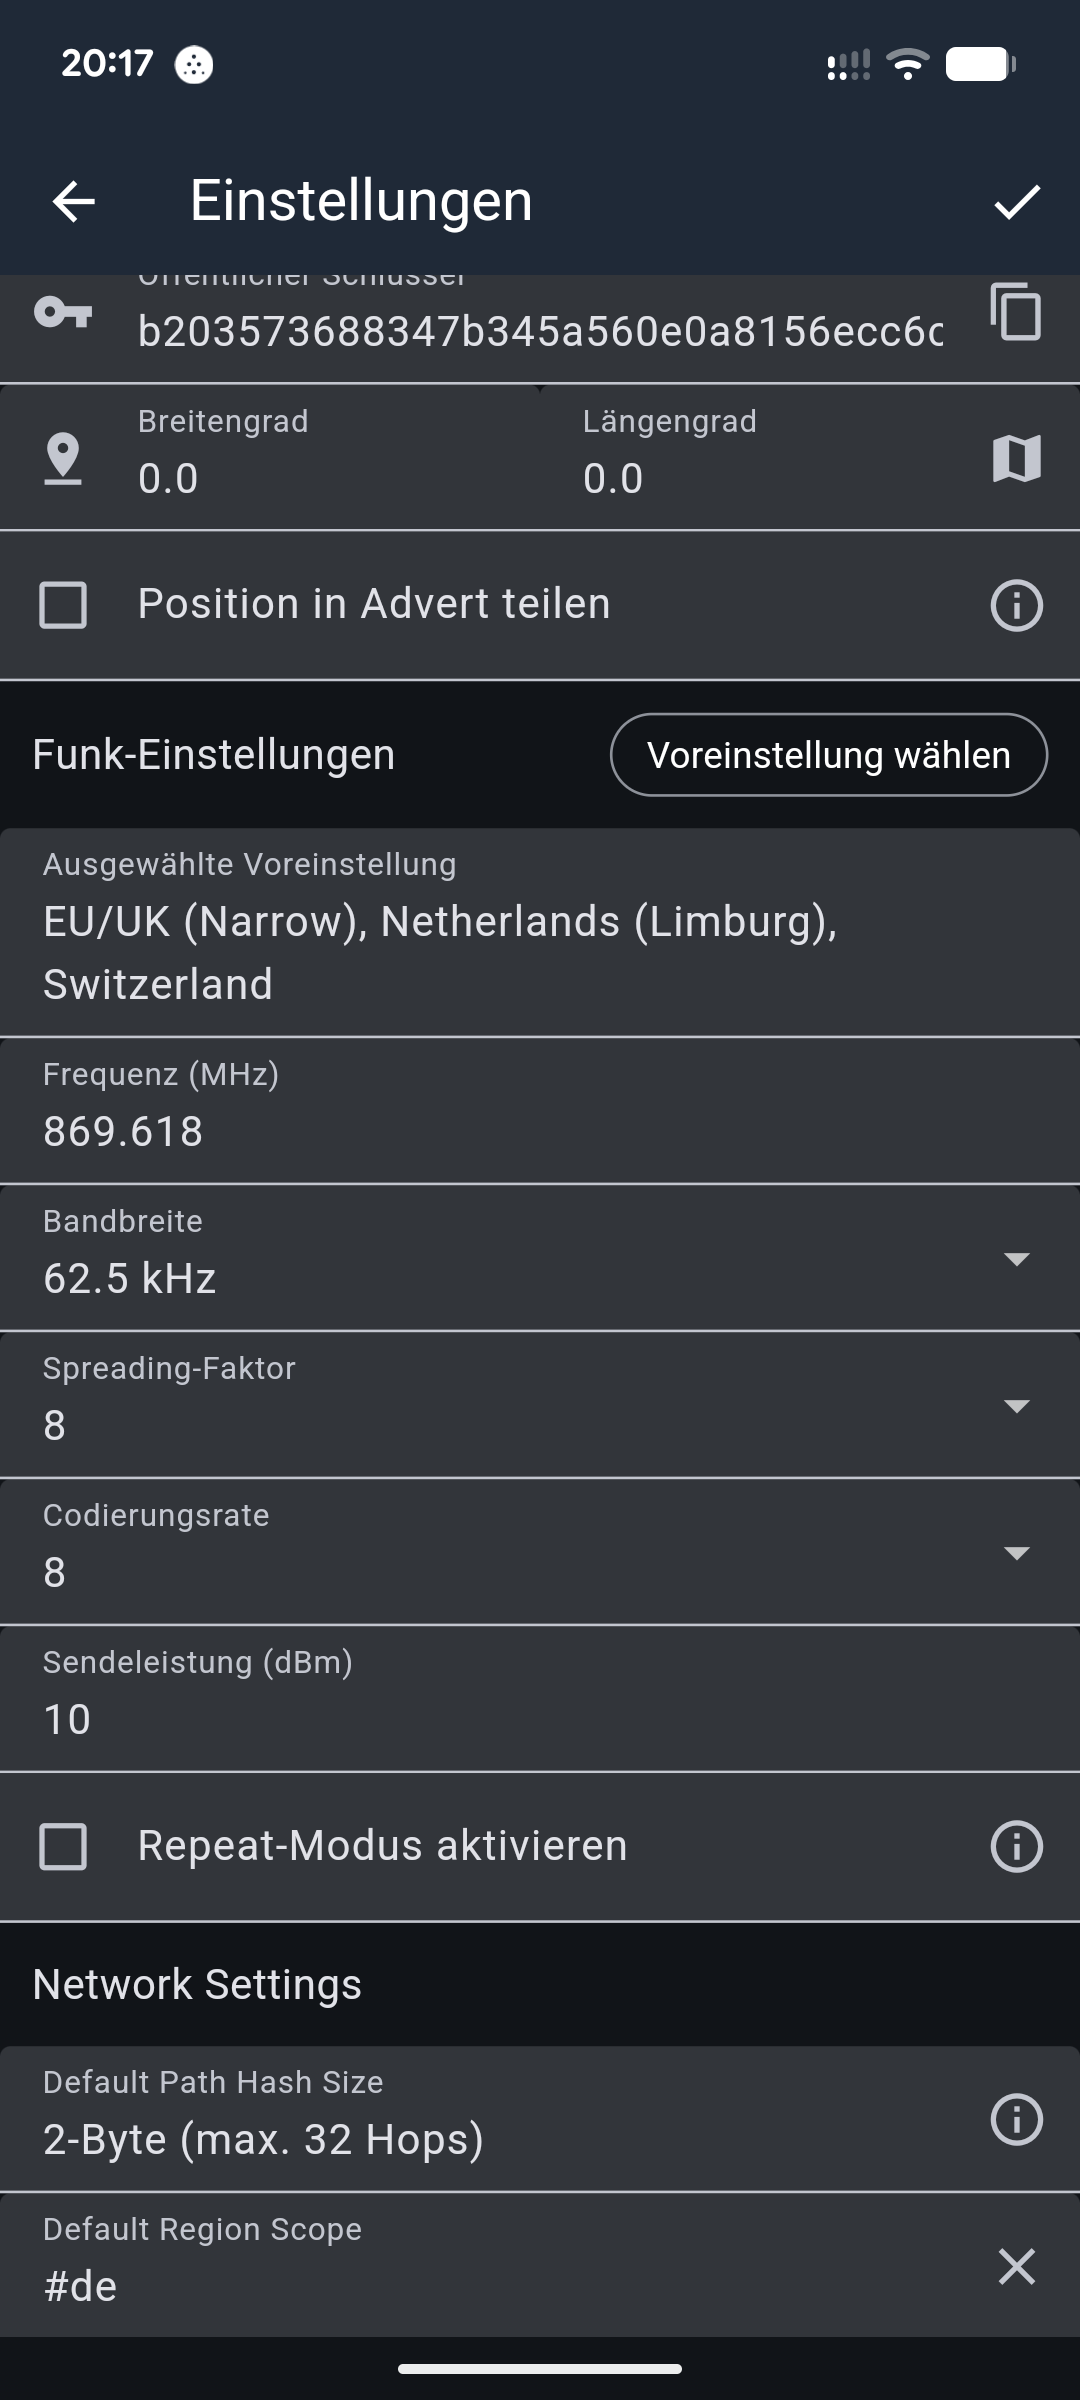
MeshCore-App, Einstellungen des Companions: öffentlicher Schlüssel, Breiten- und Längengrad 0.0, Position in Advert teilen deaktiviert, Preset EU/UK (Narrow), Frequenz 869.618 MHz, Bandbreite 62.5 kHz, Spreading-Faktor 8, Codierungsrate 8, Sendeleistung 10 dBm, Repeat-Modus deaktiviert, Default Path Hash Size 2-Byte (max. 32 Hops), Default Region Scope #de
Die Companion-Einstellungen von Kernel-Error: Sendeleistung 10, Pfad-Hash 2 Byte, Default-Scope #de, Position im Advert aus und Repeat-Modus aus.

Der Schalter „Repeat-Modus aktivieren“ sieht verlockend aus, macht aber nicht, was man erwartet. Laut Quellcode der Companion-Firmware ist er nur auf 433,000, 869,495 oder 918,000 MHz erlaubt. Auf 869,618 MHz lehnt die Firmware ihn ab. Wer ihn einschaltet, zieht also auf eine andere Frequenz um und verlässt das Netz der Community. Gedacht ist das für Off-Grid-Gruppen ohne Repeater. Bei meinen Companions bleibt er aus, das Weiterleiten erledigen hier die Repeater.

Kanäle

Neben Direktnachrichten an Kontakte gibt es Kanäle. Jeder MeshCore-Companion kennt den Kanal „Public“. Dessen Schlüssel 8b3387e9c5cdea6ac9e5edbaa115cd72 ist überall gleich und öffentlich, die Verschlüsselung schützt dort also vor niemandem im Mesh. Dazu kommen Hashtag-Kanäle wie #nrw, #bonn oder #rheinbach. Bei denen wird der Schlüssel per SHA-256 aus dem Namen abgeleitet. Wer den Namen kennt, kann mitlesen. Privat sind nur Kanäle mit einem selbst erzeugten, geheim geteilten Schlüssel.

Jeder Kanal kann zusätzlich einen eigenen Scope tragen, meinen Public-Kanal habe ich auf de gestellt. Welcher Scope für welchen Kanal sinnvoll ist und wie du den tatsächlich wirksamen Scope prüfst, steht in Teil 6. Ein Nebeneffekt, den man sofort sieht: Mit Scope begrenzt die App die maximale Nachrichtenlänge im Kanal auf 120 statt 130 Zeichen. Die Firmware selbst kürzt dabei nichts, der Transport-Code steckt im Paketkopf und nicht in den Nutzdaten.

Mein Kontakt als QR-Code

Über „Kontakt teilen“ erzeugt die App einen QR-Code. Darin steckt eine Adresse der Form meshcore://contact/add?name=...&public_key=...&type=1, also nur Name, öffentlicher Schlüssel und Typ (1 steht für Chat). Position, Zeitstempel und Signatur fehlen. Der Code beweist deshalb nicht von selbst, dass er von mir stammt. Das Vertrauen kommt hier aus dem Kanal: Du hast ihn aus meinem Blog. Wenn du mich hinzufügen willst, scann den Code und vergleich den Fingerprint mit <b2035736...84ce8610>. Der volle Schlüssel lautet:

b203573688347b345a560e0a8156ecc6c0dc7d14c4f53046064bfabe84ce8610
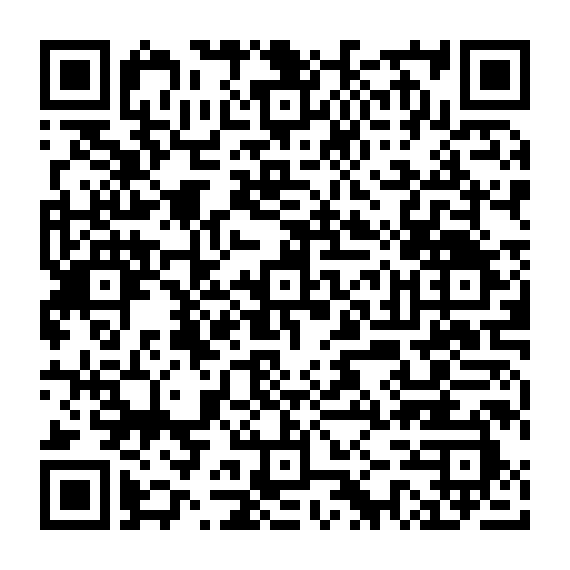
Schwarz-weißer QR-Code mit einer MeshCore-Kontaktadresse, die den Namen Kernel-Error und den öffentlichen Schlüssel enthält
Mein Companion „Kernel-Error“ als MeshCore-Kontakt. Der Code enthält nur Namen und öffentlichen Schlüssel.

Viel gebe ich damit nicht preis. Name und Schlüssel stehen ohnehin in jedem Advert, das mein Node sendet. Was dazukommt, sind vielleicht ein paar ungefragte Direktnachrichten. Die nehme ich in Kauf.

Ein Gehäuse aus dem Drucker

Mein erstes Board lag anfangs nackt auf dem Tisch. Für unterwegs habe ich mir das Modell „WiFi LoRa 32 V4 (Heltec V4)“ von Adi_CEvil auf MakerWorld in Rot gedruckt. Danke dafür. Heltec und ein 1100-mAh-LiPo passen hinein, geladen wird über USB-C. Beim Filament lieber keine Varianten mit Carbon- oder Metallanteil nehmen, leitfähige Füllstoffe direkt an der Antenne verstimmen sie und schlucken Leistung. Ihr wickelt das Teil ja auch nicht in Alufolie ein, oder?
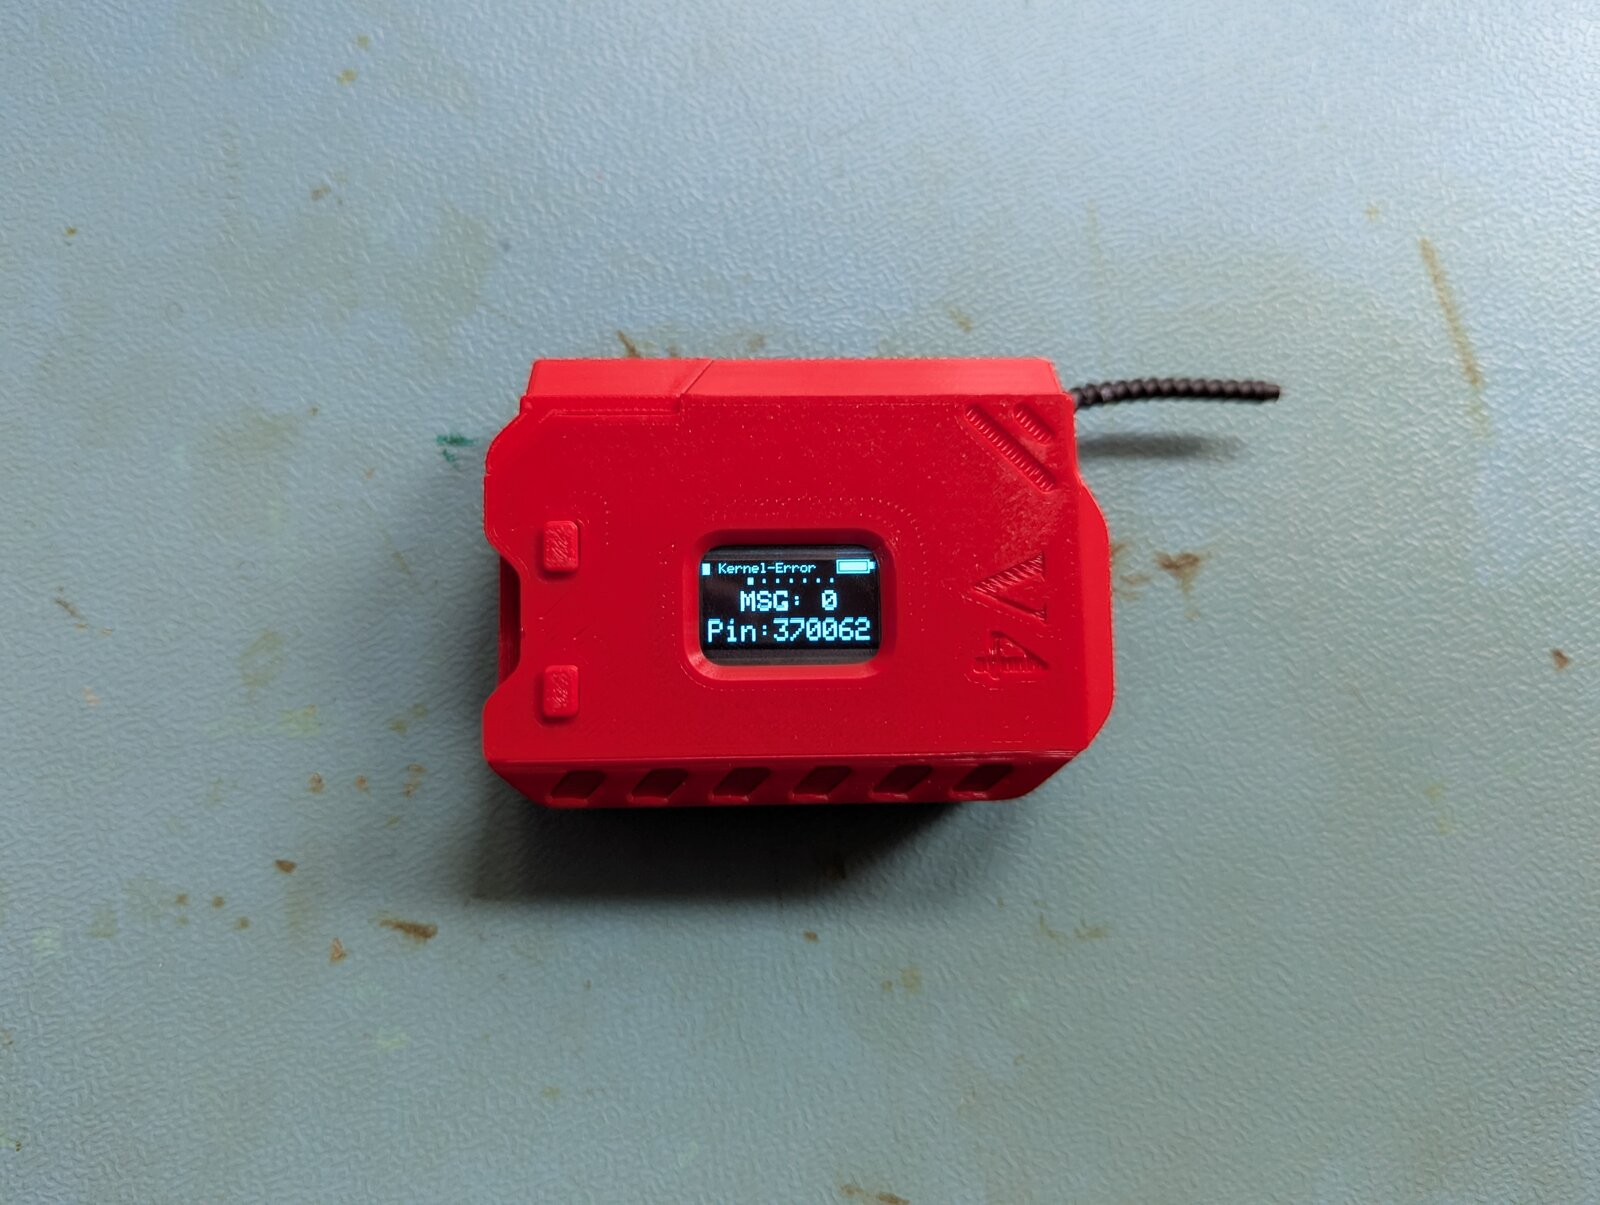
Rotes 3D-gedrucktes Gehäuse mit Heltec V4 und Akku auf einer Werkbankmatte, im Fenster das OLED mit Kernel-Error, Akkusymbol, MSG: 0 und Pin: 370062, oben rechts schaut die schwarze Federantenne heraus
Fertig für die Hosentasche: Heltec V4 mit LiPo im gedruckten Gehäuse. Das OLED zeigt den Namen ohne Emoji, der kleine Font kennt keine Emojis.

Vom Linux-Rechner aus: meshcore-cli und Meshy

Am PC benutze ich zwei Werkzeuge. Für die Kommandozeile gibt es meshcore-cli, installiert mit pipx, der Befehl heißt dann meshcli. Gekoppelt wird über BlueZ. Vorher am Handy Bluetooth aus, denn es gibt nur den einen BLE-Platz. Nach dem Pairing hält bluetoothctl die Verbindung gern offen, dann findet meshcli das Gerät nicht. Ein disconnect löst das.

$ pipx install meshcore-cli
$ bluetoothctl
[bluetooth]# agent KeyboardOnly
[bluetooth]# pair <BLE-MAC>
  (PIN vom OLED eingeben)
[bluetooth]# trust <BLE-MAC>
[bluetooth]# disconnect <BLE-MAC>
$ meshcli -a <BLE-MAC> ver
Model: Heltec V4.3 OLED

Mit meshcli komme ich an Dinge, die die App nicht zeigt, etwa die Funkstatistik mit get stats_radio oder node_discover, bei dem Repeater in direkter Reichweite mit ihren Empfangswerten antworten. Den Pfad-Hash kann man dort mit set path_hash_mode 1 auf 2 Byte stellen. Ein Tipp aus der Praxis: meshcli 1.6.5 holt die Kontakte mit einem Timeout von 5 Sekunden. Bei über hundert Kontakten über BLE reicht das nicht, dann behauptet das Tool, es gäbe keine. Die Python-Bibliothek dahinter mit längerem Timeout schafft es.

Für den Alltag am Schreibtisch nehme ich Meshy, einen grafischen MeshCore-Client für den Linux-Desktop. Meshy verbindet sich ebenfalls per BLE, zeigt Geräteinfos, Kontakte, Kanäle und eine Karte und kann Adverts senden, Pfade tracen und Nodes in der Nähe suchen.
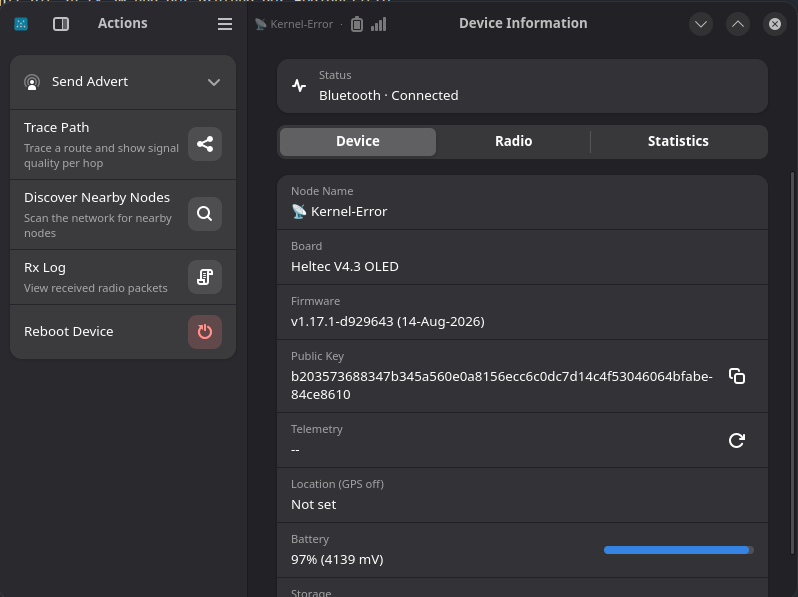
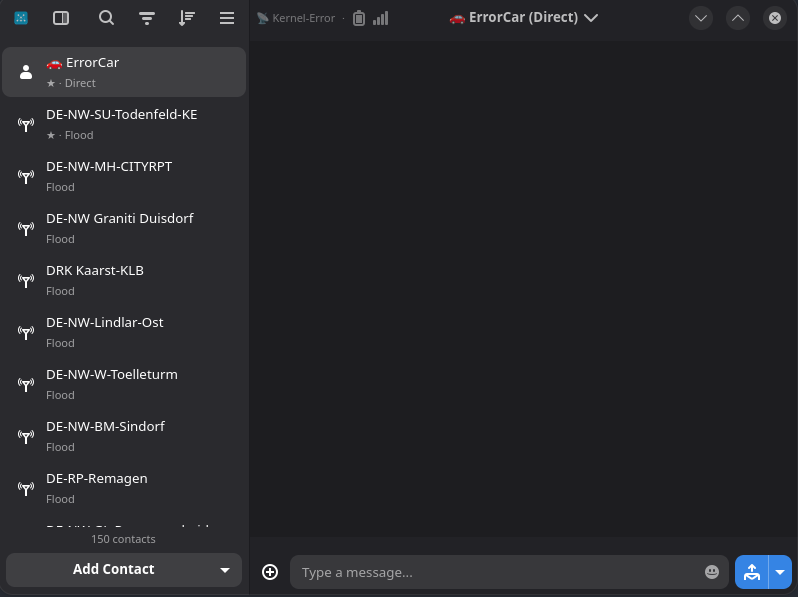
Meshy unter Linux, Ansicht Device Information: Status Bluetooth Connected, Node Name Kernel-Error, Board Heltec V4.3 OLED, Firmware v1.17.1-d929643 vom 14-Aug-2026, öffentlicher Schlüssel, Location GPS off, Battery 97 % bei 4139 mV, links Aktionen wie Send Advert, Trace Path, Discover Nearby Nodes und Rx Log
Meshy unter Linux: Geräteinfo des Companions, hier noch mit Firmware v1.17.1.
Meshy-Kontaktliste mit 150 Kontakten, oben ErrorCar als Favorit mit Direct-Route, darunter Repeater wie DE-NW-SU-Todenfeld-KE, DE-NW-MH-CITYRPT, DE-NW Graniti Duisdorf und DE-RP-Remagen mit Flood-Route
Kontakte in Meshy. Favoriten stehen oben, daneben steht, ob der Weg bekannt ist (Direct) oder geflutet wird (Flood).
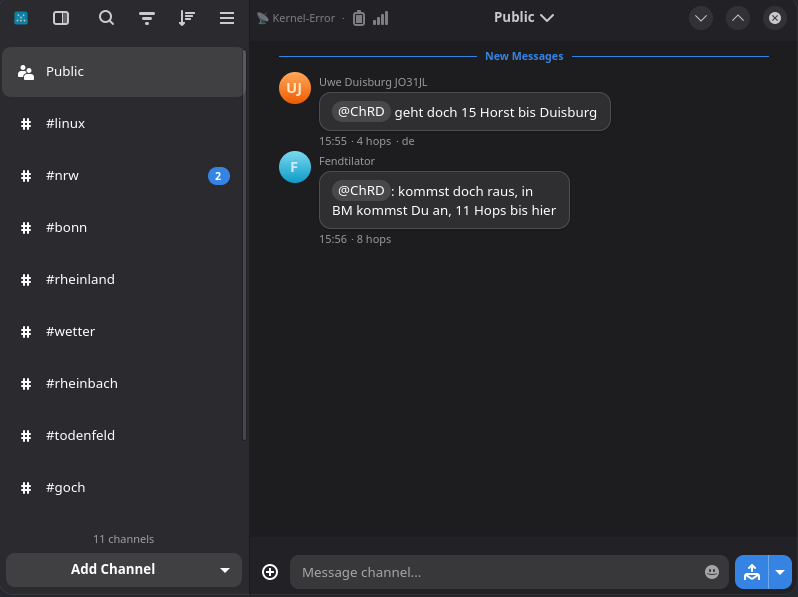
Meshy mit geöffnetem Kanal Public, links die Kanalliste mit Public, #linux, #nrw, #bonn, #rheinland, #wetter, #rheinbach, #todenfeld und #goch, rechts zwei Nachrichten mit den Angaben 4 hops und de sowie 8 hops
Der Public-Kanal in Meshy. Unter jeder Nachricht stehen Hop-Anzahl und, falls vorhanden, der Scope.

KiekR auf Android

Auf dem Handy bin ich inzwischen bei KiekR gelandet, einer alternativen Android-App von Marcel Verdult (kiekr.app). Sie ist Closed Source, das sollte man wissen. Mir gefällt sie trotzdem besser als die offizielle App, weil sie mehr vom Funk zeigt: den Scope pro Nachricht, eine Statistik und vor allem „Live-Funk“, eine Rohansicht aller empfangenen Pakete, auch der, die der Node nicht entschlüsseln kann. KiekR ersetzt die offizielle App, parallel geht wegen des einen BLE-Platzes nicht.
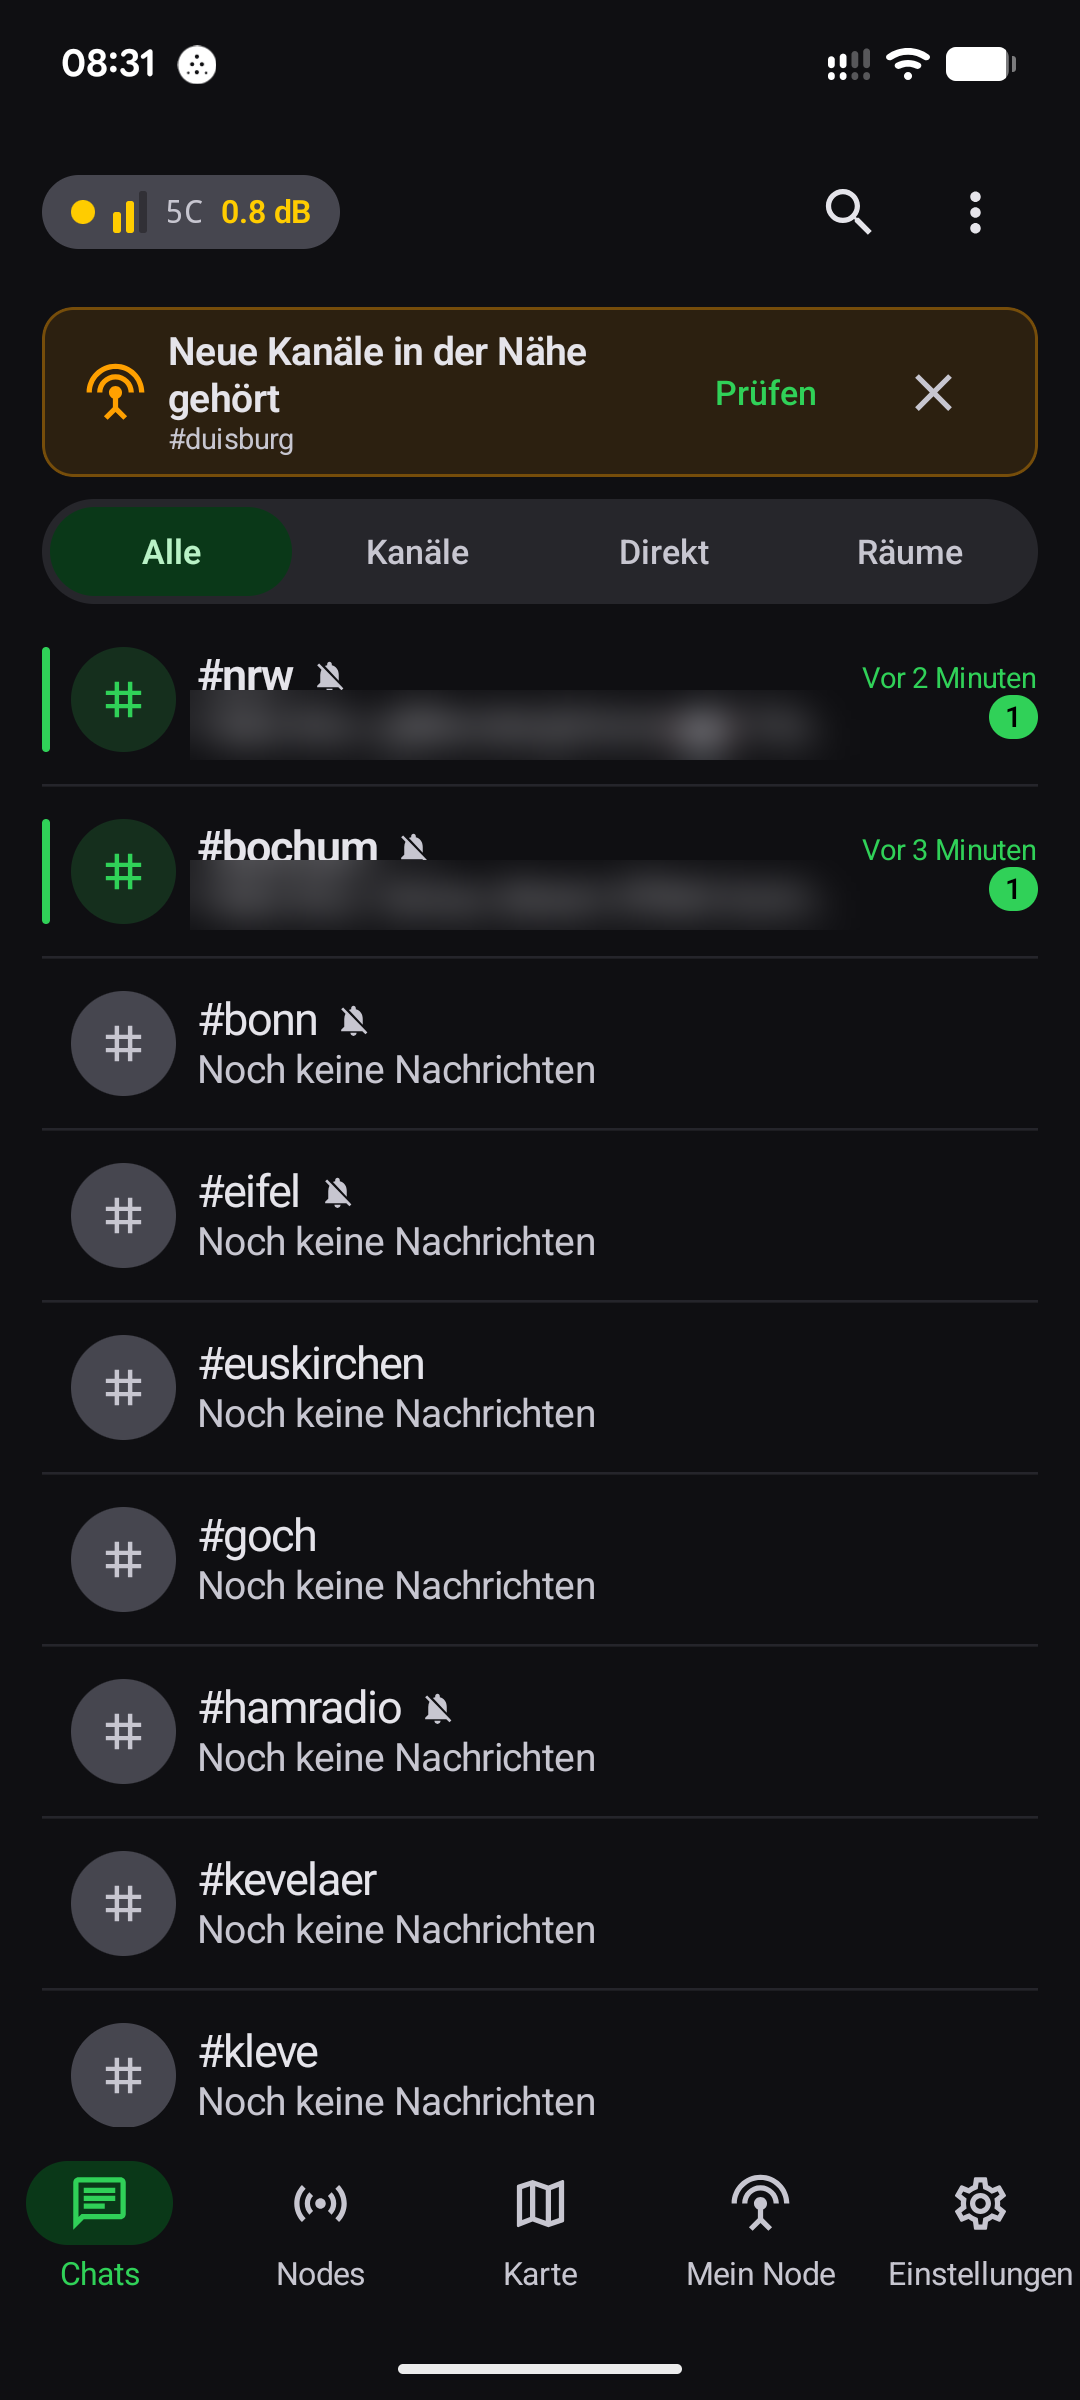
KiekR-Chatliste mit Kanälen #nrw, #bochum, #bonn, #eifel, #euskirchen, #goch, #hamradio, #kevelaer und #kleve, Nachrichtenvorschauen unscharf gemacht, oben ein Hinweis Neue Kanäle in der Nähe gehört: #duisburg
Die Chatliste in KiekR. Die App meldet sogar Hashtag-Kanäle, die in der Nähe gehört wurden.

An einem Morgen zu Hause hat der Live-Funk innerhalb weniger Minuten 250 Pakete gezeigt, rund 23 pro Minute. 232 davon waren für meinen Node nicht lesbar. Das ist kein Fehler, das sind Direktnachrichten, Anfragen und Antworten anderer Nodes und Kanäle, deren Schlüssel ich nicht habe. Schön zu sehen war auch, wie weit gescopte Floods laufen: Eine Anfrage mit Scope de kam über 17 und 18 Hops, mit 1-Byte-Pfad-Hashes. Jeder dieser Hops kostet Sendezeit. Warum das relevant ist, steht in Teil 6.
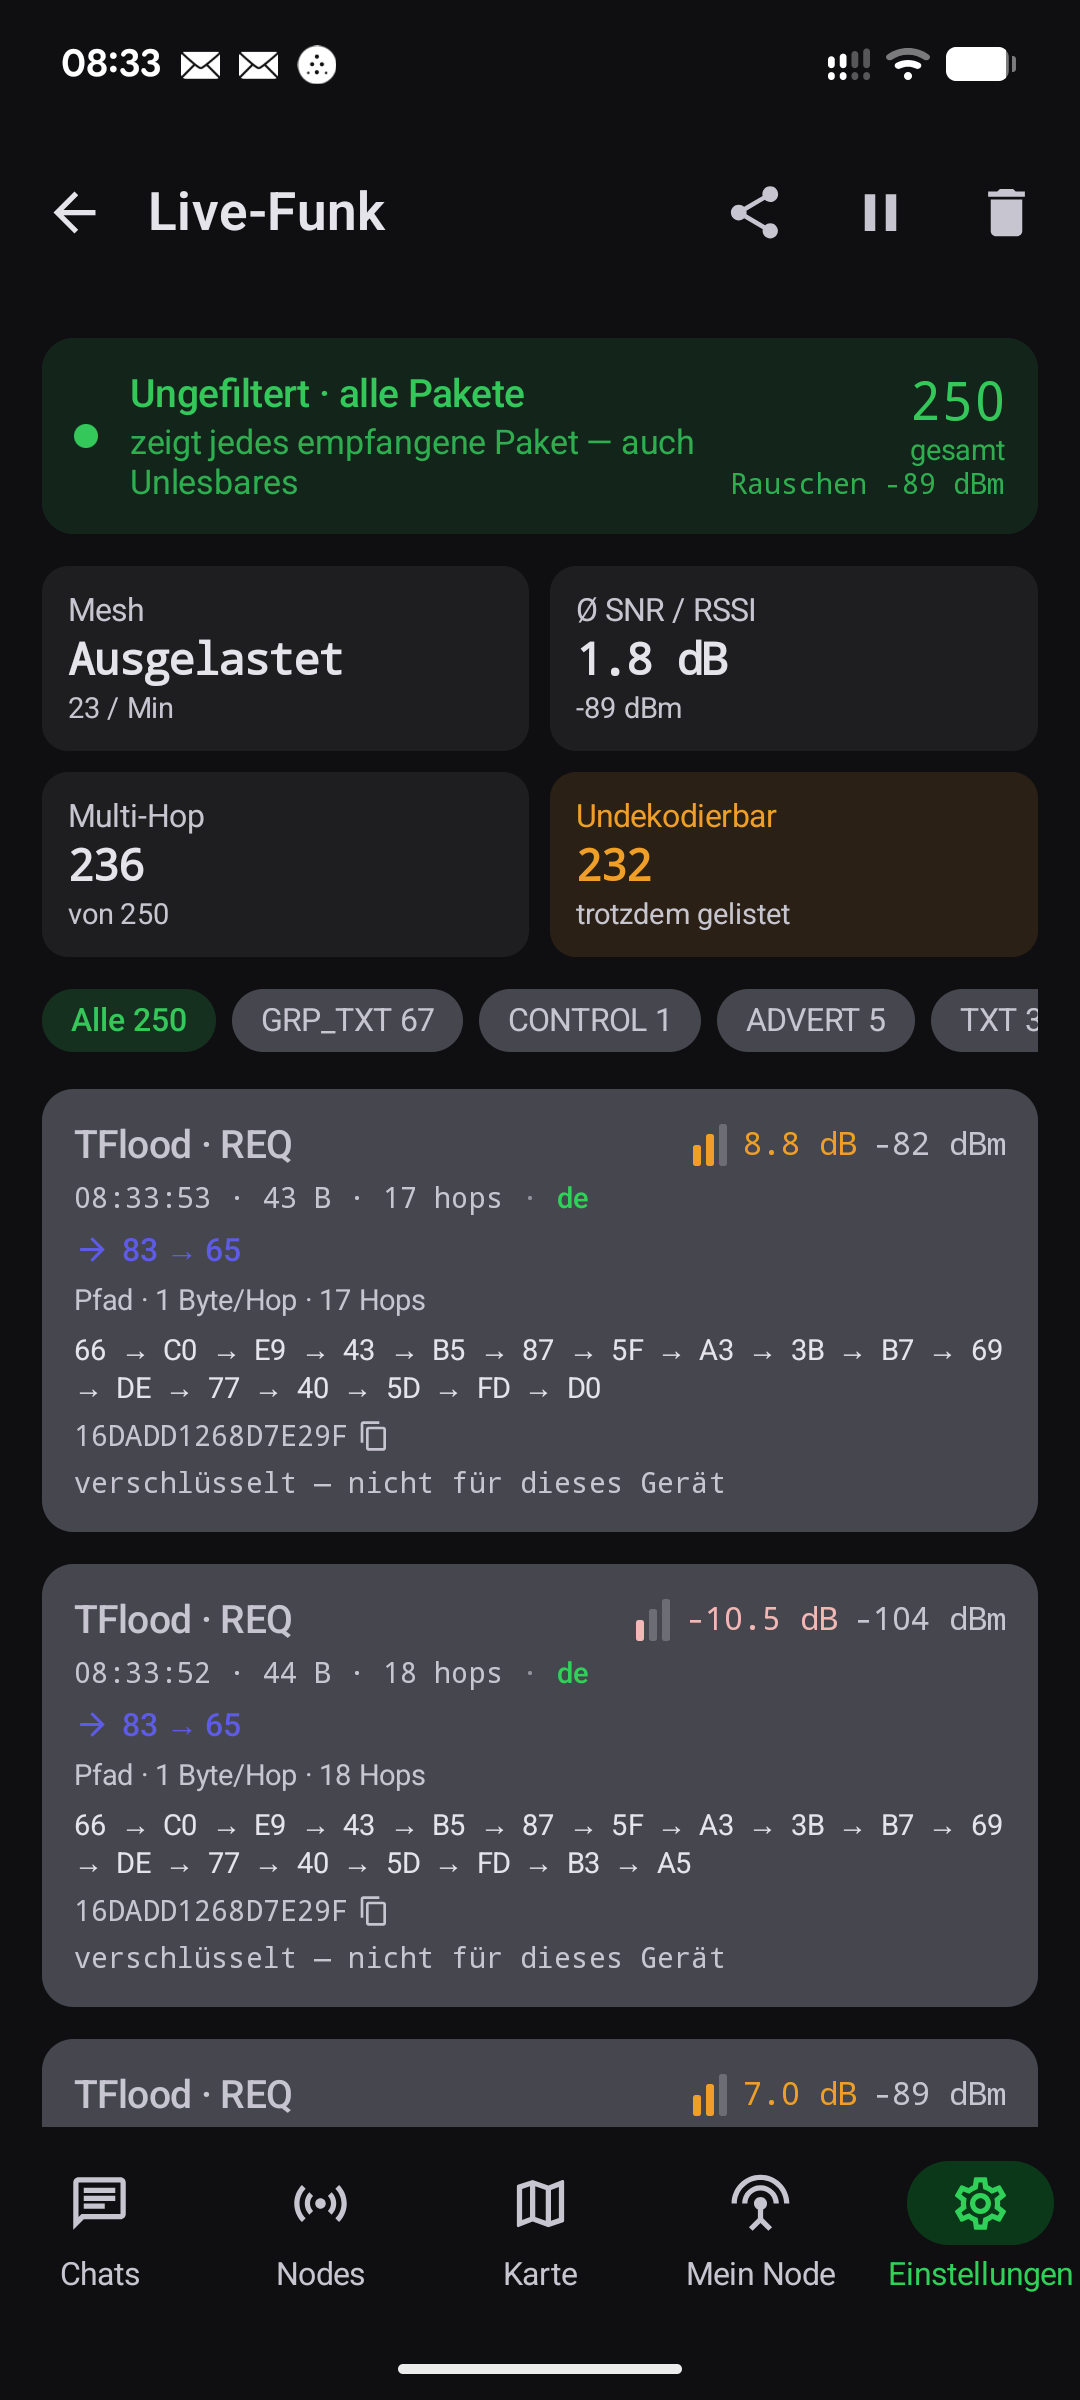
KiekR Live-Funk ungefiltert: 250 Pakete gesamt, Rauschen -89 dBm, Mesh ausgelastet mit 23 pro Minute, 236 Multi-Hop, 232 undekodierbar, darunter TFlood-REQ-Pakete mit 17 und 18 Hops, Scope de und Pfad mit 1 Byte pro Hop, Hinweis verschlüsselt, nicht für dieses Gerät
Live-Funk in KiekR: Die meisten Pakete sind verschlüsselt und nicht für diesen Node. Oben ein gescopter Flood über 17 Hops.
KiekR-Statistik: 336 Adverts gehört, 266 in den letzten 7 Tagen, 319 mit GPS, 336 Kontakte installiert, nach Typ 34 Chats, 292 Repeater, 10 Räume, 0 Sensoren, 0 Andere
336 Kontakte bei einem Limit von 350: Ohne „älteste überschreiben“ wäre die Tabelle bald voll.

KiekR hat außerdem optionale Community-Funktionen, etwa das Hochladen gehörter Repeater-Adverts auf Karten oder einen Observer-Modus, der Rohpakete an Analyse-Seiten weiterreicht. Die sind standardmäßig aus. Bevor du sie auf einem mobilen Node einschaltest, überleg kurz, was sie über deine Wege verraten.

Firmware-Update ohne Datenverlust

Mitten im Projekt erschien MeshCore v1.18.0 (Release-Notes). Unter anderem kann der BLE-Build für den Heltec V4 seitdem auch WLAN. Beim Update will ich weder Identität noch Kontakte verlieren, also gehe ich so vor:

  • Erst wieder ein volles 16-MB-Backup mit read-flash. Darin steckt der private Schlüssel, die Datei bekommt Rechte 600 und bleibt auf dem eigenen Rechner.
  • Die Partitionstabelle aus dem Backup lesen. Bei mir liegt die Anwendung ab 0x10000, Identität, Kontakte, Kanäle und Einstellungen liegen in einer eigenen Datenpartition weiter hinten.
  • Prüfen, ob Bootloader und Partitionstabelle im neuen Merged-Image identisch sind. Nur dann reicht es, das reine App-Image an 0x10000 zu schreiben.
  • Kein erase-flash. Damit bleiben Datenpartition und BLE-Kopplung unangetastet.
$ esptool --port /dev/ttyACM0 --baud 921600 read-flash 0 ALL backup/companion-before-1.18.0-16MB.bin
$ chmod 600 backup/companion-before-1.18.0-16MB.bin
$ esptool --port /dev/ttyACM0 --baud 921600 write-flash 0x10000 heltec_v4_companion_radio_ble-v1.18.0-81dbae5.bin

Das Schreiben hat acht Sekunden gedauert. Danach meldete sich der Node mit v1.18.0-81dbae5, gleichem Schlüssel, gleichem Namen, allen 244 Kontakten, allen Kanälen, 2-Byte-Pfad-Hash und Default-Scope #de. Auch das Pairing mit dem Handy hielt. Nur die Uhr lief nach den Resets ein paar Minuten hinterher. Nach einem Update also kurz die Zeit vom Handy oder PC synchronisieren. Keine Angst, hier fühlt man sich ganz schnell wieder zuhause, wenn man schon mal mit arduino, esp usw. gearbeitet hat.
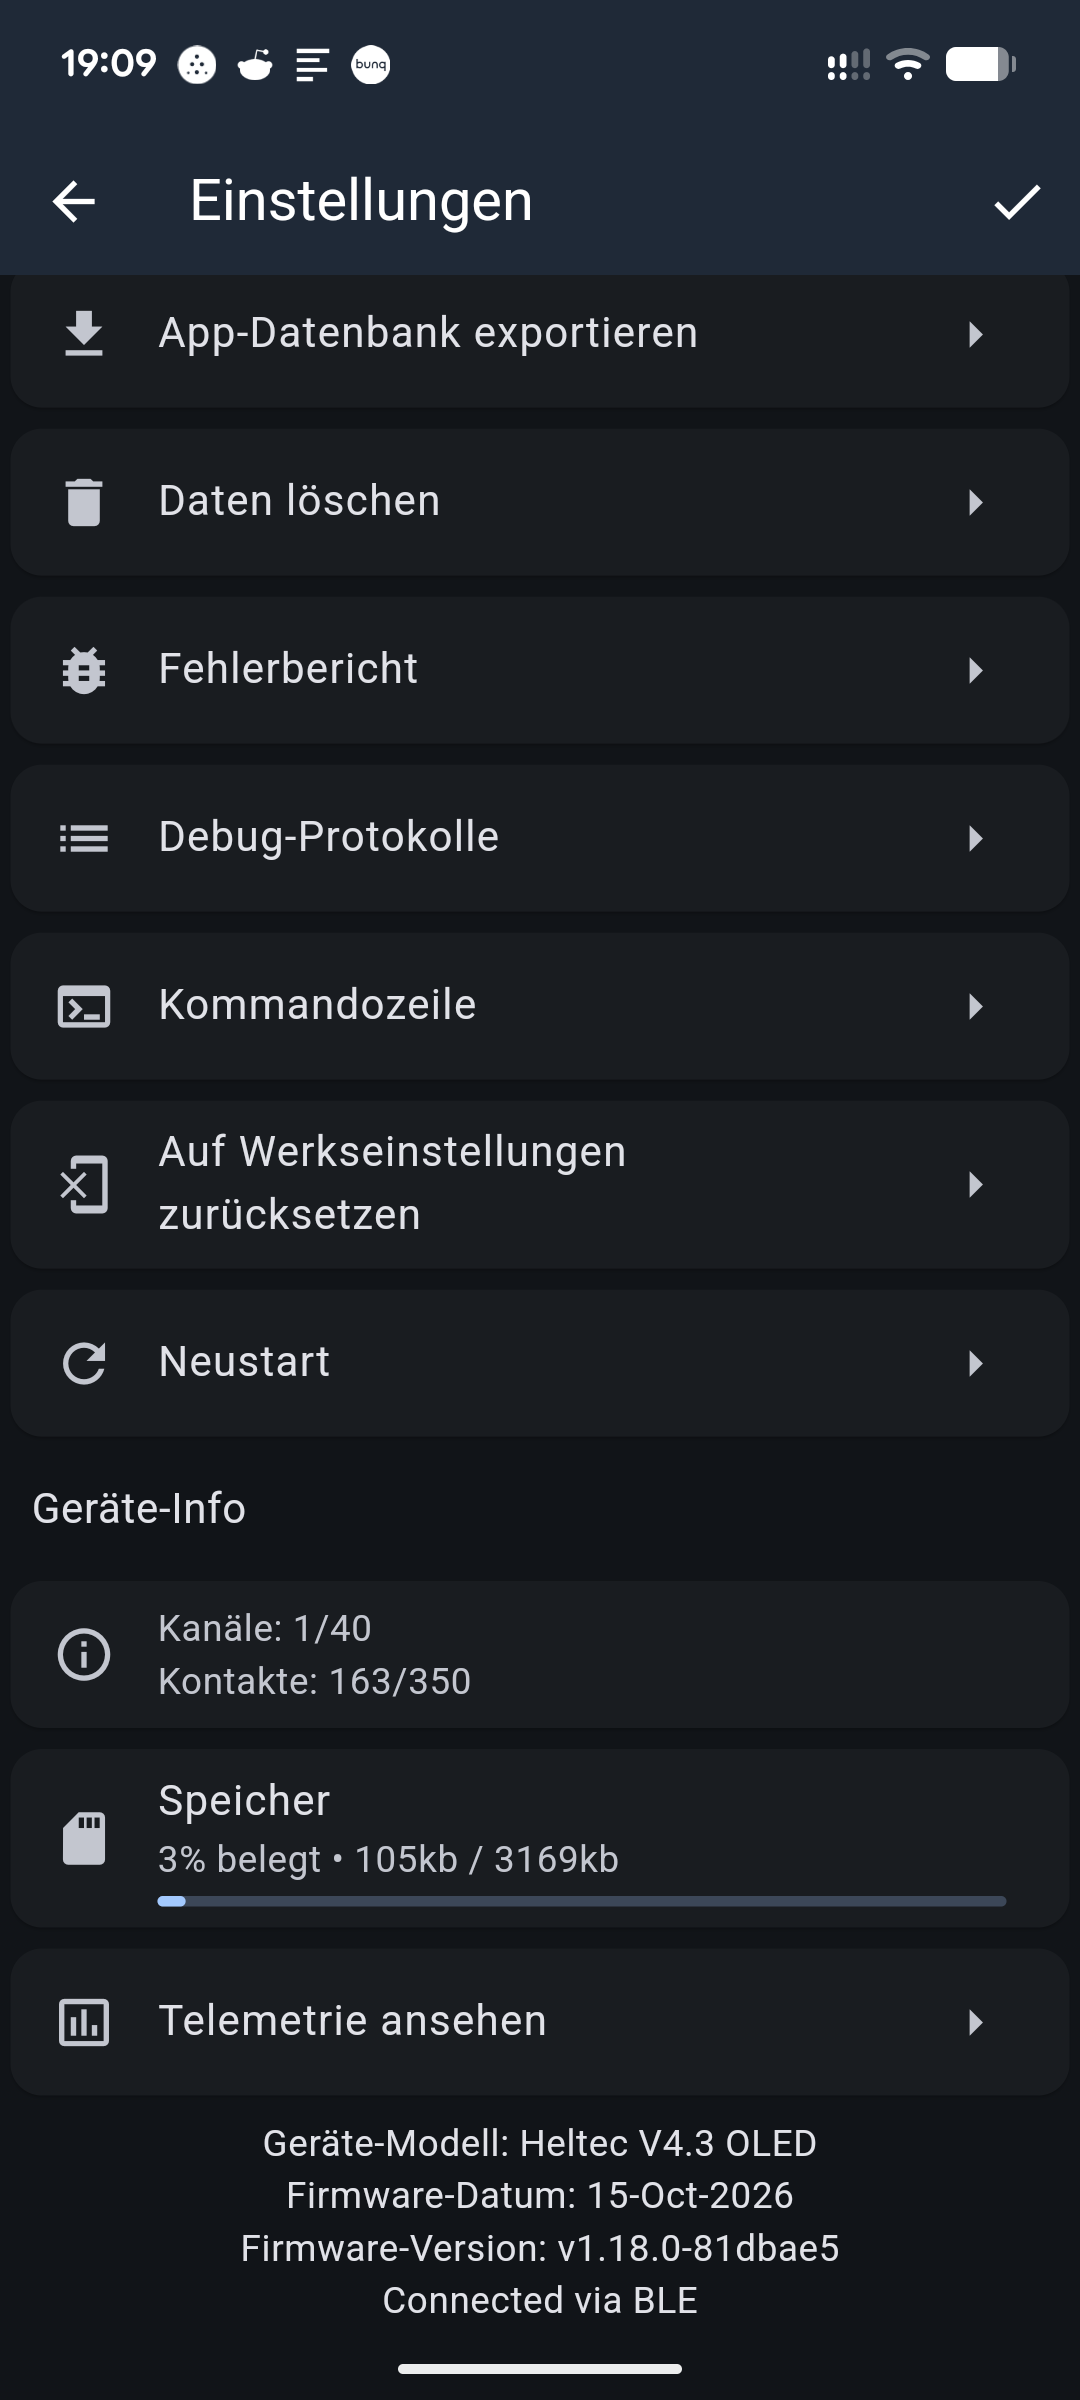
MeshCore-App, Einstellungsmenü mit App-Datenbank exportieren, Daten löschen, Fehlerbericht, Debug-Protokolle, Kommandozeile, Auf Werkseinstellungen zurücksetzen und Neustart, darunter Geräte-Info mit Kanäle 1/40, Kontakte 163/350, Speicher 3 % belegt, Geräte-Modell Heltec V4.3 OLED, Firmware-Datum 15-Oct-2026, Firmware-Version v1.18.0-81dbae5, Connected via BLE
Geräte-Info in der App nach dem Update auf v1.18.0.

Ein zweiter Node mit GPS fürs Auto

Als das Komplettset da war, habe ich meine Identität „Kernel-Error“ auf das neue Board umgezogen. SUPER WICHTIG: Ein Schlüssel gehört nur einem aktiven Gerät. Also zuerst das alte Board komplett löschen und neu flashen, dann auf dem neuen Board den gesicherten Export importieren. Pfad-Hash und Default-Scope stehen nicht im Export und müssen auf beiden Geräten neu gesetzt werden.

Das alte Board mit dem GPS-Modul hat einen neuen Schlüssel bekommen und wohnt jetzt als „ErrorCar“ im Auto. Die Position sendet es nicht im Advert. Stattdessen darf genau ein Kontakt, mein persönlicher Node, sie per Telemetrie abfragen. Die Antwort ist verschlüsselt, Repeater unterwegs sehen nur Chiffretext, und ohne Anfrage verrät das Auto gar nichts. Achtung: Das klappt nur, wenn neben der Standort-Telemetrie auch die Basis-Telemetrie für diesen Kontakt freigegeben ist, sonst antwortet der Node niemandem. Was ich mit dem Auto-Node sonst noch mache, zeige ich in Teil 5 über MeshMapper. Aber ich werde an dem Punkt nicht der Einzige sein, der den Satz „ich kann remote also die GPS Position abfragen?“ im Kopf hatte. Damit ist auch klar, warum ich an Sensoren denke und öhm einen GPS Tracker?!

Was du jetzt tun kannst

Wenn du selbst einsteigen willst, ist das Heltec-V4-Komplettset mit Gehäuse und 3000-mAh-Akku der bequemste Weg: Antenne an die LoRa-Buchse, Backup ziehen, MeshCore drauf, Preset deiner Region wählen, Advert senden und im Public-Kanal auf das erste „Repeater empfangen“ warten. Wer gleich einen Companion fürs Auto oder ein zweites Board für einen eigenen Repeater haben möchte, bekommt den Heltec V4 mit L76K-GPS im Doppelpack. Eins solltest du dabei wissen: Der V4 ist ein ESP32-S3 mit zusätzlichem Verstärker und braucht deutlich mehr Strom als Boards mit nRF52-Chip, etwa der RAK4631. Für meinen Einstieg war mir das egal. Wer lange am Akku laufen will, schaut sich besser so ein Board an. Und wenn du mich hinzufügst, freue ich mich über ein kurzes „Moin“ per Direktnachricht.

Siehe auch: Teil 1: LoRa und MeshCore, Teil 3: Der Repeater, Teil 4: Antennen und Messen, Teil 5: MeshMapper, Teil 6: Konfiguration, die zählt.

Links zu Amazon und AliExpress sind Affiliate-Links: Kaufst du darüber, bekomme ich eine kleine Provision, für dich ändert sich am Preis nichts. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen.

Wenn ihr Fragen habt oder euer Companion partout keinen Repeater hören will, dann dürft ihr mich gerne fragen.
LoRa-Mesh mit MeshCore, Teil 1: LoRa, Routing und warum MeshCore

Heltec WiFi LoRa 32 V4 mit MeshCore-Firmware und GPS-Modul vor einer Landschaft im Rheinland. Funkverbindungen zwischen mehreren Repeatern veranschaulichen ein dezentrales LoRa-Mesh-Netzwerk ohne Internet oder Mobilfunk.

Textnachrichten über zig Kilometer verschicken, ohne Mobilfunk, ohne Internet und ohne dass irgendwo ein Server stehen muss. Mit ein paar Euro Hardware und einer ordentlichen Antenne geht das inzwischen ziemlich gut. Die Technik dahinter heißt LoRa, und darauf laufen verschiedene Mesh-Projekte. Ich habe mich hier für MeshCore entschieden und betreibe inzwischen einen festen Repeater auf dem Dach, einen Node fürs Handy und einen fürs Auto. Weil… Weil ich wohl noch immer ein Tech Nerd bin, den man mit so etwas bekommt. Dezentral, offen, community und nützlich!

Daraus ist wieder mal eine kleine Serie geworden. Die Teile sind geschrieben und die Veröffentlichung ist wieder wöchentlich geplant, wie auch bei der Bios Serie. Das klappt ja so ganz gut, nur manche Links auf die Folgebeiträge sind damit eher eine Art Cliffhanger geworden; was aber auch zu einer Serie passt, oder? Dieser erste Teil erklärt, wie so oft, die Grundlagen: was LoRa auf der Funkseite macht, welche Regeln im 868-MHz-Band gelten, wie MeshCore Nachrichten durch das Netz bringt und warum ich nicht beim vorinstallierten Meshtastic geblieben bin. Am Ende findest du eine Übersicht über alle sechs Teile.

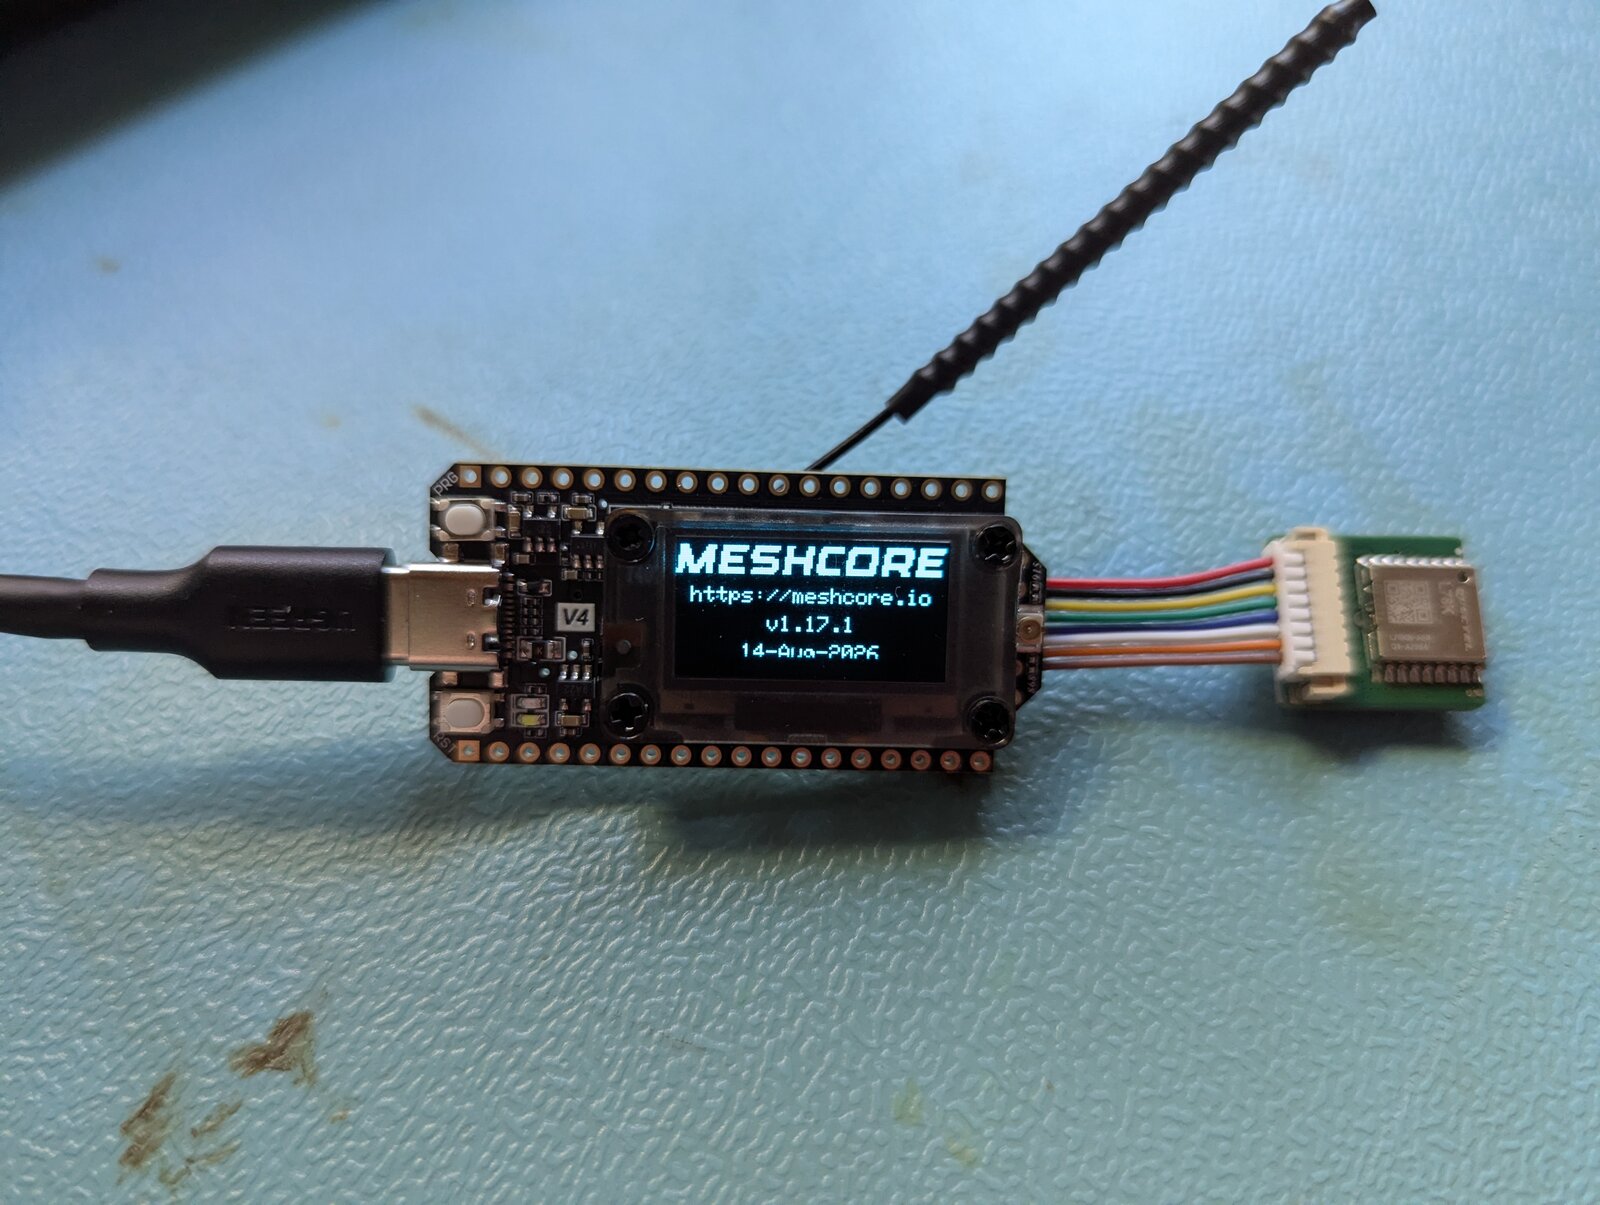
Heltec WiFi LoRa 32 V4 am USB-C-Kabel, das OLED zeigt den MeshCore-Schriftzug, https://meshcore.io und die Firmware v1.17.1, rechts hängt ein L76K-GPS-Modul am Flachbandkabel
Der erste Start: ein Heltec V4 mit frisch geflashter MeshCore-Firmware v1.17.1

Was LoRa ist

LoRa (Long Range) ist ein Funkverfahren von Semtech. Es ist nur die physikalische Schicht, also wie Bits über die Luft gehen. LoRaWAN ist etwas anderes: ein Netzwerkprotokoll mit Gateways und zentralen Servern, wie man es von Sensoren und TTN kennt. MeshCore und Meshtastic nutzen dagegen nur die LoRa-Modulation und bauen ihr eigenes Mesh darauf.

Technisch ist LoRa ein Chirp-Spread-Spectrum-Verfahren. Ein Symbol ist ein Chirp, also ein Ton, dessen Frequenz gleichmäßig über die gesamte Bandbreite läuft. Die Information steckt darin, an welcher Stelle der Chirp startet. Der Empfänger korreliert gegen diese bekannte Form und kann ein Signal noch dekodieren, wenn es deutlich unter dem Rauschen liegt. Daher kommt die Reichweite. Wie sich das im Detail verhält, legen drei Parameter fest:

  • Spreading Factor (SF) legt fest, wie viele Bits ein Symbol trägt, von SF5 bis SF12. Ein Symbol besteht aus 2^SF Chips. Jede Stufe höher verdoppelt die Symboldauer, das Signal wird robuster und lässt sich bei schlechterem Signal-Rausch-Abstand noch empfangen, braucht aber doppelt so lange.
  • Die Bandbreite (BW) sagt, wie breit der Chirp ist, typisch 62,5, 125 oder 250 kHz. Schmaler heißt langsamer, aber auch weniger Rauschen im Empfänger.
  • Die Coding Rate (CR) ist der Anteil der Vorwärtsfehlerkorrektur. Bei 4/5 kommen auf vier Nutzbits fünf gesendete, bei 4/8 acht. Mehr Redundanz kostet Sendezeit, verzeiht dafür kaputte Bits.

Bei SF8 und 62,5 kHz dauert ein Symbol 2^8 / 62.500 Hz, also rund 4,1 ms. Daraus ergibt sich die Airtime, die Zeit, die ein Paket den Kanal belegt. Und die ist bei LoRa die knappe Ressource. Es gibt nur einen Kanal, alle teilen ihn sich, und jede Millisekunde, in der ein Node sendet, kann kein anderer in Reichweite sinnvoll senden. Ein Mesh, in dem jeder Node alles wiederholt, läuft deshalb schnell voll. Zugegeben, dass löst flashbacks aus, in eine Zeit in welcher ich mich mit BNC Netzwerken beschäftigen „durfte“.

Der Rahmen: 869,4 bis 869,65 MHz

In Europa funken MeshCore und Meshtastic im 868-MHz-Bereich. Dafür braucht man keine Lizenz, muss sich aber an die Allgemeinzuteilung halten. Für das Teilband, in dem die Community hier unterwegs ist, gelten laut BNetzA Vfg 91/2025 (Band 54, entspricht ERC REC 70-03) diese Eckdaten (die werden wir später noch wieder sehen und immer mal wieder kontrollieren, dass wir uns daran auch sicher halten):

  • Frequenzbereich 869,4 bis 869,65 MHz
  • maximal 500 mW ERP, das sind 27 dBm
  • höchstens 10 % Duty Cycle, also maximal 360 Sekunden Sendezeit pro Stunde und Gerät

ERP heißt Effective Radiated Power und bezieht sich auf die Abstrahlung einer Dipolantenne. Wichtig ist: Der Antennengewinn zählt mit. Weil ERP gegen den Dipol rechnet, gehen vom dBi-Wert 2,15 dB ab. Wer am Board 27 dBm einstellt und dann eine Antenne mit mehr als 2,15 dBi Gewinn anschraubt, liegt drüber. Kabelverluste ziehen wieder etwas ab. Beim Heltec V4 mit seinem zusätzlichen Leistungsverstärker ist das kein theoretisches Thema, mit einer Außenantenne kommt man auf dem Papier schnell an die Grenze. Wie man das ausrechnet und warum Messen mit Hobby-Equipment schwierig ist, steht ausführlich in Teil 4.

Die 10 % Duty Cycle klingen nach viel. Bei Paketen, die eine Drittelsekunde bis eine ganze Sekunde dauern, ist ein viel genutzter Repeater aber schneller am Limit, als man denkt. Airtime zählt also zweimal, einmal auf dem gemeinsamen Kanal und einmal im eigenen Budget. Klingt schon fast wie Afu (Amateurfunk) und ja man beschäftigt sich zum Teil mit den gleichen Dingen und Physik.

Das Preset hier in der Region

Damit sich Nodes überhaupt hören, müssen Frequenz, Bandbreite, SF und CR exakt übereinstimmen. Die Community im Rheinland nutzt das Preset „EU/UK (Narrow)“. Bei mir sind das diese konfigurierten Werte:

Frequenz:    869.618 MHz
Bandbreite:  62.5 kHz
SF:          8
CR:          8   (= 4/8)

Nominell belegt der Kanal damit 869,618 MHz plus/minus 31,25 kHz, also 869,58675 bis 869,64925 MHz. Das liegt im Teilband, bis zur oberen Kante bleiben aber nur 750 Hz. Das ist die rechnerische Spanne aus Mittenfrequenz und Bandbreite, keine Messung der tatsächlichen Aussendung.

Schmale Bandbreite mit SF8 heißt nicht automatisch kurze Pakete. Ich habe das mit der Time-on-Air-Formel aus dem SX126x-Datenblatt nachgerechnet (CRC an, expliziter Header, für MeshCore 32 Symbole Präambel, die die Firmware bei SF8 setzt, für LongFast 16), daneben das Meshtastic-Standardpreset LongFast:

NutzlastMeshCore SF8 / 62,5 kHz / CR 4/8SF8 / 62,5 kHz / CR 4/5Meshtastic LongFast SF11 / 250 kHz / CR 4/5
20 Byte378 ms304 ms395 ms
50 Byte607 ms447 ms641 ms
100 Byte1033 ms714 ms1010 ms
180 Byte1689 ms1123 ms1583 ms

Die Airtime liegt also ungefähr auf dem Niveau von LongFast, mit CR 4/8 etwas darüber. CR 4/8 bringt Robustheit und bezahlt sie mit Sendezeit. Auch die theoretische Empfindlichkeit ist ähnlich, rund -130 dBm für SF8 bei 62,5 kHz gegenüber rund -131,5 dBm für SF11 bei 250 kHz. Beides sind gerechnete Schätzwerte, keine Messungen. Ich bin auch nur eine Wurst, korrigiert mich also bitte unbedingt. Einfach als Kommentar, oder ihr erreicht mich über einen anderen Weg, vielleicht sogar direkt über das MeshCore Netz? So kann ich lernen, besser werden, euch dankbar sein und es hier korrigieren.

Was MeshCore ist

MeshCore ist eine Open-Source-Firmware für LoRa-Boards wie den Heltec V4 oder RAK-WisBlock-Module. Es gibt sie in mehreren Varianten, und die Rolle eines Geräts wird damit fest gesetzt:

  • Ein Companion ist das Funkmodem für dein Handy oder deinen Rechner. Die Oberfläche und der Nachrichtenverlauf leben in der App, die per Bluetooth oder USB verbunden ist. Der Node selbst speichert Kontakte und puffert eingehende Nachrichten, solange das Handy weg ist.
  • Ein Repeater ist Infrastruktur. Er läuft unbeaufsichtigt, idealerweise hoch oben, und leitet Pakete für andere weiter.
  • Ein Room Server ist eine Art kleines Forum auf Funkbasis, dazu weiter unten mehr.

Diese Trennung ist der zentrale Unterschied zu einem Mesh, in dem jedes Gerät mitwiederholt. Bei MeshCore übernehmen das die Repeater. Meine Companions haben den Repeat-Modus aus. Einen eingeschränkten Companion-Repeat gibt es nur für spezielle Frequenzen. Und auch die Repeater wiederholen nicht blind alles: Berechtigte Repeater leiten weiter, abhängig von Scope, Duplikaterkennung, Hop-Limits und Airtime-Budget. Der Repeater-Modus an meinem Companion ist nicht dafür gedacht, wirklich als Repeater im ganzen Netzwerk zu arbeiten, sondern eher, wenn man mit einer kleinen Gruppe unterwegs ist, vielleicht sogar an einer Stelle, an welcher kein anderer Empfang ist und dennoch die Kommunikation sichergestellt sein soll. Klar es gibt den direkten Weg zwischen den einzelnen Geräten aber wenn man mit einer kleinen Gruppe eine längere Wanderung macht, kann es ja passieren, dass die ersten ein gutes Stück weiter vorne sind und die letzten deutlich zurück, dann kann ein Companion mit Repeater-Modus in der Mitte schon helfen, nur ist die Gruppe auf diesen speziellen Frequenzen dann raus aus dem Mesh-Rheinland-Netz.

Flood, Direct und Pfad-Hashes

MeshCore kennt zwei Arten, ein Paket zu verschicken. Beim Flood Routing sendet der Absender das Paket einfach aus, und jeder berechtigte Repeater, der es hört, sendet es nach einer kleinen zufälligen Verzögerung erneut. Die Verzögerung soll verhindern, dass mehrere Repeater gleichzeitig senden. Stellt euch einfach einen Saal voll Leute vor, wenn alle gleichzeitig schreien, hört man auch wieder nichts. Hört ein Repeater dasselbe Paket ein zweites Mal, verwirft er es. Dafür merkt er sich die Hashes der Pakete, die er gesehen hat, nicht die Kennungen der Nodes. Der Hash wird über Pakettyp und Nutzdaten gebildet, ohne Pfad. Die Liste ist ein Ringpuffer mit maximal 160 Einträgen, neue Einträge überschreiben die ältesten. „Dasselbe Paket ein zweites Mal“ erkennt der Repeater also nur, solange es noch in diesen letzten 160 Einträgen steht. Was bisher wohl ganz okaiish klappt, zumindest habe ich noch kein Problem bewusst gesehen.

Gegen Schleifen gibt es einen eigenen Mechanismus, nur für Flood-Pakete. Der Repeater zählt, wie oft sein eigener Pfad-Hash schon im Pfad des Pakets steht, und leitet ab einer bestimmten Anzahl nicht mehr weiter. Wie streng das ist, stellt man mit set loop.detect auf off, minimal, moderate oder strict ein. Mit 2-Byte-Pfad-Hashes und minimal, wie bei mir, ist bei zwei Vorkommen Schluss. Details stehen in der MeshCore CLI-Doku zur Loop Detection.

Dabei wird übrigens die Uhr wichtig. Der Zeitstempel des Absenders steckt in den verschlüsselten Nutzdaten. Weil die Verschlüsselung deterministisch ist, ist er bei Textnachrichten das, was zwei gleiche Texte zu zwei verschiedenen Paketen macht. Bei Text- und Kanalnachrichten aus der App liefert die App diesen Zeitstempel vom Handy mit, da spielt die Uhr des Nodes keine Rolle. Seine eigene Uhr nutzt der Node aber für seine Adverts und für die Anmeldung an Repeatern und Room Servern. Beides ist über den Zeitstempel gegen Wiederholung geschützt: Ein Advert, das älter ist als das zuletzt gesehene, wird ignoriert, und eine Anmeldung per Passwort mit älterem Zeitstempel als die letzte wird abgelehnt. Kommt ein Node nach einem Neustart mit falscher, zurückgestellter Uhr hoch, laufen seine Adverts und Anmeldungen also im Zweifel ins Leere, bis die Uhr wieder stimmt. Noch ein Grund für die RTC, zu der ich in Teil 3 komme.

Jeder Repeater hängt beim Weiterleiten eine kurze Kennung an das Paket, die ersten ein bis drei Bytes seines öffentlichen Schlüssels. MeshCore nennt das Pfad-Hash, es ist aber einfach der Anfang des Schlüssels. Ein Flood-Paket trägt also die Liste der Repeater mit, über die es gelaufen ist, zum Beispiel 84ca. Kommt eine Direktnachricht so beim Empfänger an, kennt er damit den Weg und schickt ihn zusammen mit der Bestätigung an den Absender zurück. Danach kennen beide Seiten einen funktionierenden Pfad.

Ab dann greift Direct Routing: Das Paket bekommt den bekannten Pfad mit, und nur der jeweils nächste Repeater in dieser Liste leitet weiter. Alle anderen bleiben still. Das spart eine Menge Airtime. Bricht der Pfad weg, etwa weil du mit dem Handy-Node unterwegs bist und ein anderer Repeater näher ist, fällt die Nachricht wieder auf Flood zurück, und der Pfad wird neu gelernt. Ich muss zugeben, den Punkt erst spät verstanden zu haben. *hust* bestimmt weil ich da nicht hin geschaut habe (klingt fast, wie eine Ausrede oder?).

Wie groß so ein Pfad-Hash ist, legt der Absender fest, möglich sind 1, 2 oder 3 Byte pro Hop. Bei einem Byte kollidieren die Kennungen in einer so dichten Gegend wie hier ständig, deshalb bittet die lokale Community um 2 Byte. Warum das so ist und wo man es einstellt, steht in Teil 6.

Damit Nodes sich überhaupt kennen, gibt es Adverts. Ein Advert ist ein signiertes Paket mit öffentlichem Schlüssel, Name, Typ und optional einer Position. Repeater senden ihre Adverts in langen Abständen als Flood, hier in der Gegend typischerweise etwa alle 50 Stunden. Companions schicken ihr Advert normalerweise nur, wenn du es in der App auslöst. Die App legt gehörte Nodes dann als Kontakt an. Adverts zu spammen ist also eher nicht sinnvoll. Wenn du an einem neuen Ort bist oder neue weitere Companions in der Nähe sind, mit welchen du deinen „Kontakt“ teilen möchtest, dann hau halt einen Advert raus. Einfach so, doof. Kurz: Adverts am Companion senden, sollte immer einen Grund haben, den du erklären kannst. „Nur mal so“ ist dabei kein Grund.

Ein letztes Konzept nur als Vorgeschmack: Region-Scopes. Ein Flood-Paket kann eine Region wie de oder rheinland tragen, und Repeater entscheiden anhand dieser Markierung, ob sie es weiterleiten. Hier im Rheinland ist das der wichtigste Stellhebel überhaupt, er bekommt in Teil 6 seinen Platz, also öhm, noch warten bis ihr das lesen könnt.

Kontakte, Schlüssel und warum der Name nichts beweist

Jeder MeshCore-Node hat ein Ed25519-Schlüsselpaar. Der öffentliche Schlüssel ist 32 Byte lang und ist die eigentliche Identität. Der Name im Advert ist zwar von der Signatur abgedeckt, aber nicht eindeutig. Jeder kann seinen Node „Kernel-Error“ nennen. Ein Kontakt mit passendem Namen sagt also nur, dass irgendwer diesen Namen gewählt hat.

Wer denkt schon jetzt an Verschlüsselung? Ja, ich auch. Ihr wisst ja, wie gerne ich Verschlüsselung habe und diese gibt es auch hier. Vielleicht mit ein Grund, warum mich das Thema so abholt? Für Direktnachrichten leiten beide Seiten per ECDH aus ihren statischen Schlüsseln ein gemeinsames Geheimnis ab. Die Nutzlast wird mit AES-128 verschlüsselt, blockweise im ECB-Modus, und mit einem auf 2 Byte gekürzten HMAC-SHA256 abgesichert. Das spart Bytes, hat aber Folgen: keine Forward Secrecy, gleiche 16-Byte-Blöcke sehen unter ECB gleich aus, und ein gefälschtes Paket kommt mit einer Wahrscheinlichkeit von 1 zu 65.536 durch den MAC. Pfade und Pakettypen sieht ohnehin jeder, der mithört. Gegen neugierige Zuhörer reicht das. Für Vertrauliches nimm einen Ende-zu-Ende-Messenger.

Denkst du genau jetzt an dein WhatsApp auf dem Smartphone? btw.: MeshRheinland verweist da auf ihre WhatsApp Community, was mich etwas enttäuscht.

Kanäle nutzen dagegen einen gemeinsamen 16-Byte-Schlüssel. Der des Public-Kanals ist überall derselbe, der Kanal ist also öffentlich. Ich habe auch noch ein paar Screenshots für euch, da habe ich öffentliche Informationen/Nachrichten auch nicht weiter versteckt. Weil, na sie eh für jeden öffentlich einsehbar sind 😀

Wenn du sicher sein willst, mit wem du schreibst, vergleichst du den öffentlichen Schlüssel über einen unabhängigen Weg, also persönlich per QR-Code, über einen bereits verifizierten Messenger oder am Telefon. Ein Advert mit dem richtigen Namen ist keine Verifikation. Wie das in der App aussieht, zeige ich in Teil 2, dort steht auch der Kontakt meines Companions.

Room Server

Kanäle sind reine Broadcasts. Wer gerade nicht empfängt, hat die Nachricht verpasst. Ein Room Server löst das wie ein kleines Schwarzes Brett: Mitglieder melden sich an, die letzten 32 Beiträge liegen in einem Ringpuffer auf dem Node und werden jedem angemeldeten Mitglied einzeln und verschlüsselt zugestellt. Wer beim Schreiben offline war, bekommt die verpassten Beiträge nach der nächsten Anmeldung nachgeliefert, aber nur, solange sie noch in diesen 32 Einträgen stehen. Ob ein Raum offen ist, entscheidet sein Betreiber über das Passwort. Mit allow.read.only dürfen auch Gäste ohne Passwort mitlesen. Hier in der Umgebung gibt es mehrere, darunter „Hi @ meshrheinland.de“ von der Community.

Warum MeshCore und nicht Meshtastic

Der Heltec V4 kam mit Meshtastic vorinstalliert, und Meshtastic ist ein ausgereiftes Projekt mit großer Verbreitung und guten Apps. Dort können je nach Rolle auch Endgeräte weiterleiten, MeshCore trennt Endgerät und Infrastruktur strikter, was geil ist. Entscheidend war für mich aber noch etwas anderes. Ein Mesh ist nur so gut wie die Nodes in Funkreichweite, also wollte ich wissen, was hier wirklich läuft.

Dafür habe ich die öffentlichen Node-Listen beider Projekte als JSON gezogen, für Meshtastic von meshmap.net, für MeshCore von map.meshcore.dev. Ein kleines Python-Skript filtert nach Luftlinie um meinen Standort im Raum Rheinbach und nach dem Zeitpunkt, an dem der Server den Node zuletzt gesehen hat. Achtung, falls du das nachbaust: Nimm den serverseitigen Zeitstempel. Das Feld last_advert bei MeshCore stammt von der Uhr des Nodes, und die liegt teils Jahre daneben, manchmal auch in der Zukunft. Die Teile haben meist keine RTC und daher kommen die gerne beim Restart mit „irgendwas“ an Datum/Uhrzeit hoch. Keine Sorge, wie wir eine RTC dazu bekommen und das rebootfest machen, kommt auch noch.

RadiusMeshCore 24 hMeshtastic 24 hMeshCore 14 TageMeshtastic 14 Tage
1 km4050
5 km4060
10 km73113
20 km335625
40 km912019220

Die Zahlen sind kumulativ. Von den 192 MeshCore-Nodes im 40-km-Radius waren 177 Repeater, 9 Room Server und 6 Companions. Der nächste MeshCore-Repeater stand nur wenige hundert Meter entfernt, der nächste Meshtastic-Router einige Kilometer.

Fair bleiben muss man trotzdem. meshmap.net kennt nur Meshtastic-Nodes, die über MQTT-Gateways gemeldet werden, und verwirft Positionen nach etwa 8 Stunden. Die 14-Tage-Spalte ist für Meshtastic deshalb strukturell zu niedrig, die 24-Stunden-Spalte ist der fairere Vergleich. Auch dort steht es bei 40 km noch 91 zu 20. Auf der anderen Seite beweist ein Eintrag auf der MeshCore-Karte keine nutzbare Funkverbindung. Die Einträge kommen von Uploadern und aus der App, Positionen können ungenau oder veraltet sein.

Dazu kommen die Funkparameter. 178 der 192 MeshCore-Einträge meldeten 869,618 MHz, 62,5 kHz, SF8 und CR 4/8, die übrigen 14 CR 4/5. Diese Werte meldet allerdings der empfangende Uploader, sie sind keine authentifizierte Angabe des Senders. An der Richtung ändert das nichts. Hier gibt es eine aktive MeshCore-Community, die Mesh Rheinland, mit klaren Empfehlungen für Preset und Konfiguration und mit CoreScope als Live-Karte und Paketanalyse. Bei Repeatern in ein paar hundert Metern Entfernung geht es für meinen Dach-Node also weniger um erste Abdeckung als darum, einen gut platzierten zusätzlichen Hop beizusteuern.

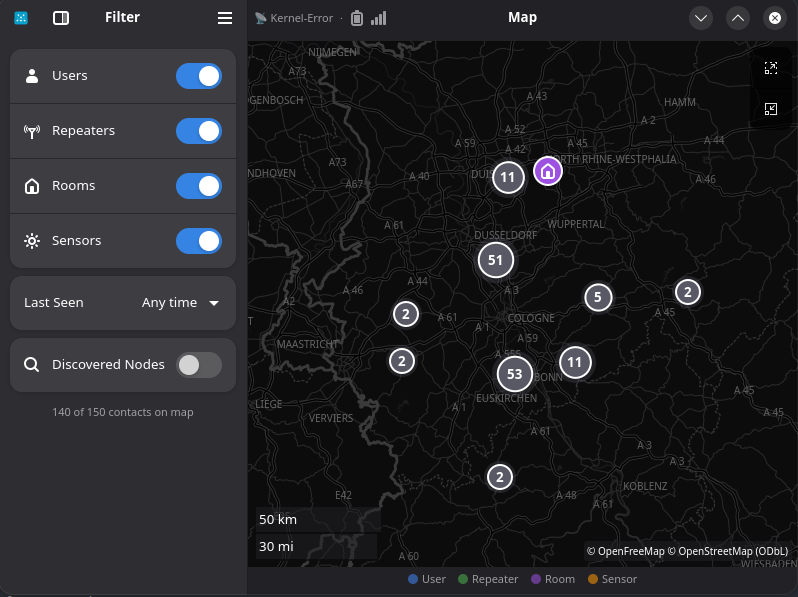
Kartenansicht im Linux-Client Meshy mit dunklem Kartenhintergrund zwischen Nijmegen, Hamm und Koblenz, Kontakte als Cluster mit Zahlen wie 53 bei Bonn und 51 bei Düsseldorf, links Filter für Users, Repeaters, Rooms und Sensors
Was ein einzelner Companion kennt: 140 von 150 Kontakten mit Position, verteilt von Nijmegen bis Koblenz

Wer lieber zuhört, dem empfehle ich den MRMCD-2026-Vortrag „MeshCore: Grenzenloser Spaß auf 868 MHz“ und den Beitrag „MeshCore: So kommuniziert ihr auch beim Blackout!“ von heise und c’t.

Mein Aufbau und die Serie

Stand Anfang November 2026 sieht mein Setup so aus: Ein Heltec V4 läuft als fester Repeater „DE-NW-SU-Todenfeld-KE“ in einem Aluminiumgehäuse auf dem Dachboden, mit Akku, Echtzeituhr und einer 5,8-dBi-Antenne am Satellitenmast über dem Dach. Strom und Logging kommen vom Raspberry Pi, der dort oben schon als ADS-B-Feeder arbeitet. Mein persönlicher Companion „Kernel-Error“ ist ein Heltec-V4-Komplettkit, das per Bluetooth am Handy hängt. Ein weiterer Heltec mit GPS fährt als „ErrorCar“ im Auto mit und sammelt Messpunkte für MeshMapper. Dazu kommt ein RAK3312 in einer Akkubox als portabler zweiter Repeater mit eigener Identität und ohne veröffentlichte Position. Ich vermute aber, dass der RAK ein Problemchen hat. Eigentlich war er als mein Repeater unter dem Dach geplant. Da ich die gefühlten Problemchen noch nicht echt gemessen habe, dennoch mit dem Projekt weiter kommen wollte, ohne wieder Hardware doppelt zu kaufen, habe ich mit dem Heltec weiter gemacht. Da wird es ggf. noch etwas außerhalb dieser Serie geben. Messen mit dem tinySA und einer 30 dB Dämpfung dazwischen um die Sendeleistung zu messen und so weiter und so weiter. Was ich ebenfalls noch im Sinn habe, ist ein Sensor, den jeder abfragen kann. Vielleicht für Luftqualität, radioaktive Strahlung, Temperatur usw. Aber das ist noch alles nicht gemacht und hängt davon ab, wie viel Zeit und Energie ich aufbringen kann; das ist im Moment Mangelware bei mir.

Die Serie geht diesen Weg der Reihe nach durch:

Bevor du Hardware kaufst

Schau in die Karte deiner Community, bevor du dich für ein Projekt entscheidest. Auf map.meshcore.dev und meshmap.net siehst du in ein paar Minuten, was in deiner Gegend wirklich aktiv ist, und wenn es eine lokale Gruppe gibt, verrät die dir auch das passende Preset. Überleg dir außerdem, ob dein Gerät an der Steckdose, am Akku oder an einer Solarzelle hängen soll. Davon hängt ab, welches Board passt, mehr dazu in Teil 2 und Teil 3. Wenn MeshCore bei dir lebt, geht es in Teil 2 mit dem ersten Companion weiter.

Siehe auch: Teil 2: Companion, Teil 3: Repeater, Teil 4: Antennen und Messen, Teil 5: MeshMapper, Teil 6: Konfiguration.

Links zu Amazon und AliExpress sind Affiliate-Links: Kaufst du darüber, bekomme ich eine kleine Provision, für dich ändert sich am Preis nichts. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Wenn du also so einen Beitrag hier hilfreich findest, ist das ein Weg um das zu zeigen.

Wenn ihr Fragen habt oder wissen wollt, wie es bei euch in der Gegend mit MeshCore aussieht, dann dürft ihr mich gerne fragen.
BIOS erklärt, Teil 12: elf leere SATA-Anschlüsse und eine Verschlüsselung die es nicht gibt

Diese Folge fängt mit einem Anti-Klimax an: die beiden Storage-Seiten dieses Boards zeigen bei mir ausschliesslich leere Anschlüsse.

SATA Port 0..7                    [Not Installed]
sSATA Port 0..2                   [Not Installed]

Elf Anschlüsse, elf mal nichts. Meine beiden Laufwerke sind NVMe und hängen an PCIe, dazu gab es Teil 8. Trotzdem ist das eine der Seiten, an der man am meisten über die Geschichte von Massenspeicher lernt, und am Ende dieser Folge steht ein Thema, das mich beim Nachlesen mehr beschäftigt hat als erwartet.

Teil 12, alle bisherigen Folgen unter BIOS & Firmware.

Warum es zwei SATA-Seiten gibt

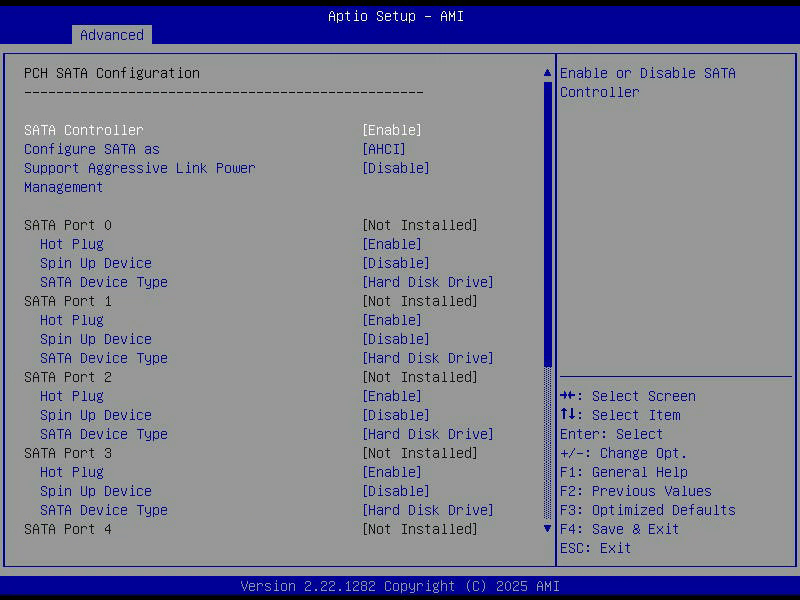
Aptio Setup, PCH SATA Configuration, AHCI-Modus und acht Anschlüsse, alle als Not Installed gemeldet

PCH SATA Configuration mit acht Anschlüssen und PCH sSATA Configuration mit drei. Das sind zwei getrennte Controller im Chipsatz, und das kleine s steht für secondary. Der Grund ist banal: irgendwann reichten die Anschlüsse des Hauptcontrollers nicht mehr, also hat Intel einen zweiten danebengesetzt. Für das Betriebssystem sind es zwei Geräte, und genau so sieht man sie:

lspci -nn | grep -i sata
#   00:11.5 SATA controller: ... C620 Series Chipset Family SSATA Controller [AHCI mode]
#   00:17.0 SATA controller: ... C620 Series Chipset Family SATA Controller [AHCI mode]

Elf Anschlüsse insgesamt, und Linux legt für jeden brav einen Port an, ob da etwas hängt oder nicht:

ls /sys/class/ata_port/
#   ata1 ata2 ata3 ata4 ata5 ata6 ata7 ata8 ata9 ata10

AHCI, und was die Alternative wäre

Configure SATA as                 [AHCI]

Dieser Schalter hat historisch mehr kaputte Windows-Installationen verursacht als vermutlich jeder andere im BIOS. Die Alternativen sind je nach Board IDE und RAID.

IDE lässt den Controller so tun, als wäre er ein Festplattencontroller von 1994. Kein Native Command Queuing, kein Hot Plug, dafür funktioniert es mit wirklich jedem Betriebssystem. AHCI ist der moderne Modus mit allem was dazugehört. RAID schiebt einen firmwaregestützten RAID-Verbund dazwischen, der in Wahrheit vom Treiber gemacht wird.

Der Klassiker war und ist: System im einen Modus installiert, später im BIOS umgestellt, Bluescreen beim nächsten Start, weil der passende Treiber nicht geladen wird. Unter Linux ist das entspannter, aber auch dort ändern sich die Gerätenamen.

AHCI ist auf diesem Board die richtige Wahl, und wäre es auch dann, wenn Laufwerke steckten. Softwareseitiges RAID ist unter Linux besser aufgehoben als in einer Chipsatz-Firmware, deren Metadatenformat man später nirgends mehr lesen kann.

Hot Plug, pro Anschluss

SATA Port 0
  Hot Plug                        [Enable]
  Spin Up Device                  [Disabled]
  SATA Device Type                [Hard Disk Drive]

Jeder der elf Anschlüsse hat sein eigenes kleines Untermenü mit denselben drei Einstellungen. Hot Plug erlaubt das Wechseln im laufenden Betrieb. Auf einem Serverboard ist das selbstverständlich an, weil dort Wechselrahmen sitzen. In einem Tower ohne Wechselrahmen ist es eine theoretische Freiheit, aber es kostet auch nichts.

Spin Up Device ist ein Relikt aus der Zeit rotierender Platten. Eingeschaltet lässt die Firmware die Laufwerke gestaffelt anlaufen statt alle gleichzeitig. Der Anlaufstrom einer Festplatte ist ein Vielfaches ihres Betriebsstroms, und wer zwölf davon gleichzeitig hochfährt, kann ein knapp bemessenes Netzteil in die Knie zwingen. Bei SSDs ist das gegenstandslos, bei einem Board für zwölf Platten nicht.

SATA Device Type unterscheidet zwischen Festplatte und SSD und dient vor allem dazu, der Firmware zu sagen ob sie mit Anlaufzeiten rechnen muss.

Support Aggressive Link Power Mgmt [Disable] ist das SATA-Gegenstück zu ASPM aus Teil 10: Stromsparzustände für die Verbindung. Auf Servern traditionell aus, weil es in der Vergangenheit zu sporadischen Abbrüchen geführt hat. Auf Notebooks dagegen unverzichtbar für die Akkulaufzeit.

Und jetzt zum interessanten Teil

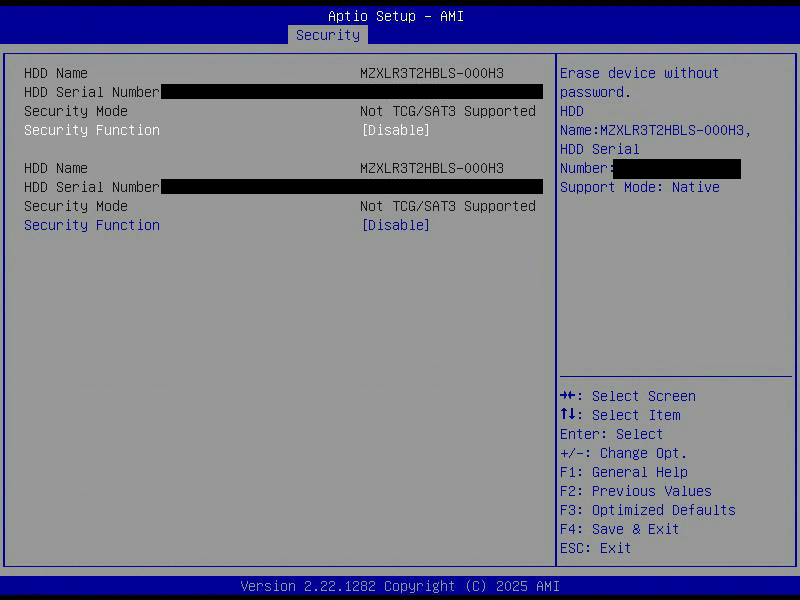
Aptio Setup, HDD Security, zwei Laufwerke mit geschwärzten Seriennummern und dem Vermerk Not TCG oder SAT3 Supported

Unter Security > HDD Security Configuration steht das hier:

HDD Name                          MZXLR3T2HBLS-000H3
HDD Serial Number                 (geschwärzt)
Security Mode                     Not TCG/SAT3 Supported
Security Function                 [Disable]

Zweimal dasselbe, weil zwei gleiche Laufwerke stecken. Und die dritte Zeile ist der Grund für diesen Abschnitt.

Es gibt seit langem eine Funktion, die im Laufwerk selbst sitzt und wenig bekannt ist: ATA Security. Man setzt ein Passwort direkt auf die Platte, und ohne dieses Passwort gibt sie keine Daten heraus. Kein Treiber, keine Software, das Laufwerk selbst verweigert die Arbeit.

Bei vielen modernen SSDs kommt etwas dazu, das die Sache erst richtig interessant macht: sie verschlüsseln ihre Daten intern ohnehin, auch ohne dass jemand ein Passwort gesetzt hat. Der Controller erzeugt beim ersten Start einen zufälligen Schlüssel, verschlüsselt damit alles was in den Flash geht, und entschlüsselt beim Lesen wieder. Das Betriebssystem merkt davon nichts.

Der Zweck ist dabei zunächst gar nicht Sicherheit, und das fand ich beim Nachlesen die überraschendste Erkenntnis: es geht um das Löschen. Wer ein Passwort setzt, schützt damit diesen bereits vorhandenen Schlüssel.

Denn daraus folgt der Trick, den ich vor einer Weile selbst genutzt habe. Ein Secure Erase auf so einem Laufwerk überschreibt nichts. Er wirft den internen Schlüssel weg und würfelt einen neuen. Danach sind sämtliche Daten auf dem Flash zwar noch physisch da, aber nur noch als Zufallsrauschen. Das ist nicht nur schneller als Überschreiben, es schont auch die Zellen, denn jedes Überschreiben kostet Lebensdauer. Das Ganze dauert entsprechend nicht Stunden, sondern:

hdparm --user-master u --security-set-pass p /dev/sda
hdparm --user-master u --security-erase-enhanced p /dev/sda

Bei den Samsung-SSDs, die ich so gelöscht habe, war das in unter einer Sekunde erledigt, obwohl das Werkzeug acht Minuten angekündigt hatte. Eine Intel-SSD im selben Durchgang brauchte siebzehn Sekunden. Beide waren danach leer, aber unterschiedlich leer: die Intel lieferte durchgehend Nullen, die Samsungs eine Mischung aus Nullen und Rauschen. Beides ist korrekt, es sind nur zwei verschiedene Herangehensweisen. Wer Nullen als Erfolgskriterium erwartet, hält ein Samsung-Ergebnis fälschlich für einen Fehlschlag.

Meine Laufwerke können das nicht

Not TCG/SAT3 Supported heisst genau das: diese beiden PM1735 unterstützen weder TCG Opal noch den ATA-Security-Durchgriff über SAT3. Es gibt hier also kein Laufwerkspasswort und keinen selbstverschlüsselnden Betriebsmodus, den man aktivieren könnte.

Das ist für Enterprise-NVMe nicht ungewöhnlich. Die Modellpalette wird üblicherweise in Varianten mit und ohne Verschlüsselungsfunktion aufgeteilt, weil manche Kunden aus regulatorischen Gründen ausdrücklich Laufwerke ohne Krypto brauchen. Meine sind offenbar aus der zweiten Gruppe.

Praktisch macht mir das nichts aus, weil ich ohnehin eine Ebene höher verschlüssele. Die Systemplatte läuft über LUKS, darüber liegt LVM, darin Wurzeldateisystem und Auslagerung. Damit ist alles verschlüsselt, inklusive Swap, und zwar mit einem Schlüssel den ich kontrolliere und nicht mit einem, der im Controller eines Laufwerks liegt.

Der Unterschied ist nicht nur philosophisch. Bei Laufwerksverschlüsselung vertraut man einer proprietären Implementierung, die man nicht prüfen kann, und es hat in der Vergangenheit mehrfach Untersuchungen gegeben, bei denen genau diese Implementierungen erhebliche Schwächen hatten. Bei LUKS kann man nachlesen was passiert.

Der Preis ist Rechenzeit, und der ist dank AES-NI vernachlässigbar. Dazu gab es in Teil 4 einen längeren Abschnitt.

Was ich stattdessen im Blick behalte

Wenn die Laufwerke selbst keine Sicherheitsfunktion anbieten, bleibt als Aufgabe des BIOS eigentlich nur, sie sauber anzubinden. Alles Weitere spielt sich im Betriebssystem ab, und dort sieht es gut aus:

smartctl -H /dev/nvme0
#   SMART overall-health self-assessment test result: PASSED

Available Spare:                    100%
Percentage Used:                    0%
Media and Data Integrity Errors:    0
Error Information Log Entries:      0
Power On Hours:                     3.166

Null Prozent Abnutzung nach gut dreitausend Betriebsstunden, keine Medienfehler, kein einziger Eintrag im Fehlerprotokoll. Eine Zeile fällt mir trotzdem auf: dreissig unsaubere Abschaltvorgänge. Das ist für eine Maschine, die auch mal hart ausgeschaltet wird, im Rahmen, aber es ist die Zahl, bei der ich hinsehe wenn sie plötzlich schneller steigt.

Fazit

Elf leere Anschlüsse und ein Laufwerk ohne Verschlüsselungsfunktion klingt nach einer mageren Folge. Ich fand sie trotzdem lohnend, weil zwei Dinge dabei herauskamen. Erstens die Erkenntnis, warum ein Secure Erase auf einer SSD in einer Sekunde fertig ist und trotzdem gründlicher als jedes Überschreiben. Und zweitens die Bestätigung, dass die Verschlüsselungsentscheidung an dieser Maschine bereits richtig getroffen ist, weil sie gar nicht anders getroffen werden konnte.

Nächste Folge: das Vorstart-Netzwerk. PXE, iSCSI, Option ROMs von Netzwerkkarten, und eine Karte die dem BIOS meldet, dass ihr eigener Treiber zu alt für sie selbst ist.

Siehe auch

Falls jemand von euch ATA Security produktiv einsetzt statt einer Softwarelösung: warum? Das würde mich ehrlich interessieren, ihr dürft mich jederzeit fragen.

pwn.watch: Sicherheitsvorfälle im Überblick, mit Vorsicht beim Brief für die AI

Terminalfenster mit Feeds für php, wordpress und nginx und dem Vorfall php2shell, daneben der Schriftzug pwn.watch, Sicherheitsvorfälle im Überblick, darunter: Empfehlung, mit Vorsicht beim AI-Brief

Bei kritischen Lücken wie gerade bei php2shell ist die erste Meldung selten das Problem. Schwieriger sind die Tage danach: Welche Versionen sind wirklich repariert, wird die Lücke schon ausgenutzt, welcher Hersteller hat für seine Appliances schon Updates, und welche Meldung war doch nur ein Gerücht? Michael hat mir dafür pwn.watch empfohlen, und ich finde die Seite nützlich genug, um die Empfehlung hier weiterzugeben. Ein paar Punkte solltest du dabei aber im Hinterkopf behalten.

Was pwn.watch ist

pwn.watch sammelt aktuelle Sicherheitsvorfälle und teilt sie in drei Bereiche: Lücken in Software, die du selbst betreibst und patchen musst, Angriffe auf Firmen und Dienste, bei denen du höchstens Zugangsdaten tauschen kannst, und Supply-Chain-Vorfälle wie manipulierte Pakete. Hinter der Seite steht der Entwickler Kitze, finanziert wird sie über Sponsoren in der Seitenleiste.

Jeder Vorfall bekommt eine eigene Seite mit Patch-Status, betroffenen und reparierten Versionen, einer Zeitleiste und den Quellen dazu. Gerade die Zeitleiste macht den Unterschied zu einer einzelnen Nachrichtenmeldung. Beim Eintrag zu php2shell stehen zum Beispiel die ersten Ausnutzungsversuche, die laut AWS schon vor dem Release begannen, die Einschätzung von Sansec, dass die öffentlichen Exploits meist eine zusätzliche Lücke in der Anwendung brauchen, eine Regression in den neuen Versionen 8.4.27 und 8.5.12 und die Advisories der Hersteller von Appliances. Unbestätigte Behauptungen sind als solche markiert. Für so etwas hätte ich sonst ein Dutzend Tabs offen.

Nur das, was du auch betreibst

Am praktischsten finde ich die Feeds. Es gibt RSS und JSON nicht nur für alles, sondern auch pro Tag, also pro Hersteller, Produkt oder Plattform. Wer wie ich PHP, WordPress und nginx betreibt, abonniert einfach diese Feeds und bekommt nur noch die Vorfälle, die ihn auch betreffen:

https://pwn.watch/t/php/feed.xml
https://pwn.watch/t/wordpress/feed.xml
https://pwn.watch/t/nginx/feed.xml

Die Übersicht aller Tags findest du unter pwn.watch/tags. Für meinen Stack fehlen allerdings einige Dinge: Für FreeBSD, OpenSSL, Postfix oder Dovecot gibt es keinen eigenen Tag. Die Seite ersetzt deshalb weder die FreeBSD Security Advisories noch ein regelmäßiges pkg audit -F, sie ergänzt beides.

Der Button „Copy brief for your AI“

Auffällig ist der Button „Copy brief for your AI“ auf jeder Seite. Er erzeugt im Browser einen Markdown-Text und legt ihn in die Zwischenablage: was betroffen ist, welche Versionen repariert sind, ein paar Befehle zum Prüfen wie php -v oder nginx -v, Hinweise zum Patchen und die Links zu den Advisories. Den Text soll man direkt in einen Coding-Agenten wie Claude Code oder Cursor kopieren, der dann prüft, ob man betroffen ist, und im besten Fall gleich aktualisiert. Dazu gibt es eine llms.txt und die Daten jedes Vorfalls als JSON. Die Seite ist also ausdrücklich darauf ausgelegt, dass Agenten sie lesen.

Hier wäre ich vorsichtig. Die Prüfbefehle stammen aus einer festen Liste im Code der Seite und sind harmlos. Der Rest des Textes ist aber Freitext, den allein der Betreiber kontrolliert und der zum Teil aus Tweets und Artikeln zusammengetragen wird. Wenn du so etwas ungelesen an einen Agenten gibst, der Shell-Zugriff hat, vertraust du darauf, dass dieser Text nie manipuliert wird. Das ist genau der Weg, über den Prompt Injection funktioniert. Dazu kommt, dass der Brief nur den einfachen Teil abdeckt. Bei php2shell steht darin „upgrade to 8.3.36“. Die eigentliche Arbeit lag bei mir aber im Bauen aus den Ports, den Extensions und dem plötzlich falschen CA-Bundle. Das hätte kein Agent aus diesem Text gewusst. Nutz am besten die Vorschau neben dem Button und lies den Brief als Zusammenfassung, nicht als Arbeitsauftrag.

Mein Fazit

pwn.watch ist ein Ein-Personen-Projekt ohne Angaben dazu, wie die Daten gepflegt werden, und schreibt selbst, dass es keine Sicherheitsberatung ist und man vor dem Handeln das Advisory des Herstellers prüfen soll. So würde ich die Seite auch nutzen: als schnellen Überblick, als Sammlung der relevanten Quellen und als Feed für den eigenen Stack. Die Entscheidung, was auf dem eigenen Server passiert, nimmt sie dir nicht ab, und das sollte auch kein Agent für dich tun, der nur diesen Text kennt.

BIOS erklärt, Teil 11: VT-d, 102 IOMMU-Gruppen und ein Menü das falsch beschriftet ist

Wenn man einer virtuellen Maschine eine echte Grafikkarte geben will, stösst man ziemlich schnell auf einen Begriff, der wie eine Ausrede klingt: IOMMU-Gruppen. Man liest dann Sätze wie „deine Karte ist in derselben Gruppe wie der USB-Controller, also geht das nicht“, und wenn man Pech hat, findet man kurz darauf Anleitungen mit dem Wort „ACS-Override“ darin, die einem erklären wie man diese Regel umgeht und dabei die Isolation aushebelt.

Der Ursprung dieser ganzen Geschichte liegt in einem einzigen BIOS-Untermenü, und um das geht es heute. Teil 11 der Serie, alle Folgen unter BIOS & Firmware. Wir sind unter Advanced > Chipset Configuration > North Bridge > IIO Configuration, und diesmal in den Untermenüs statt auf der Übersicht.

VT-d, oder: wer darf in den Speicher schreiben

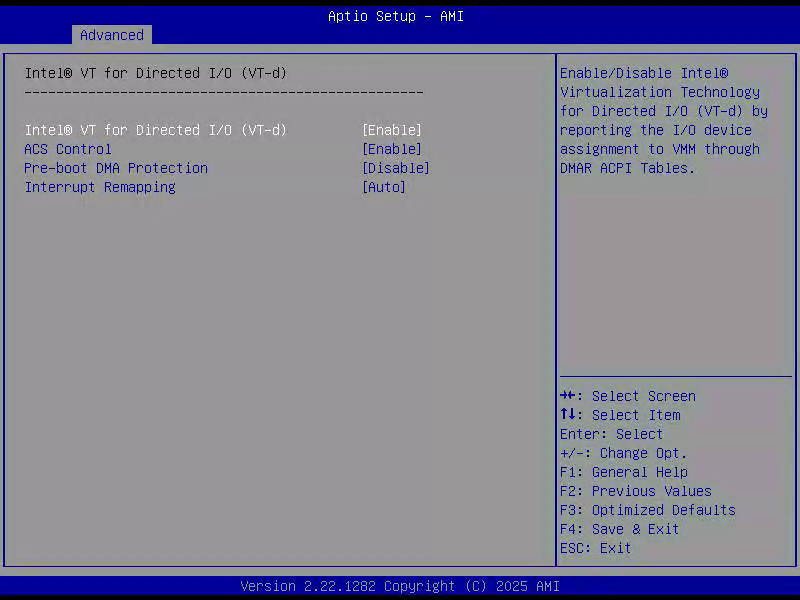
Aptio Setup, Intel VT for Directed I O, mit ACS Control, Pre-boot DMA Protection und Interrupt Remapping
Intel(R) VT for Directed I/O (VT-d)   [Enable]
ACS Control                           [Enable]
Pre-boot DMA Protection               [Disable]
Interrupt Remapping                   [Auto]

Das Grundproblem, das VT-d löst, ist älter als Virtualisierung. Eine PCIe-Karte darf per DMA selbständig in den Arbeitsspeicher schreiben, ohne die CPU zu fragen. Das ist der Grund, warum Netzwerkkarten und Laufwerke überhaupt schnell sind. Es bedeutet aber auch, dass eine Karte in jeden beliebigen Speicherbereich schreiben kann, sofern niemand sie daran hindert.

Die IOMMU ist dieser Jemand. Sie sitzt zwischen den Geräten und dem Speicher und übersetzt Adressen, genau wie die MMU es für Prozesse tut. Ein Gerät sieht dann nur noch den Speicher, der ihm zugewiesen wurde. Damit kann man einer virtuellen Maschine eine echte Karte geben, ohne dass diese Karte den Speicher des Wirtssystems lesen könnte.

Bei mir ist das aktiv, was man am Startprotokoll sieht:

dmesg | grep DMAR-IR
#   DMAR-IR: Enabled IRQ remapping in x2apic mode

Interrupt Remapping ist der zweite Teil derselben Absicherung. Interrupts sind auf modernen Systemen einfach Schreibzugriffe auf eine bestimmte Adresse. Ohne Umsetzung könnte ein Gerät damit Interrupts auslösen, die für andere gedacht sind. Die Umsetzung schiebt eine Tabelle dazwischen.

Nebenbei erklärt das eine Kuriosität aus Teil 4: dort stand ein Schalter namens Extended APIC auf Disable, und trotzdem läuft mein System im x2APIC-Modus. Der Grund steht in der Zeile oben. Der Kernel schaltet x2APIC selbst ein, sobald Interrupt Remapping läuft, weil er es dafür braucht. Die BIOS-Option entscheidet nur, ob die Firmware es vorab tut.

ACS, und die Sache mit den Gruppen

ACS Control [Enable] ist der Schalter, wegen dem ich diese Folge angefangen habe.

Access Control Services regeln, ob zwei Geräte hinter demselben Switch direkt miteinander reden dürfen, ohne dass der Verkehr über die IOMMU läuft. Ohne ACS kann die IOMMU nicht garantieren, dass zwei Geräte voneinander getrennt sind, und muss sie deshalb als eine Einheit behandeln. Das ist eine IOMMU-Gruppe: die kleinste Menge Geräte, die man nur gemeinsam durchreichen kann.

Bei mir sieht das ordentlich aus:

ls /sys/kernel/iommu_groups | wc -l
#   102

102 Gruppen, und die meisten enthalten genau ein Gerät. Das ist der Zustand, den man haben will, und man bekommt ihn nicht geschenkt. Auf typischen Consumer-Boards liegen regelmässig ein halbes Dutzend Geräte in einer Gruppe, weil der Chipsatz sie hinter einem Switch ohne ACS bündelt. Dann kommen die Anleitungen mit dem ACS-Override ins Spiel, und die tun genau das wonach sie klingen: sie lügen dem Kernel vor, es gäbe eine Trennung. Für ein Heimlabor mag das reichen. Es ist trotzdem das Abschalten einer Sicherheitsfunktion, und man sollte wissen dass man es tut.

Ein Beispiel aus meiner Maschine, das den Unterschied zeigt: als vorübergehend eine Beschleunigerkarte in Steckplatz 7 steckte, landete sie allein in Gruppe 6. Alleine in einer Gruppe heisst durchreichbar, ohne Tricks, ohne Override. Das war die Voraussetzung dafür, überhaupt darüber nachzudenken, sie einer virtuellen Maschine zu geben.

Pre-boot DMA Protection [Disable] schützt das Zeitfenster vor dem Betriebssystemstart. Der klassische Angriff dagegen läuft über Thunderbolt: Gerät anstecken während der Rechner im Setup steht, per DMA Speicher auslesen. Dieses Board hat kein Thunderbolt, und wer physisch am Gehäuse steht, hat ohnehin bessere Möglichkeiten. Aus ist hier vertretbar.

VMD, und warum es aus bleibt

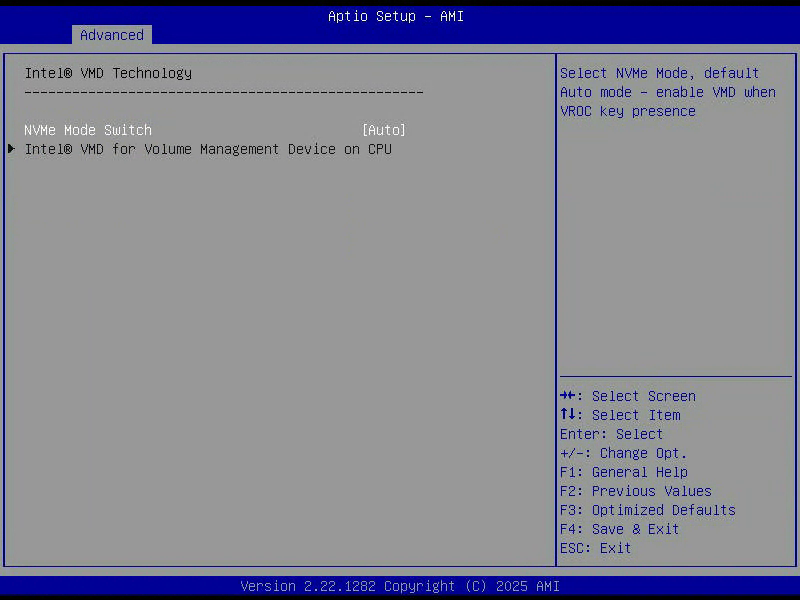
Aptio Setup, Intel VMD Technology, NVMe Mode Switch steht auf Auto
Intel(R) VMD Technology
NVMe Mode Switch                  [Auto]
> Intel(R) VMD for Volume Management Device on CPU

Volume Management Device ist eine Erfindung, die vor allem für vorkonfigurierte Server gedacht ist. Eingeschaltet fasst der Prozessor mehrere NVMe-Laufwerke zusammen und präsentiert sie nach aussen als ein einziges Gerät. Das ermöglicht Hot-Plug ohne Betriebssystemunterstützung und ist die Voraussetzung für Intels RAID-Lösung VROC.

Bei mir steht das auf Auto, und der Hilfetext im Setup sagt dazu wörtlich default Auto mode, enable VMD when VROC key presence. Also nur aktiv, wenn ein VROC-Lizenzschlüssel steckt. Es steckt keiner. Die Gegenprobe:

lspci -nn | grep -i "volume management"
#   (keine Ausgabe)

Nichts da, beide Laufwerke hängen direkt an ihren Root Ports.

Und dabei soll es bleiben. Mit eingeschaltetem VMD verschwinden meine NVMe-Laufwerke hinter einem Controller, brauchen einen zusätzlichen Treiber, und sind nicht mehr einzeln als PCIe-Geräte sichtbar. Damit wäre unter anderem das weg, was ich in Teil 10 gerade mühsam eingerichtet habe: die AER-Zähler pro Gerät. Ich tausche keine funktionierende Diagnose gegen ein RAID, das ich nicht will.

Der dritte Wert wäre Manual, und laut Handbuch erscheint erst dann das Untermenü, in dem sich VMD pro Stack einzeln einschalten lässt. Solange Auto steht, ist dort nichts zu holen, was erklärt warum ich es beim Durchklicken nie geöffnet habe.

Kleine Korrektur in eigener Sache: in meinen Notizen stand lange, VMD stünde auf Disabled. Der Schalter heisst tatsächlich NVMe Mode Switch und kennt Manual, VMD und Auto. Die Wirkung ist dieselbe, die Beschriftung war meine.

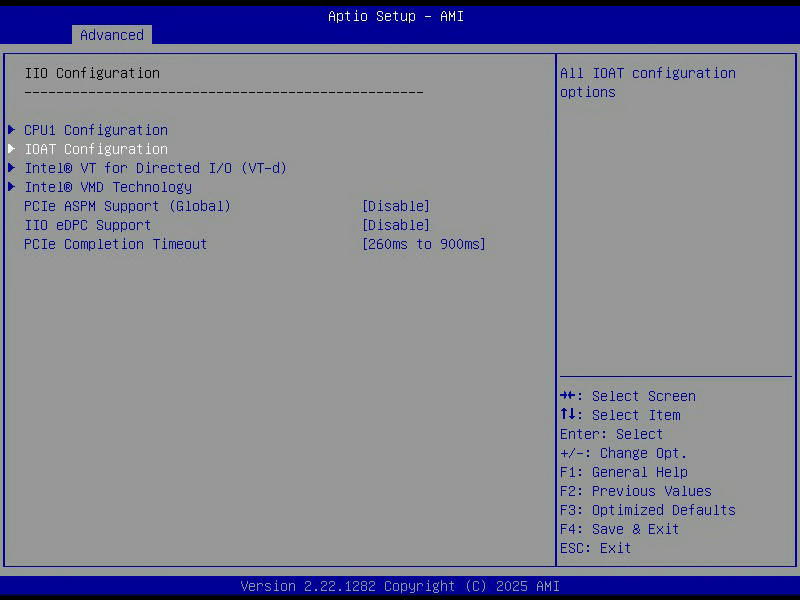
IOAT, das Menü das nicht hält was der Name verspricht

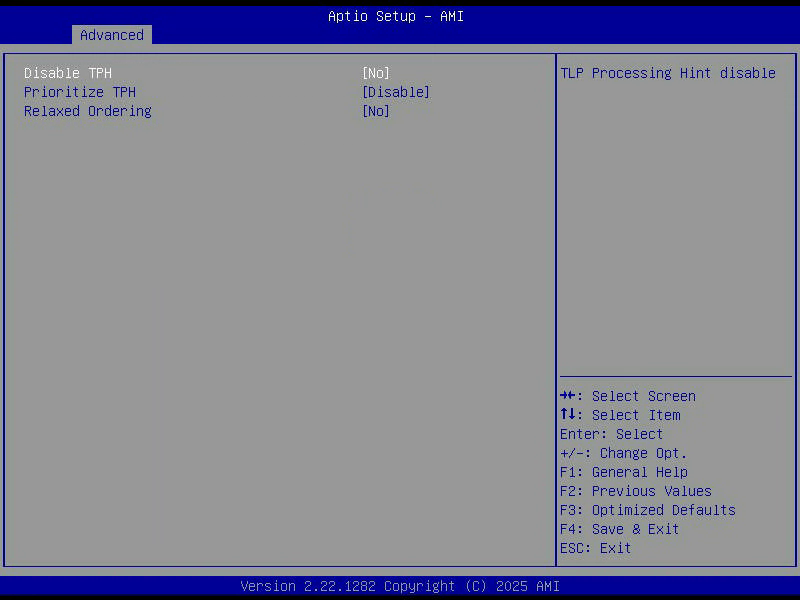
Aptio Setup, IOAT Configuration, mit Disable TPH, Prioritize TPH und Relaxed Ordering
IOAT Configuration
Disable TPH                       [No]
Prioritize TPH                    [Disable]
Relaxed Ordering                  [No]

Ich habe dieses Menü mit einer klaren Erwartung geöffnet. IOAT steht für I/O Acceleration Technology, dahinter stecken DMA-Engines im Prozessor, die Speicherkopien erledigen ohne die Kerne zu beschäftigen. Ich hatte mit Schaltern wie Enable IOAT und DCA gerechnet. Beide gibt es nicht.

Stattdessen stehen dort drei Optionen, die mit dem Namen des Menüs wenig zu tun haben. TPH ist TLP Processing Hint: ein PCIe-Gerät kann einem Schreibzugriff einen Hinweis mitgeben, wohin die Daten am besten sollen, etwa direkt in den Cache eines bestimmten Kerns statt in den Hauptspeicher. Für eine Netzwerkkarte, deren Pakete gleich darauf verarbeitet werden, spart das den Umweg.

Relaxed Ordering erlaubt es, Transaktionen in anderer Reihenfolge abzuarbeiten als sie eingetroffen sind. Das kann Durchsatz bringen und setzt voraus, dass die Beteiligten keine Annahmen über die Reihenfolge treffen. Standard ist deshalb No.

Die DMA-Engines selbst laufen übrigens, ganz ohne sichtbaren Schalter:

ls /sys/class/dma/
#   dma0chan0  dma1chan0  ...  dma7chan0

Acht Kanäle. Der Name des Menüs stimmt also, der Inhalt passt nur nicht dazu.

Das Ganze hat mir nebenbei einen Fehler in meiner eigenen Dokumentation gezeigt. In meiner ersten Aufzeichnung war ein Bildschirm mit genau diesen drei Zeilen, und ich hatte ihn als „Slot-Unterseite“ abgelegt, weil ich das Menü nicht geöffnet hatte und nur den Inhalt sah. Es war die IOAT-Seite. Ich hatte sie die ganze Zeit, nur unter dem falschen Namen.

Was ich davon tatsächlich nutze

Ehrlich? Von diesen vier Menüs nutze ich aktiv genau eines. VT-d ist an und tut seinen Dienst, die Isolation ist sauber, 102 Gruppen sprechen für sich. VMD ist aus und soll aus bleiben, IOAT läuft von selbst, und die TPH-Einstellungen fasse ich nicht an ohne eine Messung zu haben.

Trotzdem ist es eine der Seiten, die ich nach diesem Durchgang anders sehe. Vorher war „IOMMU“ für mich ein Wort aus Passthrough-Anleitungen. Jetzt weiss ich, welcher Schalter dafür verantwortlich ist, dass meine Gruppen sauber getrennt sind, und warum das auf anderen Boards oft nicht so ist.

Nächste Folge: Storage. AHCI, Hot Plug, elf SATA-Anschlüsse von denen keiner belegt ist, und eine Sicherheitsfunktion in Laufwerken, die meine beiden NVMe nicht können.

Siehe auch

Falls jemand von euch ACS-Override im Einsatz hat: aus Not oder bewusst? Und hat es je Ärger gemacht? Ihr dürft mich gerne fragen.
php2shell: PHP am Tag der Veröffentlichung aus den FreeBSD-Ports gepatcht

Warndreieck neben dem Schriftzug php2shell mit CVE-2026-109618 und CVE-2026-109619, reparierte Versionen 8.5.12, 8.4.27, 8.3.36 und 8.2.35, darunter: gepatcht, Blog wieder online

Wie im letzten Beitrag angekündigt, war mein Blog offline, bis das PHP-Update für die beiden kritischen Lücken auf dem Server eingespielt ist. Das ist inzwischen passiert, der Blog ist wieder erreichbar. Seit dem Nachmittag des 21. Oktober sind auch die technischen Details öffentlich, heise security hat sie im Artikel php2shell: Kritische Sicherheitslücken erlauben Codeeinschleusung in PHP zusammengefasst. In diesem Beitrag geht es weniger um die Lücken selbst als darum, wie ich PHP am Tag der Veröffentlichung auf FreeBSD gepatcht habe, über welche Fallen ich dabei gestolpert bin und wie ich geprüft habe, ob vorher schon jemand drin war.

Was hinter php2shell steckt

Unter dem Namen php2shell laufen zwei Fehler im Kern von PHP, beide mit CVSS 9.2 bewertet. CVE-2026-109618 steckt in der Speicherverwaltung. Läuft ein Skript in das eingestellte memory_limit, bricht PHP es ab und räumt danach auf. Mit einem passend gebauten Upload oder tief verschachtelten Arrays gerät genau dieses Aufräumen durcheinander, und am Ende kann ein Angreifer eigenen Code mit den Rechten des Webservers ausführen. CVE-2026-109619 sitzt in der Fehlerbehandlung. Hier bringt eine erste Anfrage PHP in einen kaputten Zustand, den eine zweite Anfrage an denselben Worker ausnutzt.

Die Anwendung selbst muss dafür keinen Fehler haben, und eine Anmeldung braucht der Angreifer auch nicht. Ein Angriff klappt zwar nicht beim ersten Versuch, nach einigen tausend bis zehntausend Anfragen aber zuverlässig. Für automatisierte Massenscans ist das kein Hindernis. Laut Wiz ist jede PHP-Version der letzten zehn Jahre von mindestens einer der beiden Lücken betroffen, das PHP-Team spricht sogar von allen Versionen seit PHP 5. Die reparierten Versionen sind 8.5.12, 8.4.27, 8.3.36 und 8.2.35.

Mein WordPress läuft mit PHP 8.3 als PHP-FPM hinter nginx, zum Zeitpunkt der Meldung in Version 8.3.33. pkg audit -F hat das Paket direkt für beide CVEs als verwundbar gemeldet. Laut Advisory ist Apache mit mod_php nachweislich per HTTP angreifbar, FPM gilt nach Analyse des Quellcodes ebenfalls als anfällig, auch wenn dafür noch kein vollständiger Exploit gezeigt wurde. Darauf wollte ich nicht wetten. Also habe ich nginx gestoppt, noch bevor es einen Patch gab. PHP-FPM lauscht bei mir nur auf einem Unix-Socket und ist ohne nginx davor von außen nicht erreichbar. Damit war die Angriffsfläche weg, ohne dass ich an PHP selbst etwas ändern musste.

Ports statt Paket

Der erste Reflex auf FreeBSD ist pkg upgrade. Nur lag im Paket-Repository auch nach pkg update -f noch PHP 8.3.35, und das ist verwundbar. Im Ports-Tree sah es anders aus: Der Commit lang/php83: Update version 8.3.35=>8.3.36 war wenige Minuten nach dem Upstream-Release in main und kurz darauf auch im Quartalszweig 2026Q4. Bis daraus ein Binärpaket im Repository wird, vergeht deutlich mehr Zeit. Wer einen Port sauber bauen kann, muss bei solchen Lücken also nicht warten.

Ist das wirklich der richtige Fix?

Dass ein Port eine neue Versionsnummer hat, heißt noch nicht, dass darin der richtige Fix steckt. Bevor ich gebaut habe, habe ich deshalb zwei Dinge geprüft. Erstens die Prüfsumme: Die SHA256-Summe von php-8.3.36.tar.xz aus der distinfo des Ports muss mit der Angabe auf php.net übereinstimmen.

cat /usr/ports/lang/php83/distinfo
curl -sS 'https://www.php.net/releases/index.php?json&version=8.3.36'

Beide Quellen nennen dd54693aa334c5c4d72e9aee96b082c2473750a18a6c1d105789c93a3b1692fd. Zweitens den Changelog: Der offizielle Changelog zu 8.3.36 enthält genau einen Eintrag, „Core: Fixed GHSA-w8hw-w9fx-j79w, GHSA-6wmf-4rv5-p3rp (Avoid state corruption via bailout)“. GHSA-w8hw-w9fx-j79w ist genau das Advisory, auf das auch heise verweist, und „Bailout“ ist der Abbruchpfad, den PHP bei einem Fatal Error nimmt. Das passt zu beiden Lücken. Die dritte Bestätigung kam nach der Installation: pkg audit -F meldet für PHP nichts mehr, die VuXML-Datenbank von FreeBSD stuft 8.3.36 also ebenfalls als repariert ein.

Bauen und tauschen

Vor dem Umbau habe ich einen ZFS-Snapshot der Jail angelegt, damit ich bei Problemen in Sekunden zurück kann. Danach ging es grob so weiter, hier vereinfacht ohne den jexec-Präfix:

# Rollback-Punkt
zfs snapshot zroot/jails/<jail>@pre-php2shell-$(date +%Y%m%d-%H%M)

# Ports-Tree auf denselben Zweig wie das Paket-Repository
cd /usr/ports && git fetch origin && git checkout 2026Q4 && git pull --ff-only

# Optionen gegen das installierte Paket abgleichen
pkg query '%Ok=%Ov' php83
make -C /usr/ports/lang/php83 showconfig

# Bauen, dann tauschen
make -C /usr/ports/lang/php83 -DBATCH clean build
make -C /usr/ports/lang/php83 -DBATCH deinstall install

Wichtig waren dabei die Extensions. Auf FreeBSD sind die PHP-Kern-Extensions eigene Pakete wie php83-mysqli, php83-curl oder php83-opcache. Technisch hätten die alten Extensions auch mit dem neuen Kern funktioniert, weil sich die Modul-API innerhalb von 8.3 nicht ändert. Der Sprung von 8.3.33 auf 8.3.36 enthält aber auch alle Korrekturen aus 8.3.34 und 8.3.35, und die stecken zu einem großen Teil in Extensions wie mysqlnd, openssl, phar, soap und filter. Nur den Kern zu tauschen hätte diese Lücken offen gelassen. Ich habe deshalb alle 43 Kern-Extensions aus demselben Tree neu gebaut. PECL-Extensions wie redis, APCu oder imagick haben eigene Versionsnummern und blieben, wie sie waren.

for o in $(pkg query -g '%o %v' 'php83-*' | awk '$2 ~ /^8\.3\.33/ {print $1}' | grep -v '^lang/php83$'); do
    make -C /usr/ports/$o -DBATCH clean build && make -C /usr/ports/$o -DBATCH deinstall install clean
done

Zum Schluss der Punkt, den man leicht vergisst: Ein neues Binary auf der Platte heißt nicht, dass der laufende Dienst es auch benutzt. PHP-FPM hatte noch das alte Programm im Speicher. Also neu starten und nachsehen, welches Binary der Prozess tatsächlich ausführt:

service php_fpm restart
procstat -b $(cat /var/run/php-fpm.pid)

Drei Stolperfallen

Ganz glatt lief es nicht. Die drei Probleme, die mir begegnet sind, dürften auch auf anderen Systemen auftauchen.

Build-Abhängigkeiten aus den Quellen. Der erste Versuch wollte cmake-core aus den Quellen bauen, eine reine Build-Abhängigkeit von re2c, und brach dabei ab. Solche Abhängigkeiten laufen nur während des Bauens und müssen nicht gepatcht sein. Mit make missing sieht man, was fehlt, und kann es einfach als Binärpaket per pkg install nachziehen.

deinstall install entfernt das PHP, das der Port selbst braucht. Beim Erzeugen der Paketliste ruft der Port ein php aus dem PATH auf. Nach dem deinstall gab es keins mehr, die Installation brach mit php: not found ab, und PHP war für ein paar Minuten gar nicht installiert. Da nginx ohnehin aus war, hatte das keine Außenwirkung. Gelöst habe ich es, indem ich das frisch gebaute CLI-Binary für diesen einen Aufruf vorne in den PATH gestellt habe:

PATH=/usr/ports/lang/php83/work/php-8.3.36/sapi/cli:$PATH make -C /usr/ports/lang/php83 -DBATCH install

Beim nächsten Mal lasse ich zuerst make stage laufen, solange das alte PHP noch installiert ist, und tausche erst danach.

Andere OpenSSL-Basis, anderes CA-Bundle. Das war die unangenehmste Falle, weil alle Prüfungen grün waren. Das alte PHP aus dem Paket-Repository war gegen das OpenSSL des Basissystems gebaut und nutzte dessen Zertifikatsspeicher /etc/ssl/cert.pem. Mein selbst gebautes PHP ist wegen DEFAULT_VERSIONS+=ssl=openssl40 in der /etc/make.conf gegen das OpenSSL aus den Ports gebaut und sucht seine CA-Zertifikate unter /usr/local/openssl/cert.pem. Diese Datei gab es nicht. Die Folge war, dass jede ausgehende TLS-Verbindung aus PHP mit Zertifikatsprüfung scheiterte. Aufgefallen ist das an einer PHP-Anwendung, die per TLS mit einem IMAP-Server spricht und nur noch „Connection to storage server failed“ meldete. nginx -t, php -m und php-fpm -t waren alle zufrieden, erst der Funktionstest hat es gezeigt.

php -r 'var_dump(openssl_get_cert_locations());'
# default_cert_file => /usr/local/openssl/cert.pem
ln -s /etc/ssl/cert.pem /usr/local/openssl/cert.pem

Alternativ lässt sich der Pfad auch per openssl.cafile in der php.ini setzen.

War schon jemand drin?

Nach dem Patch bleibt die Frage, ob die Lücke vorher schon ausgenutzt wurde. Hier hilft, dass der Angriff laut ist: Er braucht tausende Anfragen, die jeweils einen memory_limit-Abbruch oder einen Fatal Error auslösen. Selbst ein am Ende erfolgreicher Angriff hinterlässt also vorher viele Fehlversuche. Ich habe den gesamten vorhandenen Log-Zeitraum von 15 Tagen durchsucht, rotierte und mit bzip2 gepackte Logs eingeschlossen:

# Abstürze von FPM-Workern
for f in /var/log/php-fpm.log*; do bzcat -f "$f"; done | grep -E 'signal|SIGSEGV|core dumped'

# Speicher- und Fatal-Errors, PHP-FPM ohne eigenes error_log schreibt ins nginx-Errorlog
for f in /var/log/nginx/*error.log*; do bzcat -f "$f"; done | grep -aE 'Allowed memory size|PHP Fatal'

# Neue oder geänderte PHP-Dateien im Webroot
find /usr/local/www -type f \( -name '*.php*' -o -name '*.phar' -o -name '.user.ini' \) -newermt 2026-10-14

Das Ergebnis:

  • Keine abgestürzten FPM-Worker, kein SIGSEGV, kein Core-Dump.
  • Kein einziges Allowed memory size und kein PHP Fatal, weder im FPM-Log noch in den nginx-Errorlogs.
  • Keine Häufung von 5xx-Antworten und keine einzelne Quelle mit auffällig vielen POST-Anfragen. Die meisten POSTs kamen von der ActivityPub-Federation und von wp-cron.
  • Keine fremden Prozesse und keine unbekannten ausgehenden Verbindungen des Webserver-Benutzers, die Crontab enthält nur bekannte Einträge.
  • Im Webroot nur fünf neue WordPress-Sprachdateien. Ihr Zeitstempel passt zu einem wp-cron-Lauf im Access-Log, und der Inhalt ist das übliche <?php return [...] ohne eval, base64_decode oder Zugriffe auf Superglobals. In den Upload-Verzeichnissen liegt gar keine PHP-Datei.

Der einzige Treffer mit Exploit-Charakter war ein Massenscanner, der den alten pearcmd-Trick gegen PHP-CGI ausprobiert hat. Das ist eine ganz andere, alte Lücke, hat mit php2shell nichts zu tun und läuft gegen PHP-FPM ins Leere.

Zur Ehrlichkeit gehören auch die Grenzen dieser Prüfung. Access-Logs enthalten keine POST-Bodies, ein einzelner, gezielter Treffer mit wenigen Anfragen wäre so nicht zu erkennen. Wegen der nötigen Menge an Anfragen halte ich das aber für unwahrscheinlich. Außerdem reichen meine Logs nur 15 Tage zurück. Eine erfolgreiche Codeausführung hätte mit den Rechten des Webserver-Benutzers stattgefunden, die Logs gehören root und hätten von dort aus nicht verändert werden können. Mein Fazit ist deshalb: Es gibt keinen Hinweis auf Ausnutzungsversuche oder eine Kompromittierung. Das heißt „sehr unwahrscheinlich“, nicht „bewiesen ausgeschlossen“.

Was du prüfen solltest

Das PHP-Team hat zusätzlich Konfigurationsänderungen veröffentlicht, die den Angriff erschweren sollen, etwa memory_limit=-1, ein kleines post_max_size, ein niedriges max_input_nesting_level und bei FPM ein niedriges pm.max_requests. Das Team nennt das selbst eine temporäre Krücke. Diese Einstellungen können Funktion oder Leistung kosten, und keine davon schließt die Lücke. Komplett hilft nur das Update. Denk dabei auch an PHP, das du nicht direkt siehst:

  • Docker-Container bringen ihr eigenes PHP mit. Ein Update des Hosts hilft da nicht, das Image muss neu gezogen und der Container neu gestartet werden.
  • Geräte mit Weboberfläche wie pfSense, OPNsense, NAS-Systeme von Synology oder QNAP und viele Router nutzen PHP für ihre Verwaltung. Hier bist du auf Updates des Herstellers angewiesen. Bis dahin gehört so eine Oberfläche erst recht nicht ins Internet.
  • Gehostete Seiten hängen vom Hoster ab. Schau nach, ob er das Update schon eingespielt hat oder einen Termin nennt.
  • Alte PHP-Versionen bekommen teilweise Backports, das ist aber eine gute Gelegenheit, mindestens auf PHP 8.3 zu wechseln. PHP 8.2 bekommt nur noch bis Ende 2026 Sicherheitsupdates.
  • Auf FreeBSD lohnt sich bei kritischen Lücken der Blick in den Ports-Tree, bevor man auf das Paket wartet. Prüf dann aber auch, gegen welches OpenSSL der Port gebaut wird.

Mein Fazit

nginx abzuschalten war die einfachste Maßnahme, die garantiert wirkt, und ein paar Stunden ohne Blog tun niemandem weh. Das eigentliche Patchen hat mich mehr gelehrt als die Lücke selbst: Eine neue Versionsnummer ist noch kein Beweis für den richtigen Fix, ein neues Binary auf der Platte noch kein gepatchter Dienst, und eine grüne Konfigurationsprüfung noch kein funktionierendes System. Erst der Funktionstest und der Blick in die Logs geben am Ende ein ehrliches Bild.

Nachtrag 23. Oktober 2026: Wer die weitere Entwicklung zu php2shell verfolgen will, findet bei pwn.watch eine laufend aktualisierte Zeitleiste mit Patch-Status, Advisories und Feeds pro Stack. Mehr dazu in pwn.watch: Sicherheitsvorfälle im Überblick, mit Vorsicht beim Brief für die AI.

Kritische PHP-Lücken: mein Blog geht bis zum Update offline

Warndreieck neben dem Schriftzug PHP, kritische Sicherheitslücken, Update am 21.10.2026 um 16:00 Uhr, Blog bis zum Patch offline

Kurze Info in eigener Sache: Heute, am 21. Oktober 2026, veröffentlicht das PHP-Projekt um 16:00 Uhr unserer Zeit (14:00 Uhr UTC) ein Sicherheitsupdate für zwei kritische Lücken. heise security hat das in der Meldung Wichtige PHP-Updates am 21. Oktober beheben Codeeinschleusung-Schwachstellen zusammengefasst, und die Lage klingt ernst genug, dass ich meinen Blog vorerst vom Netz nehme.

Was bisher bekannt ist

Das PHP-Projekt hat das Update am Vortag auf php.net angekündigt. Beide Lücken sind mit CVSS 4.0 von 9.2 bewertet, betroffene und reparierte Versionen sollen erst mit dem Release genannt werden. Das CERT-EU warnt ebenfalls und spricht von möglicher Codeausführung aus der Ferne ohne Anmeldung.

Laut heise stecken die Fehler in jeder PHP-Version seit PHP 5. Ein bereits kursierender Proof of Concept zielt zwar nur auf die Server-API von LiteSpeed, darauf würde ich mich aber nicht verlassen. Auch die herumgereichte Gegenmaßnahme session.upload_progress.enabled = 0 soll nach Kenntnisstand von heise nicht helfen. Funktionierende Exploits erwartet heise innerhalb von Stunden, spätestens Tagen. Wer kein Risiko eingehen will, hat bis zum Update also nur die Wahl, PHP-Webserver vom Netz zu nehmen.

Warum mein Blog offline geht

Dieser Blog läuft mit WordPress und damit mit PHP auf einem FreeBSD-Server. Selbst wenn das Update um 16 Uhr erscheint, dauert es noch eine Weile, bis die gepatchten Pakete in den FreeBSD-Ports und im Paket-Repository landen und ich sie eingespielt habe. Für dieses Zeitfenster möchte ich keinen Server offen im Netz haben, auf dem jeder anonym Code ausführen könnte. Ein paar Stunden oder auch Tage ohne Blog sind ärgerlich, ein kompromittierter Server wäre deutlich ärgerlicher.

Ich nehme den Blog daher jetzt erst einmal offline. Sobald die reparierten PHP-Pakete installiert sind und ich mir die technischen Details angesehen habe, kommt er wieder zurück. Wer mir im Fediverse oder auf Bluesky folgt, bekommt diesen Beitrag trotzdem zu sehen, auch wenn die Seite selbst gerade nicht erreichbar ist.

Was du jetzt tun solltest

Wenn du selbst PHP-Anwendungen im Netz betreibst, schau jetzt nach, wo überall PHP läuft. Gerade bei vergessenen Testinstanzen, alten Foren oder einem phpMyAdmin wird es schnell unübersichtlich. Behalte die Sicherheitsmeldungen deiner Distribution im Blick und spiel die Updates ein, sobald sie da sind. Was davon du bis dahin vom Netz nimmst, musst du für deine eigenen Systeme abwägen.

Update 21. Oktober 2026: Der Blog ist wieder online. Was hinter php2shell steckt und wie ich PHP noch am selben Tag aus den FreeBSD-Ports gepatcht habe, steht im Folgebeitrag php2shell: PHP am Tag der Veröffentlichung aus den FreeBSD-Ports gepatcht.

Orca: eine ADE, in der mehrere Coding-Agenten sauber nebeneinander arbeiten

Illustration von Orca als Agent Development Environment: Vier KI-Coding-Agenten arbeiten parallel in getrennten Git-Worktrees an Code, Benutzeroberfläche, API und Tests. Ein Entwickler überprüft die Änderungen und führt sie zusammen.

Seit fast fünf Monaten arbeite ich mit Orca, und es ist in der Zeit zu einem Werkzeug geworden, das ich jeden Tag offen habe. Ich möchte es euch deshalb kurz vorstellen. Das hier ist kein großer Testbericht, eher eine Empfehlung mit ein paar Erklärungen dazu, was so ein Tool überhaupt ist und warum ich gerade bei diesem hängen geblieben bin.

Was ist eine ADE?

Eine IDE kennt jeder, der programmiert: Editor, Terminal, Debugger und Git in einem Programm. Sie ist für einen Menschen gebaut, der selbst tippt. Mit Coding-Agenten wie Claude Code oder Codex hat sich die Arbeit aber verschoben. Ich schreibe weniger Code selbst, ich gebe Aufgaben ab, schaue mir an, was zurückkommt, korrigiere und lasse weiterlaufen. Dafür ist eine klassische IDE nicht gemacht.

ADE steht für Agent Development Environment. Orca beschreibt das selbst ganz treffend: Eine IDE ist für dich gebaut, eine ADE für dich und deine Agenten. Im Mittelpunkt steht also nicht mehr der Editor, sondern die Frage, wie man mehrere Agenten gleichzeitig arbeiten lässt, ohne den Überblick zu verlieren. Was macht welcher Agent gerade, wer wartet auf eine Freigabe, wer ist fertig, und was hat er eigentlich geändert?

Der technische Kern dabei sind Git-Worktrees. Ein Worktree ist ein zusätzliches Arbeitsverzeichnis desselben Repositories mit eigenem Branch. Lässt man zwei Agenten im selben Verzeichnis arbeiten, schreiben sie sich gegenseitig in die Dateien, und spätestens beim Testlauf weiß keiner mehr, welche Änderung von wem kommt. Bekommt jeder Agent seinen eigenen Worktree, arbeiten sie sauber getrennt nebeneinander, und am Ende entscheide ich, was gemergt wird. Ohne Werkzeug ist das allerdings viel Handarbeit mit git worktree add, mehreren Terminals und dem Gefühl, ständig irgendwo etwas zu vergessen.

Was Orca besonders macht

Genau diese Handarbeit nimmt mir Orca ab. Ich lege eine Aufgabe an, Orca erstellt den Worktree, startet darin den Agenten und zeigt mir in der Seitenleiste alle laufenden Aufgaben über alle Projekte hinweg. Die Punkte, die Orca für mich von anderen Lösungen abheben:

  • Jeder CLI-Agent, jedes eigene Abo. Orca bringt keinen eigenen Agenten und kein eigenes Modell mit. Claude Code, Codex, Gemini, OpenCode und viele weitere sind vorkonfiguriert, und alles, was im Terminal läuft, lässt sich einbinden. Dabei nutze ich die Abos, die ich ohnehin habe. Ich bin also nicht an einen Anbieter gebunden und muss auch kein zusätzliches Abo abschließen.
  • Parallele Worktrees. Jede Aufgabe läuft isoliert. Man kann sogar denselben Prompt an mehrere Agenten geben, die Ergebnisse vergleichen und den besten Stand übernehmen.
  • Diffs kommentieren. Änderungen eines Agenten sehe ich als Diff, kann direkt an einzelne Zeilen Kommentare hängen und diese gesammelt an den Agenten zurückgeben. Das fühlt sich an wie ein Code-Review mit einem Kollegen und ist deutlich angenehmer, als jede Anmerkung einzeln in den Prompt zu tippen.
  • Terminals, Editor und Browser in einem Fenster. Terminals lassen sich beliebig teilen, der Verlauf übersteht einen Neustart. Für Web-Projekte gibt es pro Worktree ein eigenes Chromium-Fenster, in dem man ein Element anklicken und es samt HTML, CSS und Bildausschnitt an den Agenten schicken kann.
  • Worktrees per SSH. Die Agenten müssen nicht auf dem eigenen Rechner laufen. Orca kann Worktrees auf einer entfernten Maschine anlegen und dort Dateien, Git und Terminals bedienen.
  • Verbrauch im Blick. Orca zeigt die Nutzung von Claude und Codex an, inklusive der Zeitpunkte, an denen die Limits zurückgesetzt werden. Bei mehreren parallelen Agenten ist das Gold wert, weil die Kontingente sonst schneller weg sind, als man denkt.
  • Eine Begleit-App fürs Handy. Für iOS und Android gibt es eine App, mit der man den Status der Agenten sieht und auch unterwegs eine Rückfrage beantworten kann.

Dazu kommt etwas, das für mich nicht ganz unwichtig ist: Orca ist Open Source unter MIT-Lizenz und läuft auf Linux genauso wie auf macOS und Windows. Für Linux gibt es Pakete als .deb, .rpm und AppImage, jeweils für x86_64 und ARM64, dazu ein Paket im AUR. Dahinter steht das Startup Stably AI. Das Repository gibt es erst seit März 2026 und es hat inzwischen knapp 96.000 Sterne auf GitHub. Es scheint also nicht nur mir so zu gehen.

Was du wissen solltest

Orca sammelt anonyme Nutzungsdaten. Laut der Doku zur Telemetrie sind das Ereignisse wie App-Starts, neu angelegte Workspaces oder gestartete Agenten, verknüpft mit einer zufälligen lokalen ID. Dateiinhalte, Prompts, Ausgaben der Agenten sowie Repo- und Branch-Namen werden nach eigener Aussage nicht übertragen. Wer das trotzdem nicht möchte, schaltet es unter Settings > Privacy ab oder startet Orca mit einer dieser Umgebungsvariablen:

DO_NOT_TRACK=1
ORCA_TELEMETRY_DISABLED=1

Außerdem ist das Entwicklungstempo enorm. Neue Versionen kommen fast täglich, die Versionsnummer steht inzwischen bei 1.4.229. Das bringt laufend neue Funktionen, heißt aber auch, dass sich hin und wieder etwas verändert oder kurz hakt. Wer ein Werkzeug sucht, das sich über Monate nicht bewegt, ist hier falsch.

Und eine ADE nimmt dir das Denken nicht ab. Mehrere Agenten parallel arbeiten zu lassen, heißt auch, mehrere Ergebnisse parallel prüfen zu müssen. Orca macht das Prüfen deutlich bequemer, die Verantwortung für das, was am Ende gemergt wird, bleibt aber bei dir. Warum ich das für einen der wichtigsten Punkte beim Arbeiten mit AI halte, habe ich in AI, der Mensch als Flaschenhals schon einmal aufgeschrieben.

Mein Fazit

Wer nur ab und zu einen Agenten im Terminal startet, braucht Orca nicht unbedingt. Sobald aber mehrere Aufgaben gleichzeitig laufen, vielleicht sogar mit verschiedenen Agenten, wird es ohne passendes Werkzeug schnell unübersichtlich. Genau da spielt Orca seine Stärken aus. Es ist kostenlos, offen und hängt nicht an einem einzelnen Anbieter. Probiere es einfach mal aus, die Downloads gibt es auf onorca.dev.

Siehe auch:

Wenn ihr Fragen habt, dann dürft ihr mich sehr gerne fragen.

BIOS erklärt, Teil 10: mein Rechner hat PCIe-Fehler protokolliert, von denen ich nichts gewusst hätte

Diese Folge hat einen anderen Charakter als die bisherigen. Die vorherigen erklären, was auf einer BIOS-Seite steht. Diese hier erklärt, was auf einer BIOS-Seite fehlt, und was das für Folgen hatte.

Angefangen hat es damit, dass ich beim Durchsehen der Startmeldungen über eine Zeile gestolpert bin, die ich vorher zwar hunderte Male gesehen, aber nie gelesen hatte:

acpi PNP0A08:07: _OSC: platform does not support [SHPCHotplug AER LTR DPC]

Übersetzt: das BIOS teilt dem Betriebssystem mit, dass es vier Dinge nicht unterstützt, unter anderem AER. Und AER ist die Fehlerbehandlung für PCIe. Teil 10 der Serie, alles Übrige unter BIOS & Firmware.

Was AER macht, und warum man es haben will

PCIe ist eine serielle Verbindung mit hoher Frequenz, und wie jede solche Verbindung ist sie nicht fehlerfrei. Es gibt zwei Sorten Fehler. Korrigierbare, bei denen ein Paket neu geschickt wird und niemand etwas merkt. Und nicht korrigierbare, bei denen Daten verloren sind.

AER, Advanced Error Reporting, zählt beides mit. Das ist vor allem bei den korrigierbaren interessant, denn die sind ein Frühwarnsystem: eine Verbindung, die langsam schlechter wird, fällt nicht plötzlich aus, sondern sammelt erst über Wochen korrigierte Fehler.

Das war für mich kein akademisches Thema. Meine NVMe-Laufwerke hängen nicht direkt am Board, sondern an einem 75 Zentimeter langen Kabel, das einen SlimSAS-Anschluss auf zwei Laufwerke aufteilt. 75 Zentimeter sind für ein Gen-4-Signal eine Menge. Wenn irgendwo in dieser Maschine eine Verbindung Ärger machen würde, dann diese.

Der Zustand vorher: die Bits werden gesetzt, aber niemand liest sie

Der spannende Teil ist, dass die Hardware trotzdem mitzählt. Im Statusregister der NVMe standen Fehlerbits:

lspci -vv -s c3:00.0 | grep DevSta
#   DevSta: CorrErr+ NonFatalErr- FatalErr- UnsupReq+

Das + hinter CorrErr heisst: hier ist mindestens ein korrigierbarer Fehler aufgetreten. Gleichzeitig standen die eigentlichen AER-Zähler auf null:

cat /sys/bus/pci/devices/0000:c3:00.0/aer_dev_correctable
#   TOTAL_ERR_COR 0

Kein Widerspruch, sondern genau das Bild, das man bei abgeschalteter Fehlerbehandlung erwartet. Die Hardware setzt ihre Statusbits, weil sie das immer tut. Aber es gibt niemanden, der sie ausliest, auswertet, ins Protokoll schreibt und wieder zurücksetzt. Ein Zähler, den keiner bedient.

Praktisch hiess das: PCIe-Fehler tauchten in meinem Journal überhaupt nicht auf. Wäre das Kabel langsam gestorben, hätte ich es erst gemerkt, wenn das Laufwerk weg gewesen wäre.

Warum das BIOS nein sagt

Der Mechanismus dahinter heisst _OSC, Operating System Capabilities. Beim Start fragt das Betriebssystem die Firmware: darf ich diese Dinge übernehmen? Die Firmware antwortet. Sagt sie nein, geht der Kernel davon aus, dass die Firmware das selbst macht, und hält sich raus.

Das Modell nennt sich firmware-first und ist in echten Servern durchaus sinnvoll: die Firmware fängt Fehler ab, meldet sie über einen definierten Kanal an das Betriebssystem, und der Verwaltungscontroller bekommt sie auch mit. In einem Rack mit Fernwartung will man genau das.

Nur muss die Firmware es dann auch tatsächlich tun. Und der Kanal dafür heisst WHEA.

WHEA, und die Falle die ich fast getappt wäre

Aptio Setup, ACPI Settings, mit NUMA, UMA-Based Clustering im Hemisphere-Modus und WHEA Support auf Disabled

Unter Advanced > ACPI Settings steht:

NUMA                              [Enabled]
UMA-Based Clustering              [Hemisphere (2-clusters)]
WHEA Support                      [Disabled]
High Precision Event Timer        [Enabled]

WHEA ist der firmware-first-Kanal, und er steht auf Disabled. Damit war die Lage eindeutig: das BIOS sagt dem Betriebssystem „lass mal, ich mache das“, und macht es dann nicht.

Meine erste Reaktion war, WHEA einzuschalten. Das wäre falsch gewesen, und ich schreibe das hier auf, weil es die naheliegende und trotzdem schlechtere Lösung ist. Firmware-first bedeutet, dass Fehlerbehandlung über ACPI-Tabellen läuft, die die Firmware bereitstellen muss. Prüfen kann man das:

ls /sys/firmware/acpi/tables/ | grep -E "HEST|BERT|ERST|EINJ"
#   (keine Ausgabe)

Keine einzige davon vorhanden. Kein HEST, in dem stünde welche Fehlerquellen es überhaupt gibt. Kein BERT für Fehler aus dem letzten Absturz. Die Firmware ist für diesen Weg schlicht nicht eingerichtet.

Der bessere Weg ist die andere Richtung: dem Betriebssystem die Arbeit geben.

Ein Kernel-Parameter statt eines BIOS-Besuchs

Linux kennt dafür einen Schalter, der die _OSC-Antwort schlicht ignoriert:

GRUB_CMDLINE_LINUX_DEFAULT="quiet splash pcie_ports=native"

Danach update-grub, neu starten, fertig. Der Unterschied ist deutlich:

# vorher
dmesg | grep -c "AER: enabled"
#   0

# nachher
dmesg | grep -c "AER: enabled"
#   7

Sieben Root Ports mit aktiver Fehlerbehandlung, darunter die beiden, um die es mir ging:

pcieport 0000:c2:04.0: AER: enabled with IRQ 130
pcieport 0000:c2:05.0: AER: enabled with IRQ 131

Wichtig für alle die das nachbauen: die _OSC-Zeile beim Booten sagt weiterhin platform does not support. Sie ändert sich nicht und wird sich nie ändern, das ist die Antwort der Firmware. Der Parameter sorgt nur dafür, dass der Kernel sie ignoriert. Wer nach dem Neustart auf diese Zeile schaut, hält die Massnahme fälschlich für wirkungslos. Das Erfolgskriterium ist AER: enabled, nicht _OSC.

Als Zugabe kam noch DPC dazu, Downstream Port Containment. Das riegelt bei einem schweren Fehler den betroffenen Anschluss ab, statt den ganzen Rechner mitzureissen. Bei einem Laufwerk an einem 75-Zentimeter-Kabel ist mir das ausgesprochen recht.

Die zwei Schalter im BIOS, die man dafür in Ruhe lassen muss

Aptio Setup, IIO Configuration, mit PCIe ASPM Support, IIO eDPC Support und PCIe Completion Timeout

Unter Advanced > Chipset Configuration > North Bridge > IIO Configuration:

> CPU1 Configuration
> IOAT Configuration
> Intel(R) VT for Directed I/O (VT-d)
> Intel(R) VMD Technology
PCIe ASPM Support (Global)        [Disable]
IIO eDPC Support                  [Disable]
PCIe Completion Timeout           [260ms to 900ms]

Einen AER-Schalter gibt es hier nicht. Ich habe danach gesucht, ihn gibt es schlicht nicht, und deshalb war der Kernel-Parameter nicht der bequemere Weg sondern der einzige.

IIO eDPC Support ist die firmware-first-Variante von DPC, also das Gegenstück zu dem, was pcie_ports=native gerade aktiviert hat. Dass es auf Disable steht, ist der Grund weshalb der Kernel DPC übernehmen konnte. Nicht einschalten, sonst reisst die Firmware die Eindämmung wieder an sich und kollidiert mit dem nativen Mechanismus.

PCIe ASPM Support (Global) [Disable] ist etwas anderes und wird gerne verwechselt. ASPM sind Stromsparzustände für die Verbindung selbst: bei wenig Verkehr werden Teile der Leitung schlafen gelegt. Das spart im Leerlauf ein paar Watt und kostet Latenz beim Aufwachen. Auf Servern ist es traditionell aus, weil es in der Vergangenheit für schwer zu findende Aussetzer gesorgt hat. Meine NVMe kann es ohnehin nicht, das steht so in ihren Fähigkeiten.

Nicht verwechseln mit dem Herunterttakten aus Teil 8: dass eine Grafikkarte im Leerlauf auf PCIe 1.0 fällt, ist Link-Geschwindigkeitsverwaltung und hat mit ASPM nichts zu tun. ASPM regelt Zustände, nicht Tempo. Die beiden Befunde „ASPM ist aus“ und „der Link taktet runter“ stehen sich nicht im Weg.

Und dann kam das, weswegen ich das alles gemacht habe

Fehlerbehandlung aktiv zu haben ist nur die halbe Miete. Die Zähler im sysfs stehen nach jedem Neustart wieder auf null. Wer alle paar Wochen hinsieht, sieht nur den Ausschnitt seit dem letzten Start.

Also habe ich noch ein Paket nachinstalliert:

apt-get install rasdaemon

Das Ding läuft als Dienst, hört auf die Fehlerereignisse des Kernels und schreibt sie mit Zeitstempel in eine kleine Datenbank. Speicherfehler, Machine Checks, und eben AER. Beim Einrichten war alles auf null, und ich hatte ehrlich gesagt damit gerechnet, dass das so bleibt.

Beim Schreiben dieser Folge habe ich noch einmal nachgesehen:

ras-mc-ctl --summary
#   No Memory errors.
#
#   PCIe AER events summary:
#           15 Corrected errors: Receiver Error
#
#   No Extlog errors.
#   No MCE errors.

Fünfzehn korrigierte Fehler. Der Speicher ist sauber, die Machine Checks sind sauber, aber auf PCIe stand etwas. Und jetzt kommt der Teil, für den sich die ganze Übung gelohnt hat, denn die Datenbank weiss auch wo und wann:

ras-mc-ctl --errors
#   1  2026-08-03 12:48:54  0000:c2:05.0  Corrected error: Receiver Error
#   ...
#   15 2026-08-03 13:04:34  0000:c2:05.0  Corrected error: Receiver Error

Alle fünfzehn am selben Tag, innerhalb von sechzehn Minuten, alle am selben Anschluss. c2:05.0 ist der zweite NVMe-Port. Und der dritte August war der Tag, an dem an genau diesem Strang gearbeitet wurde.

Damit ist es keine besorgniserregende Meldung, sondern eine erklärbare: Empfangsfehler, während sich eine Verbindung aufbaut, sind erwartbar. Seitdem, und das ist die eigentlich gute Nachricht, ist kein einziger dazugekommen.

Aber genau das ist der Punkt. Ohne den Kernel-Parameter hätte niemand diese fünfzehn Ereignisse registriert. Ohne rasdaemon wären sie beim nächsten Neustart verschwunden. Und wenn dieselben fünfzehn Einträge nicht an einem einzigen Nachmittag aufgetreten wären, sondern verteilt über drei Wochen ohne dass jemand am Gehäuse war, dann wäre das die Vorwarnung gewesen, wegen der ich das alles überhaupt eingerichtet habe.

Fazit

Von allen Änderungen, die ich an dieser Maschine gemacht habe, ist diese die unauffälligste und vermutlich die nützlichste. Sie kostet einen Kernel-Parameter, ein Paket und einen Neustart. Sie ändert im Alltag nichts. Und sie ist der Unterschied zwischen „das Laufwerk ist plötzlich weg“ und „an diesem Anschluss stimmt seit zwei Wochen etwas nicht“.

Was ich mitnehme: eine Firmware, die _OSC mit „unterstütze ich nicht“ beantwortet und gleichzeitig den eigenen Meldeweg abgeschaltet hat, hinterlässt eine Lücke, die man nur findet wenn man danach sucht. Beim Einrichten einer neuen Maschine würde ich ab jetzt immer nach dieser einen Zeile im Startprotokoll greppen.

Nächste Folge: Virtualisierung. VT-d, IOMMU-Gruppen, VMD und ein Menü namens IOAT, in dem etwas ganz anderes steht als der Name vermuten lässt.

Siehe auch

Falls jemand von euch eine steigende Zahl korrigierter PCIe-Fehler in freier Wildbahn hatte und am Ende die Ursache gefunden hat: Kabel, Riser, Steckplatz? Das würde mich sehr interessieren, ihr dürft mich jederzeit fragen.

BIOS erklärt, Teil 9: Above 4G, Resizable BAR und eine Liste von Option ROMs

Es gibt in jedem BIOS eine Seite, auf der die Dinge landen, die sonst nirgends hinpassen. Bei Supermicro heisst sie PCIe/PCI/PnP Configuration, und das PnP im Namen ist Plug and Play, ein Begriff aus den Neunzigern, der damals eher ein Versprechen als eine Beschreibung war. Ich interpretiere das einfach für mich jetzt mal so, ok?

Oben stehen Einstellungen, die für alle PCIe-Geräte gelten. Unten steht für jeden einzelnen Steckplatz eine Zeile. Beides ist interessant, aber aus unterschiedlichen Gründen. Das hier ist Teil 9, gesammelt liegt alles unter BIOS & Firmware.

Die obere Hälfte

Aptio Setup, PCIe PCI PnP Configuration, mit Above 4G Decoding, Resizable BAR, SR-IOV und ARI
Above 4G Decoding                 [Enabled]
Re-Size BAR Support               [Enabled]
SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]
Bus Master Enable                 [Enabled]
Consistent Device Name Support    [Disabled]
MMIO High Base                    [32T]
MMIO High Granularity Size        [64G]
Maximum Read Request              [Auto]
MMCFG Base                        [Auto]

Alles auf Enabled, ich denke für mich genau richtig; also den Computer hier :D. Trotzdem lohnt es sich, die ersten beiden anzusehen, weil sie zusammengehören und weil sie ein handfestes Problem lösen. Mein letztes Bios hatte diese Möglichkeit nicht, weil die PCIe Version zu alt war. Ich freue mich also über diese neue Möglichkeit. Ich muss grade an Franck Ribéry „Jubel“ denken.

Das 4-GB-Problem, oder: warum 16 GB Grafikspeicher nicht sichtbar waren

Jedes PCIe-Gerät blendet seinen Speicher in den Adressraum des Rechners ein. Diese Fenster heissen BARs, Base Address Registers. Eine Grafikkarte mit 16 GB Videospeicher hätte gerne ein Fenster von 16 GB, damit die CPU auf den ganzen Speicher direkt zugreifen kann.

Das Problem: historisch lagen diese Fenster alle unterhalb der 4-GB-Grenze, weil dort in einem 32-Bit-Adressraum eben Schluss ist. Na wer erinnert sich noch an zu große DVD Images auf 32-Bit Filesystemen? Unterhalb von 4 GB liegen aber auch der Arbeitsspeicher, die Firmware und noch einiges mehr. Für die Geräte bleibt ein schmaler Streifen übrig, bei mir ist das dieser hier:

Global MMIO Low Base / Limit      90000000 / FBFFFFFF

Von 0x90000000 bis 0xFBFFFFFF, also knapp 1,7 GB für alle Karten zusammen. Da passt keine moderne Grafikkarte hinein, geschweige denn eine Grafikkarte und zwei Netzwerkkarten und zwei NVMe-Laufwerke.

Above 4G Decoding hebt diese Grenze auf. Die Fenster dürfen dann oberhalb von 4 GB liegen, und dort ist Platz ohne Ende:

Global MMIO High Base / Limit     0000200000000000 / 0000204FFFFFFFFF

Das beginnt bei 32 Terabyte und ist 320 GB gross. Genau das steht auch in der Zeile MMIO High Base [32T] weiter unten.

Ohne diesen Schalter bekommt eine 16-GB-Grafikkarte ein Notfallfenster von 256 MB und muss ihren restlichen Speicher stückweise durchreichen. Das funktioniert, kostet aber Leistung, und bei manchen Karten funktioniert es gar nicht. Wer sich fragt, warum sein Rechner mit einer neuen Grafikkarte gar nicht mehr durchbootet: hier nachsehen oder auch, wenn die Performance deutlich unter der Erwartung liegt.

Resizable BAR, der Schalter mit dem Spielerimage

Re-Size BAR Support ist der zweite Teil desselben Gedankens. Above 4G schafft den Platz, Resizable BAR erlaubt der Karte, ein entsprechend grosses Fenster tatsächlich anzufordern.

Bekannt geworden ist die Funktion vor ein paar Jahren als Gaming-Feature, weil AMD sie als „Smart Access Memory“ vermarktet hat und in einigen Spielen ein paar Prozent mehr Bilder pro Sekunde herauskamen. Der eigentliche Nutzen liegt woanders: überall dort, wo grosse Datenmengen in den Grafikspeicher wandern und die CPU dabei mitreden muss. Rechnen auf der GPU, Modelle laden, Videobearbeitung.

Bei mir ist es also erst 2026 angekommen:

lspci -vv -s 51:00.0 | grep -A2 "Resizable BAR"
#   BAR 1: current size: 16GB, supported: ... 16GB

16 GB aktuell, und 16 GB ist zugleich die grösste unterstützte Grösse. Der komplette Videospeicher ist eingeblendet, mehr geht nicht. Zwei BIOS-Schalter, die zusammen dafür sorgen, dass die Karte tut was sie soll und zwar, zumindest hier, ungebremst.

SR-IOV und ARI

SR-IOV Support                    [Enabled]
ARI Support                       [Enabled]

SR-IOV steht für Single Root I/O Virtualization und erlaubt einer Karte, sich gegenüber dem System als mehrere Geräte auszugeben. Eine Netzwerkkarte meldet dann neben ihrer physischen Funktion noch eine Reihe virtueller, und jede davon kann einer virtuellen Maschine direkt zugewiesen werden. Die VM redet dann ohne Umweg über den Hypervisor mit der Hardware. Wichtig für VMs also.

Meine X710 kann das, ich nutze es immer mal wieder in verschiedenen Projekten. Der Schalter kostet nichts, solange niemand virtuelle Funktionen anlegt, und wenn ich es noch einmal brauche, muss ich nicht neu starten.

ARI ist die technische Voraussetzung dafür. Alternative Routing-ID Interpretation klingt kompliziert und ist eine Adressierungsfrage: klassisch hat ein PCIe-Gerät bis zu acht Funktionen. Eine Karte mit dutzenden virtuellen Funktionen sprengt das. ARI verschiebt die Bitgrenze im Adressfeld, sodass mehr Funktionen pro Bus möglich sind. Ohne ARI kein sinnvolles SR-IOV.

Bus Master Enable erlaubt Geräten, selbst Speicherzugriffe auszulösen, statt darauf zu warten dass die CPU sie abholt. Das ist DMA, und ohne DMA ist jede halbwegs moderne Karte unbrauchbar. Der Schalter existiert vermutlich nur noch aus historischen Gründen. Oder fällt euch etwas ein, warum man direkten Speicherzugriff nicht will?

Maximum Read Request [Auto] legt fest, wie viele Daten ein Gerät mit einer einzigen Anfrage holen darf. Grössere Anfragen bedeuten weniger Verwaltungsaufwand. An meiner NVMe ergibt Auto 512 Byte, was zunächst wenig aussieht. Es ist aber kein BIOS-Problem: das Laufwerk selbst gibt in seinen Fähigkeiten nur 512 Byte an. Hochdrehen würde also nichts bringen, solange die Gegenseite nicht mitspielt.

Die untere Hälfte: Option ROMs

VGA Priority                      [Offboard]
Onboard Video Option ROM          [EFI]
CPU SLOT1 PCI-E 4.0 X8 OPROM      [EFI]
CPU SLOT2 PCI-E 4.0 X8(IN X16) OPROM [EFI]
CPU SLOT4 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT6 PCI-E 4.0 X16 OPROM     [EFI]
CPU SLOT7 PCI-E 4.0 X8 OPROM      [EFI]
M.2-H OPROM                       [EFI]
Onboard LAN1 Option ROM           [EFI]
Onboard NVMe1 Option ROM          [EFI]
Onboard NVMe2 Option ROM          [EFI]

Ein Option ROM ist ein Stück Firmware auf der Steckkarte selbst. Beim Start lädt das BIOS diesen Code und führt ihn aus, damit die Karte schon nutzbar ist, bevor ein Betriebssystem existiert. Klassische Beispiele: eine Netzwerkkarte, die über PXE booten soll. Ein Speichercontroller, von dem gestartet wird. Eine Grafikkarte, die ein Bild anzeigen soll. Ihr versteht schon…

Die drei Werte sind EFI, Legacy und Disabled. EFI heisst modernes UEFI-Modul, Legacy heisst 16-Bit-Code aus der BIOS-Zeit, Disabled heisst gar nicht laden.

Bei mir steht überall EFI, was zum restlichen System passt, denn Legacy-Boot ist auf diesem Board abgeschaltet. Interessant ist eher, dass man diese Liste überhaupt hat. Auf einem Desktopboard gibt es allenfalls einen Schalter für alle. Hier kann man pro Steckplatz entscheiden.

Wozu? Zwei Gründe. Erstens Startzeit: jedes Option ROM kostet Zeit, und Netzwerkkarten sind darin führend, weil sie auf Link warten. Zweitens Angriffsfläche: das ist fremder Code, der vor dem Betriebssystem mit vollen Rechten läuft. Wer die Karte nur unter Linux nutzt und nie davon bootet, verliert durch Disabled nichts.

Ich habe einen konkreten Kandidaten dafür. Meine X710 meldet auf der Driver-Health-Seite des BIOS Failed, weil ihr UEFI-Treiber älter ist als die Firmware, die ich vor einer Weile aktualisiert habe. Die Karte funktioniert unter Linux tadellos, nur der Vorstart-Code beschwert sich über sich selbst. CPU SLOT6 OPROM auf Disabled, und die Meldung wäre weg. Kostenpunkt: kein PXE-Boot über diese Karte, was ich noch nie gebraucht habe. Dazu mehr in Teil 13.

VGA Priority

VGA Priority                      [Offboard]

Dieses Board hat eine eingebaute Grafik. Sie sitzt im Verwaltungscontroller, dem ASPEED AST2600, und ihr einziger Zweck ist die Fernkonsole. Sie ist grottig, das ist Absicht, sie soll ein Terminal darstellen und sonst nichts.

VGA Priority entscheidet, welche Karte das Bild beim Start bekommt. Offboard heisst: die Steckkarte. Genau so meldet es das laufende System:

cat /sys/bus/pci/devices/0000:51:00.0/boot_vga    # 1  (RTX 4060 Ti)
cat /sys/bus/pci/devices/0000:03:00.0/boot_vga    # 0  (AST2600)

Ganz abschalten lässt sich die eingebaute Grafik nicht, und das ist auch gut so: sie hängt am Verwaltungscontroller, und wer sie loswürde, hätte auch keine Fernkonsole mehr. Genau über die habe ich diese ganze Serie aufgezeichnet. IPMI und so halt, Video aufnehmen, Bilder heraus kopieren usw….

Eine Kleinigkeit, die mir erst beim zweiten Mal aufgefallen ist

Die Liste oben endet bei Onboard NVMe2 Option ROM. In meiner ersten Aufzeichnung war das letzte, was ich hatte, Onboard NVMe1, weil ich nicht weit genug gescrollt hatte. Der Hilfetext auf derselben Seite sprach aber von NVMe2, es musste also noch etwas darunter geben.

Nächste Folge: die dritte und letzte PCIe-Folge. ASPM, eDPC und die Frage, wer eigentlich mitbekommt wenn auf einer PCIe-Verbindung Fehler auftreten. Bei mir war die Antwort eine Zeit lang: niemand.

Siehe auch

Falls jemand von euch Option ROMs gezielt abgeschaltet und dabei messbar Startzeit gespart hat: wie viel war es? Ihr dürft mich jederzeit fragen.

« Ältere Beiträge

© 2026 -=Kernel-Error=-

Theme von Anders Norén — Hoch ↑