IT security, FreeBSD, Linux, mail server hardening, post-quantum crypto, DNS, retro computing & hands-on hardware hacks. Privater Tech-Blog seit 2003.

Kategorie: Netzwerke & Protokolle (Seite 5 von 5)

IPv4, IPv6, DNS, DNSSEC, SSH und Netzwerk-Grundlagen — Praxiswissen für Admins und Netzwerker.

IPv6 ICMP Redirect erklärt: „rt6_redirect: source isn’t a valid nexthop“

Man stolpert irgendwann über diese Meldung im Kernel-Log:

rt6_redirect: source isn't a valid nexthop for redirect target
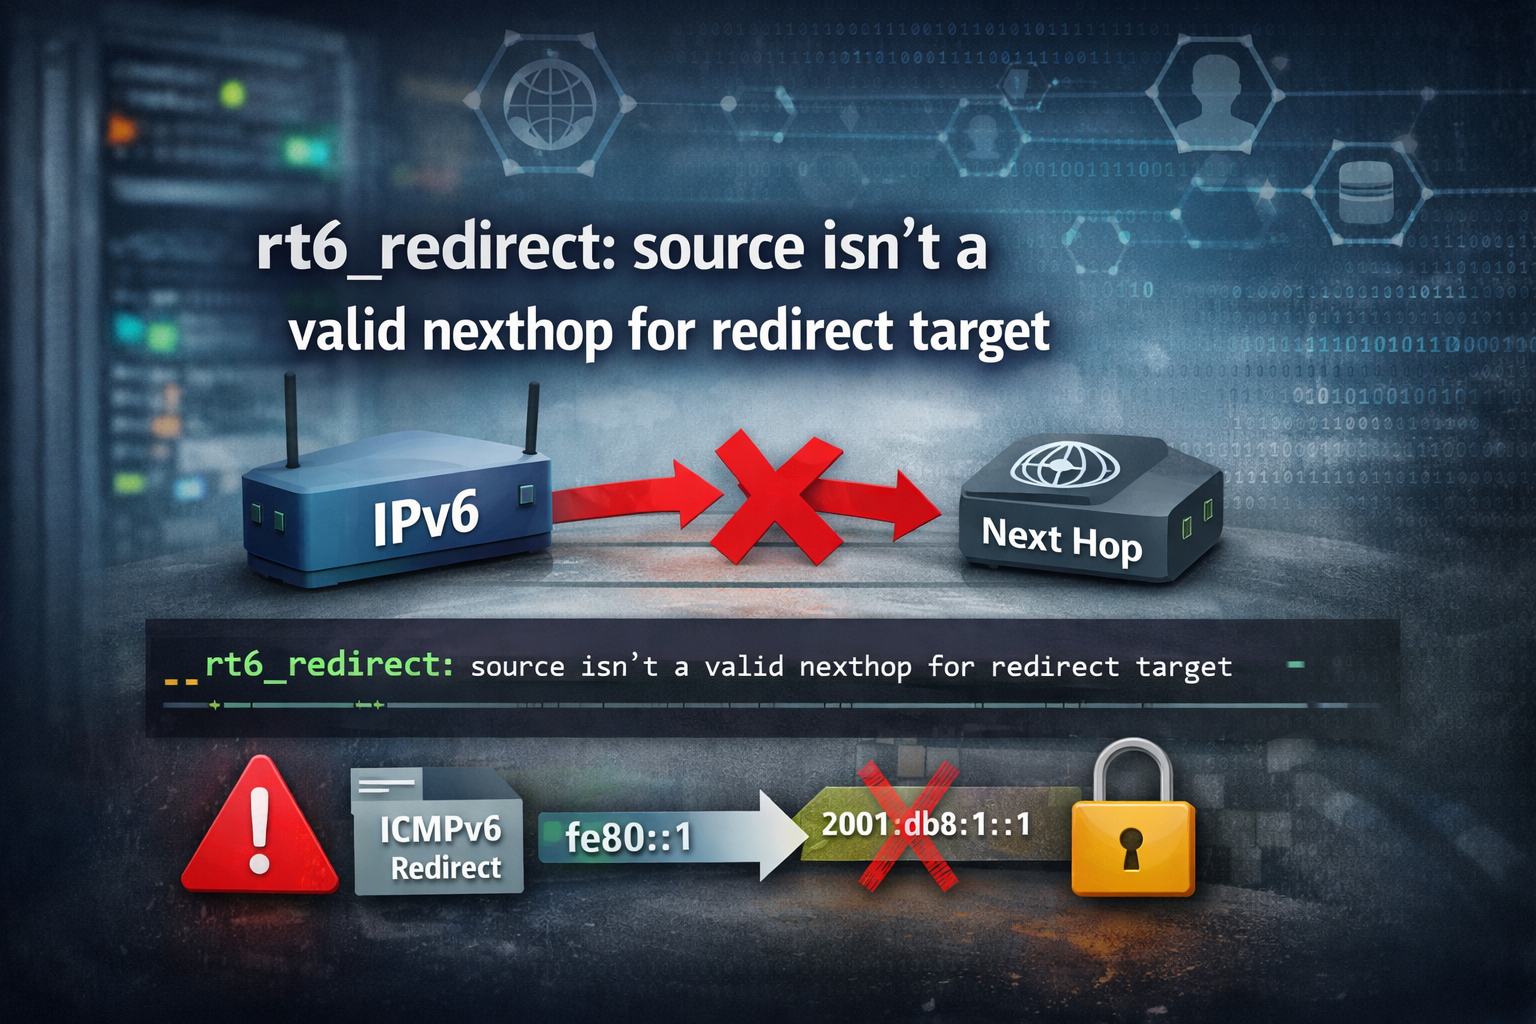
Illustration eines IPv6-Netzwerks mit Kernel-Logmeldung „rt6_redirect: source isn't a valid nexthop for redirect target“. Ein ICMPv6-Redirect verweist fälschlich von einer Link-Local-Adresse auf eine globale IPv6-Adresse als Next Hop, was vom System abgelehnt wird.

Gerne im Zusammenhang mit IPv6, gerne dann, wenn man glaubt, eigentlich alles richtig gemacht zu haben. Routing stimmt. Neighbors sehen gut aus. Und trotzdem meckert der Kernel.

Die Kurzfassung: Der Linux-Kernel hat ein ICMPv6 Redirect bekommen und lehnt es ab, weil der vorgeschlagene Next Hop aus seiner Sicht kein gültiger First Hop ist.

Worum geht es überhaupt?

ICMPv6 Redirects (Typ 137) sind Teil von Neighbor Discovery. Ein Router sagt damit zu einem Host sinngemäß:

„Für dieses Ziel gibt es einen besseren ersten Hop als mich.“

Wichtig: erster Hop. Nicht irgendein Router irgendwo, sondern ein direkt erreichbarer Nachbar auf dem Link.

Ein Redirect enthält deshalb zwei zentrale Informationen:

  • das Target (Zieladresse, für die das Redirect gilt)
  • den Better Next Hop

Und jetzt kommt der Teil, den viele Implementierungen (und Admins) gerne unterschätzen:
Der Host muss diesem Vorschlag nicht glauben.

Was Linux hier tatsächlich prüft

Linux ist bei Redirects ziemlich streng. Zu Recht. Redirects sind ein beliebtes Einfallstor für Unsinn und Angriffe.

Bevor der Kernel ein Redirect akzeptiert, prüft er u. a.:

  • stammt das Redirect von einem Router, den ich bereits als Router kenne?
  • liegt der vorgeschlagene Next Hop auf demselben Link?
  • ist dieser Next Hop als Neighbor bekannt bzw. grundsätzlich auflösbar?
  • passt das Ganze zur bestehenden Routing-Entscheidung?

Und genau hier schlägt diese Logmeldung zu.

Der Kernel schaut auf den Better Next Hop im Redirect und stellt fest:

„Diese Adresse kann für dieses Ziel kein gültiger Next Hop sein.“

Dann wird das Redirect verworfen. Keine neue Route. Kein Update. Nur diese Meldung.

Der Klassiker: Global statt Link-Local

In der Praxis sieht man das oft in Setups, in denen Router ihre Default-Route oder interne Routen nicht sauber über Link-Local-Adressen aufbauen.

Beispiel (vereinfacht):

default via 2001:db8:1::1 dev eth0

Sieht harmlos aus. Funktioniert auch meistens. Aber:
IPv6 erwartet, dass Router auf einem Link über ihre Link-Local-Adresse angesprochen werden.

Korrekt wäre also eher:

default via fe80::1 dev eth0

Was passiert nun?

Der Router verschickt ein Redirect und trägt als „Better Next Hop“ seine globale Adresse ein (z. B. 2001:db8:1::1).
Der Host bekommt das Redirect, prüft es – und sagt:

„Moment. Dieser Next Hop ist kein gültiger direkt erreichbarer Neighbor für dieses Ziel.“

Und genau dann landet diese Meldung im Log.

Wichtig:
Das Problem ist nicht primär, dass die Adresse global ist.
Das Problem ist, dass der Kernel den vorgeschlagenen Next Hop nicht als legitimen First Hop auf diesem Link akzeptiert.

Link-Local ist der Normalfall. Alles andere muss extrem gut begründet sein – und ist es fast nie.

Ein Blick auf die Nachbartabelle hilft

Wenn man wissen will, warum der Kernel das Redirect ablehnt, lohnt sich ein Blick in die Neighbor-Daten:

ip -6 neigh show

Oder gezielter:

ip -6 route get 2001:db8:dead:beef::1

Wenn der vorgeschlagene Next Hop dort nicht als sinnvoller Neighbor auftaucht, ist die Sache im Prinzip entschieden.
Kein Neighbor → kein gültiger Next Hop → Redirect wird verworfen.

Das Redirect live mitschneiden

Wenn man genau wissen will, ob der Router wirklich ein Redirect schickt und was er als Next Hop vorschlägt, hilft tcpdump. ICMPv6 Typ 137 ist das Redirect:

tcpdump -n -i eth0 'icmp6 and ip6[40] == 137'

Im Paket sieht man den Router als Absender, das Target (Ziel, für das der Hinweis gilt) und den Better Next Hop. Passt der Next Hop nicht zu einem gültigen Neighbor auf dem Link, ist klar warum der Kernel ablehnt.

Ebenfalls nützlich: ob der Host Redirects überhaupt annehmen will.

sysctl net.ipv6.conf.all.accept_redirects
sysctl net.ipv6.conf.eth0.accept_redirects

Default ist 1 auf einem Host, 0 auf einem Router. Zusätzlich greift secure_redirects (Default 1): nur Redirects von bereits bekannten Gateways werden überhaupt akzeptiert.

Default-Route mit Link-Local als Next Hop

Wer die Route selbst setzt (statische Konfiguration ohne RA), sollte Link-Local nehmen. Link-Local ist pro Interface nicht eindeutig, der Eintrag braucht also immer ein dev:

ip -6 route add default via fe80::1 dev eth0

Persistenz hängt vom System ab. systemd-networkd in /etc/systemd/network/*.network unter [Route] Gateway=fe80::1, netplan in /etc/netplan/*.yaml, die klassische /etc/network/interfaces kennt post-up ip -6 route .... Wichtig: das Interface muss im Eintrag stehen.

Mit Link-Local als Next Hop verschwindet die rt6_redirect-Meldung in der Regel. Der Kernel hat einen gültigen First Hop als Neighbor, und ein Redirect desselben Routers passt dann sauber ins Modell.

Oder: Redirects abschalten

Auf Servern in kontrollierten Hosting-Umgebungen (Hetzner, Netcup, Cloud-VPCs) ist das Routing sauber vorgegeben, und der Provider-Router hat keinen besseren Next Hop anzubieten. Dann sind ICMPv6-Redirects nur Rauschen im Log:

sysctl -w net.ipv6.conf.all.accept_redirects=0
sysctl -w net.ipv6.conf.default.accept_redirects=0

Persistent in /etc/sysctl.d/99-ipv6.conf. Nachteil: kennt der Router tatsächlich einen legitimen besseren Weg, bleibt der Host trotzdem bei seiner existierenden Route. Im Rechenzentrum mit einer einzigen Default-Route ist das genau richtig, in einem verzweigten Firmennetz mit mehreren Uplinks eher nicht.

Warum das kein Bug ist

Die Meldung klingt erstmal nach kaputtem Routing. Ist es aber meistens nicht.

Im Gegenteil:
Der Kernel verhält sich exakt so, wie es das Protokoll vorsieht. Redirects sind Hinweise, keine Befehle. Und Linux nimmt diese Hinweise nur an, wenn sie sauber in das bestehende Neighbor- und Routing-Modell passen.

Das schützt unter anderem vor:

  • falschen Router-Konfigurationen
  • kaputten RA-Setups
  • Bridge-/VM-Konstrukten mit „kreativem“ IPv6
  • trivialen Redirect-Spoofing-Angriffen

Update 2026: was heute anders ist

In modernen Setups begegnet einem die Meldung seltener. Nicht weil das Protokoll sich geändert hätte, sondern weil die Umgebung drumherum sauberer geworden ist:

  • Enterprise-Switches mit RA Guard und ND Inspection filtern unerwünschte RAs und Redirects bereits auf Layer 2 heraus. Cisco, Juniper und andere haben das seit Jahren im Portfolio.
  • Cloud-Umgebungen (AWS VPC, Hetzner Cloud, Azure) liefern ein sauber vorgegebenes Default-Gateway aus, in der Regel ein Link-Local-Hop. Redirects tauchen praktisch nie auf.
  • Home-Router (FritzBox, Unifi, OpenWrt) machen es per Default richtig.
  • SEND/CGA (RFC 3971) hätte kryptografisch signierte Neighbor Discovery gebracht und Redirect-Spoofing strukturell verhindert. Die Adoption ist praktisch bei null geblieben. Tot.

Übrig bleibt die Meldung heute fast nur in selbstgebauten VM- und Container-Setups, in denen Host- und Gast-Routing nicht sauber zusammenpassen, oder wenn in statischer Konfiguration aus Gewohnheit eine globale Adresse als Next Hop gesetzt wird.

Fazit

Die Meldung

rt6_redirect: source isn't a valid nexthop for redirect target

bedeutet nicht „IPv6 kaputt“.
Sie bedeutet: Ein Router hat ein Redirect geschickt, das aus Sicht des Hosts keinen gültigen Next Hop beschreibt.

In der Praxis ist das fast immer ein Hinweis auf:

  • Default- oder interne Routen ohne Link-Local-Next-Hop (siehe auch IPv6 ULA und Adresspriorisierung)
  • Router, die globale Adressen in Redirects verwenden
  • Setups, in denen Neighbor Discovery und Routing nicht sauber zusammenpassen

Oder anders gesagt:
Der Kernel ist hier nicht pingelig. Er ist vorsichtig. Und das ist gut so.

Siehe auch: IPv6 Grundlagen. Zum Nachlesen: RFC 4861 §8 (Redirect-Handling bei Hosts) und RFC 6980 (fragmentiertes Neighbor Discovery ist verboten — ein harter Security-Fix für ND-Spoofing).

Fragen? Einfach melden.
IPv6 Prefix Delegation: FritzBox und MikroTik

Prefix Delegation per DHCPv6 ist nichts Neues. Dass eine FritzBox das bietet, war mir aber neu. Vielleicht unterschätze ich das Teil?

Ich bekomme ein /48 zugeteilt, die FritzBox bietet die — nicht weiter konfigurierbare — Möglichkeit, ein /62 per Prefix Delegation an einen weiteren Router im Netzwerk weiterzugeben.

Ich habe also meinen MikroTik über den DHCPv6-Client mit einem Prefix füttern lassen. Der MikroTik arbeitet als Hotspot und Trenner fürs WLAN. Nun schiebt dieser das per Prefix Delegation zugewiesene /64 auch ins WLAN durch.

Damit ist im WLAN über die FritzBox und den MikroTik auch IPv6 angekommen. An der FritzBox lässt sich kaum etwas hinsichtlich Netzwerk konfigurieren — ist halt alles zielgruppengerecht. Aber hier hat mich die Kiste von AVM überrascht.

Fragen? Einfach melden.

IPv6 / Default Route / DNS /DHCP

Nun arbeite ich schon seit einigen Jahren, privat wie im Berufsleben, mit IPv6. Was mir bei vielen Schulungen, Einführungen, Netzumstellungen usw… auffällt ist dass es vielen Admins schwer fällt zu verstehen wie der Client nun an seine Netzwerkkonfiguration kommt. Da in der letzten Zeit immer mehr Fragen zu dem Thema bei mir landen (scheinbar müssen viele jetzt noch „auf den letzten Drücker“ IPv6 lernen), versuche ich es hier mal grob aufzuschlüsseln. Im Grunde ist es ganz einfach: –    Bei IPv6 verteilt der DHCPv6 Server keine Default Route, das macht der Router! –    Der DHCPv6 kann DNS Server, NTP-Server usw. verteilen und für eine automatische Eintragung des Clients am DNS Server sorgen. Er kann natürlich auch zusätzliche IPv6 Adressen verteilen. –    Der Router verteilt sein Präfix per RA (Router Advertisment).       o    Der Client kümmert sich um die Generierung einer IP-Adresse.       o    Im RA kann der Client aufgefordert werden einen DHCPv6 Server nach weiteren Informationen zu fragen.       o    Im RA kann ein DNS Server an den Client übergeben werden (RDNSS) Erst einmal ist also für eine vollständige Autokonfiguration des Clients kein DHCPv6 Server mehr nötig. Denn der Client hat immer und direkt eine IPv6 Adresse vom scope link (fe80:….). Diese Adresse hat der Client sobald er einen Netzwerklink hat und wird aus der eigenen MAC-Adresse per EUI (Extended Unique Identifier) erstellt. Nun sendet der Client im einfachsten Fall ein RS (Router Solicitation) an die Multicast Adresse, auf welche ALLE Router hören, ins Netzwerk (ff02::2). Der Router antwortet dann mit einem RA und übermittelt dem Client das IPv6-Präfix. Der Client baut dann aus diesem Präfix und EUI wieder eine Adresse vom scope global. Sowie bei aktivierten Privacy Extensions eine gewürfelte Adresse. Der Client hat nun mindestens zwei IPv6 Adressen bei aktivierten Privacy Extensions sogar bereits drei IPv6 Adressen, sowie eine Default Route über den Router welcher uns den RA verpasst hat. Ist am Router die Option RDNSS gesetzt wird dem Client zum Präfix auch noch ein DNS Server übergeben. Dieses ~verstehen~ leider noch nicht alle Clients. Damit wäre der Client schon in der Lage vollständig am „Internetleben“ teil zu nehmen. Ist am Router das Other Config Flag gesetzt, wird der Client angewiesen einen DHCPv6 Server nach weiteren Einstellungen/Informationen zu fragen. Nun kommt der DHCPv6 Server ins Spiel. Wird dieser vom Client nach weiteren Einstellungen/Informationen gefragt wird er die gewünschten Informationen an den Client übermitteln. Was nicht bedeutet dass der Client damit eine weitere IPv6 Adresse bekommen muss. Es ist auch möglich nur wins, ntp, dns usw.. an die Client zu übermitteln. Der Client muss dazu über einen DHCPv6-Client verfügen. Dieser ist bisher noch nicht bei allen Clientsystemen per Default vorhanden bzw. aktiviert! Natürlich kann man seinen DHCPv6 Server auch so konfigurieren dass er zusätzlich noch eine dritte bzw. vierte (oder mehr) IPv6 Adresse an den Client übermittelt. Damit wäre der DHCPv6-Server zusätzlich in der Lage diese IPv6 Adressen einem DNS Server bekannt zu machen. Wie auch beim Thema NAT bei IPv6 gibt es Vorschläge dem DHCPv6 Server wieder die Option Route zu spendieren, ich denke es ist nicht nötig / sinnvoll… Hier kann man sich streiten! Die Idee bei IPv6 möglichst viel Arbeit auf den Client zu verlagern ergibt meist erst auf den zweiten Blick Sinn. Bei IPv4 war es bisher so dass der Client als erstes ins Netzwerk herumbrüllt ob den ein DHCP Server da ist, dann gab es einen regen Austausch zwischen diesen Systemen und am Ende hatte der Client alle seine Informationen. Denkt man aber nun daran dass im größten IPv4 Netzausbei maximal (24^2)-2 Hostadressen herausspringen und beim IPv6 im kleinsten Netzausbau minimal (64^2)-2 Hostadressen herausspringen… Ja dann ahnt man schon, wenn sich hier ein Router noch ums Popo abwischen kümmern muss, dann ist nicht mehr viel mit Netzwerk. Noch Fragen? Dann fragen….

Siehe auch: IPv6 Grundlagen

Fragen? Einfach melden.

Unser RIPE ist bald wirklich alle: Einblick in die Erschöpfung der IPv4-Adressen

RIPE ist in Sachen IPv4 Adressen nun soweit leer dass sie nun auf ein „erweitertes“ Vergabeverfahren wechseln. Soll bedeuten dass nun ganz super streng (bla bla bla) kontrolliert wird warum und wo die Adresse hingeht und ob die auch wirklich gebraucht wird…..

Wie auch immer! Damit man sich besonders gut anschauen kann was noch übrig ist gibt es von den Jungs selbst eine kleine Grafik (http://www.ripe.net/internet-coordination/ipv4-exhaustion/ipv4-available-pool-graph).

Dass ich ein großer Freund davon bin, mal endlich mit IPv6 aus dem Arsch zu kommen, muss ich ja keinem mehr erzählen. Wenn ich mir andere Hochrechnungen anschaue (http://www.potaroo.net/tools/ipv4/index.html) dann haben wir aktuelle noch bis zum 24.09.2012 (das ändert sich noch mal) IPv4 Adressen.

Ja ja… IPv4 ist ab dem Tag nicht tot (Dualstack für die nächsten Jahre..) und unsere Provider und Hoster haben auch noch Reserven. Zusätzlich kann man ab dem Moment beginnen seine IPv4 Adressen zu verkaufen *lach*…..  AAAABBBER, warum der ganze Stress? Warum nicht einfach mal mit IPv6 beschäftigen? Nein nein, ich meine wirklich beschäftigen, nicht nur so tun als ob.

Siehe auch: IPv4-Adressen sind aufgebraucht

Fragen? Einfach melden.

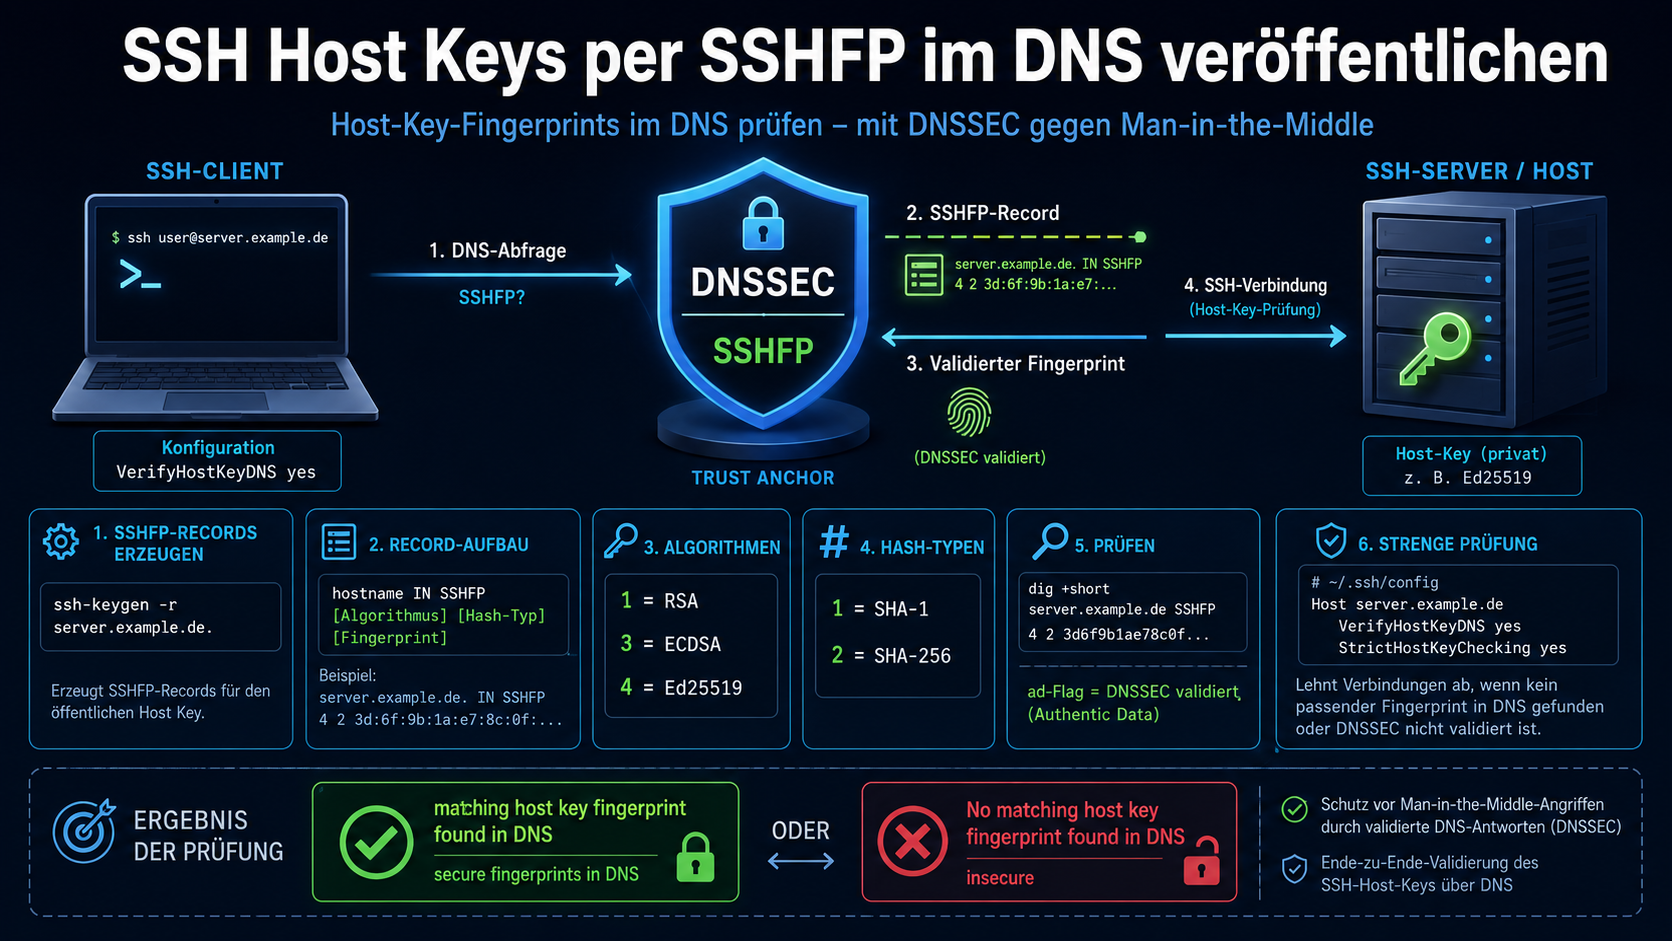
SSH Host Keys per SSHFP im DNS veröffentlichen

SSH-Host-Key-Prüfung per SSHFP im DNS mit DNSSEC-validiertem Fingerprint, OpenSSH-Client, Server-Host-Key und Schutz vor Man-in-the-Middle-Angriffen.

OpenSSH kann die Fingerprints seiner Host Keys als SSHFP-Records im DNS veröffentlichen. Beim Verbindungsaufbau prüft der Client dann automatisch, ob der Fingerprint des Servers mit dem DNS-Eintrag übereinstimmt, ein wirksamer Schutz gegen Man-in-the-Middle-Angriffe. Ist die Zone zusätzlich per DNSSEC gesichert, kann der DNS-Record selbst nicht gefälscht werden. Die Spezifikation steht in RFC 4255.

Client konfigurieren

Damit OpenSSH beim Verbindungsaufbau SSHFP-Records prüft, muss VerifyHostKeyDNS aktiviert werden. Global für alle Benutzer in /etc/ssh/ssh_config:

VerifyHostKeyDNS yes

Oder nur für die aktuelle Sitzung:

ssh -o "VerifyHostKeyDNS=yes" server.example.de

SSHFP-Records erzeugen

Am einfachsten direkt auf dem Server mit ssh-keygen, das erzeugt die fertigen DNS-Records für alle vorhandenen Host Keys:

ssh-keygen -r server.example.de.

Ausgabe (Beispiel mit RSA, ECDSA und Ed25519):

server.example.de. IN SSHFP 1 1 47890eecc9a2893061734b07b8f60caa1a856148
server.example.de. IN SSHFP 1 2 b2518ad49cc2adf517d3f6a9faaf4017abc2c3e3...
server.example.de. IN SSHFP 3 1 3dd9de0dcf1523341b45a53f1d57043609e26c62
server.example.de. IN SSHFP 3 2 e1c76bd66b5a0641789b0b37be5b80ae3f6395c1...
server.example.de. IN SSHFP 4 1 a1b2c3d4e5f6...
server.example.de. IN SSHFP 4 2 d4e5f6a7b8c9...

Aufbau des SSHFP-Records

Ein SSHFP-Record besteht aus zwei Zahlen und dem Fingerprint:

hostname IN SSHFP [Algorithmus] [Hash-Typ] [Fingerprint]

Algorithmus:

  • 1, RSA
  • 3, ECDSA
  • 4, Ed25519 (empfohlen, ab OpenSSH 6.7)

DSS (2) ist seit OpenSSH 7.0 standardmäßig deaktiviert und sollte nicht mehr verwendet werden.

Hash-Typ: 1 = SHA-1, 2 = SHA-256. Beide sollten veröffentlicht werden, ältere Clients verstehen nur SHA-1, neuere bevorzugen SHA-256.

Prüfen

Mit dig lässt sich prüfen, ob die Records im DNS angekommen sind:

dig +short server.example.de SSHFP
1 1 47890EECC9A2893061734B07B8F60CAA1A856148
1 2 B2518AD49CC2ADF517D3F6A9FAAF4017ABC2C3E3...
3 1 3DD9DE0DCF1523341B45A53F1D57043609E26C62
4 2 D4E5F6A7B8C9...

Wichtig: Bei der DNSSEC-validierten Abfrage muss das ad-Flag (Authenticated Data) gesetzt sein, sonst ist die Antwort nicht vertrauenswürdig:

dig +dnssec server.example.de SSHFP | grep flags
;; flags: qr rd ra ad; QUERY: 1, ANSWER: 6, AUTHORITY: 0, ADDITIONAL: 1

Verbindungsaufbau mit SSHFP

Ohne SSHFP-Records im DNS meldet OpenSSH:

DNS lookup error: data does not exist
No matching host key fingerprint found in DNS.
Are you sure you want to continue connecting (yes/no)?

Mit SSHFP-Records und DNSSEC:

debug1: found 4 secure fingerprints in DNS
debug1: matching host key fingerprint found in DNS

secure bedeutet: Die DNS-Antwort wurde per DNSSEC validiert. Ohne DNSSEC steht dort insecure, der Fingerprint wurde zwar gefunden, aber der DNS-Antwort selbst kann nicht vertraut werden. Für echte Sicherheit braucht man beides: SSHFP-Records und DNSSEC.

Strenge Prüfung erzwingen

Optional: OpenSSH anweisen, die Verbindung nur aufzubauen, wenn der Host Key erfolgreich validiert wurde:

Host *
    VerifyHostKeyDNS yes
    StrictHostKeyChecking yes

Damit wird die Verbindung abgelehnt, wenn kein passender SSHFP-Record gefunden wird oder die DNSSEC-Validierung fehlschlägt. Das ist die sicherste Einstellung, setzt aber voraus, dass alle Zielserver SSHFP-Records haben.

Kleiner Aufwand, viel mehr Sicherheit. Fragen? Einfach melden.

DNS konfigurieren um die XMPP Information zu verteilen

Warum vergessen nur immer alle die DNS Informationen zu ihrem neuen Jabber-Server zu setzten? Ich bin heute sicher zum 12 mal nach einem Problem gefragt worden welches damit zusammen hing. Die Info fehlt aber auch in _fast_ jedem Howto. Kopieren denn wirklich alle nur noch Zeile für Zeile? Als Wikipedia mal einen Tag ausgesetzt hat, konnten tausende keine Hausaufgaben abgeben. Irgendwie habe ich dass Gefühl, wenn Google mal einen Tag aussetzten würde könnten tausende „Admins“ nichts installieren oder Probleme lösen ;-P

Also um es noch mal in Google zu werfen:

Damit die Kommunikation zwischen den Jabber-Server sauber läuft müssen die nötigen DNS Records vorhanden sein. Für meinen Bind schaut es so aus wie im folgenden Beispiel:

_jabber._tcp.jabber.kernel-error.de.       IN SRV   0 0 5269   jabber.kernel-error.de.
_xmpp-server._tcp.jabber.kernel-error.de.  IN SRV   0 0 5269   jabber.kernel-error.de.
_xmpp-client._tcp.jabber.kernel-error.de.  IN SRV   0 0 5222   jabber.kernel-error.de.

Testen lässt sich dieses am Ende natürlich mit dig:

$ dig SRV _xmpp-server._tcp.jabber.kernel-error.de +short
0 0 5269 jabber.kernel-error.de.

$ dig SRV _xmpp-client._tcp.jabber.kernel-error.de +short
0 0 5222 jabber.kernel-error.de.

Fragen? Einfach melden.

Ejabberd Dualstack IPv4 und IPv6

Wie so oft führen viele Wege nach Rom. Damit Ejabberd auf der IPv4 und den IPv6 Adressen gleichzeitig lauscht hat sich für mich folgender als gut erwiesen:

In der Konfigurationsdatei: /etc/ejabberd/ejabberd.cfg

Im Abschnitt Listening Ports einfach in die Portkonfiguration inet4 sowie inet6 aufnehmen:

{5222, ejabberd_c2s, [
                        inet4,
                        inet6,
                        {access, c2s},
                        {shaper, c2s_shaper},
                        {max_stanza_size, 65536},
                        %%zlib,
                        starttls, {certfile, "/etc/ejabberd/ejabberd.pem"}
                       ]},

Schon arbeitet Ejabberd mit beiden:

# netstat -an|grep 5222
tcp6       0      0 :::5222                 :::*                    LISTEN     
tcp6       0      0 *:5222                 *:*                    LISTEN    


Ach ja, Ejabberd Version ist gerade: 2.1.5

Fragen? Einfach melden.

IPv6: Adressarchitektur, Autokonfiguration und radvd unter Linux

Meine IPv6-Reise begann 2003. Damals kam IPv6 vom eigenen ISP nicht in Frage, also ging es über einen Tunnelbroker. SixXS stellte kostenlos IPv6-Tunnel bereit und vergab auf Antrag sogar ein komplettes /48 Netz. SixXS wurde 2017 eingestellt, aber die Grundlagen von IPv6 haben sich nicht geändert. Heute liefern die meisten ISPs IPv6 nativ aus.

Adressformat

IPv6-Adressen sind 128 Bit lang. Das sind 2128 mögliche Adressen, ausgeschrieben: 340.282.366.920.938.463.463.374.607.431.768.211.456. Geschrieben werden sie hexadezimal, jeweils zwei Bytes durch Doppelpunkt getrennt:

2a01:0198:0200:0945:0000:0000:0000:0002

Führende Nullen darf man weglassen. Ein zusammenhängender Block aus Nullen kann einmal durch :: ersetzt werden:

# Führende Nullen weg
2a01:198:200:945:0:0:0:2

# Ein Nullblock durch :: ersetzt
2a01:198:200:945::2

# Als Netz
2a01:198:200:945::/64

Wichtige Adressen

::1 ist der Localhost. fe80::/10 sind Link-Local-Adressen, die jedes Interface automatisch bekommt. ff02::1 erreicht alle Hosts im lokalen Netz, ff02::2 alle Router. 2001:db8::/32 ist für Dokumentation reserviert.

# Alle Hosts im lokalen Netz anpingen
ping6 -I eth0 ff02::1

# Alle Router im lokalen Netz anpingen
ping6 -I eth0 ff02::2

Adressbildung und EUI-64

Link-Local-Adressen bildet der Host selbst aus dem Prefix fe80 und der MAC-Adresse im EUI-64 Format. Die MAC-Adresse hat 48 Bit, EUI-64 erweitert sie auf 64 Bit. Zusammen mit dem 64-Bit-Prefix ergibt das die vollen 128 Bit. IPv6 ist damit bereits auf 64-Bit-MAC-Adressen vorbereitet, falls die 48-Bit-Adressen irgendwann knapp werden. Duplicate Address Detection (DAD) stellt sicher, dass keine Adresse doppelt vergeben wird.

Autokonfiguration mit radvd

ARP wurde durch Neighbor Discovery (ND) ersetzt. IPv6 ist auf Autokonfiguration ausgelegt. Ein Router Advertisement Daemon (radvd) teilt allen Hosts im Netz das IPv6-Prefix mit. Die Hosts bilden sich ihre Adresse selbst. Kein DHCP nötig für die Grundkonfiguration.

Forwarding aktivieren und radvd konfigurieren:

echo 1 > /proc/sys/net/ipv6/conf/default/forwarding
# /etc/radvd.conf
interface eth0
{
    AdvSendAdvert on;
    AdvLinkMTU 1280;
    MaxRtrAdvInterval 300;
    prefix 2a01:198:200:945::/64
    {
        AdvOnLink on;
        AdvAutonomous on;
    };
};

Nach dem Start von radvd holen sich alle Hosts im Netz automatisch eine Adresse aus dem Prefix. Prüfen mit:

ip addr show eth0

Kein NAT mehr

Mit IPv6 ist NAT nicht mehr nötig. Jedes Gerät bekommt eine eigene öffentliche Adresse. Das bedeutet aber auch: Jedes Gerät ist direkt aus dem Internet erreichbar. Eine Firewall ist Pflicht. IPv6 hat einen eigenen Paketfilter, ip6tables statt iptables. Wer iptables kennt, kann auch ip6tables.

Über die Probleme die durch fehlende IPv6-Unterstützung bei Diensteanbietern entstehen habe ich separat geschrieben.

Hurricane Electric IPv6 Zertifizierung

Hurricane Electric bietet eine kostenlose IPv6-Zertifizierung an. Man arbeitet sich durch verschiedene Levels, vom ersten Tunnel bis zum voll IPv6-fähigen Mailserver. Am Ende gibt es ein T-Shirt.

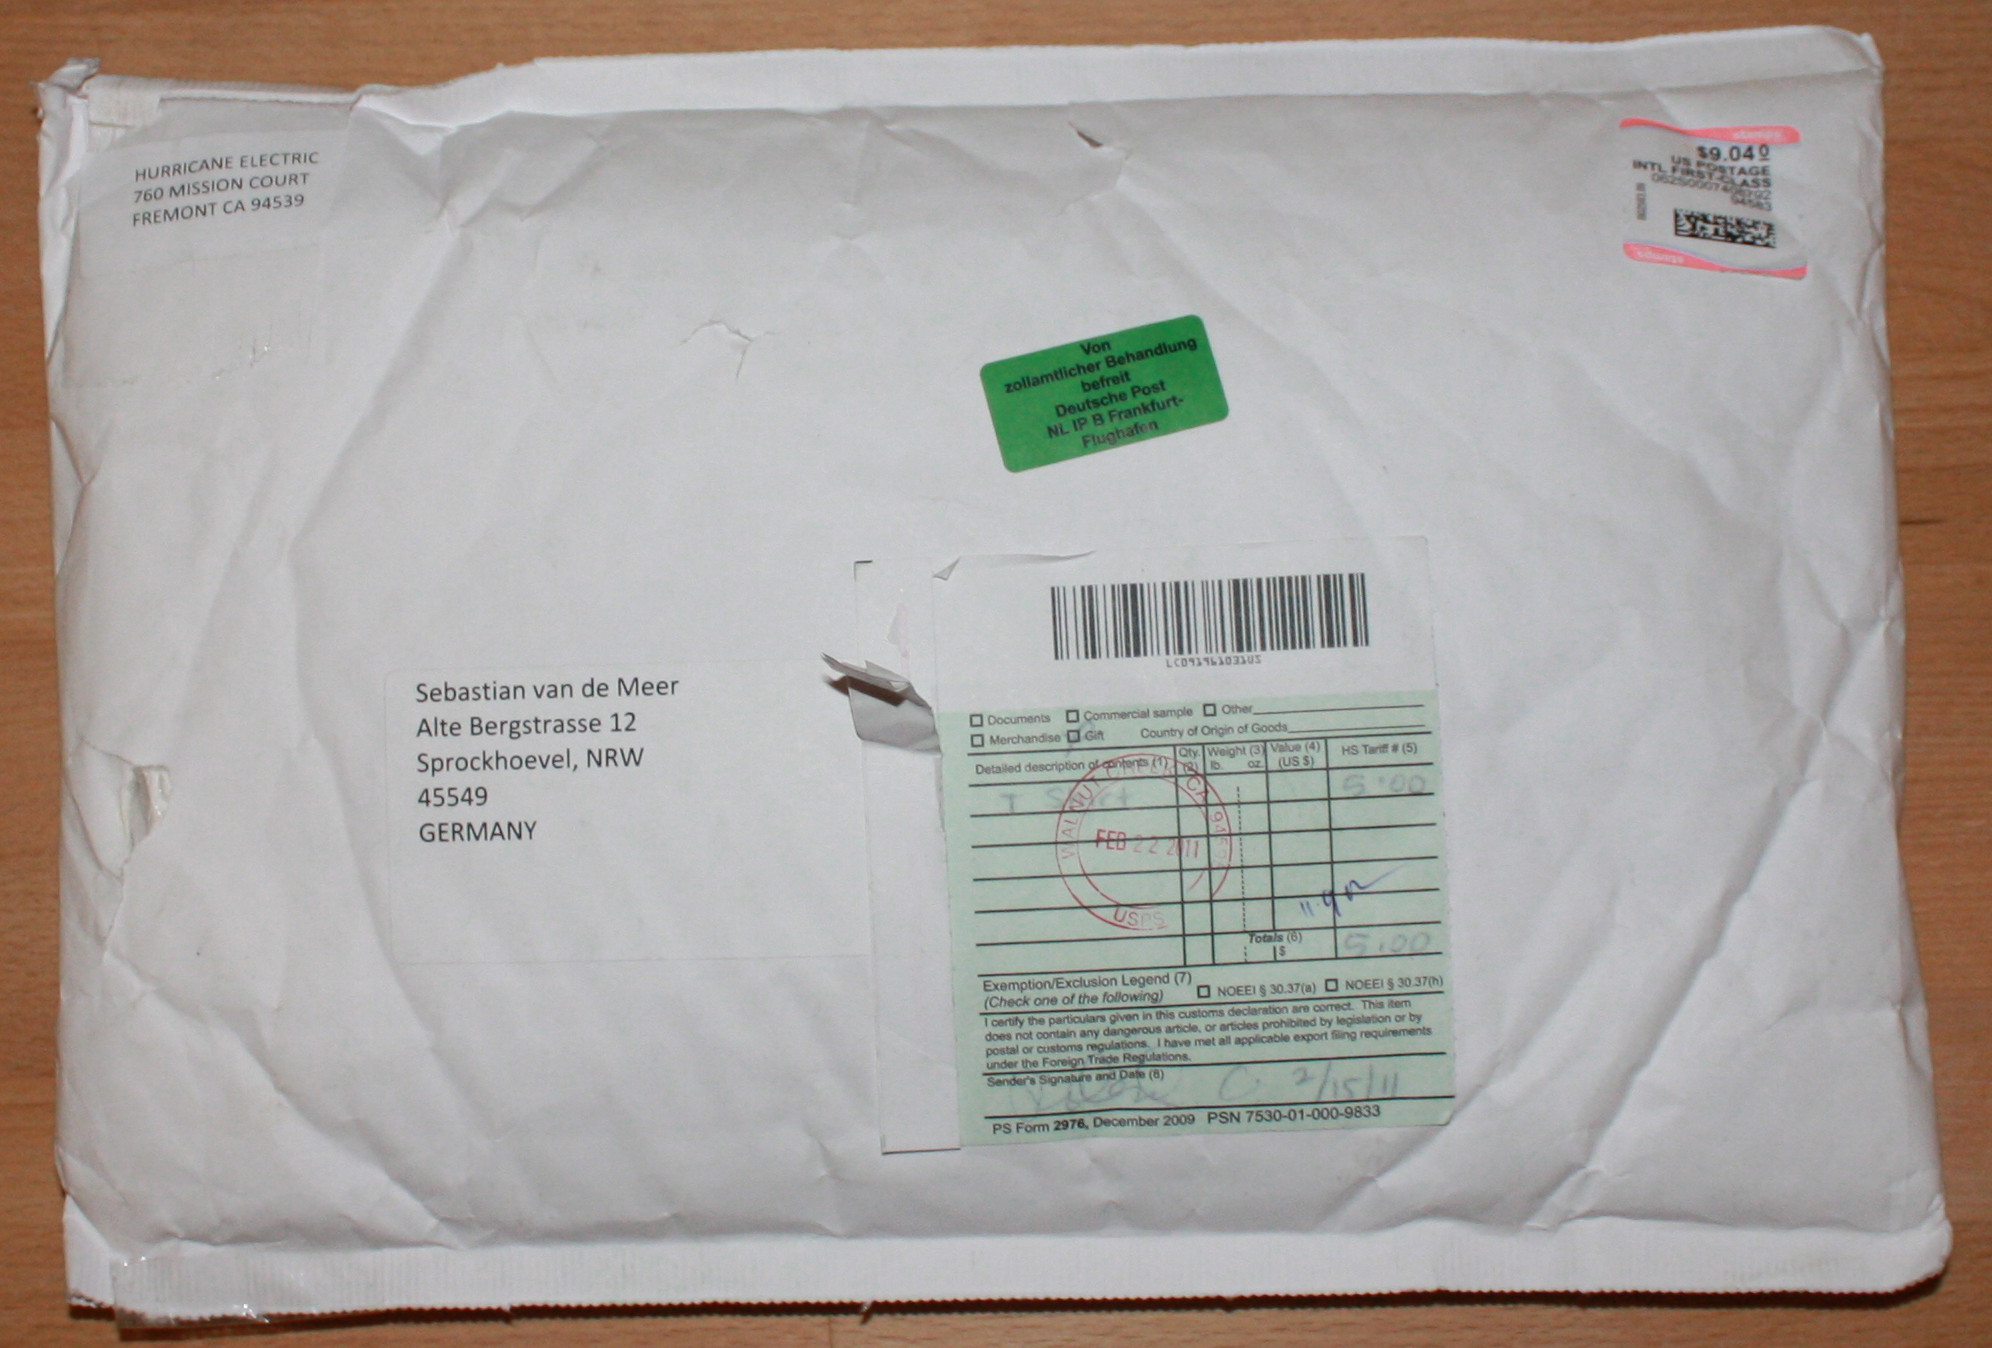
Hurricane Electric T-Shirt Sendung
Umschlag aus den USA
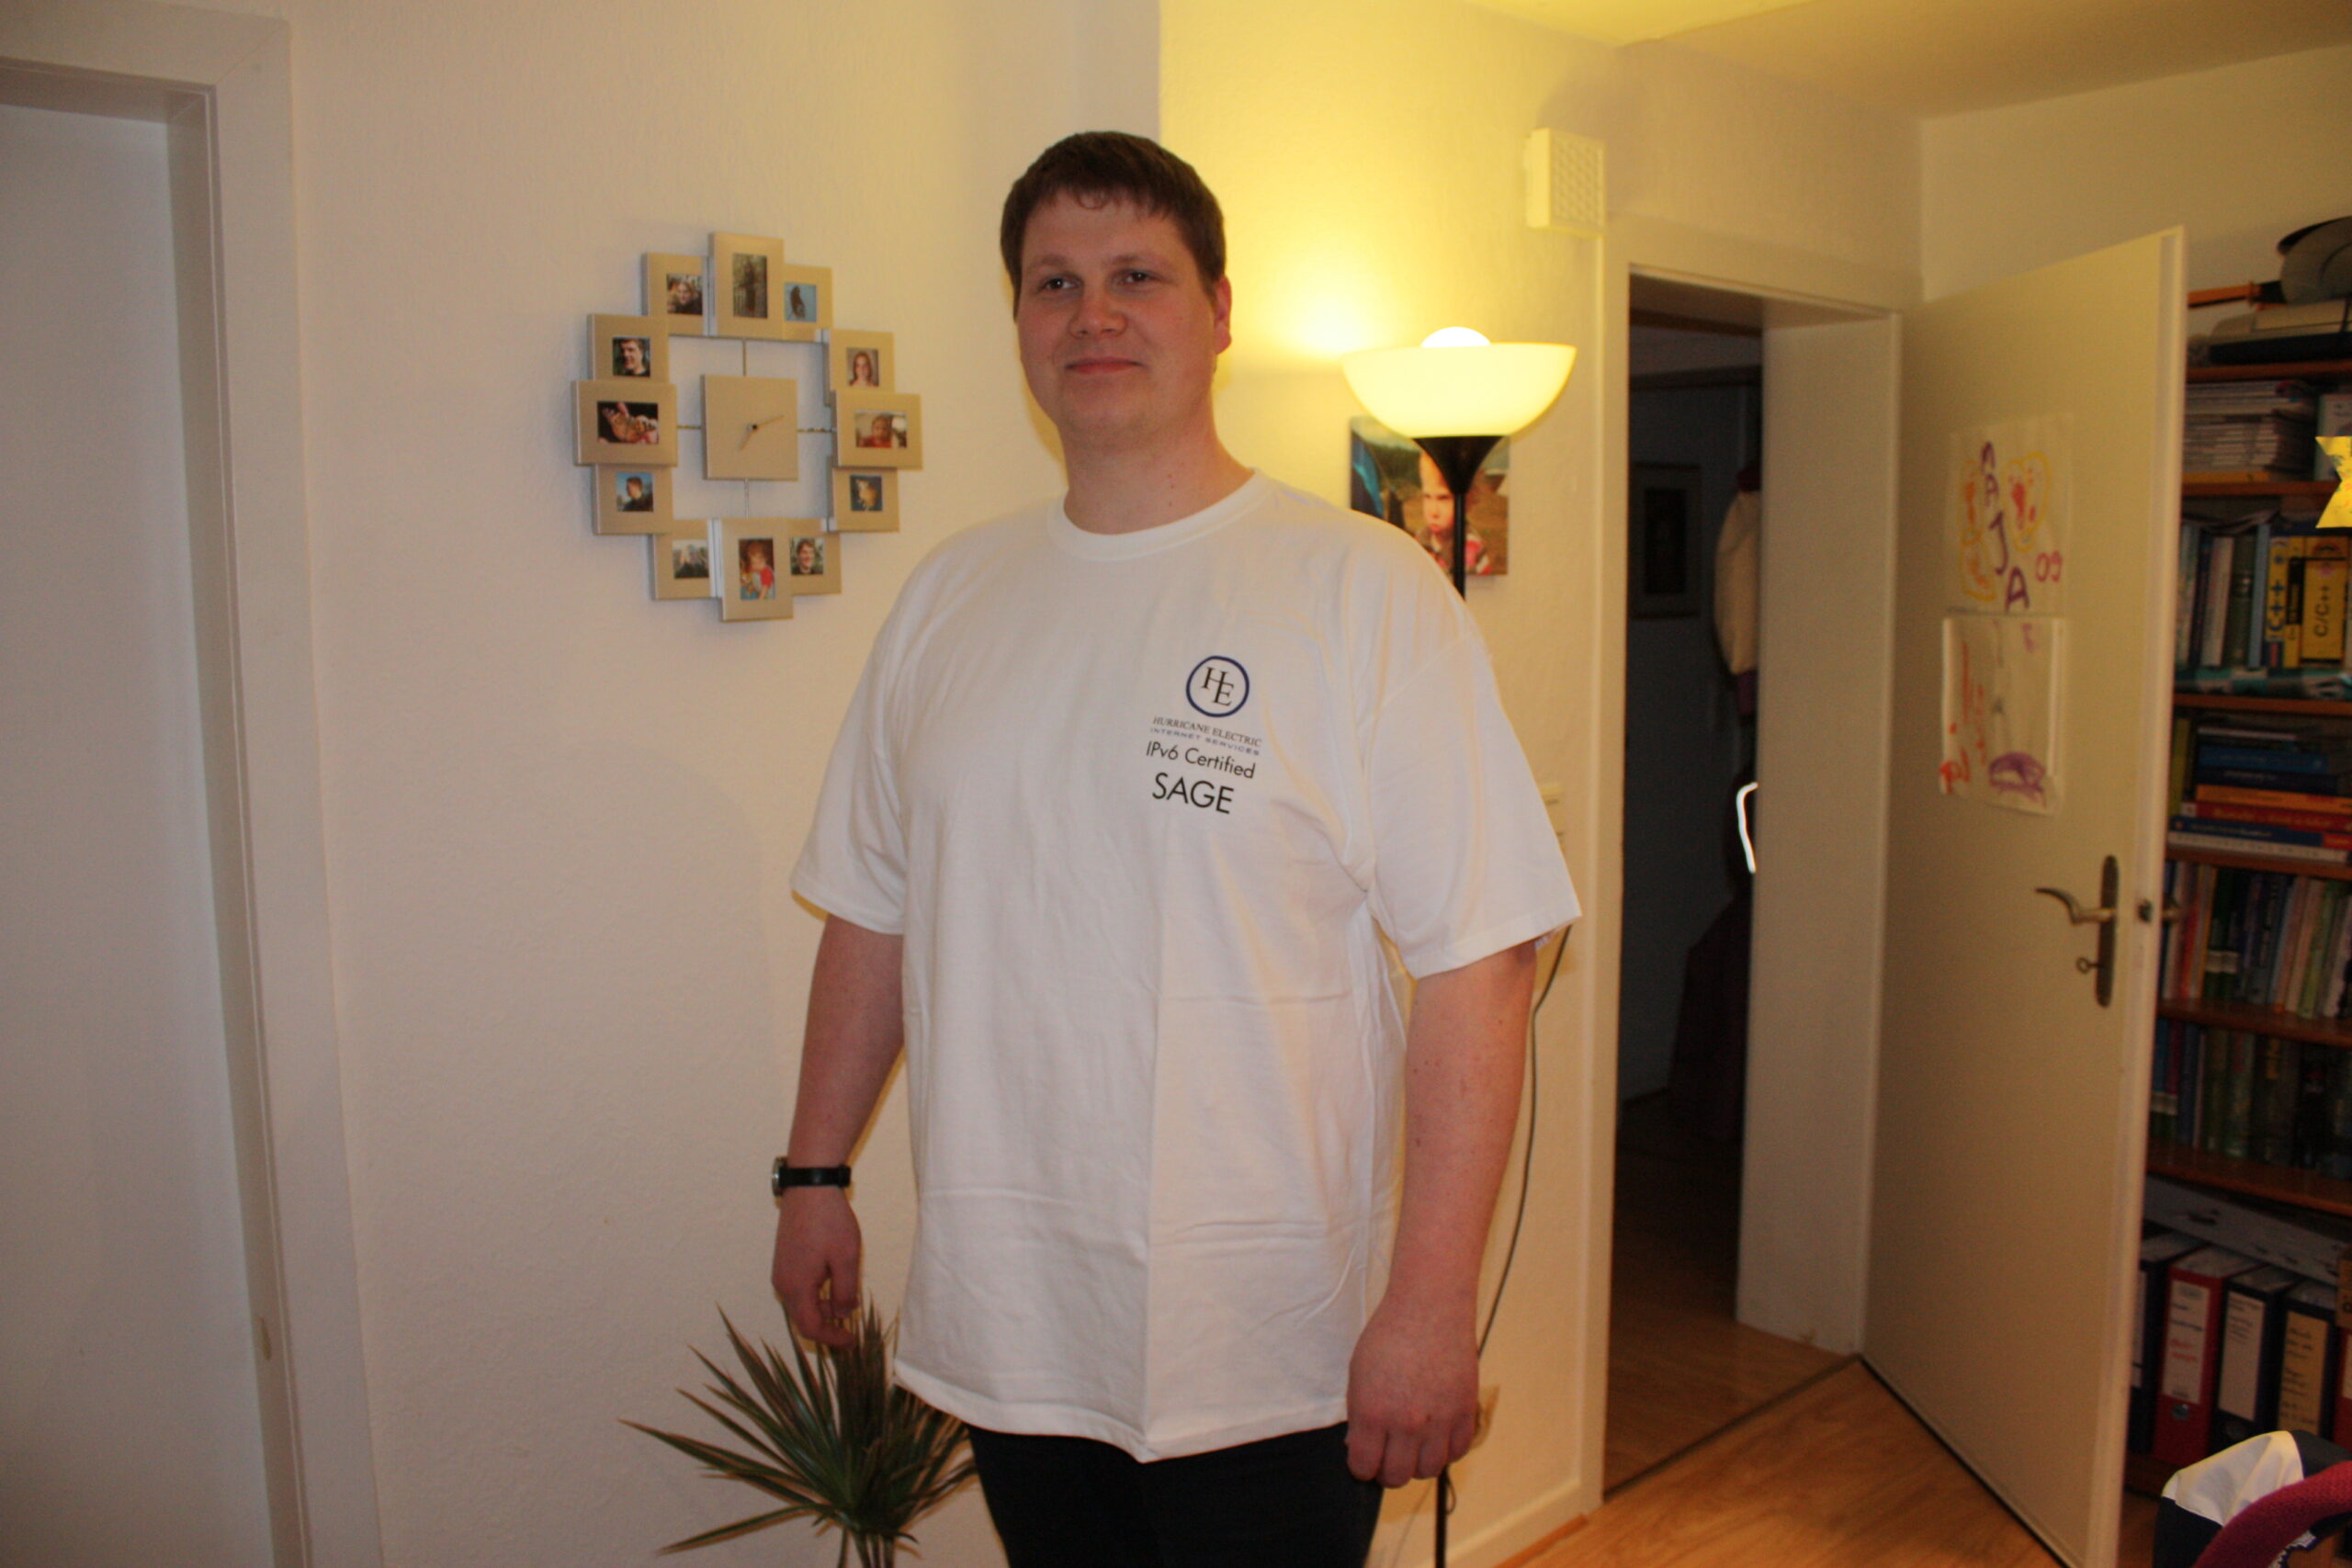
Hurricane Electric T-Shirt vorne
T-Shirt vorne
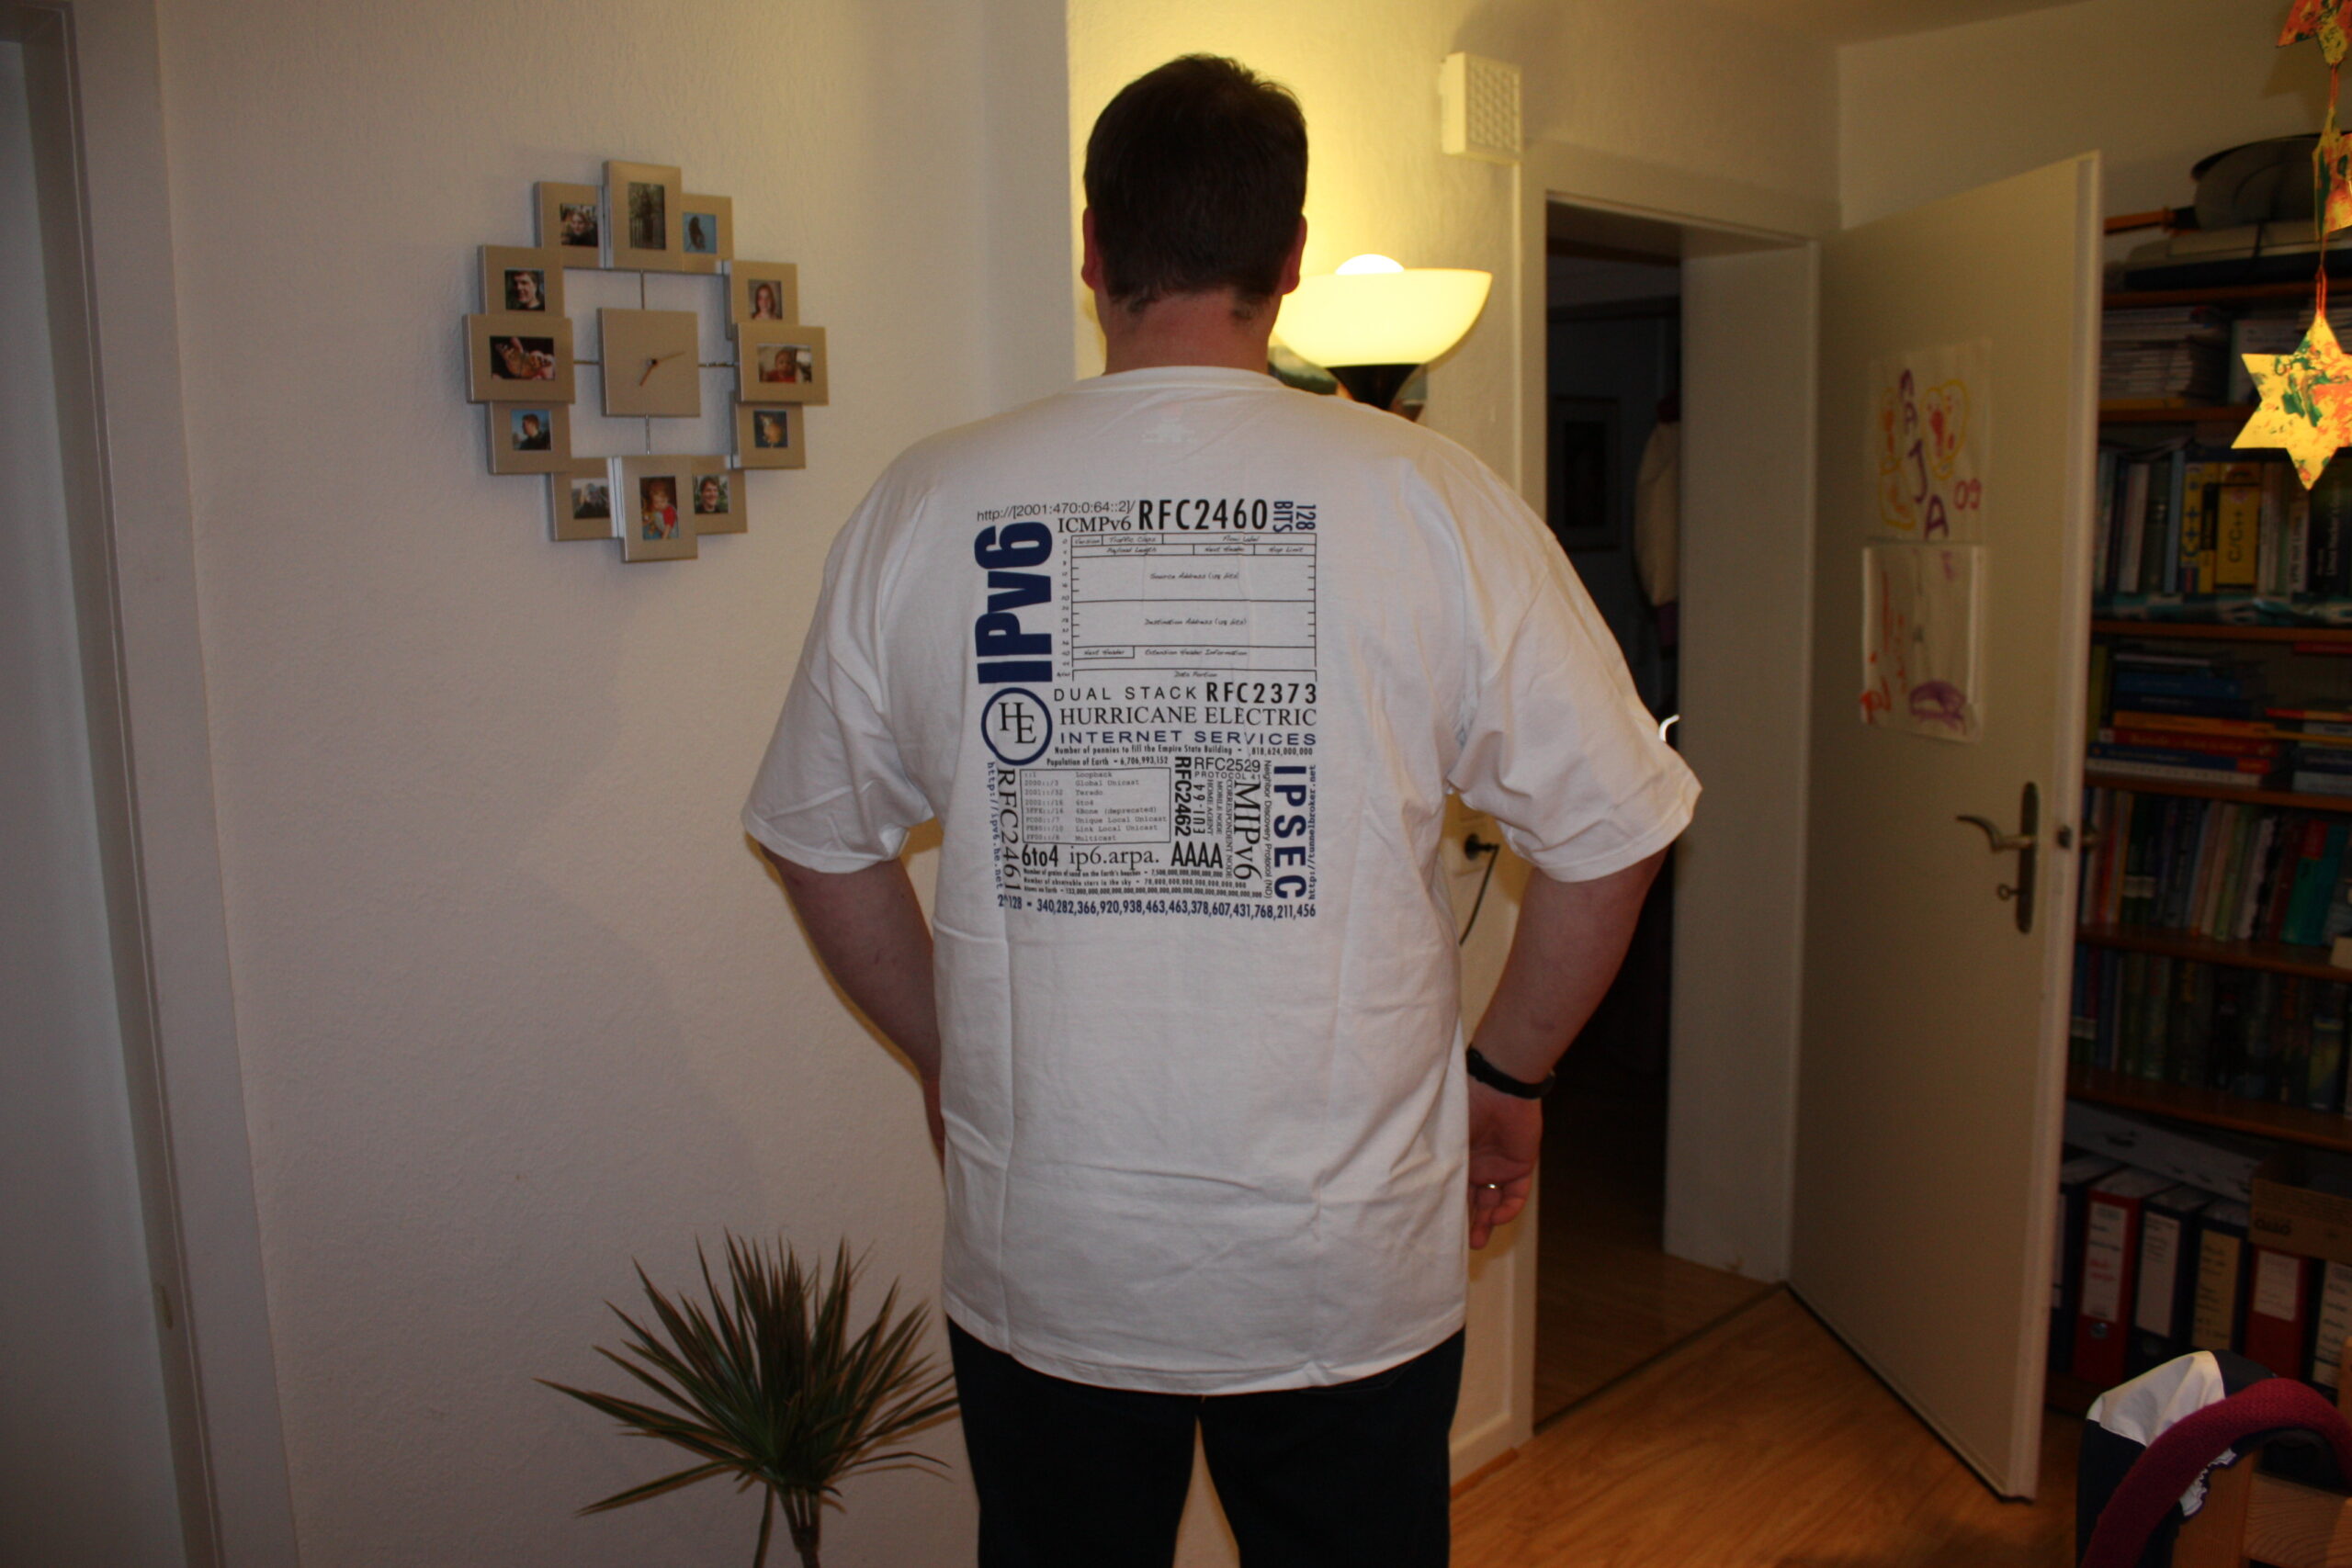
Hurricane Electric T-Shirt hinten
T-Shirt hinten

Fragen? Einfach melden.

Neuere Beiträge »

© 2026 -=Kernel-Error=- — RSS

Theme von Anders Norén — Hoch ↑