In Teil 6 der MeshCore-Serie, der noch erscheint, beschreibe ich das Rezept der Community, mit dem ein Repeater im Rheinland sauber ins Netz passt: Preset, Region-Scopes, Pfad-Hash, Duty Cycle. Damit läuft ein Repeater. Mein Repeater auf dem Dach, „DE-NW-SU-Todenfeld-KE“ mit dem Hop-Präfix 1863, lief damit auch. Nur hat er dabei mehr gesendet, als mir lieb war, und ein guter Teil davon war Verkehr, den eigendlich niemand braucht.
Also habe ich mich hingesetzt und jede Einstellung angeschaut, die ein Repeater-Betreiber überhaupt anfassen kann. Pro Einstellung wollte ich wissen, wofür sie da ist, was sie bei mir bringt und was sie kaputt machen kann. Daraus ist wieder eine kleine Serie geworden, diesmal mit drei Teilen. Dieser erste Teil geht durch die Konfiguration: Coding Rate, Timing, einen Community-Fork der Firmware, Kanalfilter und Sendeleistung, und am Ende steht, was es gemessen gebracht hat. Teil 2 kümmert sich ausschließlich um CAD, denn das war eine eigene Geschichte. In Teil 3 wird es um eigene Firmware-Builds gehen, der ist noch nicht fertig.
Die Grundlagen erkläre ich hier nicht noch einmal. LoRa, Airtime, Flood und Direct stehen in Teil 1, der Repeater selbst in Teil 3, Antennen und ERP in Teil 4.
Der Ausgangspunkt
Am Anfang lief auf 1863 die unveränderte MeshCore-Firmware v1.18.0 mit dem Rezept von Mesh Rheinland, also CR 4/8 und txdelay 0.5. Die Frage war erst einmal ganz einfach: Was sendet mein Repeater da eigentlich den ganzen Tag?
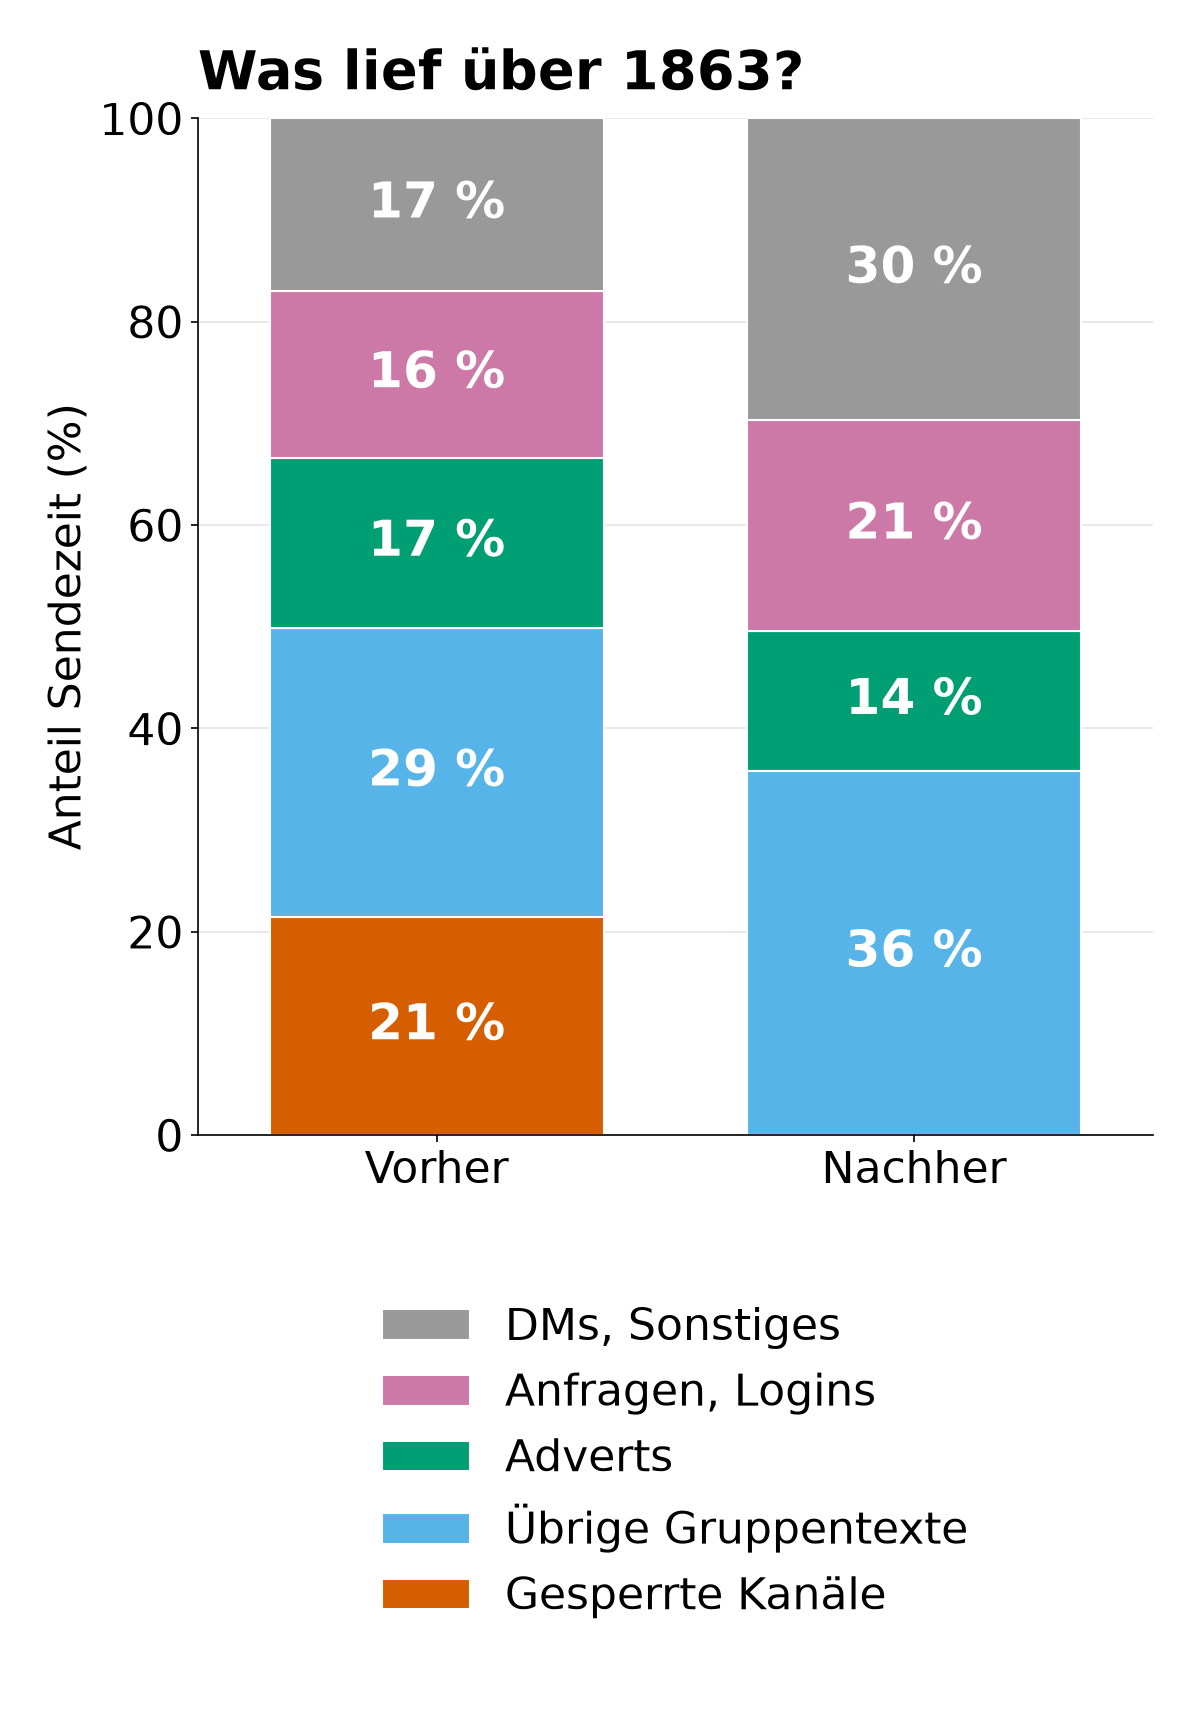
Die Antwort kommt aus zwei Quellen. Ein Raspberry Pi am Repeater liest jede Minute die Statistiken aus, daraus ergeben sich Sendezeit pro Stunde, Millisekunden pro Paket und Weiterleitungen. Und CoreScope, der Community-Analyzer, zeigt, welche Pakete Observer mit 1863 im Pfad gesehen haben. Daraus habe ich geschätzt, dass die drei Kanäle #test, #ping und #bot rund 19 bis 26 % der Sendezeit ausmachten, die über meinen Repeater lief. Das ist eine Schätzung aus dem, was die Observer gesehen haben, und Beobachtungslücken oder mehrdeutige Hashes können sie in beide Richtungen verschieben. Inhaltlich sind das Testnachrichten, Erreichbarkeitsprüfungen und Bots, die in vielen Fällen automatisch senden. Bis zu ein Viertel meiner Airtime für Verkehr, der keine Nachricht von Mensch zu Mensch ist, fand ich zu viel.
Ein Tipp vorweg, falls du Änderungen gegen CoreScope oder einen anderen öffentlichen Analyzer auswerten willst: Archivier die Daten selbst. CoreScope hält Pakete nur knapp zwei Tage vor. Ich ziehe jede Nacht den Vortag mit allen Beobachtungen auf mein NAS, sonst hätte ich für die Vorher-Nachher-Vergleiche schlicht keine Daten mehr gehabt. Welche Statistik welche Frage beantwortet, habe ich im Anhang als Tabelle zusammengefasst.
Funk: CR 4/5 statt 4/8 und ein längeres txdelay
Der größte einzelne Hebel brauchte überhaupt keine neue Firmware. Die Coding Rate legt fest, wie viel Fehlerkorrektur in jedem Paket steckt. Mit CR 4/8 kommen auf vier Nutzbits acht gesendete, mit CR 4/5 nur fünf. Ein Paket wird dadurch spürbar kürzer. Seitdem ich das umgestellt habe, sendet 1863 mit CR 4/5:
set radio 869.618,62.5,8,5
Die naheliegende Sorge war: Hört mich dann noch jemand? Ja. Die Coding Rate steht im LoRa-Header, der Empfänger liest sie aus jedem Paket und dekodiert entsprechend. Frequenz, Bandbreite und Spreading Factor müssen im ganzen Mesh gleich sein, die Coding Rate nicht. Umgekehrt ändert meine CR auch nichts daran, was ich selbst empfangen kann. Der Preis ist weniger Fehlerkorrektur auf meinen Sendungen. Wer am Rand der Reichweite liegt, verliert mit CR 4/5 eher ein Paket als mit 4/8. Deshalb ist das eine Abweichung vom Rezept, die man in der Community ankündigen sollte, und das habe ich auch getan.
Gleichzeitig habe ich txdelay von 0,5 auf 1 gesetzt. Der Wert ist ein Faktor, keine Zeit. Vor jeder Flood-Weiterleitung wartet der Repeater eine zufällige Zeit zwischen null und fünfmal der eigenen Paketdauer mal txdelay. Ein längeres Fenster streut die Weiterleitungen mehrerer Repeater weiter auseinander. Bei einem 100-Byte-Paket kostet das nach meiner Rechnung im Mittel etwa eine halbe Sekunde mehr pro Hop. Gemessen habe ich das nicht getrennt. direct.txdelay bleibt bei 0,3, rxdelay bei 0.
Zu rxdelay gibt es übrigens eine Tabelle aus einer anderen regionalen Community, die je nach Zahl der Nachbarn feste Werte empfiehlt. Nach der Zahl meiner Nachbarn wäre 1863 dort in der Klasse „Regional“ gelandet, mit rxdelay 8. Ich habe mir im Quellcode angesehen, was rxdelay bei MeshCore wirklich macht. Es ist keine zufällige Wartezeit, sondern eine feste Verzögerung, die von SNR und Paketlänge abhängt. Starke Pakete werden sofort verarbeitet, schwache und lange warten. Getroffen hätte das genau die schwachen Pakete aus großer Entfernung, für die ein hoher Repeater da ist, und zwar mit 1,5 bis 5 Sekunden pro Hop. Ein schon eingeplantes Weiterleiten eines anderen Repeaters bricht es auch nicht ab. Für 1863 habe ich es deshalb gelassen. Auf einem Nachbar-Repeater wäre rxdelay 8 mit meinen Werten verträglich, würde dort aber ebenso die schwachen und langen Pakete verzögern.
Der Community-Fork
Mit CR 4/5 war die Sendezeit pro Paket kleiner, an der Menge änderte sich aber nichts. Die unveränderte Firmware v1.18.0 kann Floods nur global begrenzen, über flood.max, flood.max.advert und die Region-Scopes. Einzelne Kanäle aussortieren oder wiederholte Adverts verwerfen kann sie nicht. Genau das wollte ich.
Aus der Community kam der Tipp auf den Fork m0urs/MeshCore, Releases mit dem Kürzel „mups“. Andere Betreiber in der Gegend nutzen ihn nach eigener Aussage schon, mit ähnlichen Kanalfiltern. Der Fork bringt drei Dinge mit:
- einen Paketfilter, der Gruppentexte einzelner Kanäle verwirft, Hop-Limits pro Pakettyp setzt und wiederholte Flood-Adverts desselben Absenders in einem Zeitfenster ausfiltert
- Diagnose, die mir in der Standard-Firmware fehlte:
get rx.errorsmit Histogrammen nach SNR, RSSI und Länge,get cadmit Zählern für „Kanal belegt“ und „nach 4 Sekunden trotzdem gesendet“ undfilter statsmit der eingesparten Sendezeit - ein Wiederholen von Direct-Paketen pro Hop, das aus dem noch offenen Upstream-PR #2670 stammt
Das Letzte war für mich kein Grund. Direct-Verkehr ist bei 1863 nur ein kleiner Teil der Weiterleitungen. Die Gründe waren der Filter und die Diagnose.
Ein Fork hat aber auch Nachteile, und die sollte man vorher kennen. Es ist ein Community-Fork, nicht die offizielle Firmware. Er enthält Pull Requests, die upstream noch nicht gemergt sind. Jede neue MeshCore-Version muss erst in den Fork übernommen werden. Nicht jedes Board hat einen Build, für den RAK_3112 gab es im Release keinen. Die Standardwerte unterscheiden sich teilweise von MeshCore. Und mit dem enthaltenen PR #1349 lässt sich die Uhr per CLI auch rückwärts stellen. Für mich hat für den Fork gesprochen, wie der Maintainer arbeitet: Zwei kleine Korrekturen von mir hat er noch am selben Tag geprüft und übernommen, sie sind seit dem Release mups18-3 drin. Eine Garantie für die Zukunft ist das natürlich nicht.
Gemessen habe ich nach dem Wechsel mit mups18-2. Wenn du den Fork heute einsetzt nimm das aktuelle Release mups18-3. Dort gibt es auch einen Build für den Heltec V4 als Repeater.
Das Update selbst lief wie in Teil 3 beschrieben: Konfiguration ausgelesen und gesichert, komplettes 16-MB-Flash-Backup, dann nur das App-Image ab Adresse 0x10000 geflasht. Die Partitionstabelle war bei beiden Firmwares gleich, das solltest du vor einem reinen App-Flash immer prüfen. Für den Rückweg hatte ich drei Stufen: filter off schaltet die Filter sofort ab, das gesicherte App-Image der Standard-Firmware bringt mich zurück auf v1.18.0, und das Flash-Backup stellt im Notfall alles wieder her. Die Einstellungen übernimmt der Fork aus der vorhandenen /prefs.json. Und hier liegt die Falle: Für Einstellungen, die die alte Firmware nie geschrieben hat, nimmt der Fork seinen eigenen Standardwert. Nach dem Update war bei mir der RX-Stromsparmodus radio.rxps an. Für einen Repeater am Netzteil will ich das nicht.
get radio.rxps
set radio.rxps off
Nach jedem Update und jedem Neustart prüfe ich get radio.rxps seitdem von Hand.
Dazu kommt eine Sache, die ich erst später gefunden habe. Mit radio.rxps off und dem LNA des Heltec V4 kann die Schätzung des Rauschbodens in dieser Firmware stundenlang bei -120 dBm hängen bleiben, und beobachtet habe ich das auch schon auf der Standard-Firmware. Ich habe das als Issue #27 beim Fork gemeldet. Der Rauschboden fließt in die Prüfung ein, ob der Kanal frei ist. Alle Messungen in diesem Beitrag liefen mit dieser Schätzung, und ich kann nicht ausschließen, dass sie einige RX- und Weiterleitungszahlen beeinflusst hat, und zwar vorher wie nachher, denn schon vor dem Wechsel auf den Fork hing der Wert bei -120 dBm. In welche Richtung und wie stark, weiß ich nicht. Die Details folgen in Teil 3.
Die Filter
Der Filter im Fork arbeitet nur auf Flood-Paketen. Direct-Pakete lässt er immer durch, das steht so im Code. Ein Login auf einen entfernten Repeater über einen bekannten Pfad ist also nie betroffen. Auch eine Sache vorweg: Ein Filter wirkt nur auf das, was mein Repeater weiterleitet. Die Nachbarn tragen dieselben Pakete weiter, solange sie nicht selbst filtern.
Kanäle. Gesperrt sind auf 1863 #test, #ping, #bot und #wardriving. Der Filter erkennt einen Kanal am Hash-Byte plus MAC, trifft also genau diesen Kanal und nur Gruppentexte. #test war mit Abstand der größte Brocken. #wardriving ist eine Entscheidung von mir, die etwas kostet. MeshMapper, das ich in Teil 5 vorstelle, wertet Echos auf #wardriving aus. Rund um 1863 sieht die Abdeckung dort jetzt schlechter aus, als sie ist. Ich nehme das in Kauf. Gesetzt habe ich die Kanalfilter übrigens, bevor die Nachbar-Betreiber zugestimmt hatten. Ein Beschluss der Community ist das also nicht.
Hop-Limits pro Pakettyp. Hier habe ich zweimal an einem Tag korrigiert, und die Geschichte ist lehrreich. Das Limit verwirft ein Flood-Paket, wenn es schon so viele Hops oder mehr hinter sich hat. Für Anfragen, Antworten und anonyme Anfragen (Typ 00, 01 und 07) bringt der Fork 5 als Standard mit. Das habe ich nach einem Hinweis eines Nachbar-Betreibers auch gelassen, weil es Sendezeit spart. Später kam der Hinweis eines anderen Betreibers, dass die Pfadsuche der App über große Entfernungen genau solche Pakete nutzt. Daraufhin habe ich das Limit auf 8 erhöht. Und dann habe ich die Frage endlich andersherum gestellt: Nicht „was spart das?“, sondern „was geht davon kaputt?“. Pfadsuche, Login, Status und Telemetrie zu entfernten Repeatern laufen als Flood, solange kein Pfad bekannt ist. Ein niedriges Limit schneidet genau diese Funktionen für alle weiter entfernten Knoten ab. Ein Limit von 5 spart hier je nach Tag etwa 7 bis 14 % der Sendezeit über meinen Repeater. Das ist nicht nichts, aber dafür funktionieren diese Dinge über größere Entfernungen nicht mehr. Seitdem steht das Limit für 00, 01 und 07 auf 32, für alles andere auf 64, was praktisch aus ist. Ehrlicherweise ist auch die 32 praktisch aus. Der Repeater prüft flood.max vor dem Paketfilter, und mups setzt flood.max bei neuen Installationen auf 15, dann greift eine 32 nie. Bei mir steht flood.max auf 63, trotzdem hat die 32 in rund zwei Tagen nur 4 Pakete verworfen. Die 5 im Fork ist also der Wert, der wirklich wirkt, und eine bewusste Entscheidung des Maintainers zugunsten der Nachrichten. Bei Adverts (Typ 04) hatte ich zwischendurch auch 5 gesetzt, das hat die Kontaktsuche im Umkreis beschnitten und ist ebenfalls wieder auf 64. Adverts deckelt ohnehin schon flood.max.advert 8 aus der Standard-Firmware. Meine Regel seitdem: Bevor du ein Hop-Limit für einen Pakettyp setzt, schreib dir auf, welche Funktion der App diesen Typ als Flood sendet.
Advert-Fenster. filter advert 24 verwirft ein Flood-Advert, wenn derselbe Absender in den letzten 24 Stunden schon eins geschickt hat, das mein Repeater weitergeleitet hat. Der Standard für Flood-Adverts eines Repeaters liegt bei 47 Stunden, seine regelmäßigen Flood-Adverts fallen also nie in das Fenster. Getroffen werden vor allem Repeater mit sehr kurzem Intervall. Ein Companion, der nach einer Namensänderung neu annonciert, wird dadurch verzögert. Das ist der Standardwert des Forks, und ich habe ihn behalten.
Was ich nicht genutzt habe. filter age 30 verwirft lesbare Gruppentexte, deren Zeitstempel mehr als 30 Minuten abweicht. In meiner Stichprobe auf Public hätte das keine einzige Nachricht betroffen. Eine Regel, die nichts trifft, brauche ich nicht. filter malformed, das Nachrichten auf Public auf fehlerhafte Inhalte prüft, und filter rate sind ebenfalls aus. Für beide hatte ich keinen Anlass. filter hash bleibt bei 1, ein strengerer Wert würde Companions mit Standardkonfiguration ausschließen.
Dazu kommen zwei Kleinigkeiten außerhalb des Filters. set flood.max 63, weil ein 64. Hop bei 1-Byte-Pfaden den 6-Bit-Zähler überlaufen lassen würde. Und set flood.max.unscoped 0, das macht die Community-Regel region denyf * noch einmal ausdrücklich. max.resend für das Direct-Wiederholen habe ich von 3 auf 2 gesenkt, weil Direct-Verkehr hier selten ist und lange Strecken ein Weiterleiten des nächsten Hops oft gar nicht mithören. Dann würde der Repeater unnötig wiederholen.
Sendeleistung
Mit dem Wechsel auf den Fork habe ich 1863 auch auf tx 20 gestellt. Beim Heltec V4 heißt dieser Wert nicht, dass 20 dBm an der Antenne ankommen. Er stellt die Ausgangsleistung des SX1262 ein, und dahinter sitzt noch ein externer Verstärker, der KCT8103L. Nach der Kennlinie, die das Meshtastic-Projekt für dieses Board veröffentlicht, liefert der bei tx 20 etwa 28 dBm am Ausgang. Nach dieser Kurve bringt alles über tx 16 nur noch wenig, weil der Verstärker in die Sättigung läuft. Gemessen habe ich das nicht.
Mit Kabel, SAW-Filter und der Antenne von Bingfu, laut Hersteller 5,8 dBi (die gibt es hier), schätze ich die abgestrahlte Leistung auf 25,5 bis 27 dBm ERP. Die Grenze im Teilband liegt bei 27 dBm. Die Dämpfung des SAW-Filters habe ich nicht gemessen, und wie viel Leistung er dauerhaft verträgt, weiß ich nicht. Das ist eine Schätzung auf dem Papier, und genau deshalb gehört sie gemessen. Wenn du einen Heltec V4 mit Außenantenne betreibst, rechne dein ERP aus, bevor du den Wert hochdrehst, und miss die Leistung am besten leitungsgebunden über ein Dämpfungsglied. Wie man das mit einfachen Mitteln angeht, steht in Teil 4. Das Board selbst gibt es im Zweierpack mit GPS.
Was es gebracht hat
Für den Vergleich habe ich zwei Dienstage im Abstand von einer Woche genommen: den ersten noch mit unveränderter Firmware v1.18.0, CR 4/8 und tx 16, den zweiten mit dem Fork, CR 4/5, den Filtern und tx 20. CAD war an beiden Tagen noch an, Board, Antenne, Kabel und SAW-Filter waren dieselben. Empfangen hat der Repeater an beiden Tagen fast gleich viel, am zweiten etwa 2 % mehr.
- Sendezeit im Tagesmittel: 5,64 % vorher, 2,98 % nachher
- Maximum im gleitenden Stundenfenster: 8,18 % vorher, 4,00 % nachher
- Sendezeit pro Paket: 924 ms vorher, 583 ms nachher, durch CR 4/5 und weil die Filter den Paketmix verändert haben
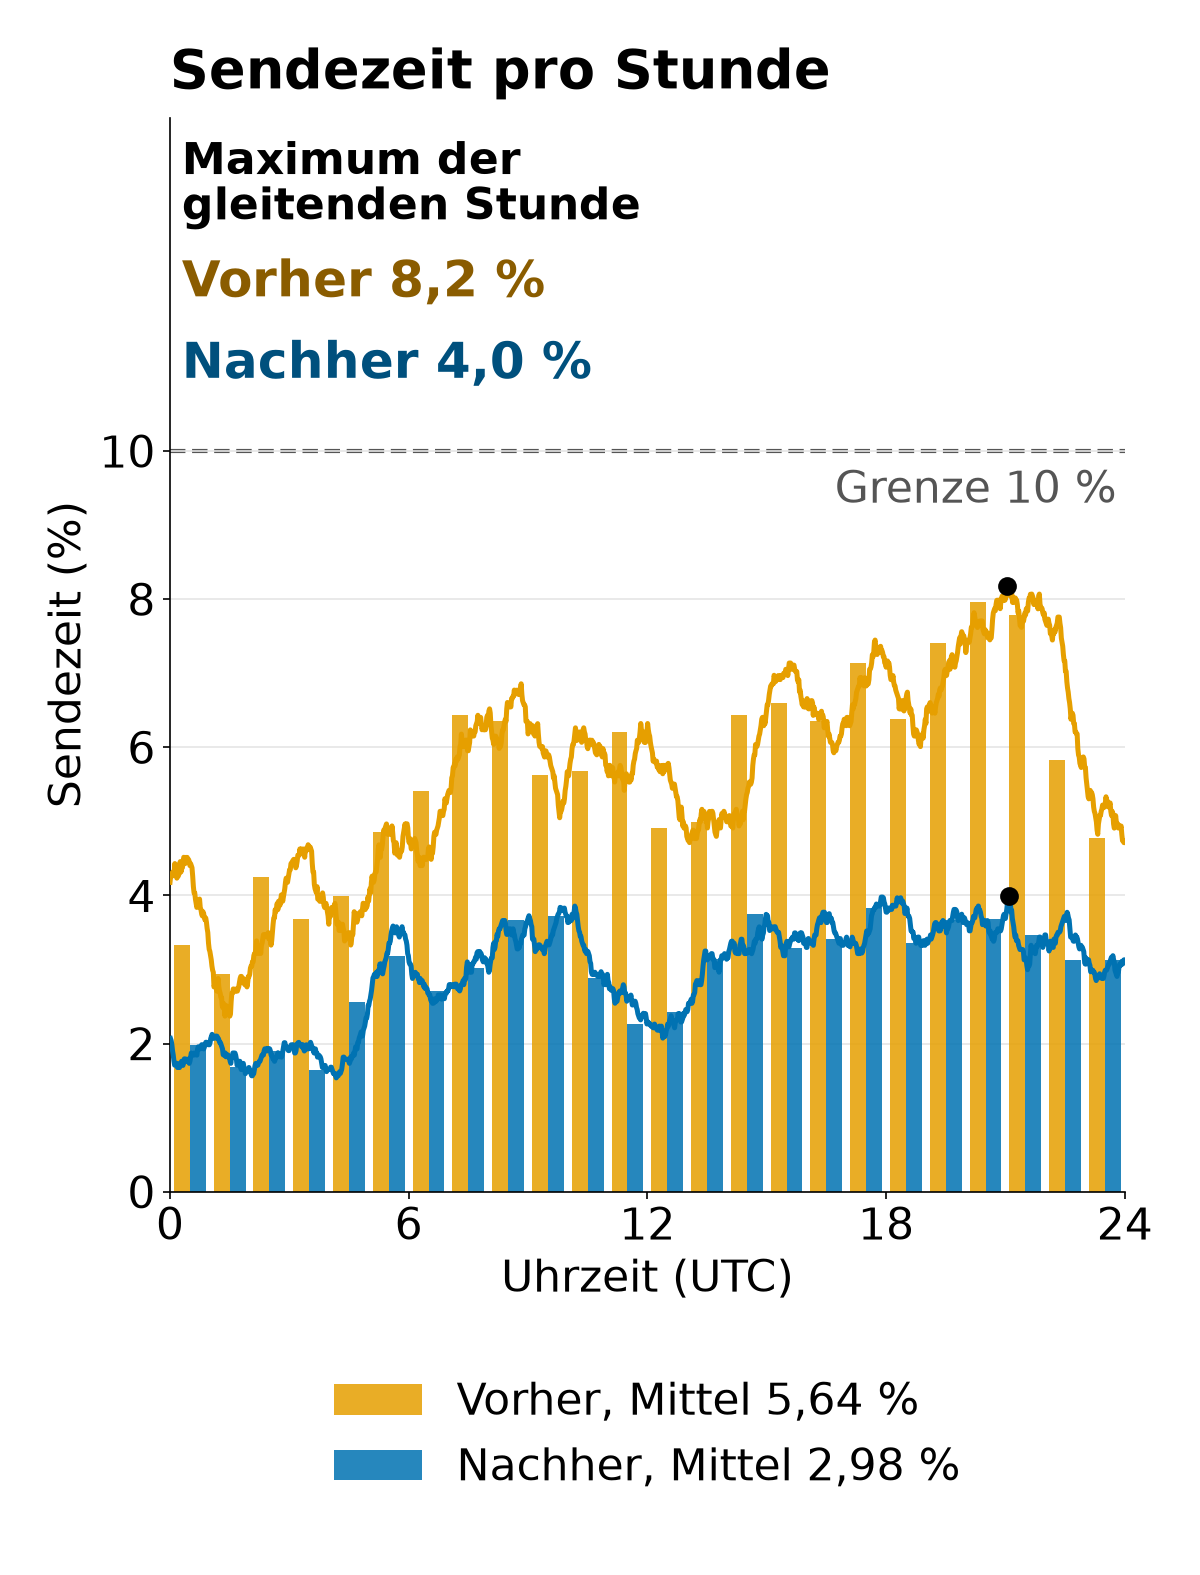
Die Sendezeit hat sich also ungefähr halbiert. Woher das kommt, lässt sich nicht sauber trennen, weil sich an zwei Tagen auch Verkehr und Timing ändern. Nach meiner Modellrechnung stammen rund 60 bis 70 % der Einsparung aus CR 4/5 und 30 bis 40 % aus den Filtern. Das heißt ehrlich gesagt: Der größte Hebel hätte den Fork gar nicht gebraucht. CR 4/5 geht auch mit der Standard-Firmware. Der Fork lohnt sich für mich wegen der Kanalfilter und vor allem wegen der Diagnose, ohne die ich vieles in Teil 2 und 3 nie gesehen hätte.
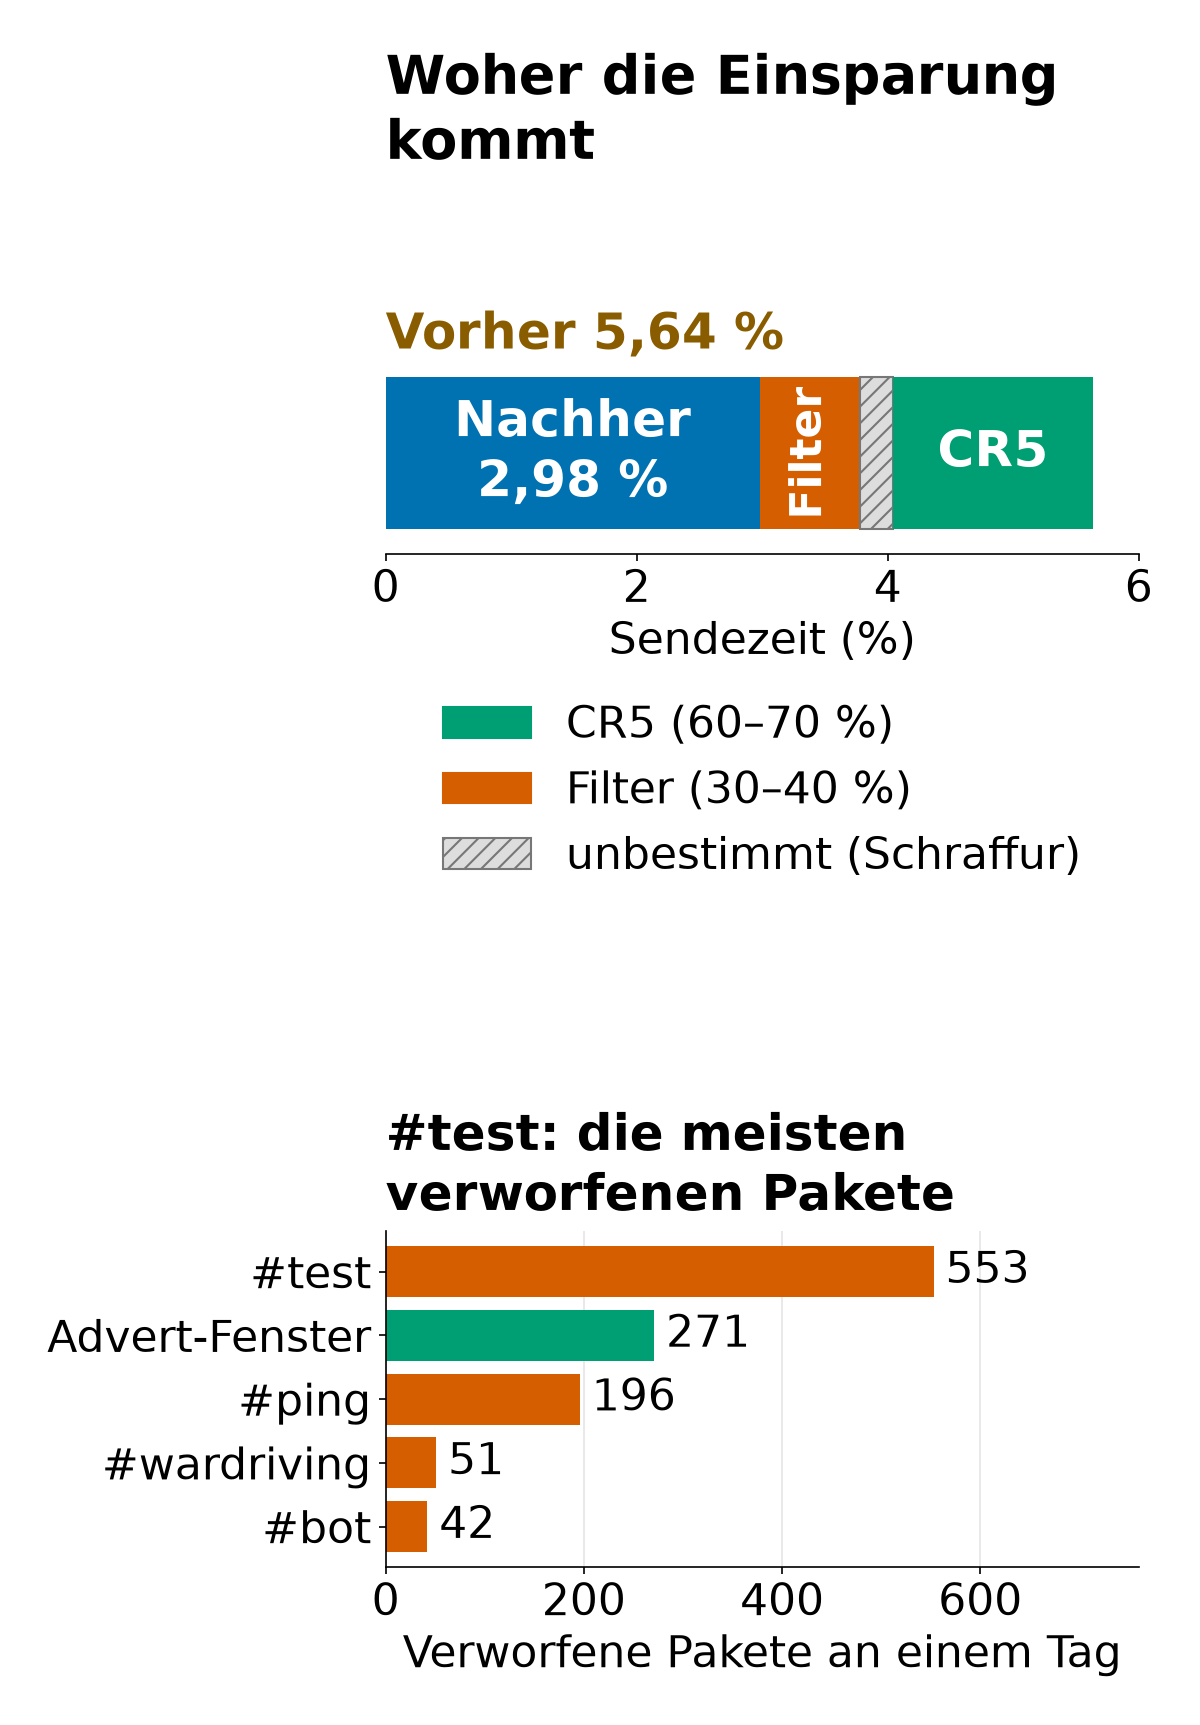
In CoreScope tauchen die gesperrten Kanäle mit 1863 im Pfad danach kaum noch auf. Ob sich bei anderen Gruppentexten etwas verändert hat, kann ich aus CoreScope nicht belastbar ablesen.
Offen sind drei Dinge, und ich schreibe sie bewusst als offen hin:
- Rund 42 % der Empfangsversuche enden bei 1863 als Fehler. Das ist kein Paketverlust von Ende zu Ende, sondern der Anteil der Pakete, die der Repeater beginnt und nicht sauber dekodiert. Die meisten Fehler kommen von schwachen Signalen an der Grenze. Selbst im stärksten SNR-Bereich sind es aber noch rund 8 %. Das passt zu Kollisionen, bewiesen ist es nicht.
- Seit CR 4/5 zählt der Repeater pro Stunde mehr Empfangsfehler als vorher. Warum, weiß ich nicht. Auch Teil 3 klärt das nicht.
- Der Speicher des Advert-Fensters ist voll. Er merkt sich die letzten 256 neuen Absender. Undicht würde das Fenster erst, wenn mehr als 256 verschiedene Absender in 24 Stunden kommen. Ob das passiert, habe ich nicht geprüft.
Und dann ist da noch CAD. CAD ist auf 1863 inzwischen aus, erst als Test, drei Tage später dann endgültig. Das weicht vom Community-Rezept ab, und in Teil 6, den ich vorher geschrieben habe, steht noch „CAD bleibt an“. Kurz darauf habe ich auch meine beiden Companions auf CAD aus gestellt und den Nachbar-Betreiber informiert. Warum ich das gemacht habe und was ich gemessen habe, steht ausführlich in Teil 2 dieser Serie.
Abstimmung mit Nachbarn und Community
Ein Filter auf einem Repeater wirkt lokal sofort. Er stoppt, was mein Repeater weiterleitet, ab der ersten Minute. Die Nachbarn tragen dieselben Pakete aber weiter. Wenn die direkten Nachbar-Repeater ähnliche Werte nutzen, verhält sich die Region einheitlich, und genau dafür lohnt es sich, miteinander zu reden.
Mit den direkten Nachbarn würde ich abstimmen: die Reihenfolge beim txdelay (ein höher gelegener Standort darf ruhig später weiterleiten), Hop-Limits, Kanalfilter und eine abweichende Coding Rate.
Mit der Community als Ganzes bleibt gleich: Funk-Preset, Region-Scopes, region denyf *, Pfad-Hash-Größe und Advert-Intervalle. Jede Abweichung davon, bei mir CR 4/5 und CAD aus, sollte man ankündigen, damit sich niemand wundert.
Die Konfiguration zum Abtippen
Das sind die Änderungen von 1863 gegenüber dem Rezept aus Teil 6. Schick die Befehle einzeln, Zeile für Zeile, an die CLI des Repeaters, über die serielle Konsole oder den Remote-Admin in der App. Das ist kein Shell-Skript.
set radio 869.618,62.5,8,5
set tx 20
set txdelay 1
set direct.txdelay 0.3
set rxdelay 0
set cad off
set flood.max 63
set flood.max.unscoped 0
set radio.rxps off
set max.resend 2
filter channel add #test
filter channel add #ping
filter channel add #bot
filter channel add #wardriving
filter hops 00 32
filter hops 01 32
filter hops 07 32
filter hops 04 64
filter advert 24
filter age off
filter malformed off
filter on
filter dryrun off
Ein paar Hinweise dazu. tx 20 gilt für einen Heltec V4 mit externem Verstärker, rechne vorher dein eigenes ERP aus. Bevor du set cad off übernimmst, lies bitte Teil 2. radio.rxps, max.resend und alle filter-Befehle gibt es nur im Fork. Unverändert vom Rezept sind dutycycle 10, path.hash.mode 1, loop.detect minimal, multi.acks 1, die Advert-Intervalle von 230 Minuten und 50 Stunden und die Regionen nach der Liste der Community. Und nach jedem Neustart oder Update: get radio.rxps.
Als Nächstes soll dasselbe Rezept auf einem tragbaren Test-Repeater mit Akku und Solarpanel laufen, mit dem ich mögliche Standorte prüfen will, bevor dort ein fester Repeater hinkommt. Die Feldtests stehen aber noch aus.
Anhang: alle Einstellungen im Überblick
Werte live von 1863 gelesen, Stand Mitte November.
| Gruppe | Option | Wert auf 1863 | Wofür | Warum dieser Wert | Effekt |
|---|---|---|---|---|---|
| Funk | radio | 869,618 / 62,5 kHz / SF8 / CR5 | Community-Preset, CR geändert | CR5 spart 28 bis 33 % Airtime pro Paket gegenüber CR8 | rund 60 bis 70 % der Einsparung (Modell); zusammen mit dem veränderten Paketmix 924 auf 583 ms pro Paket |
| Funk | tx | 20 | Ausgang des SX1262 vor dem Verstärker | meine Entscheidung; laut Kennlinie über tx 16 wenig Gewinn | ERP 25,5 bis 27 dBm geschätzt, nicht gemessen |
| Funk | radio.fem.rxgain | on | LNA im Frontend des Heltec V4 | Standard, mehr Empfindlichkeit | nicht getrennt gemessen |
| Funk | radio.rxps | off | RX-Stromsparen im Fork | Repeater am Netzteil; war nach dem Update an | |
| Timing | txdelay / direct.txdelay / rxdelay | 1,0 / 0,3 / 0 | Zufallsfenster Flood / Direct / SNR-abhängige Verzögerung | höher gelegener Nachbar darf später senden; rxdelay würde schwache, weite Pakete 1,5 bis 5 s bremsen | etwa +0,5 s pro Hop bei 100 Byte (Modell) |
| Duty | dutycycle | 10 % (Faktor 9) | Sendebudget als Token Bucket | Grenze im Teilband; keine Compliance-Garantie | Spitzenstunde 8,18 auf 4,00 % durch die Änderungen |
| Kanalprüfung | cad | off | Prüfung auf LoRa-Aktivität vor dem Senden | gemessen in Teil 2; weicht vom Rezept ab | siehe Teil 2 |
| Kanalprüfung | int.thresh / agc.reset.interval | 0 / 0 | Störschwelle / AGC-Reset | Standard, kein Grund für eine Änderung gefunden | |
| Flood-Grenzen | flood.max / flood.max.unscoped / flood.max.advert | 63 / 0 / 8 | Hop-Obergrenzen | 64. Hop würde den 6-Bit-Zähler überlaufen; 0 macht * deny ausdrücklich; 8 ist Standard | nicht getrennt gemessen |
| Scopes | region allowf / denyf | 15 Regionen erlaubt, * verboten; home und default de-nw | welche Scopes weitergeleitet werden | Community-Rezept | ungescopte Floods werden nicht weitergeleitet |
| Pfade | path.hash.mode / loop.detect / multi.acks | 1 (2 Byte) / minimal / 1 | Pfad-Hash, Schleifen, zusätzliches ACK | Community-Rezept | |
| Adverts | advert.interval / flood.advert.interval | 230 min / 50 h | eigene Adverts | Community-Rezept | |
| Zugang | Gastzugang / allow.read.only | wie im Rezept / off | anonymer Login | Community-Rezept | |
| Strom | powersaving | off | Schlafmodus im Fork | Netzteil; würde auch die serielle Konsole abschalten | |
| Fork | max.resend | 2 | Direct-Wiederholung pro Hop (PR #2670) | Fork-Standard 3; wenig Direct-Verkehr hier | kleiner Anteil, nur Zählerverhältnis |
| Filter | filter channel | #test #ping #bot #wardriving | Gruppentexte dieser Kanäle verwerfen | #test, #ping, #bot rund 19 bis 26 % der Airtime über 1863 (Schätzung); #wardriving meine Entscheidung | an einem Tag 553 / 196 / 42 / 51 verworfen; alle Filter zusammen rund 30 bis 40 % der Einsparung (Modell) |
| Filter | filter hops 00/01/07 | 32 | Hop-Limit für Flood-Anfragen und Antworten | niedrige Werte verhindern Pfadsuche und Login über weite Strecken | mit diesen Werten 0 verworfen |
| Filter | filter hops 04 und Rest | 64 (aus) | Hop-Limit Adverts und Sonstiges | 5 hat die Kontaktsuche beschnitten | 0 verworfen |
| Filter | filter advert | 24 h | wiederholte Flood-Adverts desselben Absenders verwerfen | Fork-Standard | 271 verworfen an einem Tag |
| Filter | filter age / malformed / hash / rate | off / off / 1 / off | weitere Fork-Regeln | age hätte 0 von 306 Public-Nachrichten getroffen; malformed und rate ohne Anlass; hash 2 würde Standard-Companions ausschließen | |
| Ergebnis | Dienstag vorher gegen Dienstag eine Woche später | Sendezeit 5,64 auf 2,98 %; Spitzenstunde 8,18 auf 4,00 %; Weiterleitungen 219 auf 182 pro Stunde; 924 auf 583 ms pro Paket | Empfang +2 %; Aufteilung CR5 rund 60 bis 70 %, Filter 30 bis 40 % (Modell) |
Die Kanalanteile und die Aufteilung der Einsparung auf CR 4/5 und Filter sind Schätzungen aus meiner eigenen Auswertung. Die Sendezeitwerte stammen aus dem Logger.
Anhang: welche Statistik welche Frage beantwortet
| Quelle | Statistik | Frage | Vorsicht |
|---|---|---|---|
| Logger am Pi, jede Minute | Empfang und Weiterleitungen pro Stunde, Sendezeit, ms pro Paket, Empfangsfehler, Warteschlange | Wie viel leitet der Repeater weiter, was kostet das an Sendezeit, hat eine Änderung etwas bewirkt? | immer dasselbe UTC-Fenster an vergleichbaren Tagen vergleichen |
| Logger, alle 10 Minuten | Nachbarn mit SNR und letztem Kontakt | Wen höre ich direkt, wie stark? | die CLI-Antwort wird nach etwa 8 Einträgen abgeschnitten, also mehrere Abfragen zusammenführen |
| Logger, alle 15 Minuten (nur Fork) | get cad belegt und erzwungen | Wie oft wartet der Repeater auf einen belegten Kanal? | Zähler sind kumulativ, also Differenzen bilden |
| dito | get rx.errors mit Histogrammen | Sind Fehlempfänge schwache Signale oder Kollisionen? | Fehleranteil ist kein Ende-zu-Ende-Verlust; RSSI durch den LNA erhöht |
| dito | filter stats | Was verwirft jede Regel, und wie viel Sendezeit schätzt die Firmware als eingespart? | nur der eigene Repeater, Nachbarn tragen die Pakete weiter |
| dito | get max.resend | Wie viele Wiederholungen zählt die Firmware im Verhältnis zu den Direct-Sendungen? | Zählerverhältnis, keine Ausfallrate |
| CoreScope-Tagesarchiv | Pakete über 1863 nach Typ und Kanal, direkte Hörer mit SNR und Entfernung | Was trägt mein Repeater zum Mesh bei, wo kommt das Signal an? | hängt von den Observern ab; 1-Byte-Hops sind mehrdeutig |
Was du jetzt tun kannst
Schau dir zuerst an, was dein Repeater sendet, bevor du irgendetwas filterst. Die Sendezeit pro Stunde und die Millisekunden pro Paket bekommst du aus den Statistiken der Standard-Firmware, und CoreScope zeigt dir, welche Kanäle über dich laufen. Wenn du CR 4/5 ausprobieren willst, kündige das vorher in deiner Community an. Wenn du den Fork einsetzt, mach vorher ein komplettes Backup, prüf die Partitionstabelle, flash nur das App-Image und lies danach jede Einstellung mit get und die Filter mit filter, filter channel list und filter hops gegen. Und bevor du ein Hop-Limit setzt, frag dich, was davon kaputt geht.
Siehe auch: Teil 1: LoRa und MeshCore, Teil 3: der Repeater, Teil 4: Antennen und Messen, Teil 5: MeshMapper, Teil 6: Konfiguration, MeshCore-Repeater tunen, Teil 2: CAD.
Links zu Amazon und AliExpress sind Affiliate-Links: Kaufst du darüber, bekomme ich eine kleine Provision, für dich ändert sich am Preis nichts. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen.
Wenn ihr selbst einen Repeater in der Gegend betreibt und eure Werte vergleichen wollt, oder wenn ihr in meinen Zahlen einen Fehler findet, dann dürft ihr mich sehr gerne fragen.
Danke für den ausführlichen Beitrag, ich habe ihn mit Interesse gelesen. Ein paar Worte dazu, warum mups bei 5 für die Paketfilter der Typen 00, 01 und 07 bleibt.
Erst mal zu deinem Wert 32: Die bringt in der Praxis eigentlich nichts . Im Repeater wird zuerst „flood.max“ geprüft und erst danach der Paketfilter. „flood.max“ sollte sowieso auf einen maximalen Wert begrenzt werden (bei mir ist es 15, bei vielen anderen noch weniger) und dann greift ein Filterlimit von 32 nie. Der Filter ist dann de facto abgeschaltet.
Die 5 ist dagegen bewusst gewählt. Requests und Responses machen bei uns inzwischen den größten Teil des weitergeleiteten Verkehrs aus. Wenn man die Netzlast senken will, damit Nachrichten zuverlässiger durchkommen, setzt man genau dort an. Mit 8 Hops kommt man, je nach Lage, schon fast quer durch Deutschland, eine Anhebung von 5 auf 8 würde also kaum etwas verbessern. Einen Repeater, der mehr als 5 Hops weg ist, kann man ohnehin kaum noch zuverlässig administrieren. Bleibt eigentlich nur die Pfadsuche zu einem DM-Kontakt, er mehr als 5 Hops entfernt ist). Wie oft das in der Praxis wirklich vorkommt und ob diese Verbindung dann tatsächlich noch stabil läuft, ist die Frage. Die Antwort auf eine Pfadsuche kommt übrigens als Typ 08 zurück, und der ist bei uns gar nicht begrenzt.
Deine Faustregel finde ich trotzdem gut: erst überlegen, welche Funktion man abschneidet, dann das Limit setzen. Bei uns ist das eben eine bewusste Abwägung zugunsten der Nachrichten.
Danke Michael, auch für die Erklärung aus erster Hand. Mit der 32 hast du recht, bei mir hat der Filter in zwei Tagen nur eine Handvoll Pakete erwischt, praktisch ist er also aus. flood.max steht bei mir allerdings noch auf 63, deshalb war 32 überhaupt erreichbar. Den Anteil von Requests und Responses sehe ich an meinem Standort etwas anders, ein Limit von 5 hätte hier je nach Tag 7 bis 14 % der Sendezeit über den Repeater gespart, nach Sendezeit sind die Gruppentexte der größte Block. Das kann bei euch natürlich ganz anders aussehen. Ich habe den Absatz im Beitrag entsprechend ergänzt.